Votre requête aboutit. L'application n'a toujours pas d'image exploitable. Le réponse contient peut-être un ID de tâche, ou l'image finale inclut un objet supplémentaire qui la rend inadaptée à la page.
Une API d'IA générative pour les développeurs permet à votre application d'envoyer des entrées à un modèle et de recevoir du contenu généré. Choisissez-en une en fonction de vos entrées requises, du format de sortie, du temps d'attente et de vos critères d'acceptation. Ensuite, mettez en place la gestion des tâches et les contrôles qui transforment une réponse en un résultat exploitable par l'utilisateur.
Ce guide suit un workflow d'images, de la sélection à la livraison. Vous y trouverez un tableau de sélection des tâches, des exemples correspondants en JavaScript et en Python, 3 briefs d'images concrets et une feuille de calcul des coûts. Le même processus de décision s'applique au texte et à la vidéo, avec des protocoles et des contrôles de sortie différents.
Points clés
- Choisissez la tâche et les critères d'acceptation avant le modèle.
- Enregistrez les ID de tâches asynchrones pour pouvoir reprendre un travail interrompu.
- Mesurez le coût par sortie acceptée, générations rejetées comprises.
- Testez les fichiers et les contraintes métier avant d'afficher un résultat final.
API d'IA générative pour les développeurs : de quoi s'agit-il
Un modèle réalise la génération. Une API définit la façon dont votre logiciel demande ce travail. Un SDK enveloppe l'interface dans des assistants propres à un langage. Une plateforme hébergée gère l'accès aux modèles, tandis que votre application fournit l'expérience utilisateur, les autorisations et les règles d'acceptation du résultat.
Ces distinctions comptent lorsqu'on consulte une page produit. Une application de chat qui crée des images ne prouve pas que son endpoint développeur accepte les mêmes entrées. Un SDK doté d'une méthode pratique ne supprime pas le besoin de comprendre la réponse sous-jacente et les états d'échec.
Commencez par la carte des tâches ci-dessous. La colonne interaction décrit une conception d'application à évaluer, et non la promesse que chaque fournisseur prend en charge ce mode.
| Tâche | Entrée | Capacité requise | Sortie | Interaction à évaluer | Critères d'acceptation |
|---|---|---|---|---|---|
| Brouillon de réponse support | Ticket et contenu d'aide approuvé | Génération de texte ancrée | Brouillon de texte | Synchrone ou streaming | Répond au ticket ; aucune politique inventée |
| Extraction de champs | Texte de document ou fichier pris en charge | Extraction structurée | Champs JSON | Requête ou tâche en file | Schéma valide et preuve source |
| Illustration éditoriale | Brief visuel écrit | Texte-vers-image | Fichier image | Tâche asynchrone | Objets, disposition, dimensions corrects |
| Édition d'image | Image source et instruction | Édition conditionnée par l'image | Image modifiée | Tâche asynchrone | Modification demandée ; détails préservés |
| Génération vidéo | Prompt ou référence prise en charge | Génération vidéo | Fichier vidéo | Tâche en file | Durée, mouvement, audio si requis, corrects |
| Réponse assistée par recherche | Question et passages récupérés | Récupération plus génération | Réponse et références | Synchrone ou streaming | Affirmations étayées par les passages récupérés |
Générer une image, analyser une image téléversée et éditer une image existante sont des capacités distinctes. Vérifiez chacune explicitement. De même, un endpoint vidéo peut prendre en charge une image de départ sans prendre en charge des références multi-images arbitraires.
Les embeddings convertissent les entrées en vecteurs utiles pour la recherche et la similarité. Ils peuvent aider à trouver des documents pertinents avant qu'une réponse soit générée. Ils ne produisent pas eux-mêmes la réponse et ne prouvent pas que le contenu récupéré étaye ses affirmations.
La frontière pratique est entrée → requête → sortie → acceptation par l'application. La dernière étape vous appartient. Un champ de facture généré doit encore être validé ; une image doit encore être inspectée ; une réponse support doit encore avoir la permission de faire la promesse qu'elle contient.
Les choix de protocole varient aussi. La référence de Google distingue la génération standard, le streaming et l'interaction en direct. Considérez cela comme la preuve que les modes d'interaction diffèrent, plutôt que de supposer une prise en charge identique ailleurs. (Référence de l'API Google Gemini, consulté en septembre 2026.)
API d'IA générative pour les développeurs : comment choisir
Rédigez un court brief d'acceptation avant de comparer les catalogues. Pour une fonctionnalité d'image éditoriale, cela peut préciser une sortie en paysage, un nombre d'objets limité, aucune marque visible et une étape de relecture humaine. Pour la classification de tickets, cela peut préciser un ensemble d'étiquettes fixe et un résultat incertain explicite.
Évaluez les candidats dans cet ordre :
- Entrées et sorties. Vérifiez l'endpoint exact du modèle pour les fichiers pris en charge, les limites d'entrée, les formats de sortie et le comportement des images de référence. Un nom de famille de modèles est trop large pour servir de contrat.
- Conformité à la tâche. Essayez des briefs représentatifs, y compris des cas délicats. Comptez les échecs de contrainte séparément des échecs de fichier ou réseau afin de savoir ce qu'il faut corriger.
- Adéquation à l'intégration. Confirmez l'authentification, les enveloppes de réponse, les valeurs de statut de tâche et la prise en charge des bibliothèques clientes. Incluez le travail nécessaire pour les adapter à votre backend existant.
- Temps d'attente et concurrence. Décidez si les utilisateurs peuvent partir et revenir. Testez votre charge de travail prévue avant de vous engager sur une expérience interactive à échéance courte.
- Clarté de la facturation. Identifiez l'unité facturable et les réglages qui la modifient. Vérifiez la gestion des échecs et des remboursements au lieu de supposer que chaque requête soumise reçoit le même tarif.
- Exigences en matière de données. Examinez le traitement des entrées, la conservation, la suppression et les conditions applicables au regard des données réelles que vous comptez envoyer. Documentez les questions non résolues avant d'utiliser des données sensibles.
- Gestion des changements. Maintenez un jeu de régression et enregistrez les identifiants de modèle, les prompts et les paramètres. Prévoyez comment vous réévaluerez le comportement après une mise à jour ou un remplacement.
Les recommandations institutionnelles illustrent pourquoi les règles d'accès et de données font partie de cette décision : Harvard décrit des voies d'accès approuvées et des restrictions concernant ses outils de développement IA. Ce sont les dispositions de Harvard, et non des autorisations universelles pour votre application. (Harvard University Information Technology, consulté en septembre 2026.)
| Voie d'accès | Équipe adaptée | Travail d'intégration | Responsabilité opérationnelle | Principale limite | À vérifier avant de choisir |
|---|---|---|---|---|---|
| Fournisseur de modèle direct | Équipe centrée sur les capacités d'un seul fournisseur | API, comptes et adaptateurs propres au fournisseur | Votre application et vos tâches ; inférence du fournisseur | Chaque fournisseur supplémentaire ajoute un contrat distinct | Fonctionnalités de l'endpoint, régions, quotas, conditions |
| Plateforme hébergée multi-modèles | Équipe évaluant plusieurs modèles pris en charge | Accès partagé plus validation propre à chaque modèle | Votre application et vos tâches ; inférence hébergée par la plateforme | L'accès partagé ne standardise pas tous les paramètres | Modèles exacts, schémas, facturation, chemin des données |
| Modèle ouvert auto-hébergé | Équipe disposant de compétences en infrastructure et en service de modèles | Déployer, exposer, sécuriser et maintenir l'inférence | Matériel, service, mise à l'échelle, supervision, mises à jour | Capacité et surcharge d'ingénierie | Licence, adéquation matérielle, débit, maintenance |
Atlas Cloud est une option hébergée à évaluer lorsque plusieurs capacités de modèles doivent cohabiter dans la même application. Cet article utilise son interface de tâches d'images comme exemple concret. Vous devez tout de même valider les entrées et sorties de chaque modèle ; changer uniquement un ID de modèle ne suffit pas.
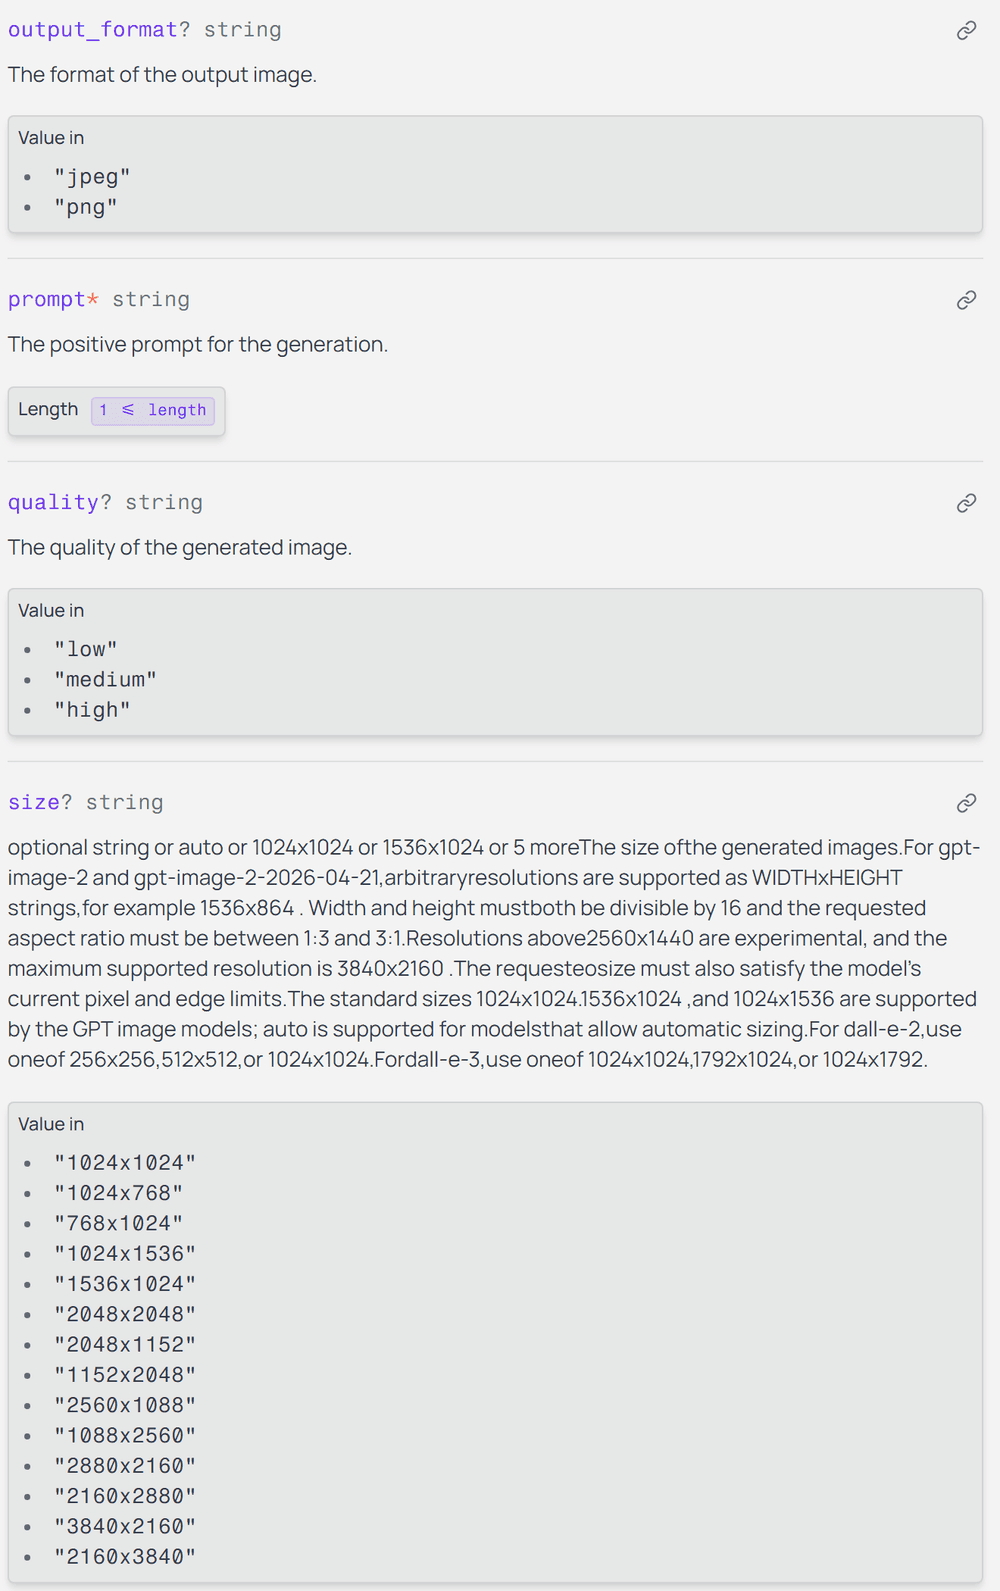
Documentation officielle de l'endpoint image montrant le format de sortie, la qualité et les contraintes de taille
Les paramètres propres au modèle font partie du contrat d'intégration. Lisez leurs valeurs autorisées avant de réutiliser un corps de requête.
Pour une petite équipe SaaS, la comparaison utile est l'effort total nécessaire pour livrer un résultat accepté. Incluez le code d'adaptation, l'investigation du support, le temps de relecture et les tests de migration en plus des frais d'inférence. Cela évite qu'un prototype pratique ne masque un workflow de production coûteux.
API d'IA générative pour les développeurs : première requête
L'exemple utilise GPT Image 2 Text-to-Image, avec l'ID de modèle openai/gpt-image-2/text-to-image. La documentation de son endpoint liste quality: high, size: 2048x1152 et output_format: png. Ce sont les réglages demandés pour les exemples ci-dessous.
1. Établissez le prompt dans le playground. Utilisez le brief petit-déjeuner ci-dessous sans ajouter d'image de référence. Vérifiez le nom du modèle et les réglages validés avant d'appuyer sur Run. Une sélection qui revient en arrière lorsque vous quittez un champ n'est pas le réglage que vous avez demandé.
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. Gardez l'authentification côté serveur. Votre frontend doit demander à votre propre backend de lancer une tâche. Stockez ATLAS_API_KEY dans l'environnement du serveur. Ne l'incluez jamais dans le JavaScript du navigateur, les URL d'images ou les journaux visibles côté client. Définissez ATLAS_API_HOST sur api.atlascloud.ai ; c'est un nom d'hôte, sans schéma ni chemin.
3. Soumettez une fois et conservez l'ID. La route de génération documentée est POST /api/v1/model/generateImage. Lisez data.id, puis associez-le à la tâche de votre application. Si la réponse de soumission est perdue, enquêtez avant de créer une autre tâche potentiellement facturable.
4. Interrogez la tâche enregistrée. Interrogez GET /api/v1/model/prediction/{prediction_id}. La documentation des prédictions décrit les statuts processing, completed et failed, avec les URL de sortie dans data.outputs. Un statut completed doit tout de même être vérifié pour confirmer que le tableau de sortie n'est pas vide.
5. Téléchargez et validez. Enregistrez le fichier sous votre contrôle, vérifiez qu'il se décode et inspectez-le au regard du brief. Ne renvoyez un résultat accepté à l'application qu'à cette condition. Une erreur de téléchargement ou de validation doit rester attachée à la tâche existante.
Le code suivant est assemblé à partir de la documentation officielle de l'interface. Il n'est pas présenté comme un benchmark d'API en direct. Le workflow média de cet article utilise le playground de test du navigateur, pas une clé API.
Enregistrez le prompt petit-déjeuner exact sous prompt.txt. Pour Node.js, utilisez un environnement doté de fetch intégré, installez sharp et enregistrez ceci sous generate.mjs. Exécutez-le dans un répertoire de travail dédié. N'exécutez qu'un seul des deux exemples de langage, sauf si vous voulez intentionnellement deux tâches.
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
L'équivalent Python plus court utilise requests et Pillow, le même prompt.txt et des réglages identiques. Il accepte également PREDICTION_ID pour la reprise. Ces scripts illustrent une tâche locale ; un service déployé a besoin d'enregistrements de tâches persistants et de téléchargements bornés.
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
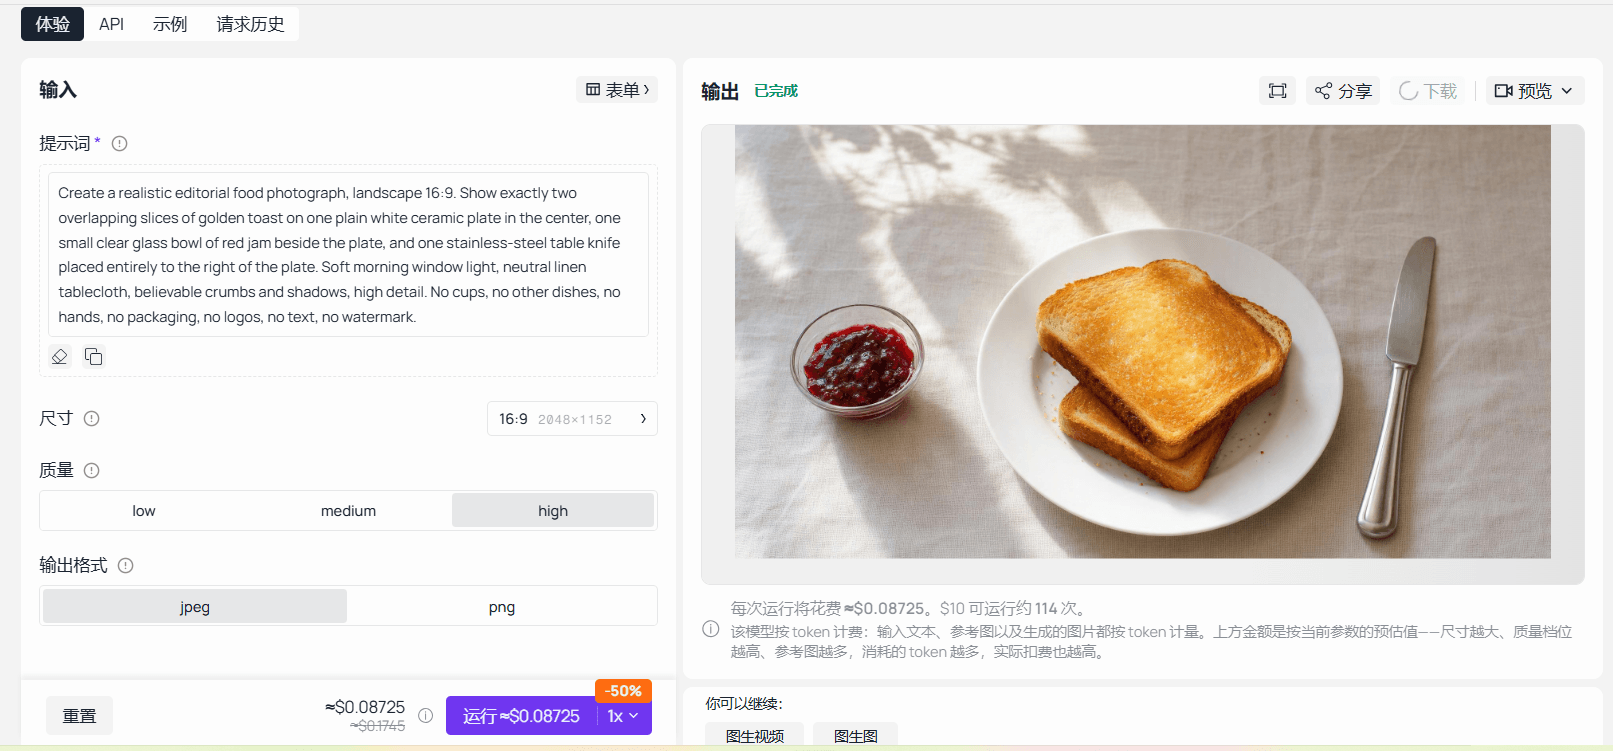 Playground GPT Image 2 terminé montrant le prompt petit-déjeuner soumis et le résultat final
Une exécution terminée dans le playground consigne ensemble le prompt soumis, la taille de sortie, le réglage de qualité et le résultat généré.
Une échéance de polling empêche ce client d'attendre ; elle n'annule pas le travail côté serveur. Une requête déjà en cours peut se terminer après la fenêtre de polling, ce qui n'est donc pas une garantie stricte de latence de bout en bout. Conservez l'ID et laissez un worker le vérifier plus tard.
API d'IA générative pour les développeurs : usages pratiques
Les 3 briefs ci-dessous testent des exigences différentes. Ce sont des requêtes indépendantes, et non une chaîne où un résultat devient l'entrée du suivant. Conservez le même modèle et les mêmes réglages demandés pour que les différences entre les briefs restent faciles à comprendre.
A. Image éditoriale culinaire : nombre et placement. Le prompt petit-déjeuner teste si la sortie contient 2 tranches de pain grillé, 1 assiette, 1 bol de confiture et 1 couteau. Le couteau doit être à droite de l'assiette, et tous les objets requis doivent rester dans le cadre.
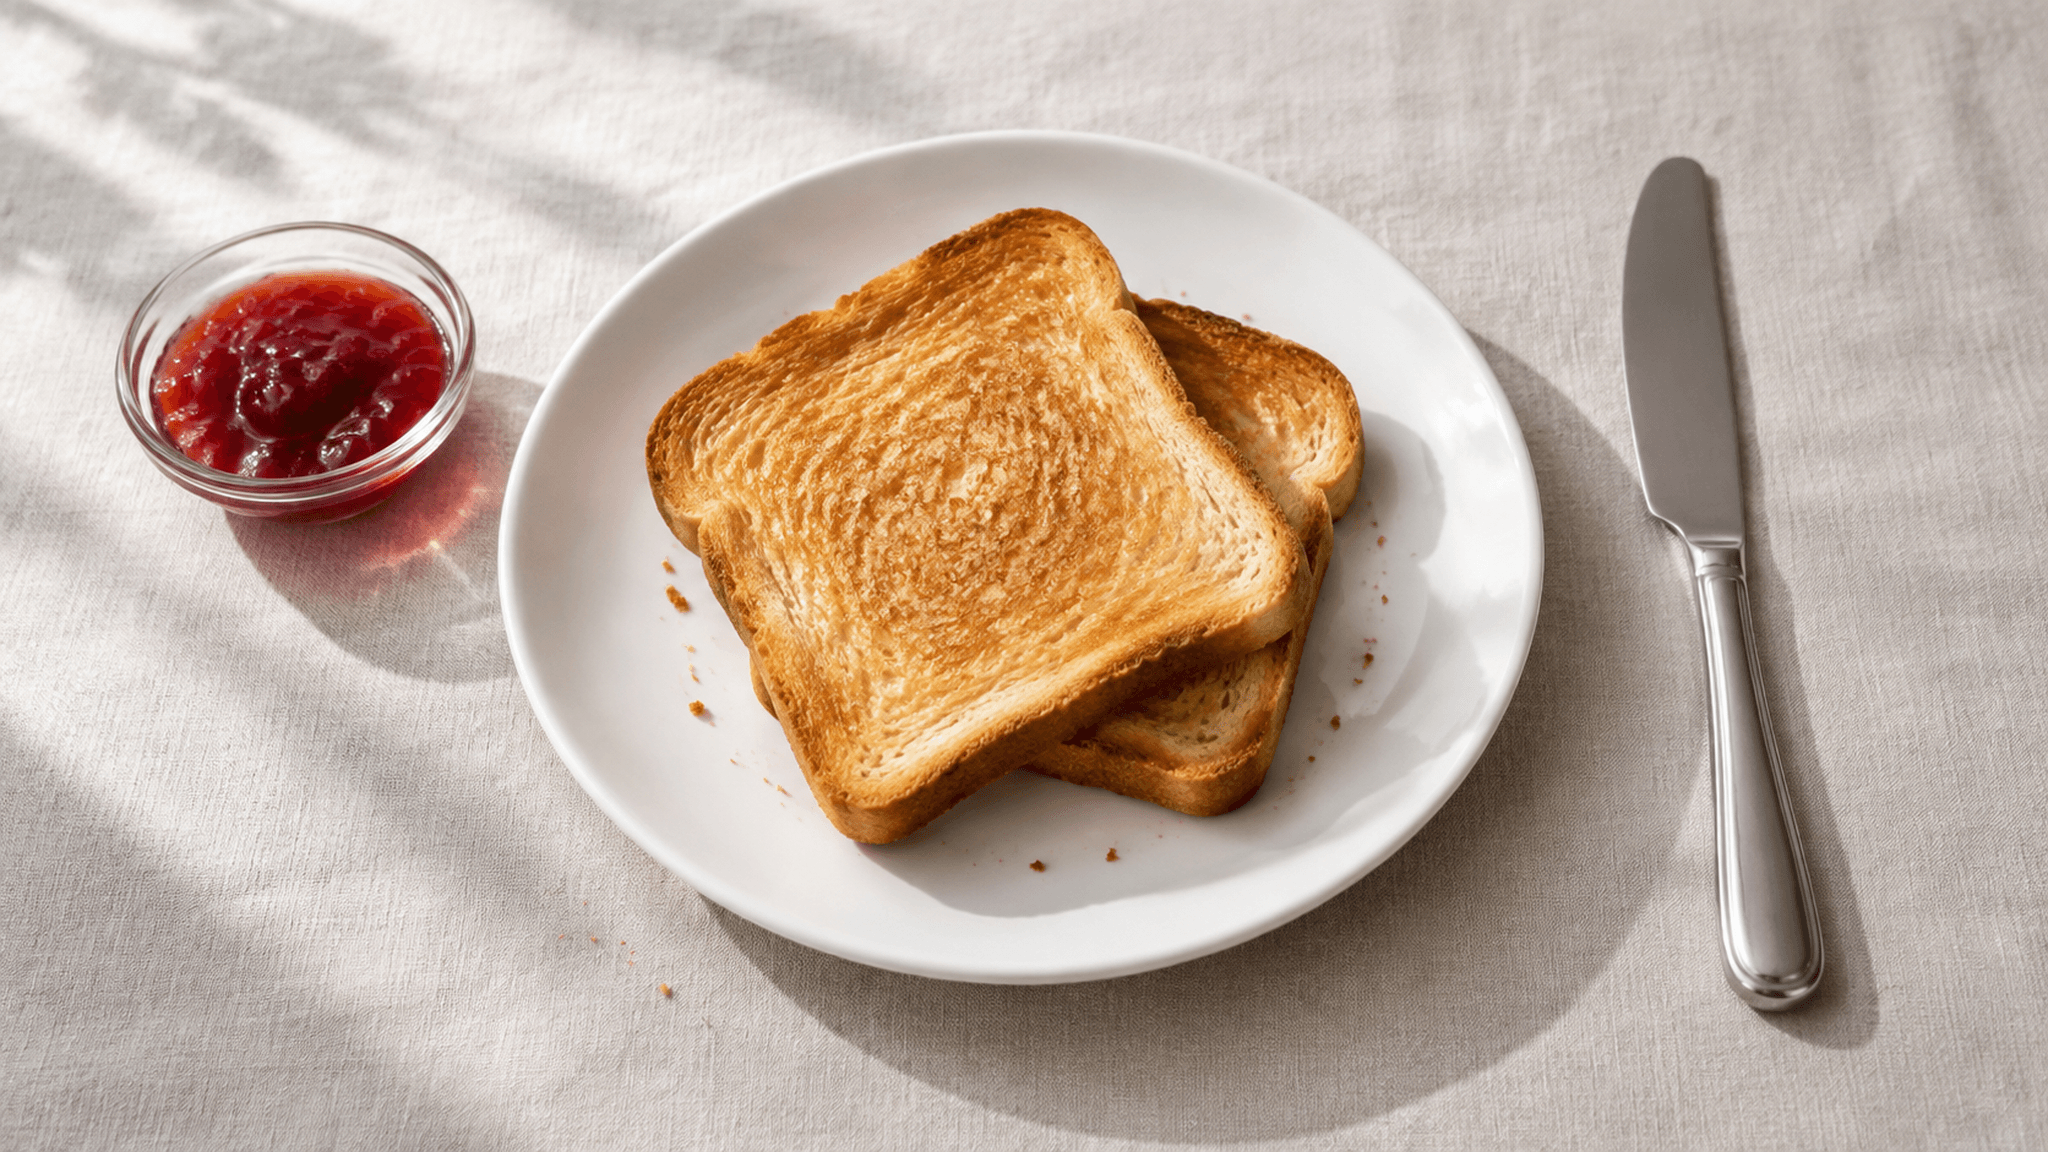
Exemple de génération d'image petit-déjeuner associé à un contrôle du nombre d'objets et du placement du couteausLe résultat généré contient l'assiette, le pain grillé, le bol de confiture et le couteau à droite demandés, prêt pour la vérification de placement ci-dessous.
Inspectez individuellement les tranches qui se chevauchent. Un petit-déjeuner visuellement convaincant peut tout de même échouer si une tasse apparaît en arrière-plan ou si le couteau se déplace sur l'assiette. Si un résultat échoue, révisez l'instruction spatiale ambiguë, changez une seule variable et conservez la raison du rejet. Évitez de demander à plusieurs reprises une image globalement meilleure.
B. Couverture d'article : espace utile pour le titre. Cette requête traite la composition comme une dépendance de mise en page. L'éditeur de la page a besoin d'un espace vide à gauche, tandis que le côté droit porte les outils et le pot. Ajoutez le titre réel plus tard en HTML/CSS pour qu'il reste modifiable et lisible.
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
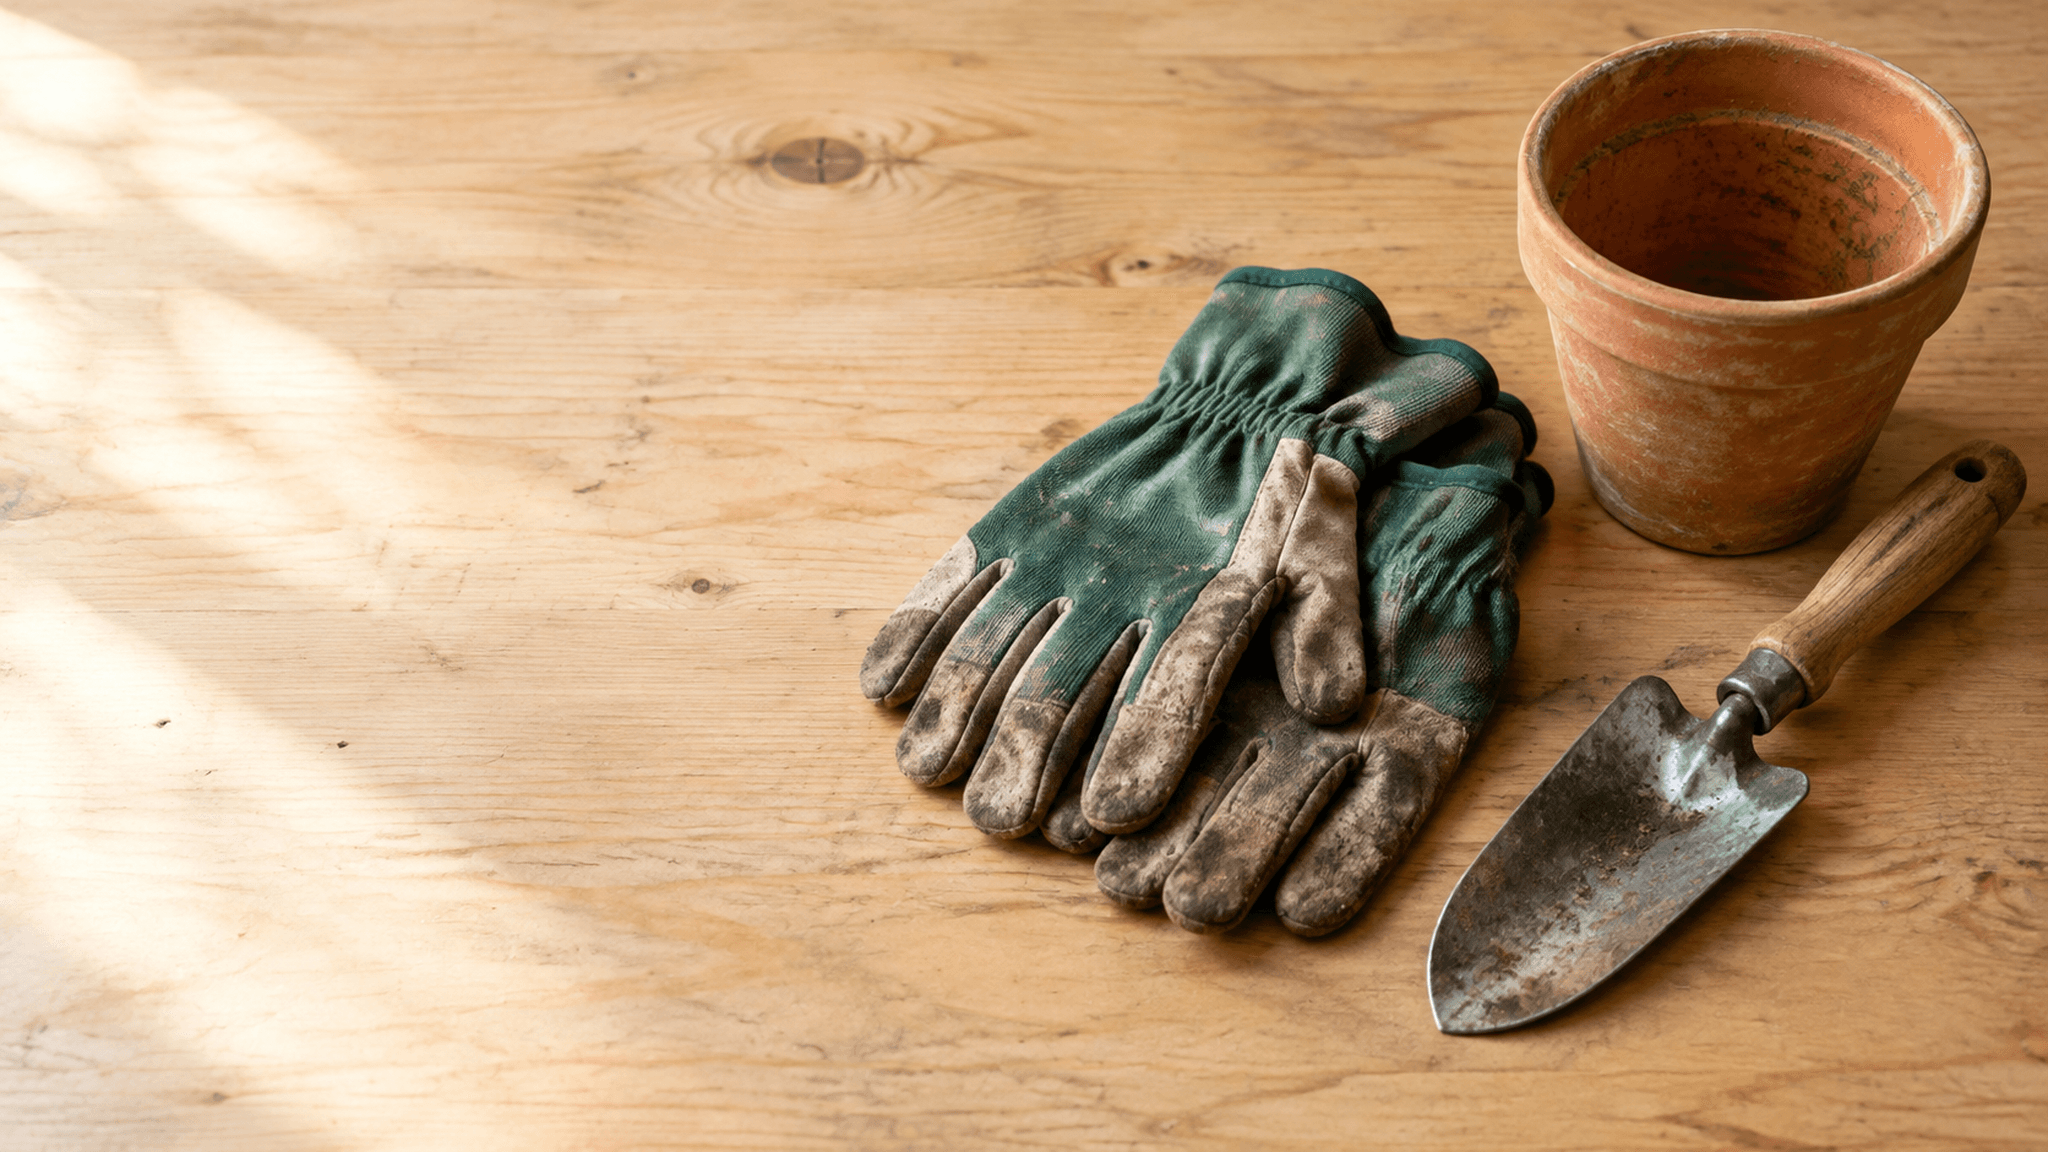 Exemple de couverture d'établi montrant l'espace demandé pour le titre à gauche et les objets à droite
Le résultat préserve un espace vide exploitable à gauche tout en gardant les gants, le pot et la truelle à droite.
Vérifiez le résultat au recadrage de publication prévu. Une image maîtresse en paysage peut perdre sa zone vide utile lorsqu'une carte mobile recadre au centre. Si la composition échoue, précisez des limites d'objets plus serrées ou modifiez le recadrage de l'application. Ne masquez pas l'échec en plaçant du texte sur les sujets demandés.
C. Illustration textile : détail et ordre. La requête suivante demande 3 échantillons pliés avec des textures visibles et distinguables. Elle teste le nombre, la position et la capacité du résultat à soutenir une illustration explicative à la taille où les lecteurs la verront.
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
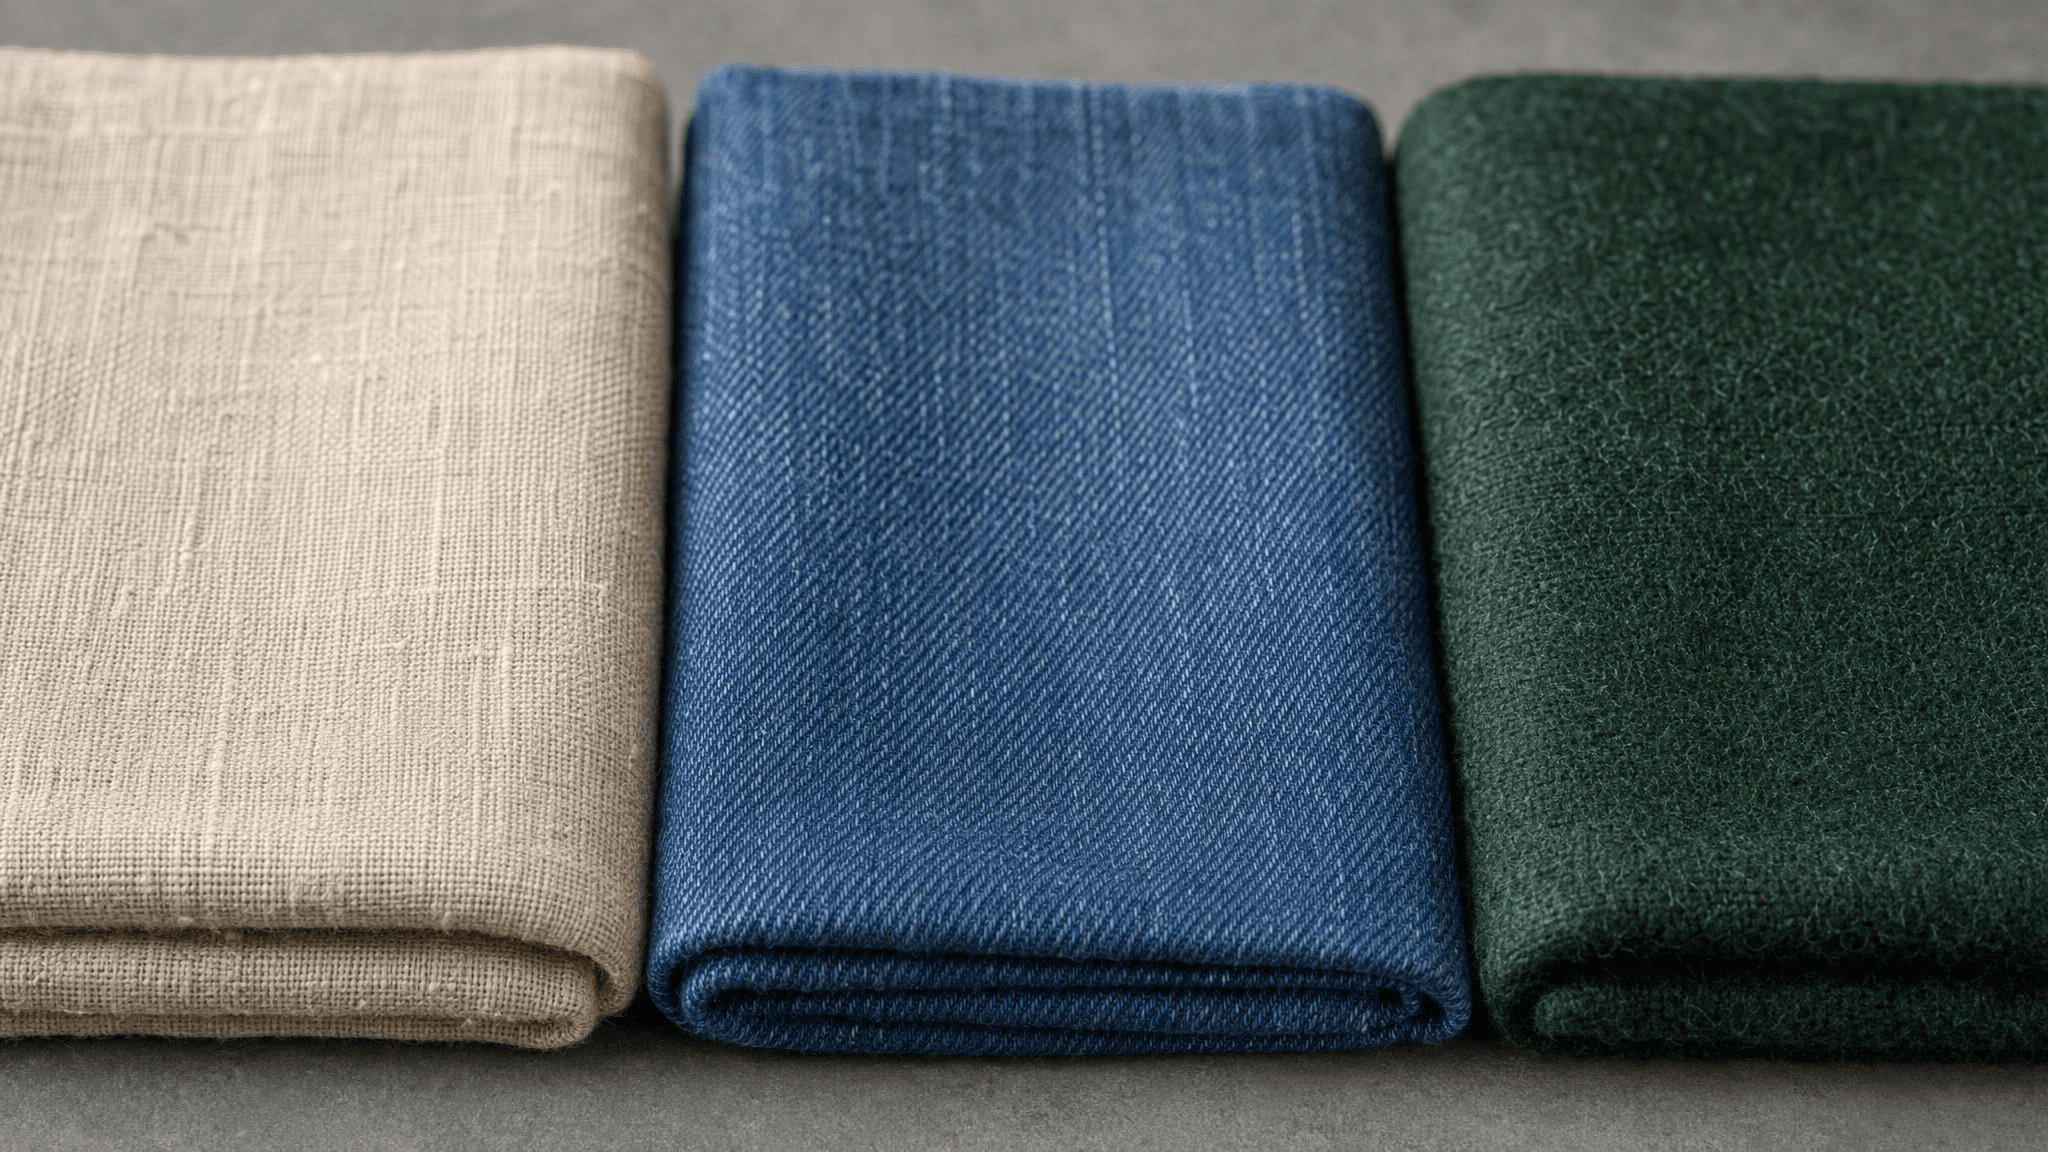 Illustration textile générée par IA avec vérification du placement des échantillons beige, bleu et vert foncé
Les trois échantillons demandés sont visuellement distincts. Cette texture générée est une illustration, et non la preuve de la composition fibreuse d'un vrai produit.
Si l'échantillon central manque d'une trame lisible, consignez ce problème et ajustez le cadrage ou l'instruction de détail. Ne décrivez jamais une texture générée comme une propriété mesurée d'un vrai produit.
Les fonctionnalités textuelles exigent des contrôles tout aussi précis. Pour la classification de tickets, rejetez les étiquettes hors de l'ensemble autorisé et conservez une route incertaine. Pour l'extraction de documents, exigez les champs et les passages sources en plus d'un JSON analysable. Une réponse syntaxiquement valide peut tout de même placer le mauvais montant dans le mauvais champ.
API d'IA générative pour les développeurs : gérer les échecs
Suivez séparément le succès du transport, l'achèvement de la tâche et l'acceptation métier. Une réponse HTTP réussie peut contenir une tâche en traitement. Une tâche terminée peut produire un téléchargement défectueux. Une image lisible peut violer le brief. Chacun nécessite une action de récupération différente.
Définissez délibérément 3 horloges : un délai HTTP individuel, un intervalle de polling et une fenêtre d'attente globale. Les exemples utilisent un délai de requête API de 30 secondes, un polling de 2 secondes et une fenêtre de polling de 10 minutes. Ce sont des choix d'application, et non des performances de service annoncées.
| Symptôme | Cause possible | À vérifier ensuite | Approche de nouvelle tentative |
|---|---|---|---|
| Erreur de paramètre | Champ ou valeur non pris en charge | Schéma exact de l'endpoint et payload soumis | Corrigez d'abord la requête |
| HTTP 401 | Problème d'authentification ou mauvaise route | Configuration de la clé et chemin de l'endpoint | Aucune nouvelle tentative inchangée |
| Solde insuffisant | Solde ou allocation disponibles | État de facturation du compte | Réglez d'abord le financement ou l'allocation |
| HTTP 429 | Limite de débit atteinte | Concurrence compte/modèle et débit de requêtes | Backoff borné avec jitter |
| Tâche signalée comme échouée | Échec du modèle, de l'entrée ou de la politique | ID de prédiction, code d'erreur, détail de l'erreur | Enquêtez avant une nouvelle génération |
| Délai de polling dépassé | Échéance client ou tâche lente | Statut actuel de la tâche existante | Reprenez l'interrogation du même ID |
| Completed avec sortie vide | Résultat manquant ou inattendu | Réponse complète et structurée de la tâche | Signalez pour enquête ; pas de renvoi aveugle |
La documentation actuelle des erreurs de la plateforme indique que les endpoints LLM et média ne fournissent pas d'en-têtes Retry-After ni de limite de débit restante. Utilisez une politique de délai côté client ; ne faites pas dépendre la récupération d'un en-tête que ces routes ne renvoient pas. D'autres familles d'API peuvent se comporter différemment.
Limitez les nouvelles tentatives automatiques de lecture. Des délais exponentiels avec un peu de jitter aléatoire aident à éviter que de nombreux workers réessaient en même temps. Réduisez la concurrence si la limitation persiste. Les échecs répétés doivent devenir un incident observable plutôt qu'une boucle sans fin cachée derrière un spinner.
Les nouvelles tentatives de soumission méritent un traitement plus strict. Lorsqu'une connexion se ferme après l'envoi du corps, vous ne savez peut-être pas si le serveur a créé une tâche. Enregistrez une intention locale avant la soumission et enquêtez sur l'historique des requêtes ou les traces du support lorsqu'aucun ID de prédiction n'arrive. N'inventez pas d'en-tête d'idempotence, sauf si l'endpoint le documente.
Une fois que vous avez un ID, utilisez-le pour reprendre. Un échec de téléchargement doit déclencher une autre tentative de téléchargement ou une vérification de statut, et non une nouvelle requête de génération d'image. Les exemples conservent délibérément le comportement de nouvelle tentative automatique sur les lectures de polling et s'arrêtent sur une soumission échouée.
Pour chaque tâche, conservez votre ID de tâche d'application, l'ID de prédiction, les ID de requête, le modèle, les réglages, les horodatages et la décision finale. Stockez les prompts uniquement dans le cadre d'une politique de données appropriée. Ne mettez jamais d'en-têtes d'autorisation ni de contenu utilisateur sensible dans les journaux d'erreurs généraux.
Donnez au frontend des états qu'il peut expliquer : préparation, traitement, vérification de la sortie, prêt ou attention requise. Affichez une tâche récupérable lorsqu'une personne recharge la page. Désactivez les soumissions répétées tant que la même tâche locale est en attente, tout en autorisant une nouvelle requête intentionnelle le cas échéant.
API d'IA générative pour les développeurs : coûts réels
Un prix de requête bas ne vous dit pas le coût d'une fonctionnalité exploitable. Votre budget a besoin du montant facturé, du nombre de sorties acceptées et du travail de support nécessaire pour les livrer.
Les API de texte distinguent généralement les tokens d'entrée et de sortie. Un long contexte, des passages récupérés, l'historique de conversation et des réponses répétées peuvent tous contribuer à l'usage. Enregistrez les catégories réellement facturées par l'endpoint choisi, au lieu d'appliquer une estimation de token unique à chaque charge de travail.
Pour les images, examinez l'unité de facturation et la configuration du modèle exact. La taille et la qualité peuvent affecter la facturation différemment selon les modèles. Pour la vidéo, la durée, la résolution et le choix du modèle peuvent modifier le tarif. Ne transformez pas un prix de départ de catalogue en devis pour une configuration spécifique.
Le prix exact haute qualité 2048 × 1152 du modèle d'image sélectionné n'a pas été vérifié à la fois dans le catalogue et la page de détail lors des recherches pour cet article. Aucun prix unitaire ni remise actuel n'est affirmé ici. Confirmez-le avant de lancer une évaluation de production payante.
Utilisez 2 calculs liés :
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
Gardez la même période d'observation. Pour le stockage continu, précisez si le calcul couvre le premier mois, une période de conservation définie ou un coût récurrent alloué. Évitez de comparer le chiffre d'inférence seul d'un modèle avec le coût complet d'un autre workflow.
Exemple hypothétique : vous soumettez 100 requêtes et acceptez 80 sorties. Divisez le montant total réel facturé pour ce lot par 80. Si les 100 requêtes étaient facturées un montant identique c, le coût API par sortie acceptée serait 1,25c. Cette condition compte : elle ne suppose pas que chaque requête échouée est facturée.
| Modèle | Réglages | Soumissions | Montant réel | Sorties acceptées | Coût API par sortie acceptée | Date de mesure |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high ; 2048x1152 ; PNG | À consigner | À consigner | À consigner | À calculer | À consigner |
| Même modèle, lot d'évaluation suivant | Consignez les réglages exacts | À consigner | À consigner | À consigner | À calculer | À consigner |
Utilisez ceci comme une feuille de calcul, non comme un tableau de résultats. Les démonstrations d'images n'établissent ni un taux d'acceptation représentatif ni un coût de production. Séparez les devis du playground des relevés de facturation réglés, en particulier lors d'une évaluation dans un environnement de test.
Lorsque les sorties acceptées sont égales à zéro, rapportez le lot comme infructueux et affichez la dépense totale. Un ratio coût par sortie acceptée est indéfini dans ce cas. Masquer les lots échoués donnerait à votre budget une meilleure apparence que le comportement réel de l'application.
Réduisez d'abord le gaspillage : validez les entrées avant soumission, enregistrez les ID de tâche, évitez les doublons accidentels et réutilisez les ressources acceptées lorsque le produit le permet. Comparez ensuite des réglages moins chers sur les mêmes briefs et contrôles. Un réglage qui réduit le devis mais double le travail de rejet peut augmenter le coût de la fonctionnalité.
Testez la sortie, pas seulement la réponse
Rédigez les critères d'acceptation pendant que vous élaborez le prompt. Cela évite qu'une image convaincante modifie votre définition du succès après coup. Séparez les exigences strictes des préférences optionnelles, et consignez pourquoi un relecteur a rejeté un résultat.
Automatisez les contrôles qui ont des réponses mécaniques claires : succès du téléchargement, décodage du fichier, format, dimensions et limites de taille de fichier. Pour le JSON, validez le schéma, les champs requis, les étiquettes autorisées et les types. Un champ requis manquant ne doit pas devenir discrètement une valeur par défaut inventée.
Faites appel à la relecture humaine pour les exigences qui nécessitent une interprétation. Dans l'exemple du petit-déjeuner, un relecteur doit distinguer les tranches qui se chevauchent, identifier le couteau, évaluer sa position et rechercher des objets supplémentaires. Un vérificateur de vision automatisé peut aider, mais évaluez ses erreurs avant de le laisser approuver seul des résultats.
La relecture du petit-déjeuner doit inclure les contrôles indépendants suivants :
- Exactement 2 tranches de pain grillé, 1 assiette blanche, 1 bol transparent de confiture et 1 couteau.
- Couteau à droite de l'assiette ; objets requis entièrement dans le cadre.
- Aucune tasse, vaisselle, main, emballage ni marque visible supplémentaire.
- PNG lisible aux dimensions demandées.
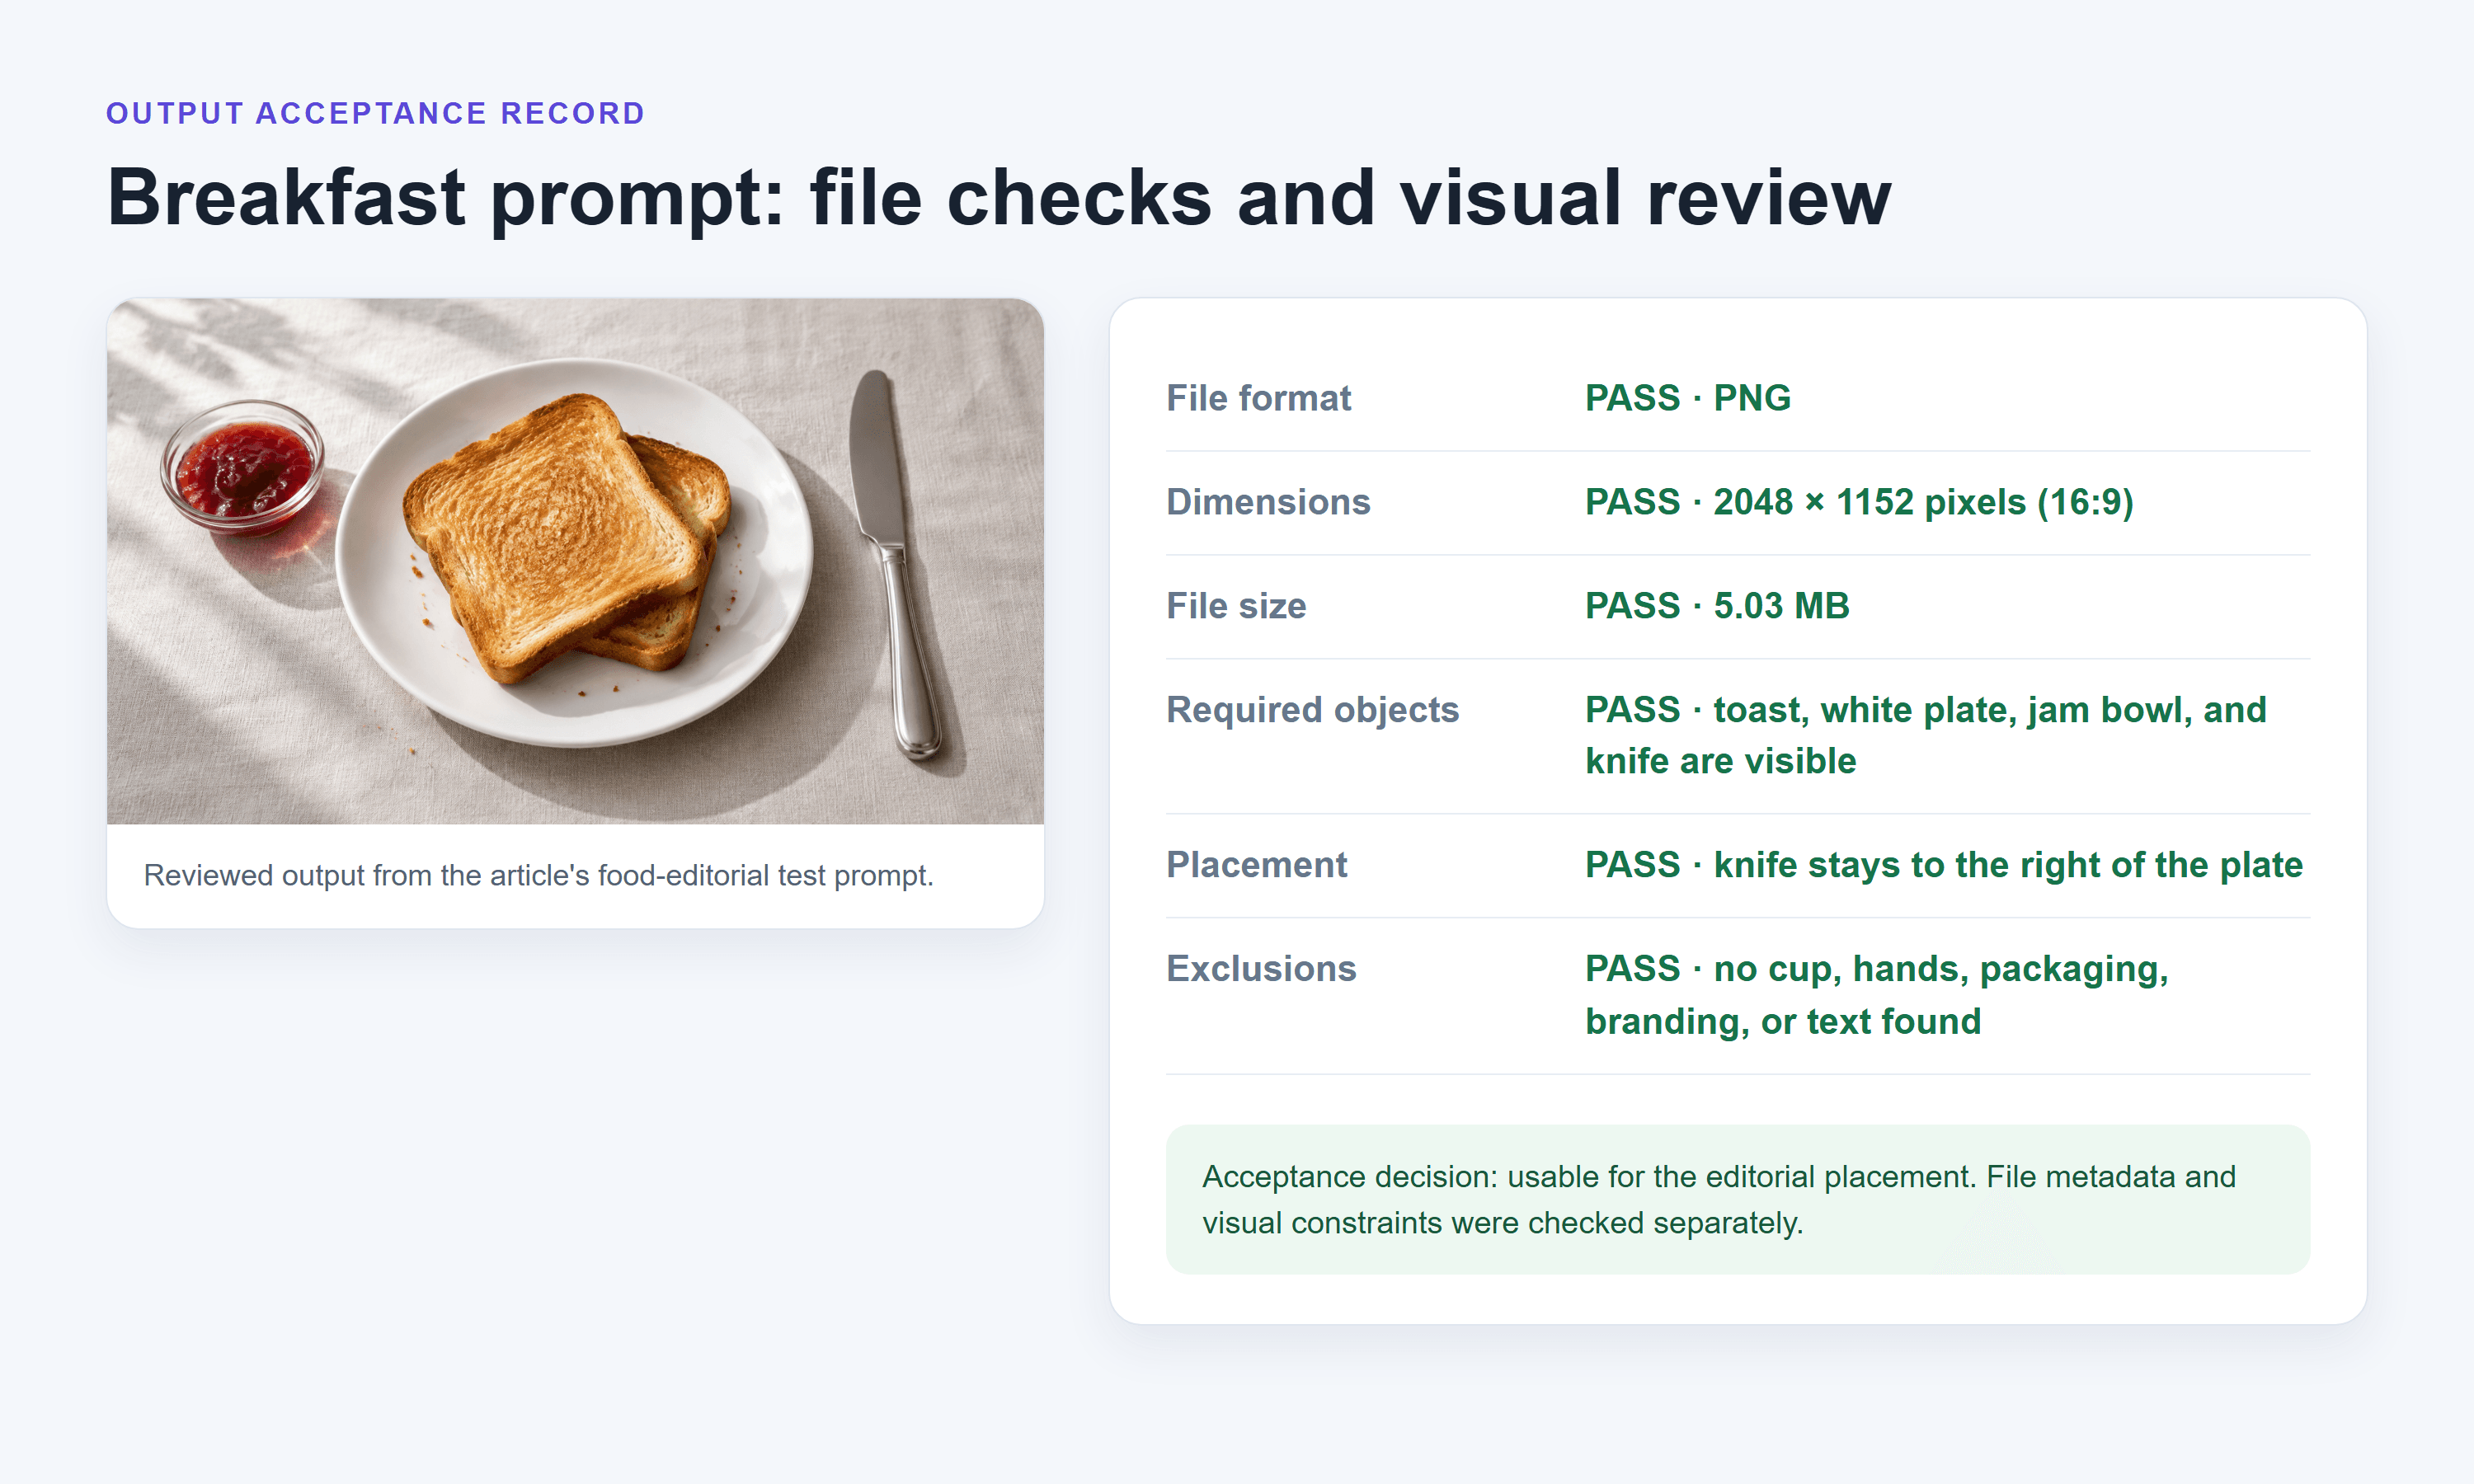 Enregistrement de validation séparant les contrôles de métadonnées de fichier des contrôles d'acceptation visuelle
L'enregistrement rapporte les dimensions et la taille réelles du fichier généré, séparément de ses contrôles d'acceptation visuelle.
Construisez un jeu de régression fixe à partir de la fonctionnalité réelle : requêtes ordinaires, compositions chargées, instructions contradictoires, recadrages difficiles et limites d'entrée pertinentes. Versionnez les briefs et les règles de relecture. Répétez-les lors d'un changement de modèle, de modèle de prompt ou de réglages de sortie.
Rapportez séparément le succès technique et le taux de sorties acceptées. Un fichier lisible qui contient un objet supplémentaire compte comme une livraison réussie et un rejet de contenu. Combiner ces résultats en un seul chiffre de succès masque la correction dont votre équipe a besoin.
L'enquête auprès des développeurs de 2025 a révélé que 46 % se méfiaient de l'exactitude des outils IA et 33 % lui faisaient confiance ; 3 % déclaraient une confiance élevée. Ces réponses concernent les outils IA dans les workflows de développement, et non un taux d'échec mesuré pour les API de génération. (Stack Overflow Developer Survey, 2025.)
De même, 3 exécutions illustratives ne peuvent établir une exactitude globale ni une latence p95 utile. Collectez un échantillon plus large et pertinent dans les conditions que vous anticipez en production, et conservez les valeurs aberrantes. Utilisez les démonstrations pour développer les contrôles, puis une évaluation systématique pour prendre une décision de mise en production.
Checklist de production avant livraison
La première requête fonctionnelle ne règle qu'une petite partie de la décision de livraison. Votre application doit aussi maîtriser les dépenses, récupérer le travail inachevé et expliquer ce qui s'est passé lorsqu'aucun résultat n'est disponible.
Protégez l'accès. Gardez les identifiants côté backend, séparez les environnements, restreignez l'accès aux enregistrements de tâches et prévoyez la rotation des identifiants. Autorisez chaque requête de statut et de téléchargement en fonction de l'utilisateur propriétaire de cette tâche. Un ID de tâche imprévisible ne remplace pas les contrôles de permission.
Bornez les entrées et l'usage des ressources. Validez la longueur du prompt, le type et la taille des téléversements, les réglages de sortie demandés et les combinaisons prises en charge. Pour les médias téléchargés, imposez des destinations autorisées, des redirections, des limites d'octets et des limites de décodage. Les scripts compacts ci-dessus illustrent le cycle de vie ; ce ne sont pas des services de téléchargement publics durcis.
Fixez des budgets avant la soumission. Définissez des limites par utilisateur et par tâche, un nombre maximal de tâches simultanées et qui peut demander des réglages plus coûteux. Réservez le budget pendant que le travail est en attente pour que des requêtes simultanées ne puissent pas toutes passer le même contrôle de solde restant.
Persistez l'état. Écrivez la tâche locale avant d'appeler le fournisseur. Enregistrez immédiatement l'ID de prédiction renvoyé et rendez le polling reprenable après un redémarrage de processus. Si le statut de soumission est inconnu, utilisez un état d'enquête plutôt que de dire aux utilisateurs que la tâche a définitivement échoué.
Assumez la propriété du fichier livré. Décidez où vivent les fichiers acceptés, qui peut y accéder et quand ils expirent. Vérifiez la durée de vie des liens fournisseurs et les conditions de conservation plutôt que de dépendre indéfiniment d'une URL de sortie temporaire. Incluez la suppression des fichiers dérivés dans le workflow de données de l'application.
Rendez l'échec compréhensible. Distinguez une tâche retardée, un résultat rejeté et une erreur de service. Offrez une voie claire pour réessayer intentionnellement ou demander une relecture. Conservez le brief de l'utilisateur pour que la récupération n'exige pas de reconstruire le travail.
Surveillez les changements. Suivez séparément l'achèvement, l'acceptation, le coût et le temps d'attente. Relancez le jeu de régression après des changements de modèle ou de paramètres, et gardez la configuration précédente disponible lorsque c'est faisable. Masquez les journaux sensibles et attribuez des durées de conservation au contenu comme aux enregistrements opérationnels.
Pour évaluer la plateforme d'exemple dans le cadre de votre propre application, commencez par le catalogue de modèles Atlas Cloud, puis lisez la documentation de l'endpoint et des prédictions sélectionné. Choisissez une tâche, définissez l'acceptation et consignez ce que l'évaluation livre réellement avant d'élargir l'accès.
Questions fréquentes
Quelle API d'IA générative choisir pour mon application ?
Choisissez en fonction des entrées, des sorties, du temps d'attente acceptable et des exigences de relecture de la fonctionnalité. Exécutez les mêmes briefs représentatifs sur les candidats que vous pouvez utiliser légalement et opérationnellement. Comparez le coût par sortie acceptée et le travail d'intégration en plus des capacités. Aucun choix universel n'est établi par ces 3 exemples d'images.
Existe-t-il des API d'IA générative gratuites pour les développeurs ?
Certains services proposent des essais ou un usage gratuit limité, mais la disponibilité, l'éligibilité, les quotas et les usages autorisés changent. Vérifiez les conditions actuelles pour l'endpoint exact. Une allocation gratuite d'outil grand public n'inclut pas nécessairement l'accès API. L'auto-hébergement consomme aussi du matériel, de l'électricité et du temps d'ingénierie, même lorsque les poids du modèle sont téléchargeables.
Faut-il de l'expérience en machine learning pour utiliser une API d'IA générative ?
Vous pouvez commencer avec des compétences en HTTP, JSON, authentification et développement backend courant. Livrer une fonctionnalité fiable demande en plus un travail d'évaluation et d'exploitation. Vous devez comprendre les limites du modèle assez bien pour définir une sortie acceptable, sans nécessairement entraîner vous-même un modèle.
Une seule API peut-elle gérer le texte, les images et la vidéo ?
Une plateforme peut proposer les 3, mais chaque capacité peut utiliser des endpoints, des paramètres, des types de sortie et des schémas d'attente différents. Vérifiez chaque interface séparément. Un compte ou un identifiant partagé ne rend pas un corps de requête texte compatible avec un modèle d'image ou de vidéo.
Pourquoi ma requête d'image renvoie-t-elle un ID de tâche plutôt qu'une image ?
L'endpoint soumet le travail de manière asynchrone. Enregistrez l'ID et interrogez la route de statut documentée. Récupérez le fichier lorsque la tâche se termine, puis validez-le. Si votre client cesse d'attendre, la tâche côté serveur peut encore être en cours ; reprenez cette tâche avant d'en soumettre une autre.
Comment réduire les coûts API sans casser le workflow ?
Évitez les soumissions en double, validez tôt les entrées, réutilisez les ressources acceptées lorsque c'est pertinent et testez des configurations moins chères avec des critères d'acceptation inchangés. Mesurez les montants réels facturés par résultat accepté. Une API d'IA générative pour les développeurs mérite sa place lorsque l'application qui l'entoure peut livrer un travail exploitable à un coût que vous pouvez soutenir.


