Le code semble terminé. Puis les tests échouent, le correctif modifie une interface et une autre requête commence à s'exécuter. Choisir la meilleure API d'IA pour le codage revient à trouver un modèle et un point de terminaison qui viennent à bout de votre type de travail dans un budget acceptable.
Commencez par Claude, GPT ou Gemini comme candidat de référence. Comparez DeepSeek, Qwen et Kimi sur les mêmes tâches si vous souhaitez d'autres options de déploiement et de dépenses. Pour le débogage, privilégiez les tests de régression. Pour la refactorisation, inspectez le diff. Pour un agent de codage, vérifiez l'ensemble de la boucle d'outils avant de comparer les prix des tokens.
La frustration est mesurable. Dans l'enquête 2025 auprès des développeurs Stack Overflow, 66 % des répondants à la question sur les frustrations ont signalé des solutions d'IA presque correctes ; 45 % ont déclaré passer plus de temps à déboguer le code généré. Il s'agit de réponses d'enquête, et non d'une évaluation de modèles de 2026. (Stack Overflow Developer Survey, 2025)
Points clés à retenir
- Choisissez l'API et l'agent séparément.
- Présélectionnez selon la tâche et les fonctionnalités requises du point de terminaison.
- Conservez les premières réponses et jugez-les selon des tests d'acceptation fixes.
- Incluez les tentatives échouées et les réparations dans votre calcul de coût.
Ce guide propose une présélection, trois tâches d'évaluation copiables et une feuille de calcul des coûts. Les recherches ont été vérifiées le 21 septembre 2026. La disponibilité des modèles, les capacités documentées et les résultats mesurés constituent des catégories de preuves distinctes tout au long de l'article.
Meilleure API d'IA pour le codage : la présélection
Commencez par deux candidats : un qui correspond à votre application existante et une alternative. Utilisez ces six familles pour constituer cette paire initiale.
Le tableau propose des tests, sans prétendre à une performance comparative. L'accès dépend de votre compte, de votre région, de votre quota et du point de terminaison ; une mention dans la documentation ne confirme pas que vos identifiants peuvent l'appeler.
| Modèle et ID précis | Chemin d'accès | Tâche à évaluer | Principale limite décisionnelle | Preuve du point de terminaison | Vérification du prix |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | API Anthropic | Modifications multi-fichiers contraintes | Vérifier le client et les contrôles de raisonnement | Vue d'ensemble des modèles Claude Platform ; accès au compte non testé | Aucun tarif indiqué |
GPT-6 Astra, gpt-6-astra | API OpenAI | Tâches de codage à conditions multiples | Vérifier la route et les outils | Documentation des modèles OpenAI ; accès au compte non testé | Aucun tarif indiqué |
Gemini 3.8 Flash, gemini-3.8-flash | API Gemini | Génération et révision interactives | Vérifier la latence et le protocole | Répertoire des modèles Google AI ; accès au compte non testé | Aucun tarif indiqué |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Route de modèle Atlas Cloud | Correctifs numériques ; expériences de contexte | Conserver la version 0813 séparément | Page de modèle exacte vérifiée ; fonctionnalités d'exécution non testées | 21 septembre 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Route de modèle Atlas Cloud | Refactorisations ; interfaces autonomes | Version spécifiée ; pas la plus récente | Page de modèle exacte vérifiée ; fonctionnalités d'exécution non testées | 21 septembre 2026 |
Kimi K3, moonshotai/kimi-k3 | Route de modèle Atlas Cloud | Les trois mêmes tâches ; interface CSV | Vérifier la sortie et les limites d'achèvement | Page de modèle exacte vérifiée ; fonctionnalités d'exécution non testées | 21 septembre 2026 |
Claude, GPT et Gemini constituent des candidats de référence utiles. Leurs répertoires officiels de modèles identifient les versions ci-dessus. Utilisez un fournisseur que vous maîtrisez déjà comme référence, puis testez si une alternative réduit le coût par tâche acceptée ou le travail d'intégration. Ne considérez pas le comportement d'un assistant grand public comme le résultat correspondant de l'API.
Le répertoire de modèles d'OpenAI liste GPT-6 Astra aux côtés de la famille GPT-5.6. Cela établit un candidat actuel, et non une supériorité en codage sur les autres lignes. Le tableau évite délibérément d'importer d'anciens ID de modèles provenant de pages de comparaison non datées. (OpenAI model directory, consulté en septembre 2026)
DeepSeek mérite une place en tant que famille de modèles distincte à étudier. Testez s'il corrige le bug particulier sans élargir la modification. Choisissez un autre candidat si la route déployée ne peut pas satisfaire le format de réponse, le comportement des outils ou le plafond de latence que vous exigez, quelle que soit la réputation générale du modèle.
Évaluez Qwen par version. Le déploiement nommé 122B A10B fournit une référence de prix concrète. Exécutez les vérifications d'analyse et de navigateur avant de tirer une conclusion sur la valeur. Les chiffres de contexte provenant d'autres versions de Qwen ne peuvent pas être attribués à ce modèle.
Kimi est le candidat de configuration détaillé. Sa page publique identifie l'ID du modèle. La vérification de la configuration est possible ; la génération réussie reste non vérifiée. Évaluez sa sortie finale selon les mêmes contraintes que les autres candidats.
Atlas Cloud se situe au niveau de la couche d'accès dans cette comparaison. Ce n'est pas un septième modèle. Sa pertinence est pratique : vous pouvez examiner plusieurs pages de modèles candidats et comparer leurs exigences d'intégration avant de vous engager dans un workflow.
Pour les poids ouverts, vérifiez la licence exacte de la version et l'artefact de déploiement. L'inférence hébergée a des conditions de service et des coûts d'exploitation distincts ; la famille de modèles seule ne peut pas les établir.
API de codage, modèles et agents expliqués
Un modèle produit du contenu en réponse à une entrée. Une API définit comment votre application envoie cette entrée et reçoit le résultat. Un agent de codage organise le travail environnant : lecture de fichiers, appel d'outils, application de modifications, exécution de tests et décision de poursuivre ou non.
Ces trois couches peuvent échouer indépendamment. Un modèle peut proposer un correctif correct tandis que l'agent l'écrit dans le mauvais fichier. Une API peut renvoyer du JSON valide tandis que l'application ignore un appel d'outil. Un agent compétent peut se bloquer parce que le point de terminaison sélectionné rejette un paramètre.
Supposons que vous envoyiez un gestionnaire et demandiez un analyseur d'ID. Une API de génération de code de base renvoie du texte contenant du code. Votre programme doit encore extraire ce code, le placer dans un espace de travail approprié et exécuter les tests. Une réponse HTTP réussie établit la livraison, pas l'exactitude.
Un agent ne peut automatiser ces étapes que si vous fournissez les outils et les autorisations. Il a aussi besoin d'une condition d'arrêt. Sans elle, il peut modifier à plusieurs reprises une fonction déjà acceptable, élargir la tâche ou dépenser des requêtes supplémentaires pour tenter d'améliorer un détail non pertinent.
Gardez trois lignes budgétaires distinctes :
- Abonnement aux outils : l'application, l'intégration à l'éditeur ou le service d'agent que vous utilisez.
- Utilisation de l'inférence : les requêtes vers le point de terminaison du modèle sélectionné, selon ses conditions de facturation.
- Environnement d'exécution : conteneurs, exécuteurs de tests, stockage et autres infrastructures.
Certains produits regroupent des parties de cette pile. D'autres attendent que vous fournissiez des identifiants distincts. Vérifiez le forfait particulier avant de supposer qu'un abonnement à un éditeur inclut le trafic API arbitraire de votre propre application.
La compatibilité des protocoles a elle aussi une limite. Un service qui accepte un tableau messages familier peut néanmoins exposer un comportement d'outil, des événements de streaming, des limites de contexte ou des contrôles de raisonnement différents. Copier une URL de base ne peut pas établir la prise en charge de toutes les fonctionnalités de l'écosystème d'un autre fournisseur.
Cartographiez l'application, l'agent, le point de terminaison, le modèle, les outils et les tests. Identifiez le composant facturable et l'opérateur responsable à chaque étape avant de changer de modèle.
Meilleure API d'IA pour le codage : 7 critères de sélection
1. Exactitude fonctionnelle et comportement de régression. Écrivez les sorties attendues avant de demander du code. Une fonction de prix qui gère les entiers ordinaires mais accepte null comme zéro viole le contrat. Exécutez à la fois les nouveaux cas limites et les tests existants du projet ; la réussite d'un nouveau test peut masquer un appelant cassé ailleurs.
2. Portée de la modification. Comparez le correctif avec la demande. L'extraction d'un analyseur d'ID doit préserver l'URL, la réponse de succès et la réponse d'erreur. Une migration de framework non sollicitée ajoute du travail de révision même lorsque le remplacement compile. Décidez à l'avance si les modifications sans rapport disqualifient la réponse ou nécessitent une réparation.
3. Contexte utile et espace de sortie. Votre requête comprend des instructions, les fichiers pertinents, les définitions d'outils et la conversation antérieure. Réservez également suffisamment d'espace pour la réponse. Une grande fenêtre de contexte annoncée n'établit pas que le modèle trouvera l'invariant pertinent, ni que votre point de terminaison accepte le même maximum.
Testez la qualité du contexte avec une dépendance importante. Incluez un appelant dont l'interface doit rester stable et vérifiez que le modèle la respecte. Mesurez la troncature séparément : une réponse qui se termine au milieu d'une fonction ne peut pas être acceptée parce que ses premières lignes semblaient prometteuses.
4. Appel d'outils et sortie structurée. Vérifiez la route déployée avec votre schéma d'outil réel. Contrôlez les types d'arguments, les champs manquants, les identifiants d'outils et la réponse de suivi après un résultat d'outil. Un modèle qui écrit un objet JSON plausible n'a pas nécessairement accompli un aller-retour natif d'appel d'outil.
5. Temps jusqu'à un résultat accepté. Enregistrez la durée de toute la tentative, y compris les réparations et les tests. Pour un assistant interactif, le temps jusqu'au premier texte visible compte aussi, mais il ne peut pas remplacer le temps d'achèvement. Un premier token rapide suivi d'une longue réponse inutilisable bloque toujours le développeur.
6. Frais d'entrée, de sortie, de cache et de nouvelle tentative. Lisez les catégories de facturation que votre point de terminaison choisi rapporte réellement. Séparez les lectures de cache de l'entrée ordinaire le cas échéant. Suivez les requêtes infructueuses et les boucles interrompues. Si le fournisseur n'expose pas le détail dont vous avez besoin, marquez explicitement les hypothèses manquantes de l'estimation.
7. Conditions d'intégration et de traitement du code. Confirmez que votre éditeur ou application prend en charge la route, la méthode d'authentification et le format d'erreur. Consultez les conditions actuelles de traitement des données du fournisseur avant d'envoyer du code source privé. Les poids ouverts décrivent un choix de distribution de modèle ; ils n'établissent pas comment un service hébergé traite vos requêtes.
Les benchmarks publics peuvent vous aider à sélectionner des candidats, à condition d'en lire les conditions. SWE-bench Verified contient 500 instances filtrées par des humains. Sa page actuelle décrit également une vue Bash Only utilisant le même environnement mini-SWE-agent. Ces détails aident à expliquer ce qui est comparé. (SWE-bench, consulté en septembre 2026)
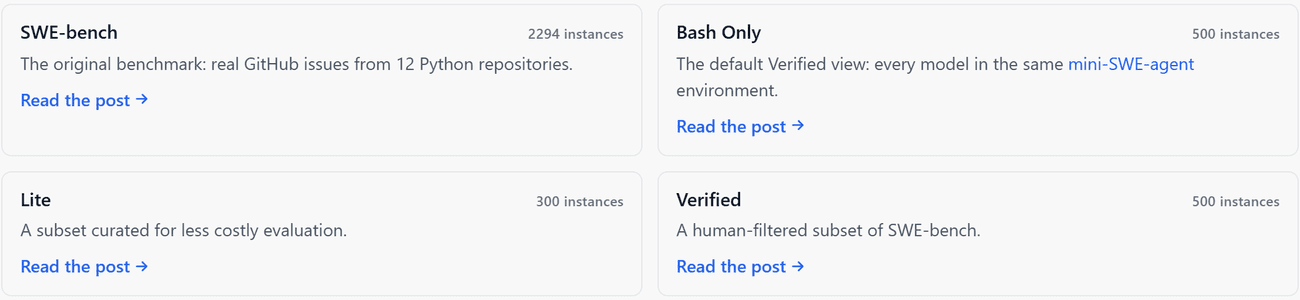 Page SWE-bench montrant la taille du jeu de données Verified et l'environnement d'agent partagé
Preuve source : la page réelle du benchmark, capturée le 21 septembre 2026. Le jeu de données et les conditions d'exécution doivent accompagner toute affirmation de performance.
Les résultats de benchmark décrivent une configuration particulière. Votre langage, vos règles métier, vos autorisations et vos normes de révision peuvent différer. Prenez la décision finale sur un travail que vous pouvez inspecter.
Meilleure API d'IA pour le codage : exécutez trois vérifications pratiques
Ces trois exemples d'évaluation reproductibles exposent différents modes de défaillance. Fixez leurs règles d'acceptation avant de demander la sortie. Jugez la fonction ou la page selon son contrat, indépendamment de la qualité de l'explication.
Pour DeepSeek V4 Pro, Qwen3.5 122B A10B et Kimi K3, le protocole prévu est de trois exécutions indépendantes par tâche. Cela représente 27 tentatives initiales. Autorisez au plus une réparation par retour d'information par tentative, conservez la première réponse et rapportez séparément les résultats initiaux et réparés.
Demandez une température zéro uniquement là où elle est prise en charge, en enregistrant le réglage réellement accepté. Utilisez un plafond de sortie demandé de 4 096 tokens pour A et B, et de 8 192 pour C après avoir vérifié les limites du point de terminaison. Les valeurs par défaut et les contrôles non pris en charge doivent être enregistrés. Une température basse ne garantit pas des réponses identiques.
Statut des preuves : l'accès à l'environnement de test a été bloqué par un écran de connexion Cloudflare Access. Les 27 tentatives candidates n'ont pas pu être exécutées. Les preuves suivantes montrent du code original exécuté localement et un fixture de référence CSV rédigé pour l'article, et non des résultats de modèles candidats. Les taux de réussite des modèles, l'utilisation des tokens et les coûts des tâches restent non mesurés.
Tâche A : corriger la sélection numérique des prix. Collez cette invite exacte dans une nouvelle session :
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
Les entrées d'acceptation fixes sont [2,10,3], ["12","3"], un tableau vide, des valeurs uniquement invalides, zéro, des nombres négatifs et des chaînes composées uniquement d'espaces. Rejetez les chaînes vides après suppression des espaces. Vérifiez que le tableau d'origine contient exactement les mêmes éléments dans le même ordre après l'appel.
L'original utilise le tri par défaut de JavaScript et modifie son entrée. La tâche vérifie donc deux obligations distinctes : sélectionner le minimum numérique correct et éviter de modifier les données de l'appelant. Testez explicitement les règles de conversion, car une solution courte basée sur la coercition peut accepter accidentellement des booléens ou null.
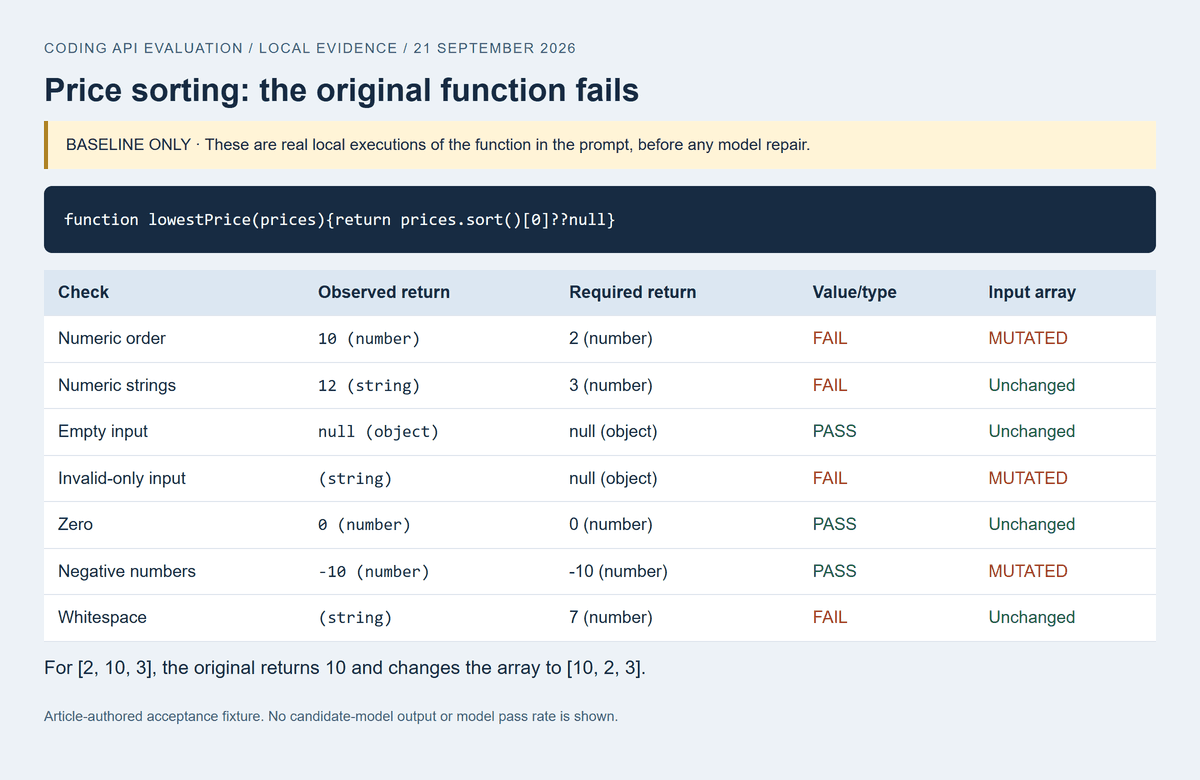 Exécution locale de la fonction de prix originale montrant un tri numérique incorrect et une entrée modifiée
Référence exécutée : la fonction originale renvoie 10 pour [2,10,3] et transforme le tableau en [10,2,3]. Les chaînes numériques échouent également au contrat de valeur de retour. Aucune réparation par modèle n'est montrée.
Tâche B : préserver une interface lors d'une petite refactorisation. Utilisez cette invite telle quelle :
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Acceptez "12" et "0012" comme 12. Rejetez "1e2", "1.0", les négatifs, zéro, les espaces, les entrées non-chaînes et les valeurs au-delà de la plage d'entiers sûrs de JavaScript. Vérifiez le chemin enregistré et les deux corps de réponse. Une entrée invalide ne doit pas atteindre findUser.
Cette tâche teste si le modèle comprend la différence entre la conversion numérique et la grammaire de chaîne spécifiée. Inspectez le diff pour détecter des modifications sans rapport, puis appelez le gestionnaire avec des objets de requête et de réponse simulés. Un assistant correct associé à un gestionnaire permissif inchangé échoue toujours.
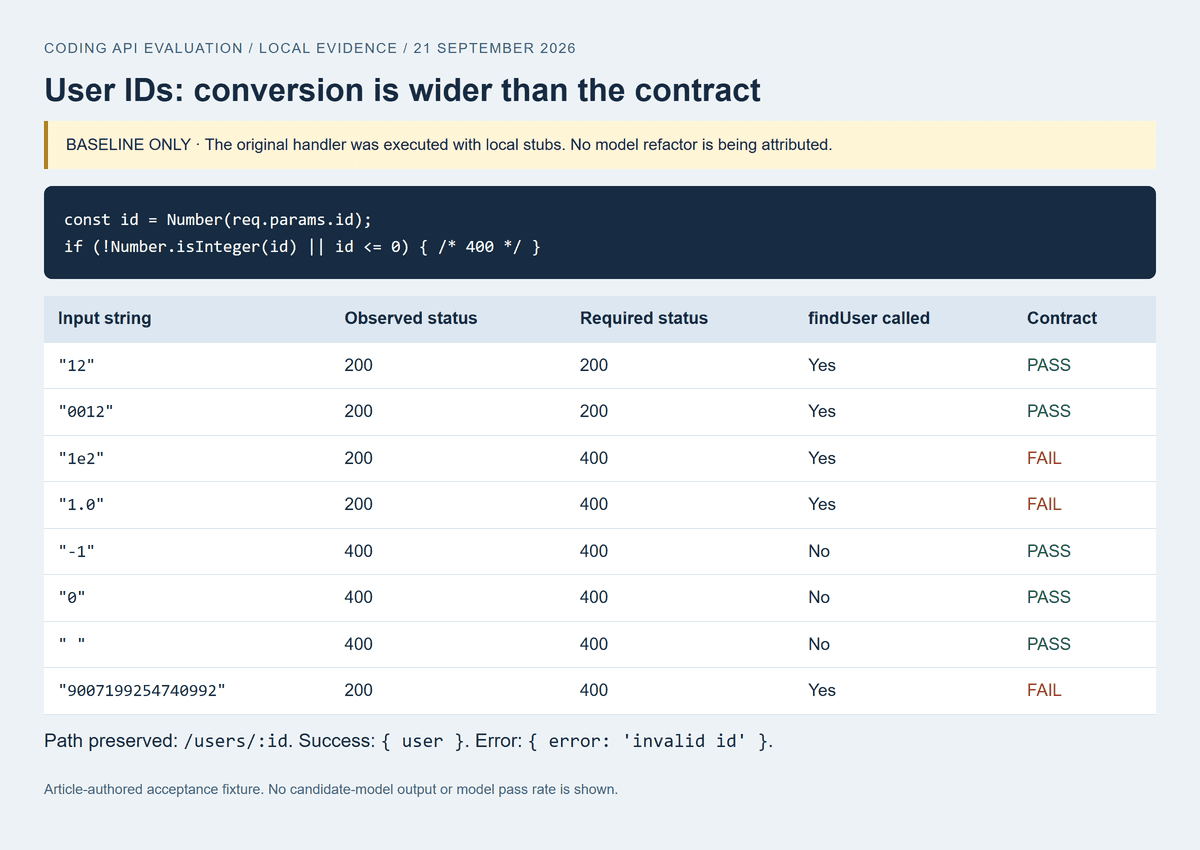 Journal de test du gestionnaire original montrant des chaînes numériques invalides acceptées avec le statut 200
Référence exécutée : le gestionnaire original renvoie 200 pour "1e2", "1.0" et "9007199254740992", malgré la réponse 400 requise. Des stubs locaux ont enregistré les appels ; il ne s'agit pas d'une refactorisation générée par un modèle.
Tâche C : construire un aperçu CSV que vous pouvez exploiter. Soumettez :
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Testez avec ces enregistrements exacts, d'abord avec LF, puis avec CRLF :
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Attendez deux colonnes, trois lignes de données, la virgule d'Alice à l'intérieur d'une seule cellule et le guillemet échappé de Bob affiché correctement. La valeur d'Eve doit apparaître sous forme de texte littéral, sans élément d'image, exécution d'événement ni requête réseau. Ajoutez une ligne avec trois champs et confirmez que la page signale visiblement l'incohérence.
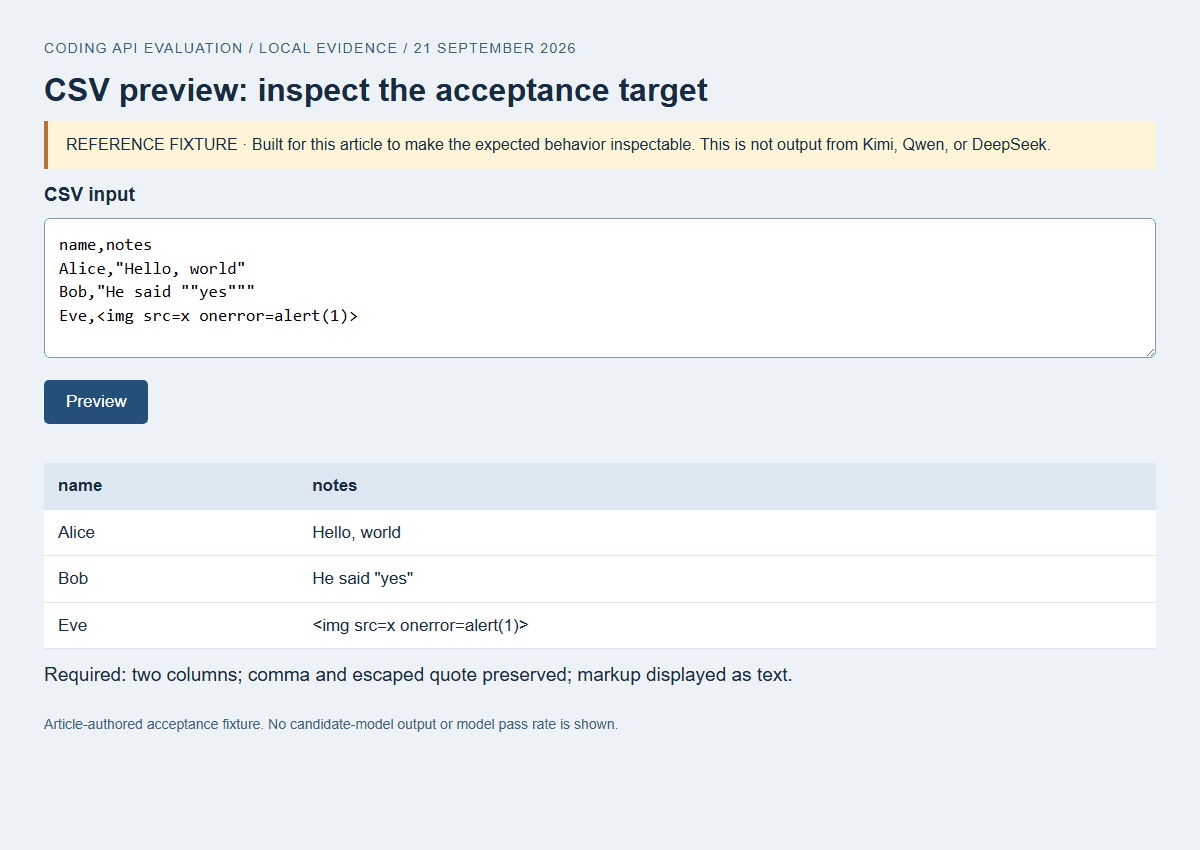 Fixture d'acceptation CSV montrant des valeurs entre guillemets et les exigences de balisage littéral
Fixture de référence exploitée, créée pour cet article, non générée par un modèle candidat. Les vérifications dans le navigateur ont validé l'analyse LF/CRLF, les guillemets échappés, le balisage littéral, les erreurs visibles de nombre de champs et l'absence de requêtes HTTP. La capture d'écran montre l'état de saisie valide après avoir cliqué sur Preview.
Conservez la sortie brute, les journaux, l'ID du modèle, la date, les paramètres, le minutage, les réparations et les modifications manuelles. Envoyez les assertions échouées pour une réparation sans modifier les résultats attendus. Conservez les refus, les troncatures et les erreurs aux côtés des succès.
Meilleure API d'IA pour le codage à petit budget
Comparez les tarifs des tokens en parallèle de la qualité d'achèvement et de l'utilisation. Les entrées répétées peuvent dominer les coûts de révision de code ; la génération de fichiers entiers peut augmenter les frais de sortie. Les réparations répétées ajoutent les deux.
Le catalogue Atlas et les pages de détail exactes affichaient ces tarifs en USD par million de tokens le 21 septembre 2026 :
- DeepSeek V4 Pro : $1.68 en entrée et $3.38 en sortie. La fiche distincte V4 Pro 0813 utilise des tarifs différents ; ne la substituez pas.
- Qwen3.5 122B A10B : $0.30 en entrée et $2.40 en sortie. Le catalogue affichait des tarifs normaux de $0.40 et $3.20 avec une remise de 25 %, en septembre 2026.
- Kimi K3 : $3.00 en entrée et $15.00 en sortie.
Il s'agit de tarifs de production affichés, et non de factures de l'évaluation de l'article. Les tarifs spécifiques au cache et leur applicabilité n'ont pas été confirmés. Les remises promotionnelles pour DeepSeek et Kimi n'ont pas été confirmées. L'absence d'observation d'une remise ne prouve pas qu'aucune offre n'existe.
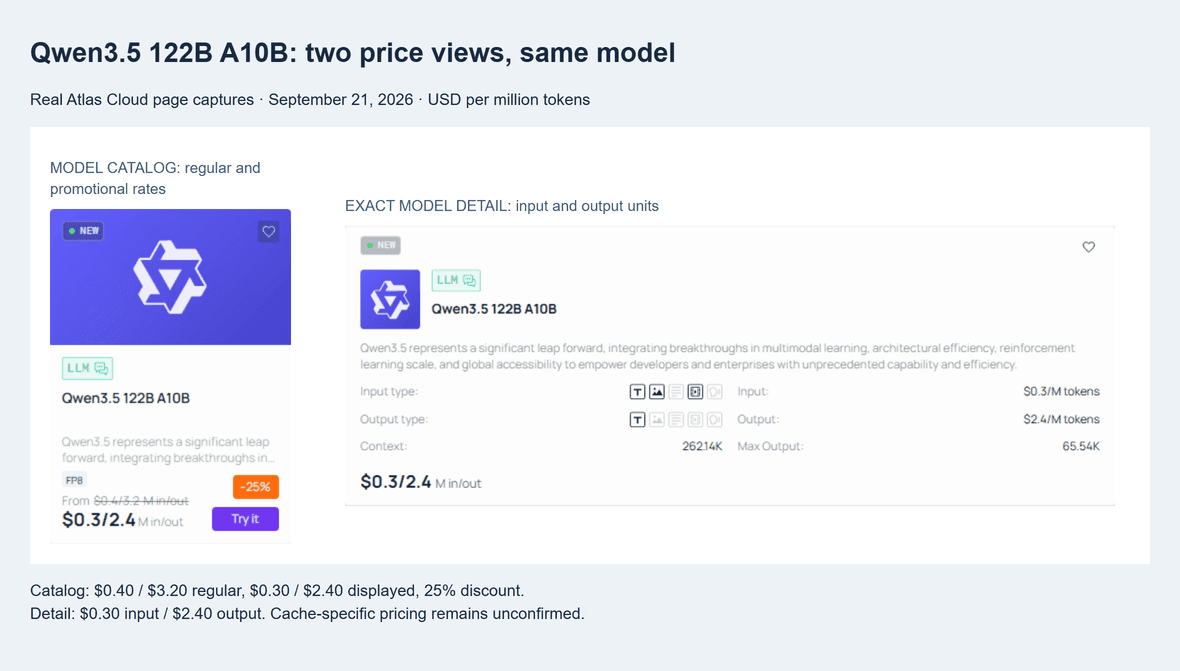 Remise du catalogue Qwen3.5 122B A10B à côté des tarifs d'entrée et de sortie de sa fiche de modèle exacte
Vérification croisée des prix Qwen, 21 septembre 2026 : le catalogue affiche la promotion de 25 % ; la fiche de modèle exacte confirme $0.30 en entrée et $2.40 en sortie par million de tokens. Les tarifs spécifiques au cache restent non confirmés.
Calculez la part du modèle pour une tâche comme suit :
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Ne facturez pas à nouveau les tokens mis en cache comme entrée ordinaire si le relevé de facturation les traite séparément. Vérifiez si l'utilisation du raisonnement est incluse dans la sortie facturable. Si aucune tâche ne réussit, indiquez « aucun résultat réussi » ; diviser par zéro ou afficher un coût d'achèvement nul indurait le lecteur en erreur.
Pour un exemple arithmétique transparent, supposons 10 000 tokens d'entrée ordinaires et 2 000 tokens de sortie aux tarifs Qwen affichés. Les frais de modèle estimés sont de $0.0078, avant tout autre élément applicable. Il s'agit d'une requête hypothétique, et non d'une utilisation de tokens observée ni d'une facture réelle.
Une réparation de taille équivalente porterait l'estimation à $0.0156. Les réparations réelles comportent un contexte et une sortie différents, alors calculez chaque requête à partir de son utilisation enregistrée.
| Tâche | Modèle | Première passe | Après réparation | Utilisation des tokens | Source du coût | Frais totaux | Temps total | Modifications manuelles |
|---|---|---|---|---|---|---|---|---|
| A, B, C ; 3 répétitions chacune prévues | DeepSeek V4 Pro | Non mesuré | Non mesuré | Non enregistré | Aucun relevé d'utilisation | Inconnu | Non mesuré | Aucune évaluée |
| A, B, C ; 3 répétitions chacune prévues | Qwen3.5 122B A10B | Non mesuré | Non mesuré | Non enregistré | Aucun relevé d'utilisation | Inconnu | Non mesuré | Aucune évaluée |
| A, B, C ; 3 répétitions chacune prévues | Kimi K3 | Non mesuré | Non mesuré | Non enregistré | Aucun relevé d'utilisation | Inconnu | Non mesuré | Aucune évaluée |
Pour votre propre feuille de calcul, développez chaque ligne en une ligne par modèle et par répétition. Comptez un succès réparé une seule fois dans le dénominateur des tâches acceptées. Incluez les tentatives infructueuses dans le numérateur et conservez des colonnes distinctes pour la première passe et l'acceptation finale.
Suivez séparément la révision humaine et l'infrastructure. Démêler une réécriture inutile peut annuler une économie d'inférence. Comparez les candidats qui satisfont à la fois aux exigences d'acceptation et à votre budget de temps de révision.
Meilleure API d'IA pour le codage avec Atlas Cloud
Commencez par la page du modèle Kimi K3, confirmez l'ID et inspectez les vues API et Code. Conservez la version choisie à côté du relevé de test.
Lisez la documentation sur les protocoles LLM avant de considérer deux routes comme interchangeables. Elle identifie Chat Completions comme la route à large couverture et oriente les utilisateurs vers le supported_apis de chaque modèle. Les contrôles d'échantillonnage et les fonctionnalités d'outils dépendent aussi de la prise en charge annoncée du modèle.
Il y a ici des détails d'intégration concrets qui valent la peine d'être vérifiés. La documentation indique que les requêtes Anthropic traduites n'appliquent pas cache_control, et que les outils hébergés par le fournisseur ne sont pas disponibles sur cette route traduite. Ces contraintes comptent si votre agent existant présuppose une mise en cache native ou un outil de navigation hébergé. Faites correspondre le client à la route réelle.
L'exemple Node.js suivant illustre une requête texte. Il utilise fetch intégré, une variable d'environnement pour les identifiants et l'ID de modèle Kimi vérifié. Enregistrez l'invite exacte de la tâche A sous task-a.txt. Définissez la variable d'environnement de l'URL de base sur l'URL de base de l'API Atlas indiquée dans sa documentation, se terminant par /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages transporte la tâche ; model sélectionne le déploiement ; max_tokens demande un plafond de sortie. Le lecteur de réponse vérifie la présence d'un texte achevé ordinaire avant de renvoyer du code. Le délai d'attente borne l'attente de cet exemple ; il n'établit pas que le serveur a cessé le traitement ni qu'aucun frais n'a été facturé.
La température est omise car la prise en charge par modèle et le comportement garanti doivent être vérifiés. L'exemple ne réessaie pas automatiquement. Examinez la classe de défaillance avant d'ajouter une politique de nouvelle tentative bornée, et ne journalisez jamais l'en-tête d'autorisation. Ce code de publication n'a pas été exécuté avec une clé API lors de la production de l'article.
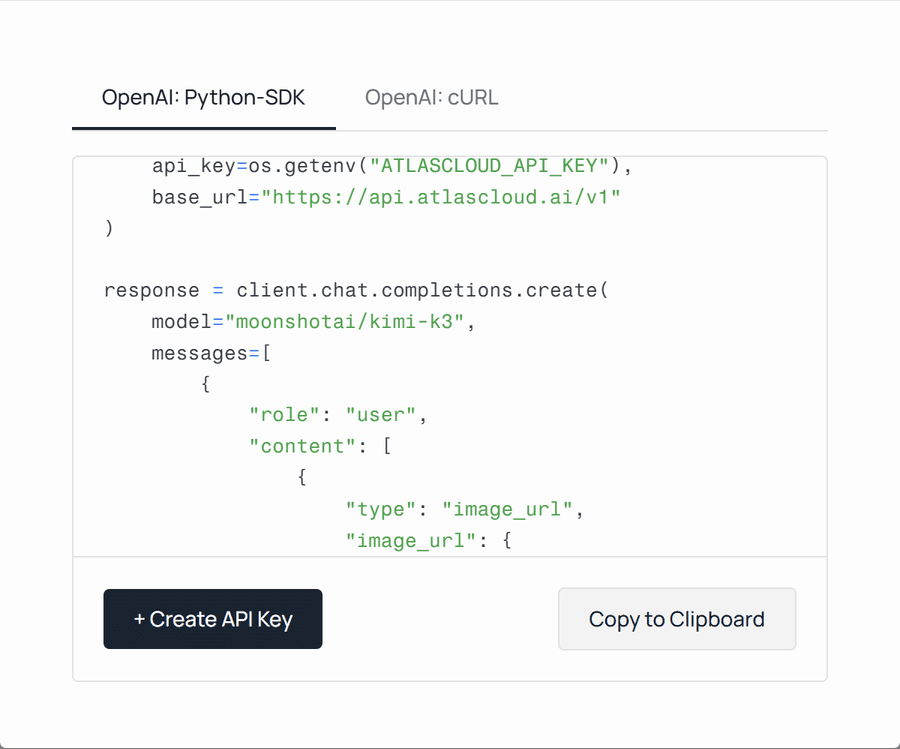 Exemple public de code API Kimi K3 montrant le point de terminaison Atlas et l'identifiant du modèle
Boîte de dialogue Code publique de Kimi K3, capturée le 21 septembre 2026. Il s'agit d'une preuve de configuration, et non d'une exécution de codage terminée. L'exemple de la page inclut une entrée média ; l'exemple de l'article utilise uniquement du texte.
Exécutez les vérifications d'acceptation de la tâche A sur toute fonction renvoyée. Avant de passer à DeepSeek ou Qwen, vérifiez son protocole et ses paramètres. Gardez les invites et les tests inchangés tout en comparant la sortie et l'utilisation ; une forme de requête partagée n'établit pas un comportement identique.
Avant d'utiliser une API de codage en production
Exécutez d'abord le code généré dans une branche jetable ou un espace de travail isolé. Pour la tâche CSV, utilisez un contexte de navigateur local avec les requêtes réseau bloquées et sans accès à un état d'application sensible. Pour les tâches sur dépôt, ne donnez au processus que les fichiers et commandes nécessaires à l'évaluation.
Définissez le succès en dehors de la réponse du modèle. Un agent qui dit « tous les tests ont réussi » doit vous conduire à un journal de test réel, un code de sortie et une révision vérifiée. Archivez le diff avec ces preuves. Sinon, une réparation ultérieure peut modifier les fichiers après le succès apparent et rendre le rapport obsolète.
Traitez les délais d'attente et les nouvelles tentatives comme un comportement d'application dont vous êtes responsable. Fixez une échéance de requête et un budget total par tâche. Séparez les erreurs dues aux identifiants ou à des paramètres invalides des défaillances de transport transitoires. Répéter une requête invalide fait perdre du temps ; répéter une requête qui déclenche des effets de bord peut créer un travail en double.
Lorsque l'agent peut appeler des outils, distinguez l'inspection en lecture seule des écritures. Attribuez des identifiants d'opération là où la conception de vos outils le permet, et confirmez l'état avant de répéter une écriture incertaine. La politique de nouvelle tentative d'un point de terminaison de modèle ne peut pas garantir l'idempotence des outils que votre application exécute ensuite.
Protégez les journaux aussi délibérément que les fichiers source. Enregistrez les ID de modèles, les horodatages, le statut, le minutage et l'utilisation sans copier systématiquement des secrets ou des dépôts privés entiers dans la télémétrie. Conservez toute preuve de sortie brute requise dans un emplacement dûment restreint et établissez la durée de conservation nécessaire pour l'équipe.
Vérifiez le streaming avec votre client réel. Il doit gérer les événements partiels, la terminaison, les erreurs et les relevés d'utilisation lorsqu'ils sont disponibles. Confirmez les limites de débit pour le compte et le déploiement réels. Une expérience silencieuse à utilisateur unique ne peut pas établir comment la même route se comporte lorsque toute une équipe soumet des requêtes en même temps.
Utilisez cette courte liste de contrôle de mise en production :
- Les tests d'acceptation et les régressions existantes passent sur la révision finale.
- Le diff reste dans les limites de la tâche approuvée.
- Le comportement d'expiration, d'annulation et de nouvelle tentative a été exercé.
- Les appels d'outils et les réponses structurées fonctionnent sur le point de terminaison sélectionné.
- Les journaux excluent les identifiants et le code privé inutile.
- Les conditions de traitement des données satisfont aux exigences de l'équipe.
- Une solution de repli dispose de sa propre configuration vérifiée et de son propre relevé de test.
Les dépôts privés nécessitent une décision propre au service. Passez en revue les conditions actuelles de conservation, d'utilisation pour l'entraînement, d'accès et les conditions contractuelles avec la personne responsable du code. N'envoyez que du matériel approuvé. Ne déduisez pas la confidentialité de la disponibilité des poids du modèle, ni de la ressemblance d'un protocole avec un autre que vous utilisez déjà.
Meilleure API d'IA pour le codage : faites votre choix final
Prenez la décision en trois étapes.
Premièrement, éliminez les candidats qui ne disposent pas d'une capacité requise. Notez les conditions qui doivent être remplies : un format de sortie accepté, une boucle d'outils fonctionnelle, un dispositif approprié de traitement des données ou une échéance de réponse exploitable. Un candidat qui en manque une nécessite une décision de remédiation distincte avant de pouvoir figurer dans la comparaison finale.
Deuxièmement, comparez le coût par tâche acceptée et le temps écoulé. Utilisez toutes les tentatives selon la même politique de réparation. Séparez les succès de première passe des succès réparés et signalez les relevés d'utilisation manquants. Si deux modèles satisfont tous deux au contrat, comparez leur charge de révision ainsi que les frais de modèle. Vos développeurs devront vivre avec les correctifs obtenus.
Troisièmement, conservez une solution de repli et définissez son déclencheur. Citons par exemple une panne prolongée du point de terminaison, des échecs répétés de sortie structurée ou des coûts de tâche dépassant un plafond choisi. Testez la configuration alternative à l'avance. Changer un ID de modèle sous pression peut introduire un second problème d'intégration si ses contrôles ou son comportement de réponse diffèrent.
Les trois petites tâches de ce guide constituent un exercice de présélection. Élargissez la suite avec un travail représentatif de votre propre base de code avant de vous fier à un candidat pour des modifications étendues. Gardez quelques tâches en dehors de l'ajustement des invites afin de pouvoir vérifier si les améliorations se transfèrent au-delà des exemples que vous avez optimisés.
La meilleure API d'IA pour le codage est la combinaison que vous pouvez expliquer : elle accomplit le travail requis, expose des coûts que vous pouvez suivre et s'adapte à la façon dont votre application fonctionne. Aucun gagnant universel n'est nécessaire pour prendre cette décision.
Ouvrez le catalogue de modèles actuel, choisissez deux candidats et enregistrez leurs ID et paramètres exacts. Utilisez ensuite la même tâche, les mêmes tests et la même règle d'arrêt pour les deux.
Questions fréquentes
Quelle est la meilleure API d'IA pour le codage avec un petit budget ?
Commencez par un candidat dont les tarifs affichés correspondent à vos volumes probables d'entrée et de sortie, puis comparez le coût par tâche acceptée. Les lignes Qwen, DeepSeek et Kimi fournissent des versions concrètes à étudier, sans affirmer un gagnant en valeur testé. Limitez les tentatives de réparation, réutilisez délibérément le contexte pertinent et suivez les requêtes échouées. Incluez séparément le temps de révision pour qu'une facture d'inférence basse ne masque pas une lourde charge de nettoyage.
Un abonnement de codage est-il moins cher que payer des tokens d'API ?
Cela dépend de votre charge de travail et de ce que comprend le forfait. Un abonnement peut convenir à un usage interactif dans son application prise en charge, tandis que la facturation à l'usage peut convenir à un service personnalisé au trafic variable. Vérifiez l'accès aux modèles, les plafonds, la concurrence et si les appels API externes sont inclus ou non. Comparez la même quantité de travail utile sur une période représentative ; un prix mensuel affiché et un tarif au token ne mesurent pas la même chose.
Quelle est la différence entre un modèle de codage et un agent de codage ?
Le modèle génère des réponses. L'agent gère la boucle autour de ces réponses, y compris l'accès aux fichiers, l'exécution des outils, les tests et les règles d'arrêt. Vous pouvez appeler un modèle de codage via une API sans construire d'agent, par exemple pour suggérer une fonction destinée à une révision humaine. Si vous souhaitez des modifications autonomes, évaluez le modèle avec l'agent et les autorisations qu'il utilisera réellement.
Quelle API d'IA dois-je utiliser pour le débogage et la refactorisation ?
Présélectionnez les candidats qui correspondent à vos exigences en matière de point de terminaison et de traitement du code, puis utilisez de petits bugs et des refactorisations contraintes issues de votre travail. La tâche A vérifie l'exactitude et la mutation des entrées ; la tâche B vérifie l'analyse et la préservation de l'interface. Faites-les suivre de tests représentatifs sur votre dépôt.
Préférez le candidat qui satisfait à vos conditions d'acceptation avec un effort de révision gérable, plutôt qu'un candidat qui produit simplement l'explication la plus longue ou la réécriture la plus étendue.
Existe-t-il une API d'IA gratuite pour le codage ?
Un crédit d'essai, une application avec un forfait gratuit et des poids de modèle téléchargeables sont des offres différentes. Aucune ne confère automatiquement à votre application une inférence hébergée illimitée. Vérifiez l'éligibilité actuelle, l'expiration, les quotas et les modèles pris en charge avant de budgéter autour d'un accès gratuit. Cet article n'affirme pas qu'une allocation gratuite est actuellement disponible.
Si vous hébergez vous-même les poids, tenez compte du calcul et de l'exploitation même lorsque le téléchargement des poids ne coûte rien.
Puis-je envoyer du code de dépôt privé à une API de codage ?
N'envoyez que du code que votre organisation vous autorise à partager selon les conditions applicables du service concerné. Passez en revue la conservation, l'utilisation pour l'entraînement, les contrôles d'accès et les exigences contractuelles du déploiement choisi.
Supprimez les identifiants et les fichiers sans rapport, et vérifiez ce que votre agent inclut automatiquement dans les invites et les journaux. Un modèle à poids ouverts ou un format d'API familier n'établit pas, à lui seul, qu'un service hébergé satisfait aux exigences de confidentialité de votre équipe.


