DeepSeek Harness ne faisait pas partie de ce benchmark. Il a été publié deux jours plus tard. Cela signifie que la question utile n'est pas « lequel a gagné ? » La question utile est de savoir comment exécuter la même tâche avec les deux outils, sur le même modèle, et lire la facture sans se tromper.
Points clés
- Le choix du harness peut faire varier la consommation de tokens d'environ 7x dans des tâches d'agent comparables.
- Mesurez DeepSeek Harness et OpenCode avec le même modèle et le même état du dépôt.
- Utilisez des clés API distinctes avant d'en choisir une pour le travail quotidien.
Deux ordinateurs portables exécutant la même tâche de codage via deux harness d'agents
La configuration équitable : un modèle, une tâche, deux terminaux.
Ce que nous dit le benchmark public
Composio a exécuté 30 workflows multi-applications complexes via 8 harness d'agents, tous utilisant DeepSeek V4 Flash, une limite de 900 secondes par tâche et une notation programmatique binaire sur 240 runs (Composio, août 2026). Même modèle, harness différents.
| Harness | Taux de réussite | Temps médian | Tokens moyens par tâche |
|---|---|---|---|
| Pi Agent | 66,7% | 132,2s | 559 000 |
| Prime Agent | 62,5% | 242,1s | 1 400 000 |
| OMP | 56,7% | 272,4s | 742 000 |
| Claude Code | 53,3% | 122,7s | 742 000 |
| Codex | 53,3% | 245,0s | 678 000 |
| DeepAgents | 53,3% | 187,1s | 665 000 |
| Hermes Agent | 50,0% | 175,5s | 192 000 |
| OpenCode | 46,7% | 129,7s | 692 000 |
La colonne des tokens importe plus que le classement. L'écart va de 192 000 à 1 400 000 tokens moyens par tâche. C'est le même modèle qui effectue un travail comparable via des runtimes différents.
OpenCode nous donne une base de référence sourcée : 692 000 tokens par tâche, 46,7% de taux de réussite et 129,7 secondes de temps médian. DeepSeek Harness n'a pas de chiffre de comparaison directe public issu de ce benchmark car DeepSeek l'a publié le 13 août 2026, deux jours après la publication du benchmark.
Utilisez le tableau comme un avertissement, pas comme un verdict. Il montre que le harness peut dominer le coût. Il ne prouve pas que DeepSeek Harness bat OpenCode sur votre dépôt.
Ce qui change quand on change de harness
Avant de tester, comparez les deux outils selon les aspects qui affectent un développeur en activité : surface de configuration, maturité, visibilité des tokens et dans quelle mesure vous pouvez remplacer la boucle de l'agent.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| Provenance | DeepSeek AI | Anomaly (à l'origine SST) |
| Date de sortie | 13 août 2026 | Fin 2025 |
| Étoiles GitHub | ~143k | ~198k |
| Licence | MIT | MIT |
| Langage | TypeScript | Go |
| Interface | Interface web sur 127.0.0.1:3080 | TUI terminal |
| Statut | Aperçu développeur, modifications de rupture attendues | Mature, largement déployé |
| Architecture | Plugins remplaçables pour modèles, outils, sessions, sandbox, stockage, boucles et UI | Noyau fixe avec agents de construction/planification, support MCP et extensions LSP |
| Configuration | $DSH_HOME/settings.yaml | opencode.json |
| Comptabilité tokens | Compteur de tokens avec pression de contexte et projections de répartition | Suivi des tokens et des coûts par session dans la TUI |
| Idéal pour | Les équipes qui souhaitent modifier la boucle de l'agent elle-même | Les équipes qui veulent un agent de codage qui fonctionne aujourd'hui |
OpenCode vous offre un agent de codage stable avec des points d'extension en périphérie. DeepSeek Harness vous offre un runtime où la boucle elle-même peut être échangée. Cette flexibilité est utile si vous construisez une infrastructure d'agents. Elle ajoute du risque si vous avez besoin d'un outil par défaut pour du code de production cette semaine.
Les deux outils peuvent atteindre le même point de terminaison compatible OpenAI. Cela rend possible un test équitable : un modèle, une URL de base, une tâche et un état de dépôt de départ.
Pour cette procédure, DeepSeek V4 Flash s'exécute via Atlas Cloud, qui expose un point de terminaison compatible OpenAI accepté par les deux outils. La fiche deepseek-v4-flash-0731 affiche 0,14 $ par million de tokens en entrée, 0,28 $ par million de tokens en sortie, une fenêtre de contexte de 1 048 576 tokens et une sortie maximale de 393 216 tokens en août 2026. N'importe quel fournisseur fonctionne si les deux harness utilisent le même point de terminaison et le même identifiant de modèle.
OpenCode publie également des données d'utilisation agrégées. Les modèles DeepSeek ont déplacé 233 billions de tokens via OpenCode, V4 Flash représentant 85,5% et V4 Pro 14,5% (OpenCode, août 2026). Cette tendance d'utilisation fait de V4 Flash un choix pratique par défaut pour la comparaison.
Étape 1 : Pointer les deux outils vers le même modèle
Créez une clé API et une URL de base, puis donnez la même paire aux deux outils. Créez la clé dans la console Atlas Cloud et exportez-la une fois :
plaintext1export ATLAS_API_KEY="votre-clé-api" 2
Vérifiez le point de terminaison avant de le confier à l'un ou l'autre harness :
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Répondez par le seul mot : prêt"}] 7 }' 8
Cet appel prouve que la route, la clé et l'identifiant du modèle fonctionnent avant qu'un harness n'ajoute des outils, des tentatives ou une relecture de conversation.
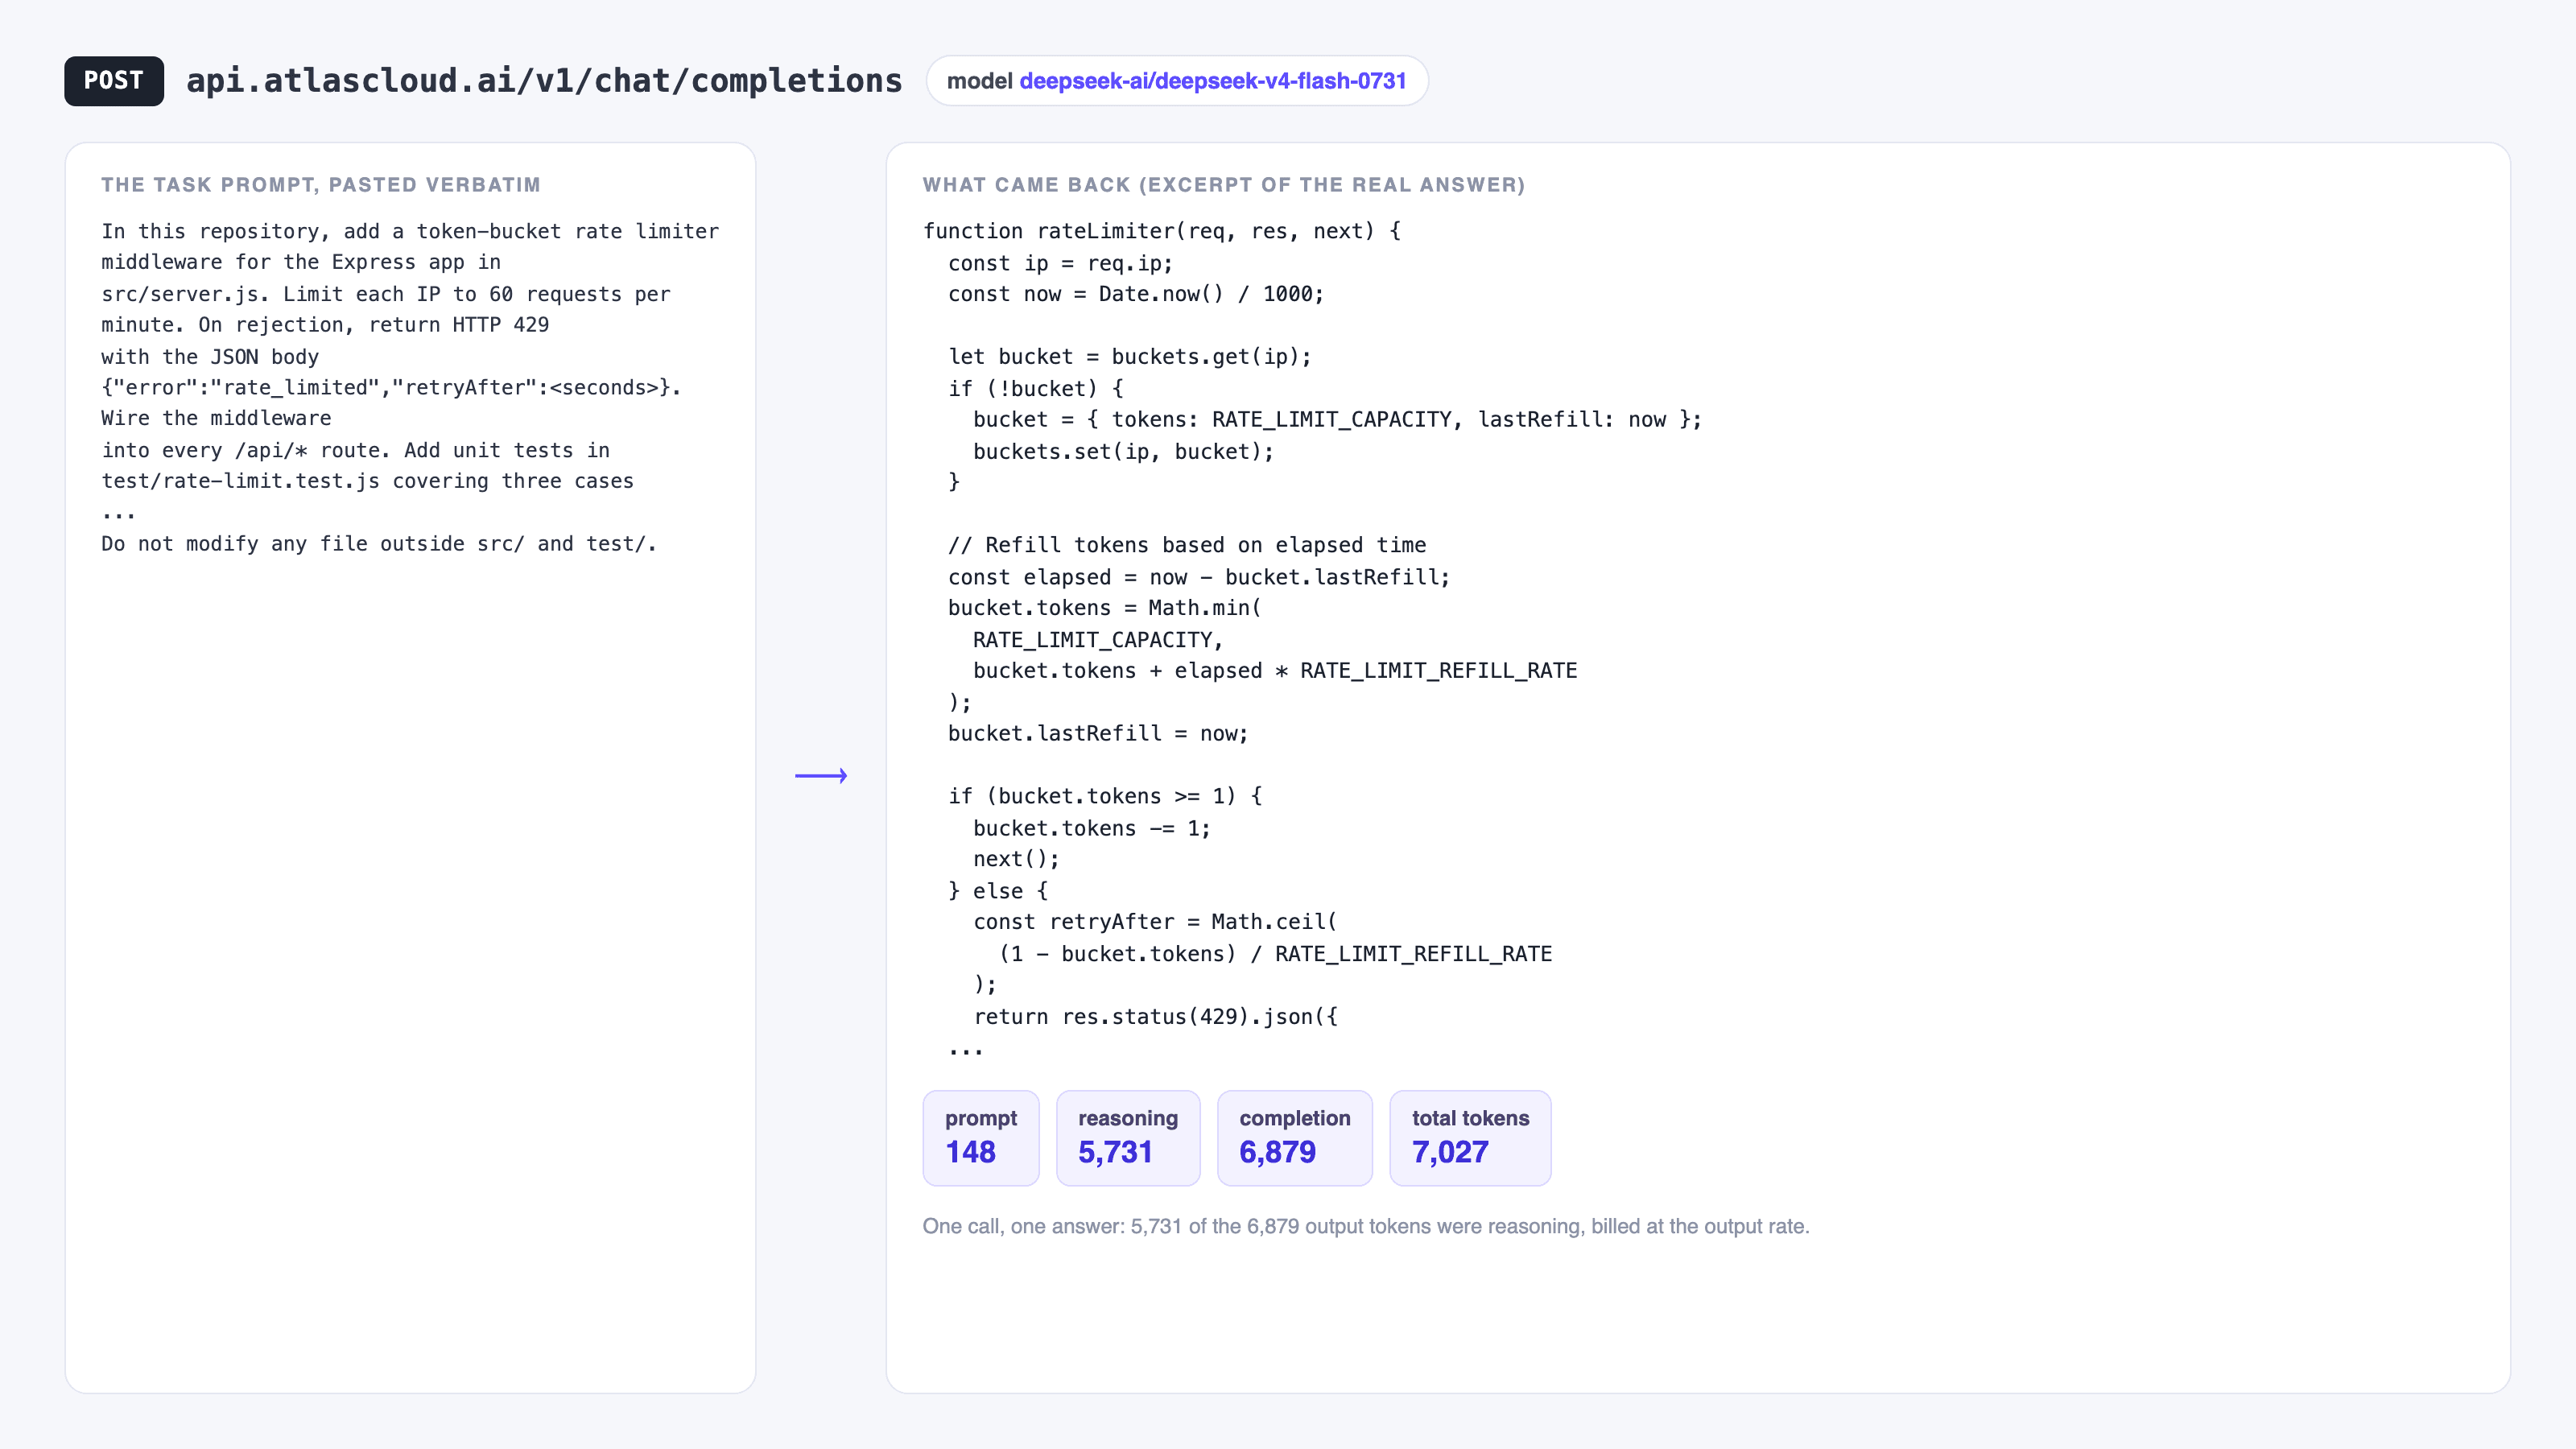
Invite de codage, code généré et statistiques de tokens provenant d'un appel de modèle
Un appel direct à deepseek-ai/deepseek-v4-flash-0731 : 148 tokens d'invite en entrée, 6 879 tokens de sortie en retour, dont 5 731 tokens de raisonnement. Considérez cela comme le plancher avant qu'un harness n'ajoute des schémas d'outils et de l'historique.
DeepSeek Harness lit $DSH_HOME/settings.yaml, et les fournisseurs personnalisés compatibles OpenAI se placent sous le plugin llm-pi-ai (docs DeepSeek Harness, août 2026) :
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
Utilisez openai-completions pour ce point de terminaison. L'interface web peut écrire le même bloc de fournisseur depuis Paramètres, Modèles, Ajouter un fournisseur personnalisé, puis stocker la clé dans $DSH_HOME/.credentials.yaml.
OpenCode lit opencode.json dans la racine de votre projet ou le répertoire de configuration global (docs OpenCode, août 2026) :
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
Utilisez @ai-sdk/openai-compatible, car ce point de terminaison sert /v1/chat/completions. Définissez les limites réelles de contexte et de sortie. OpenCode les utilise pour décider quand résumer, et des limites erronées peuvent fausser la comparaison des tokens.
Étape 2 : Exécuter la même tâche de benchmark dans DeepSeek Harness
Choisissez une tâche suffisamment grande pour nécessiter plusieurs appels d'outils et suffisamment petite pour être notée. Utilisez le même état de dépôt pour les deux exécutions, donc commitez ou stash avant de commencer.
Collez cette tâche exacte dans les deux outils :
plaintext1Dans ce dépôt, ajoutez un middleware de limiteur de débit à seau de jetons pour l'application Express 2dans src/server.js. Limitez chaque IP à 60 requêtes par minute. En cas de rejet, 3retournez HTTP 429 avec le corps JSON {"error":"rate_limited","retryAfter":<secondes>}. 4Branchez le middleware sur chaque route /api/*. Ajoutez des tests unitaires dans 5test/rate-limit.test.js couvrant trois cas : une requête sous la limite est autorisée, 6une requête au-dessus de la limite est bloquée avec 429, et le compteur se réinitialise 7après l'expiration de la fenêtre. Exécutez la suite de tests et corrigez les échecs jusqu'à ce qu'elle passe. 8Ne modifiez aucun fichier en dehors de src/ et test/. 9
Démarrez Harness depuis votre répertoire de projet :
plaintext1cd /chemin/vers/votre/depot 2npx @deepseek-ai/dsh web 3
L'interface s'exécute sur http://127.0.0.1:3080. Sélectionnez le fournisseur atlas et le modèle deepseek-ai/deepseek-v4-flash-0731, collez la tâche et laissez-la se terminer. N'ajoutez pas d'indices après le début de l'exécution. Une aide supplémentaire pour un outil invalide la comparaison.
Lorsque Harness se termine, ouvrez la vue Trajectory. Cet enregistrement de session est l'endroit où se trouvent ses chiffres de tokens.
Étape 3 : Répéter l'exécution dans OpenCode
Réinitialisez le dépôt à l'état de départ exact. Le second harness ne doit pas hériter des fichiers que le premier a déjà modifiés.
plaintext1git checkout -- . && git clean -fd 2
Exécutez ensuite OpenCode avec le même modèle :
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
Collez la même invite de tâche de l'étape 2. Utilisez l'agent build par défaut. Laissez-le se terminer sans indices.
Notez les deux exécutions avec la même commande :
plaintext1npm test 2
Une exécution qui laisse la suite en échec est un échec, même si le résumé de l'agent semble confiant. Utilisez une notation binaire : succès ou échec.
Étape 4 : Lire l'utilisation des tokens
Les deux outils suivent l'utilisation, mais aucun compteur ne devrait être votre chiffre de facture final.
DeepSeek Harness fournit un compteur de tokens monté par défaut. Il expose tokenUsage, contextPressure et contextBreakdown dans la vue Trajectory. contextBreakdown vous indique si la facture provient de l'invite système, des schémas d'outils, des lectures de fichiers ou de la relecture de conversation. Le compteur estime environ un token pour quatre caractères, utilisez-le donc comme une vue de diagnostic.
OpenCode suit les tokens et les coûts par session et les affiche dans la ligne d'état de la TUI. Sa ventilation intégrée est plus petite, donc les équipes qui ont besoin d'une attribution par outil inspectent souvent la base de données des sessions avec des analyseurs externes.
Utilisez les chiffres du côté du fournisseur pour la comparaison :
| Ce qu'il faut comparer | Où l'obtenir |
|---|---|
| Total des tokens en entrée | Tableau de bord d'utilisation du fournisseur, par clé API |
| Total des tokens en sortie | Tableau de bord d'utilisation du fournisseur, par clé API |
| Nombre d'appels de modèle | Vue trajectoire du harness / journal de session OpenCode |
| Temps réel | Chronomètre, du début à la dernière écriture de fichier |
| Succès ou échec | Code de sortie de npm test |
Créez deux clés API, harness-test et opencode-test, et utilisez chaque clé pour une exécution. Le tableau de bord du fournisseur vous donne alors une utilisation propre côte à côte sans avoir à concilier deux estimateurs internes.
Pourquoi la facture varie
La consommation de tokens change pour des raisons concrètes. Ces cinq facteurs ont généralement plus d'importance que le prix du modèle.
La relecture de conversation s'accumule. Les agents renvoient la conversation qui s'allonge à chaque étape. Une tâche en 40 étapes coûte plus près de la somme de 40 invites croissantes que de 40 invites identiques. Les harness qui résument tôt se situent plus près de l'extrémité inférieure de la fourchette du benchmark.
Les hits de cache réduisent le coût des entrées. Les hits de cache de DeepSeek V4 Flash sont facturés environ 0,0028 $ par million de tokens contre 0,14 $ par million en cas d'échec, soit environ 98% moins cher. La mise en cache nécessite un préfixe stable octet par octet. Si un harness mélange le texte de l'invite système entre les appels, il transforme les hits en échecs.
Les schémas d'outils sont transportés. Vingt serveurs MCP connectés signifient vingt ensembles de schémas dans l'invite, même si la tâche n'en utilise que deux. Déconnectez les outils dont vous n'avez pas besoin avant de faire un benchmark, sinon vous mesurez votre configuration d'outils plutôt que le harness.
Les sorties volumineuses des outils empoisonnent le contexte. Un cat d'un fichier de 3 000 lignes ou un journal de test verbeux reste dans la conversation pour les appels ultérieurs. DeepSeek Harness peut élaguer les résultats d'outils surdimensionnés avant de résumer. Activez cette option lorsque la tâche produit une sortie bruyante.
Les tentatives se cachent dans le nombre d'appels. Un harness qui réessaie une boucle de test échouée dépense des tokens à chaque fois. Comparez le nombre d'appels de modèle en plus du total des tokens afin de pouvoir séparer une boucle de tentatives d'une invite coûteuse.
Au tarif Atlas Cloud pour DeepSeek V4 Flash, une tâche de 692 000 tokens pondérée vers l'entrée se situe dans les quelques centimes. C'est peu pour une seule exécution et beaucoup pour une équipe qui utilise des agents toute la journée. Parcourez le catalogue de modèles complet si vous souhaitez répéter le test sur un second modèle et séparer les effets du modèle de ceux du harness.
DeepSeek Harness est encore un aperçu développeur, et son README avertit de modifications de rupture. Benchmarquez-le si vous voulez le contrôle de la boucle de l'agent. Standardisez-le uniquement si votre équipe peut absorber les changements. OpenCode est le choix plus stable pour les équipes qui ont besoin d'un outil aujourd'hui.
Questions fréquemment posées
DeepSeek Harness est-il meilleur qu'OpenCode ?
Pas pour la plupart des équipes pour l'instant. OpenCode est mature, natif du terminal, a environ 198k étoiles et un grand catalogue de fournisseurs, et fonctionne aujourd'hui. DeepSeek Harness est plus récent, en aperçu développeur, et prévient de modifications de rupture. Choisissez Harness si vous voulez modifier les composants internes de l'agent. Choisissez OpenCode si vous voulez un agent de codage pour le travail quotidien.
DeepSeek Harness fonctionne-t-il uniquement avec les modèles DeepSeek ?
Non. Il est indépendant du modèle. Il fournit des fournisseurs de catalogue pour DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure et Codex, et vous pouvez ajouter n'importe quel fournisseur personnalisé qui parle openai-completions, openai-responses ou anthropic-messages dans $DSH_HOME/settings.yaml. La configuration de l'étape 1 le pointe vers un point de terminaison compatible OpenAI sans code d'adaptateur.
Comment vérifier l'utilisation des tokens de DeepSeek Harness ?
Utilisez le compteur de tokens intégré dans la vue Trajectory. Il expose tokenUsage, contextPressure et contextBreakdown. Considérez-le comme une estimation car il utilise environ un token pour quatre caractères. Pour la précision de la facturation, lisez le tableau de bord d'utilisation du fournisseur, idéalement avec une clé API dédiée pour chaque exécution.
Quel harness utilise moins de tokens, DeepSeek Harness ou OpenCode ?
Aucun benchmark public en tête-à-tête ne répond encore à cette question. Le benchmark Composio a mesuré OpenCode à 692 000 tokens moyens par tâche, mais il a été exécuté avant la sortie de DeepSeek Harness. Effectuez le test de l'étape 2 à l'étape 4 sur votre propre dépôt car l'utilisation des tokens dépend de la taille de la base de code, de la configuration des outils et de la forme de la tâche.
Puis-je exécuter DeepSeek Harness et OpenCode avec la même clé API ?
Oui, pour un test occasionnel. Pour une mesure propre, utilisez deux clés distinctes, une par harness. Le tableau de bord du fournisseur attribue alors chaque token à la bonne exécution.
Quelle est la différence entre un agent et un harness ?
DeepSeek décrit un agent comme Modèle plus Harness. Le modèle raisonne. Le harness connecte le modèle aux fichiers, commandes shell, outils, sessions, approbations et la boucle qui décide la prochaine action. Changez le harness et le même modèle peut dépenser un nombre différent de tokens pour la même tâche.


