

Une archive de projet de 900 pages est facile à téléverser. La question plus difficile est de savoir si le modèle peut pointer vers la clause, le commit ou la donnée exacte dont vous avez besoin. Les cas d’usage de la fenêtre de contexte de 1 M de DeepSeek V4.1 Flash ont du sens lorsque plusieurs sources liées doivent être examinées ensemble, comme une base de code, un corpus de recherche ou des années de dossiers de projet. La fenêtre plus large réduit le besoin de scinder ces documents en amont, tandis que les vérifications des preuves déterminent encore si une réponse est fiable.
Les cas les plus adaptés sont la revue de code entre fichiers, la synthèse de recherche, la comparaison de politiques, l’analyse de retours, les chronologies de projet et les longs enregistrements multimodaux. DeepSeek indique un contexte de 1 M de tokens, mais cette capacité ne garantit pas que chaque détail sera rappelé avec exactitude. Vérifiez les limites du modèle et de l’API pour votre route, puis testez votre propre matériel avant de vous fier au résultat.
Points clés
- Utilisez une fenêtre d’un million de tokens lorsque la question dépend de relations entre de nombreuses sources pertinentes.
- Demandez des références de fichier, de section ou de page et distinguez les preuves directes de l’inférence.
- Commencez par un test à réponse connue et élargissez le contexte uniquement lorsque cela améliore le résultat.
- Estimez le coût à partir de l’entrée, de la sortie et du traitement du cache, pas uniquement de la limite de contexte.
Que signifie une fenêtre de contexte de 1 M de tokens ?
Une fenêtre de contexte correspond à la quantité d’informations qu’un modèle peut prendre en compte dans une requête ou un état de conversation, y compris le matériel fourni et les instructions environnantes. La page de tarification actuelle de l’API DeepSeek répertorie DeepSeek-V4.1-Flash avec une longueur de contexte de 1 M et une sortie maximale de 384 K tokens. C’est la limite déclarée par le fournisseur ; votre application, votre point de terminaison ou votre configuration de requête peut imposer une limite inférieure. ( Documentation de l’API DeepSeek )
Les tokens sont des fragments de texte, pas des mots ni des pages. Une archive source contenant du code, des tableaux, du balisage, des éléments répétitifs et des numérisations peut se tokeniser très différemment d’une prose propre ayant le même nombre de pages. Pour une charge de travail réelle, estimez les tokens avec le tokenizer ou les rapports d’utilisation de l’API que vous allez appeler. Incluez les instructions système, les noms de fichiers, les métadonnées, le texte de la question et le budget de réponse dans votre estimation.
L’avantage pratique est la continuité. Vous pouvez poser des questions sur les dépendances entre plusieurs modules ou sur les contradictions entre une politique actuelle et ses annexes sans devoir d’abord assembler manuellement des résumés. La contrepartie est qu’un très grand prompt peut contenir du matériel non pertinent ou dupliqué, prendre plus de temps à traiter et rendre malgré tout l’extraction exacte plus difficile. Considérez « tient dans la fenêtre » comme une vérification de capacité, puis testez si le modèle peut trouver les faits dont votre tâche a besoin.
Les meilleurs cas d’usage du contexte de 1 M de DeepSeek V4.1 Flash
La bonne question n’est pas « Puis-je tout téléverser ? » mais « Quelles sources doivent être comparées pour répondre à cette question ? » Utilisez un contexte long lorsque la réponse dépend de liens entre des documents, et définissez comment vous vérifierez cette réponse avant d’envoyer l’archive complète.
| Cas d’usage | Pourquoi un contexte long aide | Quoi inclure | Quoi vérifier |
|---|---|---|---|
| Revue d’une grande base de code | Les interfaces et conventions couvrent plusieurs modules | Source pertinente, tests, notes d’architecture | Chemins de fichiers, symboles, preuves de test |
| Synthèse de recherche | Les méthodes et résultats nécessitent une comparaison côte à côte | Articles, rapports, limites | Source et réserves de chaque affirmation |
| Comparaison de contrats ou de politiques | Les définitions et exceptions reviennent dans plusieurs sections | Versions actuelle et antérieures, annexes | Numéros de clause et libellé exact |
| Analyse des retours | Les thèmes apparaissent dans de nombreux commentaires | Retours dé-identifiés et règles de codage | Citations représentatives et méthode de comptage |
| Chronologie de l’historique de projet | Les décisions évoluent au fil des comptes rendus | Procès-verbaux, journaux de décision, notes de version | Dates, responsables, enregistrements contradictoires |
| Revue d’incident longue | Les journaux, tickets et post-mortems expliquent différentes étapes | Plage temporelle pertinente et documents d’incident | Horodatage, source de l’événement, incertitude |
| Revue de documents multimodaux | Les preuves textuelles et visuelles peuvent nécessiter une lecture conjointe | Images prises en charge et leurs légendes ou contexte | Si le point de terminaison prend en charge le type de média |
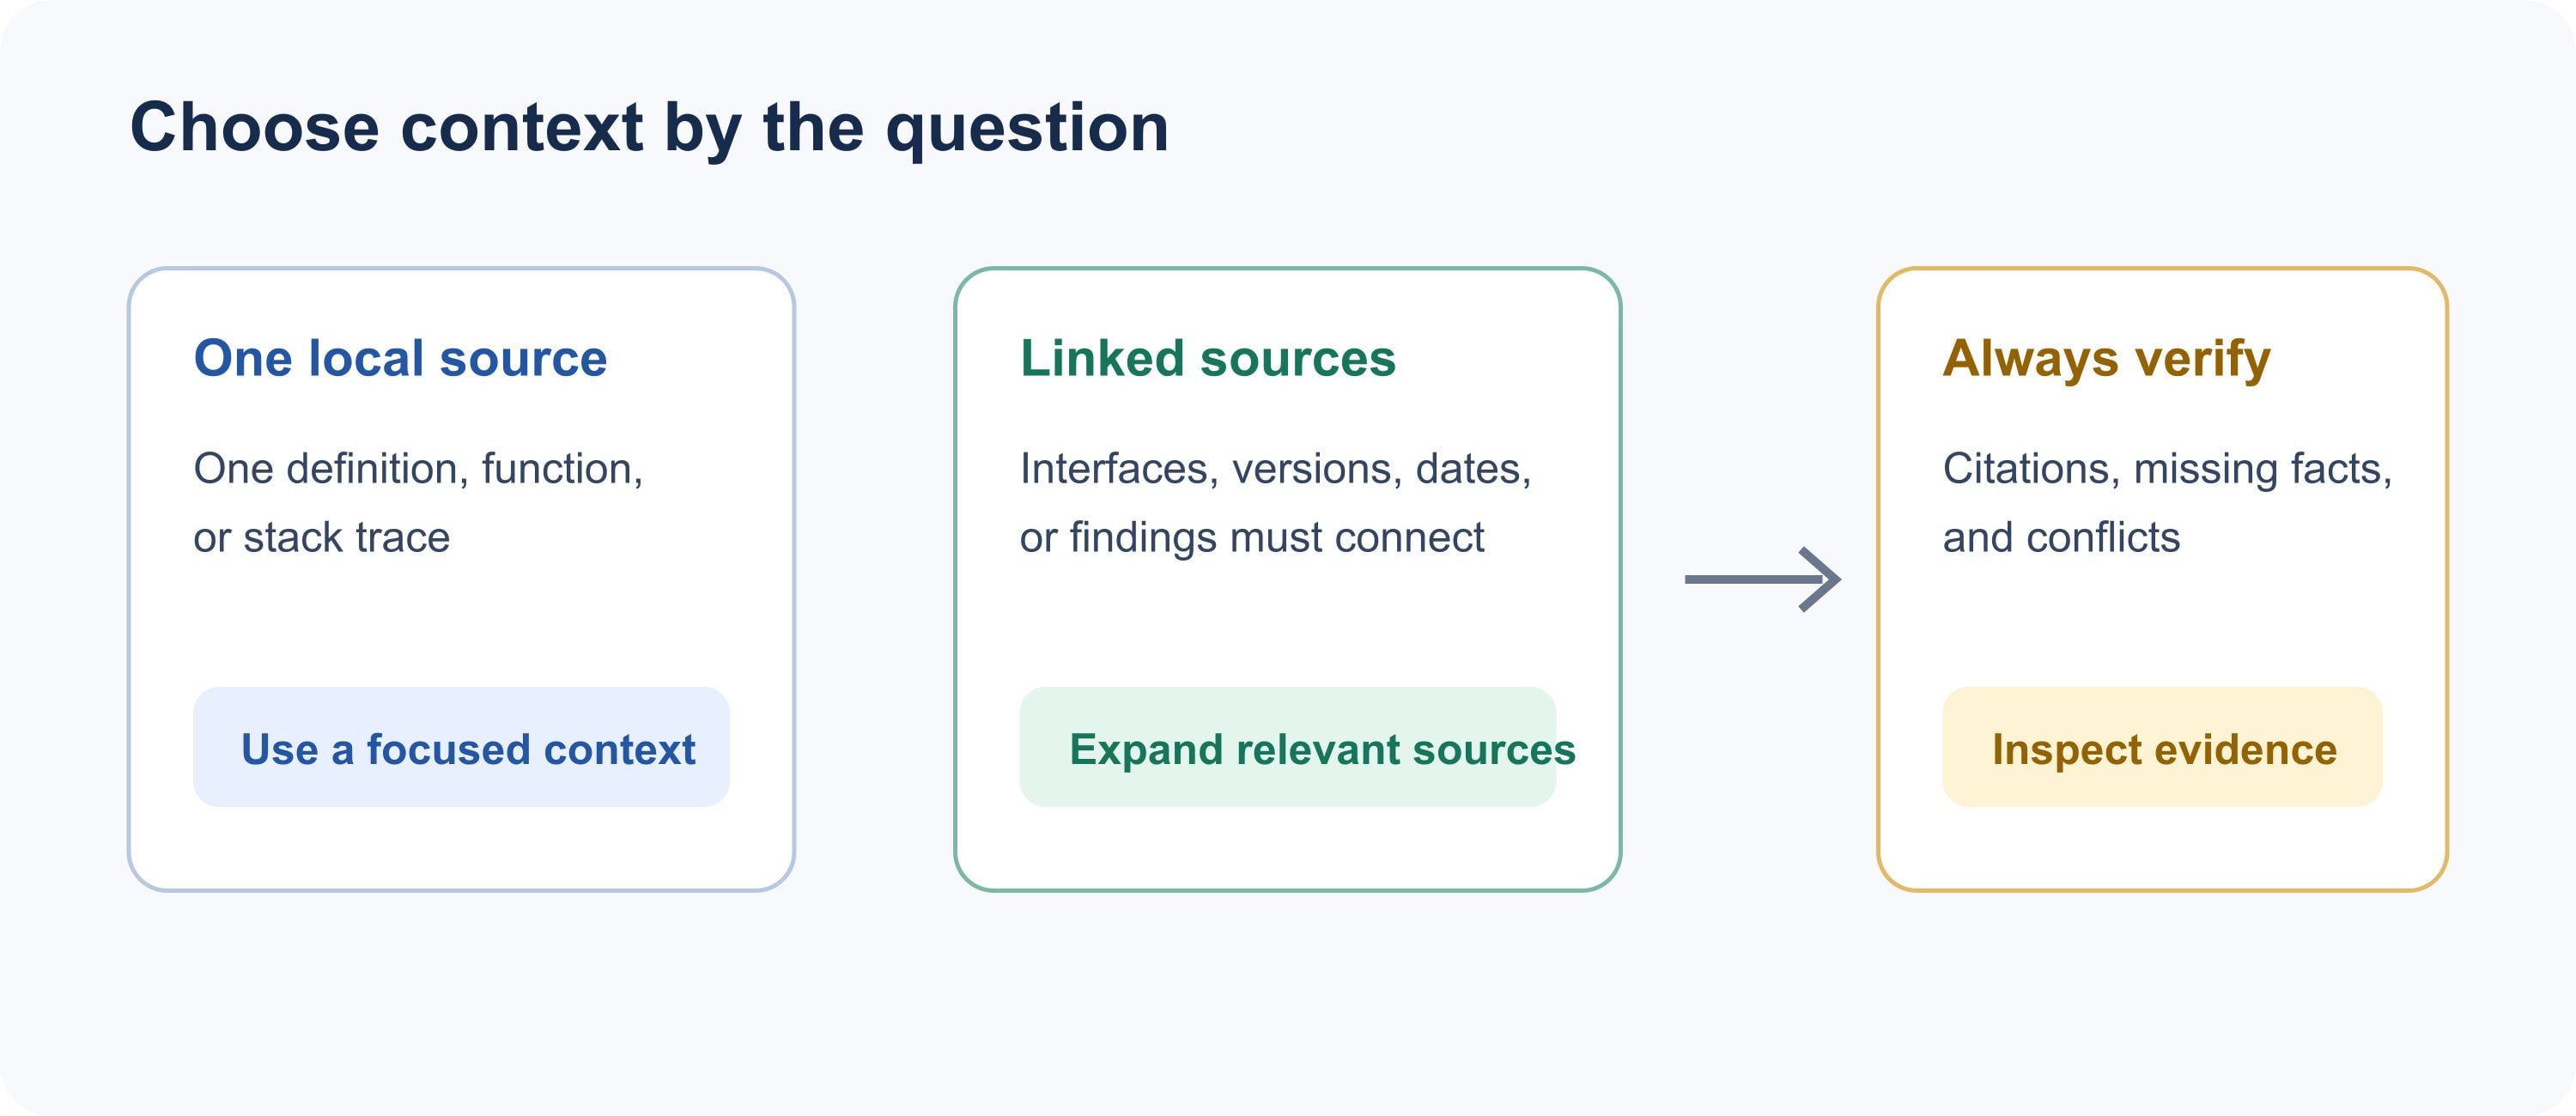
Utilisez un contexte ciblé pour une question locale ; élargissez lorsque les sources doivent être reliées, puis inspectez les preuves.
Examiner une grande base de code entre les fichiers
Un contexte d’un million de tokens peut aider un ingénieur à suivre une structure de données depuis une frontière d’API jusqu’à la logique de service, le stockage et les tests. Il est utile pour les résumés d’architecture, l’identification des modules probablement concernés et la rédaction d’un plan de refactorisation qui respecte les conventions documentées à plusieurs endroits.
Fournissez au modèle un instantané borné du dépôt plutôt qu’un vidage de disque non filtré. Incluez les fichiers source pertinents pour la modification, les tests les plus proches, les manifestes de dépendances et les notes d’architecture. Excluez les sorties de build, les dépendances vendoriées, les bundles générés et les copies en double, sauf si la question les concerne. Demandez les chemins de fichiers et les noms de symboles pour chaque dépendance proposée, ainsi qu’une distinction entre le comportement observé et une hypothèse.
Utilisez la sortie comme plan de revue. Confirmez que chaque symbole cité existe, examinez les lignes citées et exécutez vous-même les vérifications du projet. Le modèle ne doit pas affirmer que les tests ont réussi, sauf si un outil les a réellement exécutés et a renvoyé le résultat. Pour un bug localisé dans une fonction, un contexte plus petit est souvent plus rapide et plus facile à auditer.
Synthétiser la recherche entre articles et rapports
Un contexte long aide lorsque les études utilisent des méthodes, populations, mesures ou définitions différentes. Demandez un tableau comparatif avec une ligne par source et des colonnes pour la question de recherche, les données, la méthode, le résultat, les limites et la pertinence pour votre question. Gardez les affirmations au niveau de la source rattachées à leur source plutôt que de laisser un résumé fusionné effacer les désaccords.
Par exemple, lorsque vous comparez des évaluations d’un outil, distinguez un résultat de benchmark d’une étude de terrain et de l’interprétation d’un auteur. Demandez au modèle de signaler les mesures incompatibles au lieu de classer des résultats qui ne peuvent pas être comparés. Ouvrez ensuite les passages sources derrière les affirmations les plus déterminantes pour la décision. Une synthèse est une carte des preuves, pas un substitut à la vérification des articles.
Comparer de longs contrats, politiques ou spécifications
Les contrats et politiques définissent souvent un terme une fois, puis le nuancent ailleurs. Fournir ensemble la version en vigueur, les amendements, les annexes et l’ébauche antérieure pertinente peut aider à faire ressortir les définitions modifiées, les renvois, les conditions manquantes et les conflits apparents.
Demandez la section ou la clause exacte pour chaque observation et un court extrait qu’un relecteur peut localiser. Séparez les différences textuelles de leurs conséquences possibles. Le modèle peut aider à organiser une revue, mais l’interprétation juridique, les décisions de conformité et le pouvoir de signature restent aux personnes qualifiées capables de tenir compte de la juridiction et du contexte.
Analyser les retours clients à grande échelle
Un vaste ensemble de retours peut révéler des demandes et objections récurrentes selon les canaux ou les périodes. Fournissez un échantillon défini, supprimez les informations personnelles non nécessaires et précisez un schéma de codage tel que « friction d’intégration », « intégration manquante » ou « confusion tarifaire ». Demandez des exemples et contre-exemples représentatifs, pas seulement une liste de thèmes.
Ne présentez pas les pourcentages de thèmes générés par le modèle comme des statistiques d’enquête. Si vous avez besoin de dénombrements, définissez l’unité (message, client ou problème), dédupliquez les enregistrements, appliquez une règle d’étiquetage cohérente et vérifiez le décompte avec un script reproductible ou un échantillon examiné par un humain. Le modèle est utile pour proposer des catégories et trouver des exemples ; une méthode documentée étaye les affirmations quantitatives.
Construire une chronologie à partir de documents de projet
Pour une transmission ou un post-mortem, les preuves pertinentes peuvent être dispersées entre les comptes rendus de réunion, les notes de version, les journaux de décision et les tickets. Demandez un tableau chronologique avec la date, l’événement, le responsable nommé lorsqu’il est indiqué, l’emplacement de la source et le niveau de confiance ou l’ambiguïté. Demandez au modèle de conserver les dates contradictoires au lieu d’en choisir une en silence.
Une chronologie utile aide un nouveau membre de l’équipe à voir ce qui a été décidé, quand une exigence a changé et quel document étaye chaque événement. Vérifiez les transitions critiques par rapport à l’enregistrement source, en particulier lorsqu’une note a été rédigée plus tard ou résume une réunion plutôt que de la consigner directement.
Examiner de longs enregistrements d’incident et du matériel multimodal
La revue d’incident peut bénéficier du regroupement des alertes, notes opérationnelles, tickets et post-mortem dans un même ensemble de preuves. Demandez une séquence d’événements observés et distinguez explicitement les horodatages des journaux des estimations ultérieures dans les notes narratives. Cela peut rendre la première passe plus cohérente, tandis que l’ingénieur d’astreinte vérifie toujours les systèmes sources avant d’agir.
L’annonce officielle de DeepSeek indique que V4.1-Flash est disponible sur son API avec prise en charge multimodale native. Les formats d’image exacts, les méthodes de requête et les limites dépendent du point de terminaison et de l’intégration ; confirmez donc ces détails avant de supposer qu’un budget de texte d’un million de tokens décrit aussi le traitement des images. ( Annonce de DeepSeek V4.1-Flash )
Quand un million de tokens aide-t-il, et quand ajoute-t-il du bruit ?
Davantage de contexte aide lorsque les sources doivent être recoupées. Une modification de code impliquant une interface partagée peut nécessiter plusieurs modules et tests. Une comparaison de versions nécessite les deux versions complètes et leurs annexes. Une chronologie de projet peut nécessiter des enregistrements répartis sur plusieurs mois.
Un bug local avec une stack trace claire peut ne nécessiter que la fonction, ses appelants et le test pertinent. Une question demandant une seule définition peut ne nécessiter que la section faisant autorité. Pour ces tâches, inclure un dépôt entier ajoute de l’espace de recherche et peut enterrer le passage utile.
Avant d’élargir le prompt, supprimez les exports répétés, les ébauches obsolètes, les dossiers non liés, les éléments répétitifs et les enregistrements hors de la plage temporelle de la question. Tenez un manifeste de ce que vous avez inclus et pourquoi. Si la réponse change lorsque vous ajoutez un grand lot de fichiers non liés, c’est le signal de resserrer l’ensemble des sources et de relancer le test.
Un workflow pratique pour des réponses fiables en contexte long
Utilisez un protocole de preuves cohérent pour qu’une réponse fluide ne soit pas confondue avec une réponse vérifiée. Étiquetez d’abord les sources avec des noms de fichiers stables et, lorsque c’est possible, des numéros de page, des titres, des numéros de ligne, des dates ou des identifiants de version. Préservez suffisamment de contexte environnant pour interpréter correctement les extraits.
Ensuite, énoncez une décision ou une question de recherche. Précisez la forme de sortie et les emplacements que le modèle doit citer. Un prompt réutilisable est :
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
Pour une base de code, ajoutez : « Citez les chemins du dépôt et les noms de fonctions ou de classes. Avant de proposer une modification, listez les fichiers concernés et les preuves de test qui étayent la proposition. Ne dites pas qu’un test a été exécuté, sauf si son résultat figure dans les preuves fournies. »
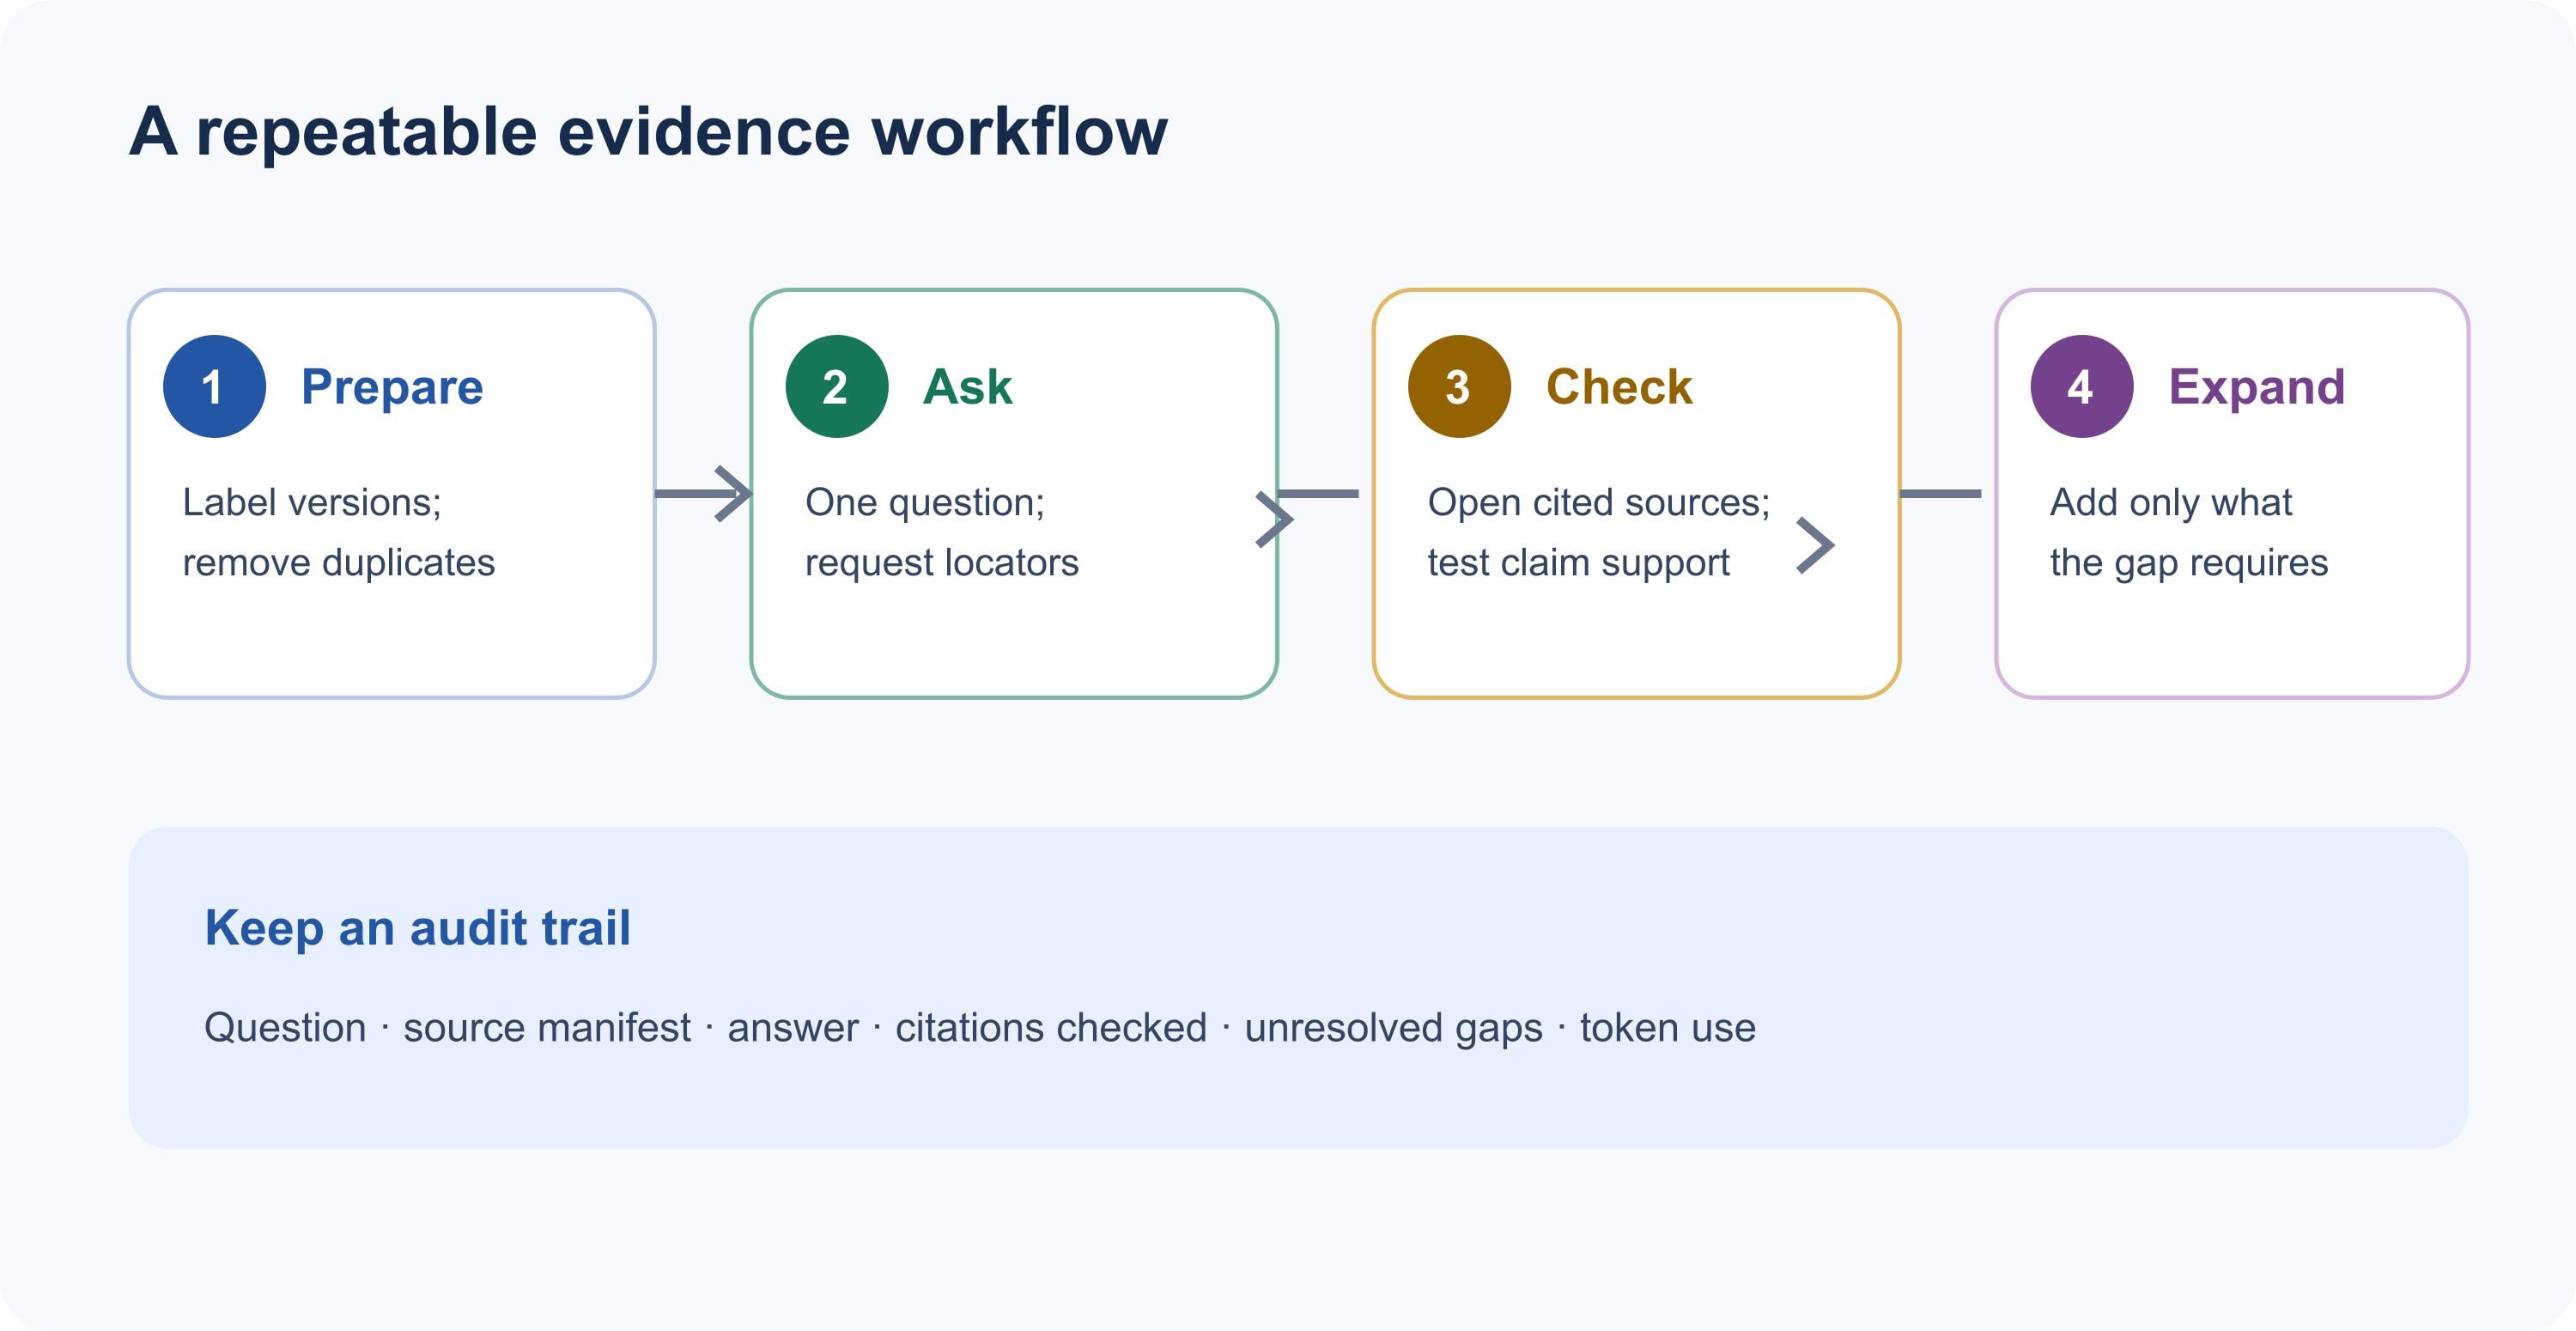
Préparez les sources, posez une question bornée, vérifiez les citations et élargissez uniquement pour combler une lacune.
Examinez ensuite la réponse en trois passes. Vérifiez si chaque citation pointe vers un emplacement réel. Vérifiez si le passage cité étaye l’affirmation, plutôt que de simplement mentionner le sujet. Enfin, examinez les omissions et les conflits en posant des questions de suivi ciblées sur le même ensemble de sources. Pour les décisions à enjeux élevés, faites lire directement le matériel source par un relecteur qualifié.
Carte des preuves du workflow en contexte long
| Étape | Action | À conserver | Signal d’arrêt |
|---|---|---|---|
| 1. Préparer | Étiqueter, dédupliquer et délimiter les sources | Manifeste des sources et versions | Provenance inconnue ou doublon obsolète |
| 2. Demander | Poser une question et définir un format de preuves | Noms de fichiers et localisateurs dans la réponse | Demande large sans cible décisionnelle |
| 3. Vérifier | Ouvrir les passages cités et comparer les affirmations | Affirmations étayées et lacunes explicites | La citation n’étaye pas l’affirmation |
| 4. Élargir | Ajouter uniquement les sources nécessaires aux liens non résolus | Amélioration sur les tests à réponse connue | Plus d’entrée sans meilleures preuves |
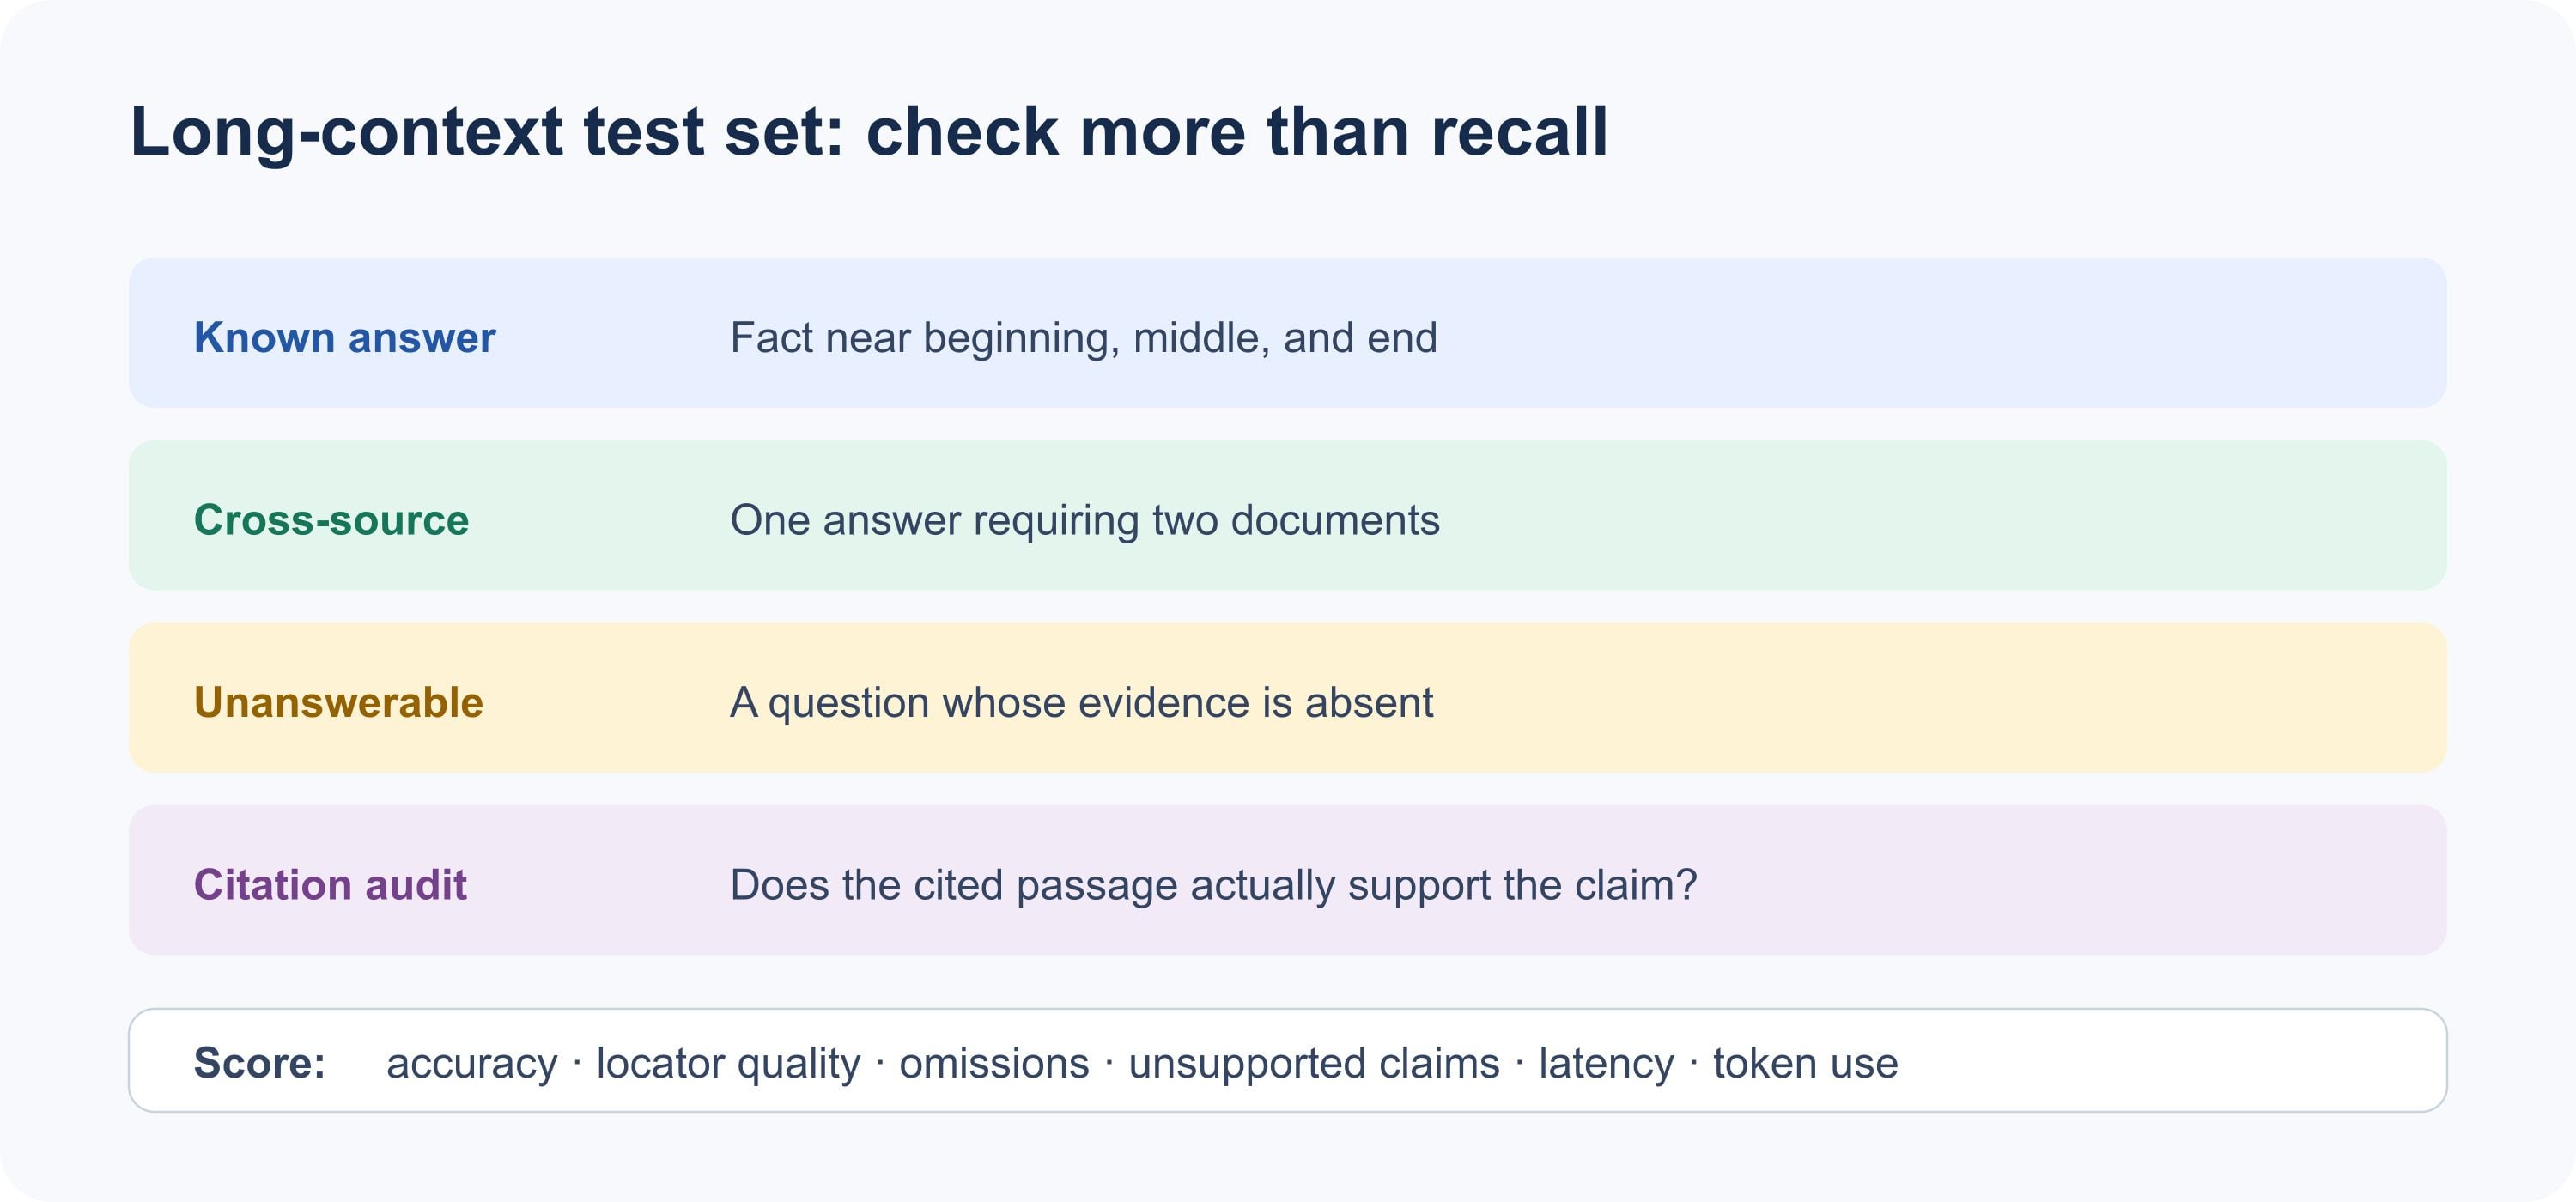
Comment tester si le contexte de 1 M est utile pour votre tâche
Créez un petit ensemble d’évaluation avant de charger l’archive complète. Rédigez des questions dont vous connaissez déjà les réponses à partir du matériel source. Placez certains faits près du début, d’autres au milieu et d’autres près de la fin. Ajoutez au moins une question qui nécessite de relier deux documents et une qui ne peut pas être répondue à partir des sources fournies.
Exécutez d’abord les mêmes questions sur un sous-ensemble plus petit et pertinent, puis augmentez le contexte par étapes mesurées. Enregistrez l’exactitude factuelle, la précision des localisateurs, les preuves manquées, les affirmations non étayées, le refus de répondre à la question sans réponse, la latence et l’utilisation de tokens. Gardez le prompt et les paramètres de décodage stables afin que les changements soient interprétables. Répétez une question si les sorties varient sensiblement entre les exécutions.
| Vérification | Ce qu’une réponse réussie montre | Que faire après un échec |
|---|---|---|
| Fait connu aux positions début, milieu et fin | Extraction à travers l’étendue de la source | Vérifier l’indexation, les étiquettes de fichier et la longueur du prompt |
| Lien entre documents | Les preuves peuvent être reliées entre les sources | Demander les deux citations, puis préciser la question du lien |
| Question sans réponse | Le modèle peut signaler des preuves manquantes | Renforcer « utilisez uniquement les sources fournies » et retester |
| Audit des citations | Le localisateur et l’extrait étayent l’affirmation | Traiter l’affirmation comme non vérifiée jusqu’à correction |
| Comparaison avec contexte plus large | Du matériel supplémentaire améliore la tâche cible | Retirer le bruit si l’exactitude ou la latence se dégrade |
Évaluez l’extraction, l’appui des citations, les omissions, les affirmations non étayées, la latence et l’utilisation de tokens.
Les retours de la communauté sont mitigés et dépendent de la tâche. Un utilisateur Reddit a partagé une augmentation propre à son harnais des arguments d’outil malformés avec des tailles de contexte plus grandes, tandis que des commentateurs ont décrit un travail réussi à des nombres de tokens plus élevés dans d’autres configurations. C’est une bonne raison de benchmarker votre propre harnais, pas une preuve d’un seuil d’échec universel. ( Discussion sur le contexte DeepSeek sur Reddit )
Une montée en charge raisonnable consiste à : valider le prompt sur un petit échantillon, ajouter les groupes de sources nécessaires aux questions inter-documents, puis tester une grande requête représentative. Conservez le plus petit contexte qui répond à la question réelle avec des preuves fiables. Cela rend aussi les comparaisons de latence et de coût plus faciles à interpréter.
Tarification et accès à l’API DeepSeek V4.1 Flash
Chez Atlas Cloud, la fiche du modèle indique actuellement DeepSeek V4.1 Flash avec un contexte de 1 M et des tarifs de $0.30 par million de tokens d’entrée, $1.20 par million de tokens de sortie et $0.03 par million de tokens de lecture de cache. La fiche n’indique aucune remise pour ce modèle. Il s’agit des tarifs d’Atlas Cloud, distincts des prix de pointe et hors pointe de DeepSeek, qui dépendent du moment. Revérifiez le catalogue de modèles Atlas Cloud et la page de tarification des modèles avant de publier ou de budgéter, car les tarifs peuvent changer.
Aux tarifs indiqués, une requête de 100 000 tokens d’entrée non mis en cache et de 2 000 tokens de sortie coûte environ $0.03 pour l’entrée plus $0.0024 pour la sortie, soit $0.0324 au total avant tout autre frais applicable. Si l’entrée est facturée comme lectures de cache, 100 000 tokens mis en cache coûteraient plutôt $0.003. L’exemple suppose ces nombres de tokens et ces tarifs ; il ne s’agit pas d’un devis pour une charge de travail spécifique. La capacité complète de 1 M n’est pas facturée simplement parce qu’elle existe. La facturation suit l’utilisation et le traitement du cache.
Pour les équipes qui veulent un point d’entrée API unique, la page du modèle DeepSeek V4.1 Flash fournit le modèle et les détails d’appel. Comparez également votre utilisation mesurée de tokens et vos besoins d’intégration avec le point de terminaison officiel ; les noms de modèles, les limites et les prix peuvent varier selon le fournisseur.
Questions fréquentes
Une fenêtre de contexte de 1 M de tokens équivaut-elle à 1 M de mots ?
Non. Les tokens peuvent être des parties de mots, de la ponctuation, des fragments de code ou d’autres unités. Le nombre de mots ou de pages qui tiennent dépend du matériel et de sa tokenisation. Utilisez des nombres de tokens mesurés plutôt qu’une conversion fixe en pages.
DeepSeek V4.1 Flash utilise-t-il toujours la fenêtre de contexte complète ?
Non. Un million de tokens est une spécification de contexte maximale, pas une cible pour chaque requête. Un prompt court en utilise moins, et une interface ou une route d’API particulière peut imposer un plafond inférieur. Vérifiez la documentation du point de terminaison et les champs d’utilisation réels.
Un contexte de 1 M suffit-il pour toute une base de code ?
Il peut correspondre à certaines bases de code en nombre de tokens, mais cela ne rend pas chaque fichier pertinent ni chaque réponse fiable. Incluez les fichiers nécessaires à la question, vérifiez les chemins et symboles cités, et testez les modifications avec les vraies vérifications du projet.
Dois-je mettre tous les documents disponibles dans un seul prompt ?
Uniquement si les documents portent sur la même question. Partez d’un manifeste des sources, supprimez les doublons et le matériel non lié, puis ajoutez-en davantage lorsqu’un test inter-documents l’exige. Les meilleurs cas d’usage de la fenêtre de contexte de 1 M de DeepSeek V4.1 Flash sont définis par les preuves qui doivent être comparées, non par la taille de l’archive.





