Deux équipes peuvent annoncer des centaines de tokens par seconde pour DeepSeek V4.1 Flash et mesurer malgré tout des choses différentes. L’une peut désigner la vitesse de décodage d’une seule requête ; l’autre peut désigner le débit de sortie agrégé sur des dizaines de requêtes simultanées. Pour améliorer l’optimisation du débit d’inférence de DeepSeek V4.1 Flash, commencez par choisir la métrique dont votre service a besoin, puis évaluez votre propre mix de requêtes, modifiez une variable de service à la fois et vérifiez conjointement la latence, la qualité et le coût. La famille de modèles inclut désormais la mise à jour Flash-1017 du 17 octobre, alors enregistrez le checkpoint exact avant de comparer les résultats. Les rapports publics présentent des pistes d’optimisation utiles, mais aucune ne remplace un test apparié sur votre matériel.
Points clés
- Les tokens/s de sortie agrégés mesurent la capacité sur l’ensemble des requêtes ; la vitesse de décodage par requête mesure l’expérience d’un utilisateur individuel.
- Reproduisez vos longueurs de prompt, limites de sortie, concurrence, état chaud et objectif de latence avant de régler quoi que ce soit.
- Le cache KV compressé et le replay borné de V4.1 Flash réduisent la pression mémoire, mais ne garantissent pas une accélération de bout en bout fixe.
- Comparez vLLM et SGLang uniquement dans des conditions identiques de modèle, matériel, charge de travail et mesure.
Que signifie le débit pour DeepSeek V4.1 Flash ?
Le débit est un taux, mais le numérateur et le périmètre de test comptent. Pour un service d’inférence, enregistrez au moins cinq mesures :
| Métrique | Ce qu’elle indique | Utilisation typique |
|---|---|---|
| Tokens/s de sortie agrégés | Tokens de sortie produits par toutes les requêtes actives par seconde | Planification de capacité et efficacité du parc |
| Tokens/s de décodage par requête | Vitesse de génération perçue par une requête individuelle | Réactivité interactive pendant la génération |
| Tokens/s de prefill | Tokens d’entrée traités par seconde | Prompts longs et charges à forte composante de récupération |
| Temps jusqu’au premier token (TTFT) | Temps entre l’arrivée de la requête et le premier token de sortie | Délai de démarrage perçu |
| Latence de bout en bout, p50/p95 | Durée totale des requêtes sur la distribution du trafic | Objectifs de niveau de service et comportement de queue |
Un serveur peut augmenter le débit agrégé en regroupant davantage de séquences, tout en faisant attendre chaque utilisateur plus longtemps entre les tokens. À l’inverse, une configuration optimisée pour une faible concurrence peut offrir des réponses individuelles très réactives tout en laissant les accélérateurs sous-utilisés. Aucun des deux résultats n’est universellement meilleur. La bonne cible est un point sur la courbe débit-latence qui satisfait l’objectif de service de votre produit.
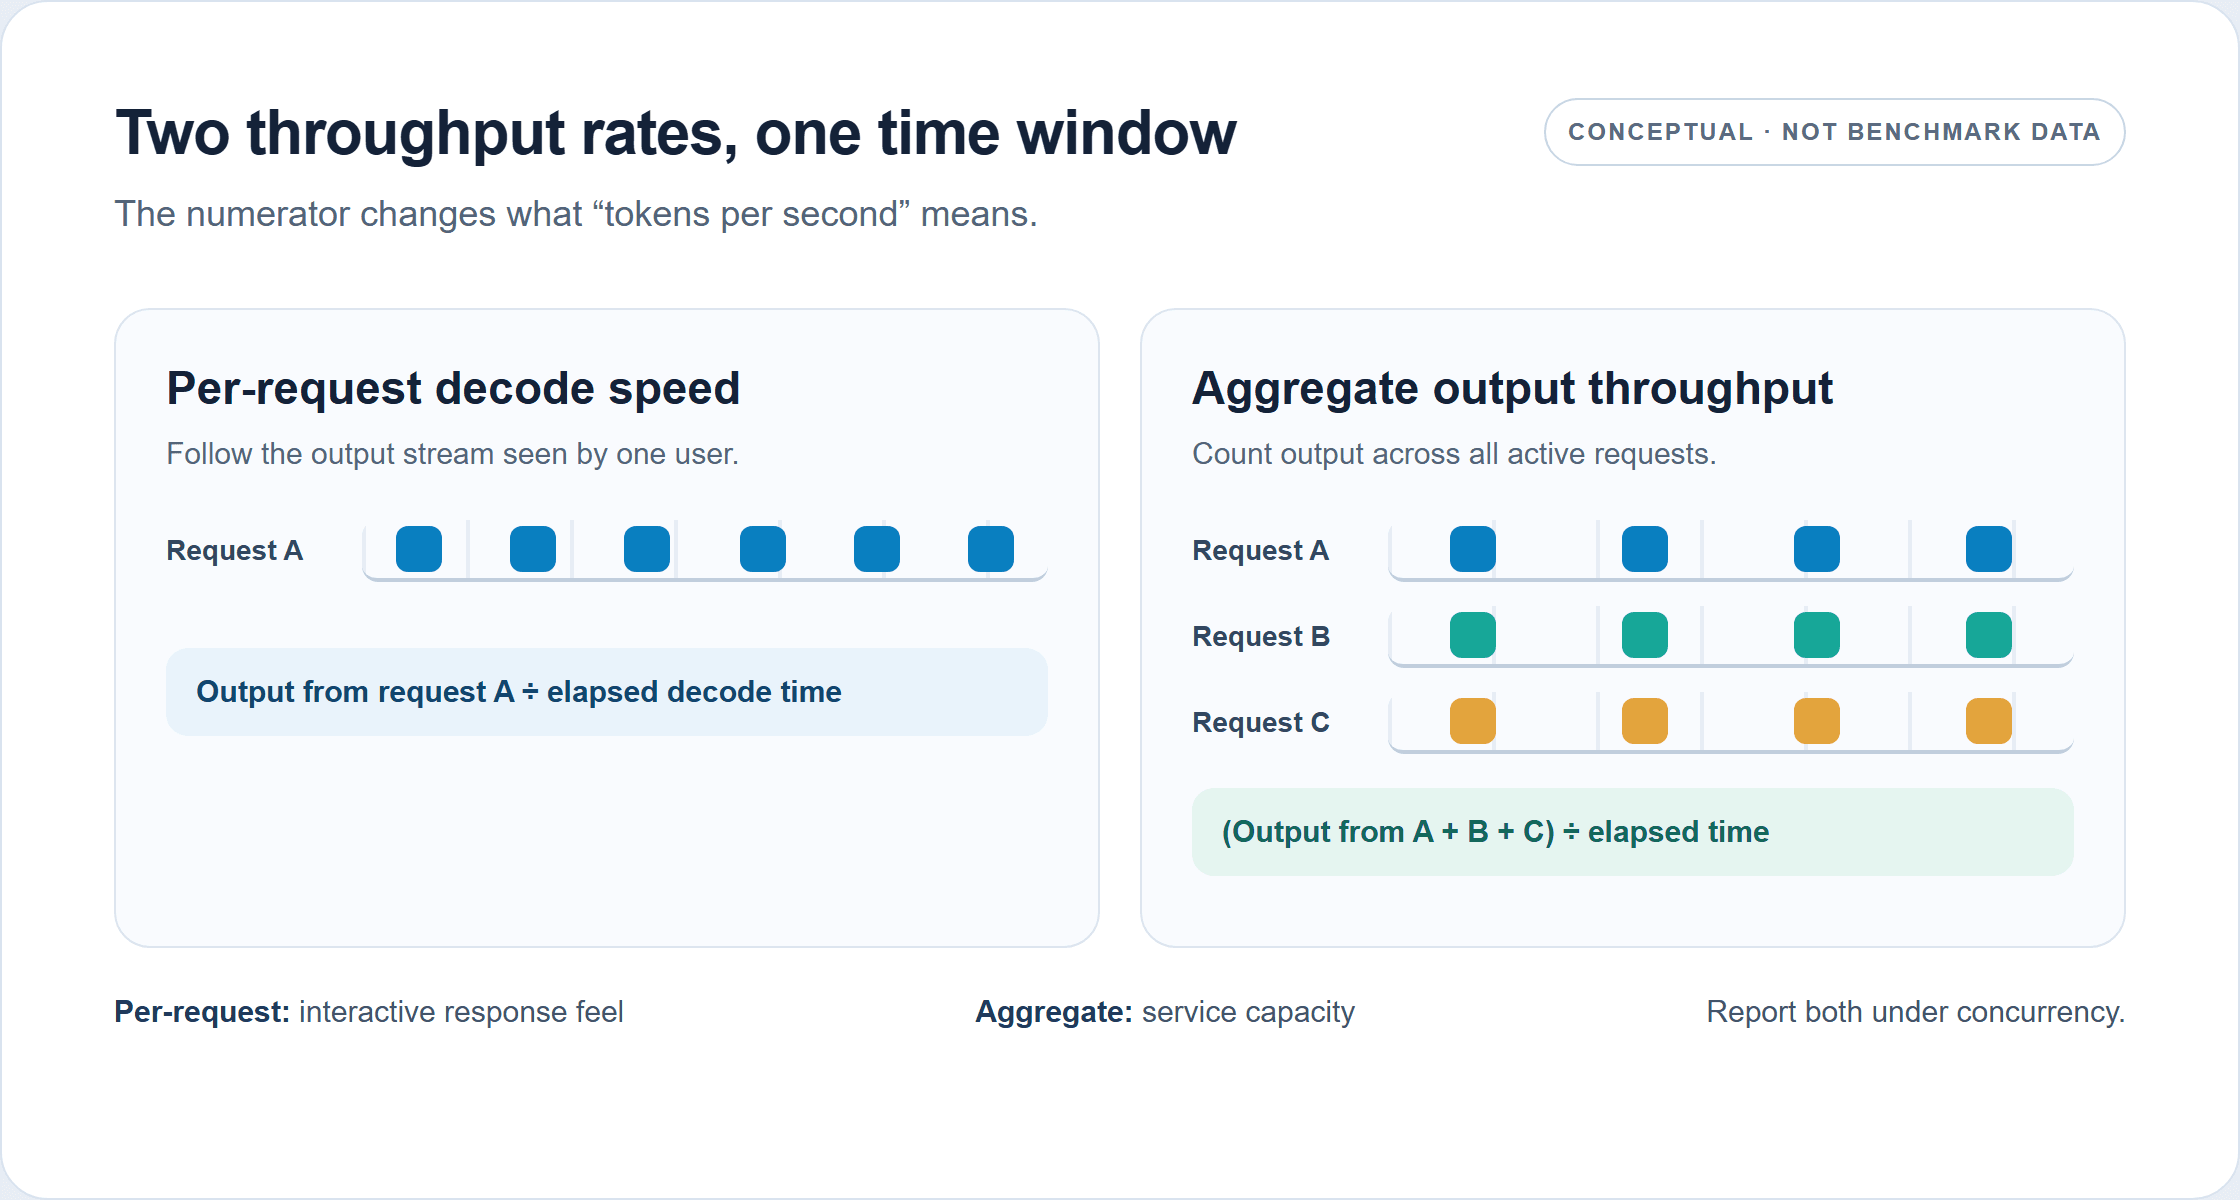
Les deux taux comptent des flux de sortie différents. Il s’agit d’un schéma conceptuel, et non de performances mesurées de DeepSeek V4.1 Flash.
Précisez si le débit inclut le prefill, le décodage ou les deux. Indiquez si vous divisez par le nombre de GPU. Rapportez les tokens de sortie réussis plutôt que le nombre maximal de tokens demandé, et mentionnez les annulations ou les erreurs. Sans ces détails, un chiffre en tokens/s ne permet pas à un opérateur de savoir s’il prédit son application.
Établir une base de référence reproductible pour DeepSeek V4.1 Flash
Une base de référence utile ressemble suffisamment au trafic de production pour exposer son goulot d’étranglement. Un seul prompt court est un mauvais proxy pour un agent qui envoie de façon répétée un long historique de conversation, et une sortie fixe de 1 024 tokens manque les charges de travail qui s’arrêtent tôt ou varient fortement.
Fixer la charge de travail et la fenêtre de mesure
Créez des groupes de requêtes à partir du trafic observé. Pour chaque groupe, conservez la longueur d’entrée approximative, la longueur de sortie attendue, le modèle d’arrivée et les éventuels préfixes partagés. Incluez les tours d’outil ou de raisonnement s’ils font partie du chemin de requête réel. Gardez les prompts, les paramètres d’échantillonnage, les conditions d’arrêt et les plafonds de sortie fixes entre les exécutions.
Exécutez à la fois un cas à faible concurrence et la concurrence que votre service attend en pic. Ajoutez ensuite des niveaux de concurrence intermédiaires pour révéler où le débit cesse d’augmenter ou où la latence dépasse sa limite. Utilisez une fenêtre de mesure stable après le préchauffage, répétez chaque point et rapportez la médiane ainsi que l’intervalle. Une courte rafale peut mesurer le comportement de démarrage plutôt que la capacité de service stable.
Séparez les mesures de démarrage à froid du service à chaud. Les exécutions à froid incluent le chargement du modèle, la capture de graphe ou le remplissage du cache selon la pile ; les exécutions à chaud décrivent un système prêt à servir. Pour une charge de travail avec mise en cache de préfixes, mesurez séparément le trafic avec succès de cache et avec échec de cache. Ne les combinez pas en une seule moyenne, sauf si le mélange correspond à la production.
Tenir un journal de benchmark
Enregistrez une ligne pour chaque exécution avec ces champs : checkpoint ou révision du modèle ; runtime et commit ; modèle et nombre de GPU ; interconnexion ; précision et quantification ; disposition parallèle tensor, expert ou pipeline ; distribution des tokens d’entrée et de sortie ; concurrence et modèle d’arrivée des requêtes ; état chaud ou froid ; durée d’exécution ; taux de réussite ; débit agrégé ; vitesse de décodage par requête ; TTFT ; et latence de bout en bout p50/p95.
Cette fiche est plus utile qu’un chiffre de classement, car elle rend la prochaine expérience reproductible. Gelez-la avant de procéder au réglage. Si la charge de travail ou le checkpoint change, repartez d’une nouvelle base de référence plutôt que d’attribuer la différence à un indicateur de service.
Diagnostiquer le prefill, le décodage, le cache KV ou l’ordonnancement
Utilisez les symptômes pour choisir la prochaine mesure, et non pour deviner une correction. Un TTFT élevé avec une vitesse de décodage acceptable oriente vers le traitement des entrées, la mise en file d’attente, les échecs de cache ou les surcoûts de démarrage. Un décodage lent à faible concurrence suggère d’examiner les kernels, la bande passante mémoire, la communication parallèle et le chemin d’exécution du modèle. Un débit agrégé qui plafonne à mesure que la concurrence augmente peut indiquer une pression mémoire, des limites d’ordonnanceur, un surcoût de communication ou un chemin de calcul saturé. Une dégradation en contexte long appelle à mesurer la résidence en cache, le travail de prefill et les transferts hôte-vers-périphérique.
| Observation | Premiers contrôles |
|---|---|
| Le TTFT augmente avec la longueur du prompt | Taux de prefill, temps de file d’attente, taux de succès du cache de préfixes, préchauffage du graphe ou de la compilation |
| La vitesse de décodage est faible même à concurrence 1 | Chemin d’exécution du modèle au runtime, prise en charge des kernels, précision, utilisation du GPU, surcoût de communication |
| Les tokens/s agrégés plafonnent à mesure que la concurrence augmente | Capacité du cache KV, traitement par lots de l’ordonnanceur, bande passante mémoire, topologie parallèle |
| La latence p95 augmente fortement tandis que la sortie agrégée s’améliore | Taille de lot, politique de mise en file d’attente, mix de longueurs de requêtes, objectif de service |
| Les prompts longs évincent des requêtes actives utiles | Résidence du cache KV, allocation de cache, distribution du contexte, trafic mémoire hôte |
V4.1 Flash possède des caractéristiques architecturales destinées à atténuer certaines de ces pressions. Le rapport sur le modèle décrit CSA2 avec réutilisation de cache inter-couches et mise en cache KV globale FP4, pour une empreinte KV globale rapportée de 890 octets par token, soit environ un quart de l’empreinte correspondante de V4-Flash. SWA Bounded Replay répond à un autre compromis de stockage : au lieu de conserver tout l’état d’attention à fenêtre glissante, un déploiement peut reconstruire l’état manquant en rejouant la fenêtre récente. DeepSeek rapporte un cache KV persistant proche d’un huitième de l’empreinte de V4-Flash pour cette conception, avec une petite quantité de recalcul de prefill supplémentaire. Ce sont des résultats d’architecture et de déploiement, non une promesse de débit multiplié par huit. (Rapport technique DeepSeek, septembre 2026)
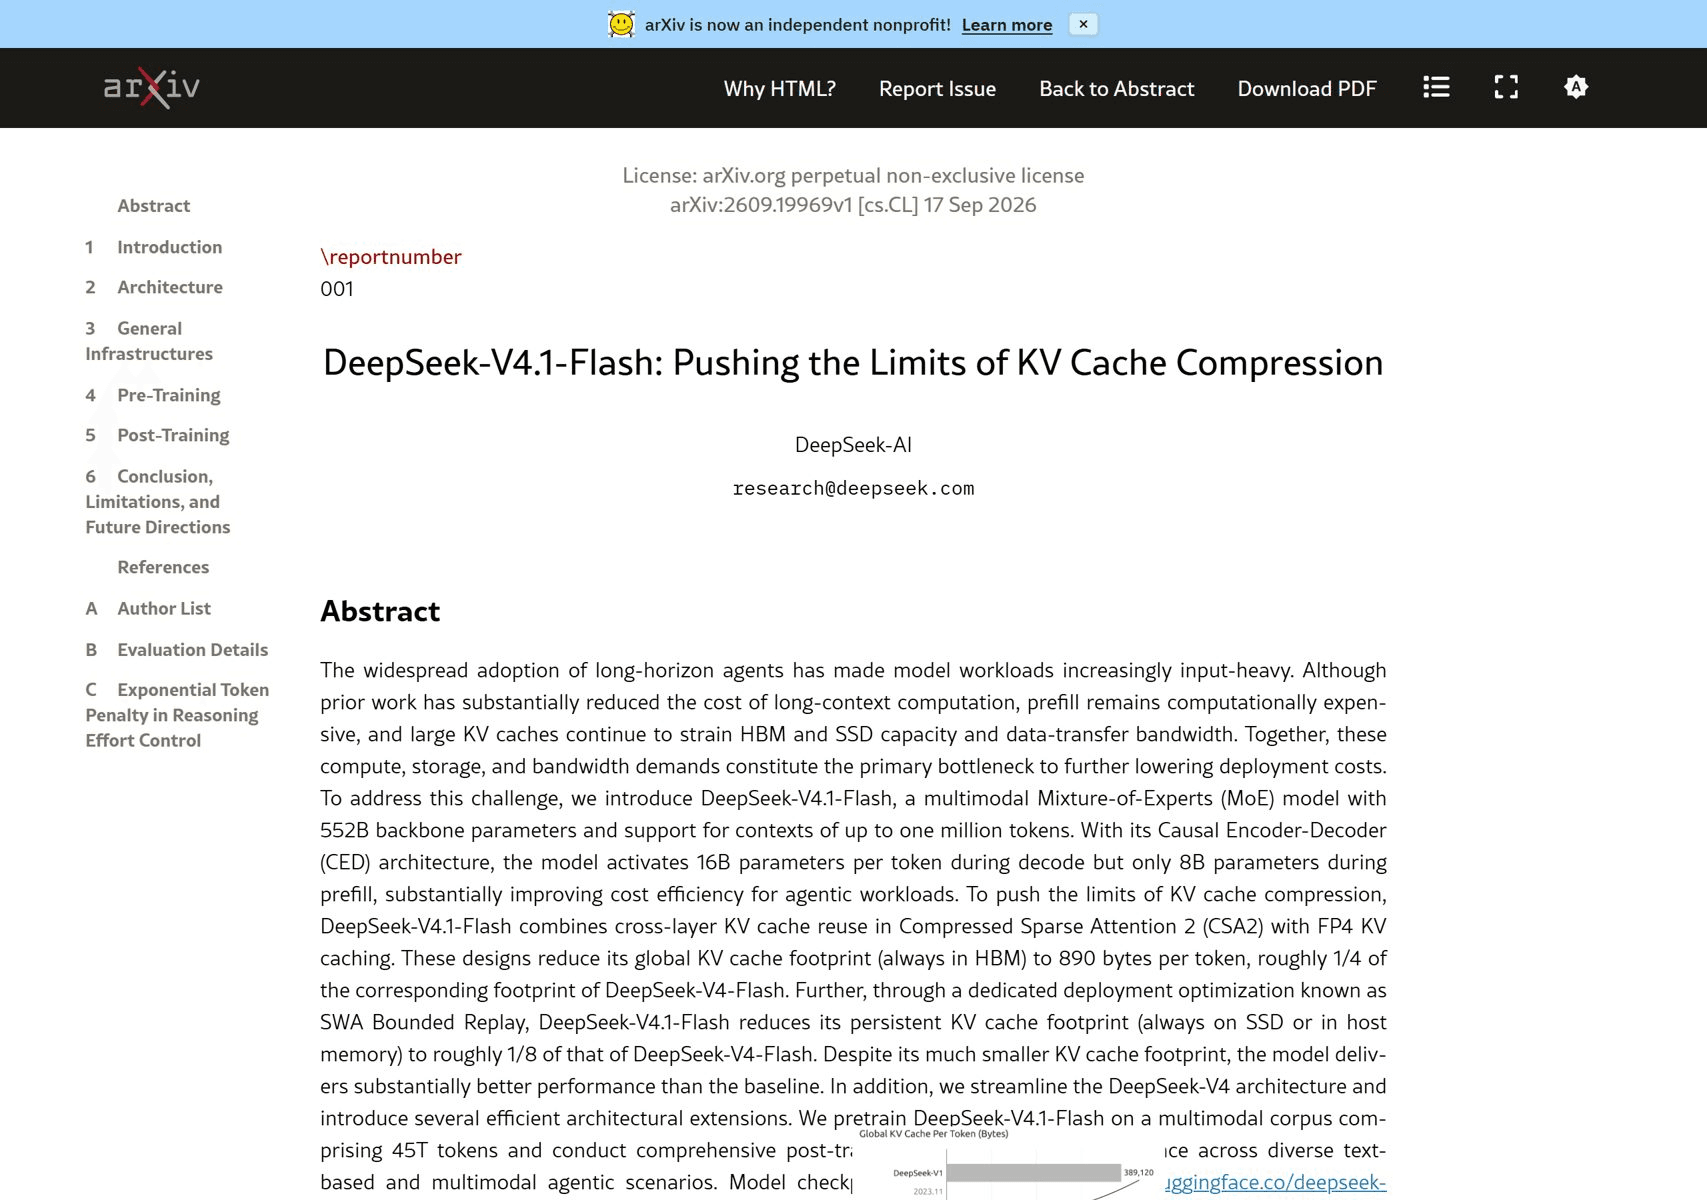
La figure source décrit la capacité de cache, et non un multiplicateur de débit de bout en bout pour chaque déploiement.
Lorsque le diagnostic n’est pas clair, profilez une exécution représentative et inspectez le temps de file d’attente, l’utilisation du GPU, l’utilisation mémoire et le temps par étape. Modifiez une variable, relancez la même charge de travail et vérifiez l’exactitude de la sortie ou la qualité des tâches. Cela évite qu’une accélération apparente masque une régression du service ou des réponses.
Régler vLLM ou SGLang par rapport à la même cible
Choisissez un runtime dont le chemin de modèle actuel prend en charge le checkpoint et le matériel que vous prévoyez de déployer. Vérifiez la version exacte, les kernels, le comportement des graphes et la disposition parallèle. Le fait qu’un modèle soit listé comme pris en charge ne signifie pas que chaque quantification ou topologie est également optimisée.
vLLM : valider le chemin de modèle propre à la version
Le rapport d’octobre de l’équipe vLLM décrit une progression sur son benchmark AgentX : environ 1,9× d’amélioration de son résultat à faible latence et environ 5,3× de débit sous une contrainte de 150 TPS par rapport à sa base de référence du premier jour. Le travail incluait le SWA bounded replay avec graphes CUDA et l’intégration de kernels spécifiques au modèle. Considérez ces valeurs comme la preuve que la pile a évolué sensiblement au fil du temps sous ce benchmark, et non comme des multiplicateurs à appliquer à un autre cluster. ( Rapport d’ingénierie vLLM, octobre 2026)
Pour votre exécution, établissez d’abord une version prise en charge et une configuration éprouvée. Mesurez ensuite individuellement la capture ou le replay de graphes, le traitement par lots et le parallélisme. Conservez la contrainte de latence utilisée pour sélectionner un point à débit plus élevé. Si la capture de graphes modifie le démarrage ou les besoins mémoire, incluez ces coûts dans la décision de déploiement.
SGLang : faire correspondre son profil de concurrence
Le rapport de l’équipe SGLang donne un exemple particulièrement clair de l’importance du contexte de test. Sur 8 GPU H200, son exécution optimisée sans décodage spéculatif est passée d’environ 76 à 168 tokens/s par utilisateur à une concurrence de 1, et d’environ 96 à 221 tokens de sortie/s par GPU à une concurrence de 64. Elle utilisait des entrées fixes de 8 192 tokens et des sorties de 1 024 tokens. Ses résultats distincts sur 4×GB300 utilisaient des longueurs de prompt, des paramètres parallèles et un décodage spéculatif DSpark différents. Le rapport soutient donc l’évaluation des optimisations de SGLang sur votre trafic, et non un classement direct face aux chiffres AgentX de vLLM. ( Rapport d’optimisation LMSYS/SGLang, septembre 2026)
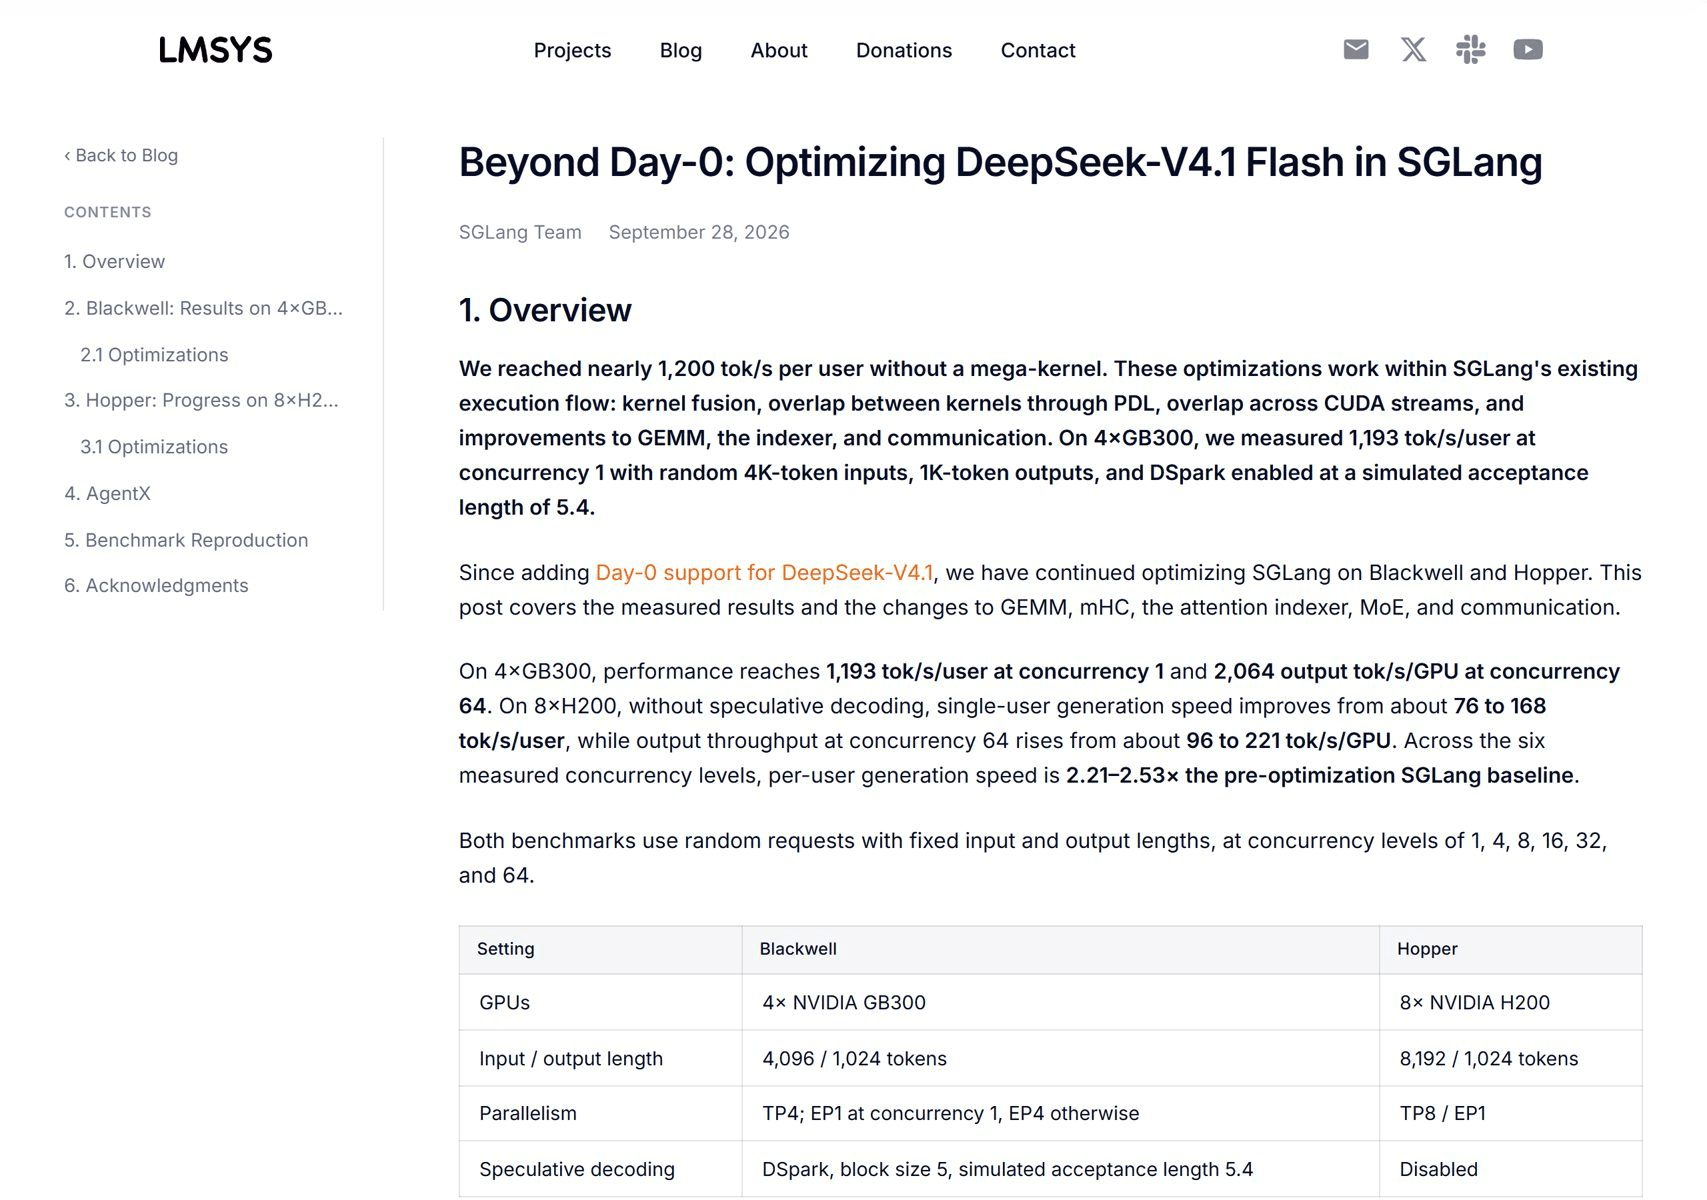
Les rapports sources utilisent des charges de travail et du matériel différents ; leurs chiffres ne doivent pas être lus comme un graphique comparatif direct.
Commencez par un seul runtime et optimisez son chemin pris en charge. Ne construisez une comparaison avec un second runtime que si vous pouvez maintenir constants le checkpoint, l’allocation GPU, les distributions de prompts et de sorties, la concurrence, le préchauffage et l’objectif de service. Cette comparaison coûte du temps d’ingénierie ; confirmez donc d’abord que la pile actuelle est réellement le facteur limitant.
Optimiser la concurrence et le contexte long sans enfreindre le SLO
Augmentez la concurrence par paliers et capturez, à chaque palier, la sortie agrégée, la vitesse de décodage par requête, le TTFT, la latence p95, l’utilisation mémoire et les échecs. Ne conservez le point au débit le plus élevé que si sa latence et ses taux d’erreur satisfont encore votre objectif de service. Si les requêtes s’accumulent en file d’attente avant la génération, un lot plus grand peut améliorer l’utilisation du matériel tout en donnant l’impression que le produit est plus lent.
Pour le trafic en contexte long, mesurez la distribution des contextes actifs et le taux de succès du cache. Une fenêtre de contexte maximale annoncée ne signifie pas que chaque requête peut être servie simultanément à cette longueur. Le cache KV est en concurrence pour la mémoire avec les poids, les activations, les pools de graphes et les tampons du runtime. Laissez une marge pour les longueurs de requêtes variables et mesurez l’éviction ou la préemption sous un trafic réaliste.
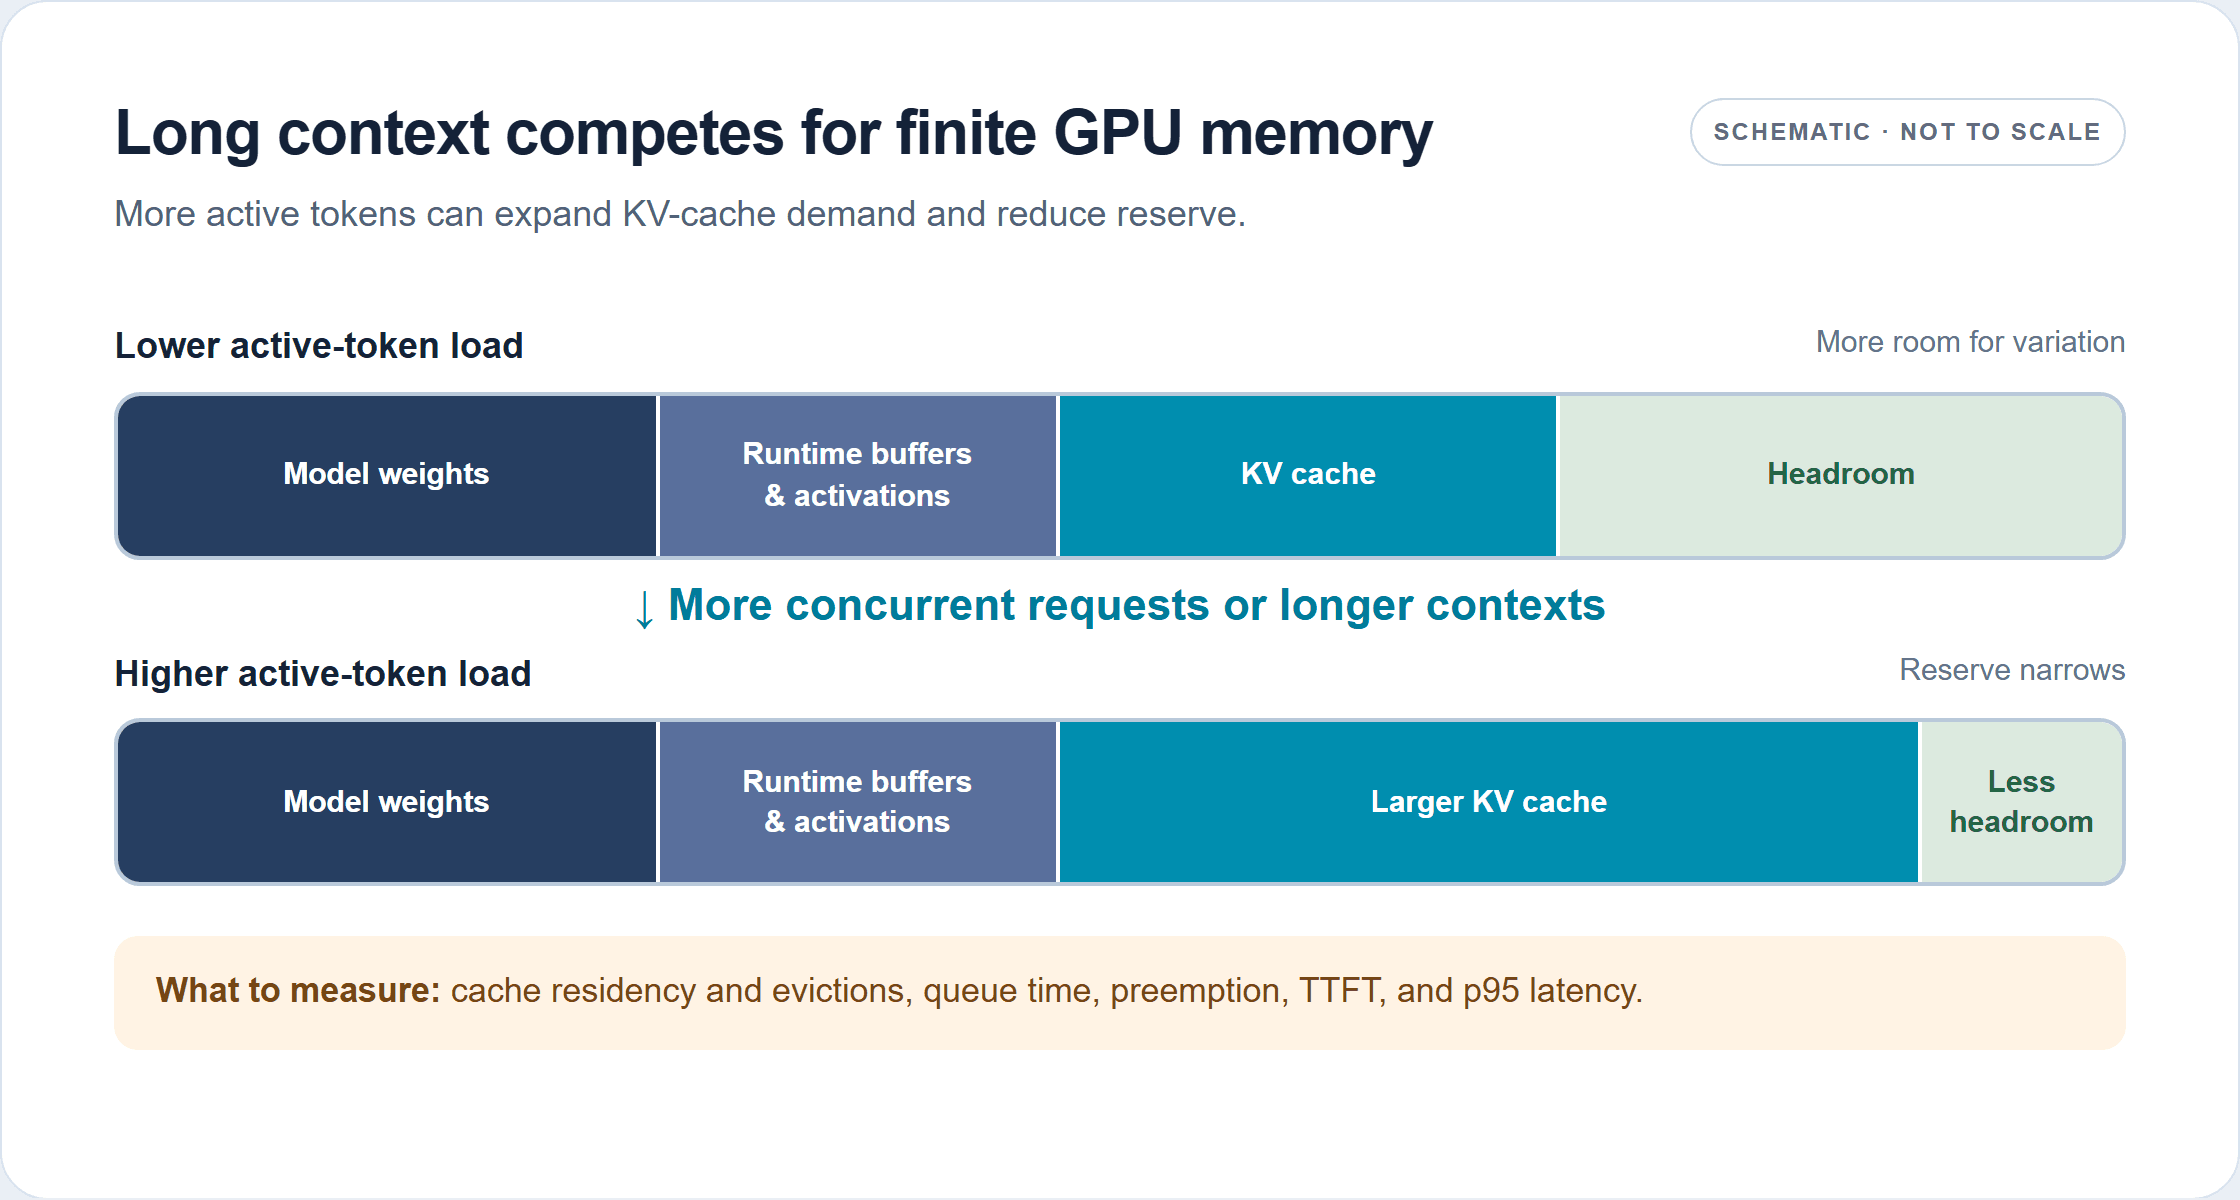
Des contextes plus longs ou davantage de requêtes simultanées peuvent augmenter la demande de cache KV. Les blocs mémoire sont schématiques et non à l’échelle.
Traitez la quantification, la précision du cache KV, le parallélisme tensor, le parallélisme expert et la désagrégation prefill/décodage comme des expériences distinctes. Ils peuvent modifier l’utilisation mémoire, la communication, la sélection des kernels, la qualité de sortie et la latence. La meilleure disposition dépend du type de GPU et de l’interconnexion ; ajouter davantage de GPU peut augmenter les coûts de communication ou laisser certaines ressources inactives. Vérifiez la qualité exacte des sorties et les modes de défaillance après avoir modifié la précision ou l’exécution du modèle.
La séquence pratique est simple : reproduisez la base de référence, identifiez la métrique qui n’atteint pas sa cible, formulez une hypothèse de goulot d’étranglement, modifiez un réglage, puis répétez. Si le réglage améliore une métrique tout en en dégradant une autre, décidez explicitement si ce compromis convient au produit. Cela fait de l’optimisation une décision contrôlée plutôt qu’un empilement de flags.
Valider le décodage spéculatif et chaque accélération annoncée
Le décodage spéculatif peut réduire le travail séquentiel du modèle cible lorsque les tokens de brouillon sont acceptés efficacement et que le runtime implémente bien la vérification. Son bénéfice dépend du chemin de brouillon, du comportement d’acceptation, de la forme du lot, du matériel et du mix prompt/sortie. Il peut aider le trafic limité par le décodage et avoir peu de valeur lorsque le prefill, la mise en file d’attente ou la communication dominent.
Exécutez un test A/B avec la spéculation activée et désactivée. Gardez fixes le checkpoint du modèle, l’ensemble de prompts, le plafond de tokens, le modèle d’arrivée, la concurrence, le préchauffage et la fenêtre de mesure. Enregistrez, si disponible, les tokens acceptés par étape de vérification, ainsi que le débit agrégé, la vitesse par requête, le TTFT, la latence p95, l’utilisation du GPU, les échecs et la qualité des tâches. Une longueur d’acceptation simulée dans un benchmark publié est une condition de test, et non une valeur à supposer pour vos prompts.
Une accélération annoncée n’est utile que si elle survit à trois vérifications : le même objectif de service, une qualité de réponse acceptable et une comparaison équitable des coûts. Rapportez le contexte complet avec tout chiffre que vous publiez. Évitez de comparer des nombres de GPU, des longueurs de prompt, des longueurs de sortie, des modes de précision, des révisions de modèle ou des métriques différents comme s’il s’agissait d’une expérience contrôlée.
Auto-héberger ou utiliser une API DeepSeek V4.1 Flash gérée ?
L’auto-hébergement a du sens lorsque le trafic est suffisamment stable pour garder les GPU utiles, que l’équipe peut exploiter une infrastructure d’inférence et que le contrôle du matériel ou de l’exécution justifie le travail opérationnel. Incluez le coût complet des accélérateurs, de la marge de capacité, de l’alimentation, du réseau, du stockage, de la maintenance et du temps d’ingénierie. Un résultat élevé en tokens/s de pointe ne suffit pas à établir un coût plus faible par tâche réussie.
Une API gérée est utile lorsqu’une équipe doit valider rapidement la demande produit, éviter d’exploiter une flotte de service ou comparer une base de référence API avec son propre déploiement. Atlas Cloud liste DeepSeek V4.1 Flash sous l’ID de modèle deepseek-ai/deepseek-v4.1-flash avec une API compatible OpenAI. La page du modèle DeepSeek V4.1 Flash affiche actuellement $0.30 par million de tokens d’entrée, $1.20 par million de tokens de sortie et $0.03 par million de tokens lus depuis le cache, sans remise affichée en octobre 2026. Consultez la liste tarifaire actuelle avant d’estimer les dépenses. Un point de terminaison géré ne supprime pas la nécessité de mesurer votre propre latence de requête ou l’économie de votre trafic.
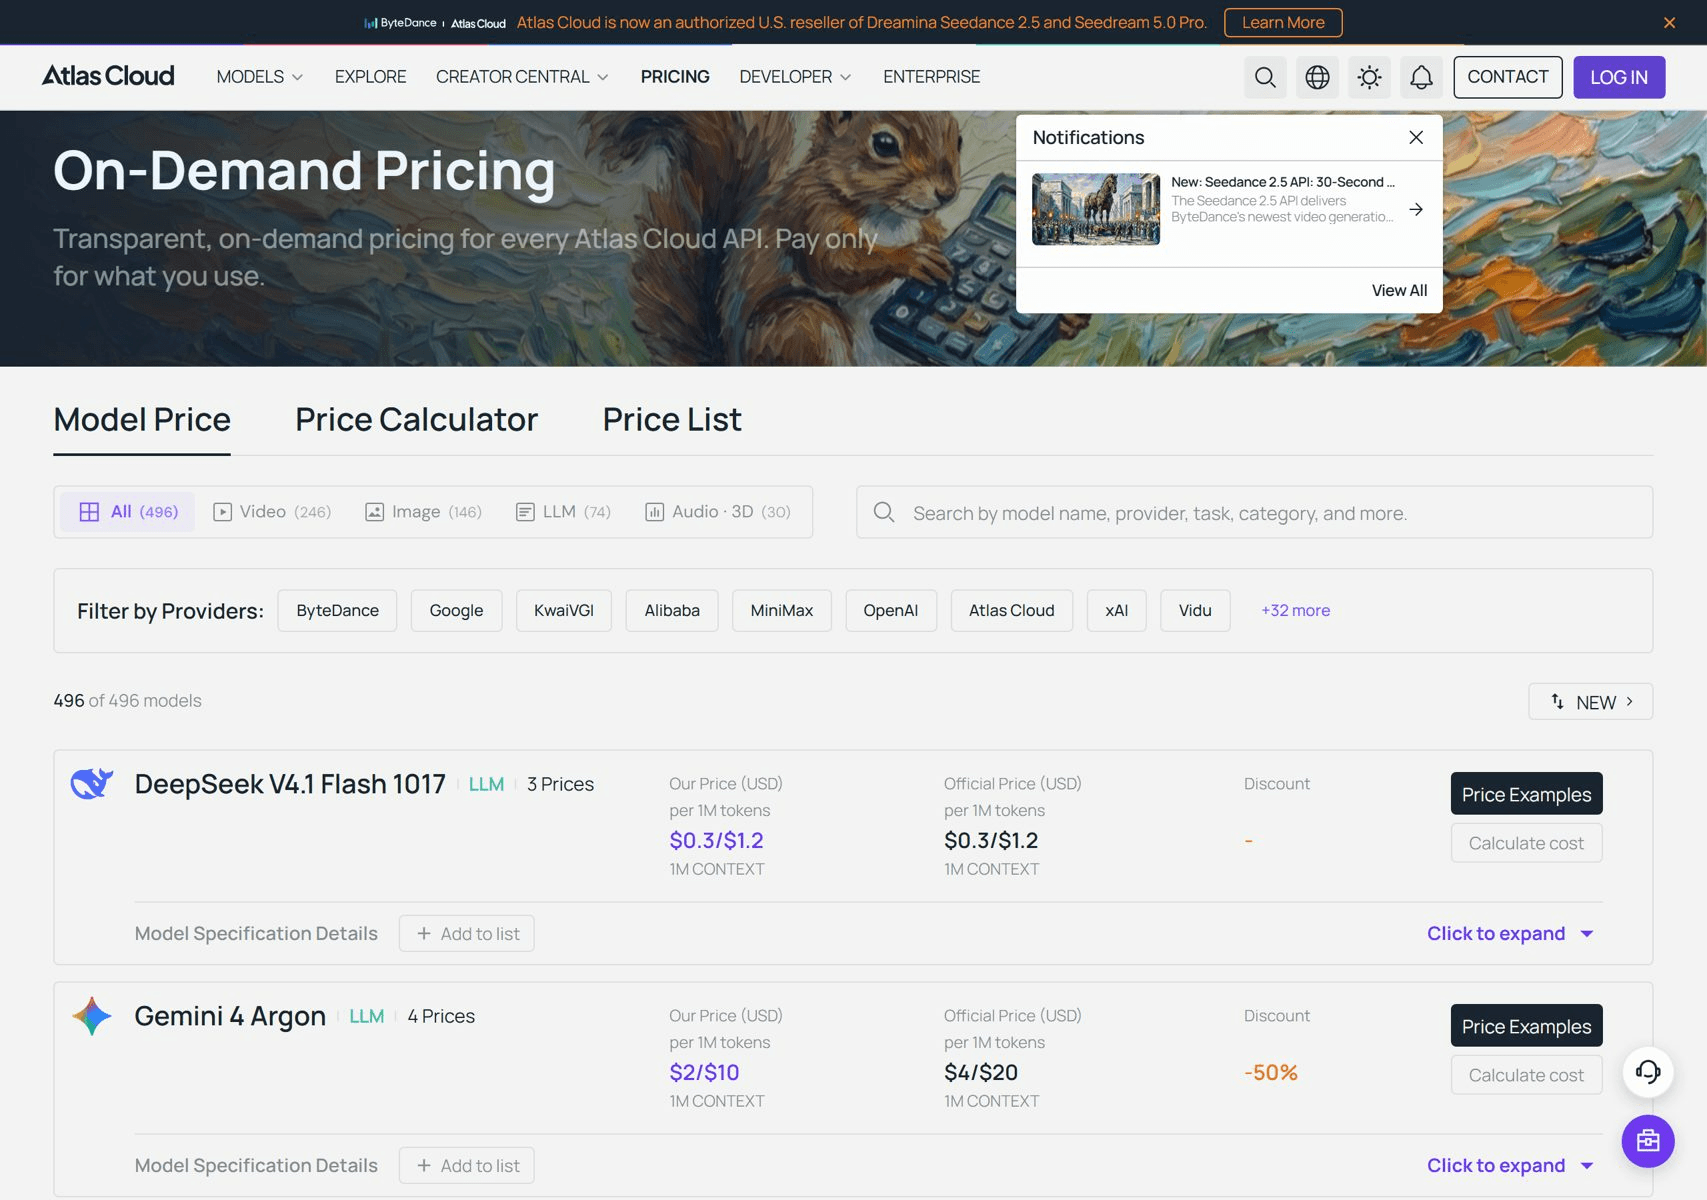
La fiche identifie une option d’API gérée ; ce n’est pas un benchmark de service.
Pour une décision de déploiement équitable, rejouez les mêmes requêtes métier sur le service auto-hébergé et le point de terminaison géré. Comparez le coût par tâche terminée, la distribution de latence, la fiabilité et le temps du personnel nécessaire pour maintenir chaque option. Si votre objectif principal est l’optimisation du débit d’inférence de DeepSeek V4.1 Flash, gardez la même charge de travail et les mêmes critères de réussite pour les deux voies.
Questions fréquentes
Quelle est la différence entre le débit et les tokens par seconde par utilisateur ?
Le débit agrégé compte la sortie sur l’ensemble des requêtes actives. Les tokens/s par utilisateur mesurent le taux de décodage d’une requête. Le traitement par lots peut augmenter le premier tout en réduisant le second ; rapportez donc les deux pour les services interactifs.
L’augmentation de la concurrence améliore-t-elle toujours le débit ?
Non. La sortie agrégée peut augmenter jusqu’à ce que le calcul ou la mémoire sature, puis se stabiliser. La mise en file d’attente et la latence de queue peuvent continuer à se dégrader après ce point. Arrêtez d’augmenter la concurrence lorsque l’objectif de service n’est plus atteint.
Les chiffres de benchmark de vLLM et SGLang peuvent-ils être comparés directement ?
Uniquement si la révision du modèle, le matériel, les longueurs de prompt et de sortie, la concurrence, l’état chaud, la frontière de mesure et la contrainte de latence correspondent. Les rapports publiés utilisent des configurations différentes ; ils démontrent donc des pistes d’optimisation plutôt qu’un vainqueur direct entre runtimes.
Quand faut-il utiliser une API gérée plutôt que l’auto-hébergement ?
Utilisez une API gérée lorsque la rapidité d’intégration et la réduction du travail d’infrastructure importent davantage que la possession de la pile de service. Auto-hébergez lorsque l’utilisation, l’expertise opérationnelle, le contrôle et un dossier de coût total mesuré justifient l’exploitation des GPU.





