Une fenêtre de contexte d'un million de tokens indique la quantité de texte qu'un modèle peut accepter, pas la fiabilité avec laquelle il interprétera chaque clause. Pour la précision de l'analyse de documents longs de DeepSeek V4.1 Flash, les preuves publiques sont utiles mais incomplètes : la fiche modèle de DeepSeek rapporte 45,2 en correspondance exacte sur LongBench-V2 pour le modèle de base V4.1 Flash dans une configuration 1-shot, tandis que l'API est depuis passée à une build 1017 plus récente. Ce benchmark est un signal concernant une configuration d'évaluation donnée, pas un taux de réussite pour votre contrat, rapport annuel ou archive de recherche.
La réponse pratique consiste à utiliser Flash pour la recherche rapide et la synthèse de premier passage, puis à exiger des preuves au niveau des pages et une revue humaine pour les décisions importantes. Aucune source publique citée ici ne fournit d'évaluation reproductible de la build actuelle sur les cinq tâches documentaires ci-dessous. Le plan de test est un protocole prêt à l'emploi, non l'affirmation que ces exécutions ont déjà eu lieu.
Points clés
- La famille de modèles prend en charge jusqu'à 1M de tokens, mais une limite de contexte n'est pas une garantie de précision.
- Le score publié de 45,2 sur LongBench-V2 concerne le modèle de base et une configuration de benchmark 1-shot.
- L'API DeepSeek sert désormais V4.1-Flash-1017 ; ses notes de version ne publient pas de nouveau score sur documents longs.
- Demandez les emplacements des preuves, vérifiez-les par rapport à la source, et mesurez les erreurs sur vos propres documents.
Ce que la fenêtre de 1M de tokens signifie pour l'analyse de documents
La fiche modèle de DeepSeek décrit V4.1 Flash comme prenant en charge des contextes allant jusqu'à un million de tokens. La documentation de l'API identifie actuellement le modèle servi comme DeepSeek-V4.1-Flash-1017 et indique une longueur de contexte de 1M. Ce sont des spécifications de capacité. Elles n'établissent pas la fréquence à laquelle le modèle trouve une note de bas de page, distingue deux versions d'un document, ou admet qu'un fait demandé est absent. (Fiche modèle DeepSeek)
Un token n'est pas une page. Le nombre de pages varie selon les tableaux, les notes de bas de page, la mise en page, la langue et la qualité d'extraction. Un PDF numérisé peut nécessiter de l'OCR ; un tableau peut perdre ses libellés de lignes lors de la conversion en texte ; les en-têtes et éléments de page répétés peuvent consommer du contexte sans aider à répondre à la question. Le prompt et la réponse demandée utilisent également des tokens. Un plafond nominal d'un million de tokens ne signifie donc pas que chaque fichier d'un million de tokens arrivera intact via chaque interface de chat ou client API.
Avant un test, enregistrez l'identifiant exact du modèle, le client et la méthode d'entrée. Vérifiez si le texte extrait complet a été envoyé, si le fournisseur l'a tronqué, et si la requête a atteint la version de modèle attendue. L'API DeepSeek actuelle utilise deepseek-flash pour la dernière build Flash. Si votre passerelle ou SDK utilise un autre alias, enregistrez cet alias et vérifiez son routage. Les équipes mettant en place des appels hébergés reproductibles peuvent partir de la plateforme de modèles d'Atlas Cloud, puis ouvrir sa fiche API DeepSeek V4.1 Flash.
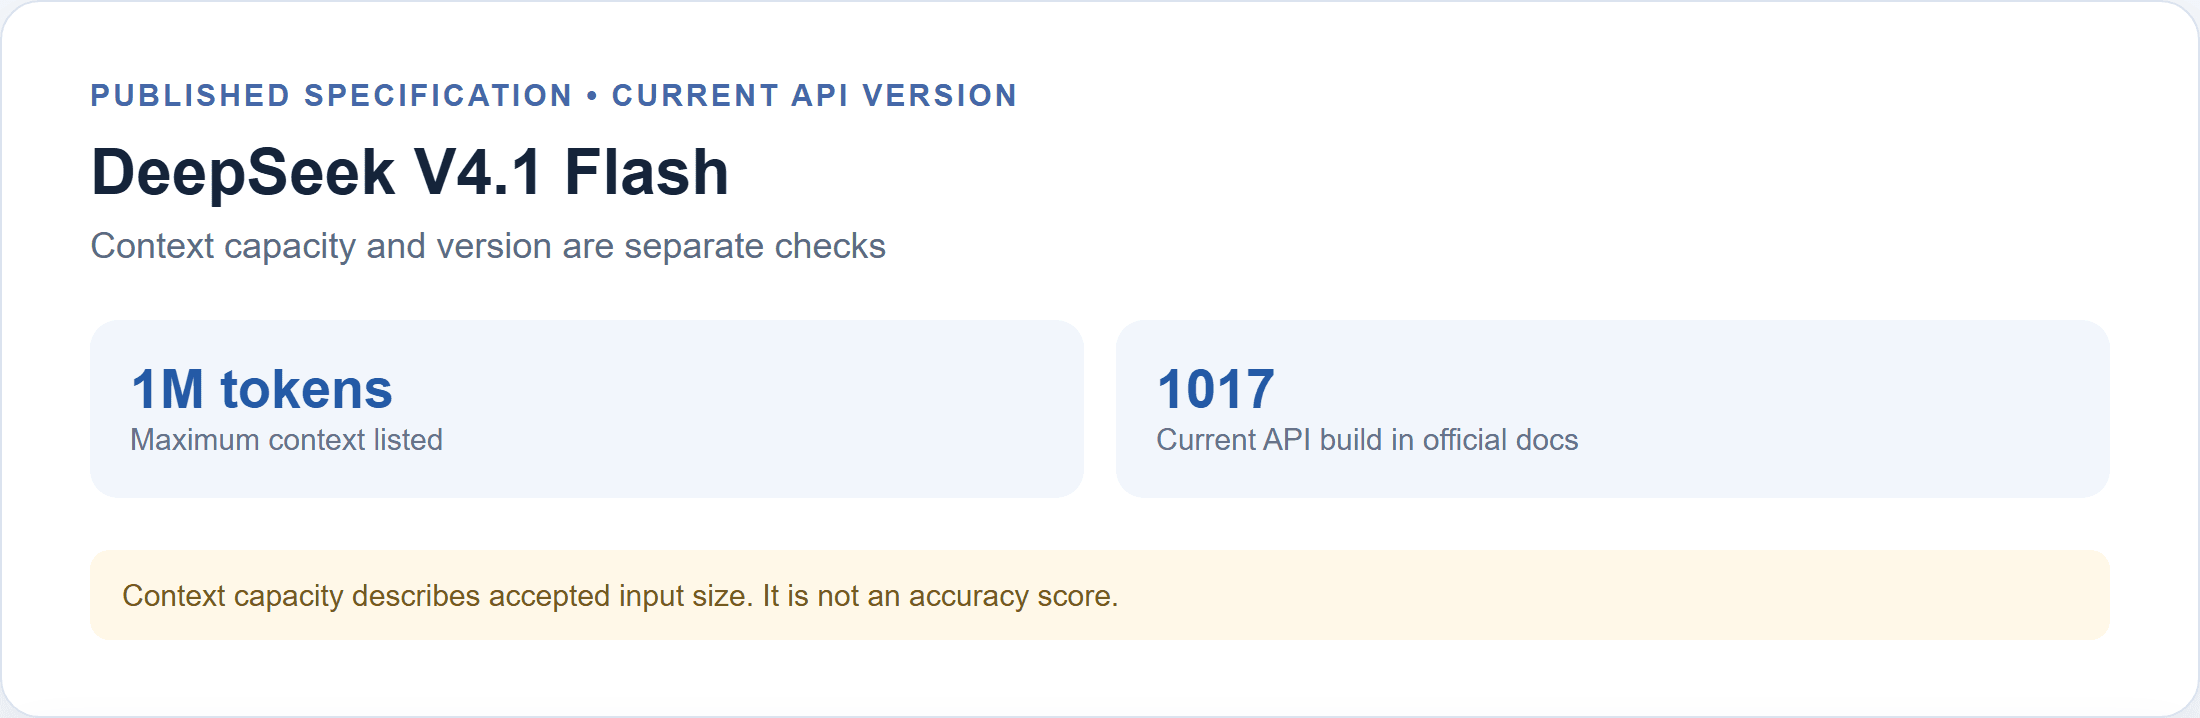
La spécification publiée donne un maximum de contexte de 1M ; la documentation actuelle de l'API identifie la build 1017.
Un téléversement ou une requête réussie montre seulement que le système a accepté une entrée. Pour établir qu'un détail pertinent a influencé la réponse, demandez un emplacement précis, récupérez ce passage, et confirmez que le texte environnant étaye l'affirmation.
Ce que le score LongBench-V2 montre et ne montre pas
La ligne LongBench-V2 de la fiche modèle rapporte des scores de correspondance exacte dans une configuration 1-shot. Son tableau étiquette les résultats comme des évaluations de modèles de base et indique que tous les modèles de base utilisent le même cadre d'évaluation interne. Il précise également que les scores à moins de 0,3 sont considérés comme équivalents. Les valeurs sont :
| Modèle de base dans la fiche modèle | LongBench-V2 (EM) | Shots |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44,7 | 1 |
| DeepSeek-V4-Pro-Base | 51,5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45,2 | 1 |
L'écart de 0,5 point entre V4-Flash-Base et V4.1-Flash-Base est supérieur à la bande d'équivalence de 0,3 indiquée par la fiche, mais il reste une comparaison de benchmark serrée. Le 45,2 n'est pas « 45,2 % de précision sur des PDF longs ». C'est un score de correspondance exacte pour un modèle de base, un ensemble de benchmark, une configuration de prompt et un évaluateur particuliers. Il ne note pas directement un modèle hébergé instruct/API répondant à vos questions avec un prompt différent.
LongBench-V2 contient 503 questions à choix multiples réparties en six catégories, notamment la réponse à des questions sur un document unique et sur plusieurs documents, le dialogue long, les dépôts de code et les données structurées. Ses contextes s'étendent de 8 000 à 2 millions de mots. Les auteurs du benchmark rapportent une précision moyenne de 53,7 % pour les experts sous une limite de 15 minutes, et de 50,1 % pour le meilleur modèle de réponse directe dans leur évaluation rapportée. Son étendue en fait un test de résistance utile, mais un chiffre agrégé ne peut pas diagnostiquer quelle opération documentaire est solide ou faible. (Article LongBench-V2)
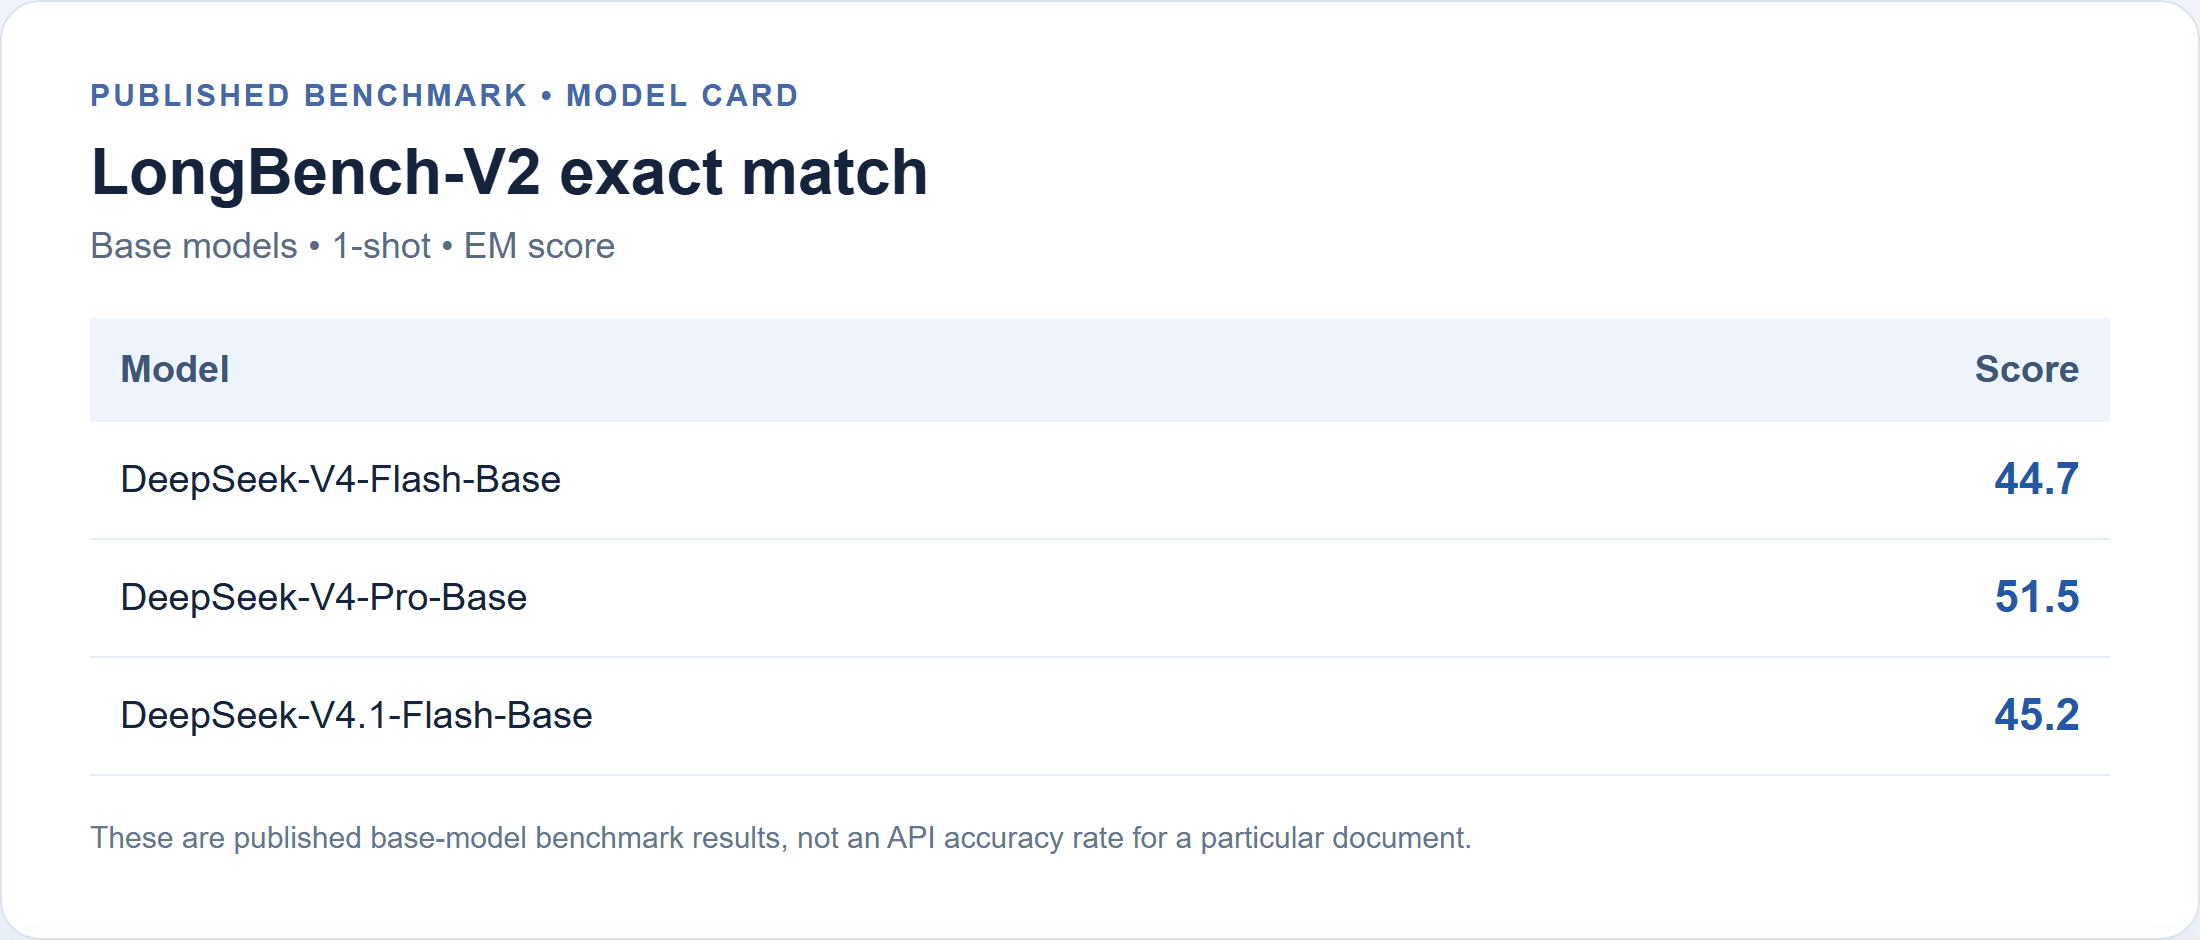
La ligne publiée est un résultat de modèle de base, en 1-shot. Ce n'est pas un taux de réussite API mesuré.
Il existe une mise en garde sur la version. Les notes de version du 17 octobre de DeepSeek indiquent que l'API et l'application web ont été mises à niveau vers V4.1-Flash-1017, et le nom de modèle API reste deepseek-flash. Les notes listent des benchmarks mis à jour pour l'agent et le raisonnement, mais ne rapportent pas de nouveau résultat LongBench-V2. Ainsi, 45,2 reste une référence publiée utile pour le modèle de base V4.1 Flash, tandis que la précision de la build API actuelle sur les questions documentaires longues reste non quantifiée dans ces sources. Ne transférez pas les gains de benchmarks sans rapport à la QA documentaire. (Mise à jour DeepSeek V4.1-Flash-1017)
Comment réaliser un test équitable de précision sur documents longs
Une évaluation utile nécessite une source fixe, un corrigé et des règles de notation. Commencez par un rapport annuel ou un rapport technique public dont la version et la structure de pages peuvent être partagées. Enregistrez le PDF et le texte extrait, notez l'URL de la source et la date de récupération, et indiquez si vous avez utilisé une extraction de texte native ou de l'OCR. Évitez de sélectionner un document parce que vous savez déjà que le modèle le traite bien.
Avant de solliciter le modèle, rédigez vous-même le corrigé à partir de la source. Pour chaque question, notez la réponse attendue et la page ou la section exacte. Cela évite qu'une réponse convaincante devienne le standard de notation. Gardez des questions suffisamment précises pour être notées, tout en préservant l'ambiguïté à laquelle un lecteur serait réellement confronté.
Utilisez le même document, le même ensemble de questions, le même identifiant de modèle, le même prompt, le même réglage de raisonnement et le même format de sortie pour chaque exécution. Si l'API expose des contrôles de température ou de raisonnement, enregistrez-les. Exécutez l'ensemble plusieurs fois si vous souhaitez estimer la variabilité ; une seule exécution est un échantillon, pas un taux stable. Ne corrigez pas silencieusement la sortie avant de la noter.
Un ensemble compact peut couvrir cinq occasions d'échec différentes :
| Tâche | Forme d'exemple de question | Ce qu'il faut vérifier |
|---|---|---|
| Recherche ponctuelle | « Quelle date le rapport indique-t-il pour la politique révisée ? » | Valeur exacte et page citée |
| Lien entre sections | « Quel est le lien entre le risque de la Section 2 et le contrôle de la Section 7 ? » | Les deux passages et si le lien est énoncé ou inféré |
| Gestion des exceptions | « Qui est exclu de la couverture indiquée ? » | Note de bas de page, périmètre et qualificatifs |
| Conflit de versions | « Quelle valeur s'applique après révision, et qu'a-t-elle remplacé ? » | Dates, libellés de version et les deux emplacements |
| Information manquante | « Quelle durée de conservation le rapport spécifie-t-il pour les copies fournisseurs ? » | L'admission si le document ne dit rien |
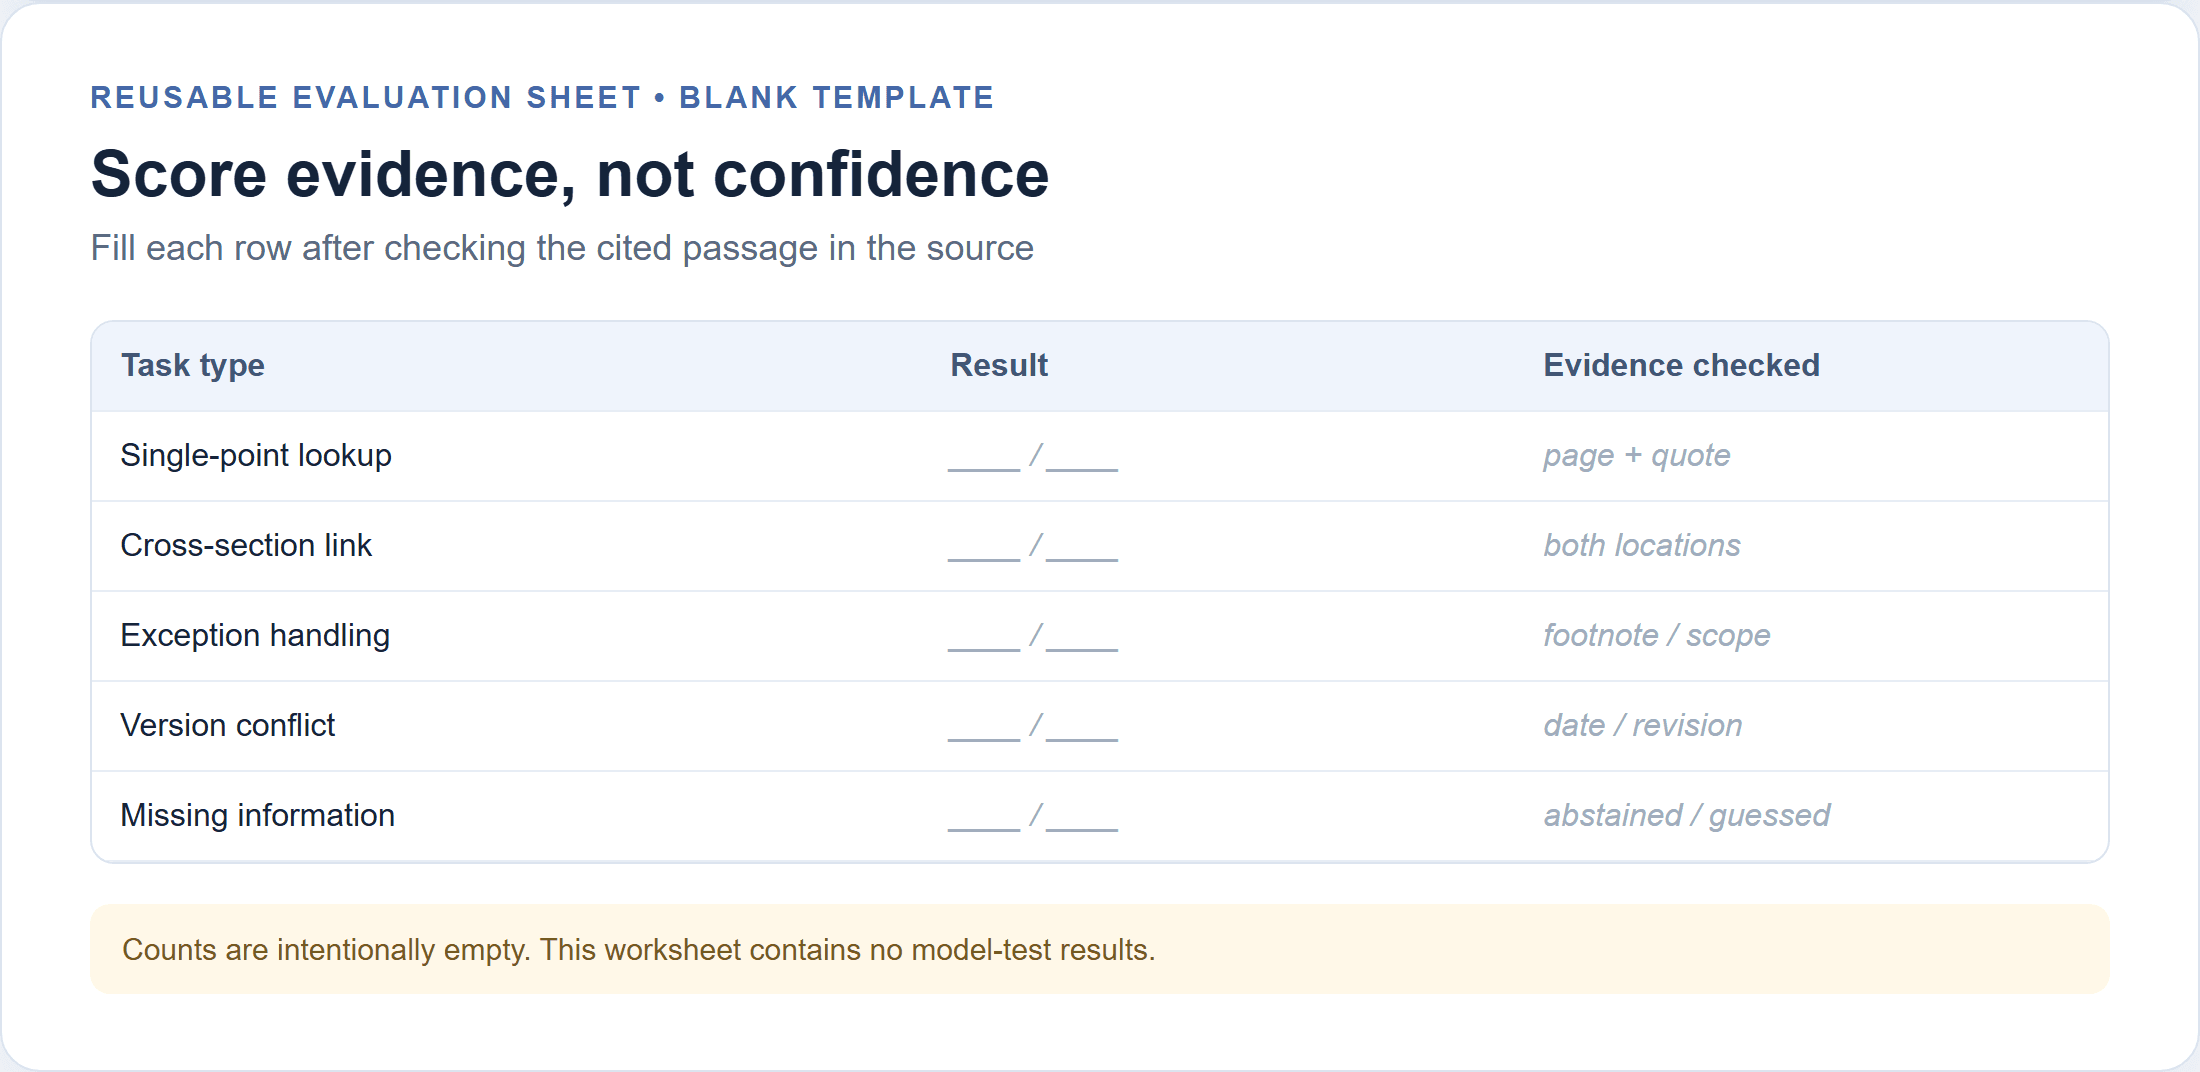
Il s'agit d'une grille de notation vierge, pas d'un tableau de résultats. Remplissez-la uniquement après avoir vérifié chaque réponse par rapport au document source.
Notez chaque réponse comme correcte, partielle, erronée, non étayée, ou correctement abstentionnelle. Comptez les affirmations non étayées séparément des réponses erronées, car une réponse peut donner la bonne réponse principale et inventer un détail. Vérifiez si chaque citation pointe vers le passage qui étaye l'affirmation. Rapportez le nombre de questions et les décomptes par catégorie ensemble. Un pourcentage global masque si le modèle a manqué des notes de bas de page ou n'a eu des difficultés que lorsque l'information était répartie entre les sections.
Conservez le fichier source exact, l'extraction, les prompts, les réponses brutes et la feuille de notation. Ne publiez que le matériel que vous êtes autorisé à partager, et masquez les noms confidentiels ou les détails de comptes. Un réviseur doit pouvoir retracer chaque réponse notée depuis la sortie du modèle jusqu'à une page de la source enregistrée.
Où les réponses sur documents longs ont tendance à échouer
Sans exécution sur la build actuelle avec un document défini, il serait erroné d'affirmer que V4.1 Flash a présenté un taux d'erreur ou un schéma d'échec particulier. Les catégories ci-dessous sont des points à examiner, pas des constats mesurés sur ce modèle.
Commencez par la perte de périmètre. Un paragraphe de corps peut énoncer une règle tandis qu'une note de bas de page la limite à une région, une plage de dates ou une catégorie de clients. Demandez explicitement l'exception et examinez si le passage cité l'inclut. Une citation du seul paragraphe principal peut être insuffisante.
Vérifiez ensuite la confusion de versions. Les rapports peuvent répéter des valeurs similaires dans une ébauche et une section révisée. Demandez au modèle de nommer la date ou la version associée à chaque valeur au lieu de demander simplement « le chiffre actuel ». S'il en choisit une silencieusement, notez la réponse comme incomplète même s'il choisit correctement par hasard.
Les questions transversales invitent à l'inférence. Un modèle peut combiner deux faits exacts en une explication causale que le document n'énonce jamais. Exigez qu'il étiquette séparément les énoncés directs et les inférences. Comparez ensuite l'inférence aux preuves et décidez si elle est raisonnable pour la tâche.
Enfin, testez l'abstention. Incluez une question dont la réponse est absente. Une supposition confiante est un échec même si elle paraît plausible. Pour les contrats, la conformité, le matériel clinique ou l'analyse financière à conséquences, demandez à une personne qualifiée de vérifier le texte original avant d'utiliser une conclusion.
Un flux de vérification pour des réponses plus sûres
Ce prompt rend les réponses plus faciles à auditer. Il ne peut pas garantir l'exactitude ni remplacer la revue de la source. Utilisez-le avec une extraction qui préserve les libellés de pages, puis posez des questions ciblées plutôt que de demander un résumé général d'un fichier volumineux.
plaintext1Répondez en utilisant uniquement le document fourni. 2Pour chaque affirmation factuelle, indiquez le numéro de page et une courte citation à l'appui. 3Séparez les énoncés directs des inférences. 4Si le document ne contient pas suffisamment de preuves, dites « Non indiqué dans le document ». 5Si les sources sont contradictoires, listez chaque version et son emplacement au lieu de choisir silencieusement. 6Retournez un tableau avec : question, réponse, emplacement des preuves, confiance et ambiguïté non résolue.
Pour un rapport long, divisez le travail par tâche, et non automatiquement par un nombre de pages arbitraire. Demandez d'abord une carte des sources : titres de sections, dates, termes définis et tableaux pertinents. Interrogez ensuite un sujet précis et demandez ses passages à l'appui. Pour une conclusion transversale, fournissez ou récupérez les deux passages dans le même tour et demandez au modèle d'expliquer le lien tout en signalant toute inférence.
Utilisez une boucle de vérification humaine :
- Vérifiez la page et la citation citées dans le fichier original.
- Confirmez que la citation inclut les exceptions voisines et les en-têtes de tableau.
- Marquez chaque affirmation comme directe, inférée, non étayée ou contredite.
- Corrigez le prompt ou divisez la tâche si l'extraction a omis une structure importante.
- Enregistrez la requête et la réponse brutes afin qu'un réviseur puisse reproduire la décision.
Lorsque vous utilisez un point de terminaison hébergé, incluez la consommation de tokens dans le journal d'exécution. La page de tarification des modèles d'Atlas Cloud liste actuellement DeepSeek V4.1 Flash à 0,30 $ par 1M de tokens d'entrée, 1,20 $ par 1M de tokens de sortie, et 0,03 $ par 1M de tokens de lecture de cache, sans remise indiquée. Vérifiez la fiche actuelle avant de budgétiser. Cette référence de prix concerne Atlas Cloud, pas un prix universel de l'API DeepSeek.
À ces tarifs indiqués, 100 000 tokens d'entrée non mis en cache et 3 000 tokens de sortie coûtent environ 0,033 $ : 0,030 $ pour l'entrée plus 0,0036 $ pour la sortie.
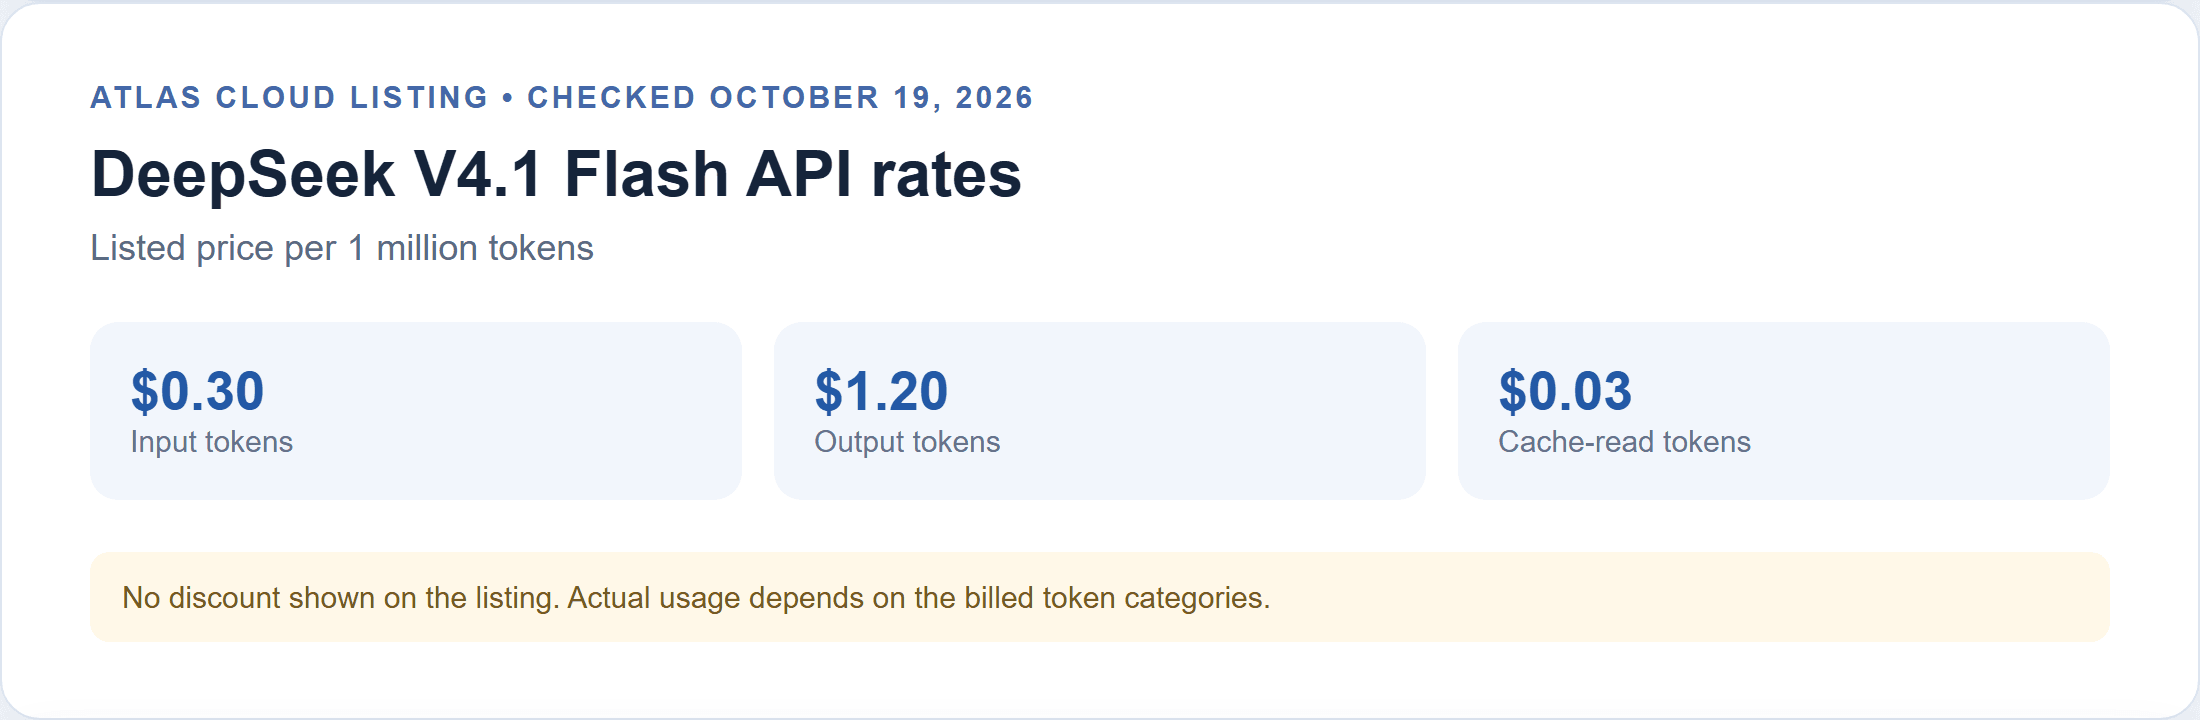
Tarification Atlas Cloud vérifiée le 19 octobre 2026 ; la fiche n'indique aucune remise. Une entrée de 1M de tokens et une réponse de 20 000 tokens coûteraient environ 0,324 $ aux mêmes tarifs, avant traitement du cache ou autres éléments facturables. Ce sont des exemples arithmétiques, pas des factures mesurées de tests documentaires. L'entrée réelle comprend le prompt et le texte extrait ; les appels répétés ajoutent de la consommation. Utilisez les décomptes de tokens renvoyés par le fournisseur plutôt que d'estimer à partir du nombre de pages.
Quand utiliser DeepSeek V4.1 Flash pour les documents longs
Flash est un premier passage raisonnable lorsque vous devez localiser des définitions, rassembler des dates, créer une carte des sections ou rédiger un résumé qu'une personne vérifiera. Ces tâches présentent des pistes de preuves visibles et sont faciles à réexécuter avec des questions plus précises. Pour un travail récurrent, conservez des questions à réponse connue et réexécutez-les lorsque la version du modèle, le pipeline d'extraction ou le prompt changent.
Ajoutez des contrôles lorsqu'une question combine des sections éloignées, dépend d'une note de bas de page ou compare des révisions. Utilisez les citations comme aides à la navigation, pas comme preuves en elles-mêmes. Si une réponse doit affecter une obligation contractuelle, une position de conformité, une communication financière ou une autre décision à fort impact, faites vérifier chaque affirmation importante dans la source par un réviseur qualifié.
La question utile est de savoir si ce modèle, sur votre version du document et votre flux de travail exact, renvoie des réponses avec des preuves qui résistent à la vérification. C'est le test qui peut établir la précision de l'analyse de documents longs de DeepSeek V4.1 Flash pour votre propre cas d'usage.
Questions fréquentes
Une fenêtre de contexte de 1M de tokens signifie-t-elle qu'un modèle peut analyser avec précision un document de 1M de tokens ?
Non. Cela décrit la capacité de contexte prise en charge. La requête réelle comprend aussi les instructions et le budget de sortie, tandis que l'extraction, les limites d'interface et la difficulté des questions affectent la disponibilité et l'interprétation correcte des preuves utiles.
LongBench-V2 est-il équivalent à la précision de réponse aux questions documentaires ?
Non. Il comprend plusieurs catégories de tâches à contexte long et rapporte les performances dans une configuration spécifique. C'est un signal de comparaison, pas une garantie pour un PDF, une build API, un prompt ou un domaine particuliers.
Dois-je utiliser un seul prompt ou diviser un document long en sections ?
Utilisez une carte des sources et des questions ciblées lorsque la structure importe. Gardez les passages qui doivent être comparés disponibles ensemble pour l'étape de synthèse, et préservez les libellés de pages pour pouvoir vérifier la réponse.
Comment vérifier les citations d'un résumé généré par IA ?
Ouvrez chaque page citée dans le fichier original, vérifiez la citation et le texte environnant, et confirmez que le passage étaye l'affirmation spécifique. Vérifiez les en-têtes de tableaux et les notes de bas de page ainsi que la phrase citée.
Comment les tokens d'entrée et de sortie affectent-ils le coût ?
Les tokens d'entrée couvrent le document, les instructions et la question. Les tokens de sortie couvrent la réponse. Des prompts plus longs, des appels multiples et des passages répétés augmentent la consommation ; utilisez les décomptes de tokens facturés et le tableau tarifaire actuel du fournisseur pour les estimations.





