

Un développeur voit « 1M tokens » et se prépare à envoyer un dépôt entier, son historique de tickets et un long rapport de conception dans une seule requête. Le détail clé dans la fenêtre de contexte 1M de gemini 4 Argon est que 1 048 576 tokens sont partagés entre l'entrée, la réflexion et la sortie. Il ne s'agit pas d'un million de tokens d'entrée plus un autre million pour la réponse. Google indique un plafond de sortie synchrone par défaut de 65 536 tokens, tandis que le décodage long peut étendre la génération jusqu'à la capacité partagée restante. La spécification du modèle de Google fournit les limites ; ce guide les transforme en budget et en décision concernant le contexte long, la récupération et le découpage.
Points clés
- Le contexte de 1 048 576 tokens est un budget combiné d'entrée, de réflexion et de sortie.
- La sortie synchrone par défaut est plafonnée à 65 536 tokens ; le décodage long n'ajoute pas de contexte supplémentaire.
- Utilisez le contexte long lorsque les relations entre un ensemble de sources connu importent ; utilisez la récupération ou le découpage lorsqu'elles n'importent pas.
Que signifie la fenêtre de contexte 1M de Gemini 4 Argon ?
Le budget de 1 048 576 tokens est partagé
Une fenêtre de contexte est la limite de tokens disponible pour une requête. Pour Argon, Google documente un total unifié de 1 048 576. Le prompt, le matériel source joint, les tokens de réflexion et la réponse générée sont puisés dans cette allocation. Cela décrit une capacité, et non une promesse que chaque détail sera également facile à récupérer ou à raisonner.
Si une requête contient 900 000 tokens source, au maximum 148 576 restent pour la réflexion et la sortie, avant les restrictions propres à l'interface. Une application qui suppose pouvoir ensuite demander une réponse de 200 000 tokens a surengagé le même budget.
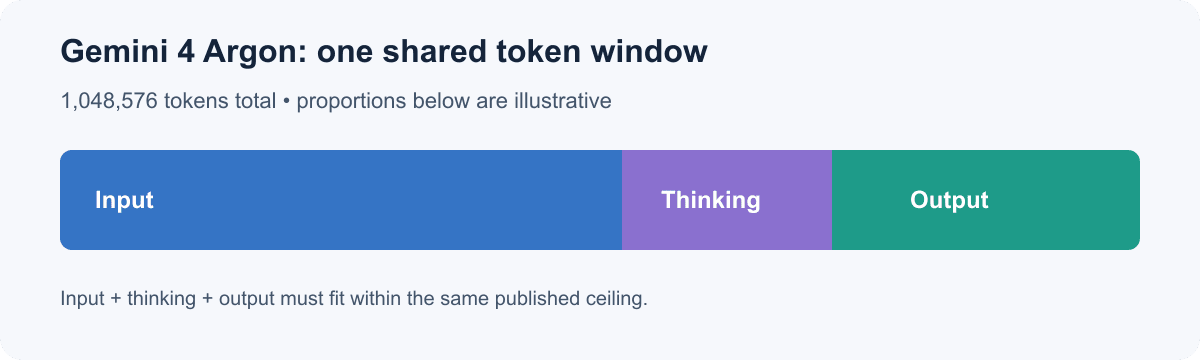
La fenêtre publiée est un plafond partagé unique. Les tailles de segment sont conceptuelles, et non une allocation fixe.
L'entrée, la réflexion et la sortie puisent dans une même fenêtre
Une équation de planification utile est :
input tokens + thinking tokens + output tokens <= 1,048,576
Il s'agit d'une vérification budgétaire, et non d'une affirmation selon laquelle les développeurs peuvent définir un nombre exact de tokens de réflexion pour chaque appel. Google répertorie des paramètres de réflexion faible, moyen et élevé ; la consommation interne peut varier selon la tâche et les paramètres. Réservez de l'espace pour le raisonnement plutôt que de traiter le reste théorique comme une capacité de réponse garantie.
Argon accepte les entrées texte, image, vidéo, audio et PDF, avec une sortie texte. La comptabilisation des médias n'est pas équivalente à celle du texte brut, donc un nombre de fichiers ou de pages ne peut pas prédire de manière fiable le total de tokens. Inspectez les métadonnées d'utilisation d'une requête représentative.
Fenêtre de contexte vs limite de sortie : la différence cruciale
Le plafond de sortie par défaut
La page du modèle indique une sortie maximale de 65 536 tokens pour la génération synchrone par défaut, soit environ un seizième de la fenêtre totale. Une requête peut respecter la limite de contexte globale et dépasser le plafond de sortie actif.
Pour de nombreuses applications, cette valeur par défaut est amplement suffisante. Une revue de dépôt ou une synthèse de documents nécessite généralement une réponse ciblée, pas une réponse aussi longue que l'ensemble source. Une sortie bornée est plus facile à examiner, à stocker et à transmettre à une autre étape.
Ce que change le décodage long
Le décodage long prend en charge une génération beaucoup plus longue, jusqu'à 1 048 576 tokens selon la spécification du modèle. Il n'élargit pas la fenêtre totale. Si le prompt occupe déjà la majeure partie de celle-ci, il reste moins de capacité pour la réflexion et la sortie. Le chemin d'API, le SDK, les paramètres de requête et la gestion des réponses comptent également, alors vérifiez les conseils d'intégration actuels avant de vous fier à une réponse longue en production.
N'utilisez le décodage long que lorsque le livrable a réellement besoin d'un matériel généré volumineux, comme une grande transformation structurée renvoyée en une seule opération. Si la réponse peut être divisée en sections validées, la génération par étapes peut faciliter la détection et la récupération des résultats incomplets.
Comment budgéter les tokens d'entrée, de réflexion et de sortie
Commencez par le livrable, puis estimez les tokens source en utilisant la méthode de comptage du modèle sélectionné lorsqu'elle est disponible. Comptez également les instructions, les résultats d'outils, le texte de schéma et l'historique de conversation. Réservez une marge pour la réflexion et les erreurs d'estimation au lieu de dépenser le reste théorique.
Les chiffres ci-dessous sont des exemples arithmétiques, et non une consommation de raisonnement fixe. Le « reste de planification » est le total après l'entrée supposée et l'allocation de réflexion réservée. Les limites de service réelles s'appliquent toujours.
| Entrée supposée | Réserve de réflexion | Reste de planification pour la sortie | Exemple |
|---|---|---|---|
| 120 000 | 20 000 | 908 576 | Plusieurs manuels, synthèse concise |
| 500 000 | 40 000 | 508 576 | Revue de base de code avec références aux fichiers |
| 900 000 | 50 000 | 98 576 | Comparaison d'archives avec une réponse bornée |
Arithmétique illustrative à partir d'un plafond de 1 048 576 tokens ; les réserves sont des hypothèses de planification.
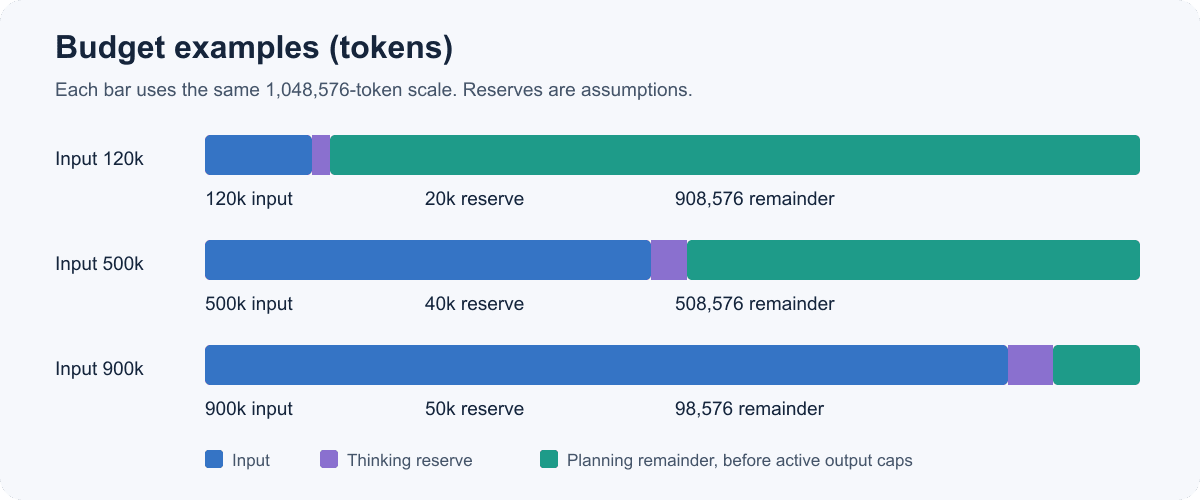
Utilisez cette liste de vérification pour la planification des requêtes :
- Entrée : tokens source et de prompt estimés.
- Réflexion : réservez une capacité en fonction de la complexité de la tâche et des paramètres pris en charge.
- Sortie : choisissez un plafond adapté au livrable.
- Vérification : additionnez les trois montants et laissez de la marge pour les erreurs d'estimation.
- Chemin : confirmez que le point de terminaison ou le SDK sélectionné prend en charge la longueur de sortie et le comportement de continuation.
Pour une revue de base de code de 500 000 tokens, une équipe pourrait réserver 40 000 tokens pour la réflexion et viser une réponse de 25 000 tokens. Ce plan utilise 565 000 tokens sur le papier et laisse une marge pour des estimations imparfaites ou des instructions supplémentaires. L'équipe doit tout de même vérifier l'utilisation réelle et les limites de génération configurées. La réserve est un outil de planification, et non une prédiction du raisonnement privé.
Avant une exécution par lots, échantillonnez plus d'un type de requête. Une courte page de documentation, un module riche en code et un PDF avec des tableaux peuvent produire des nombres de tokens différents même si leurs tailles de fichier semblent similaires. Comptez des entrées représentatives, puis comparez les estimations avec l'utilisation renvoyée par l'API. Si la réflexion réelle ou le signalement de sortie du modèle diffère de vos hypothèses, mettez à jour la réserve et le plafond avant d'augmenter la taille du lot. Cette petite étape de calibration aide à maintenir un flux de travail à contexte long dans son enveloppe de tokens et de budget.
Que pouvez-vous faire tenir dans un million de tokens ?
Documents, code et matériel multimodal
Un million de tokens peut rendre plausible une analyse en une seule passe pour un ensemble de manuels, plusieurs contrats, une grande arborescence de code source ou une longue transcription avec notes. Google a utilisé des illustrations approximatives telles qu'environ 1 500 pages de texte ou 30 000 lignes de code. Considérez-les comme des exemples d'échelle, et non comme des garanties. La mise en page, la densité du code, la langue, le formatage et la tokenisation influent tous sur le décompte.
Pour le travail sur un dépôt, incluez dans votre estimation les fichiers de build, le code généré, les commentaires, les métadonnées de dépendances, les tests et le contexte pertinent des tickets. Demandez-vous ensuite si la tâche a besoin de tout. Une revue d'architecture inter-modules peut bénéficier d'un large ensemble de sources ; une question sur un seul message d'erreur, probablement pas.
Les entrées multimodales compliquent également les estimations. La durée d'une vidéo, l'échantillonnage des images, l'audio, la résolution et le traitement par l'API peuvent affecter l'utilisation et les preuves que le modèle voit. Pour une question précise, n'incluez que les médias pertinents et inspectez l'utilisation d'une requête représentative avant de monter en charge.
Les décomptes de tokens ne sont pas des décomptes de pages
Un token est une unité de traitement du modèle, et non un mot, un caractère, une page ou une ligne. Les identifiants, les tableaux, le code source et l'écriture non anglaise peuvent se tokeniser différemment de la prose ordinaire. Une estimation de pages ne peut pas vous dire si votre collection particulière tient.
La capacité est également différente de la qualité. Le fait qu'un ensemble de sources tienne ne prouve pas que le modèle trouvera chaque exception enfouie, préservera chaque dépendance ou résoudra correctement des passages contradictoires. La spécification établit une limite, et non un rappel exhaustif ou un score de précision spécifique à la tâche. Pour les conclusions importantes, demandez les emplacements sources et validez les affirmations importantes par rapport aux originaux.
Quand une fenêtre de 1M aide, et quand elle n'aide pas
Le contexte long est plus utile lorsqu'une réponse dépend de relations dispersées dans un matériel qu'une simple requête peut ne pas récupérer. Il est moins convaincant pour des questions précises répétées sur un corpus changeant, où la récupération peut sélectionner un ensemble de preuves plus restreint. Ce sont des compromis de flux de travail, et non un classement universel de précision.
| Approche | L'envisager quand | Compromis |
|---|---|---|
| Requête à contexte long | Une analyse ponctuelle nécessite des relations entre un ensemble de sources connu | Une entrée volumineuse peut augmenter le coût et la latence ; vérifiez la couverture |
| Récupération | Les utilisateurs posent des questions répétées sur un corpus changeant | L'indexation et la récupération déterminent quelles preuves atteignent le modèle |
| Découpage | Les documents peuvent être traités comme des unités ou des étapes indépendantes | Les relations entre les segments nécessitent une réconciliation |
| Hybride | Vous avez besoin d'une orientation large suivie de vérifications ciblées des preuves | Plus d'orchestration et de gestion d'état |
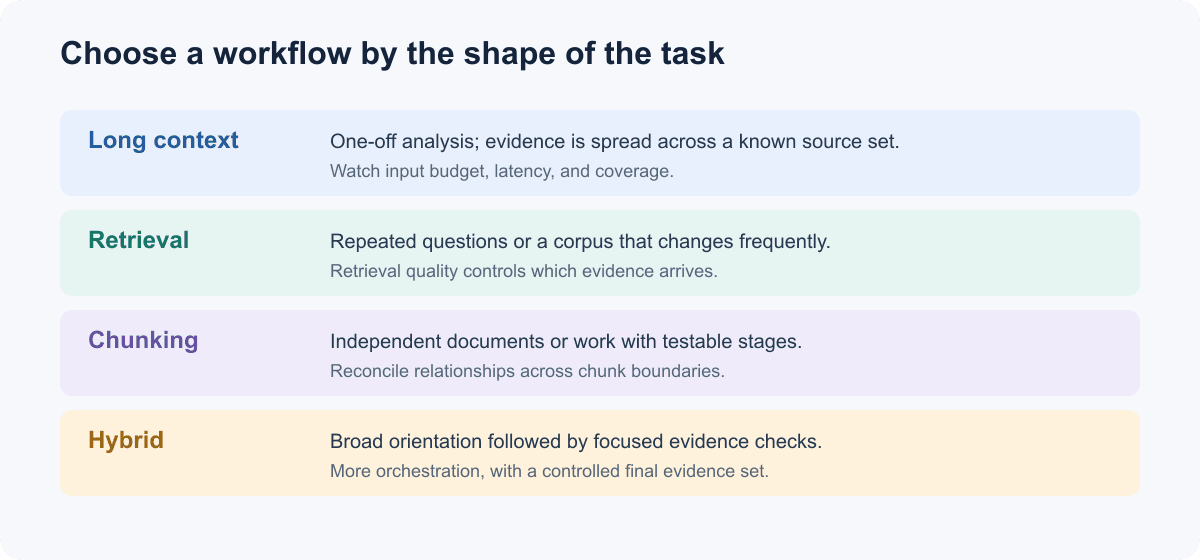
Choisissez en fonction de la forme de la tâche et du modèle de requête, puis validez sur des entrées représentatives.
Envisagez le contexte long pour comparer des politiques dont les clauses s'influencent mutuellement, examiner un changement sur de nombreux modules logiciels ou synthétiser des documents où un détail dans une source change l'interprétation d'une autre. La récupération convient aux questions de support répétées sur une base de connaissances croissante. Le découpage fonctionne lorsque les unités source sont indépendantes ou que chaque étape a une sortie testable. Un flux de travail hybride peut d'abord cartographier la collection, puis récupérer et vérifier les passages pour une réponse finale.
Évaluez les options par rapport aux mêmes questions représentatives. Suivez si les preuves requises ont été incluses, si les citations pointent vers les bons passages, l'utilisation des tokens, le temps de réponse et l'effort de récupération après une réponse incomplète. Cela donne à votre équipe des preuves pour sa charge de travail au lieu de supposer qu'une fenêtre plus grande l'améliore automatiquement.
Utiliser Gemini 4 Argon pour les tâches à contexte long
Confirmez l'ID du modèle et le chemin de requête
Google répertorie l'ID de modèle de l'API Gemini comme `gemini-4-argon`. Confirmez qu'il est activé pour votre compte et que la surface d'API exacte prend en charge les fonctionnalités dont vous avez besoin. Le même nom de modèle ne garantit pas que chaque proxy, SDK, console ou client expose des limites identiques ou un comportement de décodage long identique.
Avant la production, vérifiez :
- L'ID du modèle et sa disponibilité pour votre compte ou région.
- Le plafond de sortie synchrone et la manière dont le décodage long est demandé ou renvoyé.
- Si le SDK gère la continuation, et comment il signale les réponses partielles ou échouées.
- Les paramètres de réflexion, outils, mise en cache et modalités pris en charge pour l'API sélectionnée.
- Les champs d'utilisation réels d'entrée et de sortie de la requête.
Le guide sur le contexte long de Google décrit le budget unifié. Ses conseils sur le SDK et l'API peuvent changer, alors épinglez une version de SDK prise en charge, inspectez l'exemple actuel et testez en intégration le même transport et la même gestion des réponses que ceux prévus pour la production. Ne copiez pas les noms de paramètres d'une intégration de modèle plus ancienne sans vérifier qu'ils s'appliquent toujours.
Rendez le contrat de sortie plus petit que l'ensemble source
Donnez au modèle une tâche et une forme de réponse bornées. Pour un audit de dépôt, demandez des constatations groupées par gravité avec chemins de fichiers et références de lignes, et précisez s'il faut inclure des hypothèses ou uniquement des défauts confirmés. Pour une comparaison de contrats, nommez les clauses et demandez les identifiants de section ou de brefs extraits justificatifs. C'est plus facile à examiner que « tout analyser ». Pour les réponses volumineuses, prévoyez la continuation et l'achèvement partiel. Conservez les identifiants et les morceaux de réponse lorsque le SDK les expose, validez la sortie structurée avant toute utilisation en aval, et ne réessayez qu'une portion échouée lorsque c'est possible. Ce sont des sauvegardes à mettre en œuvre et à vérifier, et non l'affirmation que chaque SDK gère les interruptions de manière identique.
Tarification et accès : ce qu'il faut vérifier avant d'exécuter
L'annonce de Google indique actuellement des tarifs d'introduction de $2 par million de tokens d'entrée et $10 par million de tokens de sortie jusqu'au 30 novembre 2026, suivis de tarifs annoncés de $4 et $20 par million. Cela dépend du moment : revérifiez l'annonce officielle de Gemini 4 Argon avant de publier ou de prévoir des dépenses. Estimez séparément l'entrée et la sortie, car les charges de travail à forte composante de prompt et celles à forte génération ont des profils de coûts différents.
La disponibilité d'Argon via Atlas Cloud n'est pas confirmée dans les pages d'annuaire consultées pour cet article. Le catalogue de modèles Gemini d'Atlas présente les modèles Gemini et les détails d'accès actuellement répertoriés ; il n'établit pas qu'Argon est disponible. Confirmez une page de détail, un protocole et un prix spécifiques au modèle avant d'acheminer des requêtes ou de comparer les coûts.
Commencez par une requête représentative et enregistrez les versions du modèle et du SDK, l'utilisation des tokens, la latence, les erreurs et les contrôles de qualité spécifiques à la tâche. Revenez sur le budget et le choix de récupération lorsque les ensembles de sources ou les modèles de requête changent. La fenêtre de contexte 1M de Gemini 4 Argon est utile lorsque son étendue résout un véritable problème multi-sources et que votre requête dispose d'un budget clair et d'un plan de vérification.
Questions fréquentes
La fenêtre 1M de Gemini 4 Argon est-elle partagée entre l'entrée et la sortie ?
Oui. Google définit une fenêtre unique de 1 048 576 tokens partagée entre l'entrée, la réflexion et la sortie. La quantité restante pour une réponse dépend de la requête et des limites d'interface applicables.
Quelle est la limite de sortie par défaut de Gemini 4 Argon ?
La spécification indique 65 536 tokens pour la sortie synchrone par défaut. Le décodage long peut prendre en charge une génération plus importante, sous réserve de la capacité partagée restante et du chemin d'API.
Gemini 4 Argon peut-il générer 1M de tokens en une seule réponse ?
La page du modèle indique un décodage long jusqu'à 1 048 576 tokens de sortie, mais il s'agit d'une capacité maximale, et non d'une garantie qu'une requête contenant une entrée peut également renvoyer un million de tokens. L'entrée et la réflexion occupent la même fenêtre totale.
Une fenêtre de contexte de 1M signifie-t-elle que chaque détail sera rappelé avec précision ?
Non. Elle décrit le budget maximal de tokens, et non une récupération ou un raisonnement parfaits. Exigez des références de preuves et testez des cas limites connus à partir de votre propre matériel.
Gemini 4 Argon est-il actuellement disponible via Atlas Cloud ?
Je n'ai pas pu confirmer une liste de modèles ou une page de détail spécifique à Argon dans le catalogue Atlas Cloud consulté pour cet article. Vérifiez l'annuaire actuel avant de supposer une prise en charge ; le lien vers le catalogue Gemini ci-dessus n'établit pas à lui seul la disponibilité d'Argon.


