

Une vidéo téléversée peut contenir la réponse dont vous avez besoin et être mal interprétée. Gemini 4 Argon peut prendre en entrée du texte, des images, de la vidéo, de l’audio et des PDF, puis renvoyer du texte qui analyse ou relie des détails entre eux. Les capacités multimodales de gemini 4 Argon sont surtout utiles lorsque votre tâche consiste à inspecter du matériel existant, et non à créer de nouveaux médias. Sa limite de contexte unifiée est de 1 048 576 tokens, mais il s’agit d’une limite de capacité, pas d’une garantie d’exactitude. Vous trouverez ci-dessous un guide tâche par tâche de ce qu’il peut analyser, comment vérifier la réponse, et où s’inscrivent l’API actuelle et Atlas Cloud.
Points clés
- Argon accepte en entrée du texte, des images, de la vidéo, de l’audio et des PDF ; sa sortie documentée est du texte.
- Le contexte de 1 048 576 tokens est partagé entre l’entrée et la sortie. La sortie synchrone par défaut est plafonnée à 65 536 tokens.
- La génération d’images, la génération audio et Live API ne sont pas prises en charge par le modèle Argon.
- Vérifiez les affirmations par rapport aux numéros de page, aux horodatages ou aux preuves visibles avant de les utiliser dans un flux de travail.
Ce que « multimodal » signifie pour Gemini 4 Argon
Pour l’API Gemini, multimodal signifie qu’Argon peut recevoir différents types de matériel source dans une requête et raisonner sur ce matériel parallèlement à des instructions textuelles. La page de modèle Gemini API actuelle répertorie les entrées texte, image, vidéo, audio et PDF, avec du texte en sortie. Elle mentionne aussi la sortie structurée, l’appel de fonctions, l’exécution de code, la recherche de fichiers et l’ancrage par recherche parmi les capacités prises en charge. Ces outils peuvent façonner un flux de travail, mais ils ne transforment pas la modalité de sortie en image, piste audio ou flux de conversation en direct. (Google AI for Developers, octobre 2026)
Les chiffres de tokens doivent être lus attentivement. Google indique une fenêtre de contexte unifiée de 1 048 576 tokens pour l’entrée et la sortie combinées. Une requête synchrone normale a une sortie maximale de 65 536 tokens ; le décodage long peut atteindre jusqu’à 1 048 576 dans le cadre de son flux de continuation en arrière-plan documenté. Si votre invite et le contenu joint consomment la majeure partie de la fenêtre partagée, il reste moins de place pour le raisonnement et le texte de réponse. Le titre « contexte 1M » ne signifie pas que chaque requête d’un million de tokens tient dans une réponse ordinaire.
| Matériel que vous fournissez | Entrée documentée ? | Sortie Argon | Première tâche utile | Preuve à vérifier |
|---|---|---|---|---|
| Texte et PDF | Oui | Texte | Résumer un rapport ou comparer des affirmations entre sections | Page, titre, ligne de tableau ou passage cité |
| Image | Oui | Texte | Lire un graphique, identifier des objets ou comparer deux images | Étiquettes, valeurs, emplacements et recadrage de l’image |
| Vidéo | Oui | Texte | Décrire l’ordre des événements ou trouver un moment dans un clip | Horodatage et image réelle |
| Audio | Oui | Texte | Répondre à des questions sur un enregistrement téléversé | Segment audio, transcription, locuteur ou son |
| Média généré | Aucune génération image/audio listée | Texte | Renvoyer une analyse écrite ou un résultat structuré | Schéma et prise en charge de la source |
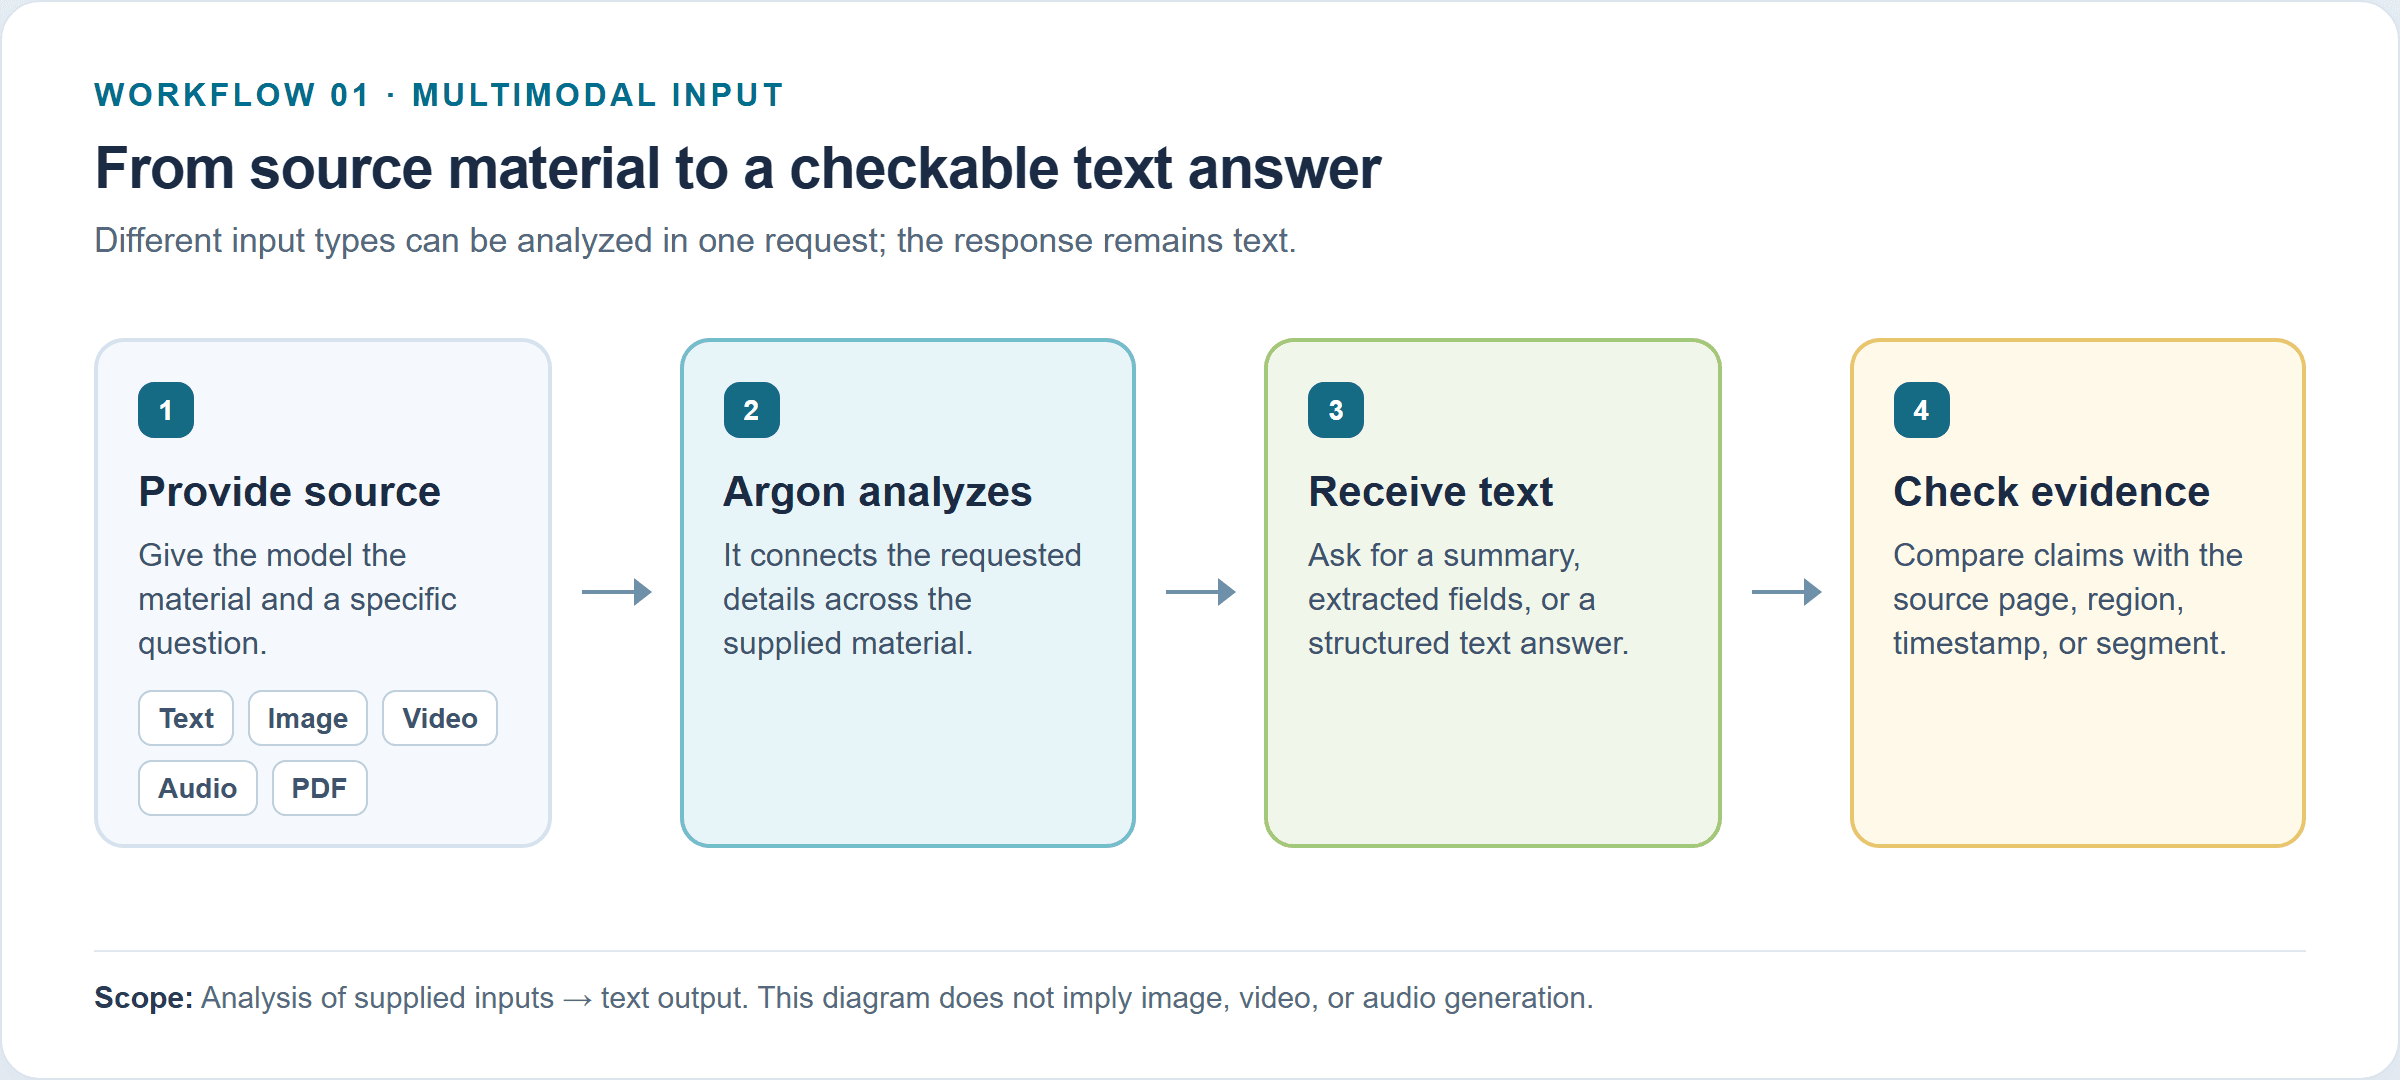 Illustration du flux de travail : le texte, l’image, la vidéo, l’audio ou le PDF fourni est analysé pour produire une réponse textuelle, puis vérifié par rapport aux preuves source.
L’application Gemini peut proposer des fonctionnalités qui composent ou créent des médias via d’autres modèles et outils. Ne supposez pas que ces fonctionnalités au niveau de l’application sont des capacités du modèle API gemini-4-argon lui-même. Pour une décision d’implémentation, utilisez le tableau des capacités de l’API et l’ID de modèle exact plutôt qu’un libellé de famille de produits.
Ce que Gemini 4 Argon peut analyser dans les images, la vidéo, l’audio et les PDF
La meilleure façon de déterminer si Argon convient est de nommer la preuve dont votre tâche a besoin. « Comprendre une vidéo » est trop vague. « Trouver chaque fois que l’opérateur place une pièce dans le plateau, puis citer l’horodatage » est testable.
Images : inspecter, comparer et extraire des informations visuelles
Une requête d’image peut demander à Argon de décrire une scène, de comparer deux images fournies, d’extraire du texte visible, d’interpréter un graphique ou de renvoyer des constats visuels dans un format structuré. Il s’agit de tâches d’analyse : la sortie est du texte ou du texte structuré. Elles peuvent aider une équipe d’assistance à trier des photos de produits, un chercheur à parcourir des figures ou un opérateur à extraire des étiquettes d’un ensemble d’images.
Des tests indépendants offrent un utile contrôle de réalité, à condition de les considérer comme une configuration de benchmark parmi d’autres plutôt que comme une prévision pour vos propres images. Vision Evals de Roboflow d’octobre 2026 classe Argon parmi les meilleurs modèles dans ses tâches testées de détection d’objets, d’OCR et de raisonnement visuel. Son évaluation OCR sépare la transcription exacte et les sous-tâches associées, et son article signale des points faibles comme les textes petits ou flous et les lectures visuelles plus difficiles. Sa configuration, les images sélectionnées, les invites et la notation définissent ces résultats ; elles n’établissent pas un taux de réussite général pour chaque scan ou graphique. (Roboflow, octobre 2026)
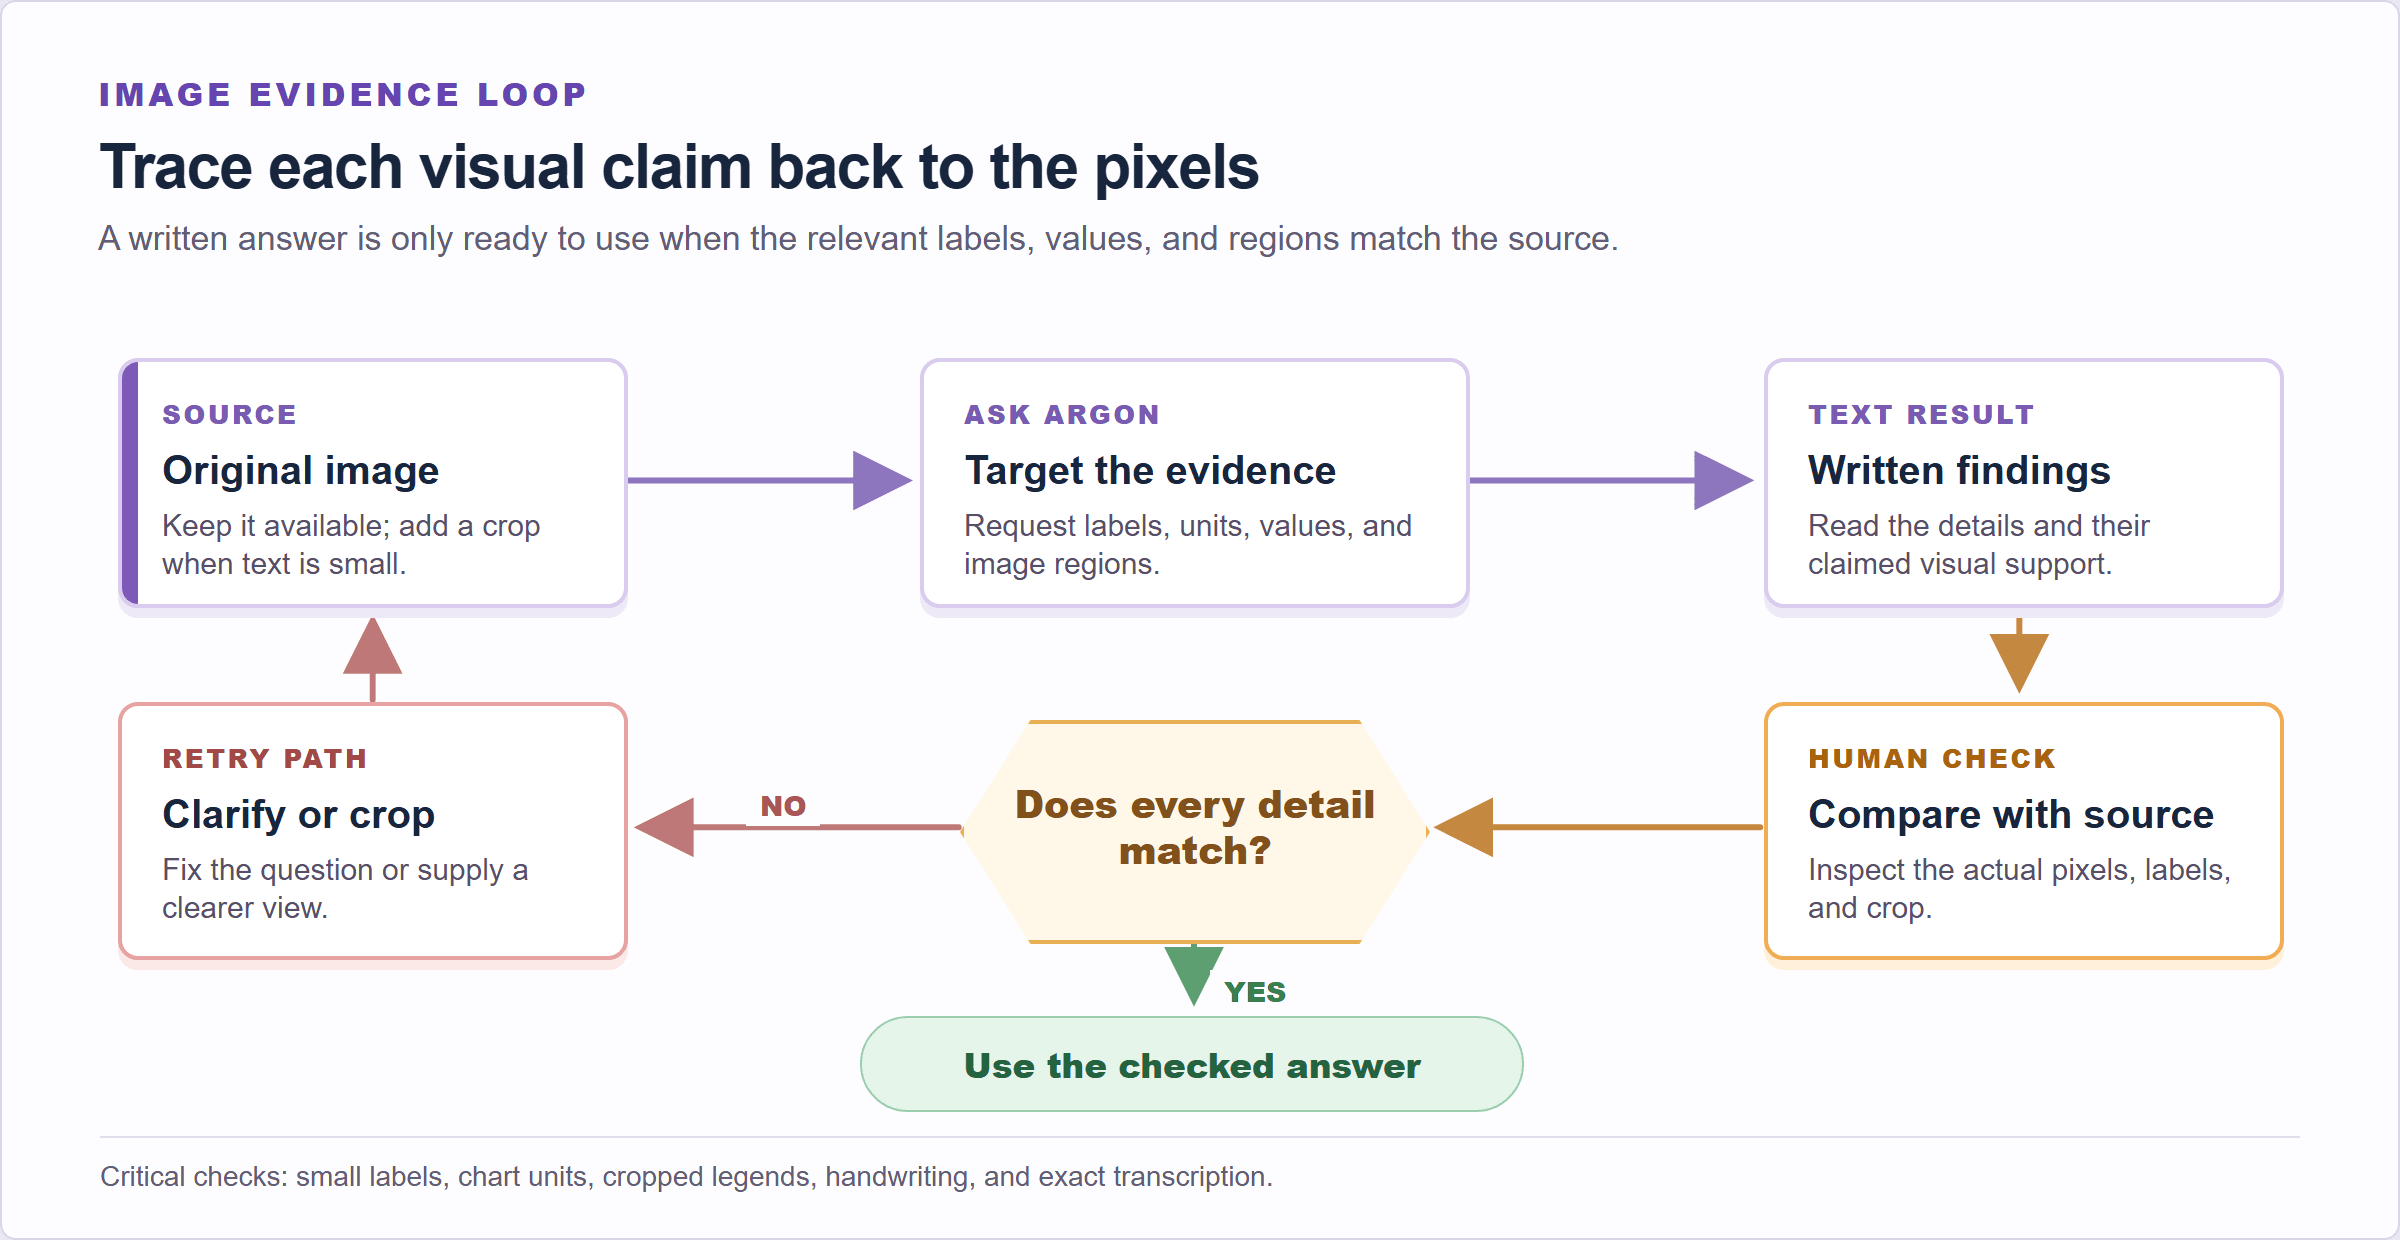 Illustration du flux de travail : demandez les détails de l’image et leurs régions justificatives, puis vérifiez chaque affirmation par rapport à l’image originale.
Pour un graphique, demandez le titre, les axes, les unités, les valeurs pertinentes et la région de l’image qui justifie chaque valeur. Comparez ensuite ces détails avec la source. Les petites étiquettes, les captures d’écran à faible résolution, l’écriture manuscrite, les marques qui se chevauchent ou une légende recadrée méritent une vérification manuelle. Si la transcription exacte compte, incluez un recadrage net et conservez l’original afin qu’un relecteur puisse vérifier chaque caractère.
Vidéo : raisonner sur des événements dans le temps
La vidéo ajoute l’ordre et le temps. Argon peut répondre à des questions sur des actions, des changements et des événements à travers les images. L’API prend en charge la compréhension vidéo agentique, une option qui peut inspecter dynamiquement la chronologie ; son mode par défaut documenté est statique. Consultez le guide vidéo et les paramètres de requête pour connaître le mode réellement utilisé par votre intégration.
Une question de production utile pourrait être : « À quel moment le technicien retire-t-il le filtre, et que se passe-t-il immédiatement avant et après ? » Exigez des horodatages, puis inspectez ces moments. Une description fluide sans preuve alignée dans le temps ne suffit pas pour une revue d’incident, des contrôles qualité ou des données d’entraînement.
L’équipe robotique de Google décrit un flux de travail Argon qui analyse un enregistrement aérien de 136 secondes d’un robot à deux bras pliant du papier en renard origami. Le système produit une hiérarchie d’annotations alignées dans le temps, de la tâche globale aux sous-tâches et aux actions au niveau du contact, avec des étiquettes de contrôle qualité autour des reprises. C’est un exemple concret de sortie d’analyse vidéo constituée d’étiquettes et de structure liées aux images. L’article est un exemple de recherche, pas une garantie qu’un appel API général reproduira un pipeline robotique. (Google Developers Blog, octobre 2026)
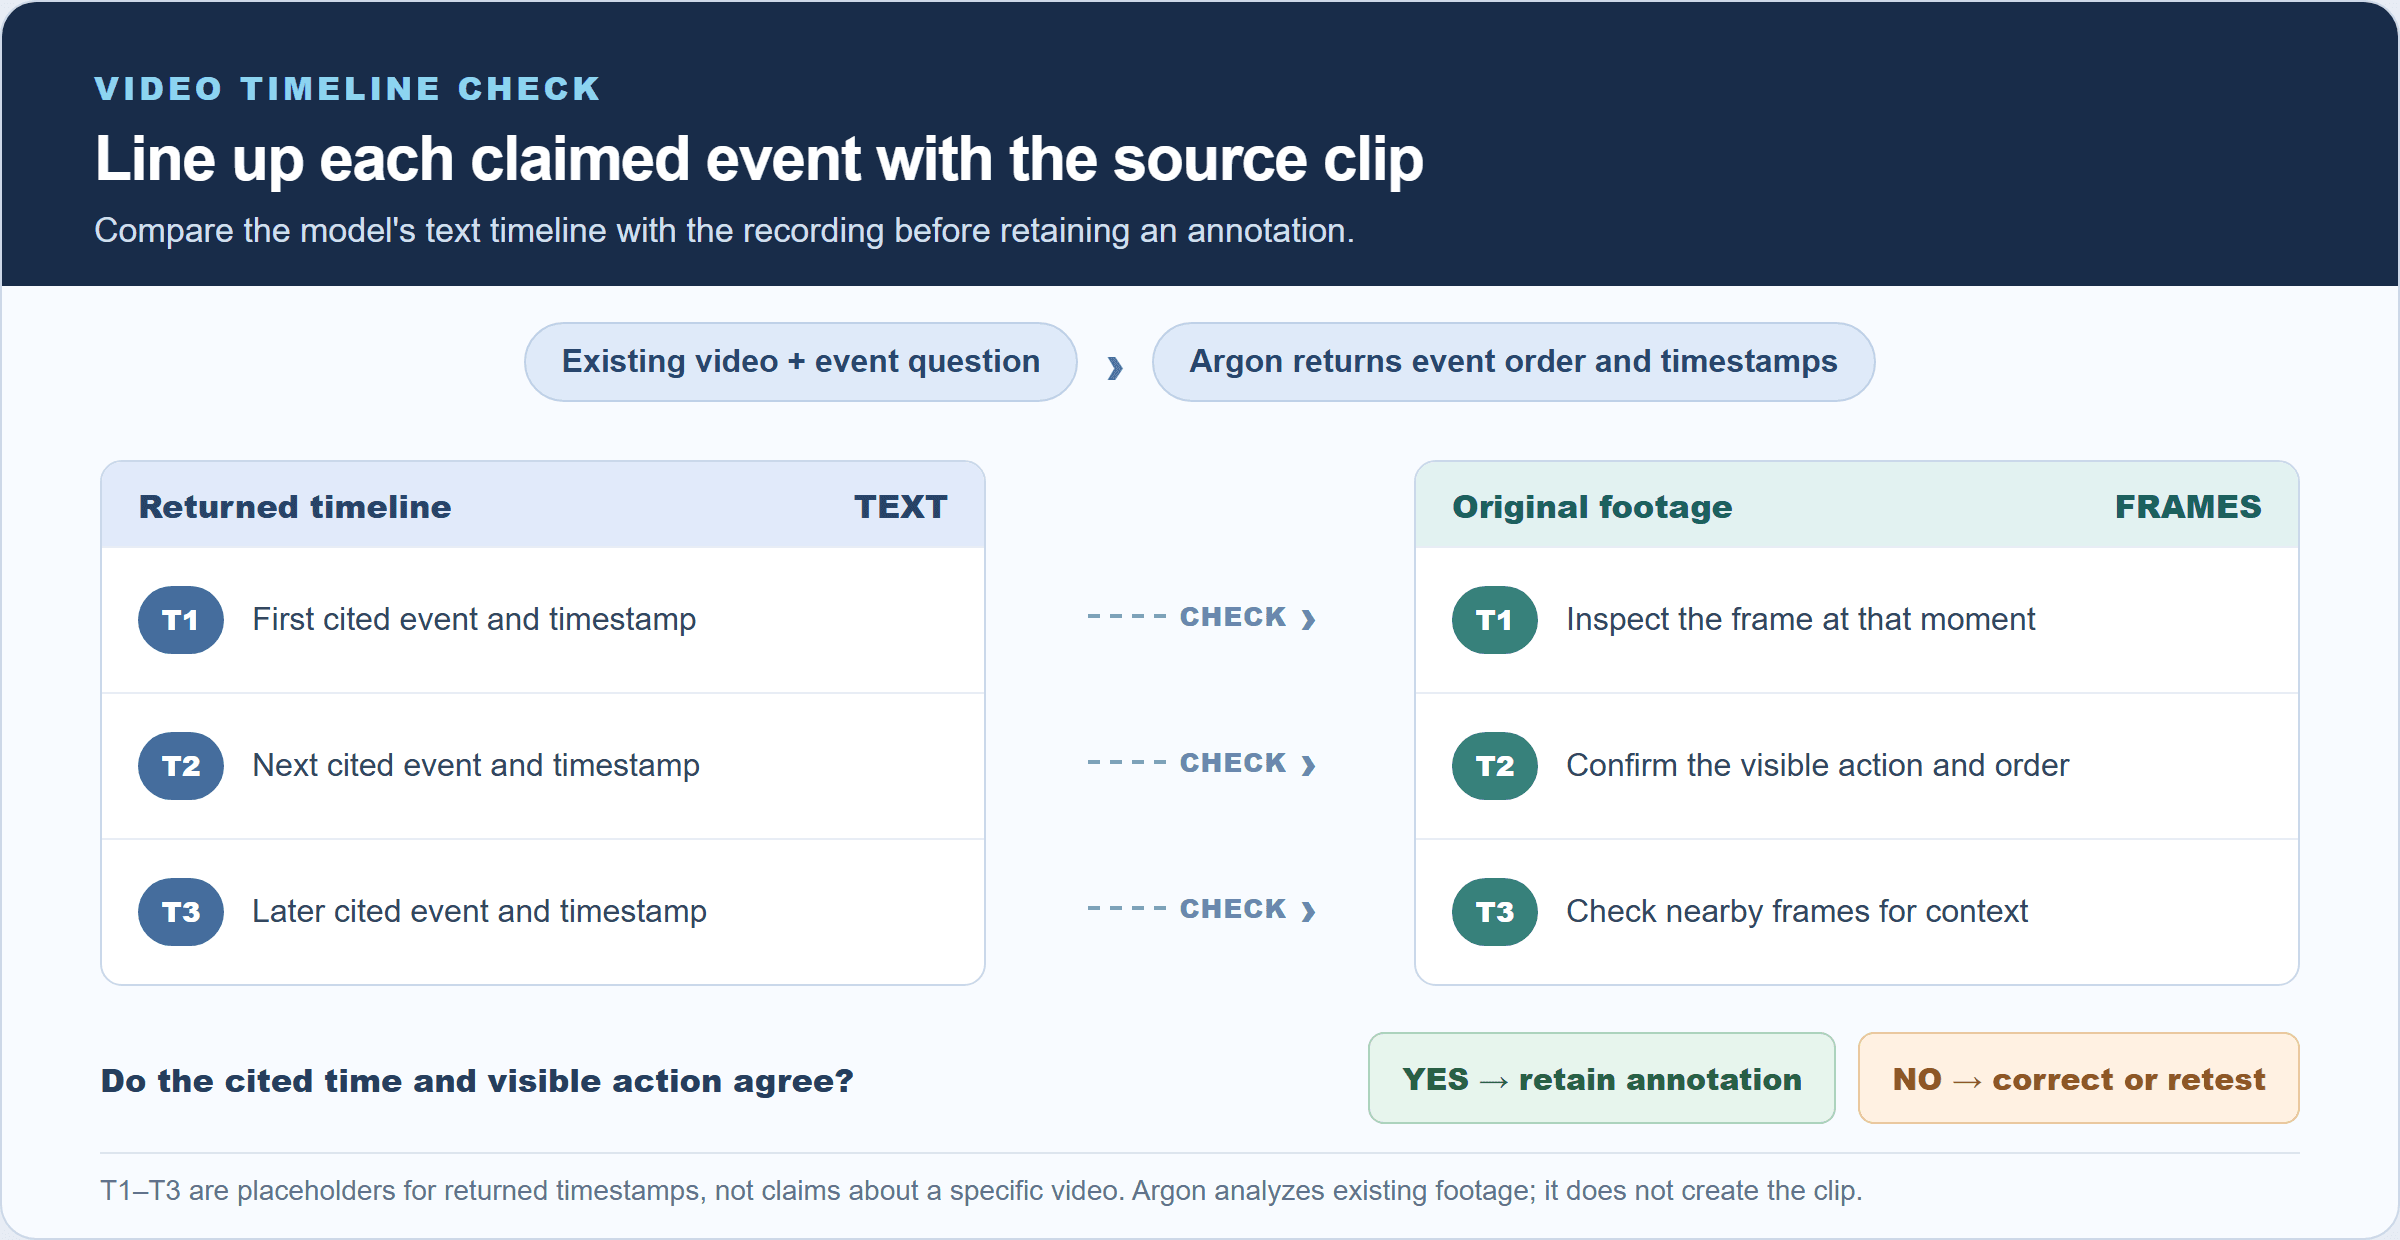 Illustration du flux de travail : demandez l’ordre des événements et les horodatages, puis vérifiez chaque moment cité par rapport à l’enregistrement original.
Le mouvement peut être facile à mal interpréter lorsque la caméra bouge, que des mains masquent un objet ou que deux actions se produisent rapprochées. Échantillonnez les horodatages renvoyés par rapport aux images originales. Si une réponse influence la sécurité ou une décision de conformité/non-conformité, faites vérifier les images critiques par une personne ou un système de vision dédié.
Audio : analyser des enregistrements fournis
L’entrée audio vous permet de poser des questions fondées sur un enregistrement, comme ce qui a été dit, quel son est apparu en premier ou si une phrase particulière apparaît. Avant de concevoir une intégration, consultez la documentation actuelle sur l’entrée audio pour connaître les formats pris en charge, les contraintes de durée et d’échantillonnage, et la forme exacte de la requête. « Entrée audio prise en charge » seul ne précise pas tous les comportements de transcription ni ne garantit qu’une pièce jointe a bien été transmise par votre client.
Créez un petit ensemble de test à réponses connues à partir d’enregistrements que vous avez l’autorisation de traiter. Incluez de la parole claire, des locuteurs qui se chevauchent, du bruit de fond, du silence et des sons non vocaux si ceux-ci surviennent en production. Demandez des horodatages ou une courte citation de preuve lorsque l’interface le permet. Vérifiez que la pièce jointe a atteint le modèle, puis comparez le résultat à l’enregistrement. Cela permet de détecter à la fois les erreurs du modèle et les erreurs d’intégration, comme des parties de fichier omises ou un encodage non pris en charge.
PDF et documents mixtes : relier des détails entre les sources
La prise en charge des PDF est précieuse lorsqu’une question traverse de la prose, des tableaux et des figures. Un relecteur pourrait demander si le résumé exécutif d’un rapport concorde avec un tableau plus loin dans le document, ou extraire une affirmation et sa figure justificative. Plusieurs documents peuvent être fournis pour comparaison, sous réserve des limites de tokens et de fichiers de la requête.
Demandez un emplacement source pour chaque affirmation. Les références de page sont utiles, mais validez-les, car la numérotation des pages PDF peut différer du libellé de page imprimé. Pour un tableau, demandez son libellé de ligne et son en-tête de colonne ainsi que la valeur. Pour un diagramme, demandez au modèle de nommer l’élément visuel qu’il a utilisé. Si un PDF est scanné, pivoté, pâle ou dense en composition, testez des pages représentatives plutôt que de supposer que toutes les pages ont été analysées aussi bien les unes que les autres.
Un schéma de sortie compact peut faciliter la relecture : affirmation, emplacement source, extrait ou détail visuel justificatif, et confiance ou « non trouvé ». Les sorties structurées peuvent imposer une forme, mais un objet JSON valide peut tout de même contenir une lecture erronée. La validation du format et la validation factuelle sont deux contrôles distincts.
Comment tester la compréhension multimodale de Gemini 4 Argon
Utilisez une courte évaluation avant de connecter le modèle à un large lot. Choisissez une source pour laquelle un humain peut établir la bonne réponse, et définissez ce qui compte comme résultat correct. L’objectif est de tester tout le chemin, de la sélection du fichier à la réponse du modèle, et pas simplement de voir si la réponse semble plausible.
- Sélectionnez un rapport public avec un graphique ou une courte vidéo dont les événements sont clairement identifiables. Conservez un corrigé vérifié par un humain.
- Demandez au modèle d’utiliser uniquement le matériel joint et d’associer un emplacement à chaque affirmation.
- Comparez chaque affirmation avec la source. Notez les omissions, les lectures erronées, les inférences non étayées et les emplacements qui ne correspondent pas à une preuve.
- Répétez avec plusieurs exemples qui ressemblent à vos fichiers réels, y compris des cas difficiles.
- Fixez un seuil de réussite en fonction du coût d’une erreur. Orientez les résultats incertains ou à fort impact vers une relecture humaine.
Vous pouvez adapter cette invite :
Analysez uniquement le matériel joint. Répondez aux questions ci-dessous dans un tableau. Pour chaque affirmation, citez le numéro de page, l’horodatage ou la preuve visible qui la justifie. Si le matériel ne contient pas la réponse, dites « non trouvé ». N’inférez pas de faits manquants.
Pour une image, remplacez « numéro de page, horodatage » par « région de l’image et étiquette visible ». Pour un PDF, demandez la page et le nom du tableau ou de la section. Pour l’audio, demandez un horodatage et les mots ou le son qui justifient la réponse. Ces petits changements rendent la sortie plus facile à auditer.
Suivez les erreurs par type plutôt qu’en utilisant un seul chiffre de précision global. Un chiffre erroné dans un graphique, un événement manqué et une citation vers la mauvaise page ont des conséquences différentes. Ce cadre d’évaluation transforme une liste impressionnante de capacités en une décision reproductible sur la fiabilité du modèle pour vos fichiers.
Limites de Gemini 4 Argon : ce que la prise en charge multimodale ne signifie pas
La prise en charge des entrées n’implique pas une prise en charge correspondante des sorties. L’API répertorie actuellement la génération d’images, la génération audio et Live API comme non prises en charge pour Argon. Si la tâche consiste à créer une nouvelle image, une bande sonore ou une interaction vocale en temps réel, choisissez un modèle ou un outil qui répertorie explicitement cette sortie. Vous pouvez tout de même utiliser Argon pour analyser l’invite, le matériel source ou le résultat généré.
Une fenêtre d’un million de tokens ne garantit pas non plus un rappel complet. Elle est partagée entre la requête et la réponse, et les entrées longues peuvent augmenter la latence et le coût. Le modèle peut négliger un détail, inférer des informations absentes ou renvoyer un horodatage incorrect tout en semblant certain. Le décodage long est un chemin d’exécution de l’API avec des exigences supplémentaires, pas le comportement par défaut de chaque client.
Les benchmarks sont des preuves indicatives. Roboflow rapporte des résultats issus d’ensembles de données de tâches et de paramètres d’évaluation spécifiques, tandis que la fiche modèle de Google résume un ensemble plus large d’évaluations internes et publiques. Aucun des deux ne remplace un test utilisant la qualité de votre caméra, vos mises en page de documents, votre vocabulaire, vos langues et votre tolérance aux erreurs. Un score élevé dans une catégorie ne peut pas prouver des performances fiables sur une autre tâche.
Faites appel à un relecteur lorsque la réponse influence une décision financière, juridique, de sécurité, médicale ou d’emploi. Conservez l’entrée originale et les preuves renvoyées ensemble afin qu’une personne puisse auditer la conclusion. Pour les flux de travail récurrents, journalisez la version du modèle, l’invite, les paramètres pertinents, l’identifiant de la source et le résultat de la revue. Cette trace aide à distinguer un changement de modèle d’un problème de fichier ou d’intégration.
| Tâche | Bon premier test | À vérifier de près |
|---|---|---|
| Lecture de graphique | Demandez des valeurs étiquetées avec les unités des axes | Petites polices, légendes denses, lectures visuelles approximatives |
| OCR | Utilisez un recadrage net avec une transcription connue | Flou, écriture manuscrite, rotation, écritures mixtes |
| Événements vidéo | Demandez des actions horodatées dans l’ordre | Occlusion, coupes rapides, causes inférées |
| Questions-réponses audio | Posez une question connue sur un court enregistrement | Bruit, locuteurs multiples, traitement des pièces jointes |
| Comparaison de PDF | Demandez l’affirmation, la page et le passage justificatif | Pages scannées, numérotation de pages incohérente, inférence entre pages |
Accès, tarification et place d’Atlas Cloud
L’ID public du modèle API est gemini-4-argon ; Google répertorie actuellement Gemini API et AI Studio comme voies d’accès. L’avis actuel de Google indique un tarif d’introduction de 2 $ par million de tokens d’entrée et de 10 $ par million de tokens de sortie jusqu’au 30 novembre 2026, puis de 4 $ et 20 $ respectivement. L’entrée mise en cache a des conditions distinctes, donc ne l’estimez pas comme une entrée ordinaire. (Google, octobre 2026)
La liste All Models actuelle d’Atlas Cloud n’affichait pas Gemini 4 Argon lors de la vérification pour cet article. Cela signifie qu’il n’y a pas de page de modèle Atlas Argon vérifiée ni de prix Atlas à citer ici. Ne considérez pas une liste générale de plateforme comme une preuve de disponibilité. Si votre équipe compare des fournisseurs ou construit un flux de travail de modèles plus large, Atlas Cloud peut être un endroit où parcourir d’autres modèles listés, mais confirmez la page de modèle exacte et les opérations prises en charge avant de planifier autour d’un fournisseur.
La vérification des sources influence aussi la recommandation : utilisez la voie officielle de Google pour tester Argon aujourd’hui, et considérez Atlas Cloud comme une option de découverte distincte pour les modèles réellement listés. Il n’est pas affirmé ici qu’Argon est hébergé sur Atlas Cloud.
Gemini 4 Argon est-il adapté à votre tâche ?
Placez Argon sur une liste restreinte lorsque la tâche exige de raisonner sur du matériel mixte, d’extraire des détails visuels, de suivre des événements dans une vidéo ou de relire un long rapport. Son grand contexte partagé et sa sortie texte peuvent aider à regrouper des preuves dans un tableau ou un résultat structuré. L’étape suivante est une petite évaluation vérifiable par un humain utilisant vos propres entrées représentatives.
Choisissez un autre modèle ou outil lorsque le livrable requis est une imagerie générée, de l’audio généré ou une conversation audio/vidéo en direct. Pour l’OCR ou les décisions opérationnelles, comparez sa sortie avec une alternative dédiée si l’exactitude, la vitesse ou un coût prévisible compte plus qu’un raisonnement large.
Si l’évaluation dépasse votre seuil spécifique à la tâche, faites un pilote avec journalisation et relecture humaine avant d’augmenter le volume. Si elle échoue, classez les erreurs et décidez si des entrées plus claires, une invite modifiée, un autre modèle ou un système OCR/transcription distinct est la bonne solution. La question utile est de savoir si les capacités multimodales de Gemini 4 Argon respectent votre budget d’erreur.
Questions fréquentes
Gemini 4 Argon peut-il analyser des vidéos et de l’audio ?
Oui. Son API répertorie à la fois la vidéo et l’audio comme entrées prises en charge. La compréhension vidéo peut renvoyer des descriptions ou une analyse horodatée ; l’audio peut être fourni pour des questions fondées sur l’audio. Consultez la documentation actuelle sur les formats de fichiers et les requêtes, puis vérifiez la réponse par rapport au média original.
Gemini 4 Argon génère-t-il des images ou de l’audio ?
Non. Le tableau actuel des capacités de l’API marque la génération d’images et la génération audio comme non prises en charge pour ce modèle. Sa modalité de sortie documentée est le texte, même lorsque son entrée contient des images, de l’audio ou de la vidéo.
Que signifie la fenêtre de contexte de 1M tokens de Gemini 4 Argon ?
La limite de 1 048 576 tokens est partagée entre l’entrée et la sortie. La sortie synchrone par défaut est plafonnée à 65 536 tokens. Google documente un flux de décodage long distinct pour des sorties plus importantes, jusqu’à la limite partagée, avec exécution en arrière-plan et étapes de continuation.
Combien coûte l’accès à l’API Gemini 4 Argon ?
Au 16 octobre 2026, Google indique 2 $ par million de tokens d’entrée et 10 $ par million de tokens de sortie jusqu’au 30 novembre 2026. Les tarifs ultérieurs indiqués sont de 4 $ et 20 $. Consultez la tarification en vigueur et les conditions des tokens mis en cache avant d’estimer un projet.


