Une scène à deux personnages devient convaincante lorsque l'on voit et entend qui prononce chaque réplique. Pour rendre le dialogue multi-intervenants de Gemini Omni 1.2 Flash facile à suivre, attribuez à chaque personnage une identité visuelle et vocale fixe, écrivez des répliques courtes dans l'ordre de prise de parole, et visionnez la vidéo finale avec vos yeux et vos oreilles. La mise à jour de Google de novembre 2026 prend en charge une parole multi-intervenants plus naturelle et des clips allant jusqu'à 15 secondes, mais un prompt ne peut pas garantir une attribution propre des intervenants dès le premier rendu. Commencez par un échange simple à 2 personnes, puis ajoutez une troisième réplique ou une ambiance de rue seulement lorsque vous savez évaluer le passage de parole de base.
Points clés
- Gemini Omni 1.2 Flash génère de la vidéo avec un son natif, y compris des dialogues ; il diffère des modèles de synthèse vocale Gemini purement audio.
- Utilisez des intervenants nommés, des répliques citées exactement, des positions claires et un auditeur silencieux pour chaque réplique.
- Laissez de la place pour les pauses dans la limite de 15 secondes, puis vérifiez chaque réplique par rapport au clip.
- Estimez le prix d'un rendu à partir de la durée et de la résolution sélectionnées, et non du tarif le plus bas annoncé par une plateforme.
Que signifie le dialogue multi-intervenants dans Gemini Omni 1.2 Flash ?
Le modèle crée une courte scène dans laquelle des personnes peuvent parler dans le cadre de l'audio et de la vidéo générés. Le test pratique consiste à déterminer si un spectateur peut savoir qui dit chaque réplique sans lire de transcription. Les mots, la voix, la personne visible et le mouvement des lèvres doivent concorder en même temps. Un clip peut sembler convaincant son coupé et échouer malgré tout à ce test.
Google a annoncé Gemini Omni 1.2 Flash le 5 novembre 2026, avec jusqu'à 15 secondes de vidéo générée ou modifiée. Il décrit un dialogue plus fluide, une synchronisation labiale plus nette et un conditionnement multi-intervenants distinct. Ce sont des affirmations de capacités, et non la promesse que chaque script sera restitué exactement tel qu'écrit (annonce de Google de novembre 2026).
La démonstration publiée par Google montre la capacité qu'il a annoncée. Elle est distincte des trois cas vidéo fournis ci-dessous.
Qu'est-ce qui a changé par rapport à Gemini Omni 1.1 Flash ?
La comparaison officielle accorde à la version 1.2 un plafond plus long : 15 secondes au lieu de 10. Elle cite également des améliorations de la parole, de la synchronisation labiale, du suivi des références et du montage conversationnel. Les 5 secondes supplémentaires rendent un échange à 3 répliques plus plausible à scénariser, mais une durée plus longue ne crée pas plus de temps de parole si un réalisateur demande aussi des pauses, des réactions physiques et des changements de scène.
L'interprétation la plus prudente est directionnelle. Un meilleur conditionnement peut faciliter la direction du dialogue, mais chaque clip livré doit encore être inspecté. Un créateur peut utiliser la limite de 15 secondes pour fixer un objectif de script. Un producteur qui promet un texte juridique exact ou une correspondance vocale précise doit traiter la sortie générée comme un brouillon jusqu'à ce qu'elle passe la revue.
Dialogue vidéo vs synthèse vocale multi-intervenants
Les modèles de synthèse vocale Gemini acceptent du texte et renvoient de l'audio. Leurs réglages d'intervenants et leurs choix de voix appartiennent à ce flux de travail audio, que Google documente séparément (documentation de synthèse vocale Gemini de Google, consultée en novembre 2026). La voie texte-vers-vidéo de Gemini Omni 1.2 Flash accepte un prompt de scène et produit une vidéo avec un son natif. Un exemple de speech_config de synthèse vocale n'est pas un contrôle vidéo de Gemini Omni 1.2 Flash. Ces exemples décrivent le caractère vocal dans le texte ; ils ne prétendent ni téléverser, ni cloner, ni sélectionner une voix enregistrée. Si un brief exige la voix d'un acteur précis, vérifiez cet accès et ce consentement séparément avant de planifier le plan.
Si votre livrable est une conversation de podcast ou une voix off verrouillée, utilisez la synthèse vocale et montez l'image autour de cet audio. S'il s'agit de deux personnes parlant visiblement dans une scène générée, utilisez la vidéo Gemini Omni 1.2 Flash et testez l'alignement dans la sortie réelle.
Où pouvez-vous l'exécuter, et combien coûtera un clip ?
Choisir la voie texte-vers-vidéo
Google référence Gemini Omni 1.2 Flash dans ses produits créatifs et pour développeurs. Pour un test reproductible, utilisez une seule voie : Atlas Cloud propose le modèle, et son playground texte-vers-vidéo Gemini Omni 1.2 Flash est l'endroit où coller les prompts ci-dessous. L'ID de la voie est google/gemini-omni-1.2-flash/text-to-video. Les prompts ci-dessous utilisent uniquement du texte, sans références d'image, de mouvement ou de voix.
Les prompts demandent 12 secondes en 16:9 pour le bureau, 15 secondes en 16:9 pour le café et 12 secondes en 16:9 pour l'interview de rue. Les trois fichiers fournis sont en 720p. Confirmez les contrôles en direct et les valeurs sélectionnées avant d'appuyer sur Run. Un réglage annoncé sur une page produit ne prouve pas qu'une exécution de test particulière l'a accepté. Enregistrez les valeurs sélectionnées et le devis avec chaque sortie. Cela rend chaque rendu utile comme preuve : vous pouvez comparer le prompt avec la résolution et la voie sélectionnées lors de la revue de sa sortie. Ce guide spécifie la voie texte-vers-vidéo, donc un résultat issu d'une voie image-vers-vidéo ou référence-vers-vidéo doit être identifié séparément.
Les fichiers vidéo fournis n'incluent pas de capture complète du playground, de réglages sélectionnés ni de devis avant soumission. Leur voie et leur configuration restent donc non vérifiées.
| Voie | Entrée pour ce guide | Idéal pour | Où vérifier le coût |
|---|---|---|---|
| Produits créatifs de Google | Un prompt de scène ; les contrôles varient selon le produit | La création manuelle dans l'éditeur de Google | L'écran actuel du forfait ou des crédits |
| API Google | Une requête vidéo de développeur | L'intégration applicative | Le prix de Google pour la résolution exacte |
| Texte-vers-vidéo Atlas Cloud | Prompt, durée, format d'image, résolution | Répéter ces tests en texte seul dans un playground | Le devis avant soumission de la configuration sélectionnée |
Vérifier le prix avant de lancer le rendu
Google annonce 0,07 $ par seconde générée en 720p via son API, soit 30 % de moins que Gemini Omni 1.1 Flash. À ce tarif annoncé, 12 secondes en 720p coûtent 0,84 $ avant tout autre travail facturable. Ce calcul n'est pas un devis Atlas Cloud pour les fichiers fournis ; leur voie et leur facturation ne sont pas vérifiées. Les crédits dans Flow ou un autre éditeur suivent les règles propres à ce produit.
Atlas Cloud affiche un tarif par seconde de départ plus bas sur son catalogue de modèles, mais le minimum peut correspondre à une autre résolution ou configuration. Lisez le devis en direct après avoir choisi la durée et la résolution. Un brouillon en 360p peut aider à explorer un prompt ; c'est une génération distincte et non un aperçu image par image d'un rendu ultérieur en 1080p.
Faire tenir deux voix dans une scène de 15 secondes
Donner à chaque intervenant une identité visuelle et vocale
Écrivez des descriptions qu'un relecteur peut vérifier. « L'intervenant A est à gauche en chemise bleu marine » est plus clair que « le premier collègue ». Ajoutez une distinction audible, comme une voix médium par rapport à une voix plus grave. Gardez les noms, les vêtements, la position et les voix cohérents dans tout le prompt. Ces repères rendent une réplique inversée plus facile à repérer.
L'identité visuelle compte parce que l'audio seul peut tromper un relecteur. Si les voix diffèrent mais que c'est la mauvaise bouche qui bouge, le clip a un problème de synchronisation labiale. Si la bonne bouche bouge mais que la voix de A change à la deuxième réplique de A, il y a une dérive vocale. L'exemple du café fait revenir A après B afin qu'un relecteur puisse vérifier si la voix de A reste cohérente.
Prévoir du temps pour la parole et la réaction
Lisez le script à voix haute au rythme voulu. Incluez une pause naturelle à chaque passage de parole, puis laissez de la place pour qu'un auditeur réagisse et pour que le plan d'ouverture établisse les deux visages. Le script de bureau révisé comporte 5 répliques en 12 secondes. Celui du café comporte 8 répliques courtes en 15 secondes, ce qui en fait le test de timing le plus exigeant ici. Ce sont des exemples de scripts, pas un seuil universel de mots par seconde ni une promesse sur la sortie.
| Budget de scène | Séquence parlée | Temps nécessaire au-delà des mots |
|---|---|---|
| Bureau 12 secondes | A-B-A-B-A | Établir les deux personnes et caser 4 passages |
| Café 15 secondes | Huit répliques en alternance | Sept passages avec peu de temps libre |
| Rue 12 secondes | A-B-A-B-A | Quatre passages par-dessus l'ambiance de rue |
Une réplique longue invite à la précipitation ou à l'omission vers la fin. Si le brouillon prend presque toutes les 15 secondes à lire à voix haute, raccourcissez-le avant la génération. Si le scénario nécessite plus de dialogue, prévoyez des plans séparés et vérifiez la continuité comme une autre tâche de production. Gardez les visages visibles pendant les répliques parlées lors du premier essai. Les coupes rapides et les bouches masquées rendent l'attribution des intervenants plus difficile à juger. Faites une lecture chronométrée à deux si l'ordre des répliques importe. Demandez à une personne de dire A et à l'autre B pendant qu'une troisième note où se termine chaque phrase. Si le dernier mot tombe à la limite du clip, supprimez une proposition ou un temps de réaction avant le rendu. Un script plus court est plus facile à auditer, car le relecteur peut rejouer tout l'échange sans devoir deviner si une réplique était censée se poursuivre hors écran.
Comment rédiger un prompt Gemini Omni 1.2 Flash pour 2 intervenants
Un prompt utile se lit comme un brief de tournage compact : décor et caméra, identités, dialogue exact, puis règles de son et d'exclusion. Cet ordre donne aussi au relecteur une liste de contrôle. C'est une méthode de prompting, pas une garantie documentée de contrôle. Gardez les libellés de personnages identiques du paragraphe d'identité au bloc de dialogue. Évitez de désigner la même personne à la fois comme A et « le client » dans des instructions sur une réplique ultérieure, sauf si la correspondance est déjà explicite. Un lecteur doit pouvoir tracer deux colonnes, une pour chaque personne, et placer chaque action demandée et chaque réplique parlée dans exactement une colonne.
Utiliser des libellés d'intervenants explicites et des répliques entre guillemets
Utilisez une ligne par réplique avec Speaker A: ou Speaker B: et les mots entre guillemets. Précisez qui reste silencieux. Demander « une discussion sur la préparation du lancement » laisse place à l'improvisation. Un script exact vous permet de repérer immédiatement un mot manquant ou réécrit.
Voici le premier prompt à copier. Il garde les deux adultes dans un seul plan continu pour que le spectateur puisse inspecter chaque bouche.
plaintext1Create a 12-second realistic video in one continuous medium two-shot in a quiet office. Two adult coworkers remain visible throughout. Speaker A is a woman on the left wearing glasses and a navy striped top, with a clear mid-pitched voice. Speaker B is a man on the right wearing a white shirt, with a lower voice. A points to an open laptop; B checks a notebook. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Only the named person speaks each line. The listener stays silent and reacts naturally. Keep each voice attached to the same person throughout. Show the correct mouth moving for every line, with brief natural pauses. Quiet room tone. No narrator, third voice, subtitles, music, or logos.
Rendu bureau fourni, 12 secondes, 720p. Les deux personnes restent visibles ; les cinq répliques parlées et la synchronisation labiale nécessitent encore une revue à l'écoute.
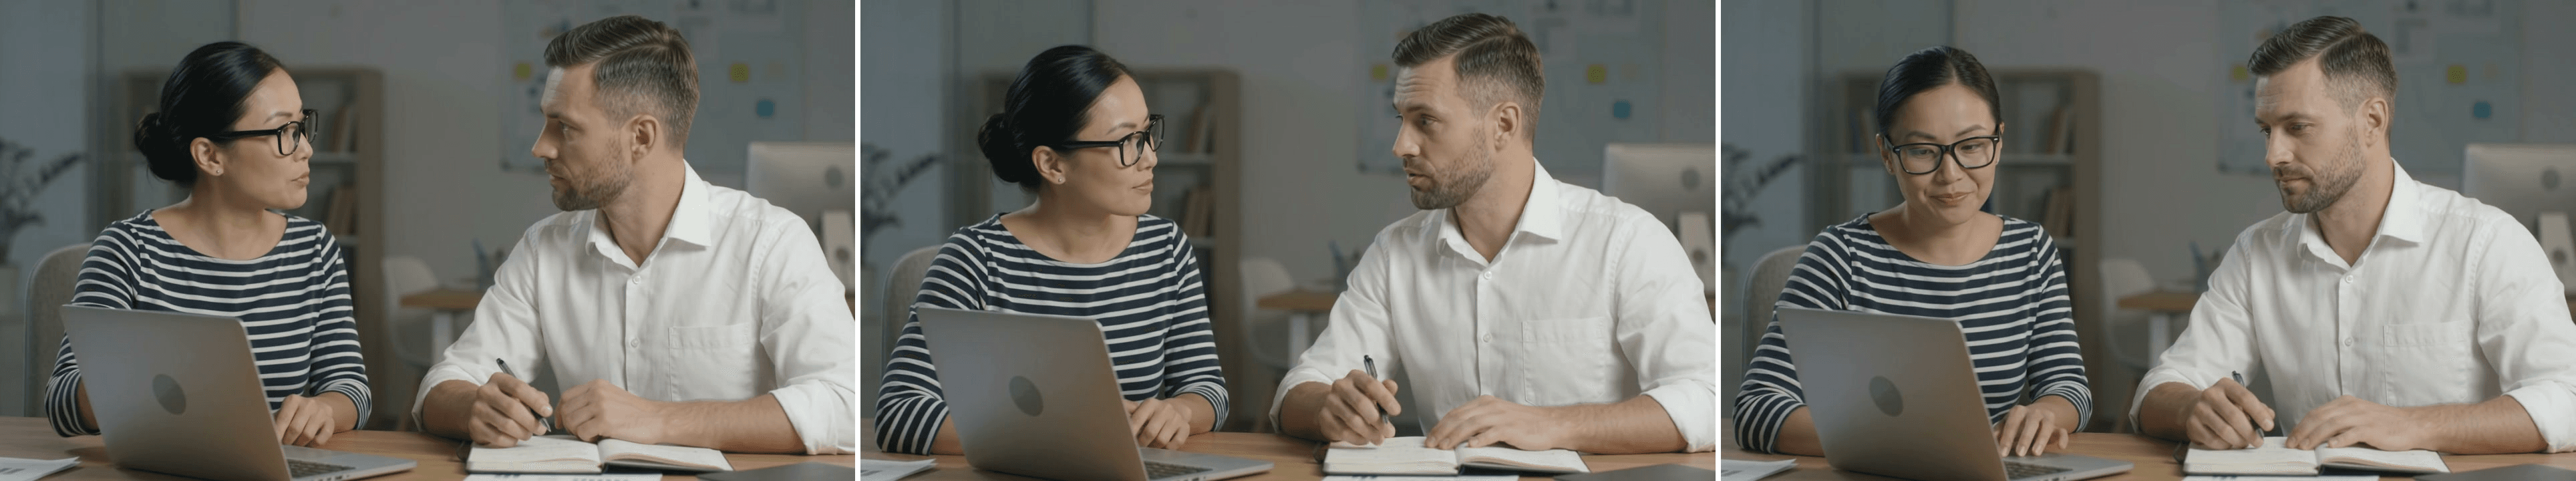 Images du cas A, de gauche à droite (environ 0:02, 0:05, 0:10) : la femme fait face à son collègue ; il semble répondre tandis que tous deux restent dans le cadre ; ils ramènent leur attention sur l'ordinateur portable et le carnet.
Contrôler la caméra sans perdre l'intervenant
Un plan moyen continu à 2 personnes est un choix diagnostique. Les deux visages restent visibles, donc un passage de parole manqué ne peut pas se cacher derrière le montage. Le modèle peut néanmoins faire varier le cadrage, c'est pourquoi le fichier final doit être inspecté.
Une fois que le passage de parole fonctionne pour votre objectif, essayez un mouvement modeste qui préserve les deux visages. Le prompt de rue en demande un dans un cadre 16:9 qui garde les deux visages visibles, ce qui facilite le jugement des mouvements de bouche. C'est une raison d'établir d'abord la référence du bureau.
Garder l'audio de fond sous le dialogue
Nommez l'ambiance et sa priorité. Un léger bruit de pièce donne au clip de bureau peu de choses pour concurrencer la parole. Un son de café doux ajoute du contexte tout en gardant les répliques testables. Le prompt de rue demande des pas et un son lointain sous les deux voix, sans parole de passants.
Les instructions négatives peuvent réduire les audio indésirables, mais elles restent des demandes. Écoutez attentivement pour repérer une troisième voix, une narration, de la musique et de l'audio de marque. Vérifiez aussi l'image pour les sous-titres et les logos.
3 scènes de dialogue qui montrent qui parle quand
Les trois fichiers vidéo fournis montrent les scènes prévues de bureau, de café et de rue. Leur contenu visuel peut être inspecté ici, mais les fichiers n'établissent pas quelle voie ou quels réglages les ont produits. Les prompts ci-dessous sont des demandes reproductibles, et non l'affirmation que la sortie a prononcé chaque mot correctement. Le bureau vérifie 5 répliques, le café teste 8 répliques rapides, et la rue ajoute du son environnemental.
| Cas | Demande du prompt | Fichier fourni | Vérification principale |
|---|---|---|---|
| A : passage bureau | 12s, 16:9, 5 répliques | 12s, 16:9, 720p | Cinq répliques, bouches correctes |
| B : échange au café | 15s, 16:9, 8 répliques | 15s, 16:9, 720p | Huit répliques, voix stables |
| C : interview de rue | 12s, 16:9, 5 répliques | 12s, 16:9, 720p | Audibilité de la rue et tours de parole |
Un passage de parole au bureau en cinq répliques
Utilisez le prompt complet et la vidéo ci-dessus. Les deux collègues restent dans le même plan, donc chacune des cinq répliques demandées a une personne visible à vérifier. Consignez chaque réplique audible par rapport au texte et inspectez la bouche active. Le fichier fourni établit la scène et la durée, mais ses mots et sa synchronisation labiale n'ont pas été vérifiés de manière indépendante.
Un passage de parole clair dans un clip étayerait une conclusion sur ce clip seul, et non un taux de réussite à l'échelle du modèle. Conservez le premier résultat afin que toute révision puisse être comparée à l'original.
Un échange au café en huit répliques
Demandez 15 secondes en 16:9. Huit répliques courtes mettent sous pression la constance de l'attribution des voix et le timing. Comparez la première et la dernière réplique de chaque personne, puis vérifiez si une réplique se chevauche ou disparaît. Le fichier fourni est en 720p.
plaintext1Create a 15-second realistic video in one continuous medium two-shot at a quiet café counter. Speaker A is an adult customer on the left in a cream sweater, holding a reusable cup, with a warm mid-pitched voice. Speaker B is an adult café worker on the right in a white shirt, with a lower voice. Both faces remain visible throughout. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Use a brisk but natural conversational pace. Do not rush or overlap the lines. Only the named person speaks each line; the other listens silently. Keep both voices consistent across all eight turns and match every line to the correct mouth. Soft café ambience stays below the dialogue. No extra speech, subtitles, music, or visible brands.
Un questions-réponses en extérieur
Demandez 12 secondes en 16:9. Cela ajoute un léger mouvement de caméra et du son environnemental. Le fichier fourni est en 16:9 à 720p et peut être examiné pour cinq tours de parole et l'audibilité de la rue.
plaintext1Create a 12-second 16:9 street interview in daylight. Keep two adults visible from the waist up throughout. Speaker A is the interviewer on the left in a dark checked shirt, holding a plain unbranded microphone, with a bright mid-pitched voice. Speaker B is the interviewee on the right in a tan jacket, with a deeper calm voice. Use a gentle sideways camera move that keeps both mouths in frame. 2 3Dialogue, spoken exactly in this order: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Only the named person speaks each line; the other listens silently. Keep both voices consistent and match every line to the correct mouth. Keep footsteps and distant street ambience below the dialogue. No bystander speech, narrator, music, captions, or logos.
Lecture combinée : 0:00–0:15 correspond au cas B, l'échange au café ; 0:15–0:27 correspond au cas C, l'interview de rue. Les deux clips sources sont inclus intégralement.
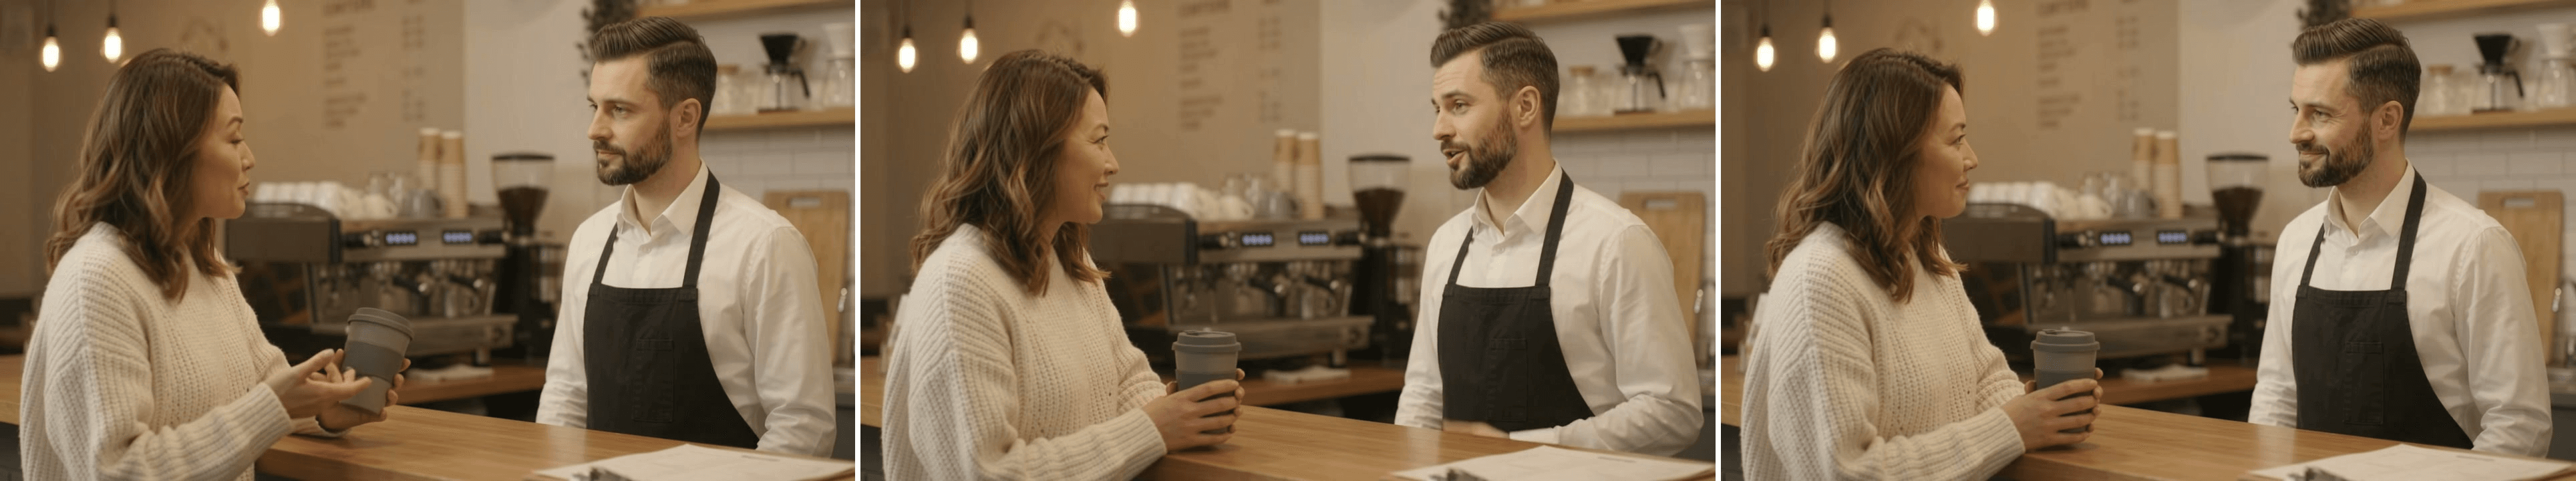 Images du cas B, de gauche à droite (environ 0:02, 0:08, 0:13 de la vidéo combinée) : la cliente montre sa tasse ; l'employé du café semble répondre ; ils se font face à la fin.
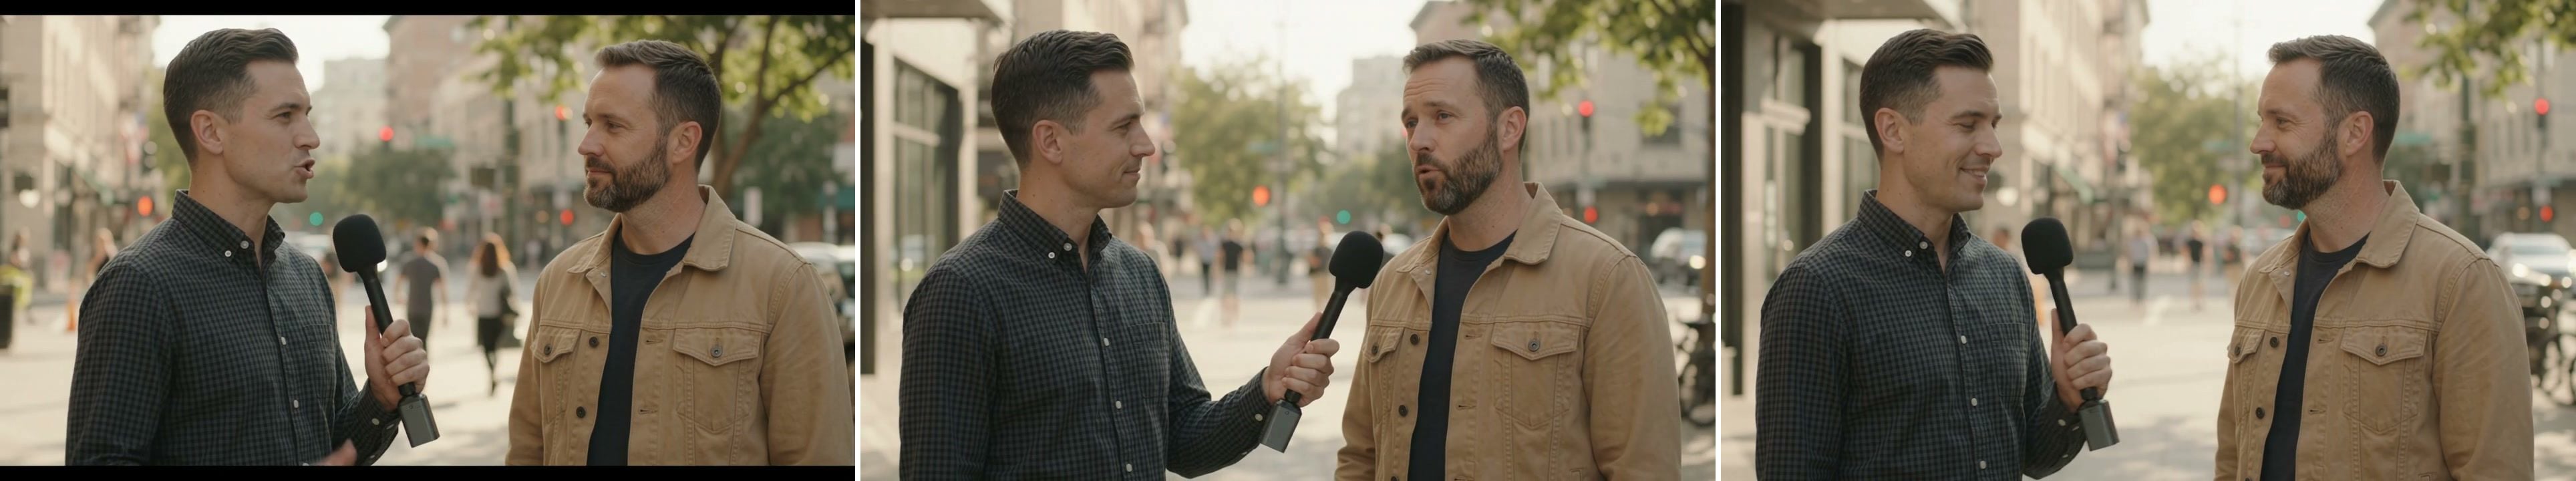
Images du cas C, de gauche à droite (environ 0:16, 0:19, 0:26 de la vidéo combinée) : l'intervieweur tient le microphone ; il le tourne vers l'interviewé ; ils se font face à la fin.
Vérifier l'ordre des intervenants, la synchronisation labiale et la dérive vocale avant publication
Examiner le clip réplique par réplique
Téléchargez la vidéo. Lancez-la une fois sans lire le script pour repérer les confusions évidentes, puis rejouez-la avec le prompt à côté. Mettez en pause à chaque réplique et notez ce que vous entendez. Inspectez les deux bouches et notez toute parole en dehors des répliques scénarisées. Pour une revue reproductible, consignez l'heure de début et de fin de chaque réplique audible, l'intervenant attendu, la voix entendue et la bouche visible qui a bougé. Écrivez « incertain » si un visage est masqué ou si le son masque un mot. Ne transformez pas une case incertaine en réussite parce que le reste de la scène semble convaincant. Un second auditeur qui n'a pas vu le prompt peut identifier qui, selon lui, parle ; comparez ce jugement au script avant de décider si un spectateur public comprendra la scène.
Vérifiez 4 choses pour chaque réplique :
- Mots : Les mots cités ont-ils été prononcés dans l'ordre, sans fin omise ni phrase ajoutée ?
- Propriétaire de la voix : La personne nommée ressemblait-elle bien à l'intervenant, surtout lorsque A est revenu ?
- Timing visible : La bouche de cette personne a-t-elle bougé pendant que l'auditeur restait silencieux ?
- Autre contenu : Le clip a-t-il ajouté un narrateur, un passant, des sous-titres, un logo ou de la musique ?
Une chronologie d'assurance qualité horodatée reste en attente tant que l'audio et les mouvements de bouche n'ont pas été examinés réplique par réplique.
Réviser une contrainte à la fois
Si la dernière réplique disparaît, raccourcissez le script ou accordez-lui plus de durée dans la limite de 15 secondes. Si le mauvais personnage parle, répétez la position visuelle et précisez que l'auditeur reste silencieux. Si l'ambiance couvre un mot, baissez-la ou supprimez-la. Si une coupe masque la bouche active, revenez à un plan continu à 2 personnes. Changez un seul facteur par nouvel essai afin que la sortie suivante réponde à une question claire.
Aucune de ces modifications ne garantit une correction. Si un rendu nécessite une révision, conservez son fichier, ses réglages et le problème que vous souhaitez résoudre. Un producteur peut alors décider si un autre rendu vaut le coût ou si des voix enregistrées et un montage manuel donneraient la précision nécessaire. Pour un échange court et visiblement parlé, commencez par le prompt du bureau et n'acceptez un clip qu'après la vérification réplique par réplique. C'est la norme pour le dialogue multi-intervenants de Gemini Omni 1.2 Flash.
Questions fréquentes
Gemini Omni 1.2 Flash peut-il conserver les mêmes voix d'un clip à l'autre ?
Qu'une voix reste reconnaissable au sein d'un même clip généré est une exigence plus étroite que de la préserver à travers des générations distinctes. Ces exemples en texte seul testent le premier cas. Ne promettez pas une identité vocale inter-clips à partir de ceux-ci. Une campagne nécessitant un intervenant récurrent doit mener un test de continuité distinct.
Gemini Omni 1.2 Flash peut-il générer du dialogue dans d'autres langues que l'anglais ?
Le modèle peut produire d'autres langues, mais ces prompts sont en anglais. Révisez la langue cible mot par mot avec un auditeur qui la maîtrise, y compris les noms, les nombres et les affirmations localisées. Le test linguistique réussi d'un autre créateur est une preuve pour ce test-là, pas une garantie pour votre script.
Comment garder chaque réplique attribuée au bon intervenant ?
Donnez à chaque personne une position visuelle et une voix, étiquetez chaque réplique citée et précisez qui reste silencieux pendant la réplique de l'autre personne. Révisez la vidéo générée réplique par réplique. Si un rendu ne respecte pas le brief, raccourcissez l'échange ou utilisez un flux de travail audio contrôlé pour une restitution exacte.
Combien de tours de dialogue tiennent dans un clip Gemini Omni 1.2 Flash de 15 secondes ?
Le prompt du café demande huit répliques brèves en 15 secondes, tandis que les prompts du bureau et de la rue demandent cinq répliques en 12 secondes. Ce sont des exemples de scripts, pas des limites garanties. Lisez les répliques à voix haute, prévoyez des pauses et raccourcissez-les si la dernière réplique atteint la fin du clip.
Gemini Omni 1.2 Flash a-t-il besoin d'une image de référence pour un dialogue à deux intervenants ?
Aucune image de référence n'est utilisée dans ces trois prompts texte-vers-vidéo. Ils décrivent la position, les vêtements et la voix de chaque intervenant dans le texte. Si un projet nécessite un visage ou un style visuel précis, testez une voie qui accepte les références et examinez sa sortie séparément.


