Réponse rapide
Une compétence de générateur vidéo IA sur GitHub connecte votre code aux modèles vidéo IA. En 2026, le choix entre open‑source (gratuit, auto‑hébergé) et API payantes (cloud, instantané) dépend de quatre variables : la disponibilité en VRAM, les exigences de confidentialité des données, le plafond de qualité nécessaire et le volume mensuel de génération. Pour les workflows de production nécessitant plusieurs modèles de pointe, Atlas Cloud (atlascloud.ai) donne accès à plus de 300 modèles — dont Kling v3.0, Seedance 2.0, Vidu 3.0, Veo et Sora — via une seule clé API avec une tarification transparente à l’usage.
Vous voulez comparer directement les modèles vidéo derrière ces outils ? La comparaison des modèles Atlas Cloud aligne les modèles d’image et vidéo côte à côte sur une même invite — avec le prix affiché avant de générer.
-
Qu’est‑ce qu’une compétence de générateur vidéo IA ? {#what-is-a-skill}
Dans le contexte des dépôts GitHub, une compétence de générateur vidéo IA est un module réutilisable, un wrapper ou une couche d’intégration qui relie une application à un backend de génération vidéo IA — qu’il s’agisse d’un modèle open‑source auto‑hébergé ou d’une API cloud.
Considérez‑la comme l’abstraction entre votre logique applicative et le moteur d’inférence proprement dit. Une compétence peut être :
- Une classe Python encapsulant le pipeline du modèle
Wan 2.2pour la génération texte‑vers‑vidéo - Un nœud personnalisé ComfyUI se connectant à l’API Atlas Cloud pour la génération Kling v3.0
- Un nœud de workflow n8n qui déclenche Seedance 2.0 via REST et renvoie une URL vidéo
- Un outil LangChain ou une compétence MCP Server qui appelle un endpoint de génération vidéo à la demande
La question centrale que tout développeur rencontre en en construisant une : le backend doit‑il être des poids open‑source exécutés localement, ou une API cloud payante ?
Des données réelles de 2026. Pas de la théorie.
-
Les projets open source GitHub en 2026 {#open-source-landscape}
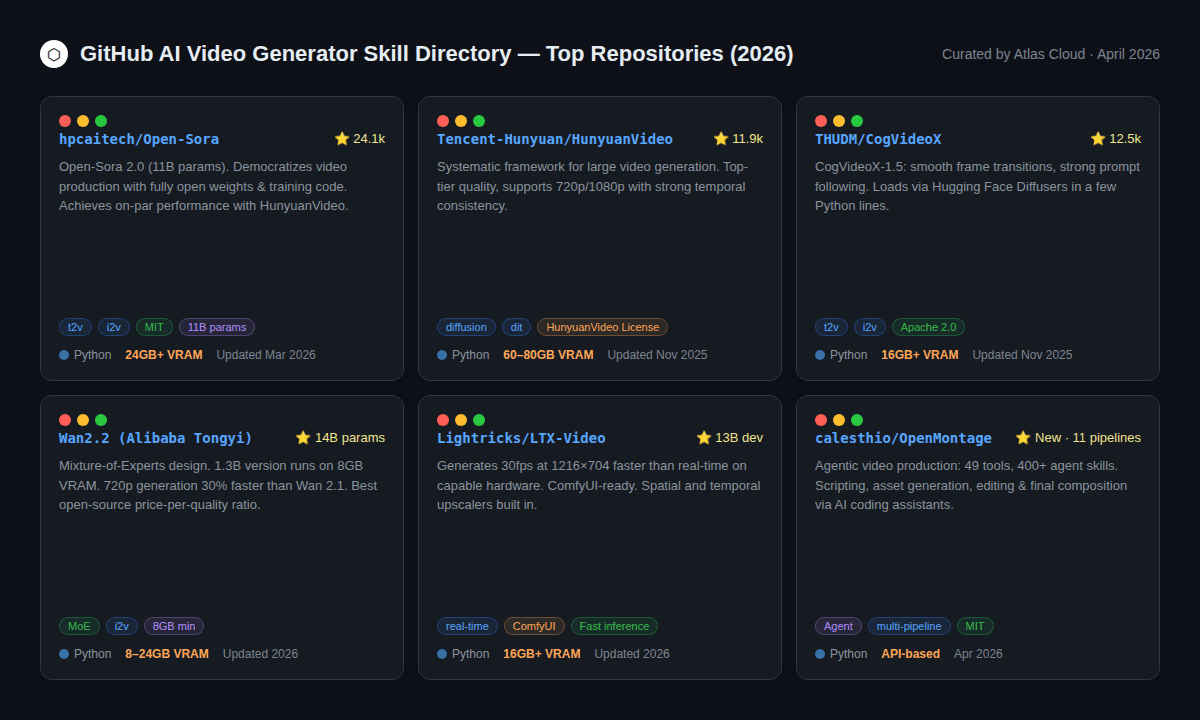
L’écosystème de génération vidéo open‑source a considérablement mûri. Certains dépôts sont désormais de véritables alternatives aux API payantes — du moins pour certaines tâches.
Niveau 1 : modèles open‑source prêts pour la production
HunyuanVideo (Tencent, 11,9k ⭐) — L’un des meilleurs générateurs vidéo open‑source. Gère la 720p et la 1080p. La principale limitation est son besoin matériel : 60 à 80 Go de VRAM pour le modèle complet, ce qui le rend accessible uniquement aux équipes disposant de GPU d’entreprise. La licence communautaire autorise une utilisation commerciale avec attribution.
CogVideoX‑1.5 (THUDM/CogVideo, 12,5k ⭐) Publié sous licence Apache 2.0, c’est l’un des modèles ouverts les plus adaptés aux développeurs. Il se charge nativement via Hugging Face Diffusers en quelques lignes de Python. Les transitions entre images sont fluides et le respect de l’invite est solide. Nécessite au minimum 16 Go de VRAM. Un bon choix si votre équipe vit déjà sur Hugging Face.
Open‑Sora 2.0 (hpcaitech, 24,1k ⭐) Le projet open‑source de génération vidéo le plus étoilé sur GitHub. La version 2.0 (11 milliards de paramètres) atteint des performances comparables à HunyuanVideo sur les benchmarks VBench, et le coût d’entraînement a été rapporté à environ 200 000 $ — un chiffre remarquable pour un modèle de cette envergure. Texte‑vers‑vidéo, image‑vers‑vidéo et génération de longueur infinie.
Niveau 2 : alternatives open‑source plus légères (moins de VRAM)
Wan 2.2 (Alibaba Tongyi) L’histoire d’accessibilité ici est convaincante : la variante 1,3B fonctionne sur 8 Go de VRAM, et la variante 14B sur 24 Go. L’architecture Mixture‑of‑Experts (MoE) offre plus de détails à moindre coût de calcul, et la version 2.2 est 30 % plus rapide en 720p que sa prédécesseure. Pour les développeurs disposant d’un seul GPU grand public, Wan 2.2 est la meilleure option open‑source.
LTX‑Video (Lightricks) Conçu avant tout pour la vitesse. Génère 30 ips en 1216×704 plus rapidement que le temps réel sur du matériel capable. L’intégration ComfyUI est mature, et les sur‑échantillonneurs spatiaux et temporels sont intégrés.
Niveau 3 : pipelines agentiques
OpenMontage (calesthio, nouveau en avril 2026) Une catégorie véritablement novatrice : un système de production vidéo agentique avec 11 pipelines, 49 outils et plus de 400 compétences d’agents. Fonctionne avec des assistants de codage IA comme Claude Code, Cursor et Copilot. Gère l’intégralité du pipeline — recherche, script, assets, montage — du début à la fin sans étapes manuelles. Conçu pour les équipes qui connectent plusieurs outils d’IA en un seul workflow.
-
Répertoire des API payantes : modèles de pointe disponibles maintenant {#paid-api-directory}
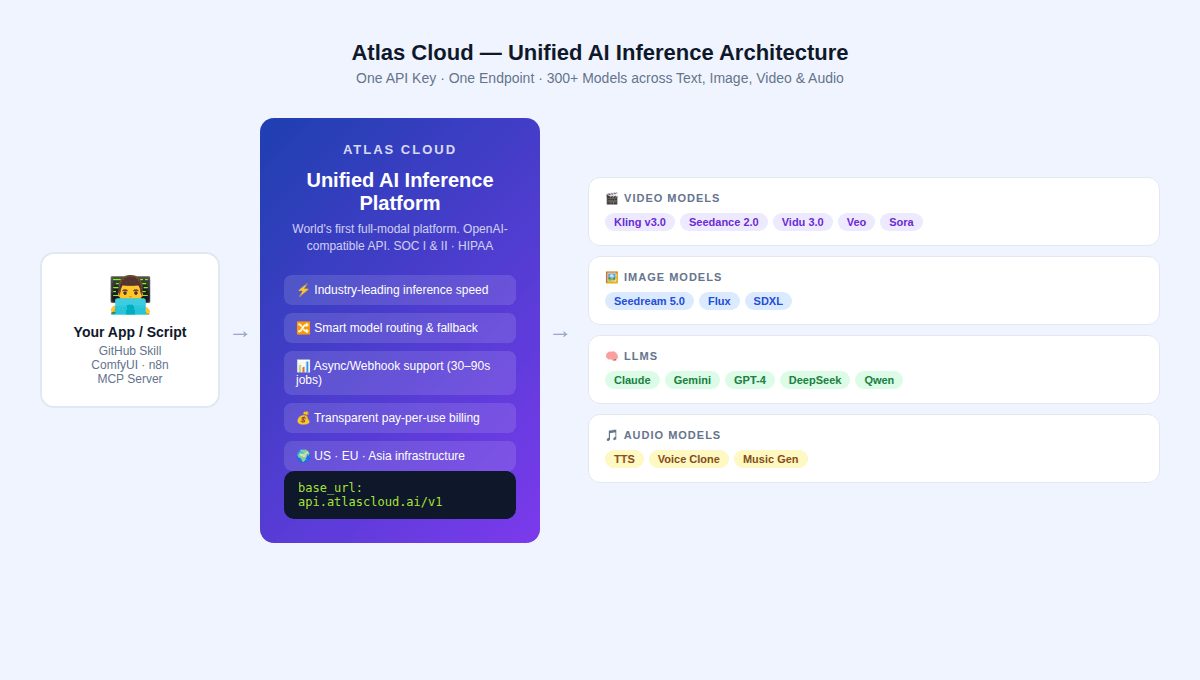
Le paysage des API payantes en 2026 est défini par trois grandes familles de modèles, chacune avec une approche technique distincte. Les trois sont disponibles via l’API unifiée d’Atlas Cloud.
Kling v3.0 (Kuaishou)
Sortie le 5 février 2026. Construit sur une architecture Visual Language multimodale — texte, images, audio et vidéo sont tous traités dans un seul système.
Ce qu’il fait réellement mieux que ses concurrents :
- Mouvements humains complexes — course, danse, arts martiaux — sans la déformation des « membres en spaghetti » qui affecte d’autres modèles
- Génération audio native multilingue (5 langues, avec mouvements labiaux synchronisés)
- Motion Brush : un outil qui permet aux développeurs (ou aux utilisateurs finaux) de peindre des trajectoires de mouvement directement sur les images sources — une fonctionnalité qui n’a actuellement pas d’équivalent dans les modèles concurrents
- Element Binding pour un suivi cohérent des personnages et des objets d’un plan à l’autre
Là où il est moins bon : La vitesse de rendu est plus lente que certains concurrents au niveau Pro. Les transitions de l’outil storyboard peuvent être « maladroites » selon des évaluateurs indépendants.
Idéal pour : Les vidéos courtes sur TikTok et Reels, les vidéos produits e‑commerce, tout ce qui nécessite un volume important avec des personnages qui restent réellement cohérents.
Seedance 2.0 (ByteDance)
Sortie le 8 février 2026, Seedance 2.0 représente un changement de paradigme dans la façon dont la vidéo IA est générée — passant d’une simple invite textuelle à un véritable contrôle basé sur des références, à la manière d’un réalisateur.
L’innovation technique centrale : Seedance 2.0 accepte des entrées quadrimodales — texte, image, vidéo et audio — simultanément. Son système « Universal Reference » permet à un développeur de fournir une vidéo de référence d’une personne dansant, et le modèle reproduit le mouvement de la caméra, les actions du personnage et la composition dans une sortie générée. Cela résout la cohérence des personnages d’une manière que les modèles purement text‑to‑video ne peuvent pas.
Les tests indépendants confirment qu’il excelle pour :
- Les récits multi‑plans avec une identité de personnage cohérente entre les coupes
- La génération audio‑vidéo synchronisée (architecture à double branche qui génère le son et la vidéo simultanément)
- La reproduction précise de la composition et de l’éclairage à partir des assets de référence
Note sur la disponibilité : Depuis avril 2026, l’accès à l’API internationale de Seedance 2.0 est disponible via des plateformes comme Atlas Cloud. L’accès direct à l’API BytePlus pour les développeurs internationaux a connu des incohérences de disponibilité — vérifiez l’état actuel avant de construire une dépendance sur les endpoints directs de ByteDance.
Idéal pour : Les clips musicaux, l’animation de personnages précise, les publicités produit où le mouvement doit être exact, les agences qui exécutent des workflows storyboard‑vers‑vidéo.
Vidu 3.0 (Shengshu AI / Tsinghua)
Construit sur l’architecture originale U‑ViT combinant les technologies Diffusion et Transformer, Vidu se concentre sur les domaines où la plupart des vidéos IA peinent encore : la cohérence environnementale et la cohérence cinématographique.
Caractéristiques distinctives :
- Système de référence universel pour un éclairage cohérent sur des séquences multi‑plans
- Génération intelligente de musique de fond qui s’adapte automatiquement à l’ambiance de la scène
- Génération de longue durée avec une forte cohérence temporelle (essentielle pour les séquences de plus de 5 secondes)
Meilleurs cas d’usage : Workflows de réalisation professionnelle, conception d’animation, publicité créative nécessitant une qualité cinématographique.
Sora 2 (OpenAI)
Sora 2 reste la référence en matière de précision de simulation physique. Brisez un verre dans une invite Sora 2 et le motif de fragmentation, la physique des fluides et les réflexions se comportent tous comme dans la réalité — la plupart des concurrents ne peuvent toujours pas égaler ce niveau de cohérence.
Idéal pour : Les effets visuels, la visualisation architecturale, les images d’illustration documentaires, partout où la précision physique compte plus que l’économie d’argent.
Tarification : Sora 2 a la facture la plus élevée dans cette catégorie. Vous payez pour la puissance de calcul.
-
Coûts d’inférence : les vrais chiffres {#inference-costs}
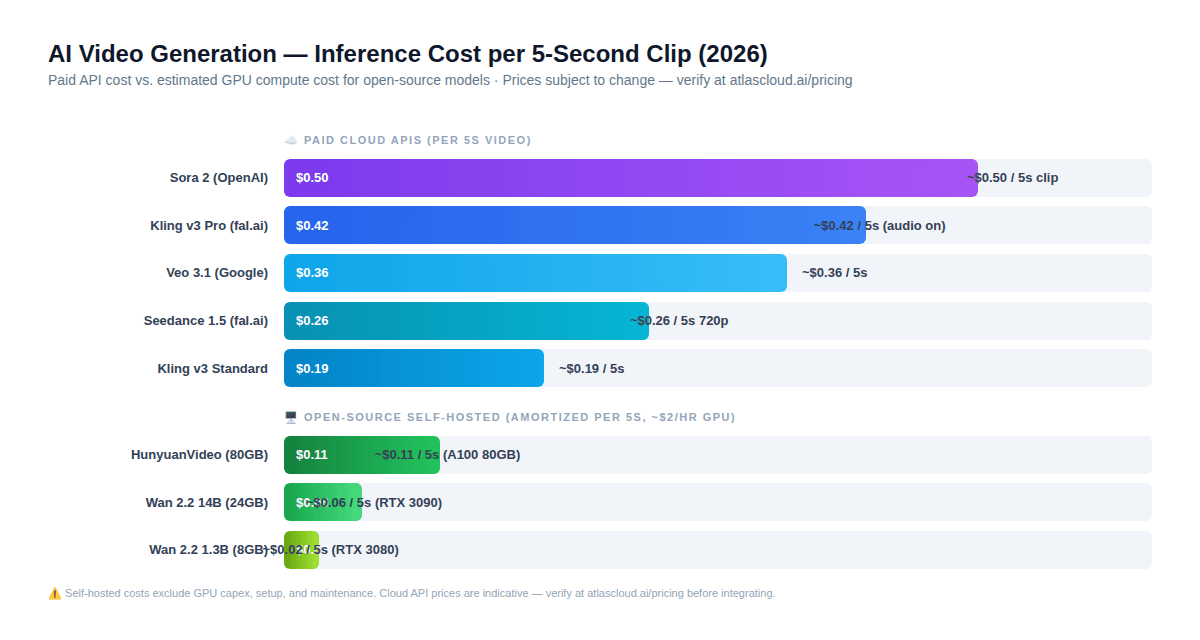
Cette section contient la découverte contre‑intuitive la plus importante de tout ce guide — celle qui change l’intuition par défaut de la plupart des développeurs concernant l’open‑source par rapport aux API payantes.
Le coût caché des modèles auto‑hébergés
La plupart des développeurs supposent : « Open‑source = gratuit = toujours moins cher. »
Cette hypothèse est fausse pour la plupart des tailles d’équipe.
Voici ce que donne le calcul réel pour un clip vidéo de 5 secondes en 2026 :
Open‑source auto‑hébergé (coût GPU amorti à ~2 $/h) :
- Wan 2.2 1.3B (RTX 3080) : ~0,02 $ par clip de 5 s
- Wan 2.2 14B (RTX 3090) : ~0,06 $ par clip de 5 s
- HunyuanVideo (A100 80 Go) : ~0,11 $ par clip de 5 s
API cloud payante (tarification indicative — vérifier sur atlascloud.ai/pricing) :
- Kling v3 Standard : ~0,19 $ par clip de 5 s
- Seedance 1.5 720p avec audio : ~0,26 $ par clip de 5 s
- Kling v3 Pro avec audio : ~0,42 $ par clip de 5 s
- Sora 2 : ~0,50 $ par clip de 5 s
Les chiffres de l’auto‑hébergement semblent séduisants isolément. Le problème est qu’ils excluent :
- 1. Le matériel GPU — Un A100 80 Go coûte entre 10 000 et 15 000 $. À 1 000 vidéos par mois (~0,11 $ chacune), il vous faudrait plus de 9 000 mois pour simplement amortir le matériel.
- Le temps de configuration — Configuration CUDA, téléchargement des poids du modèle, gestion de la VRAM et débogage représentent 20 à 40 heures de développement pour la mise en place initiale.
- La maintenance continue — Mises à jour des modèles, conflits de dépendances et fiabilité de l’infrastructure sont des coûts de temps permanents.
- Le coût d’opportunité — Le temps passé sur l’infrastructure d’inférence est du temps non passé sur le produit.
La condition limite pratique :
L’auto‑hébergement n’est rentable que si : (a) vous avez déjà des GPU qui exécutent d’autres charges de travail, (b) vous produisez plus de 5 000 vidéos par mois, ou (c) les réglementations vous obligent à tout garder sur site.
En dessous de ce seuil, les API payantes — en particulier les plateformes unifiées comme Atlas Cloud — sont moins chères lorsque le coût total de possession est calculé honnêtement.
-
Limites de débit et latence des API — ce que les développeurs rencontrent réellement {#rate-limiting}
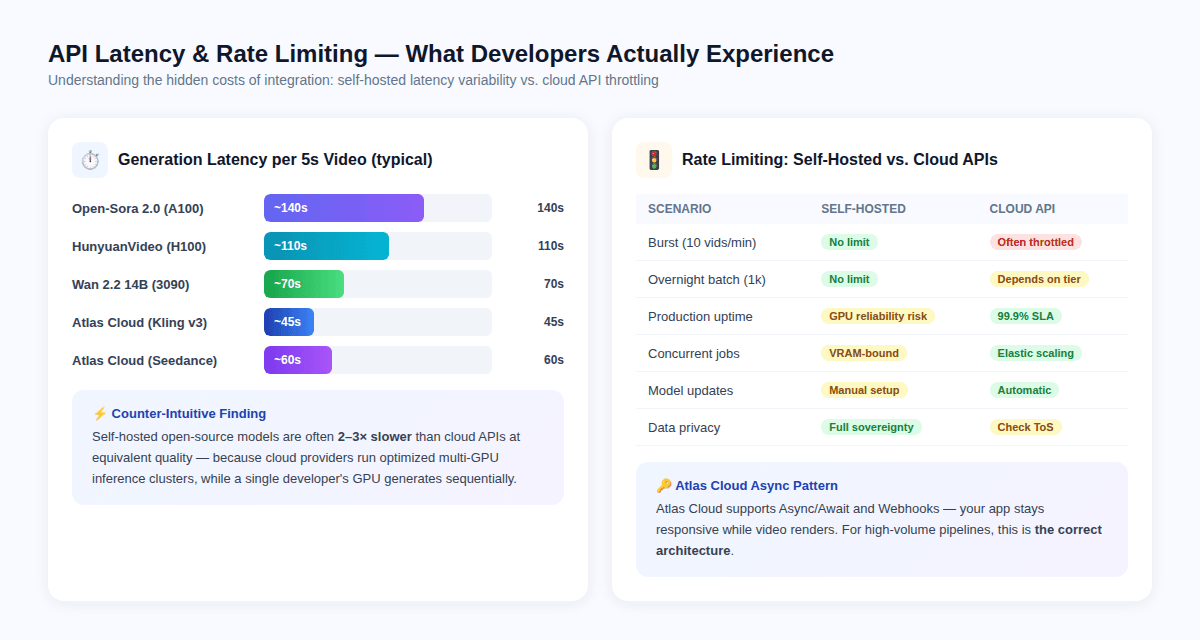
Le paradoxe de la latence
Contre‑intuitivement, les API cloud sont souvent plus rapides par vidéo que les modèles auto‑hébergés — non pas parce que les modèles sont différents, mais parce que les fournisseurs cloud exploitent des clusters d’inférence multi‑GPU optimisés avec un traitement par lots au niveau matériel, tandis qu’un seul GPU de développeur génère les images séquentiellement.
Latence typique par clip de 5 secondes :
- Open‑Sora 2.0 sur A100 : ~140 secondes
- HunyuanVideo sur H100 : ~110 secondes
- Wan 2.2 14B sur RTX 3090 : ~70 secondes
- Atlas Cloud / Kling v3 : ~45 secondes
- Atlas Cloud / Seedance 2.0 : ~60 secondes
Cela signifie que construire une compétence GitHub autour d’un modèle auto‑hébergé peut produire des temps d’attente plus longs pour l’utilisateur final, même si le coût par vidéo est inférieur.
Limites de débit : la réalité en production
Les modèles auto‑hébergés n’ont pas de limites de débit imposées par l’API — ils sont uniquement limités par la VRAM de votre GPU et ses limites thermiques.
Les API payantes imposent des limites de débit qui varient selon le niveau de tarification. Les implications techniques pertinentes :
- Les requêtes en rafale (10+ vidéos par minute) déclencheront une limitation sur la plupart des niveaux d’API payants
- Les traitements par lots nocturnes (1 000+ vidéos) nécessitent une conception asynchrone minutieuse pour éviter les délais d’attente
- Les requêtes simultanées sur des modèles auto‑hébergés sont limitées par la VRAM — exécuter 2 inférences simultanées d’un modèle 14B sur une seule carte de 24 Go n’est généralement pas possible
Atlas Cloud résout le problème des limites de débit grâce à une architecture Async/Webhook : votre application soumet un travail de génération, reçoit un identifiant de tâche et est notifiée via webhook lorsque le rendu est terminé. Ce modèle empêche les blocages de l’application pendant le rendu vidéo et s’adapte correctement aux charges de travail par lots.
L’architecture correcte pour la production
plaintext1# Atlas Cloud Async Pattern — Production-Ready 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Submit generation task 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Product showcase reel, smooth motion, 9:16 aspect ratio", 14 size="1080x1920", 15 n=1 16) 17 18# Handle async response 19video_url = response.data[0].url 20print(f"Video generated: {video_url}")
Pour les workflows image‑vers‑vidéo, notez que certains modèles — dont certaines variantes i2v de Kling — n’acceptent pas de paramètre de rapport hauteur/largeur séparé pour la génération image‑vers‑vidéo ; la résolution de sortie suit les dimensions de l’image d’entrée. Construisez votre génération d’image en amont avec le bon ratio cible.
-
Hébergement local vs. API cloud : la matrice des compromis {#local-vs-cloud}
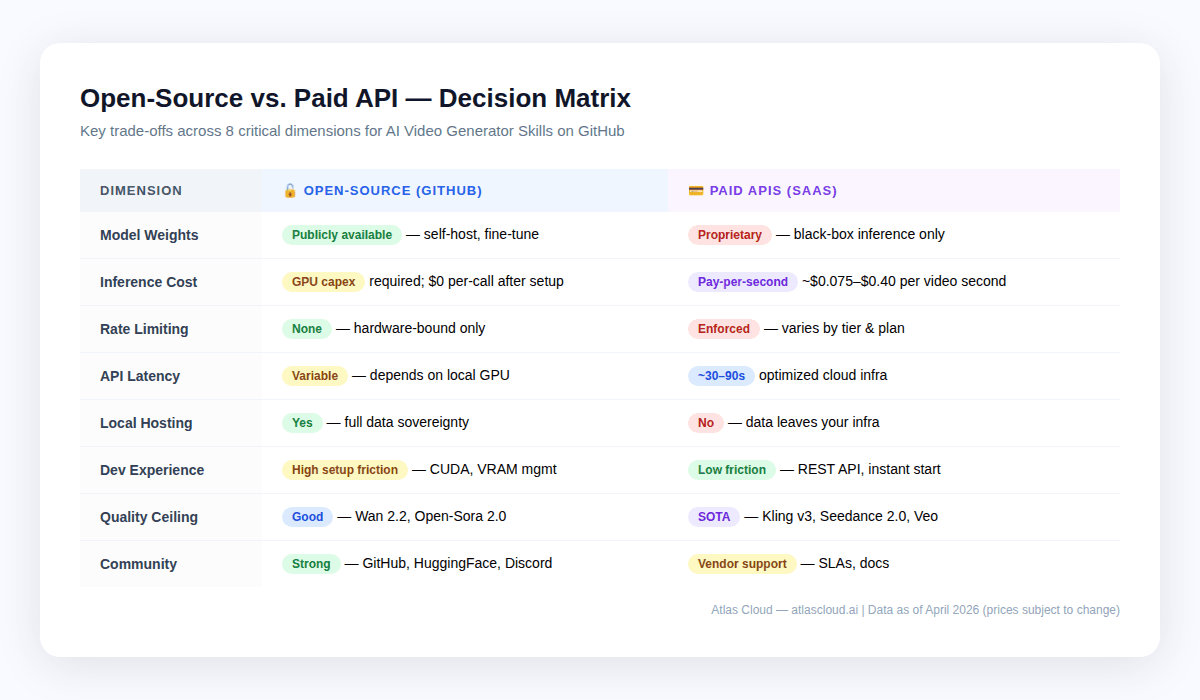
Ce n’est pas l’un ou l’autre. La plupart des pipelines de production mélangent les deux : open‑source pour le prototypage et les passes de masse de faible qualité, API cloud pour les rendus finaux et la qualité de pointe.
Quand l’hébergement local a du sens
- Contraintes de conformité — HIPAA, RGPD, ou tout ce qui est propriétaire et ne peut pas quitter vos serveurs. L’auto‑hébergement est votre seule option. Atlas Cloud est conforme HIPAA et certifié SOC I & II, ce qui couvre la plupart des besoins des entreprises, mais les environnements réglementés doivent vérifier leurs exigences spécifiques.
- Volume très élevé à qualité acceptable — les équipes générant 10 000+ vidéos par mois avec le niveau de qualité de Wan 2.2 peuvent constater que les coûts de location de GPU sont inférieurs aux frais d’API à cette échelle.
- Recherche et fine‑tuning — les poids des modèles ouverts permettent le fine‑tuning sur des ensembles de données propriétaires. Aucune API cloud n’offre actuellement d’entraînement de modèle personnalisé.
- Environnements isolés — déploiement en périphérie sans connectivité ou réseaux verrouillés.
Quand les API cloud gagnent
- Time‑to‑market — une intégration Atlas Cloud prend des heures, pas des semaines
- Qualité de premier ordre — les leaders open‑source comme Wan 2.2 et Open‑Sora 2.0 sont encore en retard par rapport aux modèles propriétaires tels que Kling v3 et Seedance 2.0, surtout sur le mouvement humain, la cohérence des plans et l’audio natif
- Charges de travail irrégulières — les API cloud montent et descendent en charge ; vos propres GPU ne le font pas
- Volume plus faible — en dessous de ~5 000 vidéos par mois, les API cloud sont généralement gagnantes sur le coût total
- Flexibilité multi‑modèles — le catalogue de plus de 300 modèles d’Atlas Cloud vous permet de passer de Kling à Seedance à Veo au sein d’une seule intégration
-
Développement piloté par la communauté vs. par le fournisseur {#community-vs-vendor}
Facile à ignorer lorsqu’on compare des API, mais cela compte vraiment si vous construisez des compétences GitHub.
Piloté par la communauté (open‑source) :
- N’importe qui peut soumettre des corrections de bugs et demander des fonctionnalités — et les voir fusionnées
- La documentation est souvent excellente car la base d’utilisateurs contribue avec des exemples
- Les changements cassants dans les API des modèles se produisent lentement, avec des périodes de préavis publiques
- Les communautés ComfyUI et Hugging Face Diffusers disposent de bibliothèques approfondies de workflows prêts à l’emploi, d’adaptateurs LoRA et de checkpoints affinés
- Les articles de recherche sont publiés avec un code reproductible ouvert
Développement piloté par le fournisseur (API payantes) :
- La stabilité de l’API est régie par des SLA commerciaux — les changements cassants sont moins fréquents mais se produisent
- Les nouvelles versions de modèles (par exemple, Kling 3.0 en février 2026, trois jours avant Seedance 2.0) sortent à un rythme concurrentiel et souvent sans préavis
- Les améliorations des modèles sont déployées côté serveur sans aucune action du développeur
- La documentation technique est maintenue professionnellement
L’implication pratique pour les auteurs de compétences GitHub : si vous écrivez une compétence qui doit rester stable et peu exigeante en maintenance, une API cloud avec des contrats d’endpoint stables est plus facile à maintenir qu’une compétence liée à une version spécifique d’un modèle open‑source. Inversement, si votre compétence est conçue pour donner aux développeurs un accès aux derniers modèles de recherche sans frais d’API, l’écosystème open‑source est là où ce travail se fait.
-
Étude de cas : Agence de médias sociaux (500 vidéos/mois) {#case-study-1}
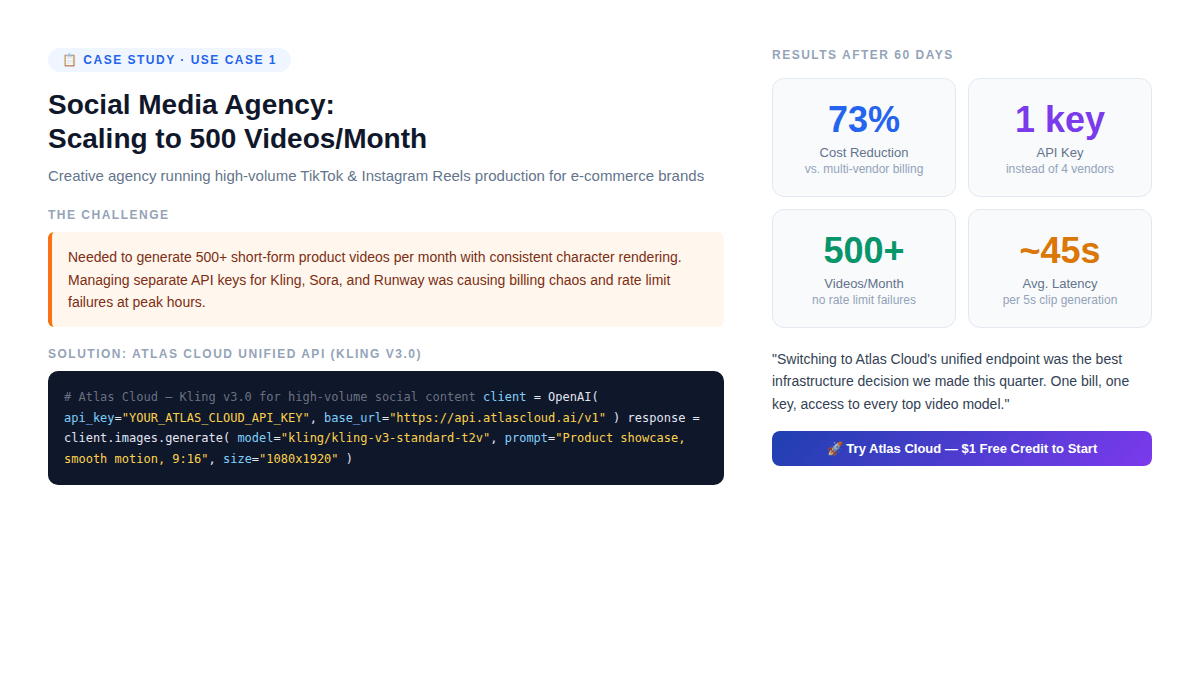
Le contexte : Une agence créative qui réalise de courtes vidéos produits pour 20 clients e‑commerce. Elle a besoin de 500 vidéos par mois, des personnages qui se ressemblent d’un clip à l’autre, du format vertical 9:16, de 5 à 10 secondes chacune, traitées par lots en dehors des heures de pointe.
Architecture initiale (avant Atlas Cloud ) :
- Des clés API séparées pour Kling, RunwayML et Pika
- Trois tableaux de bord de facturation, trois pools de limites de débit
- Sélection manuelle du modèle par client
- Échecs de limites de débit aux heures de pointe entraînant des retards de livraison
Problème ainsi créé : Lorsque Kling a sorti v3.0, l’agence a dû ré‑intégrer un nouveau SDK, mettre à jour la facturation et tester la compatibilité — trois fois pour trois fournisseurs.
Solution : Atlas Cloud API unifiée avec Kling v3.0 Standard
plaintext1# Atlas Cloud — Social Media Video Pipeline 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, smooth motion, cinematic lighting, 9:16 vertical format", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Résultats après 60 jours :
- 73 % de réduction du coût par vidéo (facture unique, pas de majoration par fournisseur)
- Zéro échec de limite de débit (l’infrastructure élastique d’Atlas Cloud a absorbé les pics de charge)
- Le changement de modèle de Kling à Seedance pour certains clients a pris moins de 2 minutes (modification d’un paramètre)
- Le bonus de 20 % sur le premier dépôt a effectivement compensé les coûts de production du premier mois
La découverte non évidente : L’agence n’a pas réduit le nombre de fournisseurs parce que Kling s’est amélioré. Elle l’a réduit parce que gérer plusieurs relations fournisseurs à 500 vidéos/mois a un coût opérationnel non négligeable qui n’apparaît pas dans la tarification par API.
-
Étude de cas : Développeur indépendant créant un SaaS vidéo {#case-study-2}
Le contexte : Un développeur solo construit un outil « texte vers démo produit » pour les startups en phase de démarrage. Besoin de plusieurs styles — cinématographique, animé, prise de vue réelle. Doit valider rapidement et garder l’infrastructure sous 200 $/mois tout en découvrant si quelqu’un en veut vraiment.
Décision architecturale :
Le développeur a d’abord envisagé d’auto‑héberger Wan 2.2 sur une instance A100 louée (~2 $/h). Pour 100 vidéos de test lors de la validation, le coût était estimé à ~6 $ en temps GPU. Cela semblait moins cher qu’Atlas Cloud.
Ce que le calcul a oublié :
- La mise en place du pipeline Wan 2.2 a pris 3 jours (dépendances CUDA, gestion de la VRAM, configuration du serveur)
- L’écart de qualité de sortie de Wan 2.2 par rapport à Kling v3 signifiait que le SaaS ne pouvait pas facturer le prix visé
- La gestion de la disponibilité du serveur ajoutait ~2 heures/semaine de maintenance continue
Architecture révisée avec Atlas Cloud :
plaintext1# Flexible model routing — switch based on user tier 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Lower cost 4 "pro": "kling/kling-v3-professional-t2v", # Higher quality 5 "enterprise": "bytedance/seedance-2.0" # Max control 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Résultat : Le développeur a lancé en 4 jours au lieu de 3 semaines. L’utilisation de Seedance 2.0 pour le niveau premium a justifié un prix 3× supérieur à celui du niveau gratuit, et la structure de modèles à plusieurs niveaux a été construite avec une seule clé Atlas Cloud — pas trois intégrations de fournisseurs distinctes.
-
L’avantage Atlas Cloud : pourquoi « une API unique » est la bonne architecture {#atlas-cloud-advantage}
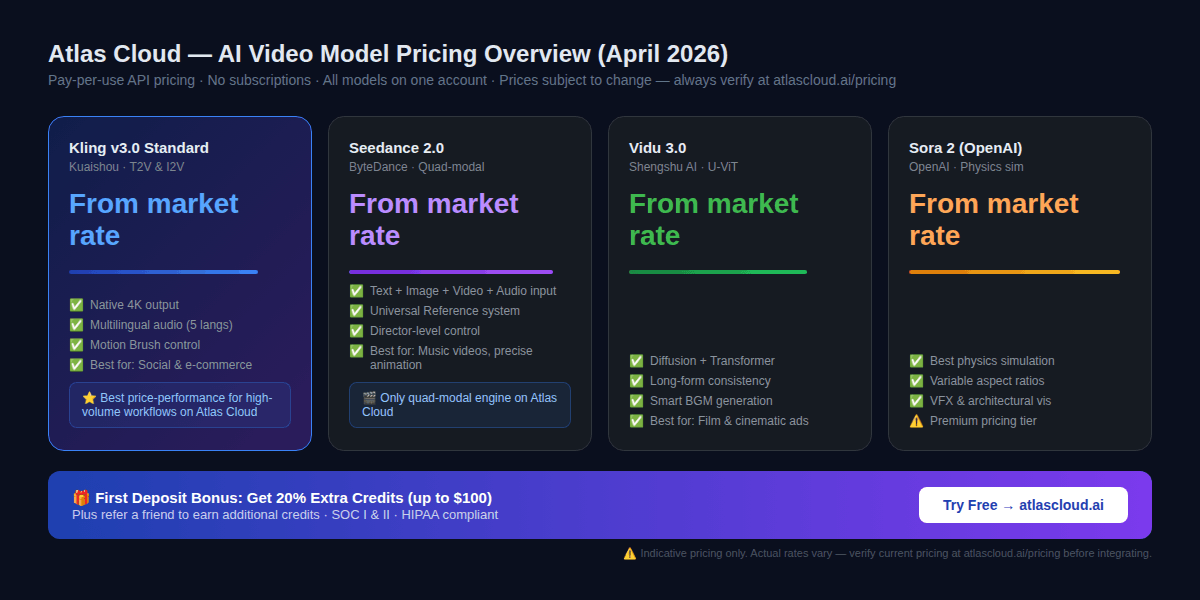
Atlas Cloud se positionne comme la première plateforme d’inférence IA multimodale complète — une API unifiée desservant plus de 300 modèles de génération de texte, d’image, de vidéo et d’audio.
Pour les auteurs de compétences de générateur vidéo IA GitHub, les avantages spécifiques sont :
-
API compatible OpenAI (remplacement direct)
Atlas Cloud utilise un endpoint compatible OpenAI. Si votre compétence s’intègre déjà avec le SDK OpenAI, passer à Atlas Cloud pour la génération vidéo nécessite de modifier deux lignes : api_key et base_url. Pas de nouveau SDK, pas de nouveau système d’authentification.
-
Facturation unique pour les workflows multi‑modèles
Les workflows vidéo de production utilisent rarement un seul modèle. Un pipeline typique peut utiliser :
- Seedream 5.0 pour la génération d’images (images de départ)
- Kling v3.0 pour la conversion image‑vers‑vidéo
- Un LLM (Claude, GPT‑4 ou DeepSeek) pour l’optimisation des invites
- Un modèle TTS pour la narration vocale
Avec des comptes fournisseurs séparés, cela représente quatre relations de facturation, quatre pools de limites de débit et quatre points d’intégration. Avec Atlas Cloud, c’est une clé API et une seule facture.
-
Transparence des prix par modèle
Atlas Cloud publie les prix par modèle sans frais de calcul cachés. Le modèle économique est simple : vous payez pour ce que vous générez. Les nouveaux développeurs reçoivent un bonus de 20 % sur leur premier dépôt (jusqu’à 100 $), et un programme de parrainage offre des crédits supplémentaires. Vérifiez toujours les prix actuels sur atlascloud.ai/pricing avant d’établir des projections financières.
-
Couverture de conformité
Pour les compétences GitHub d’entreprise déployées dans des environnements réglementés : Atlas Cloud est certifié SOC I & II et conforme HIPAA, avec une infrastructure répartie dans les régions USA, UE et Asie. Cela couvre la majorité des exigences de résidence des données des entreprises.
-
Intégration ComfyUI, n8n et MCP Server
Atlas Cloud s’intègre nativement avec les outils les plus couramment utilisés pour construire des compétences de génération vidéo GitHub :
- ComfyUI — nœuds personnalisés pour l’écriture de workflows visuels
- n8n — automatisation de workflows avec des étapes de génération vidéo Atlas Cloud
- MCP Server — intégration du protocole de contexte de modèle pour les frameworks d’agents IA
-
Quelle stack utiliser réellement ? {#decision-guide}
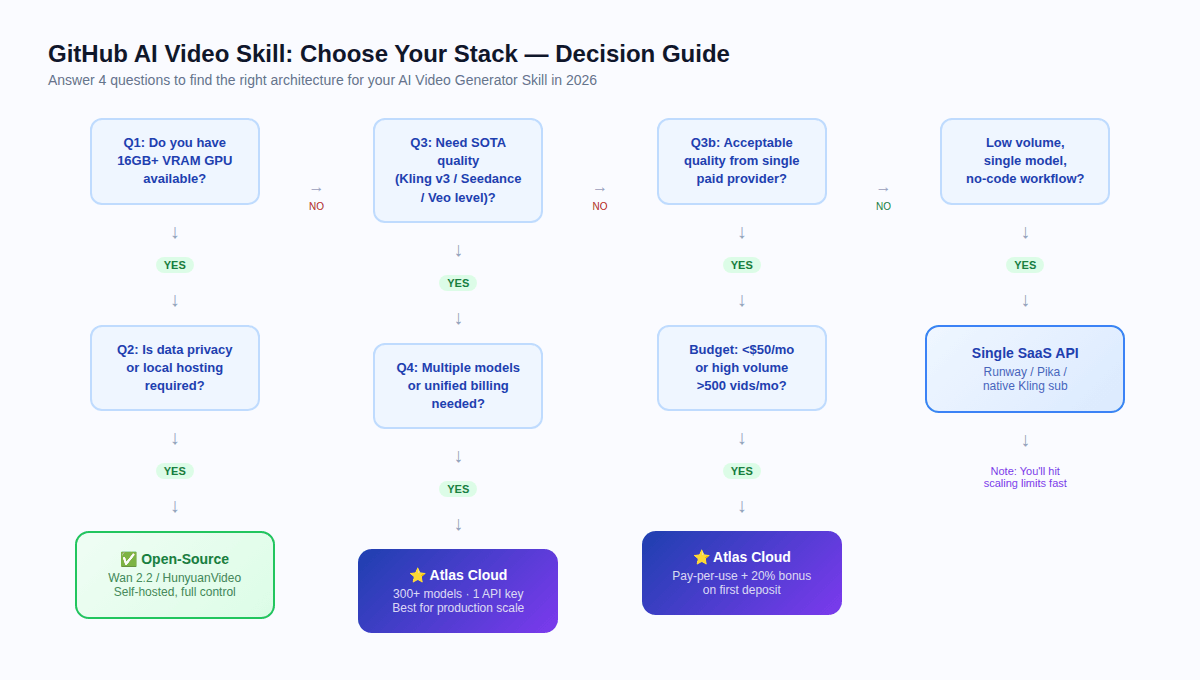
Passez en revue ces quatre questions :
Q1 : Disposez‑vous d’un GPU avec 16 Go+ de VRAM ?
Si non → sautez l’auto‑hébergement complètement. L’API cloud est votre seul chemin pratique.
Q2 : La confidentialité des données ou l’hébergement local sont‑ils imposés par la réglementation ?
Si oui + GPU disponible → évaluez l’open‑source (Wan 2.2 ou HunyuanVideo selon la VRAM).
Si oui + pas de GPU → utilisez Atlas Cloud (conforme HIPAA, certifié SOC) et examinez vos exigences réglementaires spécifiques.
Q3 : Avez‑vous besoin de la qualité de pointe (niveau Kling v3, Seedance 2.0, Veo) ?
Si oui → API cloud requise. Les modèles open‑source présentent un écart de qualité significatif par rapport aux meilleurs modèles propriétaires en 2026.
Si une qualité acceptable au niveau open‑source suffit → Wan 2.2 auto‑hébergé peut fonctionner.
Q4 : Avez‑vous besoin de plusieurs modèles ou d’une facturation unifiée ?
Si oui → Atlas Cloud. Gérer trois comptes fournisseurs à grande échelle a un coût opérationnel caché qui ne devient visible qu’en volume de production.
Recommandations résumées par cas d’usage
| Cas d’usage | Stack recommandée |
| Recherche / prototypage | Open‑source (Wan 2.2, CogVideoX) |
| Agence médias sociaux, 500+/mo | Atlas Cloud + Kling v3.0 |
| Clip musical / animation de personnage | Atlas Cloud + Seedance 2.0 |
| Effets visuels / simulation physique | Atlas Cloud + Sora 2 |
| Souveraineté des données / hors ligne | Auto‑hébergé (HunyuanVideo, Open‑Sora 2.0) |
| SaaS avec qualité de modèle par niveau | Atlas Cloud (une clé, plusieurs modèles) |
| Lot open‑source à volume élevé | Wan 2.2 auto‑hébergé (seuil 10 000+/mo) |
-
FAQ {#faq}
Q : Qu’est‑ce qu’une compétence de générateur vidéo IA ?
Un module de code réutilisable ou une couche d’intégration qui relie une application à un backend de génération vidéo IA — soit des poids open‑source, soit une API cloud. Formes courantes : classe Python, nœud ComfyUI, workflow n8n, outil MCP Server.
Q : Quelle est la VRAM minimale pour auto‑héberger un modèle vidéo open‑source ?
8 Go de VRAM pour Wan 2.2 1.3B (qualité acceptable pour des clips courts). 16 Go pour CogVideoX‑1.5 ou Open‑Sora (meilleure qualité). 24 Go+ pour Wan 2.2 14B. 60 à 80 Go pour HunyuanVideo ou Open‑Sora 2.0 modèle complet.
Q : La génération vidéo IA open‑source est‑elle réellement gratuite ?
Les poids du modèle sont gratuits. L’inférence n’est pas gratuite — elle nécessite du calcul GPU. À faible volume (<5 000 vidéos/mois), les API cloud comme Atlas Cloud sont généralement moins chères lorsque le coût total de possession est calculé.
Q : Puis‑je utiliser Atlas Cloud pour des workflows image‑vers‑vidéo (i2v) ?
Oui. Atlas Cloud prend en charge les variantes i2v pour Kling, Seedance et Vidu. Note : pour les modèles i2v, certaines variantes n’acceptent pas de paramètre de rapport hauteur/largeur séparé — la résolution de sortie suit les dimensions de l’image d’entrée.
Q : Comment Atlas Cloud gère‑t‑il les limites de débit ?
Atlas Cloud prend en charge les modèles Async/Webhook. Les travaux de génération vidéo sont soumis en tant que tâches ; votre application reçoit un identifiant de tâche et est notifiée lorsque le rendu est terminé. Cela évite le blocage à grande échelle.
Q : Quel est le meilleur modèle pour la cohérence des personnages entre les plans ?
Le système Universal Reference de Seedance 2.0 est la solution la plus avancée en 2026. Il permet de fournir des vidéos, images et audio de référence pour maintenir une apparence et un mouvement cohérents du personnage dans les clips générés.
Q : Atlas Cloud prend‑il en charge ComfyUI ?
Oui. Atlas Cloud dispose d’une intégration ComfyUI native, ainsi que de nœuds n8n et d’une compatibilité MCP Server.
Q : Comment les modèles vidéo open‑source gèrent‑ils les rapports hauteur/largeur ?
Cela varie selon le modèle. Open‑Sora prend en charge 16:9, 9:16, 1:1 et 2.39:1 via le paramètre --aspect_ratio. Wan 2.2 et LTX‑Video prennent en charge plusieurs ratios. Pour les workflows i2v, la plupart des modèles suivent le rapport hauteur/largeur de l’image d’entrée, quels que soient les paramètres spécifiés.
Résumé
Le paysage de 2026 se divise en deux camps, chacun avec son point fort :
L’open‑source a du sens si vous avez des GPU de rechange, vous produisez plus de 10 000 vidéos par mois, les données ne peuvent pas quitter vos serveurs ou vous devez faire du fine‑tuning sur vos propres séquences propriétaires.
Les API payantes sont le meilleur choix si vous avez besoin de la meilleure qualité disponible, la vitesse prime sur le coût, vous êtes en dessous de 5 000 vidéos par mois, ou vous voulez mélanger plusieurs modèles sans jongler avec des contrats de fournisseurs.
Atlas Cloud fait le pont entre les deux : en tant que plateforme unifiée donnant accès à plus de 300 modèles — y compris les meilleurs modèles open‑source via l’inférence hébergée et tous les grands modèles propriétaires — via une seule clé API compatible OpenAI. Pour la plupart des développeurs construisant des compétences de générateur vidéo IA GitHub en production en 2026, c’est le chemin le plus fluide du prototype à la production.
Les informations tarifaires dans cet article sont indicatives et sujettes à modification. Vérifiez toujours les tarifs actuels sur atlascloud.ai/pricing avant d’établir des projections financières. La disponibilité des modèles peut varier selon la région.
Atlas Cloud_ : atlascloud.ai — Certifié SOC I & II · Conforme HIPAA · Infrastructure USA · UE · Asie_


