Les limites de débit de GPT Image 2.5 vont actuellement de 5 à 250 images par minute pour les paliers d’API payants indiqués sur les pages des modèles Flare et Sunburst d’OpenAI. Les deux pages indiquent également des limites de jetons. Vérifiez la configuration réelle de votre compte avant de planifier le travail : les allocations d’utilisation de ChatGPT, les limites de l’API OpenAI et les contraintes des points de terminaison Atlas Cloud doivent être vérifiées séparément.
Le moment gênant arrive lorsqu’une campagne est presque prête et que les dernières images manquent encore. Cliquer de nouveau sur Générer peut vous laisser avec une tâche d’origine, une tâche en double, et aucune idée claire de laquelle se terminera en premier.
Ce guide fait le lien entre les limites publiées et un plan de livraison pratique. Vous y trouverez un tableau de diagnostic, une procédure de file d’attente, un calcul concret pour 100 images et une méthode contrôlée pour vérifier si une image réussie correspond réellement à son brief. L’objectif utile est un dossier d’éléments approuvés avant votre échéance.
Documentation consultée le 16 septembre 2026. La capacité spécifique au compte et les coûts exacts configurés nécessitent une vérification séparée.
État éditorial : la barrière d’accès à l’environnement de test a empêché les six générations prévues. L’article inclut le protocole reproductible et les preuves issues des sources officielles, mais ses trois comparaisons de sorties et la capture de l’exécution terminée restent indisponibles.
Points clés
- Identifiez votre voie d’accès avant d’appliquer une limite quelconque.
- Vérifiez le compte, le projet, le modèle et toute allocation partagée.
- Diagnostiquez l’erreur avant de décider de réessayer.
- Prévoyez un budget pour les images approuvées, y compris l’inspection et la reprise.
Les limites de débit de GPT Image 2.5 dépendent de votre voie d’accès
Commencez par l’endroit où vous avez cliqué sur Générer. Un abonnement ChatGPT, un projet d’API OpenAI et un compte Atlas Cloud sont des voies d’accès différentes. Une capture d’écran de l’une ne permet pas d’établir l’allocation de l’autre.
Dans ChatGPT, vérifiez votre forfait actuel, l’accès à la fonctionnalité d’images et le message affiché lorsque la génération s’arrête. Un abonnement payant ne signifie pas une allocation illimitée. Évitez de planifier une journée de travail en fonction d’un nombre quotidien d’images copié depuis le compte de quelqu’un d’autre.
La discussion autour de la sortie inclut des utilisateurs qui demandent si Plus a toujours un plafond quotidien d’images. Cela établit une préoccupation des lecteurs ; les chiffres dans ces questions n’établissent pas une règle. (Discussion sur la sortie – Reddit, septembre 2026.)
Pour l’API, notez l’organisation, le projet et l’identifiant exact du modèle utilisé par votre application. Pour Atlas, identifiez le point de terminaison sélectionné et le compte qui l’exécute. Classez ensuite le signal visible selon un type de limite.
| Type de limite | Signal visible | Vérification suivante |
|---|---|---|
| Allocation d’utilisation du produit | ChatGPT indique que la création d’images est temporairement indisponible | Lire le message actuel du compte et toute heure de réinitialisation |
| Images par minute, IPM | Restriction du débit d’images lors de soumissions répétées | Confirmer l’allocation d’images pour cette voie et ce modèle |
| Jetons par minute, TPM | Une erreur ou le panneau du compte mentionne une limite de jetons | Inspecter l’allocation de jetons concernée |
| Travail simultané | Les tâches attendent pendant que d’autres tâches restent actives | Compter le travail en cours et vérifier la politique de concurrence |
| Solde ou quota de facturation | Avertissement de facturation ou erreur de quota | Vérifier les fonds, le statut de facturation et les restrictions de dépenses |
| Accès au modèle | Réponse d’autorisation ou de modèle indisponible | Confirmer l’éligibilité du compte et le point de terminaison exact |
Gardez cette distinction visible dans la feuille de travail de votre équipe. Un responsable marketing qui dit « j’ai atteint la limite » doit noter la voie et le message avant qu’un collègue ne commence le dépannage.
Identifiez aussi qui d’autre utilise les mêmes ressources du compte. Une deuxième station de travail n’offre pas nécessairement une capacité supplémentaire. Demandez au propriétaire du compte si le site web, l’outil interne et les travaux nocturnes puisent dans le même pool.
La mention « Gratuit : non pris en charge » dans le tableau de l’API concerne ce palier de modèle API. Elle ne permet pas de savoir si l’offre gratuite de ChatGPT peut générer des images.
Limites de débit de GPT Image 2.5 par palier d’API
Les pages officielles des modèles publient actuellement le tableau suivant pour les deux variantes. Il s’agit de chiffres publics par palier d’utilisation, vérifiés le 16 septembre 2026, et non d’une garantie que chaque compte dispose exactement de cette configuration.
| Palier d’utilisation de l’API OpenAI | TPM | IPM |
|---|---|---|
| Gratuit | Non pris en charge | Non pris en charge |
| Palier 1 | 100,000 | 5 |
| Palier 2 | 250,000 | 20 |
| Palier 3 | 800,000 | 50 |
| Palier 4 | 3,000,000 | 150 |
| Palier 5 | 8,000,000 | 250 |
Sources : (Page du modèle OpenAI Flare, vérifiée en septembre 2026) et (Page du modèle OpenAI Sunburst, vérifiée en septembre 2026).
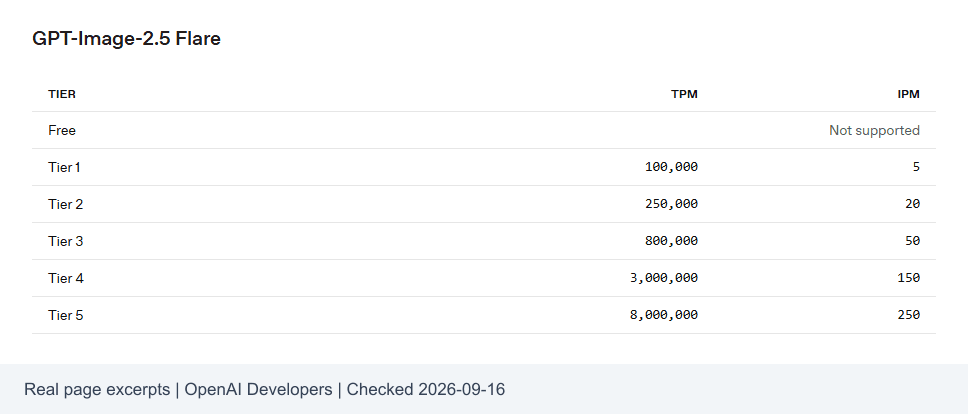 Page officielle du modèle OpenAI indiquant les limites de débit de GPT Image 2.5 par palier d’utilisation
Preuve issue de la page officielle du modèle. Date de vérification : 16 septembre 2026.
Les IPM comptent les images ; les RPM comptent les requêtes. Conservez cette distinction dans votre feuille de calcul de planification. Avec une image par requête réussie, les deux compteurs peuvent coïncider dans une estimation simple. Des sorties multiples, des nouvelles tentatives ou d’autres comportements du point de terminaison peuvent rompre cette hypothèse.
Utilisez le tableau comme point de départ d’une discussion sur la capacité. Notez le palier publié, puis comparez-le avec les limites visibles pour le compte qui effectue réellement le travail. S’ils diffèrent, enquêtez avant de vous engager sur une échéance.
Des tableaux identiques ne montrent pas que Flare et Sunburst terminent une tâche dans le même temps. Ils n’établissent pas non plus que passer d’une variante à l’autre additionne leurs allocations. Confirmez toute limite partagée dans la configuration du compte.
Une équipe qui prépare une campagne pour vendredi peut en faire une brève vérification préalable : identifier la voie de production, vérifier l’allocation actuelle, contrôler les autres charges planifiées et désigner une personne pour surveiller la file d’attente. Enregistrez la date de vérification afin qu’une ancienne capture d’écran ne devienne pas une hypothèse de fonctionnement permanente.
Ne multipliez pas une allocation par minute par le nombre de minutes d’une journée pour promettre autant d’images terminées. Un tel calcul exclut les temps d’inactivité, la latence de génération, les autres contraintes et les sorties rejetées.
Diagnostiquer les limites de débit de GPT Image 2.5 avant de réessayer
Enregistrez le corps de l’erreur, le statut HTTP, l’horodatage et l’identifiant de requête disponible avant de modifier quoi que ce soit. Une capture d’écran indiquant uniquement « 429 » laisse trop d’inconnues.
La documentation d’OpenAI décrit les limites d’organisation et de projet, les pools de modèles partagés, les en-têtes de réponse et la gestion des erreurs temporaires. Elle conseille d’attendre au moins la durée d’un Retry-After fourni, d’ajouter de la gigue et d’éviter les échecs rapides répétés, qui peuvent consommer l’allocation par minute. (Limites de débit OpenAI, consulté en septembre 2026.)
La procédure de diagnostic suivante est une proposition de conception d’application. Les libellés d’erreur et les contrôles de récupération doivent être adaptés à la plateforme que vous utilisez réellement.
| Situation visible | Première vérification | Action |
|---|---|---|
| Erreur 429 temporaire | Corps de l’erreur et tout indice d’attente ou de réinitialisation | Mettre en pause la file concernée, puis réduire le rythme de soumission |
OpenAI insufficient_quota | Solde, état de facturation et éligibilité du compte | Résoudre le problème du compte ; arrêter les nouvelles tentatives automatiques |
| Délai expiré après la soumission | Enregistrement de la requête d’origine, identifiant de tâche si disponible, historique | Réconcilier la tâche d’origine avant de la soumettre à nouveau |
| File d’attente longue | Statut en attente et nombre de tâches actives | Continuer d’attendre tant que la tâche reste valide ; examiner les retards séparément |
| Rejet de paramètre ou de contenu | Raison spécifique de validation ou de rejet | Corriger la requête ; ne pas la classer comme une nouvelle tentative liée à la limite de débit |
Le code OpenAI du tableau est un exemple de diagnostic propre à OpenAI. Il ne garantit pas qu’Atlas renvoie le même objet d’erreur ou prenne en charge les mêmes en-têtes.
En cas de délai expiré, distinguez ce que vous savez de ce que vous soupçonnez. « Mon client a cessé d’attendre » ne permet pas de savoir si le serveur a accepté la tâche. Marquez l’enregistrement local comme incertain et inspectez l’opération d’origine via le mécanisme de statut ou d’historique fourni par la voie.
S’il n’existe aucun mécanisme de réconciliation, transmettez cette incertitude à un opérateur. Soumettre à nouveau sans vérification peut créer une autre tâche facturable. Consignez ce risque avant que quelqu’un décide de réessayer.
Pour le moment de réinitialisation, utilisez la réponse ou le message du compte correspondant à la limite atteinte. Évitez de supposer que chaque restriction se réinitialise à minuit ou exactement 60 secondes après l’erreur.
Conservez les preuves après la récupération. Un petit journal d’incident indiquant la voie, l’erreur d’origine, la durée d’attente et le résultat final aide l’opérateur suivant à distinguer un problème de compte d’un pic de trafic.
Gérer les limites de débit de GPT Image 2.5 avec une file d’attente
Une file d’attente donne à votre équipe un endroit unique pour décider de ce qui s’exécute ensuite. Pour une petite campagne, un tableur et un opérateur peuvent suffire. Une application peut implémenter les mêmes décisions dans un stockage de tâches durable.
Utilisez cette procédure en six étapes :
- Attribuez un identifiant métier stable. Enregistrez la version du prompt, la sortie souhaitée, le modèle, les dimensions, la qualité et l’échéance. Un brief révisé reçoit une nouvelle version.
- Vérifiez les travaux existants. Renvoyez la sortie enregistrée pour une tâche terminée. Laissez une tâche active ou incertaine en réconciliation plutôt que de créer une autre soumission.
- Contrôlez séparément le rythme et la concurrence. N’admettez du travail que lorsque le budget de débit local et un emplacement en cours d’exécution sont disponibles. Les nouvelles tentatives utilisent les mêmes contrôles d’admission.
- Respectez l’indication d’attente du serveur. Pour une erreur confirmée comme réessayable, attendez au moins la durée indiquée et ajoutez un peu d’aléatoire.
- Sinon, utilisez un backoff borné. Augmentez les délais entre les tentatives, ajoutez de la gigue et plafonnez le délai. Gardez en vue l’échéance globale de la tâche.
- Arrêtez délibérément. Lorsque le budget de tentatives ou l’échéance est épuisé, enregistrez les dernières preuves et envoyez la tâche pour examen.
Ce pseudocode neutre vis-à-vis de la plateforme illustre les décisions de planification. Il ne constitue ni un SDK Atlas ni un contrat de point de terminaison.
plaintext1claim business_job_id atomically 2if completed: return saved_asset 3if active_or_uncertain: reconcile_original; stop 4 5while attempts_remaining and before_deadline: 6 wait_for_rate_budget_and_inflight_slot() 7 result = submit_once_and_record_identifiers() 8 9 if completed: save_asset_and_finish() 10 if accepted: track_original_until_terminal(); stop 11 if submission_outcome_unknown: mark_uncertain(); stop 12 if billing_or_access_or_validation_error: stop_for_review() 13 if not_retryable: stop_for_review() 14 15 delay = server_minimum_wait_if_present() 16 otherwise: delay = capped_exponential_backoff() 17 schedule_next_attempt_after(delay + random_jitter) 18 19save_final_state_for_review()
La réservation atomique est importante lorsque deux travailleurs voient la même ligne de file d’attente. Ils ne doivent pas conclure indépendamment que la tâche peut être soumise. Persistez l’état de soumission avant qu’un travailleur ne disparaisse ou ne redémarre.
La déduplication au niveau applicatif laisse encore une fenêtre difficile : un service peut accepter une requête juste avant que le client ne perde la réponse. L’idempotence native du point de terminaison peut traiter certains risques de soumission en double lorsqu’elle est documentée. Un identifiant métier local ne peut pas à lui seul garantir une exécution exactement une fois, et ce guide ne suppose pas qu’Atlas accepte un en-tête d’idempotence particulier.
Priorisez selon les besoins de livraison. Terminez l’image manquante de la campagne approuvée avant d’admettre des variantes facultatives. Laissez une courte note d’opérateur expliquant pourquoi le travail s’est arrêté afin qu’un collègue puisse reprendre sans deviner.
Planifier 100 images en tenant compte des limites de débit de GPT Image 2.5
Utilisez deux compteurs : les sorties générées et les livrables acceptés. Le second compteur indique au responsable de campagne si le travail est prêt.
Considérons un exemple de planification hypothétique, avec une sortie par tâche. Supposons une allocation effective de 5 IPM, une occupation moyenne de 60 secondes en cours d’exécution et un maximum de 2 tâches simultanées. Ces données sont illustratives, ce ne sont pas des mesures d’Atlas ou d’OpenAI.
| Donnée ou calcul de planification | Valeur hypothétique | Interprétation |
|---|---|---|
| Images approuvées requises | 100 | L’objectif de livraison réel |
| Allocation d’images effective | 5 IPM | Capacité du compte supposée |
| Allocation d’images nécessaire pour 100 sorties | 100 ÷ 5 = 20 minutes | Exigence de capacité de quota, pas une promesse d’achèvement |
| Tâches simultanées | 2 | Plafond en cours d’exécution supposé |
| Occupation moyenne d’un emplacement | 60 secondes | De la soumission à l’achèvement |
| Capacité côté concurrence | 2 × 60 ÷ 60 = 2 images/minute | Inférieure à l’allocation d’images |
| Taux d’acceptation supposé | 80 % | Estimation simplifiée pour la planification |
| Allocation de génération pour 100 images acceptées | 100 ÷ 0,8 = 125 sorties | Inclut une enveloppe approximative de reprise |
| Temps de capacité à 2 sorties/minute | 125 ÷ 2 = 62,5 minutes | Exclut l’inspection et la passation supplémentaires |
Une approximation utile est :
plaintext1sustainable images/minute ≈ minimum of: 2 image allowance 3 request allowance × images per request 4 token allowance ÷ applicable tokens per image 5 concurrency × 60 ÷ average occupancy seconds
Utilisez des unités comparables et des mesures réelles du compte. Si la consommation de jetons n’est pas disponible, laissez ce terme non résolu plutôt que de l’estimer à partir du nombre de mots du prompt. Cette formule décrit un modèle de planification, pas l’implémentation du fournisseur.
L’estimation de 125 sorties suppose une probabilité d’acceptation stable entre les tentatives. La reprise réelle peut être corrélée : un prompt qui compte mal les objets de façon répétée peut continuer d’échouer jusqu’à ce que quelqu’un le modifie. Examinez les défauts récurrents avant d’acheter d’autres tentatives.
Différents travaux nécessitent différents critères d’acceptation :
- Illustrations de contenu hebdomadaire : le sujet doit correspondre à l’article et le recadrage doit fonctionner au format de publication.
- Supports de concept produit : l’image doit préserver la forme et l’emplacement requis. Une image conceptuelle ne remplace pas une photographie produit vérifiée.
- Illustrations pédagogiques ou de recettes : les quantités, les objets et les détails de séquence doivent correspondre à l’explication. Un ingrédient supplémentaire peut induire les lecteurs en erreur.
Ajoutez au calendrier le temps de téléchargement, d’inspection, de révision et de passation. Si une seule personne examine chaque élément, mesurez aussi son rythme.
Avant une échéance, séparez les images essentielles des variantes facultatives. Suivez séparément les éléments prêts, rejetés, actifs et incertains. Un dossier contenant 100 fichiers peut encore être en retard de plusieurs livrables approuvés.
Réduire la reprise avant d’augmenter vos limites
Définissez un critère de réussite avant de cliquer sur Générer. Cela rend la décision reproductible et évite qu’une image d’apparence convaincante ne passe avec un mauvais nombre d’objets ou un texte inutilisable.
Le protocole contrôlé décrit ici utilise GPT Image 2.5 Flare Text-to-Image, un PNG par tâche, en 2048x1152. Pour chaque brief, exécutez d’abord max, puis high, en conservant tous les autres réglages disponibles inchangés. Conservez les originaux et inspectez les deux à la même taille d’affichage.
État des preuves : Les six sorties Flare ci-dessous ont été générées pour les trois briefs en 2048x1152. Chaque paire enregistre un résultat MAX et un résultat HIGH. Ces exemples illustrent les étapes d’inspection présentées ici, mais six sorties n’établissent pas un classement général de qualité ni un taux d’acceptation.
A. Nombre d’objets et composition
Copiez ce prompt sans modification :
plaintext1Create a realistic overhead food photograph for a recipe article. 2Show exactly six whole red tomatoes arranged in two neat rows of three 3on a light wooden cutting board. Place one stainless-steel kitchen knife 4to the right of the board and one folded beige linen towel to the left. 5No other vegetables, no sliced tomatoes, no plates, no hands, no text, 6and no logos. Use soft natural window light from the upper left. 7Keep the entire cutting board inside the frame. 8Horizontal 16:9 composition.
Comptez chaque tomate, vérifiez les deux rangées et inspectez les quatre bords de la planche. Cherchez ensuite les objets interdits. N’acceptez le cadre que lorsque l’ensemble du brief est satisfait. Un nombre de tomates correct avec une planche recadrée exige encore une décision sur la réparation ou la régénération.
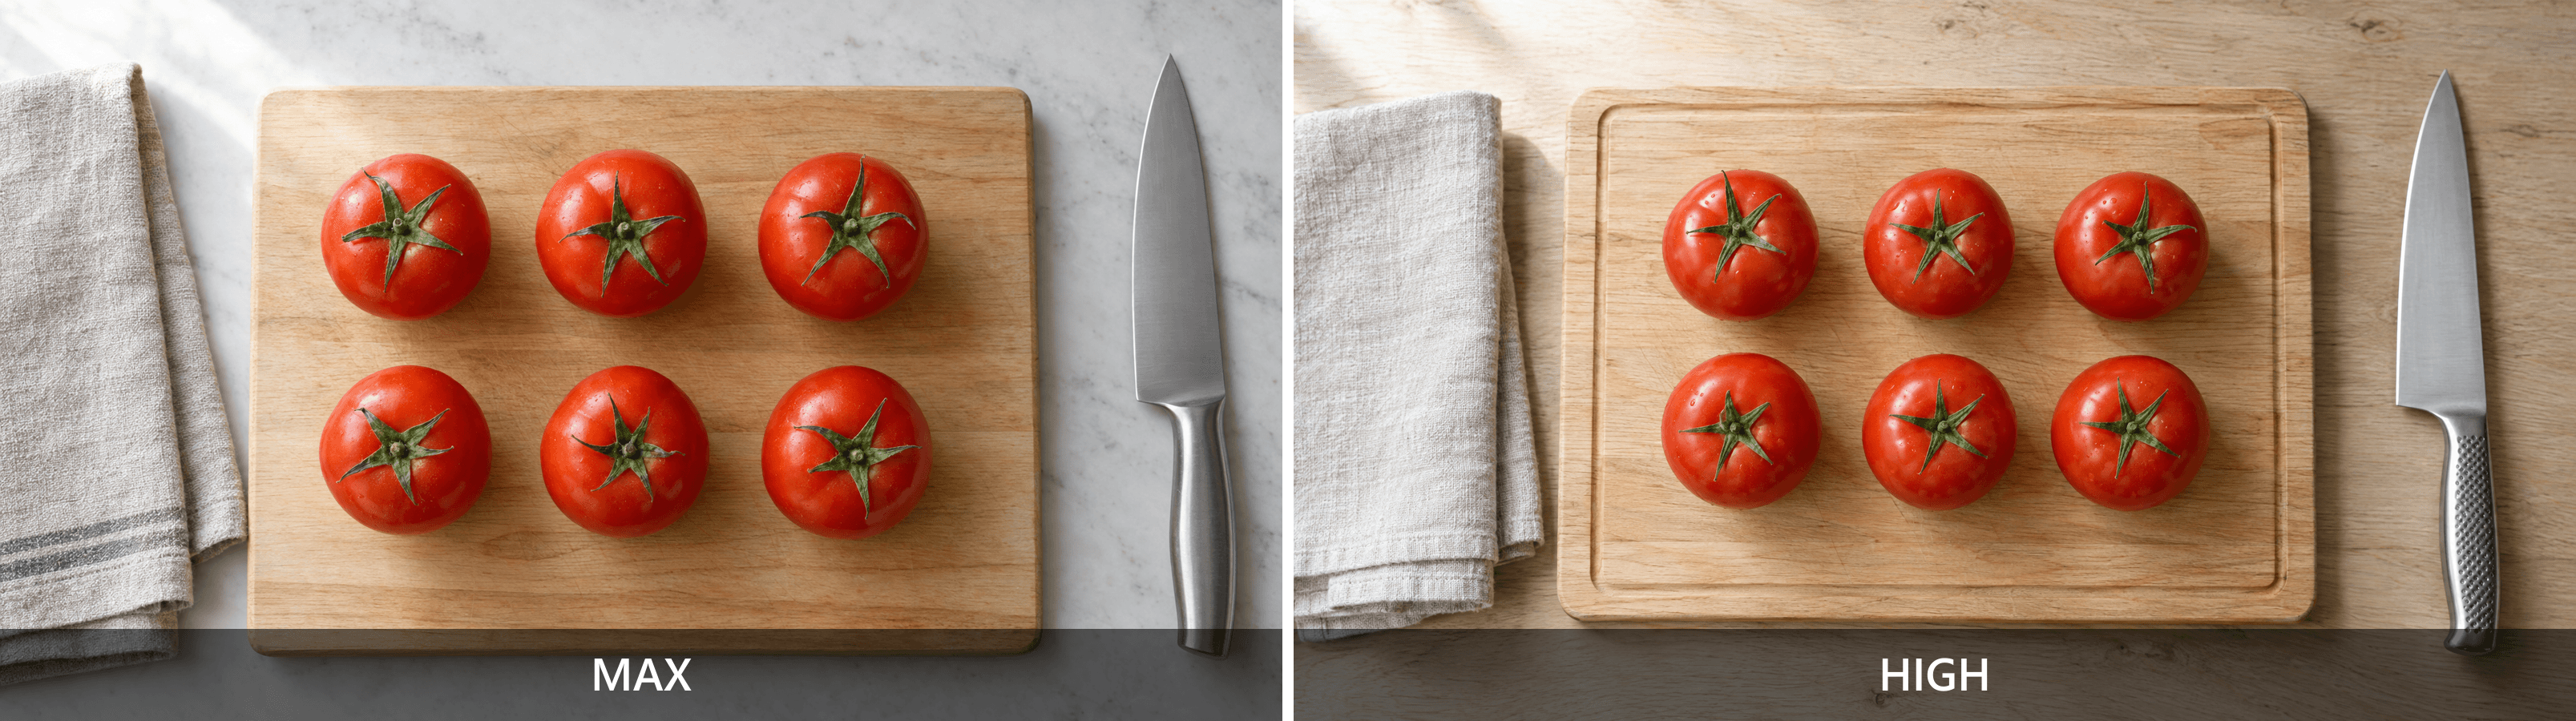 Sorties Flare high et max pour le contrôle du nombre de tomates et de la planche complète
Gauche : MAX. Droite : HIGH. Les deux sorties montrent six tomates en deux rangées ; inspectez la planche entière, le couteau, le torchon et tout objet interdit avant d’approuver l’un ou l’autre résultat.
B. Espace pour un titre
plaintext1Create a realistic editorial still-life photograph for a home-office 2article. Place an open unbranded notebook, one black pen, and one plain 3ceramic coffee cup entirely within the left half of a pale oak desk. 4Keep the right 45 percent of the frame empty, showing only the desk 5surface so a designer can add a headline later. No laptop, no phone, 6no plants, no visible writing, no text, and no logos. 7Use soft daylight and a slightly elevated camera angle. 8Horizontal 16:9 composition.
À 2048 pixels de large, les 45 % les plus à droite commencent environ à x = 1126. Vérifiez cette zone sur l’original. Placez ensuite un vrai titre dans un aperçu de mise en page local pour évaluer la lisibilité. Une ligne de repère est une annotation de post-production, pas une partie de la scène générée.
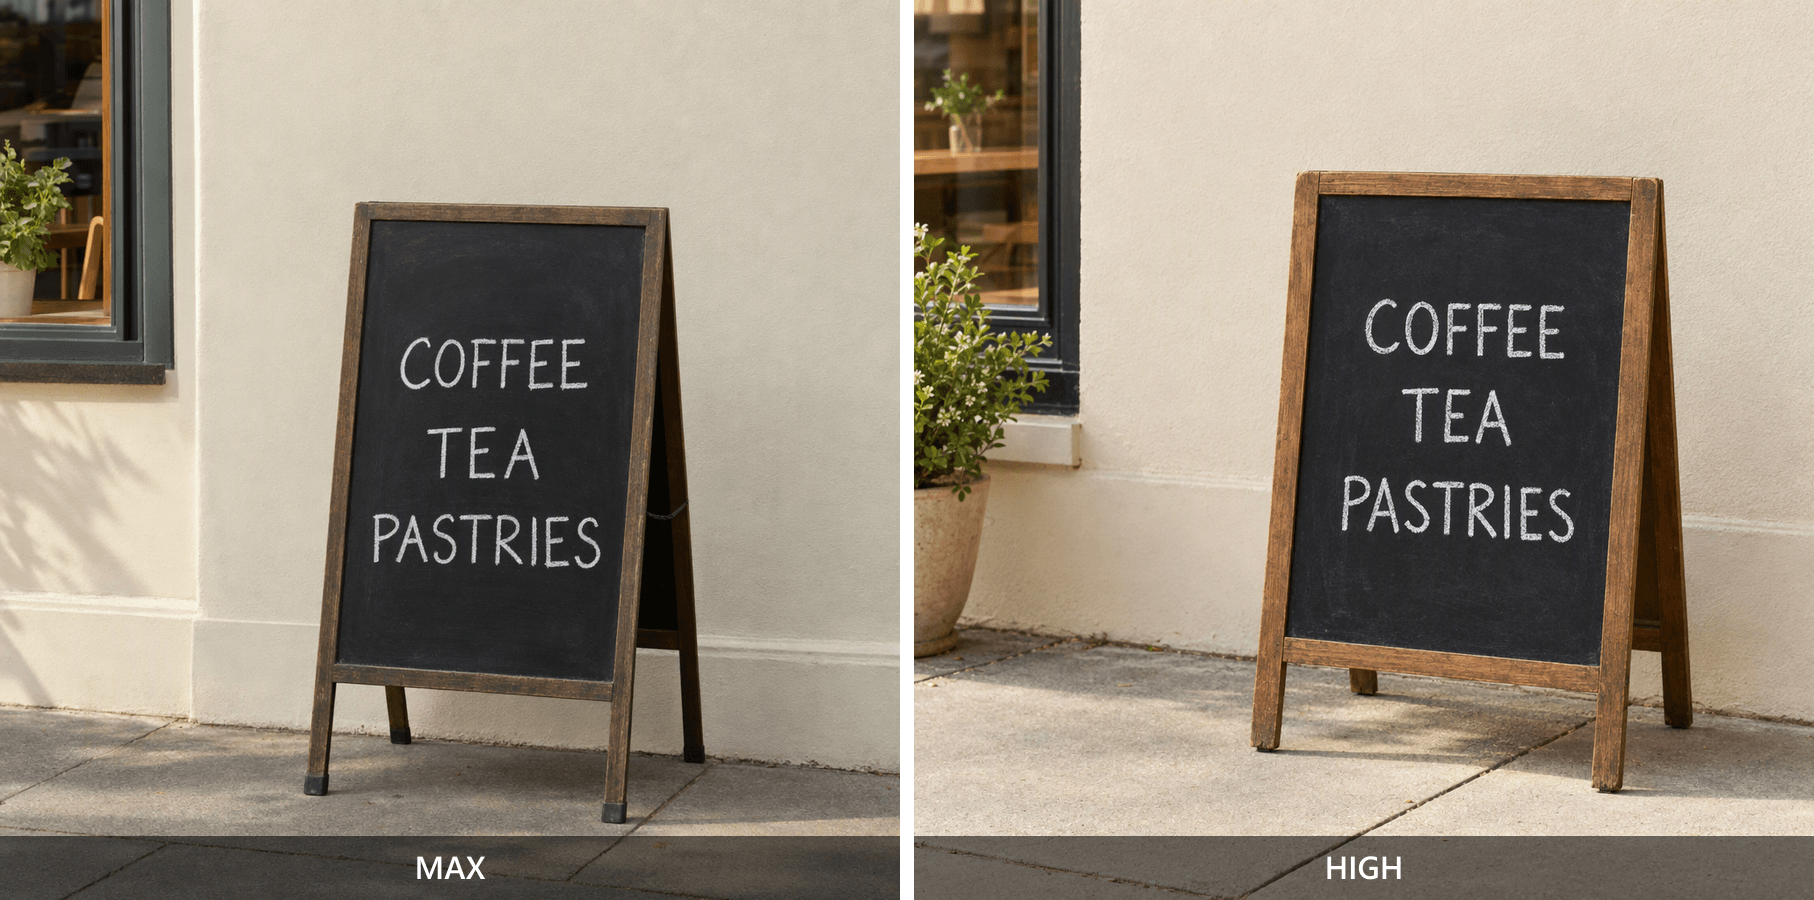 Sorties high et max bureau à domicile avec la zone de titre à droite demandée et marquée
Gauche : MAX. Droite : HIGH. Les deux sorties préservent une zone de bureau à droite utilisable pour un titre ; évaluez cette zone vide à la taille d’affichage finale.
C. Texte court exact
plaintext1Create a realistic photograph of a small freestanding black chalkboard 2outside a quiet neighborhood cafe. The board must contain exactly 3these three lines of clearly readable white lettering: 4COFFEE 5TEA 6PASTRIES 7Do not add prices, extra words, logos, or other readable signs. 8Show the full board with a simple cream-colored wall behind it, 9warm morning daylight, and a small area of clean pavement. 10No people. Horizontal 16:9 composition.
Lisez chaque lettre dans l’original et dans l’aperçu au format de publication. Vérifiez l’arrière-plan pour d’autres panneaux lisibles. Il s’agit d’une scène de test générée par IA, pas d’une photographie documentant un vrai café. Conservez les fautes d’orthographe dans les preuves au lieu de les effacer par retouche.
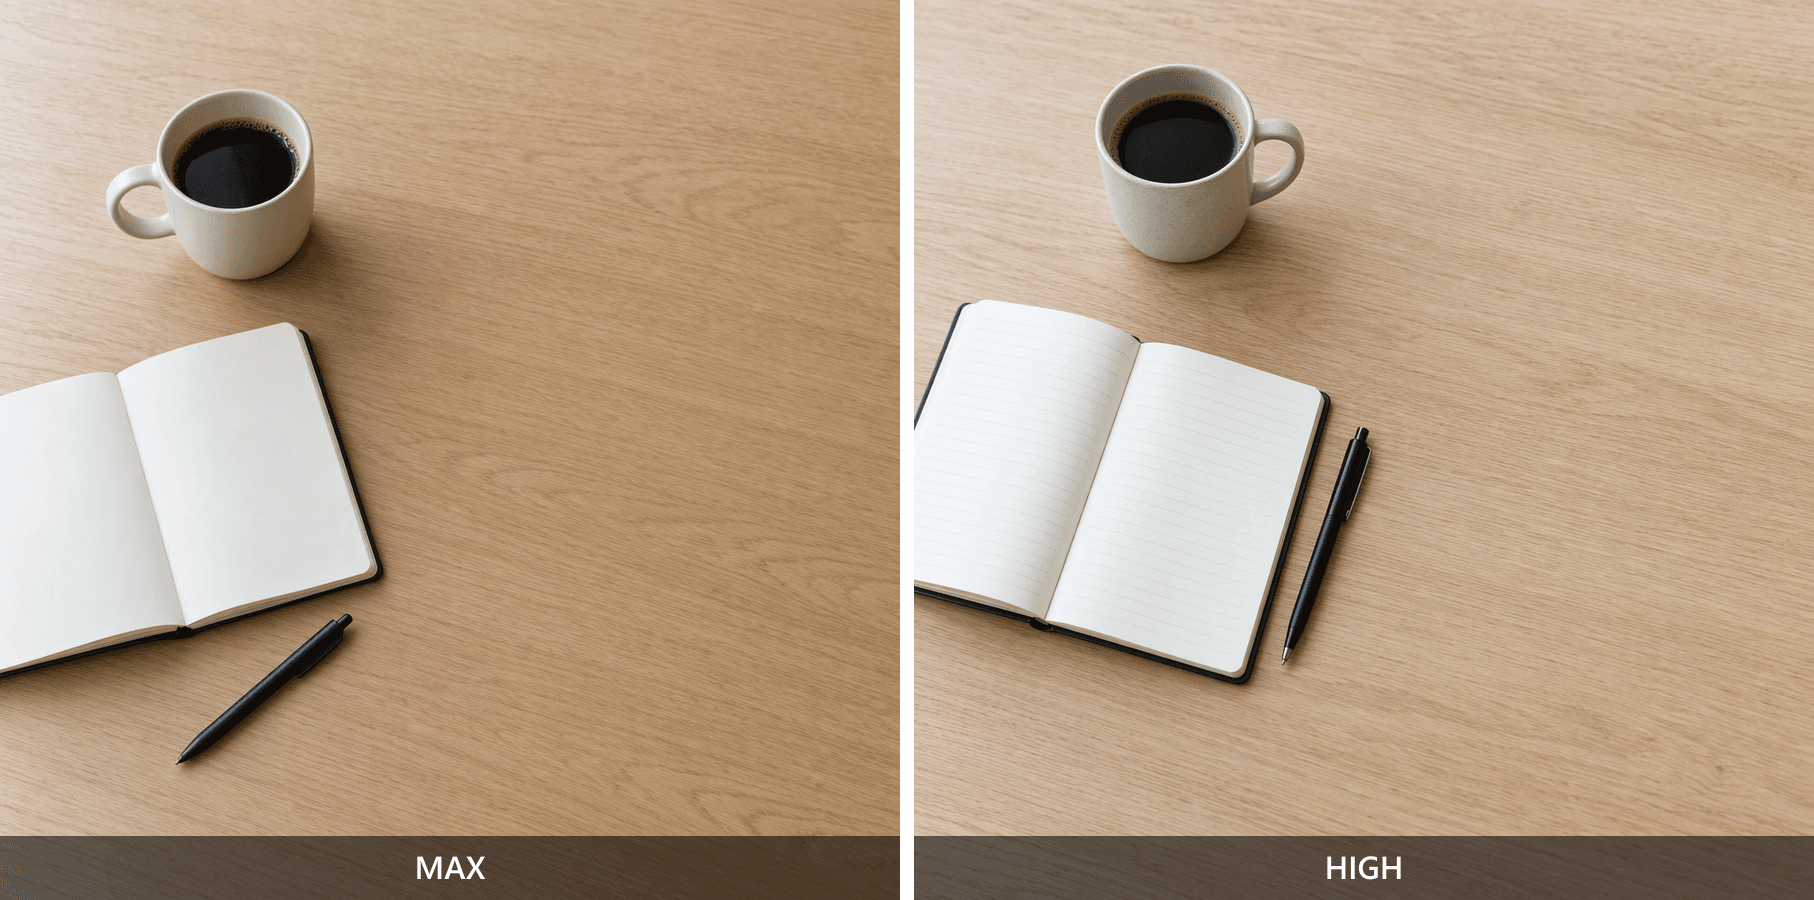
Tableaux de café générés par IA en high et max pour vérifier COFFEE, TEA et PASTRIES
Gauche : MAX. Droite : HIGH. Lisez chaque ligne au format de publication et vérifiez l’arrière-plan pour tout texte supplémentaire lisible avant d’approuver un résultat.
Six sorties peuvent illustrer un processus d’inspection. Elles ne peuvent pas établir un taux de réussite de la plateforme, un débit de production ni un plafond de limite de débit. Une seule paire ne peut pas non plus isoler les effets du réglage de qualité de la variabilité de génération.
Jugez un réglage selon l’élément accepté et son coût enregistré. Sans charges exactes, une conclusion sur le coût high par rapport à max reste non mesurée. Si les deux passent, enregistrez-le ; si aucun ne passe, révisez le brief avant de répéter le même échec.
Évaluer Atlas Cloud pour votre flux de travail d’images
Utilisez la même tâche représentative pour évaluer une voie d’accès. Cela maintient l’évaluation liée au travail que votre équipe doit livrer.
La page GPT Image 2.5 Flare Text-to-Image sélectionnée est le point de terminaison de ce protocole. Ouvrez-la, confirmez le nom du modèle, collez un prompt complet ci-dessus et sélectionnez la taille et la qualité demandées.
Vérifiez ce que le formulaire conserve effectivement après avoir quitté chaque champ. Une largeur saisie qui est annulée avant la soumission ne crée pas un test en 2048 pixels. Enregistrez les réglages validés, exécutez une tâche, attendez un état terminal et téléchargez la sortie réelle.
Enregistrez ensemble l’identifiant de tâche s’il est exposé, l’heure de soumission, l’heure d’achèvement et le fichier de résultat. Pour l’exécution de comparaison, créez une tâche distincte et modifiez uniquement la qualité. N’inférez pas une nouvelle sortie à partir d’exemples déjà affichés sur la page du modèle.
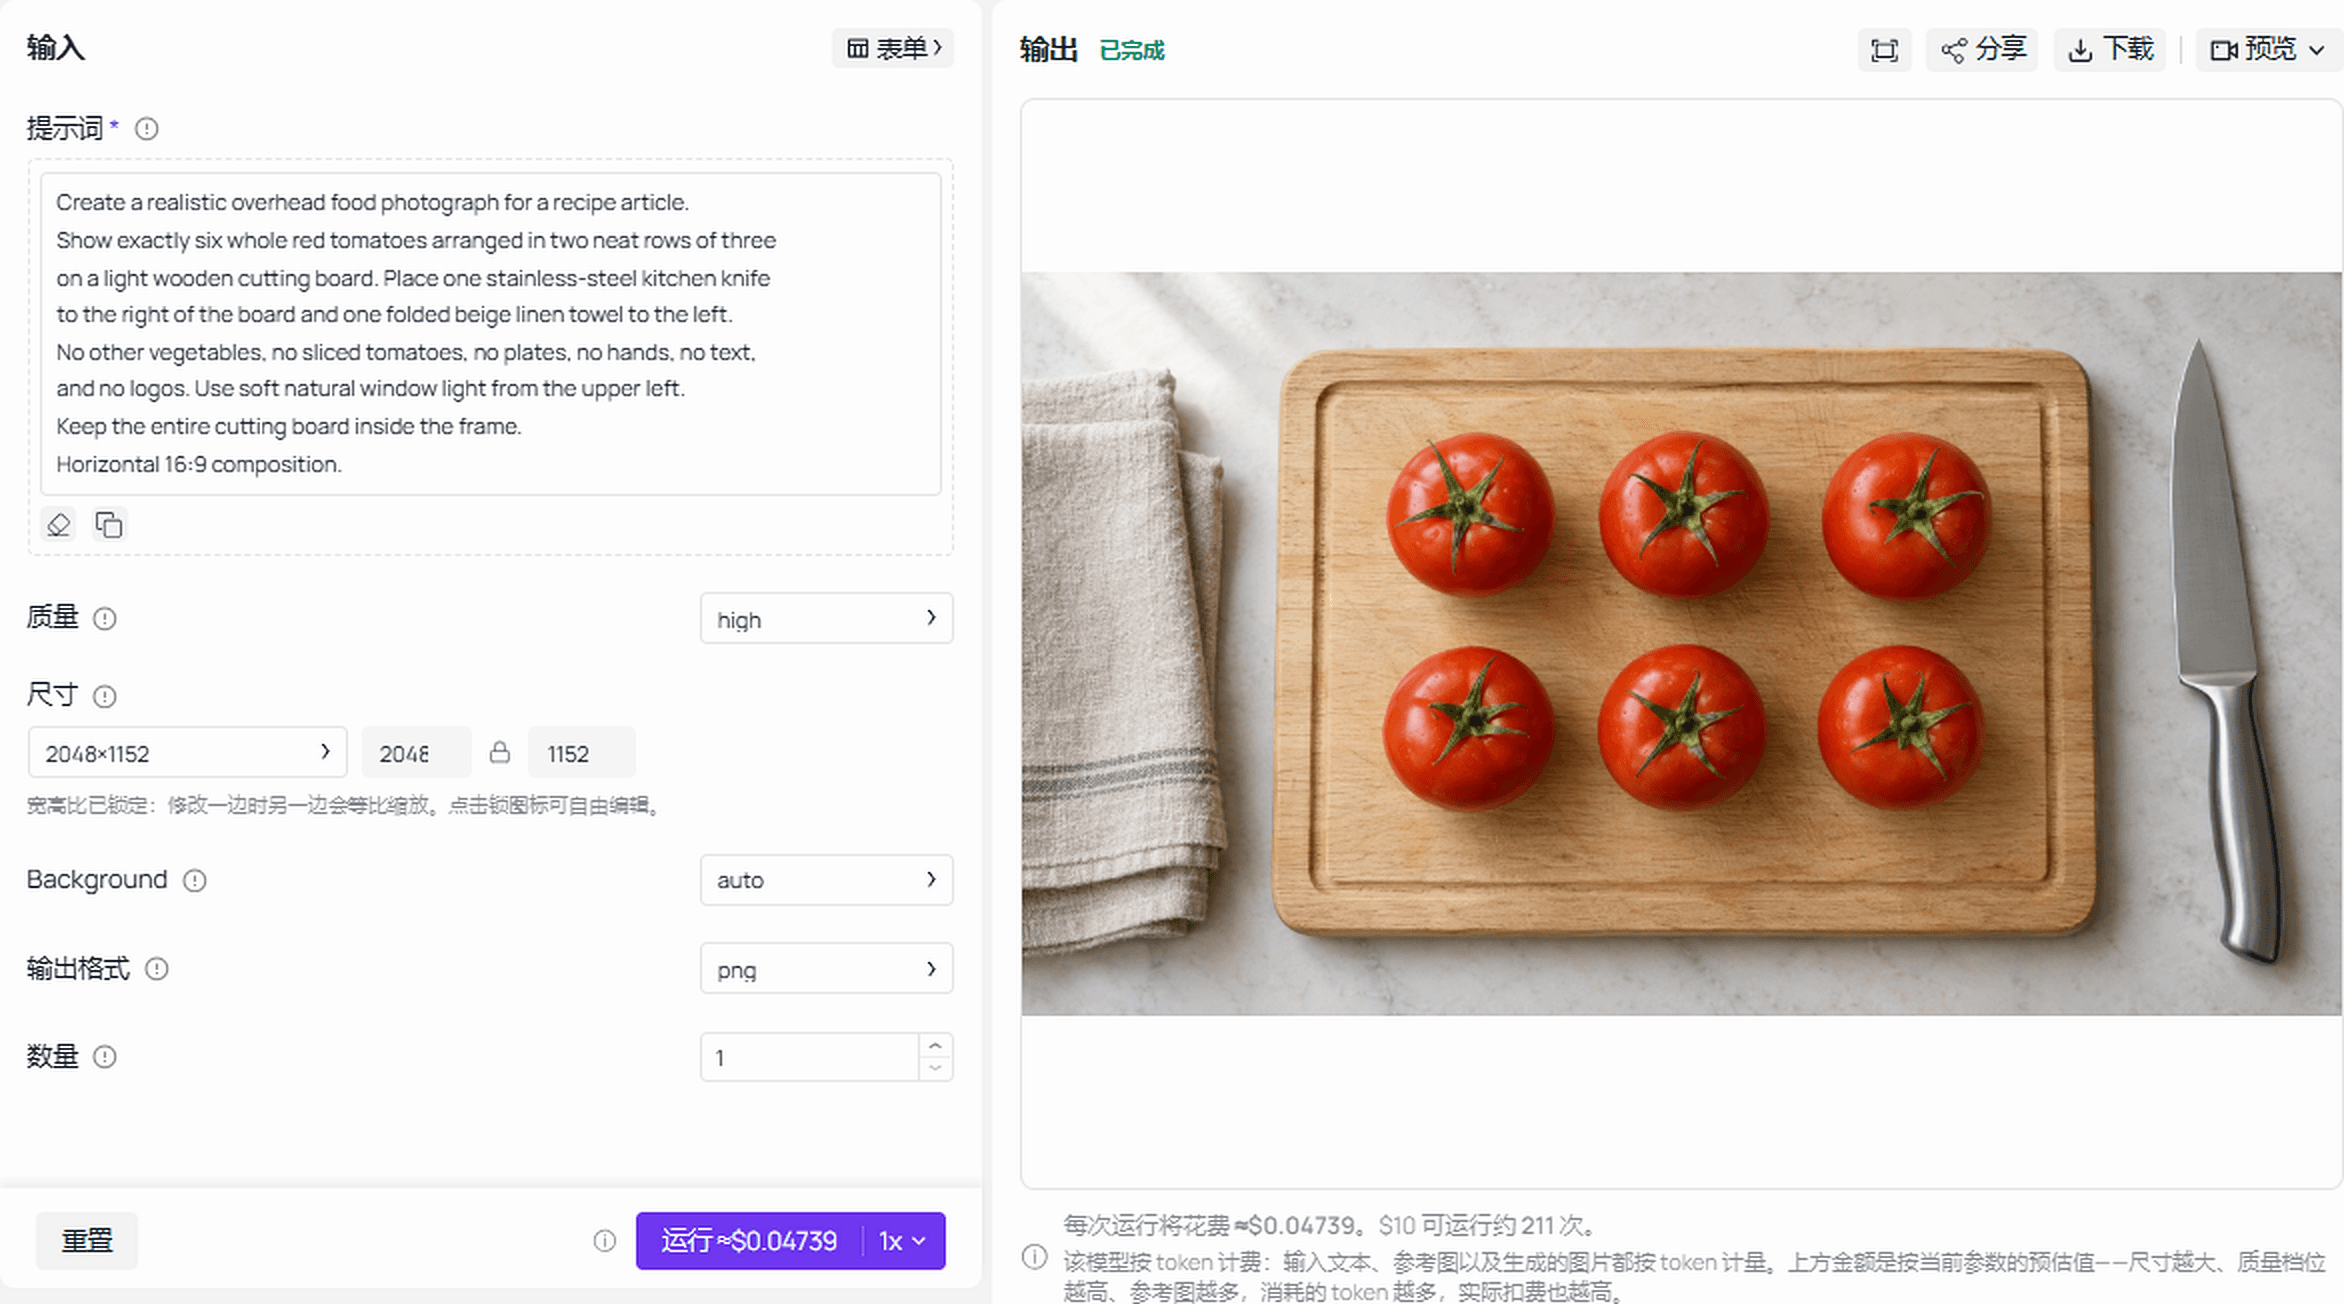 Exécution Flare terminée montrant le brief tomate, les réglages actifs et le résultat généré
Exécution Flare terminée : l’écran montre le brief tomate, la qualité HIGH, la taille 2048x1152, la sortie PNG et le résultat de six tomates renvoyé.
Évaluez la voie selon cinq champs :
- Modèle et point de terminaison : confirmez Flare text-to-image plutôt qu’un point de terminaison d’édition ou une autre variante.
- Débit et concurrence : obtenez les limites applicables du compte et déterminez si les charges de travail les partagent.
- Récupération des tâches : vérifiez comment le compte expose le travail actif, les échecs terminaux et les résultats après un délai expiré.
- Coût configuré : vérifiez l’unité, les dimensions sélectionnées, la qualité et les éventuelles conditions de remise.
- Acceptation et reprise : conservez la sortie d’origine et une courte raison pour chaque élément rejeté.
Utilisez le répertoire actuel des modèles comme point d’entrée pour vérifier les prix, puis inspectez la configuration sélectionnée. Un prix de départ arrondi n’établit pas le coût pour 2048x1152 + max.
La concurrence des comptes Atlas, le débit de production, les allocations partagées et la facturation des tâches en échec n’ont pas été établis indépendamment pour cet article. Confirmez-les côté compte. Les temps de tâches dans l’environnement de test ne peuvent pas non plus établir les performances de l’API en production.
Exécutez un prompt représentatif, inspectez le résultat et vérifiez vos limites de compte avant de passer à l’échelle.
FAQ sur les limites de débit de GPT Image 2.5
Combien d’images GPT Image 2.5 puis-je générer par minute ?
Les paliers payants des pages de modèles de l’API OpenAI indiquent de 5 à 250 IPM. Utilisez les paramètres actuels de votre compte pour la planification opérationnelle, y compris les jetons et toute autre contrainte applicable. Une allocation d’images publiée ne garantit pas que chaque image se termine ou soit acceptée dans cette minute.
ChatGPT Plus a-t-il une limite quotidienne fixe d’images ?
Cet article n’établit pas de nombre quotidien fixe universel pour Plus. Vérifiez le message actuel de génération d’images et les informations de votre forfait. Les retours d’utilisateurs peuvent aider à identifier une question à examiner, mais un chiffre provenant de la session d’un autre ne peut pas devenir sans risque le budget de production quotidien de votre équipe.
Flare et Sunburst ont-ils les mêmes limites de débit ?
Leurs pages officielles de modèles affichaient des tableaux de paliers identiques lors de la vérification du 16 septembre 2026. Cela n’établit pas des temps de génération identiques ni des pools de capacité distincts. Avant de planifier une charge de travail répartie, confirmez les limites et les règles de partage qui s’appliquent aux deux variantes dans votre compte.
Pourquoi reçois-je une erreur 429 alors que j’ai encore des crédits ?
Un solde répond à la question de savoir si des fonds restent disponibles ; il ne répond pas à la question de savoir si la requête actuelle respecte une contrainte de débit. Lisez le corps de l’erreur et toute indication d’attente. Si l’erreur identifie un problème de compte ou de quota, traitez ce problème au lieu de supposer que des soumissions retardées répétées le résoudront.
Quand les limites de débit de GPT Image 2.5 se réinitialisent-elles ?
Utilisez les en-têtes de réponse pertinents ou l’avis du compte. Différentes contraintes peuvent avoir différentes fenêtres, et aucun moment de réinitialisation unique n’est établi ici pour toutes les voies. Respectez une attente minimale fournie, réduisez le rythme de la file et conservez l’état d’origine de la tâche tout en décidant si une nouvelle tentative est appropriée.
Utiliser Atlas Cloud supprime-t-il les limites de débit de GPT Image 2.5 ?
Non. Évaluez Atlas comme une option d’accès avec son propre comportement de point de terminaison et ses propres contraintes de compte. Confirmez ces détails avant d’augmenter le volume. Un plan pratique pour les limites de débit de GPT Image 2.5 combine une capacité vérifiée, des soumissions contrôlées, une récupération des tâches et des contrôles d’acceptation qui réduisent la reprise évitable.


