

Le clip how i become a millionaire in 30 days est une blague sur le fait de demander à un chatbot un raccourci miraculeux et de recevoir la réponse la moins magique possible : « Trouve-toi un travail. » Le regard blessé du personnage, sa frappe frénétique et sa seconde tentative constituent la véritable histoire. Ci-dessous, deux exemples en ligne montrent comment le même dispositif fonctionne avec un humain et avec un animal. Ensuite, nous construisons une nouvelle version plus longue avec un personnage original, un nouveau décor, un dialogue lisible et une réaction qui dure assez longtemps pour faire mouche.
À retenir
- La séquence reconnaissable est la question pleine d’espoir, la réponse abrupte, la pause vexée et une nouvelle tentative.
- Les versions en ligne avec un humain et avec un animal changent l’interprète tout en conservant le timing de la blague.
- Notre version originale de 26 secondes dans une aire de jeux utilise un enfant comme interprète et ajoute un dialogue lisible au montage plutôt que de demander à un modèle vidéo de dessiner une interface de téléphone.
- Traitez « Trouve-toi un travail » comme une chute scénarisée, pas comme la preuve de ce que répondrait un chatbot ni comme un véritable plan pour s’enrichir.
Que se passe-t-il dans les versions en ligne ?
Le premier exemple en ligne garde la blague proche d’une conversation téléphonique quotidienne. Une personne lève son téléphone avec une confiance totale, baisse les yeux pour lire la réponse et perd brusquement cette confiance. Observez le changement de posture. La mise en place est dite vers le téléphone, mais la chute est jouée vers le spectateur. La réaction rend la courte réplique mémorable.
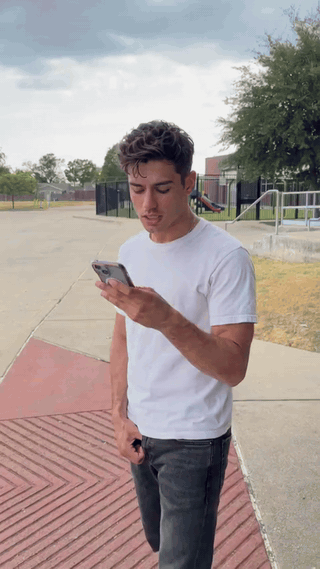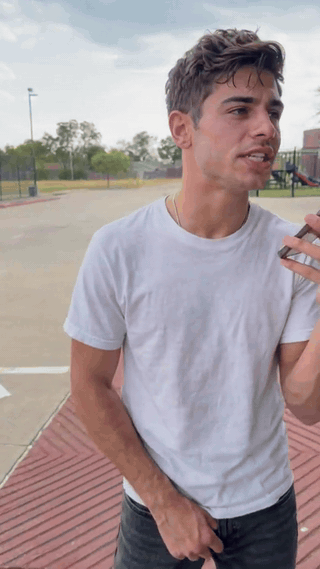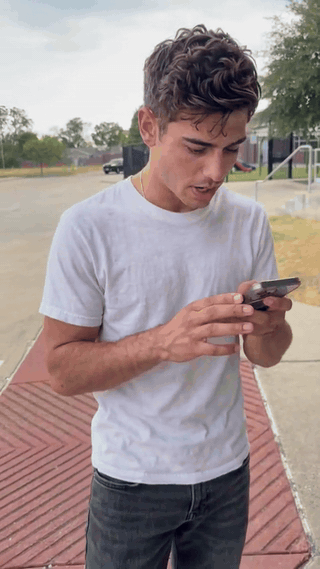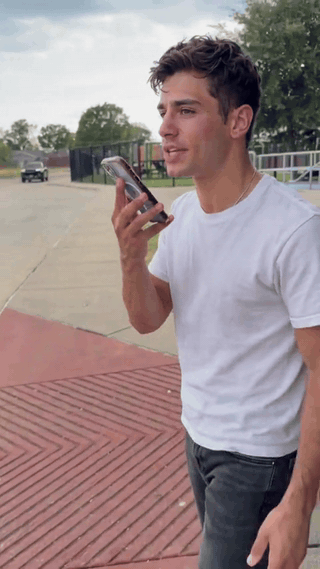
Exemple en ligne, version humaine. Le moment visuel clé est le passage d’une prestation pleine d’espoir à une incrédulité visible.
Le deuxième exemple en ligne confie le même rôle à un animal. Sa posture droite et son accessoire téléphonique rendent l’ambition absurde avant même que la réponse n’arrive. Un tour de tête et un long regard caméra font le travail qu’un acteur humain ferait avec les sourcils et une protestation murmurée. Il ne s’agit pas d’un simple échange de costume : le langage corporel de l’animal change la sensation de la chute, tandis que la question et la réponse restent reconnaissables.
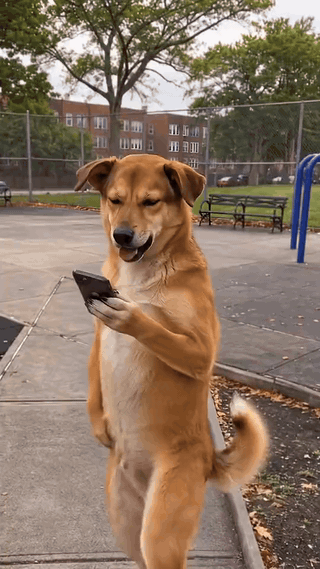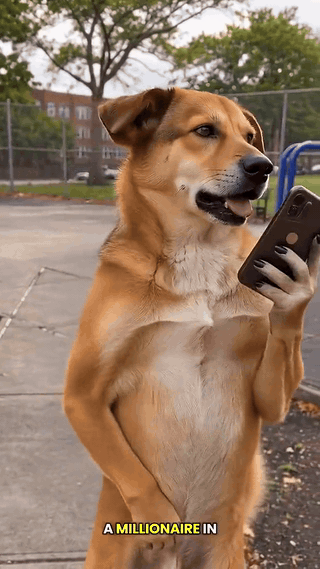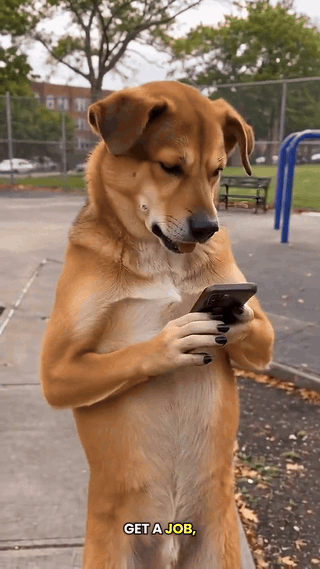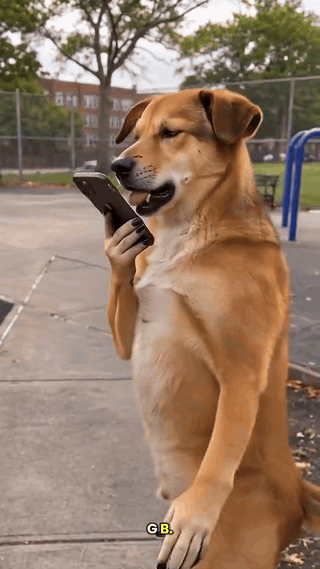
Exemple en ligne, version animal. La performance repose sur une posture droite, un geste de téléphone lisible et le regard vexé retardé.
Ce sont des exemples du format vidéo qui circule, et non des enregistrements qui établissent la réponse d’un chatbot en particulier. Un sketch comique peut mettre en scène l’échange ; un remake par IA peut générer l’interprète. La formulation « how I become » est conservée ici parce qu’elle fait partie de la phrase de mème recherchée, bien que « how do I become » soit de l’anglais courant. Aucune de ces formulations ne fait de la vidéo un conseil financier.
Les quatre temps qui le rendent reconnaissable
| Temps | Ce que voient les spectateurs | Pourquoi c’est important |
|---|---|---|
| Question | Un téléphone est levé comme s’il pouvait révéler un secret | La confiance du personnage installe une attente démesurée. |
| Réponse | « Trouve-toi un travail. » apparaît ou est lu à voix haute | La réponse est volontairement simple et courte. |
| Réaction | Le personnage se fige, lève les yeux ou fixe la caméra | La pause permet au public de découvrir l’insulte en même temps que le personnage. |
| Nouvelle question | Une frappe rapide ou un autre message vocal | Le personnage refuse la réponse ordinaire et prolonge la blague. |
L’ordre compte plus qu’une durée de plan exacte. Si la réponse arrive avant que le spectateur ait compris la question, il n’y a pas de contraste. Si la réaction est coupée immédiatement, la chute n’a pas le temps de respirer. Si le personnage s’éloigne simplement, le clip perd la seconde tentative obstinée qui rend ce format spécifique.
Comment créer votre propre version ?
Partez de la structure de la blague, puis changez la performance, le décor et la fin. Rejouer plan par plan les images de quelqu’un d’autre rend le résultat plus difficile à distinguer et vous donne moins de contrôle sur le dialogue. Pour notre démonstration, nous plaçons un enfant fictif dans une aire de jeux ensoleillée. L’enfant demande un raccourci pour devenir millionnaire avec un bel optimisme, puis reçoit la réponse abrupte « Trouve-toi un travail. » Ce conseil est volontairement absurde pour un enfant ; le passage de l’enchantement à l’incrédulité porte la blague. L’écran du téléphone est tourné vers l’enfant, de sorte que le modèle n’a jamais besoin d’inventer des boutons d’application ou des messages lisibles.
La contrainte de conception utile consiste à séparer la performance du texte. Un modèle vidéo peut animer une personne qui lève un téléphone, lit, recule et tape. Il est moins fiable pour afficher le texte exact d’un chat sur un téléphone en mouvement. Nous générons donc d’abord le jeu d’acteur, puis nous ajoutons des sous-titres éditoriaux propres. Les sous-titres rapportent les répliques scénarisées de la blague ; ils ne sont pas présentés comme une capture d’écran d’une véritable session ChatGPT.
1. Construire une première image cohérente
Utilisez une image paysage 16:9 où le visage de l’enfant, ses deux mains et le téléphone sont visibles. Une composition à mi-corps laisse de la place pour que l’expression change sans perdre le toboggan coloré ni les balançoires derrière l’enfant. Laissez un espace dégagé pour les sous-titres. La première image doit sembler pleine d’espoir plutôt que déjà choquée.
Pour cet article, la première image est générée avec Seedream v5.0 Pro sur Atlas Cloud. Le prompt est volontairement concret :
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
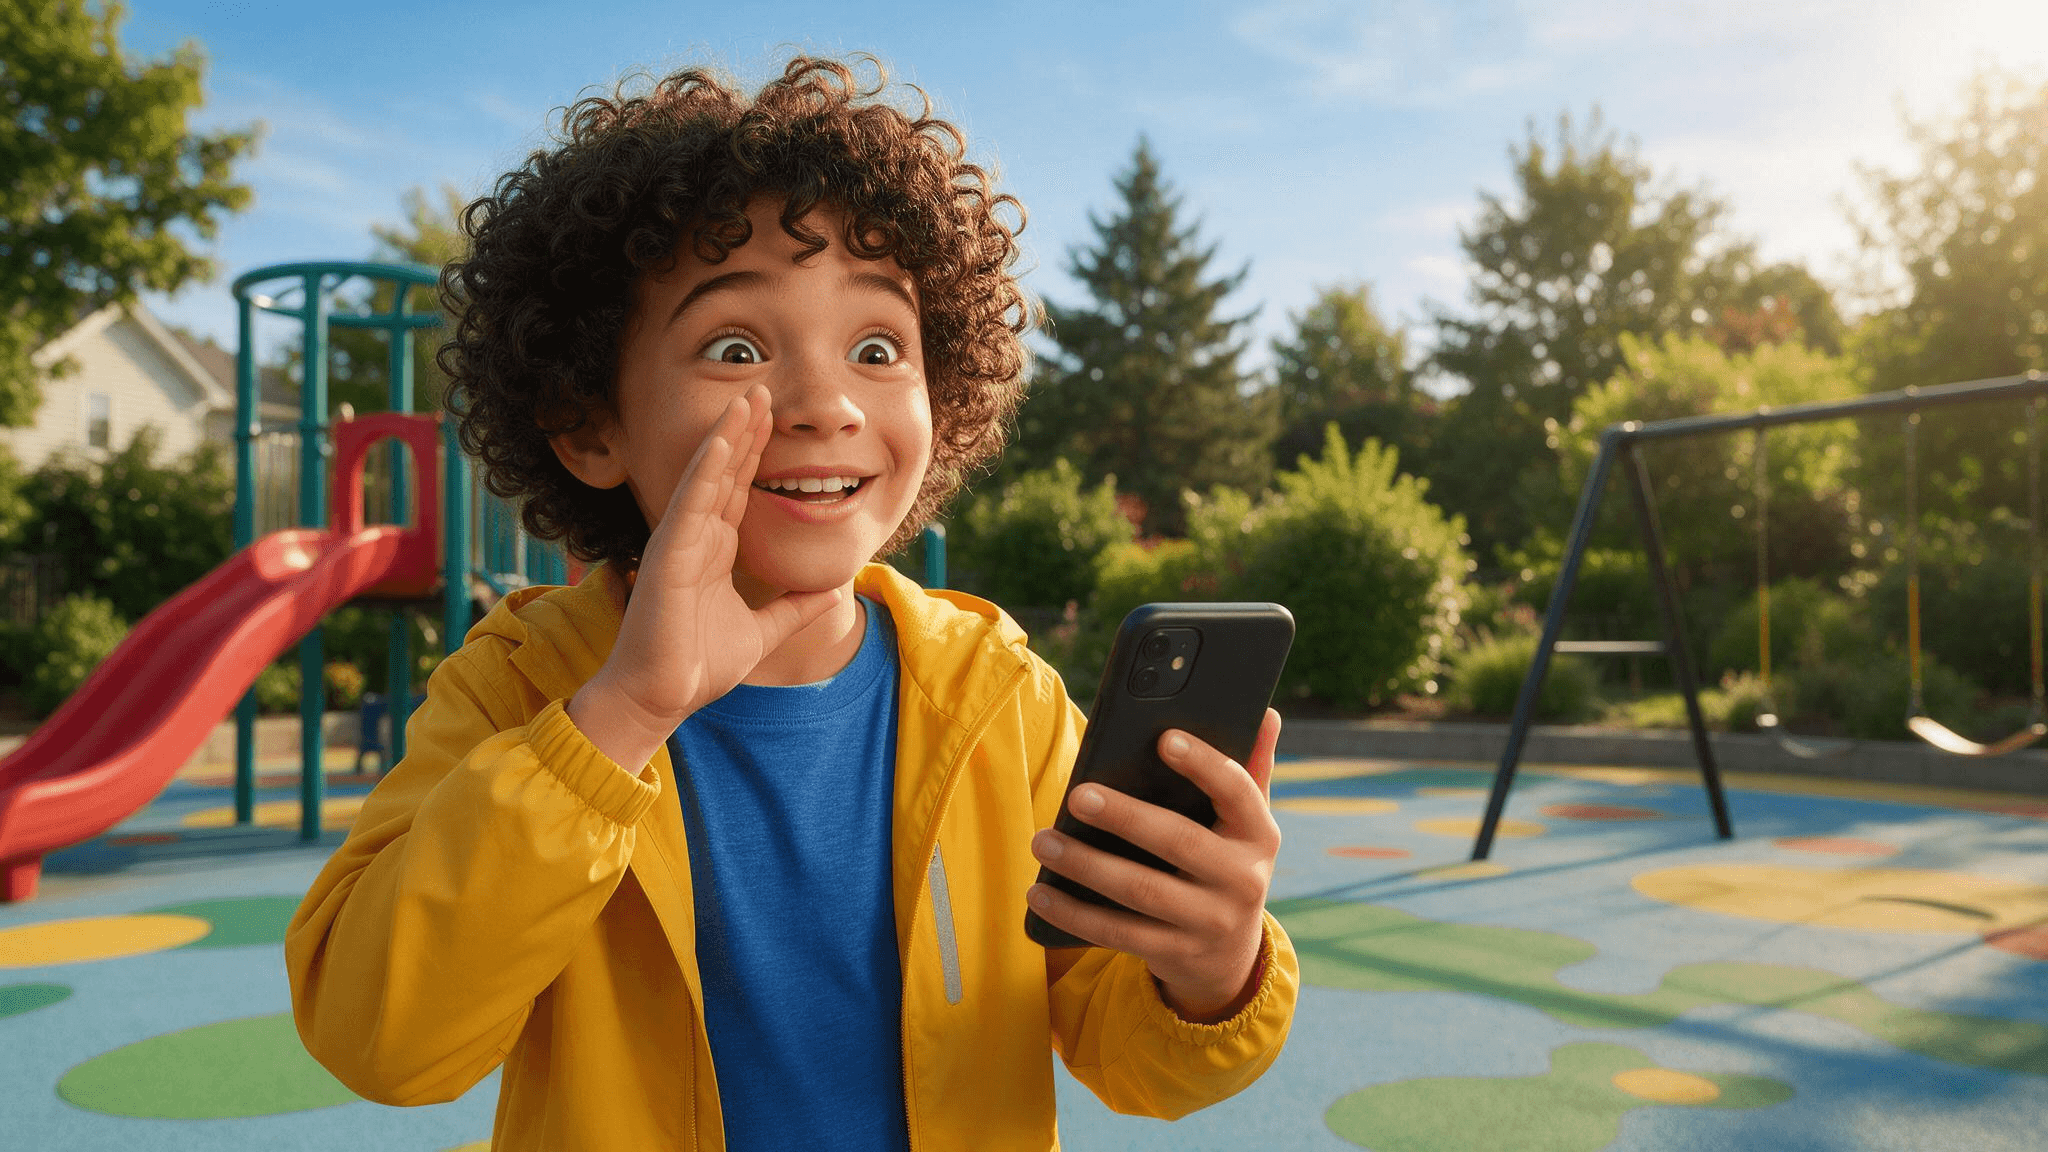
Notre image de départ générée. Le large sourire et les sourcils relevés de l’enfant installent une ouverture pleine d’espoir ; le toboggan et les balançoires rendent le nouveau décor immédiatement identifiable.
2. Animer une réaction complète, pas un portrait en mouvement
Utilisez la première image comme entrée d’image pour Seedance 2.5 Image-to-Video sur Atlas Cloud. Nous réglons la cible sur 26 secondes, paysage 16:9, avec son. Le prompt demande une séquence de réactions faciales distinctes. Il ne demande pas au modèle d’afficher des bulles de chat ni d’épeler la chute, car ces mots exacts sont ajoutés au montage.
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
Le clip livré rend le changement émotionnel facile à suivre : l’enfant commence avec un large sourire, ouvre la bouche de surprise à la première réponse, fronce les sourcils, tape une autre question et finit par hausser les épaules d’exaspération. L’image fixe supplémentaire ci-dessous isole l’instant où la réponse ordinaire fait basculer le plan millionnaire de l’enfant.
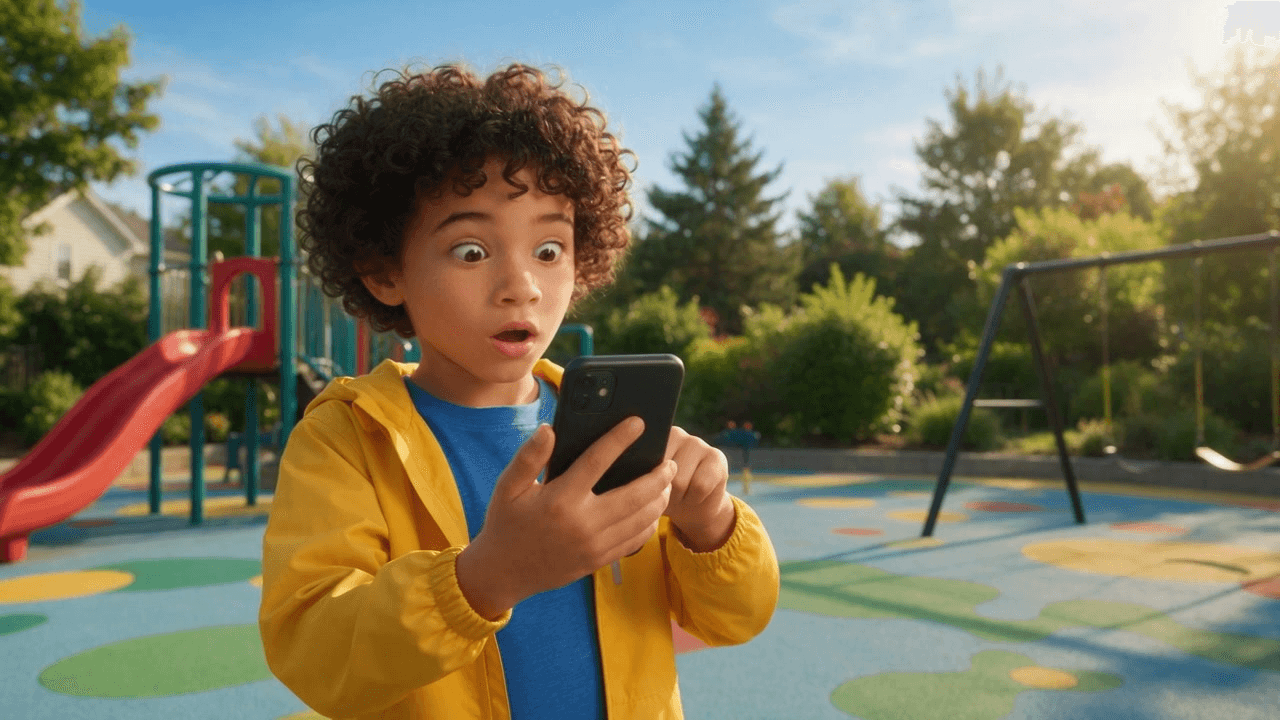
Image d’environ 6 secondes dans la vidéo générée. Par rapport à la première image pleine d’espoir, les yeux écarquillés et la bouche ouverte rendent immédiatement visible l’effet de la chute.
3. Ajouter un dialogue exact et garder la blague lisible sans son
Un court script suffit. Affichez la question à l’écran pendant que l’enfant s’adresse au téléphone, n’introduisez « Trouve-toi un travail. » que lorsque l’enfant lit la réponse, et laissez un temps avant la protestation. Pour la relance, utilisez une nouvelle question plutôt que de répéter mot pour mot la question d’ouverture. Les sous-titres doivent rester dans une zone sûre cohérente, avec un fort contraste, et ne jamais couvrir le visage ni les mains.
| Moment dans notre montage de 26 secondes | Sous-titre éditorial | Indication de jeu |
|---|---|---|
| Ouverture | « Comment je deviens millionnaire en 30 jours ? » | Débit lumineux et assuré vers le téléphone. |
| Réponse | « Trouve-toi un travail. » | Les yeux descendent vers l’écran ; le sourire disparaît. |
| Réaction | « Sérieusement ? » | La surprise cède la place à un froncement de sourcils avant la frappe. |
| Seconde tentative | « D’accord, mais si je passe cette étape ? » | Le téléphone remonte ; le ton devient suppliant. |
Gardez le texte assez court pour être lu d’un coup d’œil. Ne fabriquez pas une fausse capture de chat réaliste pour prouver que la réplique a été générée par une application. Un sous-titre clairement conçu communique honnêtement l’échange scénarisé et garde le clip 16:9 compréhensible sans son. L’audio d’origine reste avec la vidéo ; les quatre lignes affichées sont des sous-titres éditoriaux.
4. Exporter, inspecter et étiqueter
Exportez un seul MP4 continu plutôt que de découper un clip source en plusieurs intégrations d’article. Vérifiez sa durée réelle après l’export. Les 26 secondes demandées ne comptent que si le fichier dépasse réellement 20 secondes et si le temps supplémentaire contient une action significative. Dans cet article, l’exemple original final est intégré ci-dessous avec une image d’affiche afin que les lecteurs puissent voir la séquence terminée en place.
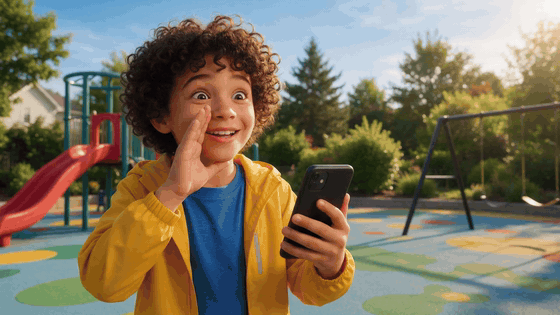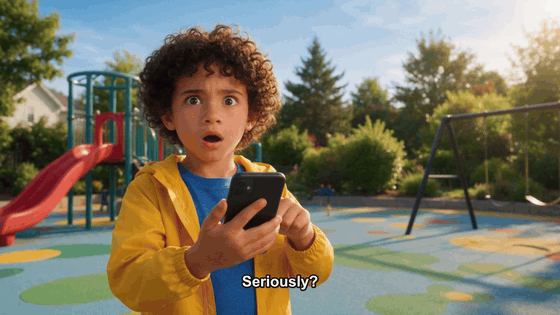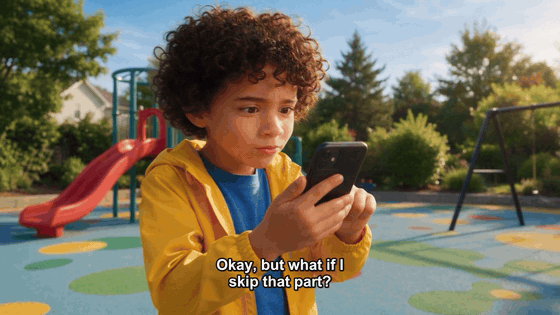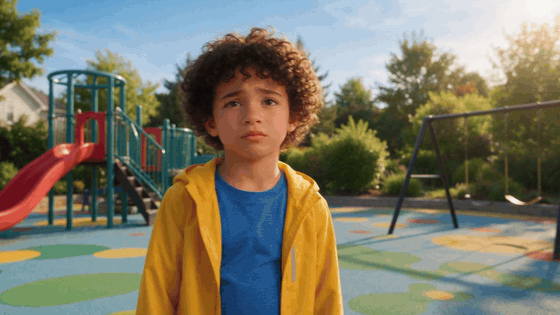
Notre exemple original : un enfant dans une aire de jeux pose une question, reçoit la réponse abrupte, fixe l’écran d’un air incrédule, tape, puis réessaie dans une seule vidéo paysage de 26 secondes. Les sous-titres sont des ajouts éditoriaux à la performance générée.
Avant de publier une scène réaliste générée par IA, utilisez l’étiquette de contenu IA de la plateforme lorsqu’il s’applique. Les consignes de TikTok sur le contenu généré par IA expliquent ses outils d’étiquetage et ses exigences pour les médias IA réalistes. Les consignes de YouTube sur le contenu modifié ou synthétique décrivent la déclaration lors de l’envoi. Utilisez votre propre apparence, un personnage fictif ou un participant qui a accepté d’apparaître. Les deux GIF en ligne ci-dessus sont des exemples d’analyse ; publier un remake exige vos propres images, sons et autorisations.
Qu’est-ce qui fait mouche dans un montage plus long ?
Une version de 26 secondes a besoin de plus que deux copies d’un mème de 13 secondes. Nous donnons à l’enfant un changement de stratégie visible. Au début, le téléphone est traité comme une machine à raccourcis. Après la réponse, l’enfant ne se contente pas de répéter sa demande : il fronce les sourcils, tape, reformule et essaie de négocier avec la réponse. Ce basculement transforme le dernier temps en une nouvelle blague plutôt qu’en remplissage.
La lisibilité sans son change aussi le montage. Dans un flux, les spectateurs peuvent découvrir le clip en mode muet. Les sous-titres doivent révéler la question et la réponse aux bons moments, tandis que les mouvements de l’acteur apportent l’émotion. Le sous-titre « Sérieusement ? » retardé ne doit pas apparaître pendant la première image de stupeur ; le regard silencieux vient d’abord. Cette petite pause est l’endroit où le spectateur lit le visage.
Enfin, restez honnête sur la mise en place. La vidéo est une scène comique mise en scène et la réplique est une blague scénarisée. Elle ne montre pas une véritable session de chatbot et ne promet pas que quiconque peut devenir riche en 30 jours. La prochaine action utile consiste à choisir un interprète et un décor originaux, à storyboarder les quatre temps et à tester si quelqu’un peut comprendre votre brouillon avec le son coupé. Si la personne identifie à la fois la question et la seconde tentative vexée, le format fonctionne.
FAQ
Un chatbot a-t-il vraiment répondu « Trouve-toi un travail » ?
Cette phrase est la chute d’un format comique. Une vidéo qui la montre ne prouve pas qu’il s’agit d’un véritable échange avec un chatbot ni d’une réponse que vous recevrez toujours.
Puis-je faire le mème avec un animal ou un ami ?
Oui, si vous disposez d’une photo adaptée et de l’autorisation de toute personne visible. Une version avec un animal nécessite des yeux, un museau et des marques de pelage bien visibles. Une version avec un ami nécessite un visage net et son accord pour être représenté disant les répliques.
Pourquoi utiliser un modèle vidéo puis ajouter les sous-titres séparément ?
Le modèle gère le mouvement et le jeu ; un monteur gère le texte exact. Séparer ces tâches évite les écrans de téléphone illisibles et vous donne le contrôle du timing de la chute.
L’exemple original ici dépasse-t-il 20 secondes ?
Oui. Le MP4 livré est vérifié après l’export, plutôt que de se fier uniquement à la durée sélectionnée dans le générateur. Le temps supplémentaire sert à une seconde tentative et à une réaction finale.





