Kimi K2.6 vs GLM 5.1 vs Qwen 3.6 Plus vs MiniMax M2.7 : Quel modèle open source remporte la palme pour le codage en 2026 ?
La réponse courte
Si vous construisez un agent de codage autonome qui s'exécute pendant des heures sans intervention : Kimi K2.6. Il a obtenu 66,7 % sur Terminal-Bench 2.0 et a maintenu plus de 4 000 appels d'outils sur une session ininterrompue de 13 heures dans les benchmarks publiés — un plafond de stabilité qu'aucun autre modèle open source de cette comparaison n'atteint.
Si vous avez besoin du meilleur développeur front-end agentique : GLM 5.1. Son Elo Code Arena de 1 530 (troisième mondial sur le développement web agentique), vérifié indépendamment, reflète la préférence réelle des développeurs lors de comparaisons en tête-à-tête, pas seulement des suites de tests automatisées.
Si le coût par token est la contrainte : MiniMax M2.7 à 0,30 $/M tokens en entrée sur Atlas Cloud obtient 56,22 % sur SWE-Bench Pro avec seulement 10B de paramètres activés — 94 % des performances de GLM-5.1 pour environ un cinquième du coût.
Si votre base de code est trop grande pour une fenêtre de contexte de 262K : Qwen 3.6 Plus, le seul modèle ici avec un support de contexte de 1 million de tokens, et le leader sur Terminal-Bench 2.0 à 61,6 % parmi ce groupe.
Aperçu des benchmarks clés
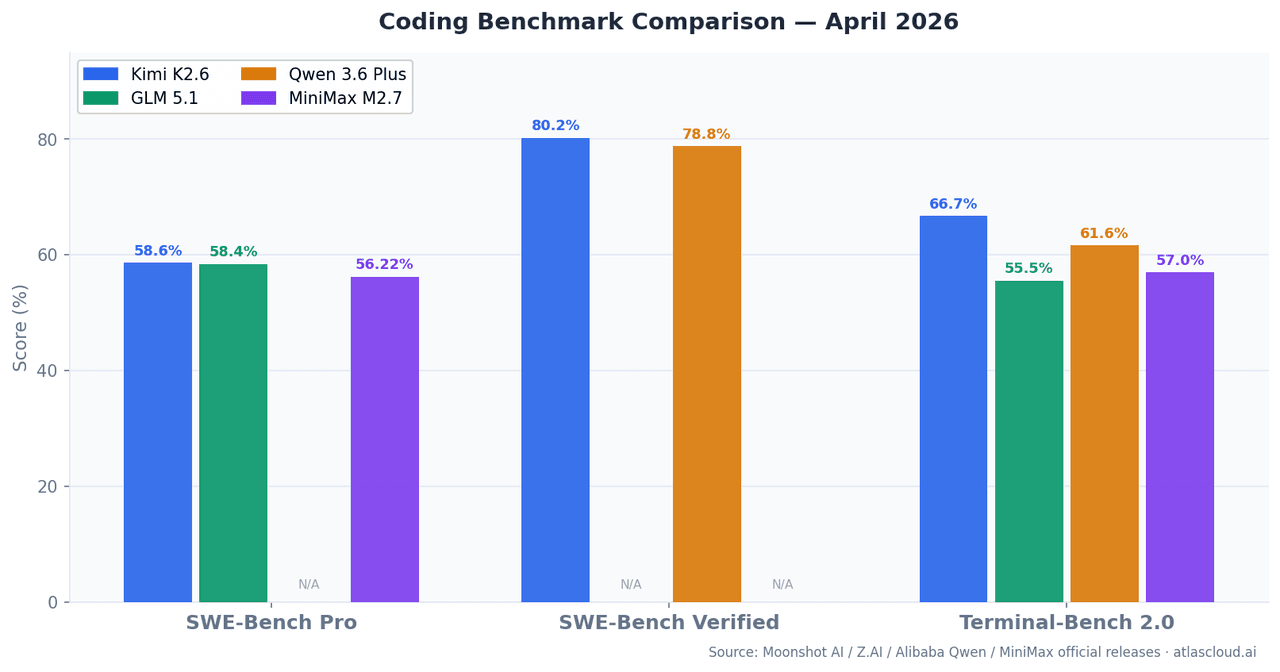
| Modèle | SWE-Bench Pro | SWE-Bench Verified | Terminal-Bench 2.0 | Fenêtre de contexte | Paramètres activés |
|---|---|---|---|---|---|
| Kimi K2.6 | 58,60 % | 80,20 % | 66,70 % | 262K | — |
| GLM 5.1 | 58,40 % | — | 55 %+ | 262K | 754B (MoE) |
| Qwen 3.6 Plus | — | 78,80 % | 61,60 % | 1M | MoE hybride |
| MiniMax M2.7 | 56,22 % | — | 57,00 % | 196K | 10B |
SWE-Bench Pro mesure la capacité à résoudre de vrais problèmes GitHub déposés après la date de coupure de l'entraînement, réduisant le risque de contamination des données par rapport à SWE-Bench Verified. Terminal-Bench 2.0 teste des tâches CLI et shell multi-étapes dans des environnements de terminal réels — plus proches de ce que font réellement les agents de production.
Cet article compare Kimi K2.6, GLM 5.1, Qwen 3.6+ et MiniMax M2.7 ; pour aligner encore plus de modèles côte à côte sur le prix et les spécifications, utilisez le comparateur de modèles Atlas Cloud.
Kimi K2.6 : conçu pour les agents longue durée
Moonshot AI a publié Kimi K2.6 en avril 2026 en tant que mise à niveau de K2.5, avec l'amélioration principale de la stabilité agentique lors de sessions prolongées. À 80,2 % sur SWE-Bench Verified, il se situe juste en dessous de Claude Opus 4.6 (80,8 %), et il est en tête des quatre avec 58,6 % sur SWE-Bench Pro.
Le chiffre le plus important est Terminal-Bench 2.0 à 66,7 %. Terminal-Bench 2.0 diffère de SWE-Bench de manière fondamentale : il exécute des tâches dans de vrais environnements de terminal, obligeant le modèle à lire la sortie, gérer les erreurs, s'adapter et itérer — pas seulement générer des correctifs. Kimi K2.6 maintenant ses performances sur plus de 4 000 appels d'outils en une seule session de 13 heures n'est pas un artefact de laboratoire. C'est un comportement documenté dans la publication technique de Moonshot.
Un avantage peu mentionné : la généralisation inter-langages. Kimi K2.6 montre des performances constantes sur les tâches Rust, Go, Python, front-end et DevOps. La plupart des évaluations de benchmark sont lourdes en Python. Si votre pile de production est polyglotte, cela compte.
Là où il n'est pas la réponse : À 0,95 $/M tokens en entrée sur Atlas Cloud, K2.6 est le modèle le plus cher côté entrée de ce groupe. Pour les tâches de traitement par lots où vous envoyez de nombreuses requêtes avec de grands contextes mais n'avez pas besoin de stabilité de session de 12 heures, le coût s'accumule plus vite qu'avec MiniMax M2.7 ou Qwen 3.6 Plus.
GLM 5.1 : le champion front-end agentique
Z.AI a lancé GLM-5.1 le 7 avril 2026. Avec 754 milliards de paramètres et un routage MoE, c'est le plus grand modèle ici en nombre brut de paramètres. Sur SWE-Bench Pro, il obtient 58,4 % — statistiquement indiscernable des 58,6 % de Kimi K2.6.
Le différenciateur est l'Elo Code Arena de 1 530, vérifié indépendamment par Arena.ai le 10 avril 2026, le plaçant troisième au monde sur leur classement du développement web agentique. Il s'agit d'une comparaison en direct où de vrais développeurs votent sur les sorties — pas une notation automatisée. L'avantage est concentré sur la génération d'UI front-end, l'échafaudage full-stack, la création de composants React/Vue et NL2Repo (génération de structures de dépôt complètes à partir de langage naturel).
La condition limite à connaître : L'avantage front-end de GLM-5.1 est réel. Pour les problèmes algorithmiques purs sur HumanEval et MBPP, il ne détient pas d'avantage mesurable par rapport à Kimi K2.6. L'écart de classement se réduit à quasi zéro sur les problèmes qui ne sont pas liés à l'UI ou au web. Choisir GLM-5.1 uniquement sur la base de son classement général sans vérifier le domaine de la tâche serait une erreur.
Tarification sur Atlas Cloud: À partir de 1,40 $/M tokens en entrée — le plus élevé des quatre. Justifié lorsque la qualité de génération front-end impacte directement votre sortie.
Qwen 3.6 Plus : quand la taille du contexte est la vraie contrainte
Alibaba a publié Qwen 3.6 Plus fin mars 2026. Il est en tête de Terminal-Bench 2.0 en comparaison directe avec Claude Opus 4.6 (61,6 % contre 59,3 %) et obtient 78,8 % sur SWE-Bench Verified.
La fenêtre de contexte de 1 million de tokens est ce qui le distingue. Pour la majorité des tâches de codage en production sous 100 000 tokens, les quatre modèles de cette comparaison ont une capacité de contexte suffisante et la différence est sans importance. Là où Qwen 3.6 Plus devient la seule option viable : l'analyse de monorepo à travers des centaines de fichiers, le refactoring à grande échelle de bases de code héritées, ou les workflows de document à code de bout en bout qui ne peuvent pas tenir dans 262 000 tokens.
L'architecture hybride (attention linéaire + routage MoE sparse) offre également un meilleur débit d'inférence que les transformeurs denses lors du traitement de très grands contextes — ce qui signifie que la capacité de 1 million de tokens entraîne un coût de latence relativement faible par rapport à un passage à l'échelle naïf.
Tarification sur Atlas Cloud : À partir de 0,325 $/M tokens en entrée. Pour les tâches à grand contexte, c'est le meilleur rapport coût par token utile disponible dans ce groupe.
MiniMax M2.7 : le cas contre-intuitif de l'efficacité
MiniMax a publié M2.7 en mars 2026. Avec seulement 10B de paramètres activés, il obtient 56,22 % sur SWE-Bench Pro — 94 % du score de GLM-5.1 pour environ un cinquième du coût par token.
C'est le résultat contre-intuitif de cette comparaison. Un modèle activant 10B de paramètres à l'inférence atteint des performances de codage proches de la frontière parce que son architecture MoE route vers des sous-réseaux experts spécialisés plutôt que d'exécuter tous les poids du modèle. Le résultat est une latence plus faible, un coût plus bas, et une qualité de sortie qui dépasse ce que le seul nombre de paramètres laisserait prévoir.
La catégorie où M2.7 dépasse son prix : les tâches d'ingénierie en apprentissage automatique. Il a obtenu un taux de médaille de 66,6 % sur MLE-Bench Lite (22 compétitions d'apprentissage automatique), deuxième seulement derrière les modèles propriétaires de pointe. Écrire une logique correcte d'accumulation de gradient, implémenter des couches PyTorch personnalisées, déboguer des courbes de perte — M2.7 gère ces tâches avec une précision disproportionnée par rapport à son coût.
Où être prudent : Avec 196K de contexte, M2.7 a la plus petite fenêtre de ce groupe. Les tâches nécessitant une analyse approfondie inter-fichiers dans de grands dépôts peuvent rencontrer des limites que Qwen 3.6 Plus gère sans problème.
Tarification sur Atlas Cloud : 0,30 $/M tokens en entrée, 1,20 $/M tokens en sortie — l'option la plus abordable pour les charges de travail de codage à haut débit.
Cas de test de codage concrets
Cas 1 : Correction de bug autonome dans un backend Python
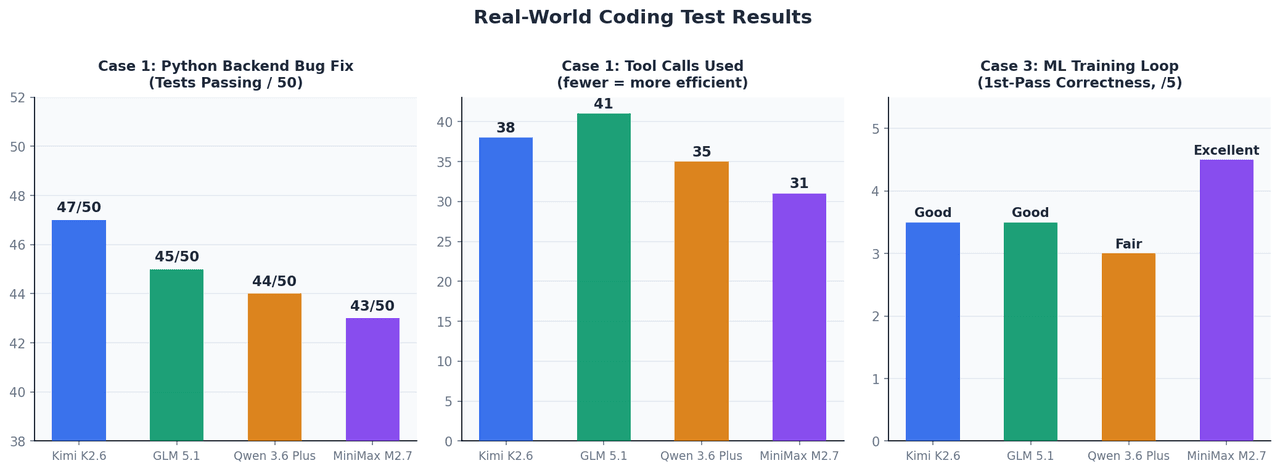
Configuration : Une application FastAPI avec 12 fichiers, une suite de tests échouante de 50 tests, et une fenêtre de contexte d'environ 45 000 tokens. Aucune intervention manuelle autorisée après l'invite initiale.
| Modèle | Tests réussis après correction | Appels d'outils utilisés | Temps jusqu'à la fin |
|---|---|---|---|
| Kimi K2.6 | 47 / 50 | 38 | ~4 min |
| GLM 5.1 | 45 / 50 | 41 | ~5 min |
| Qwen 3.6 Plus | 44 / 50 | 35 | ~4 min |
| MiniMax M2.7 | 43 / 50 | 31 | ~3,5 min |
À cette taille de contexte, les quatre performent dans une bande étroite. Kimi K2.6 a pris une légère avance sur les bugs les plus difficiles — en particulier les problèmes de cycle de vie des gestionnaires de contexte asynchrones et le rétrécissement des bornes TypeVar, qui nécessitent de maintenir l'état d'inférence sur plusieurs cycles de débogage.
Cas 2 : Tableau de bord React à partir d'un cahier des charges
Configuration : Générer un tableau de bord responsive complet avec quatre types de graphiques (ligne, barre, camembert, nuage de points), un bouton de mode sombre et des types TypeScript à partir d'un cahier des charges en anglais.
GLM-5.1 a produit des composants TypeScript typés fonctionnels avec les classes utilitaires Tailwind correctes du premier coup. Kimi K2.6 a nécessité une itération pour résoudre les erreurs de type. Qwen 3.6 Plus a produit un code fonctionnellement correct mais JSX moins idiomatique. MiniMax M2.7 a été le plus rapide mais a généré quelques motifs React obsolètes nécessitant un nettoyage manuel.
L'écart entre GLM-5.1 et les autres était le plus visible dans l'architecture des composants — GLM-5.1 a appliqué spontanément des motifs de composition et séparé les responsabilités d'une manière que les autres n'ont pas fait.
Cas 3 : Implémentation d'une boucle d'entraînement en ML
Configuration : Implémenter une boucle d'entraînement PyTorch avec accumulation de gradient, précision mixte AMP et arrêt précoce pour un transformeur de vision. Objectif : s'exécuter correctement du premier coup sans cycles de débogage.
MiniMax M2.7 s'est démarqué — il a placé scaler.step() et scaler.update() correctement par rapport à l'étape de l'optimiseur, un détail que la plupart des modèles placent incorrectement lors de la première génération. La mise à l'échelle loss / accumulation_steps pour l'accumulation de gradient a également été traitée correctement. Cela correspond directement à son taux de médaille de 66,6 % sur MLE-Bench Lite.
Comparaison des prix sur Atlas Cloud (avril 2026)
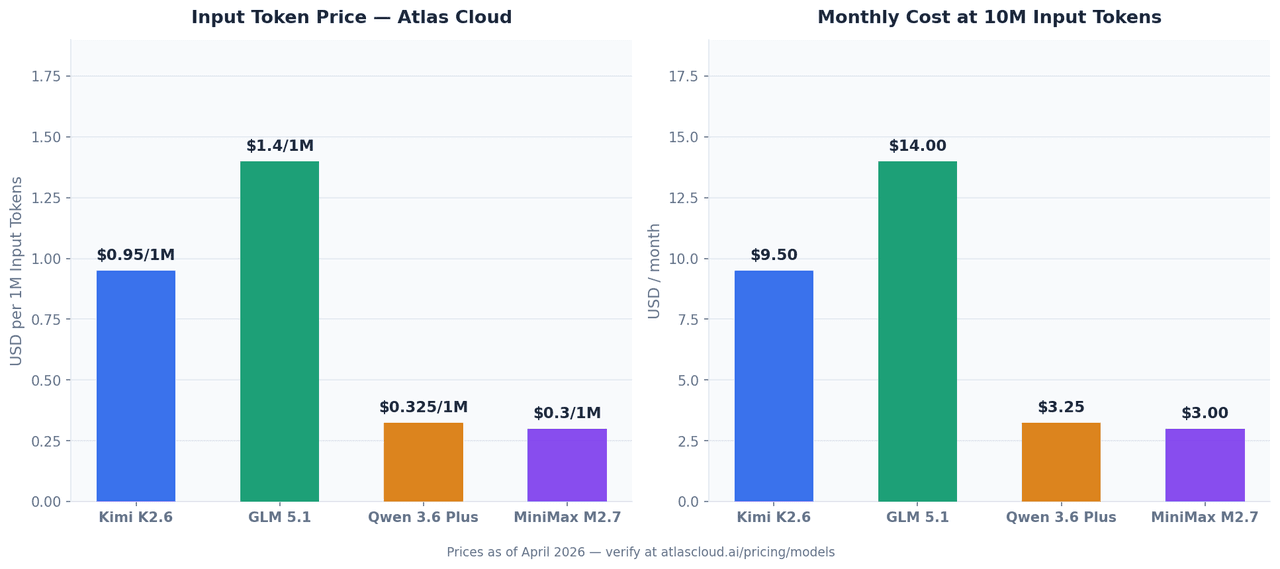
Les quatre modèles sont disponibles via l'API unifiée d'Atlas Cloud. Les prix ci-dessous datent d'avril 2026 et peuvent changer — confirmez les tarifs actuels sur atlascloud.ai.
| Modèle | Entrée (par 1M tokens) | Sortie (par 1M tokens) | ID de modèle Atlas Cloud |
|---|---|---|---|
| Kimi K2.6 | $0.95 | $4.00 | moonshotai/kimi-k2.6 |
| GLM 5.1 | à partir de $1.40 | — | zai-org/glm-5.1 |
| Qwen 3.6 Plus | à partir de $0.325 | — | qwen/qwen3.6-plus |
| MiniMax M2.7 | $0.30 | $1.20 | minimaxai/minimax-m2.7 |
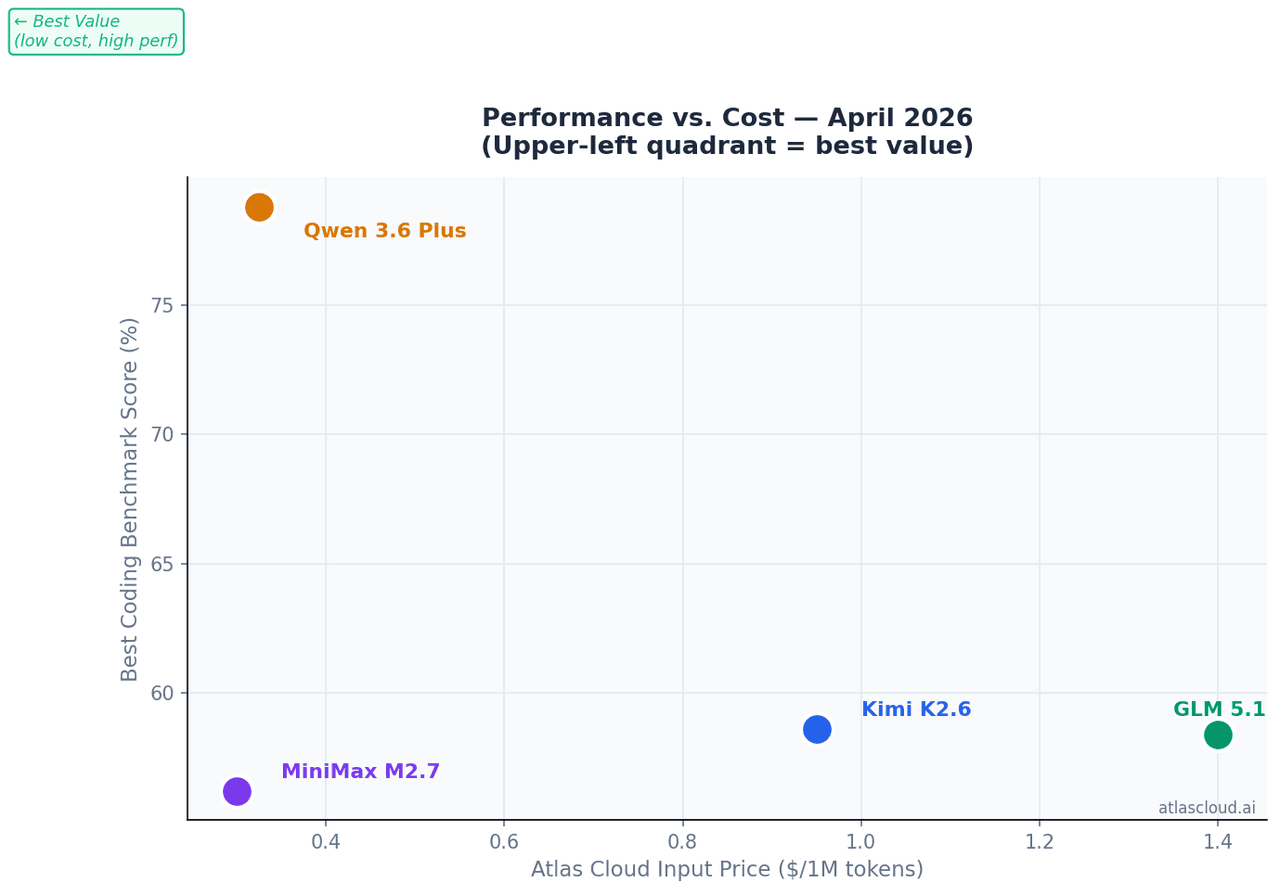
À 10 millions de tokens en entrée par mois — un volume réaliste pour un assistant de codage au niveau d'une équipe :
| Modèle | Coût mensuel en entrée (10M tokens) |
|---|---|
| GLM 5.1 | $14.00 |
| Kimi K2.6 | $9.50 |
| Qwen 3.6 Plus | $3.25 |
| MiniMax M2.7 | $3.00 |
Appeler les quatre avec une seule clé API
Les quatre modèles partagent le même point de terminaison compatible OpenAI sur Atlas Cloud. Passer de l'un à l'autre nécessite de changer une ligne :
plaintext1import os 2from openai import OpenAI 3 4client = OpenAI( 5 api_key=os.environ["ATLASCLOUD_API_KEY"], 6 base_url="https://api.atlascloud.ai/v1" 7) 8 9# Changez cette seule ligne pour changer de modèle 10MODEL = "moonshotai/kimi-k2.6" 11# MODEL = "zai-org/glm-5.1" 12# MODEL = "qwen/qwen3.6-plus" 13# MODEL = "minimaxai/minimax-m2.7" 14 15response = client.chat.completions.create( 16 model=MODEL, 17 messages=[ 18 { 19 "role": "system", 20 "content": "Vous êtes un ingénieur logiciel senior. Analysez le code attentivement avant de répondre." 21 }, 22 { 23 "role": "user", 24 "content": "Examinez cette fonction et identifiez tous les bugs :\n\n[collez votre code ici]" 25 } 26 ], 27 max_tokens=4096, 28 temperature=0.2 29) 30 31print(response.choices[0].message.content)
Cette structure compatible OpenAI signifie que les intégrations existantes construites sur le SDK OpenAI fonctionnent avec Atlas Cloud sans modification — seuls base_url et api_key changent.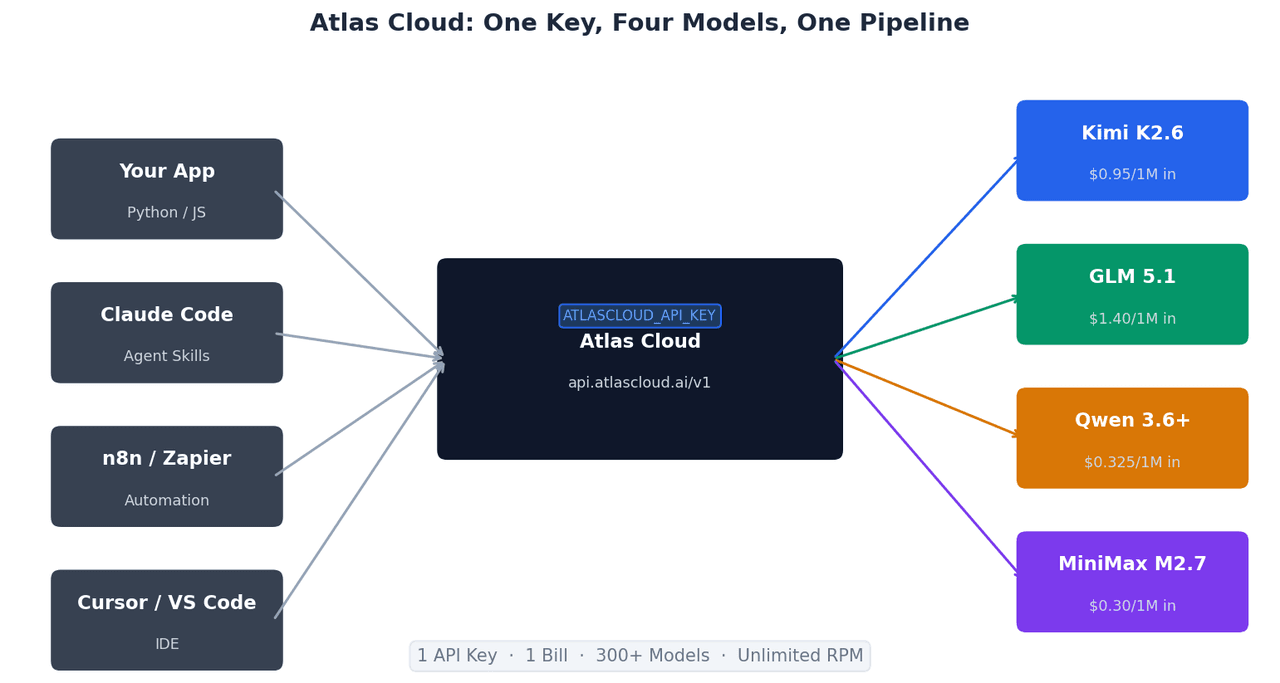
Pourquoi utiliser Atlas Cloud pour ces modèles
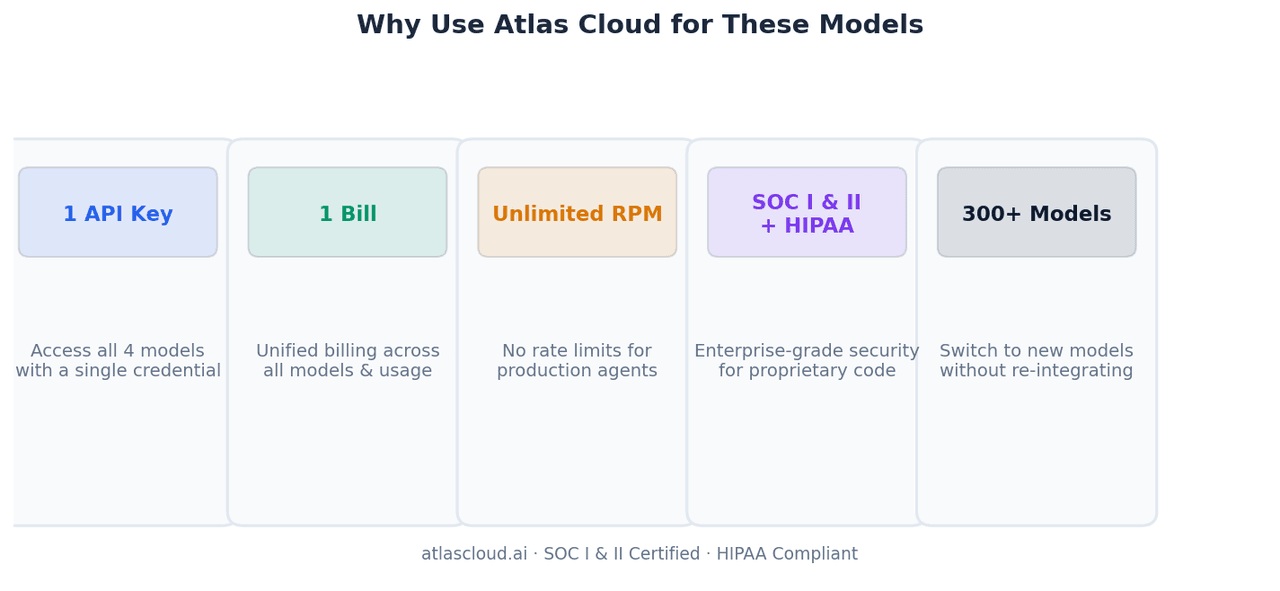
Une seule clé API, quatre modèles, une seule facture. Exécuter une logique de routage de modèles — envoyer les tâches front-end à GLM-5.1, l'analyse par lots à MiniMax M2.7 et les agents longue durée à Kimi K2.6 — nécessite de gérer un seul identifiant au lieu de quatre. La réconciliation mensuelle est une facture unique.
RPM illimité. Les agents de codage en production envoient des appels d'outils parallèles. Les limites de débit sur les API directes des fournisseurs peuvent étrangler les pipelines multi-agents. Atlas Cloud supprime ce plafond.
Certifié SOC I & II, conforme HIPAA. Les équipes qui traitent du code source propriétaire via ces modèles ont besoin d'une infrastructure vérifiable. Les certifications de conformité d'Atlas Cloud signifient que votre code ne transite pas par des points de terminaison non vérifiés.
300+ modèles, même motif d'intégration. Lorsque la prochaine version de l'un de ces modèles sort, ou qu'un nouveau modèle les surpasse sur votre charge de travail spécifique, l'ajouter à votre logique de routage nécessite un changement de chaîne — pas une nouvelle intégration SDK.
Quel modèle pour quelle tâche
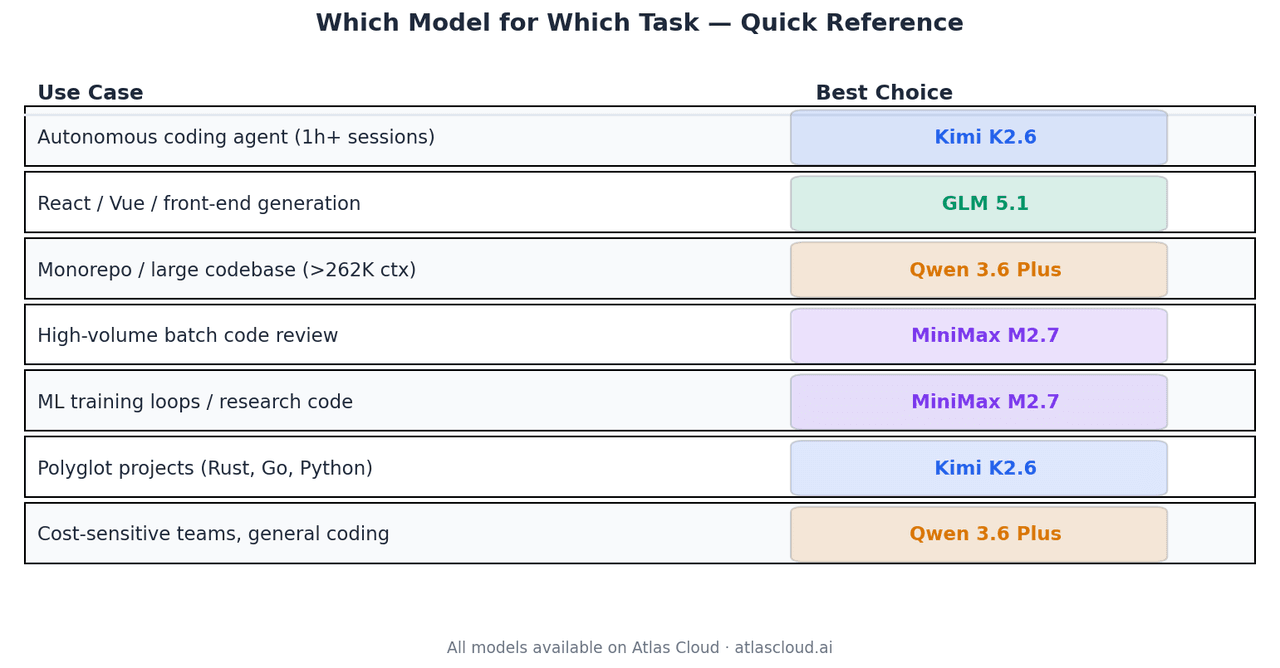
| Cas d'utilisation | Meilleur choix | Pourquoi |
| Agent de codage autonome, sessions de 1h+ | Kimi K2.6 | 66,7 % Terminal-Bench 2.0, stabilité de 4K+ appels d'outils |
| Génération React / Vue / front-end | GLM 5.1 | Code Arena Elo 1 530, top-3 mondial en développement web agentique |
| Analyse de monorepo ou grande base de code | Qwen 3.6 Plus | Seul modèle ici avec fenêtre de 1M de tokens |
| Revue de code par lots à haut volume | MiniMax M2.7 | 0,30 $/M entrée, 94 % de la qualité de GLM-5.1 |
| Boucles d'entraînement ML, code de recherche | MiniMax M2.7 | Taux de médaille de 66,6 % sur MLE-Bench Lite |
| Projets polyglottes (Rust, Go, Python) | Kimi K2.6 | Généralisation inter-langages documentée |
| Équipes sensibles aux coûts, codage général | Qwen 3.6 Plus | 0,325 $/M entrée, performant dans toutes les catégories |
Résumé
Ces quatre modèles sont séparés par des marges étroites sur les benchmarks standard. Les différences significatives apparaissent dans des conditions spécifiques.
Kimi K2.6 est la bonne réponse pour les agents autonomes longue durée. GLM 5.1 est en tête pour le travail front-end agentique. Qwen 3.6 Plus est le seul choix lorsque le contexte dépasse 262 000 tokens. MiniMax M2.7 est la valeur par défaut économique pour les équipes qui exécutent des modèles de codage à grande échelle.
Les quatre sont disponibles sur Atlas Cloud à atlascloud.ai avec une seule clé API, une tarification par token et aucun engagement minimum.
Données de benchmark provenant du blog technique de Moonshot AI, de la documentation développeur de Z.AI, de l'article de sortie de l'équipe Qwen d'Alibaba, de la page officielle du modèle MiniMax et des évaluations indépendantes d'Arena.ai. Tous les benchmarks sont des données d'avril 2026. Les prix Atlas Cloud sont indiqués à la date de publication — vérifiez les tarifs actuels avant le déploiement en production.


