

Un test de mémoire utile ressemble moins à la question « Que retiens-tu de moi ? » qu’à une vérification à livre fermé avec une correction et quelques distractions. Pour exécuter un test Active Memory de Muse Wonder, donnez à Muse Wonder des détails fictifs dans une conversation, corrigez l’un d’eux, puis demandez les faits actuels pertinents dans une nouvelle conversation. Notez ce qu’il récupère, ce qu’il rate et s’il admet une incertitude.
La séquence ci-dessous demande environ 10 minutes à mettre en place et à noter. Cela ne prouve pas la mémoire sur plusieurs jours, comptes ou toutes les surfaces produit Muse. Il s’agit d’une première vérification reproductible. Utilisez des détails inventés plutôt que des informations privées.
Points clés
- Testez séparément la récupération, les corrections, la résistance aux distracteurs, l’incertitude et la traçabilité.
- Exécutez le test dans la surface produit que vous comptez utiliser, avec ses réglages de mémoire documentés.
- Une nouvelle requête API ne teste la mémoire persistante que si l’application ou le service la fournit.
- MemoryBench de Meta est une évaluation interne bien plus longue ; cette courte vérification ne la reproduit pas.
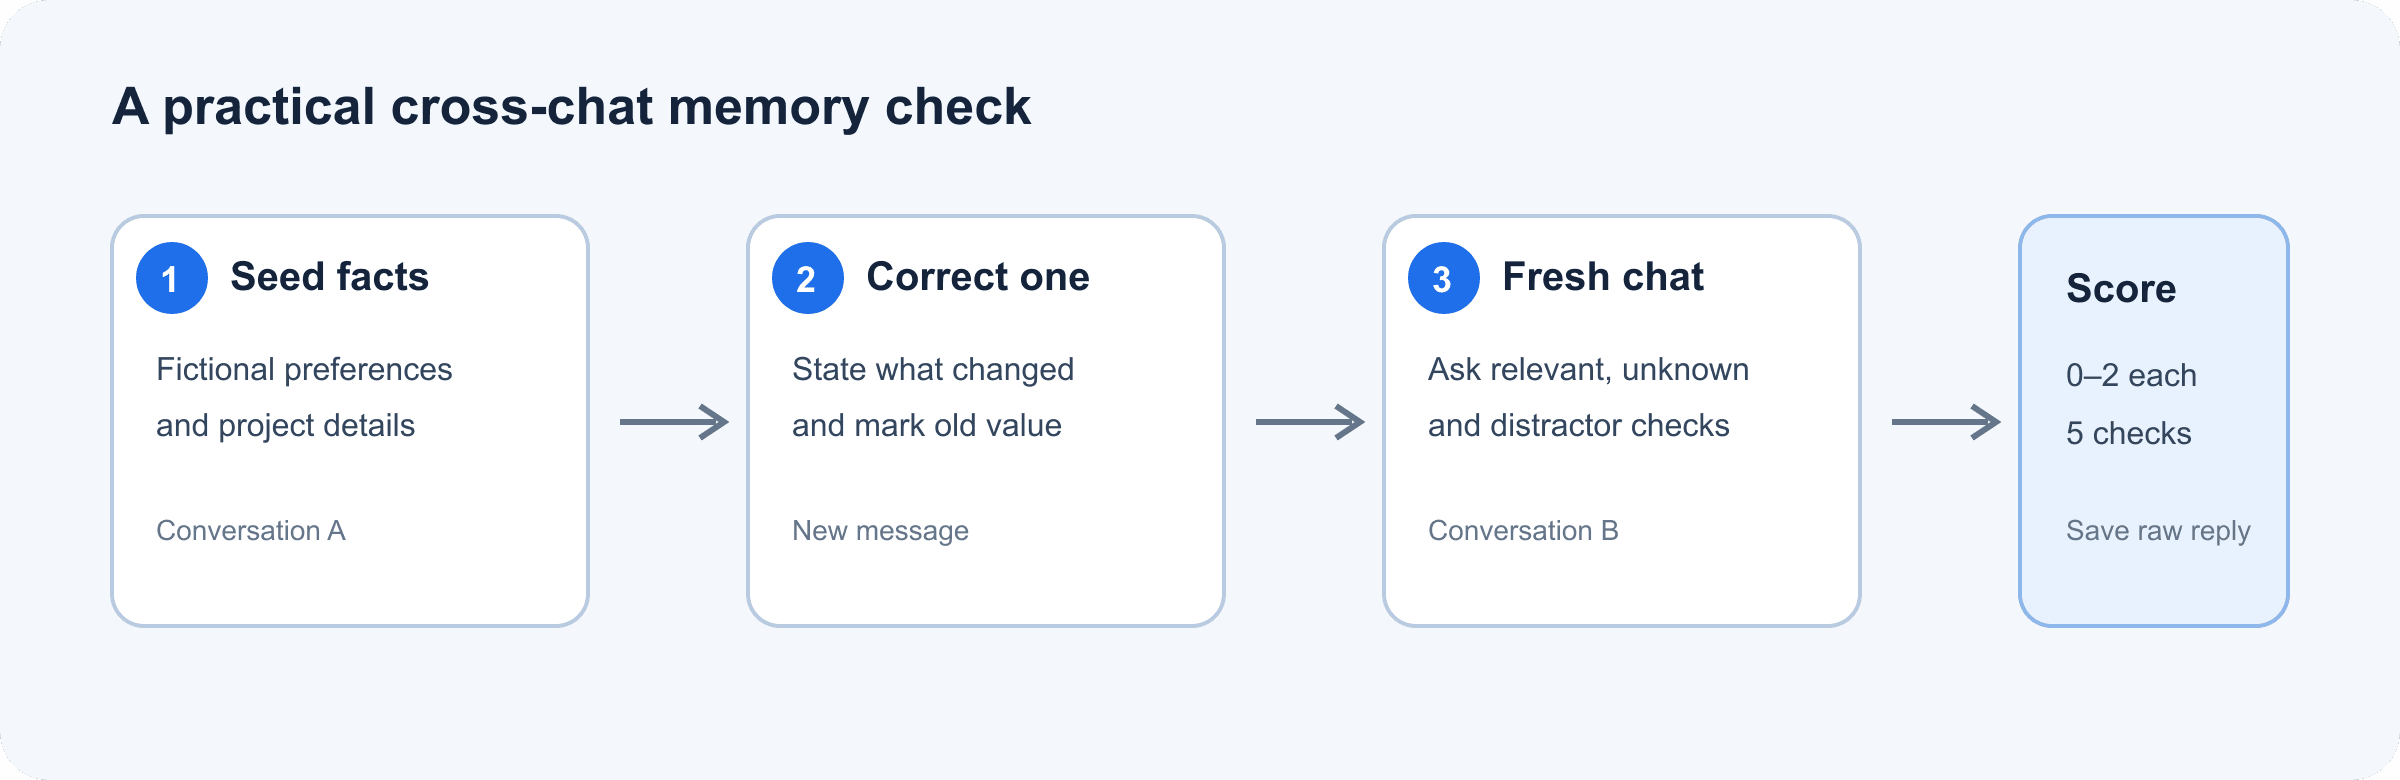
Flux de test Active Memory de Muse Wonder, des détails fictifs à la correction, à la récupération dans une nouvelle conversation et à la notation
Le flux de test sépare les faits initiaux, une correction explicite et la récupération dans une nouvelle conversation.
Ce que l’Active Memory de Muse Wonder est censé faire
Meta décrit Active Memory comme le fait de transporter un contexte important sur une personne d’une conversation à l’autre et de récupérer des détails lorsqu’ils importent pour une tâche ultérieure. Active Focus désigne la poursuite d’un objectif, notamment l’essai d’alternatives en cas de blocage et l’adaptation à de nouvelles informations. Ces idées sont liées, mais elles répondent à des questions différentes : la mémoire concerne le contexte rappelé ; le focus concerne la manière dont le travail progresse.
Cette description est une affirmation de capacité produit, et non une garantie que chaque interface ou appel API partage automatiquement l’historique d’un utilisateur. Meta indique que Muse Wonder est disponible via son Model API et Muse Code. Sa documentation développeur répertorie une fenêtre de contexte de 1 048 576 jetons et des réglages de raisonnement pris en charge, mais une fenêtre de contexte est la quantité de contexte qu’une requête peut contenir, pas la preuve que des requêtes antérieures persistent. Vérifiez l’historique ou la mémoire que votre produit choisi fournit réellement.
Comment exécuter un test de mémoire Muse Wonder
Utilisez un seul compte et la même variante de modèle pendant toute une exécution. Pour un produit de chat, activez la fonctionnalité de mémoire que vous souhaitez évaluer et notez son réglage. Pour une intégration API, indiquez si votre propre application inclut les tours précédents, un profil stocké ou des notes récupérées dans la requête. Sans ces informations, vous ne pouvez pas attribuer le rappel au modèle seul.
1. Fournissez-lui des faits pertinents
Dans la première conversation, collez ce profil fictif. Demandez uniquement un accusé de réception, afin que le modèle ne transforme pas immédiatement les faits en plan.
plaintext1I’m planning a fictional weekend trip. Remember these details for a later planning task: 2- I prefer quiet outdoor activities over crowded events. 3- My fictional trip budget is $400. 4- I avoid shellfish. 5Do not make a plan yet. Reply only with a brief acknowledgment.
Ouvrez une véritable nouvelle conversation dans le même produit, puis demandez :
plaintext1Suggest a suitable weekend activity for me. Use only the preferences I previously shared that matter to this task. List the relevant details you used, and say if you are unsure about any of them.
Une bonne réponse utilise la préférence pour des activités de plein air calmes. Elle n’a pas besoin de mentionner le budget ou les crustacés, car aucun de ces détails n’est nécessaire pour suggérer une activité. Surveillez les préférences inventées. Si le produit ne peut pas accéder aux chats antérieurs ou si la mémoire est désactivée, notez « mémoire indisponible dans cette surface » plutôt que de noter le modèle comme s’il avait reçu les faits.
2. Corrigez un fait obsolète
Dans un autre fil de test, introduisez un rendez-vous, puis remplacez-le explicitement. Gardez la correction dans un message séparé afin de pouvoir déterminer si la mise à jour ultérieure l’emporte.
plaintext1For this fictional project, the review meeting is initially set for Tuesday at 2 p.m. Please retain that detail.
plaintext1Correction: the review meeting has moved to Thursday at 10 a.m. The Tuesday time is outdated. Please use Thursday at 10 a.m. from now on.
Posez la question dans une nouvelle conversation :
plaintext1When is the review meeting? If you have conflicting information, give the current time and explain which update you treated as authoritative.
Réussite si elle donne jeudi à 10 h et considère mardi comme obsolète. Une réponse mélangée ou une utilisation assurée de mardi est un échec significatif, même si le détail d’origine a été parfaitement rappelé.
3. Ajoutez des distracteurs et testez ce qui est inconnu
Ajoutez deux ou trois faits fictifs inoffensifs à la conversation initiale, comme une couleur de projet inventée ou un faux numéro de colis. Après un délai, démarrez une nouvelle conversation et posez une question sur une préférence pertinente, plus une autre sur un fait que vous n’avez jamais fourni. Séparez les questions afin que chaque réponse soit facile à noter.
Un résultat solide utilise la préférence pertinente, laisse de côté les détails sans rapport et déclare ne pas connaître le fait manquant. Pour un test de délai plus strict, répétez la même invite le lendemain. Dix minutes permettent de vérifier une frontière entre nouvelles conversations, mais pas d’établir une rétention sur une semaine.
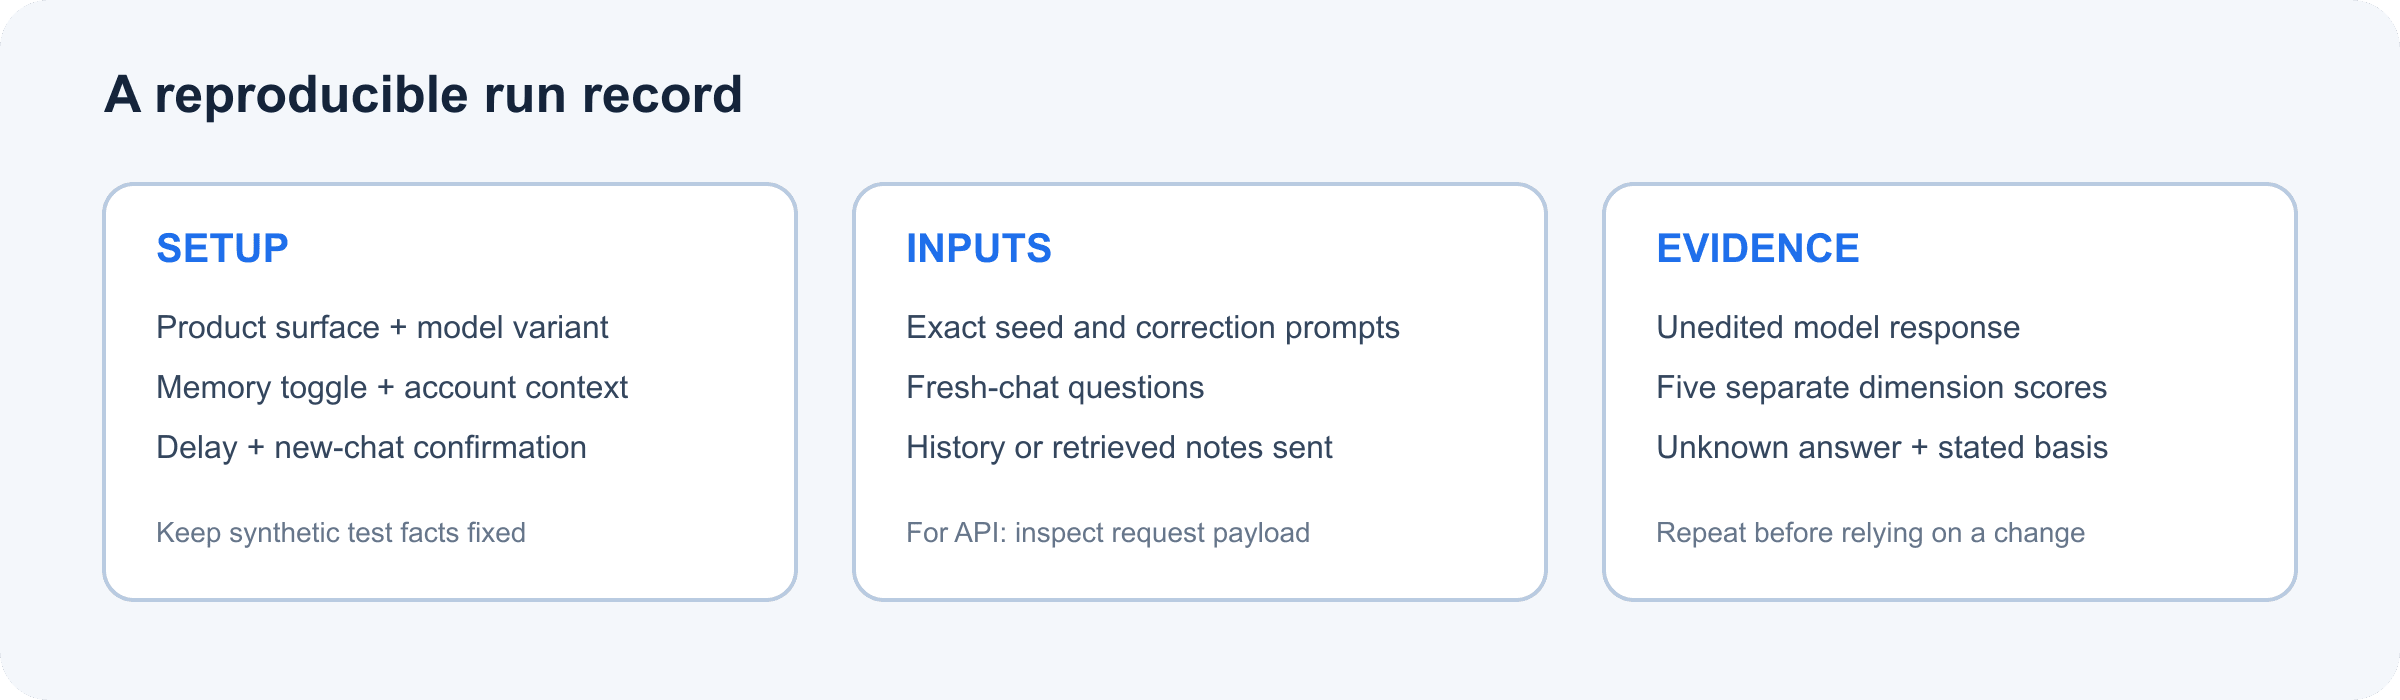
Carte de test Active Memory de Muse Wonder montrant la configuration, les questions pour nouvelle conversation et les preuves à consigner
Conservez ensemble l’invite, la surface produit, le réglage de mémoire, le délai et la réponse brute afin qu’un autre évaluateur puisse reproduire la vérification.
Comment noter le test Active Memory
Notez chaque comportement de 0 à 2. Utilisez le résultat pour comparer des exécutions dans votre propre flux de travail, et non pour classer les modèles de façon universelle.
| Dimension | 0 point | 1 point | 2 points |
|---|---|---|---|
| Récupération des faits pertinents | Rate ou invente le fait nécessaire | Partiellement correct | Sélectionne précisément le bon fait |
| Gestion des corrections | Utilise l’ancienne valeur | Reste vague ou mélange les deux | Utilise la valeur la plus récente et identifie l’ancienne comme obsolète |
| Contrôle des distracteurs | Se laisse attirer par des faits non pertinents | Inclut certains détails non pertinents | Utilise uniquement le contexte pertinent pour la question |
| Incertitude | Devine avec assurance | Nuance mais devine quand même | Dit clairement que la réponse n’a pas été fournie |
| Traçabilité | Ne donne aucune base | Nomme seulement une partie de sa base | Énumère brièvement le contexte sur lequel il s’est appuyé |
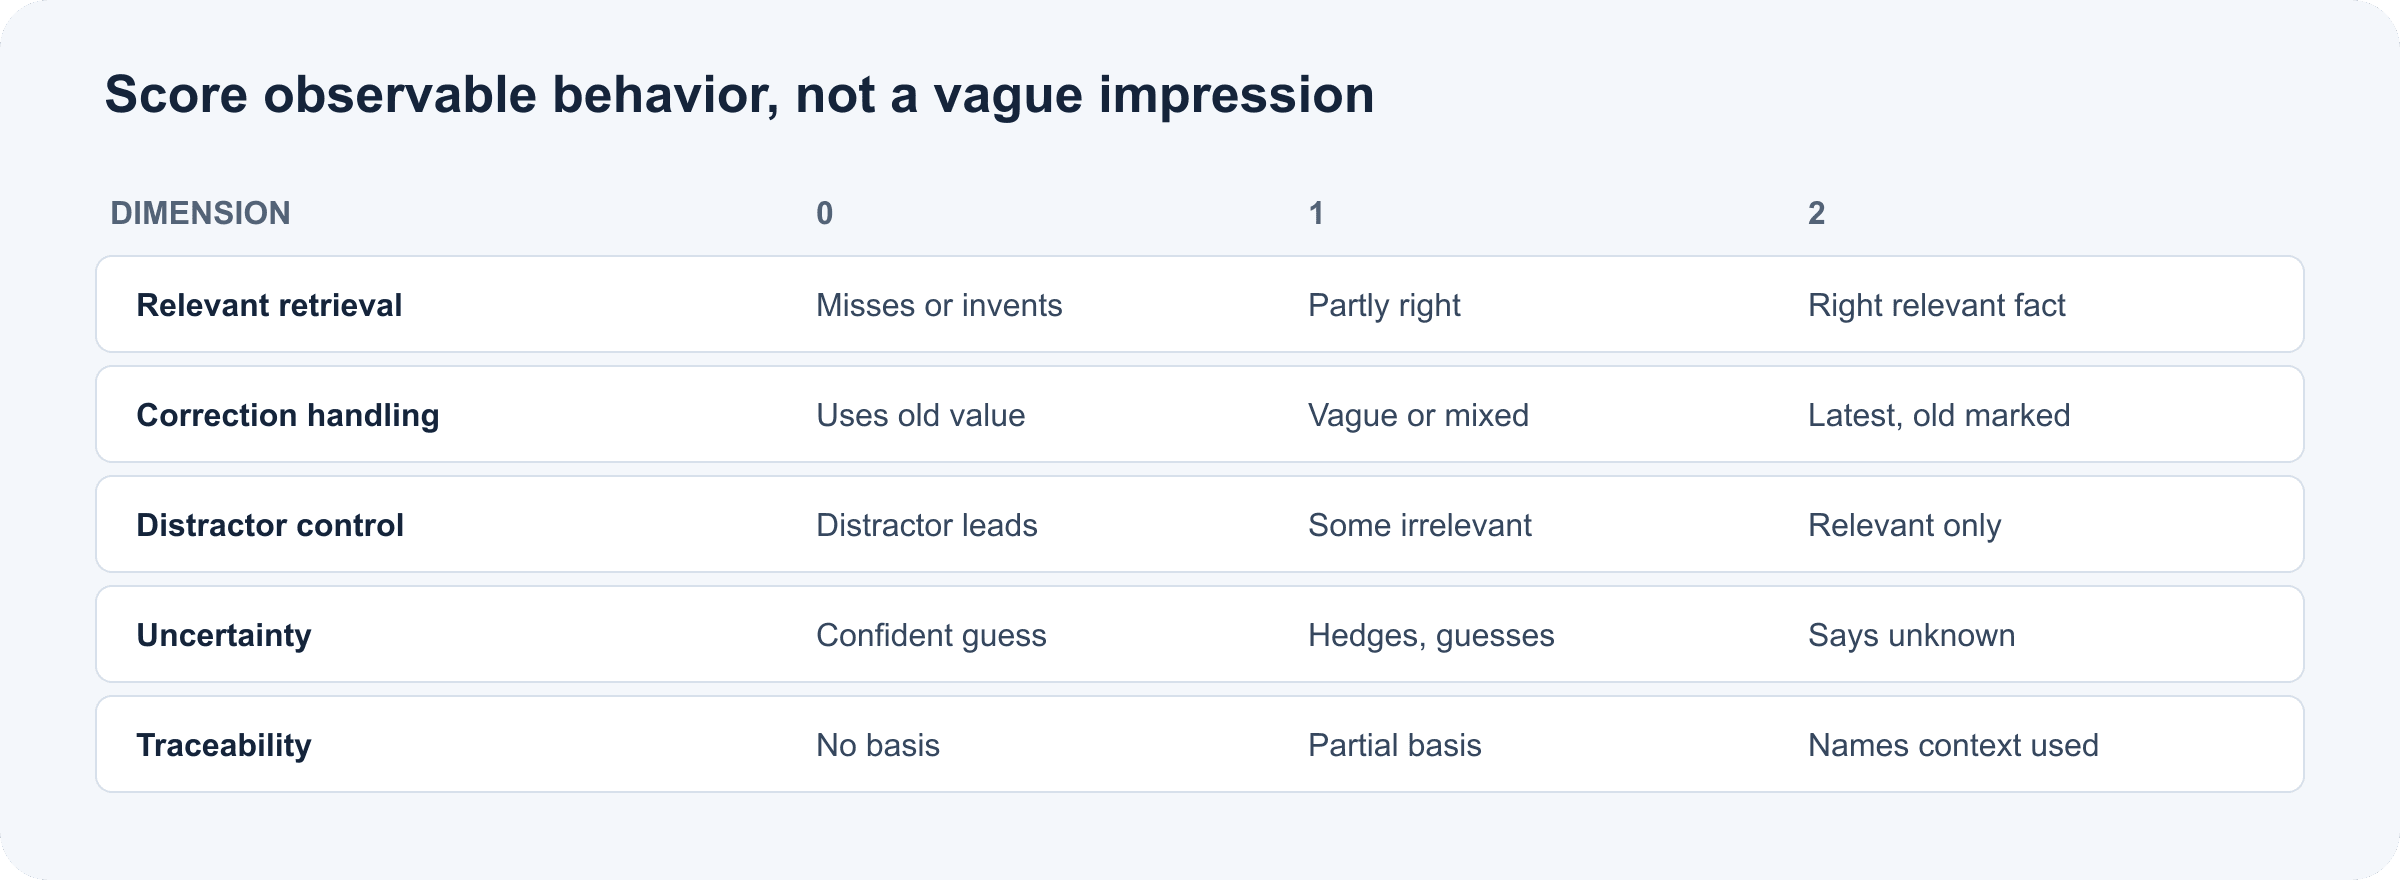
Cinq dimensions de notation Active Memory de zéro à deux points, avec des critères de réussite observables
La grille 0–2 transforme une impression subjective en cinq vérifications observables.
Dix points constituent un score interne pratique, pas un seuil validé. Conservez les scores par dimension : un total peut masquer un grave échec de correction derrière un bon rappel ailleurs. Enregistrez les invites exactes et les sorties non modifiées, puis répétez l’exécution avant de modifier votre décision de déploiement.
Ce que MemoryBench peut et ne peut pas vous dire
La fiche modèle de Meta décrit MemoryBench comme une évaluation interne portant sur de longues conversations complexes de 64 K à 100 K jetons. Ses tâches incluent plusieurs faits, des conversations distractrices et des tours injectés qui entrent en conflit avec les détails cibles ou les mettent à jour ultérieurement ; un juge LLM note les réponses selon des critères pondérés propres à chaque question. C’est un contexte utile pour comprendre la portée du benchmark, mais ce n’est pas la même chose que le réglage de mémoire personnelle d’un utilisateur fonctionnant d’un chat à l’autre.
La fiche modèle explique la conception des tâches ; elle ne transforme pas cet exercice de 10 minutes en réplication. Le score publié par Meta est une preuve concernant la configuration d’évaluation rapportée. Votre exécution répond à une question opérationnelle plus étroite : cette surface produit, cette configuration et ce compte particuliers récupèrent-ils les faits dont votre flux de travail a besoin ? Ni l’un ni l’autre ne permet à lui seul d’établir une mémoire fiable pour chaque utilisateur ou tâche.
Muse Wonder vs Muse Wonder Full : où tester
Les deux variantes n’ont pas les mêmes voies d’accès. La documentation développeur actuelle de Meta indique que Muse Wonder (muse-wonder-1.0) est disponible sur Model API et dans Muse Code. Muse Wonder Full n’est disponible que dans Muse Code avec les forfaits Power Usage et Maximum Usage. Régler l’effort de raisonnement de Muse Wonder sur « max » ne le bascule pas vers Wonder Full.
| Variante | Accès documenté | À consigner |
|---|---|---|
| Muse Wonder | Model API et Muse Code | ID de modèle API ou surface Muse Code, et si un contexte antérieur est fourni |
| Muse Wonder Full | Muse Code avec les forfaits Power Usage et Maximum Usage | Forfait, variante sélectionnée et réglage de mémoire disponible dans cette surface |
Exécutez le même profil fictif séparément dans chaque surface disponible. Ne comparez pas un test Muse Code capable de récupérer des détails de profil enregistrés avec un appel API sans état qui n’a reçu que l’invite actuelle. Cela comparerait des systèmes différents, et pas seulement deux variantes de modèle.
Confidentialité et tests reproductibles
Utilisez des préférences, des dates et des détails de projet inventés. Avant d’essayer des données réelles, examinez les contrôles de mémoire du produit, le processus de suppression, les informations de conservation et le réglage d’utilisation des données. La documentation API de Meta indique que le contenu en mode Standard n’est pas utilisé pour entraîner les modèles Meta ; Muse Code propose aussi un mode Contributor, activé par défaut et susceptible d’utiliser le contenu pour l’entraînement s’il n’est pas désactivé. Vérifiez les réglages et conditions actuels du produit que vous utilisez plutôt que de supposer que toutes les surfaces traitent les données de la même manière.
Pour une API, séparez le modèle de la couche mémoire de votre application. Une base de données, un système de récupération ou un historique d’invites que votre logiciel envoie peut être ce qui se souvient. Journalisez ce que l’application a récupéré et ce qu’elle a transmis dans chaque requête, tout en gardant les enregistrements de test synthétiques.
Les équipes peuvent transformer les trois tours en un petit ensemble d’évaluation versionné. Gardez fixes le profil de faits, la correction, les distracteurs, la variante de modèle, les réglages produit, le délai et la réponse brute. Relancez après des modifications de configuration ou de modèle et examinez les échecs par dimension. Pour les équipes qui comparent déjà des modèles hébergés dans un harnais reproductible, Atlas Cloud propose un catalogue et un guide d’API LLM unifiée. Vous pouvez parcourir son répertoire de modèles pour une comparaison distincte. Le répertoire ne répertorie actuellement pas Muse Wonder, et l’utilisation d’un autre modèle à cet endroit ne testerait que le contexte explicitement fourni à ce modèle, sauf si votre application ajoute une couche mémoire.
Questions fréquentes
Comment tester l’Active Memory de Muse Wonder entre les chats ?
Fournissez des faits fictifs dans une conversation, puis posez des questions sur les détails pertinents dans une nouvelle conversation. Incluez une correction et un fait manquant, et consignez la surface produit et les réglages de mémoire.
Muse Wonder se souvient-il des corrections ou seulement des détails antérieurs ?
La description de MemoryBench par Meta inclut des tours qui mettent à jour des détails antérieurs ou entrent en conflit avec eux. Votre propre test de correction vérifie si la configuration produit actuelle suit la mise à jour ; répétez-le, car un seul résultat n’établit pas un comportement constant.
Ce test d’historique de chat est-il identique au MemoryBench de Meta ?
Non. Meta décrit MemoryBench comme un benchmark interne de contexte long utilisant des conversations de 64 K à 100 K jetons, des distracteurs, des faits contradictoires ou mis à jour et un juge LLM. Cette courte vérification est un test de fumée pratique, pas une réplication.
Puis-je tester l’Active Memory de Muse Wonder via l’API ?
Vous pouvez tester le rappel par le modèle API du contexte qui atteint la requête. Pour la persistance entre requêtes, vérifiez ce que l’API ou votre application stocke et envoie. La disponibilité d’une grande fenêtre de contexte ne prouve pas en soi que des requêtes distinctes partagent une mémoire.
Comment distinguer la mémoire du modèle de la mémoire stockée par l’application ?
Inspectez la requête complète envoyée au modèle. Si votre application insère un profil, une note récupérée ou une conversation antérieure, c’est cette couche logicielle qui a fourni la mémoire. Comparez avec une exécution contrôlée qui l’omet, le cas échéant.
Est-il sûr d’utiliser des informations personnelles dans un test Active Memory ?
Utilisez des informations fictives pour le test. Si vous évaluez ensuite des données réelles, examinez d’abord les réglages de mémoire, de suppression, de conservation et d’utilisation des données du produit concerné.
Un test Active Memory de Muse Wonder est surtout utile lorsqu’il révèle quelle étape a échoué : accès au contexte antérieur, récupération, correction, filtrage ou incertitude. Enregistrez l’exécution brute, puis répétez-la dans la configuration exacte à laquelle vous comptez faire confiance.
Sources : Annonce de Muse Wonder par Meta (12 octobre 2026) ; Documentation des modèles de l’API Meta Model (consultée le 15 octobre 2026) ; Fiche modèle Muse Wonder (octobre 2026).





