

Un benchmark de pointe peut sembler décisif jusqu’à ce que le même modèle manque une exigence à l’exécution suivante. Un test de fiabilité muse wonder utile pose une question plus précise : le modèle accomplit-il votre tâche, selon votre standard, de manière répétée, dans les mêmes conditions ?
Les premières preuves sont mitigées, car les tests mesurent des choses différentes. Un ensemble de tâches du jour du lancement a attribué à Muse Wonder standard un score très élevé après une seule exécution par tâche. Une autre évaluation a relevé des forces en analyse de recherche, ainsi que des faiblesses en conception d’enquête, en allégations commerciales et en mise en page de diapositives. Aucun de ces résultats ne prouve la constance avec laquelle il gérera votre base de code ou votre workflow d’agent.
Points clés
- Considérez les benchmarks de lancement comme des signaux de capacité, pas comme des garanties de production.
- Muse Wonder et Muse Wonder Full sont des variantes distinctes. Séparez leurs résultats.
- Mesurez le taux de réussite, la répétabilité, l’achèvement et la reprise comme des résultats distincts.
- Commencez avec 10 à 20 tâches réelles, figez la configuration et répétez les tâches importantes au moins trois fois.
- Choisissez un seuil en fonction du coût d’une mauvaise réponse et de votre processus de revue humaine.
Muse Wonder est-il fiable ? La réponse courte
Les preuves disponibles au 15 octobre 2026 soutiennent une évaluation tâche par tâche, pas un verdict de fiabilité universel. Muse Wonder a bien performé sur certains premiers contrôles, tandis que d’autres exécutions ont exposé des erreurs ou un travail de présentation qui nécessitait encore une revue. Les études diffèrent par les prompts, les paramètres de raisonnement, les évaluateurs, les tailles d’échantillon et le nombre de tentatives.
(Meta, 12 octobre 2026) indique que Muse Wonder et Muse Wonder Full sont conçus pour des tâches d’agent professionnelles et personnelles, avec des fonctionnalités appelées Active Memory et Active Focus. Ce sont des affirmations produit sur le comportement attendu. Une affirmation selon laquelle un modèle peut se remettre d’erreurs est une raison de tester la reprise dans votre propre workflow, pas une preuve qu’il récupérera de manière fiable.
Gardez Wonder standard séparé de Wonder Full. Meta liste Muse Wonder standard pour son Model API et Muse Code, tandis que Full est proposé via les abonnements Muse Code. Exécuter Wonder standard avec un paramètre de raisonnement plus élevé ne le transforme pas en Full.
Pour une décision défendable, testez la variante et la route exactes que vous comptez déployer. Ne comptez une tâche comme réussie que lorsqu’elle respecte une règle d’acceptation écrite et que son résultat peut être vérifié.
Ce qu’un test de fiabilité Muse Wonder doit mesurer
Précision et constance sont différentes
Un taux de réussite mesure combien de tentatives respectent une grille définie. La constance mesure si des exécutions répétées de la même tâche produisent des résultats acceptables à chaque fois. Un modèle peut avoir un taux de réussite élevé tout en variant de manières qui comptent pour votre workflow.
Suivez quatre dimensions séparément :
| Mesure | Ce qu’il faut enregistrer | Exemple de contrôle |
|---|---|---|
| Précision | Tentatives qui passent la grille | Le total extrait correspond-il au document source ? |
| Constance | Si les tentatives répétées passent et concordent | Trois exécutions préservent-elles les mêmes contraintes requises ? |
| Qualité d’achèvement | Si chaque livrable demandé est présent | Tous les fichiers, citations et champs demandés sont-ils inclus ? |
| Reprise | Si l’exécution reprend correctement après une panne | Signale-t-elle un échec d’outil, réessaie-t-elle prudemment, puis vérifie-t-elle l’état final ? |
Une réponse qui semble complète n’est pas forcément complète. Une modification de code nécessite des tests ; un résumé de recherche nécessite des sources traçables ; une exécution d’agent nécessite la preuve que son action finale a eu lieu.
Séparez les défaillances du modèle des défaillances du workflow
Enregistrez suffisamment de contexte pour distinguer une erreur de modèle d’un problème de service ou d’outil. Au minimum, journalisez la variante et la version du modèle, le paramètre de raisonnement, le prompt, la configuration des outils, la date, le temps d’exécution, le coût en tokens ou par tâche, et la sortie brute.
Classez les défaillances avant de les noter :
- Modèle : fait incorrect, mauvais raisonnement ou exigence manquée.
- Outil : appel API échoué, arguments d’outil invalides ou résultat erroné d’un système externe.
- Service : délai d’attente, interruption ou point de terminaison indisponible.
- Évaluation : grille peu claire ou contrôle incapable de distinguer un travail acceptable d’un travail inacceptable.
Si vous combinez les quatre en un seul taux d’échec, vous ne saurez pas quoi corriger.
Ce que montrent les tests actuels de Muse Wonder
Les comparaisons de benchmarks publiées par Meta sont des preuves fournisseur concernant la performance sur benchmark. Elles ne sont pas équivalentes à une évaluation de workflow menée indépendamment. Les tests indépendants ont aussi leurs limites : un petit ensemble de tâches publiques, une seule tentative, une route de modèle particulière ou une note de préférence humaine ne répondent qu’à une question étroite.
Le tableau ci-dessous sépare les preuves par source et par portée. C’est un guide de ce que chaque résultat peut étayer, pas un score combiné.
| Source de preuve | Ce qui a été testé | Date et configuration | Ce qu’elle peut vous apprendre | Principale limite |
|---|---|---|---|---|
| Annonce Meta et supports du modèle | Benchmarks de capacité et fonctionnalités d’agent prévues | Annoncée le 12 octobre 2026 ; comparaisons rapportées par le fournisseur | Quelles capacités Meta met en avant et quelles variantes elle a publiées | Les tests du fournisseur n’établissent pas la répétabilité dans votre workflow |
| (Spring Prompt, 13 octobre 2026) | Enquêtes, fiches produit, diapositives, planification publicitaire, échecs et recherche visuelle | 13 octobre ; modèle API standard, raisonnement généralement moyen ; tâches publiques | La performance variait selon la tâche ; certaines évaluations incluaient des exécutions répétées de fiches produit | La plupart des tâches étaient de petits échantillons ; beaucoup de résultats provenaient d’une seule exécution par tâche ; pas un test de codage ou Muse Code |
| (Quantslant, 12 octobre 2026) | 23 tâches couvrant agents, codage, rédaction, raisonnement et un document long | 12 octobre ; modèle standard via OpenRouter, faible raisonnement ; une exécution par tâche | Le modèle a réussi cet ensemble de tâches défini à un taux élevé dans cette configuration | Une seule exécution ne peut pas mesurer la constance d’une exécution à l’autre ; les résultats proches de 100 % nécessitent une inspection au niveau des tâches |
| Publications communautaires | Réactions individuelles sur le codage, les agents et les benchmarks | Publications de la période de lancement ; utilisateurs et tâches auto-sélectionnés | Pistes utiles pour ce qu’il faut tester ensuite | Les anecdotes et votes ne sont pas des taux de réussite mesurés |
Le contraste entre les sources compte. Quantslant a rapporté 99,7 % sur son ensemble de 23 tâches, avec une exécution par tâche et un faible paramètre de raisonnement. Il a également noté un test unitaire échoué dans une tâche de codage de conversion de nombres en mots. Ce résultat est une preuve concernant cette suite particulière, pas une preuve que 99,7 % des tâches quotidiennes réussiront ou que des exécutions répétées concorderont.
Spring Prompt a rapporté un tableau plus varié pour Wonder standard aux paramètres par défaut de l’API le 13 octobre. Son score d’analyse de recherche était de 93,6/100 sur neuf tâches publiques, tandis que seulement trois plans d’enquête sur neuf passaient tous les contrôles. Pour les fiches produit, la part jugée réellement prête à publier sur trois répétitions était de 66,1 % pour les briefs factuels et de 51,8 % pour les briefs commerciaux. Cinq présentations sur six nécessitaient des corrections de mise en page, et une a été jugée présentable. Ce sont des mesures distinctes avec des dénominateurs distincts, pas des éléments d’un score global unique.
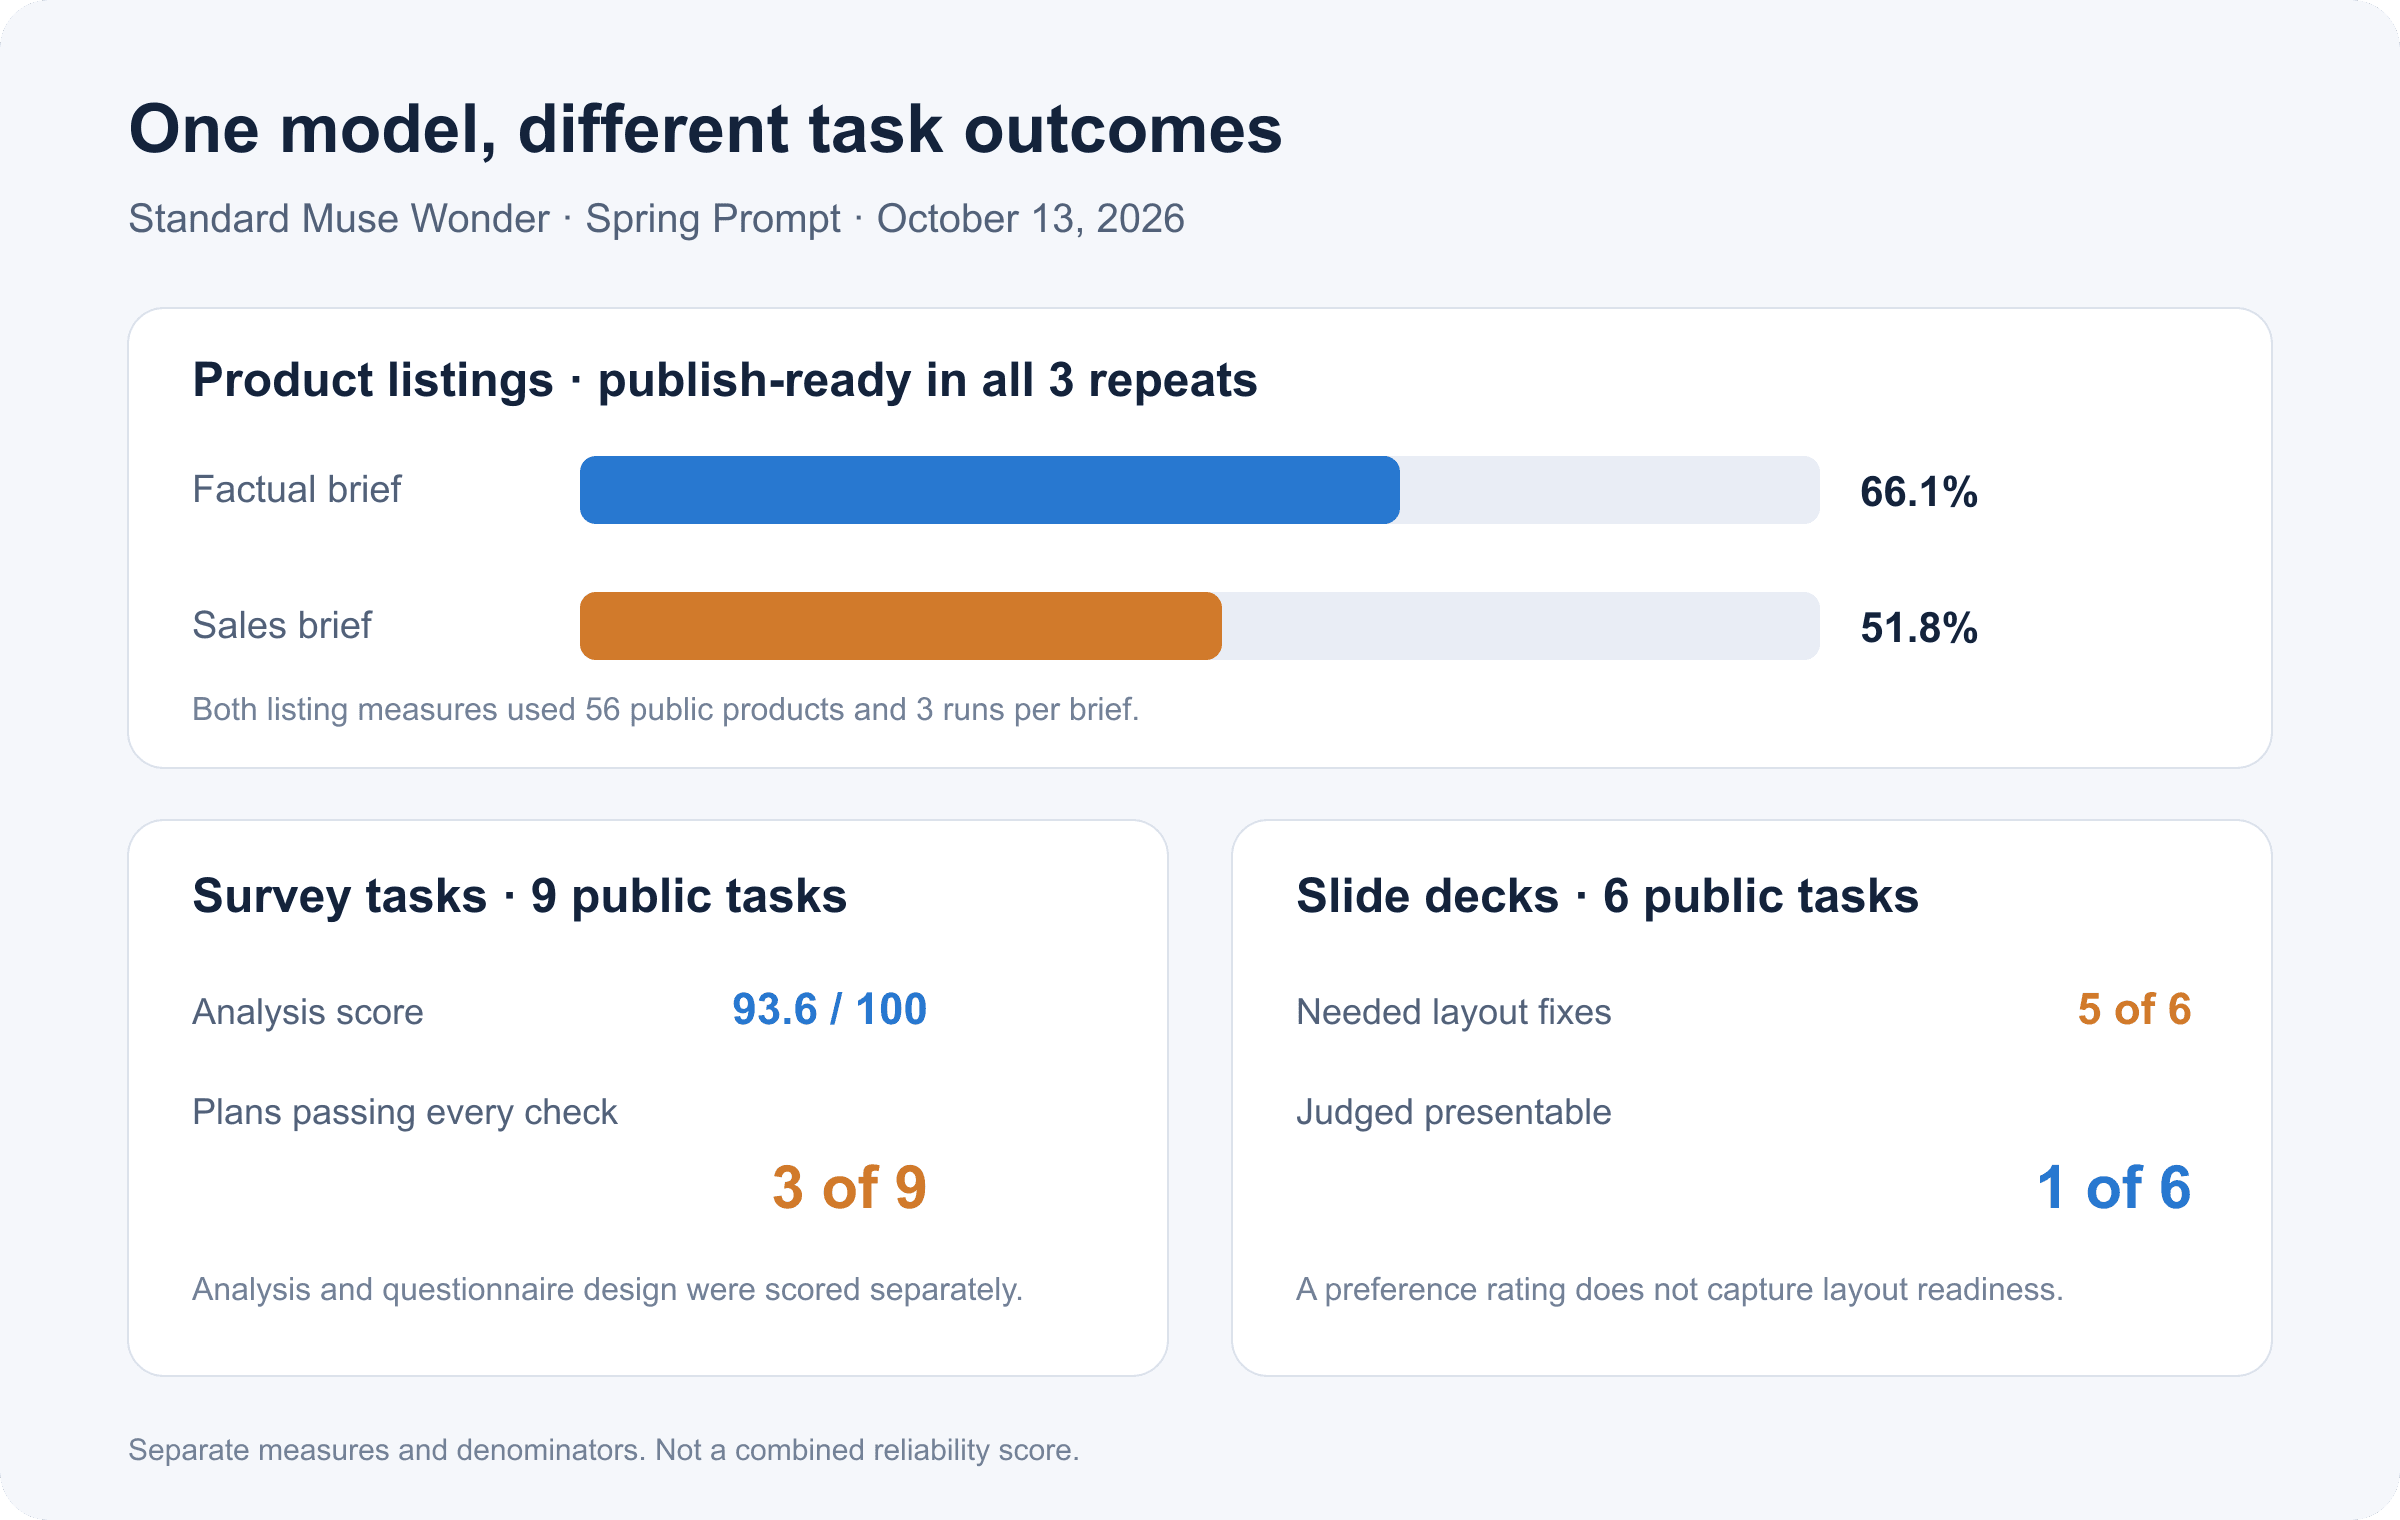
Résultats Muse Wonder standard de Spring Prompt du 13 octobre 2026 : taux de réussite des fiches testées en répétition, analyse d’enquête et résultats de revue de présentation
Résultats de tâches indépendantes issus d’une évaluation. Les mesures utilisent des dénominateurs différents et sont présentées séparément, sans être combinées en un score.
Les tests de Spring Prompt n’ont pas mesuré le codage, la mémoire persistante ou Muse Code. Leur comparaison ne peut donc pas trancher si Wonder est fiable pour le codage ou si Full performe mieux. Elle montre toutefois pourquoi une seule étiquette générale masque des différences importantes entre tâches.
L’article de lancement de Meta indique que Muse Wonder standard est disponible via le Meta Model API et Muse Code, tandis que Wonder Full est disponible pour les abonnés Muse Code. Il décrit Active Memory et Active Focus comme des fonctionnalités permettant de retenir des détails utiles et de poursuivre le travail malgré les erreurs. Ces descriptions aident à définir des cas de test, mais l’article de lancement n’est pas une étude indépendante en exécutions répétées.
Pour les affirmations sur le codage et les constructions 3D abordées dans les fils communautaires de la semaine de lancement, traitez les publications comme des hypothèses. Transformez une plainte spécifique en tâche reproductible et vérifiez la sortie. Ne convertissez pas les commentaires ou les votes en taux de réussite.
Comment réaliser un test de fiabilité Muse Wonder répétable
1. Construisez un petit ensemble de tâches à partir du travail réel
Choisissez 10 à 20 tâches que votre équipe attend réellement du modèle. Répartissez-les en catégories telles que codage, extraction factuelle, suivi d’instructions, contexte long et utilisation d’outils. Privilégiez les tâches avec des tests objectifs, des réponses de référence ou une grille claire.
Incluez des cas limites réalistes : entrée manquante, exigences contradictoires, outil indisponible et tâche qui devrait déclencher une question de clarification. Gardez les données sensibles ou réglementées hors du test, sauf si votre processus approuvé le permet.
2. Figez le prompt, le modèle et les paramètres
Notez le prompt exact et les instructions système. Enregistrez le nom et la version du modèle, le niveau de raisonnement, les outils, le contexte fourni, la date et toute limite de temps. Ne comparez pas Wonder standard avec Full comme s’il s’agissait du même modèle.
Un prompt de test utile peut demander au modèle de montrer ses preuves et d’identifier les exigences non testables :
Lisez la spécification et l’implémentation jointes. Retournez uniquement : (1) chaque exigence marquée PASS, FAIL ou NOT TESTABLE ; (2) la preuve exacte pour chaque statut ; (3) toute exigence manquante ; (4) un test reproductible minimal pour chaque FAIL. Ne prétendez pas qu’un test a réussi sauf si vous pouvez pointer vers sa sortie.
Ceci est une entrée d’évaluation, pas une garantie que le modèle la suivra. Notez la réponse obtenue et vérifiez indépendamment toute sortie de test revendiquée.
3. Répétez les tâches et notez chaque tentative
Exécutez chaque tâche à fort impact au moins trois fois avec la même configuration. Si le budget ne permet qu’une tentative, qualifiez le résultat d’échantillon initial plutôt que de résultat de constance. Conservez chaque réponse brute ; ne rapportez pas seulement la meilleure.
Utilisez une ligne pour chaque tentative. Gardez la règle d’acceptation stable entre les exécutions.
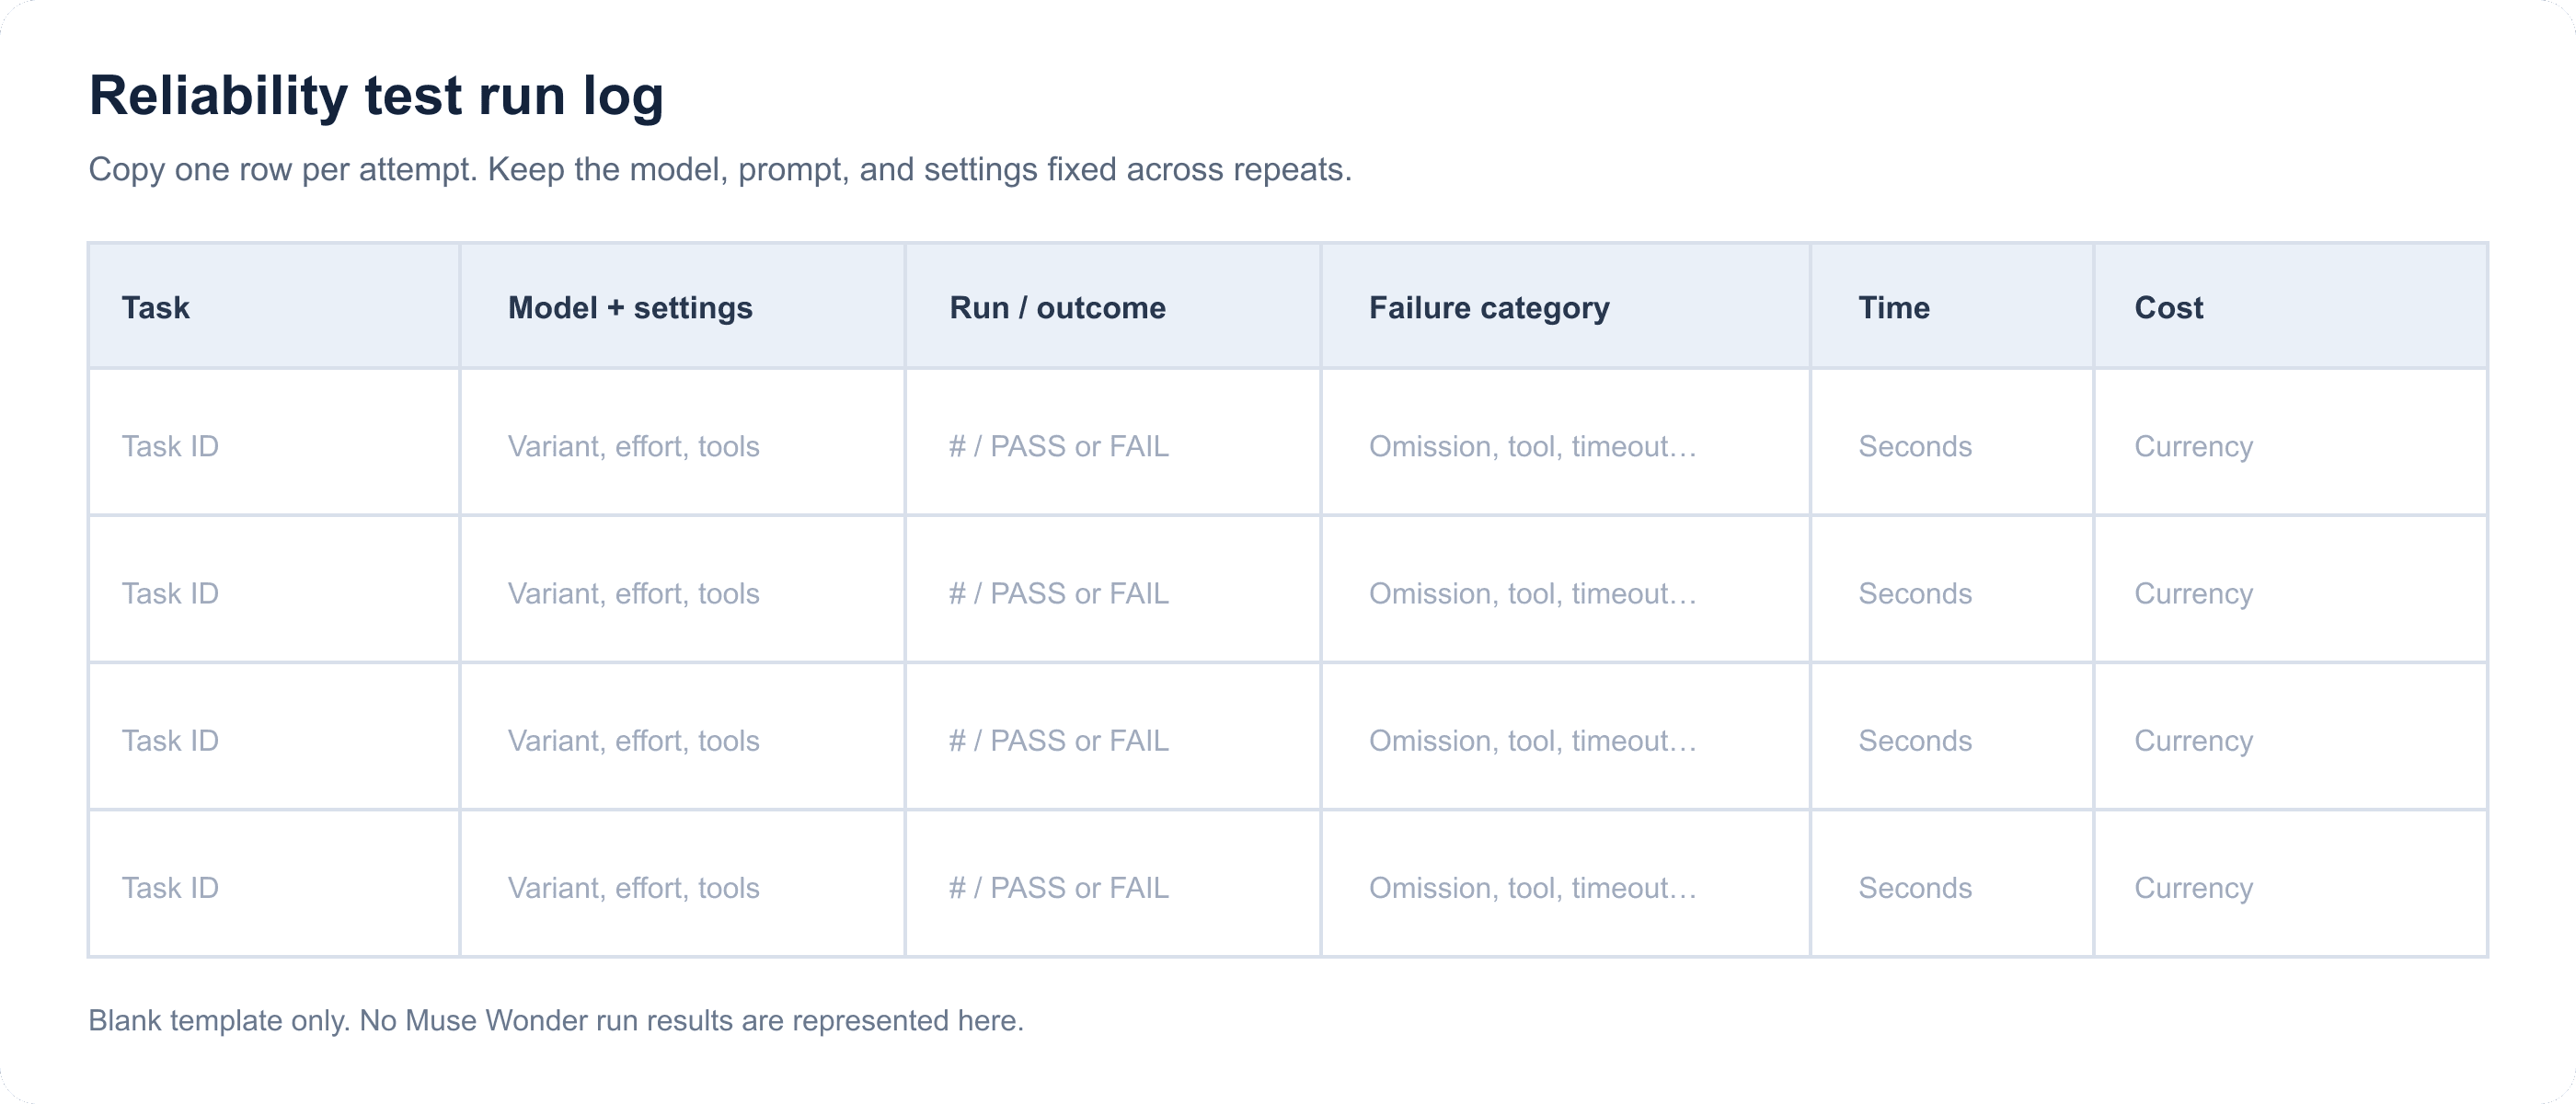
Journal de test de fiabilité Muse Wonder vierge montrant des champs pour la tâche, le modèle, l’exécution, le résultat, l’erreur, le temps et le coût
Modèle d’enregistrement vierge réutilisable. Remplissez une ligne par tentative ; il ne contient aucun résultat Muse Wonder mesuré.
4. Tenez un journal des défaillances et vérifiez la reprise
Utilisez des catégories précises : erreur factuelle, omission, test de code échoué, erreur d’outil, délai d’attente, affirmation d’achèvement non étayée ou incohérence de format. Pour le travail en plusieurs étapes, notez où l’exécution s’est arrêtée et si une nouvelle tentative a répété des actions déjà effectuées ou vérifié l’état final.
Un agent qui dit « terminé » sans preuve n’a pas passé un contrôle d’achèvement. Exigez un résultat de test, un fichier enregistré, une citation de source ou un état vérifié correspondant à la tâche.
5. Fixez un seuil de décision en fonction du coût des défaillances
Il n’existe pas de seuil universel utile de taux de réussite. Un brouillon qu’une personne vérifie ligne par ligne a un profil de risque différent d’une migration de base de données ou d’un paiement automatisé.
Fixez le seuil à partir de trois facteurs :
- Quel est le caractère nuisible ou coûteux d’un résultat erroné ?
- Une personne peut-elle détecter l’erreur avant qu’elle n’affecte quelqu’un ?
- Le workflow échoue-t-il de manière sûre, avec un arrêt clair et une piste d’audit ?
Pour les brouillons à faible risque, une revue peut suffire. Pour les modifications de code, la finance, le juridique, la santé ou les actions qui affectent les utilisateurs, utilisez des tests plus robustes et une vérification indépendante. Ne laissez pas une moyenne élevée masquer un mode de défaillance grave.
Fiabilité de Muse Wonder par type de tâche
Codage et constructions en plusieurs étapes
Exécutez la suite de tests réelle du dépôt et vérifiez le comportement demandé. Notez la couverture des exigences, les régressions et si les modifications revendiquées par le modèle correspondent aux fichiers et à la sortie des tests. Un enregistrement d’écran ou une explication convaincante ne remplace pas un contrôle exécutable.
La première suite Quantslant incluait quatre tâches de codage et rapportait 15 tests unitaires réussis sur 16 dans une tâche de conversion de nombres en mots. C’est un signal limité à une seule exécution. Spring Prompt n’a explicitement pas testé le codage, ses conclusions ne doivent donc pas servir à généraliser sur la fiabilité des agents de codage.
Recherche et extraction factuelle
Utilisez un paquet de sources ou des réponses de référence que votre relecteur peut inspecter. Vérifiez chaque affirmation factuelle par rapport à une source primaire, et suivez séparément les citations inventées et les attributions incorrectes de la qualité générale de la réponse.
L’analyse d’enquête de Spring Prompt était une force relative dans sa petite évaluation, mais la conception des questions d’enquête était plus faible. Un score d’analyse élevé ne doit pas certifier silencieusement l’instrument d’enquête ou les sources derrière une nouvelle tâche de recherche.
Contexte long et workflows d’agent
Vérifiez si le modèle retient chaque contrainte, utilise correctement chaque outil et vérifie l’état final. Testez délibérément la reprise après interruption : arrêtez une exécution après une étape connue, puis voyez si elle reprend depuis un point de contrôle ou répète un effet secondaire.
L’annonce de Meta décrit des capacités de mémoire et de reprise, mais les premières évaluations publiques citées ici n’établissent pas la constance sur longue durée de la mémoire persistante ou de la reprise d’agent. Mesurez directement ces comportements avant de vous y fier.
Muse Wonder vs Muse Wonder Full : gardez les preuves séparées
Muse Wonder et Muse Wonder Full sont des variantes distinctes. Les informations de lancement de Meta décrivent des routes d’accès séparées, et les tests API indépendants de Wonder standard ne deviennent pas des résultats Full simplement parce que le paramètre de raisonnement change.
| Question de comparaison | Ce que les preuves disponibles étayent |
|---|---|
| Full est-il identique à Wonder standard au raisonnement maximal ? | Non. Traitez-les comme des variantes distinctes et enregistrez le nom exact. |
| L’évaluation API Spring Prompt citée a-t-elle testé Full ? | Non. Elle a testé Wonder standard ; Full était hors de cette comparaison. |
| Les chiffres cités de l’API standard peuvent-ils classer Full ? | Non. Ils ne testent pas Full. |
| Qu’est-ce qui permettrait une comparaison équitable ? | Même ensemble de tâches, grille de notation, fenêtre de dates, accès aux outils et paramètres documentés, avec des répétitions pour les deux variantes. |
Une comparaison équitable commence par des tâches appariées et des conditions correspondantes. Si les routes d’accès imposent des prompts, des outils ou une facturation différents, documentez ces différences et qualifiez la comparaison d’exploratoire.
Coût, accès et où tester Muse Wonder
Comparez le coût par tâche acceptée, pas seulement le prix indiqué par token. Les prompts longs, les nouvelles tentatives, les tokens de raisonnement, les appels d’outils, les délais d’attente et la revue humaine modifient tous le coût d’un résultat utilisable. Quantslant a rapporté les tarifs de tokens de Wonder standard à 4 $ par million de tokens d’entrée et 20 $ par million de tokens de sortie le 12 octobre 2026, et sa propre exécution de 23 tâches a coûté 0,64 $. C’est une route et une charge de travail rapportées, pas un prix universel par tâche.
L’annonce de lancement actuelle de Meta liste Wonder standard via le Meta Model API et Muse Code, et Full via les abonnements Muse Code. Confirmez l’accès, l’éligibilité régionale et la facturation actuelle dans l’interface officielle avant de budgétiser.
Commencez sur Atlas Cloud pour une vue plus large de sa plateforme développeur. Au 15 octobre 2026, je n’ai pas pu confirmer Muse Wonder dans le catalogue de modèles, cet article ne présente donc pas Atlas Cloud comme route d’exécution pour ce modèle. Si votre équipe compare d’autres modèles déjà listés, la bibliothèque de modèles Atlas Cloud peut vous aider à identifier des candidats à tester sur le même ensemble de tâches.
Le résultat utile d’un test de fiabilité Muse Wonder est une décision de déploiement liée à des preuves : quelle tâche a réussi, à quelle fréquence, à quel coût, et quelle revue reste nécessaire.
Questions fréquentes
Muse Wonder est-il fiable pour le codage ?
Les premiers tests de lancement ne fournissent qu’un petit échantillon de codage. Quantslant a rapporté quatre tâches de codage, avec un échec de test unitaire dans l’une d’elles, tandis que Spring Prompt n’a pas testé le codage. Exécutez les tests du dépôt sur vos propres tâches et répétez les tâches importantes avant de prendre une décision de workflow de codage.
Comment tester moi-même la fiabilité de Muse Wonder ?
Utilisez un ensemble fixe de tâches réelles, préservez les paramètres exacts du modèle et du prompt, définissez les critères de réussite à l’avance et conservez chaque sortie. Répétez les tâches importantes et vérifiez les résultats avec des tests ou des documents sources.
Combien de fois dois-je répéter chaque tâche Muse Wonder ?
Utilisez au moins trois exécutions pour les tâches à fort impact comme contrôle initial de constance. Trois tentatives restent un petit échantillon ; élargissez donc l’ensemble lorsque les erreurs sont coûteuses ou que les sorties varient.
Quelle est la différence entre Muse Wonder et Muse Wonder Full ?
Ce sont des variantes de modèle distinctes avec différentes routes de disponibilité. Ne traitez pas Wonder standard au raisonnement maximal comme Full, et ne transférez pas les résultats entre eux sans un test apparié.
Puis-je faire confiance aux scores de benchmark Muse Wonder de Meta ?
Utilisez-les comme preuves de capacité rapportées par le fournisseur et lisez la configuration du benchmark. Ils ne prouvent pas une performance constante sur vos prompts, vos outils et vos exécutions répétées.
Muse Wonder est-il disponible sur Atlas Cloud ?
Je n’ai pas pu le vérifier dans le catalogue de modèles d’Atlas Cloud au 15 octobre 2026. Vérifiez le catalogue en direct avant de choisir un fournisseur d’exécution.





