

Une voix peut sembler retenir ses larmes alors que le visage animé reste neutre. Avec la correspondance entre voix émotionnelle et expressions faciales d’OmniHuman 2.0, la première correction consiste souvent à écouter plus attentivement, et non à ajouter plus d’adjectifs. L’audio porte déjà les mots, le rythme et l’accentuation vocale ; un prompt court doit orienter la performance visible qui soutient ces indices.
Ce guide propose aux créateurs une méthode reproductible pour préparer un portrait et une piste, rédiger un prompt ciblé et examiner le résultat afin de repérer les incohérences significatives. Il couvre la parole et le chant, tout en distinguant les informations documentées des conseils de tiers et des affirmations produit non vérifiées.
À retenir
- Considérez l’audio comme le socle de la performance et ne dirigez que les actions visibles, le cadrage et les détails de scène.
- Repérez les temps forts émotionnels avant de rédiger le prompt, puis vérifiez ces mêmes moments avec le son coupé et activé.
- Ne changez qu’une variable à chaque nouvel essai ; un prompt ne peut pas corriger tous les problèmes d’audio source ou de génération.
Comment OmniHuman 2.0 relie l’audio, l’expression faciale et le mouvement
Une façon utile de concevoir un modèle de portrait piloté par l’audio consiste à attribuer une tâche à chaque entrée. L’image ancre le sujet visible. L’enregistrement fournit la parole ou le chant, y compris son rythme et son interprétation. Une orientation textuelle facultative peut décrire la performance ou la scène. Le comportement et les contrôles exacts peuvent varier selon l’implémentation du produit ; ne considérez donc pas la recherche générale sur OmniHuman ni les instructions d’un studio tiers comme des spécifications officielles d’OmniHuman 2.0.
La recherche originale OmniHuman-1 décrit une animation humaine conditionnée par des combinaisons d’image, de texte, d’audio et de pose. Cet article établit le cadre plus large de cette famille de recherche, et non l’interface, les limites ou la qualité exactes d’OmniHuman 2.0 (ICCV 2025, article OmniHuman-1).
| Entrée | Contribution probable | Ce que vous pouvez préparer |
|---|---|---|
| Portrait de référence | Apparence du sujet et pose de départ | Choisissez un visage clair et un cadrage adapté au mouvement prévu |
| Audio parlé ou chanté | Mots, cadence, pauses, énergie vocale | Utilisez une piste propre à l’interprétation intentionnelle et coupez les silences inutiles |
| Prompt d’orientation facultatif | Actions visibles, cadrage, scène ou indices d’ambiance | Donnez quelques indications concrètes qui concordent avec l’enregistrement |
La synchronisation labiale et la performance émotionnelle sont liées, mais elles ne relèvent pas du même contrôle qualité. Une bouche peut suivre les syllabes tandis que les yeux, la tête ou le geste semblent inadéquats pour la réplique. De même, un visage peut sembler expressif alors que le timing dérive par rapport à la voix. Vérifiez les deux.
Les guides tiers sur OmniHuman 2.0 décrivent un flux de travail image + audio avec une orientation textuelle facultative, mais ces pages ne constituent pas la documentation technique de BytePlus. La documentation Atlas accessible publiquement couvre son propre modèle Avatar Omni Human 1.5, et non OmniHuman 2.0. L’hypothèse de travail la plus sûre est donc pratique plutôt qu’absolue : laissez l’audio suggérer ce dont la performance a besoin, et utilisez le prompt pour demander des choix visibles que vous pouvez inspecter.
Choisissez un portrait et une piste audio qui rendent l’émotion lisible
Un modèle ne peut pas jouer sur des indices difficiles à voir ou à entendre. Commencez par des entrées qui lui donnent une tâche simple et équitable, puis gardez-les fixes pendant que vous testez la formulation du prompt.
| Entrée de départ | Pourquoi cela peut aider | Complication à surveiller |
|---|---|---|
| Un visage net et dégagé, avec un éclairage uniforme | Facilite la lecture des traits du visage | Des ombres marquées, des cheveux, des mains ou des accessoires peuvent masquer des zones clés |
| Une pose de départ neutre ou légèrement expressive | Laisse de la place à l’évolution de la performance | Une expression fixe marquée peut entrer en conflit avec une humeur vocale différente |
| Une voix claire au premier plan | Facilite le suivi de la parole et des pauses | La musique, le bruit ambiant ou des voix qui se chevauchent peuvent masquer les indices |
| Un phrasé délibéré avec des pauses audibles | Vous donne des moments à associer à des actions visibles | Une diction plate peut offrir moins de changements émotionnels clairs |
| Une chanson centrée sur la voix avec des phrases distinctes | Facilite l’identification des mots chantés et de la dynamique | Les passages instrumentaux fournissent moins d’indices vocaux pour le mouvement de la bouche |
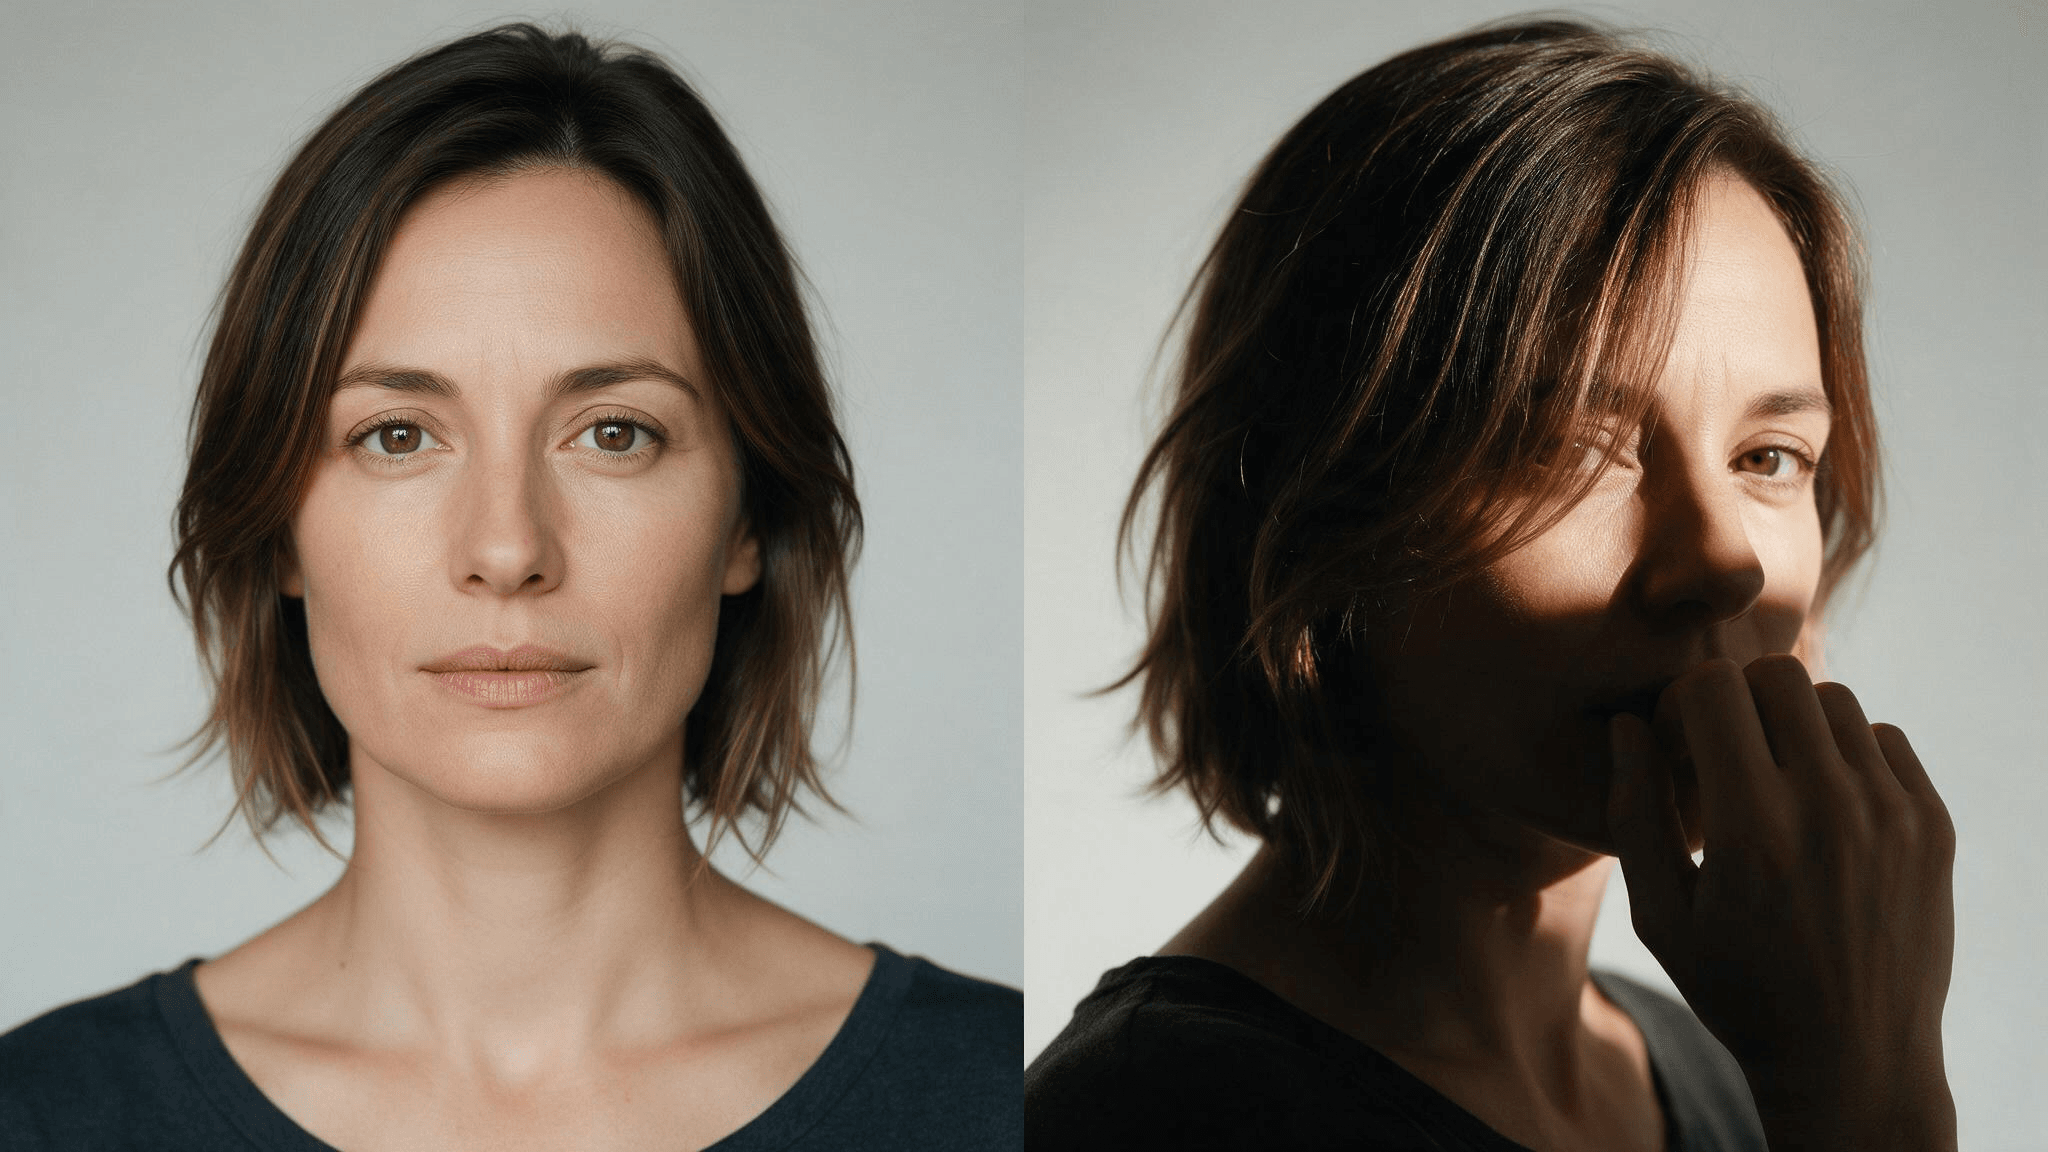 Comparaison de portraits à titre illustratif : la vue claire et de face rend les indices faciaux plus faciles à inspecter que la vue ombragée et partiellement masquée. Il ne s’agit pas d’une comparaison de sorties de modèle.
Ce sont des vérifications de production, pas des garanties. Une bonne entrée peut tout de même produire une prise faible, et un portrait visuellement expressif ne garantit pas une animation cohérente. Pour un premier test, utilisez un portrait, un court extrait audio et un seul prompt. Évitez de modifier simultanément le recadrage, l’enregistrement et l’orientation ; sinon, vous ne saurez pas quel ajustement a aidé.
Pour le chant, écoutez les fins de phrases, les notes tenues et les changements d’intensité. Le prompt peut orienter une inclinaison de la tête ou un mouvement de la main autour d’un temps musical, mais il ne doit pas répéter des paroles déjà présentes dans l’enregistrement. Pour un dialogue parlé, repérez les pauses et les mots accentués. Un prompt qui demande un important changement d’humeur pendant une phrase calme et continue peut produire une performance qui semble imposée.
Un cadre de prompt pour faire correspondre voix et expression faciale
Gardez l’orientation assez courte pour pouvoir l’évaluer. Une structure pratique est la suivante :
Cadrage + locuteur et interprétation + émotion cohérente avec la piste + une ou deux actions visibles + orientation de caméra facultative.
Par exemple, si un locuteur semble chaleureux et posé, vous pourriez écrire :
Plan poitrine fixe. La femme parle chaleureusement face caméra, commençant de manière posée et laissant apparaître un léger sourire sur la dernière réplique. Elle fait un léger signe de tête après la pause. Gardez le cadrage stable.
Il s’agit d’un prompt illustratif, et non d’une exécution documentée d’OmniHuman 2.0. Son intérêt est que chaque instruction correspond à un élément visible : le plan reste stable, l’expression change vers la fin et le signe de tête a un repère. Vous pouvez comparer le résultat à la piste plutôt que de juger une demande vague comme « sois émotif ».
Un guide de prompt tiers recommande une orientation concise en langage naturel et une émotion demandée qui correspond à la voix. Considérez cela comme une heuristique pratique, et non comme une garantie ou une règle officielle du produit (guide de prompts KreatorFlow).
Avant d’utiliser un prompt, vérifiez-le par rapport à l’enregistrement :
- Si la voix est calme et retenue, demandez une expression subtile plutôt qu’un large sourire.
- Si l’interprétation devient plus assurée, placez le changement visible après le changement audible.
- Si l’enregistrement contient un rire, une pause ou un soupir, décidez si le visage doit rester figé, réagir ou bouger à ce moment-là.
- Si le portrait de départ montre déjà l’expression souhaitée, évitez de la décrire de nouveau, sauf si vous voulez que l’expression change.
N’utilisez des mots temporels comme « d’abord », « puis » et « enfin » que lorsque l’audio comporte des temps forts clairs. Évitez d’empiler des instructions contradictoires comme « cadrage statique » et « caméra en orbite », ou « calme » et « furieux ». Un prompt est une orientation pour une performance existante, et non une piste vocale de remplacement.
Trois modèles de prompt pour la parole, les changements émotionnels et le chant
Choisissez le modèle de prompt le plus simple qui correspond à votre audio. Ces exemples sont des modèles à adapter, et non des affirmations vérifiées sur les résultats.
Explication calme
Plan poitrine stable. Le locuteur explique calmement le point, avec une expression posée et un petit geste d’insistance. Gardez la caméra fixe.
Utilisez ce modèle lorsque la piste est mesurée et constante. Un geste peut rendre l’insistance visible sans transformer une explication simple en performance théâtrale.
Un changement d’émotion
Gros plan fixe. Le locuteur commence sérieux, puis s’adoucit en un léger sourire après la pause avant la dernière phrase. Gardez le mouvement retenu.
N’utilisez ceci que lorsque l’enregistrement contient une pause ou un changement audible qui soutient cette transition. S’il n’y a pas d’indice, la transition peut sembler arbitraire.
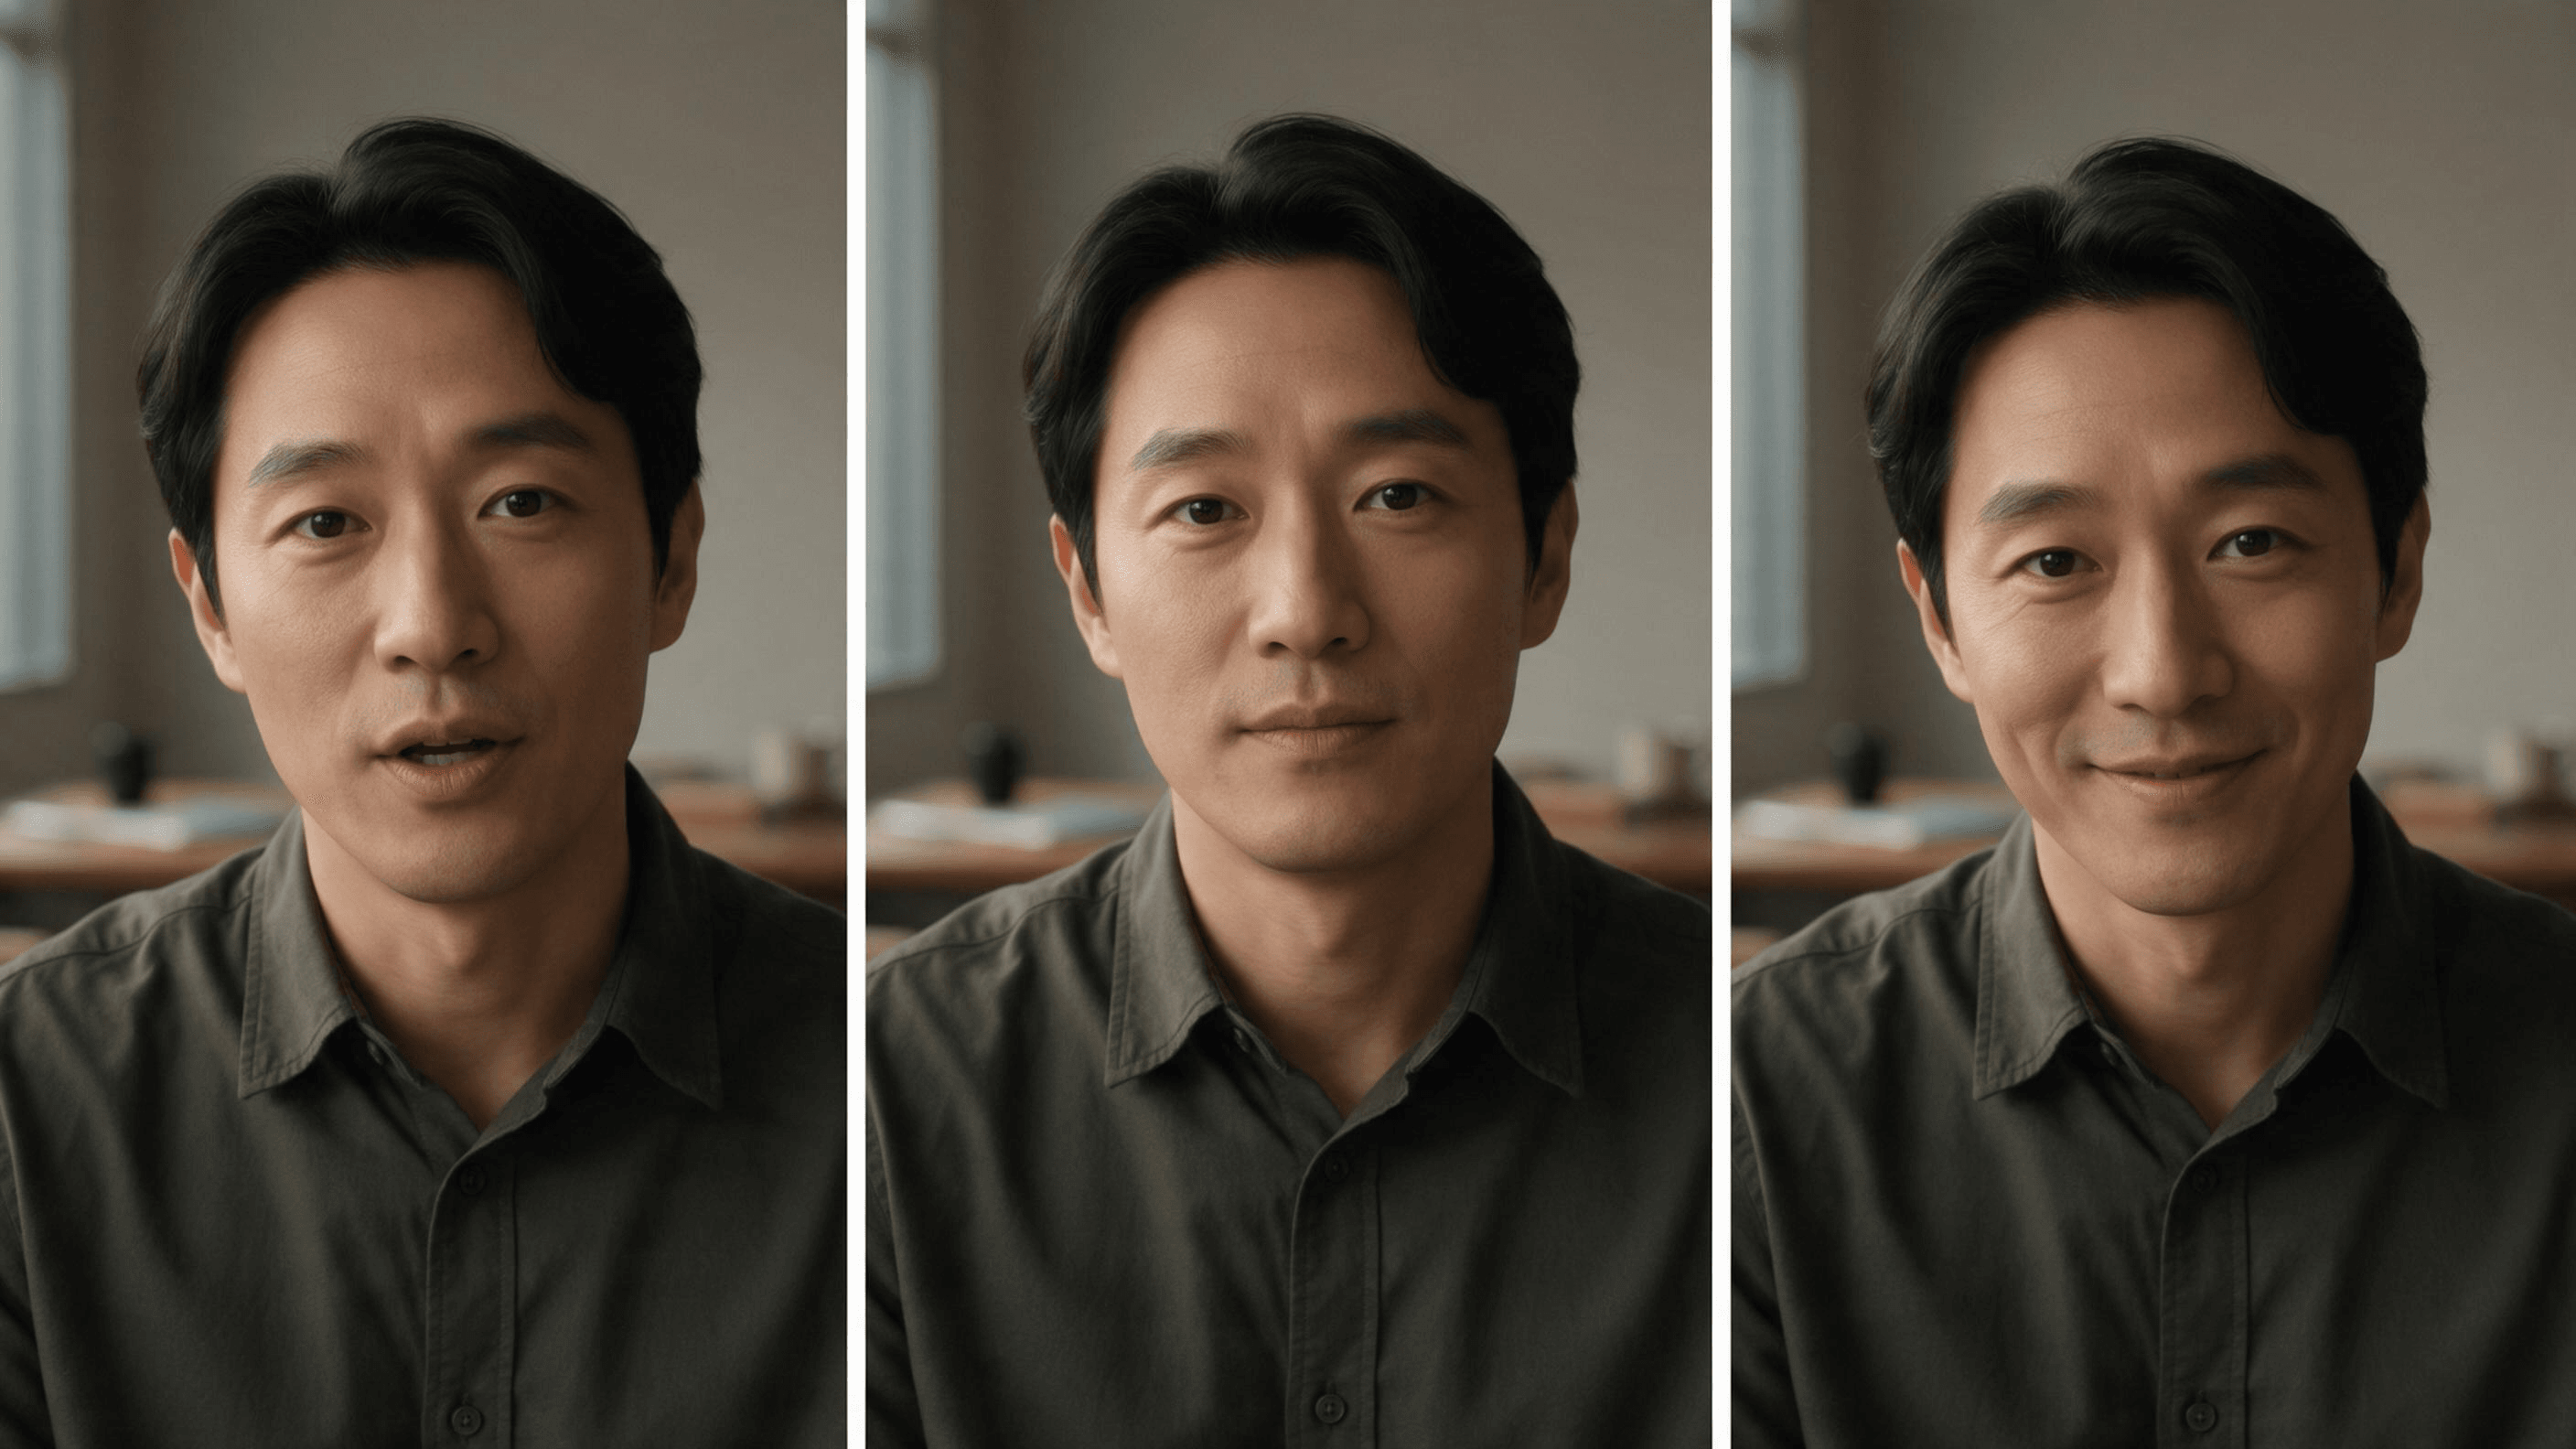 Storyboard conceptuel pour le prompt de parole : une interprétation sérieuse, une pause, puis un sourire retenu. Ce sont des temps faciaux prévus, et non des images issues d’une génération OmniHuman 2.0.
Chant
Plan poitrine. La chanteuse interprète avec une expression concentrée, ferme brièvement les yeux sur la note tenue, puis baisse le menton à la fin de la phrase. Gardez le cadrage stable.
Orientez la performance autour des événements musicaux plutôt que de reformuler les paroles. Le prompt peut suggérer une action visible ; la piste fournie reste la source des mots chantés et du timing.
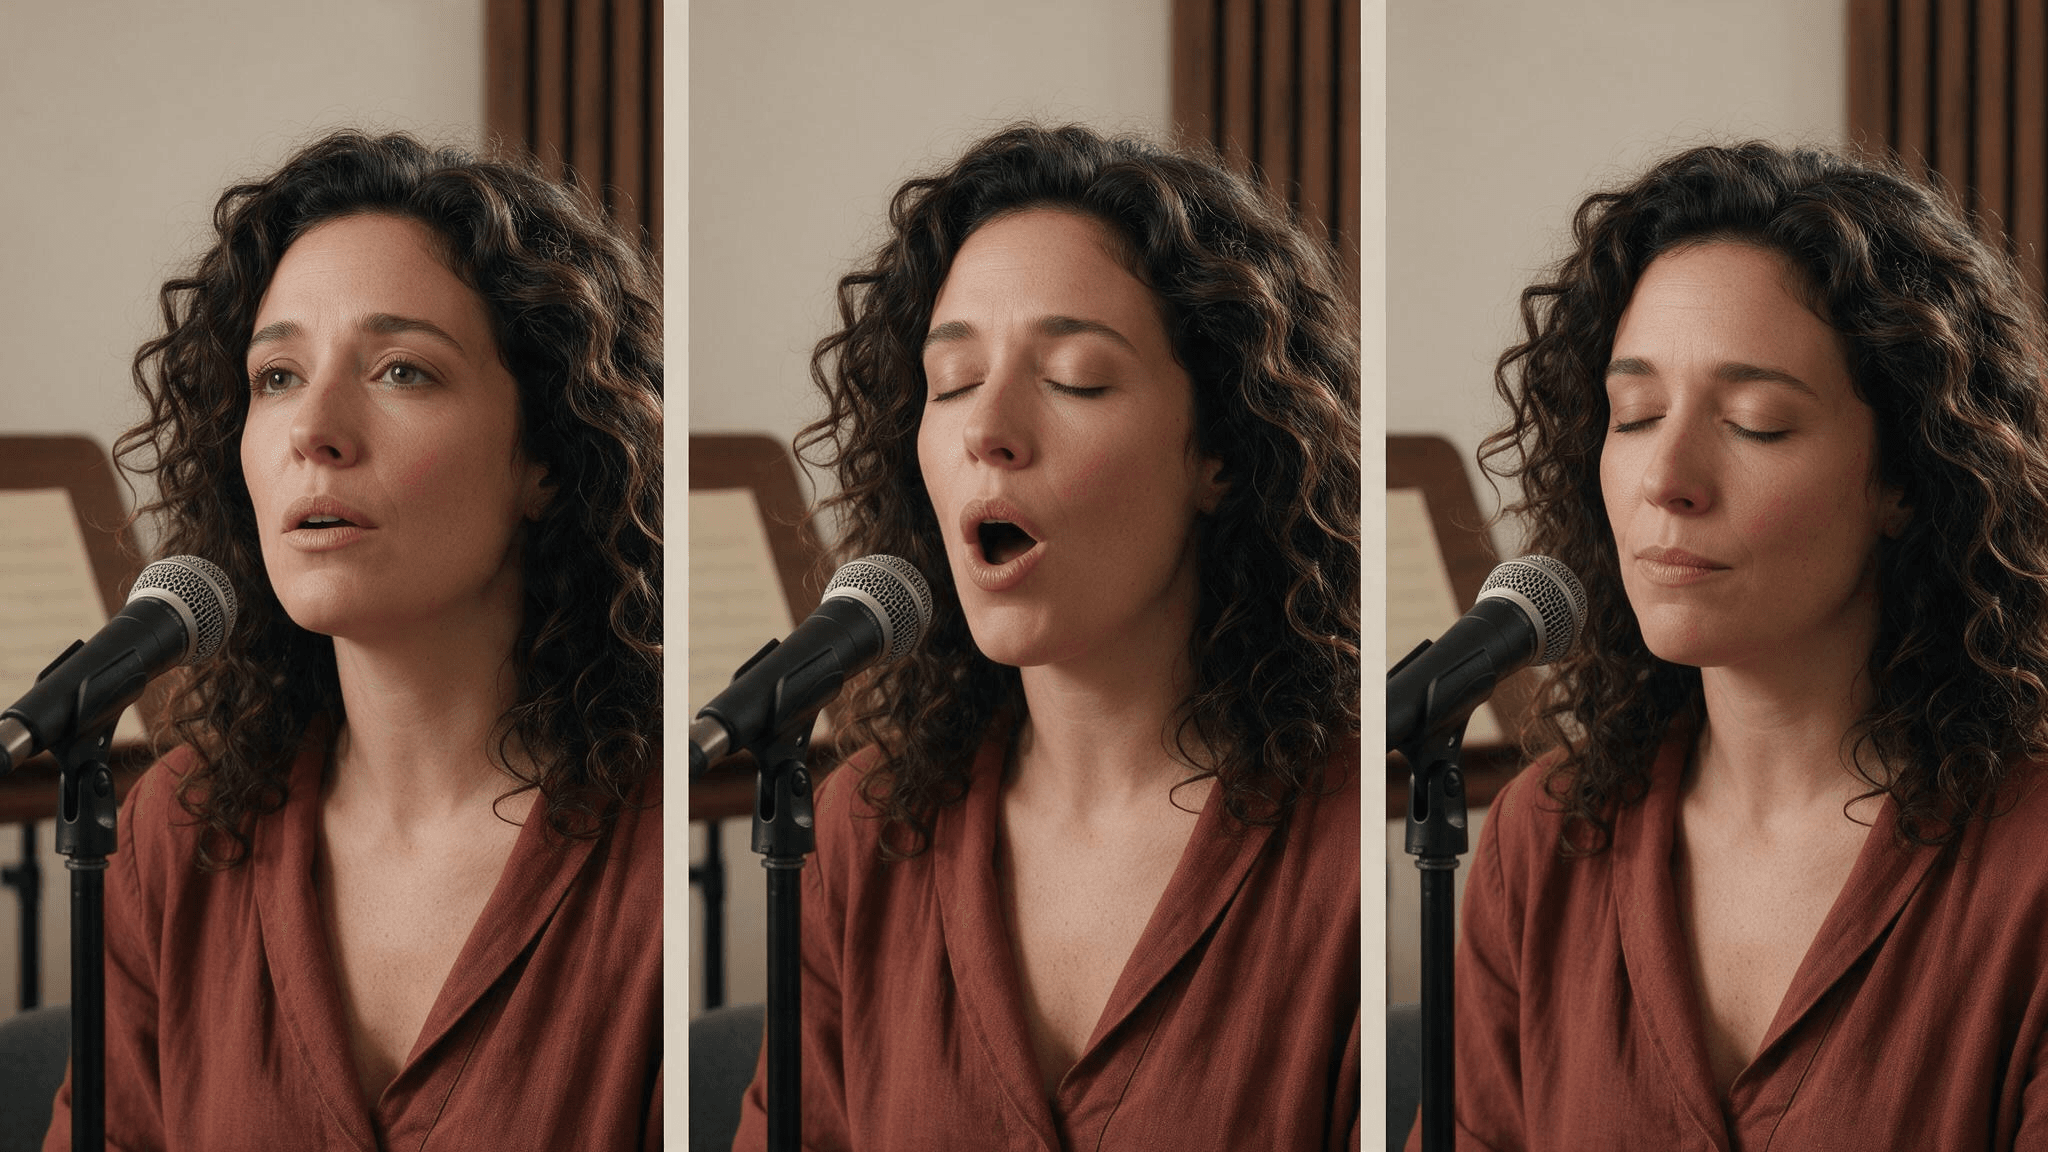 Storyboard conceptuel pour le prompt de chant : commencez la phrase, tenez une note, puis installez-vous à la fin. Les images fixes ne démontrent pas la synchronisation audio.
Comparez « sois émotif et cinématographique » avec « parle chaleureusement, puis souris après la pause ». Le premier laisse l’émotion, le timing et l’action visible ouverts à l’interprétation. Le second vous donne un moment précis à inspecter. Si le résultat manque ce moment, vous disposez d’un prochain test ciblé : déplacez le repère, adoucissez l’expression ou choisissez un montage audio différent.
Une vérification en trois passages pour l’alignement voix-visage
Une méthode d’examen rapide peut révéler si le problème se situe dans l’audio, l’orientation visuelle ou la prise générée. Utilisez les mêmes horodatages pour les trois passages.
La boucle silencieuse ci-dessous vous permet d’inspecter la partie visible d’une performance parlée : mouvement de la bouche, regard et changements faciaux. Utilisez le clip original avec le son pour la vérification voix-visage.
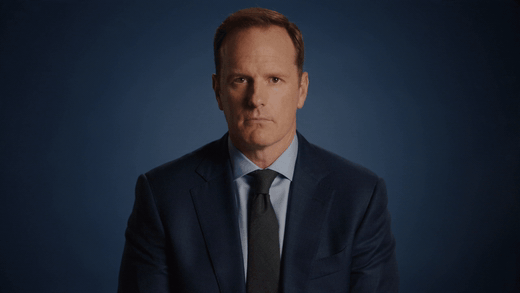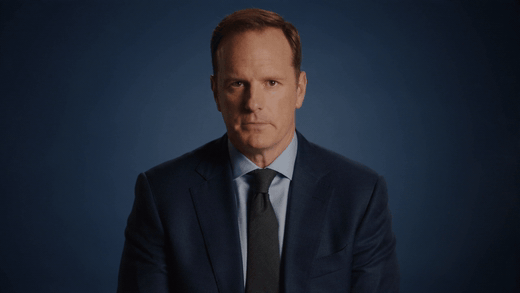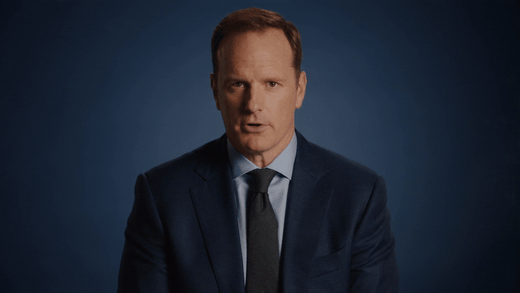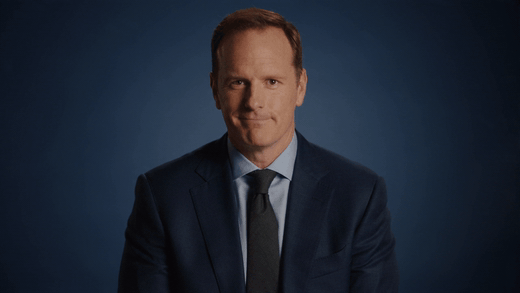
GIF silencieux converti à partir de la vidéo d’avatar fournie. Il montre un mouvement visible, mais ne peut pas établir à lui seul la synchronisation audio ni la performance d’OmniHuman 2.0.
- Écoutez sans regarder. Repérez les changements émotionnels, les pauses, les insistances, les rires, les chuchotements et les fins de phrases. Notez ce qu’un auditeur pourrait déduire de la voix seule.
- Regardez en sourdine. À ces horodatages, notez le visage, le regard, les mouvements de tête et les gestes. Consignez ce que la performance semble communiquer sans le son.
- Lisez-les ensemble. Signalez uniquement les incohérences qui changent le sens ou distraient de la réplique. Un petit sourire sous une phrase de détresse peut compter ; un clignement mineur, généralement non.
Un tableau d’examen transforme ces observations en une prochaine action :
| Temps | Indice vocal | Indice visible | Correspondance ? | Plus petit prochain test |
|---|---|---|---|---|
| 00:04 | Phrase calme et tendue | Large sourire | Non | Réduire l’intensité du sourire demandé |
| 00:09 | Pause avant une phrase rassurante | Le visage reste immobile | Peut-être | Ajouter un léger signe de tête après la pause |
| 00:13 | Rire dans l’enregistrement | L’expression reste sérieuse | Non | Vérifier si le montage audio préserve clairement le rire |
Les entrées ci-dessus sont des exemples hypothétiques d’utilisation du tableau, et non des observations issues d’une exécution de modèle. Vos notes d’examen doivent se rapporter à votre propre clip. Ne changez qu’une chose à la fois : révisez le prompt, ajustez le montage audio ou essayez un autre portrait. Répétez ensuite les mêmes vérifications aux mêmes moments.
Si l’incohérence persiste malgré un indice clair et une orientation ciblée, considérez-la comme une limitation de génération pour cette prise. Ajouter des adjectifs peut introduire du bruit sans résoudre le problème de timing ou de performance. Décidez si une autre entrée ou un autre flux de travail mérite d’être testé, ou si la prise convient déjà à son contexte prévu.
Résoudre les expressions plates ou incohérentes
Utilisez le symptôme pour choisir une prochaine étape contrôlée. Ce sont des hypothèses générales de dépannage, et non des affirmations vérifiées sur des défauts d’OmniHuman 2.0.
| Ce que vous remarquez | Cause possible | Un prochain test |
|---|---|---|
| Le visage paraît neutre pendant tout le clip | La voix a peu de contraste, ou l’orientation n’a pas d’indice visible | Utilisez un passage audio plus expressif ou demandez une action concrète sur un temps clair |
| Le visage surjoue une réplique subtile | Le prompt demande une émotion plus forte que la piste ne le permet | Supprimez les actions supplémentaires et réduisez l’intensité émotionnelle |
| La bouche semble désynchronisée | L’enregistrement présente du bruit, des voix qui se chevauchent, un long silence ou des coupes difficiles | Essayez un montage plus propre avec un timing plus serré avant de réécrire le prompt |
| Un auditeur semble parler dans une image de groupe | Les rôles de locuteur et d’auditeur peuvent être ambigus dans le flux de travail testé | Identifiez chaque personne par sa position et précisez qui parle, si l’interface le permet |
| L’identité ou les détails fins changent pendant le mouvement | Le cadrage source ou le mouvement demandé peut rendre la cohérence plus difficile à juger | Simplifiez le mouvement et comparez une prise plus courte et plus stable |
Ne présumez pas qu’un correctif uniquement basé sur le prompt suffira pour un problème audio. Vérifiez d’abord si les mots sont clairs et si les silences ou les montages perturbent le rythme. Si ces éléments sont bons, simplifiez l’orientation visible. Un nouvel essai ciblé vous donne de meilleures preuves que la réécriture simultanée de toutes les entrées.
OmniHuman 2.0 est-il disponible sur Atlas Cloud ?
Les pages de modèles publics actuelles d’Atlas Cloud répertorient Avatar Omni Human 1.5 et documentent ses entrées image, audio et prompt facultatif. Je n’ai pas trouvé OmniHuman 2.0 dans la liste des modèles Atlas lors de cette vérification. Cela signifie que le modèle 2.0 exact ne doit pas être présenté comme exécutable via Atlas Cloud.
Si vous souhaitez explorer une tâche d’avatar pilotée par l’audio apparentée sur Atlas, consultez la page du modèle Avatar Omni Human 1.5 et ses entrées documentées. La documentation précise une image de référence, une URL audio et un prompt facultatif ; elle décrit un audio allant jusqu’à 60 secondes et recommande 15 secondes ou moins pour une meilleure qualité. Ce sont des détails de la v1.5, et non des spécifications d’OmniHuman 2.0. Consultez le catalogue actuel des modèles Atlas pour connaître la disponibilité et les tarifs à jour avant de choisir un flux de travail. Je n’ai pas pu confirmer de tarif public actuel pour ce modèle lors de mes recherches ; cet article n’en cite donc aucun.
Vérifiez les droits et le contexte avant de publier
Avant de partager une personne animée, confirmez que vous disposez de l’autorisation d’utiliser le portrait et la voix pour l’usage prévu. Examinez également les droits sur la musique, l’image, la voix et la distribution pour le contexte spécifique. Les exigences peuvent varier selon le matériel source et l’usage ; cette liste de contrôle constitue des conseils pratiques, et non une conclusion juridique.
Étiquetez les médias synthétiques ou modifiés lorsque les spectateurs pourraient raisonnablement les confondre avec des images documentaires ou une déclaration actuelle d’une personne réelle. Conservez des notes de projet sur les fichiers sources et les modifications, en particulier pour le travail client ou de campagne. Une performance techniquement alignée a tout de même besoin d’un contexte de publication responsable.
Pour la correspondance entre voix émotionnelle et expressions faciales d’OmniHuman 2.0, la prochaine étape utile est un test contrôlé : choisissez un portrait clair, repérez les temps forts émotionnels de l’audio, rédigez un prompt court et examinez les mêmes horodatages avec le son coupé puis activé. Si vous envisagez une option hébergée par Atlas, vérifiez d’abord le modèle exact et le tarif actuel.
Questions fréquentes
OmniHuman 2.0 génère-t-il la voix ?
Le flux de travail décrit par les guides tiers part d’un audio fourni et anime un portrait en fonction de celui-ci. Ne présumez pas que le modèle génère une voix, sauf si l’interface du produit concerné documente cette capacité.
OmniHuman 2.0 peut-il animer le chant comme la parole ?
Les guides tiers sur OmniHuman 2.0 décrivent l’utilisation d’audio parlé et chanté. Pour un test de chant, utilisez une section centrée sur la voix avec un phrasé clair, puis dirigez des actions visibles autour d’une note tenue ou d’une fin de phrase.
Le prompt doit-il répéter le dialogue ou les paroles ?
Généralement, non. L’enregistrement fournit déjà les mots. Utilisez le prompt pour une orientation visible comme l’expression, le geste, le cadrage ou un indice de scène, et évitez d’ajouter des formulations qui entrent en conflit avec la piste.
Que dois-je changer en premier si l’expression semble incorrecte ?
Utilisez la vérification en trois passages pour localiser l’incohérence. Si l’audio lui-même est peu clair ou émotionnellement plat, testez d’abord un montage audio. Si l’indice est clair mais que le visage le manque, simplifiez et recalez une orientation de prompt.
OmniHuman 2.0 est-il disponible sur Atlas Cloud ?
Je n’ai pas trouvé OmniHuman 2.0 dans le catalogue public des modèles d’Atlas Cloud lors de cette recherche. Atlas documente Avatar Omni Human 1.5 comme option apparentée ; vérifiez la liste actuelle avant de la choisir.





