MiniMax a publié H3 vendredi. En vingt-quatre heures, Seedance 2.5 était entre les mains des utilisateurs, et la chronologie s'est réduite à une conversation : trente secondes, 4K natif, cinquante entrées de référence. Le post de lancement de H3 restait en dessous, discrètement, presque personne ne faisait un vrai test.
Je comprends pourquoi. Trente secondes, c'est un beau chiffre. Ça tient dans un titre.
Mais si vous fabriquez vraiment du court-métrage vertical, vous savez que ce qui ruine votre nuit, ce n'est pas la seconde trente. C'est le plan 4. La mâchoire du héros bouge d'un demi-centimètre, sa cravate perd un pli, et le spectateur balaye avant que l'accroche ne fonctionne. Personne ne se désabonne parce qu'une vidéo dure quinze secondes au lieu de trente. On se désabonne parce que le gars au gros plan n'est pas le gars du plan large.
Alors j'ai ignoré le duel des fiches techniques. J'ai construit une feuille de référence de personnage, un plateau de décors en six panneaux, rédigé un prompt de 15 secondes pour un court-métrage gothique, et envoyé le même paquet aux deux côtés. Puis j'ai regardé le visage.
Points clés
- Seul H3 est appelable aujourd'hui — L'API de Seedance 2.5 est chez ByteDance, mais encore une page Day-0 sur cette plateforme.
- Les spécifications se séparent nettement : Seedance 2.5 = 30s en un seul plan, 4K natif, jusqu'à 50 références ; H3 = 5–15s, 2K, audio stéréo sur chaque clip.
- La stabilité du personnage est un problème d'emballage — un bon pack de référence, pas un modèle plus gros, maintient le visage.
- Les deux génèrent de l'audio natif ; H3 peut aussi fixer une voix à partir de trois références audio.
- Jugez les pixels par image, pas les secondes — sur le même run, H3 a renvoyé du 1440p contre 720p pour Seedance.
Le résultat Seedance 2.5 vs MiniMax H3, avant toute théorie
Avant toute théorie, voici ce que produit le workflow. Ce sont quatre plans extraits d'un clip vertical de 15 secondes et assemblés. C'est le propre run de référence H3 de MiniMax, construit exactement à partir de la feuille de personnage et du plateau de décors que vous verrez aux étapes 1 et 2, en 1440x2560 natif. Mes propres runs du même pack viennent plus tard, dans le tutoriel, avec l'état du playground visible.
Elle atteint la porte sculptée (panneau 4 du plateau de décors), puis la confrontation dans le couloir, puis un gros plan serré sur lui, puis le plan à deux. Sa raie est la même de profil et en gros plan. Sa couronne tressée en demi-chignon survit à un gros plan sur le visage, là où la plupart des modèles reconstruisent discrètement un visage. Le corsage en dentelle crème garde le même décolleté et les mêmes manchettes du premier au dernier plan.
C'est tout le test. Pas trente secondes. Quatre plans et une mâchoire.
Pourquoi Seedance 2.5 vs MiniMax H3 est sorti la même semaine, et pourquoi la plupart des tests de personnages sont inutiles
MiniMax a publié H3 le 30 juillet, un modèle vidéo multimodal généraliste qui lit texte, images, vidéo et audio comme un seul contexte et renvoie des clips de 5 à 15 secondes jusqu'en 2K avec son stéréo natif. Il peut aussi éditer des séquences existantes et transférer le mouvement d'un clip à un autre, et MiniMax a annoncé que les poids suivraient dans les jours (Reuters, juillet 2026).
Seedance 2.5 est arrivé dans la même fenêtre avec un chiffre plus fort : 30 secondes en une seule génération, 4K natif, et jusqu'à 50 entrées de référence multimodales en un seul job (The Next Web, juillet 2026). Son API est déjà entre les mains des développeurs, avec une édition localisée qui redessine une partie d'une image tout en laissant la performance, l'éclairage et le comportement de la caméra intacts, la référence vers la vidéo qui accepte les fonds verts ou les maquettes 3D blanches, onze langues, et un mode vidéo longue expérimental atteignant 180 secondes (CineD, juillet 2026).
L'écart d'attention est la partie intéressante. Presque tous les posts que j'ai pu trouver étaient un clip de 2.5. Pendant ce temps, les chiffres de l'arène publique disent autre chose : sur le leaderboard image-vers-vidéo d'Artificial Analysis, Seedance 2.0 en 720p mène avec 1 196 Elo, Gemini Omni Flash suit à 1 195, et MiniMax H3 est déjà troisième à 1 185, quatre jours après sa sortie. Seedance 2.5 n'a pas encore de note là-bas (Artificial Analysis, juillet 2026). Le modèle dont on parle le moins est celui avec le meilleur ratio score/attention.
Maintenant, la partie qui décide vraiment de votre résultat, car elle n'a presque rien à voir avec le logo que vous choisissez.
La plupart des tests de cohérence des personnages échouent avant même que le modèle ne soit impliqué. Quatre modes d'échec, et tous les quatre sont à vous de corriger :
| Mode d'échec | Ce que vous voyez dans la sortie | La correction |
|---|---|---|
| Références multivues envoyées en fichiers séparés | Chaque plan a un visage « presque bon » et aucun ne concorde | Composez les vues en une seule image, puis assignez des rôles dans le prompt (« l'homme à GAUCHE », « la femme à DROITE ») |
| Réécrire la description du personnage à chaque plan | Les vêtements et accessoires dérivent d'un plan à l'autre | Écrivez le bloc d'identité une fois et réutilisez-le textuellement ; seuls la caméra et l'action changent par plan |
| Laisser l'éclairage suivre la scène | Le visage est structurellement reconstruit sous la nouvelle lumière | Construisez un plateau de décors séparé qui verrouille la direction de la lumière, le brouillard et le reflet au sol, et fournissez-le comme référence |
| Traiter la durée maximale comme une métrique de qualité | Une dérive en 30 secondes tue les 30 secondes | Découpez à la granularité que vous pouvez relancer, puis parlez de longueur |
Vous voulez mettre Seedance 2.5 et MiniMax H3 devant le même prompt vous-même ? La comparaison de modèles d'Atlas Cloud les exécute côte à côte en un seul passage — prompt et paramètres identiques, avec le coût estimé avant la génération — afin que vous puissiez juger les visages, les mouvements et le texte à l'écran sans réserver deux tests séparés.
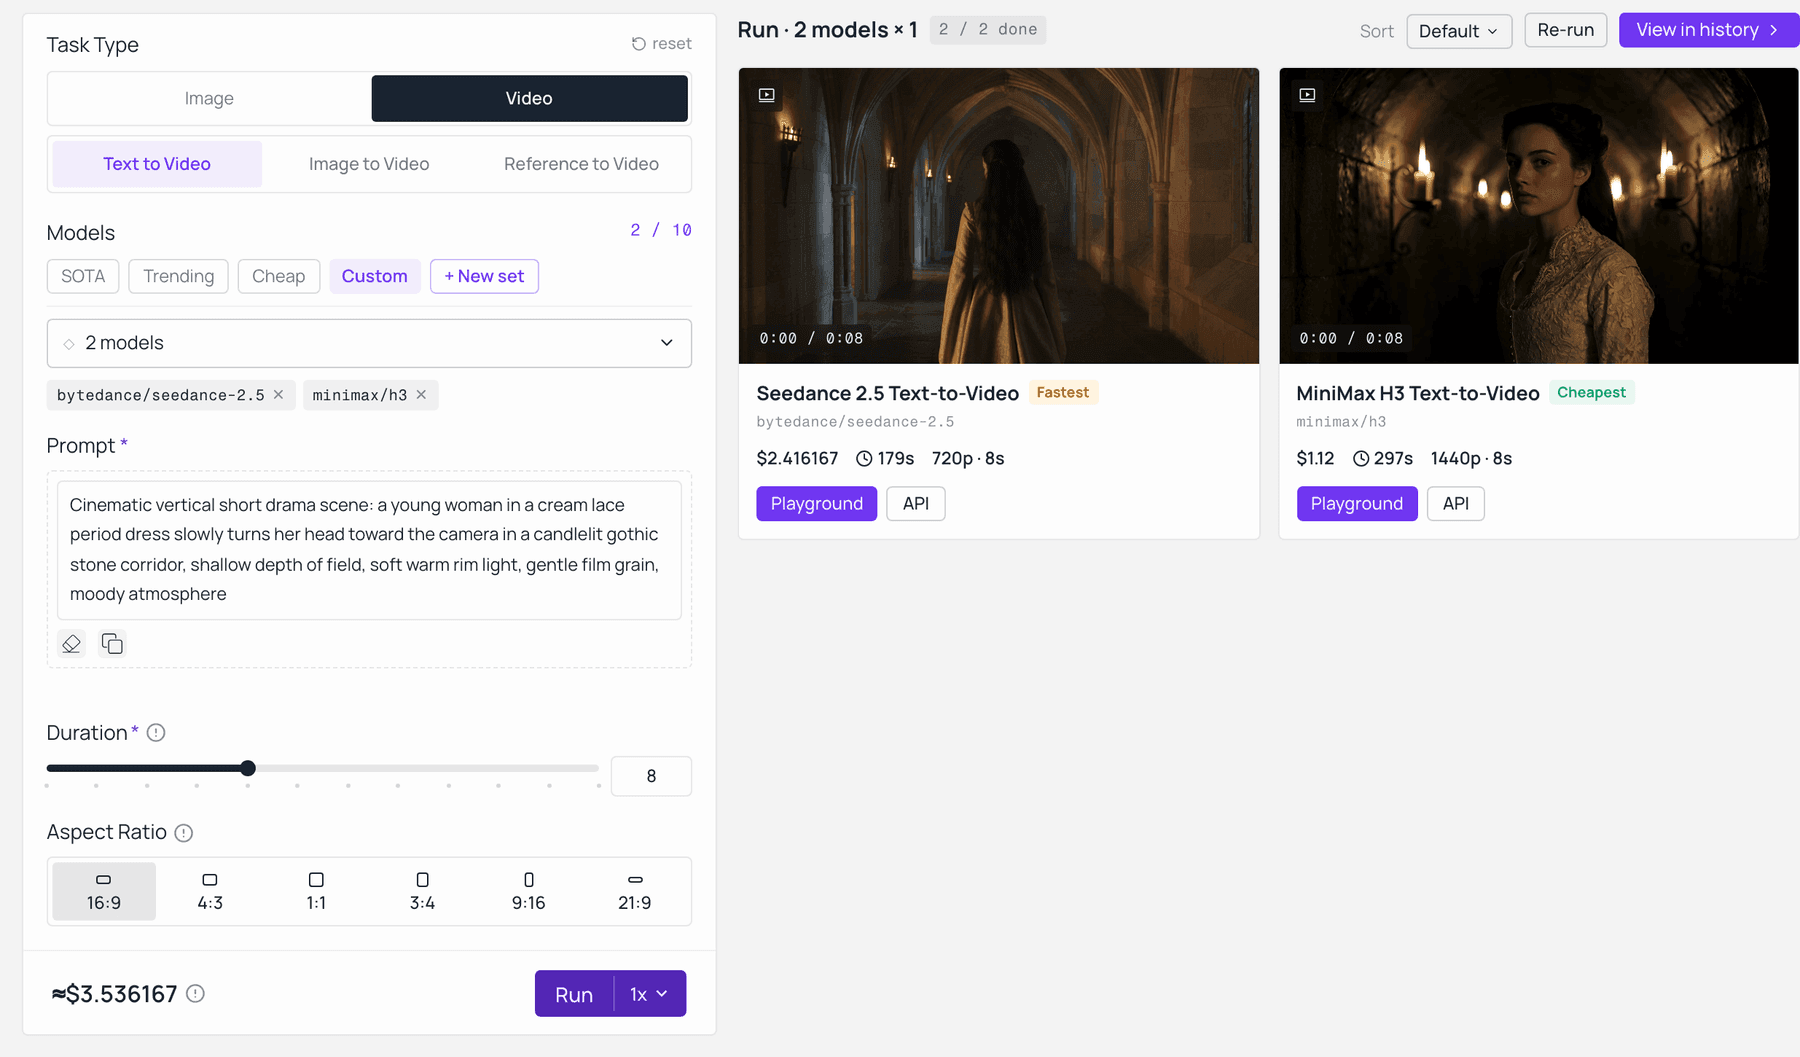
Seedance 2.5 et MiniMax H3 sur le même prompt dans la comparaison de modèles d'Atlas Cloud. Seedance 2.5 a renvoyé du 720p à 2,42 $ ; MiniMax H3 a renvoyé du 1440p pour 1,12 $, et les deux prix étaient estimés avant le run. Capturé en direct sur le model-explorer.
La première ligne est celle que les gens comprennent le plus mal. Envoyez six images à vue unique et le modèle les traite comme six candidats et les moyenne. Envoyez une seule composition propre et il les traite comme une seule personne vue sous trois angles. Mêmes pixels, résultat complètement différent.
Fiche technique Seedance 2.5 vs MiniMax H3, et ce que vous pouvez réellement appeler aujourd'hui
Séparez la capacité de la disponibilité, et la tension devient claire. En capacité brute, Seedance 2.5 mène sur la durée, le plafond de résolution, le nombre de références et la granularité d'édition. En disponibilité, H3 est celui qui a trois endpoints en direct sur une plateforme de modèle généraliste cette semaine. Si vous faites une comparaison de modèles vidéo IA pour la planification 2026, cette deuxième colonne compte autant que la première.
| MiniMax H3 | Seedance 2.5 | Seedance 2.0 Ref-to-Video (ce que j'ai utilisé) | |
|---|---|---|---|
| Durée maximale, une génération | 5 à 15 s | jusqu'à 30 s, sans couture (mode beta à 180 s, expérimental) | menu des clips courts, voir la page du modèle |
| Résolution | 2K natif, 1440p petit côté en 16:9 à 9:16 ; un palier 768p est annoncé à venir | 4K natif, couleur 10 bits | jusqu'à 720p sur cet endpoint |
| Fréquence d'images | 24 ips | non publié séparément | non publié séparément |
| Entrées de référence | 9 images + 3 vidéos + 3 audios, 12 fichiers au total | jusqu'à 50 références multimodales | 9 images + 3 vidéos + 3 audios |
| Audio natif | oui, chaque sortie, stéréo | oui, plus 11 langues de sous-titres et voix | oui |
| Granularité d'édition | éditions d'instructions sur l'ensemble du clip (changer personnage, arrière-plan, éclairage, dialogue) | éditions au niveau de la région qui redessinent une partie de l'image | éditions d'instructions sur l'ensemble du clip |
| Limite de prompt | 7 000 caractères | non publiée | non publiée |
| Poids ouverts | annoncé pour les jours suivant le lancement | non annoncé | non annoncé |
| Elo I2V Artificial Analysis, 31 juil. 2026 | 1 185 (3e) | pas encore noté | 1 196 (1er, entrée Dreamina 720p) |
| Appelable sur la plateforme testée | oui, 3 endpoints | pas encore, page Day-0 | oui |
Divulgation complète sur la configuration du test. Seedance 2.5 n'était pas ouvert sur ma plateforme quand j'ai fait ce test, donc le côté Seedance est Seedance 2.0 Reference-to-Video, le membre actuellement expédié de la même famille avec le même système de référence quadrimodal. Là où 2.5 changerait la réponse, je le dis. La page Seedance 2.5 est un avis Day-0 pour l'instant.
Tout ce qui suit s'exécute dans un seul onglet de navigateur, sur une seule clé, trois modèles au total :
| Étape | Modèle | Ce qu'il produit | Paramètres clés | Ce qui détermine le coût |
|---|---|---|---|---|
| 1 | OpenAI GPT Image 2 Text-to-Image | la feuille de référence du personnage | qualité haute, 16:9 | par image, paiement à l'utilisation, tarif en vigueur sur la page du modèle |
| 2 | même modèle, deuxième run | le plateau de décors et d'éclairage en six panneaux | qualité haute, 16:9 | par image, paiement à l'utilisation |
| 3 | MiniMax H3 Reference-to-Video | le clip 9:16 avec audio natif | 9:16, 2K, durée 5 pour un test et 15 pour la vraie coupe | secondes x résolution, facturé à la seconde |
| 4 | Seedance 2.0 Reference-to-Video | le run de contrôle, entrées identiques | 9:16, résolution max disponible, même durée | secondes x résolution, facturé à la seconde |
| 5 | H3 Reference-to-Video, clip en entrée | un plan fixé sans tout relancer | même résolution, courte durée | secondes x résolution, facturé à la seconde |
H3 a aussi des entrées text-to-video et image-to-video si vous voulez une base textuelle pure ou un contrôle première/dernière image.
Encore une chose à savoir avant de planifier un lot : le texte à l'écran. Cette séquence de titre de 15 secondes de H3 tient des crédits anglais à travers huit coupures franches sans une seule faute d'orthographe, ce qui est l'une des choses les plus difficiles à stabiliser dans une vidéo générée.
Le workflow Seedance 2.5 vs MiniMax H3 pour le court-métrage, étape par étape
Cinq étapes. Copiez les prompts exactement comme écrits, y compris les parties laides. Je ne les ai pas nettoyés pour l'article et vous ne devriez pas les nettoyer pour le modèle.
Étape 1 : Construire la feuille de personnage avec GPT Image 2
Faites le pack de référence avant de faire la moindre vidéo. Une image, deux personnages, trois vues chacun, fond blanc pur sans couture, éclairage de studio uniforme. Cela supprime toute ambiguïté sauf celle qui vous importe : à quoi ressemble cette personne.
plaintext1Une feuille de référence de personnage en corps entier sur fond blanc pur sans couture, deux personnages côte à côte, six figures au total, éclairage de studio neutre et uniforme, pas d'ombres au sol, pas de texte, pas d'étiquette, pas de filigrane. 2 3MOITIÉ GAUCHE, héros masculin, trois vues en ligne : face, profil droit, dos. Fin de la vingtaine, teint pâle, cheveux foncés ondulés mi-longs, mâchoire nette. Portant un frac long en velours noir avec une broderie ton sur ton subtile sur les revers et les manchettes, un gilet en brocart noir, une cravate en soie noire, un pantalon noir droit, des chaussures derby en cuir noir ciré. Bras détendus le long du corps, expression neutre. 4 5MOITIÉ DROITE, héroïne féminine, trois vues en ligne : face, profil droit, dos. Début de la vingtaine, teint clair, cheveux longs ondulés châtain clair avec une couronne tressée en demi-chignon. Portant une robe victorienne en dentelle de coton crème, manches longues avec manchettes en dentelle, corsage ajusté avec petits boutons, jupe longue jusqu'aux chevilles, chaussures à talons bas crème à bride. Bras détendus le long du corps, expression neutre. 6 7Réalisme photographique, échelle cohérente entre les six figures, pieds alignés sur la même ligne de base, mise au point nette d'un bord à l'autre.
Paramètres : modèle OpenAI GPT Image 2 Text-to-Image, Qualité haute, Ratio 16:9, tout le reste par défaut.
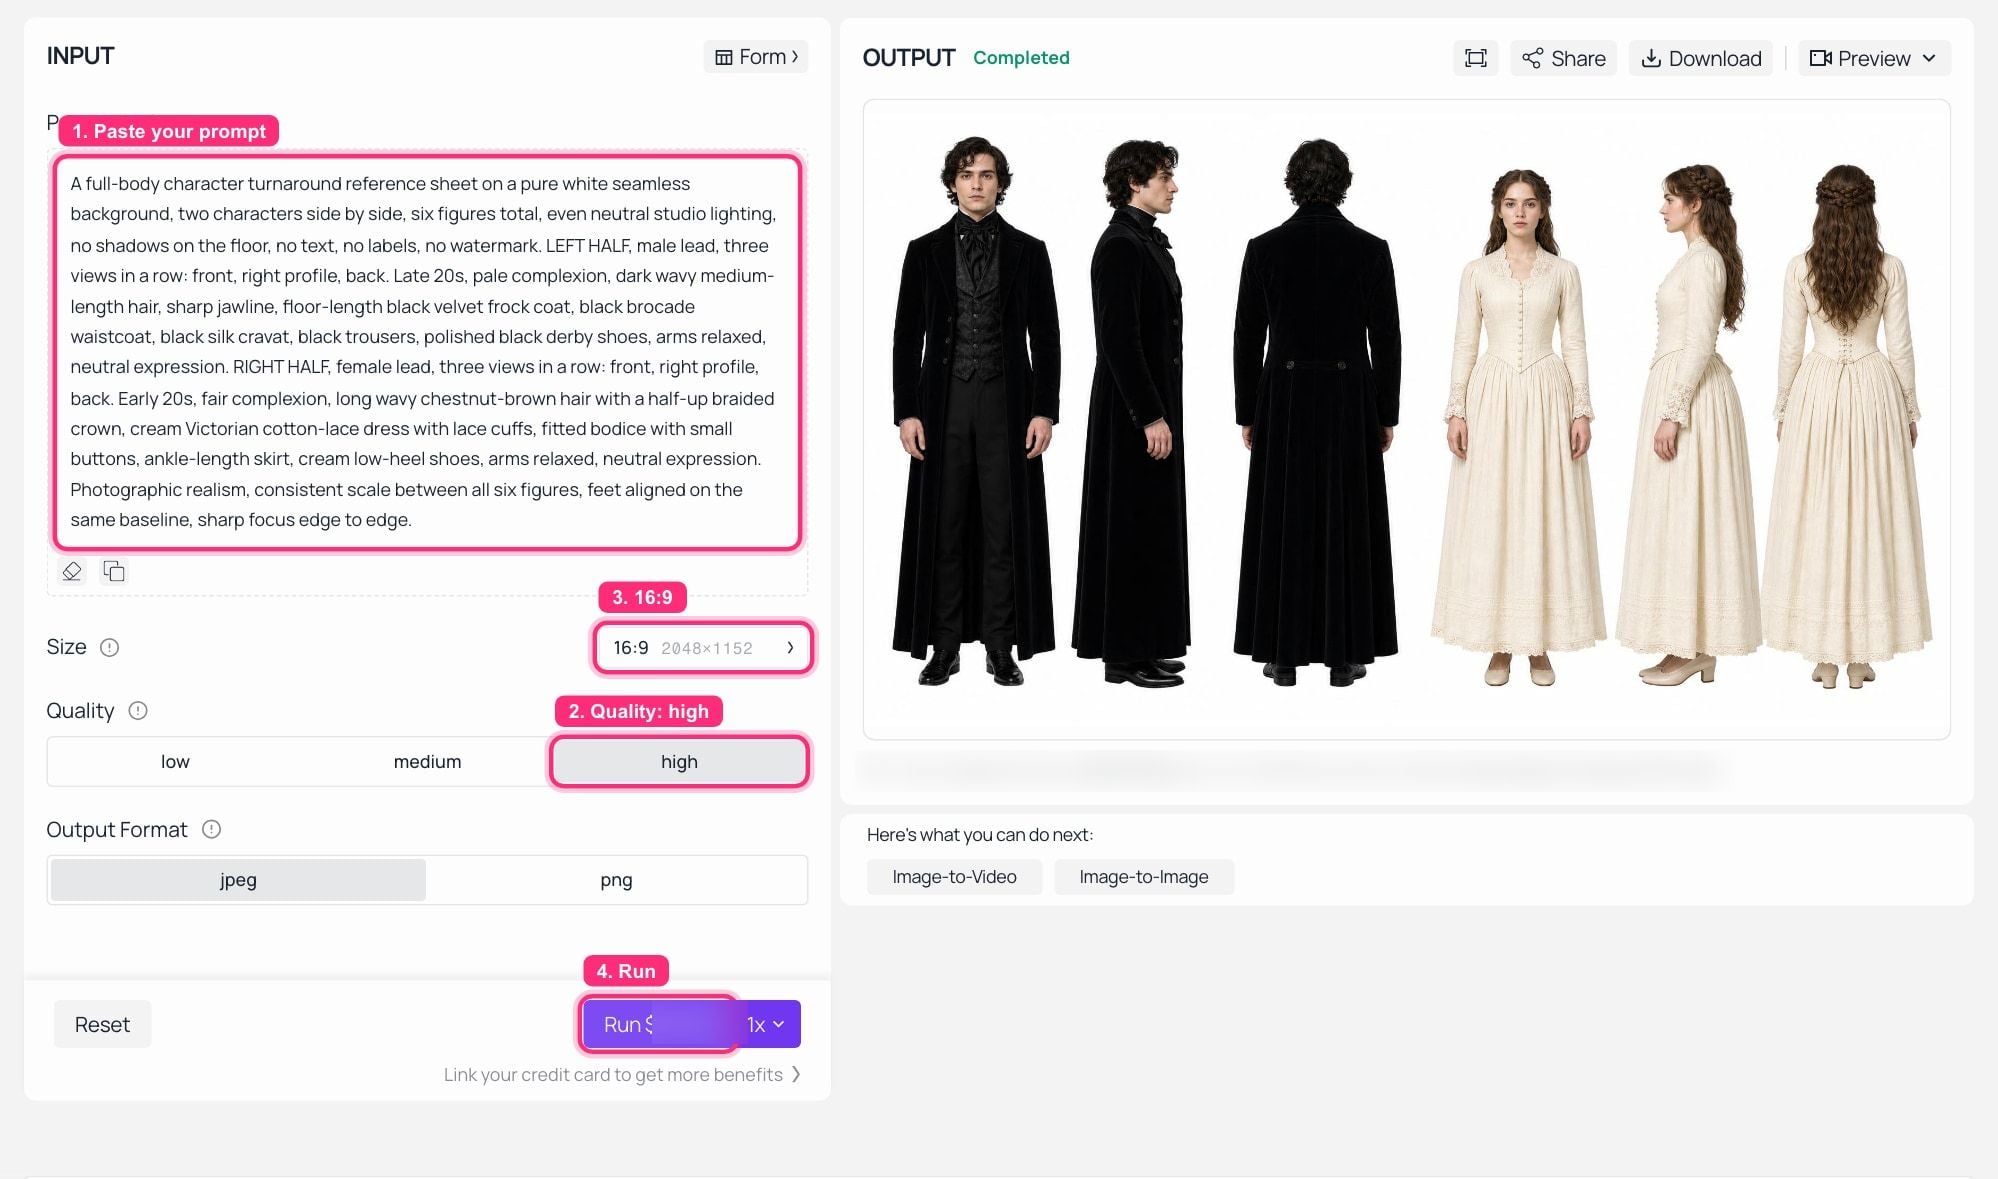 GPT Image 2 Text-to-Image sur Atlas Cloud, run terminé : le prompt de la feuille de référence à gauche, six figures sur une feuille blanche dans le panneau OUTPUT.
Voici la forme cible. Six figures, une ligne de base, rien dans l'arrière-plan pour discuter :
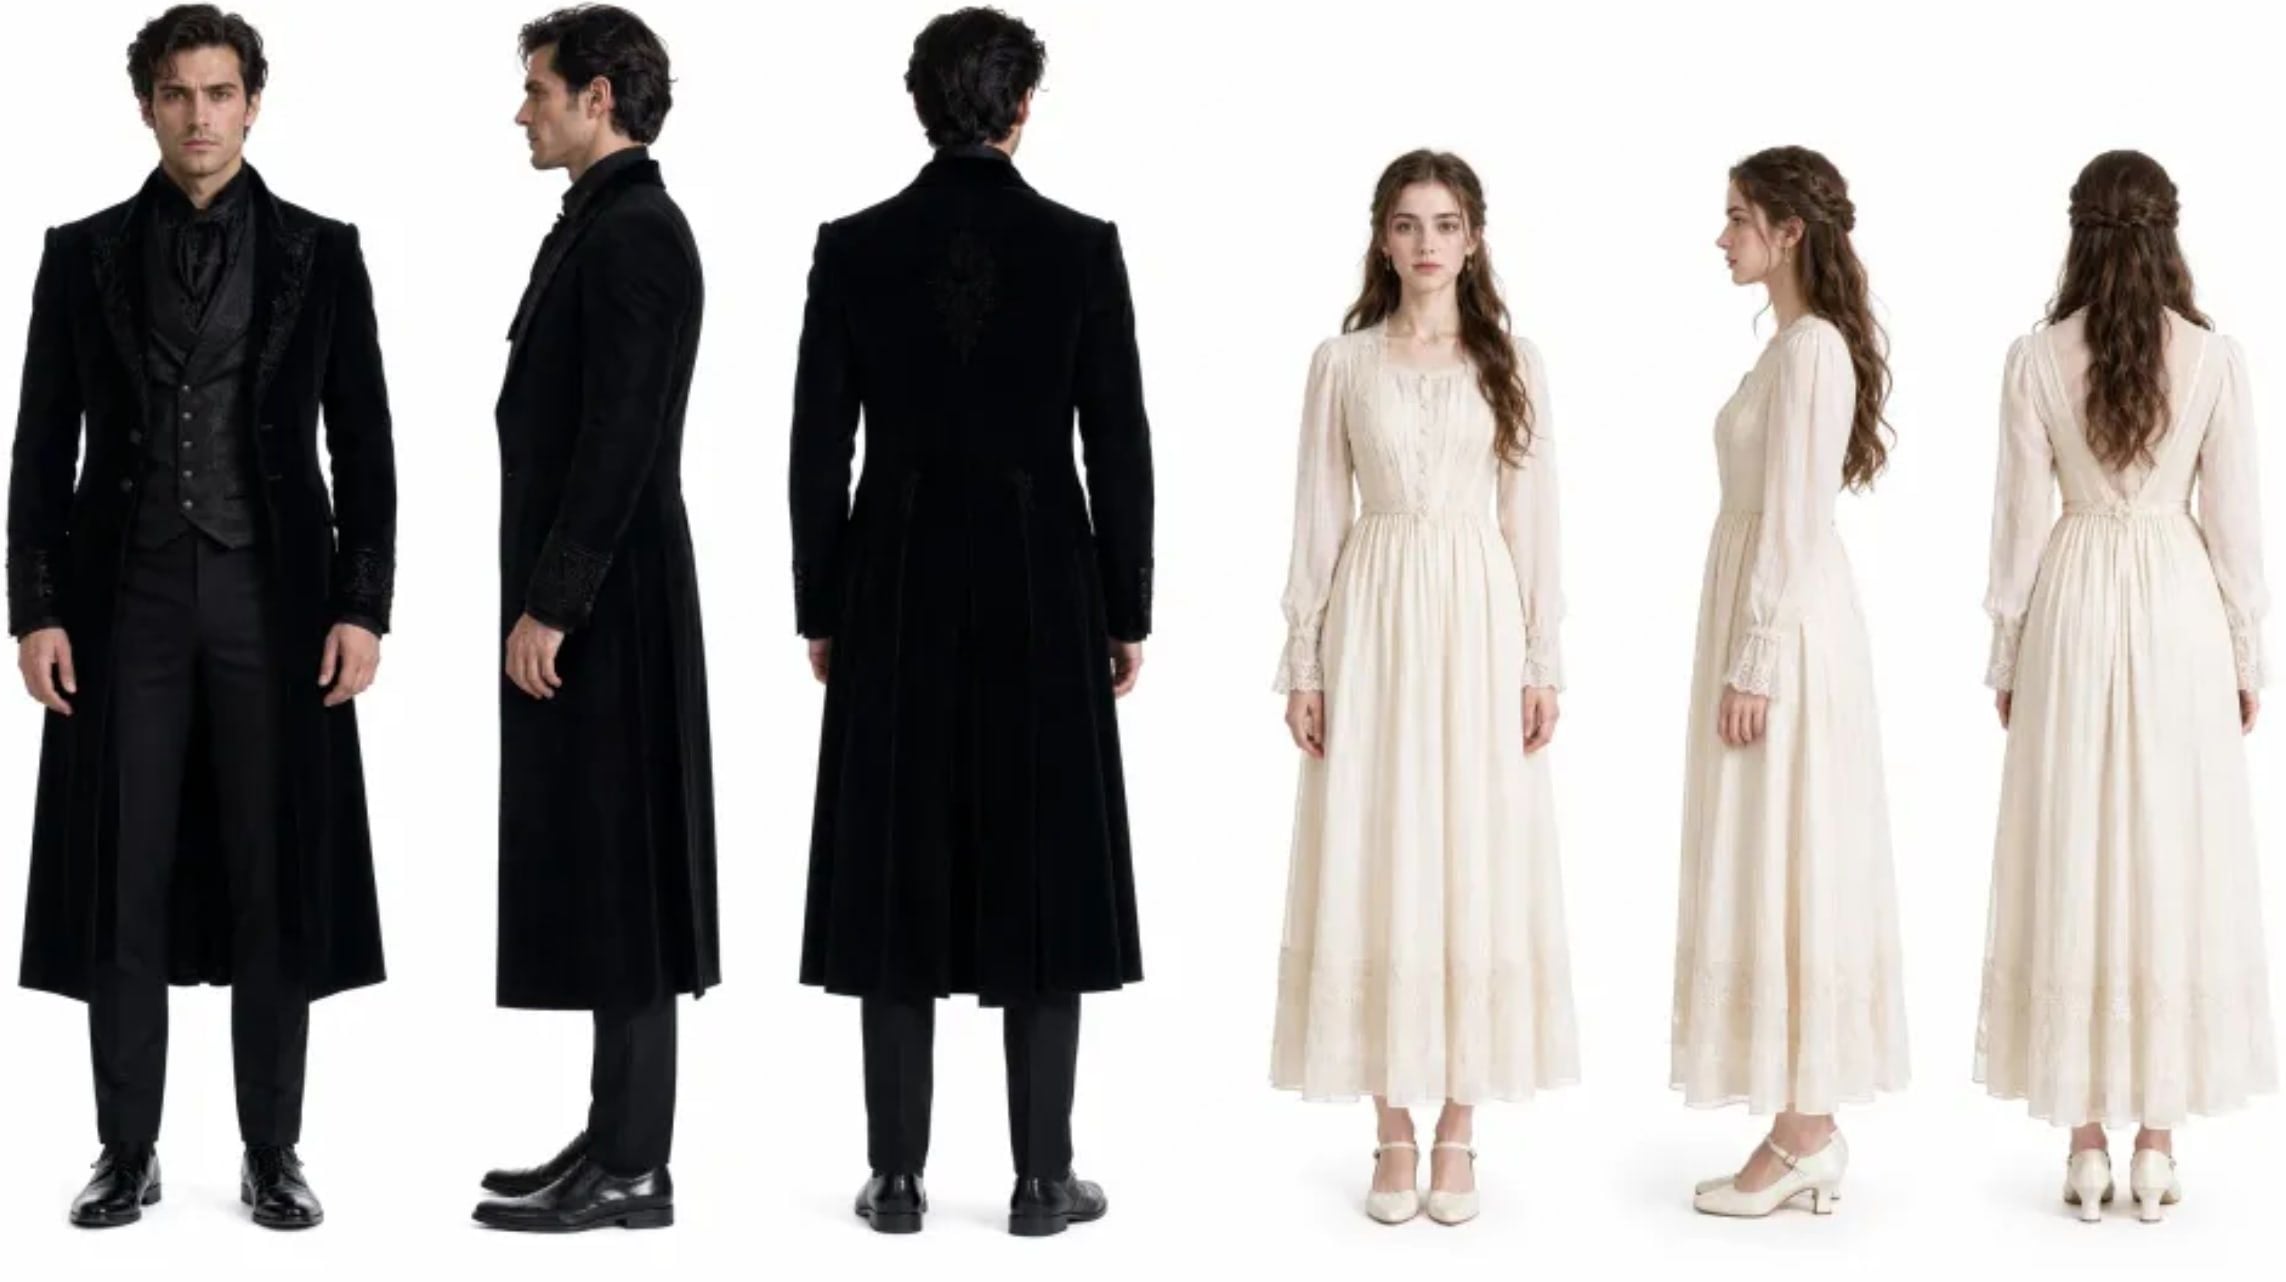 Le pack de référence qui a conduit le clip de démonstration : héros masculin en velours noir, héroïne féminine en dentelle victorienne crème, trois vues chacun, un fichier.
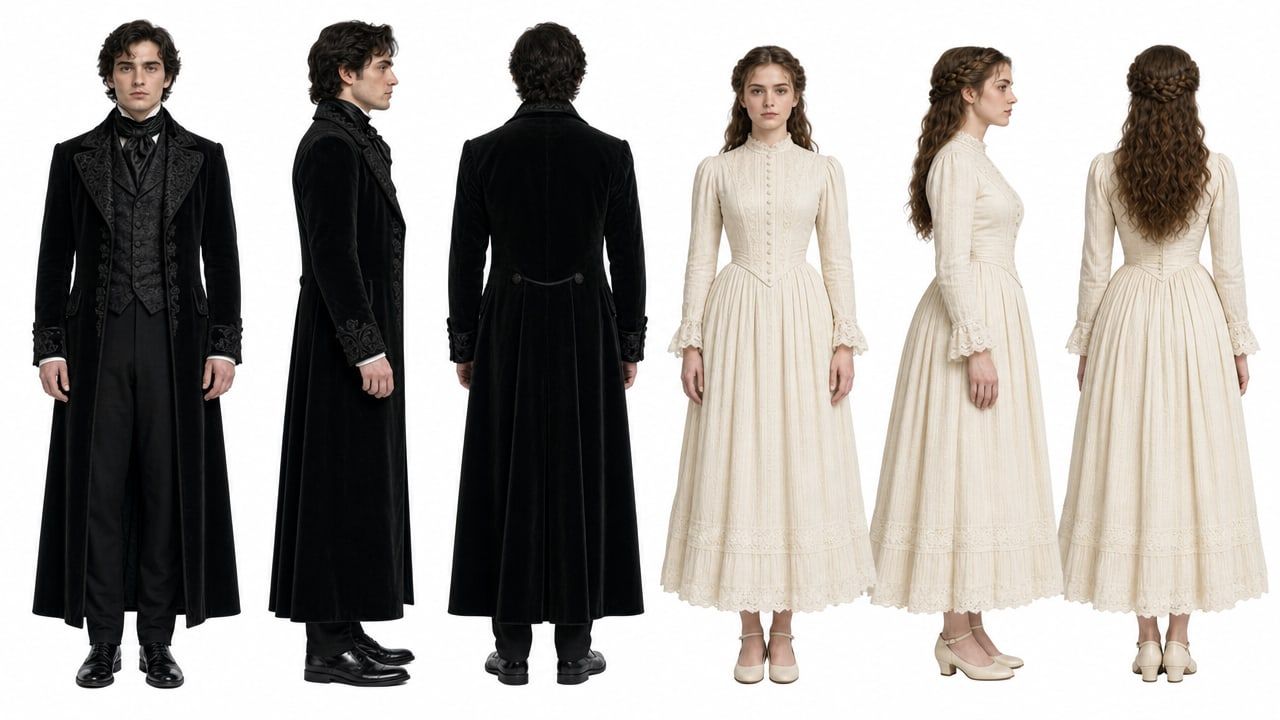 Mon propre run GPT Image 2 du prompt de l'étape 1, pour comparaison avec la référence ci-dessus.
Étape 2 : Verrouiller le décor avec un plateau de scène en six panneaux
Vous avez tenu le visage. La lumière vous trahira encore. La deuxième image de référence fixe six positions de caméra, la direction du clair de lune, la quantité de brouillard dans l'air et le degré d'humidité du sol. Vous dites au modèle que ce film a exactement une configuration d'éclairage.
plaintext1Un plateau de tournage cinématographique en six panneaux, 2 rangées sur 3 colonnes, fines gouttières noires entre les panneaux, chaque panneau légendé en petits caractères blancs élégants en haut de casse espacés en bas du panneau. Sujet : l'intérieur d'un château gothique abandonné la nuit. Lumière lunaire bleue froide, brouillard bas dérivant, sol en pierre humide et réfléchissant, hautes fenêtres en vitrail, appliques en fer à bougies avec petites flammes chaudes, noirs désaturés profonds, lourds rideaux de velours. Aucune personne dans aucun panneau. 2 3Panneau 1, légende « VUE GÉNÉRALE LARGE - COULOIR » : un long couloir à colonnes s'enfonçant vers une fenêtre à vitrail éclairée. 4Panneau 2, légende « ANGLE BAS - CLAIR DE LUNE SUR LE SOL » : caméra basse, un rayon de lune balayant les dalles humides. 5Panneau 3, légende « COMPOSITION PORTE & ESCALIER » : une porte en arche encadrant un escalier de pierre courbe. 6Panneau 4, légende « DÉTAIL RAPPROCHÉ - PORTE SCULPTÉE » : plan serré d'une lourde porte en bois sculpté avec une poignée en fer. 7Panneau 5, légende « VUE PRÈS DE LA FENÊTRE - BROUILLARD & RIDEAUX » : haute fenêtre, brouillard entrant, bord de rideau au premier plan. 8Panneau 6, légende « CADRE FINAL AFFICHE - SALLE VIDE » : salle vide symétrique, tapis d'escalier à motifs menant à la fenêtre. 9 10Photographique, cinématographique, grain de film, étalonnage cohérent sur les six panneaux.
Paramètres : même modèle, Qualité haute, Ratio 16:9.
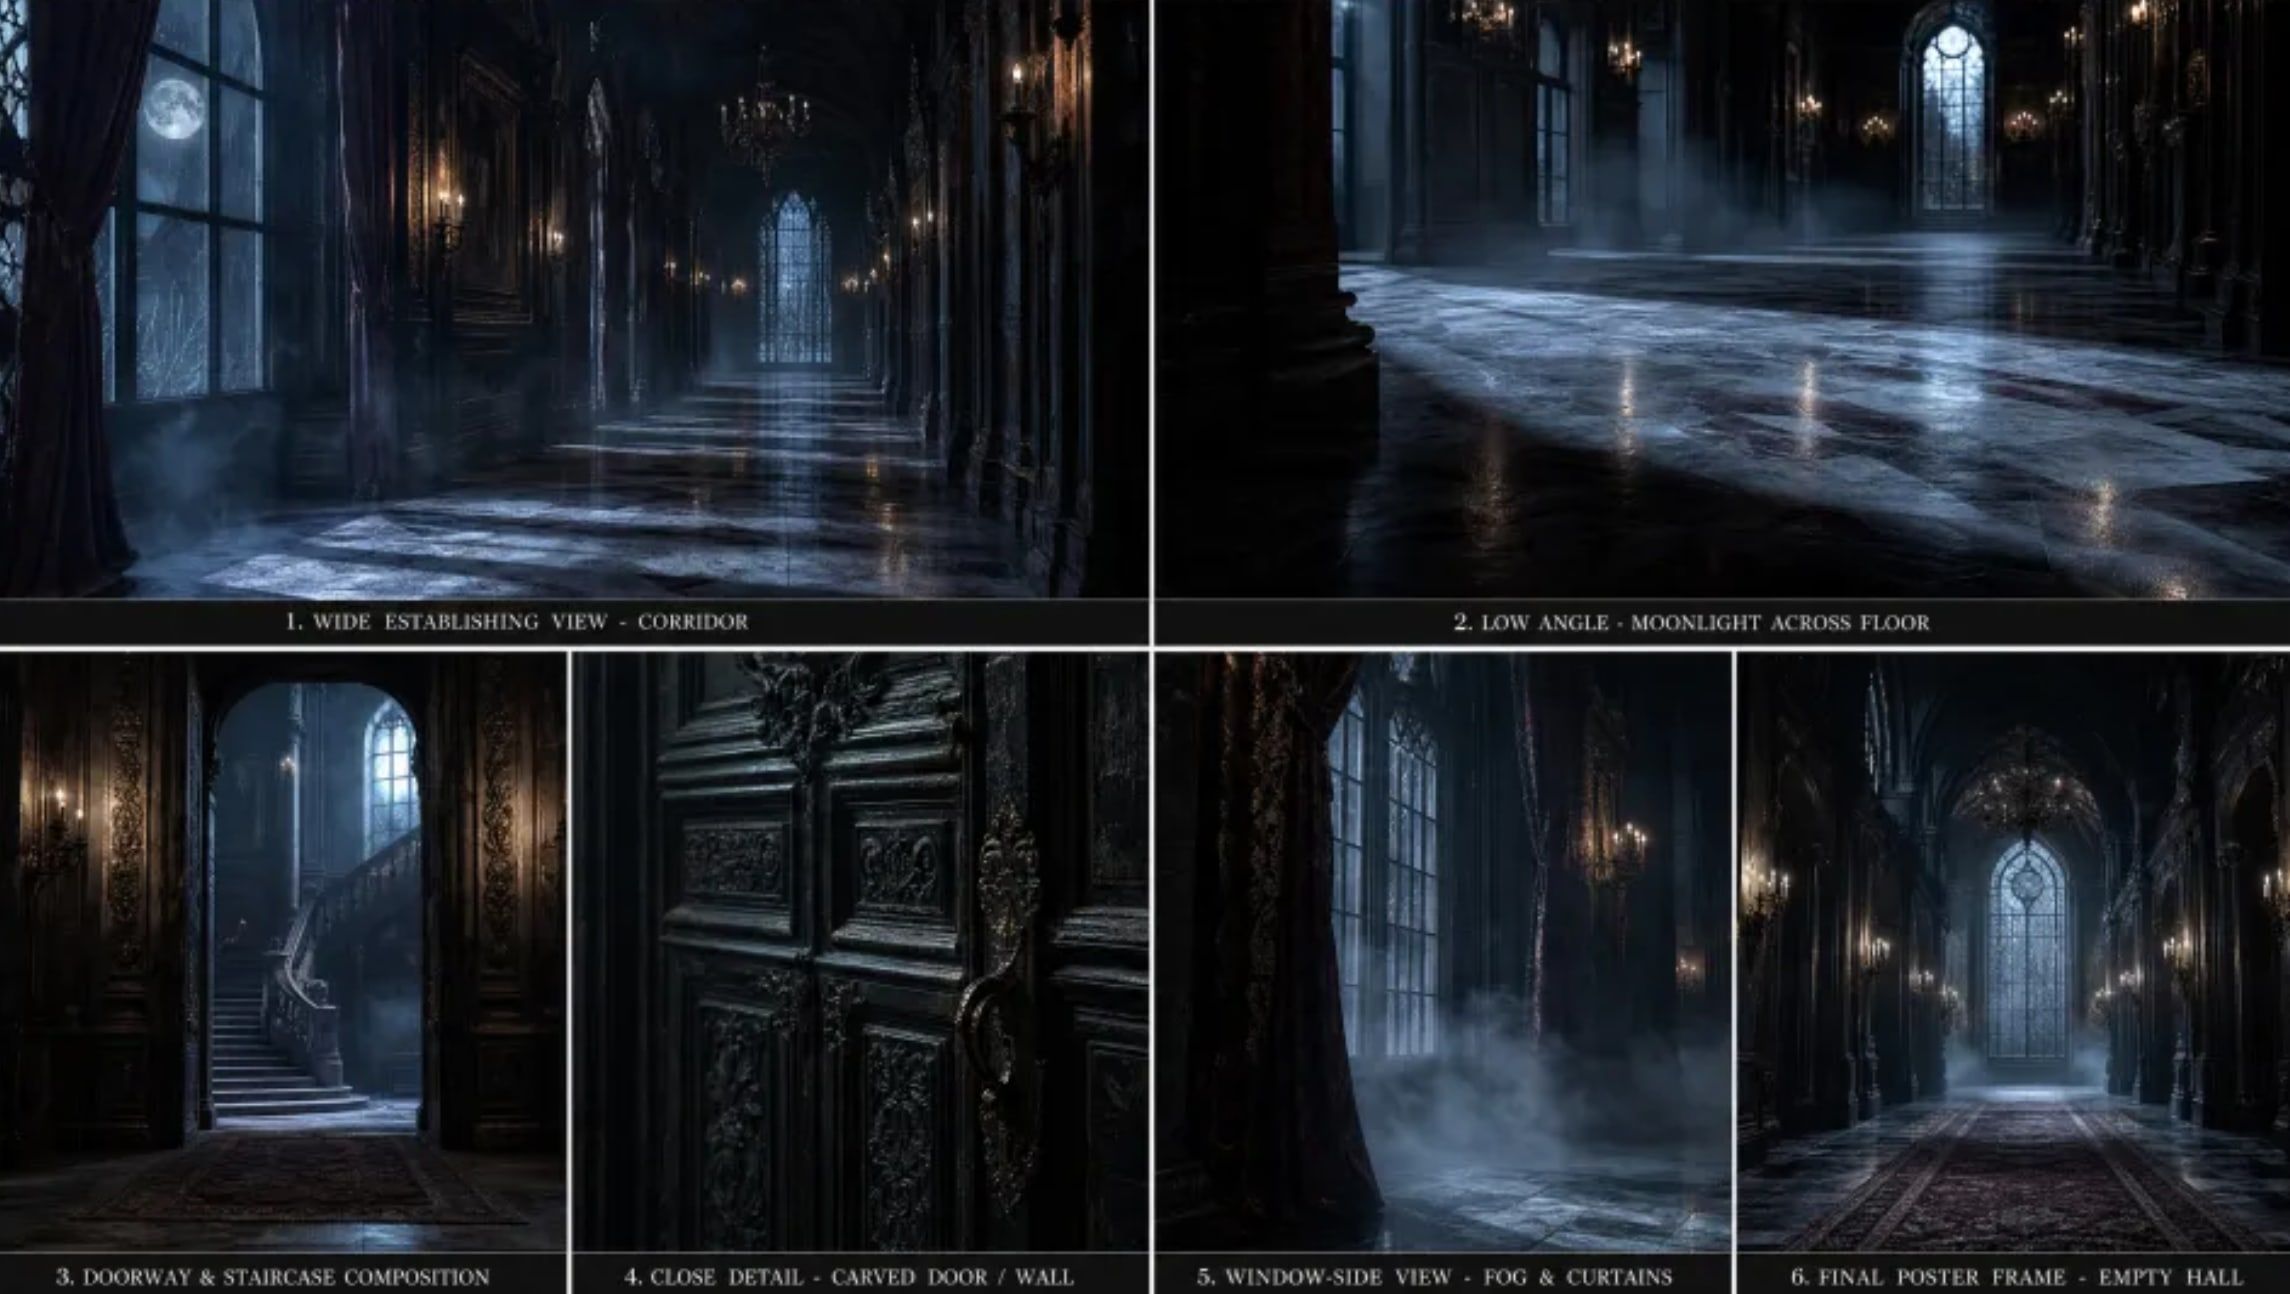 Le plateau de décors qui a conduit le clip de démonstration : six intérieurs de château gothique, un étalonnage, légendes lisibles.
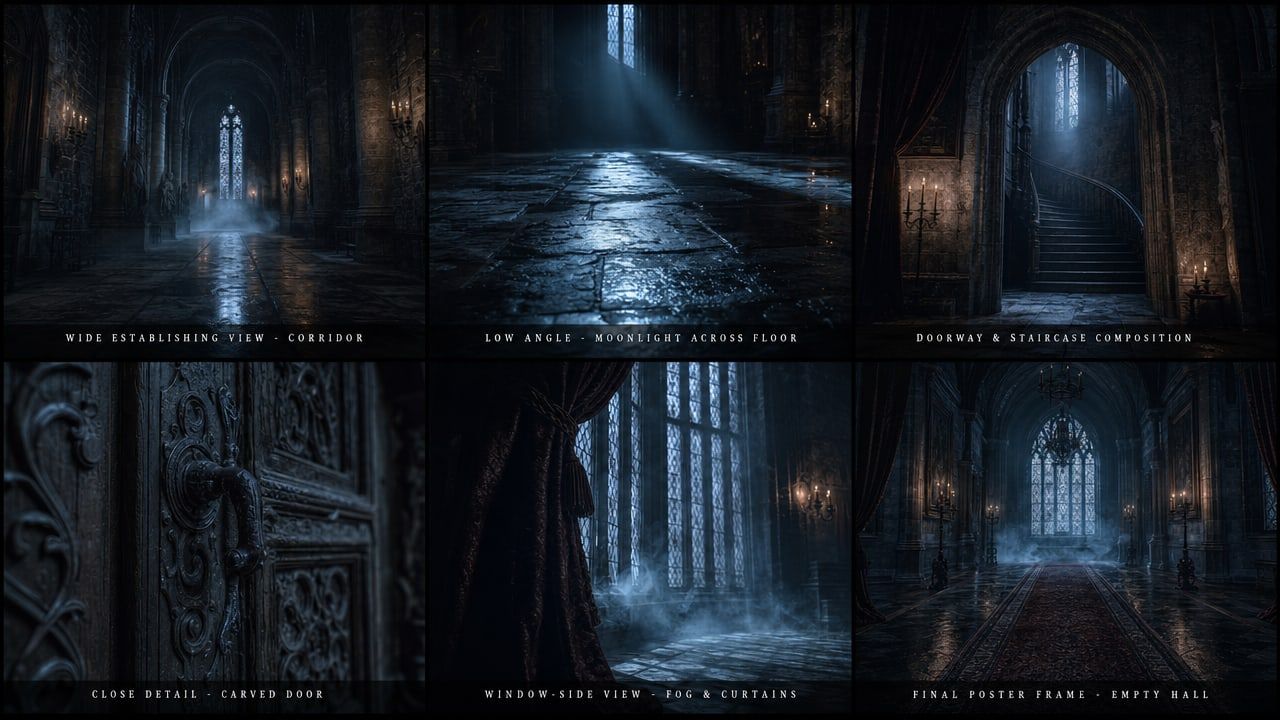 Mon propre run GPT Image 2 du prompt du plateau de l'étape 2.
Étape 3 : Générer le plan avec MiniMax H3 reference-to-video
Deux images de référence plus un prompt portant les positions de caméra et la direction audio. Le son est produit dans le même passage, donc il n'y a pas d'étape de voix ou de musique séparée. Gardez la durée courte pendant que vous réglez, puis passez à 15 pour la vraie coupe.
plaintext1L'image de référence 1 est la feuille de personnage : l'homme à GAUCHE est le héros masculin, la femme à DROITE est l'héroïne féminine. Gardez les deux identités exactement comme montré : sa mâchoire, ses cheveux foncés ondulés, son frac en velours noir, son gilet en brocart noir et sa cravate en soie noire ; ses cheveux châtains en demi-chignon tressé et sa robe en dentelle victorienne crème. L'image de référence 2 est le plateau de décors et d'éclairage : faites correspondre sa lumière lunaire bleue froide, son brouillard dérivant, son sol en pierre humide et réfléchissant et ses tons noirs désaturés. 2 39:16 vertical, aspect premium de court-métrage dramatique en prise de vue réelle, faible profondeur de champ, contraste cinématographique, pas de sous-titres, pas de texte à l'écran, pas de filigrane. 4 5Plan 1 : Plan moyen rapproché, caméra avançant lentement. L'héroïne se tient dans le couloir éclairé par la lune, respirant superficiellement, les yeux fixés sur quelque chose hors cadre à droite. Le brouillard passe à hauteur de ses genoux. 6Plan 2 : Coupure franche. Par-dessus l'épaule depuis derrière elle, le héros sort de l'arche sombre dans la lumière de la lune, le manteau attrapant la lumière, expression froide et curieuse. 7Plan 3 : Gros plan serré sur son visage, à moitié éclairé par la fenêtre, puis un gros plan similaire sur le sien alors qu'elle refuse de détourner le regard. 8 9Audio : bourdonnement grave soutenu, écho lointain de pierre, sa respiration haletante, un pas lourd alors qu'il entre dans la lumière, une seule nappe de cordes douce sur la dernière coupure.
Paramètres : modèle MiniMax H3 Reference-to-Video, Résolution 2K, Durée 8 (le curseur par défaut ; poussez à 15 pour la vraie coupe), Ratio adaptatif, et les deux fichiers dans Matériaux de référence. Le panneau les compte comme 2 sur 9, vous avez donc largement la place d'ajouter des plaques de vêtements ou d'accessoires plus tard.
À noter ce qui s'est passé avec le ratio. J'ai laissé le ratio sur adaptatif et seulement écrit « 9:16 vertical » dans le prompt. H3 est quand même revenu vertical, donc il a lu le cadrage dans le texte plutôt que de nécessiter le champ de formulaire.
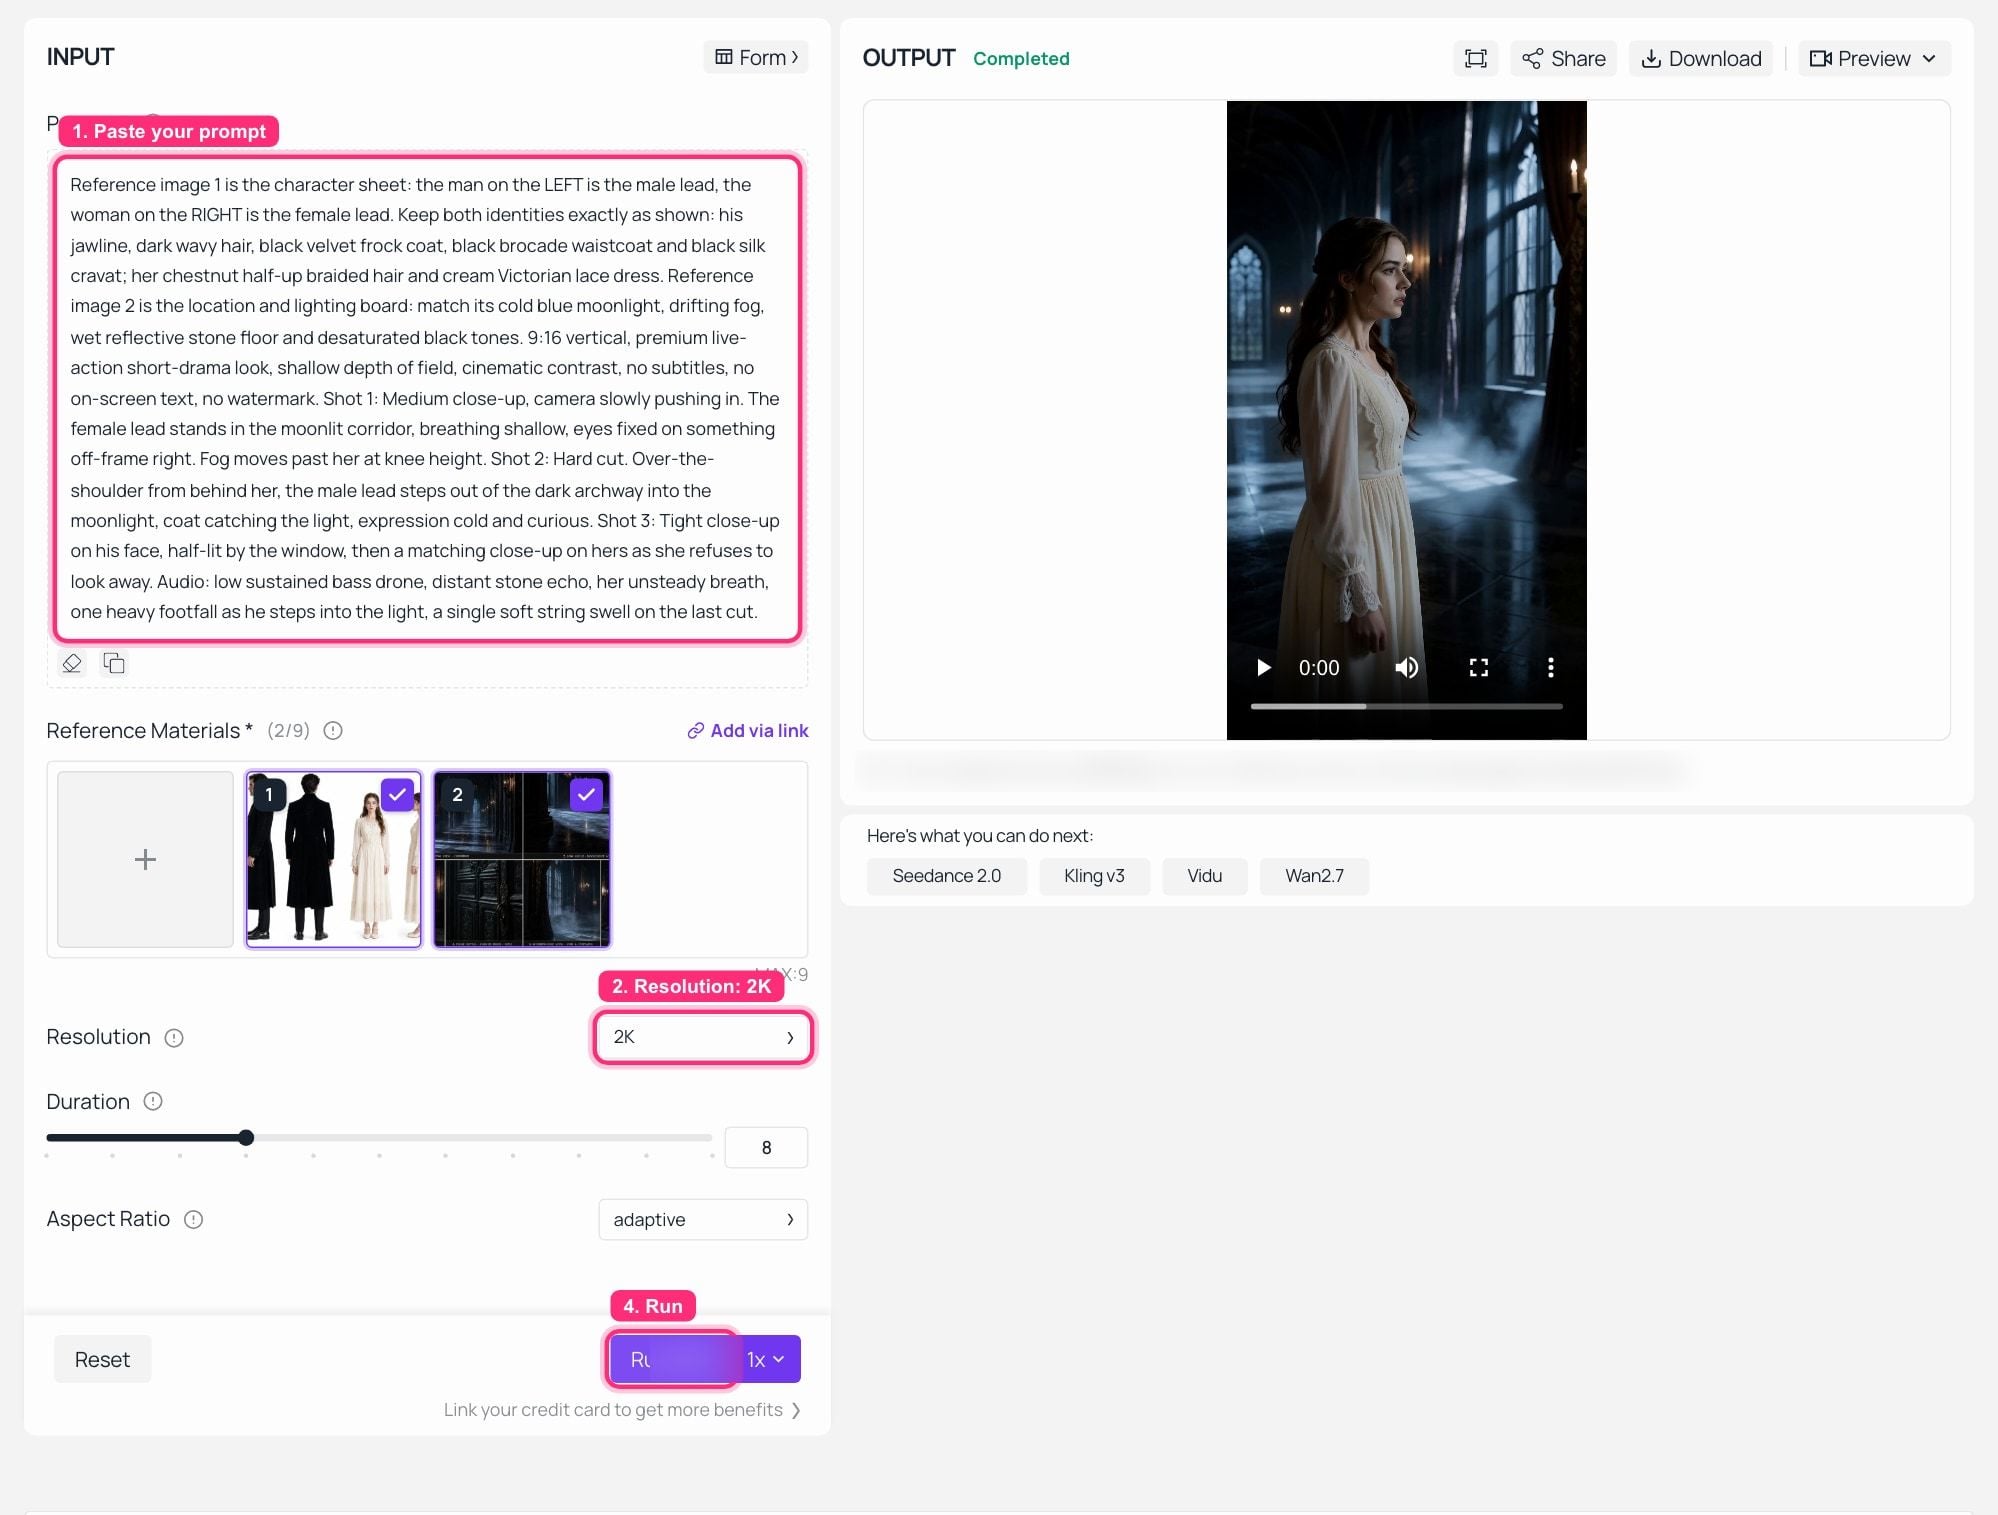 MiniMax H3 Reference-to-Video sur Atlas Cloud, run terminé : les deux fichiers de référence chargés comme 2 sur 9, résolution 2K, et le clip vertical généré jouant dans le panneau OUTPUT.
La première image est l'héroïne dans le corsage en dentelle crème, debout dans le couloir du panneau 1 du plateau, avec le brouillard à hauteur des genoux et la lumière de la lune frappant le sol humide exactement là où le plateau l'avait placée. Les deux images de référence ont atterri.
Étape 4 : Exécuter le contrôle Seedance 2.5 vs MiniMax H3 avec le même pack
Ne changez pas un mot. Mêmes deux images de référence, même prompt, modèle différent. J'ai laissé la durée par défaut de chaque page tranquille plutôt que de forcer une correspondance, et je dis ce que chacun a renvoyé ci-dessous. Reformuler un prompt « pour » l'autre modèle est exactement ainsi que les comparaisons commencent à mentir.
plaintext1Même prompt que l'étape 3, textuellement. Ne le reformulez pas pour l'autre modèle.
Paramètres : modèle Seedance 2.0 Reference-to-Video, Résolution 720p, mêmes deux images de référence dans Images de référence (encore 2 sur 9, avec des emplacements séparés pour jusqu'à 3 vidéos de référence et 3 fichiers audio de référence). Durée laissée à la valeur par défaut de la page, qui est revenue comme un clip de 10 secondes.
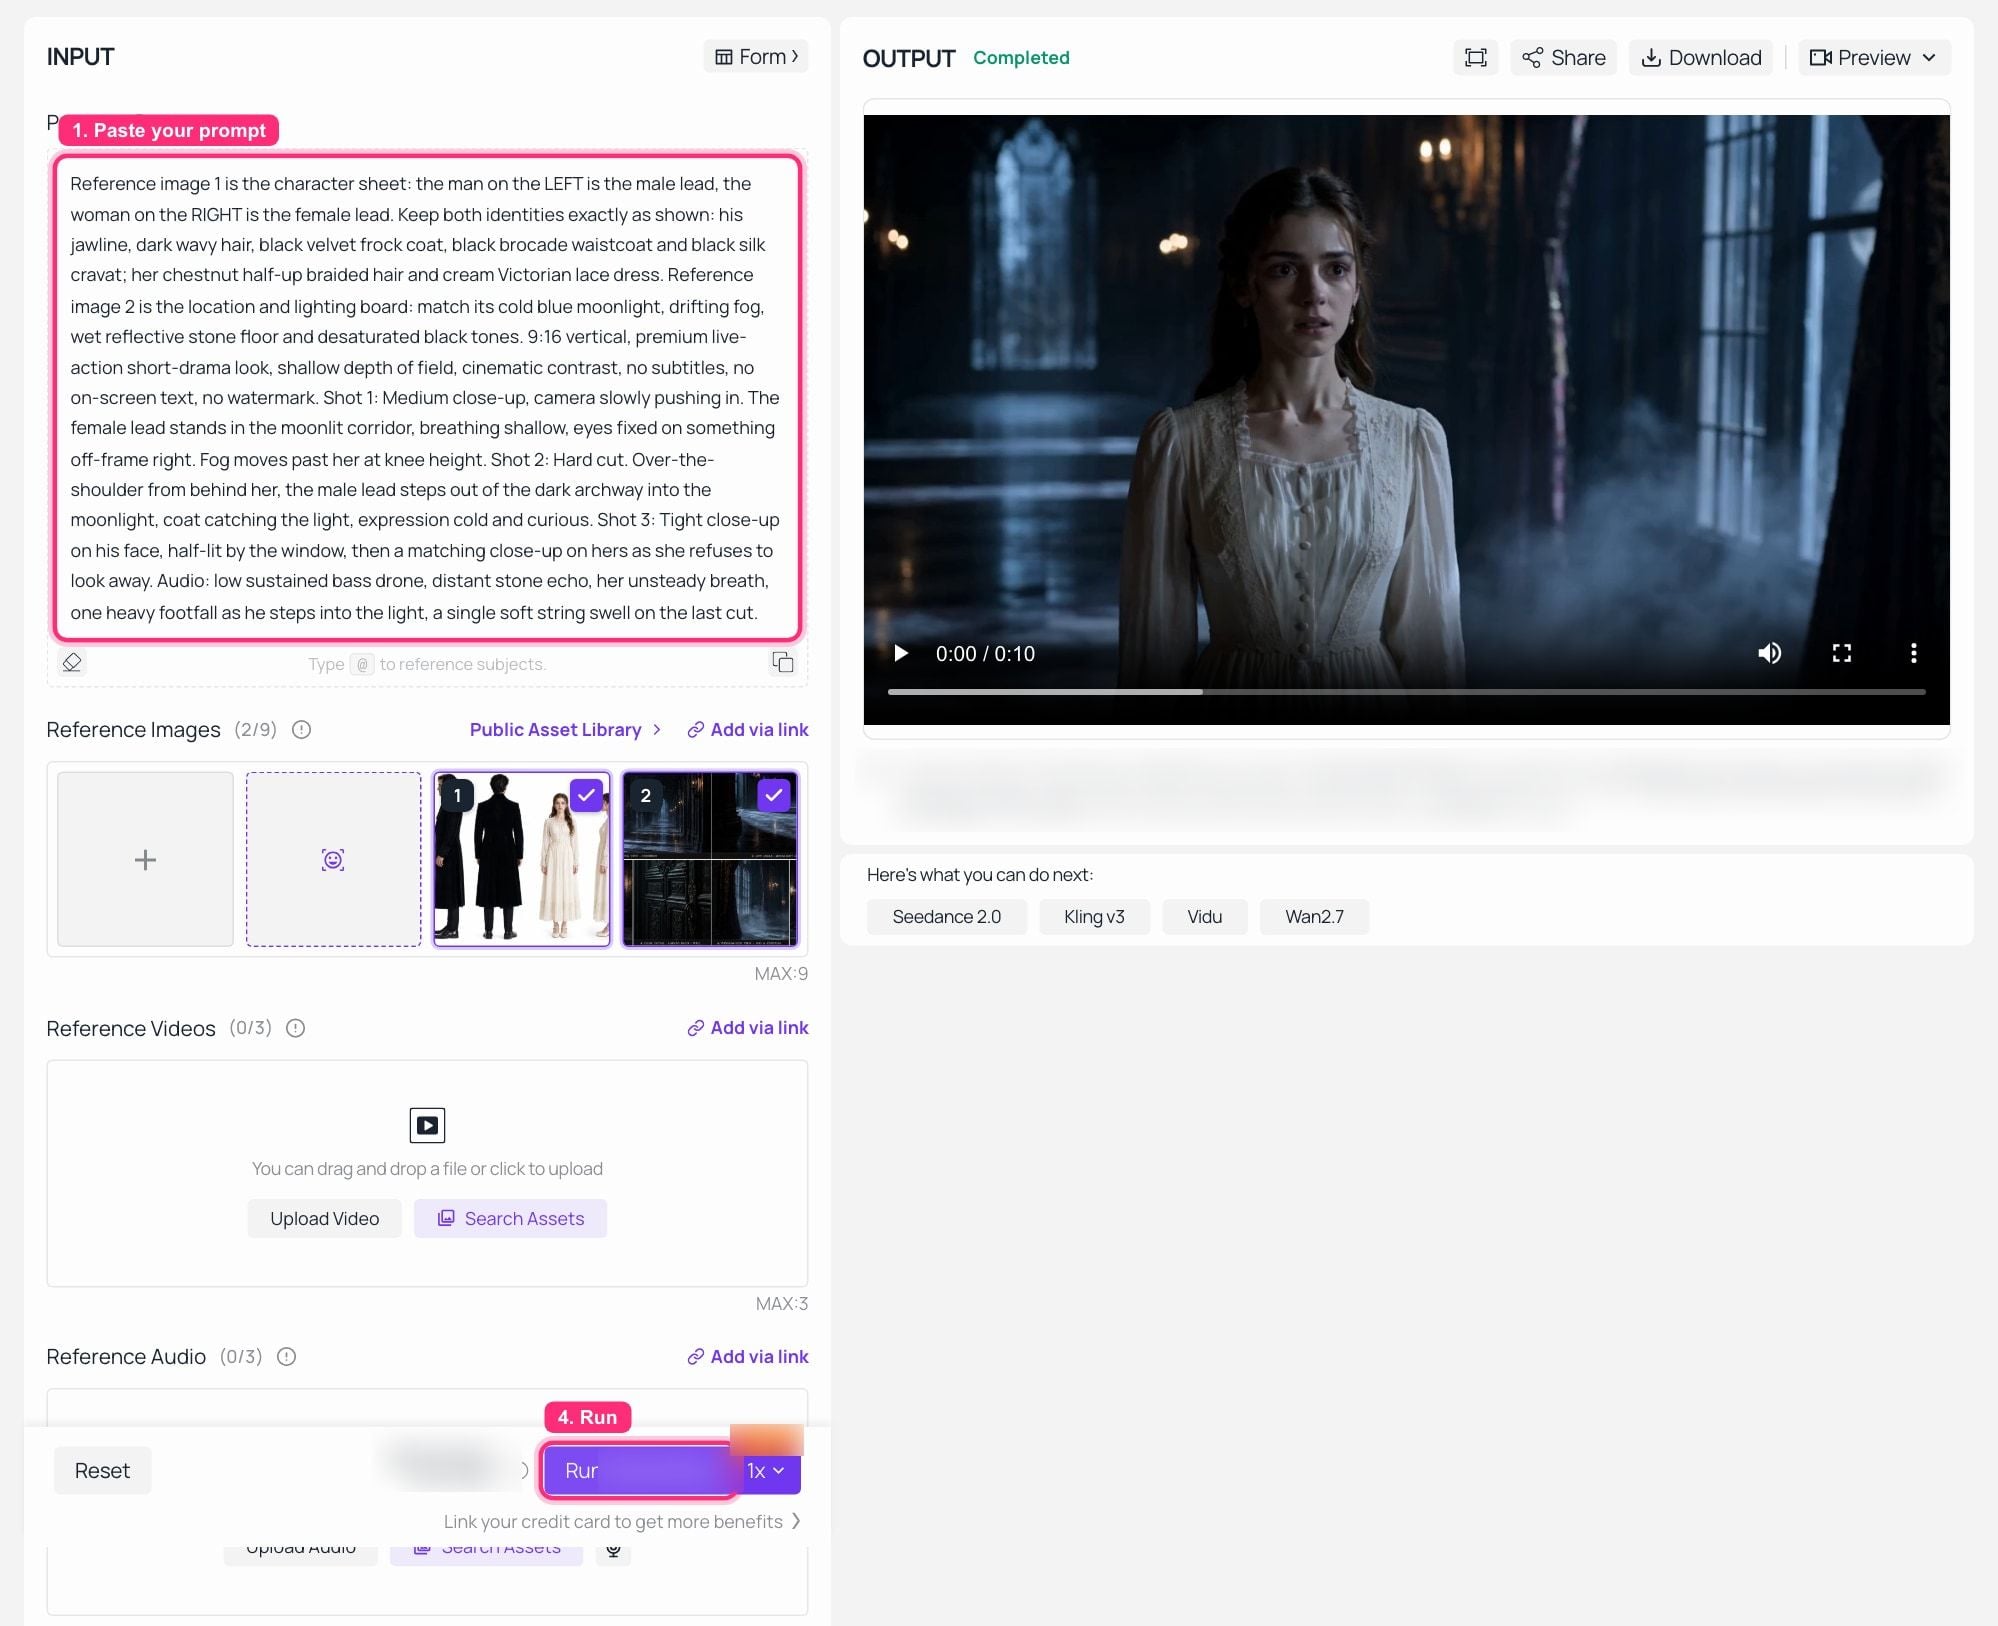 Seedance 2.0 Reference-to-Video sur Atlas Cloud, run terminé avec le même pack de référence et le même prompt de l'étape 3, et un résultat de 10 secondes dans le panneau OUTPUT.
Voici ce que les deux panneaux OUTPUT ont réellement montré, et je le rapporte platement plutôt que de choisir un gagnant.
Les deux runs ont tenu le personnage. Même robe en dentelle crème avec le même décolleté et les mêmes manchettes, mêmes cheveux châtains, même couloir de brouillard et de lune extrait du plateau. Aucun des deux n'a inventé une femme différente. Le pack de référence a fait ce travail des deux côtés, ce qui est la conclusion qui m'importe le plus.
Les différences concernaient la forme, pas le visage. Cet endpoint Seedance a livré du 720p ; H3 a livré du 2K à partir des mêmes entrées. Et la division du cadrage : H3 a lu « 9:16 vertical » directement dans le texte du prompt et a renvoyé du vertical, tandis que le run Seedance est revenu en 16:9 parce que cette page a son propre contrôle de ratio et que le texte du prompt seul ne l'a pas remplacé. Si vous coupez pour TikTok, cette différence vous coûtera un run la première fois que vous oublierez le champ de formulaire. Seedance 2.5 changerait probablement la moitié résolution de cela et ajouterait des relances au niveau de la région, et je ne vais pas prétendre avoir mesuré cela.
Étape 5 : Corriger un plan sans relancer tout le clip
Le vrai coût d'un court-métrage n'est pas la génération un. C'est la révision sept. H3 accepte un clip existant comme entrée et édite en fonction des instructions, en gardant ce que vous n'avez pas mentionné. L'argument de Seedance 2.5 ici est plus fin : redessiner une région de l'image et laisser la performance, l'éclairage et la caméra intacts.
plaintext1En utilisant le clip fourni : gardez les deux personnages, leurs vêtements, les mouvements de caméra et le rythme de coupe exactement tels quels. Changez seulement l'environnement, remplacez le couloir éclairé par la lune par la même salle de bal du château, hautes fenêtres en arc, un lustre allumé, et une lumière de bougie chaude, et rééclairez les deux personnages de sorte que leur lumière clé vienne du lustre à gauche du cadre au lieu de la fenêtre. Réécrivez sa seule ligne parlée pour « Tu n'as jamais dormi, n'est-ce pas. » Gardez le timing de sa performance sur les mêmes beats.
Paramètres : MiniMax H3 Reference-to-Video avec le clip de l'étape 3 comme entrée de référence, Durée 5, Résolution 2K.
Au-delà du test Seedance 2.5 vs MiniMax H3 : quatre façons de pousser un pack de référence
Même personnage, épisode suivant. Enregistrez la feuille de l'étape 1 comme un atout et changez seulement la liste des plans et le bloc d'histoire dans le prompt. L'identité vient d'un fichier, pas de votre souvenir de la façon dont vous l'avez formulé mardi dernier.
Fixez aussi la voix. H3 accepte jusqu'à trois références audio, 2 à 15 secondes chacune, et elles doivent accompagner une entrée image ou vidéo. Donnez-lui un échantillon de voix et le personnage parle dans ce timbre, vous n'avez donc pas à recruter un comédien de doublage entre les épisodes.
Bloquez la caméra avant de payer pour le rendu. Le reference-to-video de Seedance 2.5 accepte les maquettes 3D blanches et les fonds verts, vous pouvez donc verrouiller le cadrage sur une géométrie grise et seulement ensuite vous engager dans un rendu final. Cet exemple a été exécuté sur Seedance 2.1, un membre antérieur de la famille, mais la forme du workflow est la même.
Localisez une coupe maître au lieu de la refaire. Le remplacement au niveau de la région échange un visage, un produit ou une langue parlée tandis que la caméra, le timing et la durée des lèvres restent en place. Ici, une coupe beauté maître est réincarnée et révoix en espagnol, coréen et hindi, avec la pièce, le cadrage et la durée des lèvres maintenus.
Et parce que quelqu'un demandera à quoi ressemble le transfert de mouvement quand on arrête d'être raisonnable : trois hommes en costume, remplacés par trois capybaras photoréalistes, suivant le chemin de mouvement du clip original battement par battement jusqu'à ce qu'ils s'empilent en pyramide.
Il y a aussi la version simple de tout cela, celle que personne ne poste : une affiche statique devient une affiche animée, et la mise en page survit.
 L'affiche source statique. Nourrissez-la au reference-to-video avec « gardez le cadre, la palette et la mise en page, animez le texte » et vous obtenez une version animée du même design.
Combien vous coûte réellement un court-métrage Seedance 2.5 vs MiniMax H3
Pas de chiffres ici, car les chiffres bougent et la structure non. Les deux familles facturent à la seconde, paiement à l'utilisation, pas de siège et pas d'abonnement. Cela laisse trois variables : secondes, palier de résolution, et relances.
La troisième est toute la facture. Un clip de 15 secondes qui atterrit du premier coup est une charge. Le même clip au septième essai en est sept. Donc l'action d'économie d'argent n'est pas de choisir le modèle le moins cher à la seconde, c'est de bien faire le pack de référence avant de générer quoi que ce soit. Ces deux appels d'image aux étapes 1 et 2 sont la ligne la moins chère de tout le pipeline et celle qui décide du nombre d'appels vidéo que vous ferez. Le meilleur retour sur investissement de toute la chaîne, et de loin.
Ensuite, corrigez l'instinct de la seconde. Même pack de référence, même durée d'exécution : le reference-to-video de H3 rend du 1440p, cet endpoint Seedance reference-to-video rend du 720p. La seconde est la mauvaise unité. Les pixels par image, et si vous devez ensuite payer pour un passage de mise à l'échelle séparé, est la bonne.
L'audio fait aussi partie de l'arithmétique. Les deux côtés produisent du son synchronisé natif dans le même passage. Si votre pipeline actuel est modèle vidéo + TTS + un éditeur alignant les pistes, ce que vous économisez, ce sont deux appels API et un après-midi d'une personne, et cette économie n'apparaît sur aucune liste de prix.
Lequel pour quel travail :
| Travail | Choisissez | Pourquoi | Mise en garde |
|---|---|---|---|
| Court-métrage vertical, 9:16, TikTok ou ReelShort | MiniMax H3 | 1440p vertical avec stéréo natif, appelable maintenant, 15 s suffisent pour une accroche | vous coupez à 15 s, donc planifiez les séquences en conséquence |
| Film de marque continu de 30 secondes | Seedance 2.5 | génération unique, sans couture, 4K natif | vérifiez d'abord la disponibilité sur votre plateforme |
| Corriger un plan dans une coupe approuvée | Seedance 2.5 | redessin au niveau de la région laisse le reste intact | l'édition de clip entier de H3 vous emmène déjà loin aujourd'hui |
| Réductions de produits et e-commerce | l'un ou l'autre | les deux tiennent bien le texte à l'écran et les marques | vérifiez le texte à la résolution que vous livrez |
| Démonstrations de jeux ou d'interfaces | MiniMax H3 | la stabilité de l'interface et de la typographie en 2K est forte | plafond de 15 s pour un seul passage |
| Versions multilingues d'une coupe maître | Seedance 2.5 | remplacement de région plus voix multilingue | la qualité de localisation nécessite encore une vérification native |
| Livrer ce soir | MiniMax H3 | trois endpoints en direct, plus toute la gamme Seedance 2.0 | l'accès à Seedance 2.5 varie selon la plateforme |
Avant de livrer. MiniMax a dit que les poids de H3 suivraient dans les jours suivant le lancement, et les poids ouverts ne sont pas la même chose qu'une licence commerciale, donc lisez les conditions avant de self-héberger. La politique de filigrane et d'utilisation commerciale diffère également entre les applications grand public et l'accès API des deux côtés, et je n'ai pu confirmer ni l'une ni l'autre à partir d'une page de conditions principale au moment de la rédaction, donc vérifiez les conditions du fournisseur plutôt que de me croire sur parole. Et rien dans aucune licence de modèle ne couvre la ressemblance ou la marque déposée. Si une personne réelle, une marque réelle ou la propriété intellectuelle de quelqu'un d'autre se trouve dans votre pack de référence, c'est une question juridique distincte et les conditions du modèle n'y répondront pas.
Tous les modèles des tableaux ci-dessus s'exécutent sur la même clé, et les pages de modèles portent les tarifs en vigueur ainsi que le code copier-coller, y compris les éventuelles promotions en cours sur la gamme Seedance cette semaine.
Foire aux questions
Seedance 2.5 est-il meilleur que MiniMax H3 pour la cohérence des personnages ?
Sur le papier, il devrait l'être, avec jusqu'à 50 références multimodales contre les 12 fichiers de H3, plus les relances au niveau de la région. Mais au 31 juillet 2026, il n'y a aucun test public apparié que je puisse citer, et Seedance 2.5 n'a pas encore de note dans l'arène. Dans les runs que j'ai pu effectuer, la variable qui décidait de la stabilité de l'identité était la structure du pack de référence, pas la génération du modèle : avec une feuille composite de référence plus un plateau d'éclairage, les deux côtés ont tenu le personnage. Faites le bon pack avant de passer du temps à comparer les modèles.
Puis-je utiliser Seedance 2.5 maintenant, ou dois-je attendre ?
Son API est en ligne chez ByteDance. La disponibilité sur les plateformes de modèles tierces est inégale, et sur celle que j'ai testée, c'est encore un avis Day-0. Si vous avez besoin de livrer ce soir, les options appelables sont les trois endpoints de MiniMax H3 et toute la gamme Seedance 2.0 en production.
MiniMax H3 fait-il vraiment de la vidéo de 30 secondes ?
Non. La spécification est de 5 à 15 secondes par génération à 24 ips. Tout ce qui est plus long est une extension ou un assemblage, ce qui est une chose différente avec un risque de dérive différent. La génération unique de 30 secondes appartient à Seedance 2.5. Ne laissez pas les deux affirmations se confondre.
Les deux modèles génèrent-ils de l'audio, et puis-je garder une voix d'un épisode à l'autre ?
Les deux produisent de l'audio synchronisé natif dans le même passage, et H3 produit du stéréo sur chaque résultat. Pour une voix persistante, H3 accepte jusqu'à trois références audio de 2 à 15 secondes chacune, qui doivent être soumises avec une entrée image ou vidéo plutôt que seules.
Combien d'images de référence dois-je réellement envoyer ?
Moins que vous ne le pensez, mieux structurées que vous ne le pensez. Une seule composition bien faite bat généralement six recadrages lâches, car des fichiers séparés invitent le modèle à les moyenner en une personne qui n'existe pas. Donnez-lui deux tâches claires : identité et éclairage, et n'incluez pas d'échantillons de style qui se contredisent.
Quel modèle dois-je utiliser pour un court-métrage vertical de style TikTok ou ReelShort ?
À livrer cette semaine, en 9:16, en haute résolution avec son déjà mixé : MiniMax H3. Pour planifier une scène continue de 30 secondes où vous prévoyez de relancer des régions individuelles plutôt que des clips entiers : construisez pour Seedance 2.5 et vérifiez quand votre plateforme l'ouvre.


