Les pipelines agentiques de production plantent fréquemment en raison de violations de schéma inattendues. Même les LLM autorégressifs les plus performants échouent au parsing JSON lors d'appels d'outils à haut volume, forçant les développeurs à créer des boucles de réessai complexes et des gestionnaires d'erreurs personnalisés.
TypeSafe Jev résout ce problème structurel en abandonnant entièrement la génération séquentielle, token par token. Opérant comme un modèle de décision non autorégressif, Jev ingère l'état de l'application et évalue les questions de schéma pré-déclarées en une seule passe avant parallèle. Comme les choix de sortie possibles sont strictement bornés avant exécution, Jev élimine mathématiquement les JSON malformés, les noms d'outils invalides et le texte hors schéma.
Points clés : Qu'est-ce que TypeSafe Jev AI ? Benchmarks de performance et vitesse
TypeSafe Jev AI est un modèle de décision non autorégressif conçu spécifiquement pour la classification sous la seconde, la notation d'intention et le routage de microservices structuré. Contrairement aux LLM autorégressifs, Jev évalue les choix de schéma pré-déclarés en une seule passe avant.
- Zéro hallucination au niveau des types : Remplace les boucles de décodage de chaînes par des primitives de schéma d'état bornées, offrant un taux d'erreur de type de 0 %.
- Exécution sous 500 ms : L'échantillonnage parallèle non autorégressif atteint une latence P95 de 70 ms à 500 ms, jusqu'à 200 fois plus rapide que les LLM standard.
- Tokens de sortie gratuits : Zéro tokens générés séquentiellement signifie que les tokens de sortie sont entièrement gratuits à 0,042 $/1M de tokens d'entrée.
- Idéal pour : Routage de microservices, dispatch d'outils agentiques, triage de tickets et filtrage d'intention.
Repenser la pile IA : la pensée du Système 1 vs le raisonnement du Système 2
Lors de la conception de logiciels de backend évolutifs, forcer des vérifications conditionnelles simples à travers un grosse endpoint de chat de completion crée une latence système sévère. La plupart des microservices n'ont pas besoin de prose créative ou de génération chain-of-thought multi-étapes ; ils nécessitent une sélection immédiate, déterministe sur des choix connus.
Application du cadre cognitif de Kahneman à l'architecture logicielle
Diogo Almeida, co-fondateur de TypeSafe, qui a précédemment co-créé l'Apprentissage par Renforcément à partir du Feedback Humain chez OpenAI, a introduit un pivot structurel avec TypeSafe Jev pour résoudre cette inefficacité. S'inspirant directement du cadre cognitif de Kahneman, la plateforme divise le traitement en deux couches décisionnelles opérationnelles distinctes dans l'architecture modern de la pile IA :
- Système 2 – Raisonnement lent, délibéré : LLM autorégressifs standard qui fonctionnent via une génération séquentielle, token par token. Ces modèles excellent dans la rédaction de documents longs, le raisonnement ambigu et l'écriture de code complexe.
- Système 1 – Décisions rapides, intuitives : Un modèle d'IA Son One dédiée, entraîné via l'Apprentissage par Renforcement pour des Décisions Calibrées (RLCD) plutôt que par le RLHF traditionnel. Il est conçu spécifiquement pour la classification sub-secondes, la notation d'intention et le routage d'exécution sans le fardeau conversationnel.
Jev vs LLM : Coût et architecture – Modèles de décision vs modèles de discussion
Remplacer les modèles de chat à usage général par des modèles de décision typés spécialisés optimise fondamentalement les workflows de microservices en isolant l'évaluation rapide de la génération approfondie.
| Dimension architecturale | LLM autorégressifs (Système 2) | TypeSafe Jev (Système 1) |
| Tâche principale | Synthèse de texte libre | Choix discret et évaluation de schéma |
| Latence d'exécution | 3,000 ms à 30,000 ms et plus | 70 ms à 500 ms |
| Format de sortie | Flux de texte non structuré | Primitives de schéma strictement typées |
| Boucle de calcul | Décodage séquentiel de tokens | Évaluation en une seule passe avantavant |
| Objectif d'entraînement | Préférence humaine (RLHF) | Confiance de décision calibrée (RLCD) |
Décharger le routage, les garde-fous de sécurité et la répartition des fonctions loin des modèles de chat standard élimine les goulots d'étranglement de performance inhérents aux LLM autorégressifs., l'incorporation d'un modèle d'IA Système 1 garantit que les moteurs de raisonnement lourds ne se déclenchent que quand une génération ouverte est réellement requise.
Comment le modèle TypeSafe Jev offre une Zéro Hallucination au niveau de type
Même avec le mode JSON strict activé, les LLM de pointe renvoient régulièrement des clés hors schéma ou des valeurs d'énumération hallucinées lors de des exécutions de production en forte concurrence, ce qui entraîne l'échec de 0,5 % à 5 % des demandes des pipelines. Les microservices de production exigent un déterminisme absolu des types, mais les modèles autorégréarrégissant restent intrinsèquement vulnérables aux erreurs de génération de chaînes.
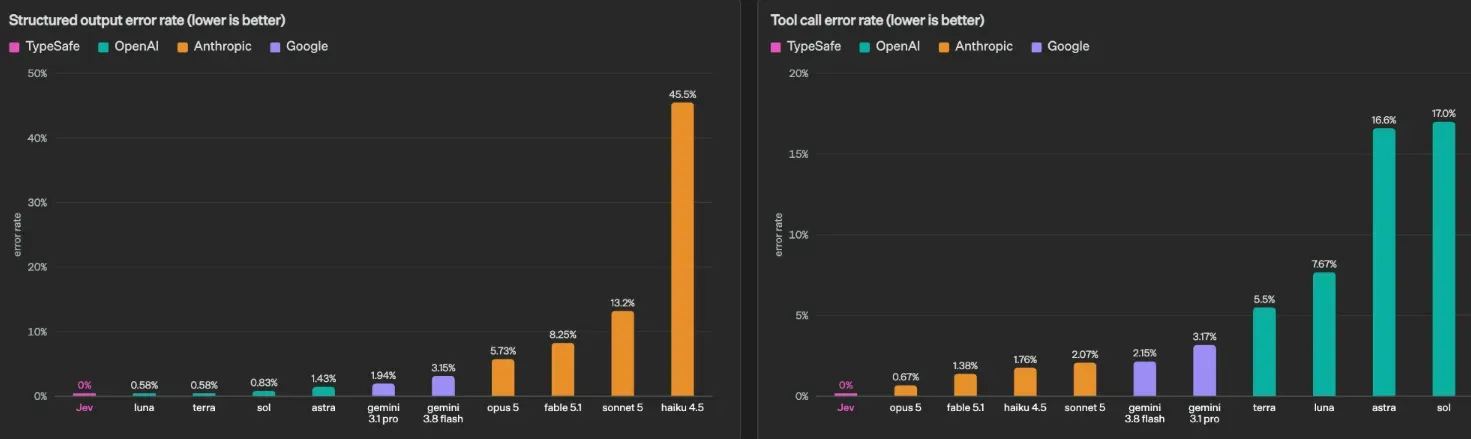
TypeSafe Jev résout ce problème en remplaçant les boucles de décodage de chaînes par une architecture d'état borné. Au lieu de générer du texte arbitraire et de tenter de le forcer dans la syntaxe JSON, Jev évalue les données d'entrée en fonction de contraintes de schéma prédéfinies en une seule passe. Ce changement structurel offre une véritable IA à zéro hallucination au niveau de type, entraînant 0 % d'erreurs de type dans lesflux de travail automatisés.
Les trois primittives centrales du schéma
Jev traite toutes les questions d'entrée via trois primitives explicites :
- Primitive de choix : Sélectionne exactement une option dans une liste prédéfinie de jusqu'à 255 choix catégoriques, renvoyant l'étiquette gagnante ainsi que les distributions de probabilité complètes.
- Primitive de évaluation : Évalue l'entrée sur une échelle numérique ordonnée ou une rubrique descriptive, fournissant des notes et les probabilités réparties sur chaque niveau.
- Primitive Noul : Calcule la probabilité exacte d'une condition oui ou non flottante entre 0,0 et 1,0, éliminant le texte de justification intermédiaire.
Parce que chaque requête est strictement mappée à ces trois primitives, le moteur d'exécution ne peut pas émettre de clés invalides, de noms d'outils hors liste ni de chargements mal formés.
Sécurité des types dans l'évaluation de sorties structurées
Les modèles de chat traditionnels génèrent de la syntaxe ou caractère par caractère, créant des risques d'analyse permancontinus dans les pipelines back-end.
| Métri d'évaluation | Mode JSON autorégressif | TypeSafe Jev Système 1 | | Application du type de sortie | Validation de chaîne post-génération | Primitives natives à limitations mathématiques | | Fréquence des erreurs de type | Variable (taux d'échec de 0,5 % à 5 %+)| 0 % d'erreurs de type (limitations de schéma) | | Risque d'énumération invalide | Élevé sans boucles de réessai personnalisées | Zéro (impossible par conception) |
Limiter strictement l'exécution du modèle à un état borné garantit une évaluation fiable des sorties structurées. Les applications consomment directement les sorties de Jev sans avoir à écrire de gestionnaires d'exceptions pour les schémas JSON cassés.
_Note sur le déterminisme des types vs la probabilité : TypeSafe Jev garantit 0 % de type et une conformité au schéma par conception, éliminant mathématiquement la syntaxe malformée, les clés manquantes et les valeurs d'énumération hors liste. Cependant, comme tous les modèles de décaison, ses choix de sortie restent probabilistes. Sur des entréesintrinsèquement ambigents, les scores de confiance doivent être utilisés pour contrôler l'exécution plutôt que d'assumer une certitude sémantique absolueLorsqu'on utilise des endpoints de chat standard pour de simples balises de classification comme
{"category": "billing"}, on introduit une latence inutile est introduite dans les microservices production. Parce que les modèles autorégressifs s'appuient sur un décodage séquentiel de tokens, les threads backend sont bloqués en attendant des boucles de génération de caractères uniques.
Les mécanismes de l'évaluation en une seule passe
GPT Les transformeurs traditionnels exécutent des boucles de génération autorégressive avec une nouvelle token résultat, exigeant une passe distincte à travers la bibliothèque réseau. Cette dépendance séquentielle crée une latence élevée et gonfle les coûts d'infrastructure en fonction du nombre de tokens générés.
TypeSafe Jev élimine la génération séquentielle en utilisant l'échantillonnage, parallèle non autorégressif. Comme le décrit la version de lancement de TypeSafe, Jev ingère l'état du contexte et évalue toutes les choix de schéma prédéclarés simultanément en une seule passe avant.
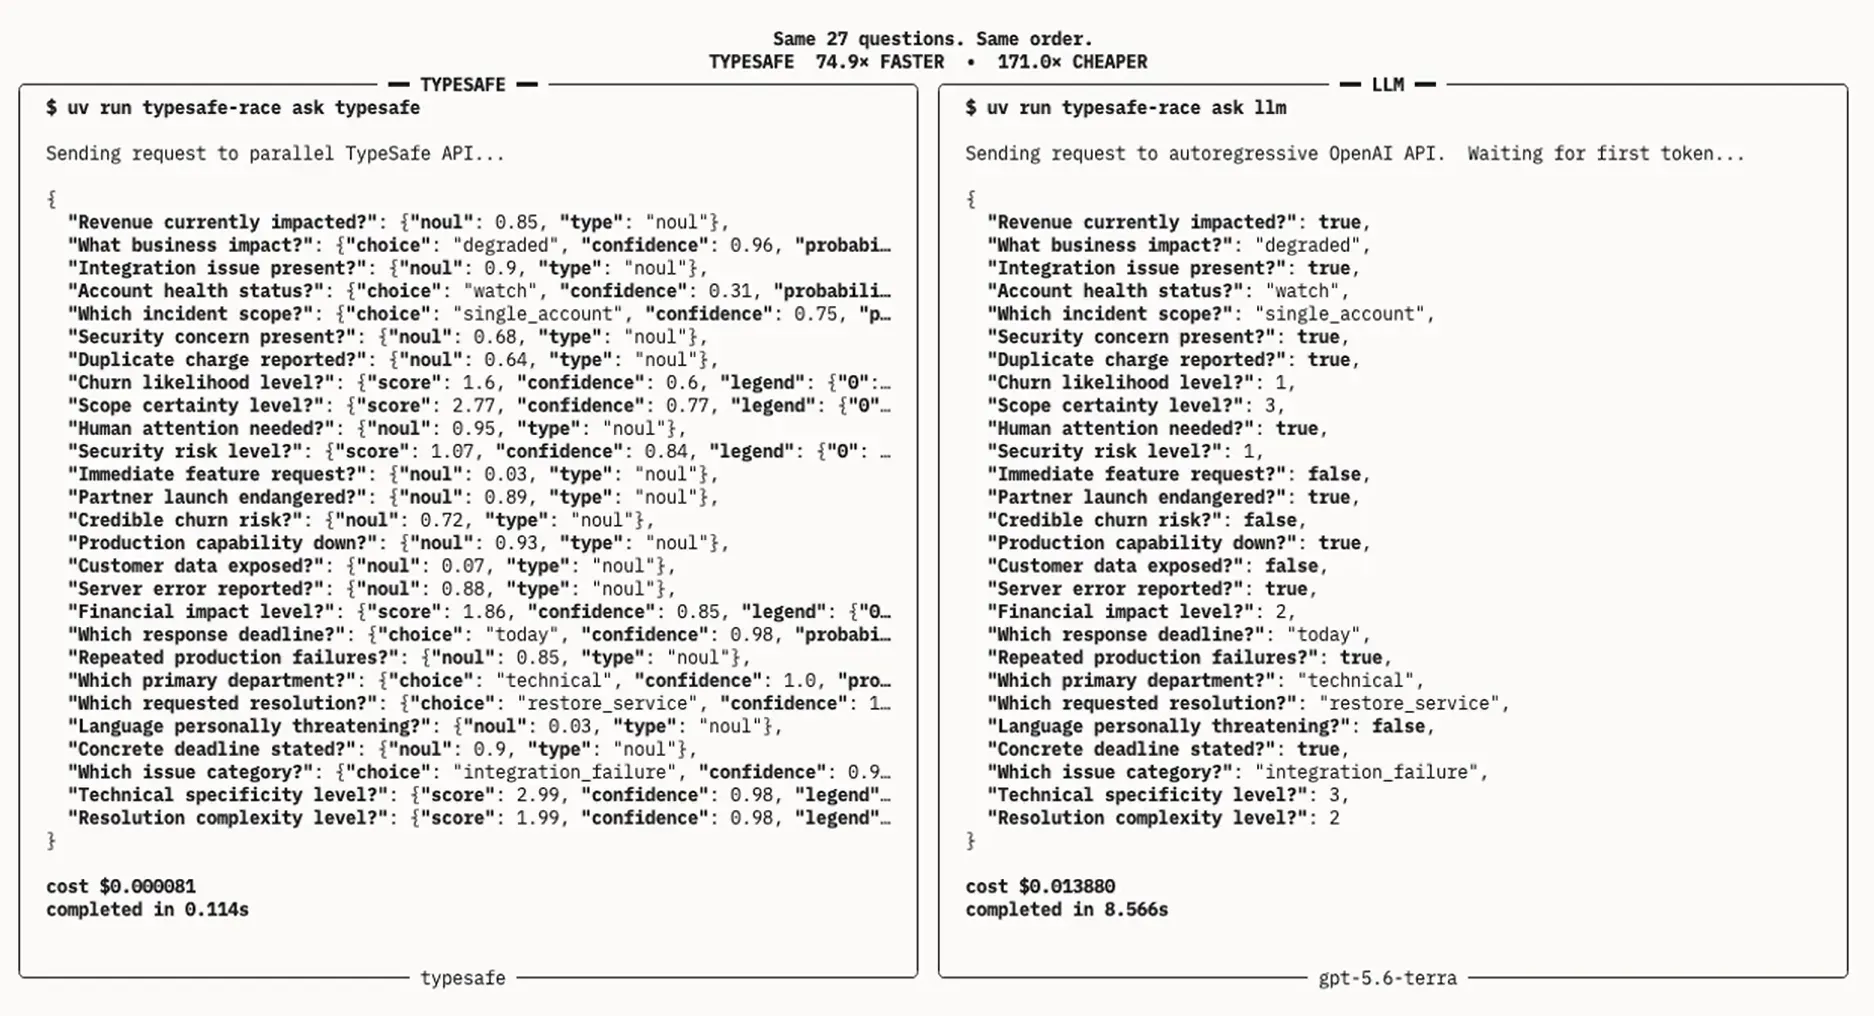
Comparaison de benchmarks de termaux : exécution de 27 questions d'évaluation de schéma simultanées sur TypeSafe Jev vs. l'endpoint GPT 5.6 Terra
Comme le modèle calcule des distributions de probabilité sur des sorties prédéfinies plutôt que de générer du texte libre, les boucles de décodage de sortie disparaissent complètement. Ce changement structurel apporte trois gains de performance clés :
- Tokens de sortie gratuits (Trop bon marché pour être mesurés) : Parce que Jev évalue les choix en une seule passe avant sans générer de tokens séquentiels, l'évaluation de sortie na n'implique pratiquement aucun calcul supplémentaire, ce qui rend les tokens de sortie effectivement gratuits.
- Tarification prévisible : Le traitement du contexte coûte un taux fixe de 0,042 $ par millions de tokens d'entrée. Évaluer des schémas statiques de invites avec Jev évite l'inflation exponentielle des factures API par rapport à la surcharge d'exécution de long contexte associées à de lourdes endpoints de chat.
- Exécution sous la seconde : Les benchmarks de latence de TypeSafe Jev montrent des temps de rént se tiensure de entre 70 ms et 500 ms, jusqu'à 200 fois plus rapides que les modèles de chat de pointe.
Répartition des performances architecturales
| Métrique / Dimension | LLM autorégressifs traditionnels (Système 2) | Moteur TypeSafe Jev System One | | Boucle d'exécution | Décodage séquentiel token par token | Passe avant parallèle unique sur un schéma pré-déclaré | | Type de sortie | Chaînes de texte non structurées / chaînes JSON | Primitives de décision typées (Choix, Éval, Noul) | | Taux d'erreur de schéma | 0,58 % à 45 %+ en fonction du modèle/prompt | 0 % d'erreur de type (bornémathématiquement) | | Profil de latence P95 | 3,000 ms à 30,000+ ms | 70 ms à 500 ms | | Économie de sortie | Variable par token ($15 à $60 / M tokens) | GRATUIT (trop bon marché pour être mesuré carté) Aucune génération de tokens de sortie séquentiels | | Domaine principal | Raisonnement, écriture de brouillonss, synthèse ouverte | Classification, sélection d'outils, contrôle de confiance |
Éviter la limite de bande mémoire
Dans l'inférence LLM standard, la bande passante mémoire se sature extrême les poids de modèle sont rechargéé dans la logique mémoire pour chaque token. En complétant les évaluations de décision en une seule passe avant, Jev contourne complètement ce goulot d'étranglement de la mémoire, des vitesses de réponse stables même sous un trafic concurrent important.
Apprentissage par renforcement pour des décisions calibrées et des portes de confiance
Les modèles de chat standard produisent régulièrement des déclarations incorrectes avec une confiance auto-déclarée de 99 %, car l'ajustement fin conventionnel récompense la formulation de phrases persuasive plutôt que la vérité statistique. Dans les microservices dproduction, une décision erronée mais trop confiante mène directement à des enregistrements de base de données corrompus, à des arguments d'outil in existants et à des temps d'arrêt imprévus.
Aligner la confiance du modèle avec la précision empirique
Pour résoudre cette surassurance structurelle, TypeSafe a introduit Apprentissage par renforcement pour des décisions calibrées. Contrairement à la méthodologie RLHF traditionnelle qui optimise une préférence humaine subjective, la calibration directe peut des modèles de décision pour produire des probabilités calibrées.
Grâce à une confiance alignée sur la précision, une probabilité de 0,90 produite par Jev signifie que le choix est empiriquement correct 90 % du temps dans les ensembles de test. Cette étalonnage mathématique permet une prise de décision probabiliste fiable, sans que les développeurs n'aient à écrire des heuristiques de prompts complexes pour estimer la certitude de la sortie.
Mise en œuvre du routage à seuil de confiance en production
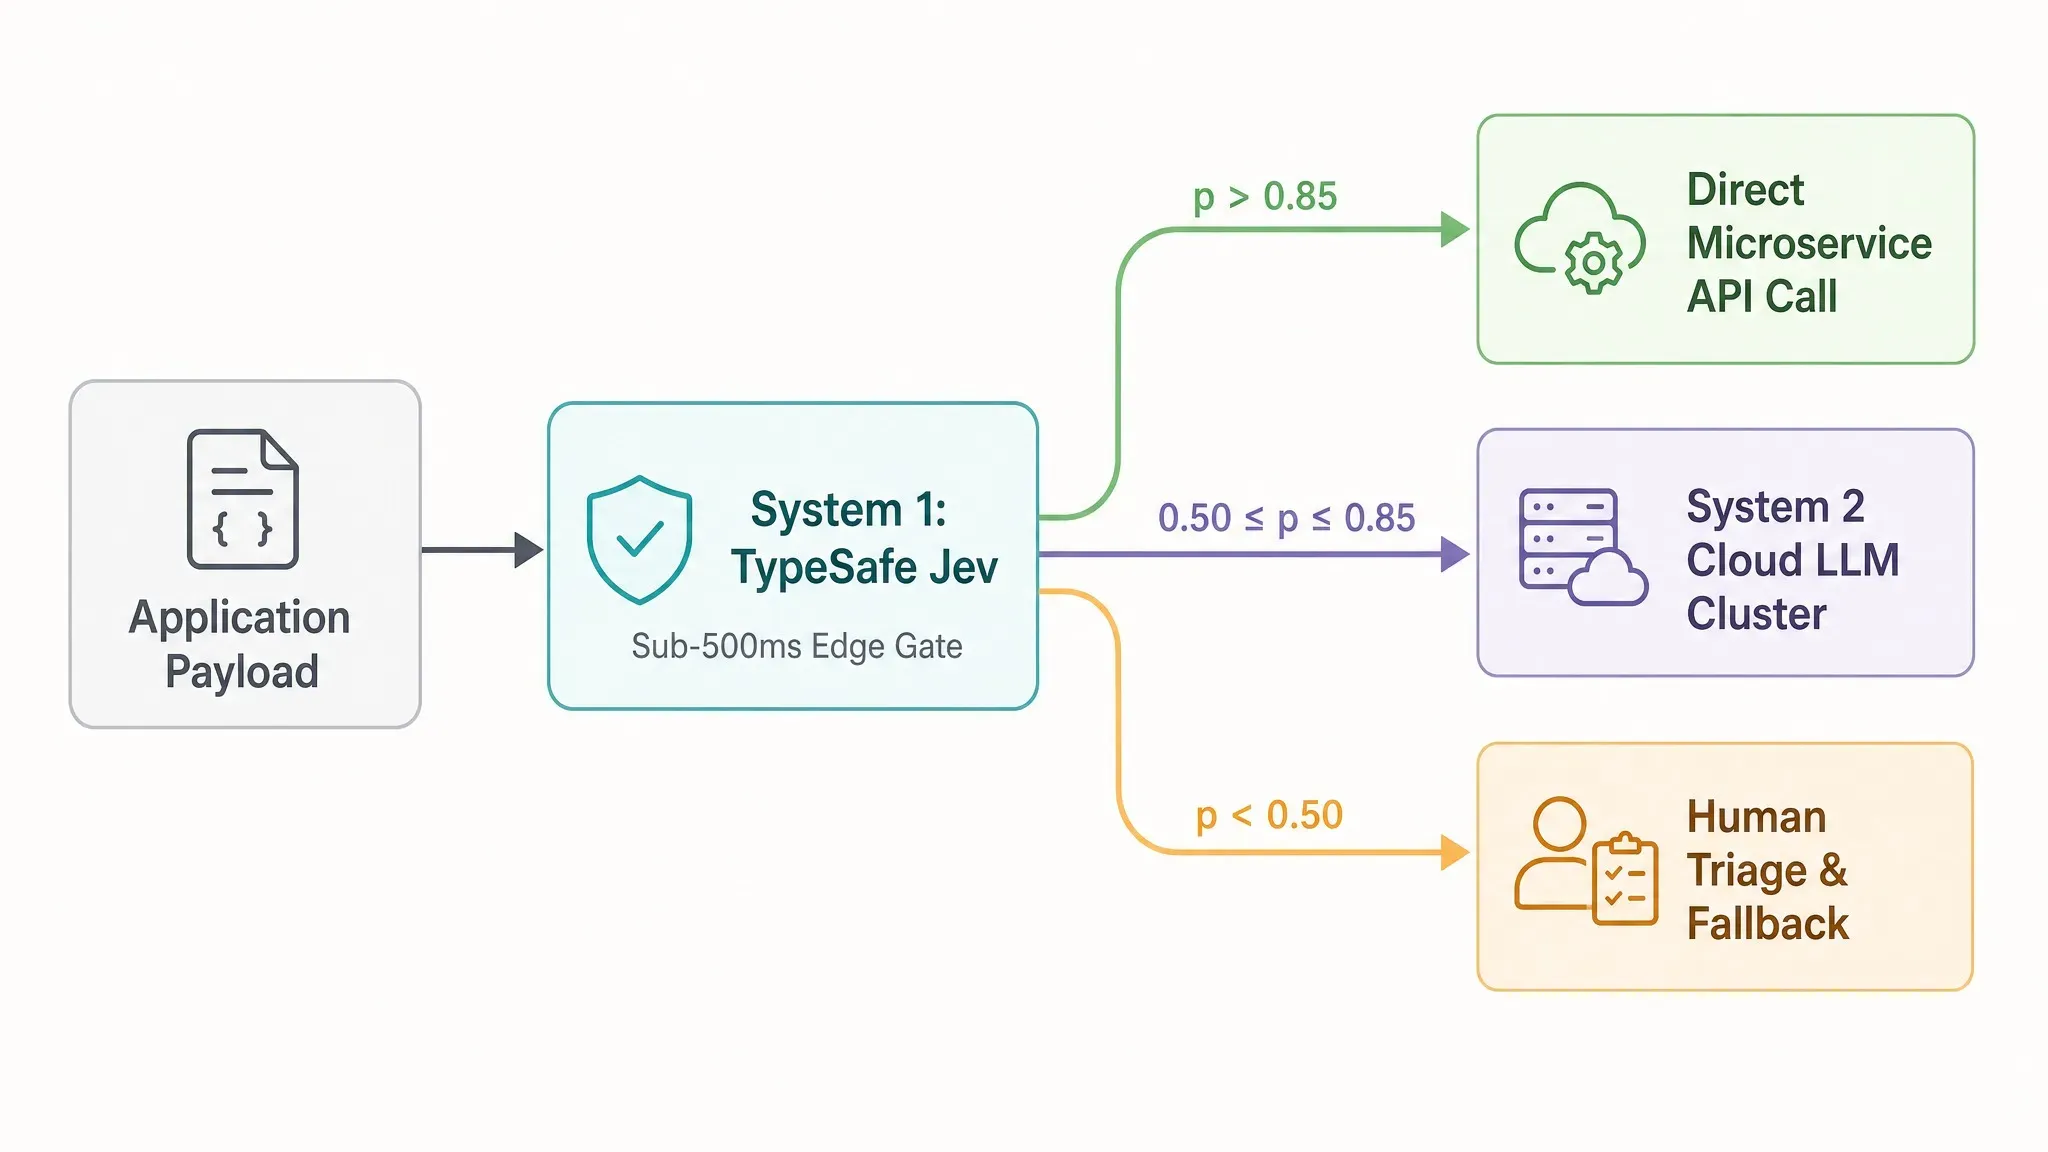
Ces distributions de probabilités calibrées permettent aux ingénieurs de configurer des portes de décision basées sur des seuils, par exemple dans un paramètre deproduction typique :
p > 0,85** (Exécution en voie rapide) :** Exécuter immédiatement dans le chemin haute vitesse, en contournant complètement les endpoints LLM lents.0,50 ≤ p ≤ 0,85** (Escalade système) :** envoyer les sorties intermédiaires à un LLM de raisonnement pour traiter les cas limites ambigus.p < 0,50** (Tri de fallback) :** Les paramètres de sécurité sont activés ou la requête est envoyéee à une file d'attente de revue humaine.
Pour les cas limites ambigus 0,50 ≤ p 0,85, le routage à contrôle de confiance redirige la charge utile vers une couche de raisonnement d'entreprise. Le recours à GPT 5.6 Terra sur Atlas Cloud offre une cible de type de secours optimale pour ces demandes escalades, en exploitant ses 1 050 K de contexte et une tarification de tokens efficace à 2 $/12 $ pour mener une analyse approfondie sans gonflement des coûts d'infrastructure de microservices.
Les logprobs bruts des LLM autorégressifs sont notoirement mal calibrés et se décalntent chaque fois que les promoms système changent. En intégrant le RLCD directement dans le processus de entraînement de base, Jev rend le routage à ruine de confiance prêt pour la production, permettant aux équipes de logiciels d'automatiser en toute sécurité des pipelines à haut volume tout en isolant les cas limites.
Patterns de conception pour la production : des pipelines IA à haute vitesse en pratique
Les agents d'IAR de production plantent fréquemment quand un LLM Stephen invente une signature de fonction inexistante comme get_user_billing_v2() ou passe des types de paramètres invalides à un endpoint d'API interne. Enchâner plusieurs contrôles conditionnels à travers des endpoints de complétion de chat standard augmente la latence systtotale, provoquant des time-out dans les microservices orientés client.
Modèles d'architecture de base pour les microservices à fort volume
L'intégration de moteurs de décision de moinsd'une seconde dans les pipelines d'IA de production permet aux équipes backend de remplacer les boucles de prompts imprévisibles par des pattern de conception déterministes :
- Sélection d'outils agentiques : Lors du choix d'outils dans des flux de workflow automatisés, Jev évalue les signatures de fonctions disponibles par rapport à l'état en cours de l'application. Comme les fonctions candidates sont fournies comme choix explicites dans le schéma de la requête, Jev ne peut pas renvoyer de noms de fonctions non définis, éliminant les échecs silencieux lors de la sélection d'outils agentiques. Ce filtrage rforward garantit des payloads de schéma valides avant de passer des instructions aux pipelines agent autonomes de coder LLM.
- Évaluation parallèle multi-questions : Les endpoints de chat standard obligent les applications à évaluer les questions conditionnelles séquentiellement, multipliant le latency totale par le nombre de contrôles effectués. Jev permet l'évaluation parallèle de multiples questions en prenant en compte des douzaines de questions de de schéma sur un seul payload d'états en une seule passe parallèle. L'exécution de quinze contrôles de classification discrets prend la même fenêtre de 100 ms que l'exécution d'un - un seul.
- Automatisation de la classification des tickets : Pour microservices à fort volume traitant des tickets clients entrants, Jev analyse le sentiment client, oriente la priorité technique et vérifie éligibilité au remboursement simultanément. Mettre en place l'automatisation de la classification des tickets avec des temps de réponse en dessous de la seconde évite les surcharges de file d'attente lors des pointes de trafic soudaines.
Implémentation des nœuds de décision Système Un via SDK
Développeurs les nœuds de décision faibles latents en intégrant le SDK officiel typesafe-sdk - dans les microservices existants. Le la charge utile d'exécution soumet l'état de l'application ainsi que les primitives de schéma pré-déclarées directement à l'endpoint https://api.typesafe.ai/v1/systemone.
plaintext1import { TypeSafe } from "typesafe-sdk"; 2 3const client = new TypeSafe({ apiKey: process.env.TYPESAFE_API_KEY }); 4 5const result = await client.systemone.evaluate({ 6 state: "Saisie du client : 'J'ai été débité de 49 $ sur la facture #1092 et j'ai besoin d'un remboursement immédiatement.'", 7 questions: [ 8 { 9 id: "routing_category", 10 type: "choice", 11 options: ["billing_dispute", "account_access", "feature_request"] 12 }, 13 { 14 id: "is_urgent", 15 type: "noul" 16 } 17 ] 18});
Les configurations classiques d'appels d'outils re-tokénisent l'ensemble du avertissement de contexte pour chaque évaluation de fonction. En séparant la représentation de l'état de décision des questions décisionnelles, Jev exécute des pipelines multiparallèles de classification dans les systèmes backend sans multiplier les frais de contexte, gonfler les coûts de façon exponentielle ou perdre les garant de latence P95.
Limites connues de TypeSafe Jev et compromis architecturaux (ce que Jev ne peut pas faire)
Déployer un modèle de décision non autorégressif en s'attendant à ce qu'il écrive une réponse e-mail polie ou coconner les lignes d'une facture commence évidemment casser le de production. Les équipes d'ingénierie qui tentent de remplacer complètement les LLM généralistes par des modèles Système Un se heurtent rapidement à des limites architecturales.
Analyse des limites structurelles3
Il est essentiel de comprendre les modes de défaillance spécifiques de Jev avant de l'intégrer dans les micropipelines de travail. Sa architecture à passe unique impose des limites strictes dans plusieurs tâches de base :
- Génération de texte ouvert : Jev produit zéro texte ou total. Il ne peut pas écrire d'articles, résumer des documents ou fournir des explications en langage naturel pour ses choix.
- Limites de moralemulti-étapes : Le architecture évalue les représentations d'états immédiates. Les chaînes logiques complexes et séquentielles ou un raisonnement multi-étapes nécessitent de déléguer ces tâches à des LLM autorégressifs de classiques.
- Limites arithmétiques : Jev ne peut pas effectuer de calculs mathématiques ni compter de manière fiable des éléments dans le contexte. Ces tâches arithmétiques doivent rester dans le code backend standard.
- Interprétation littérale des critères : Le modèle suit les règles de prompt à la lettre, sans déduire la logique métier non explicitée. Des schémas d'options ambigus produisent des cartouchs de probabilité inattendus.
- Diminution après contexte sur de gros volumes de données : Le transmettre des journaux massifs non structurés crée une "pourriture du contexte", affectant la précision du évaluation. Filtrer le bruit dans les champs d'état intro avant les envois reste essentiel.
Mapping architectural : Capacités du Système Un vs Système Deux
| Tâche opérationnelle | TypeSafe Jev Système Un (System One) | LLM autorégressif (System Two) | | Classification classification | Native (moins de 500 ms) | Lent (texte séquentiel) | | Synthèse et rédaction de textes | Impossible (aucune boucle de décodage) | Native (génération de texte ouverte)| | Calculatif mathématique | Non pris en entrée (limites arithmés) |Variable (exécution de code nécessaire)| | Résistance au bruit | Sujet à la pourriture du contexte dans grandes zones | Meilleure résilience fenêtre contexte |
Considérer Jev comme un nœud de décision sous la seconde plutôt que comme moteur de raisonnement universel garantit une conception système appropriée de des microservices de production.
Infrastructure cloud futur : Orchestration de nœuds de décision rapides
Routage demande entrante directement vers un modèle de raisonnement de 70 milliards de paramètres est extrêmement coûteux en calculs de calculs de et provoque des attentes de plusieurs secondes pour des contrôles de base, et le routage des charges techniques. Des plates.
Vers une architecture IA hybride
Environnements adoptent un changement : de endpoints LLM monolithiques vers une architecture IA hybride découplée. Dans ce nouveau modèle, les orchestrateurs de cloud placent des nœuds de décision rapides à la limite offrant la possibilité d'évaluer immédiatement les requêtes entrantes.
En les edge AI routage, vérification des schémas et scoring-de-confiance en moins de 500 ms, les nœuds de décision rapides filtrent le trafic avant qu'il n'atteigne les clusters de modèles intensifs. Cette topologie optimise l'utilisation des ressourceset sur les trois classiques opérationnels du cloud :
- Limitations de garde et routage en périphérie : Les nœuds de décision rapides filtrent lan, assainissent les entrées et vérifient le conformité au schéma en une seule passe.
- Transfert d'état et orchestration : Les contrôleurs de cloud analysent les scores de confiance, exécuent immédiatement les requêtes très certaines et transmettent les tâches de raisonnement complexes.
- Raisonnement centralisé du système Deux : Les clusters LLM intensifs ne reçoivent que des données pré-filtertées et structurées, uniquement lorsqu'une synthèse multi-tours ougénération ouverte est réellement nécessaire.
Déploie de modèles Système un à l'échelle
Avec l'expansion des leur capacité d'hébergement, l'intégration du déploiement TypeSafe Jev d' dans l'infrastructure d'IA offre un pattern efficace pour les microservice ens de périphérie. L'utilisation de modèles de décision non autorégressifs à proximité des utilisateurs finaux réduit considérablement les temps de trajet aller-retour et réduit les coûts de calculs pour les applications à haut throughput.
Concevoir des pipelines avec des unités de décision dédiées garantit que les réseaux de backend restent réactifs aux charges importantes tout en maintenant les modèles de raisonnement de pointe exclusivement consacrés aux tâches nécessitant des calculs profonds.


