Dernière mise à jour : Wan 3.0 est désormais disponible depuis le 24 août 2026.
Vous avez créé un dossier pour une publicité de 15 secondes. Deux photos d’acteurs. Une vidéo de marque envoyée par le client. Un guide de marque qui n’existe qu’en PDF. Un échantillon vocal de l’acteur que vous voulez vraiment.
Puis vous avez ouvert votre modèle vidéo et il n’a demandé qu’une seule image.
Vous avez donc fait ce que tout le monde fait. Vous avez traduit le dossier en un prompt de 800 mots et croisé les doigts. Le visage a dérivé dans le plan trois. La veste a changé de couleur. La voix était celle de quelqu’un d’autre.
La référence omni de Wan 3.0 est la première fois qu’un modèle vidéo dit : d’accord, donne-moi le dossier. Jusqu’à 20 ressources en un seul appel, couvrant cinq types d’entrée, maintenues ensemble sur une seule prise continue de 30 secondes.
Cet article fait trois choses et laisse le reste de côté. Il détaille ce que sont réellement ces 20 ressources, il utilise les clips générés par Alibaba comme preuve et il vous propose un workflow équivalent que vous pouvez exécuter dès aujourd’hui, car Wan 3.0 est toujours en bêta publique sur le cloud d’Alibaba et n’est pas encore accessible depuis des plateformes tierces.
Points clés
- La référence multimodale de Wan 3.0 accepte jusqu’à 20 ressources en un seul appel, couvrant images, vidéos, audio, documents et pages web en direct, et les maintient cohérentes sur une seule prise de 30 secondes.
- C’est le premier modèle vidéo grand public à traiter un PDF, un diaporama ou une URL comme une entrée créative plutôt que comme quelque chose à reformuler dans un prompt.
- Wan 3.0 est entré en bêta publique le 6 août 2026 sur Alibaba Cloud Model Studio et Qwen Cloud sous le nom
wan3.0-video. Ses poids sont fermés. Quiconque vous dit qu’il est déjà sous Apache 2.0 devine. - Le titre des 20 ressources n’est pas là où il est vraiment en avance. Les modèles de référence vers vidéo que vous pouvez appeler maintenant acceptent déjà plus de 20 ressources. L’écart réside dans les documents et les pages web, pas dans le nombre.
- Vous pouvez tester le format à deux personnages, verrouillé par référence et entièrement vocalisé gratuitement avec le générateur gratuit de sketchs publicitaires IA d’Atlas Cloud : quatre photos de produit en entrée, un sketch parlé de 15 secondes en sortie, sans carte de crédit.
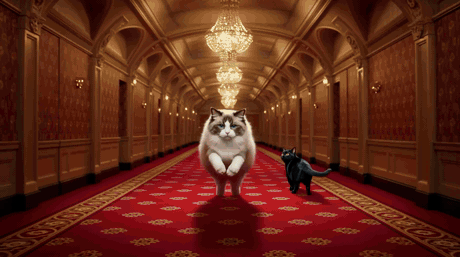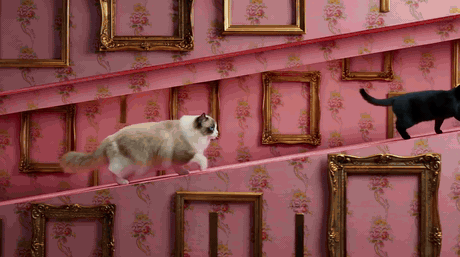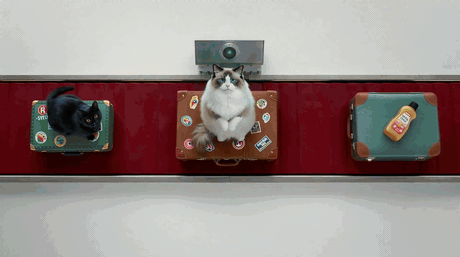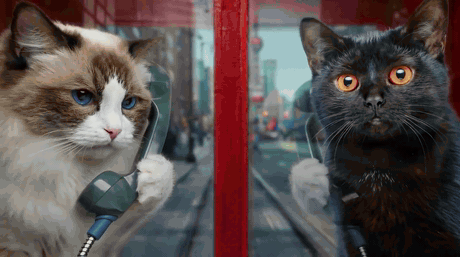
Deux chats poursuivis à travers cinq décors différents par Wan 3.0 sans dérive des personnages. Deux images de référence. Cinq décors totalement différents, d’un couloir d’hôtel à un tambour de machine à laver en passant par une cabine téléphonique rouge. Pas une seule image de dérive. Source : manuel officiel du créateur Wan 3.0 d’Alibaba, Alibaba Wan 3.0 creator handbook, août 2026, qui est également la source de tous les autres clips Wan 3.0 dans cet article.
Pourquoi la vidéo multi-référence échoue et ce que la référence multimodale Wan 3.0 change
Les modèles vidéo n’ont pas de mémoire entre les clips. Chaque génération repart de zéro. C’est tout le problème en une phrase.
Ainsi, dès que votre histoire nécessite plus d’un plan, vous assemblez. Le plan un vous donne un visage que vous aimez. Le plan deux vous donne un cousin de ce visage. Le plan trois change silencieusement la veste de prune à bordeaux, et quand vous vous en rendez compte, vous avez déjà payé pour onze rendus.
La référence d’image unique a aidé, mais elle ne verrouillait qu’une seule chose. Un visage. Elle ne pouvait pas simultanément contenir un visage, une tenue, un accessoire, un lieu et une voix, car il n’y avait qu’un seul emplacement pour cinq tâches.
Il y a deux façons de s’en sortir. Donner plus d’emplacements au modèle, ou l’empêcher de recommencer. Wan 3.0 fait les deux à la fois, et c’est pourquoi les deux fonctionnalités principales n’en font qu’une. Une prise native de 30 secondes signifie qu’il n’y a pas de coupe pour que le personnage dérive. Vingt ressources de référence signifie que chaque élément qui doit rester fixe obtient son propre emplacement dédié au lieu de se battre pour un seul.
Voici à quoi cela ressemble quand rien n’est assemblé. Trente secondes, une caméra continue, un enfant dans un chariot de supermarché qui finit incrusté dans un panneau publicitaire puis en sort par en dessous.
30 secondes complètes en un seul passage, sans coupure, avec la bande sonore générée dans le même passage. Source : manuel officiel du créateur Wan 3.0 d’Alibaba.
Ce que signifient réellement « 20 ressources » dans la référence multimodale Wan 3.0
Vingt est un chiffre d’accroche. Ce qui compte, c’est que les vingt ne sont pas tous du même type. La référence omni de Wan 3.0 couvre cinq types d’entrée, et chacun contrôle un axe différent de la sortie.
Les images contrôlent l’identité. Une fiche personnage, une photo de produit, une vignette de lieu. Wan 3.0 appelle cela une cohérence au niveau du pixel, et dans les exemples d’Alibaba, le verrouillage s’étend au-delà du visage jusqu’à la garde-robe : la robe grise superposée, le gilet de cuir sanglé, la ceinture sombre à la taille survivent tous à un combat au corps à corps de seize secondes sur trois lieux.
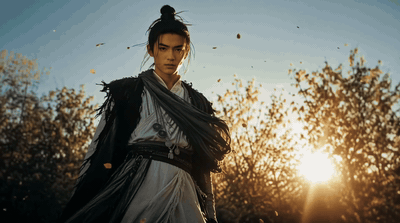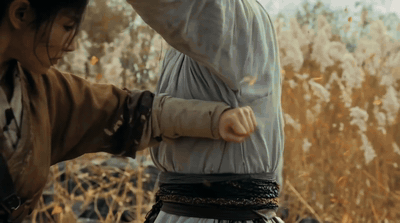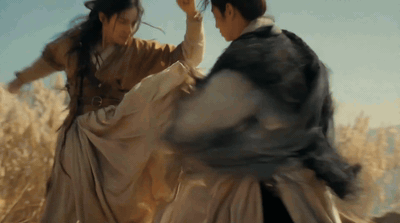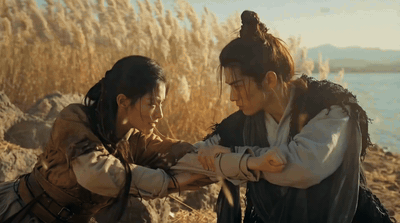
Deux fiches personnages pilotant une scène de combat wuxia avec les détails de costume conservés image par image
Deux fiches personnages plus une vignette de lieu de la roselière. La garde-robe et le décor tiennent à travers chaque lancer. Montré ici sous forme de GIF silencieux ; le fichier livré contient un mix stéréo 44,1 kHz. Source : manuel officiel du créateur Wan 3.0 d’Alibaba.
L’audio contrôle la voix. C’est la partie qui rend « multimodal » plus qu’un argument marketing. Vous attachez un échantillon vocal par personnage, écrivez les répliques dans le prompt, et le dialogue revient dans ce timbre, synchronisé labialement, dans le même passage que l’image. Deux personnes, deux références vocales, une salle de sport.
Deux images de sujets plus deux clips de référence vocale distincts, et le dialogue revient dans ces deux voix. Cela vaut la peine d’activer le son pour celui-ci. Source : manuel officiel du créateur Wan 3.0 d’Alibaba.
La vidéo contrôle le rythme. Une vidéo de référence n’est pas là pour être copiée. Elle est là pour donner son rythme : combien de temps une pause tient, comment une transition se déplace. Dans celui-ci, cinq images clés fournissent les sujets et une vidéo de référence fournit le rythme de retournement horizontal de carte entre eux.
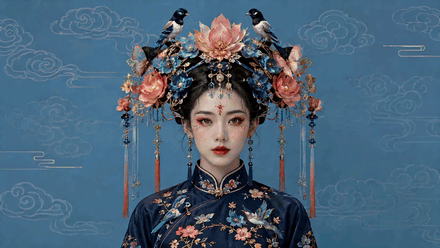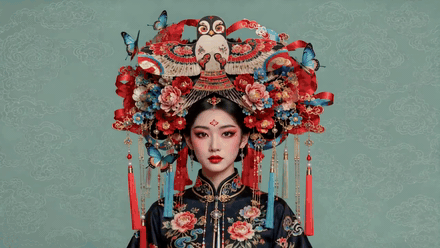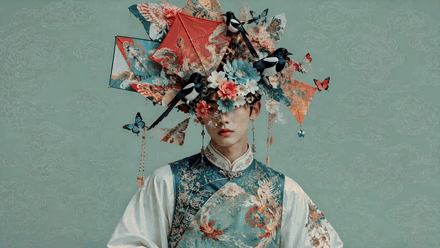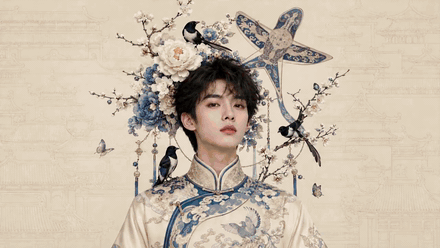
Cinq images clés retournées avec le rythme tiré d’une vidéo de référence. Cinq images clés pour les sujets, une vidéo de référence pour le rythme de retournement. Source : manuel officiel du créateur Wan 3.0 d’Alibaba.
Les documents et pages web contrôlent la structure. C’est la véritable nouveauté. Wan 3.0 accepte les fichiers de documents et les URL en direct comme entrée créative, et les rapports sur la bêta listent .doc, .xls, .ppt, .pdf et .txt parmi les formats acceptés (AlphaSignal, août 2026). La même logique fonctionne déjà avec une image de storyboard : un storyboard en entrée, six plans en sortie, dans l’ordre du storyboard.
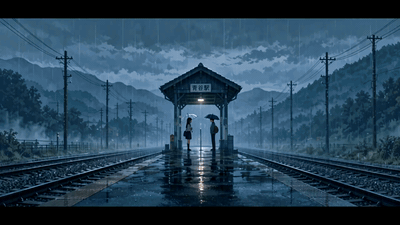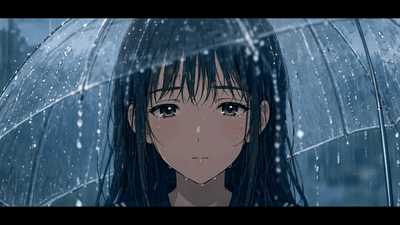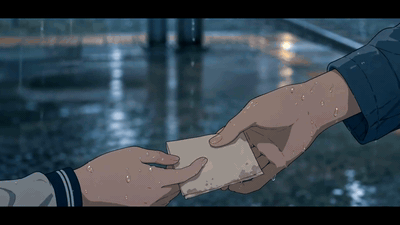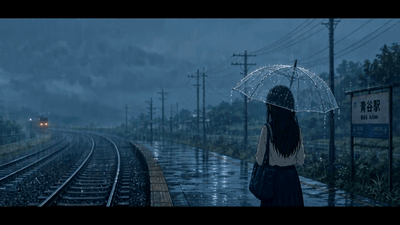
Une seule feuille de storyboard développée en six plans séquentiels sur un quai de gare pluvieux
Une feuille de storyboard comme référence, six plans générés dans son ordre, jusqu’au passage de notes entre les mains dans le plan cinq. Source : manuel officiel du créateur Wan 3.0 d’Alibaba.
Les première et dernière images contrôlent les points de départ et d’arrivée. La plus vieille astuce du livre, toujours prise en charge, toujours le moyen le plus rapide de délimiter un plan.
Voici comment cela se compare à la version que la plupart des gens utilisent réellement aujourd’hui.
| Wan 2.7 Référence vers vidéo | Wan 3.0 Référence omni | |
|---|---|---|
| Ressources de référence | une image par sujet, jusqu’à 3 vidéos, 1 clip vocal | jusqu’à 20 ressources au total |
| Modalités | image, vidéo, audio | image, vidéo, audio, document, page web |
| Durée max, un seul passage | 10 s | 30 s natif, plus durée intelligente |
| Audio dans le même passage | oui | oui |
| Édition et extension vidéo | non exposé | édition par instruction et référence, plus extension |
| Disponibilité | disponible sur API tierces | Alibaba Cloud Model Studio et Qwen Cloud bêta |
Il y a une règle que personne ne met dans la documentation et que tout le monde apprend à ses dépens : une référence, une tâche. Image1 verrouille le visage et la tenue. Vidéo1 ne donne que le mouvement. Audio1 ne donne que le timbre. Dès que vous donnez à une seule ressource deux tâches contradictoires, ou que vous téléchargez une image de référence avec deux personnes, le modèle doit deviner, et deviner est exactement ce que vous essayiez d’empêcher. Le manuel d’Alibaba est également clair à ce sujet : un sujet par image de référence.
Le workflow de référence multimodale Wan 3.0 que vous pouvez exécuter aujourd’hui
Réponse directe d’abord. Wan 3.0 est en bêta publique sur le cloud d’Alibaba, sous l’ID de modèle wan3.0-video (Alibaba Wan, août 2026). Il n’est pas encore arrivé sur les plateformes d’API tierces, y compris Atlas Cloud. Quiconque vous vend un accès API Wan 3.0 en ce moment revend autre chose.
Ce qui est arrivé, c’est la forme du workflow. Pack de référence en entrée, un seul appel, clip fini avec son en sortie. Cela fonctionne aujourd’hui sur les modèles référence vers vidéo que vous pouvez appeler dans un onglet de navigateur, et une fois que vous les alignez tous, le titre des 20 ressources prend un autre sens.
| Modèle | Ressources de référence | Modalités | Durée max | Audio natif | Prix par seconde |
|---|---|---|---|---|---|
| Wan 3.0 (bêta Alibaba, pas sur Atlas) | 20 au total | image, vidéo, audio, document, page web | 30 s | Oui | 0,05 $ à 0,20 $ signalés selon la résolution |
| Wan 2.7 Référence vers vidéo | 1 image par sujet, 3 vidéos, 1 clip vocal | image, vidéo, audio | 10 s | Oui | 0,10 $ |
| Seedance 2.5 Référence vers vidéo | 50 (30 image / 10 vidéo / 10 audio) | image, vidéo, audio | 30 s | Oui | 0,13 $ |
| MiniMax H3 Référence vers vidéo | mélangé, sans limite indiquée | image, vidéo, audio | 15 s | Oui | 0,10 $ |
| Kling Video O3 Pro Référence vers vidéo | 7 images, ou 4 images + 1 vidéo | image, vidéo | 15 s | Oui | 0,10 $ |
| Vidu Q3-Mix Référence vers vidéo | 4 images | image | 16 s | Oui | 0,11 $ |
| Veo 3.1 Référence vers vidéo | 3 images | image | 8 s | Optionnel | 0,20 $ |
Les prix sont les tarifs Atlas Cloud d’août 2026. Les chiffres de Wan 3.0 sont ceux rapportés pour la bêta Alibaba Cloud, pas un tarif Atlas, et Alibaba n’a pas encore publié de page de prix publique pour le modèle, donc considérez cette ligne comme provisoire.
Lisez ce tableau deux fois et la vraie histoire apparaît. Le titre des 20 ressources n’est pas là où Wan 3.0 gagne, car Seedance 2.5 en prend déjà 50 et atteint les 30 secondes. Ce que rien d’autre sur cette liste ne prend, c’est un PDF.
Pour la démonstration ci-dessous, la démo tourne sur Wan 2.7 Référence vers vidéo, car sa forme d’entrée est la plus proche parente de la référence omni : plusieurs images de sujets, une vidéo de référence optionnelle et un clip vocal, tous mappés aux étiquettes character1 et character2 dans le prompt. Trois modèles, un onglet de navigateur, pas d’installation locale.
Pour une exécution hébergée actuelle, ouvrez Wan 3.0 sur Atlas Cloud et testez un prompt comme celui ci-dessous avant de publier le workflow.
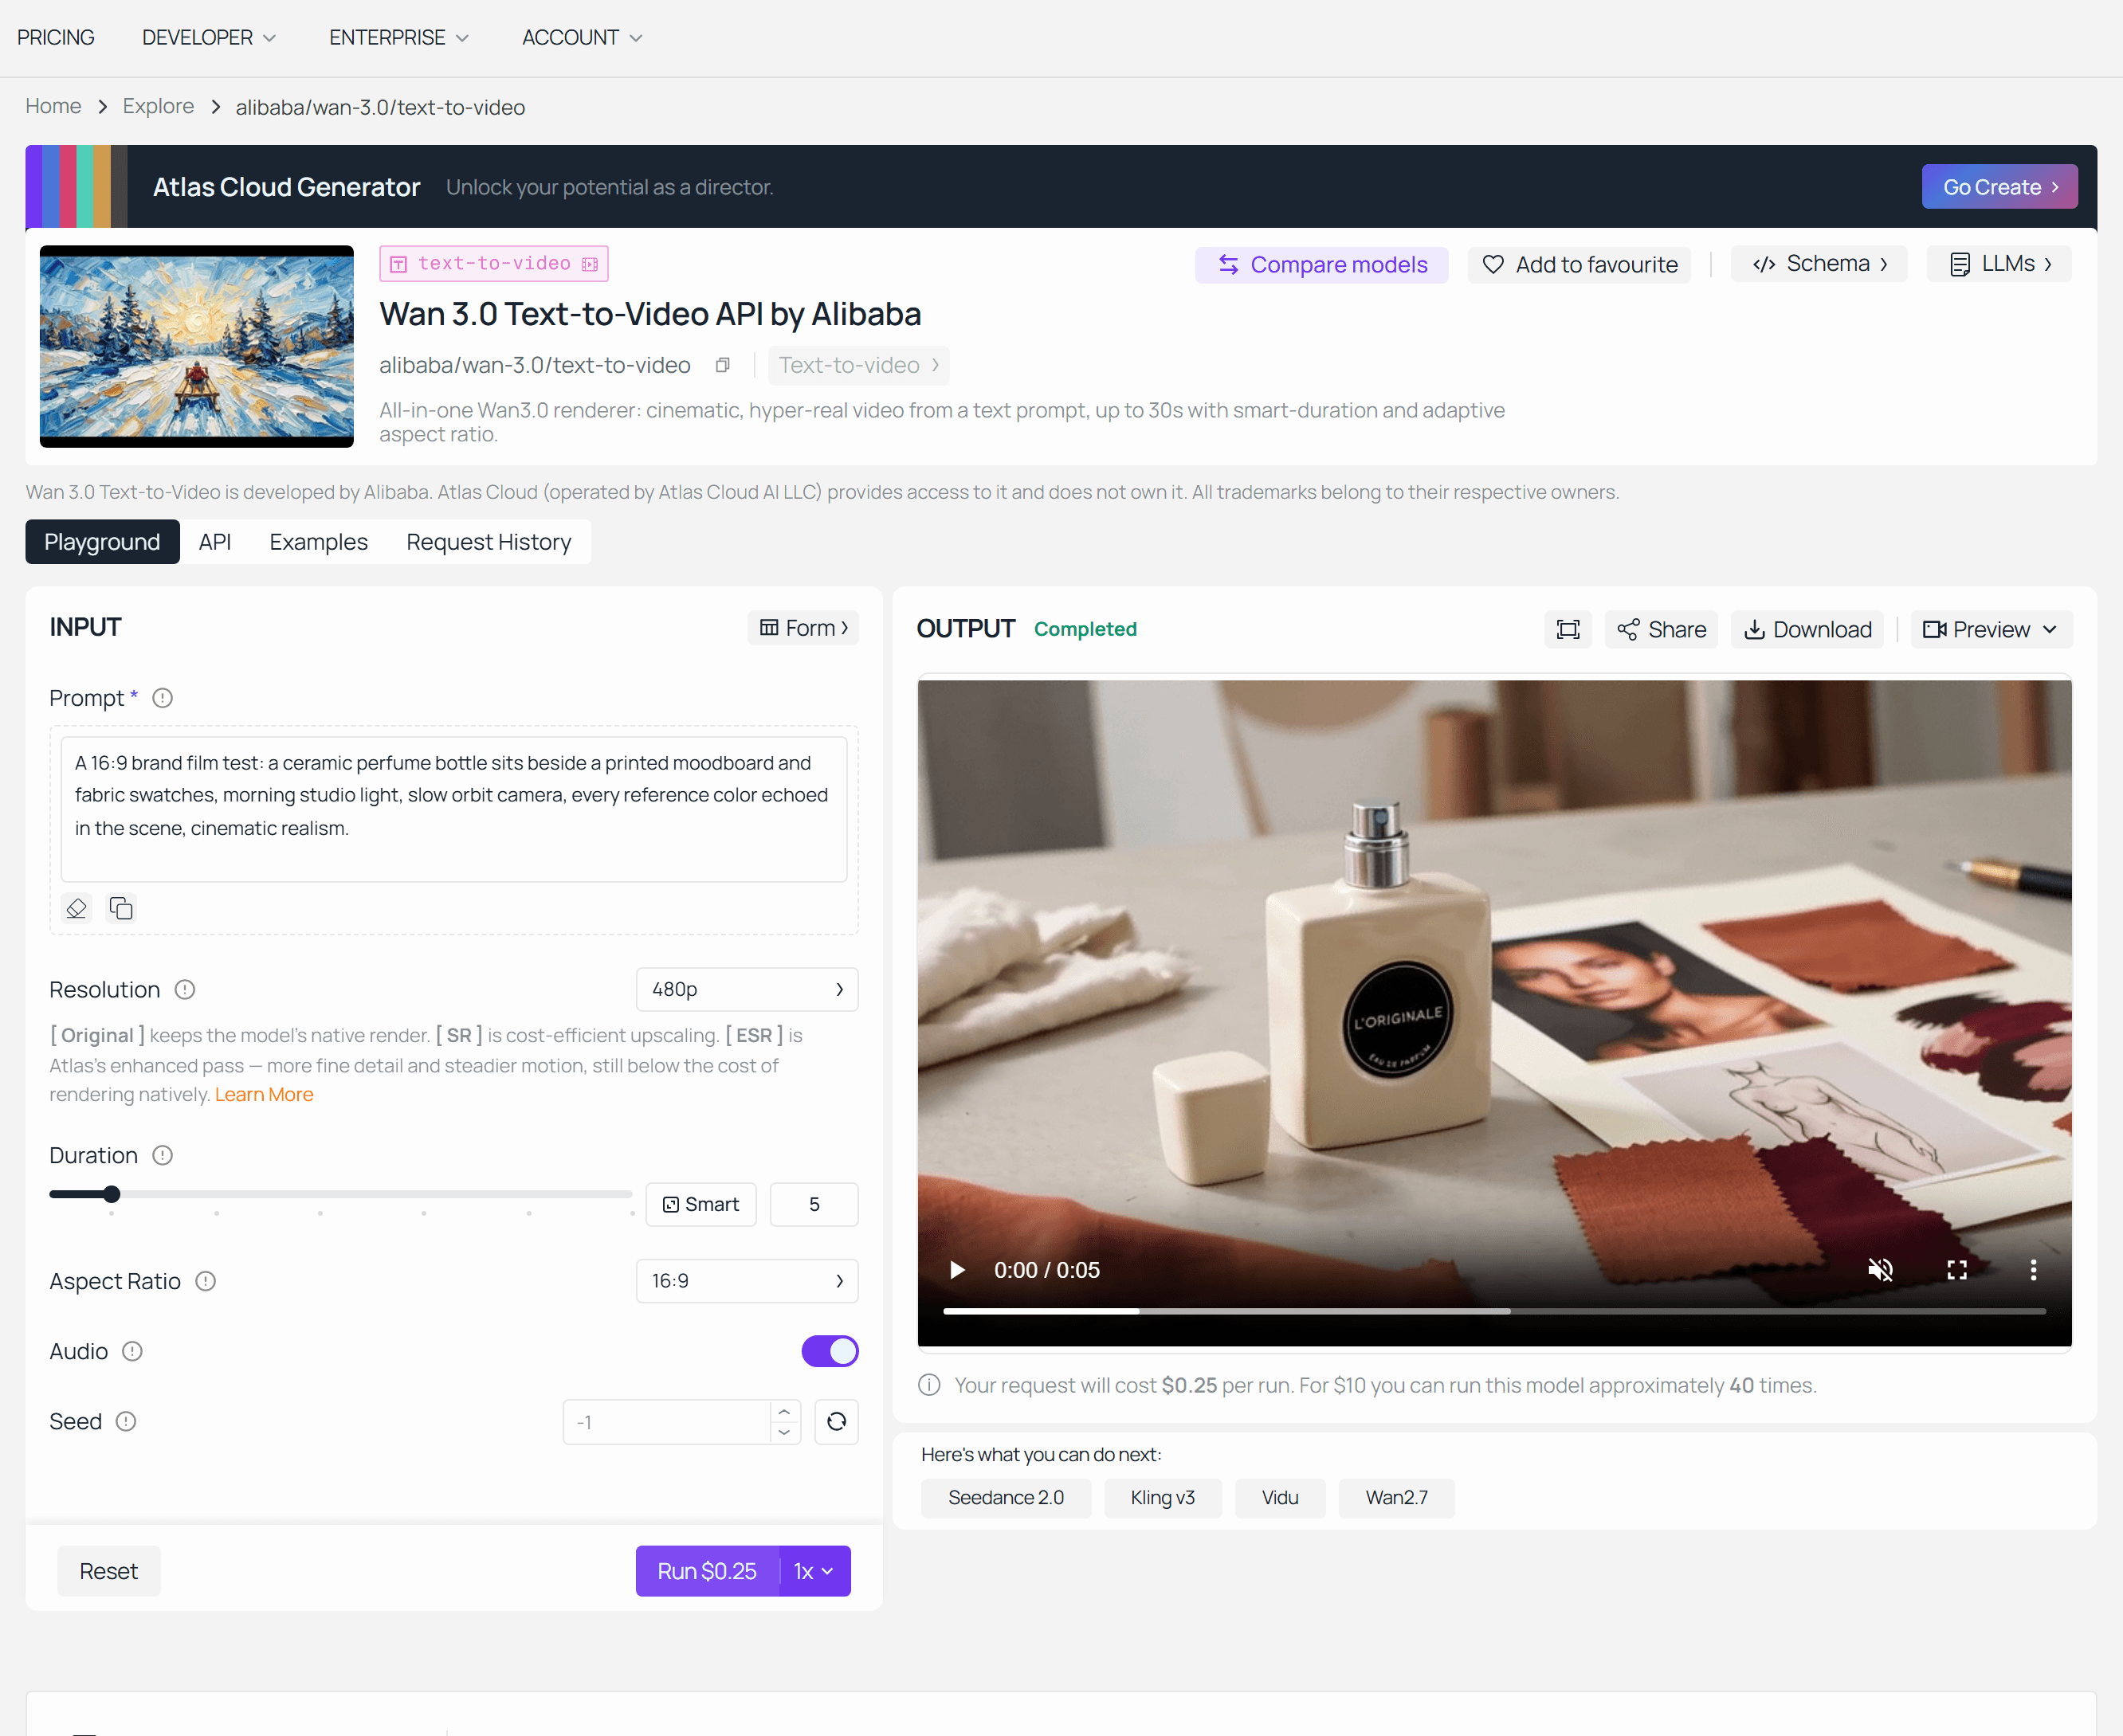
Capture d’écran du résultat prompt Wan 3.0 : transfert de marque avec 20 références.
Construisez-le vous-même : une scène de référence multimodale en quatre étapes
La scène : un comptoir de réception d’hôtel pastel. Un concierge imperturbable. Un voyageur tenant un chat ragdoll. Le concierge regarde droit dans l’objectif et dit « Le chat a une réservation. Pas vous. »
Deux images plus un clip vocal, soit trois ressources de référence sur deux modalités. C’est la construction la plus petite qui soit honnêtement multimodale plutôt que simplement multi-image.
Étape 1. Générer l’image de référence 1, le sujet à verrouiller
Les images de référence ont trois tâches et seulement trois : un seul sujet, face à la caméra, fond propre. Tout le reste est décoration. Utilisez GPT Image 2 avec quality à high, size 16:9, n=1.
Plain1Portrait en pied en studio d'un concierge d'hôtel d'âge moyen avec une expression impassible, debout au centre exact contre un mur plat rose poussière. Il porte un uniforme de groom violet prune à double boutonnage avec passepoil doré et boutons en laiton, une petite calotte ronde, et une fine moustache. Cadrage parfaitement symétrique, lumière frontale douce et uniforme, pas d'ombre portée sur le mur, grain de film 35 mm, palette pastel atténuée. Un seul sujet, pas d'autres personnes, pas de texte, pas de logo, pas d'accessoires dans le cadre.
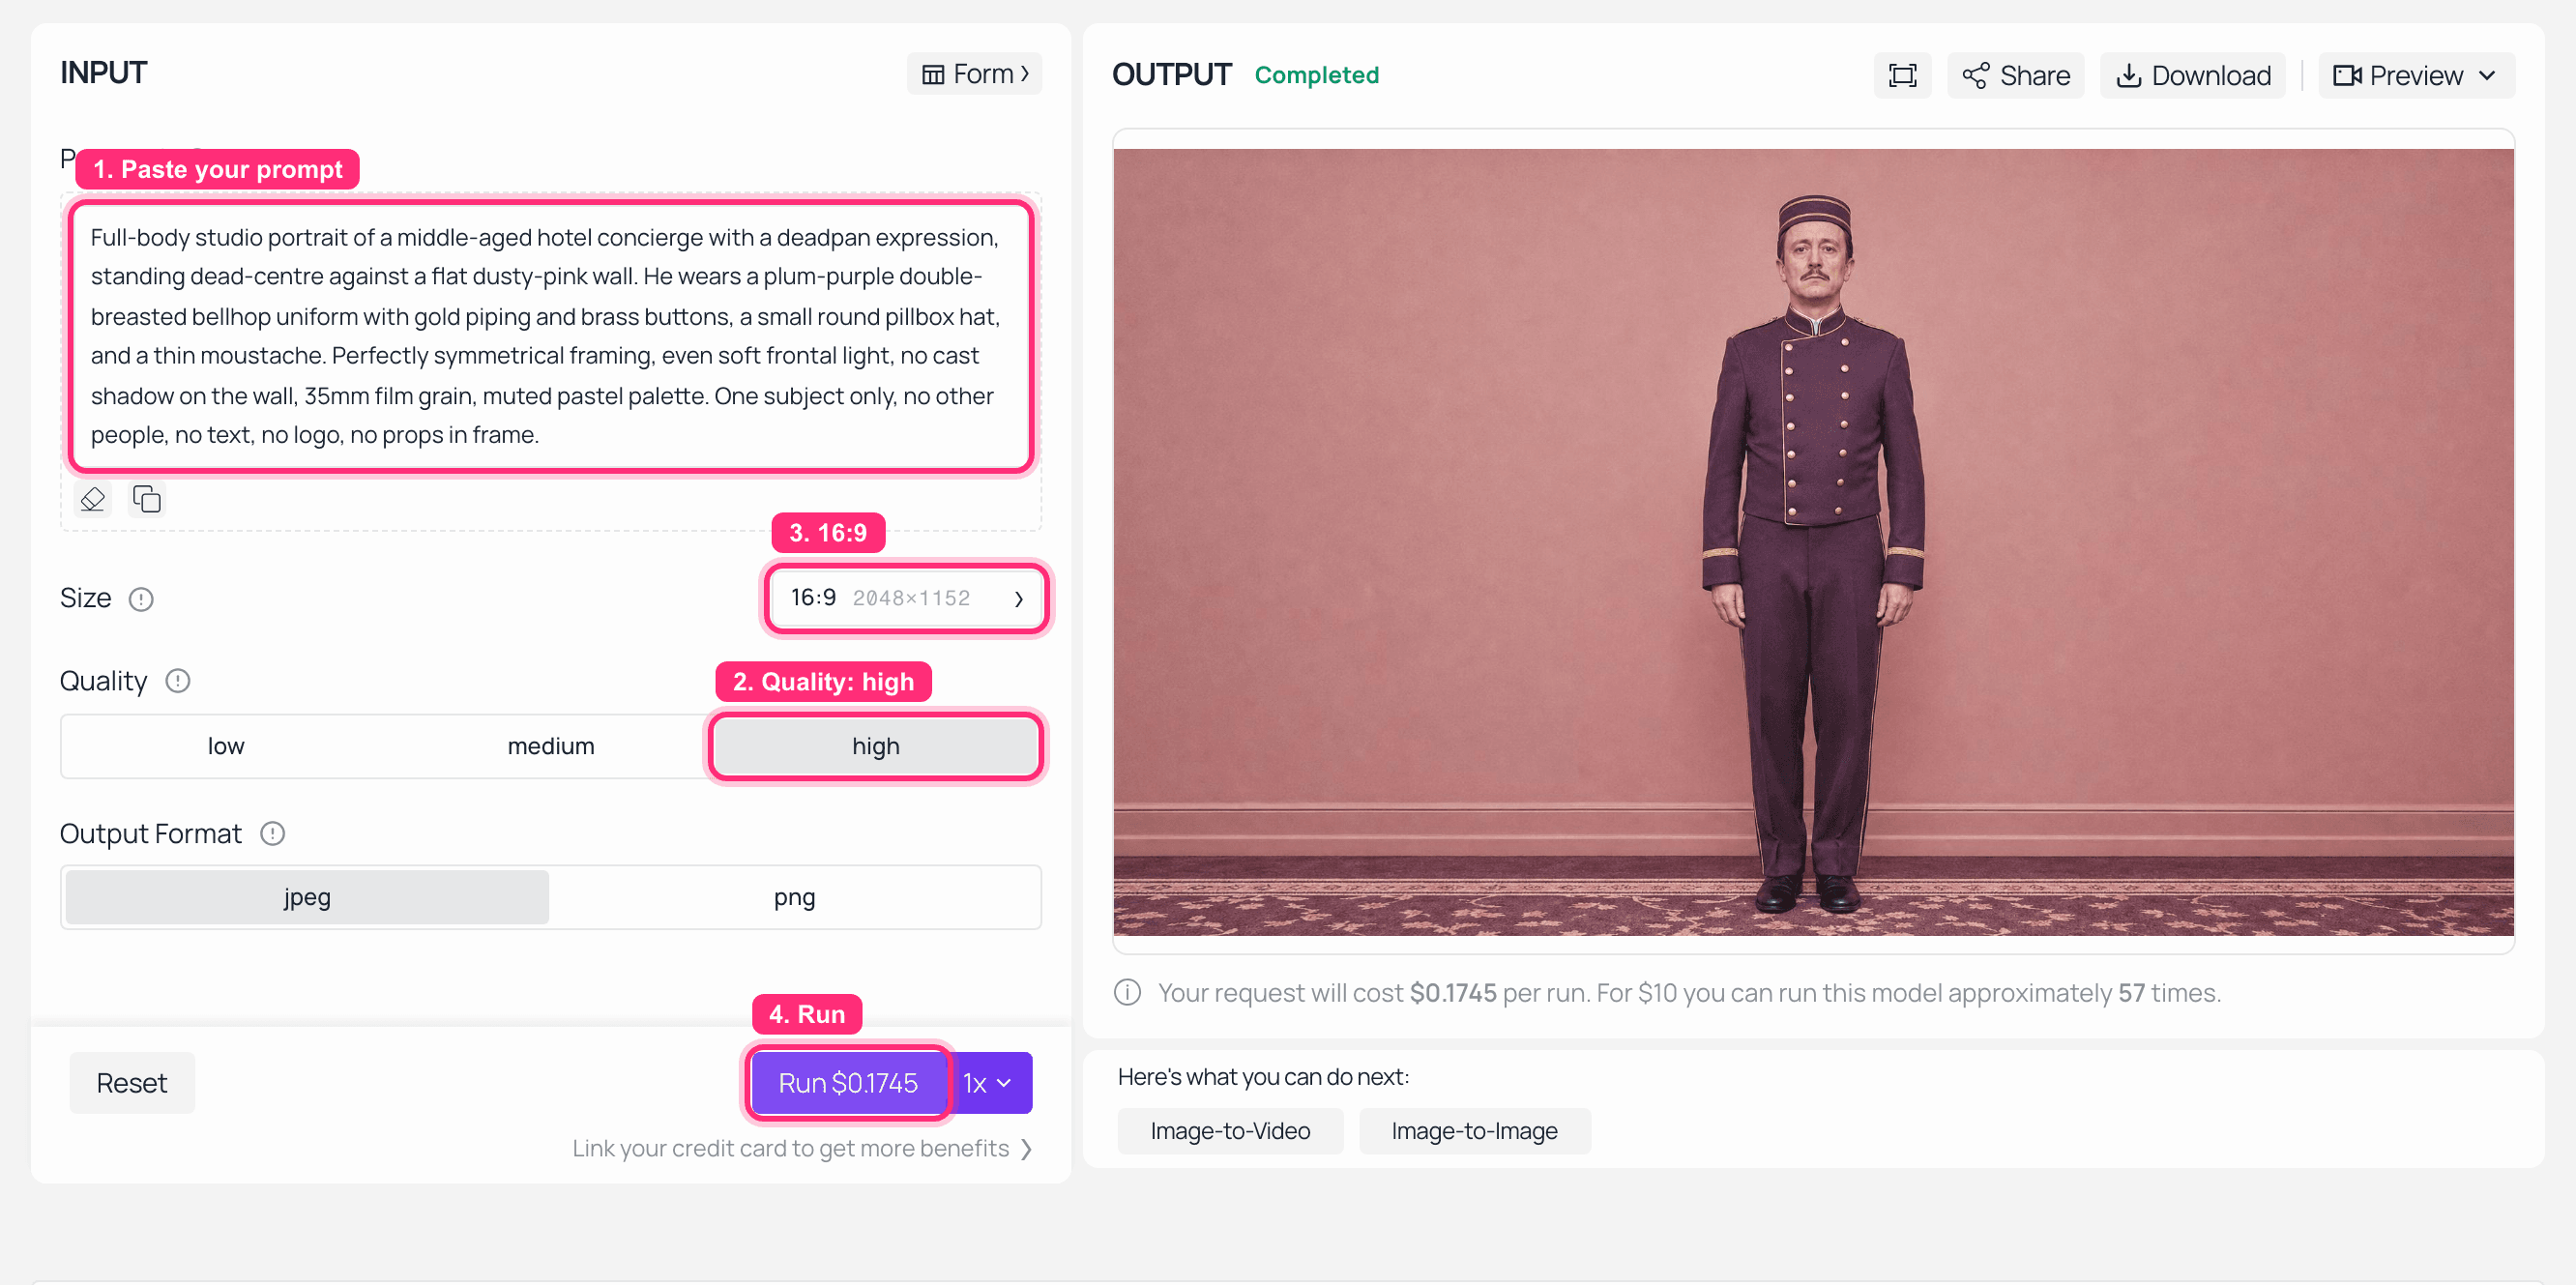
Aire de jeu GPT Image 2 sur Atlas Cloud avec le portrait du concierge de référence rendu dans le panneau de sortie
GPT Image 2 sur Atlas Cloud : qualité haute, 16:9, un sujet, fond plat. C'est le fichier qui deviendra character1.
Étape 2. Générer l’image de référence 2, le deuxième sujet verrouillé
Même modèle, mêmes paramètres. Le contraste de couleur entre les deux personnages est délibéré, car il donne au modèle un moyen facile de les distinguer lorsqu’ils partagent le cadre.
Plain1Portrait en pied en studio d'une jeune femme voyageuse tenant un chat ragdoll fluffy contre sa poitrine, debout au centre exact contre un mur plat jaune moutarde. Elle porte un manteau en laine moutarde, un béret rouge et des lunettes rondes écaille, et tient une petite valise en cuir vintage dans sa main libre. Cadrage parfaitement symétrique, lumière frontale douce et uniforme, pas d'ombre portée sur le mur, grain de film 35 mm, palette pastel atténuée. Un seul sujet, pas d'autres personnes, pas de texte, pas de logo.
Étape 3. Générer la référence vocale, qui est la partie réellement multimodale
Le clip vocal est ce qui transforme ce travail de multi-image en multimodal. L’emplacement audio de Wan 2.7 veut un court échantillon, environ 1 à 10 secondes, donc gardez la ligne courte. Utilisez MiniMax Speech 2.6 HD et choisissez une voix masculine grave, plate et imperturbable.
Plain1Bonsoir. Vous avez une réservation ? Bien sûr. Tout le monde en a une.
Étape 4. Un seul appel, trois références, un clip fini
Maintenant, tout le pack est envoyé ensemble sur Wan 2.7 Référence vers vidéo. Paramètres : resolution: 1080P, ratio: 16:9, duration: 10 (c’est le plafond de ce modèle), prompt_extend: false, seed: -1. Chargez images dans l’ordre : d’abord l’étape 1, pour qu’elle corresponde à character1, puis l’étape 2 en character2, et attachez le fichier de l’étape 3 à audio.
Plain1Plan large symétrique, centré, d'un hall d'hôtel pastel avec un comptoir de réception, murs rose poussière et un porte-clés jaune moutarde derrière. character1 est le concierge debout derrière le comptoir ; character2 est la voyageuse debout devant, tenant toujours son chat ragdoll. La caméra avance lentement sur un axe central parfait et ne penche jamais. character1 regarde droit dans l'objectif et dit d'un ton plat : "Le chat a une réservation. Pas vous." character2 cligne des yeux une fois, tourne lentement la tête vers le chat, puis revient vers le comptoir. Le chat regarde fixement la caméra sans bouger. Grain de film 35 mm, éclairage doux et uniforme, palette pastel atténuée, pas de tremblement de caméra, pas de coupures.
Prompt négatif :
Plain1tremblement caméra portée, coupures brusques, sous-titres, texte à l'écran, filigrane, personnes supplémentaires, mains déformées, morphing de visage, changement de couleur, flou de mouvement
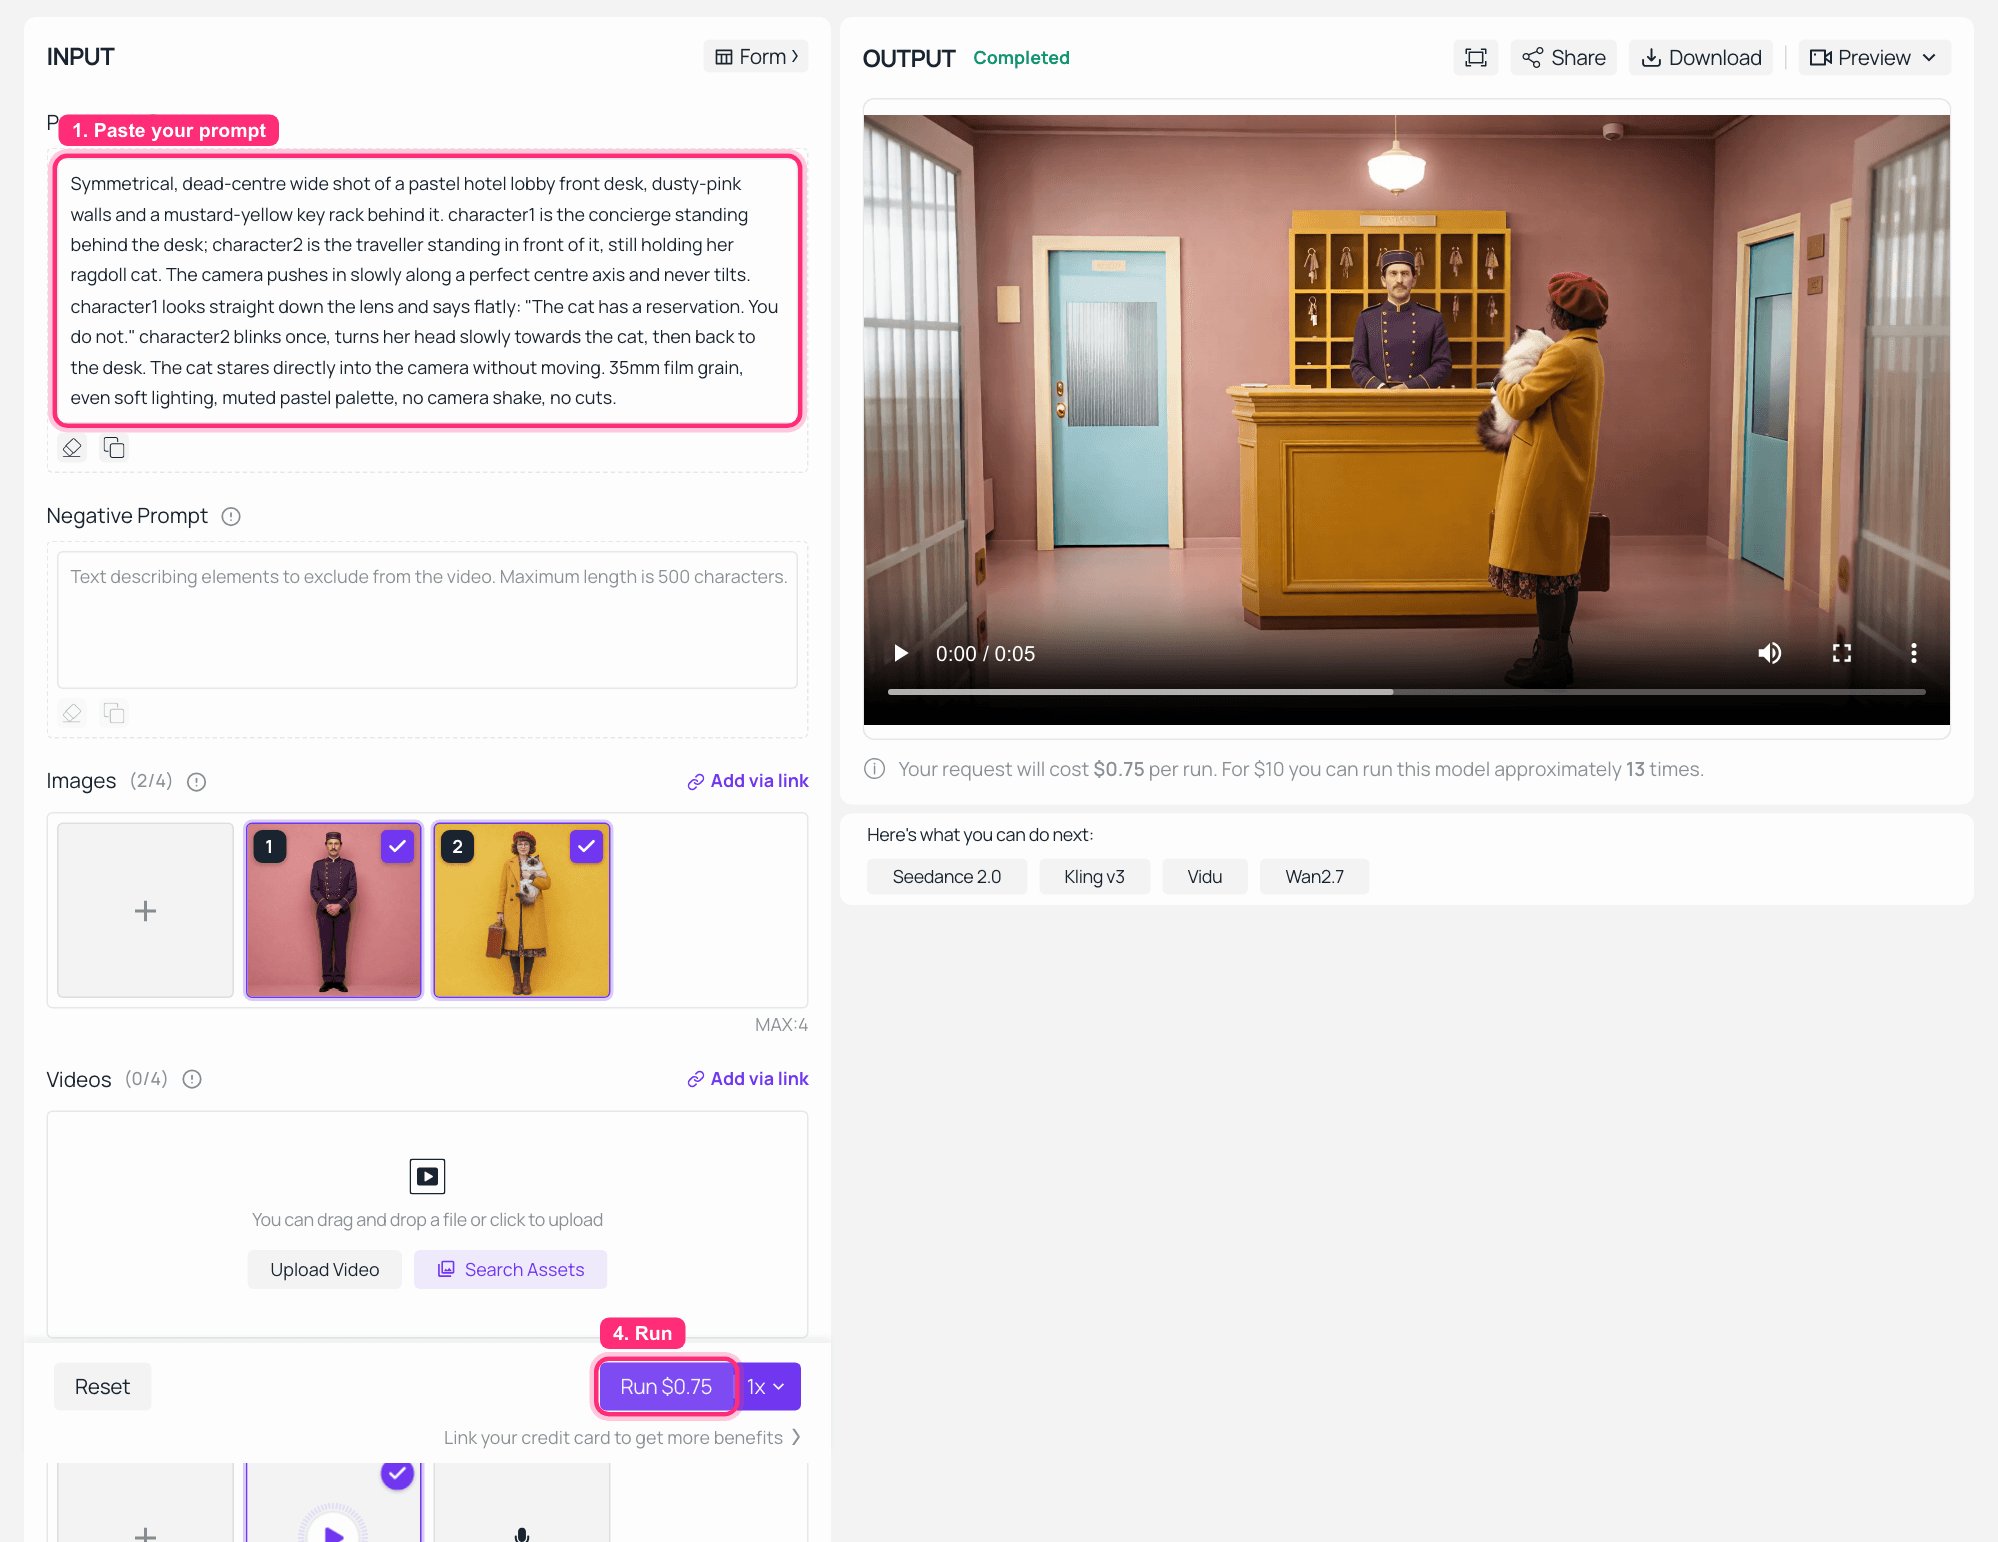
Aire de jeu Wan 2.7 Référence vers vidéo sur Atlas Cloud avec deux images de référence et un fichier audio chargés, et le clip fini dans le panneau de sortie
Wan 2.7 Référence vers vidéo sur Atlas Cloud : deux images de référence et un clip vocal attachés à gauche, la prise finale jouée à droite en 1080P et 16:9. Cette capture a été exécutée avec la durée par défaut du modèle ; réglez-la sur 10 pour la version complète ci-dessous.
Le clip fini. Les deux visages tenus, les deux tenues tenues, et la réplique livrée dans la voix clonée de l’étape 3, donc celui-ci vaut la peine d’être joué avec le son.
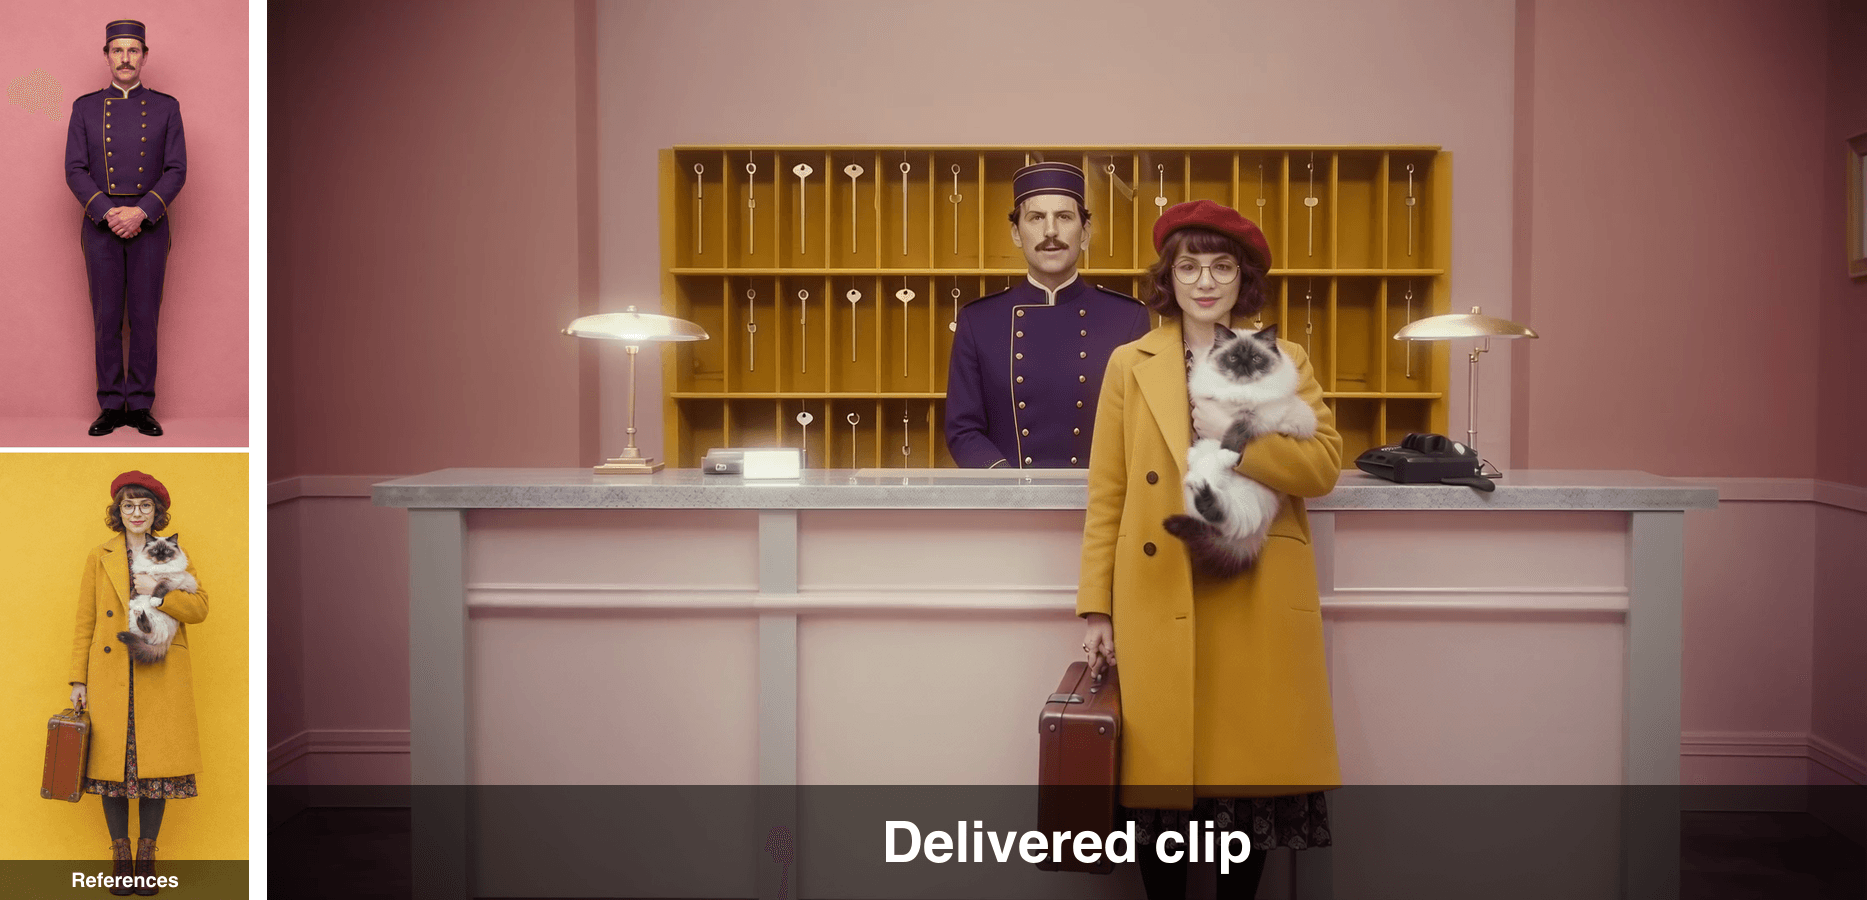
Les deux portraits de référence à côté d’une image du clip fini, montrant les mêmes visages et tenues
Références à gauche, une image du clip livré à droite. Le passepoil de l’uniforme, le béret, les lunettes et le chat survivent tous au voyage.
Variations sur le workflow de référence multimodale Wan 3.0
Poussez-le à 30 secondes. Le même pack de référence fonctionne sur Seedance 2.5 Référence vers vidéo avec duration: 30, ce qui vous donne la longueur promise par Wan 3.0 sans attendre la bêta. Il accepte jusqu’à 30 images de référence, 10 vidéos et 10 clips audio, donc le pack a de la place pour s’agrandir. Écrivez les 20 secondes supplémentaires comme des battements dans le prompt, pas comme des ambiances, sinon le modèle comblera.
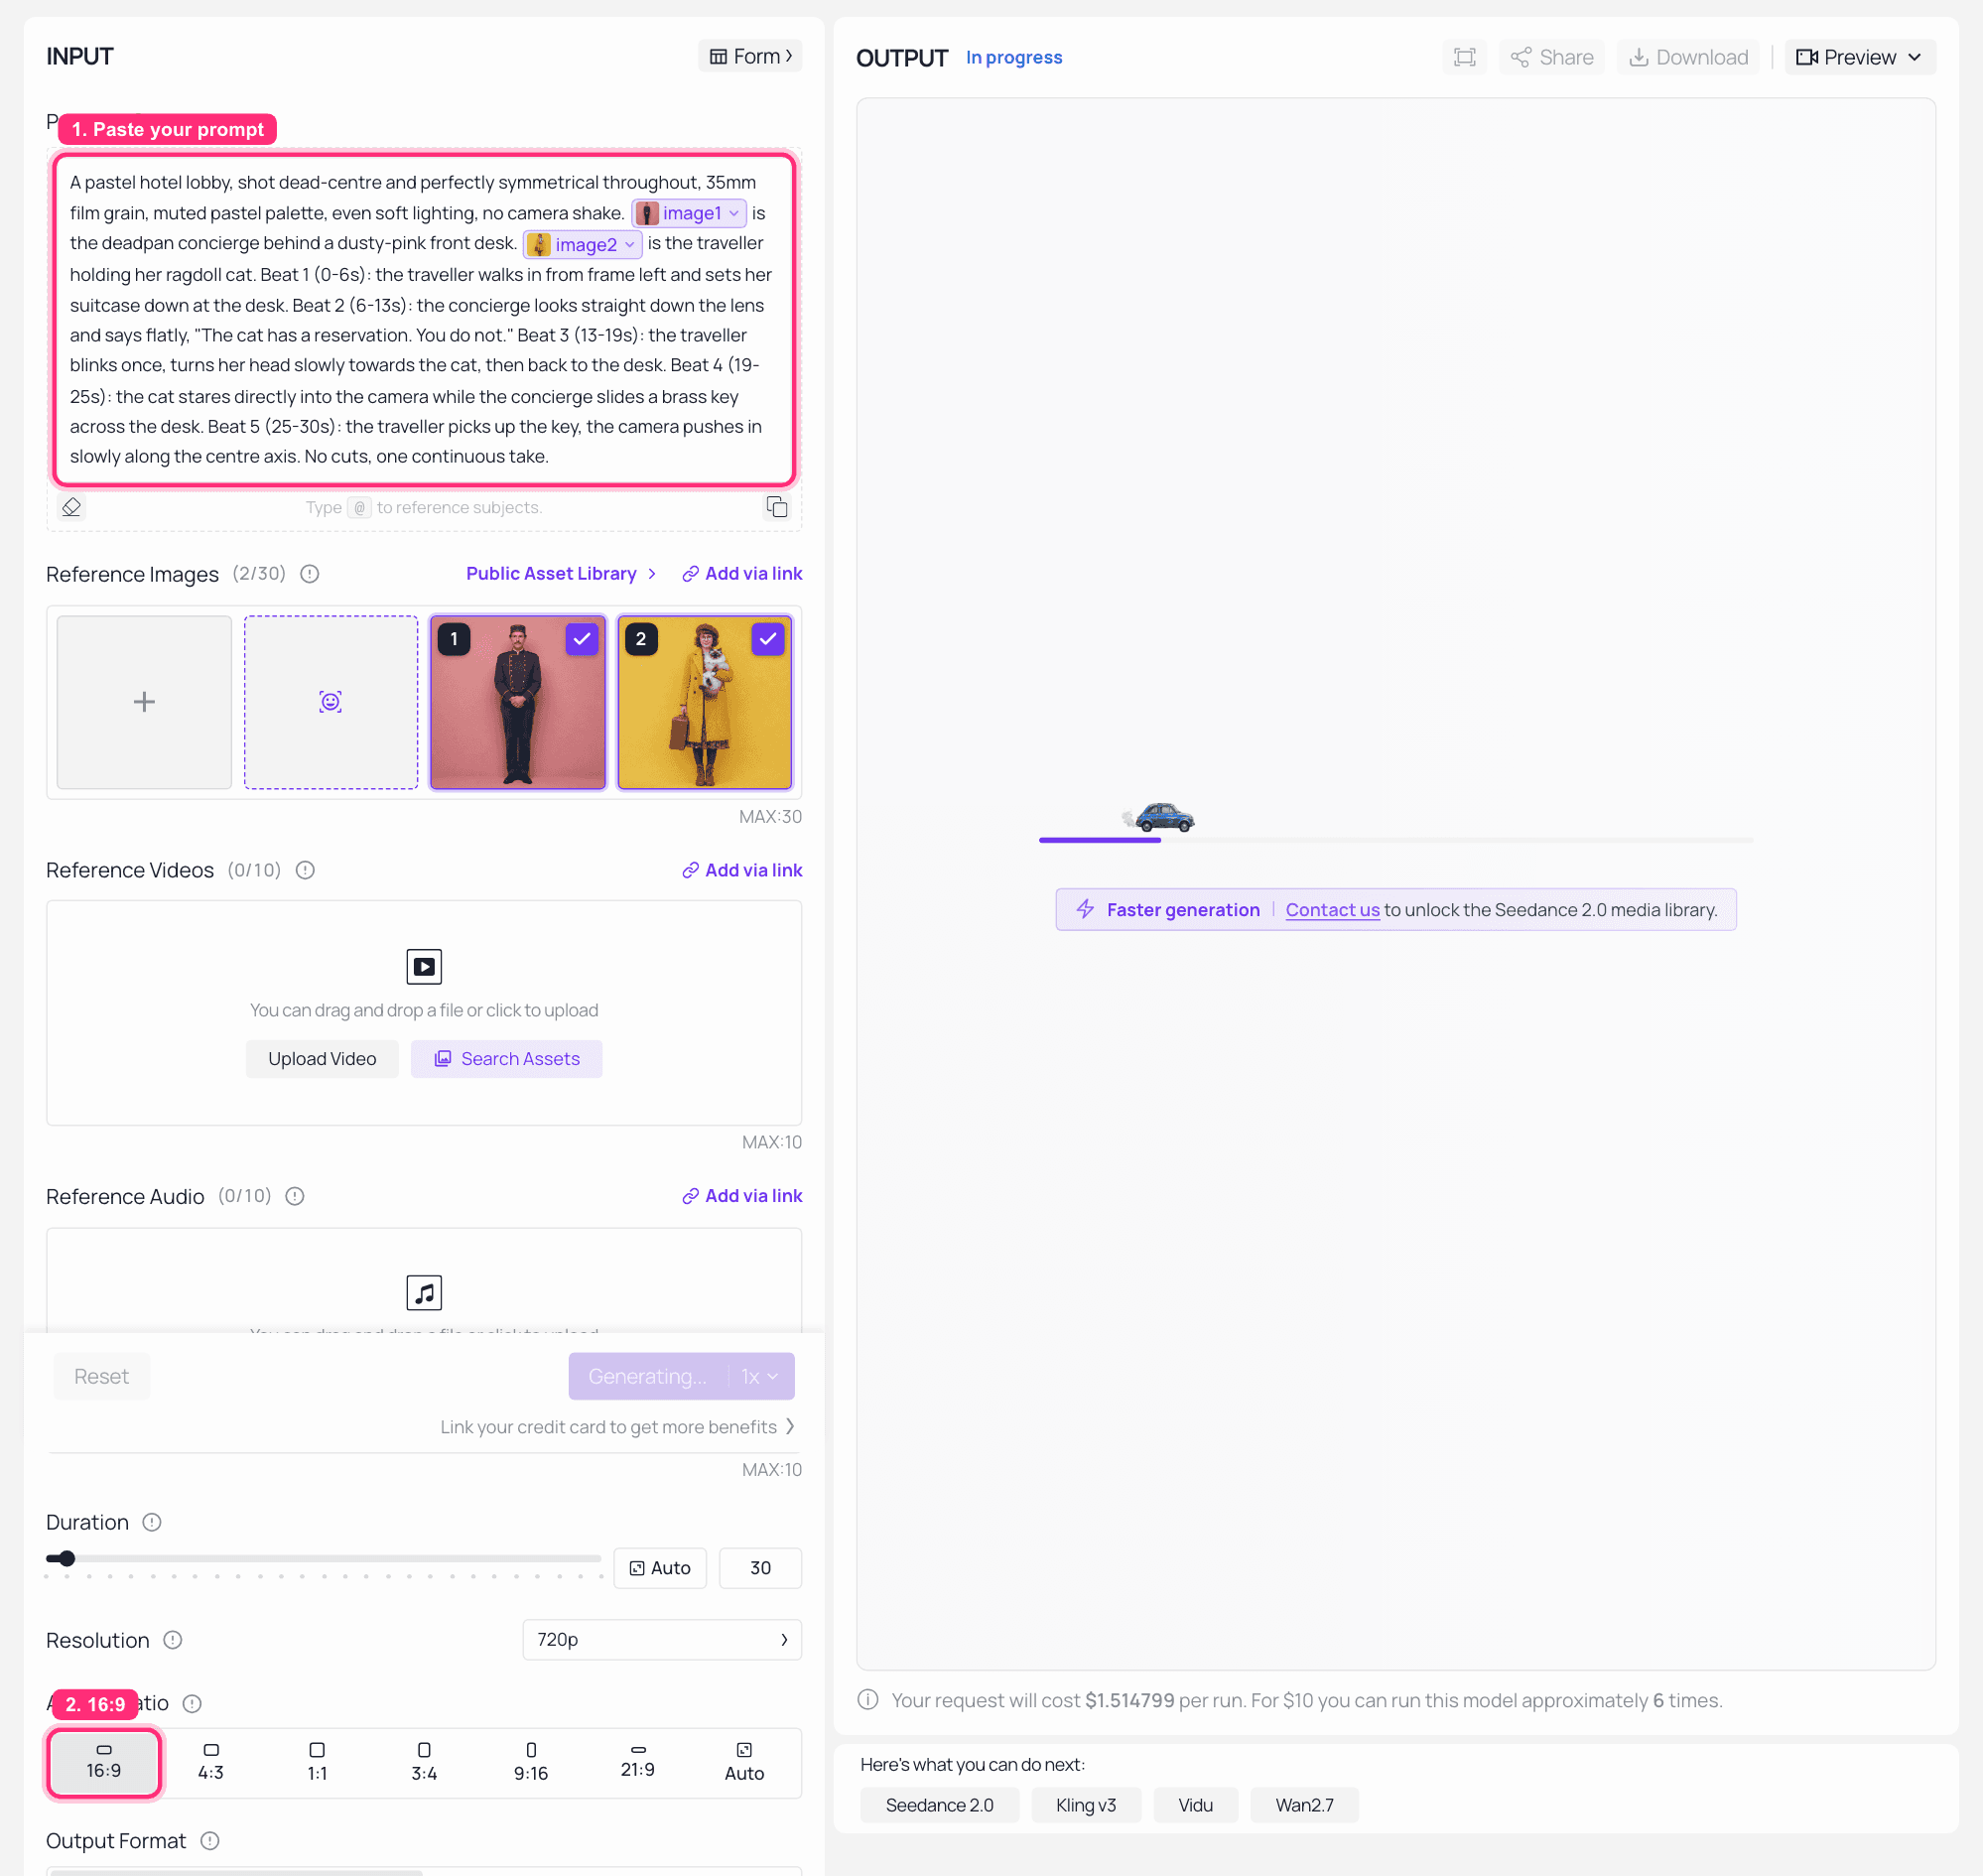
Aire de jeu Seedance 2.5 Référence vers vidéo sur Atlas Cloud avec la durée réglée sur 30 et la longue prise rendue
Seedance 2.5 Référence vers vidéo sur Atlas Cloud avec la durée réglée sur 30 et les deux mêmes portraits de référence attachés, capturé en cours de génération. Notez les tags @image1 et @image2 dans le prompt : c’est ainsi que vous dites à Seedance quelle référence joue quel rôle. Vérifiez le prix indiqué sur le bouton Run avant de vous engager, car il reflète la durée que le travail va réellement soumettre.
La version de 30 secondes de la même scène, même pack de référence, les battements écrits plan par plan.
Ajoutez une vidéo de référence pour le mouvement uniquement. Attachez un clip dont le rythme vous plaît et dites-le explicitement dans le prompt, quelque chose comme « suivre la vidéo de référence pour le rythme de coupe uniquement, ignorer ses sujets et son décor ». C’est l’astuce derrière l’exemple du retournement de carte plus haut.
Corrigez la dérive avec le prompt négatif avant de toucher au positif. Le morphing de visage, le changement de couleur et le tremblement de caméra sont les trois qui ruinent les plans verrouillés par référence, et ils sont généralement moins chers à supprimer qu’à décrire.
Essayez le format de référence multimodale gratuitement
Si vous voulez la forme de cela avant les paramètres, Atlas Cloud a lancé un générateur gratuit de sketchs publicitaires IA la semaine dernière qui exécute la même chaîne sans aucun bouton.
Vous écrivez une ligne sur votre produit et ses arguments de vente. Il écrit un script comique à deux personnages pour vous, accroche, conflit, rebondissement, puis rend une vidéo de 15 secondes avec dialogue parlé et effets sonores intégrés. Vous pouvez attacher jusqu’à quatre vraies photos de produit comme références, et la publicité conserve leur forme, couleur, étiquette et logo du script à l’image finale. Six styles sont disponibles, du mème drôle au rebondissement en passant par la sitcom, le luxe et la vente agressive, et le dialogue revient dans la langue dans laquelle vous avez écrit la description.
C’est la même chaîne à deux personnages plus images de référence plus voix du tutoriel, moins l’écriture du prompt et moins la facture. Ce qui en fait un bon moyen de savoir si ce format convient à votre produit avant de dépenser quoi que ce soit pour l’ajuster.
Pour avoir une idée de ce qu’un tas d’images de référence fait pour un produit, voici la version de Wan 3.0 du travail : cinq images en entrée, une bobine de lancement en sortie, chaque image ancrant un battement du montage.
Cinq images de référence développées en une bobine de lancement de produit de style Material Design. Cinq images de référence pilotant une vidéo produit de neuf secondes, chacune ancrant un battement et passant au suivant. Source : manuel officiel du créateur Wan 3.0 d’Alibaba.
Combien coûte un clip de référence multimodale Wan 3.0
| Étape | Modèle | Prix unitaire | Quantité | Coût |
|---|---|---|---|---|
| 1 et 2, deux images de référence | GPT Image 2 | 0,009 $ par image | 2 | 0,02 $ |
| 3, référence vocale | MiniMax Speech 2.6 HD | 0,08 $ par 1 000 caractères | 49 caractères | 0,00 $ |
| 4, la prise de 10 secondes en 1080P | Wan 2.7 Référence vers vidéo | 0,15 $ par seconde en 1080P | 10 s | 1,50 $ |
| Total du tutoriel | environ 1,52 $ | |||
| Variation, 30 secondes | Seedance 2.5 Référence vers vidéo | 0,134 $ par seconde en 480P | 30 s | environ 4,02 $ |
| Option gratuite | Générateur gratuit de sketchs publicitaires IA | gratuit | 1 clip, 15 s | 0 $ |
Ce sont les tarifs propres à la plateforme, vérifiés en août 2026 et facturés au paiement à l’utilisation. Deux choses font bouger le total plus que ce que les gens attendent. La résolution est la première : le 0,10 $ par seconde dans le tableau de comparaison est le tarif de base de Wan 2.7, et 1080P facture à 0,15 $, d’où le 1,50 $ ci-dessus. La seconde est que Seedance facture par nombre de pixels, donc son 0,134 $ par seconde indiqué est le chiffre en 480P et une prise en 720P coûte plus qu’une multiplication simple ne le suggère. Pour référence, le taux bêta rapporté de Wan 3.0 de 0,20 $ par seconde en 1080P placerait une prise complète de 30 secondes à environ 6 $, ce qui est plus que la voie Seedance en 480P aujourd’hui.
Une note sur l’utilisation de ces outils. Wan 3.0 est une bêta et ses conditions peuvent changer, donc relisez-les avant de construire un pipeline dessus. Si vos images de référence sont de vraies personnes, obtenez leur permission d’abord, car la référence vers vidéo est précisément la capacité qui rend cela important. Les clips d’exemple dans cet article sont les résultats générés par Alibaba eux-mêmes à partir de son manuel public pour créateurs, reproduits ici à des fins de commentaire.
Questions fréquentes
Combien de références la référence multimodale de Wan 3.0 peut-elle réellement prendre ?
Jusqu’à 20 ressources en un seul appel, provenant d’images, vidéos, audio, documents et pages web. La limite pratique est inférieure à la limite technique. Attribuez à chaque ressource exactement une tâche, un sujet par image, et vous utiliserez bien moins de 20 pour la plupart des scènes.
Wan 3.0 peut-il vraiment transformer un PDF ou une page web en vidéo ?
Oui, c’est la partie vraiment unique. En plus du texte, des images, de l’audio et de la vidéo, il accepte les fichiers de documents et les URL en direct, les rapports sur la bêta listant .doc, .xls, .ppt, .pdf et .txt. Aucun autre modèle de référence vers vidéo dans le tableau de comparaison ci-dessus n’accepte de document.
Wan 3.0 est-il open source ? Puis-je l’exécuter dans ComfyUI ?
Non, et pas pour le moment. Wan 3.0 est une bêta fermée fonctionnant sur le cloud d’Alibaba. Les générations précédentes de Wan ont été publiées ouvertement, d’où l’attente, mais Alibaba n’a pas confirmé les poids pour 3.0. Les pages affirmant une version Apache 2.0 de 1,3B ou 14B de Wan 3.0 ne sont étayées par rien d’officiel.
Wan 3.0 est-il disponible via des API tierces ?
Pas encore, y compris Atlas Cloud. Le plus proche que vous puissiez appeler aujourd’hui est Wan 2.7 Référence vers vidéo, dont la forme d’entrée correspond presque exactement à la référence omni, à l’exception des modalités document et page web, ou Seedance 2.5 Référence vers vidéo si vous avez besoin des 30 secondes complètes.
Quel est le moyen le moins cher de tester une vidéo à deux personnages verrouillée par référence ?
Le générateur gratuit de sketchs publicitaires IA lié ci-dessus. Quatre photos de référence en entrée, un clip parlé de 15 secondes à deux personnages en sortie, sans paramètres et sans dépense. S’il tient votre produit et votre format, alors allez ajuster la chaîne payante.
Pourquoi mes personnages dérivent-ils encore même avec des images de référence ?
Trois causes, par ordre de fréquence. Une référence porte deux tâches, donc on lui demande de fixer à la fois le visage et le lieu. L’image de référence a plus d’une personne ou un fond chargé, donc le modèle ne sait pas quelle partie verrouiller. Ou la dérive est un artefact de rendu plutôt qu’un échec de référence, auquel cas mettez morphing de visage, changement de couleur dans le prompt négatif avant de réécrire quoi que ce soit.


