A barra de download chega a 65 GB, as ventoinhas disparam, e a verdadeira pergunta surge: será que vai carregar mesmo? A resposta curta para os requisitos de memória do GPT-OSS-120B é cerca de 61 GB para os pesos, mais alguns gigabytes para espaço de trabalho, e é por isso que a OpenAI o apresenta como um modelo para uma única GPU de 80 GB.
A seguir, dividimos esse número em partes, mostramos o hardware que já o executou com velocidades medidas e abordamos a rota hospedada para quando o seu não for suficiente.
Principais conclusões
- O GPT-OSS-120B é distribuído como um checkpoint MXFP4 de 60,8 GiB, e é por isso que a OpenAI mira uma única GPU de 80 GB.
- O comprimento do contexto adiciona pouca memória: o cache KV chega a apenas cerca de 4,5 GiB com os 131K tokens completos.
- Com menos de 80 GB de VRAM, o llama.cpp pode descarregar camadas de especialistas para a RAM do sistema e ainda executá-lo.
- Macs com mais de 96 GB de memória e mini PCs de 128 GB conseguem manter o modelo completo em uma única máquina.
- Sem hardware adequado? Chame Qwen3.5 122B A10B no Atlas Cloud por meio de uma API compatível com OpenAI.
Requisitos de memória do GPT-OSS-120B: pesos mais cache KV
A OpenAI lançou o gpt-oss-120b em 5 de agosto de 2025, sob a licença Apache 2.0. É um modelo de mistura de especialistas, então apenas 5,1B dos seus 116,8B de parâmetros trabalham em cada token. Isso ajuda na velocidade, não na memória: cada especialista ainda precisa ficar na memória pronto para ser escolhido.
O truque que o mantém pequeno é o MXFP4. De acordo com o model card do gpt-oss, os pesos dos especialistas, que compõem mais de 90% dos parâmetros, são armazenados a 4,25 bits cada. Uma cópia de 16 bits do mesmo modelo precisaria de aproximadamente quatro vezes o espaço.
| Especificação | GPT-OSS-120B |
|---|---|
| Parâmetros totais | 116,8B |
| Parâmetros ativos por token | 5,1B |
| Camadas e especialistas | 36 camadas, 128 especialistas, 4 ativos por token |
| Formato dos pesos | MXFP4 para camadas de especialistas, BF16 para o restante |
| Tamanho do checkpoint | 60,8 GiB |
| Janela de contexto | 131.072 tokens |
Como a janela de contexto altera a memória do GPT-OSS-120B
Cada token deixa uma chave e um valor para trás em cada camada de atenção. Esse armazenamento é o cache KV e, quando cada camada atende ao contexto completo, ele cresce junto com o comprimento do contexto.
O GPT-OSS-120B contorna a maior parte disso. Metade das suas 36 camadas usa uma janela deslizante que só olha para trás 128 tokens, e cada camada armazena apenas 8 cabeças KV de 64 dimensões. Apenas 18 camadas mantêm o contexto completo. Calculamos o cache KV a partir da configuração do modelo e ele corresponde aos totais medidos no guia gpt-oss do llama.cpp.
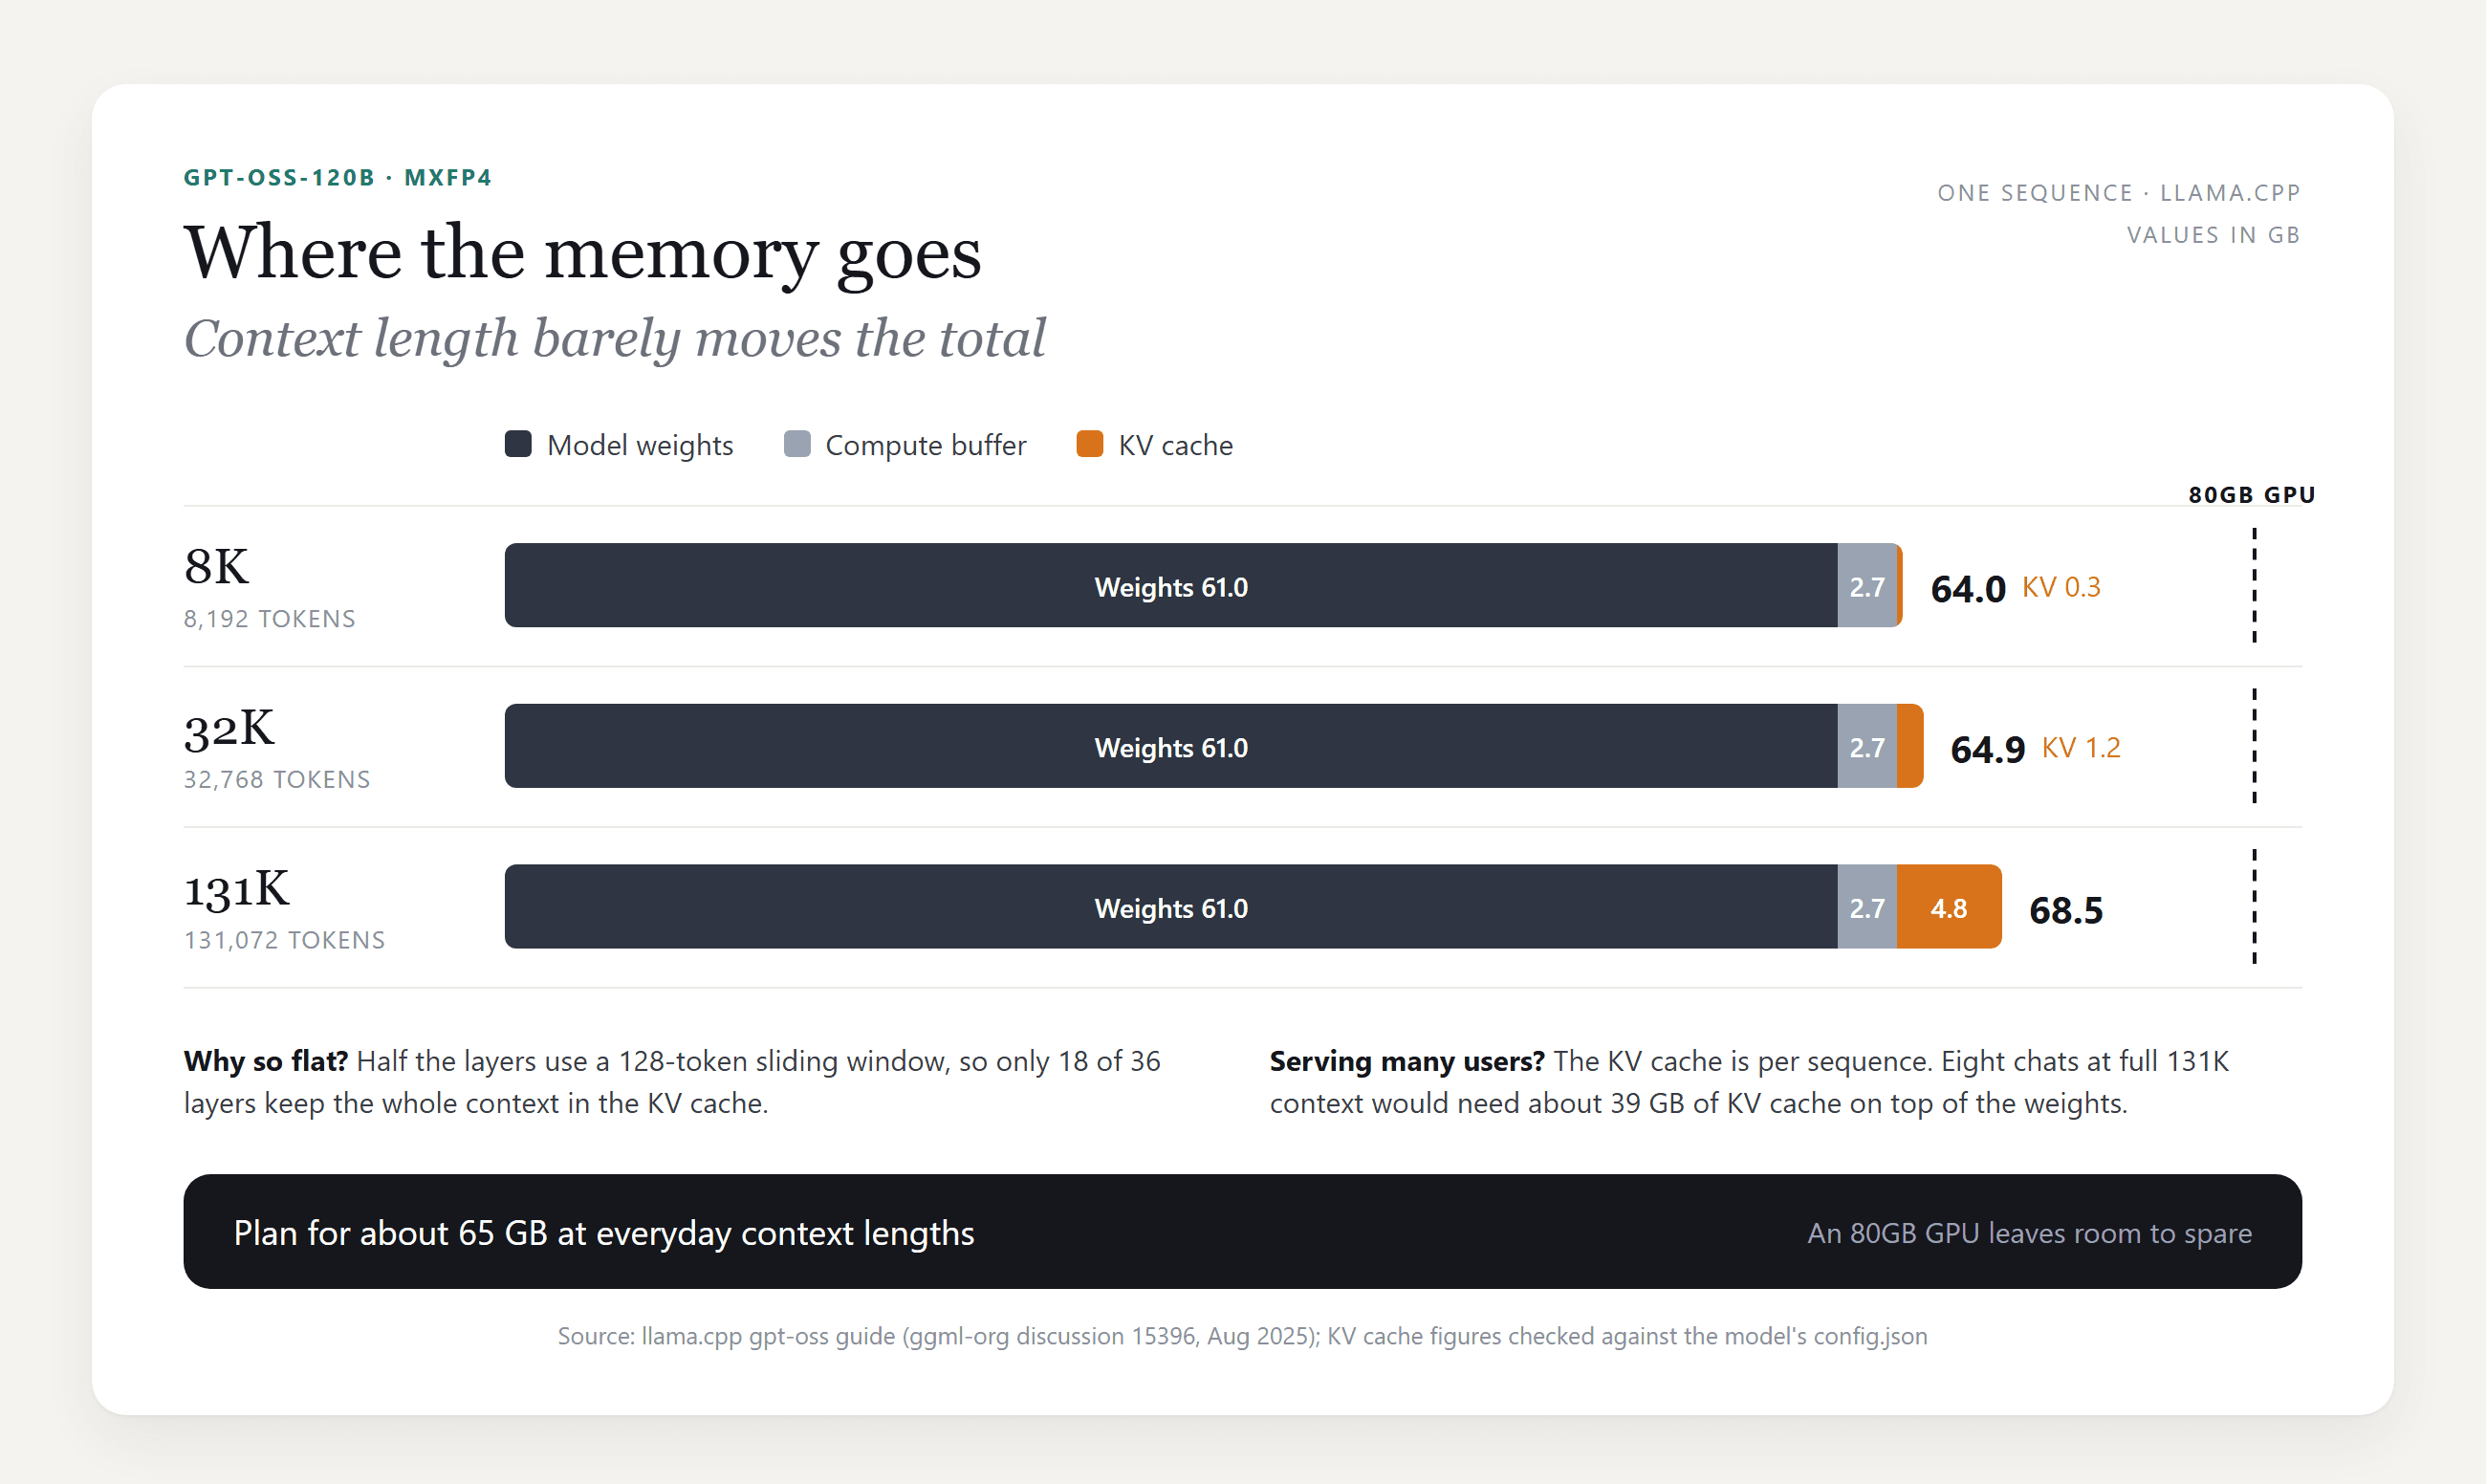
Ir de 8K até os 131K completos custa menos de 5 GB. Onde isso se acumula é na concorrência: o cache KV é por conversa, então um servidor mantendo oito conversas de comprimento total precisa de aproximadamente 39 GB além dos pesos.
Posso executar o GPT-OSS-120B localmente? Requisitos de hardware por configuração
Sim, se você conseguir colocar cerca de 65 GB em algum lugar rápido: uma GPU grande, uma GPU mais RAM do sistema, ou uma máquina com memória unificada.
Requisitos de GPU do GPT-OSS-120B
O caso mais simples é uma placa de data center de 80 GB. A receita do vLLM para gpt-oss diz que o modelo 120b "cabe em uma única A100 (80GB)", e que dividi-lo entre mais GPUs ajuda na vazão.
Abaixo de 80 GB, o guia do llama.cpp oferece uma saída. Sua flag --n-cpu-moe mantém algumas camadas de especialistas na RAM do sistema e o restante na GPU. O guia coloca o mínimo em cerca de 8 GB de VRAM, desde que a memória da GPU e a do sistema juntas ainda comportem o modelo.
| Configuração | Onde os pesos ficam | Velocidade de geração relatada |
|---|---|---|
| RTX Pro 6000, 96GB | Tudo na GPU | 196 tokens/s (guia do llama.cpp) |
| A100 ou H100, 80GB | Tudo na GPU | Cabe em uma placa (receita do vLLM) |
| RTX 5090, 32GB, mais RAM do sistema | 21 camadas de especialistas mantidas na RAM do sistema | Cerca de 30 tokens/s com contexto zero (guia do llama.cpp) |
Uma armadilha do Windows do mesmo guia: o driver pode extravasar silenciosamente para a RAM do sistema quando a VRAM acaba, então o modelo carrega e depois se arrasta. Observe a Memória da GPU no Gerenciador de Tarefas e aumente a contagem de offload até ela ficar abaixo do tamanho da sua placa.
Executando o GPT-OSS-120B em um Mac ou mini PC de 128 GB
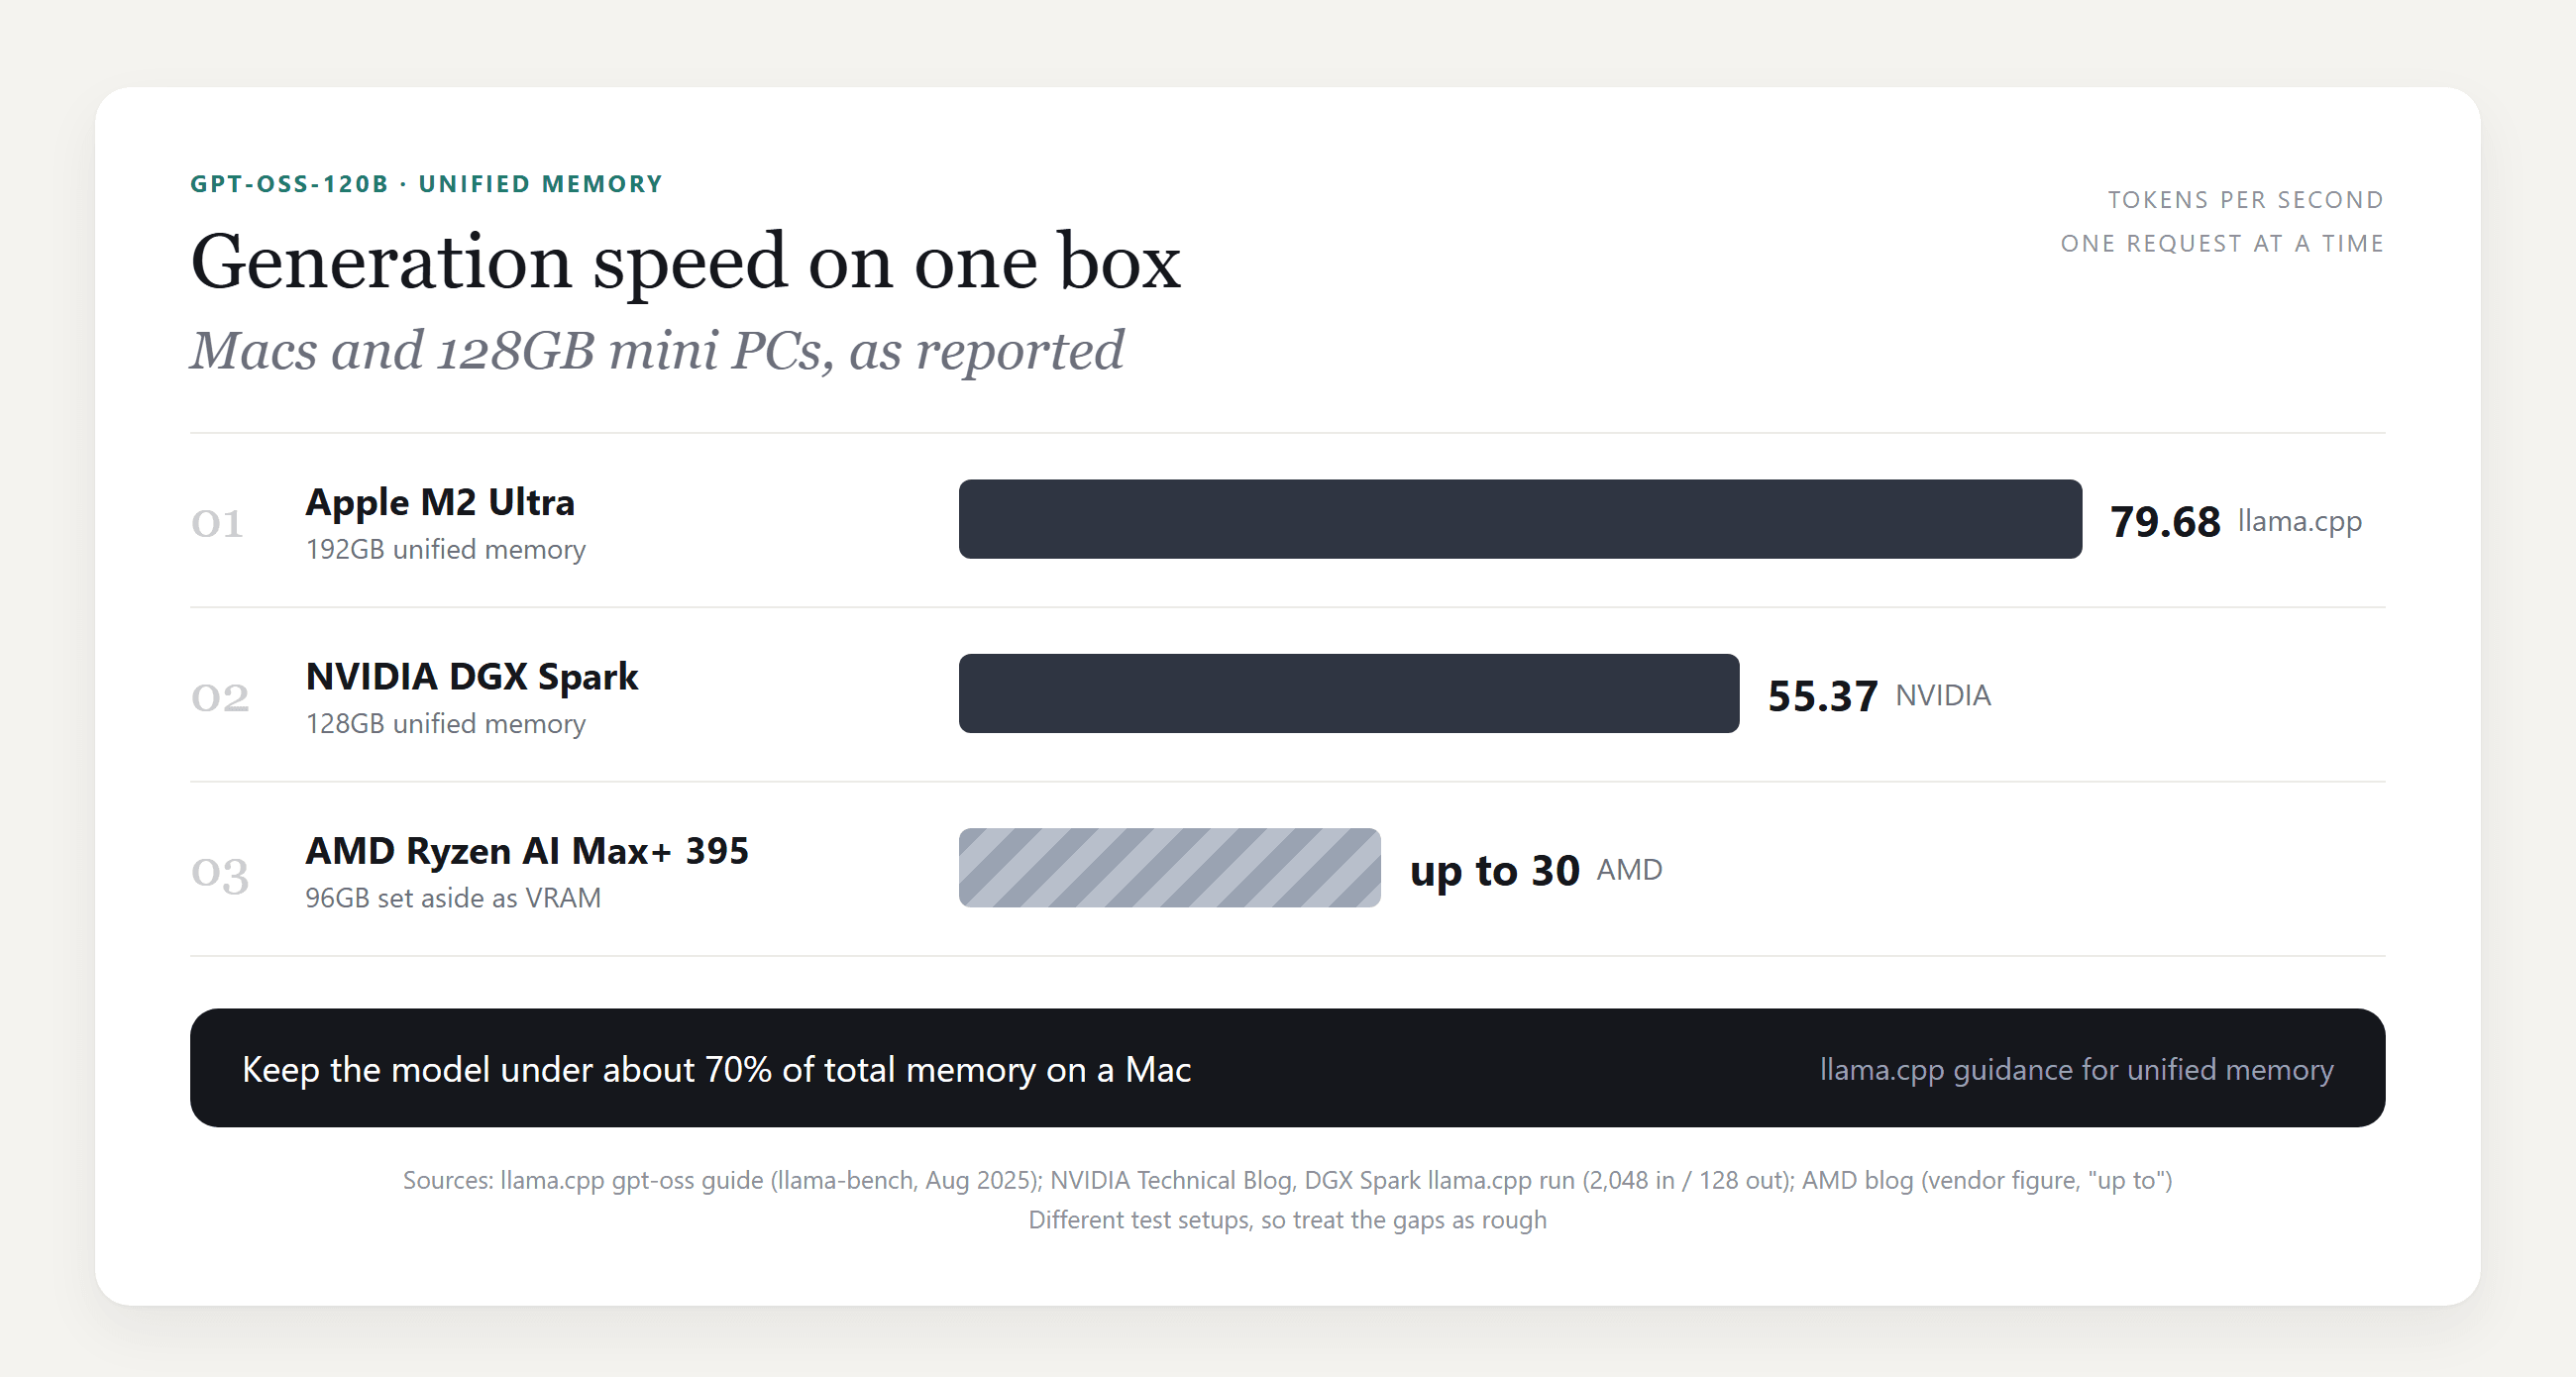
A memória unificada elimina a divisão entre GPU e RAM. O guia do llama.cpp diz que Macs com mais de 96 GB de RAM, como máquinas M2 Ultra ou M3 Max, podem executar o modelo com contexto completo, e aconselha ficar abaixo de cerca de 70% da memória total.
O macOS limita por padrão quanta memória a GPU pode fixar. Em uma máquina de 192 GB, o guia eleva esse limite de 154 GB para 180 GB com um comando:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
Os novos mini PCs de 128 GB entram na mesma classe. A NVIDIA relata 55,37 tokens/s para o gpt-oss-120b em um DGX Spark executando llama.cpp. A AMD diz que uma máquina Ryzen AI Max+ 395 com 96 GB reservados como VRAM alcança "até 30 tokens por segundo", que é um número da própria empresa.
Memória insuficiente? Use um modelo aberto hospedado por meio de uma API
Se nenhuma dessas máquinas está na sua mesa, um modelo aberto hospedado pula completamente a questão de hardware.
O Atlas Cloud serve o Qwen3.5 122B A10B, parte da sua linha de modelos Qwen. No papel, é um equivalente próximo do gpt-oss-120b: um modelo de mistura de especialistas Apache 2.0 da equipe Qwen da Alibaba, com 122B no total e 10B de parâmetros ativos. Ele lê até 262.144 tokens de contexto.
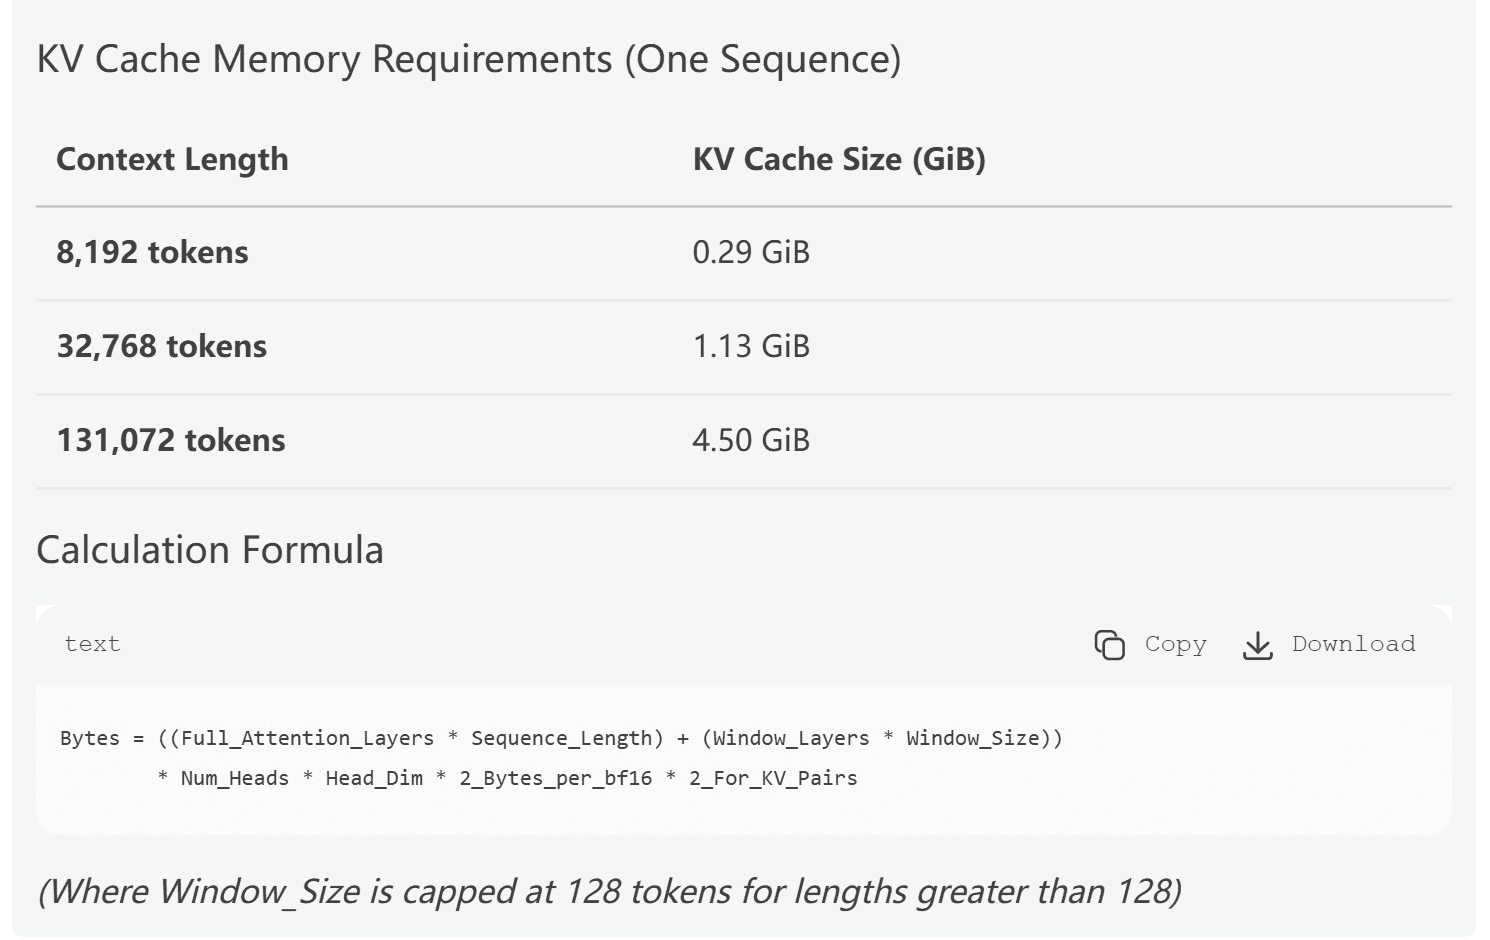
Demos a ele o layout de atenção da configuração do gpt-oss e pedimos o cache KV em três comprimentos. A tabela dele correspondeu à nossa própria matemática com duas casas decimais. Se depois você quiser um Qwen para sua própria máquina, nosso guia do melhor modelo Qwen para programação local dimensiona os modelos pela RAM.
Método 1: Experimente o Qwen3.5 122B A10B no Playground
Faça login e abra o playground do Qwen3.5 122B A10B, depois:
- Digite sua pergunta na caixa de mensagem.
- Clique na seta de enviar. O raciocínio aparece em um painel Thinking Process acima da resposta.
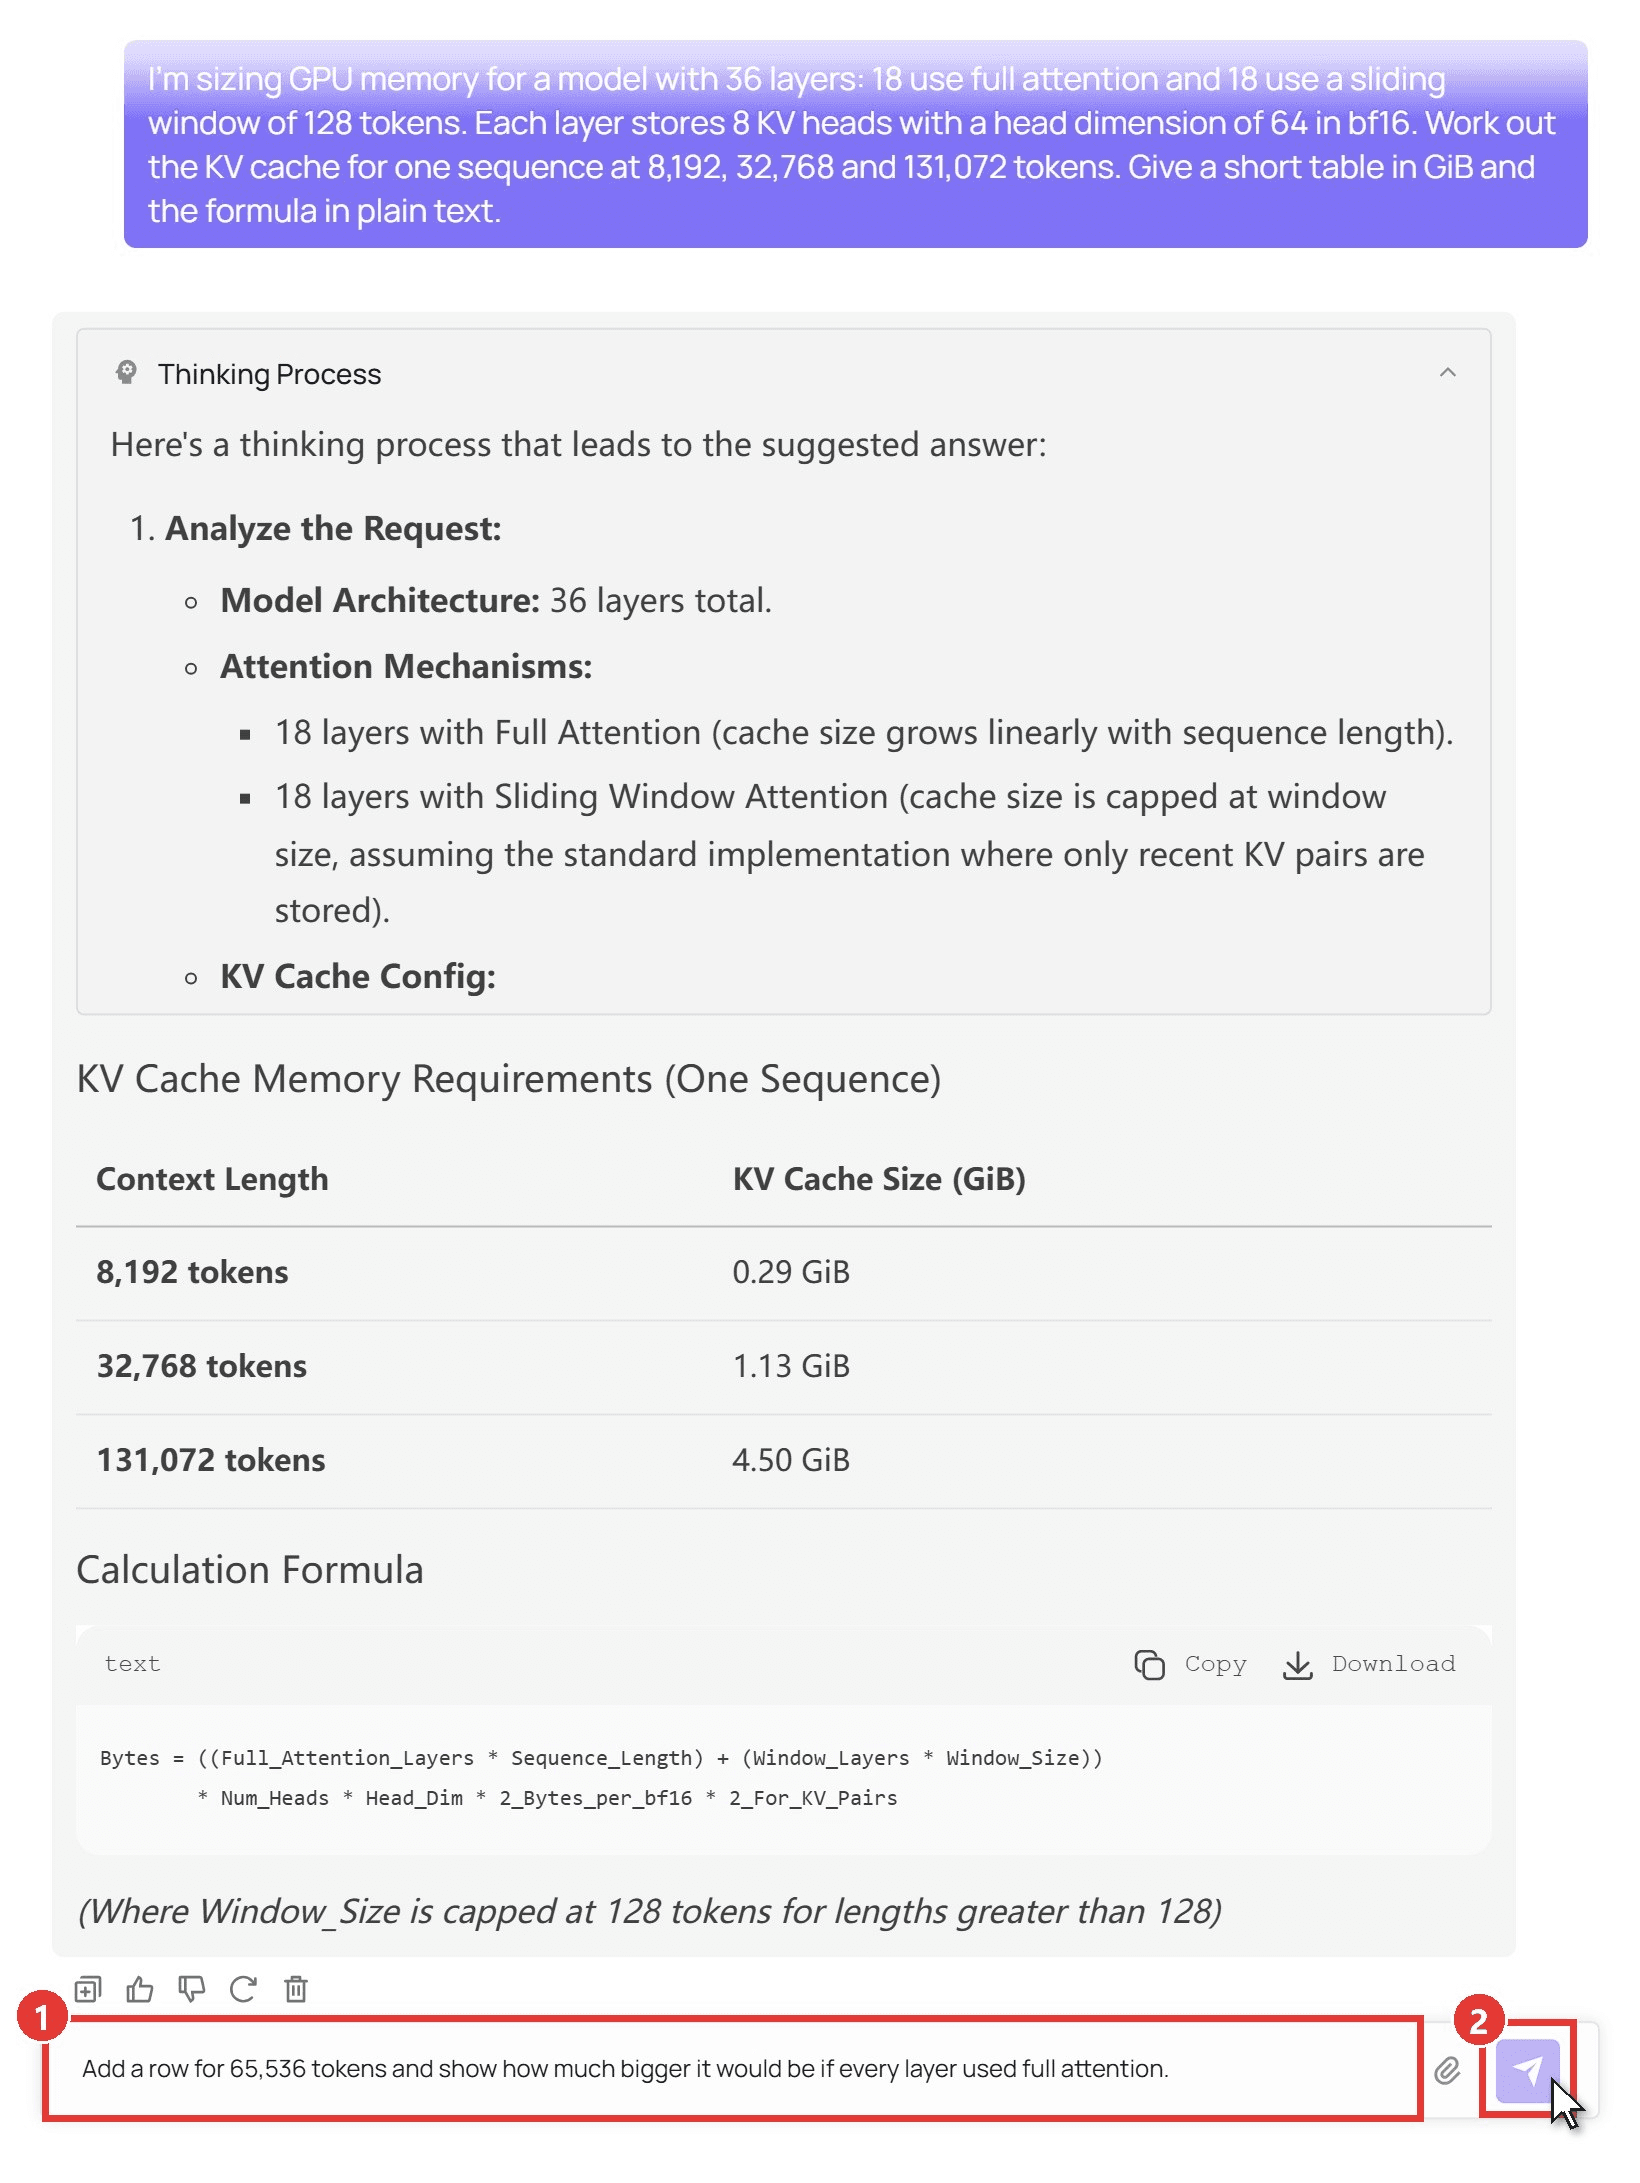
Método 2: Chame o Qwen3.5 122B A10B com a API do Atlas Cloud
Para scripts e aplicativos:
Passo 1: Crie uma chave de API. Abra Configurações no console, vá em Chaves de API e clique em Criar chave de API. Mantenha-a no lado do servidor.
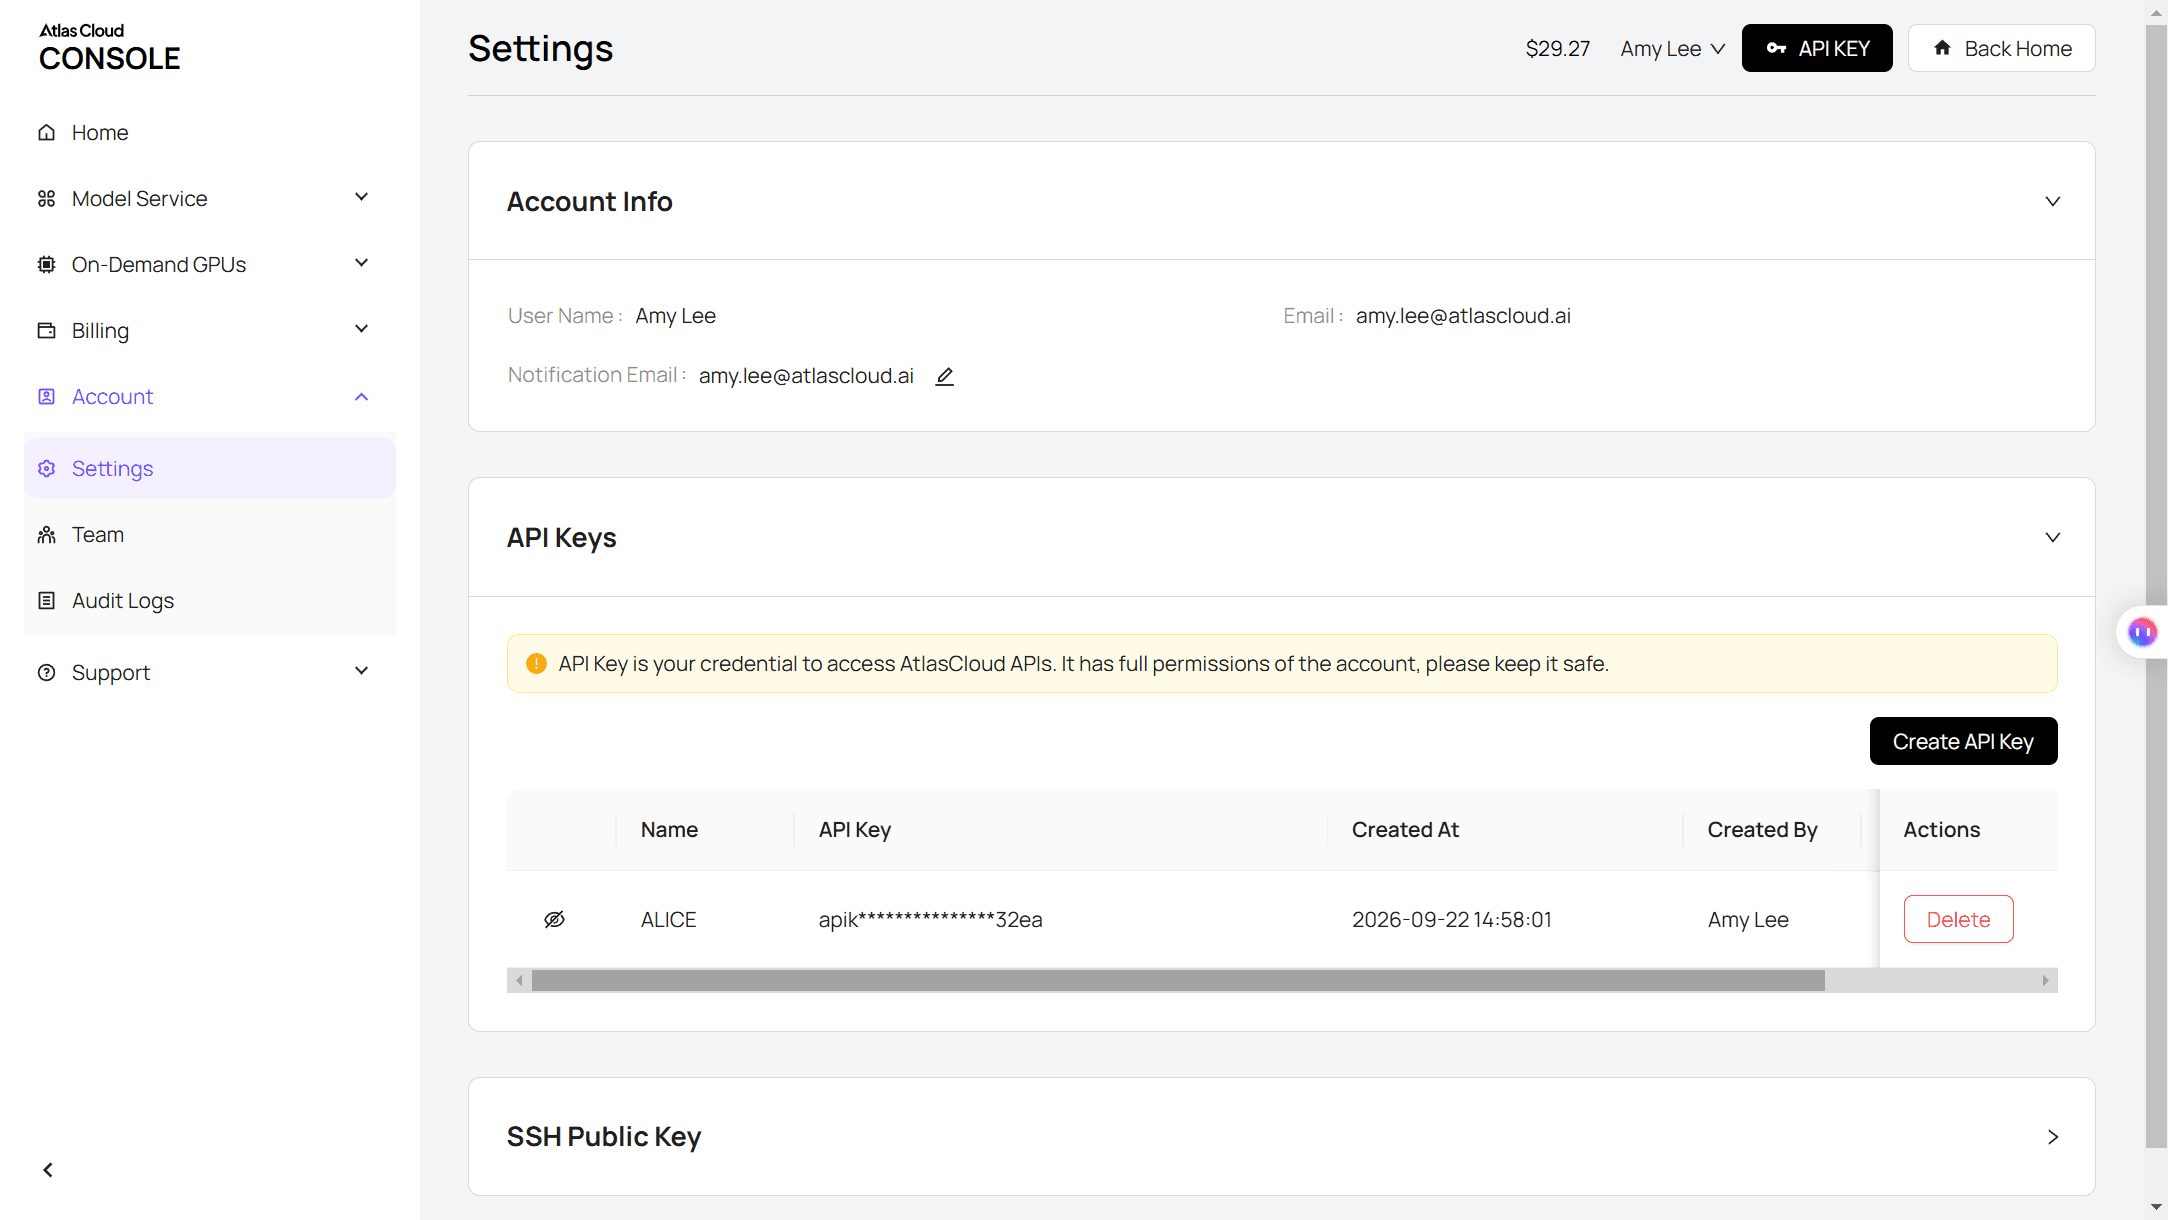
Passo 2: Verifique o formato da requisição. A documentação da API cobre o formato de chat completions, e a página do modelo tem uma aba API com um exemplo pronto.
Passo 3: Envie sua primeira requisição.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
A resposta volta em choices[0].message.content. Como o endpoint segue o formato da OpenAI, código escrito para um servidor gpt-oss local geralmente precisa apenas de uma nova URL base, chave e string de modelo. A mesma chave também funciona nos outros modelos de chat da plataforma, como nosso artigo sobre um gateway unificado de API de LLM explica.
GPT-OSS-120B vs. GPT-OSS-20B: trade-off de memória e benchmark
O irmão menor precisa de um quinto da memória. O gpt-oss-20b tem 20,9B de parâmetros com 3,6B ativos, e a OpenAI diz que ele roda com "apenas 16 GB de memória". A questão é o que você abre mão.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Memória em contexto de 8K (llama.cpp) | 64,0 GB | 14,9 GB | | MMLU | 90,0 | 85,3 | | GPQA Diamond (sem ferramentas) | 80,1 | 71,5 | | SWE-Bench Verified | 62,4 | 60,7 | | Codeforces Elo (sem ferramentas) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
As pontuações vêm do model card com alto esforço de raciocínio. A diferença em programação é de menos de dois pontos no SWE-Bench Verified, enquanto a diferença de conhecimento é de cerca de 9 pontos em ciência de nível de pós-graduação e 15 no HealthBench. Para uso predominantemente de código em uma placa de 16 GB a 24 GB, o 20b é a escolha sensata. Precisa do conhecimento extra? É aí que o 120b justifica sua conta de memória.
GGUF, Ollama ou vLLM: escolhendo um runtime para seu orçamento de memória
Cada um executa os pesos MXFP4 que a OpenAI lançou; eles diferem em onde esses pesos podem ficar.
| Runtime | Download | Melhor para |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | Um usuário em uma máquina que comporta o modelo inteiro |
| LM Studio | 65 GB | Um aplicativo de desktop em um Mac ou PC Windows |
| llama.cpp (ggml-org GGUF) | Cerca de 63 GB | Menos de 65 GB de VRAM, com camadas de especialistas descarregadas para a RAM |
| vLLM | Cerca de 65 GB de safetensors | Atendendo muitos usuários a partir de uma ou mais GPUs de data center |
Para um início rápido em uma máquina com muita memória:
plaintext1ollama run gpt-oss:120b
Para uma GPU menor, use o llama.cpp e ajuste o número de offload:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Todos os quatro lidam com o formato de chat harmony da OpenAI, que o modelo precisa para funcionar corretamente. Isso importa apenas se você escrever seu próprio código de serving.
Perguntas frequentes
O GPT-OSS-120B é melhor que o GPT-5 ou o Gemini 3 Pro?
Eles estão em categorias diferentes: GPT-5 e Gemini são modelos fechados acessados por um aplicativo ou API, enquanto o gpt-oss-120b roda no seu próprio hardware. O Gemini 3 Pro Preview também foi desativado em 9 de março de 2026, e seu nome agora aponta para o Gemini 3.1 Pro Preview. Se o controle local importa, a linha de pesos abertos do Google é a família Gemma 4.
Por que alguns sites dizem que o GPT-OSS-120B precisa de 255 GB?
Esses números assumem pesos de 16 bits: aproximadamente 117B de parâmetros vezes 2 bytes, mais a sobrecarga. O checkpoint que a OpenAI publica já está em MXFP4, então o download realista fica na faixa de 61 GB.
O esforço de raciocínio altera o uso de memória?
Não para os pesos. As configurações baixa, média e alta mudam por quanto tempo o modelo pensa. O esforço alto escreve mais tokens de raciocínio, que preenchem a janela de contexto e aumentam o cache KV, então sessões longas avançam lentamente em direção aos totais maiores do gráfico acima.
Por que as pessoas dizem que o GPT-OSS-120B tem dificuldades com jogos baseados em texto?
As evidências são anedóticas. Na página de discussão do modelo no Hugging Face, alguns usuários relatam recusas ao escrever ficção violenta, enquanto outros dizem que o role-play funciona bem. Para ficção interativa, teste seus próprios prompts antes de comprar hardware para isso.
Quanto custa um modelo hospedado da classe 120B?
Em outubro de 2026, o Qwen3.5 122B A10B custa $0.3 por milhão de tokens de entrada e $2.4 por milhão de tokens de saída no Atlas Cloud. Isso é um desconto de 25% sobre os preços regulares de $0.4 e $3.2. Nossa pergunta de dimensionamento usou cerca de 5.000 tokens de saída depois de contar o raciocínio, aproximadamente um centavo com o preço com desconto.
Conclusão
O GPT-OSS-120B é mais fácil de acomodar do que a contagem de parâmetros sugere. Planeje cerca de 65 GB em comprimentos de contexto do dia a dia e menos de 70 GB nos 131K completos. Uma GPU de 80 GB, um Mac com mais de 96 GB ou um mini PC de 128 GB vão comportá-lo, e placas menores podem executá-lo movendo camadas de especialistas para a RAM do sistema.
Se esses números descartam sua máquina, use o gpt-oss-20b para trabalho predominantemente de programação, ou chame um modelo aberto hospedado quando precisar do cérebro maior sem comprar hardware. De qualquer forma, os requisitos de memória do gpt oss 120b deixam de ser um jogo de adivinhação quando você sabe que os pesos ocupam 61 GB e o restante é margem.


