
Grok API: xAI Reasoning and Coding Models
Grok, desenvolvido pela xAI, é uma série de grandes modelos de linguagem construídos em torno da consciência em tempo real e raciocínio de nível de fronteira. O Grok 4.3 é o modelo conversacional avançado da xAI, otimizado para diálogo natural, exploração de conhecimento e raciocínio de múltiplas etapas em uma janela de contexto de 1.000.000 de tokens. O Grok Build 0.1 segue uma direção diferente — foi criado especificamente para o desenvolvimento de software, com capacidades focadas na geração de código, depuração e refatoração em fluxos de trabalho complexos de desenvolvedores. Ambos os modelos estão disponíveis no Atlas Cloud por meio de endpoints de API compatíveis com OpenAI, a partir de US$ 1 por milhão de tokens.
Grok foi desenvolvido pela xAI. A Atlas Cloud (operada pela Atlas Cloud AI LLC) fornece acesso ao modelo, mas não é sua proprietária. Todas as marcas registradas pertencem aos seus respectivos titulares.
Explorar Modelos Líderes
O Atlas Cloud oferece os modelos criativos mais avançados e inovadores do setor.



Comparar os modelos da API Grok
Match each job to the right model: Grok 4.3 for reasoning across a 1M token context and Grok Build 0.1 for agentic coding, both reachable through one OpenAI-compatible key on Atlas Cloud.
| Model | Type | Best For | Context | Inputs | Function Calling | Structured Outputs | Prompt Caching | Status |
|---|---|---|---|---|---|---|---|---|
| Grok 4.3 | Flagship reasoning model | Logic, analysis, multi-step agents, long-document work | 1M tokens | Text, image | Yes | Yes | Yes | Flagship, GA |
| Grok Build 0.1 | Coding-focused model | Code generation, debugging, refactoring, coding agents | 256K tokens | Text, image | Yes | Yes | Yes | Early access |
Grok API Features
The Grok API brings xAI's reasoning and coding models to Atlas Cloud with a 1M token context window, always-on reasoning, function calling, structured outputs, vision input, and prompt caching, all behind one OpenAI-compatible key.
1M Token Context Window
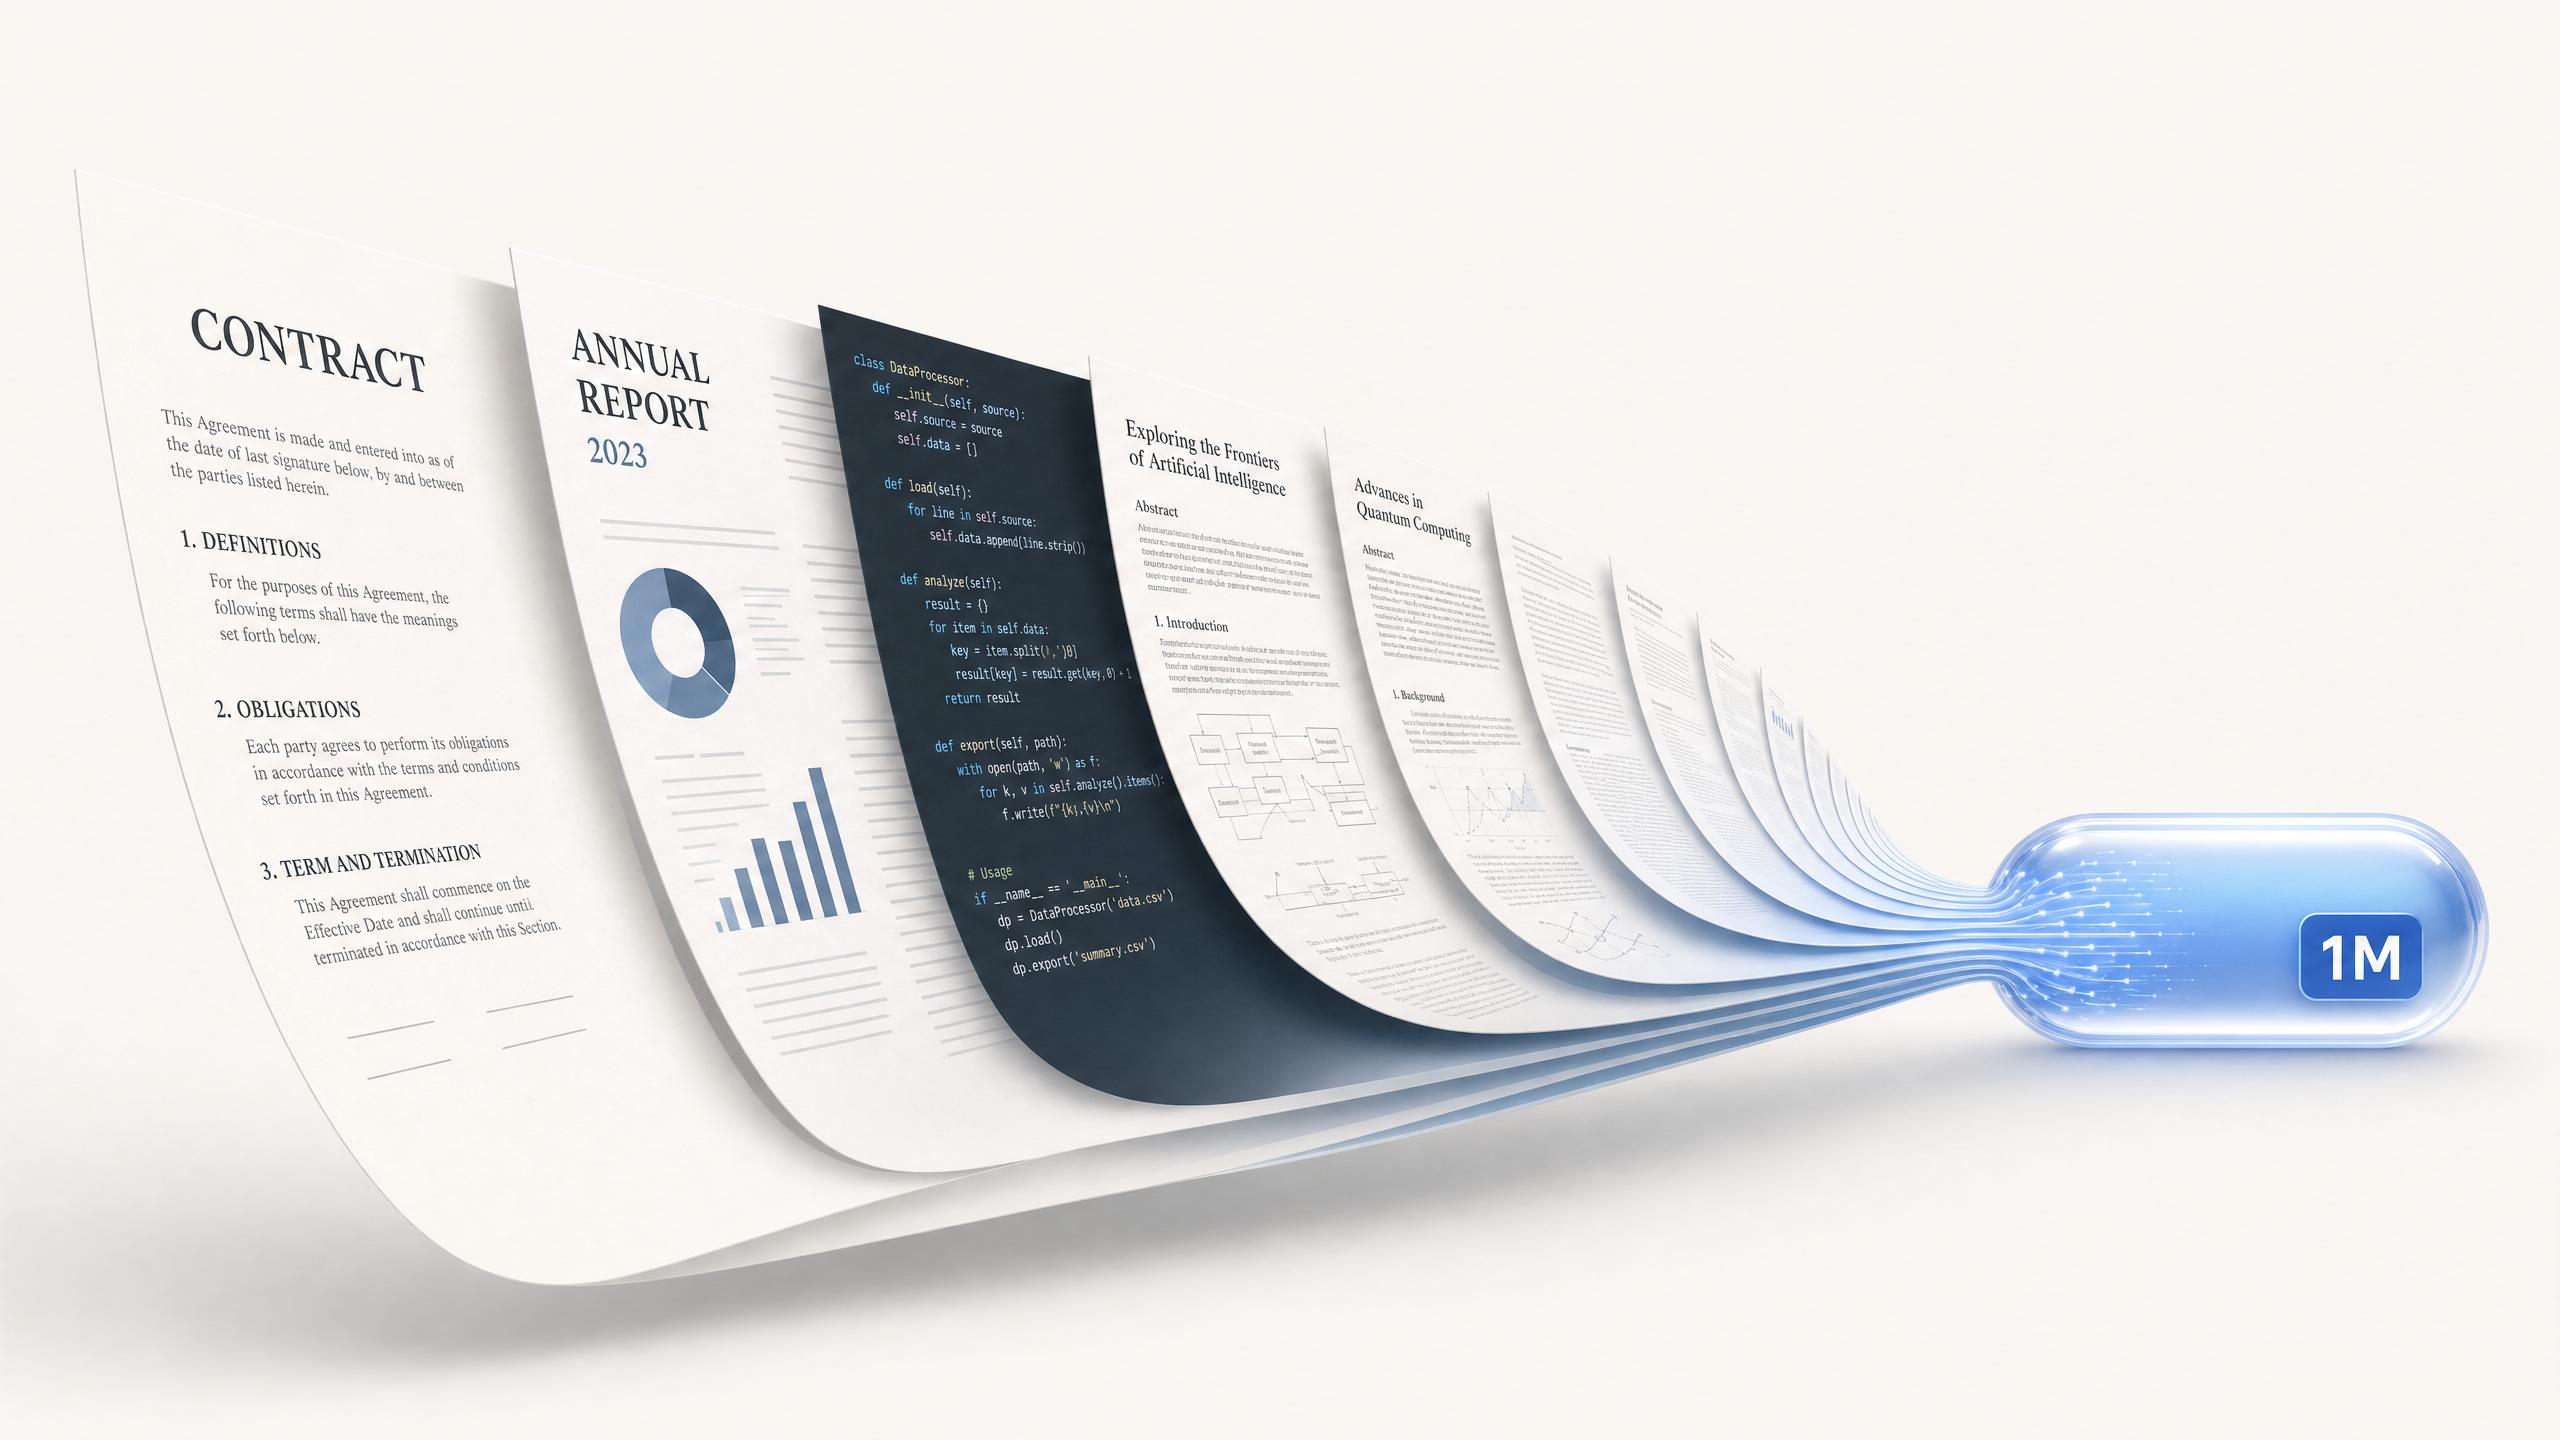
Grok 4.3 handles up to one million tokens in a single request, enough for full contract sets, large codebases, or long multi-turn agent sessions. The wide context removes chunked retrieval and preserves cross-document reasoning that shorter models lose.
Always-On Reasoning with the Grok API
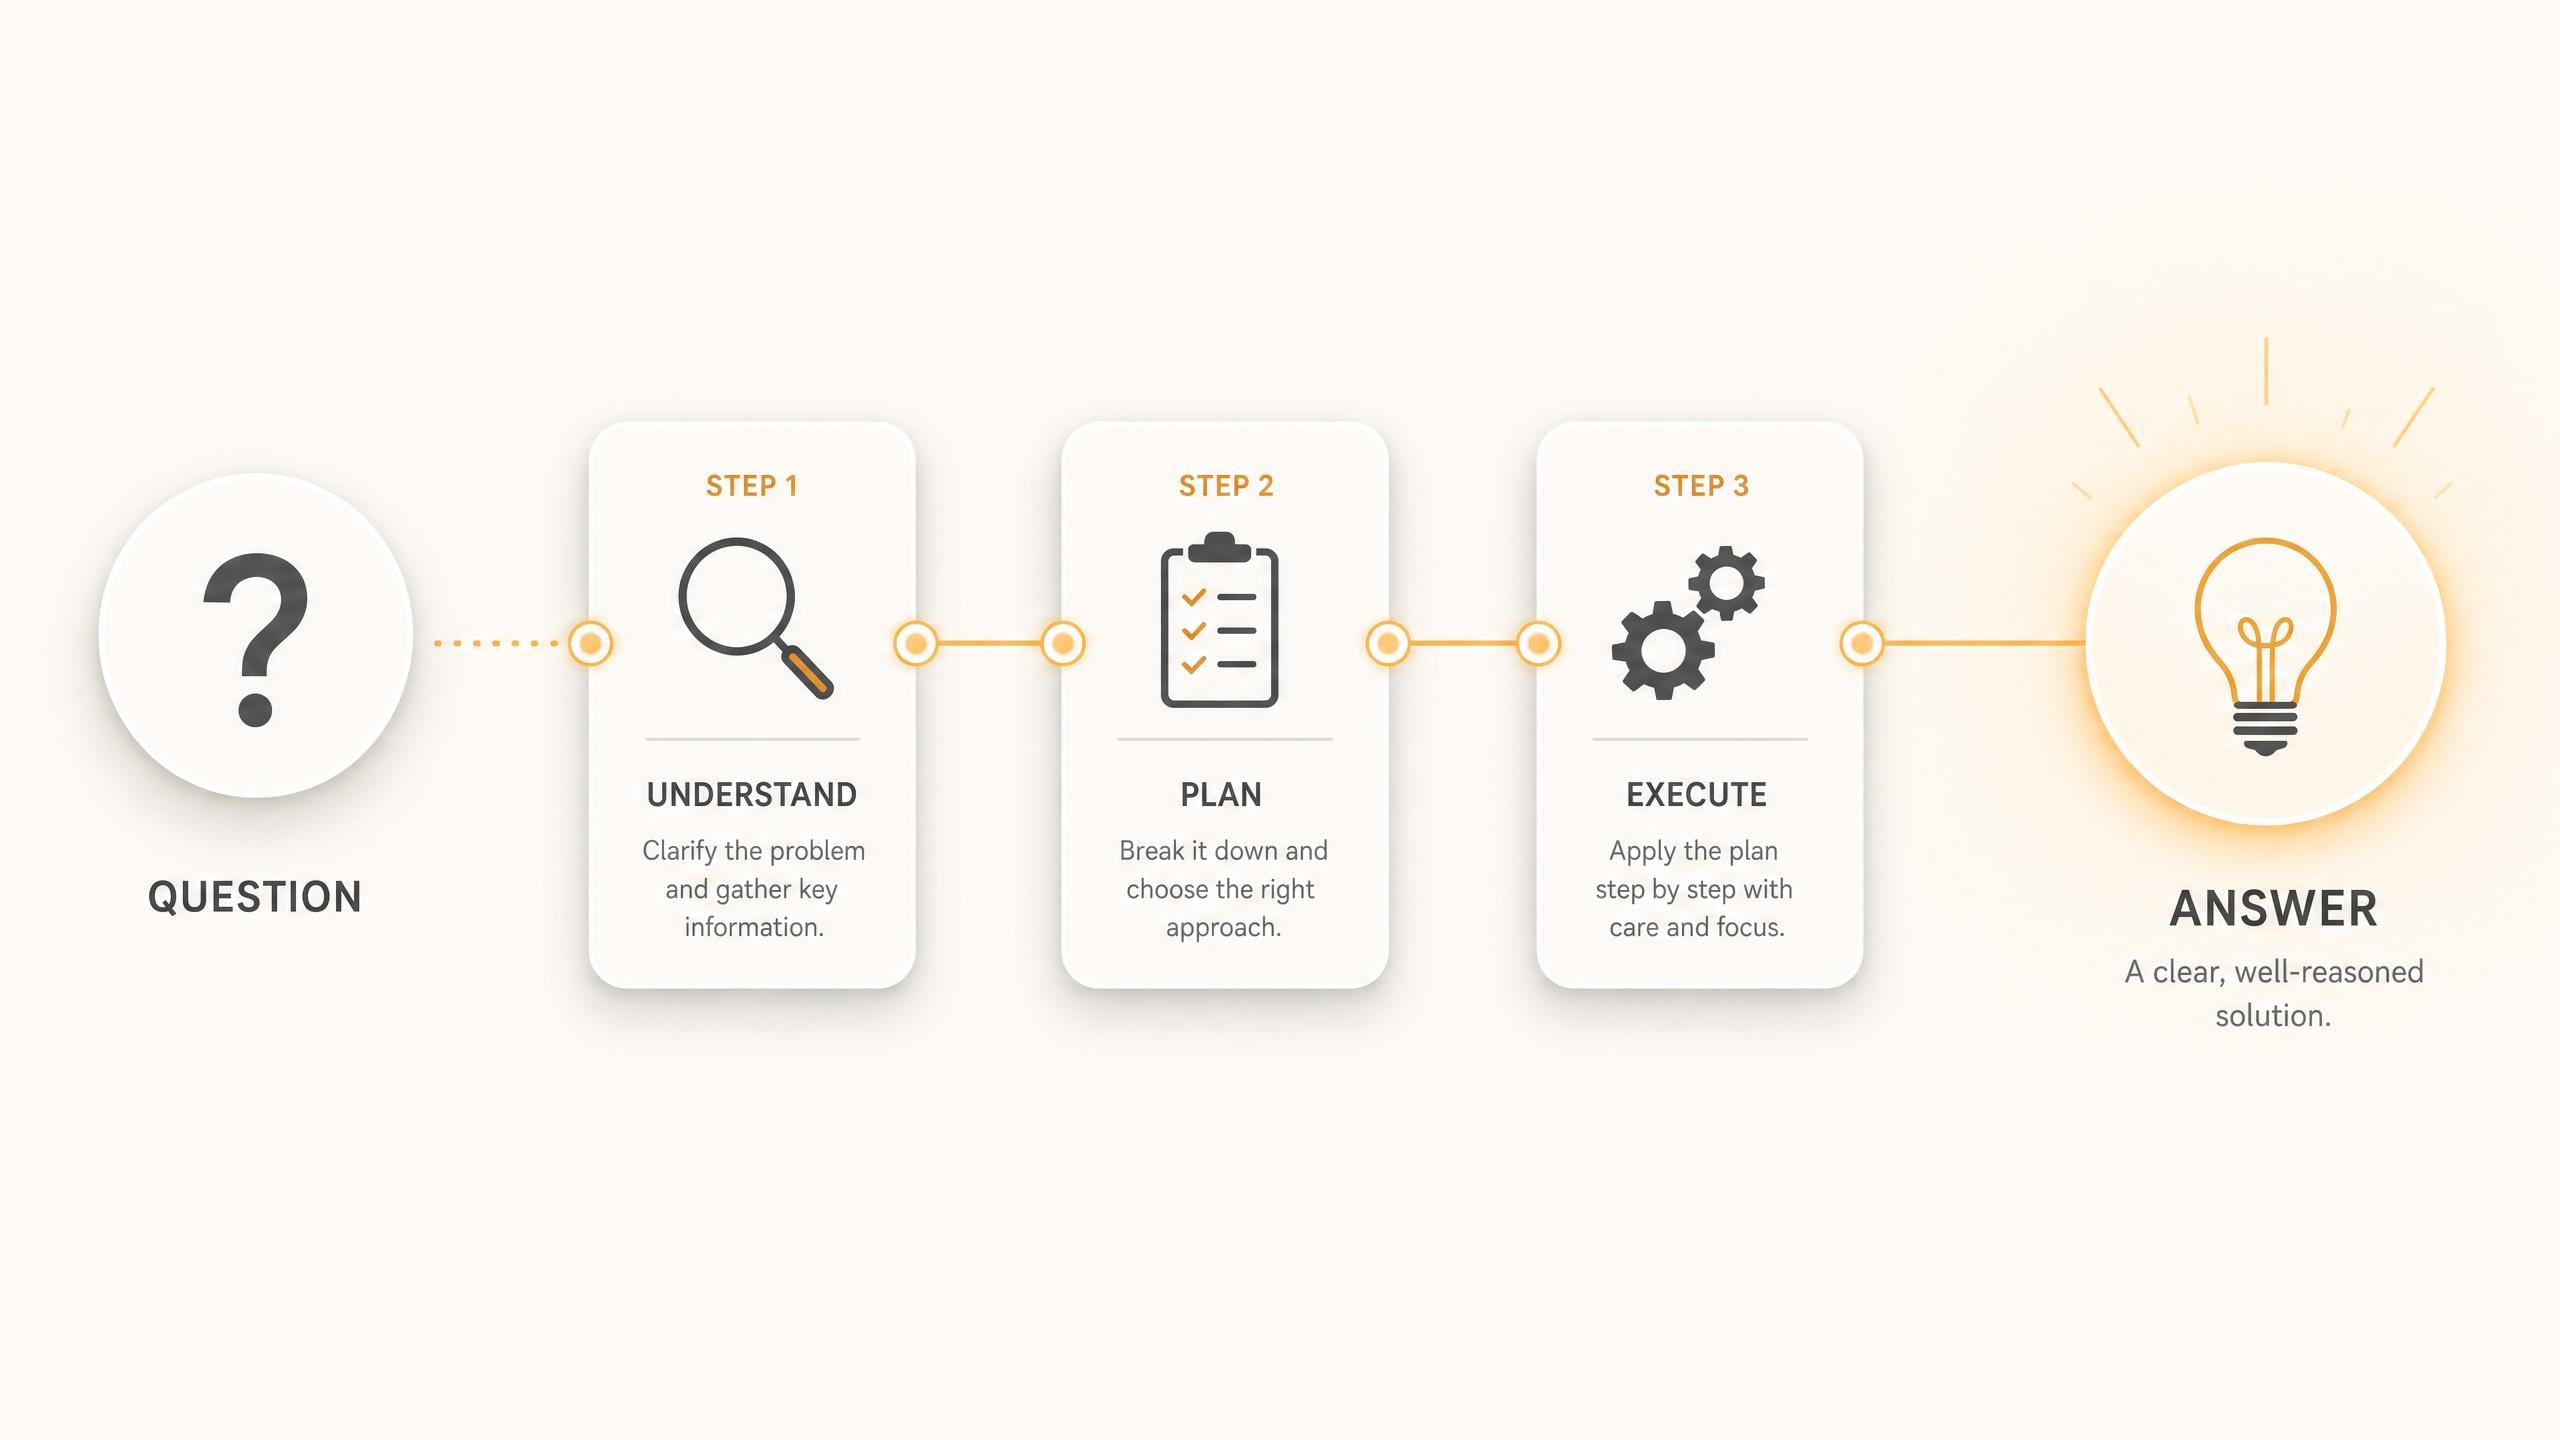
The Grok API runs Grok 4.3 with built-in step-by-step reasoning, tuned for accuracy-critical work like logic, math, and multi-step analysis. The model thinks before it answers, which lifts factual reliability and instruction following on complex prompts.
Agentic Tool Calling
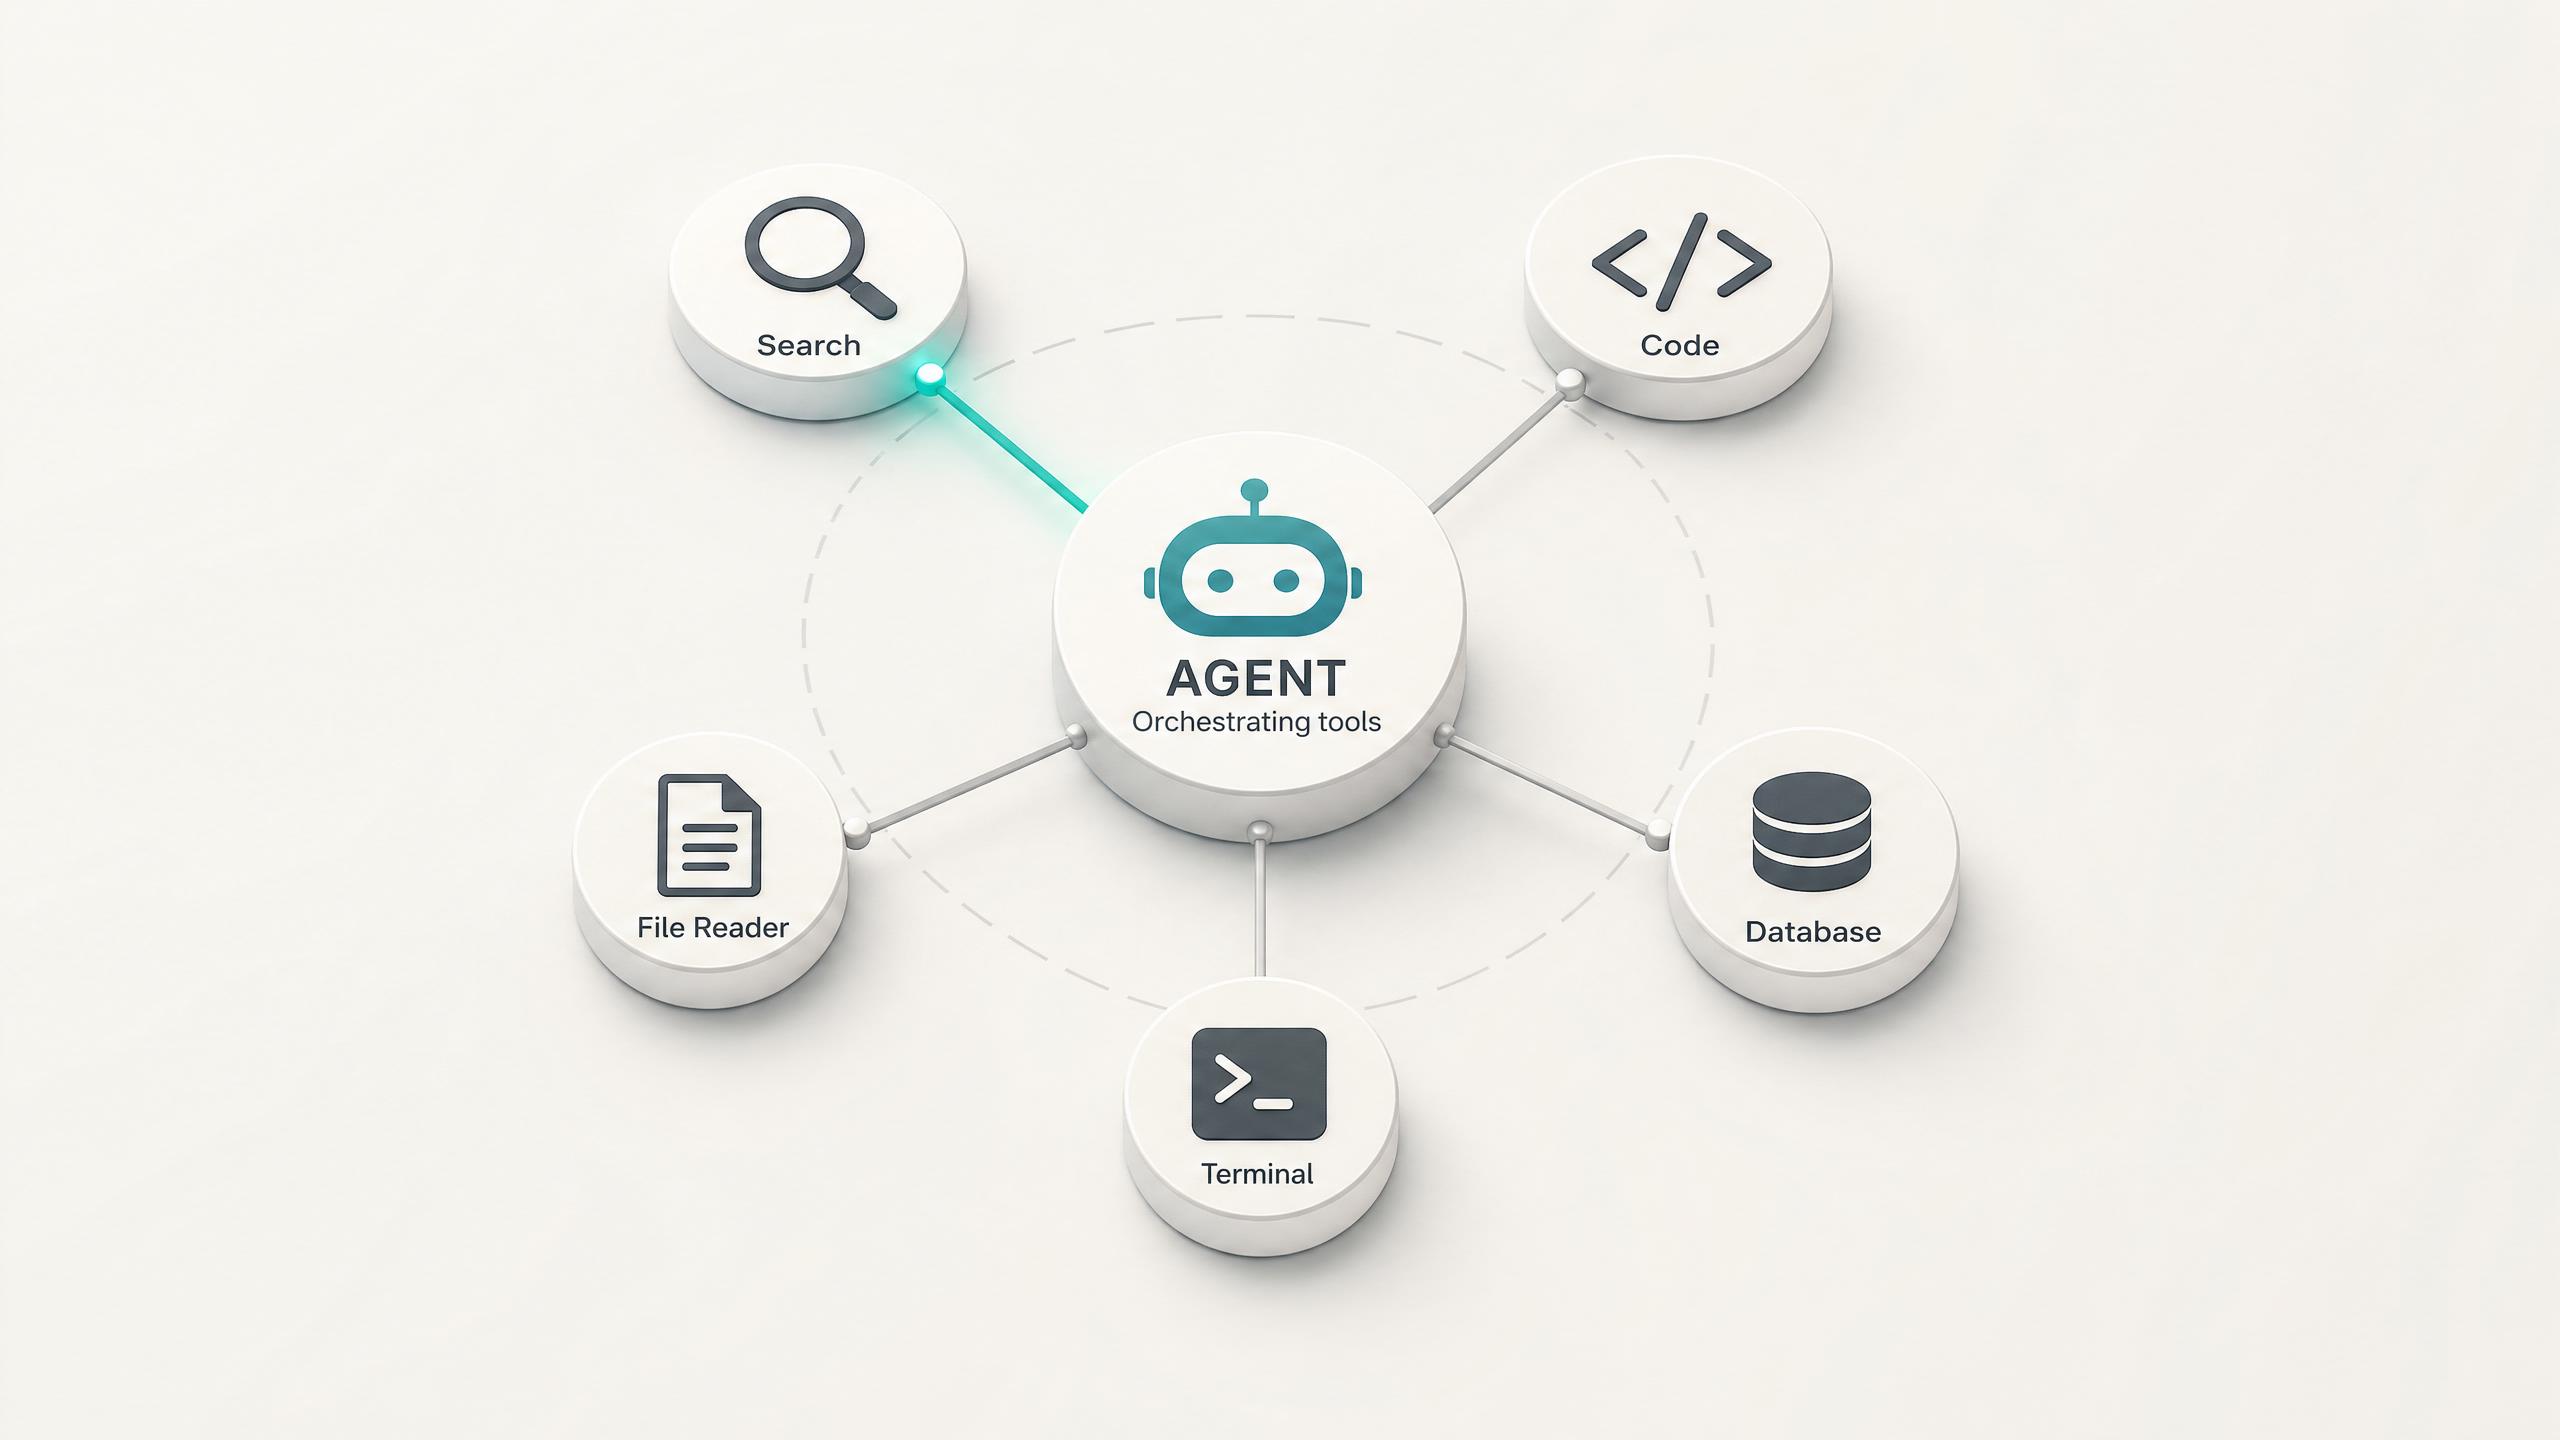
Grok 4.3 is built for agents: it plans, calls functions in sequence, and adjusts on intermediate results. Native function calling lets it trigger tools and APIs mid-task, the foundation for research agents, support bots, and automation that runs without a human in the loop.
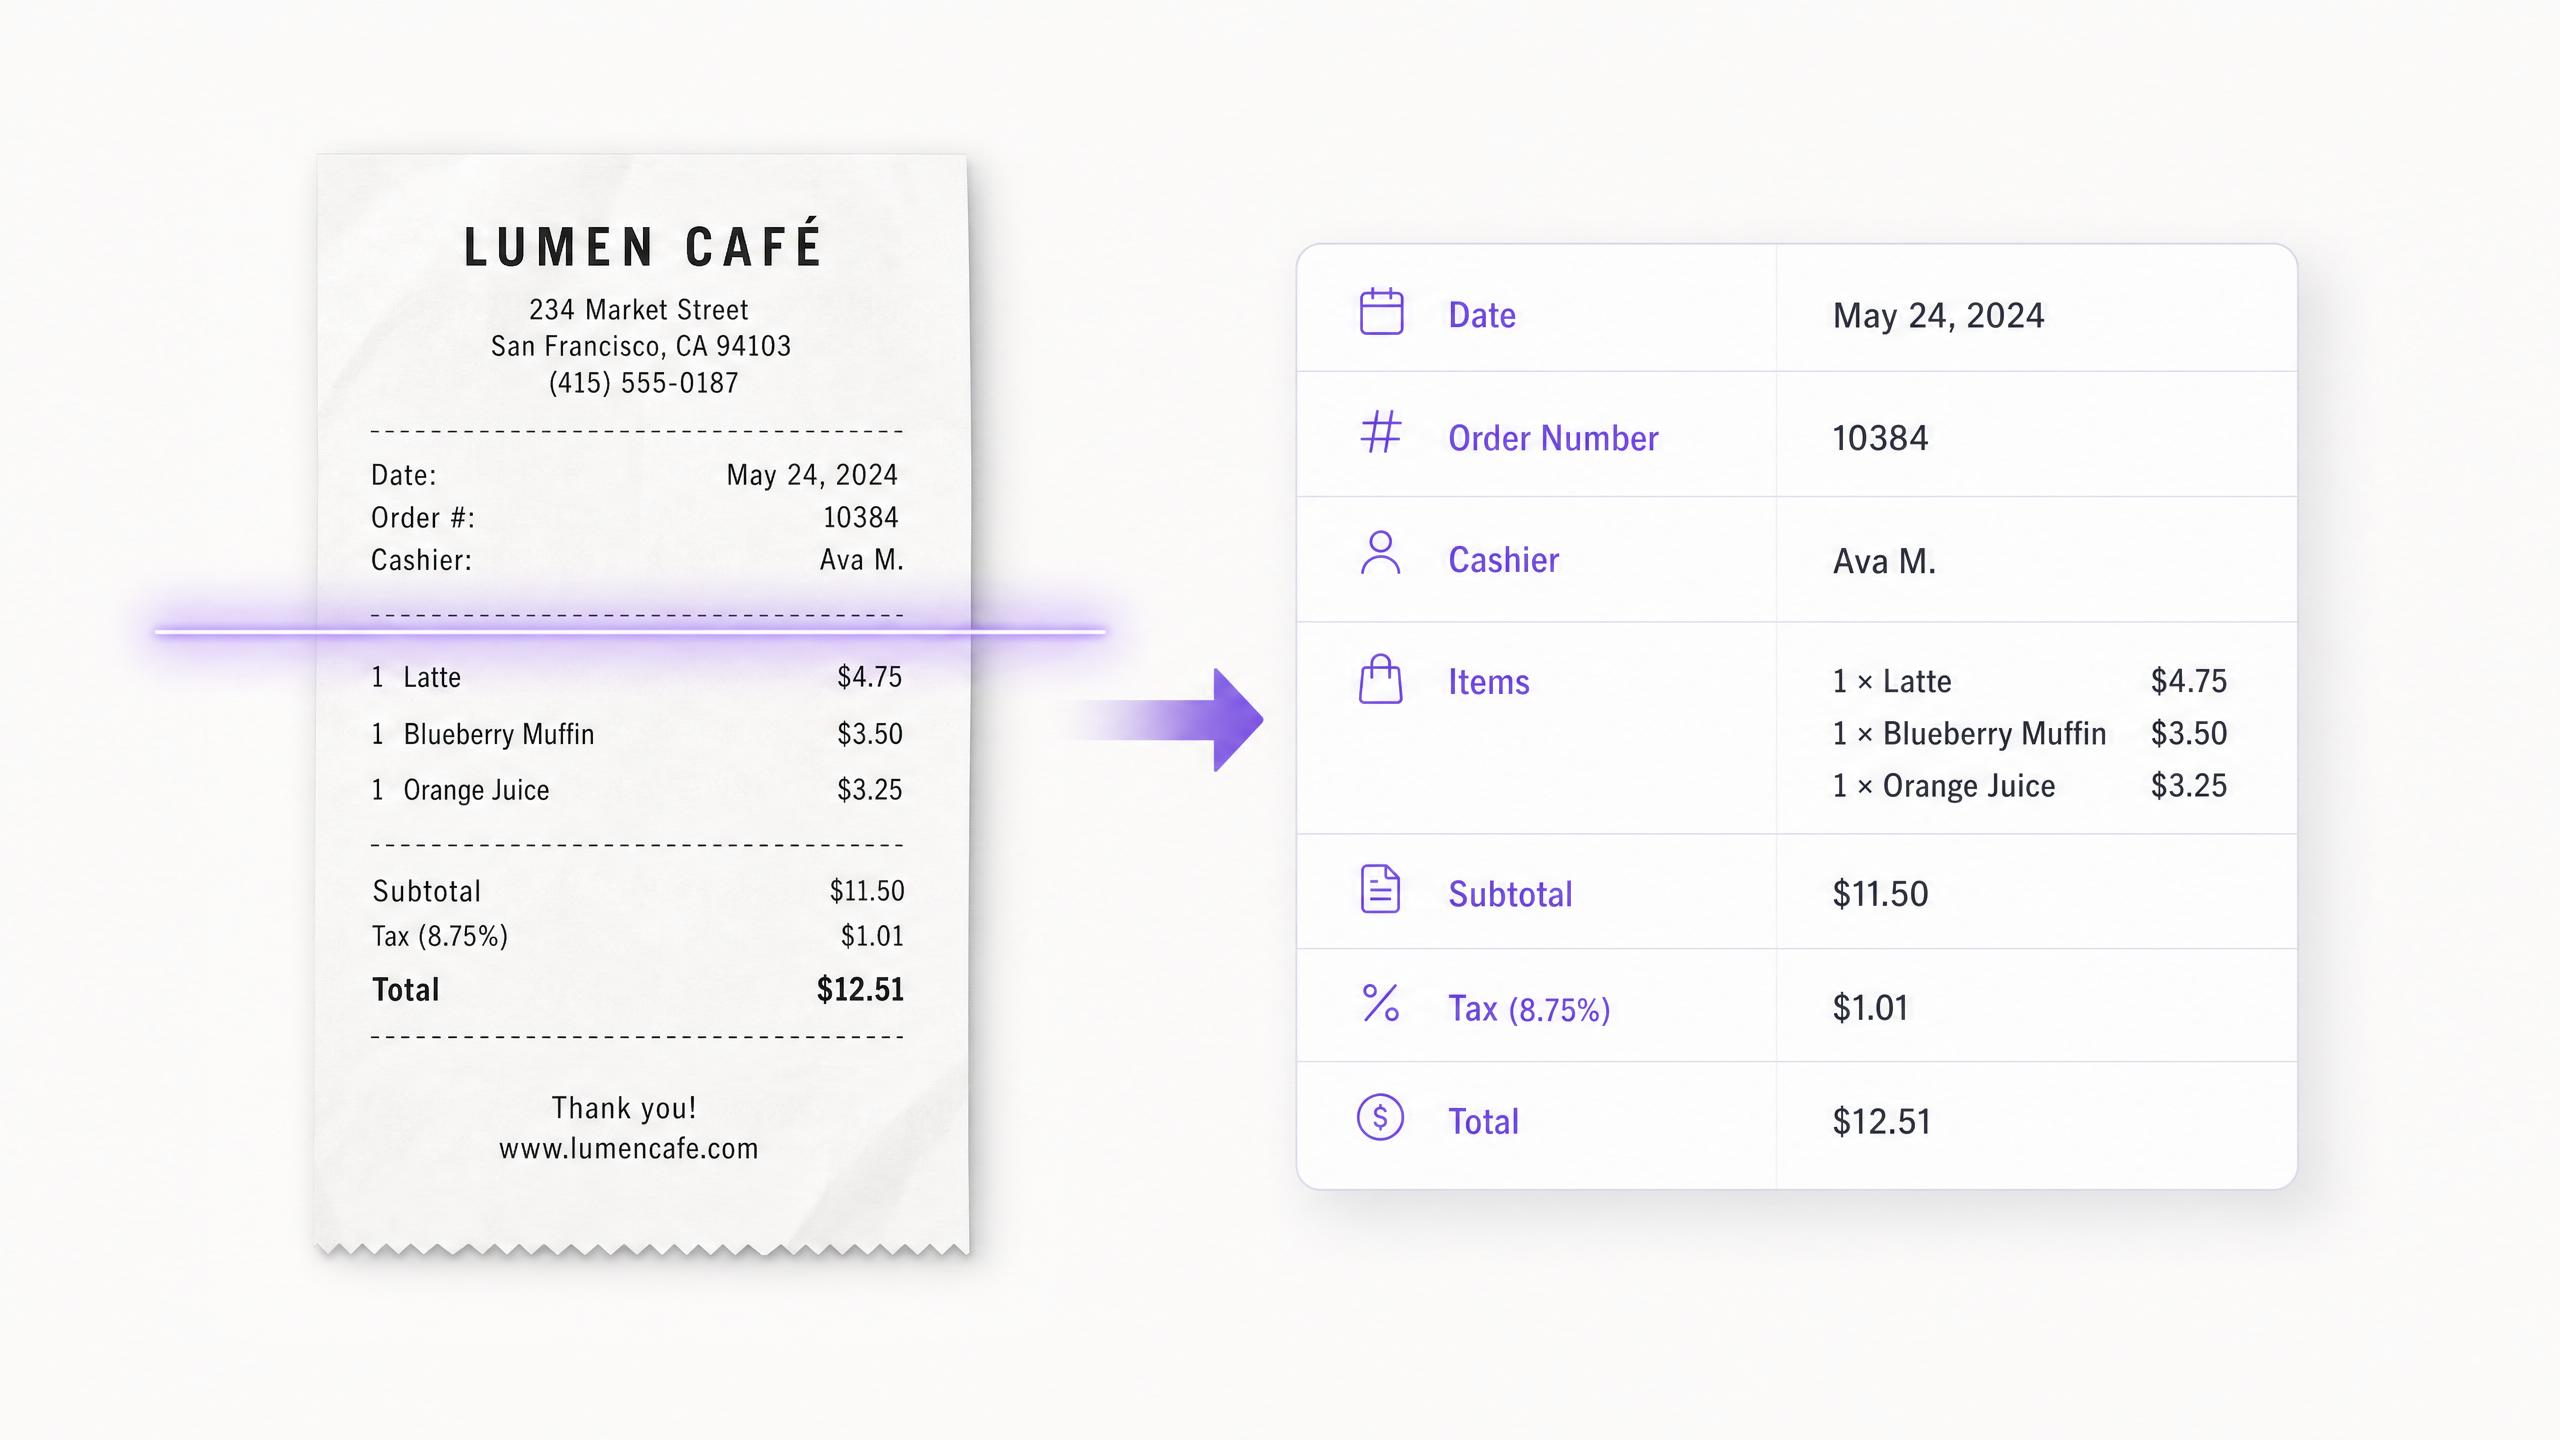
Structured Outputs and Vision with the Grok API
The Grok API returns structured JSON that matches your schema, so extracted data flows straight into downstream code. Grok 4.3 also accepts images alongside text, handling diagrams, screenshots, and UI mockups in the same call.
Coding with Grok Build 0.1
Grok Build 0.1 is xAI's coding-tuned model for code generation, debugging, and refactoring across developer workflows, with a 256K token context. It targets interactive coding agents and multi-step development tasks rather than general chat.
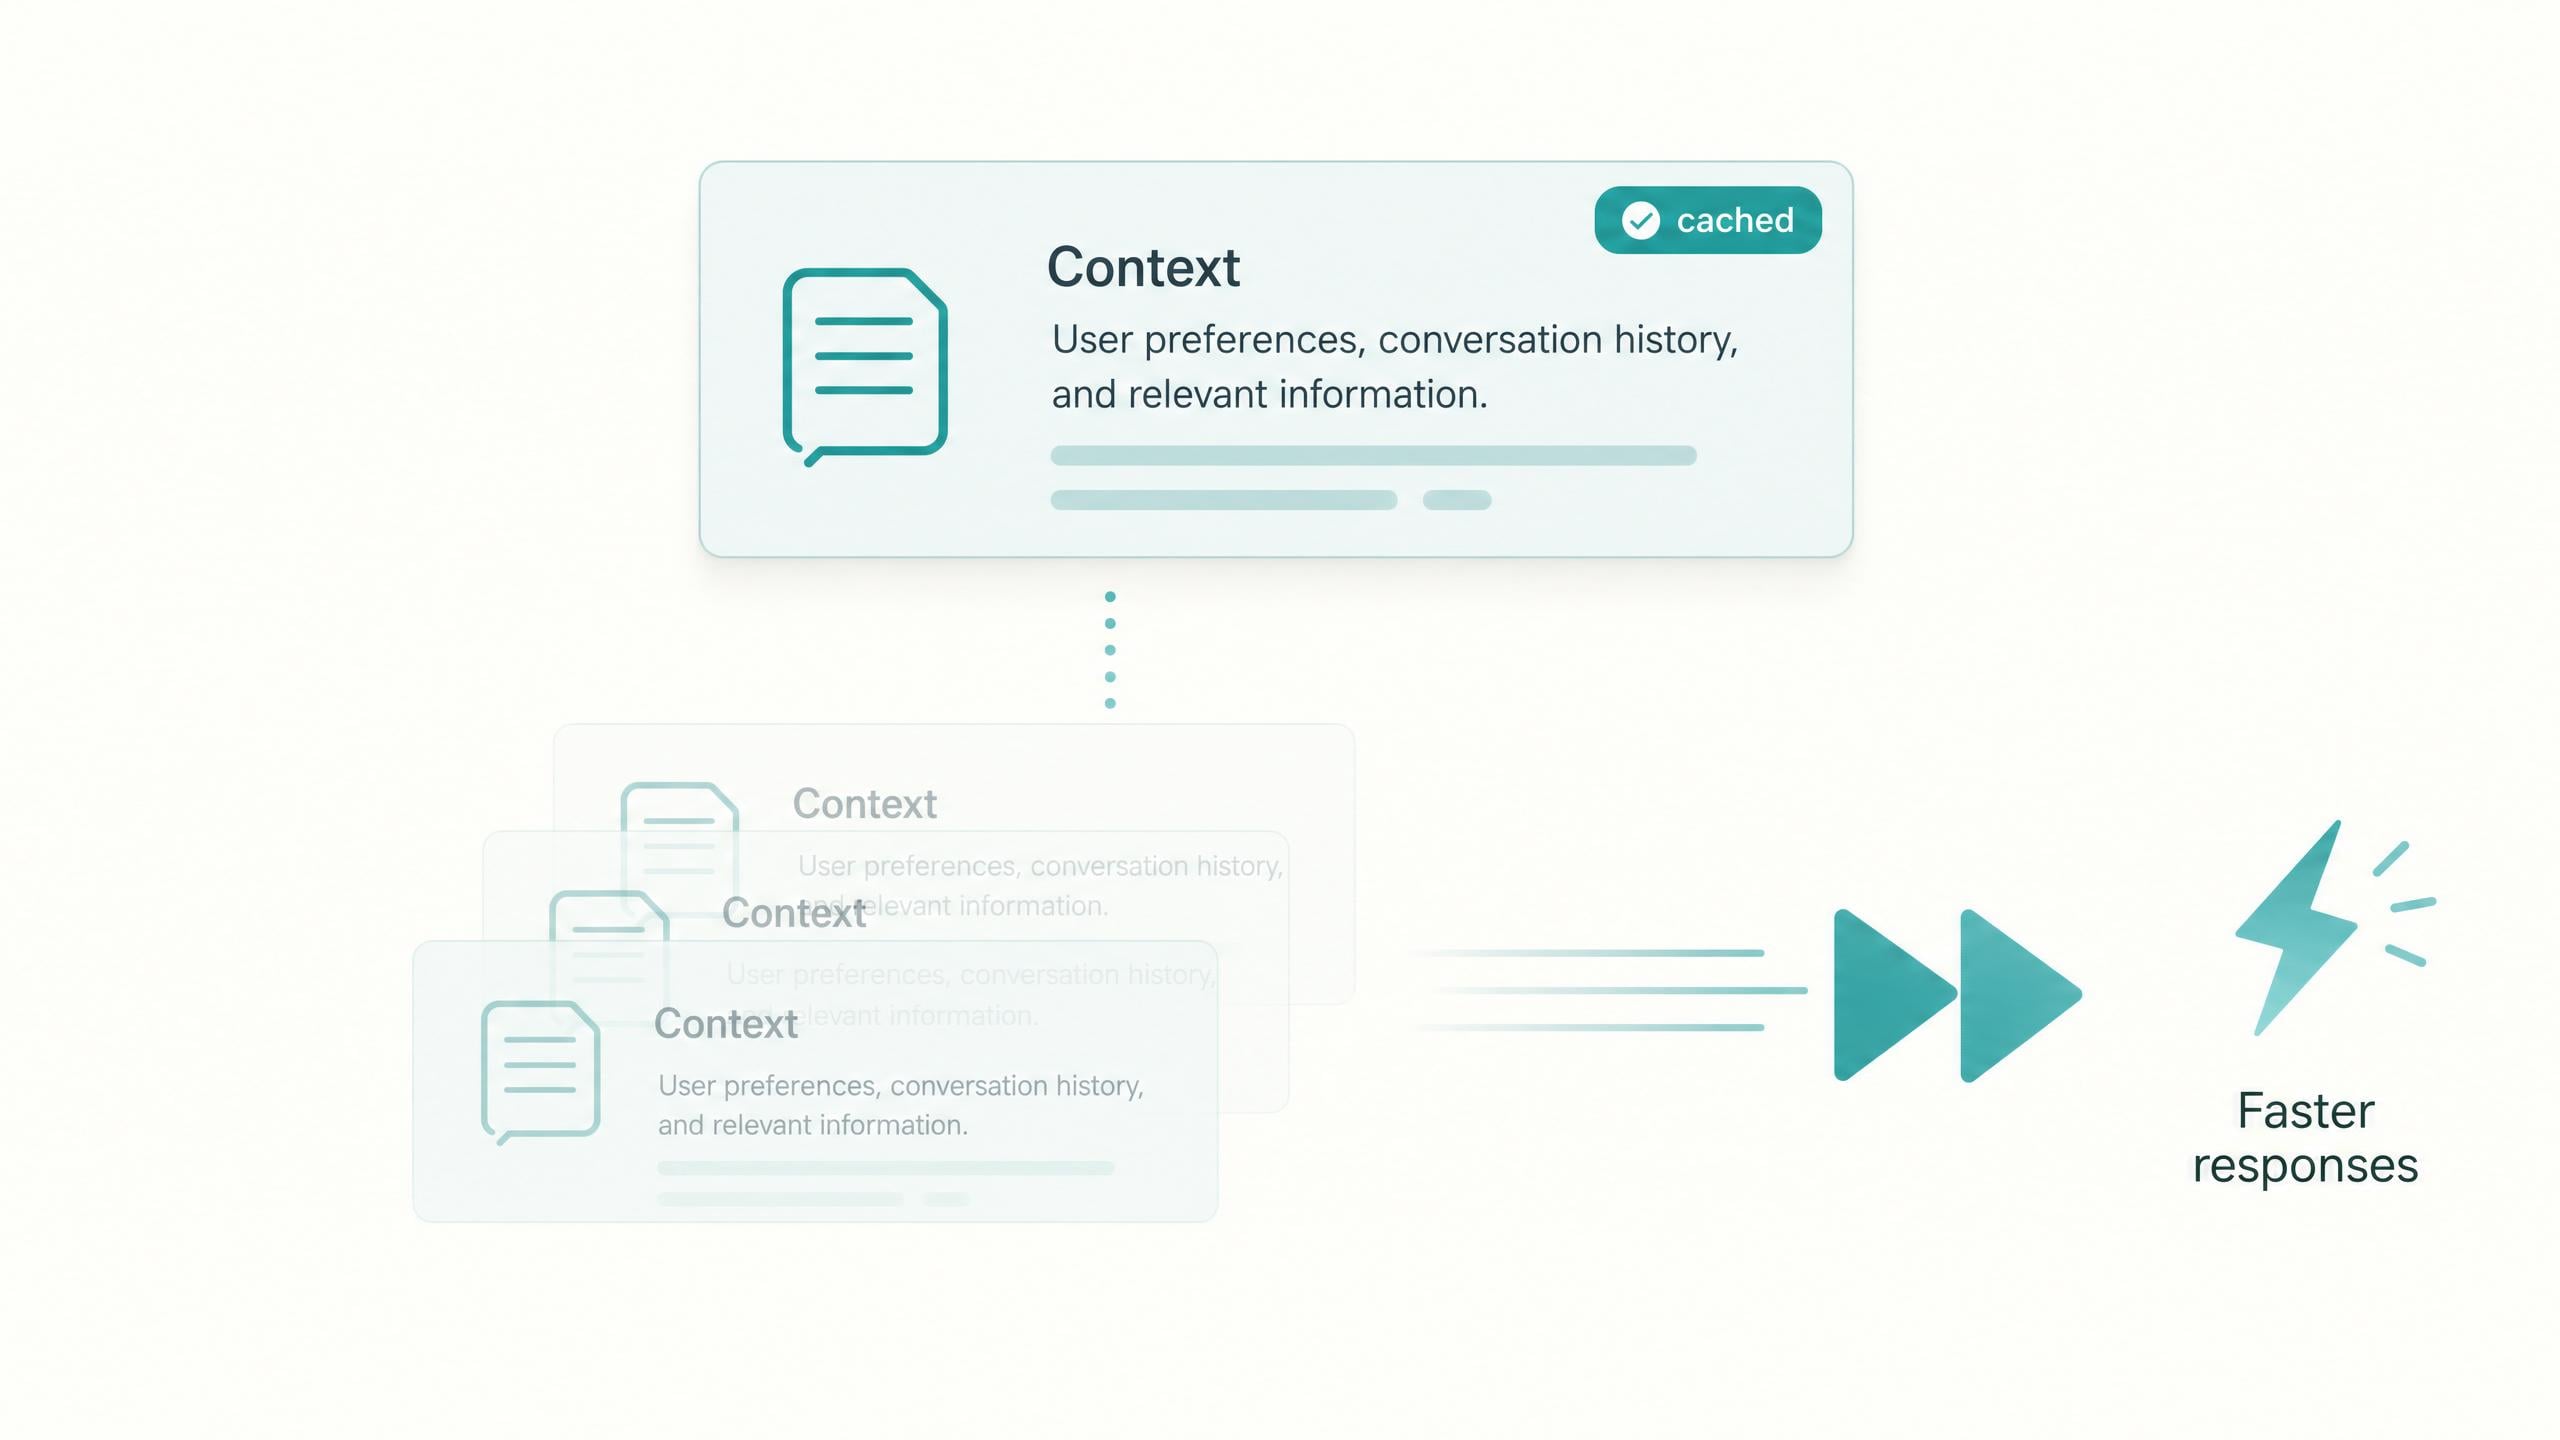
Prompt Caching on the Grok API
The Grok API supports prompt caching, which reuses a shared system prompt or context prefix at a lower token rate. For agentic loops that send the same instructions across many calls, this cuts repeated input cost without changing your code.
Um único prompt de construção em vários modelos
Forneça o mesmo prompt de construção ao Grok e aos outros modelos no Atlas Cloud, e observe cada um gerar uma página web completa e executável, para que você possa comparar o estilo de codificação e os resultados lado a lado.
Crie um único arquivo HTML independente que mostre um sistema solar 3D interativo usando Three.js de uma CDN. Renderize o sol e os oito planetas em órbita com texturas aproximadas por cores e brilho, órbitas animadas e um fundo de campo estelar. Permita que o usuário gire e aplique zoom na câmera com o mouse, e clique em um planeta para que a câmera voe suavemente até ele e exiba suas estatísticas. Inclua um título sobreposto elegante e um controle para acelerar ou desacelerar o tempo. Mantenha tudo em um único arquivo HTML com a importação via CDN do Three.js. Priorize um visual cinematográfico e impressionante.
Grok 4.3
GLM 5
Grok Build 0.1
Crie um único arquivo HTML independente que seja um painel de análises animado. Inclua um gráfico de barras animado, um gráfico de linhas que se desenha ao carregar, um gráfico de rosca e cartões de estatísticas de resumo com contagem crescente. Use dados de amostra codificados diretamente, animações de entrada suaves e um layout de painel escuro, moderno e limpo. Adicione uma dica de ferramenta sutil ao passar o mouse em cada elemento do gráfico. Use apenas CSS inline e JavaScript puro com canvas ou SVG, sem bibliotecas externas. Faça com que pareça um painel SaaS premium.
Grok 4.3
GLM 5
Grok Build 0.1
O que você pode fazer com a API Grok LLM no Atlas Cloud
O Grok 4.3 combina uma janela de contexto de 1 milhão de tokens com pesquisa na web e no X em tempo real, tornando-o prático para fluxos de trabalho de produção que precisam de informações atualizadas juntamente com raciocínio profundo.

Pipelines de pesquisa e inteligência em tempo real
As equipes que desenvolvem ferramentas de pesquisa usam os complementos Web Search e X Search do Grok 4.3 para extrair dados em tempo real da web e do X diretamente para a geração, sem uma camada de recuperação separada. Isso é útil para análise competitiva, resumo de notícias e fluxos de trabalho de inteligência de mercado onde a resposta depende de informações publicadas após o limite de treinamento do modelo. Web Search e X Search são faturados a US$ 5 por 1.000 chamadas na API xAI.

Backend de LLM de produção com eficiência de custos
As equipes de engenharia que mudam do GPT-4.1 ou Claude Sonnet usam o Grok 4.3 como um substituto direto através do endpoint da Atlas Cloud compatível com OpenAI. A US$ 1,25 por milhão de tokens de entrada, o Grok 4.3 é aproximadamente 37% mais barato que o GPT-4.1 e 58% mais barato que o Claude Sonnet 4.6 na entrada. A migração requer apenas a alteração da base URL e da chave de API no código SDK existente.

Análise de documentos longos com contexto de 1M
Equipes jurídicas, financeiras e de pesquisa usam a janela de contexto de 1 milhão de tokens do Grok 4.3 para processar conjuntos completos de contratos, relatórios financeiros ou documentação técnica em uma única chamada de API. O amplo contexto elimina a necessidade de pipelines de recuperação em blocos e preserva o raciocínio entre documentos que modelos de contexto mais curto quebram. O cache de prompts reduz ainda mais os custos quando o mesmo contexto de documento é reutilizado em várias chamadas de análise.

Codificação Multimodal e Análise Visual
Os desenvolvedores usam a compreensão de imagens do Grok 4.3 para passar diagramas, capturas de tela, mockups de interface do usuário e logs de erro junto com texto na mesma chamada de API. Isso é útil para fluxos de trabalho de depuração em que a captura de tela de um erro ou um diagrama de arquitetura de sistema fornece um contexto que apenas o texto não consegue. A chamada de função e as saídas estruturadas são suportadas na mesma chamada, portanto, os dados visuais extraídos podem ser retornados em um esquema pronto para processamento posterior.

Execução de Tarefas em Múltiplas Etapas Baseada em Agentes
As equipes de produto usam a otimização de agentes do Grok 4.3 para construir agentes que planejam, executam e iteram por múltiplas etapas sem a necessidade de comandos humanos entre elas. O modelo é especificamente ajustado para a decomposição de tarefas complexas — dividindo um objetivo de alto nível em subtarefas, chamando ferramentas em sequência e ajustando-se com base em resultados intermediários. Combinado com a chamada de função e o complemento Web Search, isso abrange fluxos de trabalho de pesquisa até a produção, como "encontrar concorrentes, analisar preços, redigir um relatório de comparação" em uma única execução do agente.

Execução de código em contexto para análise de dados
As equipes de dados e análise usam o Grok 4.3 com o complemento Code Execution para executar Python diretamente na chamada de inferência, processar dados e retornar resultados computados junto com o raciocínio do modelo. Isso elimina a necessidade de um ambiente de execução de código separado ao criar ferramentas de análise de dados ou pipelines de relatórios automatizados. O Code Execution é cobrado a US$ 5 por 1.000 chamadas na xAI API, separadamente dos custos de tokens.
Comparativo da Grok API
Veja como a Grok API se compara a outros LLMs líderes na Atlas Cloud por contexto, entradas e foco, para que você possa direcionar cada tarefa para o modelo adequado, tudo sob uma única chave.
| Model | Provider | Context Window | Inputs | Best For |
|---|---|---|---|---|
| Grok 4.3 | xAI | 1M tokens | Text | Agentic reasoning, long-document analysis, high factual accuracy |
| Grok Build 0.1 | xAI | 256K tokens | Text | Code generation, debugging, refactoring |
| DeepSeek V4 Pro | DeepSeek | 1M tokens | Text | Cost-efficient reasoning and agentic tool use at scale |
| Kimi K2.6 | Moonshot | 262K tokens | Text, image | Long-horizon coding agents and multimodal workflows |
| GLM 5.2 | Z.ai | 202.8K tokens | Text | Long-horizon agentic engineering and project-scale coding |
Como Usar Grok no Atlas Cloud
Comece em minutos — siga estes passos simples para integrar e implantar modelos pela plataforma da Atlas Cloud.
Crie uma Conta no Atlas Cloud
Cadastre-se em atlascloud.ai e conclua a verificação. Novos usuários recebem créditos gratuitos para explorar a plataforma e testar modelos.
Por Que Usar Grok no Atlas Cloud
Combine modelos avançados de Grok com a plataforma acelerada por GPU do Atlas Cloud, fornecendo desempenho, escalabilidade e experiência de desenvolvimento incomparáveis.
Desempenho e Flexibilidade
Baixa Latência:
Inferência otimizada por GPU para respostas em tempo real.
API Unificada:
Uma única integração para acessar Grok, GPT, Gemini e DeepSeek.
Preços Transparentes:
Faturamento por Token, suporta modo Serverless.
Empresa e Escala
Experiência do Desenvolvedor:
SDK, análise de dados, ferramentas de ajuste fino e modelos tudo em um.
Confiabilidade:
99.99% de disponibilidade, controle de permissões RBAC, logs de conformidade.
Segurança e Conformidade:
Certificação SOC 2 Type II, conformidade HIPAA, soberania de dados nos EUA.
Perguntas frequentes sobre o Grok LLM
O Atlas Cloud hospeda o Grok 4.3, o atual LLM principal da xAI, disponível a US$ 1,25 por milhão de tokens de entrada. O modelo suporta chat, raciocínio, chamada de função, saídas estruturadas e compreensão de imagens em uma única API. Verifique a página da coleção xAI do Atlas Cloud para ver quaisquer versões adicionais do Grok à medida que são adicionadas.
O Grok 4.3 suporta uma janela de contexto de 1 milhão de tokens. Isso é grande o suficiente para processar bases de código completas, documentos de pesquisa extensos ou sessões prolongadas de agentes de múltiplos turnos em uma única chamada. O limite de contexto aplica-se a entradas de texto e imagem combinadas.
Sim. A API da xAI suporta Web Search e X Search como complementos opcionais, faturados separadamente a US$ 5 por 1.000 chamadas. Isso permite que o Grok recupere informações em tempo real da web ou do X durante uma geração. Acesse esses recursos por meio do endpoint padrão da API junto com suas chamadas de API regulares.
Sim. A API da xAI suporta o cache de prompts, o que reduz o custo de solicitações que reutilizam o mesmo prompt de sistema ou prefixo de contexto. Os tokens de entrada em cache são faturados a uma taxa significativamente mais baixa do que os tokens não armazenados em cache. Isso é particularmente útil para fluxos de trabalho de agentes que enviam as mesmas instruções em várias chamadas.
Sim. O Grok 4.3 suporta entrada multimodal, aceitando imagens junto com texto na mesma chamada de API. Você pode passar URLs de imagens ou imagens codificadas em base64 por meio do formato padrão de mensagens. Isso permite casos de uso como respostas a perguntas visuais, análise de documentos e geração de código guiada por imagens.
Sim. O Grok 4.3 suporta chamadas de função, saídas estruturadas e respostas em streaming. Esses recursos funcionam com o esquema de funções padrão compatível com a OpenAI, de modo que as definições de ferramentas existentes de integrações baseadas em GPT são transferidas diretamente. A execução de código também está disponível como um complemento opcional a US$ 5 por 1.000 chamadas.
O cache de prompt reutiliza um prefixo de contexto repetido, como um prompt de sistema longo ou instruções compartilhadas, com uma taxa de tokens de entrada reduzida em chamadas subsequentes. Para chatbots e agentes que reenviam a mesma configuração em cada solicitação, isso reduz o custo de entradas repetidas sem alterar seu código. Coloque o conteúdo estático no início do prompt e o conteúdo variável do usuário no final para que o cache seja aplicado.
Os limites de taxa e a simultaneidade variam de acordo com o nível da conta, portanto, adicione um recuo exponencial e uma nova tentativa em uma resposta 429, e coloque as solicitações em fila durante os picos de tráfego. Para grandes trabalhos offline, o processamento em lote mantém o trabalho em massa fora dos seus limites de tempo real. Um custo oculto comum em escala é reenviar o histórico completo da conversa em cada chamada, portanto, passe um resumo compacto em vez de todo o tópico e entre em contato com o suporte para aumentar os limites à medida que cresce.
A API do Grok usa faturamento pré-pago baseado no uso de tokens, com tokens de entrada e saída medidos por solicitação e sem necessidade de assinatura. Executar o Grok ao lado de mais de 300 outros modelos no Atlas Cloud significa ter uma única conta e uma única fatura, em vez de contratos separados por provedor. O cache de prompts e o processamento em lote podem reduzir o custo efetivo em cargas de trabalho repetitivas ou offline.
Crie uma conta na Atlas Cloud, gere uma chave de API e direcione seu cliente existente compatível com OpenAI para o endpoint da Atlas com o nome do modelo Grok. Envie sua primeira solicitação para o Grok 4.3 para raciocínio ou para o Grok Build 0.1 para codificação e, em seguida, expanda conforme necessário. Como a mesma chave acessa mais de 300 modelos, você pode testar outros modelos sem nenhuma configuração extra.
Explorar Mais Séries
Seedance 2.5
A API do Seedance 2.5 já está disponível no Atlas Cloud! Ela oferece aos desenvolvedores o mais novo modelo de vídeo da ByteDance. Ele gera até 30 segundos de vídeo nativo em uma única passagem a partir de texto, uma única imagem ou até 50 referências multimodais, com áudio sincronizado e texto multilíngue no quadro. No Atlas Cloud, você o acessa por meio de uma única chave, com consistência de sujeito e física aprimorada mantendo a coerência em tomadas longas.

Wan 3.0
A API Wan 3.0 é a próxima geração da família de vídeos Wan da Alibaba, desenvolvida para elevar a geração de formato longo, o controle de múltiplas referências e a qualidade audiovisual a novos patamares. O Atlas Cloud já hospeda o Wan 2.7, 2.6 e 2.5, e o Wan 3.0 funciona com a mesma chave unificada, sem necessidade de configuração separada. Comece a construir hoje mesmo. Role a tela para baixo até a vitrine para ver o que o Wan 3.0 pode criar.
MiniMax H3
MiniMax H3 é a família de modelos de vídeo da MiniMax para geração orientada por texto, imagem e referências. Crie clipes de 5 a 15 segundos, oriente o movimento com um último quadro opcional, preserve os elementos das imagens de referência ou selecione H3 Developer quando o áudio gerado se adequar ao fluxo de trabalho. O Atlas Cloud reúne H3, H3 Fast, H3 Max e H3 Developer em um único fluxo de trabalho de API, com preços padrão a partir de $0.038 por segundo. Comece a desenvolver hoje.
Seedream 5.0 Pro
A API do Seedream 5.0 Pro fornece aos desenvolvedores o modelo de edição de imagens controlável da ByteDance no Atlas Cloud. Ela posiciona as edições com precisão usando âncoras e coordenadas, separa as imagens em camadas editáveis, funde múltiplas referências e combina cores e materiais exatos, com texto multilíngue em 2K e 3K. No Atlas Cloud, você pode acessá-lo por meio de uma única chave!
Seedance 2.0
A API do Seedance 2.0 oferece acesso de produção ao modelo de vídeo multimodal da ByteDance — entradas quadrimodais (texto, imagem, vídeo, áudio) e um sistema "Universal Reference" líder do setor que fixa a composição, o movimento da câmera e as ações dos personagens entre as cenas. Integre um controle de nível de diretor com uma única chamada de API, uma taxa fixa de $0,09/s, chave instantânea e sem lista de espera — respaldado por tempo de atividade e conformidade de nível corporativo. O Seedance 2.0 Native 4K já está no ar!
GPT Image 2.5
A família gpt-image-2.5 da OpenAI oferece aos desenvolvedores a opção entre Flare e Sunburst para fluxos de trabalho de imagens em produção. Renderize em resoluções arbitrárias de até 3840x2160 e escolha entre cinco níveis de qualidade, incluindo xhigh e max, para atender a requisitos específicos de saída. A Atlas Cloud oferece inferência REST pronta para uso, sem cold starts, com preços padrão a partir de US$ 0,004 por geração. Comece a criar hoje.
GPT Image 2
A API do GPT Image 2 dá aos desenvolvedores acesso ao mais recente modelo de imagem da OpenAI, o sucessor do GPT Image 1.5. Ele gera e edita imagens com renderização de texto precisa em caracteres latinos e CJK, além de uma forte composição para pôsteres, mockups e infográficos. Na Atlas Cloud, você o acessa através de uma API unificada junto a mais de 300 modelos, com créditos gratuitos, 99,99% de tempo de atividade e sem a necessidade de verificação de organização da OpenAI.
Gemini Omni Flash
A API gemini omni oferece aos desenvolvedores a família Gemini Omni Flash nativamente multimodal do Google DeepMind, incluindo o Gemini Omni 1.1 Flash. Crie vídeos cinematográficos com áudio nativo sincronizado, anime imagens estáticas com controle preciso dos frames inicial e final ou edite vídeos existentes por meio de edições guiadas por texto que preservam o conteúdo não alterado. A Atlas Cloud fornece uma única chave compatível com OpenAI, acesso unificado e preços transparentes conforme o uso. Comece a desenvolver hoje.
Grok Imagine
A API Grok Imagine cobre os modelos de imagem, vídeo e fala da xAI, desde Image 2.0 até Video 1.5 e xAI TTS v1. Renderize imagens estáticas em 1K ou 2K em 14 proporções de aspecto, estenda uma cena para 15 segundos de movimento em 1080p, controle os planos com até 7 imagens de referência ou narre-os em 20 idiomas. O Atlas Cloud executa todos os modos em um único endpoint, com preço por uso a partir de $0.02 por imagem e $0.05 por segundo. Comece a construir hoje.
Os modelos criativos mais poderosos do Google estão todos disponíveis na Atlas Cloud. O Veo 3.1 oferece geração de vídeo cinematográfico, o Nano Banana 2 impulsiona a criação de imagens de alta fidelidade e o Gemini traz inteligência multimodal para cada fluxo de trabalho. Acesse o pacote completo de modelos do Google por meio de uma única API key com disponibilidade Day-0 e preços de pagamento conforme o uso (pay-as-you-go).
Seedance 2.0 Mini
O Seedance 2.0 Mini leva a geração de vídeo multimodal da ByteDance para fluxos de trabalho onde a velocidade e o custo são essenciais. Ele oferece os principais recursos do Seedance 2.0 com menor impacto — geração mais rápida, menor custo por vídeo e a mesma integração de API que você já usa. Para equipes que executam pipelines de alto volume ou prototipagem em escala, o Mini é a opção padrão prática.
ByteDance
Da geração de vídeo cinematográfico à criação de imagens de alta fidelidade, os modelos mais poderosos da ByteDance estão disponíveis no Atlas Cloud. Execute o Seedance e o Seedream em grande escala com os preços de inferência mais baixos e zero custos indiretos de infraestrutura.
Artigos recomendados
Guias, tutoriais e novidades de produto para você aproveitar ao máximo a Atlas Cloud.


