
GLM API for Autonomous Task Execution
GLM é a principal série de LLMs da Z.ai, da Zhipu AI, e a GLM API abrange desde o GLM-5 agêntico até o eficiente GLM-4.6 MoE de 357B. Esses modelos são especializados em execução autônoma de tarefas, orquestração complexa de agentes e programação em nível de produção. No Atlas Cloud, um único endpoint unificado oferece acesso Day-0 a toda a família GLM, com preços baseados no uso e disponibilidade confiável para produção. Comece a criar hoje mesmo.
GLM foi desenvolvido pela Z.ai. A Atlas Cloud (operada pela Atlas Cloud AI LLC) fornece acesso ao modelo, mas não é sua proprietária. Todas as marcas registradas pertencem aos seus respectivos titulares.
Explorar Modelos Líderes
O Atlas Cloud oferece os modelos criativos mais avançados e inovadores do setor.
Comparação dos modelos GLM API: do GLM-4.6 ao GLM-5.2
Associe cada endpoint à sua carga de trabalho e ao seu orçamento.
| Modalidade | Descrição |
|---|---|
| GLM-5.2 | Concebido especificamente como um modelo orientado a agentes, o GLM-5.2 transforma prompts em linguagem natural e contexto de chamadas de ferramentas em raciocínio estruturado, chamadas de função e execução autónoma de tarefas. Está ajustado para problemas complexos em que o modelo tem de planear, agir e iterar por conta própria. Use-o ao criar agentes autónomos e workflows de longo prazo com utilização de ferramentas, ao preço de $1.4 per million input tokens and $4.4 per million output tokens. |
| GLM-5.1 | Dê ao GLM-5.1 uma tarefa de programação ou um problema com várias etapas e ele devolve resultados de programação sólidos, juntamente com uma execução passo a passo estável. Sendo o mais recente flagship da Z.AI, também oferece conversas mais naturais e uma estética de front-end mais refinada. É adequado para equipas que criam apps web complexas e pipelines de agentes, com input at $1.4 and output at $4.4 per million tokens. |
| GLM-5v Turbo | O GLM-5v Turbo converte prompts de texto em conclusões rápidas, mantendo a programação melhorada e a execução multi-etapas estável do flagship. Esta variante turbo dá prioridade a uma latência mais baixa para produtos interativos e de elevado débito, sem comprometer o refinamento conversacional. Escolha-o quando a capacidade de resposta for o mais importante, a $1.2 per million input tokens and $4 per million output tokens. |
| GLM-5 Turbo | O texto entra e as conclusões saem rapidamente com o GLM-5 Turbo, um flagship otimizado para latência, criado para programação melhorada e raciocínio multi-etapas fiável. Mantém as respostas naturais e a geração de front-end limpa, ao mesmo tempo que acelera o débito para uso em tempo real. Ajusta-se bem a interfaces de chat e ciclos rápidos de agentes, faturado a $1.2 per million input tokens and $4 per million output tokens. |
| GLM-5 | O GLM-5 recebe instruções em texto e gera código, cadeias de raciocínio e respostas conversacionais como a versão flagship principal da Z.AI. As suas principais melhorias concentram-se numa programação mais robusta e numa execução multi-etapas mais estável em tarefas complexas de agentes. Uma opção equilibrada para desenvolvimento full-stack e raciocínio do dia a dia, disponível a $1 input and $3.2 output per million tokens. |
| GLM-4.7 | Peça ao GLM-4.7 tarefas de programação ou orquestração de agentes e ele responde com execução multi-etapas fiável e diálogo natural. Este modelo de nível flagship combina programação melhorada com output de front-end polido a um preço mais acessível. Adequa-se a cargas de trabalho de produção sensíveis a custos, faturado a $0.6 per million input tokens and $2.2 per million output tokens. |
| GLM-4.6 | Um modelo Mixture-of-Experts eficiente de 357B parâmetros da Zhipu AI, o GLM-4.6 mapeia prompts de texto para conclusões de alta qualidade com forte débito. O seu design MoE ativa apenas os especialistas de que cada pedido precisa, mantendo a inferência eficiente em tarefas de análise e conteúdo. Implemente-o para análise de dados, criação de slides e conteúdo web a $0.6 input and $2.2 output per million tokens. |
O que impulsiona a GLM API
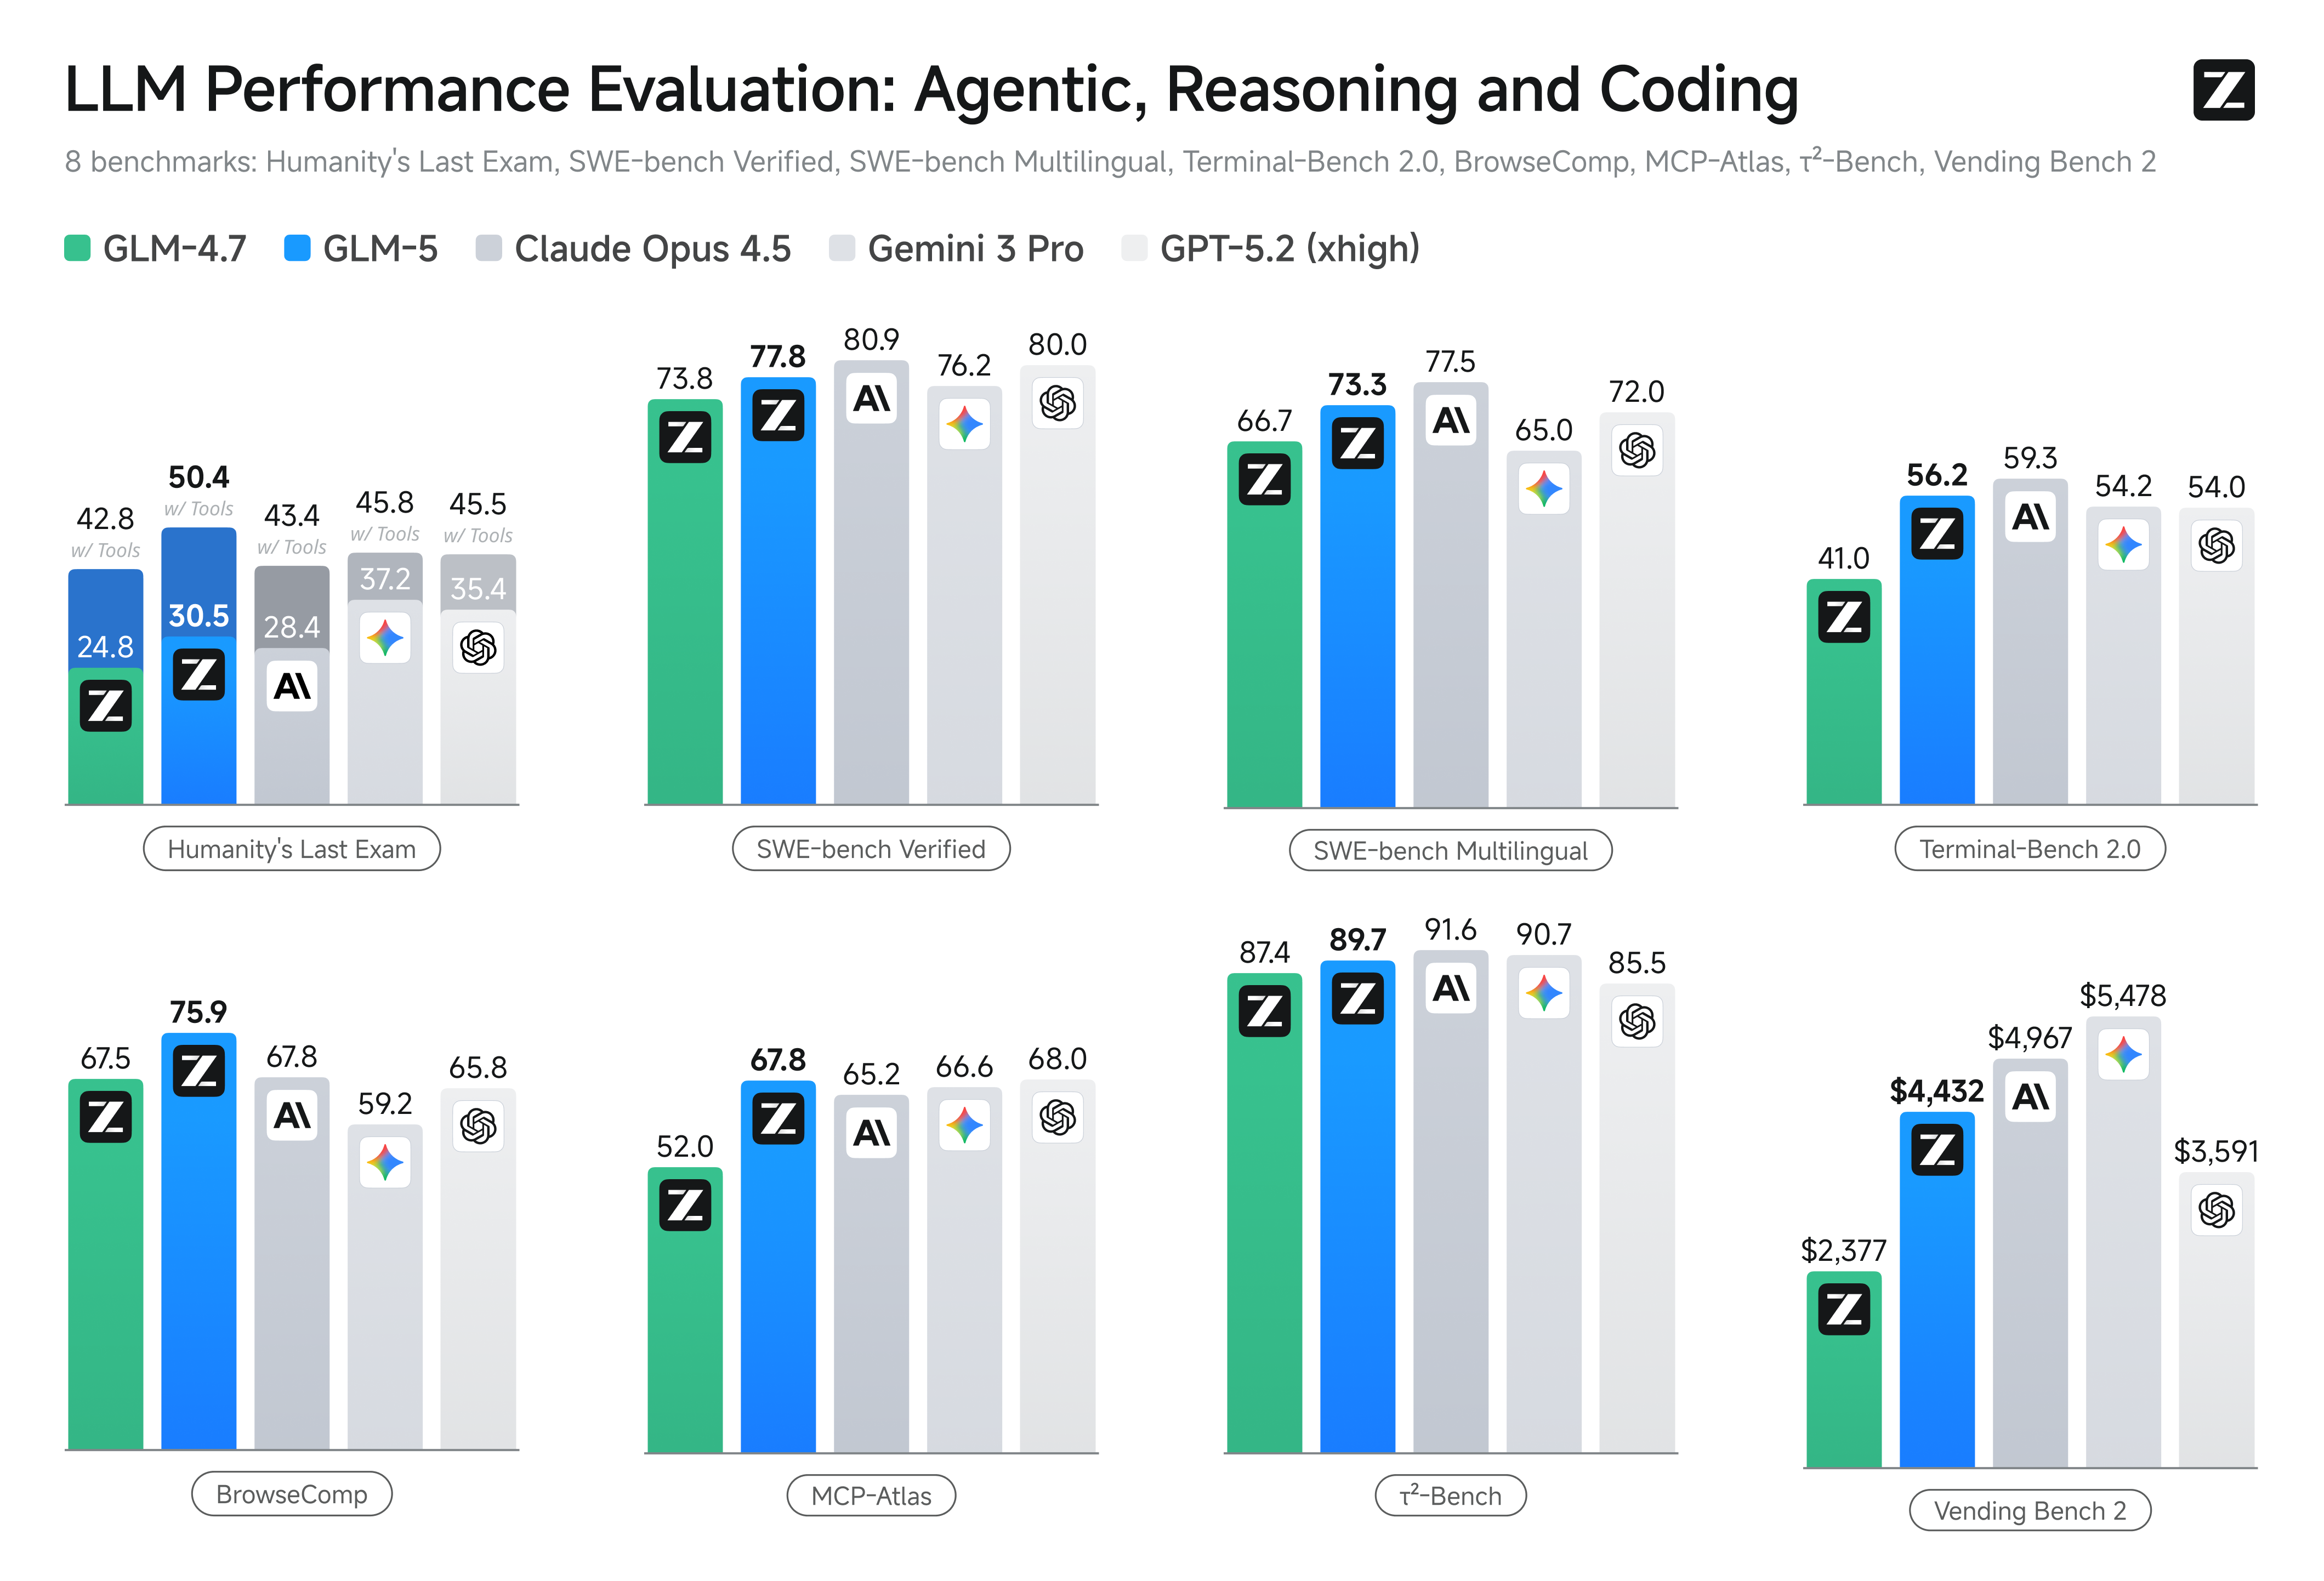
De um núcleo sparse Mixture-of-Experts e contexto de 200K tokens a tool calling nativo e modos de thinking alternáveis, a GLM API traz a stack flagship de raciocínio e programação da Z.ai por trás de um único endpoint compatível com OpenAI.
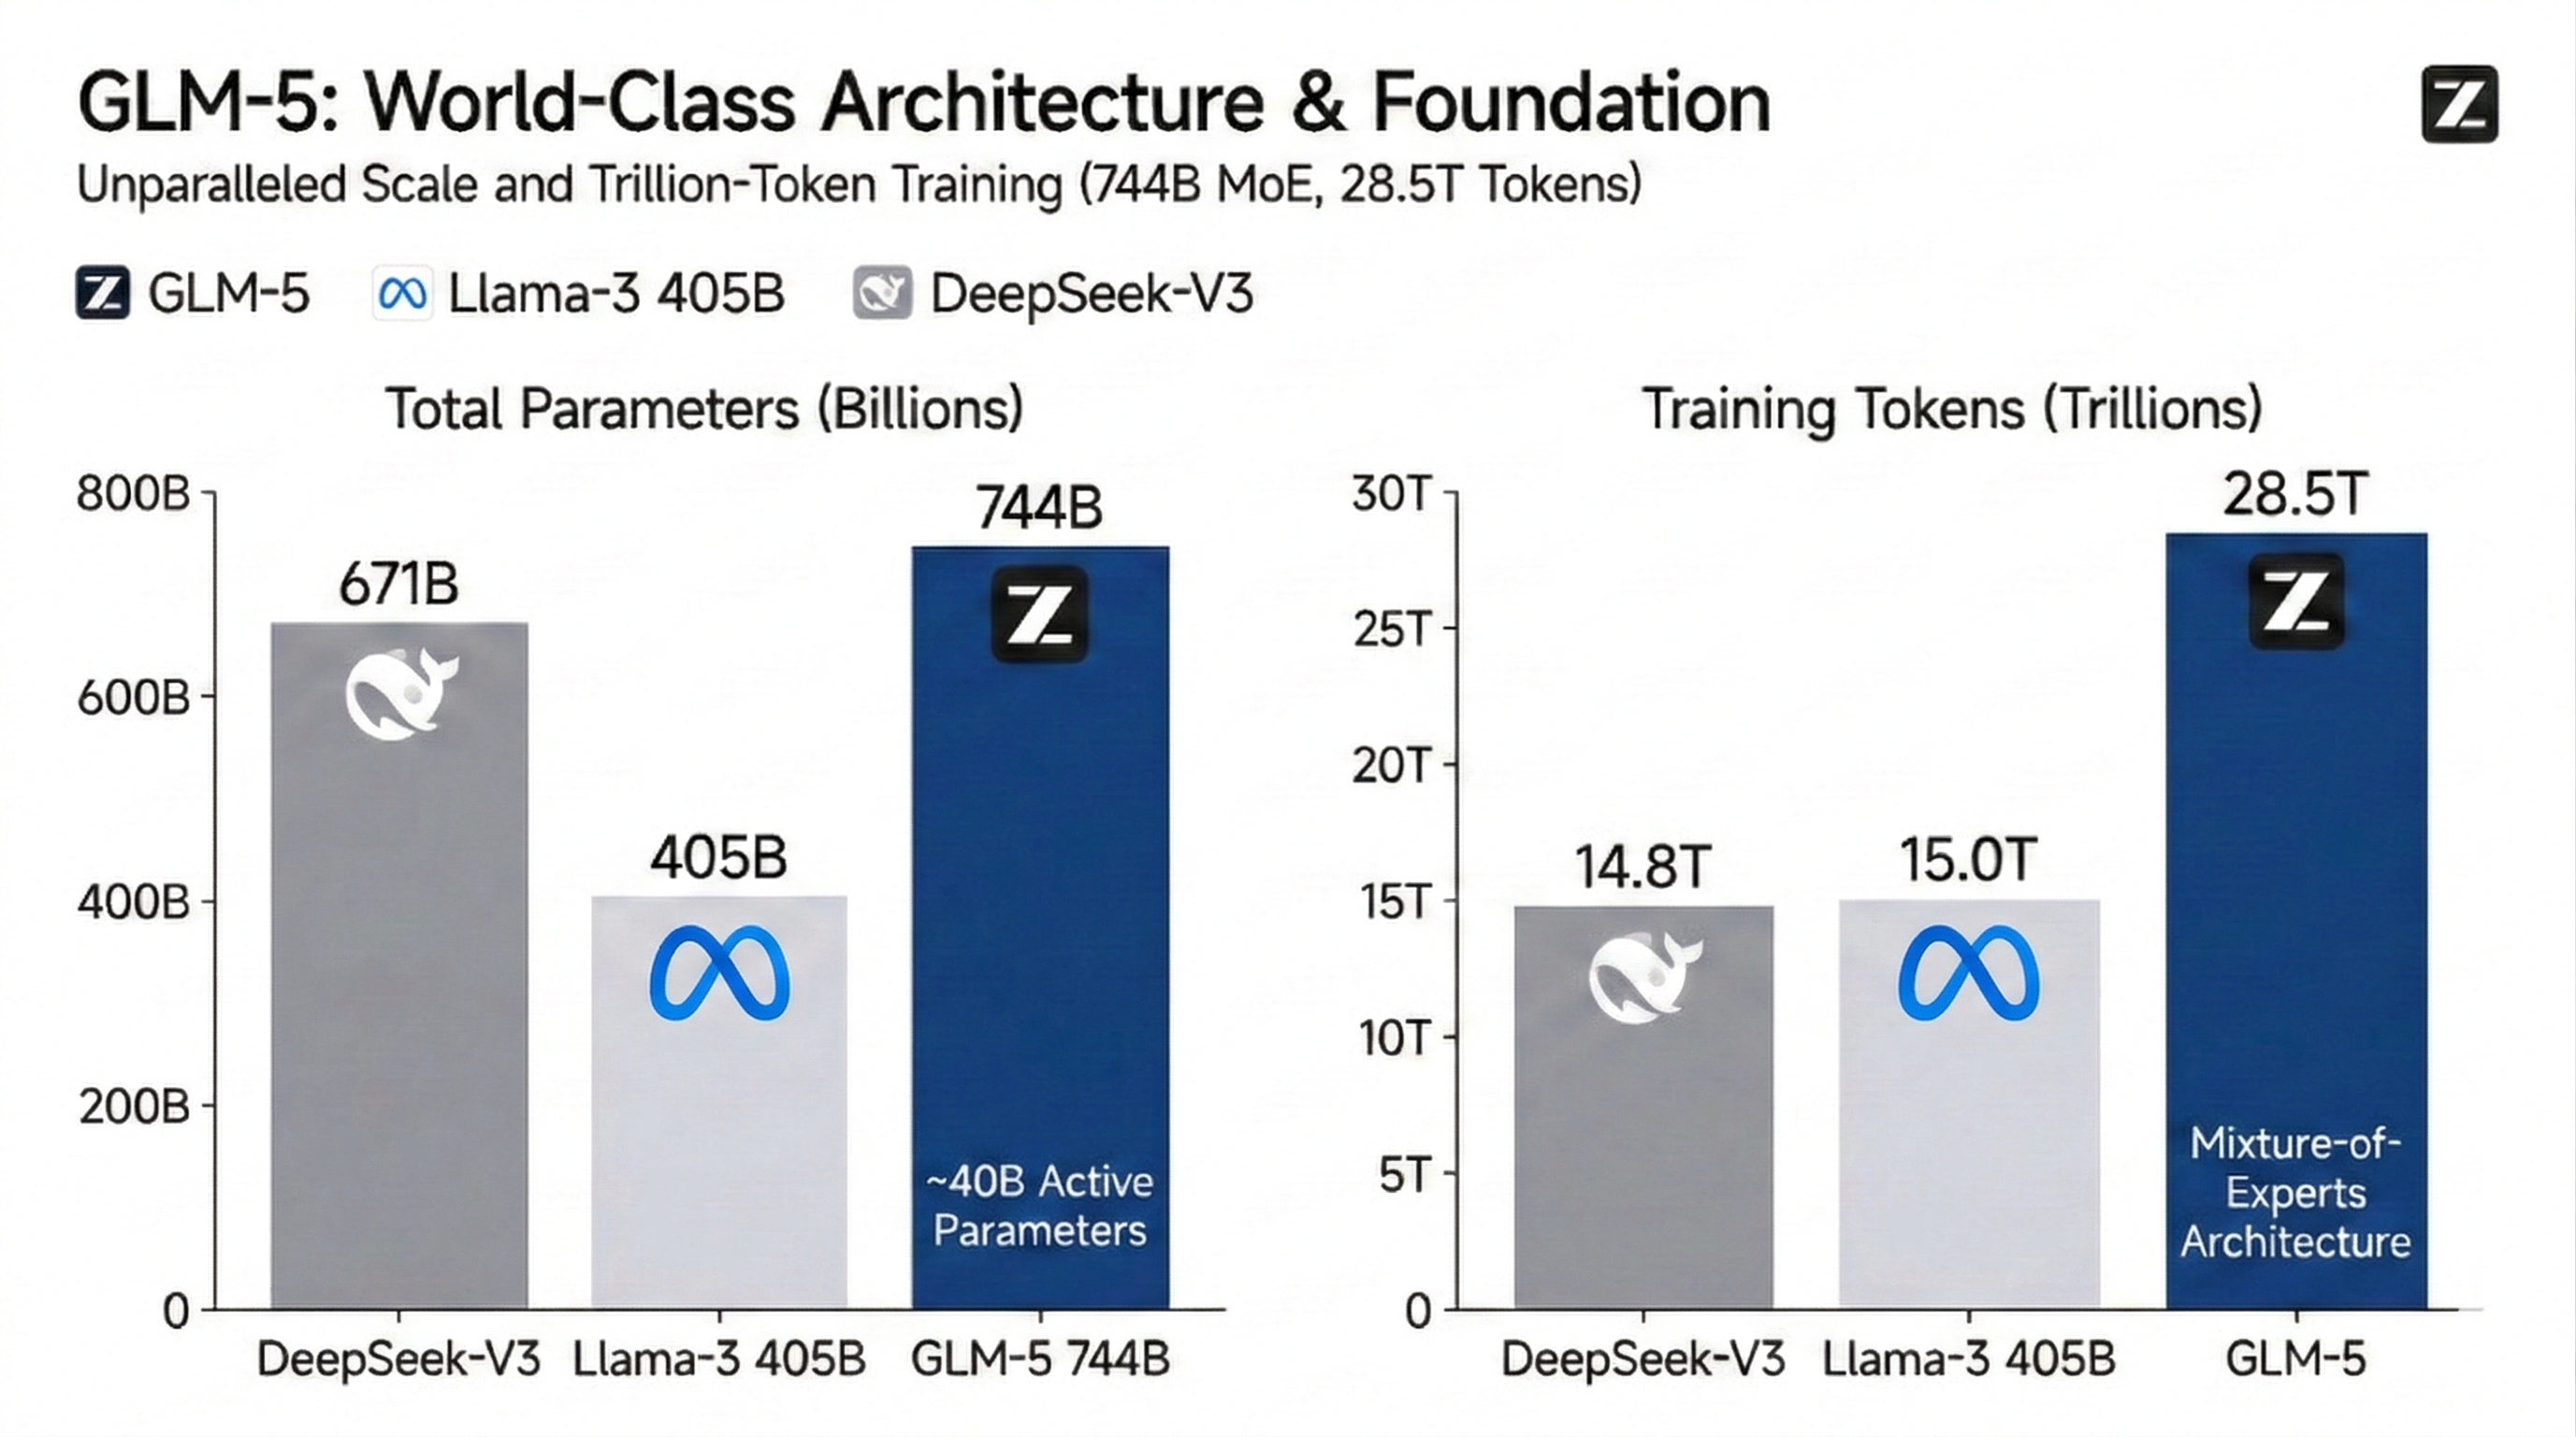
Sparse Mixture-of-Experts em escala
Um núcleo sparse Mixture-of-Experts ativa apenas cerca de 40 bilhões de parâmetros por consulta, recorrendo a um conjunto muito maior de experts. O resultado é conhecimento profundo e recall preciso sem o custo de um dense model em cada chamada.
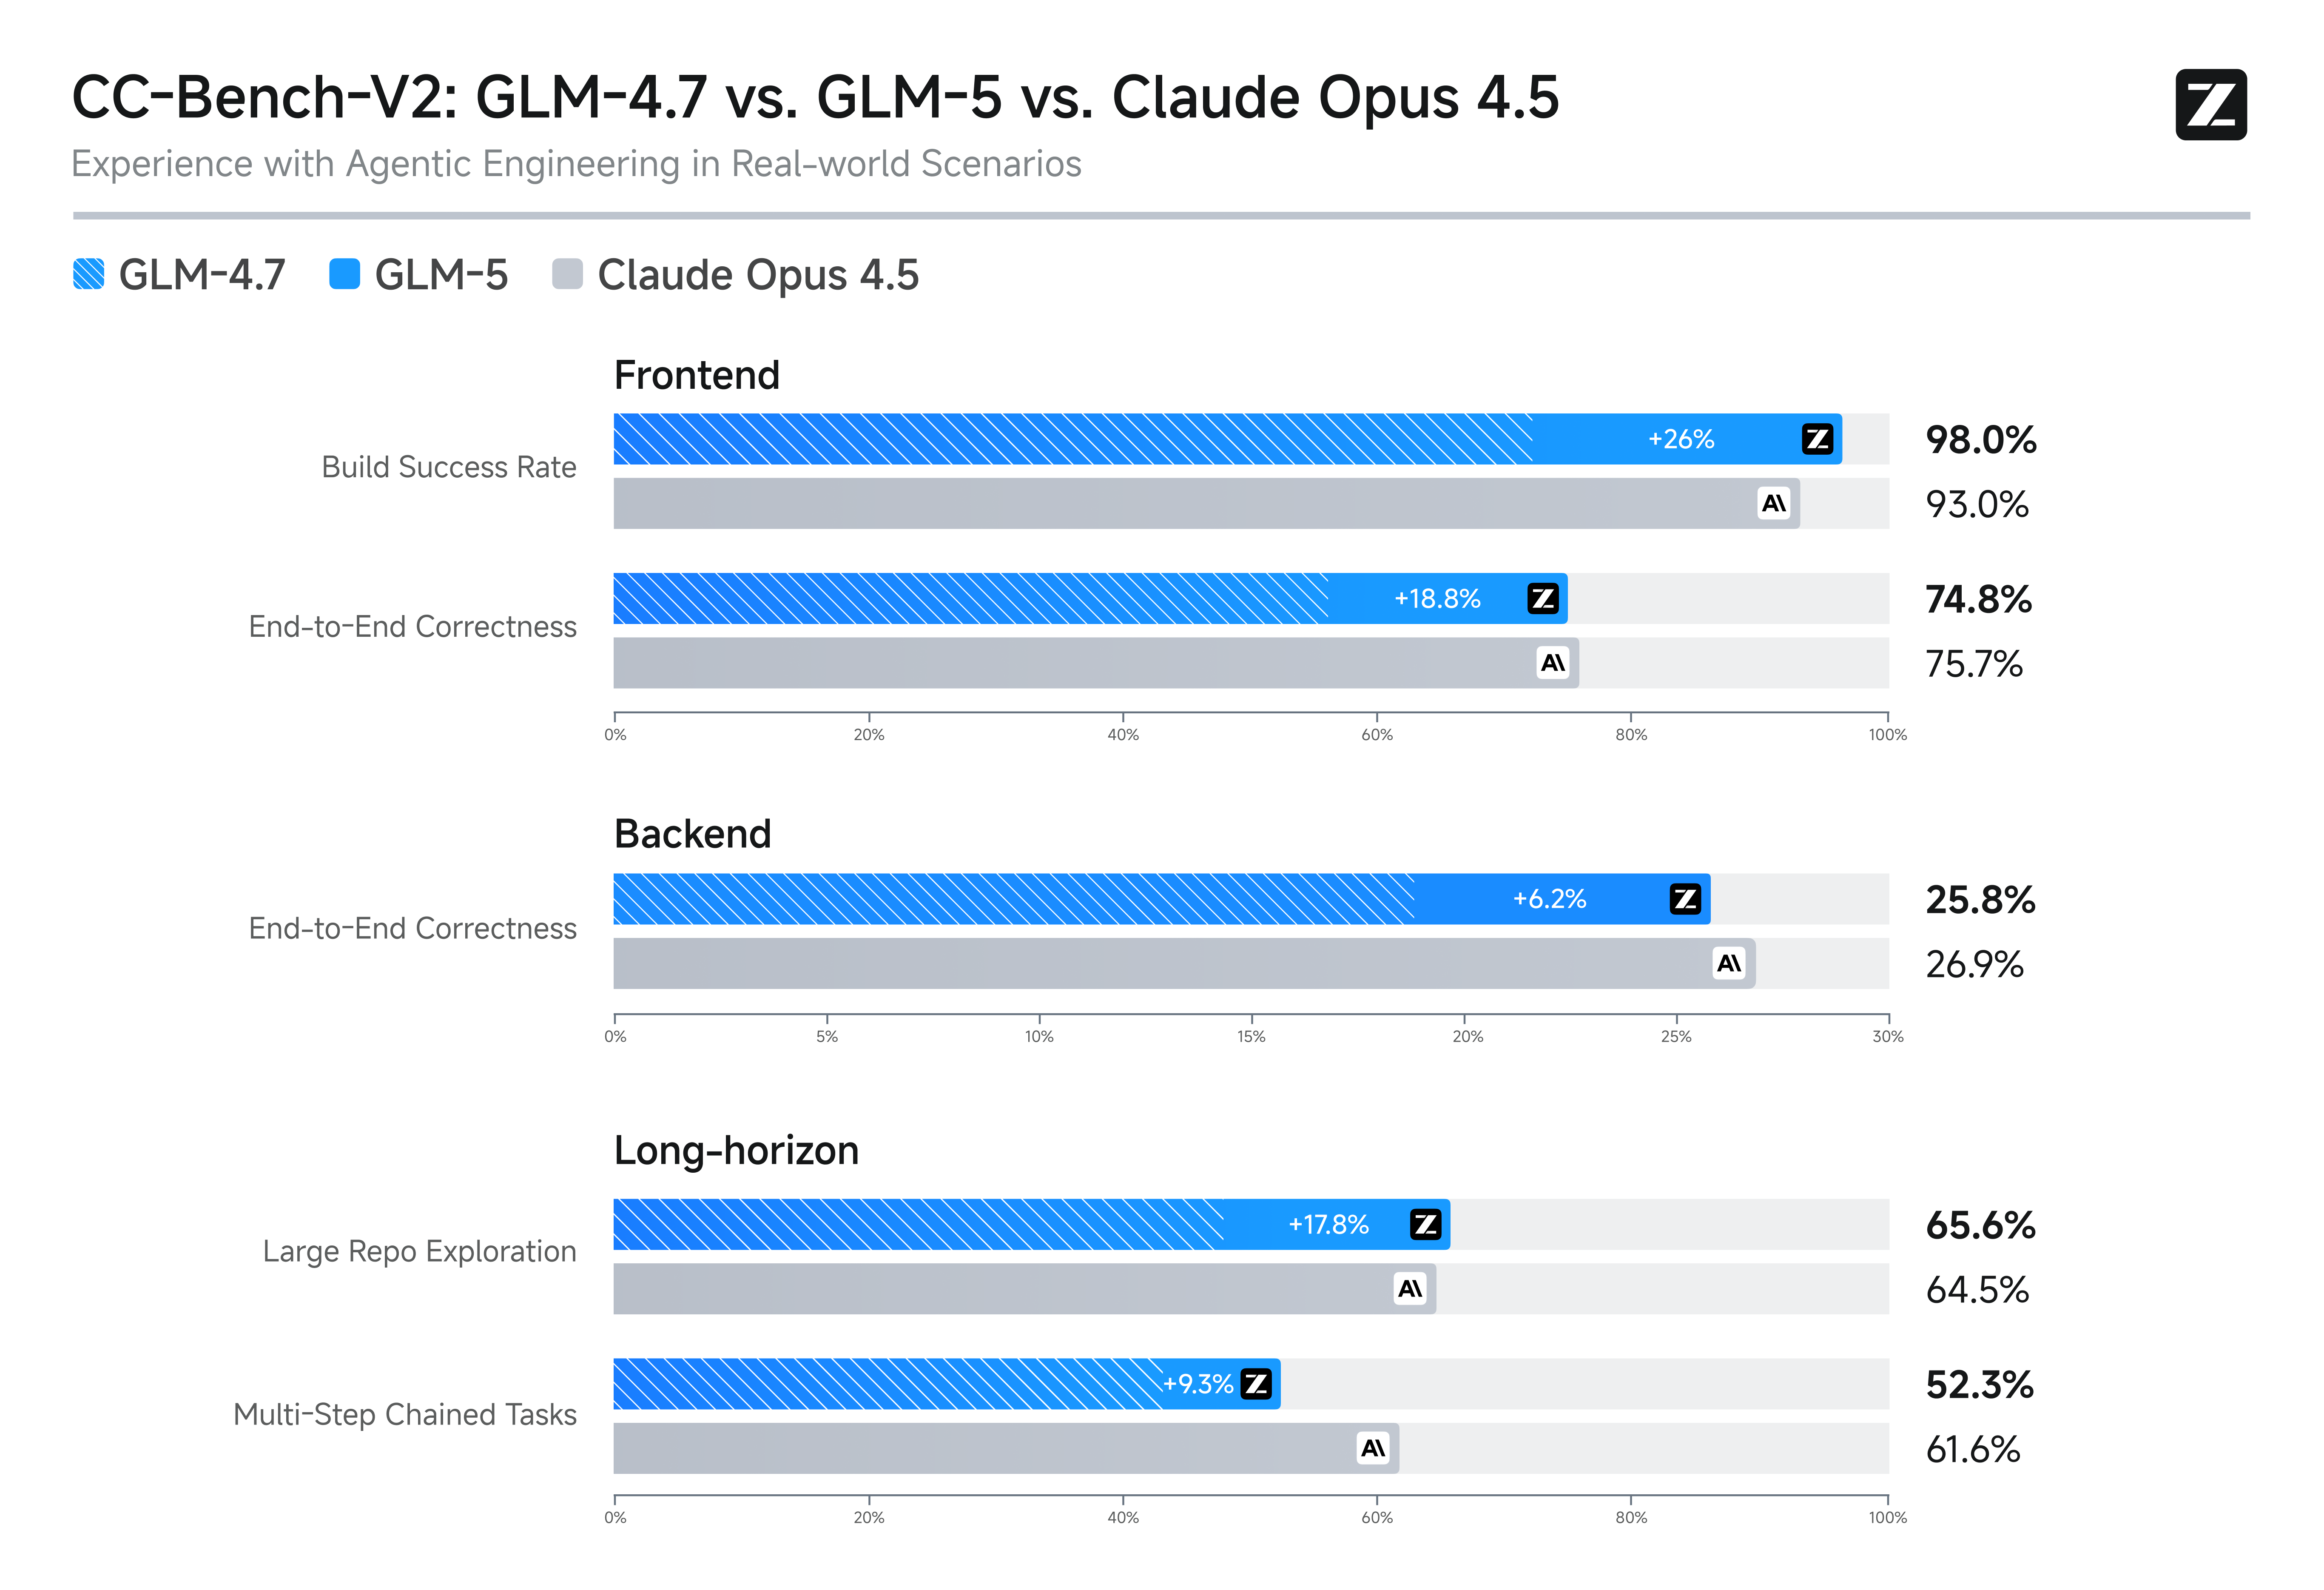
Execução agentic integrada à GLM API
A lógica de planejamento vem integrada à GLM API para que agentes executem tarefas longas e de múltiplas etapas sem perder o rumo. Essa estabilidade atende bem ao desenvolvimento de software automatizado, pipelines de pesquisa e workflows que precisam manter coerência ao longo de muitas etapas.
Programação e raciocínio ajustados por reinforcement learning
O pós-treinamento com reinforcement learning aprimora a geração de código e o raciocínio algorítmico do modelo muito além das versões anteriores do GLM. Desenvolvedores obtêm resultados full-stack mais confiáveis e uma resolução estrutural de problemas mais robusta, especialmente onde pequenos erros de lógica tendem a se acumular.
Uma janela de contexto de 200K com sparse attention
Cada modelo lida com 200K tokens de contexto ou mais, com até 128K tokens de saída, e a sparse attention mantém essa escala economicamente viável. Repositórios inteiros, contratos longos e briefings de pesquisa permanecem visíveis de uma só vez.
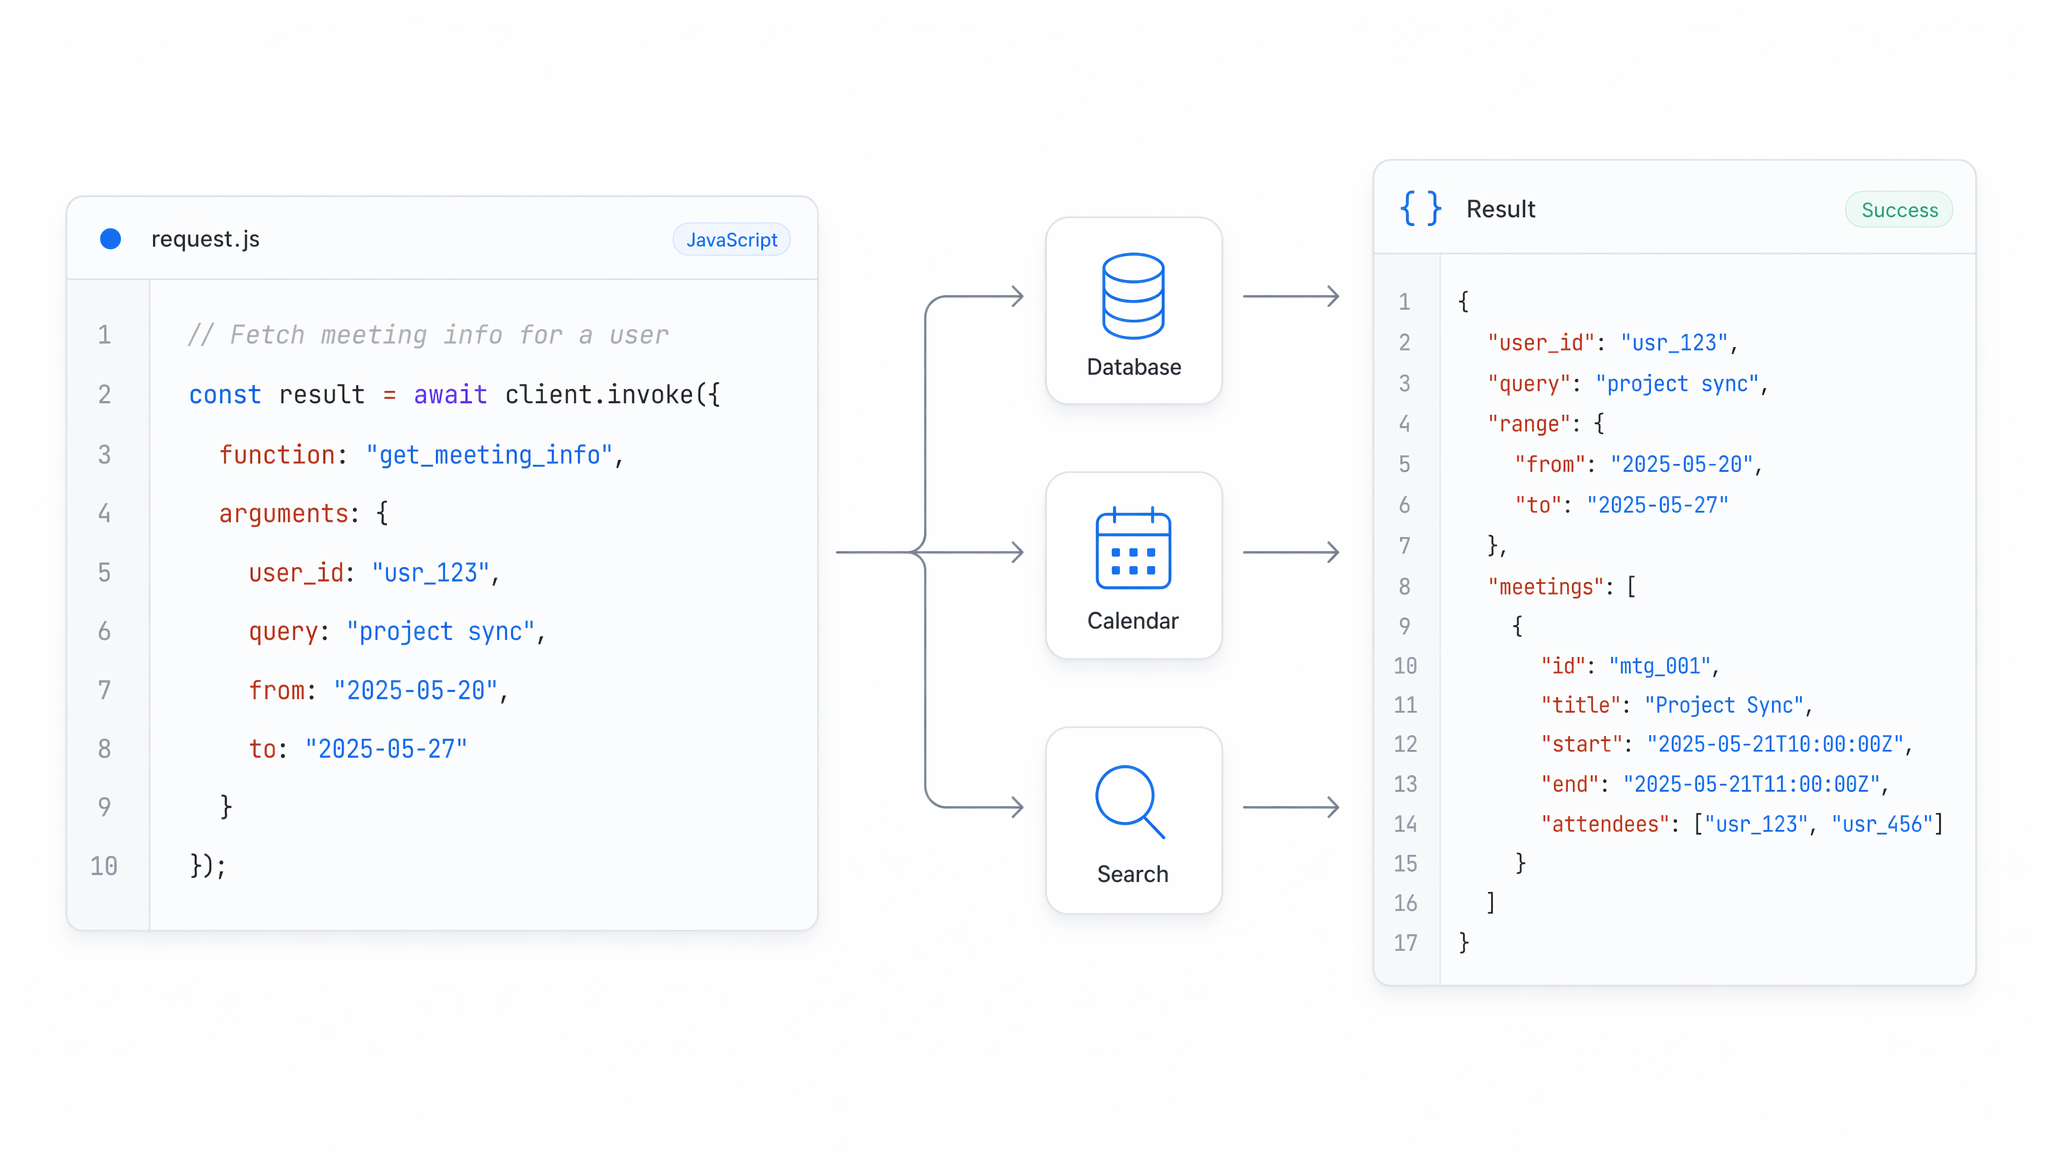
Tool calling nativo pela GLM API
Conecte ferramentas e serviços externos à GLM API por meio de function calling nativo e saída JSON estruturada. O modelo decide quando invocar uma ferramenta, formata os argumentos conforme o seu schema e retorna resultados legíveis por máquina.
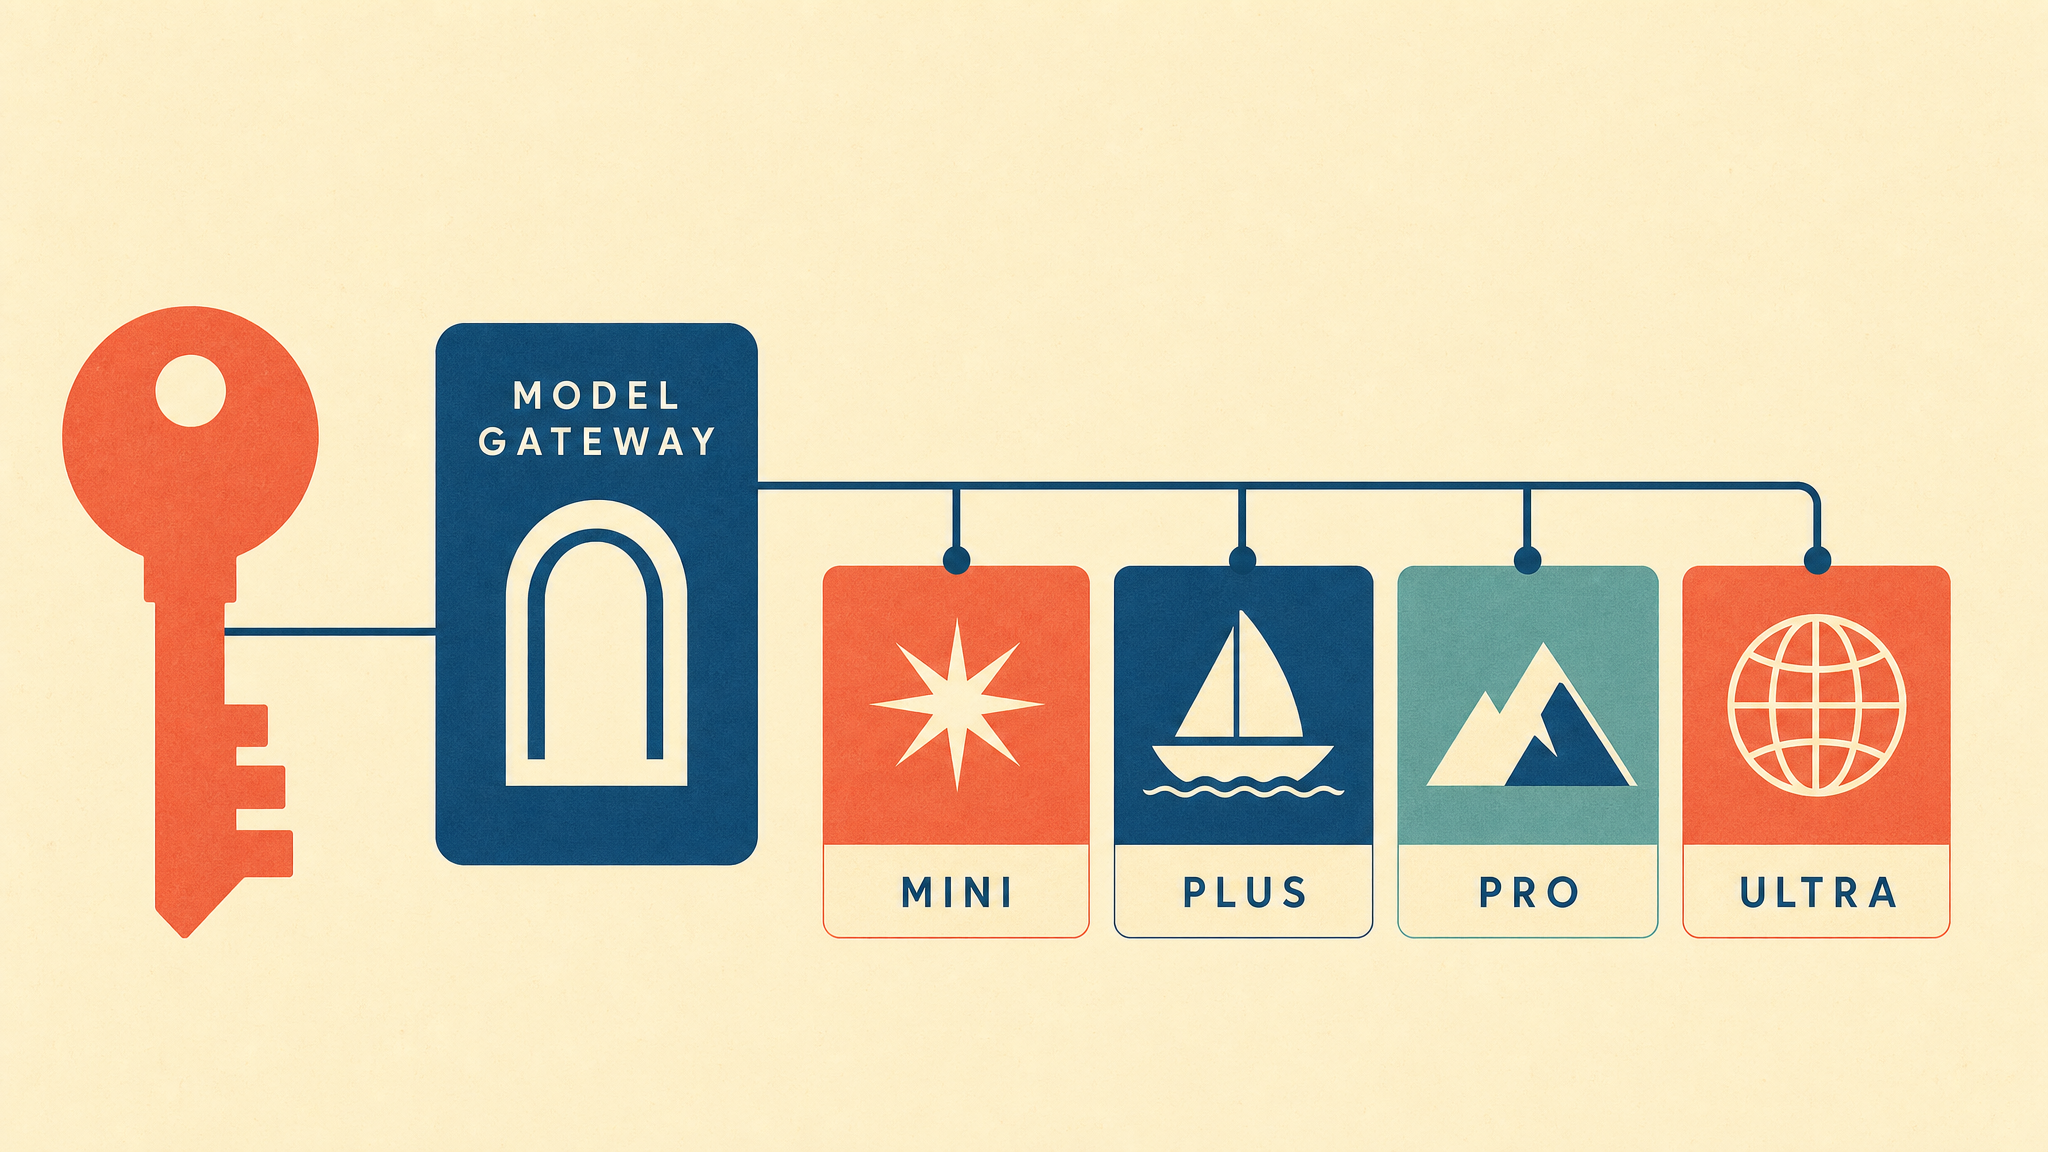
Toda a linha GLM API sob uma única chave
Uma única chave compatível com OpenAI dá acesso a toda a linha GLM API, do flagship GLM-5.2 aos níveis Turbo e ao GLM-4.6 mais econômico. Prototipe em um nível mais leve e depois promova para produção com uma linha de código e preços pay-as-you-go.
GLM API frente a frente: um briefing, três modelos comparados
Envie uma única solicitação de build pela GLM API e veja GLM 5.2, DeepSeek V4 Pro e GLM 5 transformarem a mesma instrução em uma página interativa funcional, para você avaliar rapidamente a qualidade do front-end, a lógica de layout e o polimento das interações.
Gere um documento HTML completo, de arquivo único e autossuficiente (todo o CSS e JavaScript embutidos, absolutamente sem dependências externas, sem CDNs, sem URLs de imagens, sem fontes externas) que renderize uma "Aurora Tuning Console" interativa — uma experiência WebGL em tela cheia de um céu polar à meia-noite, onde a aurora é calculada em tempo real dentro de um GLSL fragment shader, nunca simulada com sprites, texturas ou pilhas de partículas. Requisito central de renderização: renderize um único quad em tela cheia e faça todo o trabalho visual em um fragment shader. A aurora boreal deve ser gerada proceduralmente a partir de ruído fractal value/simplex em camadas (fbm, 4–6 octaves) que flui e se deforma ao longo do tempo por meio de um uniform de relógio, produzindo altas cortinas verticais de luz que respiram, ondulam, se enovelam e se dissipam. Modele a aurora como brilho volumétrico autoemissivo: acumule o brilho ao longo de uma atenuação vertical, adicione um bloom suave na base de cada cortina e espalhe um ruído sutil de poeira estelar em deriva pelo céu superior escuro. Componha o quadro como um olhar minimalista para cima, com horizonte baixo — cerca de 80% de céu, com uma crista de montanhas escura em silhueta e um lago espelhado e imóvel na parte inferior, refletindo a aurora e as estrelas em uma cópia verticalmente espelhada com ondulações suaves. A paleta base é índigo quase preto (noite azul-violeta profunda); a aurora é o único elemento de alta saturação — contida, luminosa, translúcida, nunca exagerada. Interações (todas em tempo real, suaves e claramente responsivas): - Arrastar o mouse pelo céu "puxa" as cortinas de luz como tecido — alimente a posição/velocidade do ponteiro em uniforms do shader para que a aurora se dobre, se estique e flua em direção ao cursor, depois retorne com inércia suave quando solta. - A rolagem da roda do mouse alterna a "estação", interpolando continuamente a faixa de cores da aurora entre verde esmeralda → magenta → índigo (e de volta), exibida como uma transição suave de gradiente, não como saltos discretos. - Um clique duplo acende uma nova estrela naquele ponto do céu: ela pulsa (brilho sinusoidal) e projeta um reflexo correspondente no lago. Suporte muitas estrelas simultâneas. - Mantenha uma animação idle sutil para que a primeira cortina de luz pareça despertar lentamente e se desenrolar ao carregar — uma atmosfera silenciosa, sagrada, fria e imóvel. UI e polimento: uma pequena sobreposição de controle elegante e semitransparente em um canto, mostrando a estação/cor atual e uma dica discreta de uma linha dos controles (arrastar / rolar / duplo clique), estilizada com uma estética moderna, limpa e de tons frios, com transições suaves de fade. Torne-a totalmente responsiva: redimensione o canvas WebGL e atualize os uniforms de resolução ao redimensionar a janela, para que ocupe qualquer viewport e permaneça nítida em telas de alto DPI. Mire em 60fps estáveis usando requestAnimationFrame. Inclua uma mensagem de fallback elegante se WebGL não estiver disponível. Priorize a qualidade matemática do fluxo de ruído, o brilho volumétrico e a fluidez das interações — é aqui que um modelo capaz deve superar visivelmente um mais fraco.
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
Construa um documento HTML completo, de arquivo único e autossuficiente (todo o CSS e JavaScript embutidos em um único arquivo, absolutamente zero dependências externas — sem CDNs, sem scripts externos, sem web fonts, sem URLs de imagens, sem assets SVG buscados pela rede; gere todo som com a Web Audio API nativa e desenhe todos os visuais com CSS e Canvas/DOM) que abra diretamente em qualquer navegador moderno e execute uma drum machine step-sequencer cyberpunk jogável na linguagem visual do neon synthwave dos anos 1980. Instrumento central: renderize uma matriz de passos brilhante com 16 colunas × 6 faixas dispostas horizontalmente pela tela, uma linha por voz — Kick, Snare, Closed Hi-Hat, Open Hi-Hat, Clap e Synth Bass. Cada uma das 96 células é um pad clicável; clicar alterna entre ligado/desligado, uma célula ativa acende com um brilho saturado de magenta a ciano, uma célula inativa fica como um retângulo rebaixado e discreto sobre o fundo índigo quase preto. O usuário programa uma batida acendendo células coluna por coluna. Suporte pintura por clicar e arrastar entre células para alternar várias de uma vez. Áudio: sintetize todas as vozes de bateria ao vivo com a Web Audio API — kick como um seno com varredura de pitch e decaimento rápido de amplitude, snare e clap como rajadas de ruído branco filtrado com envelope, closed e open hi-hats como ruído em high-pass com decaimento curto vs. longo, e synth bass como uma saw/square desafinada passando por um filtro low-pass ressonante e tocando uma nota fundamental selecionável. Agende os passos com um relógio look-ahead preciso (não timing ingênuo com setInterval) para que o loop permaneça absolutamente sólido em tempos altos. Repita continuamente o padrão de 16 passos enquanto estiver tocando. Transporte e controles, acoplados em uma barra de controle simétrica fixada na parte inferior: um grande botão Play/Stop, um dial de BPM ou knob rotativo (arrastável, faixa ~60–200 BPM, padrão 120) com leitura numérica ao vivo, um fader de volume mestre, botões de mute por faixa, um botão Clear e um botão Randomize que gera uma batida plausível. Um playhead em movimento — uma lâmina vertical de luz — varre a grade em perfeita sincronia com o áudio, e cada célula ativa que ele atinge floresce com um pulso radial de ondulação que desaparece. Inclua uma visualização ao vivo de osciloscópio/forma de onda que mostre a amplitude da saída mestre em tempo real, reagindo ao som. Estilo visual: fundo em gradiente de índigo profundo a violeta, tão escuro que parece quase preto; linhas da grade e acentos da UI em magenta e ciano elétricos; toda a luminosidade vindo do brilho próprio dos elementos e do bloom de flash ao tocar (box-shadow glow, destaques com sensação aditiva), evocando um clube underground tarde da noite pulsando ao ritmo do loop. Centralize a grade completa na tela, mantenha o layout simétrico com a barra de controle comprimindo a base e torne-o responsivo para que a grade escale com elegância em viewports menores. Adicione scanlines animadas sutis ou um brilho cromático para criar atmosfera sem prejudicar a legibilidade. Requisitos de interação: tudo responde instantaneamente — clicar nos pads, arrastar o knob de BPM e o fader de volume, alternar mutes, pressionar a barra de espaço para Play/Stop e pressionar as teclas numéricas para trocar a nota fundamental do bass. O estado (quais células estão ativas, BPM, volume, mutes, status de reprodução) deve ser gerenciado de forma limpa para que a UI e o áudio nunca saiam de sincronia. A primeira interação com a página também deve desbloquear/retomar o AudioContext. Priorize uma sincronização áudio-visual precisa, animação suave a 60fps do playhead e das ondulações, e um resultado realmente satisfatório e musical logo de início.
Generated with GLM 5.2 on Atlas Cloud
Generated with Grok 4.5 on Atlas Cloud
Generated with GLM 5 on Atlas Cloud
Onde os desenvolvedores colocam a GLM API em prática
De agentes de codificação autônomos e pesquisas de longo horizonte a produtos conversacionais e análise de dados em grande volume, a GLM API oferece aos desenvolvedores um endpoint compatível com OpenAI para criar software confiável orientado por agentes.

Agentes de codificação autônomos com a GLM API
Criados para execução autônoma de tarefas, os modelos GLM planejam, escrevem e refinam código em fluxos de trabalho de várias etapas sem perder o contexto do projeto. Equipes de desenvolvimento contam com isso para impulsionar bots de revisão de PR, assistentes de refatoração e pipelines de build.

Pesquisa de longo horizonte e orquestração de fluxos de trabalho
O raciocínio multi-step estável permite que esses modelos decomponham questões de pesquisa amplas, acionem ferramentas externas e mantenham o contexto ao longo de longas cadeias de ações dependentes. Isso atende bem analistas e equipes de produto que automatizam síntese de múltiplas fontes e operações entre plataformas.

Criação de interfaces front-end bem-acabadas
Os modelos GLM transformam mockups rascunhados e descrições simples em código de interface limpo e responsivo, com forte senso de acabamento visual. Fundadores solo e desenvolvedores com olhar para design lançam protótipos funcionais e UIs de produção muito mais rápido.

Produtos conversacionais na GLM API
Quer assistentes que pareçam humanos? A GLM API oferece experiências conversacionais naturais apoiadas por raciocínio estável, impulsionando chatbots, copilotos de suporte e assistentes in-app que permanecem coerentes em diálogos longos e ramificados.

Backends com tool-calling e execução de funções
Como esses modelos são criados para uso de ferramentas, eles selecionam funções, formatam argumentos e encadeiam chamadas de API dentro de sistemas agentic. Engenheiros usam isso para integrar a GLM a camadas de orquestração, pipelines RAG e stacks multi-agent.

Escale a análise de dados com a GLM API
Use a GLM API para raciocinar sobre documentos extensos, planilhas e relatórios, extraindo insights estruturados por meio de um design Mixture-of-Experts eficiente. Ideal para equipes de finanças, jurídico e operações que precisam de análise confiável em grande volume.
GLM API vs LLMs rivais: matriz de especificações e preços
Compare todos os modelos da GLM API com os principais LLMs de texto no Atlas Cloud em termos de comprimento de contexto, limites de saída e preços transparentes pay-as-you-go.
| Modelo | Janela de contexto | Saída máxima | Entrada ($/1M tokens) | Saída ($/1M tokens) |
|---|---|---|---|---|
| GLM 5.2 | 1M | 128K | $1.40 | $4.40 |
| GLM 5.1 | 203K | 203K | $1.40 | $4.40 |
| GLM 5 | 203K | 203K | $1.00 | $3.20 |
| GLM 4.7 | 203K | 203K | $0.60 | $2.20 |
| DeepSeek V4 Pro | 1M | 384K | $1.74 | $3.45 |
| Kimi K2.7 Code | 256K | 256K | $0.95 | $4.00 |
| MiniMax M3 | 512K | 512K | $0.60 / $1.20 >512K | $2.40 / $4.80 >512K |
Como Usar GLM no Atlas Cloud
Comece em minutos — siga estes passos simples para integrar e implantar modelos pela plataforma da Atlas Cloud.
Crie uma Conta no Atlas Cloud
Cadastre-se em atlascloud.ai e conclua a verificação. Novos usuários recebem créditos gratuitos para explorar a plataforma e testar modelos.
Por Que Usar GLM no Atlas Cloud
Combine modelos avançados de GLM com a plataforma acelerada por GPU do Atlas Cloud, fornecendo desempenho, escalabilidade e experiência de desenvolvimento incomparáveis.
Desempenho e Flexibilidade
Baixa Latência:
Inferência otimizada por GPU para respostas em tempo real.
API Unificada:
Uma única integração para acessar GLM, GPT, Gemini e DeepSeek.
Preços Transparentes:
Faturamento por Token, suporta modo Serverless.
Empresa e Escala
Experiência do Desenvolvedor:
SDK, análise de dados, ferramentas de ajuste fino e modelos tudo em um.
Confiabilidade:
99.99% de disponibilidade, controle de permissões RBAC, logs de conformidade.
Segurança e Conformidade:
Certificação SOC 2 Type II, conformidade HIPAA, soberania de dados nos EUA.
GLM API: Respostas a perguntas comuns de desenvolvedores
A GLM API dá aos desenvolvedores acesso à série GLM de modelos de linguagem grandes com pesos abertos da Z.ai (Zhipu AI), incluindo GLM-5.2, GLM-5, GLM-4.7 e GLM-4.6. Esses modelos foram projetados para programação, raciocínio em várias etapas e tarefas de agentes autônomos. No Atlas Cloud, você acessa toda a família por meio de um único endpoint compatível com OpenAI, com preços pay-as-you-go.
O Atlas Cloud hospeda a linha GLM atual, incluindo GLM-5.2, GLM-5.1, GLM-5, GLM-5 Turbo, GLM-5v Turbo, GLM-4.7 e GLM-4.6. As versões flagship são voltadas para trabalho agentic complexo e programação, enquanto as variantes Turbo priorizam respostas mais rápidas e com menor latência. Alternar entre elas exige apenas alterar o identificador do modelo na sua requisição.
Cadastre-se no Atlas Cloud, gere uma chave de API e aponte seu cliente existente compatível com OpenAI para o nosso endpoint. Como a GLM API segue o formato de requisição da OpenAI, a maioria das integrações precisa apenas alterar a URL base e o nome do modelo para começar a enviar requisições. O acesso é pay-as-you-go, com preços transparentes por chamada e sem assinatura.
Os preços são pay-as-you-go e cobrados por token, sem necessidade de assinatura. GLM-4.7 e GLM-4.6 começam em $0.60 por milhão de tokens de entrada e $2.20 por milhão de tokens de saída, GLM-5 custa $1.00 por entrada e $3.20 por saída, e GLM-5.2 custa $1.40 por entrada e $4.40 por saída. Entradas em cache são cobradas a uma tarifa menor, reduzindo o custo em contextos repetidos.
Os modelos GLM no Atlas Cloud oferecem uma grande janela de contexto de aproximadamente 200K tokens, com saída máxima chegando a cerca de 131K tokens nas versões flagship. Essa capacidade é suficiente para carregar repositórios inteiros, documentos longos ou históricos extensos de agentes em uma única requisição. Existem variantes de contexto mais longo dentro da família GLM, então consulte a página de cada modelo para ver seu limite exato.
Sim. Os modelos GLM oferecem suporte a chamadas de ferramentas e funções, além de saída JSON estruturada, o que permite integrá-los diretamente a pipelines agentic e sistemas de produção que esperam respostas legíveis por máquina. Combinada com o formato compatível com OpenAI, a GLM API é simples de conectar a fluxos de trabalho existentes com uso de ferramentas.
Esses modelos foram criados para programação, raciocínio de longo alcance e execução de agentes autônomos. Usos comuns incluem análise de código de repositórios inteiros, prototipagem full-stack e pesquisa em várias etapas ou automação de fluxos de trabalho. A série flagship GLM-5 lida com os trabalhos agentic mais exigentes, enquanto GLM-4.6 oferece um forte equilíbrio entre velocidade e capacidade para tarefas do dia a dia.
Os modelos flagship da GLM são posicionados como alternativas competitivas de pesos abertos aos principais modelos closed-source em benchmarks de programação e agentic. O principal atrativo prático é o custo, já que o preço por token é uma fração do de modelos proprietários comparáveis, enquanto o desempenho em programação continua forte. Para equipes que equilibram orçamento e qualidade, GLM oferece capacidade de nível frontier a um custo menor.
Sim. O Atlas Cloud disponibiliza modelos GLM por meio de um endpoint compatível com OpenAI, então qualquer framework ou SDK que aceite uma URL base personalizada e nome de modelo pode chamá-los com mudanças mínimas. Isso permite inserir GLM em agentes com chamadas de ferramentas, assistentes de programação e pipelines de orquestração em várias etapas que você já usa. Comece a criar hoje.
Sim. A série GLM é lançada pela Z.ai (Zhipu AI) como modelos de pesos abertos sob uma licença permissiva, por isso é amplamente considerada uma das principais opções open-source. No Atlas Cloud, você obtém acesso gerenciado e pronto para produção a esses modelos sem precisar hospedar ou manter a infraestrutura por conta própria.
Explorar Mais Séries
Kling 4.0
Desenvolvido pela Kuaishou, o Kling V4 é um modelo de vídeo criado para produção profissional. Ele combina movimentos complexos estáveis com o formato ultrawide 21:9 e edição direcionada de expressões, ângulos de câmera, planos de fundo, estilos visuais e diálogos. A Atlas Cloud está preparando o acesso no Day-0 com uma única chave compatível com a OpenAI e preços transparentes conforme o uso, para uma integração flexível. Comece a desenvolver hoje.

Seedance 2.5
A API do Seedance 2.5 já está disponível no Atlas Cloud! Ela oferece aos desenvolvedores o mais novo modelo de vídeo da ByteDance. Ele gera até 30 segundos de vídeo nativo em uma única passagem a partir de texto, uma única imagem ou até 50 referências multimodais, com áudio sincronizado e texto multilíngue no quadro. No Atlas Cloud, você o acessa por meio de uma única chave, com consistência de sujeito e física aprimorada mantendo a coerência em tomadas longas.
Wan 3.0
A API Wan 3.0 é a próxima geração da família de vídeos Wan da Alibaba, desenvolvida para elevar a geração de formato longo, o controle de múltiplas referências e a qualidade audiovisual a novos patamares. O Atlas Cloud já hospeda o Wan 2.7, 2.6 e 2.5, e o Wan 3.0 funciona com a mesma chave unificada, sem necessidade de configuração separada. Comece a construir hoje mesmo. Role a tela para baixo até a vitrine para ver o que o Wan 3.0 pode criar.
MiniMax H3
MiniMax H3 é a família de vídeo multimodal da MiniMax para criação guiada por texto, imagem e referências. Nas rotas compatíveis, preserva os elementos das mídias de referência, oferece proporções flexíveis e combina som gerado com elementos visuais por meio do H3 Developer, com perfis de saída selecionados por endpoint. O Atlas Cloud unifica a família com uma única chave compatível com a OpenAI e preços transparentes de pagamento conforme o uso, a partir da tarifa padrão de $0.038 por segundo. Comece a criar hoje.
GPT Image 2.5
A família gpt-image-2.5 da OpenAI oferece aos desenvolvedores a opção entre Flare e Sunburst para fluxos de trabalho de imagens em produção. Renderize em resoluções arbitrárias de até 3840x2160 e escolha entre cinco níveis de qualidade, incluindo xhigh e max, para atender a requisitos específicos de saída. A Atlas Cloud oferece inferência REST pronta para uso, sem cold starts, com preços padrão a partir de US$ 0,004 por geração. Comece a criar hoje.
Seedream 5.0 Pro
A API do Seedream 5.0 Pro fornece aos desenvolvedores o modelo de edição de imagens controlável da ByteDance no Atlas Cloud. Ela posiciona as edições com precisão usando âncoras e coordenadas, separa as imagens em camadas editáveis, funde múltiplas referências e combina cores e materiais exatos, com texto multilíngue em 2K e 3K. No Atlas Cloud, você pode acessá-lo por meio de uma única chave!
Seedance 2.0
Seedance 2.0 é o modelo de vídeo para produção da ByteDance, desenvolvido para a criação precisa de planos. Transforme prompts em vídeo, anime uma imagem do primeiro quadro com orientação opcional do último quadro ou defina os resultados com mídia de referência e pesquisa opcional na web. O Atlas Cloud reúne esses fluxos de trabalho em uma única API, com preços transparentes conforme o uso e uma única chave compatível com OpenAI. Comece a desenvolver hoje.
Kling V3.0
Da Kuaishou, a família de APIs Kling V3 oferece fluxos de trabalho com texto, imagens e vídeos de referência. Transfira movimentos preservando a identidade dos personagens, oriente a geração com referências visuais e edite vídeos com comandos em linguagem natural. A Atlas Cloud oferece endpoints Standard e Pro para diferentes necessidades de produção. Já está criando com Kling 3.0? Kling V4 já está disponível na Atlas Cloud. Conheça-o na [página da família Kling V4](https://www.atlascloud.ai/models/kling-v4).
Grok Imagine Video
Grok Imagine Video dá aos desenvolvedores acesso à família de modelos de vídeo da xAI para criar, animar, estender e editar clipes. Gere vídeos de 1 a 15 segundos a partir de prompts, oriente pessoas, objetos ou estilos com até sete imagens de referência e trabalhe em 480p ou 720p. A Atlas Cloud reúne esses recursos por meio de endpoints compatíveis com a OpenAI, com preços transparentes conforme o uso. Comece a desenvolver hoje.
Vidu Q4 Preview
O Vidu Q4 é o mais recente modelo de vídeo topo de linha da Vidu, desenvolvido para geração de imagem para vídeo e referência para vídeo. Ele pode animar uma única imagem estática e criar transições automáticas de cena, oferecendo aos desenvolvedores dois caminhos de entrada para diferentes fluxos de trabalho de produtos. A Atlas Cloud fornece endpoints de API dedicados com esquemas de parâmetros publicados pelo preço padrão verificado de $0.04 por segundo. Comece a desenvolver hoje.
Gemini Omni 1.1 Flash
Gemini Omni 1.1 Flash é a família de vídeos nativamente multimodal do Google DeepMind, criada para fluxos de produção flexíveis. Edite filmagens existentes por meio de instruções de texto, mantenha a consistência visual com até 10 imagens de referência e 3 clipes de vídeo ou estenda uma tomada em segmentos encadeáveis de até 40 segundos. Acesse todos os fluxos de trabalho no Atlas Cloud com uma única chave de API compatível com a OpenAI, preços conforme o uso e disponibilidade desde o Dia 0. Comece a desenvolver hoje.
Nano Banana 2.1
Nano Banana 2.1 é a família de modelos de imagem do Google baseada no Gemini 3.6 Flash. Oferece geração e edição de nível Pro com a velocidade do Flash, permite edições em linguagem natural e combinações entre 1 e 14 imagens de entrada, além de manter a consistência de até 4 personagens e 10 objetos. Por meio do Atlas Cloud, os desenvolvedores podem acessar a família com uma única chave compatível com OpenAI, disponibilidade confiável e disponibilidade desde o Dia 0. Comece a criar hoje.
Artigos recomendados
Guias, tutoriais e novidades de produto para você aproveitar ao máximo a Atlas Cloud.





