İndirme çubuğu 65 GB'a ulaşıyor, fanlar dönmeye başlıyor ve asıl soru ortaya çıkıyor: gerçekten yüklenecek mi? GPT-OSS-120B bellek gereksinimleri için kısa cevap, ağırlıklar için yaklaşık 61 GB artı çalışma alanı için birkaç GB daha; bu yüzden OpenAI bunu tek bir 80GB GPU modeli olarak sunuyor.
Aşağıda bu sayıyı parçalara ayırıyor, ölçülen hızlarla çalıştıran donanımı gösteriyor ve sizinki yetersiz kaldığında barındırılan yolu ele alıyoruz.
Önemli Noktalar
- GPT-OSS-120B, 60,8 GiB'lık bir MXFP4 kontrol noktası olarak gelir; bu yüzden OpenAI tek bir 80GB GPU'yu hedefliyor.
- Bağlam uzunluğu çok az bellek ekler: KV önbelleği tam 131K token'da yalnızca yaklaşık 4,5 GiB'a ulaşır.
- 80GB'den az VRAM ile llama.cpp, uzman katmanlarını sistem RAM'ine aktarabilir ve yine de çalıştırabilir.
- 96GB'den fazla belleğe sahip Mac'ler ve 128GB mini PC'ler tam modeli tek bir kutuda tutabilir.
- Uygun donanımınız yok mu? OpenAI uyumlu tek bir API üzerindenAtlas Cloud'da Qwen3.5 122B A10Bmodelini çağırın.
GPT-OSS-120B Bellek Gereksinimleri: Ağırlıklar Artı KV Önbelleği
OpenAI, gpt-oss-120b'yi 5 Ağustos 2025'te Apache 2.0 lisansı altında yayınladı. Bu bir uzmanlar karışımı modeldir, yani 116,8B parametresinin yalnızca 5,1B'si her token üzerinde çalışır. Bu hıza yardımcı olur, belleğe değil: her uzman yine de seçilmeye hazır şekilde bellekte durmak zorundadır.
Onu küçük tutan hile MXFP4'tür. gpt-oss model kartına göre parametrelerin %90'ından fazlasını oluşturan uzman ağırlıkları her biri 4,25 bit olarak depolanır. Aynı modelin 16 bitlik bir kopyası yaklaşık dört kat alan gerektirirdi.
| Özellik | GPT-OSS-120B |
|---|---|
| Toplam parametre | 116,8B |
| Token başına aktif parametre | 5,1B |
| Katmanlar ve uzmanlar | 36 katman, 128 uzman, token başına 4 aktif |
| Ağırlık biçimi | Uzman katmanları için MXFP4, gerisi için BF16 |
| Kontrol noktası boyutu | 60,8 GiB |
| Bağlam penceresi | 131.072 token |
Bağlam Penceresi GPT-OSS-120B Belleğini Nasıl Değiştirir
Her token, her dikkat katmanında bir anahtar ve bir değer bırakır. Bu depo KV önbelleğidir ve her katman tam bağlama dikkat ettiğinde, bağlam uzunluğuyla birlikte büyür.
GPT-OSS-120B bunun çoğundan kaçınır. 36 katmanının yarısı yalnızca 128 token geriye bakan bir kayan pencere kullanır ve her katman sadece 64 boyutlu 8 KV başlığı depolar. Yalnızca 18 katman tüm bağlamı tutar. KV önbelleğini modelin yapılandırmasından hesapladık ve llama.cpp gpt-oss kılavuzundaki ölçülen toplamlarla eşleşiyor.
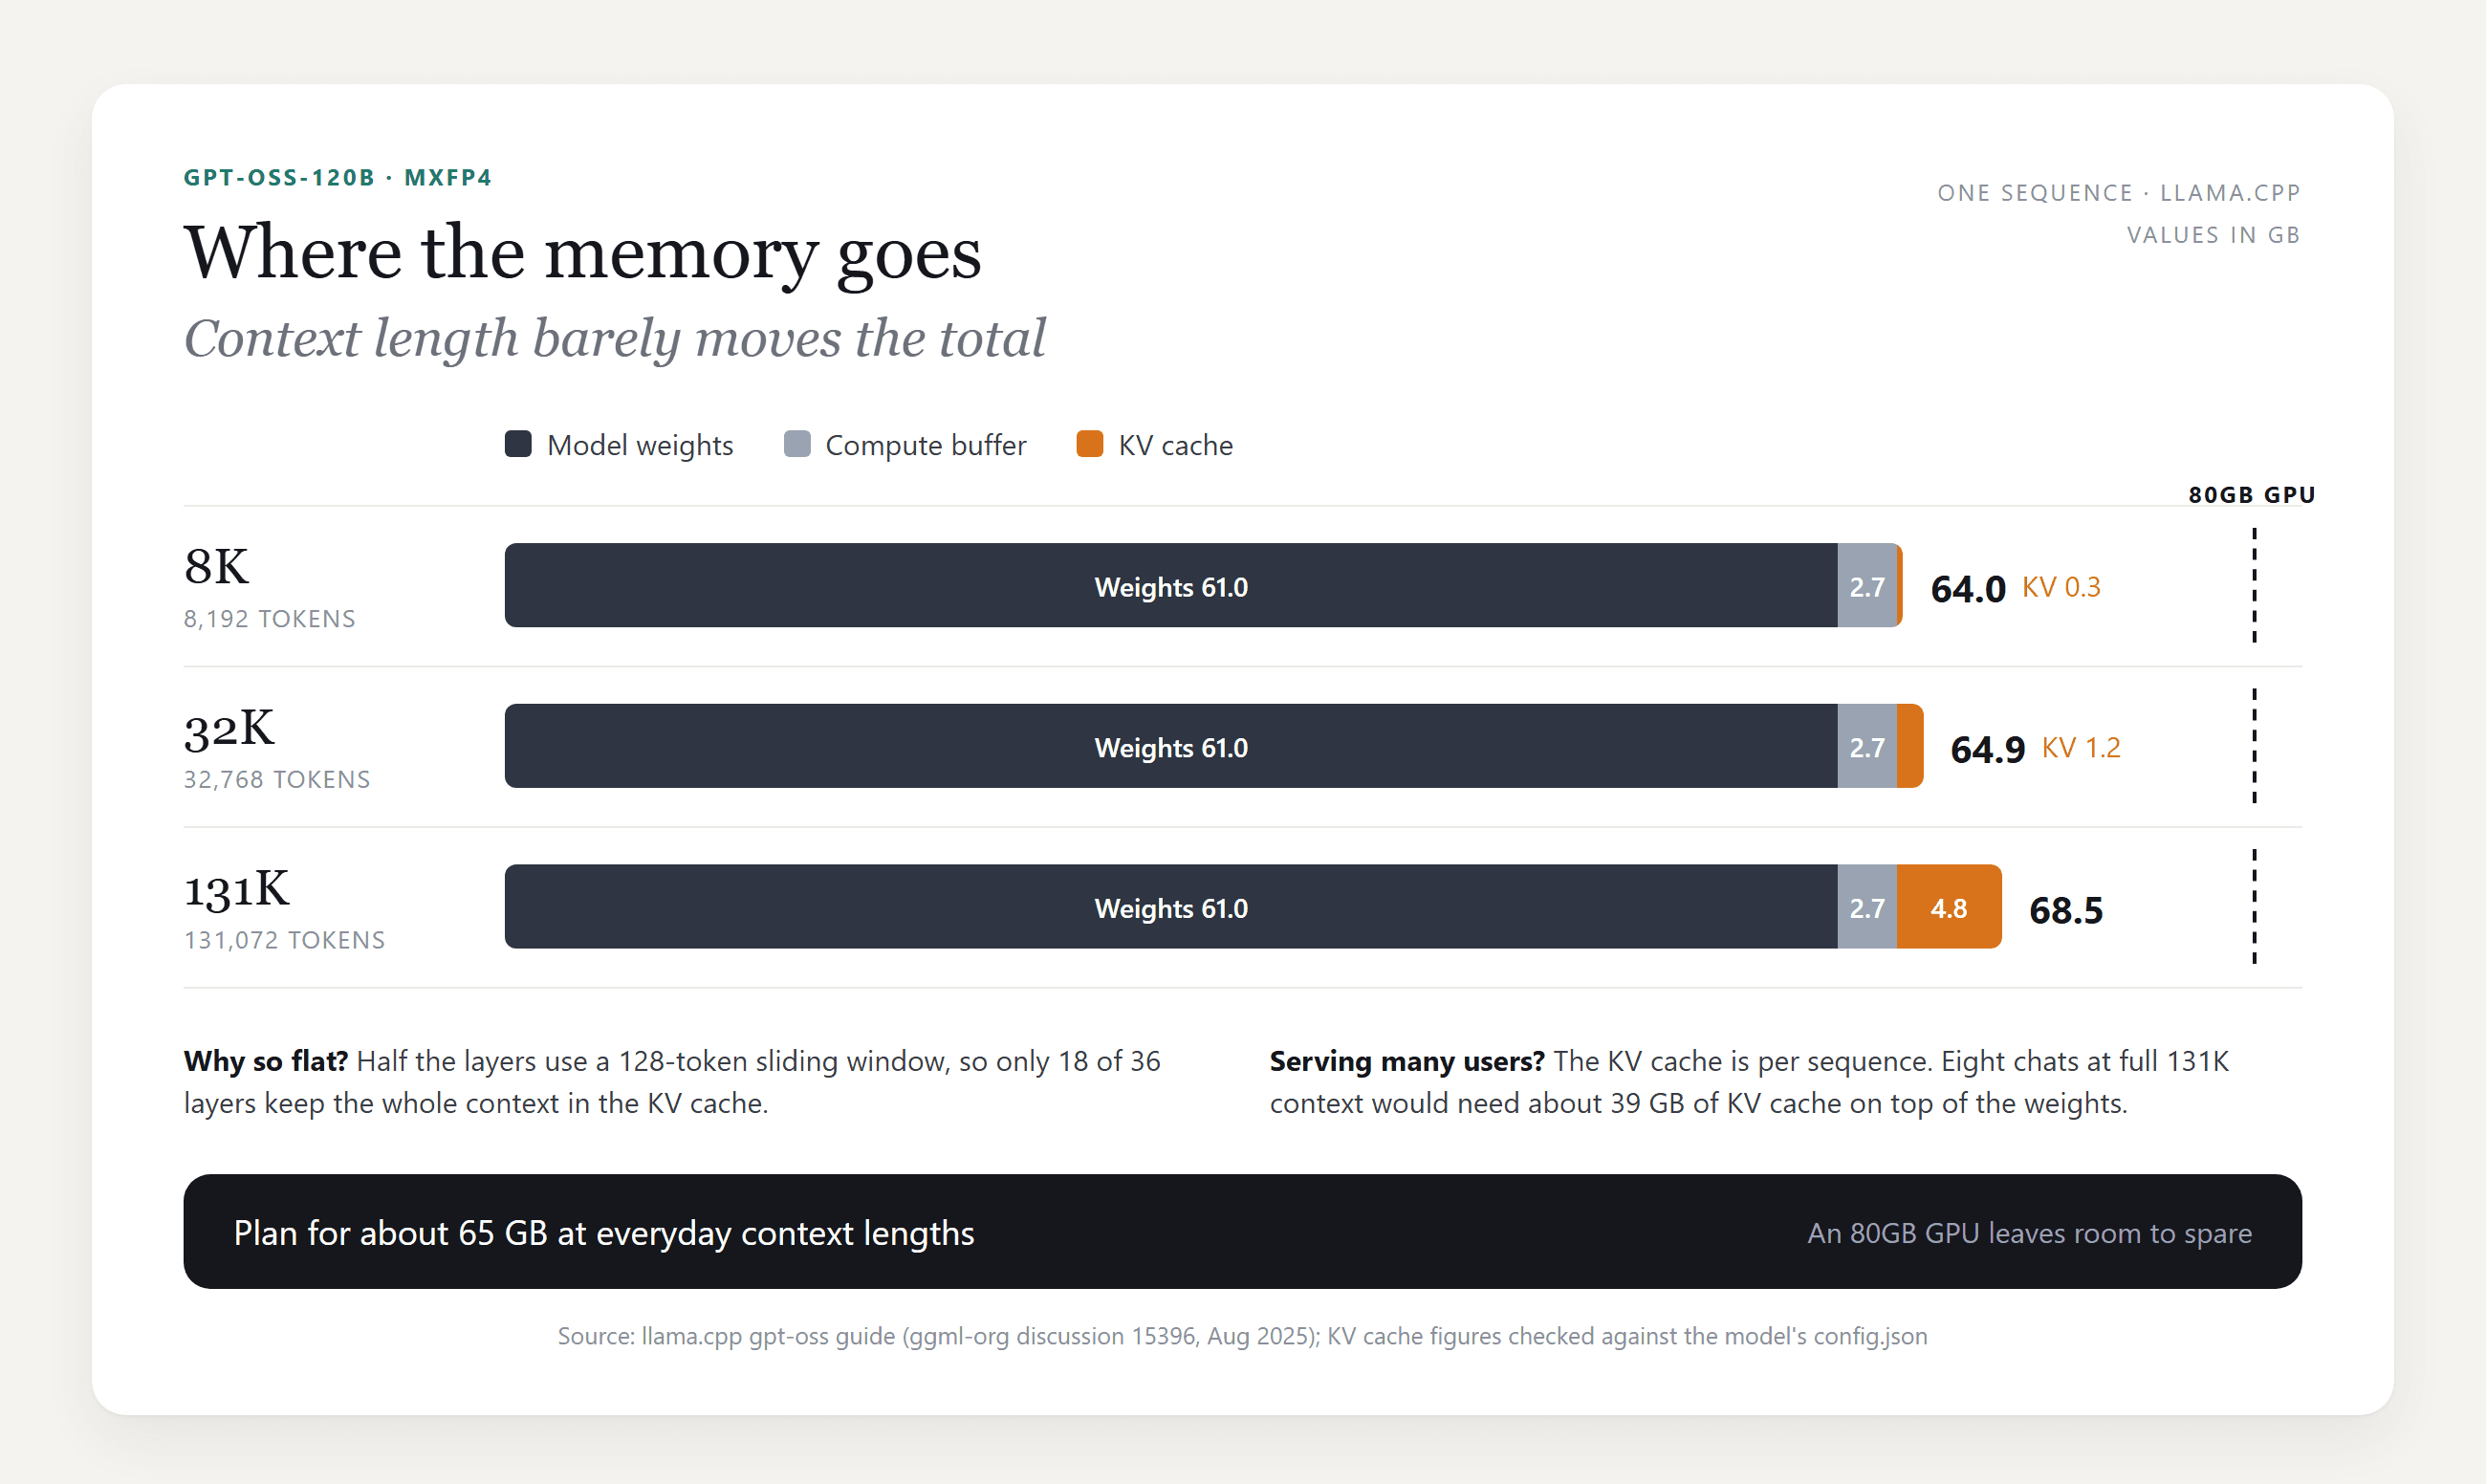
8K'dan tam 131K'ya gitmek 5 GB'ın altında maliyetlidir. Asıl biriktiği yer eşzamanlılıktır: KV önbelleği konuşma başınadır, bu yüzden sekiz tam uzunlukta sohbeti tutan bir sunucu ağırlıkların üstüne yaklaşık 39 GB daha gerektirir.
GPT-OSS-120B'yi Yerel Olarak Çalıştırabilir miyim? Kuruluma Göre Donanım Gereksinimleri
Evet, yaklaşık 65 GB'ı hızlı bir yere koyabilirseniz: büyük bir GPU, bir GPU artı sistem RAM'i veya birleşik belleğe sahip bir kutu.
GPT-OSS-120B GPU Gereksinimleri
En basit durum, tek bir 80GB veri merkezi kartıdır. gpt-oss için vLLM tarifi, 120b modelinin "tek bir A100'e (80GB) sığacağını" ve onu daha fazla GPU'ya bölmenin verimi artırdığını söylüyor.
80GB'ın altında, llama.cpp kılavuzu bir çıkış yolu sunuyor. --n-cpu-moe bayrağı, bazı uzman katmanlarını sistem RAM'inde ve gerisini GPU'da tutar. Kılavuz, minimumu yaklaşık 8GB VRAM olarak belirliyor; tabii GPU ve sistem belleği birlikte hâlâ modeli tutabiliyorsa.
| Kurulum | Ağırlıkların bulunduğu yer | Bildirilen üretim hızı |
|---|---|---|
| RTX Pro 6000, 96GB | Tamamı GPU'da | 196 token/s (llama.cpp kılavuzu) |
| A100 veya H100, 80GB | Tamamı GPU'da | Tek karta sığar (vLLM tarifi) |
| RTX 5090, 32GB, artı sistem RAM | 21 uzman katmanı sistem RAM'inde tutulur | Sıfır bağlamda yaklaşık 30 token/s (llama.cpp kılavuzu) |
Aynı kılavuzdan bir Windows tuzağı: VRAM tükendiğinde sürücü sessizce sistem RAM'ine taşabilir, böylece model yüklenir ve sonra sürünür. Görev Yöneticisi'nde GPU Belleği'ni izleyin ve kartınızın boyutunun altında kalana kadar aktarma sayısını artırın.
GPT-OSS-120B'yi Mac veya 128GB Mini PC'de Çalıştırma
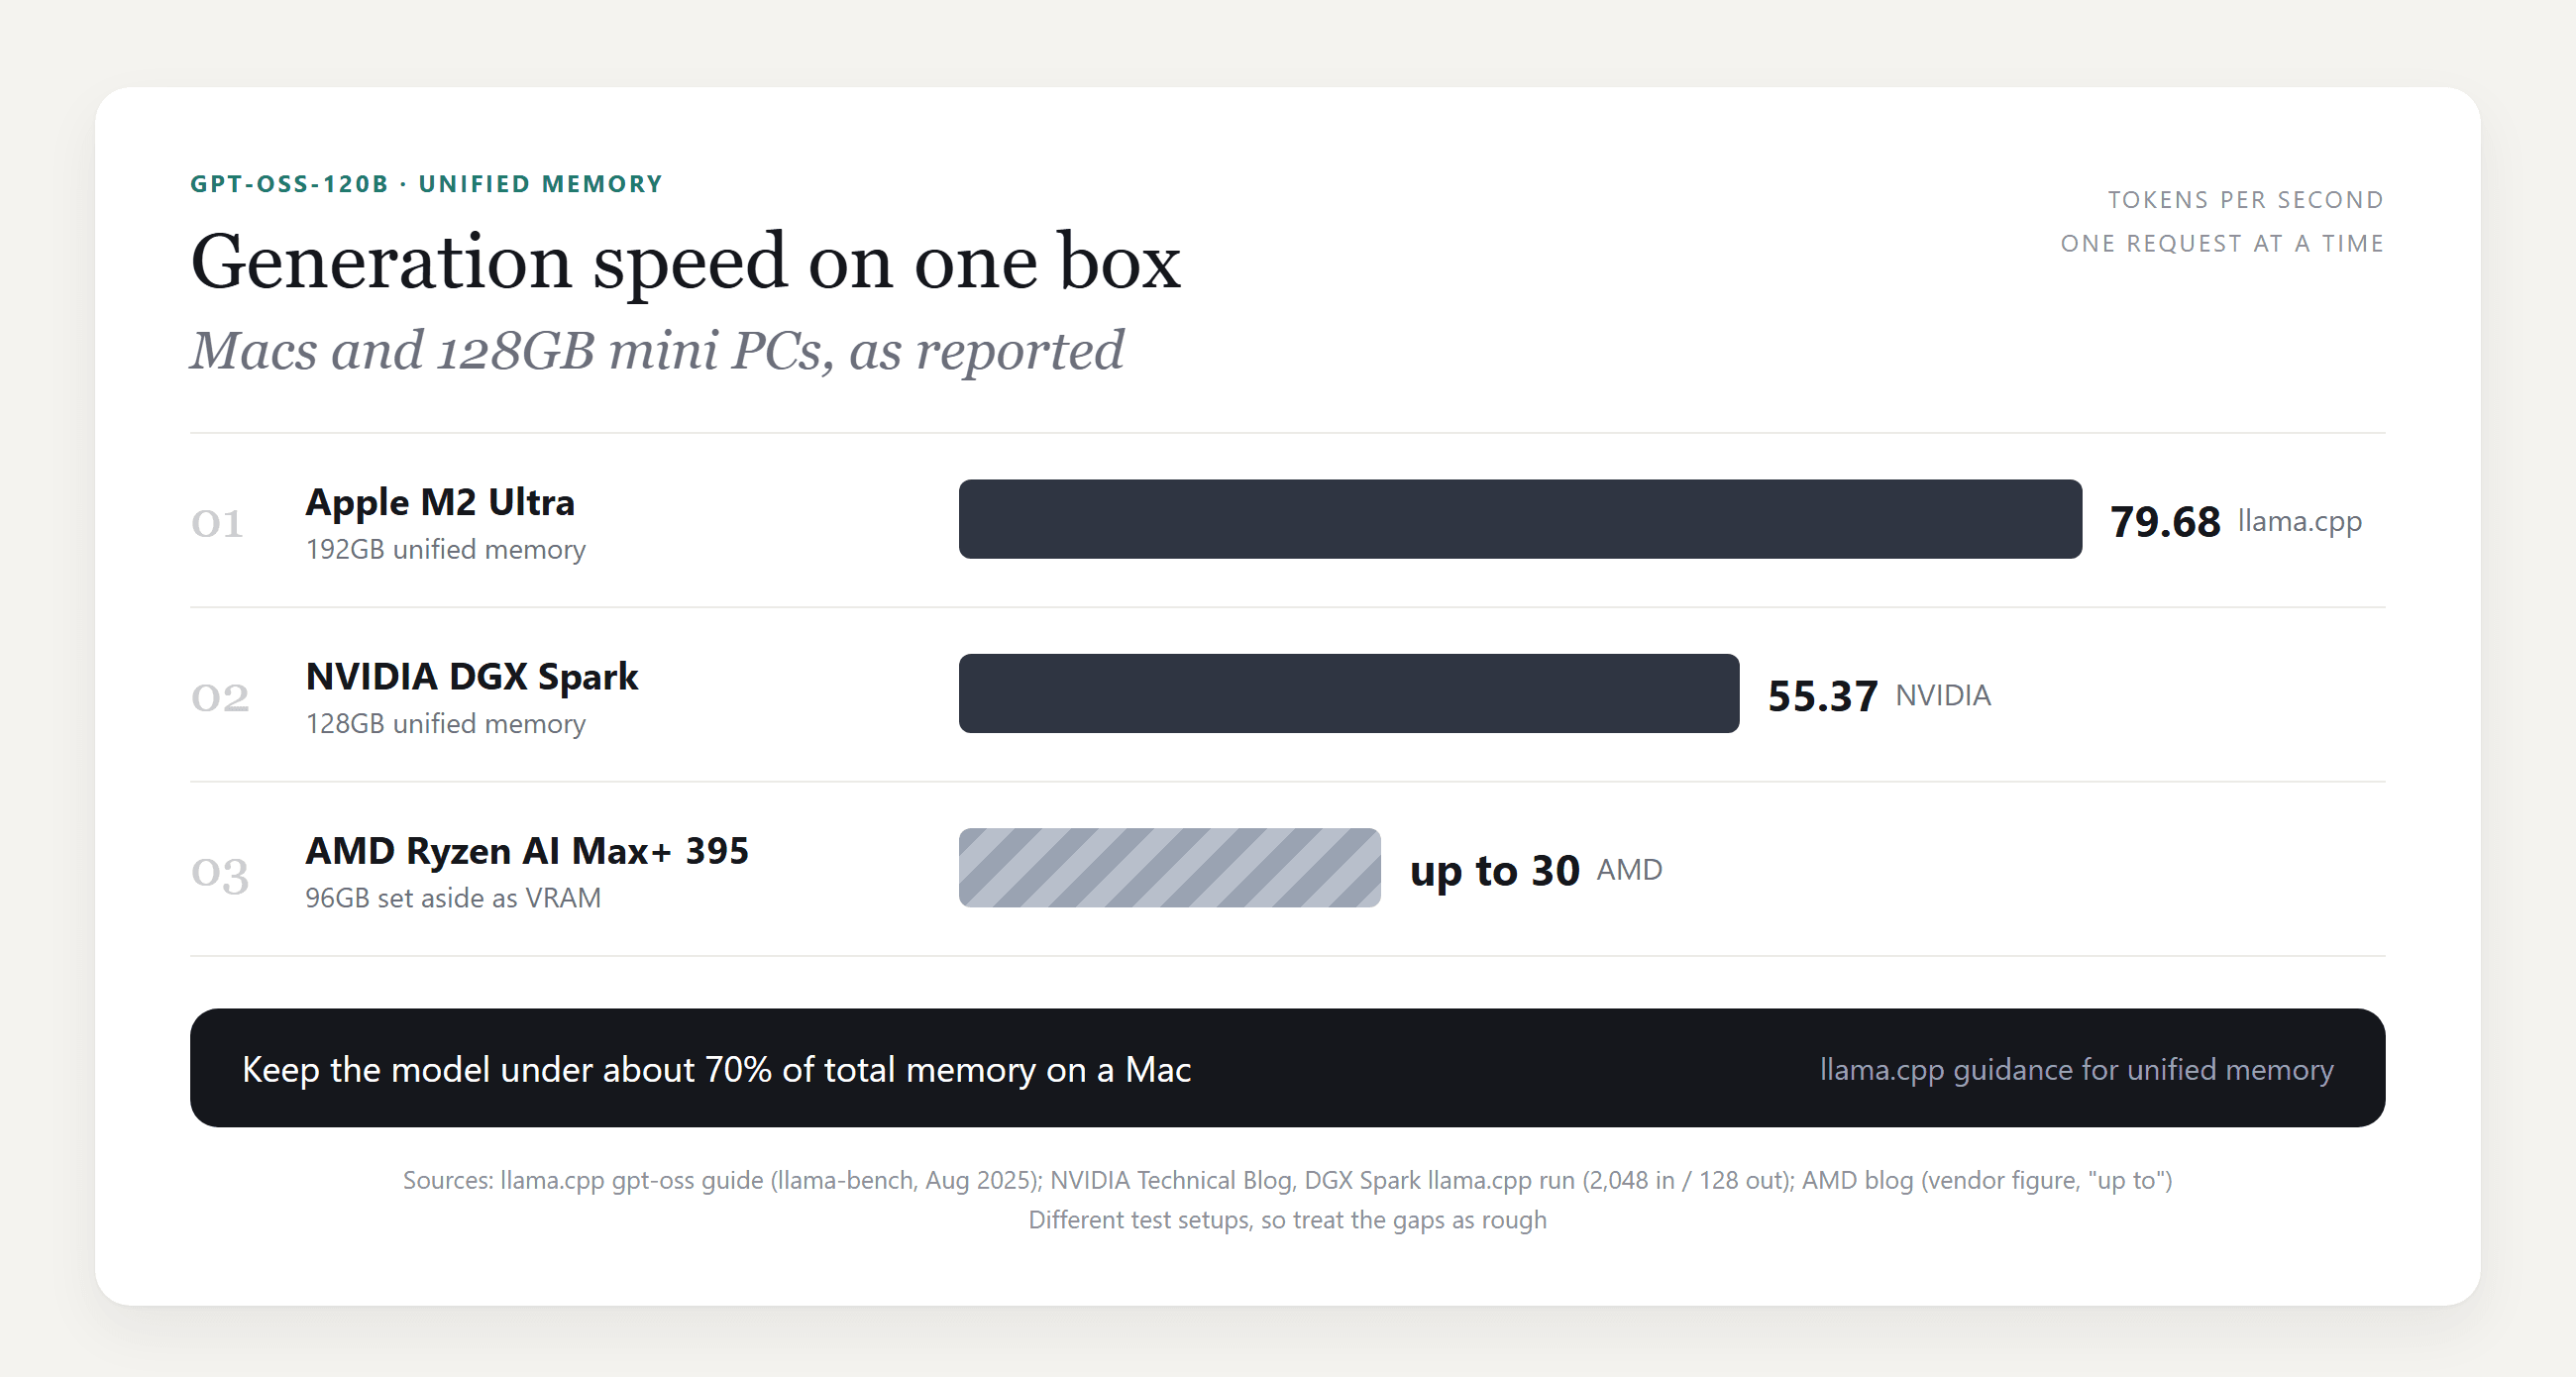
Birleşik bellek, GPU ve RAM ayrımını ortadan kaldırır. llama.cpp kılavuzu, M2 Ultra veya M3 Max makineleri gibi 96GB'den fazla RAM'e sahip Mac'lerin modeli tam bağlamda çalıştırabileceğini söylüyor ve toplam belleğin yaklaşık %70'inin altında kalınmasını öneriyor.
macOS, GPU'nun varsayılan olarak bağlayabileceği bellek miktarını sınırlar. 192GB'lık bir makinede kılavuz, bu sınırı tek bir komutla 154GB'den 180GB'ye yükseltiyor:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
Yeni 128GB mini PC'ler de aynı sınıfa giriyor. NVIDIA, llama.cpp çalıştıran bir DGX Spark üzerinde gpt-oss-120b için 55,37 token/s bildiriyor. AMD, VRAM olarak 96GB ayrılmış bir Ryzen AI Max+ 395 makinesinin "saniyede 30 token'a kadar" ulaştığını söylüyor; bu şirketin kendi rakamıdır.
Bellek Yetersiz mi? API Üzerinden Barındırılan Açık Ağırlıklı Bir Model Kullanın
Bu makinelerden hiçbiri masanızda değilse, barındırılan bir açık ağırlıklı model donanım sorununu tamamen atlar.
Atlas Cloud, Qwen model serisinin bir parçası olan Qwen3.5 122B A10B'yi sunuyor. Kâğıt üzerinde gpt-oss-120b ile yakın bir eşleşme: Alibaba'nın Qwen ekibinden Apache 2.0 uzmanlar karışımı bir model, toplam 122B ve 10B aktif parametreyle. 262.144 token'a kadar bağlam okuyabiliyor.
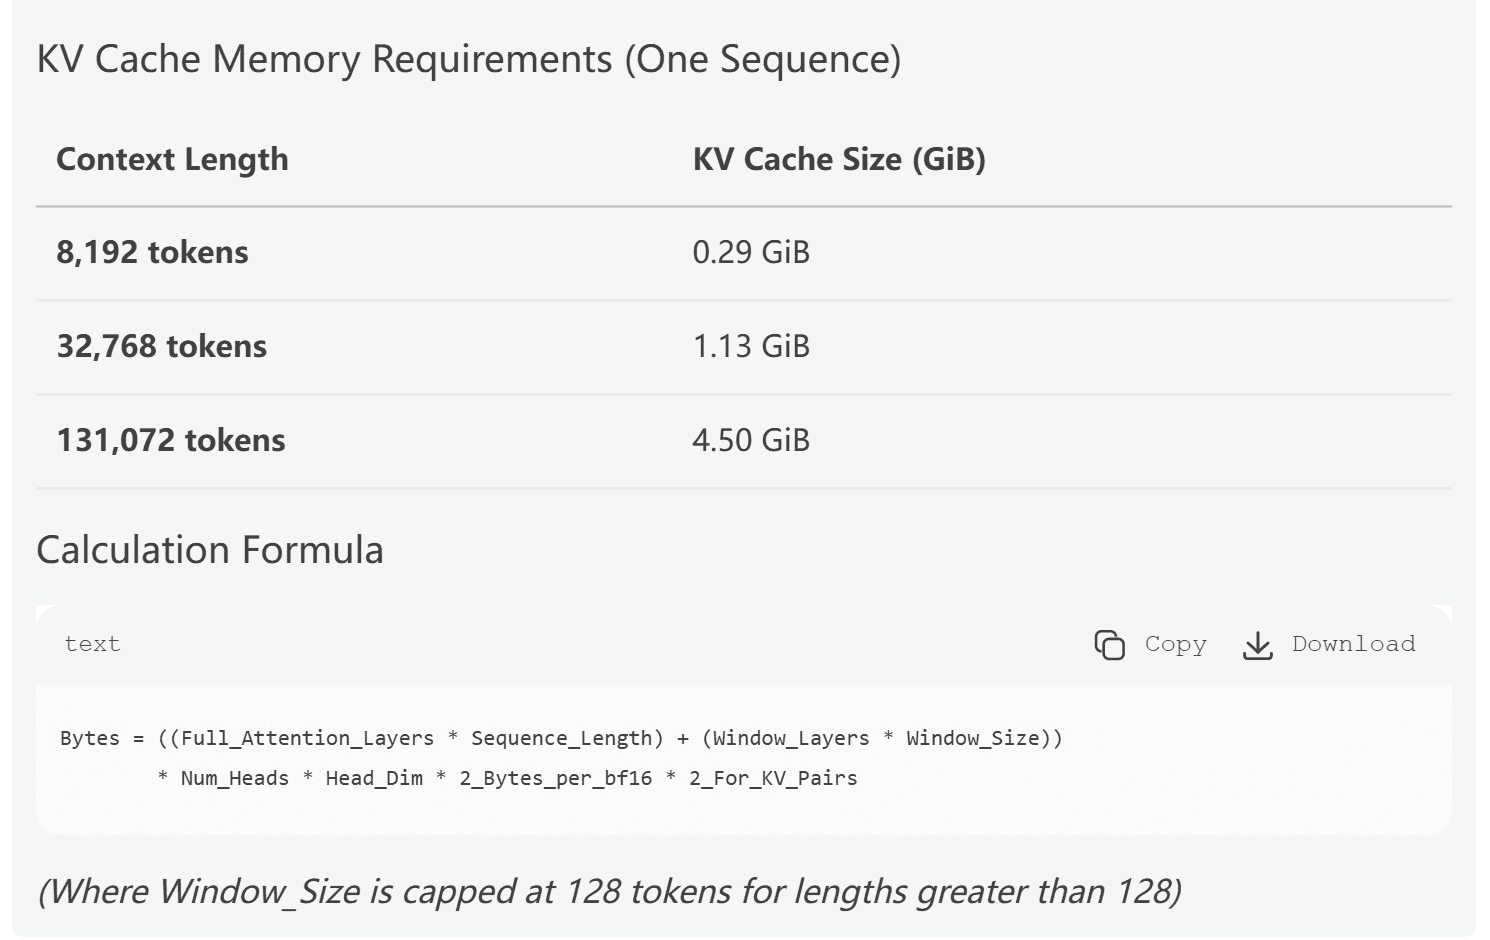
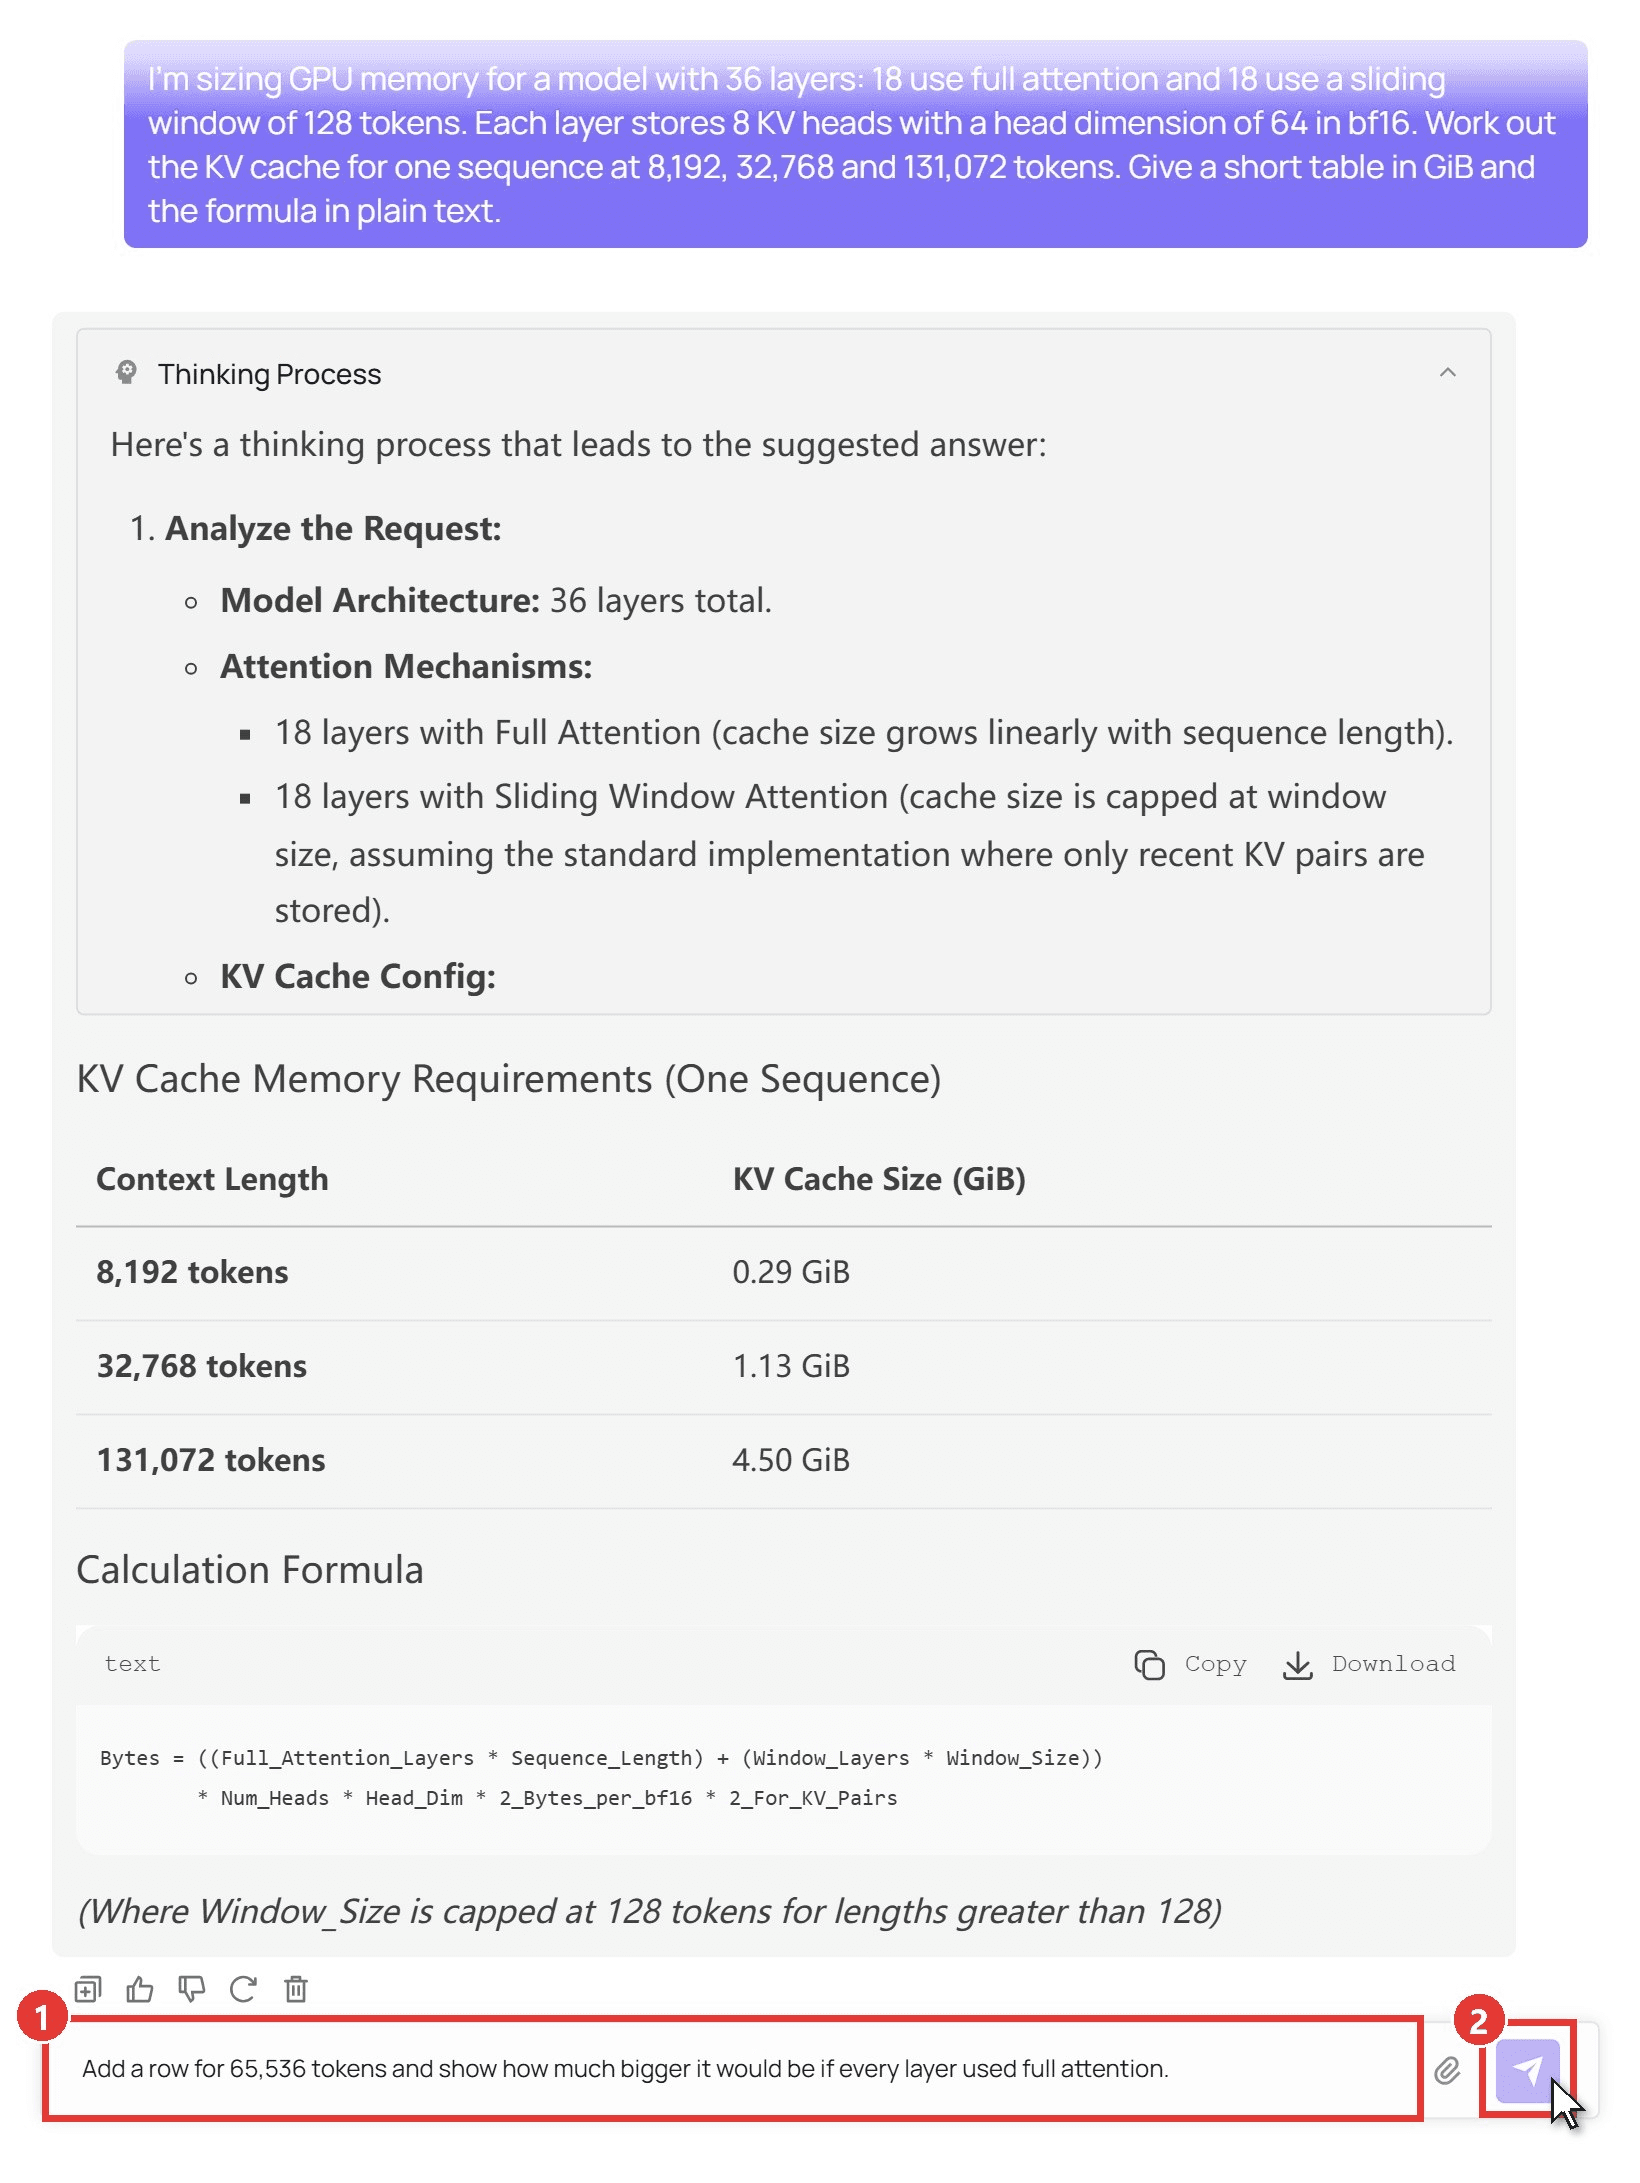
Ona gpt-oss yapılandırmasındaki dikkat düzenini verdik ve üç uzunlukta KV önbelleğini istedik. Tablosu kendi hesaplarımızla iki ondalık basamağa kadar eşleşti. Daha sonra kendi makineniz için bir Qwen isterseniz, yerel kodlama için en iyi Qwen modeli kılavuzumuz onları RAM'e göre boyutlandırıyor.
Yöntem 1: Playground'da Qwen3.5 122B A10B'yi Deneyin
Oturum açın ve Qwen3.5 122B A10B playground sayfasını açın, ardından:
- Sorunuzu mesaj kutusuna yazın.
- Gönder okuya tıklayın. Muhakeme, yanıtın üstündeki bir Düşünme Süreci panelinde görünür.
Yöntem 2: Atlas Cloud API ile Qwen3.5 122B A10B'yi Çağırın
Betikler ve uygulamalar için:
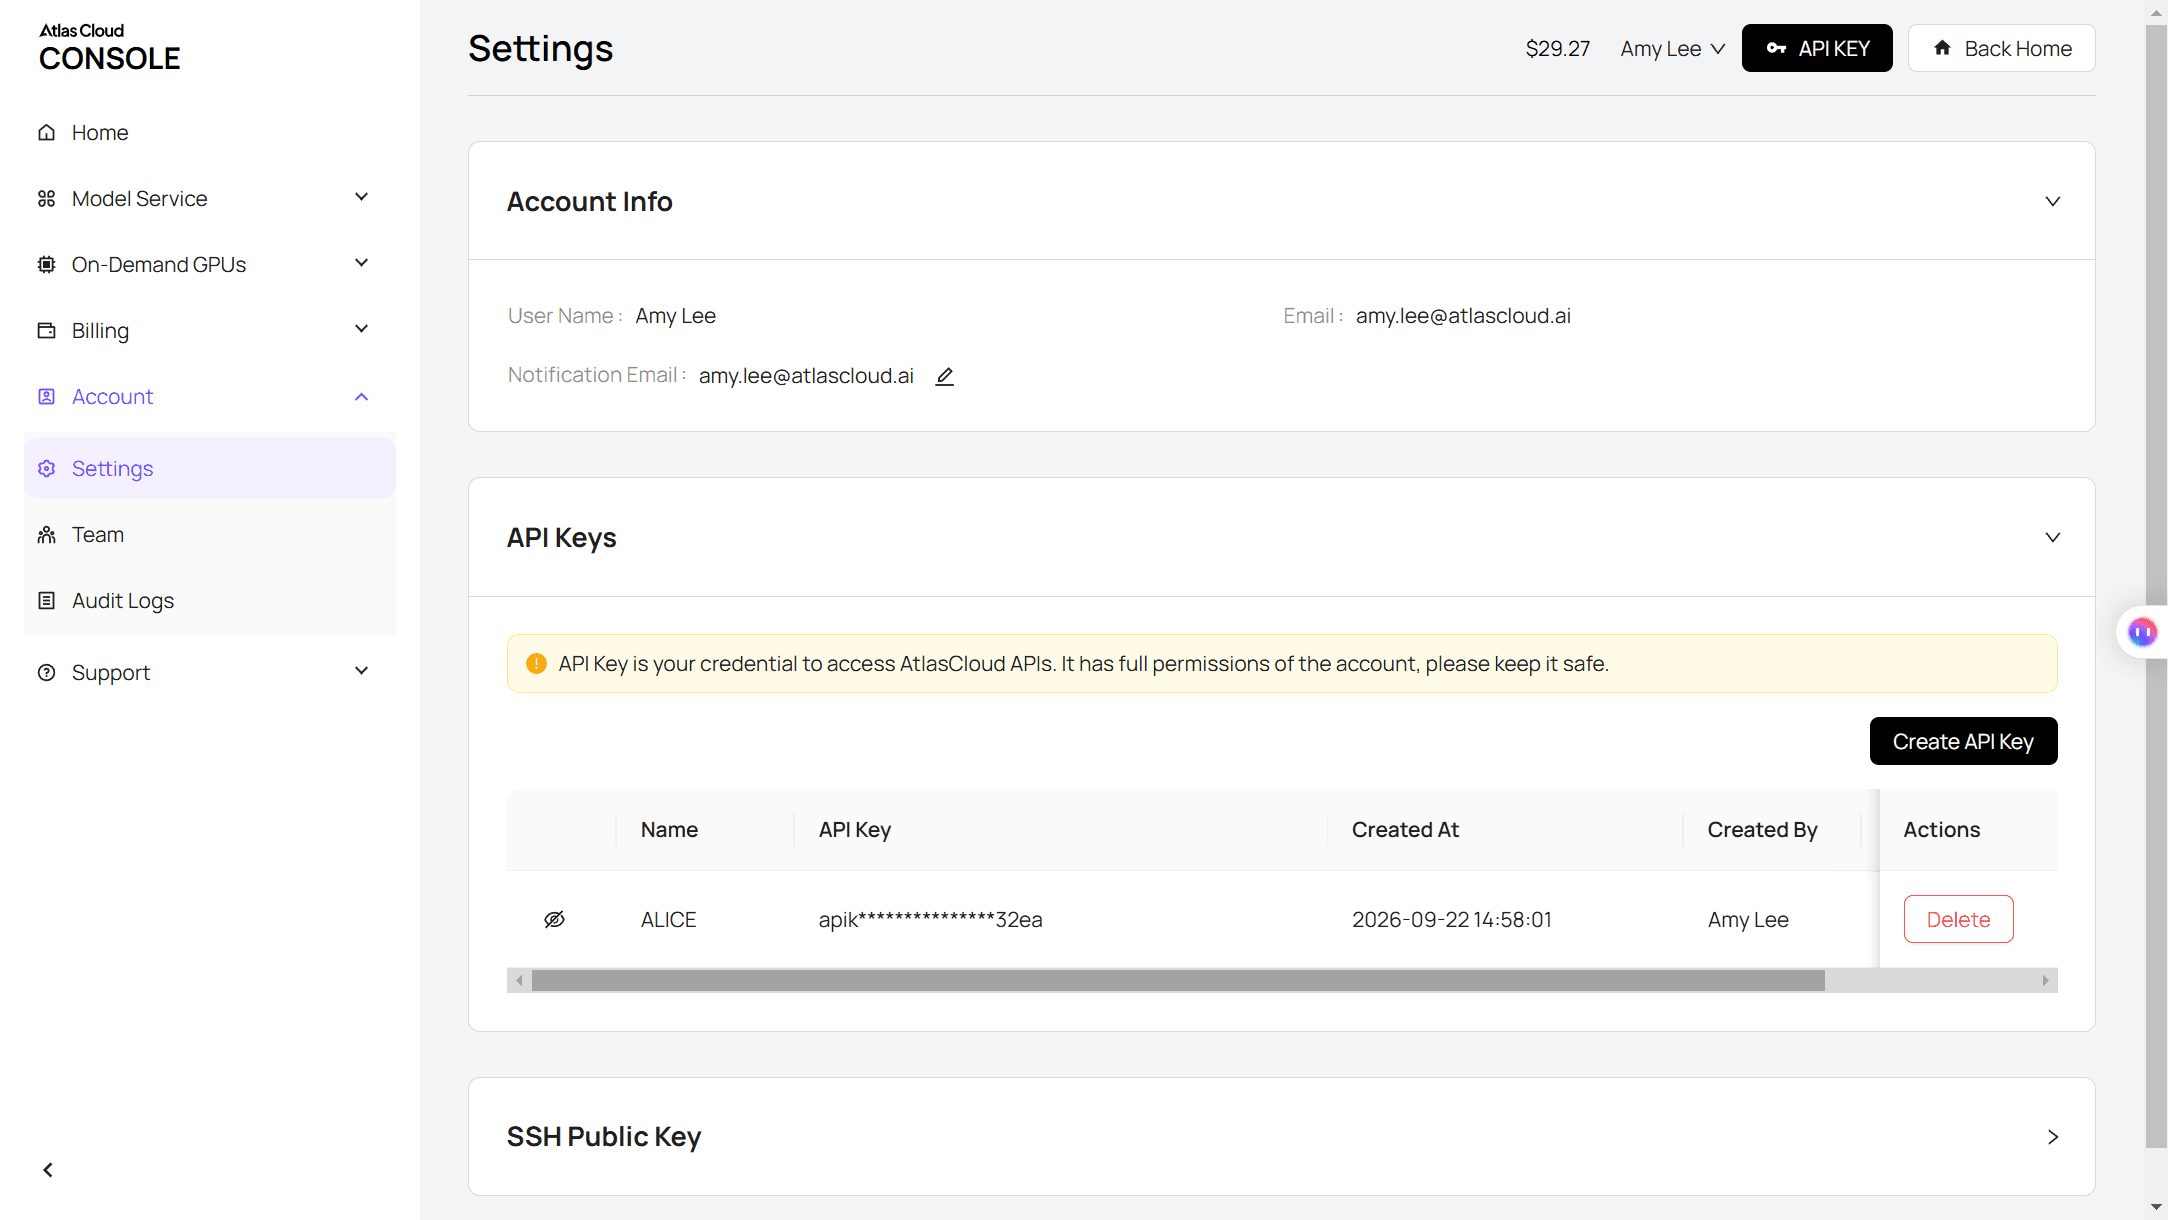
Adım 1: Bir API anahtarı oluşturun. Konsolda Ayarlar'ı açın, API Anahtarları'na gidin ve API Anahtarı Oluştur'a tıklayın. Bunu sunucu tarafında tutun.
Adım 2: İstek biçimini kontrol edin. API dokümantasyonu sohbet tamamlama biçimini kapsıyor ve model sayfasında hazır bir örnek içeren bir API sekmesi var.
Adım 3: İlk isteğinizi gönderin.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
Yanıt choices[0].message.content içinde geri gelir. Uç nokta OpenAI biçimini izlediği için, yerel bir gpt-oss sunucusu için yazılmış kod genellikle yalnızca yeni bir temel URL, anahtar ve model dizesi gerektirir. Aynı anahtar platformdaki diğer sohbet modellerinde de çalışır; birleşik LLM API ağ geçidi yazımız bunu ele alıyor.
GPT-OSS-120B vs GPT-OSS-20B: Bellek ve Kıyaslama Ödünleşimi
Küçük kardeş, belleğin beşte birini gerektirir. gpt-oss-20b 20,9B parametreye sahip ve 3,6B'si aktif ve OpenAI bunun "16GB kadar az bellekte" çalıştığını söylüyor. Soru, neyden vazgeçtiğinizdir.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | 8K bağlamda bellek (llama.cpp) | 64,0 GB | 14,9 GB | | MMLU | 90,0 | 85,3 | | GPQA Diamond (araçsız) | 80,1 | 71,5 | | SWE-Bench Verified | 62,4 | 60,7 | | Codeforces Elo (araçsız) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
Puanlar, yüksek muhakeme çabasında model kartından gelir. Kodlama farkı SWE-Bench Verified'da iki puanın altında, bilgi farkı ise lisansüstü düzey bilimde yaklaşık 9 puan ve HealthBench'te 15 puan. 16GB ila 24GB'lık bir kartta çoğunlukla kod içinse 20b mantıklı seçimdir. Ekstra bilgiye mi ihtiyacınız var? 120b'nin bellek faturasını hak ettiği yer burasıdır.
GGUF, Ollama veya vLLM: Bellek Bütçeniz için Bir Çalışma Zamanı Seçin
Her biri OpenAI'nin yayınladığı MXFP4 ağırlıklarını çalıştırır; farkları bu ağırlıkların nerede yaşayabileceğidir.
| Çalışma zamanı | İndirme | En uygun olduğu durum |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | Tüm modeli tutan bir makinede tek bir kullanıcı |
| LM Studio | 65 GB | Mac veya Windows PC'de bir masaüstü uygulaması |
| llama.cpp (ggml-org GGUF) | Yaklaşık 63 GB | 65 GB'den az VRAM, uzman katmanları RAM'e aktarılmış |
| vLLM | Yaklaşık 65 GB safetensors | Bir veya daha fazla veri merkezi GPU'sundan çok sayıda kullanıcıya hizmet |
Büyük bellekli bir makinede hızlı başlangıç için:
plaintext1ollama run gpt-oss:120b
Daha küçük bir GPU için llama.cpp kullanın ve aktarma sayısını ayarlayın:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Dördü de modelin düzgün çalışması için gereken OpenAI harmony sohbet biçimini işler. Bu yalnızca kendi sunum kodunuzu yazarsanız önemlidir.
SSS
GPT-OSS-120B, GPT-5 veya Gemini 3 Pro'dan daha mı iyi?
Farklı kategorilerde yer alıyorlar: GPT-5 ve Gemini, bir uygulama veya API üzerinden eriştiğiniz kapalı modellerdir, gpt-oss-120b ise kendi donanımınızda çalışır. Gemini 3 Pro Preview da 9 Mart 2026'da kapatıldı ve adı artık Gemini 3.1 Pro Preview'ı işaret ediyor. Yerel kontrol önemliyse, Google'ın açık ağırlıklı serisi Gemma 4 ailesidir.
Bazı siteler neden GPT-OSS-120B'nin 255 GB gerektirdiğini söylüyor?
Bu rakamlar 16 bit ağırlıkları varsayar: kabaca 117B parametre çarpı 2 bayt, artı ek yük. OpenAI'nin yayınladığı kontrol noktası zaten MXFP4, bu yüzden gerçekçi indirme 61 GB aralığındadır.
Muhakeme çabası bellek kullanımını değiştirir mi?
Ağırlıklar için hayır. Düşük, orta ve yüksek ayarları modelin ne kadar düşündüğünü değiştirir. Yüksek çaba daha fazla muhakeme token'ı yazar; bu da bağlam penceresini doldurur ve KV önbelleğini büyütür, böylece uzun oturumlar yukarıdaki grafikteki daha büyük toplamlara doğru sürünür.
İnsanlar neden GPT-OSS-120B'nin metin tabanlı oyunlarda zorlandığını söylüyor?
Kanıtlar anekdot niteliğinde. Modelin Hugging Face tartışma sayfasında bazı kullanıcılar şiddet içeren kurgu yazarken reddetmeler bildiriyor, diğerleri ise rol yapmanın sorunsuz çalıştığını söylüyor. Etkileşimli kurgu için, bunun için donanım satın almadan önce kendi istemlerinizi test edin.
Barındırılan 120B sınıfı bir model ne kadar maliyetli?
Ekim 2026 itibarıyla, Qwen3.5 122B A10B Atlas Cloud'da milyon giriş token'ı başına 0,3 $ ve milyon çıkış token'ı başına 2,4 $ maliyetlidir. Bu, normal 0,4 $ ve 3,2 $ ücretlerinde %25 indirimdir. Boyutlandırma sorumuz, muhakeme sayıldığında yaklaşık 5.000 çıkış token'ı kullandı; indirimli oranda yaklaşık bir sent.
Sonuç
GPT-OSS-120B, parametre sayısının ima ettiğinden sığdırması daha kolaydır. Günlük bağlam uzunluklarında yaklaşık 65 GB ve tam 131K'da 70 GB'ın altında planlayın. Tek bir 80GB GPU, 96GB'den fazla belleğe sahip bir Mac veya 128GB'lık bir mini PC onu tutacaktır ve daha küçük kartlar uzman katmanlarını sistem RAM'ine taşıyarak çalıştırabilir.
Bu sayılar makinenizi eliyorsa, çoğunlukla kodlama işleri için gpt-oss-20b'ye düşün veya donanım satın almadan daha büyük beyne ihtiyaç duyduğunuzda barındırılan açık ağırlıklı bir modeli çağırın. Her iki durumda da, gpt oss 120b bellek gereksinimleri, ağırlıkların 61 GB aldığını ve gerisinin hareket alanı olduğunu bildiğinizde bir tahmin oyunu olmaktan çıkar.


