


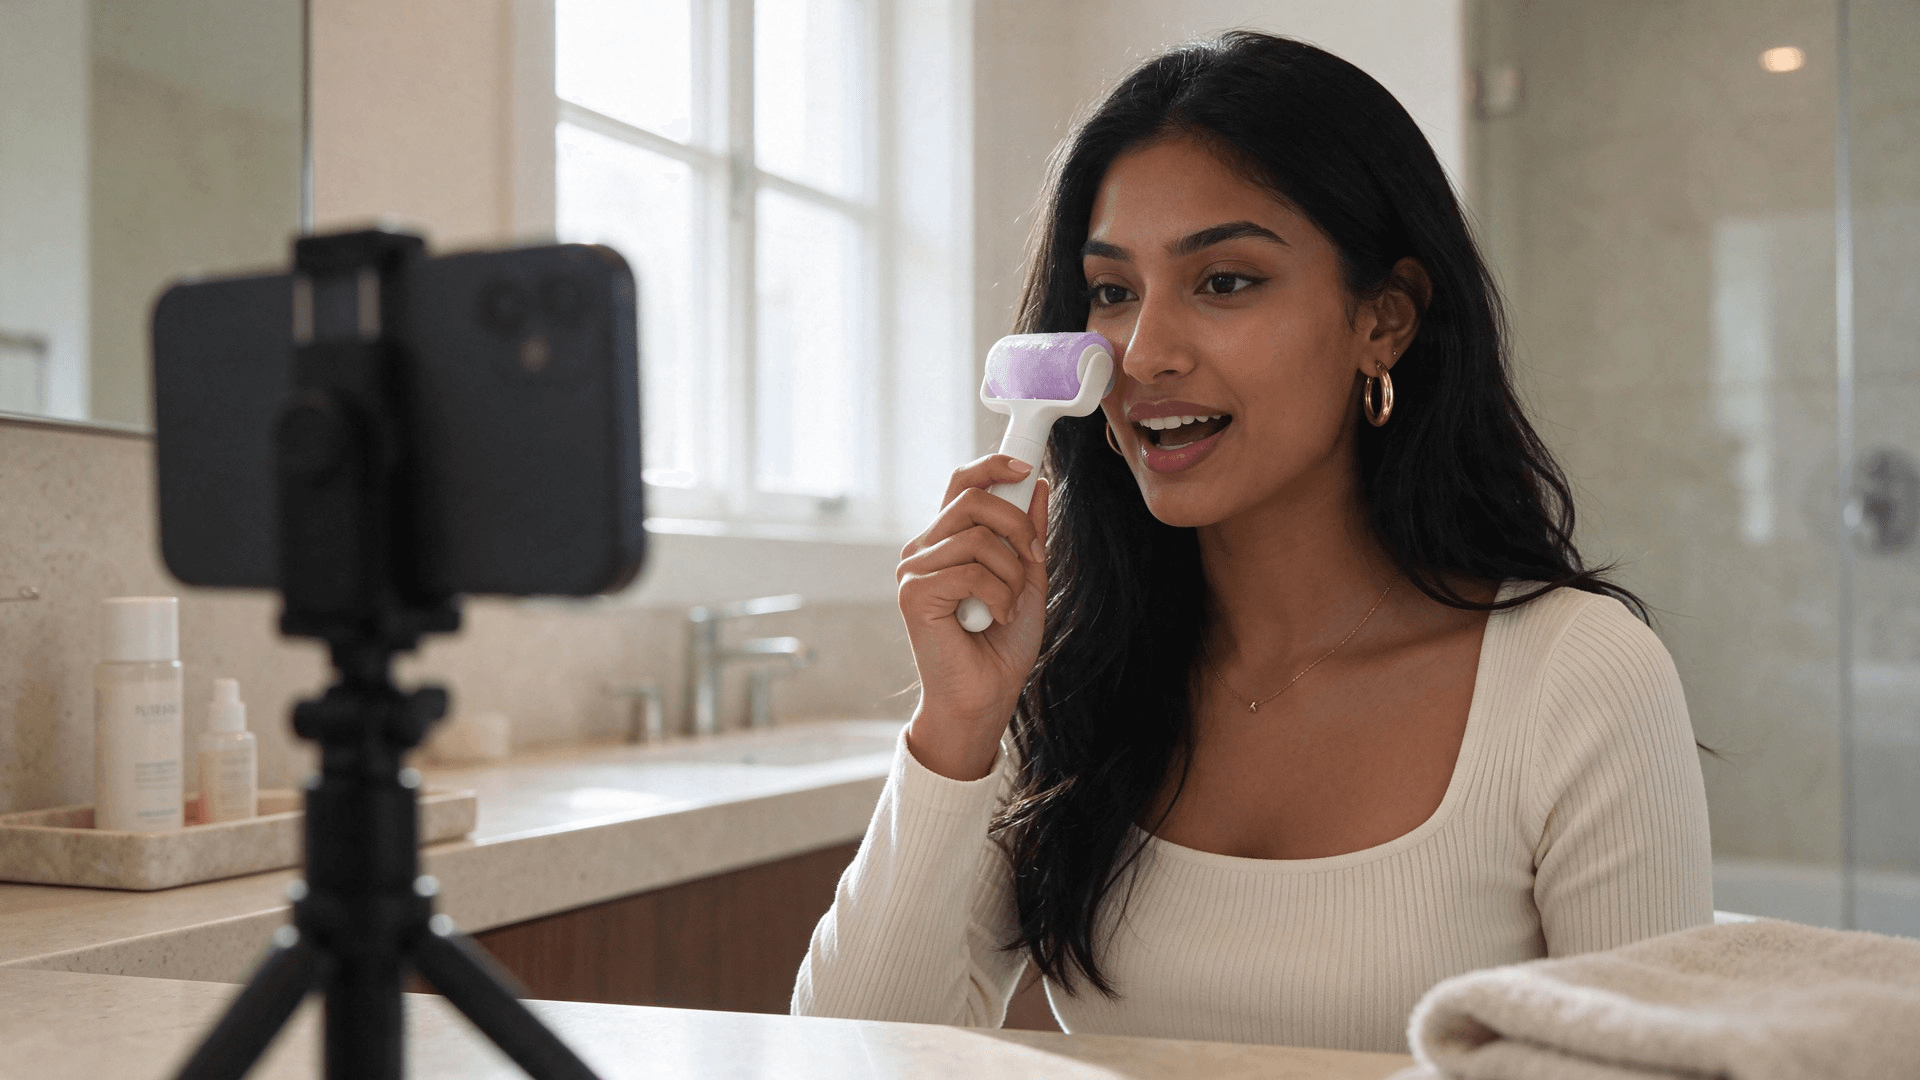
這段影片開頭是一名女子在浴室梳妝台前。她把霧面冰滾輪沿著顴骨往上滾,並抱怨自己只睡四小時就接了早上 7 點的電話。沒有人拿攝影機對著她拍。這支影片來自一張肖像、一張產品照和一段 8 秒的語音台詞。
本指南會帶你了解如何為品牌影片打造像她這樣的 AI 網紅:一張可重複用於任何場景的臉、借用自已爆紅影片的開場鉤子,以及每當腳本變更就能重新生成的會說話短片。我們在撰寫本文時打造了這個範例,因此每個步驟都會展示真實的輸入與輸出。
重點摘要
- AI 網紅是一張一致的脸孔,讓你跨影片重複使用,並以單一參考照片打造。
- 從已驗證的 TikTok 開場鉤子著手:在寫下任何一行腳本前,先拆解一支爆紅影片。
- Seedance 2.5 能將一張肖像、一張產品照和一段配音台詞變成對嘴的會說話影片。
- 寫下三句開場鉤子,各跑成一支短片,然後留下前三秒最到位的那一支。
- 在 TikTok 上標註 AI 製作的主持人,且只使用你獲准使用的真人臉孔。
什麼是 AI 網紅,以及誰會打造他們
AI 網紅是一個生成人物,會以同一張臉、同一把聲音和同一種風格一再出現在鏡頭前。「一再出現」正是整件事的核心。一個好看的畫面很容易。真正會讓人搜尋的,是一位主持人在週一看起來像是在廚房、週五在車裡,但看起來仍是同一個女人。
有兩類人會打造它們,而且想要的不同:
| 人設帳號 | 品牌主持人 | |
|---|---|---|
| 目標 | 以虛擬人物身分成長追蹤者 | 為產品影片與廣告出鏡 |
| 必須保持不變的項目 | 臉孔、個性、人生故事 | 臉孔、聲音、表達風格 |
| 典型輸出 | 每日貼文、限時動態、直播 | 10 到 30 秒的開場鉤子與示範 |
| 成功指標 | 受眾規模 | 觀看時間與產品點擊數 |
本指南涵蓋第二欄。如果你還不熟悉這種形式,我們關於什麼是 AI UGC的說明會先介紹基礎。
在 Atlas Cloud 上將一張照片變成會說話的 AI 網紅
在進入任何理論之前,先看完成品:10 秒、直式,有她的聲音、滾輪作用的特寫,以及最後舉起產品。
它是在 Atlas Cloud 上以 Seedance 2.5 Reference-to-Video 製作的。作為 AI 網紅生成器,它從你的輸入開始:你提供臉孔、產品和聲音,它則圍繞這些元素建立鏡頭。
它在單一請求中最多接受 30 張參考圖片,包括真人照片,而單一音訊片段本身就能驅動對嘴。
這對品牌主持人來說很重要。每支影片都保有你的臉孔,而當腳本變更時,你只要替換一個音訊檔案,不必安排重拍。
整個流程都在 Seedance 2.5 Reference-to-Video 操作頁面的同一頁面上完成:
- 先在 Reference Images 上傳肖像,再上傳產品照。順序很重要:第一個檔案會成為 Image1。
- 在 Reference Audio 上傳語音台詞。
- 貼上提示詞,然後重新輸入每個 @ 提及,並從清單中選取對應檔案,讓它變成標籤。
- 將 Duration 設為 10、Resolution 設為 1080p、Aspect Ratio 設為 9:16。
- 按一下 Run。
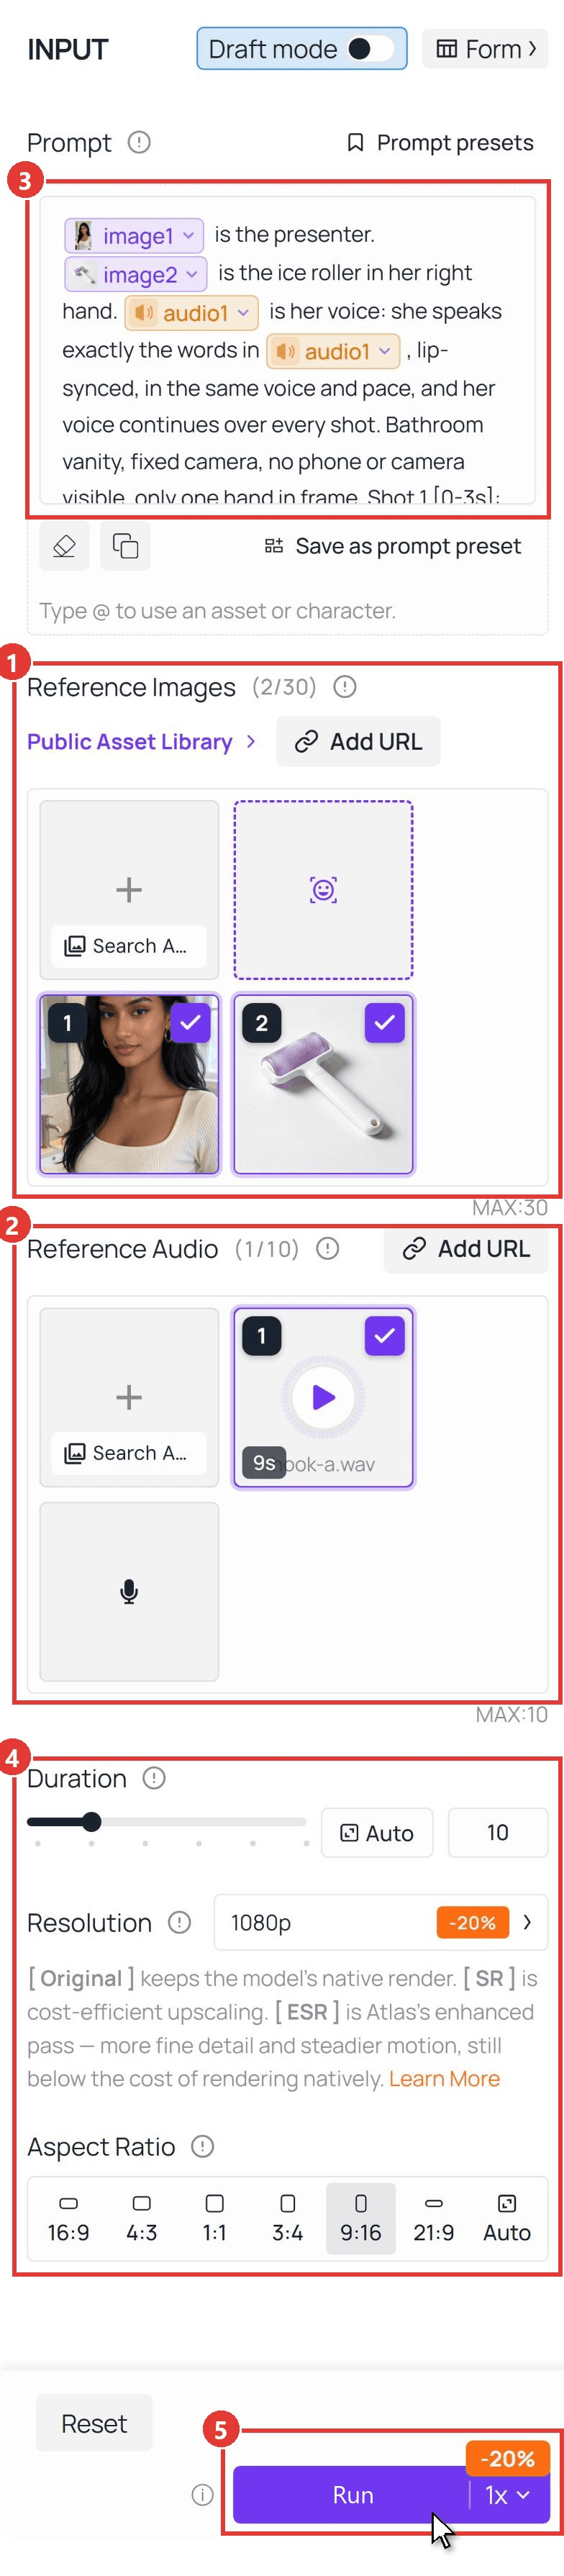
如何用 5 個步驟打造 AI 網紅
操作頁面只是最後一鍵。真正決定影片能否讓人停下滑動的,是你餵給它的一切,因此以下從研究到完成開場鉤子,說明如何打造 AI 網紅。
步驟 1:從一支真實爆紅影片拆解 TikTok 開場鉤子
不要從空白腳本開始。挑一支你所在領域中已經帶來觀看的 Short,把它拆解開來。
我們使用了 All You Can Face 頻道一支 19 秒的例行程序,改善浮腫臉、浮腫眼皮與浮腫眼下的例行程序。我們沒有看它十遍,而是透過 Atlas Cloud API 把連結交給 Gemini 3.5 Flash。公開的 YouTube 連結可直接作為影片輸入:
plaintext1curl -X POST "https://api.atlascloud.ai/v1/models/google/gemini-3.5-flash:generateContent" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "contents": [{ 6 "role": "user", 7 "parts": [ 8 {"fileData": {"mimeType": "video/mp4", "fileUri": "https://www.youtube.com/shorts/V_rNa1iOuXA"}}, 9 {"text": "Return the 0-3s hook line verbatim, the hook type, each shot change with its timestamp, all on-screen text, and the hook as one reusable template sentence."} 10 ] 11 }] 12 }'
以下是回傳結果的重點整理:
| 我們詢問的項目 | 影片實際做法 |
|---|---|
| 開場台詞 | 「如果你醒來臉很腫,就做這個 20 次。」 |
| 鉤子類型 | 以直接指示包裝的痛點 |
| 結構 | 四個鏡頭,每個問題一個,每個鏡頭都用同一句式開場 |
| 螢幕文字 | 每顆鏡頭新增一個項目的檢查清單 |
| 取景 | 胸部以上,全程眼睛看著鏡頭 |
| 可重複使用的模式 | 若你醒來有 [problem],就 [Action] [amount] |
一份 TikTok 開場鉤子清單能給你開頭台詞。拆解中有用的部分,是台詞底下的結構:一個重複的句式、每個鏡頭都有一個看得見的收穫、沒有開場白。這就是我們帶進腳本裡的東西。
步驟 2:鎖定一張臉,並跨場景重複使用
你的網紅只有在每次看起來都是同一個人時,對觀眾才算真實。從一張你擁有使用權的肖像開始,然後改變除了臉孔之外的一切:服裝、房間、光線。
任何能依參考圖編輯的圖像模型都能做到。我們在 Atlas Cloud 上使用了 Seedream:用 5.5 Edit 模型把一張攝影棚肖像變成浴室梳妝台主鏡頭,再用 5.0 Lite 序列編輯器在單一請求中,從該主鏡頭衍生出另外三個場景。
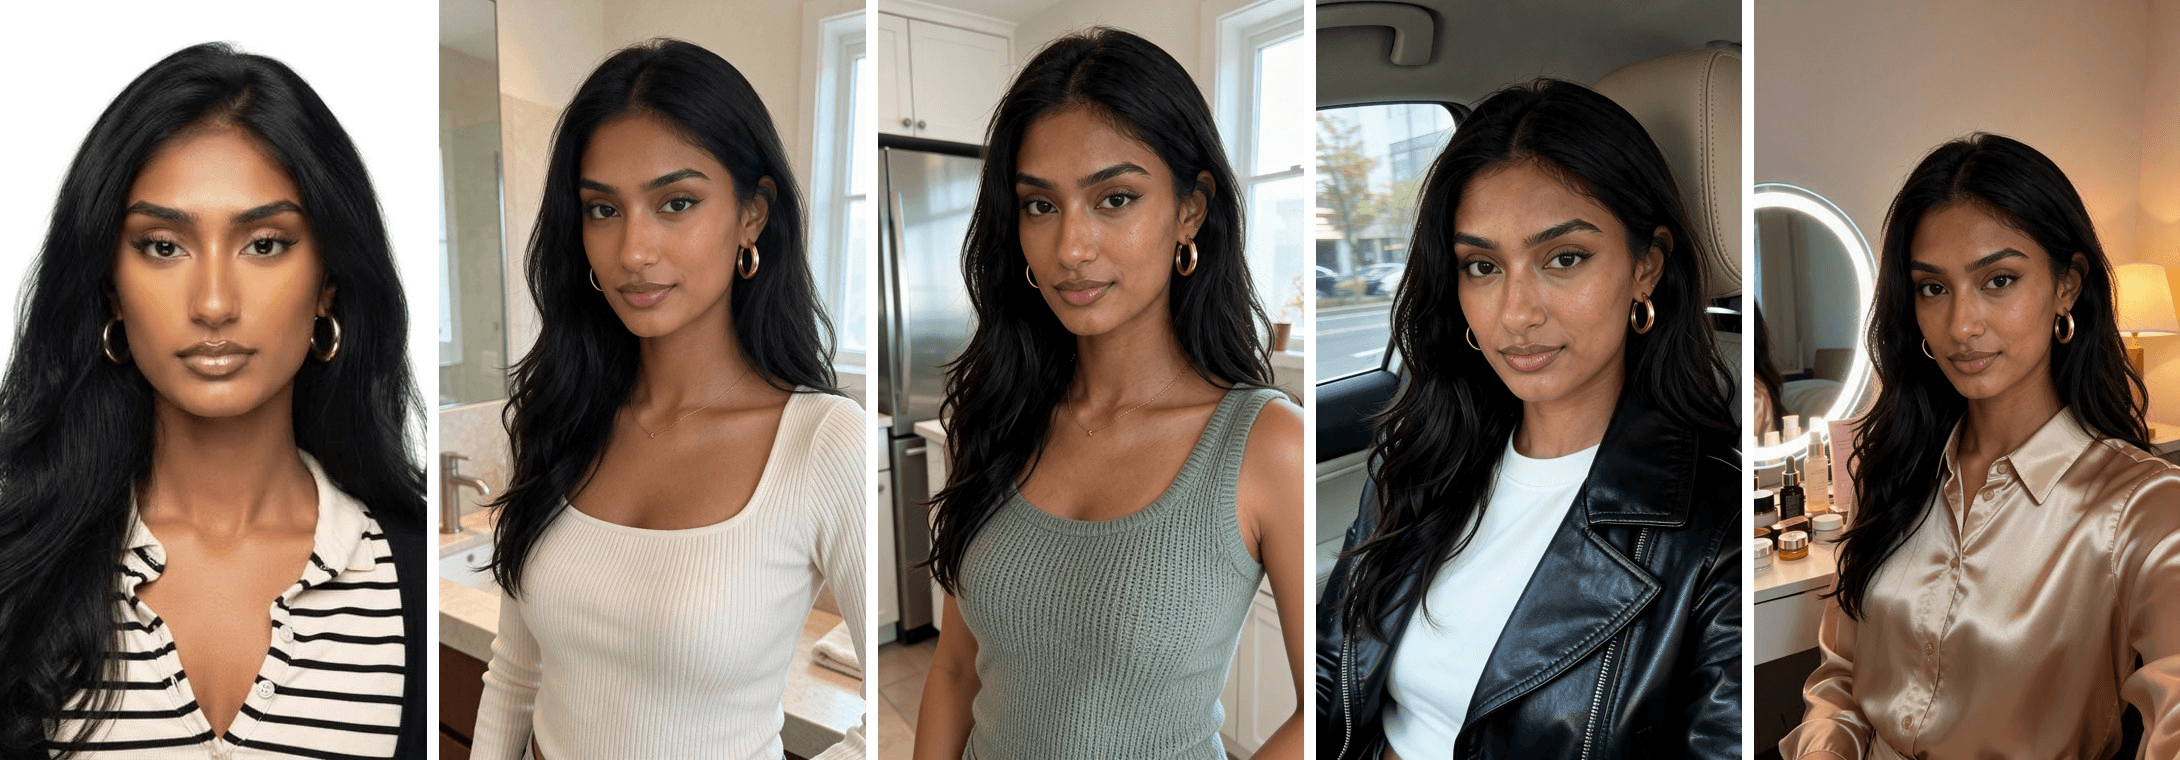
有三件事讓臉孔對我們來說保持穩定:
- 釘住身分,放開造型。 在第一句寫出不能改變的部分(臉孔、膚色、頭髮、耳環),再描述新的服裝與房間。
- 描述攝影機,而不是裝置。 「以固定攝影機在胸口高度拍攝」會得到乾淨的自拍風格畫面。提到櫃檯上的手機,模型往往就會畫出手機。
- 把她打扮得像創作者。 基本款運動衫看起來像素材影片。羅紋方領上衣或緞面襯衫,看起來就像一個刻意自拍的人。
步驟 3:依經過驗證的模式,寫出爆紅 TikTok 開場鉤子
有了步驟 1 的模式,寫作就變成填空。我們為冰滾輪草擬了三句台詞,各自借用不同的開場方式:
| 鉤子 | 台詞 | 開場類型 |
|---|---|---|
| A | 我只睡四小時,早上七點還接了電話。用這個東西兩分鐘,就沒人問我是不是累了。以下是我怎麼用。 | 誇張情境加數字 |
| B | 如果你醒來臉很腫,就做這個兩分鐘。從下顎往上滾、每邊眼睛下方,再滾過額頭。就這樣。 | 步驟 1 的模式 |
| C | 別再買抗浮腫眼霜了。我把它放進冷凍庫一整晚,滾兩分鐘,差別在鏡頭前看得出來。 | 反直覺建議 |
接著為每句台詞各自準備一條語音軌。Seedance 2.5 會直接對參考音訊進行對嘴,因此音訊就是腳本:用同一把聲音,把每個鉤子錄成或生成為獨立檔案。
我們在 Atlas Cloud 上用 Gemini 2.5 Pro TTS 生成我們的語音,使用 Sulafat 聲音,並在文字前加一句風格提示,要求以隨性、溫暖、帶點俏皮的方式朗讀。
步驟 4(方法 1):在操作頁面生成會說話的影片
對每個鉤子執行上方截圖中的五個點擊。每次執行之間只有音訊檔案不同。提示詞保持不變:
plaintext1@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced, in the same voice and pace, and her voice continues over every shot. Bathroom vanity, fixed camera, no phone or camera visible, only one hand in frame. 2Shot 1 [0-3s]: chest-up, she talks straight to the lens, holding the roller near her chin. 3Shot 2 [3-6s]: extreme close-up on her cheek. The roller head is pressed flat against her skin and rolls slowly upward along her cheekbone. The lilac cylinder turns on its axle as it moves, the white frost streaks on its surface rotating up and out of view, while the white handle stays still. Her skin gently dips under the roller. 4Shot 3 [6-10s]: back to chest-up, she holds the roller up beside her face toward the lens and finishes the line.
那段提示詞中有兩個選擇起了大部分作用。中間鏡頭是特寫,因為像圓柱轉動這類小型機械細節,在產品占滿畫面時最容易看清楚。而且語音台詞明確延續跨過剪接點,所以特寫感覺像同一個鏡頭裡的 B-roll。
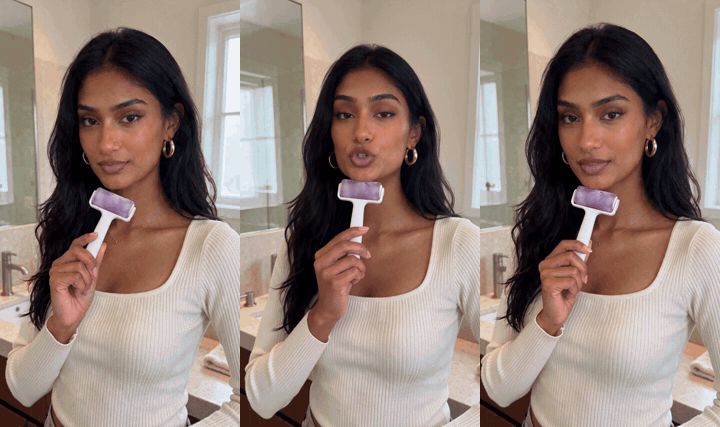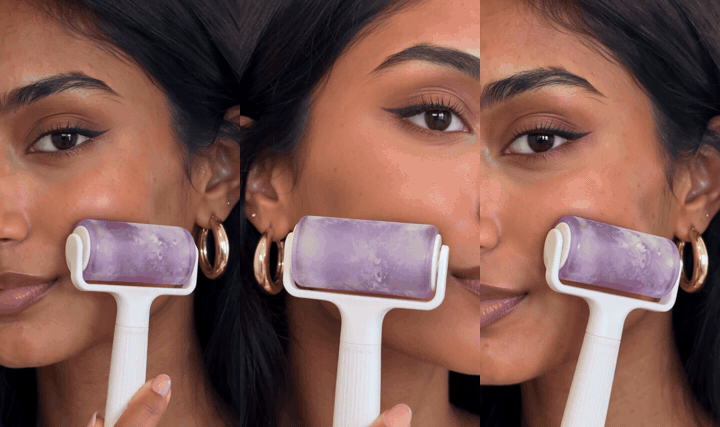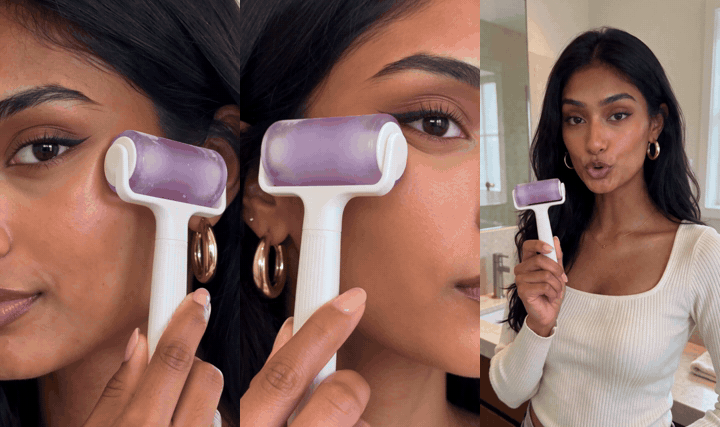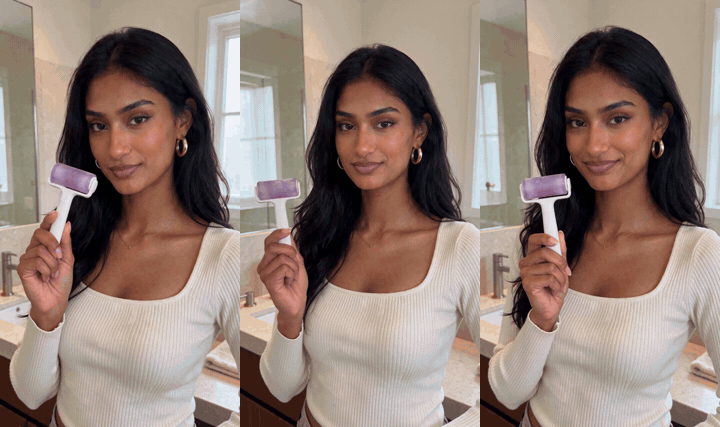
我們保留了鉤子 A 作為 1080p 版本。它的前兩秒帶有一個數字和一個代價(四小時睡眠、早上 7 點的電話),所以觀眾在第一次剪接前就知道回報是什麼。如果你比較想親手寫下每個畫面和鏡頭清單,我們的 20 分鐘 AI UGC 廣告工作流程會走那條路。
步驟 5(方法 2):透過 API 批次處理鉤子
一旦某個鉤子奏效,API 就能把另外十個變成音訊檔案上的迴圈。
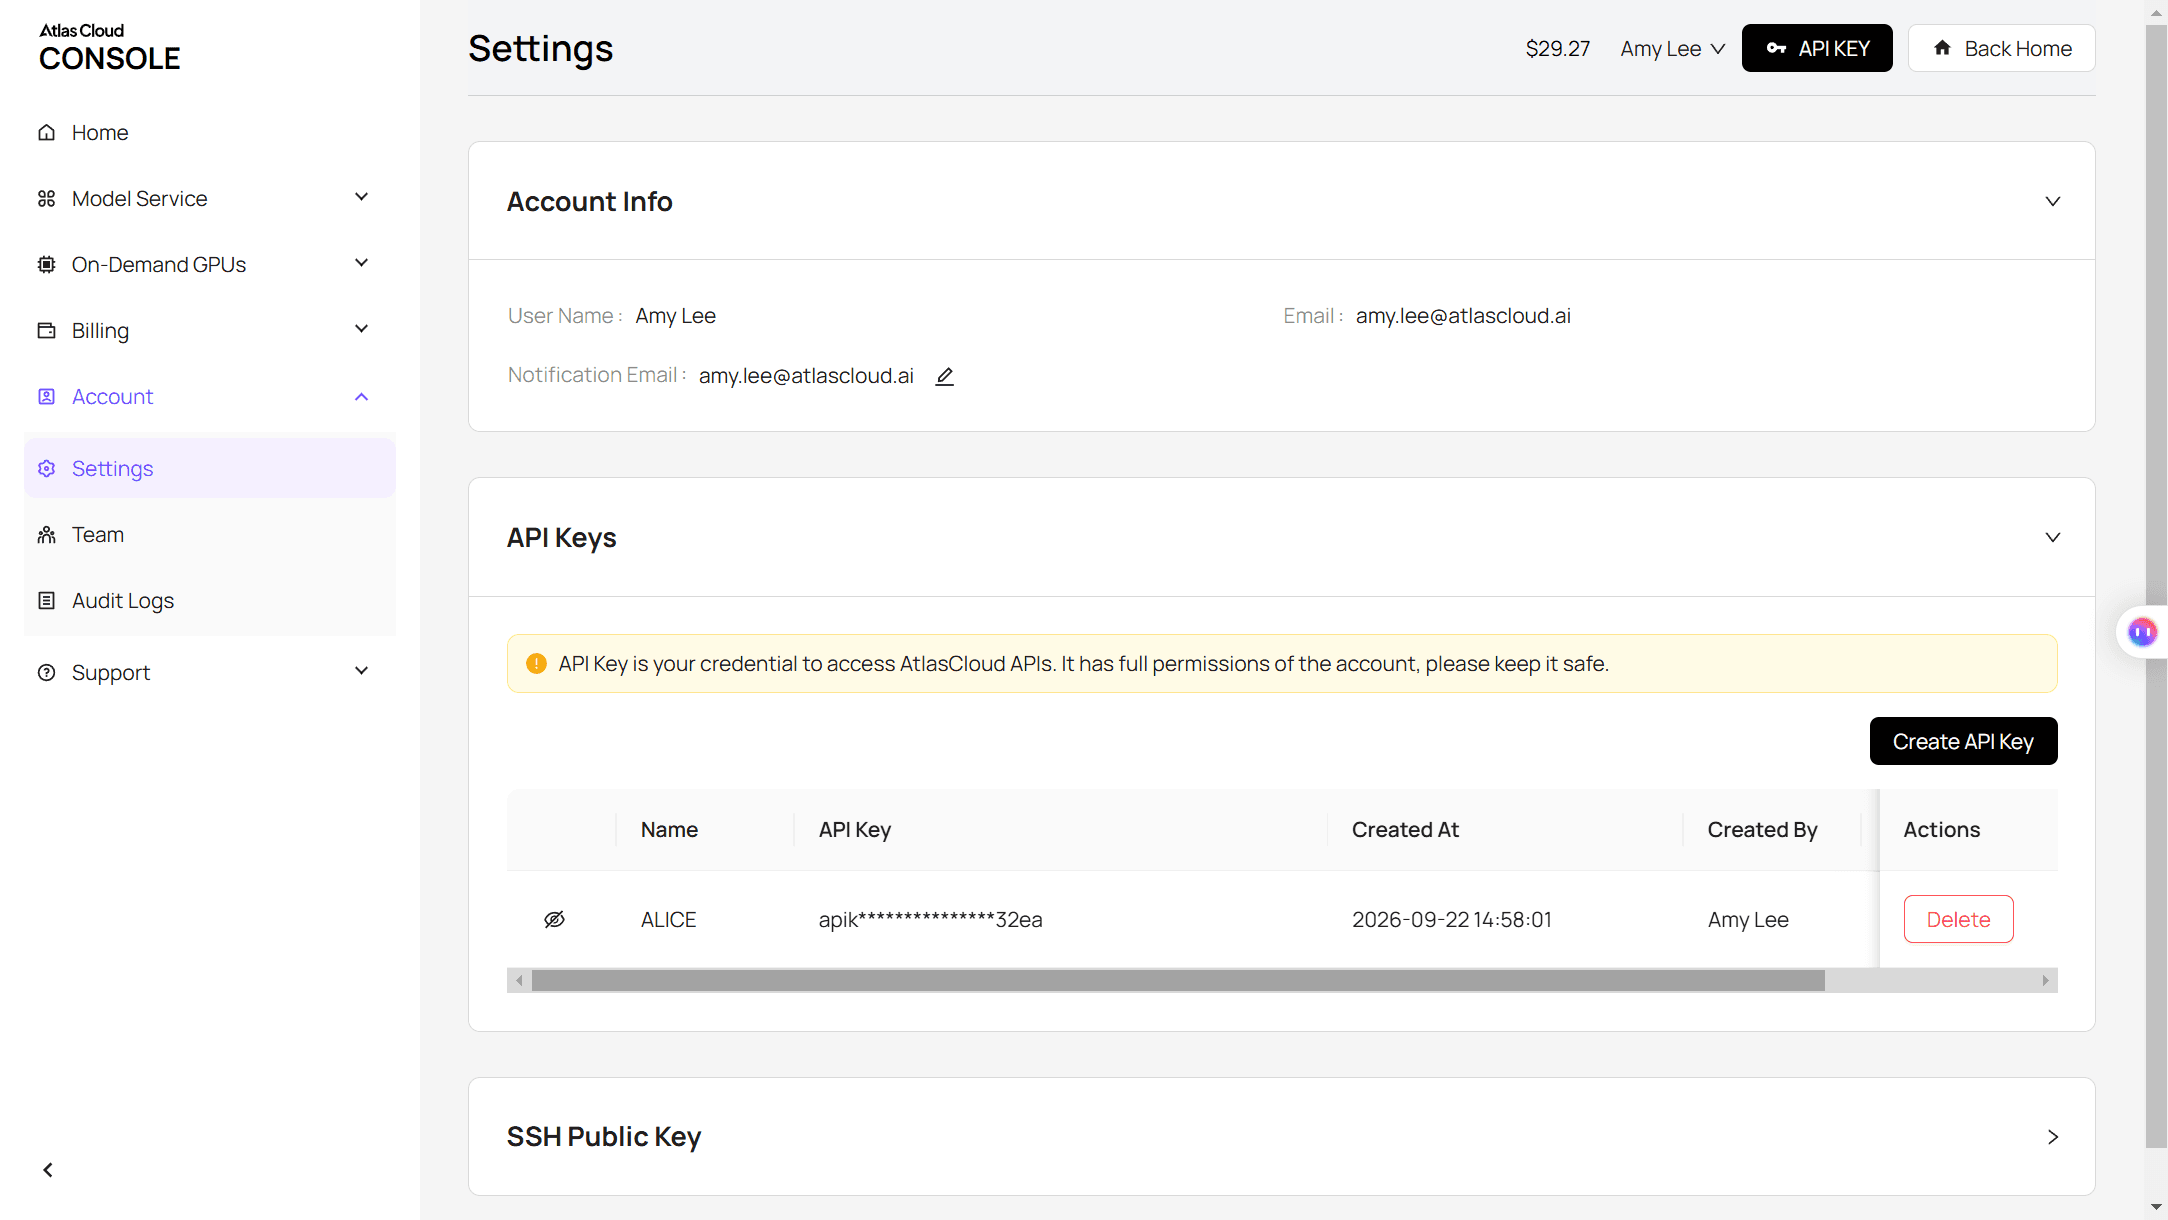
步驟 1:建立並複製你的 API key。 開啟 Atlas Cloud 主控台,前往 Settings,然後前往 API Keys,按一下 Create API Key。
步驟 2:查看 API 文件。 每個模型的參數,包括這裡使用的參考欄位,都在 API 文件中。
步驟 3:發出你的第一個請求。 提交一個鉤子:
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "@Image1 is the presenter. @Image2 is the ice roller in her right hand. @Audio1 is her voice: she speaks exactly the words in @Audio1, lip-synced. Shot 1 [0-3s]: chest-up, talking to the lens. Shot 2 [3-6s]: extreme close-up, the roller pressed to her cheek, the cylinder turning on its axle as it rolls upward. Shot 3 [6-10s]: chest-up, she holds the roller beside her face and finishes the line.", 7 "reference_images": ["https://your-cdn.com/presenter.png", "https://your-cdn.com/ice-roller.png"], 8 "reference_audios": ["https://your-cdn.com/hook-a.wav"], 9 "duration": 10, 10 "resolution": "1080p", 11 "ratio": "9:16", 12 "generate_audio": true 13 }'
回應會傳回一個 prediction ID。持續輪詢,直到狀態顯示為 completed:
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
若要批次處理,保持請求主體不變,並為每個鉤子替換 reference_audios URL。Atlas Cloud 以一套 API 跨其模型運行:每個影片模型都共用這個 endpoint、key 和輪詢迴圈,因此切換模型只代表更改 model 字串。上述的圖像與語音步驟也使用同一把 key 和同樣的先提交再輪詢模式。
若要完整的依格式劃分的鉤子測試網格,請參閱如何擴展 UGC 廣告製作。
AI 網紅規則:標籤與肖像權
在她推銷任何東西之前,先確認兩類規則:平台標籤,以及廣告中合成人物的法律。
| 適用對象 | 要求什麼 | 該怎麼做 |
|---|---|---|
| TikTok | 標註顯示擬真場景或人物的 AI 生成內容 | 發布時開啟 AI 生成標籤,或加上說明文字或貼紙 |
| 紐約州廣告 | 當廣告主知道廣告中使用合成表演者時,須揭露 | 在廣告中加入清楚可見的揭露 |
| 以真人臉孔作為參考 | 取得你所使用肖像之人的許可 | 取得書面同意,或從你擁有權利的肖像開始 |
TikTok 在 2023 年 9 月推出了其 AI 生成內容標籤,並要求創作者在擬真 AI 內容上使用。紐約的 合成表演者法 S.8420-A 於 2025 年 12 月 11 日簽署,2026 年 6 月 9 日生效,首次違規的民事罰款為 $1,000,之後每次為 $5,000。
在模型方面,Atlas Cloud 上的 Seedance 2.5 接受真人照片作為參考,並自動將其註冊為資產。其文件要求你僅在獲得授權時使用真人肖像,這與你對真人創作者會遵循的規則相同。
常見問題
打造 AI 網紅要花多少錢?
使用 Seedream 5.5 Edit 在 9:16 比例下,每張肖像約為 $0.03。Seedance 2.5 影片依解析度與長度計價:在 Atlas Cloud 上,一支 10 秒直式影片含兩張參考圖片和一個語音檔,720p 約為 $3.02,1080p 約為 $5.94。
這些價格為 2026 年 11 月 13 日、已套用 20% 折扣的價格。由於每個鉤子都是自己的短片,主要的 AI UGC 成本在於你挑出贏家前測試了多少個鉤子。
有我可以使用的 TikTok 開場鉤子生成器嗎?
任何文字模型都能生成鉤子,但當你給它一個模式而不是一個主題時,輸出會更好。先拆解一支爆紅影片(步驟 1),再要求模型用那個確切句式,為你的產品寫出十句台詞。挑三個來拍,勝過生成五十個卻一個都沒拍。
我的 AI 網紅能說其他語言嗎?
可以。根據其模型文件,Seedance 2.5 原生支援超過 10 種語言的語音生成。為了最緊密的對嘴,先以目標語言生成語音台詞,並將其作為參考音訊傳入,就像你對英文所做的一樣。
一支 AI 網紅影片可以多長?
一次 Seedance 2.5 生成可從 4 到 30 秒。鉤子最好簡短:我們的三支短片各為 10 秒,這樣就有空間放入一句台詞、一個特寫和一次產品展示。若要更長的廣告,請分別生成場景再剪接在一起。
結論
現在臉孔是簡單的部分。能推銷的主持人與只是好看的主持人之間的差別,在於她周圍的工作:從已經爆紅的內容借來的鉤子模式、跨場景重複使用的單一肖像,以及每一句台詞都有語音軌,讓嘴唇與文字相符。
如果你正在研究如何為自己的產品打造 AI 網紅,先從小處著手。拆解一支影片、寫三句台詞、跑三支短片,並留下能在前三秒贏得注意的那一支。然後讓 API 為之後的每個鉤子重複這個迴圈。




