朋友轉傳給你一段影片,在畫面最精彩的部分貼了一個笑臉表情符號。影片本身沒問題,但等到它存到你的相簿時,那個表情符號已經不是獨立圖層了。
所以當你從影片中移除表情符號時,你其實是要求工具在貼圖覆蓋的像素上重新繪製,一格接著一格,而底下的畫面仍在持續移動。
我們試過裁切、放大和遮蓋,接著讓一款 AI 影片編輯器處理三個更棘手的案例:一個會跟著鏡頭移動的貼圖、同一個畫面中的多個表情符號,以及一個蓋在某人臉上的表情符號。
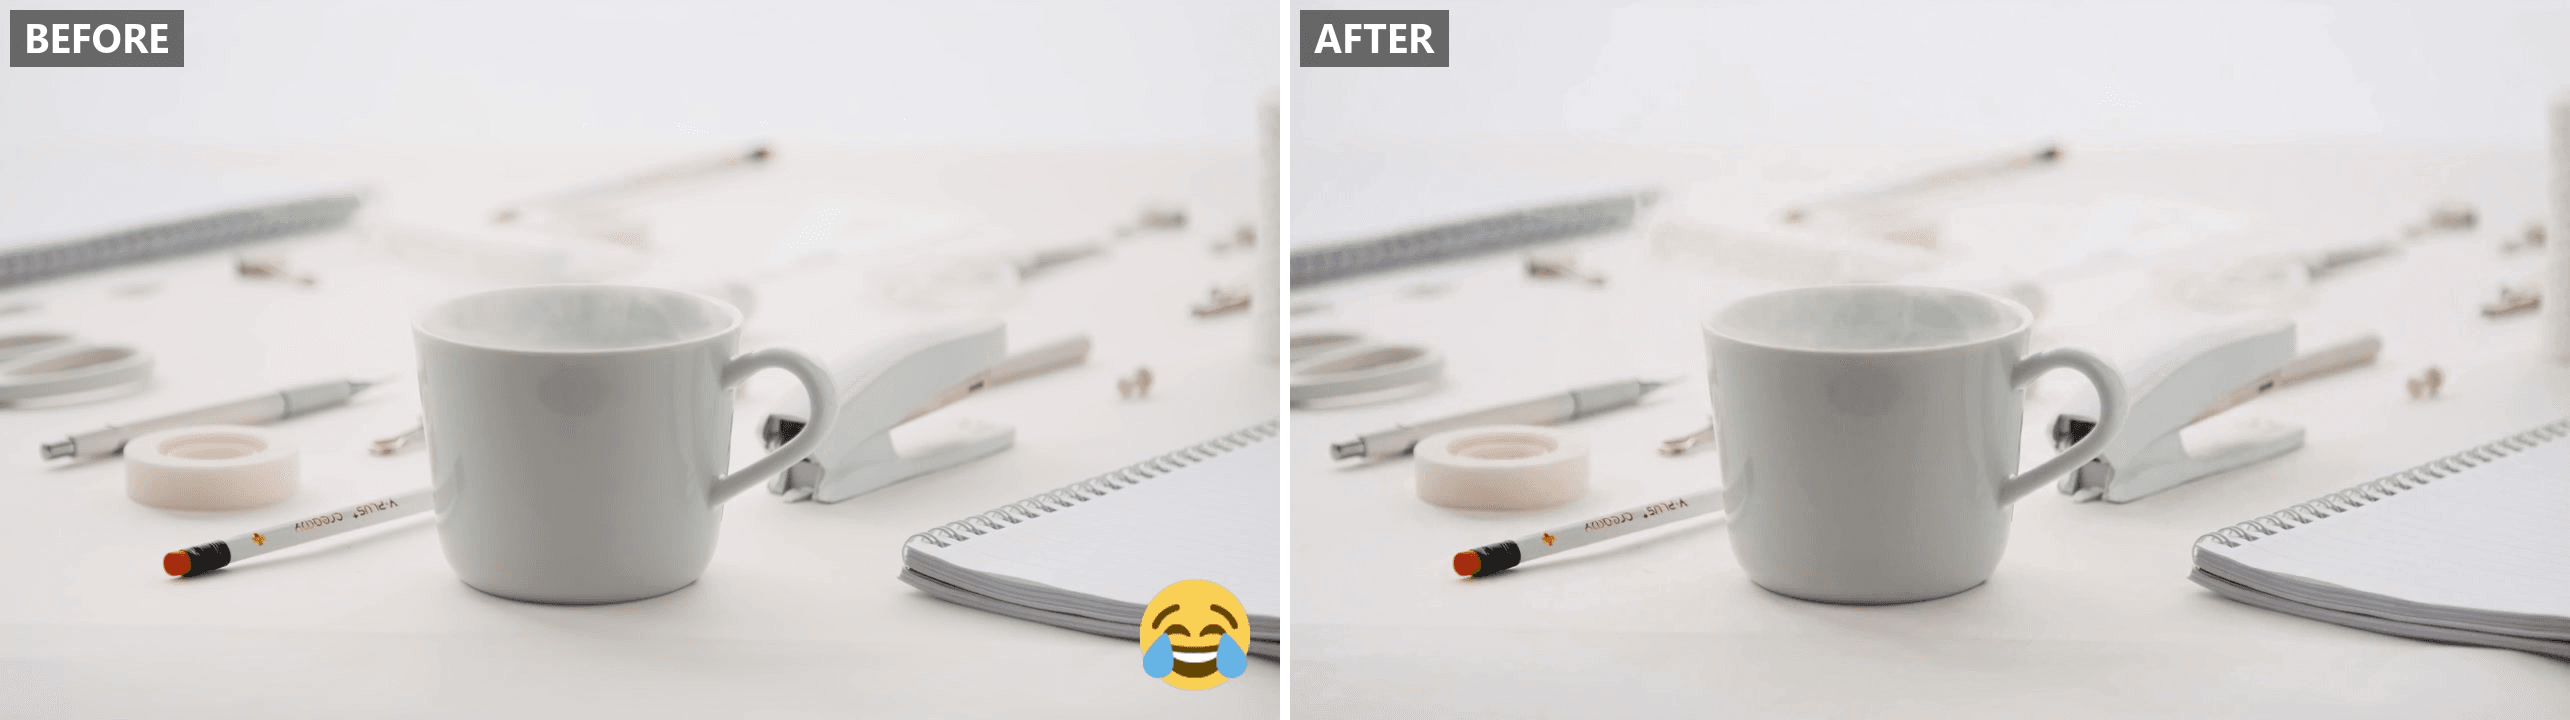
重點摘要
- 匯出後的影片中,表情符號或貼圖已經變成像素。檔案不會把它記錄成獨立圖層。
- 裁切、放大避開或用形狀遮蓋,都只是把圖形藏起來。生成式編輯則會重建鏡頭底下原本拍到的內容。
- 打開 Atlas Cloud 的影片編輯器,切換到「影片編輯」分頁,上傳影片,並指出要消除的表情符號或貼圖及其位置。
- 還留著原始的 TikTok、Instagram 或 Snapchat 專案嗎?在匯出前直接在該處刪掉貼圖。只需拖曳一下。
- 只能從你自行拍攝或獲得授權編輯的影片中移除表情符號或貼圖。
還能編輯,還是已經匯出?移除影片中的表情符號前先確認
在你打開任何移除工具之前,先確認一件事:你手上還有這段影片的原始專案,還是只有它匯出後的檔案?
TikTok 是最清楚的例子。TikTok 自己的說明 只用一行就涵蓋了在編輯時刪除貼圖的方法:「將文字或貼圖拖曳到刪除按鈕,直到它被選取,然後放開。」Instagram 限時動態和 Snapchat 的貼圖匣也採用類似的拖曳刪除手勢。CapCut 的運作方式略有不同:疊加內容會位於主視訊軌上方自己的圖層,所以你在時間軸中選取該圖層,並在匯出前刪除它,不需要拖曳。
一旦你匯出或發布,那個機會之窗就關上了。當影片被壓平成單一視訊檔案後,就沒有圖層面板可以打開了。貼圖會成為它觸及的每一個畫面的一部分,就像周圍的影片畫面一樣,這和字幕會遇到的燒錄字幕與可切換字幕問題是同一種情況。
| 影片所在位置 | 還能刪除貼圖嗎? |
|---|---|
| 還在 TikTok、Instagram 或 Snapchat 編輯器中,尚未發布 | 可以。將它拖曳到刪除圖示上,就能在任何人看到之前刪掉。 |
| 還在 CapCut 專案中,尚未匯出 | 可以。在時間軸中選取疊加圖層並刪除。 |
| 已下載、轉發或已經匯出 | 不行。貼圖已經烙印在像素中。這時就需要 AI 表情符號移除工具。 |
如果你的影片屬於最後一列的情況,裁切或放大是第一個誘人的做法,因為兩者都不需要特殊工具。但每種修正都會留下痕跡。
人們嘗試從影片中抹除表情符號的 3 種方法(以及為何大多數都會留下痕跡)
| 方法 | 運作方式 | 留下的痕跡 |
|---|---|---|
| 裁切或放大避開 | 重新取景,讓貼圖落在新畫面之外 | 影片變小或放大;邊緣附近的其他東西也會一起消失 |
| 用形狀遮蓋或模糊 | 在貼圖上貼一個方塊,或把該區域抹到無法辨識 | 一塊明顯的補丁,看起來就像「這裡藏了東西」,顏色也與周圍不符 |
| 生成式重寫 | AI 模型以畫面其餘部分為指引,重新繪製被遮蓋的區域 | 在簡單背景上什麼都不留下。只有在底下的背景細節密集時,才會留下淡淡的補丁 |
前兩種方法只是把貼圖藏起來。裁切過的畫面或模糊的補丁,只要有人一看就會發現被編輯過,這和我們在AI 影像修補工具指南中提到的照片取捨相同。生成式重寫的目標,是做出一個表情符號從未存在過的畫面。
在 Atlas Cloud 上使用 AI 從影片中移除表情符號
Atlas Cloud 處理表情符號和貼圖移除的方式,與處理其他任何影片編輯任務相同:上傳影片、描述影片上方的內容,模型就會重建底下的畫面。
其背後的預設模型是 Seedance 2.5,它會將上傳的影片讀取為參考,並傳回一段遵循原始影片長度的影片,在我們的測試中誤差約在半秒內,因此結果放回時間軸時,最多只需要在尾端修剪一下。
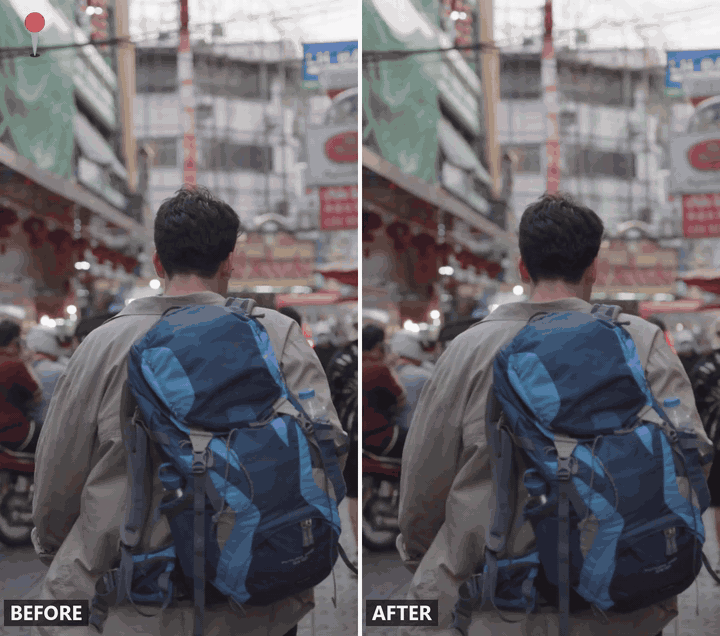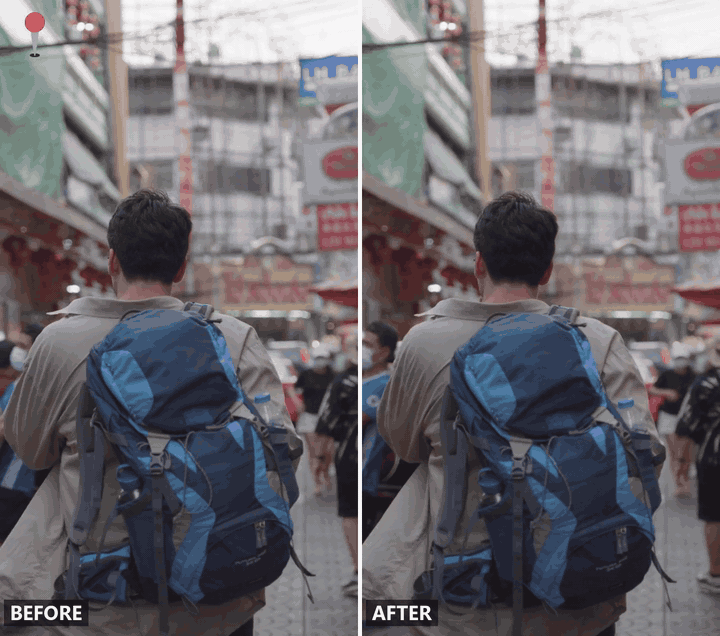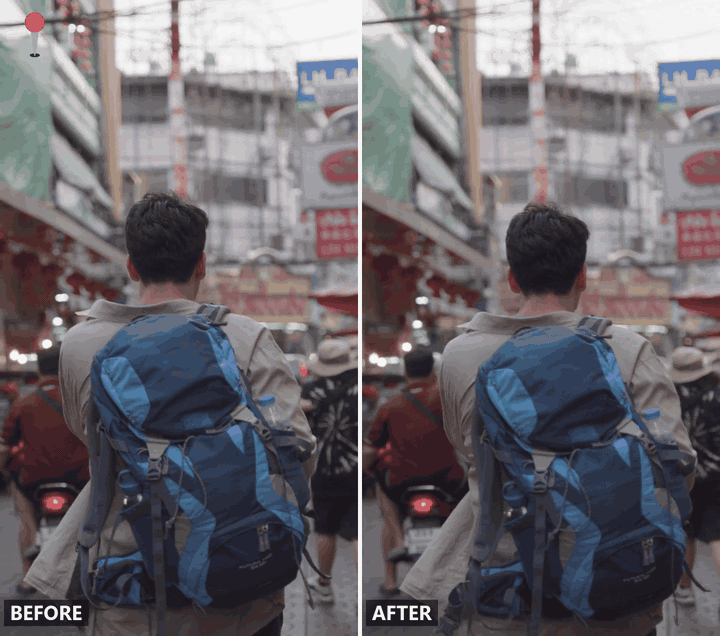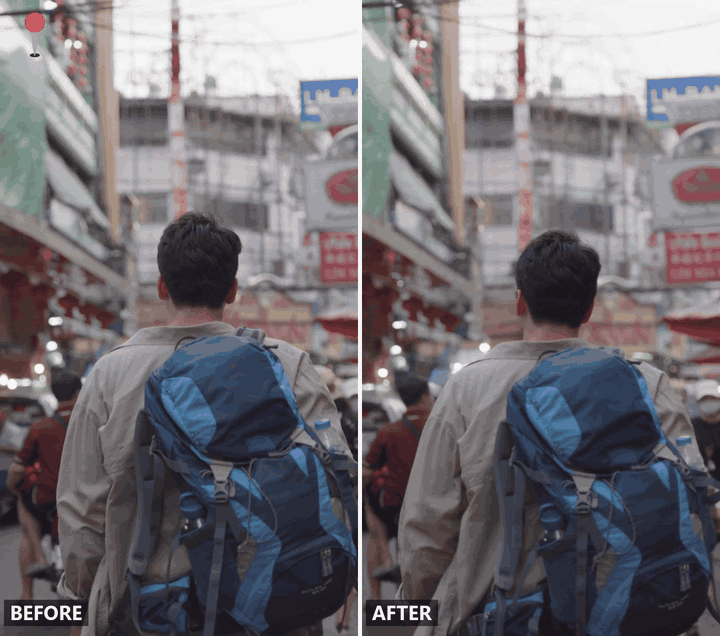
方法 1:在「影片編輯」分頁中移除表情符號和貼圖
- 打開 AI 影片編輯器,並切換到 影片編輯 分頁,就在「生成」、「延伸」和「動態」旁邊。
- 上傳帶有表情符號或貼圖的影片。
- 說出圖形及其位置:「移除右上角的愛心表情符號。其餘保持不變。」精確的描述能讓編輯範圍保持狹窄。
- 執行工作,並在匯出前以完整解析度檢查結果,放大貼圖覆蓋的區域查看。
方法 2:透過 API 從影片中移除表情符號
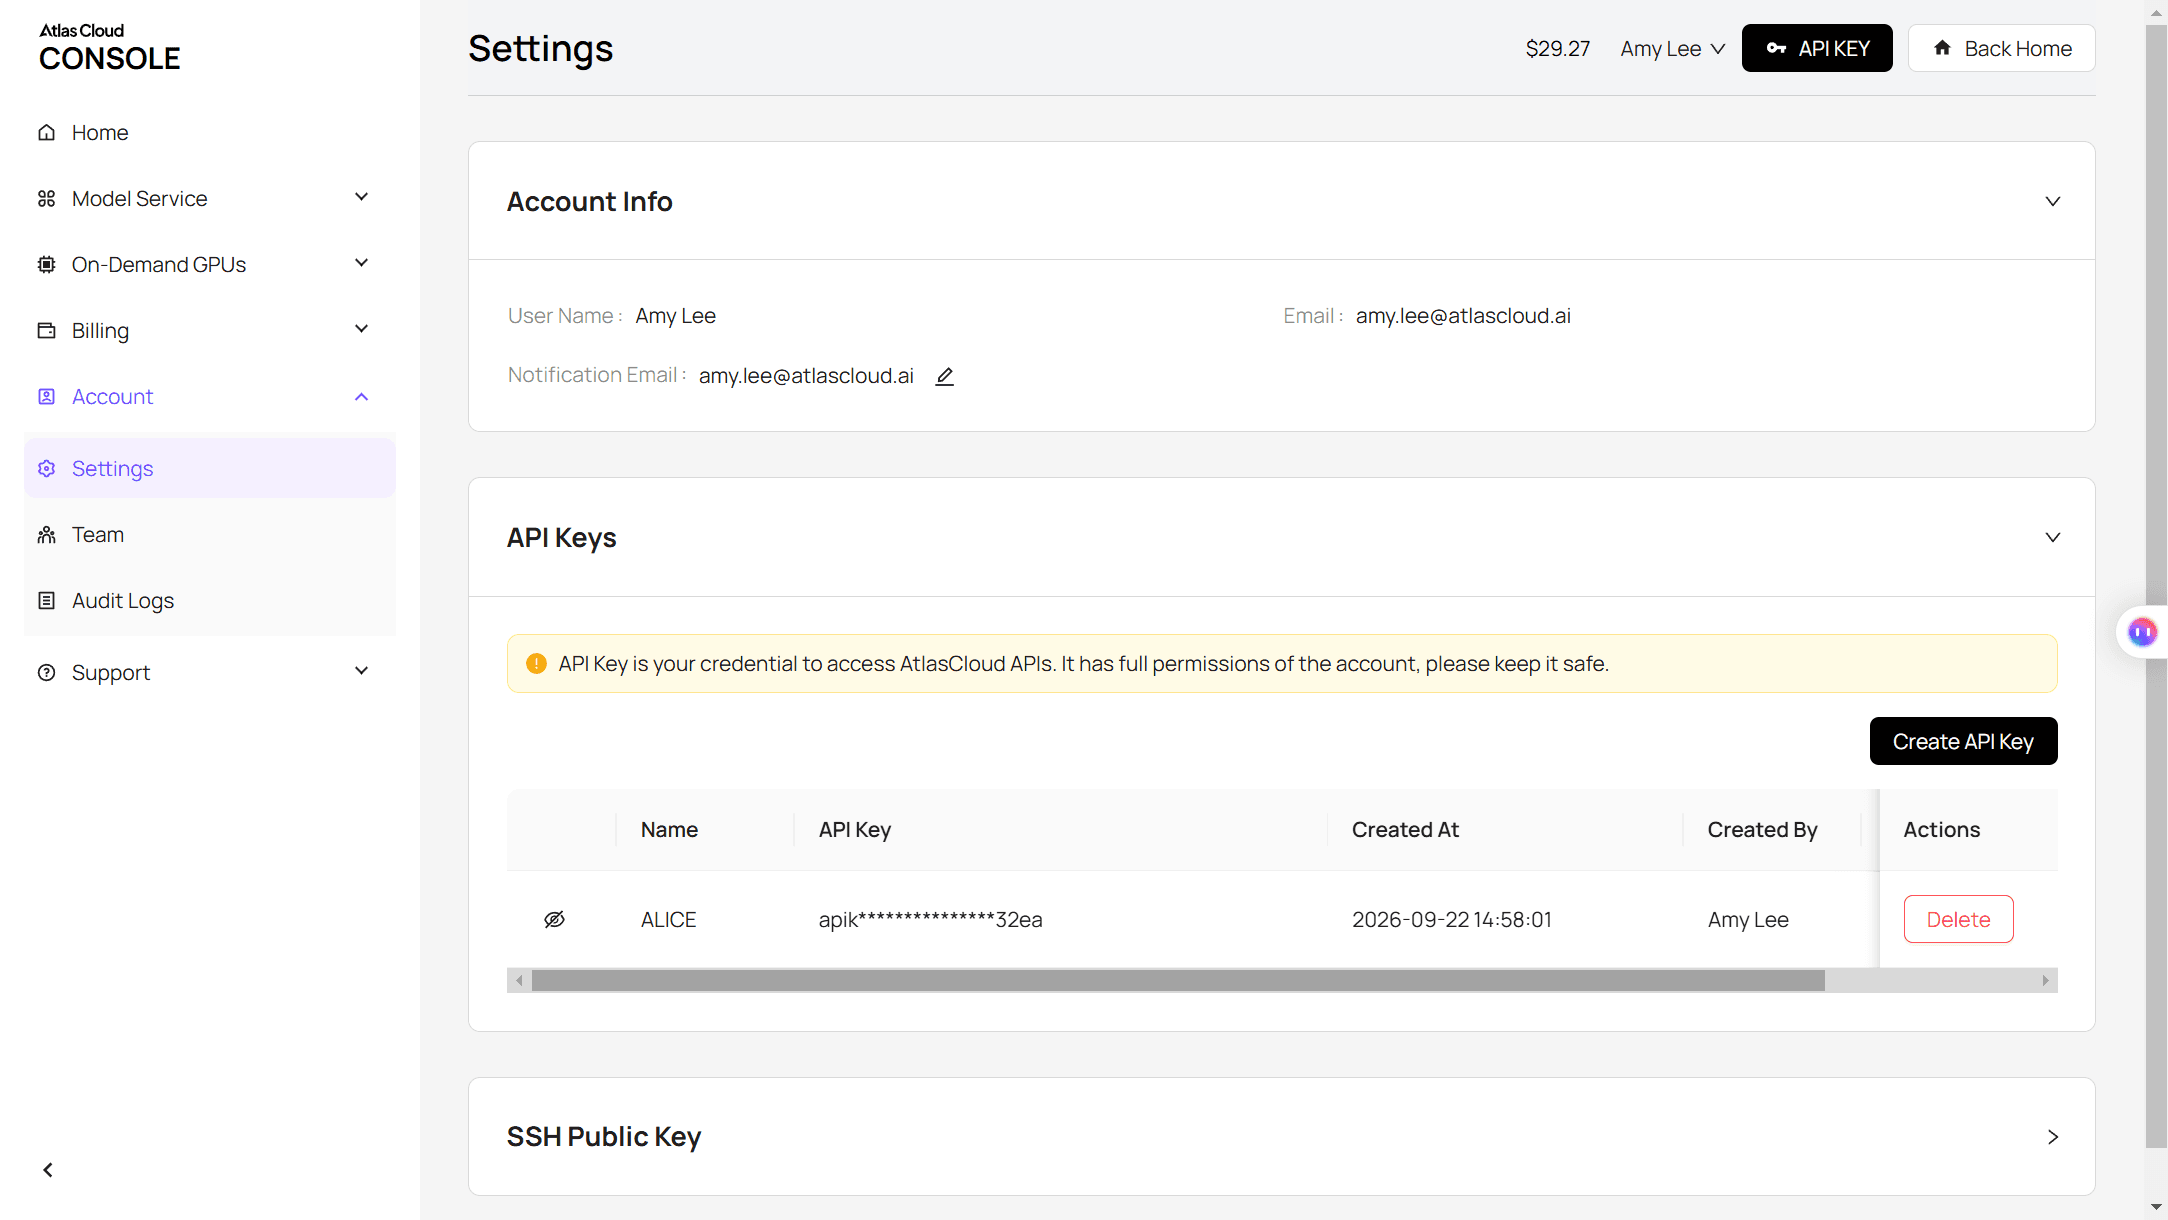
步驟 1:取得你的 API 金鑰。 在 Atlas Cloud 主控台 建立一組金鑰並複製。
步驟 2:查看 API 文件。 參數、接受的格式和長度限制都在 API 文件 中。
步驟 3:發出你的第一個請求。 提交影片和指令:
plaintext1curl -X POST https://api.atlascloud.ai/api/v1/model/generateVideo \ 2 -H "Content-Type: application/json" \ 3 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 4 -d '{ 5 "model": "bytedance/seedance-2.5/reference-to-video", 6 "prompt": "Remove the emoji sticker in the top-right corner of the frame throughout the clip. Keep everything else unchanged.", 7 "reference_videos": ["<your_clip_url>"], 8 "duration": -1, 9 "resolution": "720p" 10 }'
對於像這樣的編輯提示,duration 必須保持為 -1。模型會將其解讀為遵循來源影片長度的指令。
輪詢工作直到完成:
plaintext1curl https://api.atlascloud.ai/api/v1/model/prediction/<prediction_id> \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY"
Atlas Cloud 在整個平台上運行一套 API,因此這組相同的金鑰和相同的提交與輪詢迴圈,適用於它託管的每一個模型。之後只要替換模型字串,其餘整合方式都不會改變。
我們用 3 個棘手案例測試 AI 表情符號移除工具
單一靜態貼圖位於靜止畫面的角落,是簡單的案例,也是那種會讓任何表情符號移除工具看起來完美無瑕的示範影片。我們挑選了三個沒那麼簡單的。
一個會跟著鏡頭移動的貼圖。 當鏡頭平移時,表情符號會在畫面中漂移,因此模型必須逐格追蹤它。
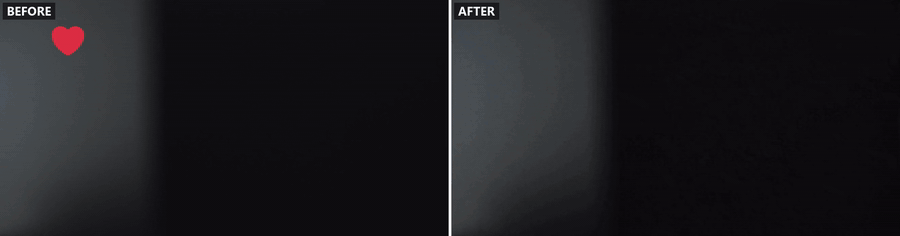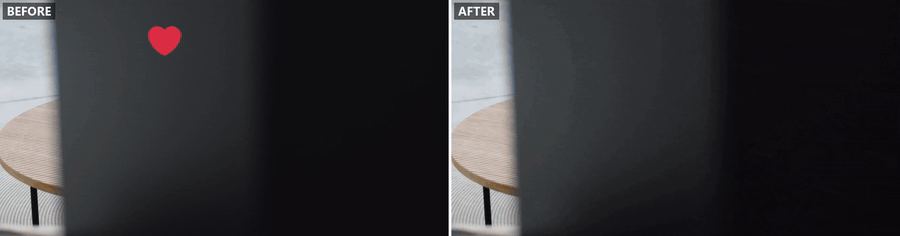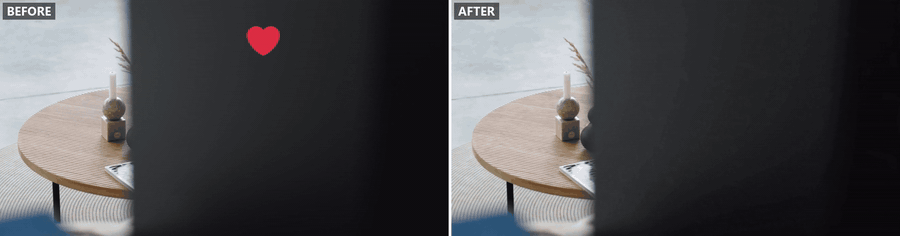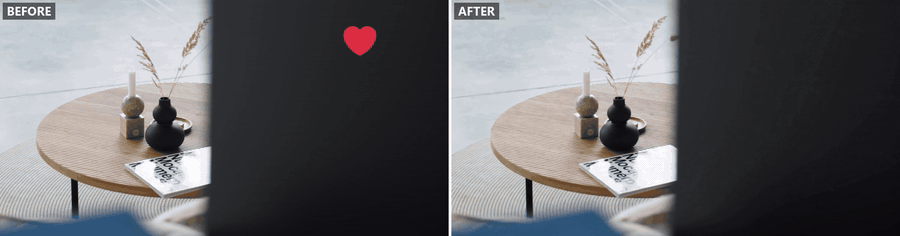
多個表情符號擠在同一個角落。 一則被轉發的影片,三個反應表情符號疊在一起,就是那種影片被到處轉傳時會堆積起來的東西。
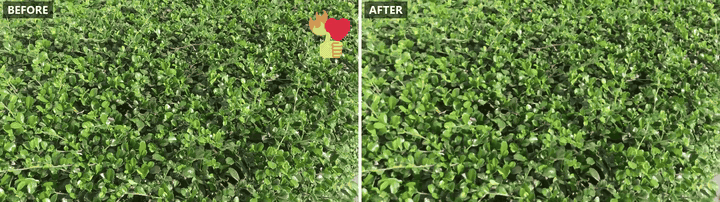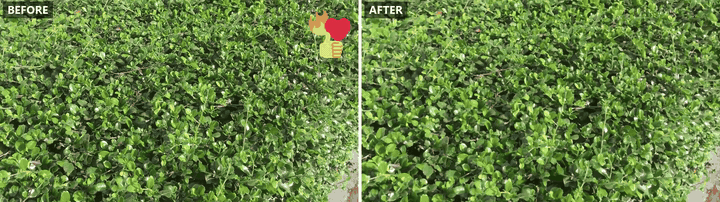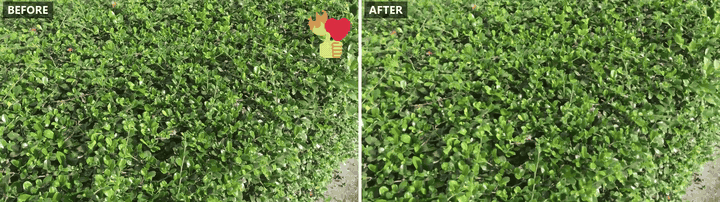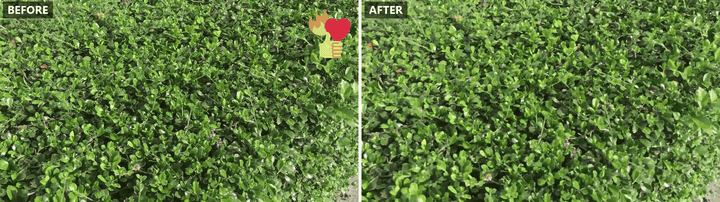
一個蓋在臉上的表情符號。 一段直式影片,貼圖遮住了某人臉部的一部分,因此模型必須重建一隻眼睛和部分臉頰。
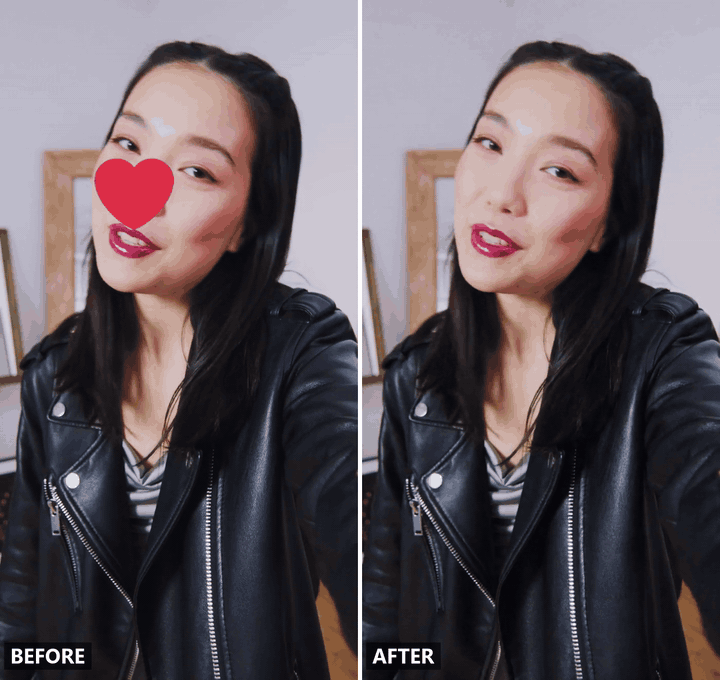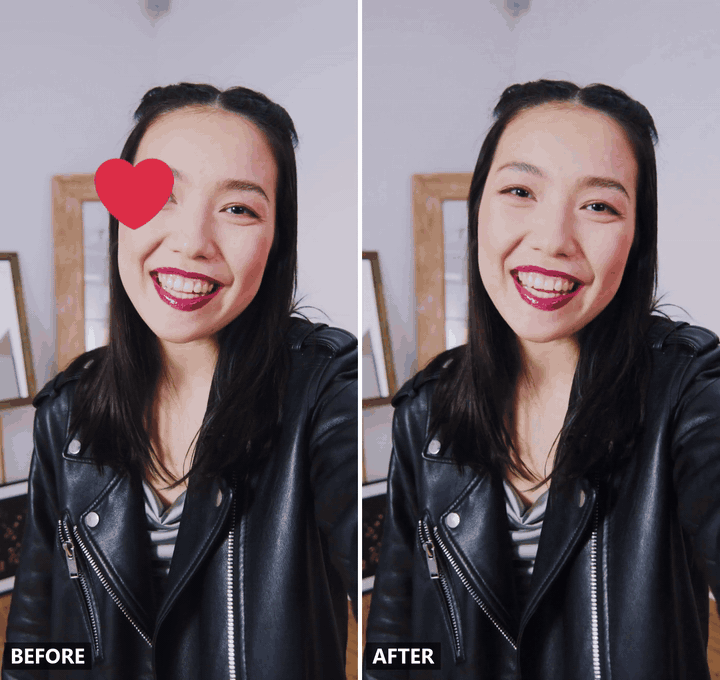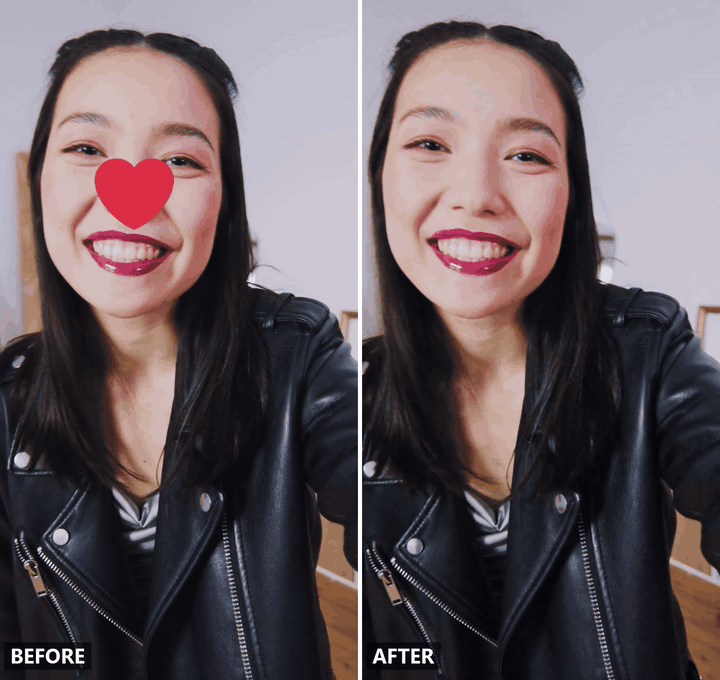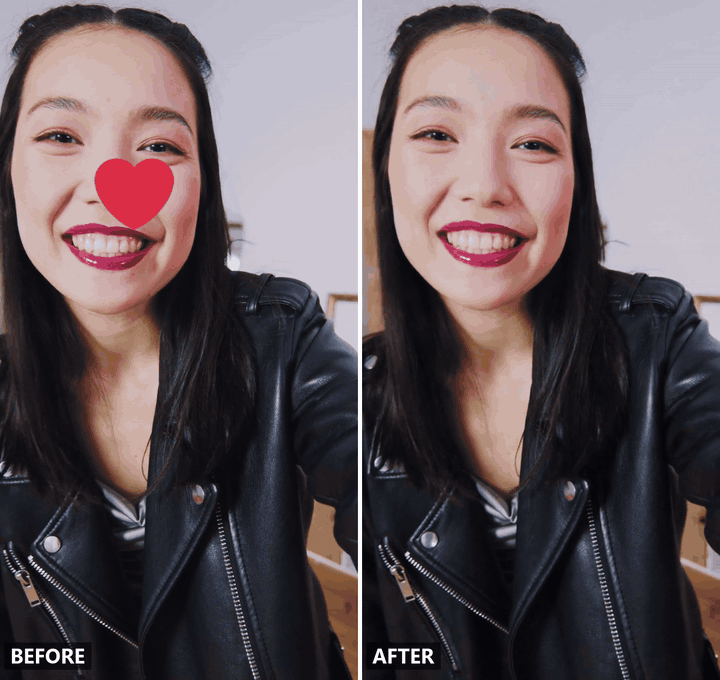
在這三個案例中,請留意鏡頭移動時遭移除區域的邊緣,並確認畫面其餘部分,尤其是臉部,保持原樣。
該輸入什麼,才能只讓表情符號消失
「影片編輯」分頁僅透過提示來鎖定貼圖,因此你輸入的每個字都在進行瞄準。
| 提示的一部分 | 作用 | 範例 |
|---|---|---|
| 說出圖形及其位置 | 當畫面上有不只一個貼圖時,給模型一個明確的目標 | 「右下角的笑臉表情符號」 |
| 說明它出現多久 | 將編輯套用到貼圖出現的每一格,而不是單一格 | 「整段影片中」或「從第 2 秒到結尾」 |
| 鎖定畫面其餘部分 | 避免編輯漂移到不需要重新繪製的區域 | 「其餘保持不變」 |
單獨一句「移除表情符號」會讓模型自行猜測邊界,而這個猜測可能會連帶移除貼圖周圍的細節。「移除整段影片中畫面左上角的愛心表情符號,其餘保持不變」則能給它一個邊界。
從影片中移除貼圖:相同工具,提示略有不同
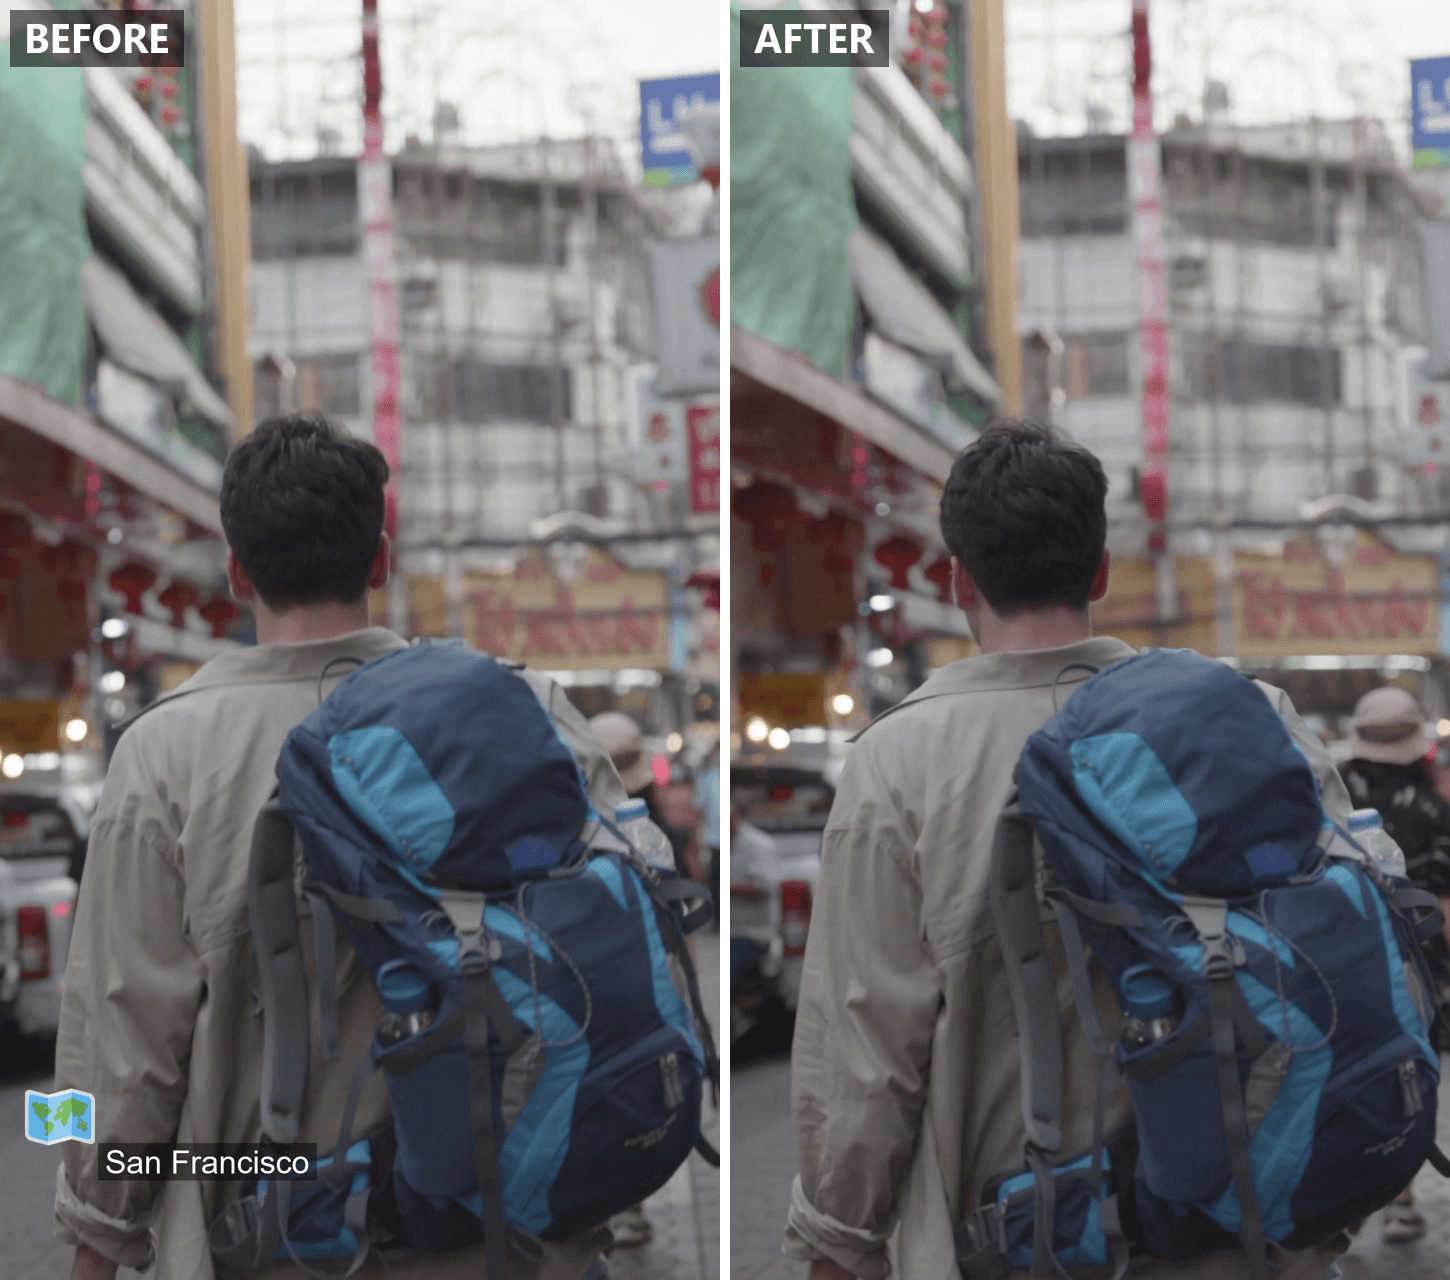
並非所有疊在影片上的東西都是單一字元。Snapchat 的溫度讀數、Instagram 的地點和 GIF 貼圖,以及 TikTok 貼圖匣中的 GIPHY 貼圖,在影片匯出後都會以相同方式烙印進去,但對於遵循文字提示的模型來說,它們的辨識方式不同。
表情符號很小,而且只有一個形狀,所以用顏色和角落就足以指稱它。貼圖佔據更多畫面,並帶有更多細節,因此除了位置之外,也要描述它的外觀。「左上角顯示雲朵圖示的動態天氣貼圖」能讓模型比「角落的貼圖」有更多比對依據。
常見問題
可以在線上免費從影片中移除表情符號嗎?
不行。Atlas Cloud 的「影片編輯」分頁按輸出秒數計費,無需訂閱,而且在瀏覽器中執行,無需安裝任何東西,所以一支影片就是一次收費。
在我們的測試中,一段 720p 的五秒影片,在撰寫本文時 Seedance 2.5 提供的 20% 折扣下,每次處理約為 $1.75。在進行較大批次之前,請先查看模型頁面上的當前費率,因為促銷價格會變動。
移除表情符號會降低底下影片的畫質嗎?
只會在被重新繪製的區域,而且只有在該處背景細節密集時才會。貼圖後方的素色牆面或柔和模糊,都能乾淨還原。
茂密的枝葉或細緻的布料紋理,對任何模型來說都更難重建,這和我們在模糊來源影片指南中提到的限制相同。無論如何,畫面其餘部分都會保持原始解析度不變。
AI 可以移除移動中的表情符號,或只出現在影片中途的表情符號嗎?
可以,前提是模型讀取整段影片,而不是單一格。上面的移動愛心測試就是這種情況,結果很乾淨。對於較晚出現的表情符號,請給模型它出現的時間範圍:「左下角的愛心,從第 3 秒標記開始直到它消失」,這樣就不會要求它重新繪製貼圖從未出現過的畫面。
編輯後音訊會保持不變嗎?
請將編輯後的檔案視為新的視訊軌。影片編輯分頁中的「音訊」開關,以及 API 中的 generate_audio,控制模型是否為輸出生成同步配樂,而我們的測試影片是無聲的,所以我們沒有讓配樂經過它。當原始音訊很重要時,請關閉「音訊」,匯出編輯結果,然後在編輯器中將原始音訊疊回其上。由於輸出會遵循來源長度,兩者對齊時最多只需要在結尾稍作修剪。
可以從別人的影片中移除表情符號,還是只能從自己的影片?
只有在影片是你製作的,或你獲得編輯許可時才可以。TikTok 的社群自律公約 用一行總結:「你應該只發布你創作或你有權分享的內容。」無論影片來自哪個平台,或由哪個工具進行編輯,這項原則都適用。
結論
從影片中移除表情符號,歸根結底是一個問題:這個修正只是把貼圖藏起來,還是重建了鏡頭底下原本拍到的內容?裁切、模糊和用形狀遮蓋,都屬於前者。
而能夠讀取整段影片,並重新繪製你所指名區域的模型,則屬於後者,結果就是看起來完全未經觸碰的影片。無論是轉發影片中的地點貼圖,還是有人在轉發影片上疊加的反應表情符號,都適用同一條規則:說出要移除什麼,並告訴模型什麼必須保留。在宣告完成之前,以完整解析度檢查結果,那麼下次你需要徹底從影片中移除表情符號時,AI 表情符號移除工具就會成為你可以信賴的選擇。


