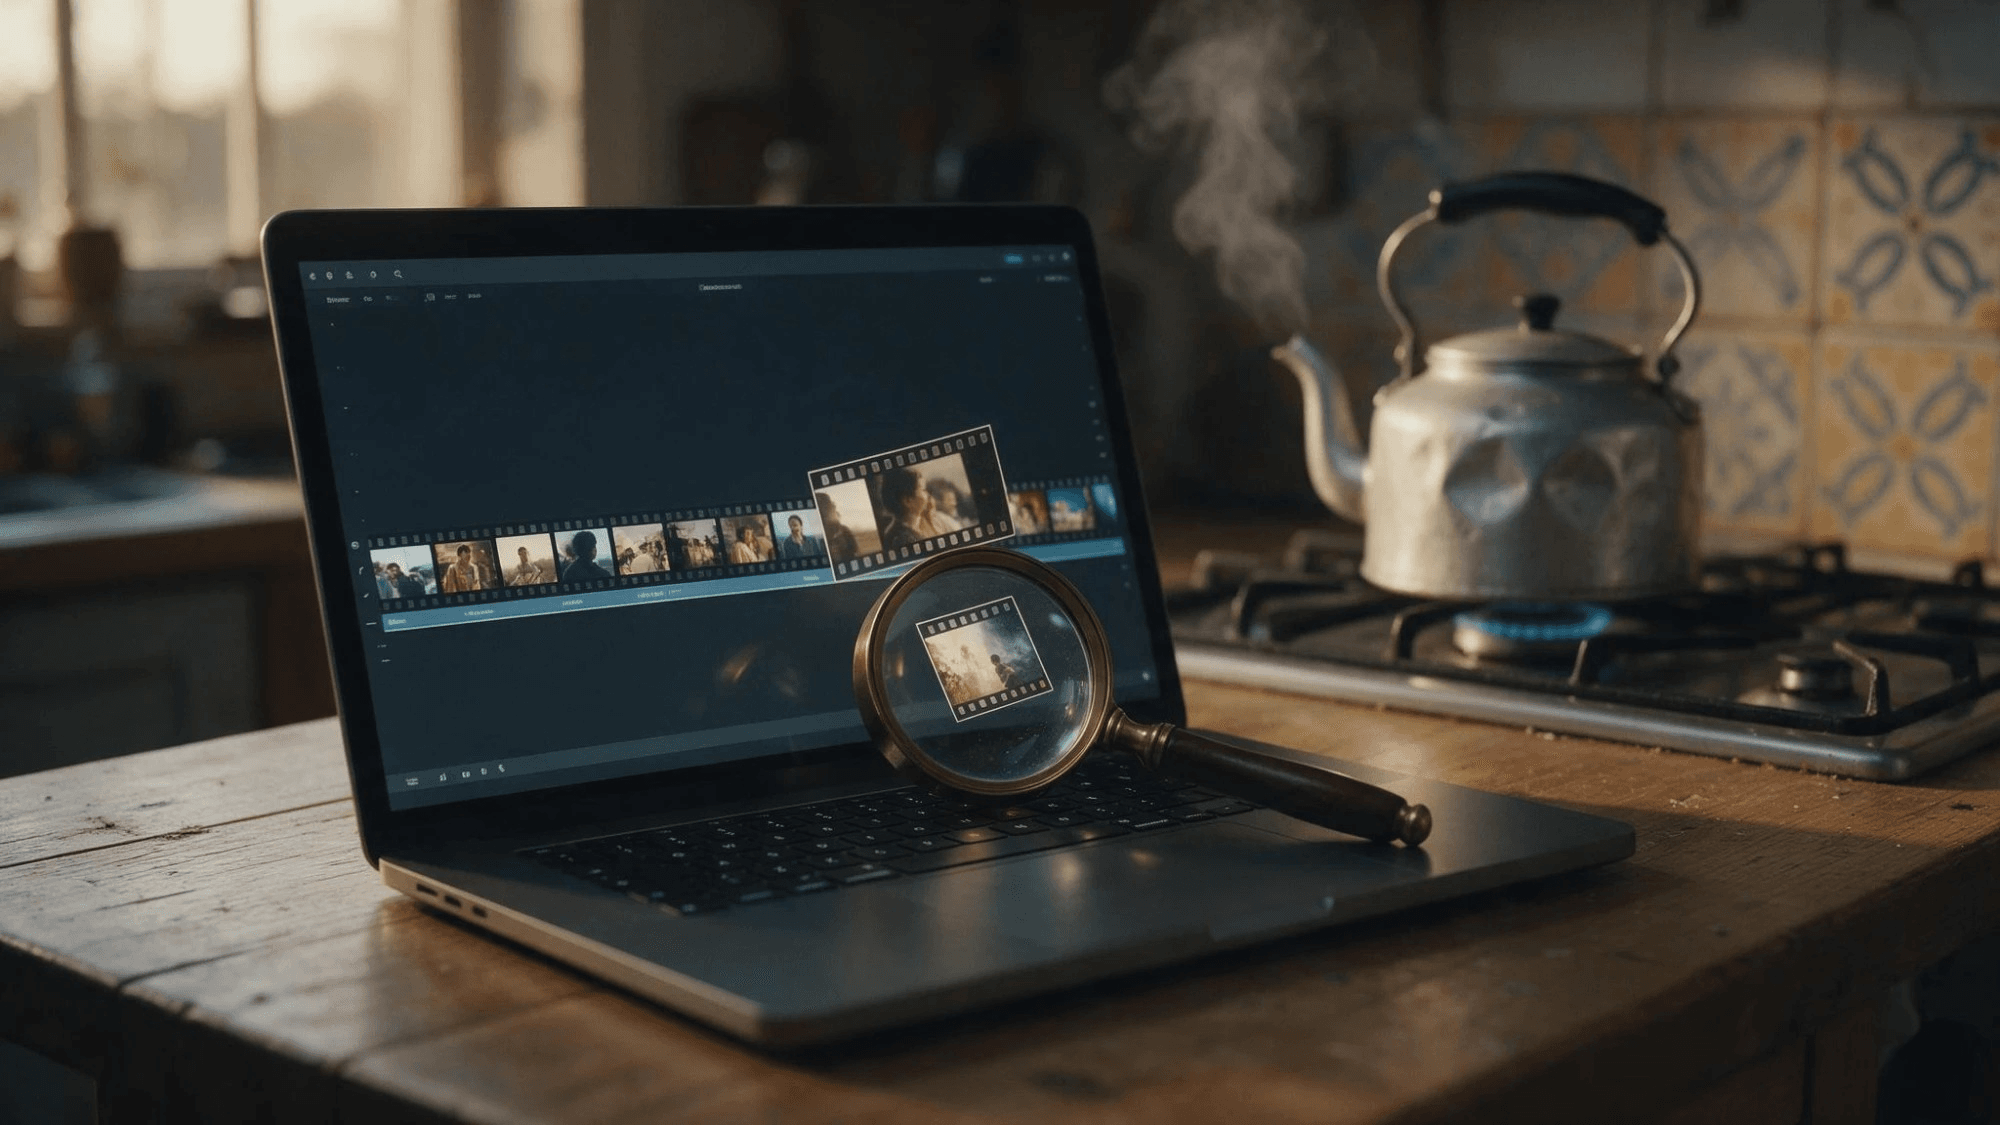
我们在一段 30 秒的厨房片段里藏了一张便利贴。上面写着 "CODE 47",只在屏幕上停留 0.4 秒。九秒后,有一个声音说出了一句话。随后我们把文件交给 ChatGPT,要求给出一份带时间戳的完整日志。
ChatGPT 接收了上传,运行了 70 秒,找出了每一处镜头切换。它报告说没有屏幕文本,也没有可辨识的语音。那么 ChatGPT 能分析视频吗?在我们的测试中它能,只不过是通过一个采样静帧的沙盒来完成,而这条路径决定了哪些内容会进入最终答案。下面就是它看到了什么、一个 YouTube 链接能得到什么,以及每一秒都很关键时该用哪个模型。
核心要点
- ChatGPT 接受视频上传,免费版也包括在内,但 OpenAI 警告它可能无法分析整个视频。
- 在我们的测试中,ChatGPT 找到了每一处场景切换,却漏掉了一张 0.4 秒的便利贴和一句语音。
- 粘贴的 YouTube 链接在我们的测试中失败了,所以请粘贴字幕而非链接。
- Atlas Cloud 上的 Gemini 3.8 Flash 直接接收视频文件,并记录下了全部四处藏入的细节。
- 实时摄像头分析存在于 iOS 和 Android 上的 Advanced Voice 中;较新的 Live 模式不支持视频。
ChatGPT 能分析你上传的视频吗?
能,但 OpenAI 自己的措辞里有一个附加说明。2026 年 10 月更新的图像输入常见问题指出,ChatGPT "可以通过支持的上传方式接受视频文件作为附件,包括免费版"。下一段又补充说,它"可能无法分析整个视频,或准确解读其音频"。
原因在于模型规格。OpenAI 的 GPT-6 Sol 模型页面将文本和图像列为输入,并将视频标记为不支持。因此 ChatGPT 需要借助工具把视频转成模型能读取的东西。
| OpenAI 的说法 | 细节 |
|---|---|
| 谁可以附加视频 | 免费版和付费版;可用性因平台和账户而异 |
| 如何分析 | 借助工具;分析"可能不完整或不准确" |
| 上传限制 | 视频计入文件上传限制:每 3 小时 80 个文件,免费版每天 3 次上传 |
| 如果"照片"不显示该片段 | 改为通过"文件"附加 |
这里与 ChatGPT 视频生成问题的区别至关重要。生成片段需要插件。读取片段开箱即用,只是无法逐帧进行。
我们测试了 ChatGPT 能否分析不到一秒的视频细节
我们的测试片段时长 30 秒,1080p,由三个不含人物的素材镜头组成。我们确切知道发生了什么以及发生在何时:
- 0:12 至 0:12.4:一张写着 "CODE 47" 的黄色便利贴出现在瓷砖上方
- 0:18:从水壶切换到台面
- 0:21:一个声音说 "The oven timer says eighty-six minutes."
- 0:25:切换到燃气火焰特写
我们在 2026 年 10 月 26 日于 ChatGPT Windows 应用中使用一个设置为 Auto 的免费账户上传了它,并要求不使用插件。提示词要求列出每一处场景变化、任何屏幕上出现的文本以及任何说出的话,全部附带 mm:ss 时间戳。
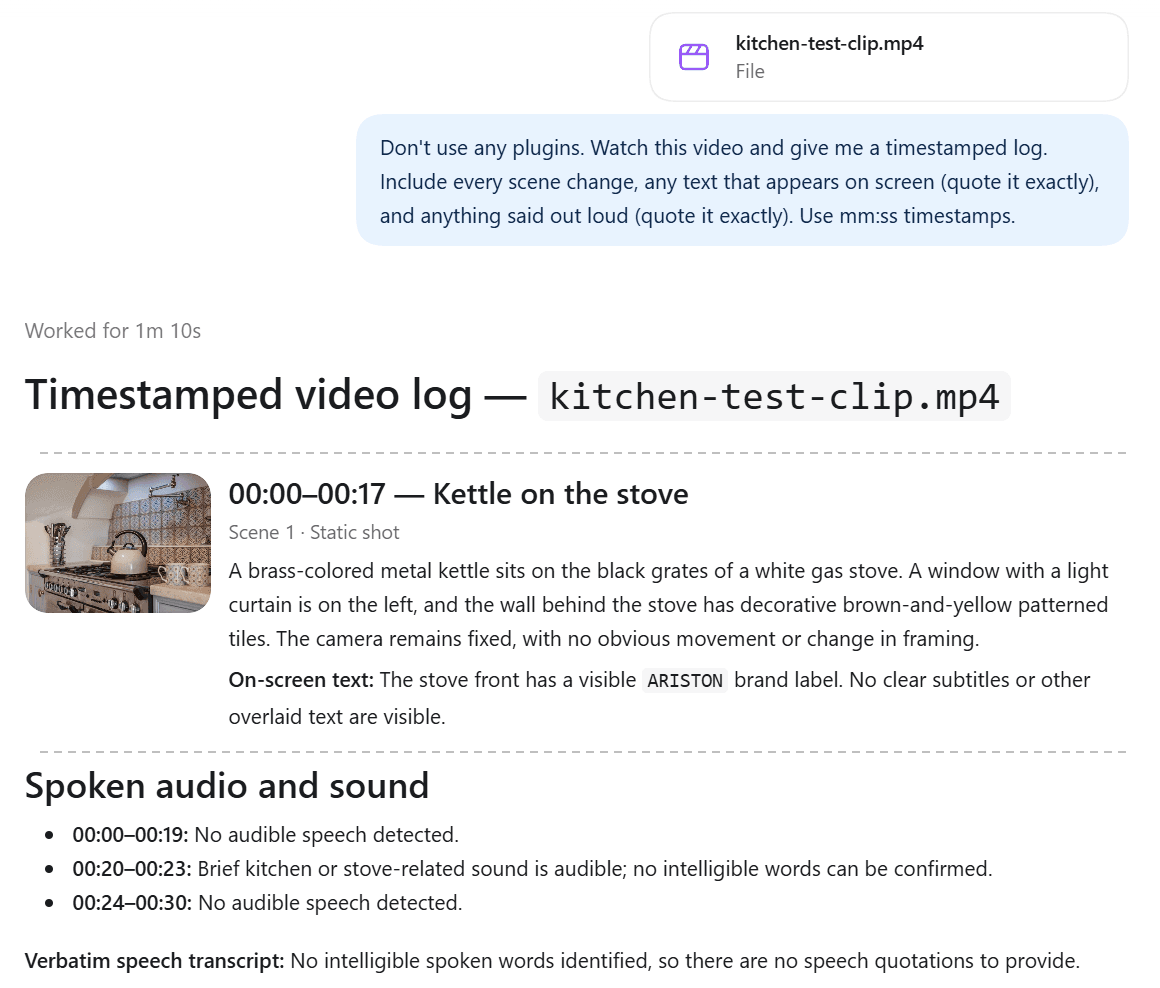
| 藏入的细节 | ChatGPT 的报告 |
|---|---|
| 0:18 的切换 | 在 00:18 找到:"Cut to wider countertop view" |
| 0:25 的切换 | 在 00:25 找到:"Cut to close-up of lit gas burner" |
| 0:12 的 "CODE 47" 便利贴 | 未找到:"No clear subtitles or other overlaid text are visible" |
| 0:21 的语音 | 未转写:"Brief kitchen or stove-related sound is audible; no intelligible words can be confirmed" |
对话日志显示了它是如何得出这一结果的。ChatGPT 把文件移入沙盒,运行 ffmpeg 每秒抽取一帧,将 30 帧缩小拼成一张联系表,然后查看这张表。接着它检查是否有语音转文字库,发现没有安装,于是改为测量响度。这就是为什么它在 00:20 至 00:23 标记出一段声音,却没有对应的文字。
关键在于:这种方法对于概要是够用的。白板上的一个快速注记可能会从每秒一张的缩略图中溜走,而一个只说一次的数字则需要一个沙盒里没有的转写器。
用能读取整个文件的模型在 Atlas Cloud 上分析视频
当细节很重要时,把片段交给一个能接收视频作为输入的模型。Atlas Cloud 托管了多个这样的模型,我们使用了来自 Google 模型系列的 Gemini 3.8 Flash。相同的片段,相同的提示词,视频以每秒 5 帧采样。
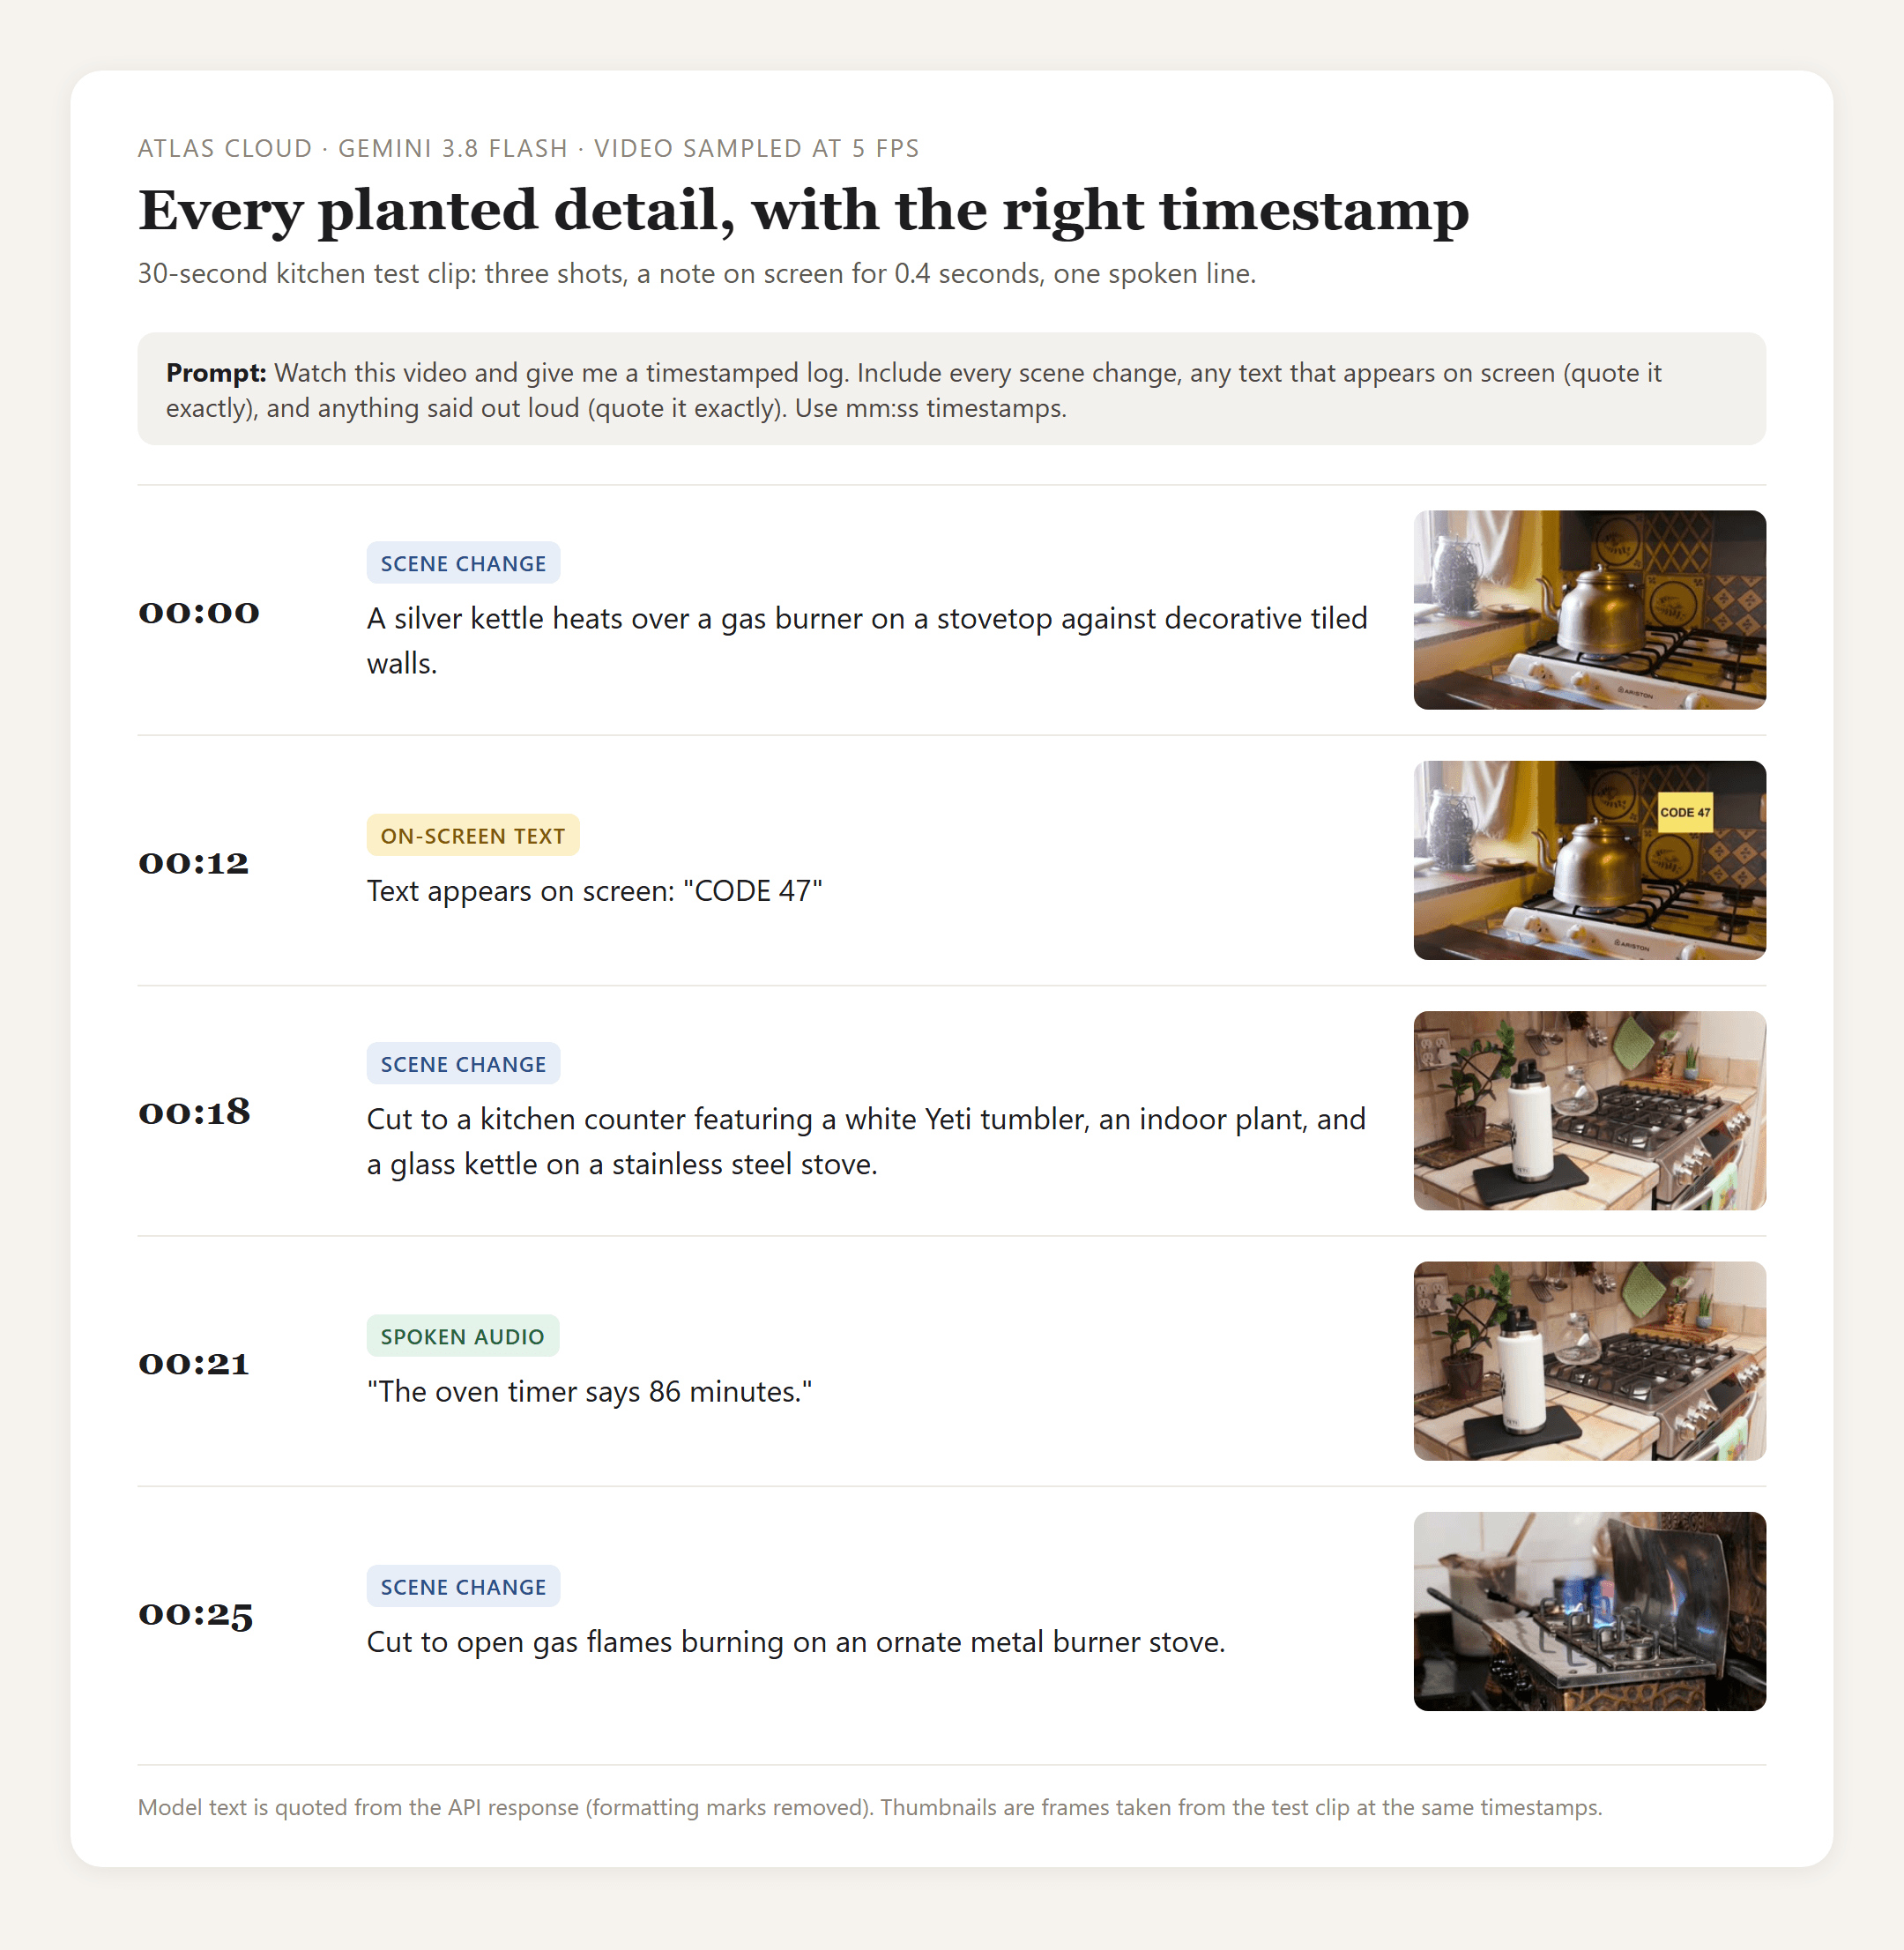
它一字不差地引用了便利贴,转写了那句话,并将两者定位到一秒之内。它甚至说出了第二个镜头中水瓶的品牌。回复大约在 13 秒内返回。
方法一:在 Gemini 3.8 Flash 演示场中上传片段
登录并打开 Gemini 3.8 Flash 演示场。上传按钮支持 MP4、MOV、WebM 及其他常见格式。
- 点击回形针图标并选择你的视频。消息框上方会出现一个缩略图。
- 输入你想了解的内容。如果需要,要求给出时间戳和精确引用。
- 点击紫色的发送箭头。
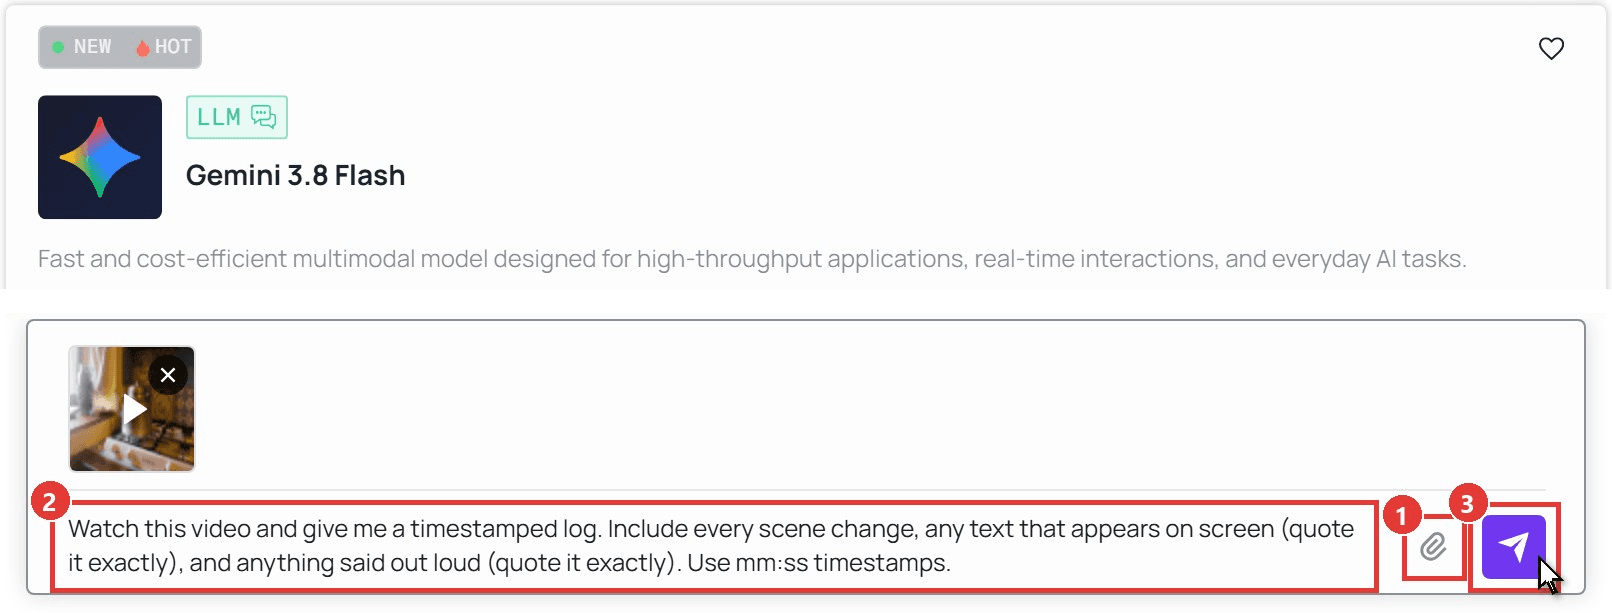
演示场适合做摘要、会议录音,以及任何你想追问的内容。对于持续时间不到一秒的细节,请使用 API,在那里你可以自行设置采样率。
方法二:通过 Atlas Cloud API 发送视频 URL
这就是我们运行每秒 5 帧测试的方式。
步骤 1:创建 API 密钥。 在控制台中打开 Settings,进入 API Keys,点击 Create API Key。
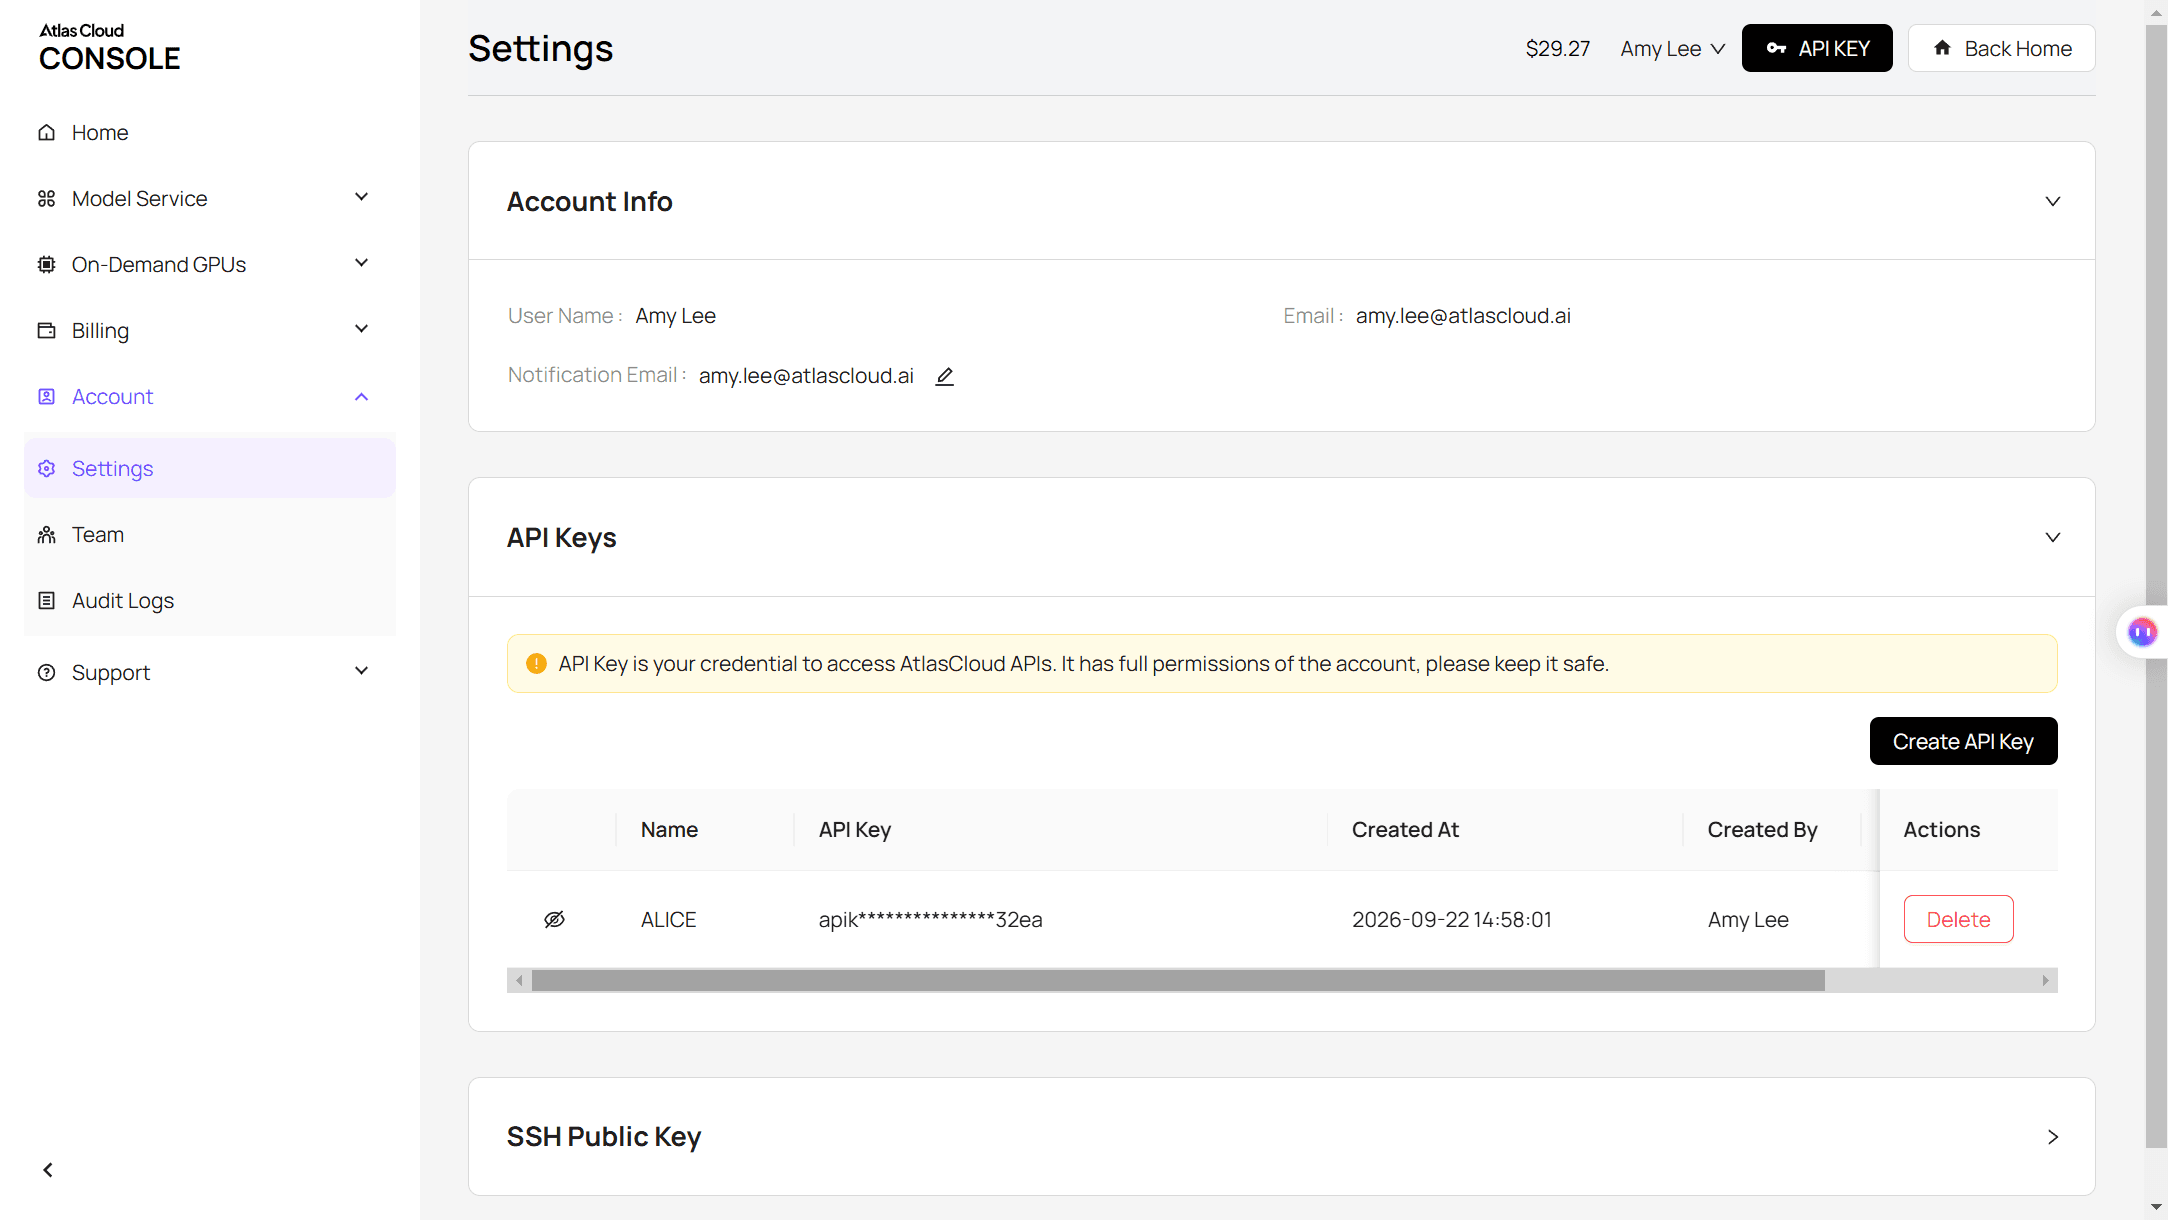
步骤 2:查看请求格式。 Atlas Cloud API 文档以及模型页面上的 API 标签页展示了 Gemini 格式。
步骤 3:发送请求。 将 fileUri 指向一个可公开访问的视频文件。一个公开的 YouTube URL 也可以用于同一字段;一段 1:55 的教程被计为 10,374 个视频 token。
plaintext1curl -X POST "https://api.atlascloud.ai/v1/models/google/gemini-3.8-flash:generateContent" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "contents": [{ 6 "role": "user", 7 "parts": [ 8 {"fileData": {"mimeType": "video/mp4", "fileUri": "https://example.com/your-clip.mp4"}, "videoMetadata": {"fps": 5}}, 9 {"text": "Watch this video and give me a timestamped log. Include every scene change, any text that appears on screen (quote it exactly), and anything said out loud (quote it exactly). Use mm:ss timestamps."} 10 ] 11 }], 12 "generationConfig": {"maxOutputTokens": 32000} 13 }'
回复位于 candidates[0].content.parts[0].text。请保留上面显示的 camelCase 字段名。若不使用 videoMetadata,同一段 30 秒片段约消耗 2,700 个 token;在每秒 5 帧下则消耗 10,650 个。要捕捉快速细节就提高帧率,做摘要则无需设置。
对于较长或较密集的素材,把模型字符串改为 google/gemini-4-argon,其他一切保持不变。密钥、端点和请求结构都不变,这正是统一 LLM API的意义所在。
ChatGPT 能通过链接分析 YouTube 视频吗?
在我们的测试中不能。我们把一段公开的 1:55 清洁教程粘贴进新对话,要求给出一份带时间戳的摘要以及说出的第一句话。ChatGPT 搜索了 15 个网站,然后回答说它"无法从 YouTube 链接中获取视频的字幕或音频"。
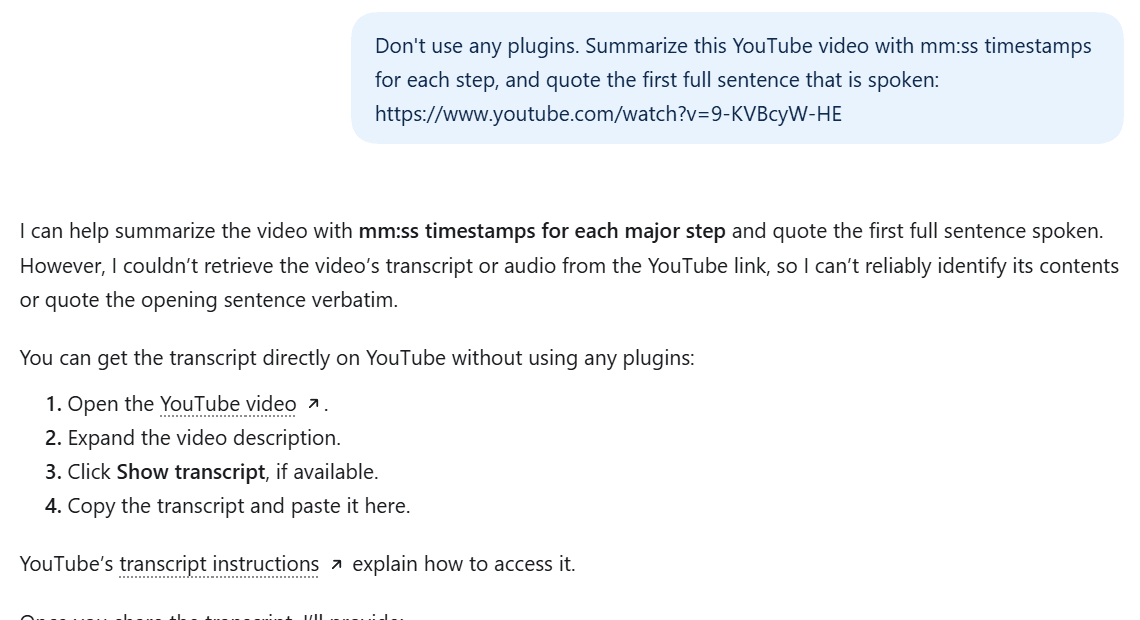
我们没有找到任何涉及 YouTube 链接的 OpenAI 帮助文章。链接给 ChatGPT 的是一个可搜索的页面,而不是一个可观看的视频。
粘贴字幕而非链接
ChatGPT 自己的建议是处理语音内容的可靠途径。在 YouTube 上,展开描述,点击 Show transcript,复制文本并粘贴到对话中。时间戳通常也会一并复制,所以你仍然可以问"1:10 左右发生了什么?"
| 途径 | ChatGPT 得到什么 | 适用于 |
|---|---|---|
| 粘贴链接 | 一个可搜索的页面;视频本身无法触及 | 在我们的测试中无用 |
| 粘贴字幕 | 说出的文字,带时间戳 | 演讲、教程、访谈 |
| 下载并上传文件 | 采样的静帧,若有转写器还可加上音频 | 你拥有版权的短片段 |
字幕不包含任何视觉信息。如果答案在图表、幻灯片或一个手势里,请把 URL 发给视频模型,如方法二所示。
ChatGPT 能通过你的摄像头实时分析视频吗?
能,但只能在一个语音模式中。OpenAI 的 ChatGPT Voice 页面称"Live 不支持视频或屏幕共享"。Live 是较新的语音体验。视频仍保留在较旧的 Advanced 模式中,且仅限 iOS 和 Android 应用中的符合条件订阅者使用。
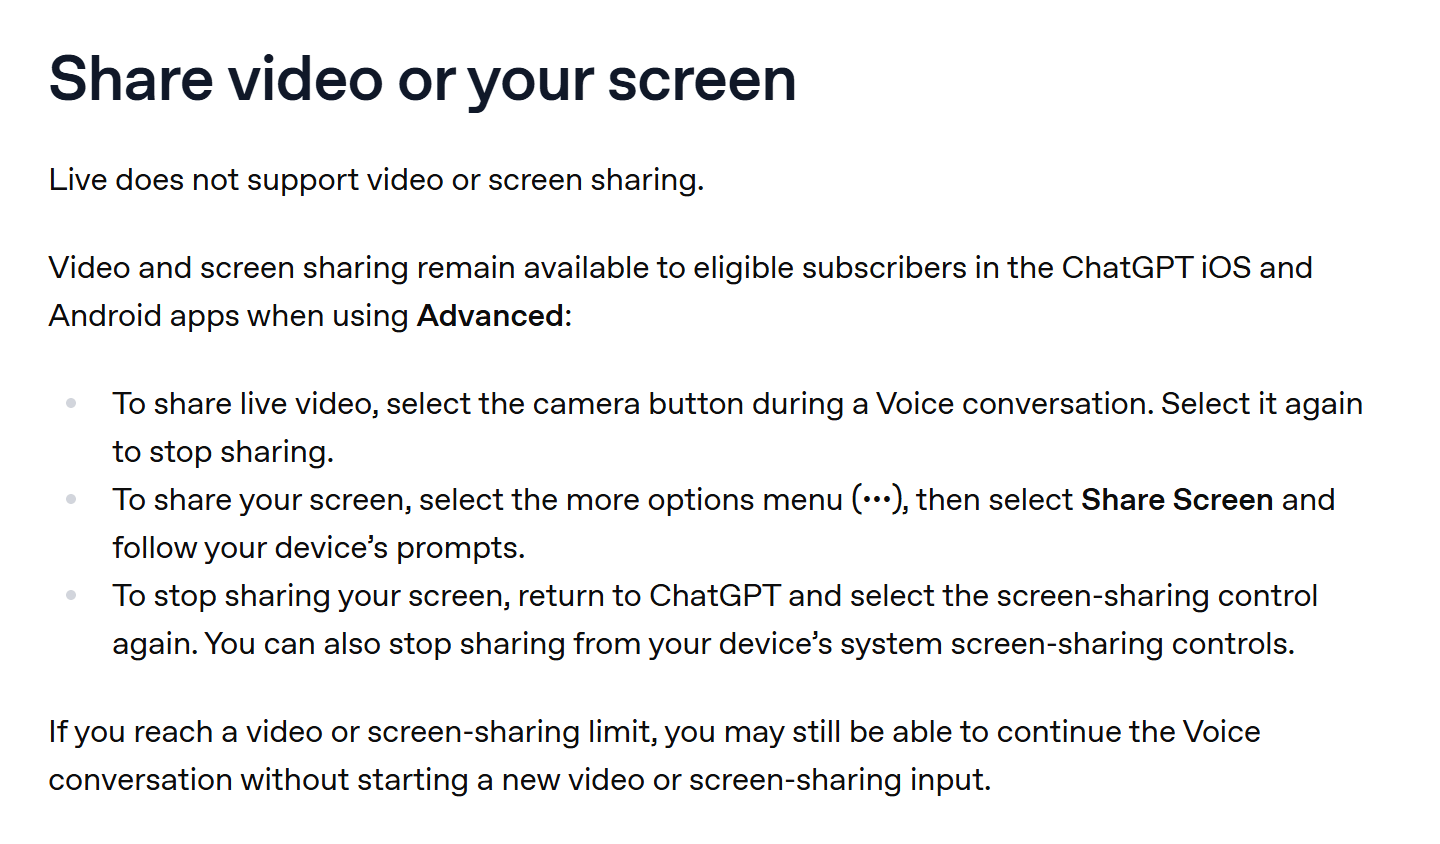
在 Advanced 中,语音聊天时点击摄像头按钮即可分享你手机看到的内容,或从 ••• 菜单中选择共享屏幕。它适用于实时询问"这个零件叫什么?"。
它不能替代分析录制的文件:没有可拖动的时间线,也没有之后可以引用的内容。OpenAI 还对视频和屏幕共享设有上限,一旦达到上限,你或许仍能继续交谈,但无法开启新的视频。
ChatGPT vs Gemini vs Claude:2026 年谁能分析视频
根据各家公司的帮助页面,这三款聊天应用以三种不同方式处理视频。
| ChatGPT | Gemini 应用 | Claude | Atlas Cloud 上的 Gemini 3.8 Flash | |
|---|---|---|---|---|
| 上传视频文件 | 支持,含免费版;借助工具分析 | 支持 | 上传页面仅涵盖文档和图像(2026 年 7 月 24 日) | 支持,在演示场中 |
| 公布的限额 | 计入上传限制;未说明视频时长 | 每个视频最大 2 GB;总计 5 分钟,Google AI Pro 或 Ultra 为 1 小时 | 不适用 | 1M token 上下文窗口 |
| 视频 URL 输入 | YouTube 链接在我们的测试中失败 | 未测试 | 不适用 | 通过 API 使用任意公开文件 URL 或 YouTube URL |
| 采样控制 | 无文档说明 | 无文档说明 | 不适用 | 在请求中设置每秒帧数 |
如果你只是想在 ChatGPT 中为手头的短片段做一份快速摘要,上传即可。若要逐字记录说了什么、展示了什么,请使用一个接收文件作为输入、并允许你根据事物发生的快慢设置帧率的模型。
常见问题
ChatGPT 5 能分析视频吗?
ChatGPT 不再默认使用 GPT-5。根据 OpenAI 的发布说明,自 2026 年 10 月初起,Plus 及更高版本计划运行 GPT-6 Sol,Free 和 Go 运行 GPT-6 Luna。OpenAI 将视频列为 GPT-6 Sol 不支持,因此上传会走我们测试过的同一条工具路径。
ChatGPT 能分析多长的视频?
我们在 OpenAI 帮助中心没有找到已发布的视频时长限制。每个片段计为一次文件上传,这在免费版每天 3 次上传时尤为重要。我们那段 30 秒、12.7 MB 的片段耗时 70 秒;文件越长意味着要采样的静帧越多,所以请一次询问一个片段。
为什么 ChatGPT 显示的图片不是来自我的视频?
我们回复中每个场景旁边的缩略图是与 ChatGPT 对该场景描述相匹配的网络图片,而非来自上传的帧。对话数据显示它们是诸如 "brass metal kettle on black gas stove" 这样的图片搜索。请把时间戳与视频本身核对。
ChatGPT 会保留你分享的视频吗?
对于 Advanced Voice,OpenAI 表示视频片段会与对话记录一起存储并保留 30 天,在你删除对话后 30 天内删除,安全与法律例外情况除外。关于上传和训练设置,我们那篇关于 ChatGPT 是否安全的指南逐一讲解了每项数据控制。
Atlas Cloud 上的视频分析费用是多少?
Gemini 3.8 Flash 标价为每百万输入 token $0.75、每百万输出 token $3.75,是 $1.50 和 $7.50 标价的一半,且未显示截止日期。我们那段 30 秒片段在每秒 5 帧下每次运行约花费一美分,在默认采样下约为三分之一。
结论
ChatGPT 在免费和付费版上都接受视频上传,并能把握大方向:场景、切换、台面上的物体。它把片段读作采样静帧,无法打开我们的 YouTube 链接,并在我们的测试中漏掉了一张短便利贴和一句语音。对于任何需要精确引用的内容,一个接收文件并允许你设置帧率的模型捕捉到了全部四处藏入的细节。
那么 ChatGPT 能分析视频吗?做摘要,能。对于演讲请粘贴字幕,对于概览请上传短片段,而对于每一秒都很关键的素材,请以更高的帧率交给 Gemini 3.8 Flash。





