你还没有工具就已经想好了文案。模板选好了,自拍拍好了,笑话已经在脑子里自动写好了。
于是你上传两张图片,点击 开始换脸,四秒后你得到了结果。然后你放大一看。脸像贴纸一样浮在脖子上。2011年的压缩颗粒感——那种让梗图看起来像梗图的感觉——被磨成了光滑的塑料。你切换到视频标签,一条12秒的片段被剪成了10秒,正好剪掉了重点台词的那句话。
你不能就这么免费换脸。
这不是在批评。Pixnova 确实是免费的,真的不需要登录,也确实在几秒内给你一个干净的下载。所以本文前半部分是诚实、完整的教程:照片、视频、GIF、多人脸、批量,每个限制都写清楚。后半部分是没人会写的那部分:一个六步链条,把脸融合进梗图而不是粘贴上去,每个提示都可以复制,每个价格都列出来。
中世纪石头议事厅,长老们靠在一张长桌旁,其中一人举起手指,手机屏幕亮着,显示“渲染中 8/10 秒”
核心要点
- Pixnova 上的照片换脸是真正免费的。无需账户,官方页面无水印,结果大约3到5秒。
- 硬性限制是真的:视频最长10秒,上传文件最大30MB,一次最多5张脸,结果在1天后删除。请立即下载。
- 它粘贴,但不会融合。一个脸矩形被放到你的底图上。它不知道你的底图是一个自2011年以来被反复压缩过几十次的JPEG,这正是为什么输出看起来像贴纸。
- 解决办法是一个四模型链条,而不是找一个更好的工具:获取真正的原始梗图,用 Nano Banana 2 Edit 融合脸部,动画化5秒,然后用本地 ffmpeg 步骤转换为 GIF,因为没有工具能直接输出 GIF。
- Atlas Cloud 的 免费 AI 换脸 工具覆盖了基础换脸,没有清理倒计时:根据其常见问题解答是免费的,无使用限制,无水印,PNG 文件保存在你的硬盘上。
两篇配套阅读,如果你想要更广的视角:我们的 换脸梗图手册 涵盖了文案创作,而 GIF 换脸指南 则深入探讨了循环输出。
Pixnova AI 换脸 vs 融合换脸:先看,后读
下面这张图就是全部论点。同一个梗图,同一个源脸。左边是直接从 Imgflip 获取的未经处理的 568x335 的 Boromir 模板。右边是经过一次融合处理后的同一文件。
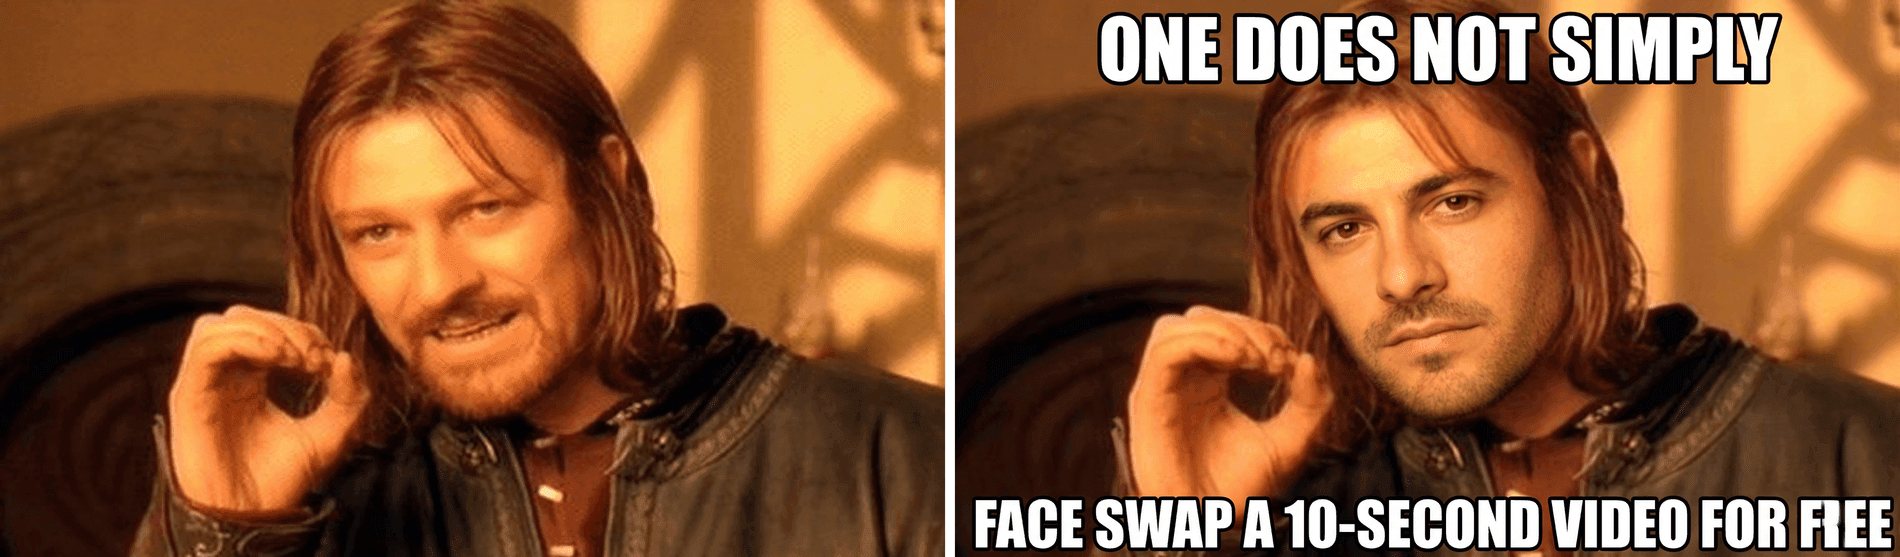
并排对比:左边是原始“你不能就这么” Boromir 梗图模板,右边是同帧画面,带有换入的人脸和 Impact 字体字幕
按此顺序检查三件事:
- 举起的手没有动。 同样的手指、同样的角度、同样的肩膀倾斜。这个姿势就是笑点,而且笑点保留了。
- 场景保持了柔和。 看看他身后模糊的石庭院。仍然模糊,仍然带有那种褪色的 2001 年电影质感。2K 级会重采样画面,所以不是字节完全相同的噪点,但没有任何东西被重新描绘成一张库存照片。
- 脸是另一个人。 不是加了滤镜的肖恩·宾。是另一个人,带着同样严肃警告的表情,被左上角来的同样光线照亮。
这就是粘贴和融合的区别,也是本文真正要讲的全部内容。
为什么 Pixnova AI 换脸在 2026 年火了(以及免费在哪里结束)
先说说 Pixnova 值得称赞的地方,因为它确实很多。
它消除了所有不尝试的理由。 没有注册墙。你打开页面,拖入两张图片,点击一个按钮。照片的结果在 3 到 5 秒 内返回,该网站声称有 超过 200 万用户(Pixnova,2026 年 7 月)。该工具提供了六种独立的模式,而不仅仅是一种:照片、视频、多人、GIF、批量、动物换脸,以及一个模板库,分为通用、圣诞、超级英雄、女模特、商务和运动,这样你甚至不需要自带底图。
它还在页脚中命名了自己的引擎室:Seedance 2.0, Nano Banana, Kling 3.0, Wan 2.7, Flux AI。先记住这一点,待会儿很重要。
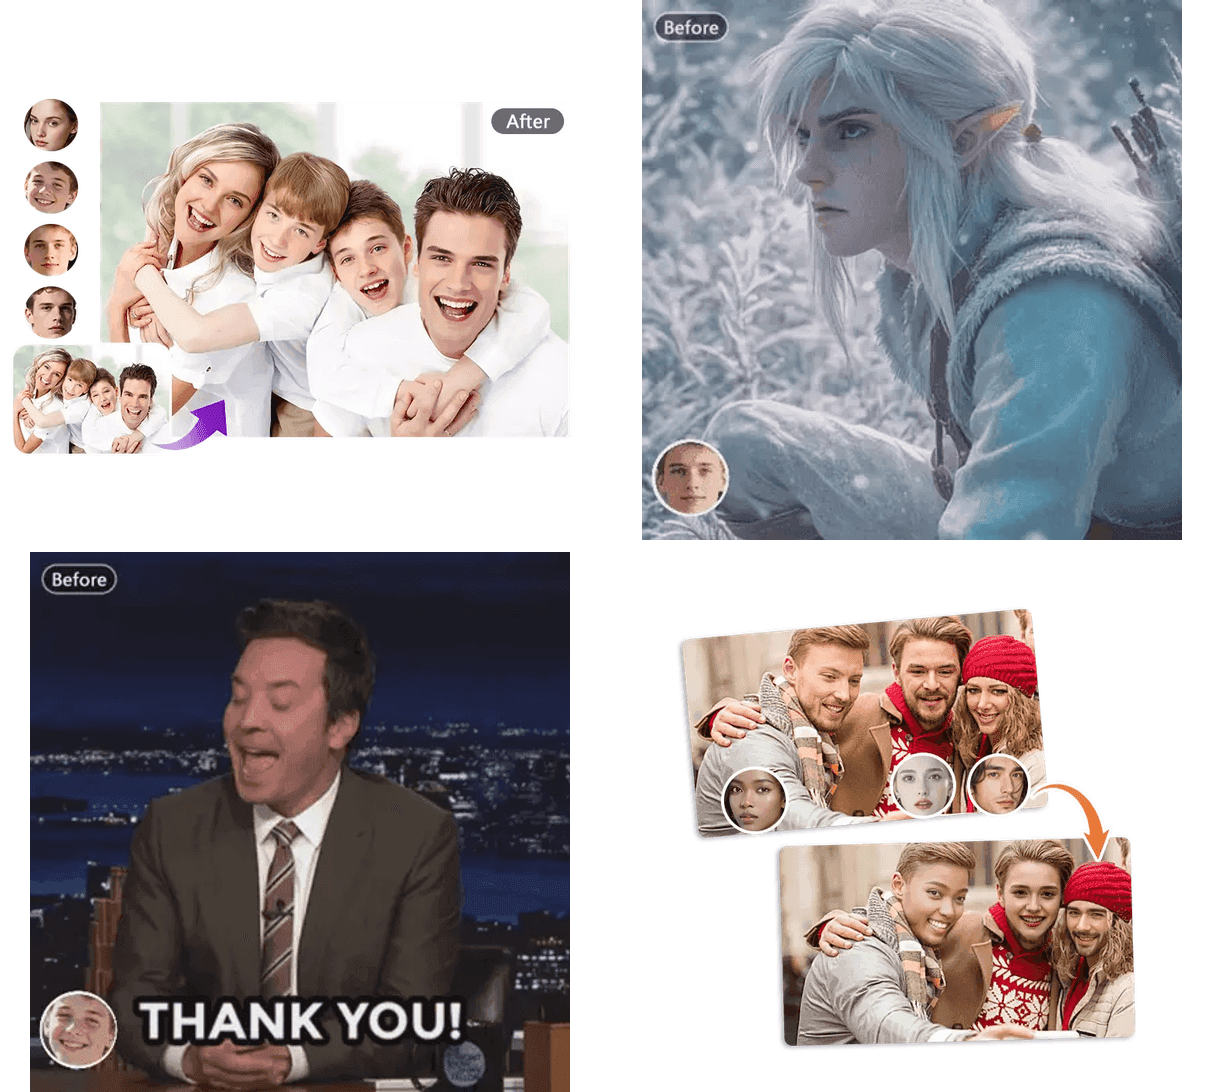
四个 Pixnova 产品示例,以 2x2 网格排列:照片换脸、视频换脸、GIF 换脸和多人换脸,来自 pixnova.ai 的截图
Pixnova 自己的照片、视频、GIF 和多人换脸模式的示例素材。来源:pixnova.ai。
现在讲阻碍你的部分。 以下全部来自 Pixnova 自己的常见问题解答,而不是竞争对手的博客:
| 限制 | 值 |
|---|---|
| 最大视频长度 | 10 秒(“服务器资源原因”) |
| 最大上传大小 | 每个文件 30MB |
| 一次最多人脸数 | 5 张脸 |
| 结果保留时间 | 1 天后 删除 |
| 批量模式 | 每次运行最多 10 张图片 |
| GIF 模式 | GIF 和 WebP,大小分别有上限 |
10 秒的限制是最伤人的。大多数值得换脸的反应片段是 12 到 20 秒,所以你要么重新剪辑笑话,要么失去笑点。视频还会让你进入积分模式而不是免费照片路径,积分包从 7.99 美元 1600 积分 起,到 194.35 美元 100,000 积分,一次性购买,无过期(Pixnova 定价,2026 年 7 月)。
在质量方面,第三方测试与快速管线的预期相符:在干净、光线充足、正面的素材上效果很好,在复杂或低光素材上则不一致(Techraisal,2026 年)。有一件事需要你自己验证,而不是相信任何人:官方页面写着“无需登录,无水印”,但零散的报告提到在某些地区某些输出中会出现水印或同意提示。在建立工作流之前,先下载一个文件看看。
为什么你的输出看起来是粘贴的。 这是机械原理的解释,不是专门针对 Pixnova 的批评。这就是基于模板的换脸的本质。
| 粘贴式换脸 | 融合式编辑 | |
|---|---|---|
| 面部身份 | 从你的照片中复制,相当忠实 | 重新渲染,接近你但不像素级精确 |
| 底图颗粒感 | 忽略,所以脸比场景更清晰 | 连同底图的压缩噪点一起重新渲染 |
| 字幕文字 | 经常被重新绘制或偏离对齐 | 保持在原位,或者有意添加 |
| 光线方向 | 根据裁剪的面部近似 | 匹配场景的实际主光源 |
| 姿势和构图 | 未改动 | 未改动 |
| “瞬间假”感 | 在低分辨率梗图上很高 | 低 |
粘贴操作会复制一个面部矩形。它不知道你的底图是一个自 2011 年以来被截图、重新上传和重新压缩了十几遍的 JPEG。所以它返回一个清晰的脸,放在一个模糊的框架里,你的眼睛在抓到笑点之前先抓到了不匹配。
融合是用底图的颗粒感、光线和颜色 重新绘制 头部,这就是为什么接缝消失了。
转折来了。 回到那个页脚。Seedance, Nano Banana, Kling, Wan, Flux。这些是实际工作的模型,而且它们都没有 10 秒的物理限制。上限、免费层的分辨率降级、1 天删除:这些都是包装决策,而不是模型限制。
这意味着有趣的问题不是“Pixnova 好不好”。而是“如果我跳过包装,会发生什么”。
超越Pixnova AI 换脸:模型链、设置和真实价格
四个模型,一个浏览器标签页,没有包装。下面的链条在 Atlas Cloud 上运行,它所需的一切都在它的两个货架上:下面这个表中的按量付费模型,以及旁边的 免费 AI 工具 集合,其中包括一个免费换脸,它自己就能覆盖基础步骤。这个工具在步骤 1 之后有专门的部分。这里是完整的链条。
| 步骤 | 模型 | 在此链条中的任务 | 要选择的设置 | 价格 |
|---|---|---|---|---|
| 3 | GPT Image 2 文本到图像 | 生成一张干净、均匀照明的源脸(如果使用自己的自拍,可跳过) | 质量 high,比例 1:1 | 每张图 $0.009 |
| 4 | Nano Banana 2 Edit | 实际的融合换脸,保留颗粒感、字幕和光线 | 分辨率 2K,宽高比留空 | 2K 时每张图 $0.12 |
| 5 | Seedance 2.0 Mini 图像到视频 | 将融合的静态图像动画化 5 秒 | 720p,5s,宽高比留空 | 截至 2026 年 7 月 20% 折扣 |
| 5b | Seedream 5.0 Pro Edit | 可选:将同一帧重新渲染为清晰的高清海报 | 尺寸 2048x1152 | 每张图 $0.045 |
| 6 | 任意 LLM | 编写将片段转换为 GIF 的 ffmpeg 命令 | 无 | 免费 |
价格已在模型页面本身验证,而非博客,截至 2026 年 7 月。完整列表见 Atlas Cloud 的模型目录。
在开始之前,有三个诚实的限制,因为我宁愿你现在就知道:
- 这里的模型都不直接输出 GIF。 步骤 6 是一个本地 ffmpeg 命令。它不是平台功能,我不会假装它是。
- 融合不是像素级精确的身份转移。 Nano Banana 2 会重新渲染头部,所以结果清晰地读作 那个人,但不是法医鉴定级别的匹配。对于梗图工作,这种权衡是正确的,因为像素级精确的身份转移正是产生贴纸外观的原因。
- 视频模型会重新渲染每一帧, 所以面部会轻微向整个片段的平均值漂移。步骤 4 的静态图像是参考结果。GIF 的存在只是为了证明它会动。
Pixnova AI 换脸教程,然后是融合升级:第 1 到 6 步
第 1 步:3 次点击的 Pixnova 换脸基础
先做这个。不到一分钟,它会给你一个用来比较的基准。
- 上传带脸的源图像。 这是你想把脸 换进去 的照片或视频。你也可以跳过上传,从面板下方的示例底图中选一个。照片支持 JPG、PNG 和 WEBP;视频支持 M4V、MP4、MOV 和 WEBM。无论哪种方式,上限都是 30MB,按钮下方有说明。
- 上传一张面部图像。 要 换上去 的脸。正面、光线均匀、无重滤镜。这比页面上任何其他东西都重要。带有硬阴影的四分之三侧面轮廓在任何工具上都会失败,包括昂贵的工具。
- 点击开始换脸。 三到五秒后你就有了一个文件。视频选项卡是同一面板顶部的一个独立选项卡,那里有 10 秒上限和基于积分的定价。
左侧边栏是其他模式所在的位置:多人换脸(适用于静态和视频)、GIF 换脸、批量换脸和动物换脸。多人模式要求你将每个检测到的面部映射到一张面部图像,最多 5 个。批量模式每次任务最多处理 10 张静态图片。还有人们一直忘记直到付出代价的部分:你的结果在 1 天后被删除,所以在关闭标签页之前下载。
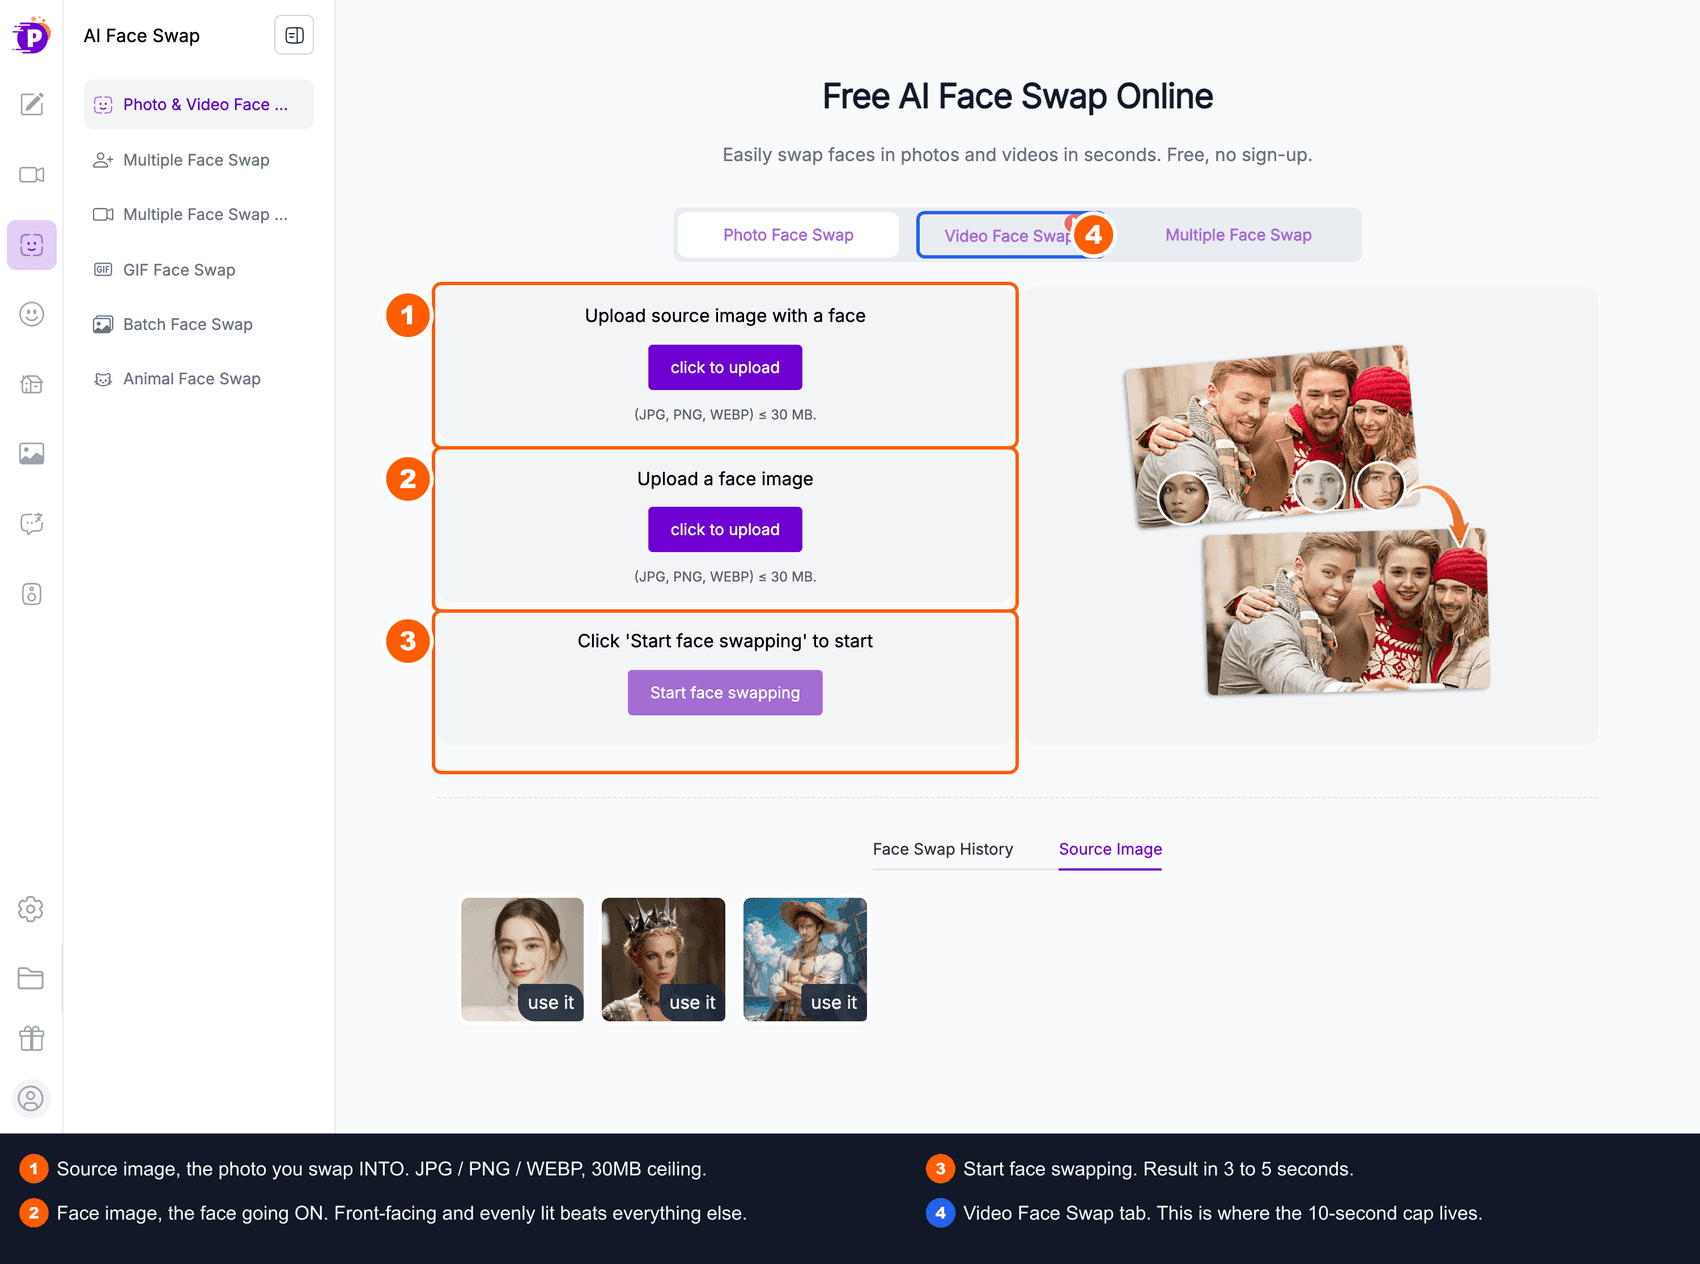
Pixnova AI 换脸界面,带有编号标注,指向源图像插槽、面部图像插槽和开始换脸按钮
Pixnova 换脸页面。截图来自 pixnova.ai,为本教程添加了注释。
作为基准,这没问题。它速度快,免费,对于干净的现代照片来说效果不错。现在放大查看颗粒感和字幕栏,继续阅读。
第 1 步,没有 1 天删除:免费的 Atlas 换脸
Pixnova 的基准带有一个倒计时:你刚刚制作的东西一天后会被删除,免费层在输出时会降低分辨率。Atlas Cloud 的 免费 AI 换脸 工具在没有任何条件的情况下运行相同的三步基准。它自己的常见问题解答用简单的“是”回答了关键问题:免费,无使用限制,无水印,并且上传插槽上方的标签用三个词说了同样的话:“免费 · 不收费”。
在完成第 1 步后,操作流程会感觉很熟悉。上传梗图作为目标照片,上传面部作为面部照片,然后换脸。该工具映射 468 个面部点,并在大约八秒内返回结果。没有提示,取而代之的是两个滑块,混合度和羽化:混合度设置新脸占用的强度,羽化设置其边缘融入周围像素的柔和程度。在颗粒感强的 2011 年截图抓取上,羽化是决定接缝是否显现的滑块,所以把它调高。
为了进行公平的比较,运行本文使用的完全相同的组合:将第 2 步中未经处理的 568x335 Boromir 模板作为目标照片,将第 3 步中的替身头部照片,或者你自己的自拍,作为面部照片。
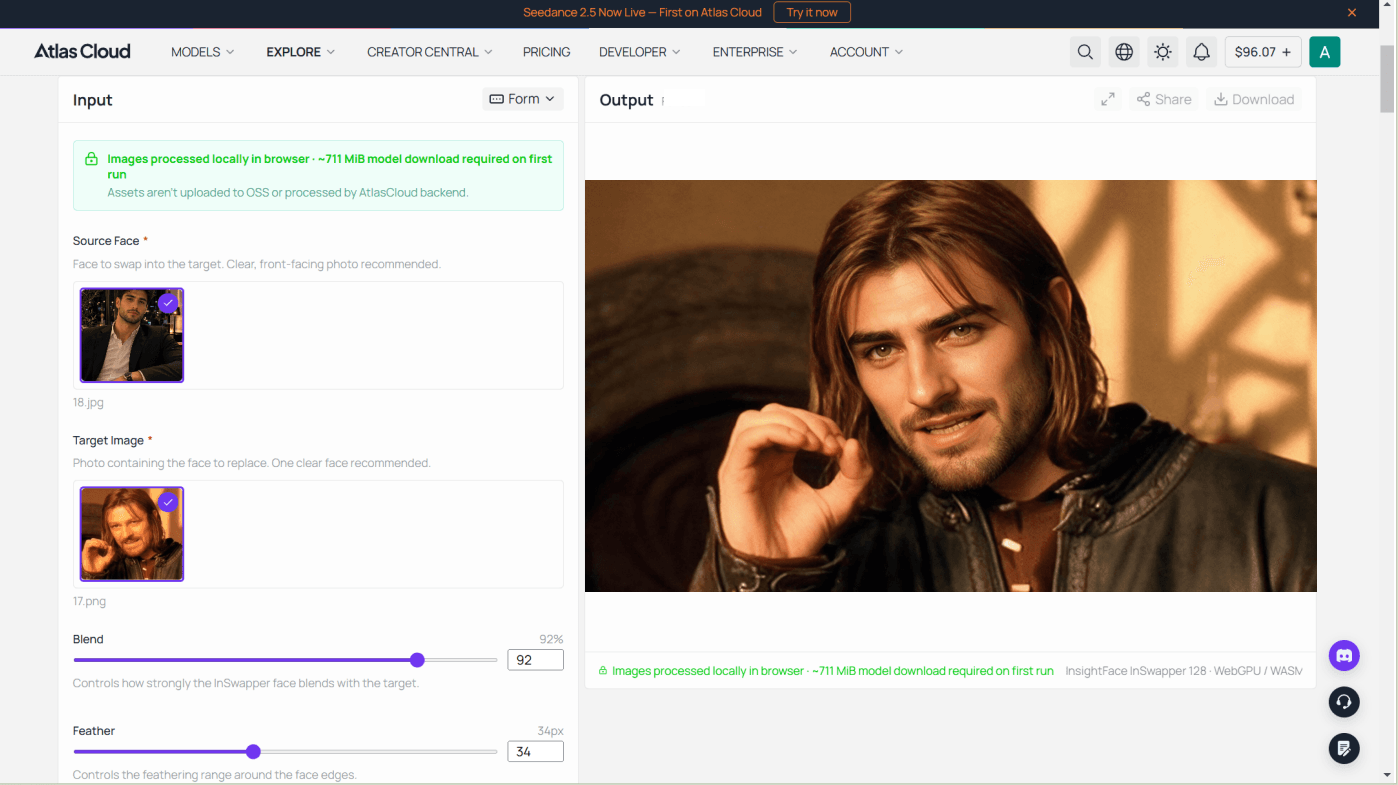
限制条件说得很清楚:这是换脸,不是融合,所以颗粒匹配仍然是第 4 步的任务。仅限照片,每次运行一张脸,没有视频、GIF 或批量模式——这正是 Pixnova 侧边栏的强项。输出是 PNG,尺寸与目标照片相同,最长边最大 1280 像素,低于编辑模型的 2K,并且首次访问会下载大约 711 MiB 的模型文件。作为交换:只要字幕需要,就可以无限次重新运行,没有计量器移动,并且 PNG 文件保存在你的硬盘上,而不是一个一天的计时器上。
第 2 步:给您的 Pixnova 换脸提供一个真正的原始底图
AI 梗图工作中最大的错误:要求模型 画 一些看起来像梗图的东西,然后在那上面换脸。这从来都不管用。AI 重制的 Boromir 不是 Boromir,读者会立刻察觉到,笑话在笑点之前就死了。
所以下载真正的文件。“你不能就这么”模板位于 https://i.imgflip.com/1bij.jpg,一个 568x335 的 JPEG,来自《指环王:护戒使者》中埃尔隆德会议的场景,自 2011 年以来一直在网络上流传(Know Your Meme)。
plaintext1curl -A "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/125 Safari/537.36" \ 2 -L -o boromir.jpg https://i.imgflip.com/1bij.jpg
不要先放大它。那个低分辨率就是梗图的身份证。如果你的输出看起来比 568x335 更清晰,你已经输了。
第 3 步:获取一张干净的源脸(GPT Image 2)
你自己的自拍是这里更好的输入,如果你有的话,直接跳到第 4 步。我生成一个替身面孔,以便本教程对任何阅读的人都是可复现的。
完全粘贴以下内容:
plaintext1一位32岁男性的工作室头像,深棕色短发,浅胡茬,温暖的棕色眼睛,正对镜头,表情中性,嘴巴闭合。前方均匀柔和的灯光,纯中灰色无缝背景,眼睛锐利对焦,自然皮肤纹理,可见毛孔,无眼镜,无帽子,可见肩膀。照片级写实,85mm 人像镜头效果。
设置: 模型 openai/gpt-image-2/text-to-image,质量 high,宽高比 1:1。一张图,高质量 $0.216;降至中等质量为 $0.058,作为替身完全足够。
为什么用这些词:“前方均匀柔和的光线”和“纯中灰色无缝背景”在做实际工作。一张中性、光线均匀的面孔,在融合模型为一幅火炬照亮的石庭院重新打光头部时,没有需要克服的固有色阴影。
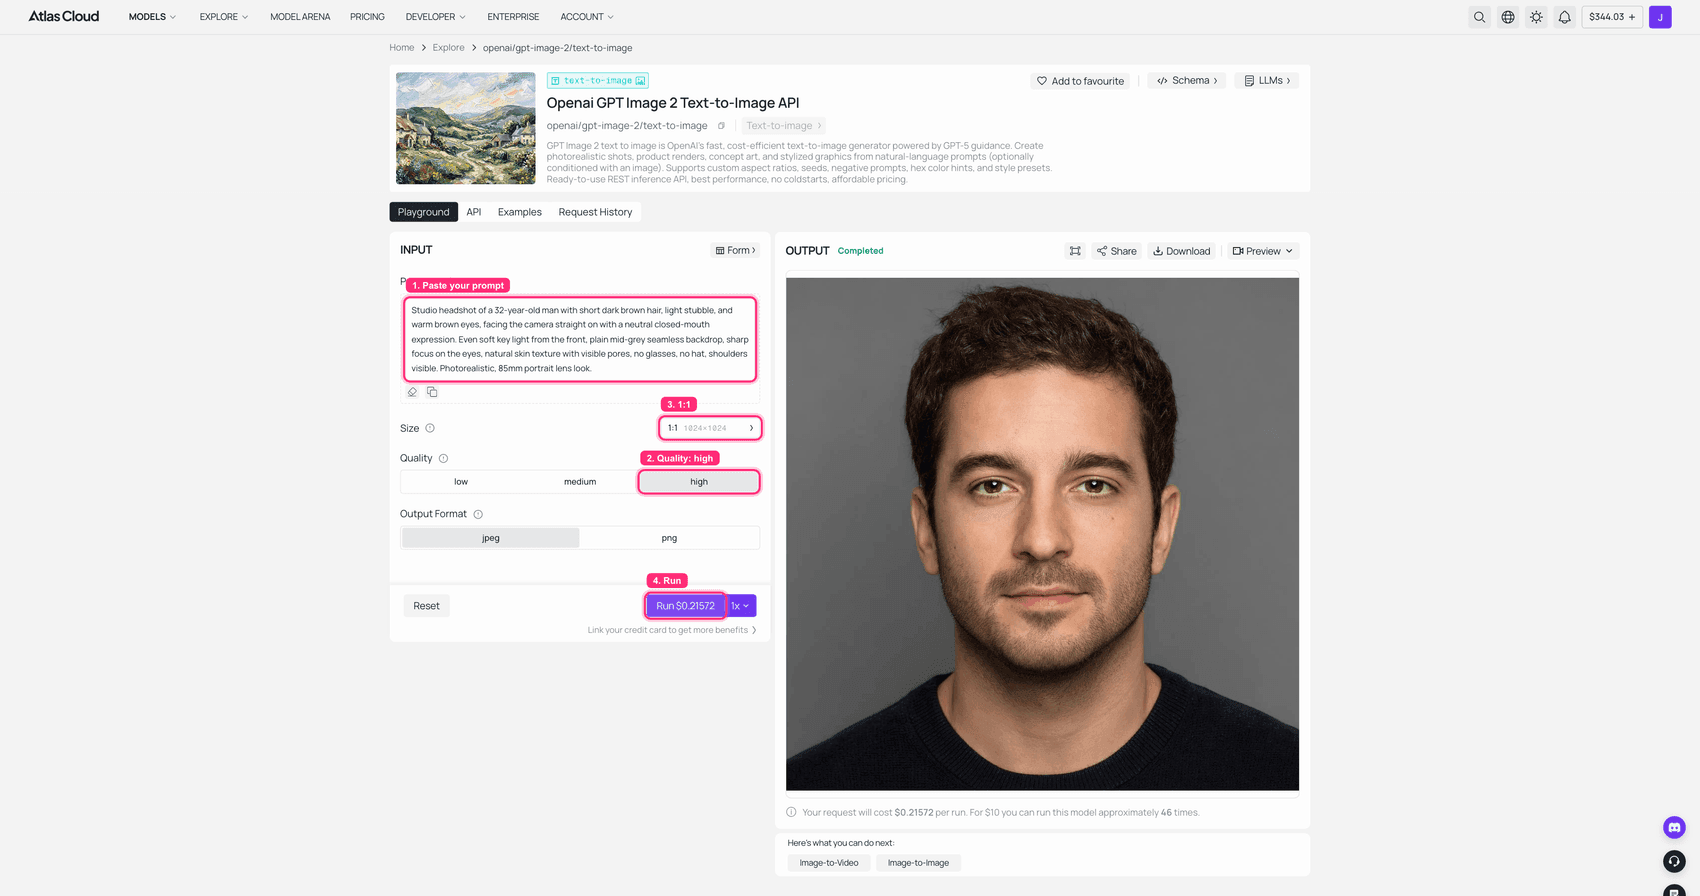
Atlas Cloud 上的 GPT Image 2 工作台,填写了头像提示,OUTPUT 面板中显示完成的正面肖像
Atlas Cloud 上的 GPT Image 2:高质量,1:1,右侧渲染出的干净源脸。
第 4 步:真正的 Pixnova 换脸升级,使用 Nano Banana 2 融合
这一步决定了你的梗图是成功还是看起来像学校作业。提示分为三个部分,按此顺序,顺序不可省略:
- 描述底图实际内容。 模型需要知道它在看什么,然后你才能要求它改变其中一部分。
- 要求头部交换,并声明身份必须改变。 没有这句话,模型经常会“改进”原始面孔,然后还给你一个皮肤更好的肖恩·宾。
- 逐项列出必须保持不变的所有内容。 这是保留列表,也是颗粒感得以存活的原因。
完全粘贴以下内容:
plaintext1Image 1 是低分辨率的“One Does Not Simply” 梗图截图,来自一部 2001 年的奇幻电影:一个长发、胡须的中世纪男人,身穿深色皮毛镶边的皮衣,坐在阳光明媚的石砌议事庭院中,身体前倾,右手食指和拇指举在脸旁,表情严肃警惕,背景是柔和模糊的石头和木头建筑。Image 2 是一位短发深棕色头发、干净剃须的男性的工作室头像。 2 3就地编辑 Image 1。执行完整的头部交换:将 Image 1 中中世纪男人的头部和面部替换为 Image 2 中的男人,使得结果明显是那个人,而不是原始演员。此身份更改是必需的,不要保留原始男人的脸。保持他的脸完全是人类,拥有他自己的眼睛、鼻子和嘴巴,以人类的形式表现出原始人物严肃警惕的表情。 4 5保持完全不变:举起的右手,食指和拇指在脸旁,肩膀前倾的姿势,皮毛镶边的皮衣和长发轮廓,石头庭院背景,来自左上方的温暖日光,以及低分辨率 2001 年风格的柔和感和厚重的 JPEG 压缩颗粒感。将他的肤色和阴影与场景的暖光相匹配。不要清洁、锐化、放大、去噪或美化图像,它必须保持明显低分辨率。 6 7然后添加经典的梗图字幕,使用白色 Impact 字体,带黑色轮廓:顶部跨帧居中显示“ONE DOES NOT SIMPLY”,底部跨帧居中显示“FACE SWAP A 10-SECOND VIDEO FOR FREE”,全部大写。 8 9输出一张编辑后的图像,不是并排、双联或前后对比图。
设置: 模型 google/nano-banana-2/edit,分辨率 2K,宽高比 留空 以继承基础帧,按此顺序加载两张参考图像:先梗图截图,再你的面部。上传前将两张参考图像压缩到大约 1600px JPEG。2K 下每次运行 $0.12。
你实际会遇到的两件事:
- 图像插槽按上传顺序编号,而不是按你想象的那个顺序。 所以在提示中写“梗图截图”和“头像照片”,而不是“第一张图片”和“第二张图片”。这完全消除了歧义。
- 输出偶尔会沿一边出现白色条带, 因为基础帧的宽高比和输出宽高比不一致。裁剪掉,不要重新运行。
- 逐字母检查字幕。 它会令人信服地渲染 Impact 字体,包括轮廓,但足够频繁地丢失或乱掉一个字符。在上面比较图像中我自己的运行中,失去了 FREE 中的 R。要么重新运行,要么之后用任何图像编辑器输入文字,如果帧的其余部分已经正确,这是更安全的方法。
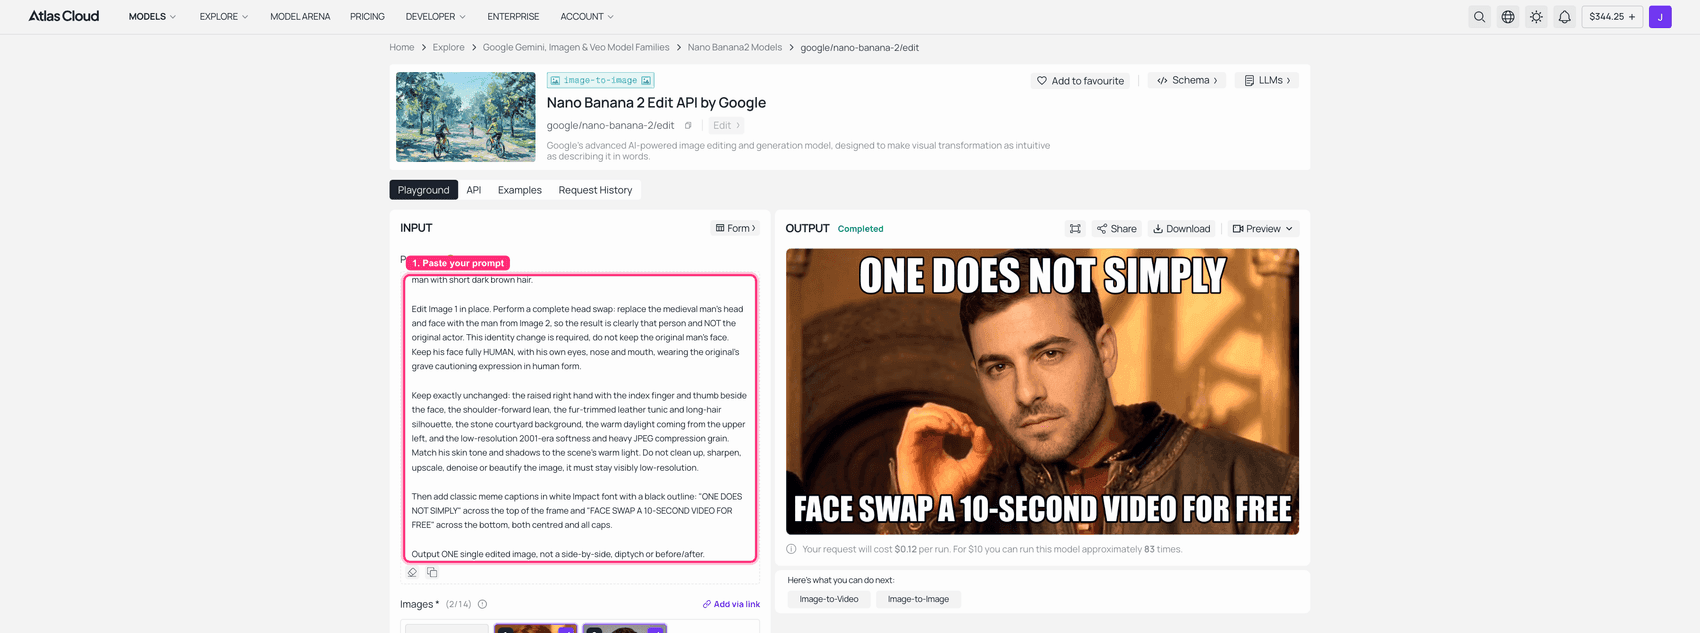 Atlas Cloud 上的 Nano Banana 2 Edit 工作台,加载了梗图底图和头像照片作为参考,OUTPUT 面板中显示融合并带字幕的梗图
Atlas Cloud 上的 Nano Banana 2 Edit:在 2K 下加载了两个参考,右侧是融合结果。
在继续之前检查你的输出。如果面部有硬边,如果整个帧变得清晰干净,或者如果看起来怪异而不是有趣,则拒绝并重新运行。预留一次重试预算。
第 5 步:让您的 Pixnova AI 视频换脸动起来(Seedance 2.0 Mini,720p 下 5 秒)
将第 4 步的静态图像作为第一帧输入,并要求最小的运动。小是整个策略:你要求视频模型改变的东西越少,面部漂移就越少。
plaintext1这位议事成员保持举起的手静止,然后慢慢将其放下几厘米,同时身体进一步前倾。他眨了两次眼,眉头皱紧,轻轻严肃地点了一下头。微妙的手持摄像机抖动。背景保持静止和模糊。锁定构图,无缩放,无剪辑,无重新造型,保持与输入帧完全相同的面部、头发、衣服、照明、字幕文字和颗粒感低分辨率外观。
设置: 模型 bytedance/seedance-2.0-mini/image-to-video,图像 = 你的第 4 步输出,分辨率 720p,时长 5s,宽高比留空。预计渲染时间一到四分钟。运行按钮在你确认之前会显示确切价格,并且该模型在 2026 年 8 月有 30% 折扣,这使得一个 5 秒 720p 的片段大约 $0.43。
再次,诚实的警告,因为它很重要:这个模型会重新生成每一帧,而不是在帧之间追踪面部。在我的片段中,面部在五秒内漂移回原始演员,举起的手降低到画面外。你第 4 步的静态图像是规范结果。这个片段的存在只是为了证明融合在运动中是成立的,而不是为了成为帧级完美的副本。
在这个步骤中发生了两件真实的事情,值得在花钱之前知道。首先,工作台的内容检查 直接阻止了电影剧照帧(“可能与版权限制有关”),而通过 API 提交的相同任务则通过了,并生成了上面 GIF 中的片段。其次,被阻止的运行不会收费。所以下面的截图是相同的步骤、相同的设置,而是在下一节的一个变体帧上运行,因为那是一个普通的街头照片,不包含电影 IP。
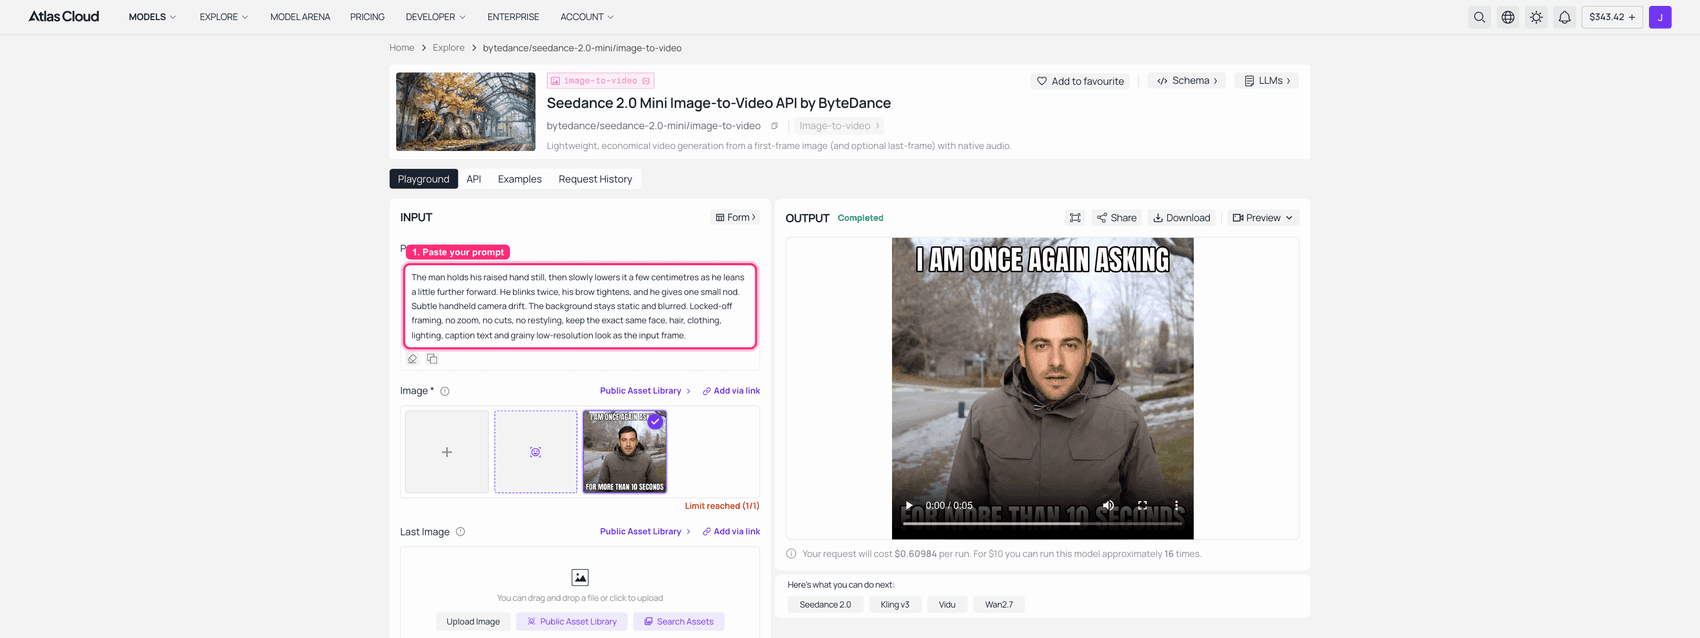
Atlas Cloud 上的 Seedance 2.0 Mini 图像到视频工作台,加载了一个融合的梗图作为第一帧,OUTPUT 面板中显示一个完成的 5 秒片段
Atlas Cloud 上的 Seedance 2.0 Mini,720p 和 5 秒,右侧是实际完成的一个 0:05 片段。在非电影变体帧上运行,因为电影剧照被内容阻止了。
第 6 步:将您的 Pixnova 换脸变成循环 GIF
每个平台上的每个图像和视频模型都会给你 PNG、JPEG 或 MP4。它们都不会给你 GIF。最后一步是在你自己的机器上使用 ffmpeg,你不需要记住这些标志。把这个交给任何 LLM:
plaintext1我有一个 5 秒 1280x720 的 MP4 文件位于 ./swap.mp4,我需要一个循环 GIF,大小低于 5MB,用于 Reddit 和 X。给我一个复制粘贴的 ffmpeg 命令,使用两次传递的 palettegen/paletteuse 滤镜,将宽度缩放至 480px 使用 lanczos,帧率降至 12fps,调色板限制为 128 色,使用 bayer 抖动,并无限循环。然后给我两个备选变体:一个调整为保持在 3MB 以下,一个保持 15fps。每种情况用一行说明我牺牲了什么。
从本文中确切片段测量的尺寸,这样你可以在开始之前选择一个目标:480px 12fps 128 色结果为 3.1MB,提高到 15fps 相同宽度为 3.4MB,降至 400px 12fps 为 2.2MB,320px 10fps 96 色为 1.1MB。低运动片段的压缩效果远比你想象的好,所以从 480px 开始,只有当你实际超出限制时才降低。
融合的“One Does Not Simply”梗图动画 GIF,换入的脸在眨眼和点头,Impact 字幕在位
完成的循环。同样的颗粒感,同样的字幕,不同的脸,而且它在动。
更多值得借鉴的 Pixnova 换脸创意(四个梗图,一张脸)
相同的六个步骤,相同的脸,四个不同的底图。每个都是单独融合的,而不是作为一个网格一次性换脸,因为一次运行要求同时处理四张脸会处理得很糟糕。
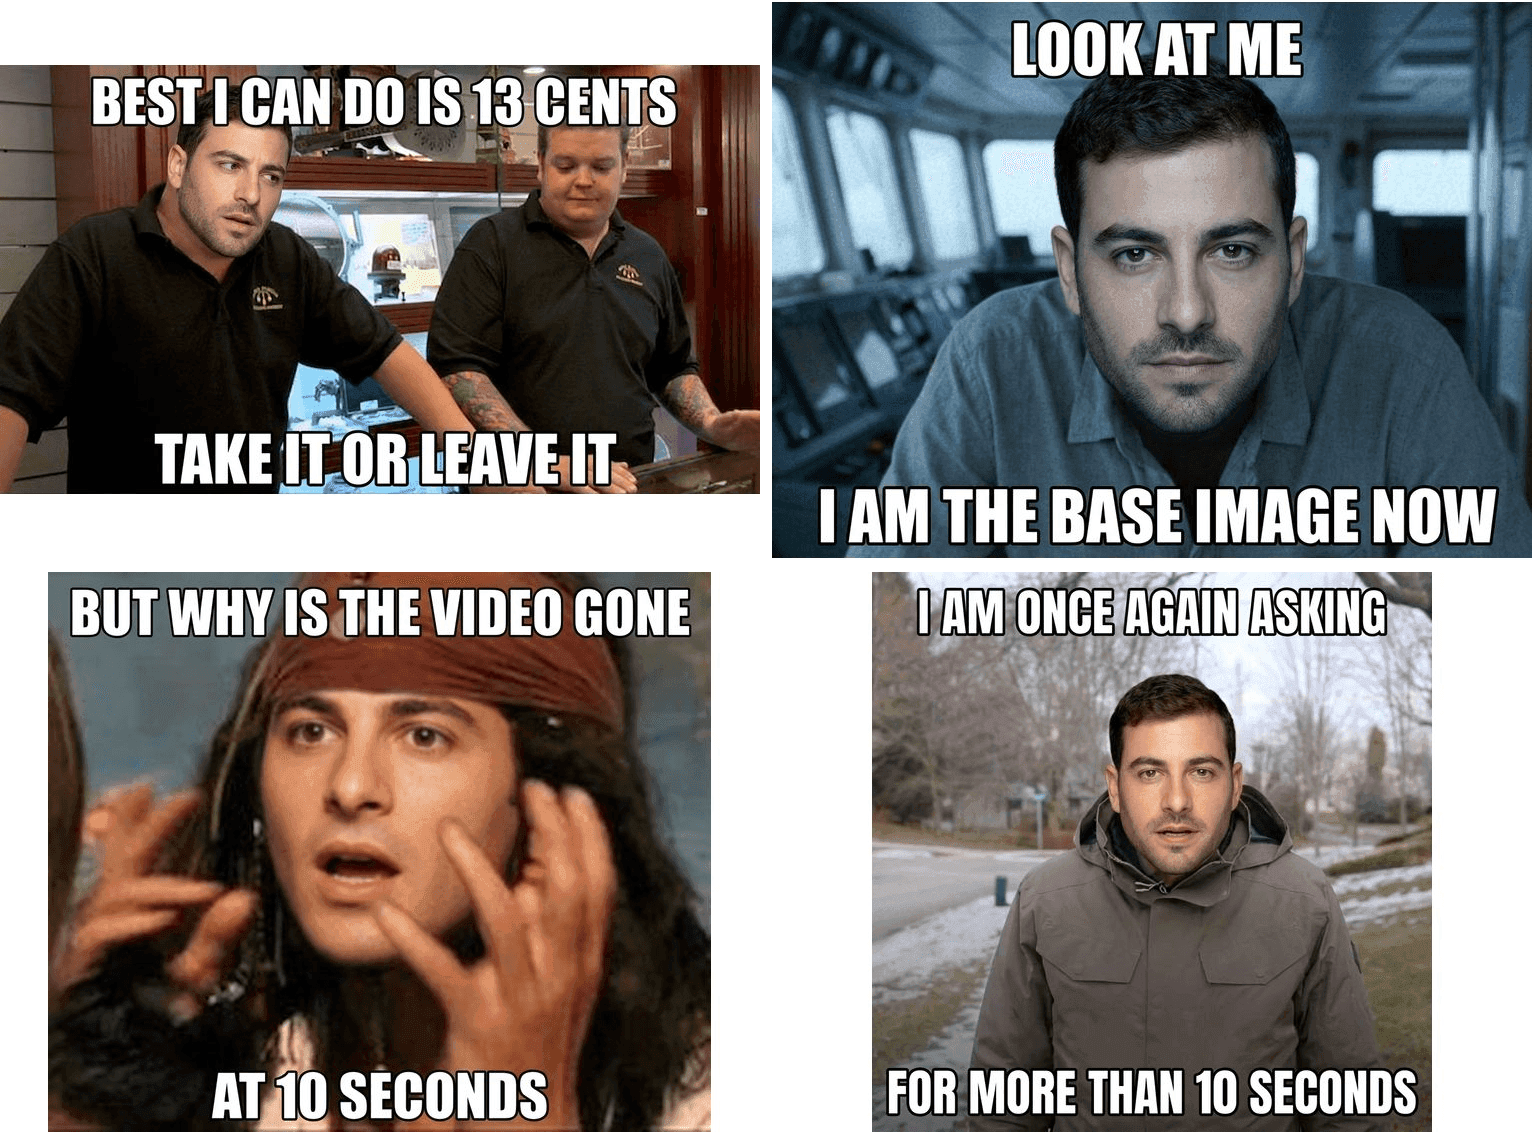
四个融合的梗图变体,以 2x2 网格排列:Pawn Stars 的 Rick Harrison、Captain Phillips 的“我现在是船长了”、Jack Sparrow 的“但为什么朗姆酒没了”、Bernie Sanders 的“再次请求”,所有都带有相同换入的脸
每次运行之间唯一改变的是底图描述和保留列表。结构是相同的:
- Pawn Stars,“我最多能出”。 底图:两个男人在玻璃典当行柜台后面,左边的人正在谈判,摊开手掌耸肩。保留:耸肩、柜台、展示柜杂物、平淡的电视摄像机灯光。字幕:我最多能出 13 美分。
- Captain Phillips,“我现在是船长了”。 底图:一个瘦削的男人穿着浅色衬衫,在狭窄的船舱桥楼里,身体倾向镜头。保留:前倾、桥楼、冷蓝灰光、浅景深。字幕:看着我。我现在是底图了。
- Jack Sparrow,“但为什么朗姆酒没了”。 底图:一个戴头巾的海盗,编着胡须,双手举起,困惑地抗议。保留:举起的双手、珠子、头巾、紧密裁剪、日晒褪色的色调。字幕:但为什么视频在 10 秒就没了。
- Bernie Sanders,“再次请求”。 底图:一个年长的男人,穿着厚重的橄榄色派克大衣,在一条灰色市郊街道上,有斑驳的雪。保留:派克大衣、泥泞的街道、平坦的阴天光线、略微偏离中心的构图。字幕:我再次请求超过 10 秒。
或者反其道而行之,把它做成海报。 以上所有内容都在努力让图像保持丑陋,因为丑陋是让梗图读起来像梗图的原因。但有时你想要相反的效果:相同的脸,相同的姿势,但渲染得像电影海报。在这种情况下,切换模型,因为破坏梗图融合的“美化”正是你现在想要的行为。
Seedream 5.0 Pro 一次就能处理这个:
plaintext1将此议事厅场景重新渲染为精致的电影风格海报:同一个人,相同的脸和身份,相同的手举在脸旁,相同的前倾,相同的皮毛镶边皮衣。升级为清晰的高清现代画质,细腻的细节,通过石拱门的体积极晚午阳光,浅景深,微妙的胶片颗粒感,青绿和琥珀色调。移除所有字幕文字。保持他的脸不变且可识别。
设置: 模型 bytedance/seedream-v5.0-pro/edit,尺寸 2048x1152,这是 16:9 并保持在更便宜的层级,每张图 $0.036。
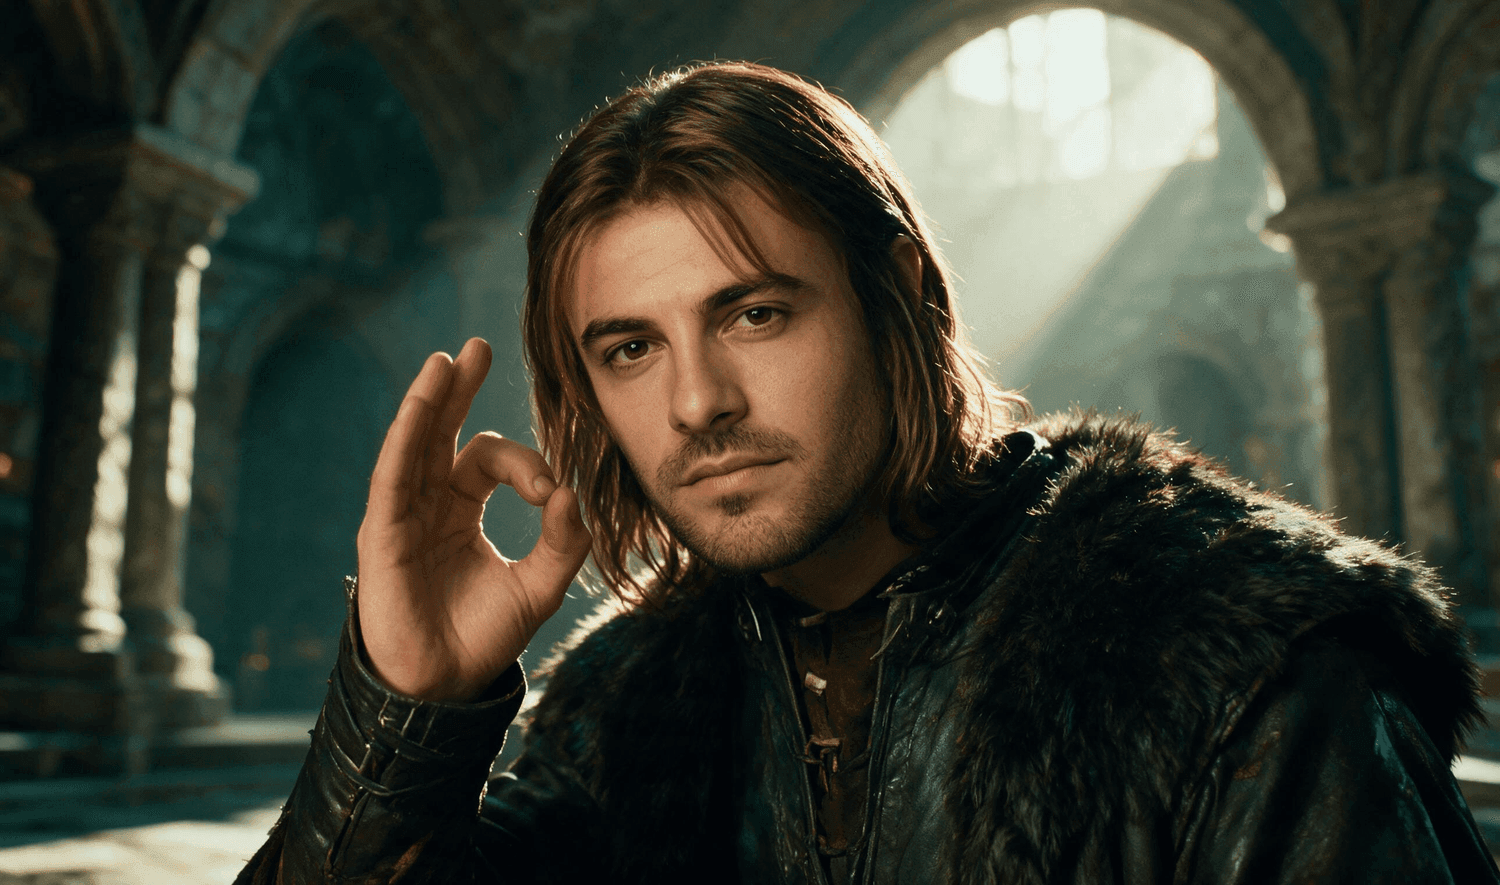
换脸议事厅场景的电影风格海报版本,清晰的高清细节,体积极光线通过石拱门,青绿和琥珀色调
相同的主题,相同的姿势,相反的目的。这就是当你故意让模型清理东西时发生的情况。
Pixnova AI 换脸的真实成本 vs 按次付费
| Pixnova 免费层 | Pixnova 积分包 | 按次付费模型链 | |
|---|---|---|---|
| 需要登录 | 否 | 是 | 是(API 密钥) |
| 水印 | 页面声明无 | 无 | 无 |
| 最大视频长度 | 10 秒 | 10 秒 | 模型无固定上限 |
| 输出分辨率 | 免费层降低 | 高级层更高 | 编辑步骤最高 2K |
| 每次运行人脸数 | 最多 5 张 | 最多 5 张 | 每次一张,设计如此 |
| 结果保留 | 1 天后删除 | 1 天后删除 | 你的,本地保存 |
| 20 张静态梗图 | $0 | $0(照片免费) | 大约 $2.40 |
| 一个 5 秒片段 | 免费层不可用 | 积分,包从 $7.99 起 | 运行前显示价格 |
本文中确切链条的逐项成本,以便你可以检查我的算术:GPT Image 2 一次性替身面孔 $0.216,加上 Nano Banana 2 Edit 2K $0.12,加上当前 30% 促销下大约 $0.43 的 5 秒 Seedance 片段,加上 GIF 转换 $0。跳过生成的替身面孔,使用你自己的自拍,图像路径为每张梗图 $0.12,在一个批次中摊销一个替身面孔后,大约 13 美分。仅静态图像,无视频:$0.12。
比较的公平版本:如果你是大量制作照片梗图,并且你真的不介意颗粒感被磨平,那么 Pixnova 的免费层比任何按次付费设置都便宜,我不会假装不是这样。免费就是免费。13 美分买来的是梗图纹理的保留、没有 10 秒上限、以及第二天早上仍然存在的文件。
关于法律方面,简要说明一下,因为当你的底图是电影剧照时,这确实相关。电影帧的版权属于制片厂。戏仿和评论在许多司法管辖区有实际但有限的余地,但这并非普遍豁免,并且因你所在地区而异。换入真人的脸需要该人的同意,没有商量余地。不要制作任何旨在误导的东西。Pixnova 自己的常见问题解答划出了同样的界限:“严禁使用 AI 创建深度伪造或欺骗性媒体。”
常见问题
Pixnova AI 换脸真的免费吗?它会加水印吗?
照片换脸是免费的,无限制,无需账户,官方页面声明“无需登录,无水印”。视频换脸则进入积分模式,价格在“渲染”按钮上显示。关于某些地区某些输出上存在水印的第三方报告确实存在,所以在投入工作流之前,先下载一个文件自己检查。
Pixnova 视频换脸最长可以多长?为什么有限制?
十秒,Pixnova 的常见问题解答将限制归因于服务器资源。免费层还会在高峰时段降低输出分辨率并排队。更长的视频、更高的分辨率和更大的上传文件位于 Premium 层之后。直接调用图像到视频模型则没有等效的 10 秒上限。
为什么我的 Pixnova 换脸看起来像是粘贴上去的?
因为一个面部矩形被复制到了一张具有完全不同锐度、颗粒感和光线方向的底图上。融合编辑通过使用底图自身的压缩噪点和主光源重新渲染头部来修复这个问题。完成这项工作的三个句子在第 4 步中:描述底图,要求身份更改,然后列出必须保持不变的所有内容。
Pixnova 能直接换脸 GIF 吗?模型链能吗?
Pixnova 有专门的 GIF 换脸模式,接受 GIF 和 WebP,在这个特定点上它确实更方便。没有图像或视频模型原生输出 GIF,所以链式流程是静态换脸,然后是图像到视频,然后是本地 ffmpeg 转换。第 6 步有一个提示,可以为你编写那个命令。
Pixnova 一次可以处理多少张脸?如果我需要更多呢?
每次运行最多五张脸,根据 Pixnova 的常见问题解答,批量模式每次任务最多覆盖 10 张单独的图像。超过这个数字,你需要分成批次。使用编辑模型,实际答案不同:每次通过处理一张脸,然后叠加通过,这比要求一次运行放置多张脸要慢得多,但可靠得多。
像 Boromir 梗图这样的电影剧照换脸合法吗?
该帧的版权属于制片厂。戏仿和评论具有实际但有限的余地,因司法管辖区而异,所以将其视为容忍而非许可。真人的脸需要他们的同意。任何旨在欺骗的东西都是不被允许的,无论根据法律还是 Pixnova 自己的既定政策。
价格和平台限制于 2026 年 7 月验证。模型价格来自 Atlas Cloud 上的各个模型页面;Pixnova 的限制来自其自身发布的常见问题解答和定价页面。


