Bist du schon auf Videos auf TikTok oder Instagram gestoßen, in denen ein „Geist“ in einem Selfie auftaucht – entweder heimlich von hinten heranschleicht oder plötzlich nach vorn stößt? Leute nutzen diesen Geistereffekt, um ihre Freunde zu erschrecken. Ich habe die letzten paar Tage damit verbracht, herauszufinden, wie man diese Geistereffekte mit KI erstellt, und möchte die Methode mit dir teilen.
Das Video oben zeigt Geistereffekte, die ich mit ChatGPT und Veo 3.1 erstellt habe. Von links nach rechts sind das:
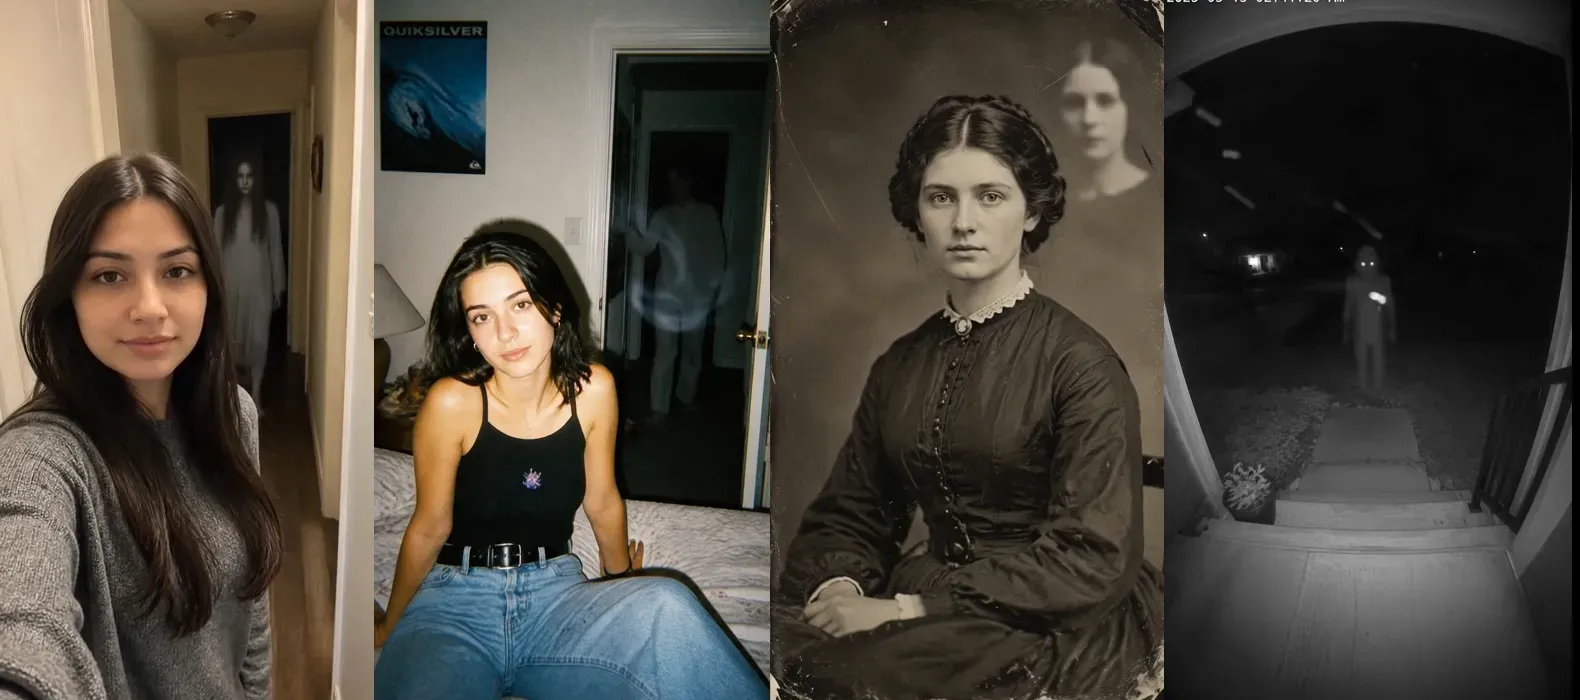
- Panel 1: Flur-Prompt-Iteration (Transparenz & Ähnlichkeit testen)
- Panel 2: Stil 1 – 90er-Einwegblitz-Schlafzimmer-Lauerer
- Panel 3: Stil 2 – Viktorianische spektrale Doppelbelichtung
- Panel 4: Stil 3 – Türklingelkamera-Infrarot-Nachtsicht-Glitch
Schauen wir uns als Nächstes an, wie ich sie erstellt habe.
Das richtige Ausgangsfoto für die KI-Geistervideo-Generierung auswählen
Die meisten fehlgeschlagenen Geister-Transformationen passieren, bevor du überhaupt einen Prompt eingibst. Wenn du ein enges Selfie mit dem gesamten Gesicht hochlädst, verzerren Diffusionsmodelle die Gesichtszüge zu Monstern, anstatt eine separate Figur hinter der Person zu platzieren. Ein erfolgreicher Workflow von Foto zu Geistervideo erfordert sauberen Negativraum.
Rahme dein Motiv von der Brust aufwärts bei flachem, neutralem Licht. Lass mindestens 30 % des Hintergrunds frei. Leere Türrahmen, dunkle Flure und freie Ecken geben Tiefenschätzern unterschiedliche Ebenen, um die Erscheinung zu rendern. Vermeide unruhige Blumentapeten, überfüllte Partyaufnahmen und niedrig aufgelöste Vorschaubilder. Starke Komprimierung ruiniert die Kantenerkennung und verschmiert visuelle Artefakte über das Vordergrundmotiv.
Checkliste vor dem Start für das Foto
Prüfe dein Ausgangsfoto anhand dieser technischen Basis, bevor du mit der Generierung von Frames beginnst:
- Hintergrundfläche: Lass neben oder hinter der Person genügend sichtbaren Hintergrund, um den Geist unterzubringen. Ein Türrahmen oder eine leere Ecke kann helfen, Tiefe zu erzeugen.
- Bildauflösung: Beginne mit der von deinem gewählten Tool empfohlenen Auflösung. Verwende ein klares, gut beleuchtetes Ausgangsfoto und vermeide stark komprimierte Bilder.
- Gesichtsausdruck: Ein entspannter Ausdruck kann es erleichtern, Gesichtsdetails zu bewahren, aber die Ergebnisse hängen vom Modell und vom Ausgangsbild ab.
- Platzierung des Motivs: Halte die Person nach Möglichkeit klar vom Hintergrund getrennt, besonders an Haaren, Schultern und Händen.
Schritt-für-Schritt-Workflow, um einen Geist aus jedem Foto zu animieren
Ein Alltagsfoto direkt in einen Videogenerator einzuspeisen, ruiniert die Ausgabe. Die meisten Foto-zu-Video-Modelle versuchen, einen Geist zu erfinden, während sie gleichzeitig die Kamerabewegung vorhersagen. Das zerreißt das Gesicht der Person zu flüssigem Gummi. Du beseitigst Gesichtsverzerrungen, indem du die Geisterfilter-Video-Pipeline in zwei kontrollierte Phasen aufteilst.
Phase 1: Ein Originalfoto generieren
Beginne damit, ein Standardbild ohne Geist zu generieren, das als Ausgangspunkt für deinen Workflow dient. Wenn du bereits ein geeignetes Bild hast, kannst du diesen Schritt überspringen.
Für diesen Test verwende ich erneut ChatGPT Image 2.0, da es kosteneffizient ist – ein einzelnes Bild in niedriger Qualität kostet nur $0.00971.
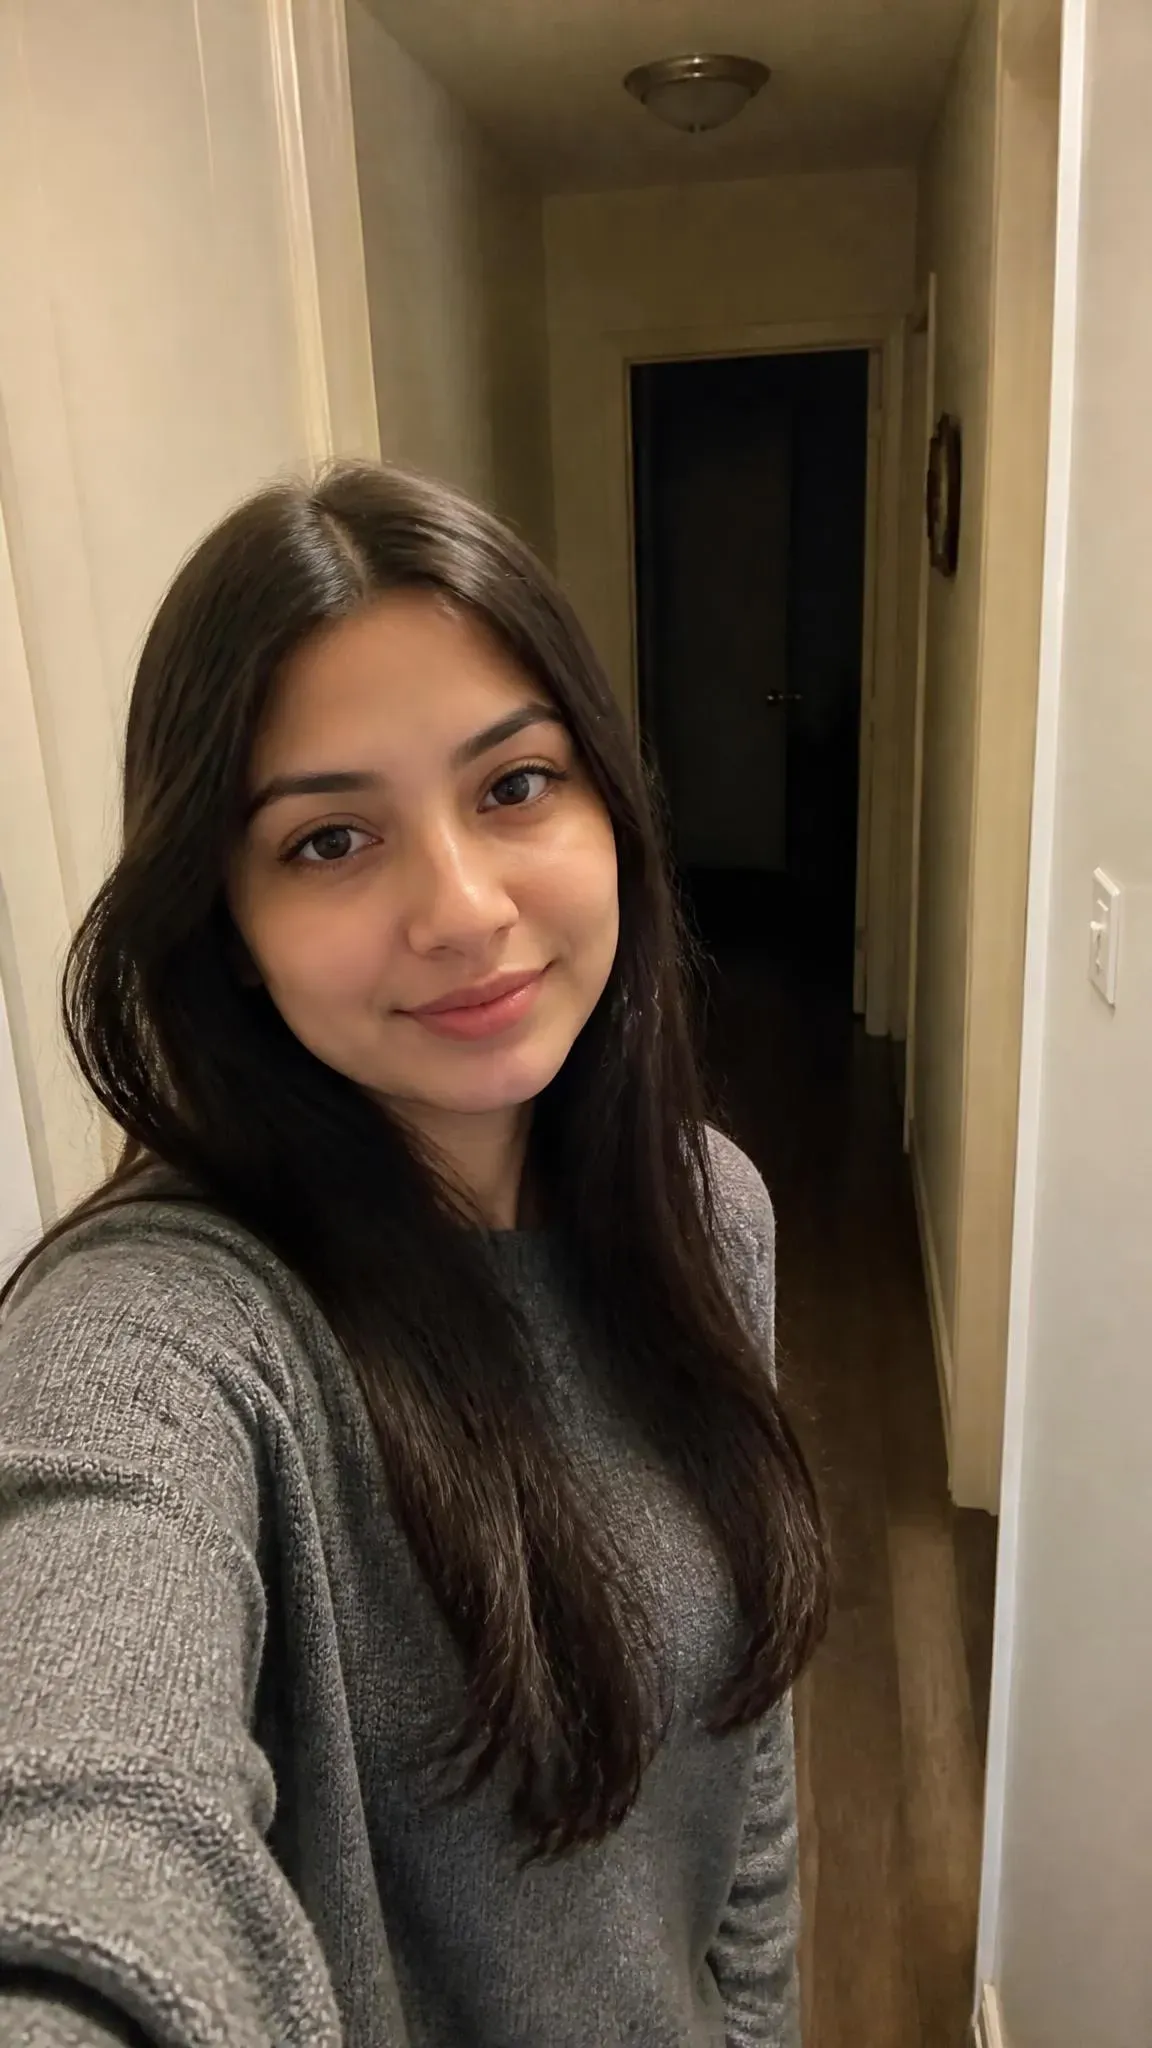
Phase 2: Bewegungsdiffusion konfigurieren
Als Nächstes lade ich das generierte Bild zurück in ChatGPT hoch und nutze seine Bildbearbeitungsfunktionen, um ein Foto zu erstellen, das einen Geist enthält.
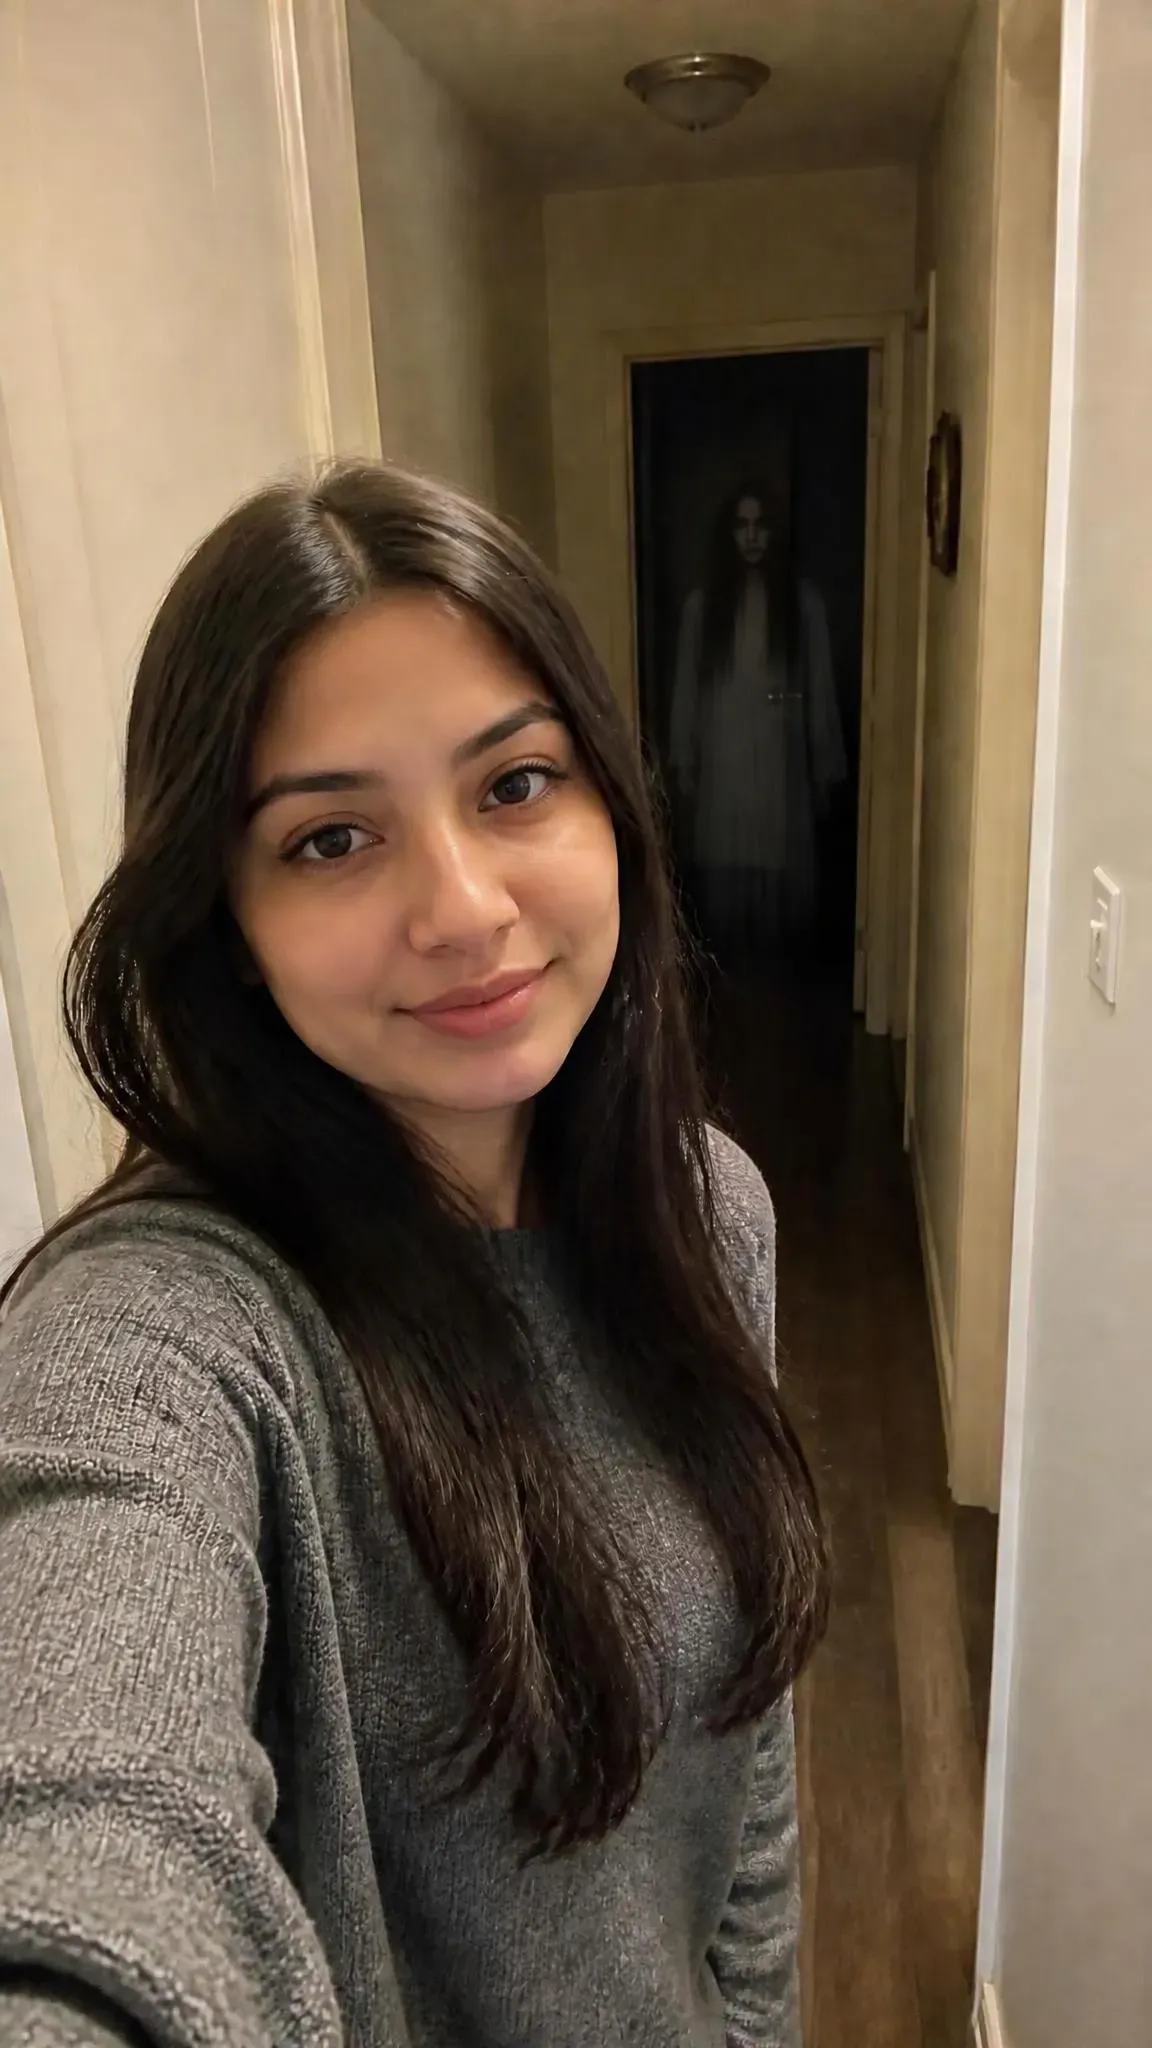
Phase 3: Den Geist mit einem KI-Tool animieren
Ich habe 3 Prompt-Iterationen in Veo 3.1 ausgeführt, um diese Horrorsequenz zu generieren, und mit Test 3 bin ich am zufriedensten.
Hier sind die Ergebnisse:
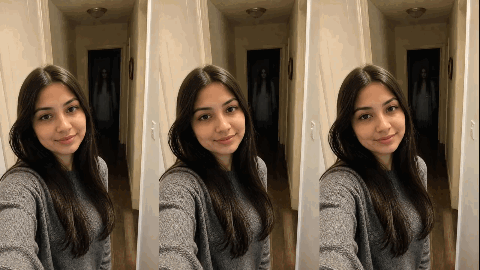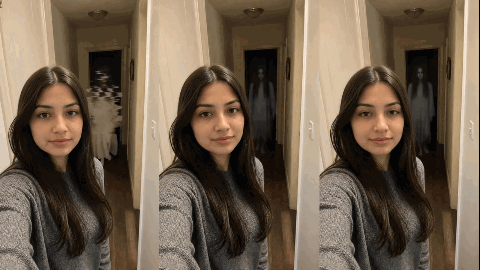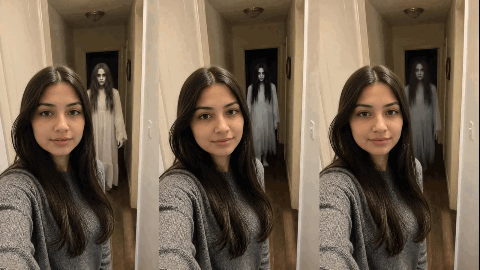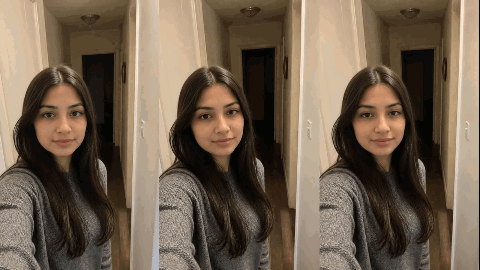
Im Video sind von links nach rechts: test1, test2 und test3.
Basierend auf diesem Test habe ich die folgenden wichtigsten Prompt-Erkenntnisse für die Erstellung von KI-„Geister“-Videos zusammengefasst:
1. Geistertransparenz gegen die Solid-Actor-Bias
- Optische Begriffe verwenden: Beschreibende Wörter wie „Geist“ oder „Spirit“ rendern undurchsichtige Akteure in weißer Kleidung. Ersetze sie durch physische optische Beschreibungen: schwacher durchscheinender Dunst, optische Doppelbelichtung oder 5 % bis 10 % Deckkraft. Zwinge die Diffusions-Engine, Pixel zu mischen.
- Hintergrund-Durchsicht erzwingen: Gib die Sichtbarkeit des Hintergrunds explizit vor: „Flurwände und Türrahmen bleiben zu 90 % durch die Figur hindurch sichtbar.“ Fixiere die Szenengeometrie direkt hinter der Entität.
- Gesichtsdetails unterdrücken: Blockiere die Gesichtsrekonstruktion. Schreibe KEINE deutlichen Augen oder scharfen Gesichtszüge vor. Hindere das Diffusionsmodell daran, kontrastreiche Gesichtskonturen aus dem Ausgangsbild neu aufzubauen.
- Entscheidende Negativ-Prompts: Eliminiere solide menschliche Geometrie und geerdete Beleuchtung: solid human, opaque body, real actress, solid white dress, clear face, floor shadow
2. Manifestations- und Bewegungsdynamik
- Gleiten, nicht gehen: Geh-Prompts lösen Beinkinematik und Stoffsimulation aus. Gib die Anweisung, lautlos durch die Luft nach vorn zu gleiten.
- Phasen und Flackern: Umgebungsschatten erzeugen falsche Verdeckung. Erzwinge direkte Alpha-Verschiebungen: flackert intermittierend zwischen 0 % (unsichtbar) und 10 % Deckkraft. Erzeuge eine echte optische Demanifestation über zeitliche Frames hinweg.
- Verschwinde-Zeitstempel verankern: Diffusionsmodelle driften bei lockeren Auflösungsanweisungen. Fixiere exakte Zeitachsenkoordinaten: „Bei Sekunde 6 löst sich die Figur vollständig in Luft auf und lässt den Flur für die letzten 2 Sekunden zu 100 % leer.“ Erzwinge absolute Hintergrundkontinuität nach dem Verschwinden.
- Hard-Cut-Jump-Scares: Entferne progressive Übergänge. Erzwinge die Einfügung in einem einzelnen Frame: „Manifestiert sich bei Sekunde X sofort in einem einzigen Frame ohne Übergang.“ Unterdrücke frameübergreifende Interpolation und Motion-Blur-Hochlauf.
3. Räumliche Distanz und Kameraframing
- Tiefenbegrenzungen: Gib feste Distanzbeschränkungen an, z. B.
strictly remains 6 to 8 feet behind the subject, um zu verhindern, dass die Figur in den äußersten Vordergrund gleitet. - Den Dual-Phone-Bug beheben: Definiere die Perspektive als
front-facing smartphone camera POV, camera handheld off-screenund fügephone in hands, visible handszu den Negativ-Prompts hinzu.
Modulare Prompt-Formeln für verschiedene Geister-Ästhetiken
Basierend auf den oben genannten Erfahrungen habe ich mit der Erstellung von Videos zum Thema Geister in verschiedenen Stilen experimentiert. Du brauchst nur strukturierte Prompt-Formeln, um die Erscheinung zu isolieren und gleichzeitig die Gesichtsähnlichkeit zu bewahren.
Verwende diese modulare Fünf-Teile-Slot-Formel über multimodale Bild- und Video-Engines hinweg:
Prompt = [POV Rig] + [Subject Anchor] + [Entity Optics] + [Entity Timeline] + [Negatives]
| Slot | Zweck | Syntax-Token |
| POV Rig | Fixiert die Perspektive außerhalb des Bildes; verhindert die Generierung eines zusätzlichen Telefons. | POV front-facing smartphone camera, camera off-screen, empty hands |
| Subject Anchor | Friert den Basisausdruck ein; stoppt dynamisches Lächeln und Gesichtsverzerrung. | neutral baseline expression, subtle blink only, no smile transitions |
| Entity Optics | Erzwingt extreme Transparenz; entfernt scharfe Gesichtszüge. | 5%-10% opacity, see-through double exposure, no sharp face/eyes |
| Entity Timeline | Steuert Gleitbewegung, räumliche Tiefe, Flackern und zeitlich festgelegten Austritt. | glides 6-8ft behind, flickers 0%-10%, dematerializes cleanly at 6s |
| Negatives | Blockiert menschliche Physik, undurchsichtigen Stoff, Schatten und Requisiten. | solid human, opaque cloth, sharp face, floor shadow, phone in hands |
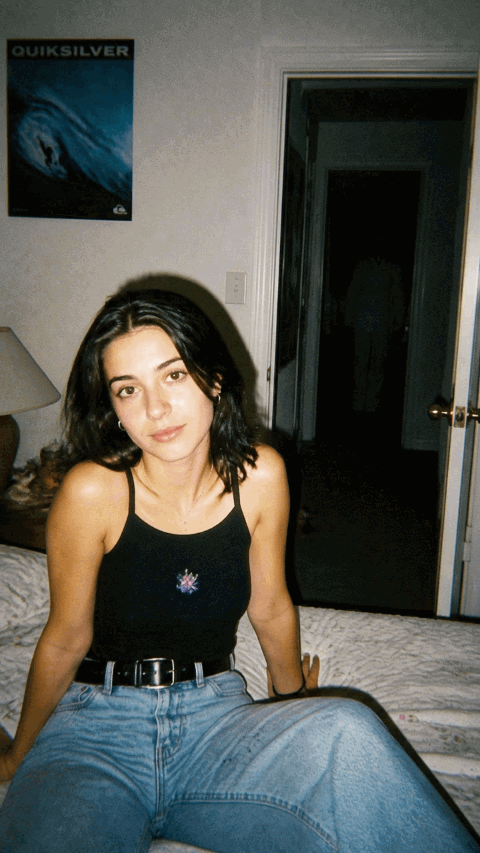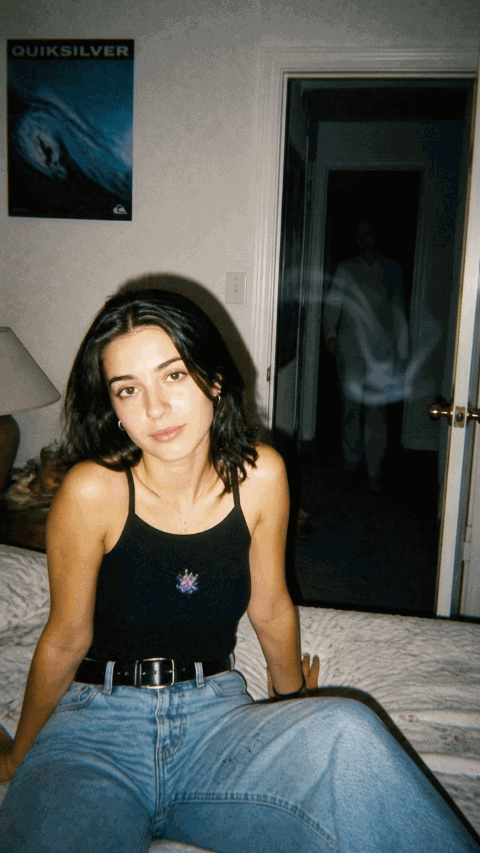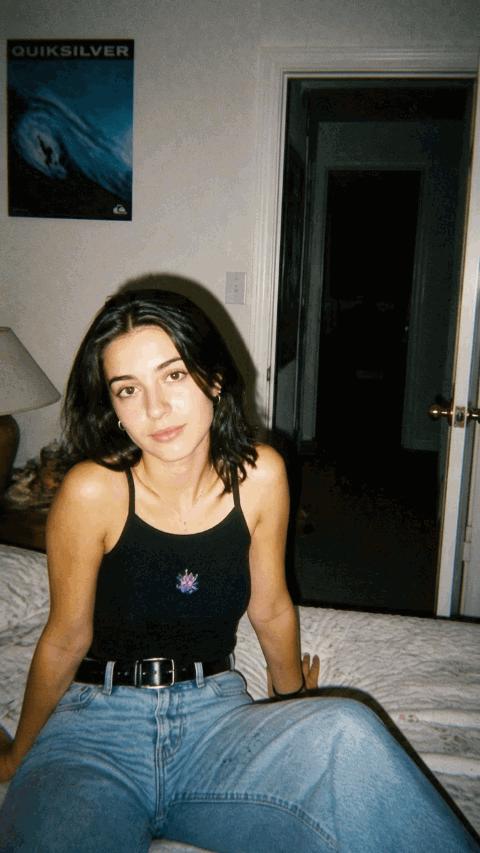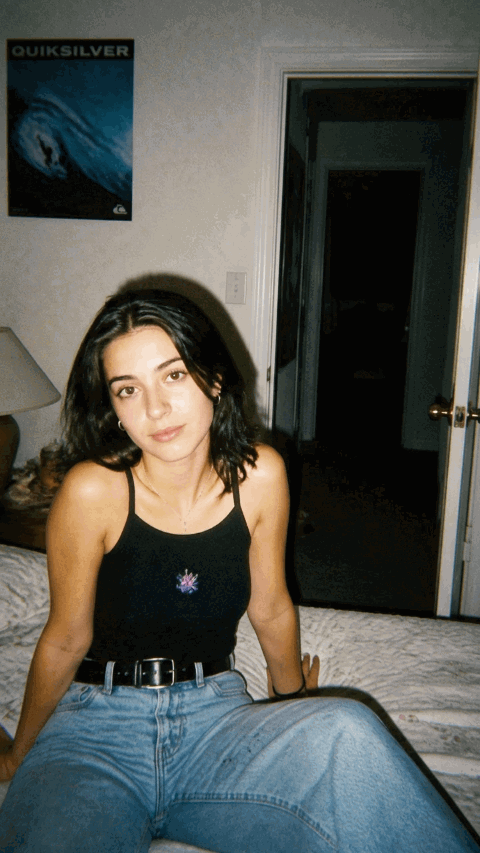
Stil 1: Der 90er-Einwegblitz-Schlafzimmer-Lauerer
Point-and-Shoot-Blitzfotografie verdeckt grobe generative Kanten. Das harte Licht wirft tiefe Schlagschatten an Rückwände. Dieser Schattenabfall gibt deinem Geisterfilter-Prompt eine saubere räumliche Verankerung.
Ziel-Look
Direkte Blitzbeleuchtung auf der Kamera, starkes Kodak-35-mm-Korn, harte Wandschlagschatten und eine extrem schwache, durchsichtige spektrale Fata Morgana, die durch die Hintergrundschatten treibt.
Prompt-Formel zum Kopieren und Einfügen
plaintext11996 point-and-shoot camera POV, direct disposable flash, harsh wall drop shadows, heavy 35mm grain. Camera handheld off-screen, no devices in frame. 2Foreground {SUBJECT_DESC}. Strictly locks baseline neutral expression, subtle blinks only; no smiling, no expression transitions. 3In {SPATIAL_ANCHOR}, a faint translucent {ENTITY_FORM} (strictly 5%-10% opacity, see-through double exposure). Background remains 90% visible through it. Soft-edged, no sharp facial features, no eyes, no cloned face. 4Entity {TRAJECTORY} without leg motion. Opacity flickers 0%-10%. At second {VANISH_TIME}, completely dissolves into dark air, leaving the area empty. 5Negative Prompt: solid human, opaque cloth, sharp eyes, cloned face, floor shadow, walking legs, phone in hands, smiling.
Stil 2: Die viktorianische spektrale Doppelbelichtung
Moderne Innenbeleuchtung steht oft im Widerspruch zur gotischen Ästhetik. Die Doppelbelichtungsformel umgeht dieses Problem, indem sie den gesamten Frame als antike Tintype-Fotografie stilisiert. Das erzeugt ein ätherisches Geisterporträt in Fine-Art-Qualität.
Ziel-Look
Monochrome Daguerreotypie-Kratzer, Silberhalogenid-Texturen und ein schwacher Doppelbelichtungsgeist, der durch einen Belichtungsblitz im Hintergrund materialisiert.
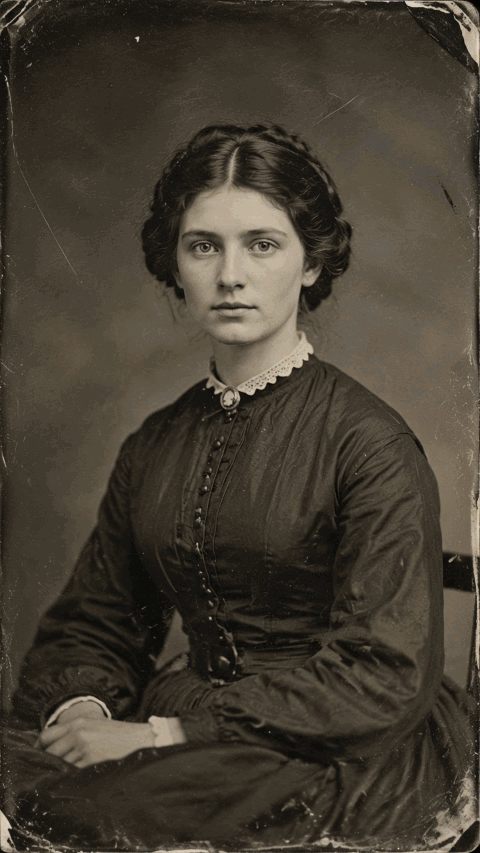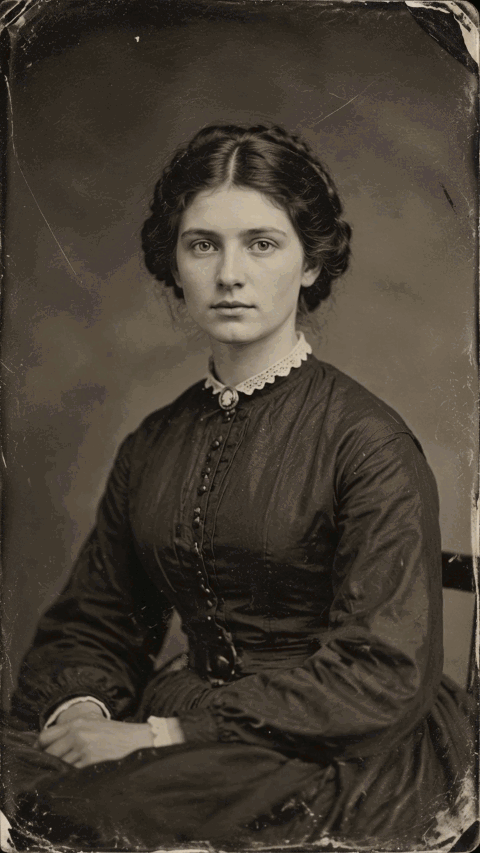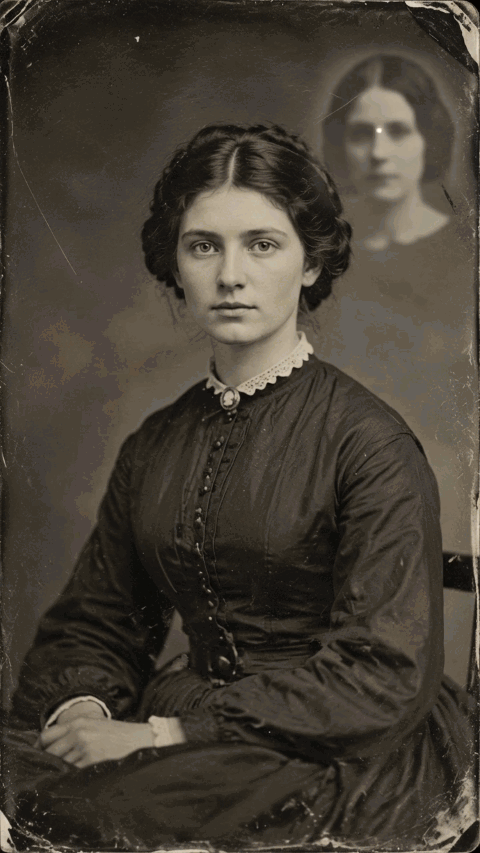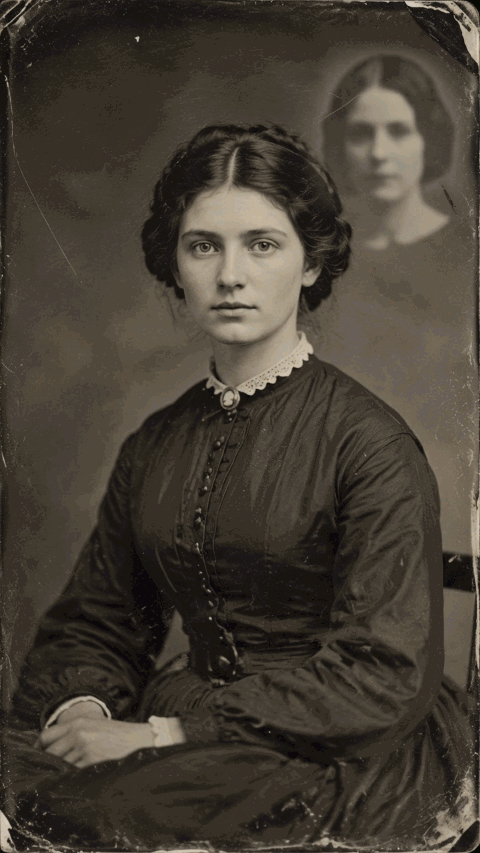
Prompt-Formel zum Kopieren und Einfügen
plaintext1Static 19th-century studio camera framing, authentic tintype aesthetic, silver halide grain, scratches, sepia tones. Zero camera movement. 2Foreground {SUBJECT_DESC}. Formal still pose, preserving exact facial identity from source image. Subtle breathing and slow eye blinks only. 3In {SPATIAL_ANCHOR}, an ultra-faint translucent ghostly haze (strictly 5%-10% opacity, double exposure effect). Blurry contour, NO sharp face, NO eyes. 4- 0 to {APPEAR_TIME}s: Subject sits calmly, background completely normal and empty. 5- {APPEAR_TIME} to {FLASH_TIME}s: Indistinct ghostly blur faintly drifts into view. 6- At {FLASH_TIME}s: Sudden bright magnesium flash fires, instantly freezing the scene into a static antique photograph for the remaining duration. 7Negative: solid human, sharp face, distinct eyes, modern digital lighting, color frames, moving after flash, cartoon.
Stil 3: Der Nachtsicht-Türklingelkamera-Schleicher auf der Veranda
Überwachungsaufnahmen erzeugen sofort Spannung bei den Zuschauern in sozialen Feeds. Niedrig aufgelöstes grünes oder graues Kamerarauschen maskiert leichte zeitliche Artefakte während der Videogenerierung, was diesen Stil ideal für virale Prankschleifen macht.
Ziel-Look
Türklingelkamera-POV, monochrome Infrarot-Nachtsicht, digitaler Zeitstempel-Overlay und eine unheimliche blasse Präsenz, die in den fernen Schatten des Hofs materialisiert und sich auflöst.
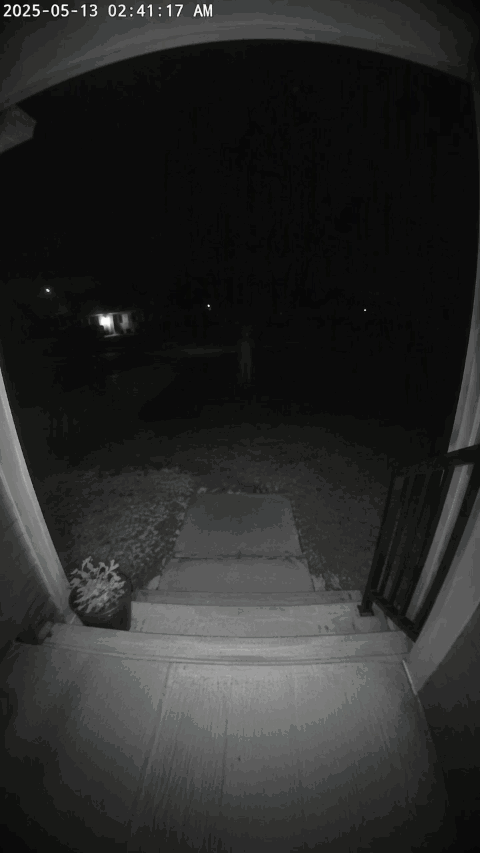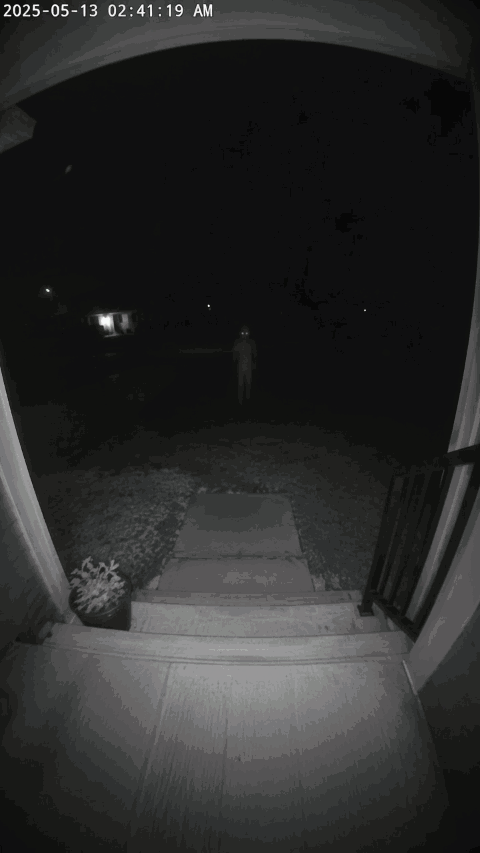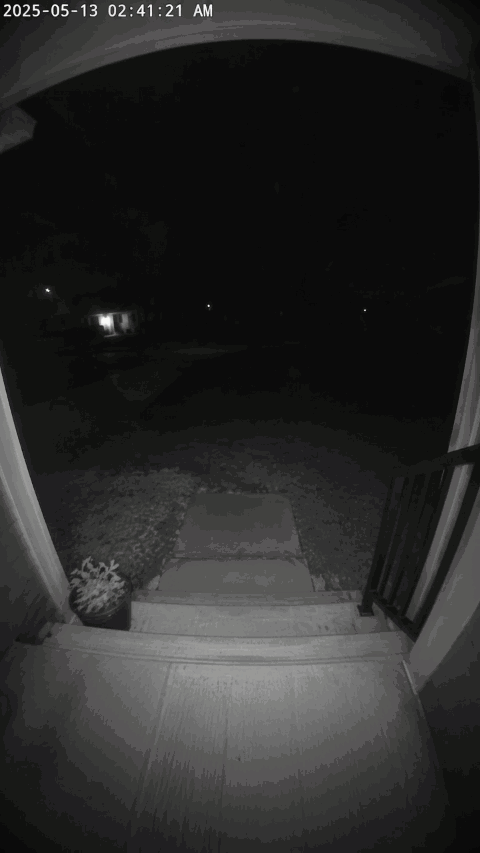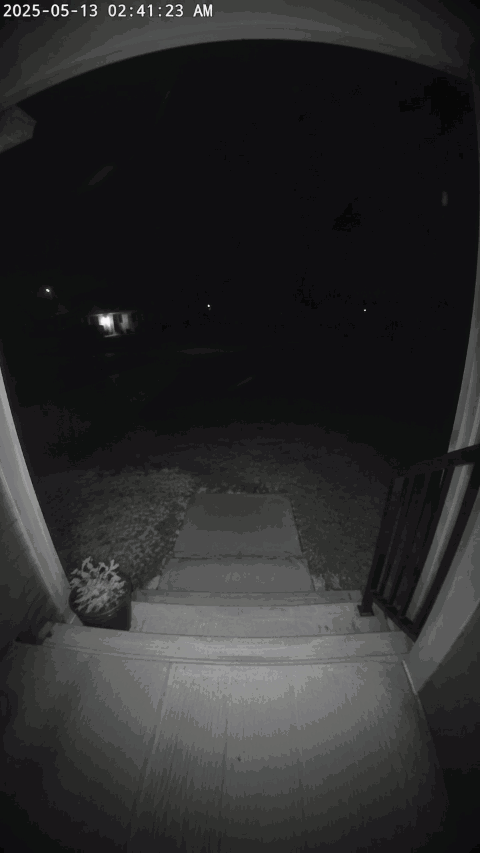
Prompt-Formel zum Kopieren und Einfügen
plaintext1Static 9:16 doorbell infrared night vision, digital sensor noise, timestamp overlay. Zero camera motion. 2Foreground {FOREGROUND_OBJ} remains completely frozen, empty, and unaltered throughout. 3In {SPATIAL_ZONE} only: an ultra-faint, barely visible translucent {ENTITY_FORM} (strictly 5% opacity, IR sensor artifact). Background remains 95% visible through it. NO clothing texture, NO hoodie, NO glowing eyes, NO distinct face. 40 to {APPEAR_TIME}s: {SPATIAL_ZONE} is completely empty. 5{APPEAR_TIME} to {VANISH_TIME}s: The faint entity drifts slightly, strictly locked {DISTANCE}. No walking steps, no forward approach. 6At {VANISH_TIME}s: Instantly dissolves into black shadows, leaving the scene 100% empty until end. 7Negative Constraints: solid human, real person, hoodie, clothes, walking legs, approaching steps, glowing eyes, intruder, burglar, solid silhouette.
KI-Artefakte beheben und Gesichtsähnlichkeit in Geistervideos bewahren
Videodiffusionsmodelle erfassen während der zeitlichen Verarbeitung häufig die falschen Gesichtspixel, wodurch Augen zu verschwommenen Höhlen werden oder Kieferlinien gedehnt werden. Diese visuellen Zusammenbrüche ruinieren den Realismus von KI-Geistervideos. Du kannst diese Renderingfehler beheben, indem du den zugrunde liegenden Fehlermodus isolierst, bevor du Clips generierst.
Diagnosematrix für KI-Geistervideos
| Visuelles Artefakt | Grundursache | Sofortige operative Lösung |
| Solider Humanoid / Akteur | Schwellenwert für Deckkraft zu hoch eingestellt (>15 %), was undurchsichtige Mesh-Synthese auslöst. | Deckkraft strikt auf 5%-10% begrenzen; Kleidungswörter durch vapor glitch, optical smear oder double exposure ersetzen. |
| Geklontes Gesicht der Person | Diffusionsmodell leiht sich das stärkste Gesichts-Token vom Vordergrundanker. | Füge NO cloned face of subject, NO distinct eyes, no sharp facial features zum Optics-Slot hinzu. |
| Annäherungs- / Gehbewegung | Modell interpretiert die menschliche Figur als physischen Fußgänger. | Füge locked distance, glides without leg motion, NO walking steps, no approaching steps hinzu. |
| Wand- und Szenen-Atmung | Nicht fixierte Sensorperspektive. | Prompt zero camera motion, static camera framing, stationary background. |
Das Negativ-Prompt-Arsenal
Unkontrollierte Modelle bringen zufällige visuelle Störungen in Szenen mit schwachem Licht. Füge diesen speziellen Negativ-Block direkt in deinen Generator ein, um die Gesichtsgeometrie zu schützen und spielzeugartige Texturen herauszufiltern:
negative_prompt: [solid human, opaque body, real actor, walking legs, approaching steps, floor shadow, cloned face of subject, glowing eyes, hoodie, clothes texture, phone in hands, sudden smile, camera shake]
Seed-Sperrung für iterative Generierung
Wenn du deinen Prompt änderst, ohne den Generierungs-Seed zu sperren, zerstörst du die Konsistenz des Motivs. Jeder zufällige Seed baut das gesamte räumliche Layout neu auf und verändert die Kieferlinie, Haare und Kleidung der Person. Kopiere den exakten numerischen Seed aus deiner ersten erfolgreichen Basisgenerierung. Sperre diese Ganzzahl in deinen Generator-Einstellungen, bevor du die Platzierung der Entität, die Schattentiefe oder die Deckkraftwerte anpasst. Diese Parametersperre isoliert deine Prompt-Änderungen auf die Hintergrunderscheinung und bewahrt gleichzeitig die Gesichtsähnlichkeit über jedes Test-Rendering hinweg.
Plattformspezifische Exporteinstellungen und virales Pacing für TikTok und Reels
Fünfzehnsekündige Slow Burns zerstören die Reichweite. Statische Frames lösen innerhalb von zwei Sekunden einen Wisch aus. Kurzformat-Algorithmen priorisieren Abschlussraten und sofortige Loop-Wiederholungen. Erscheinungen in Sekunde acht verlieren das Publikum vollständig. Geistervideos mit hoher Retention komprimieren die gesamte visuelle Wirkung in eine strikte Sechs-Sekunden-Schleife.
Das Drei-Sekunden-Reveal-Framework
Strukturiere deine Video-Timeline um virale Pacing-Regeln, um die Retention zu maximieren und Debatten in den Kommentaren anzuregen:
| Zeitstempel | Visuelle Aktion | Zuschauerpsychologie |
| 0:00 bis 0:02 | Normale Alltagsszene. | Zuschauer konzentriert sich auf das Motiv oder liest die Bildunterschrift. |
| 0:02 bis 0:04 | Erscheinung bewegt sich oder dreht sich. | Zuschauer bemerkt periphere Bewegung und schaut zweimal hin. |
| 0:04 bis 0:06 | Motiv bleibt ahnungslos. | Zuschauer wiederholt den Clip, um die visuelle Anomalie zu überprüfen. |
Dieses Timing löst algorithmisches Engagement aus. Zuschauer sehen sich den Clip erneut an, um die Hintergrundbewegung zu überprüfen. Viele pausieren auf einzelnen Frames oder diskutieren in den Kommentaren, ob die Aufnahme gestellt ist, was das Video auf TikTok und Reels einem breiteren Publikum zuführt.
Technische Kodierungsstandards
Plattform-Komprimierungsalgorithmen verschlechtern kontrastarme Schatten und dunkle Flurdetails. Du verhinderst Komprimierungsartefakte, indem du dein KI-Geisterfilter-Video mit plattformspezifischen Exporteinstellungen exportierst:
- Auflösung: 1080×1920 px (striktes vertikales Verhältnis 9:16).
- Video-Codec: H.264 in einem MP4-Container.
- Bildrate: 24 fps oder 30 fps. Höhere Bildraten entlarven synthetische Bewegungsfehler.
- Ziel-Bitrate: 15 bis 20 Mbps konstante Bitrate. Niedrige variable Bitraten verursachen blockartiges Banding in dunklen Ecken.
Der Instagram-Carousel-Wachstums-Hack
Poste niemals einzelne Clips in Instagram-Feeds. Erstelle ein Carousel mit zwei Slides.
Setze das uneditierte Ausgangsfoto auf Slide 1. Lade das gerenderte Geistervideo auf Slide 2. Weise die Zuschauer in der Bildunterschrift an, nach links zu wischen. Das Wischen zwischen dem harmlosen Porträt und dem spektralen Reveal protokolliert mehrere Interaktionsereignisse. Der Algorithmus erkennt diese hohe Verweildauer und spielt den Post neuen Zielgruppen erneut aus.
Die Formeln in die Praxis umsetzen
Die Erstellung hyperrealistischer KI-Geistervideos läuft auf eine einfache Balance hinaus: Fixiere die Identität des Vordergrunds mit Negativraum, begrenze die Deckkraft der Erscheinung strikt auf 5 % bis 10 % und lass das physische Timing das Storytelling übernehmen.
Ob du dich für die harte Körnigkeit des 90er-Einwegblitzes, den Fine-Art-Verfall der viktorianischen Doppelbelichtung oder den verstörenden Realismus eines Smart-Doorbell-Glitches entscheidest – diese zweistufige Pipeline bewahrt die Gesichtsähnlichkeit und eliminiert gleichzeitig die Solid-Actor-Bias.
Probiere diese modularen Formeln mit deinen eigenen Porträt-Prompts aus und teste, welche Ästhetik in deinem Feed am besten funktioniert hat!





