Der Downloadbalken erreicht 65 GB, die Lüfter drehen auf, und die eigentliche Frage steht im Raum: Wird es tatsächlich laden? Die kurze Antwort auf GPT-OSS-120B-Speicheranforderungen lautet etwa 61 GB für die Gewichte plus ein paar weitere GB für Arbeitsbereich, weshalb OpenAI es als Modell für eine einzelne 80-GB-GPU bewirbt.
Im Folgenden zerlegen wir diese Zahl in Teile, zeigen die Hardware, die es mit gemessenen Geschwindigkeiten ausgeführt hat, und behandeln den gehosteten Weg für den Fall, dass Ihre Hardware nicht ausreicht.
Wichtigste Erkenntnisse
- GPT-OSS-120B wird als 60,8-GiB-MXFP4-Checkpoint ausgeliefert, weshalb OpenAI auf eine einzelne 80-GB-GPU abzielt.
- Die Kontextlänge erhöht den Speicherbedarf kaum: Der KV-Cache erreicht bei den vollen 131K Token nur etwa 4,5 GiB.
- Mit weniger als 80 GB VRAM kann llama.cpp Experten-Schichten in den System-RAM auslagern und es trotzdem ausführen.
- Macs mit mehr als 96 GB Speicher und 128-GB-Mini-PCs können das vollständige Modell auf einem einzigen Rechner unterbringen.
- Keine geeignete Hardware? Rufen Sie Qwen3.5 122B A10B auf Atlas Cloud über eine OpenAI-kompatible API auf.
GPT-OSS-120B-Speicheranforderungen: Gewichte plus KV-Cache
OpenAI veröffentlichte gpt-oss-120b am 5. August 2025 unter der Apache-2.0-Lizenz. Es ist ein Mixture-of-Experts-Modell, daher arbeiten pro Token nur 5,1B seiner 116,8B Parameter. Das hilft bei der Geschwindigkeit, nicht beim Speicher: Jeder Experte muss weiterhin im Speicher bereitliegen, um ausgewählt werden zu können.
Der Trick, der es klein hält, ist MXFP4. Laut der gpt-oss-Modellkarte werden die Experten-Gewichte, die über 90 % der Parameter ausmachen, mit jeweils 4,25 Bit gespeichert. Eine 16-Bit-Kopie desselben Modells bräuchte ungefähr den vierfachen Speicherplatz.
| Spezifikation | GPT-OSS-120B |
|---|---|
| Gesamtzahl Parameter | 116,8B |
| Aktive Parameter pro Token | 5,1B |
| Schichten und Experten | 36 Schichten, 128 Experten, 4 aktiv pro Token |
| Gewichtsformat | MXFP4 für Experten-Schichten, BF16 für den Rest |
| Checkpoint-Größe | 60,8 GiB |
| Kontextfenster | 131.072 Token |
Wie das Kontextfenster die GPT-OSS-120B-Speichernutzung verändert
Jedes Token hinterlässt in jeder Attention-Schicht einen Key und einen Value. Dieser Speicher ist der KV-Cache, und wenn jede Schicht auf den vollen Kontext achtet, wächst er im Gleichschritt mit der Kontextlänge.
GPT-OSS-120B umgeht das größtenteils. Die Hälfte seiner 36 Schichten verwendet ein Sliding Window, das nur 128 Token zurückschaut, und jede Schicht speichert nur 8 KV-Heads mit 64 Dimensionen. Nur 18 Schichten behalten den gesamten Kontext. Wir haben den KV-Cache aus der Konfiguration des Modells berechnet, und er stimmt mit den gemessenen Summen im llama.cpp-gpt-oss-Leitfaden überein.
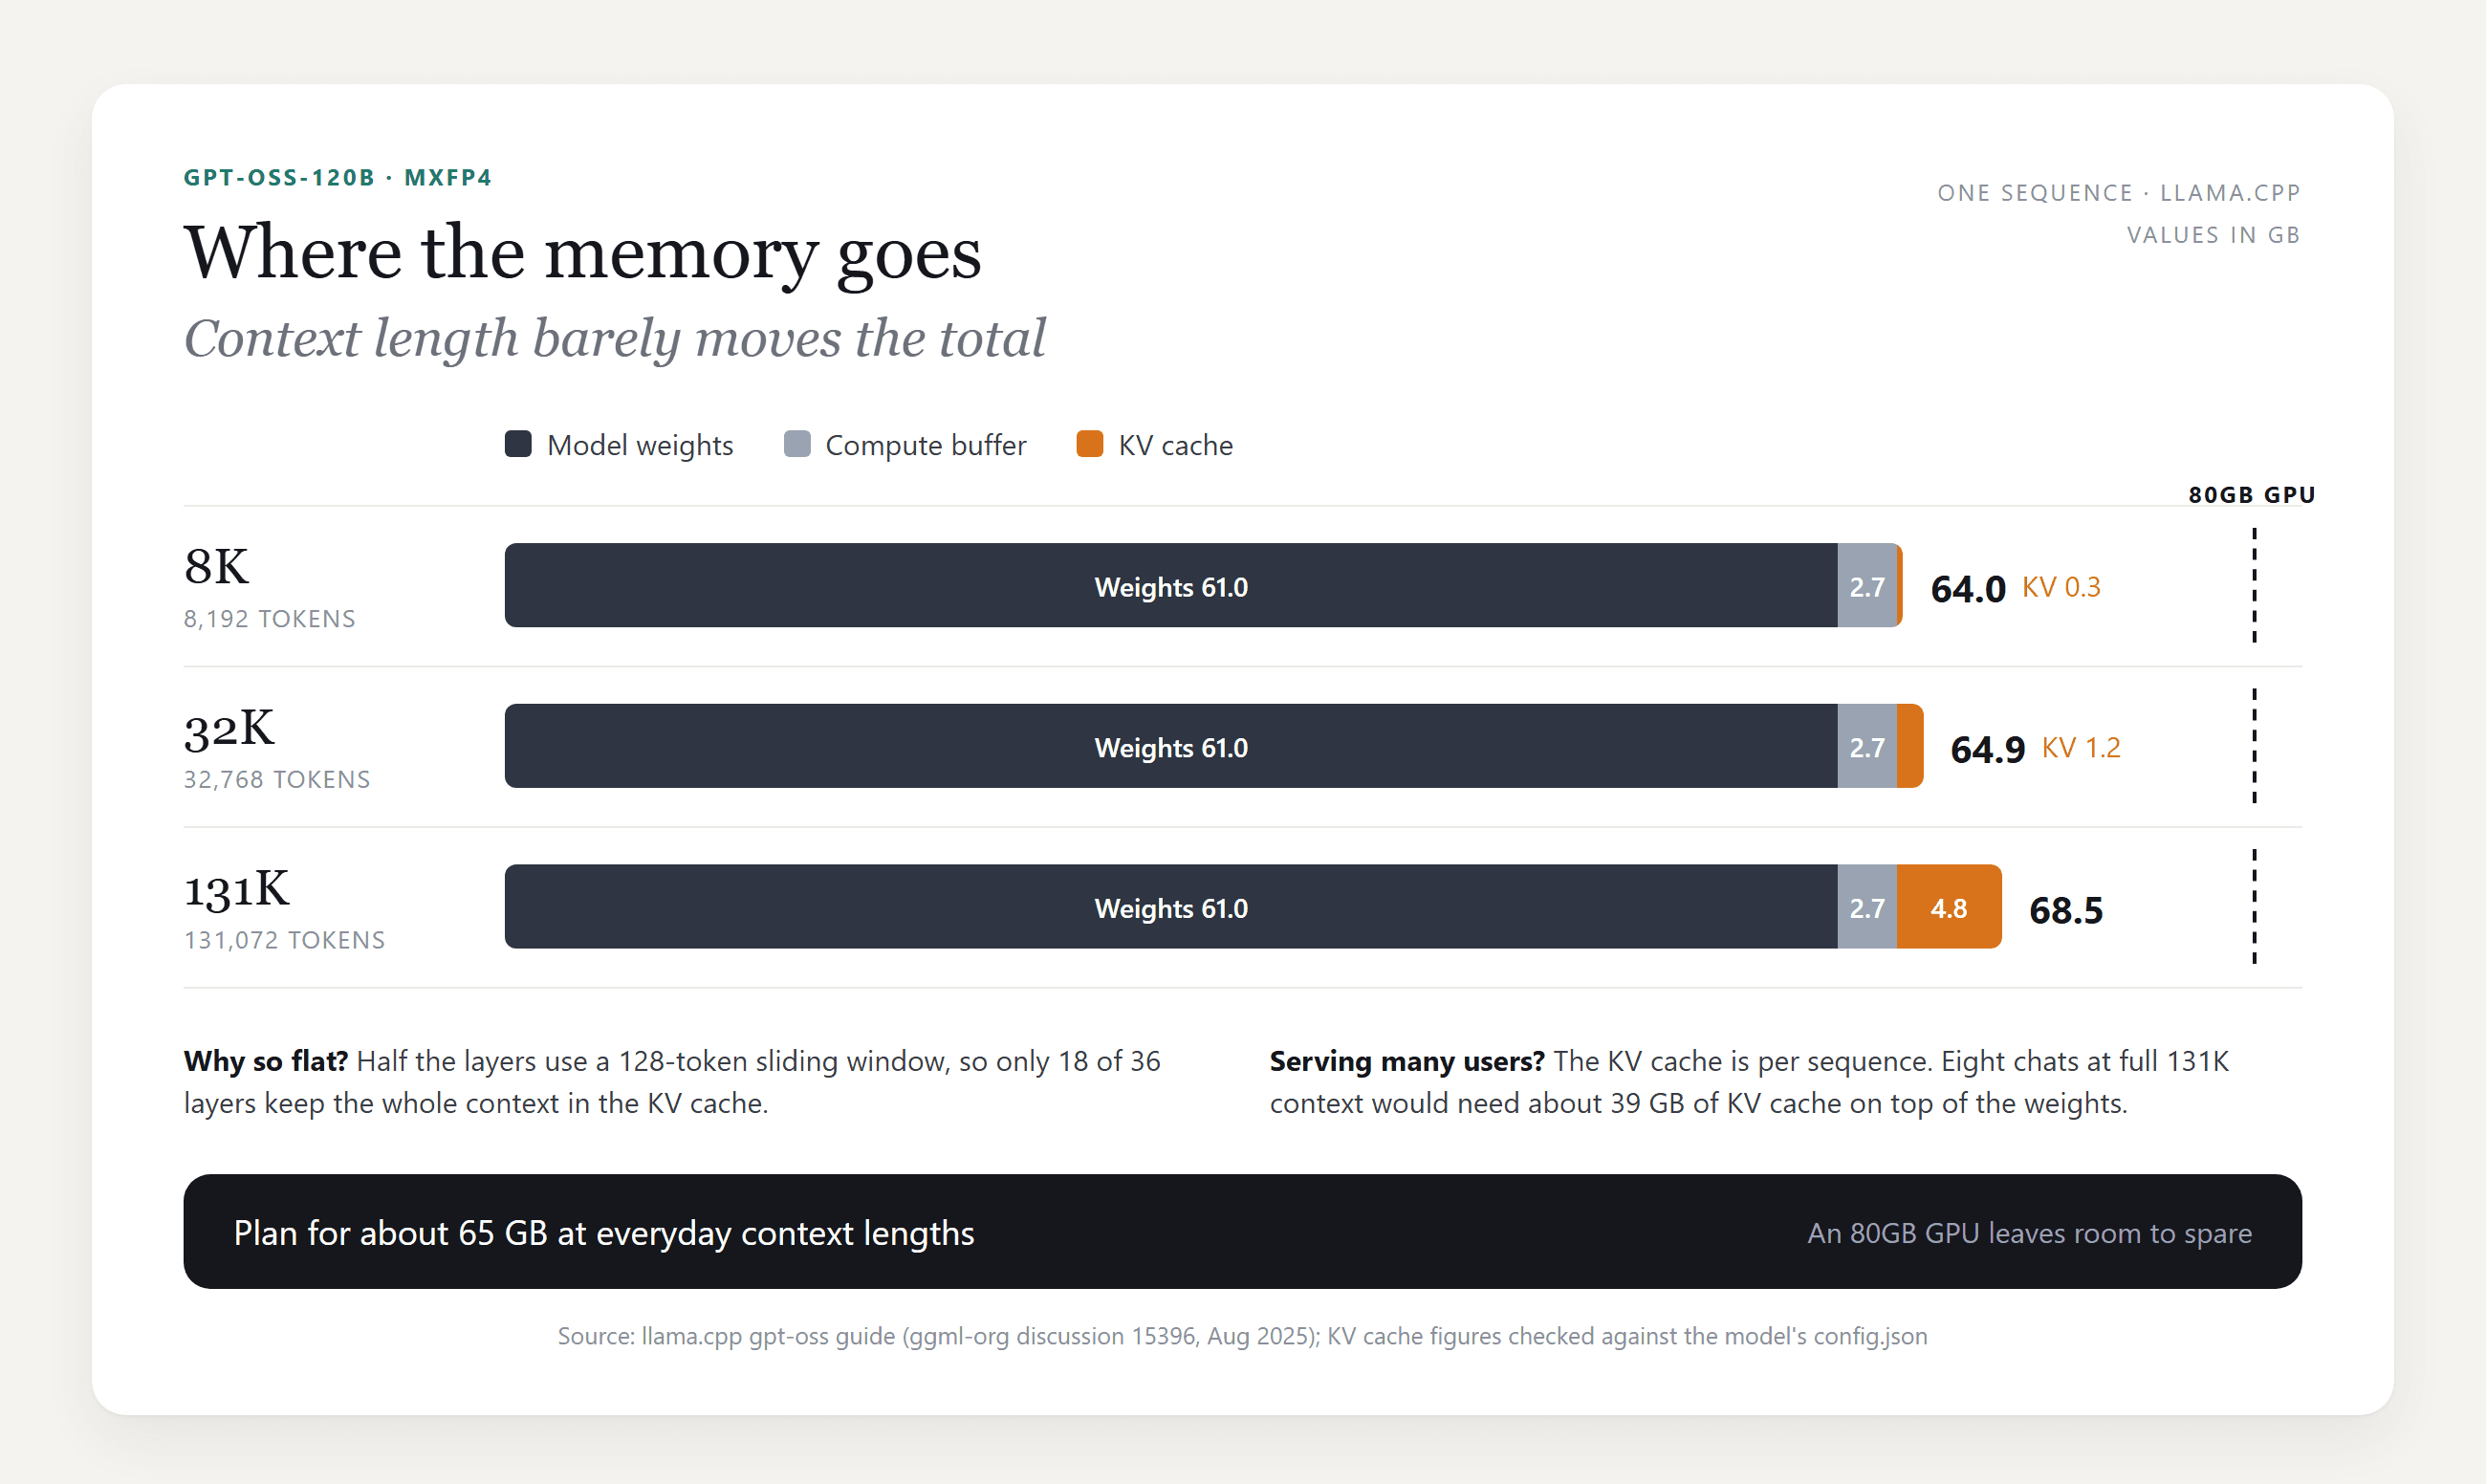
Der Sprung von 8K auf die vollen 131K kostet unter 5 GB. Wo es sich summiert, ist die Parallelität: Der KV-Cache fällt pro Konversation an, sodass ein Server mit acht Chats in voller Länge zusätzlich zu den Gewichten grob 39 GB benötigt.
Kann ich GPT-OSS-120B lokal ausführen? Hardwareanforderungen je Setup
Ja, wenn Sie etwa 65 GB irgendwo schnell unterbringen können: eine große GPU, eine GPU plus System-RAM oder ein Rechner mit Unified Memory.
GPT-OSS-120B-GPU-Anforderungen
Der einfachste Fall ist eine einzelne 80-GB-Rechenzentrumskarte. Das vLLM-Rezept für gpt-oss sagt, das 120b-Modell „passt auf eine einzelne A100 (80GB)", und dass die Aufteilung auf mehr GPUs den Durchsatz erhöht.
Unter 80 GB bietet der llama.cpp-Leitfaden einen Ausweg. Sein --n-cpu-moe-Flag behält einige Experten-Schichten im System-RAM und den Rest auf der GPU. Der Leitfaden nennt etwa 8 GB VRAM als Minimum, solange GPU- und Systemspeicher zusammen weiterhin das Modell aufnehmen können.
| Setup | Wo die Gewichte liegen | Gemeldete Generierungsgeschwindigkeit |
|---|---|---|
| RTX Pro 6000, 96GB | Alle auf der GPU | 196 Token/s (llama.cpp-Leitfaden) |
| A100 oder H100, 80GB | Alle auf der GPU | Passt auf eine Karte (vLLM-Rezept) |
| RTX 5090, 32GB, plus System-RAM | 21 Experten-Schichten im System-RAM behalten | Etwa 30 Token/s bei null Kontext (llama.cpp-Leitfaden) |
Eine Windows-Falle aus demselben Leitfaden: Der Treiber kann bei vollem VRAM still in den System-RAM ausweichen, sodass das Modell lädt und dann kriecht. Beobachten Sie den GPU-Speicher im Task-Manager und erhöhen Sie die Offload-Anzahl, bis er unter der Größe Ihrer Karte bleibt.
GPT-OSS-120B auf einem Mac oder 128-GB-Mini-PC ausführen
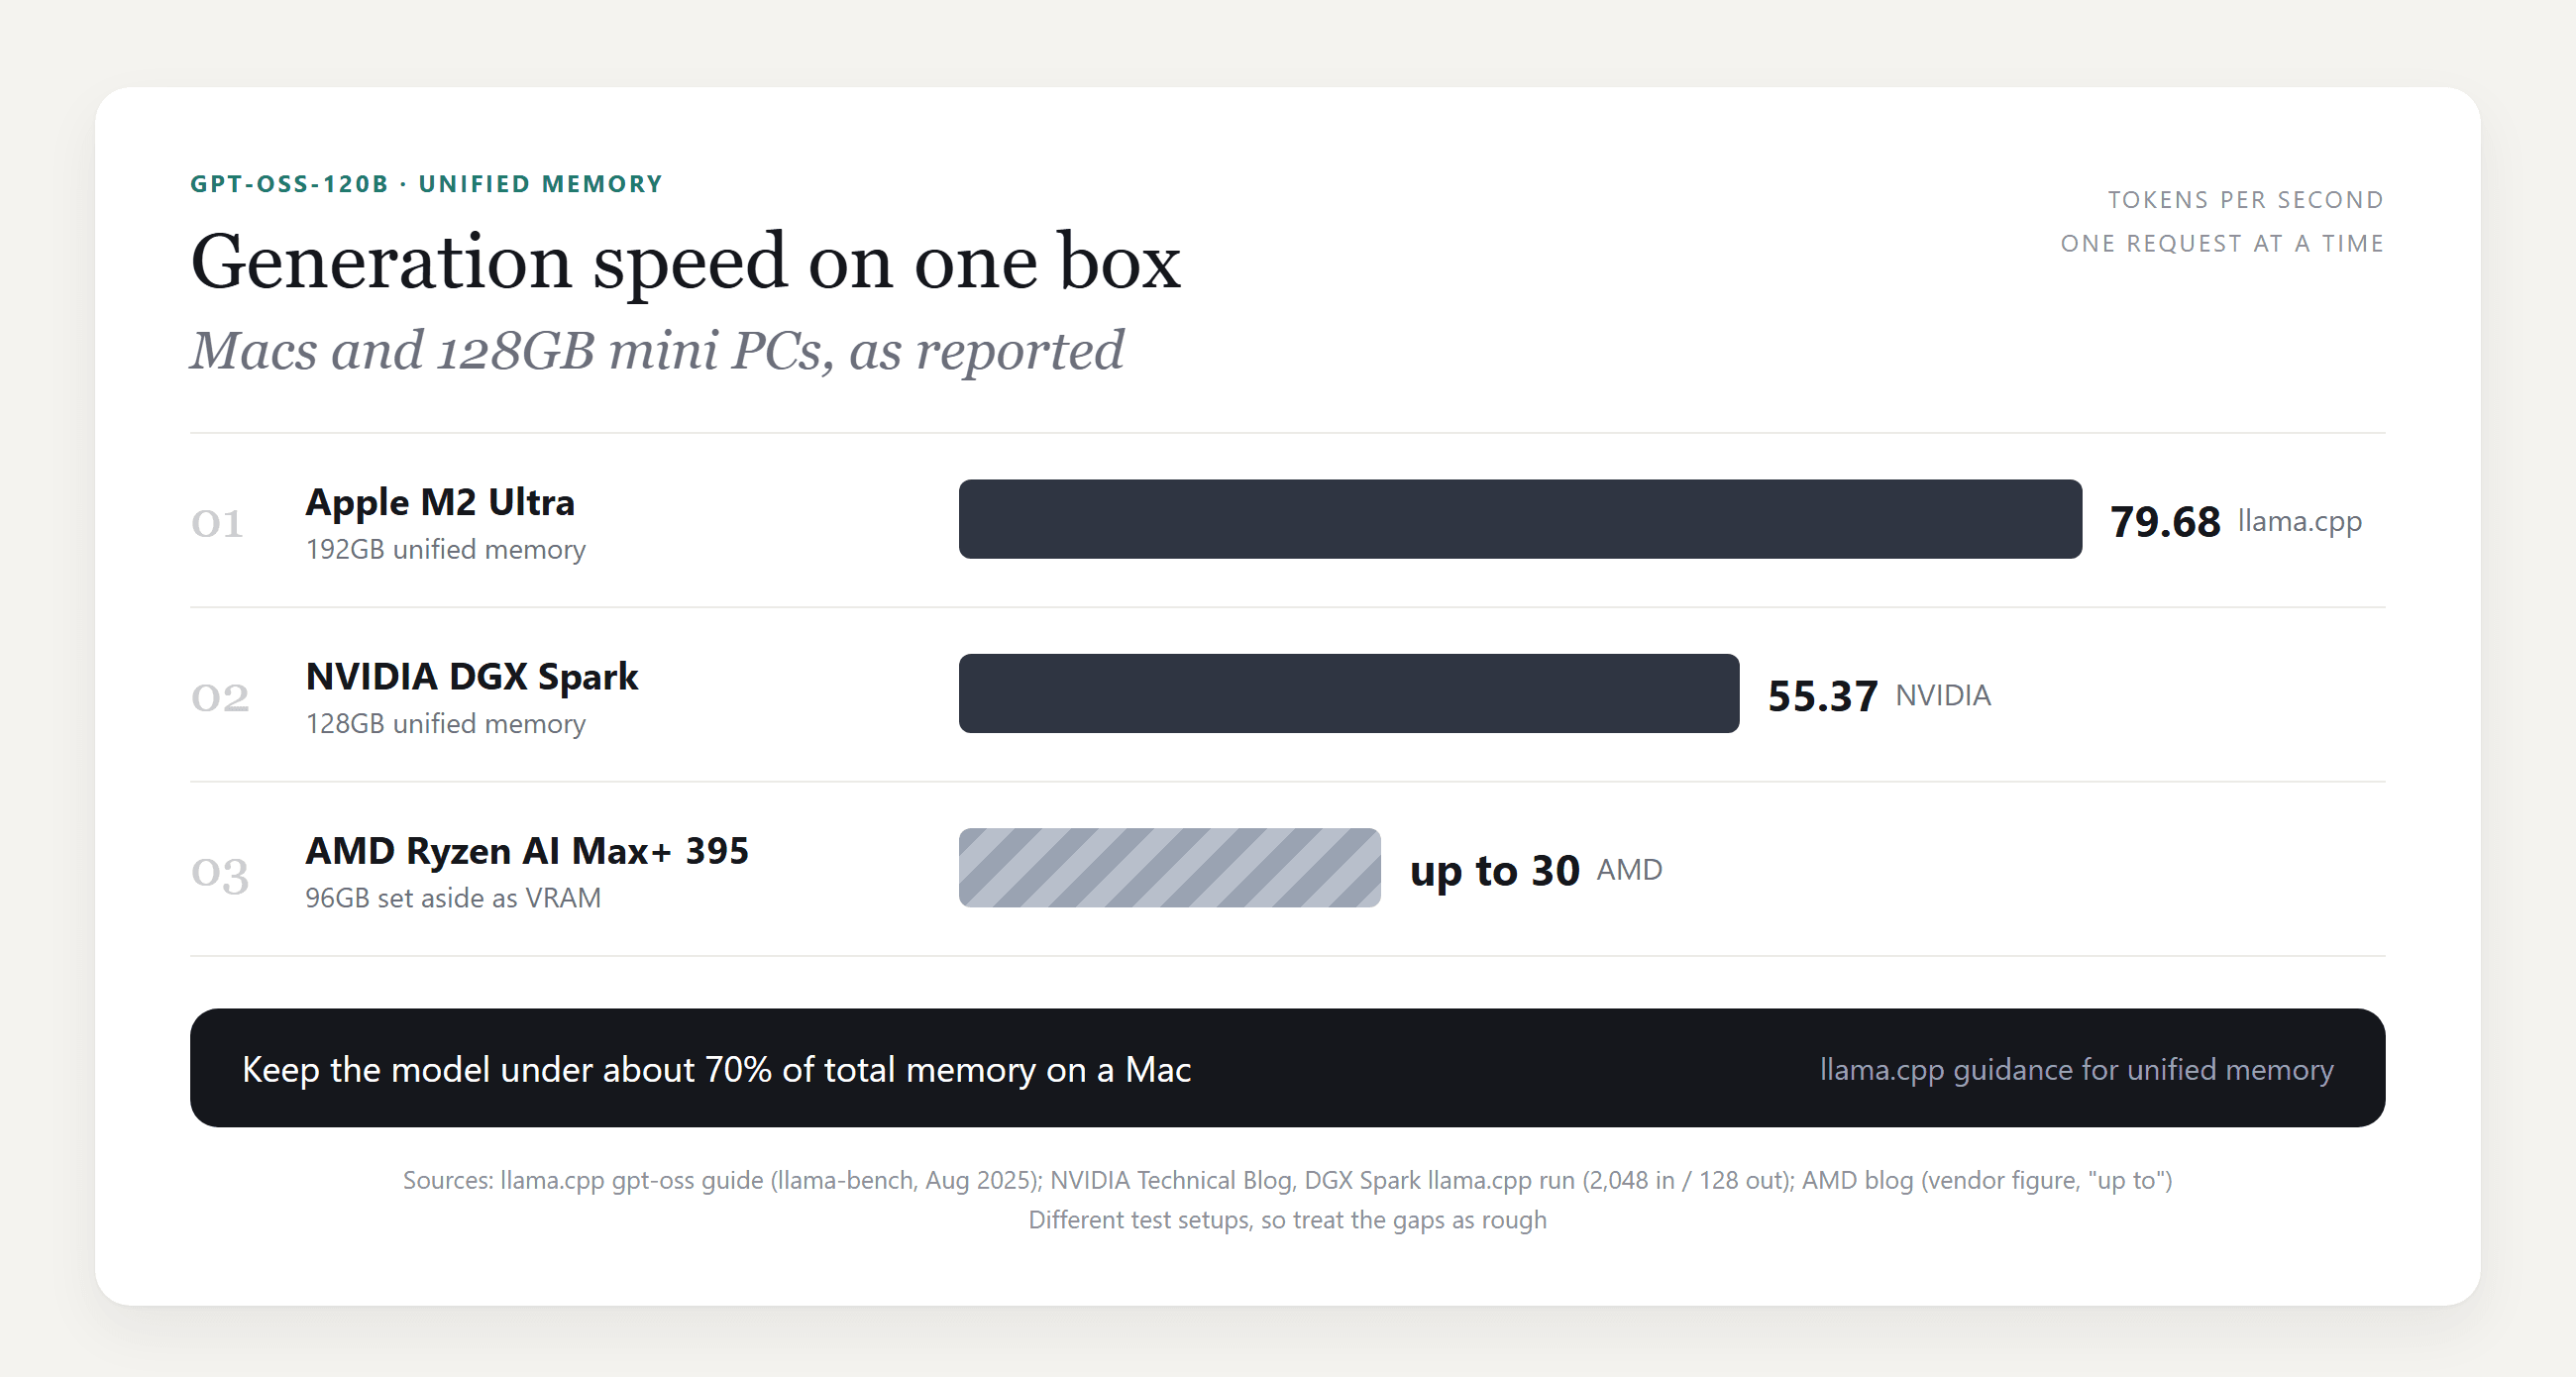
Unified Memory hebt die Trennung zwischen GPU und RAM auf. Der llama.cpp-Leitfaden sagt, dass Macs mit mehr als 96 GB RAM, etwa M2-Ultra- oder M3-Max-Maschinen, das Modell mit vollem Kontext ausführen können, und rät, unter etwa 70 % des Gesamtspeichers zu bleiben.
macOS begrenzt standardmäßig, wie viel Speicher die GPU binden kann. Auf einer 192-GB-Maschine hebt der Leitfaden diese Obergrenze mit einem Befehl von 154 GB auf 180 GB an:
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
Die neuen 128-GB-Mini-PCs fallen in dieselbe Klasse. NVIDIA meldet 55,37 Token/s für gpt-oss-120b auf einem DGX Spark mit llama.cpp. AMD sagt, dass eine Ryzen AI Max+ 395-Maschine mit 96 GB, die als VRAM reserviert sind, „bis zu 30 Token pro Sekunde" erreicht, was eine eigene Angabe des Unternehmens ist.
Nicht genug Speicher? Nutzen Sie ein gehostetes Open-Weight-Modell über eine API
Wenn keines dieser Geräte auf Ihrem Schreibtisch steht, umgeht ein gehostetes Open-Weight-Modell die Hardwarefrage vollständig.
Atlas Cloud bietet Qwen3.5 122B A10B an, Teil seiner Qwen-Modellreihe. Auf dem Papier ist es ein enger Treffer für gpt-oss-120b: ein Apache-2.0-Mixture-of-Experts-Modell aus Alibabas Qwen-Team mit 122B Gesamt- und 10B aktiven Parametern. Es liest bis zu 262.144 Token Kontext.
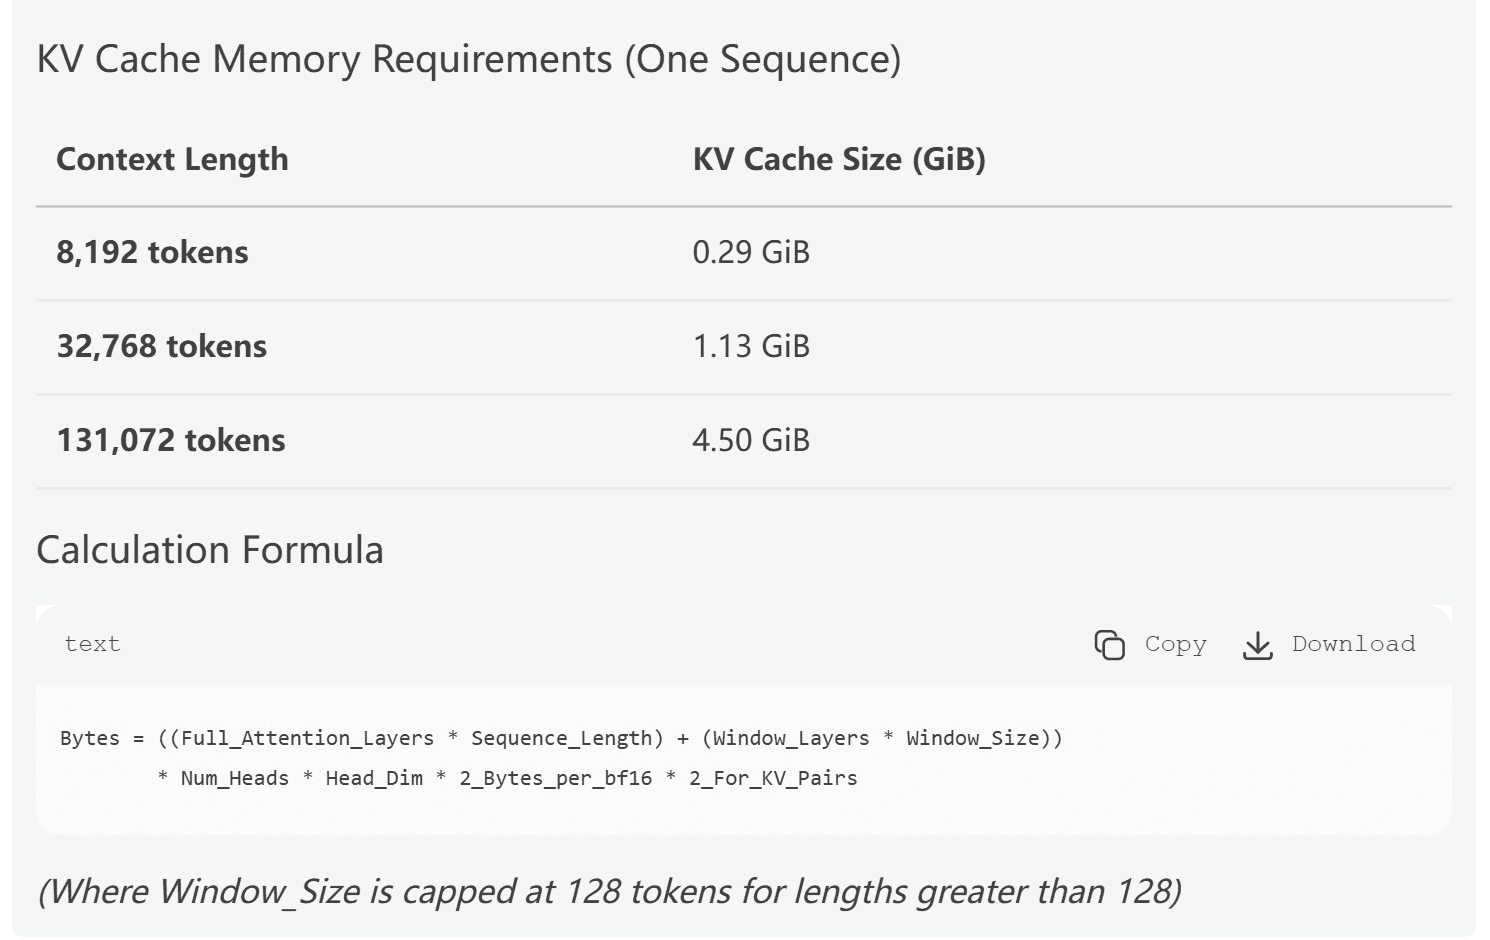
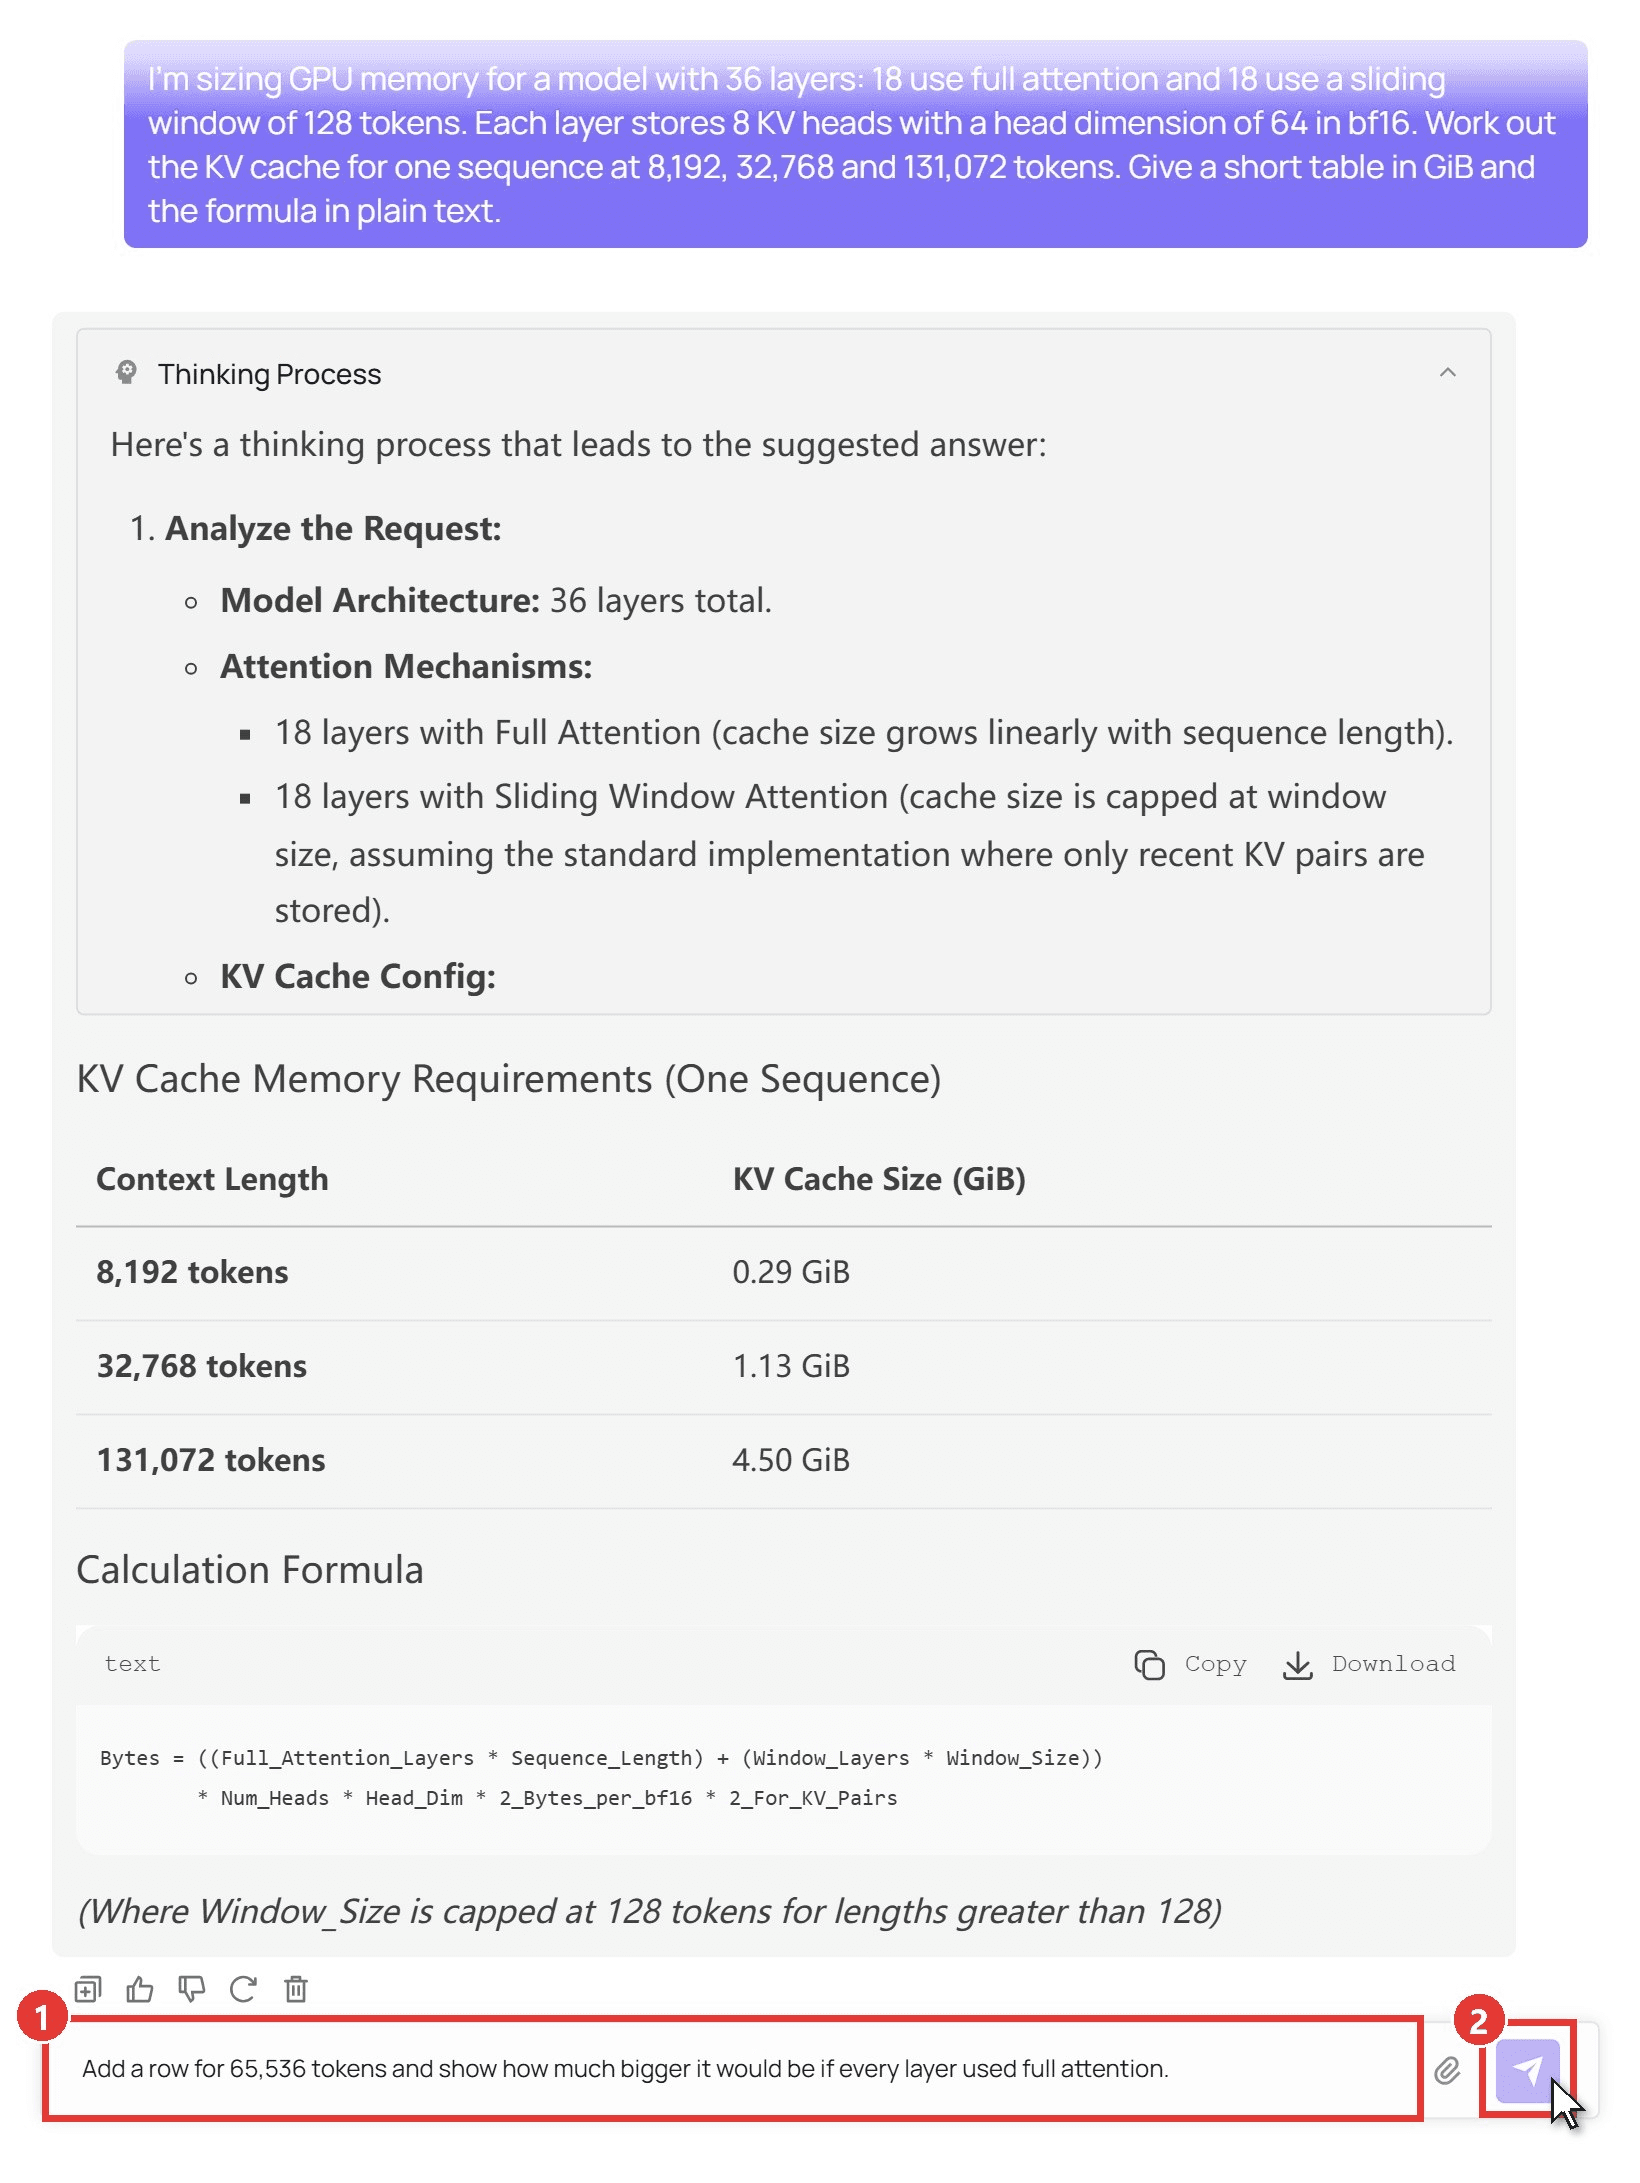
Wir haben ihm das Attention-Layout aus der gpt-oss-Konfiguration gegeben und nach dem KV-Cache bei drei Längen gefragt. Seine Tabelle stimmte bis auf zwei Dezimalstellen mit unserer eigenen Berechnung überein. Wenn Sie später ein Qwen für Ihre eigene Maschine möchten, dimensioniert unser Leitfaden zum besten Qwen-Modell für lokales Coding sie nach RAM.
Methode 1: Qwen3.5 122B A10B im Playground testen
Melden Sie sich an und öffnen Sie den Qwen3.5 122B A10B Playground, dann:
- Geben Sie Ihre Frage im Nachrichtenfeld ein.
- Klicken Sie auf den Senden-Pfeil. Das Reasoning erscheint in einem Thinking-Process-Panel über der Antwort.
Methode 2: Qwen3.5 122B A10B mit der Atlas Cloud API aufrufen
Für Skripte und Apps:
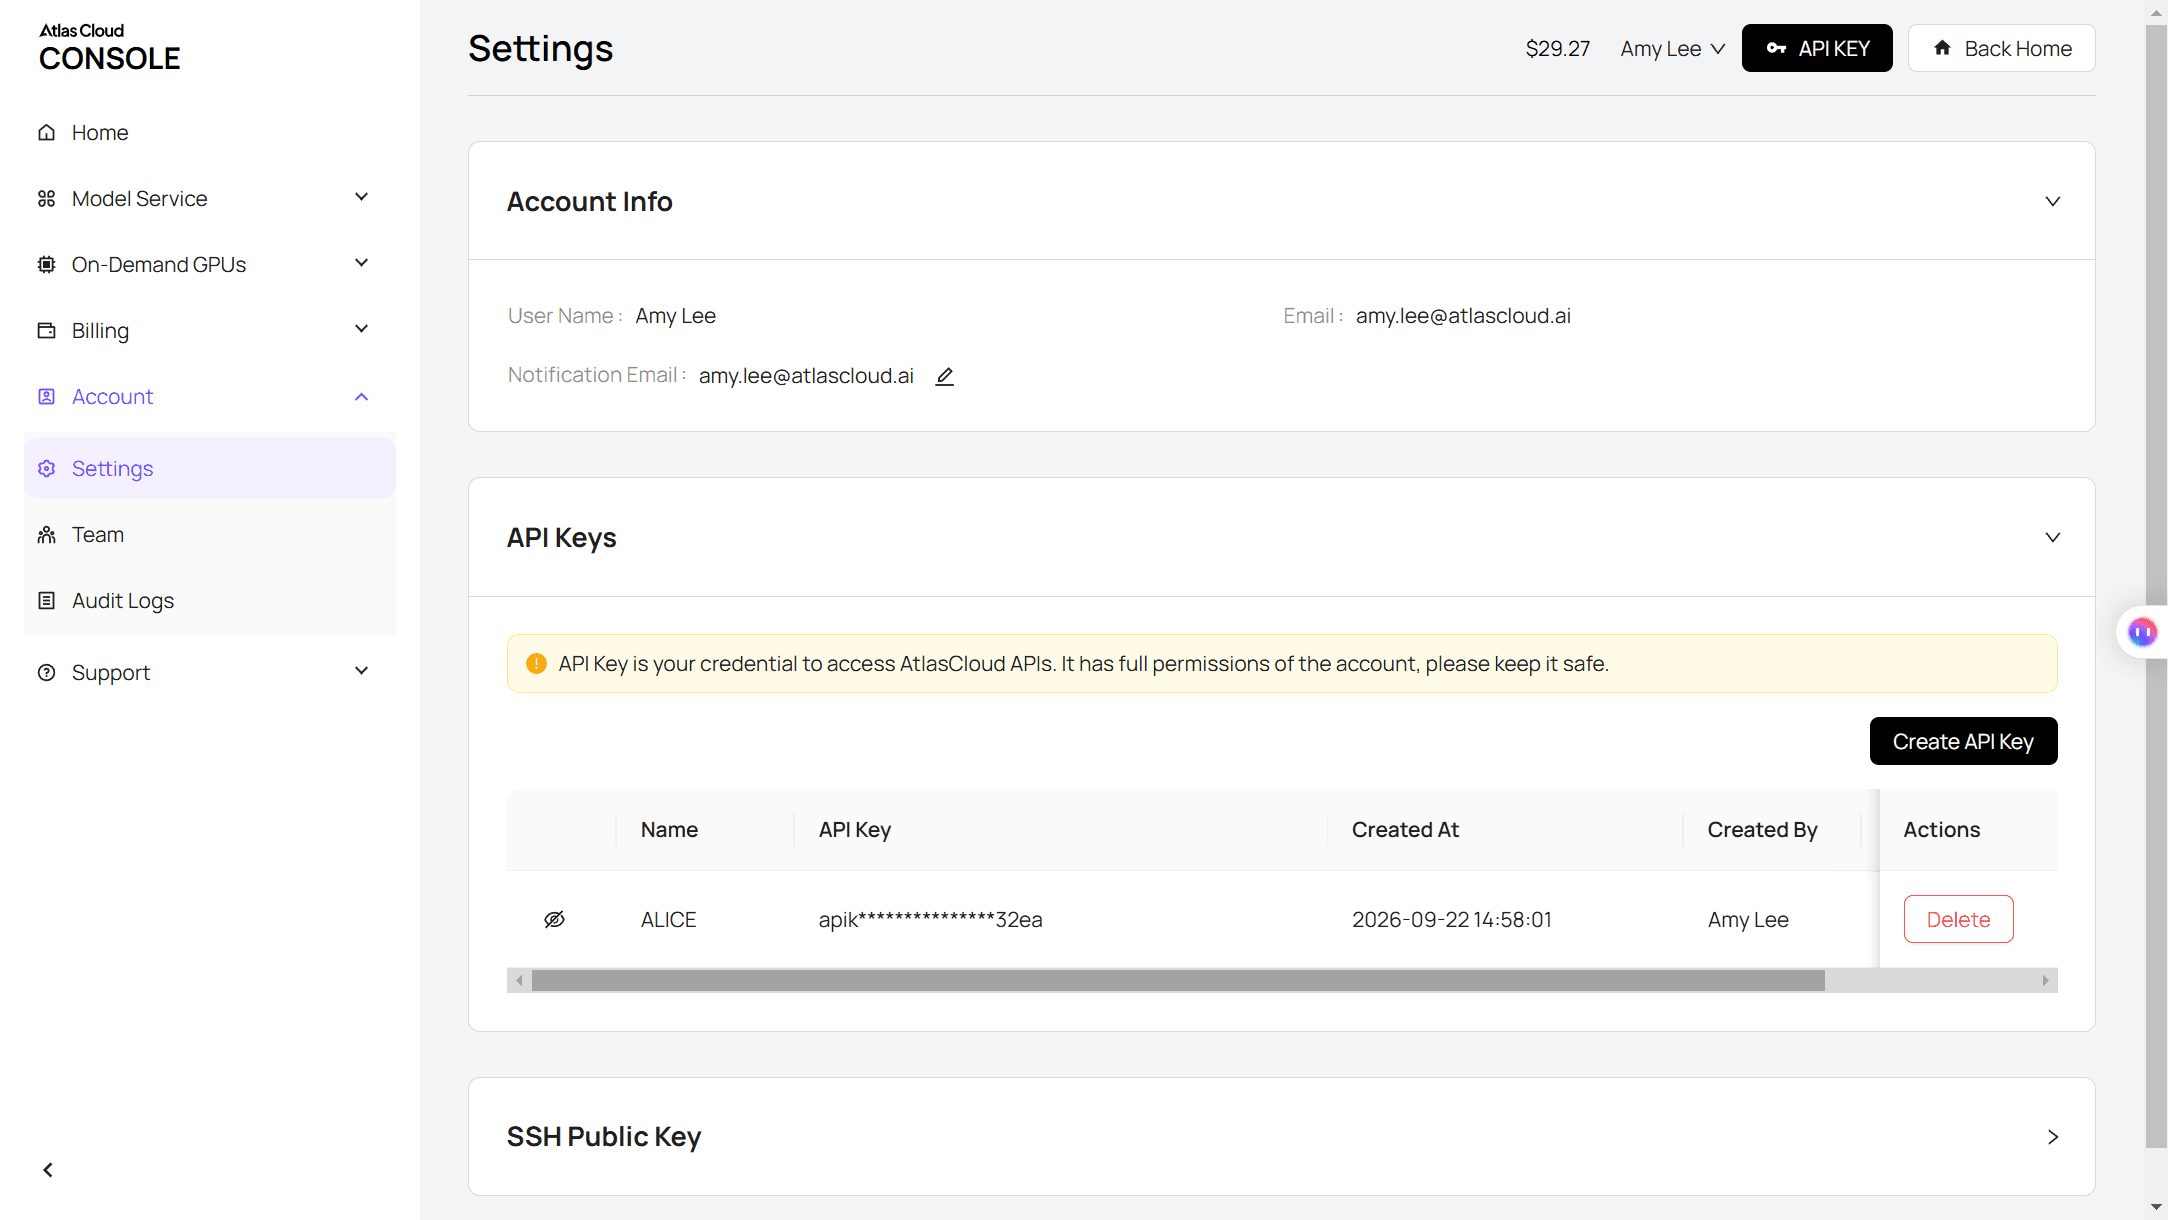
Schritt 1: API-Schlüssel erstellen. Öffnen Sie in der Konsole die Einstellungen, gehen Sie zu API Keys und klicken Sie auf Create API Key. Bewahren Sie ihn serverseitig auf.
Schritt 2: Anfrageformat prüfen. Die API-Dokumentation behandelt das Chat-Completions-Format, und die Modellseite hat einen API-Tab mit einem fertigen Beispiel.
Schritt 3: Erste Anfrage senden.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
Die Antwort kommt in choices[0].message.content zurück. Da der Endpoint dem OpenAI-Format folgt, braucht Code, der für einen lokalen gpt-oss-Server geschrieben wurde, normalerweise nur eine neue Basis-URL, einen neuen Schlüssel und einen neuen Modell-String. Derselbe Schlüssel funktioniert auch für die anderen Chat-Modelle der Plattform, wie unser Beitrag zu einem einheitlichen LLM-API-Gateway erläutert.
GPT-OSS-120B vs. GPT-OSS-20B: Speicher- und Benchmark-Abwägung
Das kleinere Geschwistermodell braucht ein Fünftel des Speichers. gpt-oss-20b hat 20,9B Parameter mit 3,6B aktiven, und OpenAI sagt, es läuft mit „nur 16 GB Speicher". Die Frage ist, was Sie dafür aufgeben.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Speicher bei 8K-Kontext (llama.cpp) | 64.0 GB | 14.9 GB | | MMLU | 90.0 | 85.3 | | GPQA Diamond (ohne Tools) | 80.1 | 71.5 | | SWE-Bench Verified | 62.4 | 60.7 | | Codeforces Elo (ohne Tools) | 2463 | 2230 | |
HealthBench
plaintext1 | 57.6 | 42.5 |
Die Werte stammen aus der Modellkarte bei hohem Reasoning-Aufwand. Der Coding-Unterschied liegt bei unter zwei Punkten auf SWE-Bench Verified, während der Wissensunterschied etwa 9 Punkte bei wissenschaftlichen Aufgaben auf Graduiertenniveau und 15 Punkte bei HealthBench beträgt. Für überwiegend Code auf einer 16-GB- bis 24-GB-Karte ist 20b die vernünftige Wahl. Brauchen Sie das zusätzliche Wissen? Dann rechtfertigt 120b seine Speicherrechnung.
GGUF, Ollama oder vLLM: Eine Laufzeitumgebung für Ihr Speicherbudget wählen
Jede führt die von OpenAI veröffentlichten MXFP4-Gewichte aus; sie unterscheiden sich darin, wo diese Gewichte liegen können.
| Laufzeitumgebung | Download | Am besten geeignet |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 GB | Ein Benutzer auf einem Rechner, der das ganze Modell aufnimmt |
| LM Studio | 65 GB | Eine Desktop-App auf einem Mac oder Windows-PC |
| llama.cpp (ggml-org GGUF) | Etwa 63 GB | Weniger als 65 GB VRAM, mit Experten-Schichten in den RAM ausgelagert |
| vLLM | Etwa 65 GB an Safetensors | Viele Benutzer von einer oder mehreren Rechenzentrums-GPUs bedienen |
Für einen schnellen Start auf einem Rechner mit viel Speicher:
plaintext1ollama run gpt-oss:120b
Für eine kleinere GPU verwenden Sie llama.cpp und stimmen die Offload-Anzahl ab:
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Alle vier verarbeiten OpenAIs Harmony-Chat-Format, das das Modell benötigt, um ordnungsgemäß zu funktionieren. Es ist nur relevant, wenn Sie Ihren eigenen Serving-Code schreiben.
FAQ
Ist GPT-OSS-120B besser als GPT-5 oder Gemini 3 Pro?
Sie gehören unterschiedlichen Kategorien an: GPT-5 und Gemini sind geschlossene Modelle, die Sie über eine App oder API erreichen, während gpt-oss-120b auf Ihrer eigenen Hardware läuft. Gemini 3 Pro Preview wurde außerdem am 9. März 2026 abgeschaltet, und sein Name verweist jetzt auf Gemini 3.1 Pro Preview. Wenn lokale Kontrolle wichtig ist, ist Googles Open-Weight-Reihe die Gemma-4-Familie.
Warum sagen manche Seiten, GPT-OSS-120B brauche 255 GB?
Diese Angaben gehen von 16-Bit-Gewichten aus: grob 117B Parameter mal 2 Bytes plus Overhead. Der von OpenAI veröffentlichte Checkpoint ist bereits MXFP4, daher liegt der realistische Download im Bereich von 61 GB.
Verändert der Reasoning-Aufwand die Speichernutzung?
Nicht bei den Gewichten. Die Einstellungen niedrig, mittel und hoch ändern, wie lange das Modell denkt. Hoher Aufwand schreibt mehr Reasoning-Tokens, die das Kontextfenster füllen und den KV-Cache vergrößern, sodass lange Sitzungen sich den größeren Summen im obigen Diagramm nähern.
Warum sagen Leute, GPT-OSS-120B habe Probleme mit textbasierten Spielen?
Die Belege sind anekdotisch. Auf der Hugging-Face-Diskussionsseite des Modells berichten einige Nutzer von Ablehnungen beim Schreiben gewalttätiger Fiktion, während andere sagen, Rollenspiel funktioniere gut. Testen Sie für interaktive Fiktion Ihre eigenen Prompts, bevor Sie Hardware dafür kaufen.
Wie viel kostet ein gehostetes Modell der 120B-Klasse?
Stand Oktober 2026 kostet Qwen3.5 122B A10B auf Atlas Cloud $0.3 pro Million Input-Token und $2.4 pro Million Output-Token. Das ist ein Rabatt von 25 % auf die regulären Preise von $0.4 und $3.2. Unsere Dimensionierungsfrage verbrauchte nach Einberechnung des Reasonings etwa 5.000 Output-Token, ungefähr ein Cent zum rabattierten Preis.
Fazit
GPT-OSS-120B lässt sich leichter unterbringen, als seine Parameterzahl vermuten lässt. Planen Sie etwa 65 GB bei alltäglichen Kontextlängen und unter 70 GB bei den vollen 131K. Eine 80-GB-GPU, ein Mac mit mehr als 96 GB oder ein 128-GB-Mini-PC nehmen es auf, und kleinere Karten können es ausführen, indem sie Experten-Schichten in den System-RAM verschieben.
Wenn diese Zahlen Ihren Rechner ausschließen, wechseln Sie für überwiegend Coding-Arbeit zu gpt-oss-20b oder rufen Sie ein gehostetes Open-Weight-Modell auf, wenn Sie das größere Gehirn brauchen, ohne Hardware zu kaufen. So oder so sind die gpt-oss-120b-Speicheranforderungen kein Rätselraten mehr, sobald Sie wissen, dass die Gewichte 61 GB belegen und der Rest Reserve ist.


