Avez-vous déjà vu des vidéos sur TikTok ou Instagram où un « fantôme » apparaît dans un selfie — soit en s’approchant discrètement par-derrière, soit en bondissant soudainement vers l’avant ? Les gens utilisent cet effet fantôme pour faire des blagues à leurs amis. J’ai passé les deux derniers jours à chercher comment créer ces effets fantôme avec l’IA, et j’aimerais partager la méthode avec vous.
La vidéo ci-dessus présente des effets fantôme que j’ai créés avec ChatGPT et Veo 3.1. De gauche à droite, il s’agit de :
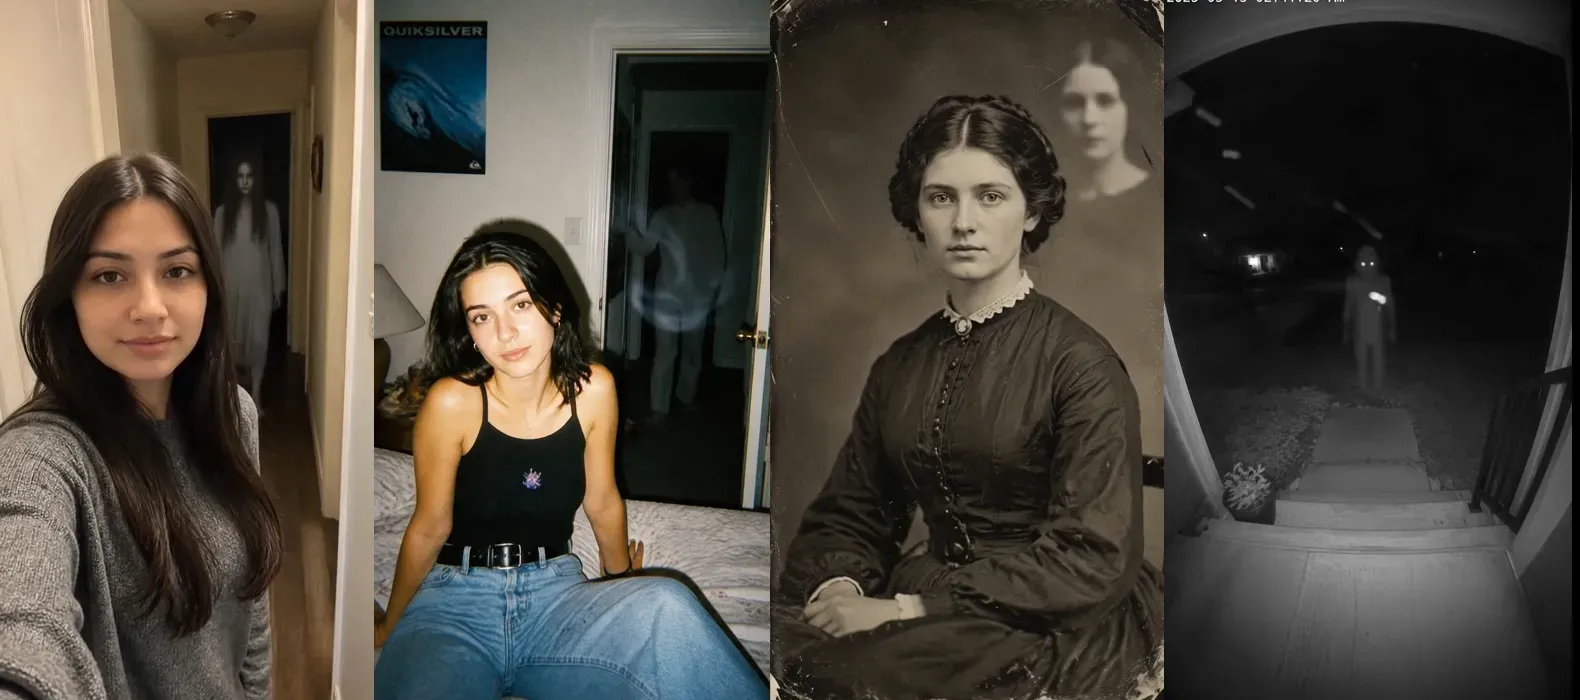
- Panneau 1 : Itération de prompt de couloir (test de transparence et de ressemblance)
- Panneau 2 : Style 1 – Rôdeur de chambre au flash jetable des années 90
- Panneau 3 : Style 2 – Double exposition spectrale victorienne
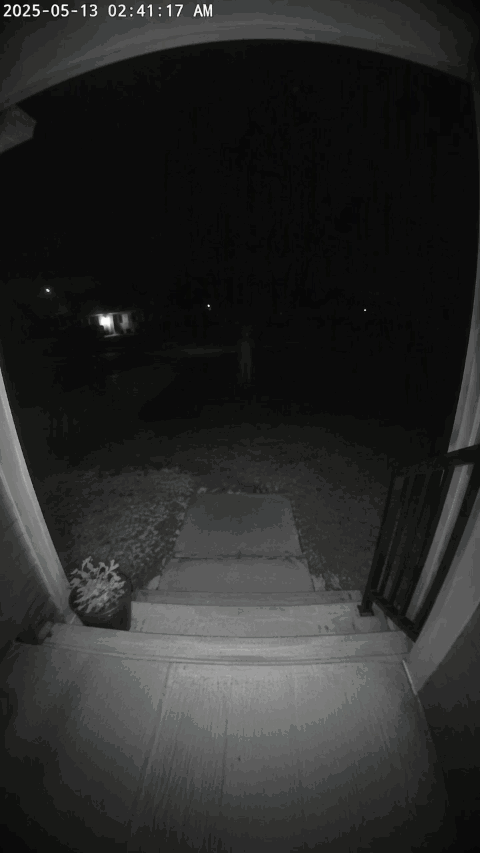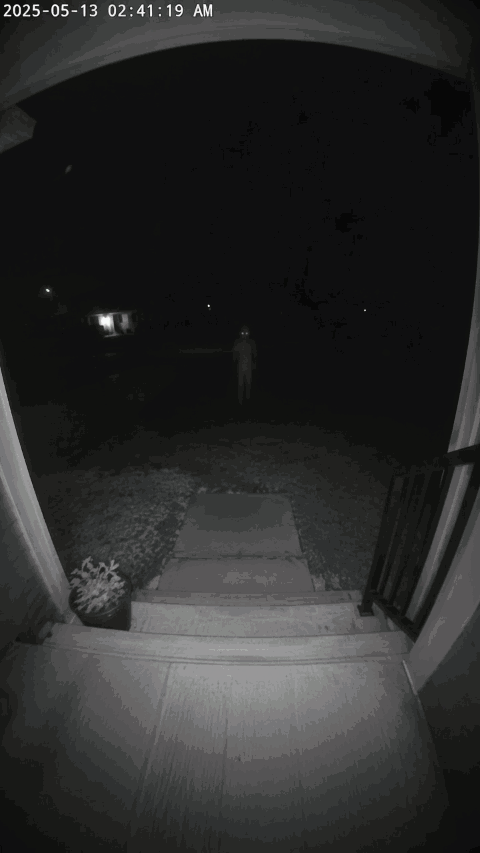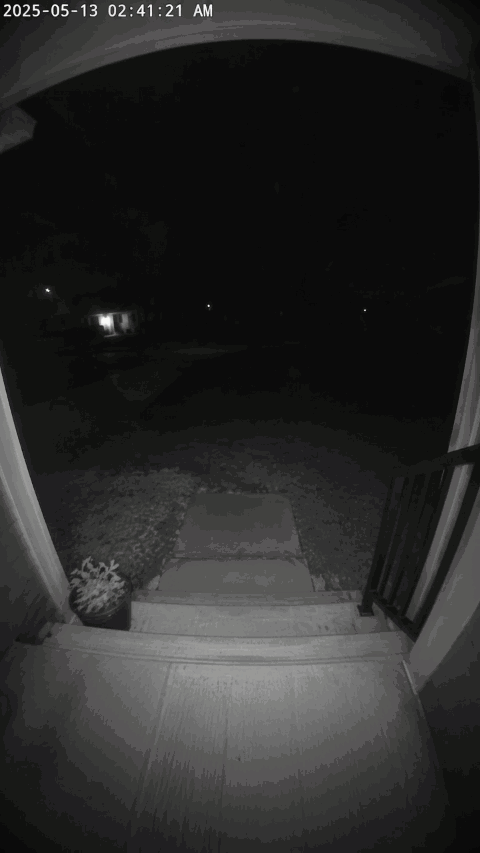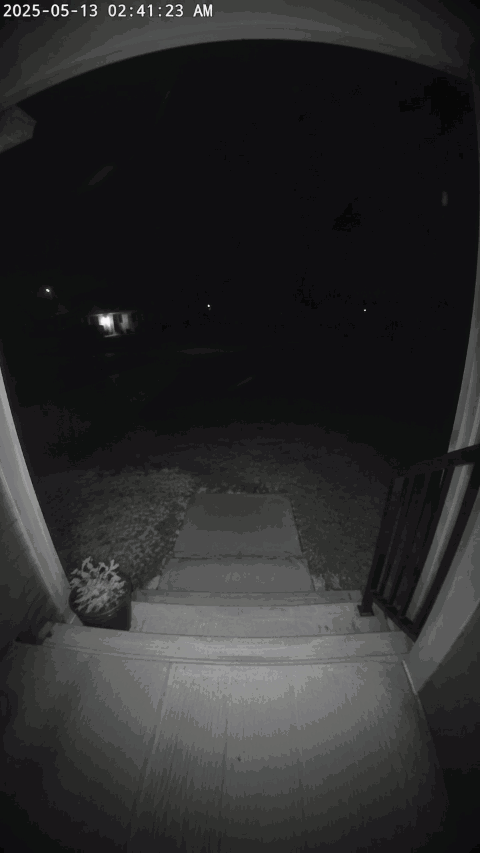
- Panneau 4 : Style 3 – Glitch de vision nocturne infrarouge de caméra de sonnette
Voyons maintenant comment je les ai créés.
Choisir la bonne photo source pour la génération de vidéos de fantômes par IA
La plupart des transformations de fantôme ratées se produisent avant même que vous ne saisissiez un prompt. Lorsque vous téléversez un selfie serré, centré sur le visage, les modèles de diffusion déforment les traits du visage en monstres au lieu de placer une silhouette distincte derrière le sujet. Un flux de travail réussi de photo vers vidéo de fantôme exige un espace négatif propre.
Cadrez votre sujet de la poitrine jusqu’en haut, sous un éclairage plat et neutre. Laissez au moins 30 % de l’arrière-plan libre. Les embrasures de porte vides, les couloirs sombres et les coins déserts donnent aux estimateurs de profondeur des plans distincts pour rendre l’apparition. Évitez les papiers peints floraux chargés, les photos de fête bondées et les vignettes basse résolution. Une forte compression nuit à la détection des contours et étale des artefacts visuels sur le sujet au premier plan.
Liste de contrôle de la photo avant génération
Faites passer votre photo source par ce référentiel technique avant de commencer à générer des images :
- Espace d’arrière-plan : Laissez suffisamment d’arrière-plan visible à côté ou derrière le sujet pour accueillir le fantôme. Une porte ou un coin vide peut aider à établir la profondeur.
- Résolution de l’image : Commencez avec la résolution recommandée par l’outil choisi. Utilisez une photo source nette et bien éclairée, et évitez les images fortement compressées.
- Expression du visage : Une expression détendue peut faciliter la préservation des détails du visage, mais les résultats dépendent du modèle et de l’image source.
- Placement du sujet : Gardez la personne bien séparée de l’arrière-plan lorsque c’est possible, en particulier autour des cheveux, des épaules et des mains.
Flux de travail étape par étape pour animer un fantôme à partir de n’importe quelle photo
Envoyer directement une photo ordinaire dans un générateur vidéo ruine le résultat. La plupart des modèles photo-vers-vidéo tentent d’inventer un fantôme tout en prédisant simultanément les mouvements de caméra. Cela déchire le visage du sujet comme du caoutchouc liquide. Vous éliminez la distorsion du visage en divisant le pipeline vidéo du filtre fantôme en deux étapes contrôlées.
Étape 1 : Générer une photo originale
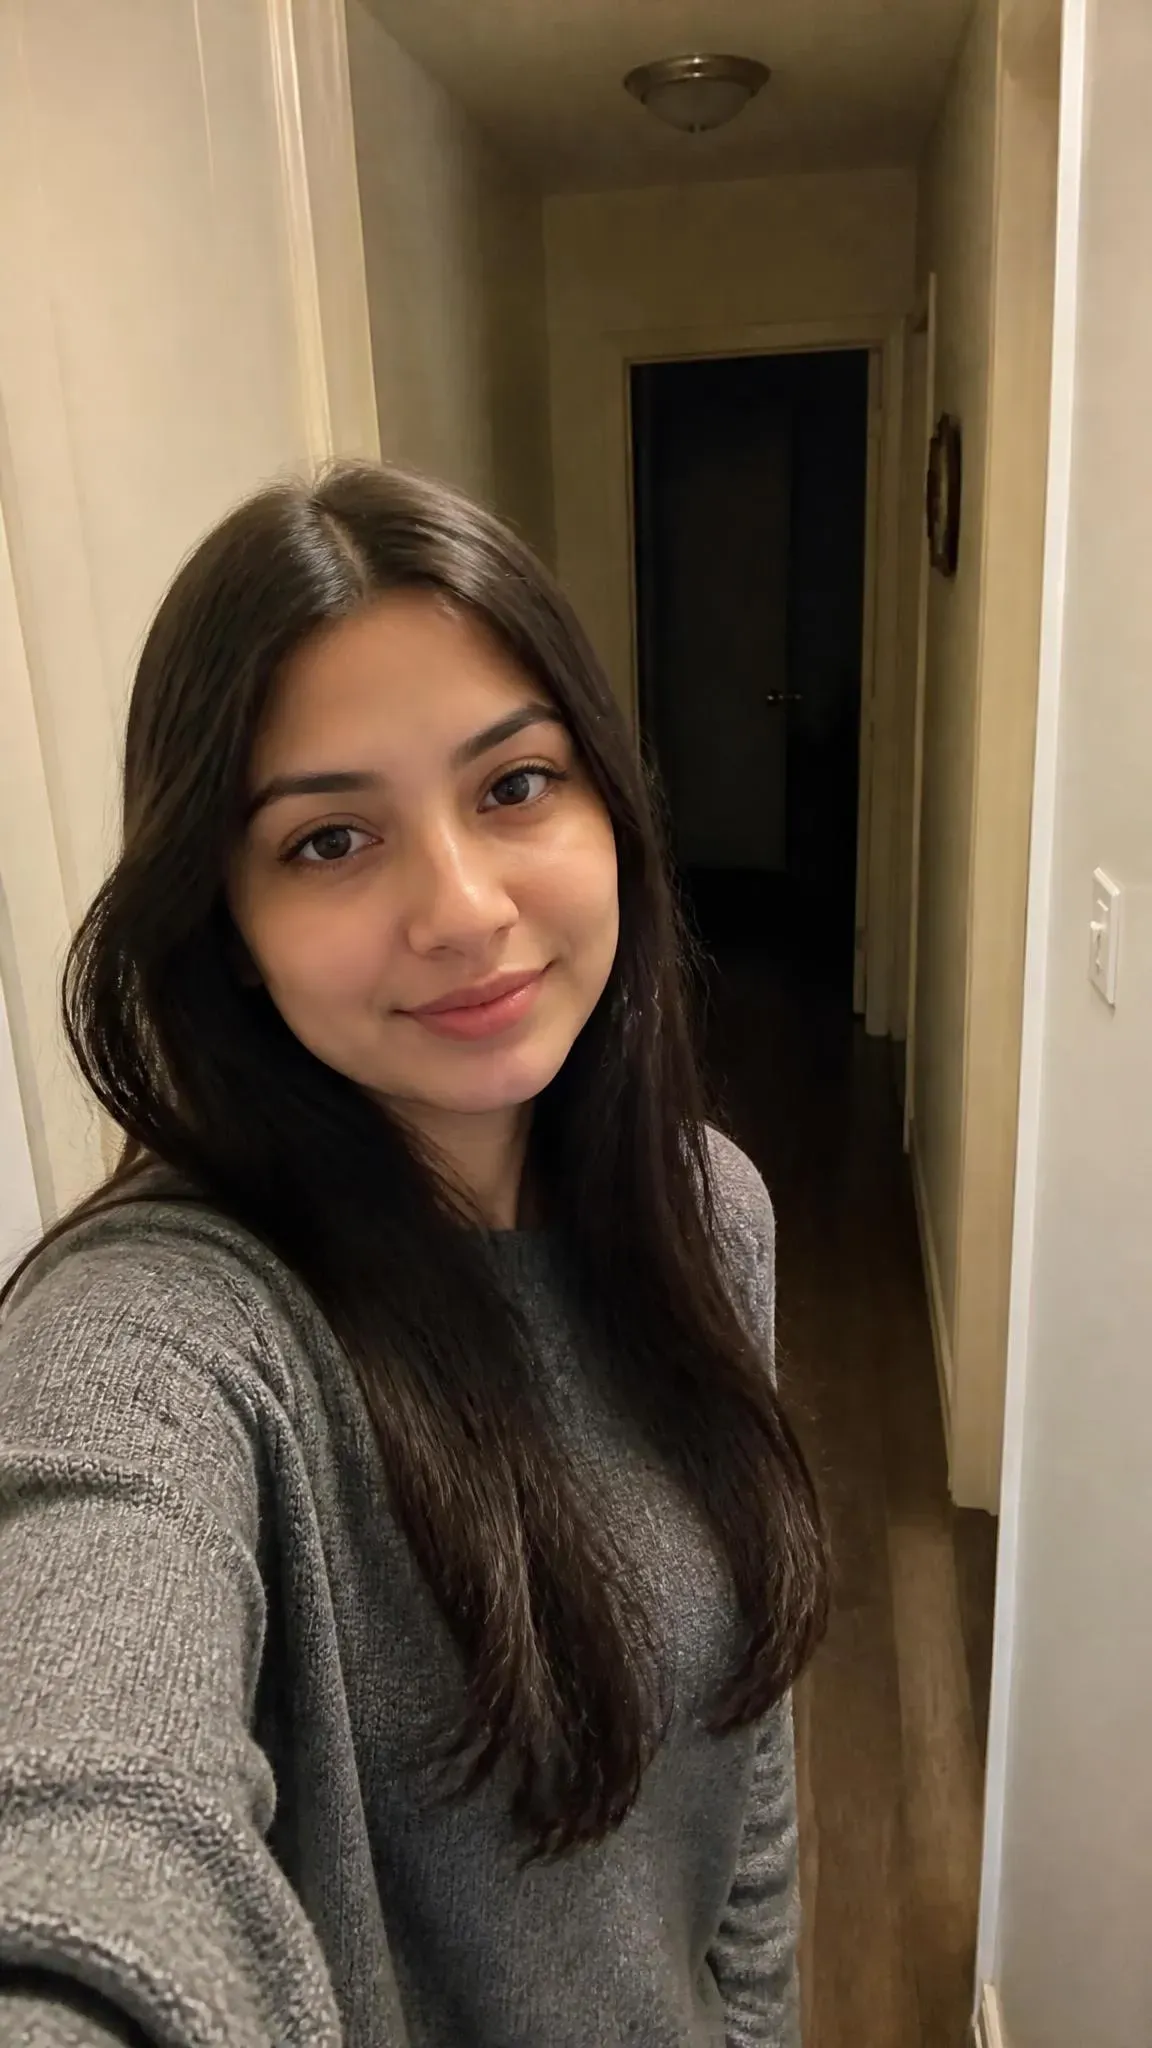
Commencez par générer une image standard, sans fantôme, qui servira de point de départ à votre flux de travail. Si vous avez déjà une image adaptée, vous pouvez passer cette étape.
Pour ce test, j’utilise à nouveau ChatGPT Image 2.0, car il est économique — une seule image de faible qualité ne coûte que $0.00971.
Étape 2 : Configurer la diffusion de mouvement
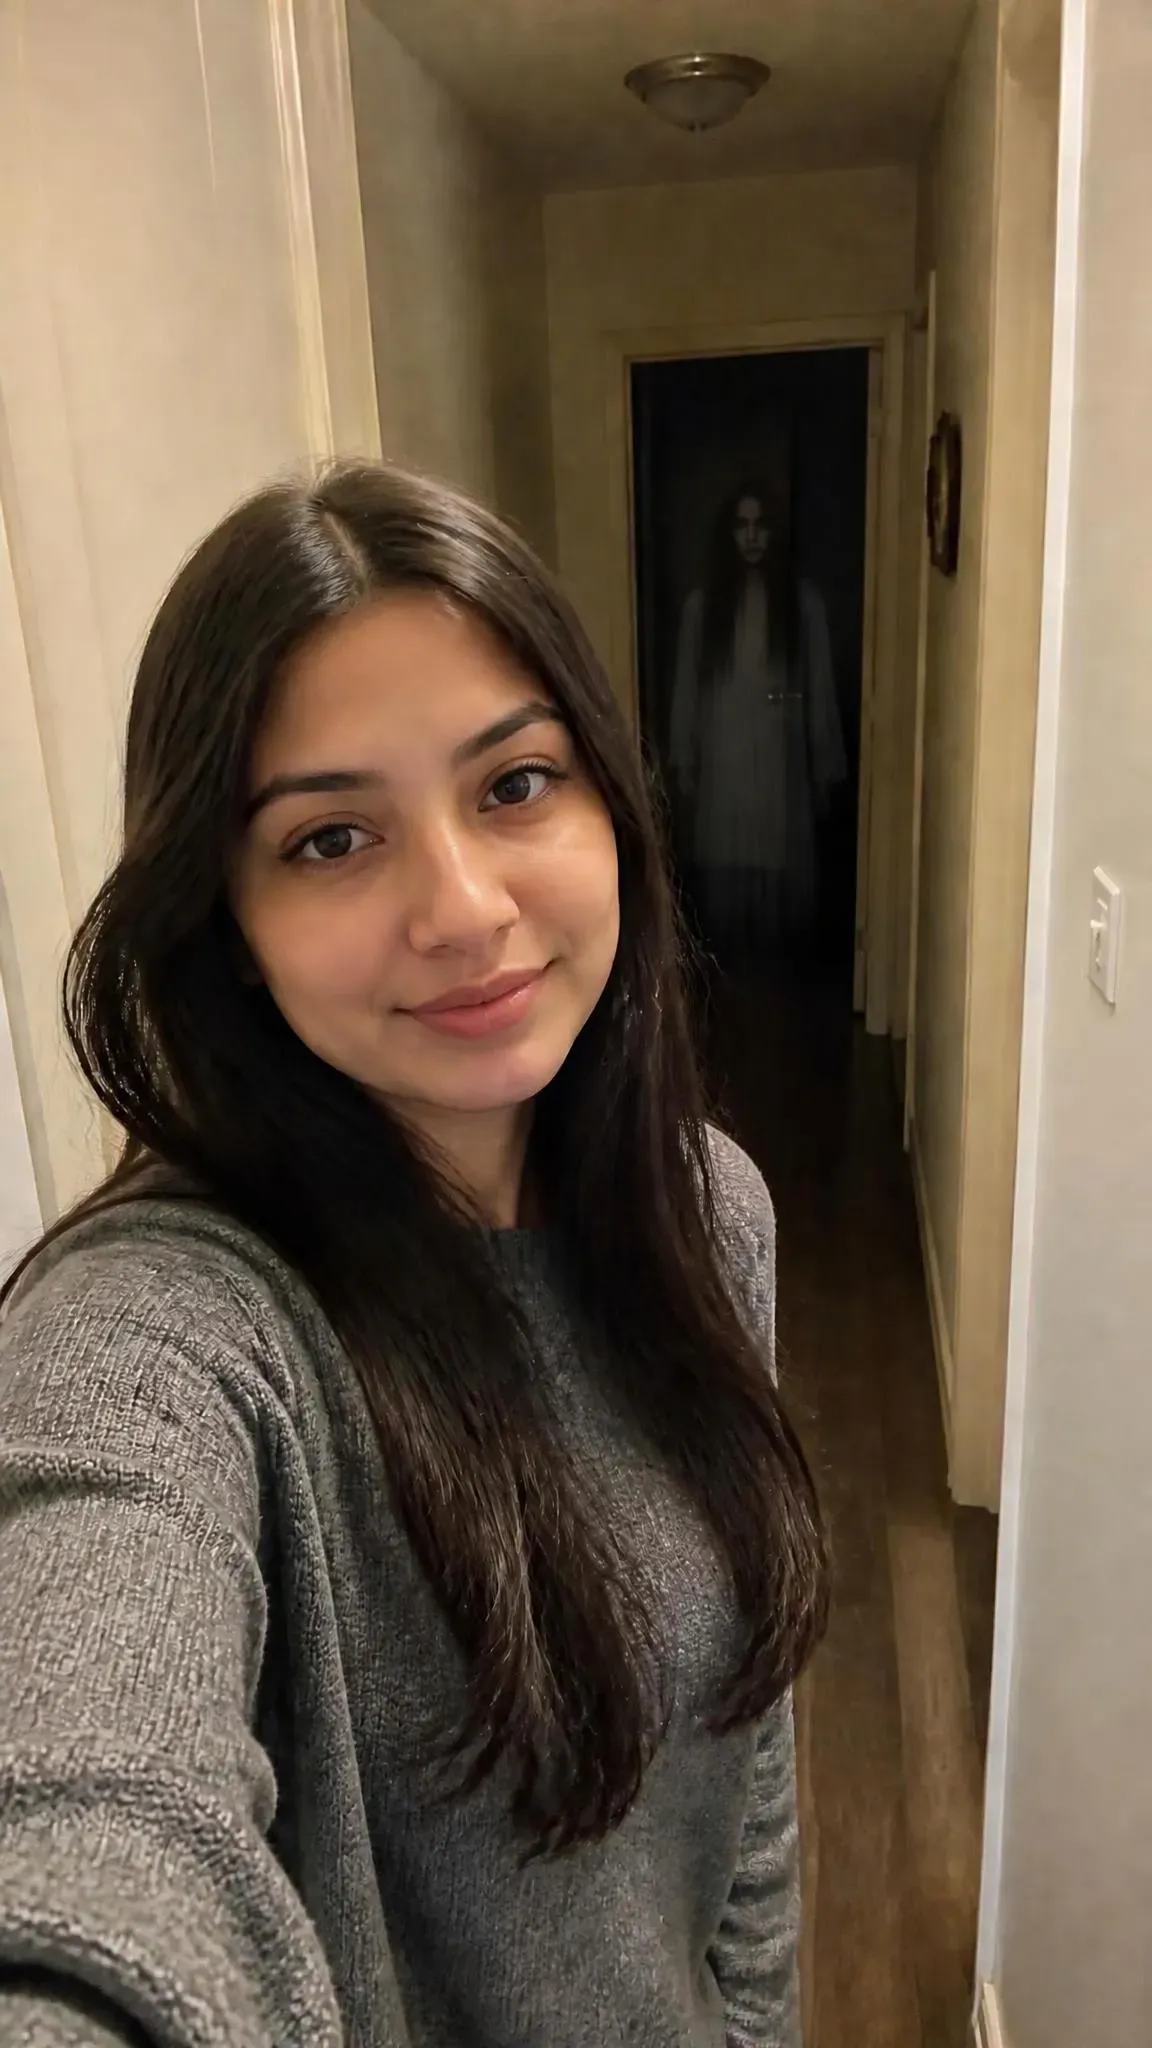
Ensuite, je vais téléverser l’image générée de nouveau dans ChatGPT et utiliser ses capacités d’édition d’image pour créer une photo incluant un fantôme.
Étape 3 : Animer le fantôme avec l’outil IA
J’ai lancé 3 itérations de prompt dans Veo 3.1 pour générer cette séquence d’horreur, et le test 3 est celui qui me satisfait le plus.
Voici les résultats :
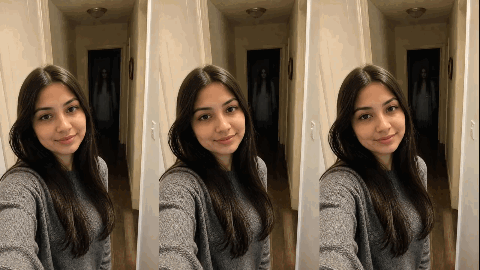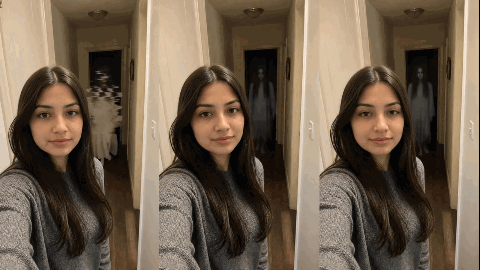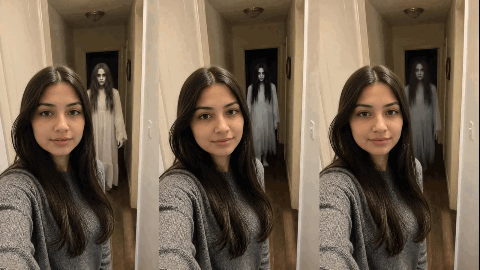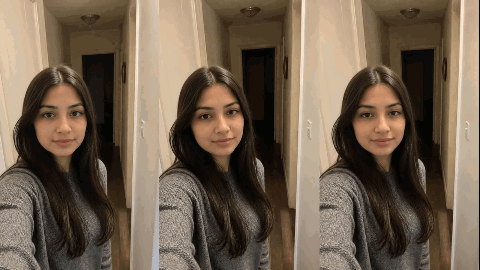
Dans la vidéo, de gauche à droite : test1, test2 et test3.
D’après ce test, j’ai résumé les principaux enseignements suivants sur les prompts pour créer des vidéos de « fantôme » par IA :
1. La transparence du fantôme doit primer sur le biais d’acteur solide
- Utilisez des termes optiques : des mots descriptifs comme « fantôme » ou « esprit » produisent des acteurs opaques en vêtements blancs. Remplacez-les par des descripteurs optiques physiques : légère brume translucide, double exposition optique ou opacité de 5 % à 10 %. Forcez le moteur de diffusion à mélanger les pixels.
- Imposez la traversée de l’arrière-plan : dictez explicitement la visibilité de l’arrière-plan : « Les murs du couloir et le chambranle de la porte restent visibles à 90 % À TRAVERS la silhouette. » Verrouillez la géométrie de la scène directement derrière l’entité.
- Supprimez les détails du visage : bloquez la reconstruction faciale. Exigez AUCUN yeux distincts ni traits du visage nets. Empêchez le modèle de diffusion de reconstruire des contours faciaux à fort contraste à partir de l’image source.
- Prompts négatifs essentiels : éliminez la géométrie humaine solide et l’éclairage ancré : solid human, opaque body, real actress, solid white dress, clear face, floor shadow
2. Manifestation et dynamique des mouvements
- Glissez, ne marchez pas : les prompts de marche déclenchent la cinématique des jambes et la simulation des tissus. Ordonnez-lui de glisser vers l’avant en silence dans les airs.
- Phase et scintillement : les ombres ambiantes créent une fausse occlusion. Imposez des variations alpha directes : scintille par intermittence entre 0 % (invisible) et 10 % d’opacité. Pilotez une véritable dématérialisation optique sur les images temporelles.
- Ancrez les horodatages de disparition : les modèles de diffusion dérivent avec des commandes de dissolution vagues. Verrouillez des coordonnées temporelles exactes : « À la 6e seconde, se dématérialise complètement dans les airs, laissant le couloir vide à 100 % pendant les 2 dernières secondes. » Imposez une continuité absolue de l’arrière-plan après le départ.
- Jump scares en coupe franche : supprimez les fondus progressifs. Exigez une insertion sur une seule image : « Se manifeste instantanément en une seule image à la seconde X, sans transition. » Supprimez l’interpolation entre images et les montées de flou de mouvement.
3. Distance spatiale et cadrage de caméra
- Limites de profondeur : Spécifiez des contraintes de distance fixes, comme
strictly remains 6 to 8 feet behind the subject, pour empêcher la silhouette de glisser au premier plan extrême. - Correction du bug du double téléphone : Définissez la perspective comme
front-facing smartphone camera POV, camera handheld off-screenet ajoutezphone in hands, visible handsaux prompts négatifs.
Formules de prompt modulaires pour différentes esthétiques de fantôme
En m’appuyant sur l’expérience mentionnée ci-dessus, j’ai expérimenté la création de vidéos sur le thème des fantômes dans divers styles. Il vous suffit de formules de prompt structurées pour isoler l’apparition tout en préservant la ressemblance du visage.
Utilisez cette formule modulaire en cinq parties avec les moteurs d’image et de vidéo multimodaux :
Prompt = [POV Rig] + [Subject Anchor] + [Entity Optics] + [Entity Timeline] + [Negatives]
| Emplacement | Objectif | Jetons de syntaxe |
| POV Rig | Verrouille la perspective hors écran ; empêche la génération d’un téléphone supplémentaire. | POV front-facing smartphone camera, camera off-screen, empty hands |
| Subject Anchor | Fige l’expression de base ; empêche le sourire dynamique et la déformation du visage. | neutral baseline expression, subtle blink only, no smile transitions |
| Entity Optics | Impose une transparence extrême ; supprime les traits nets du visage. | 5%-10% opacity, see-through double exposure, no sharp face/eyes |
| Entity Timeline | Contrôle le mouvement de glissement, la profondeur spatiale, le scintillement et la sortie minutée. | glides 6-8ft behind, flickers 0%-10%, dematerializes cleanly at 6s |
| Negatives | Bloque la physique humaine, les tissus opaques, les ombres et les accessoires. | solid human, opaque cloth, sharp face, floor shadow, phone in hands |
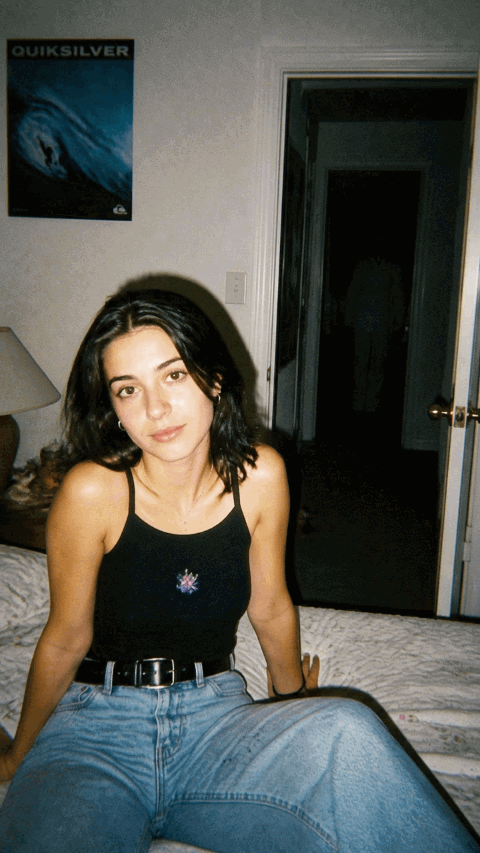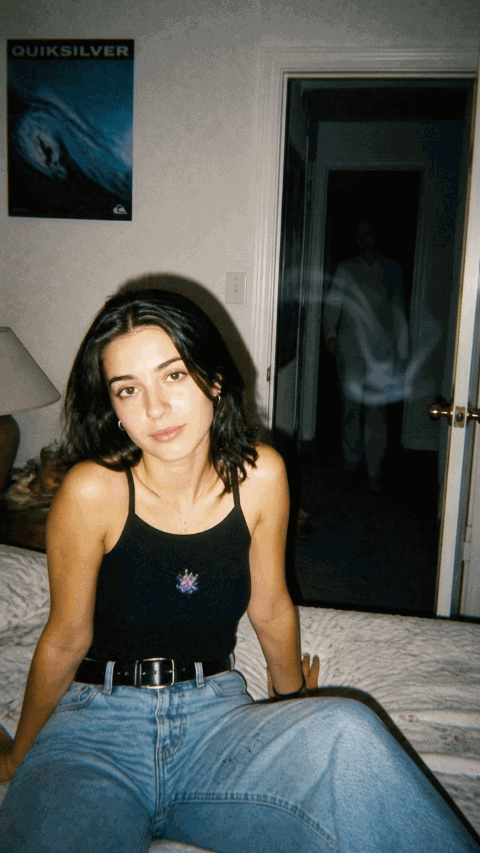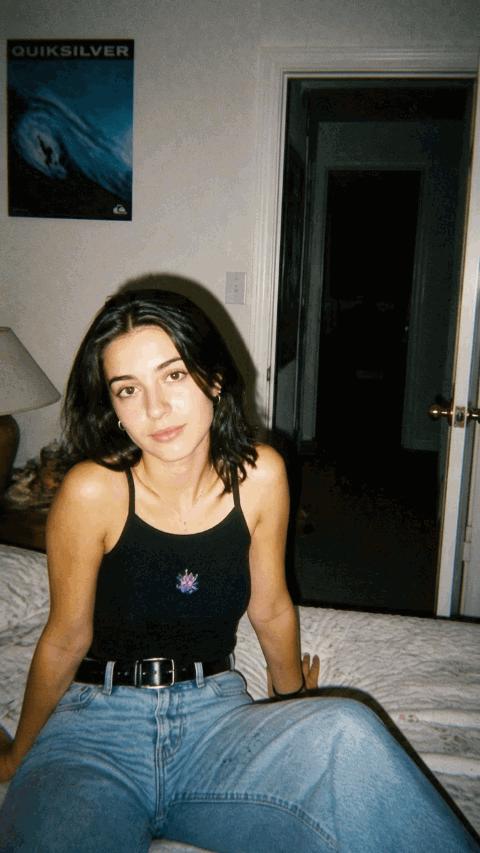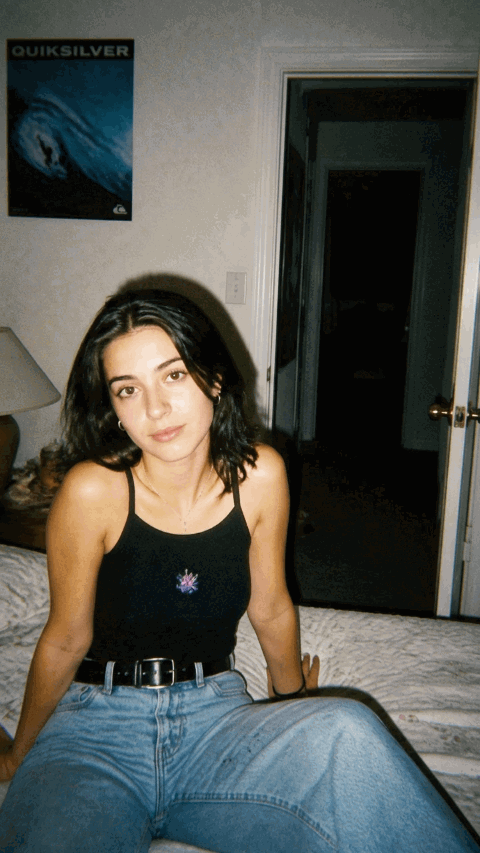
Style 1 : Le rôdeur de chambre au flash jetable des années 90
La photographie au flash avec un appareil point-and-shoot masque les bords génératifs grossiers. La lumière dure projette des ombres portées profondes sur les murs du fond. Cette atténuation des ombres donne à votre prompt de filtre fantôme un ancrage spatial propre.
Rendu cible
Éclairage direct au flash sur l’appareil, fort grain Kodak 35 mm, ombres portées dures sur les murs et mirage spectral ultra-faible, transparent, dérivant à travers les ombres de l’arrière-plan.
Formule de prompt à copier-coller
plaintext11996 point-and-shoot camera POV, direct disposable flash, harsh wall drop shadows, heavy 35mm grain. Camera handheld off-screen, no devices in frame. 2Foreground {SUBJECT_DESC}. Strictly locks baseline neutral expression, subtle blinks only; no smiling, no expression transitions. 3In {SPATIAL_ANCHOR}, a faint translucent {ENTITY_FORM} (strictly 5%-10% opacity, see-through double exposure). Background remains 90% visible through it. Soft-edged, no sharp facial features, no eyes, no cloned face. 4Entity {TRAJECTORY} without leg motion. Opacity flickers 0%-10%. At second {VANISH_TIME}, completely dissolves into dark air, leaving the area empty. 5Negative Prompt: solid human, opaque cloth, sharp eyes, cloned face, floor shadow, walking legs, phone in hands, smiling.
Style 2 : La double exposition spectrale victorienne
L’éclairage intérieur moderne entre souvent en conflit avec l’esthétique gothique. La formule de double exposition contourne ce problème en stylisant toute l’image comme une photographie tintype ancienne. Cela produit un portrait de fantôme éthéré, digne des beaux-arts.
Rendu cible
Rayures de daguerréotype monochrome, textures aux halogénures d’argent et esprit en faible double exposition se matérialisant à travers un flash d’exposition en arrière-plan.
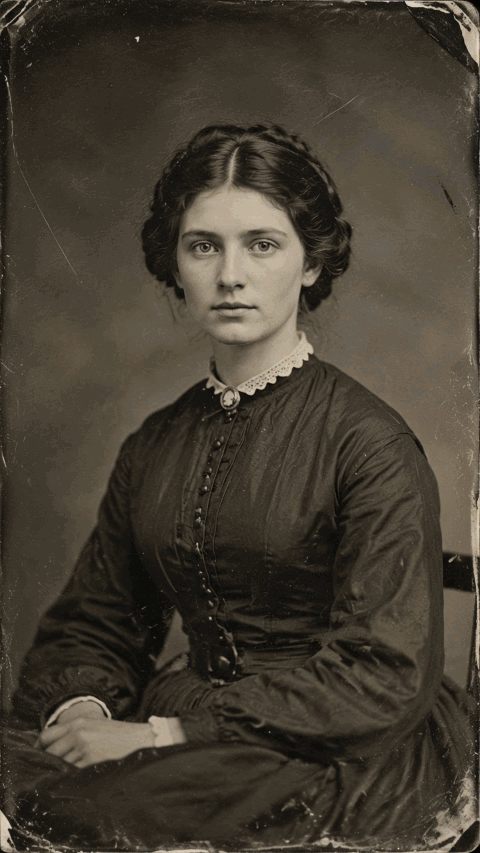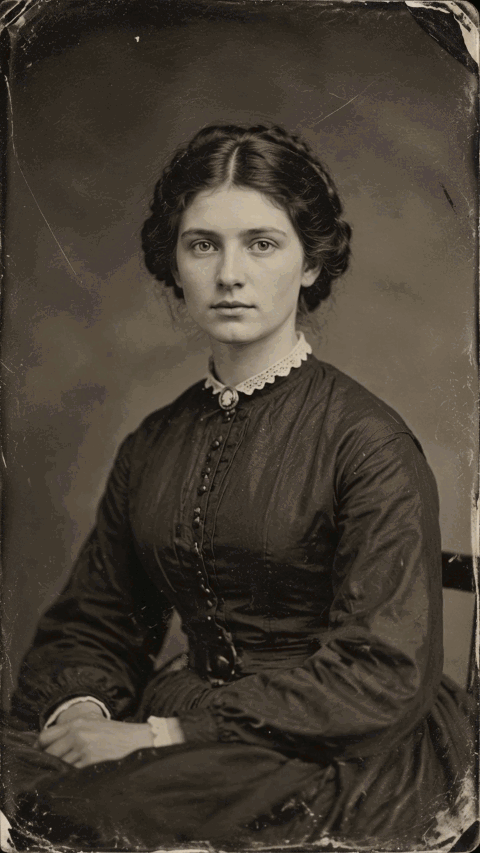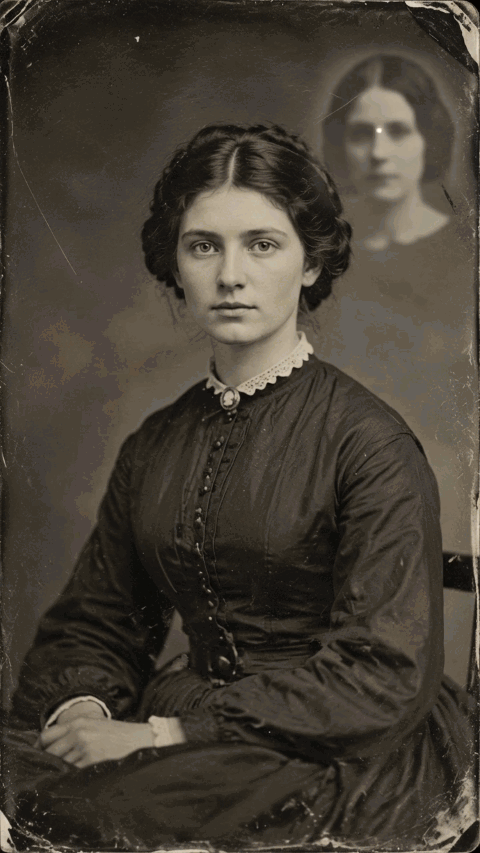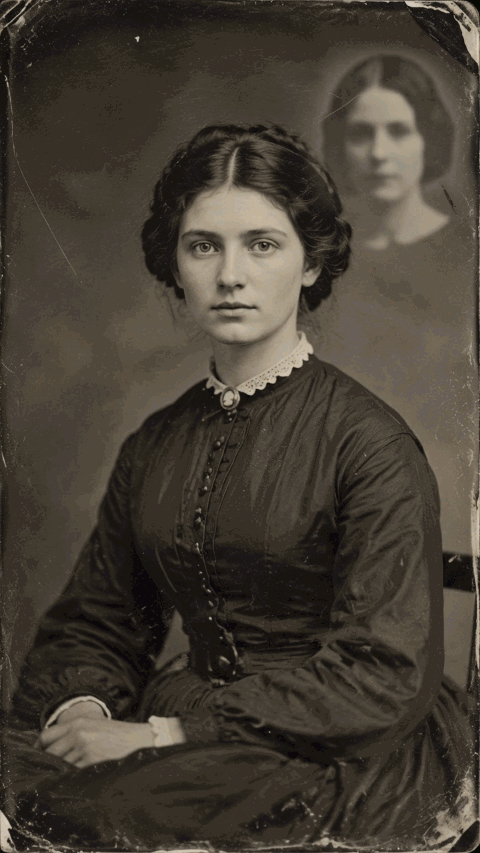
Formule de prompt à copier-coller
plaintext1Static 19th-century studio camera framing, authentic tintype aesthetic, silver halide grain, scratches, sepia tones. Zero camera movement. 2Foreground {SUBJECT_DESC}. Formal still pose, preserving exact facial identity from source image. Subtle breathing and slow eye blinks only. 3In {SPATIAL_ANCHOR}, an ultra-faint translucent ghostly haze (strictly 5%-10% opacity, double exposure effect). Blurry contour, NO sharp face, NO eyes. 4- 0 to {APPEAR_TIME}s: Subject sits calmly, background completely normal and empty. 5- {APPEAR_TIME} to {FLASH_TIME}s: Indistinct ghostly blur faintly drifts into view. 6- At {FLASH_TIME}s: Sudden bright magnesium flash fires, instantly freezing the scene into a static antique photograph for the remaining duration. 7Negative: solid human, sharp face, distinct eyes, modern digital lighting, color frames, moving after flash, cartoon.
Style 3 : La créature de vision nocturne de la sonnette de porche
Les images de surveillance déclenchent immédiatement une tension chez le spectateur dans les fils sociaux. Le bruit de caméra vert ou gris basse résolution masque les légers artefacts temporels pendant la génération vidéo, ce qui rend ce style idéal pour les boucles de farces virales.
Rendu cible
Point de vue de caméra de sonnette, vision nocturne infrarouge monochrome, superposition d’horodatage numérique et présence pâle troublante se matérialisant et se dissolvant dans les ombres lointaines du jardin.
Formule de prompt à copier-coller
plaintext1Static 9:16 doorbell infrared night vision, digital sensor noise, timestamp overlay. Zero camera motion. 2Foreground {FOREGROUND_OBJ} remains completely frozen, empty, and unaltered throughout. 3In {SPATIAL_ZONE} only: an ultra-faint, barely visible translucent {ENTITY_FORM} (strictly 5% opacity, IR sensor artifact). Background remains 95% visible through it. NO clothing texture, NO hoodie, NO glowing eyes, NO distinct face. 40 to {APPEAR_TIME}s: {SPATIAL_ZONE} is completely empty. 5{APPEAR_TIME} to {VANISH_TIME}s: The faint entity drifts slightly, strictly locked {DISTANCE}. No walking steps, no forward approach. 6At {VANISH_TIME}s: Instantly dissolves into black shadows, leaving the scene 100% empty until end. 7Negative Constraints: solid human, real person, hoodie, clothes, walking legs, approaching steps, glowing eyes, intruder, burglar, solid silhouette.
Corriger les artefacts IA et préserver la ressemblance du visage dans les vidéos de fantômes
Les modèles de diffusion vidéo s’accrochent souvent aux mauvais pixels du visage pendant le traitement temporel, transformant les yeux en cavités floues ou étirant la mâchoire. Ces défaillances visuelles ruinent le réalisme des vidéos de fantômes par IA. Vous pouvez résoudre ces erreurs de rendu en isolant le mode de défaillance racine avant de générer les clips.
Matrice de diagnostic pour les vidéos de fantômes par IA
| Artefact visuel | Cause racine | Correctif opérationnel immédiat |
| Humanoïde / acteur solide | Seuil d’opacité réglé trop haut (>15 %), déclenchant une synthèse de maillage opaque. | Verrouillez strictement l’opacité entre 5 % et 10 % ; remplacez les mots de vêtements par vapor glitch, optical smear ou double exposure. |
| Visage cloné du sujet | Le modèle de diffusion emprunte le jeton facial le plus fort de l’ancre au premier plan. | Ajoutez NO cloned face of subject, NO distinct eyes, no sharp facial features à l’emplacement Optics. |
| Mouvement d’approche / de marche | Le modèle interprète la figure humaine comme un piéton physique. | Ajoutez locked distance, glides without leg motion, NO walking steps, no approaching steps. |
| Respiration des murs et de la scène | Perspective de capteur non verrouillée. | Prompt zero camera motion, static camera framing, stationary background. |
L’arsenal de prompts négatifs
Les modèles non contrôlés introduisent des débris visuels aléatoires dans les scènes peu éclairées. Collez ce bloc négatif dédié directement dans votre générateur pour protéger la géométrie du visage et filtrer les textures ressemblant à des jouets :
negative_prompt: [solid human, opaque body, real actor, walking legs, approaching steps, floor shadow, cloned face of subject, glowing eyes, hoodie, clothes texture, phone in hands, sudden smile, camera shake]
Verrouillage de la graine pour la génération itérative
Changer votre prompt sans verrouiller la graine de génération détruit la cohérence du sujet. Chaque graine aléatoire reconstruit toute la disposition spatiale, modifiant la mâchoire, les cheveux et les vêtements du sujet. Copiez la graine numérique exacte de votre génération de base initiale réussie. Verrouillez cet entier dans les paramètres de votre générateur avant d’ajuster le placement de l’entité, la profondeur des ombres ou les valeurs d’opacité. Ce verrouillage de paramètre isole vos modifications de prompt sur l’apparition en arrière-plan tout en préservant la ressemblance du visage sur chaque rendu de test.
Paramètres d’export spécifiques à la plateforme et rythme viral pour TikTok et Reels
Les montées en tension de quinze secondes détruisent la portée. Les images statiques déclenchent un balayage en moins de deux secondes. Les algorithmes de formats courts privilégient les taux d’achèvement et les relectures immédiates en boucle. Les apparitions à la huitième seconde font complètement perdre l’audience. Les vidéos de fantômes à forte rétention compressent tout le gain visuel dans une boucle stricte de six secondes.
La structure de révélation en trois secondes
Structurez la chronologie de votre vidéo selon les règles de rythme viral pour maximiser la rétention et alimenter les débats dans les commentaires :
| Horodatage | Action visuelle | Psychologie du spectateur |
| 0:00 à 0:02 | Scène quotidienne normale. | Le spectateur se concentre sur le sujet ou lit la légende. |
| 0:02 à 0:04 | L’apparition se déplace ou se retourne. | Le spectateur perçoit un mouvement périphérique et fait un double take. |
| 0:04 à 0:06 | Le sujet reste inconscient. | Le spectateur relit le clip pour vérifier l’anomalie visuelle. |
Ce timing déclenche l’engagement algorithmique. Les spectateurs regardent à nouveau le clip pour vérifier le mouvement en arrière-plan. Beaucoup mettent en pause sur des images individuelles ou débattent dans les commentaires pour savoir si la séquence est mise en scène, ce qui pousse la vidéo vers un public plus large sur TikTok et Reels.
Normes d’encodage techniques
Les algorithmes de compression des plateformes dégradent les ombres à faible contraste et les détails des couloirs sombres. Vous évitez les artefacts de compression en exportant votre vidéo de filtre fantôme IA avec des paramètres d’export spécifiques à la plateforme :
- Résolution : 1080×1920 px (ratio vertical strict 9:16).
- Codec vidéo : H.264 dans un conteneur MP4.
- Fréquence d’images : 24 fps ou 30 fps. Des fréquences plus élevées exposent les défauts de mouvement synthétique.
- Débit cible : débit constant de 15 à 20 Mbps. Les faibles débits variables provoquent un banding en blocs dans les coins sombres.
L’astuce de croissance du carrousel Instagram
Ne publiez jamais de clips isolés dans les fils Instagram. Créez un carrousel à deux diapositives.
Placez la photo source non modifiée sur la diapositive 1. Chargez la vidéo de fantôme rendue sur la diapositive 2. Invitez les spectateurs à balayer vers la gauche dans la légende. Le balayage entre le portrait innocent et la révélation spectrale enregistre plusieurs événements d’interaction. L’algorithme détecte ce temps de pause élevé et rediffuse la publication à de nouveaux publics.
Mettre les formules en pratique
Créer des vidéos de fantômes par IA hyperréalistes se résume à un équilibre simple : verrouiller l’identité du premier plan avec de l’espace négatif, contraindre l’opacité de l’apparition strictement entre 5 % et 10 %, et laisser le timing physique raconter l’histoire.
Que vous optiez pour le grain dur du flash jetable des années 90, la dégradation artistique de la double exposition victorienne ou le réalisme troublant d’un glitch de sonnette intelligente, ce pipeline en deux étapes préserve la ressemblance du visage tout en éliminant le biais d’acteur solide.
Essayez ces formules modulaires avec vos propres prompts de portrait, et testez quelle esthétique a le mieux fonctionné dans votre fil !





