La barre de téléchargement atteint 65 Go, les ventilateurs s'activent, et la vraie question se pose : le modèle va-t-il réellement se charger ? La réponse courte aux besoins mémoire de GPT-OSS-120B est d'environ 61 Go pour les poids, plus quelques gigaoctets pour l'espace de travail, ce qui explique pourquoi OpenAI le présente comme un modèle destiné à un seul GPU de 80 Go.
Ci-dessous, nous décomposons ce chiffre, présentons le matériel qui l'a exécuté avec des vitesses mesurées, et couvrons la voie hébergée pour le cas où le vôtre serait insuffisant.
À retenir
- GPT-OSS-120B est livré sous forme de checkpoint MXFP4 de 60,8 Gio, c'est pourquoi OpenAI vise un seul GPU de 80 Go.
- La longueur de contexte ajoute peu de mémoire : le cache KV n'atteint qu'environ 4,5 Gio sur les 131K tokens complets.
- Avec moins de 80 Go de VRAM, llama.cpp peut déporter les couches d'experts vers la RAM système et continuer à l'exécuter.
- Les Mac avec plus de 96 Go de mémoire et les mini PC 128 Go peuvent contenir le modèle complet sur une seule machine.
- Pas de matériel adapté ? Appelez Qwen3.5 122B A10B sur Atlas Cloud via une API compatible OpenAI.
Besoins mémoire de GPT-OSS-120B : poids plus cache KV
OpenAI a publié gpt-oss-120b le 5 août 2025 sous licence Apache 2.0. C'est un modèle à mélange d'experts : seuls 5,1 B de ses 116,8 B de paramètres travaillent sur chaque token. Cela améliore la vitesse, pas la mémoire : chaque expert doit tout de même rester en mémoire, prêt à être sélectionné.
L'astuce qui le garde compact est MXFP4. D'après la fiche modèle gpt-oss, les poids des experts, qui représentent plus de 90 % des paramètres, sont stockés sur 4,25 bits chacun. Une copie 16 bits du même modèle nécessiterait environ quatre fois plus d'espace.
| Spécification | GPT-OSS-120B |
|---|---|
| Total des paramètres | 116,8 B |
| Paramètres actifs par token | 5,1 B |
| Couches et experts | 36 couches, 128 experts, 4 actifs par token |
| Format des poids | MXFP4 pour les couches d'experts, BF16 pour le reste |
| Taille du checkpoint | 60,8 Gio |
| Fenêtre de contexte | 131 072 tokens |
Comment la fenêtre de contexte modifie la mémoire de GPT-OSS-120B
Chaque token laisse une clé et une valeur derrière lui dans chaque couche d'attention. Ce stockage est le cache KV et, lorsque chaque couche s'intéresse à tout le contexte, il grandit au même rythme que la longueur du contexte.
GPT-OSS-120B en évite la majeure partie. La moitié de ses 36 couches utilise une fenêtre glissante qui ne remonte que sur 128 tokens, et chaque couche ne stocke que 8 têtes KV de 64 dimensions. Seules 18 couches conservent tout le contexte. Nous avons calculé le cache KV à partir de la configuration du modèle, et cela correspond aux totaux mesurés dans le guide gpt-oss de llama.cpp.
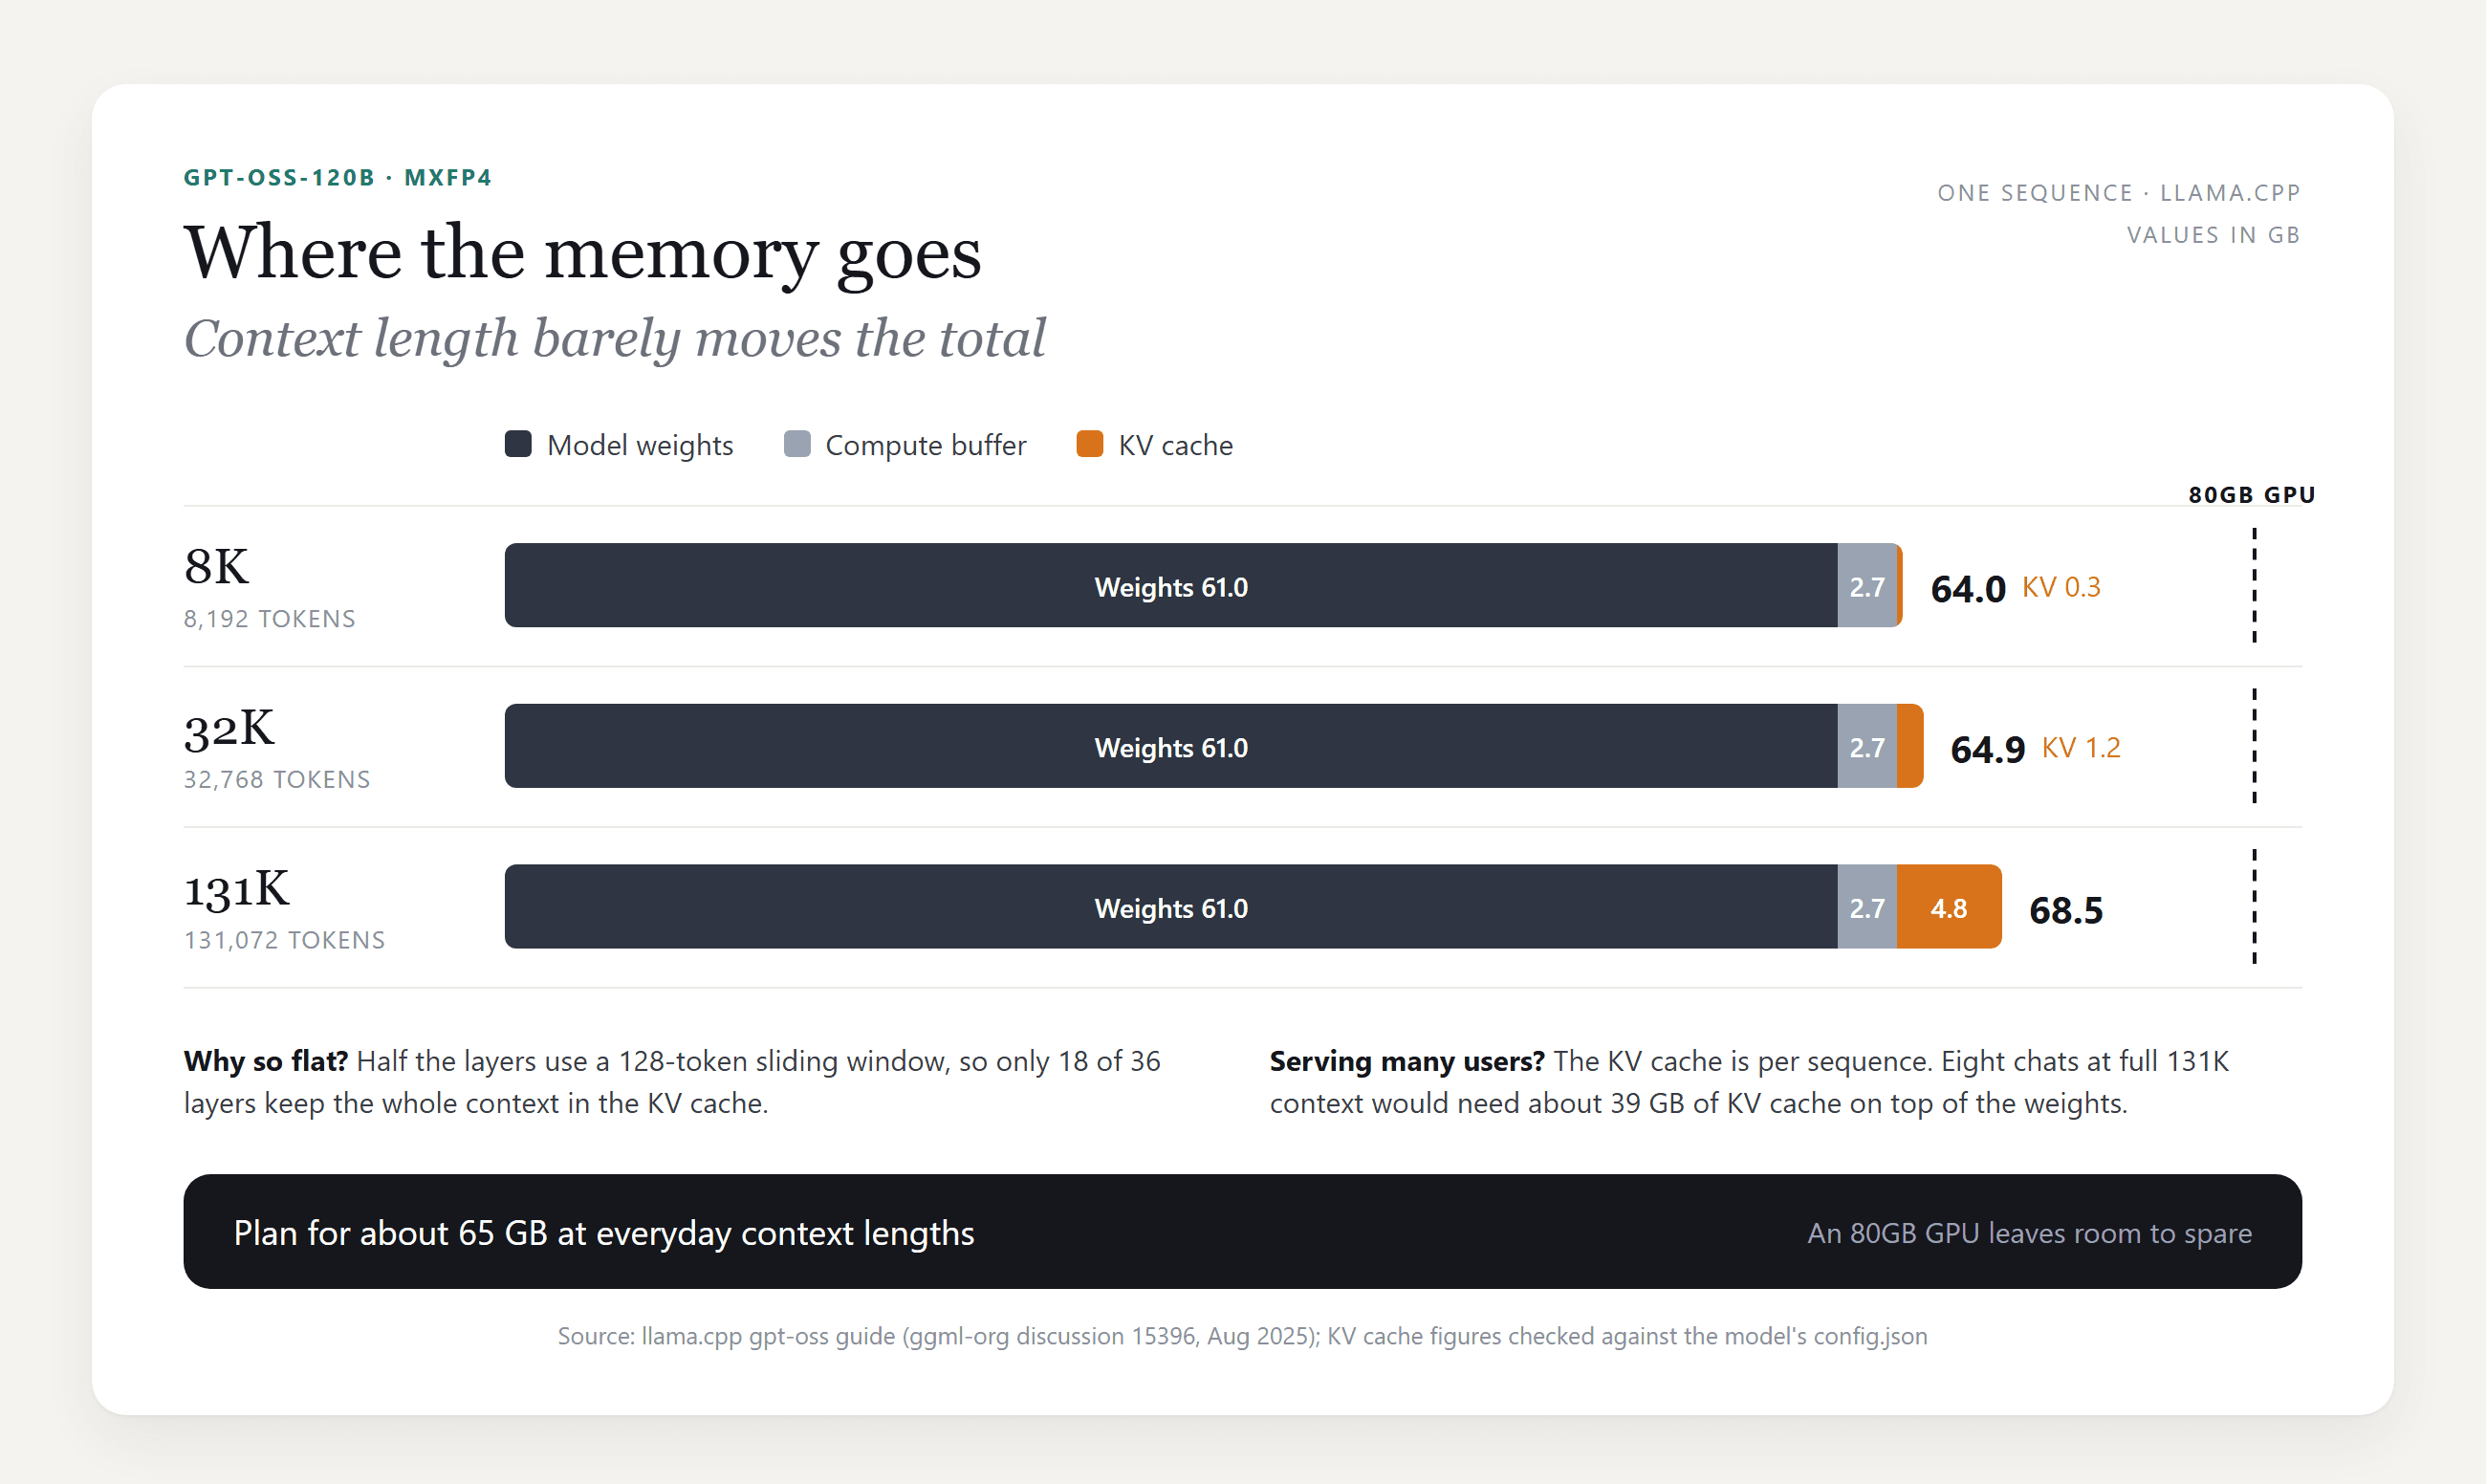
Passer de 8K à la totalité des 131K coûte moins de 5 Go. Ce qui fait grimper le total, c'est la concurrence : le cache KV est propre à chaque conversation, donc un serveur qui héberge huit conversations de longueur maximale a besoin d'environ 39 Go en plus des poids.
Puis-je exécuter GPT-OSS-120B en local ? Besoins matériels selon la configuration
Oui, si vous pouvez réserver environ 65 Go quelque part de rapide : un gros GPU, un GPU plus de la RAM système, ou une machine à mémoire unifiée.
Configuration GPU requise pour GPT-OSS-120B
Le cas le plus simple est une carte de centre de données de 80 Go. La recette vLLM pour gpt-oss indique que le modèle 120b « tiendra sur une seule A100 (80 Go) », et que le répartir sur plusieurs GPU améliore le débit.
En dessous de 80 Go, le guide llama.cpp propose une solution. Son option --n-cpu-moe conserve certaines couches d'experts dans la RAM système et le reste sur le GPU. Le guide situe le minimum à environ 8 Go de VRAM, tant que la mémoire GPU et la mémoire système réunies peuvent encore contenir le modèle.
| Configuration | Où résident les poids | Vitesse de génération rapportée |
|---|---|---|
| RTX Pro 6000, 96 Go | Tout sur le GPU | 196 tokens/s (guide llama.cpp) |
| A100 ou H100, 80 Go | Tout sur le GPU | Tient sur une seule carte (recette vLLM) |
| RTX 5090, 32 Go, plus RAM système | 21 couches d'experts conservées dans la RAM système | Environ 30 tokens/s à contexte zéro (guide llama.cpp) |
Un piège Windows signalé par le même guide : le pilote peut discrètement déborder vers la RAM système lorsque la VRAM est épuisée, si bien que le modèle se charge puis avance au ralenti. Surveillez GPU Memory dans le Gestionnaire des tâches et augmentez le nombre de déports jusqu'à ce qu'il reste sous la capacité de votre carte.
Exécuter GPT-OSS-120B sur un Mac ou un mini PC 128 Go
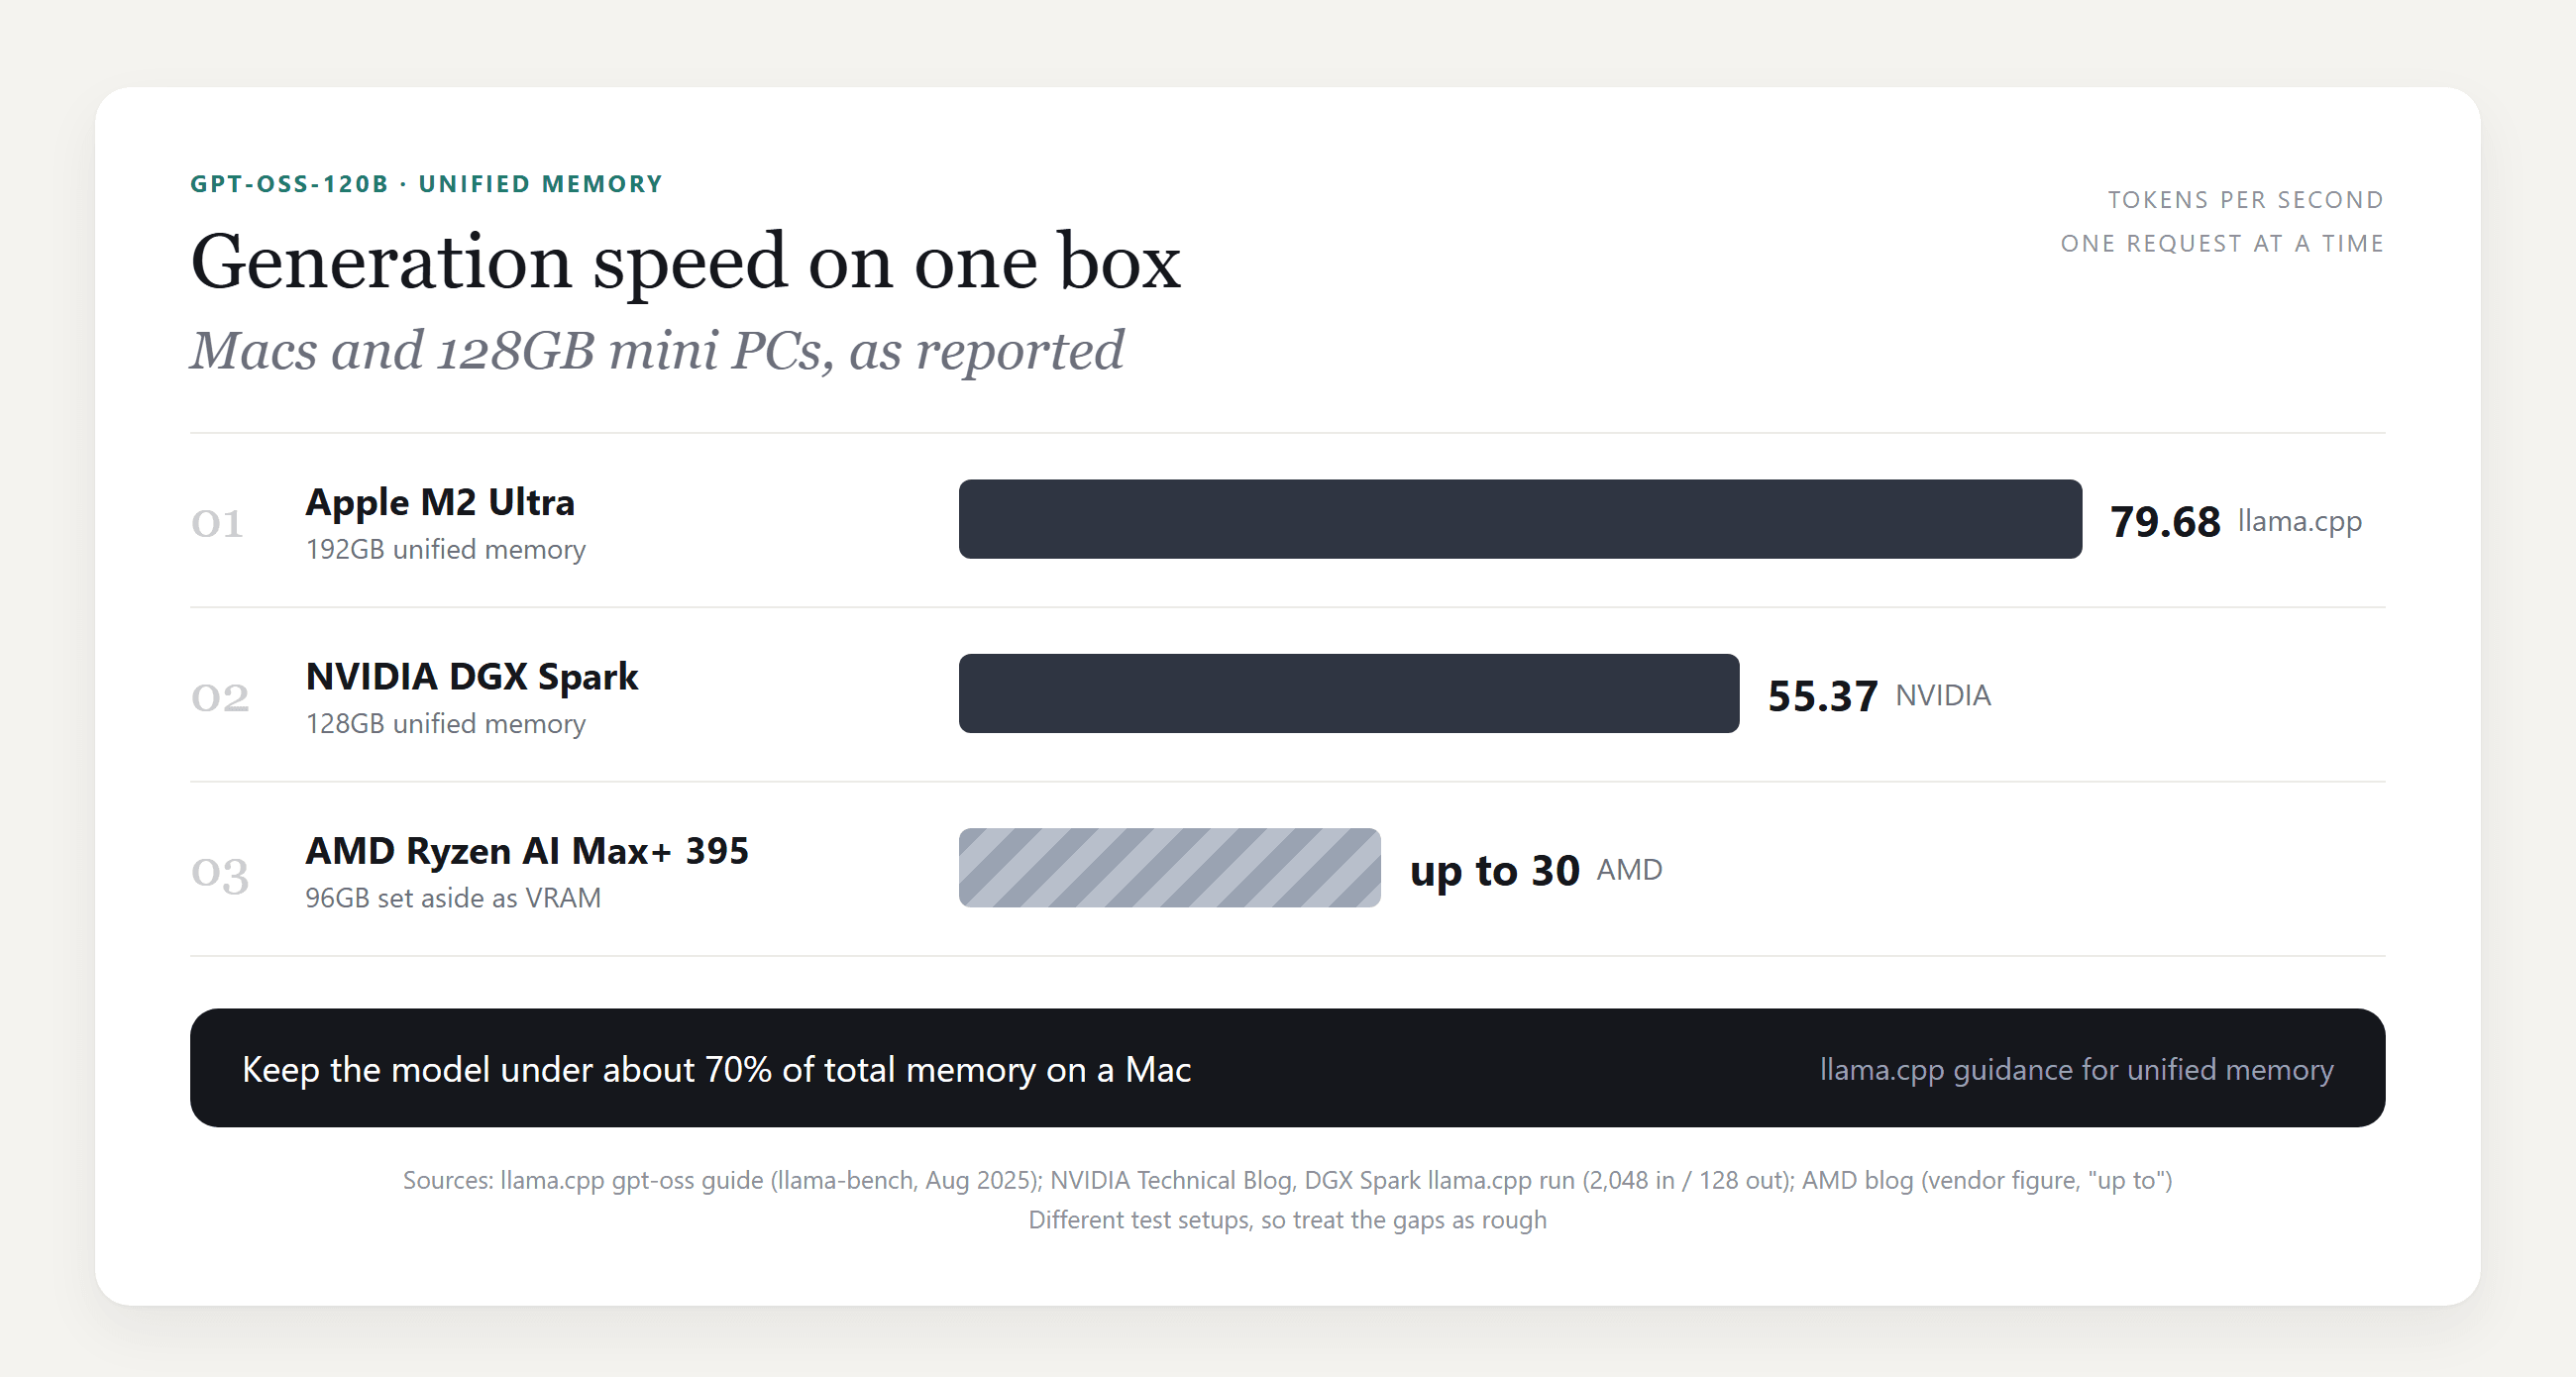
La mémoire unifiée supprime la séparation GPU/RAM. Le guide llama.cpp indique que les Mac avec plus de 96 Go de RAM, comme les machines M2 Ultra ou M3 Max, peuvent exécuter le modèle au contexte complet, et il conseille de rester sous environ 70 % de la mémoire totale.
macOS limite par défaut la quantité de mémoire que le GPU peut câbler. Sur une machine de 192 Go, le guide relève ce plafond de 154 Go à 180 Go avec une seule commande :
plaintext1sudo sysctl iogpu.wired_limit_mb=184320
Les nouveaux mini PC 128 Go appartiennent à la même catégorie. NVIDIA rapporte 55,37 tokens/s pour gpt-oss-120b sur un DGX Spark exécutant llama.cpp. AMD affirme qu'une machine Ryzen AI Max+ 395 avec 96 Go réservés comme VRAM atteint « jusqu'à 30 tokens par seconde », un chiffre de l'entreprise elle-même.
Pas assez de mémoire ? Utilisez un modèle à poids ouverts hébergé via une API
Si aucune de ces machines n'est sur votre bureau, un modèle à poids ouverts hébergé élimine complètement la question du matériel.
Atlas Cloud propose Qwen3.5 122B A10B, qui fait partie de sa gamme de modèles Qwen. Sur le papier, c'est un proche équivalent de gpt-oss-120b : un modèle à mélange d'experts Apache 2.0 de l'équipe Qwen d'Alibaba, avec 122 B de paramètres au total et 10 B actifs. Il lit jusqu'à 262 144 tokens de contexte.
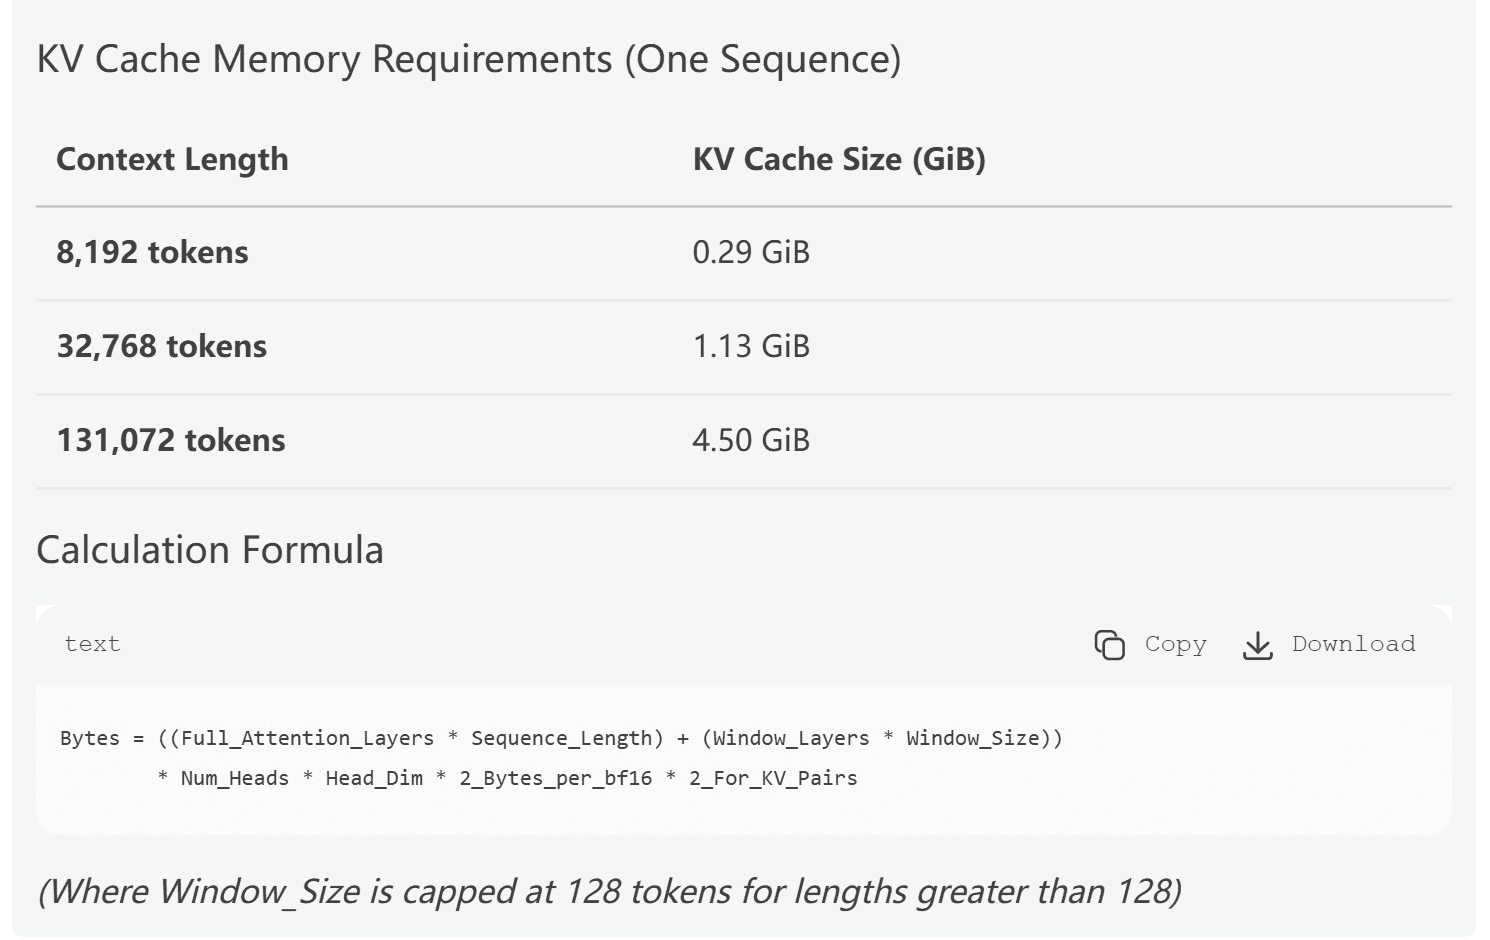
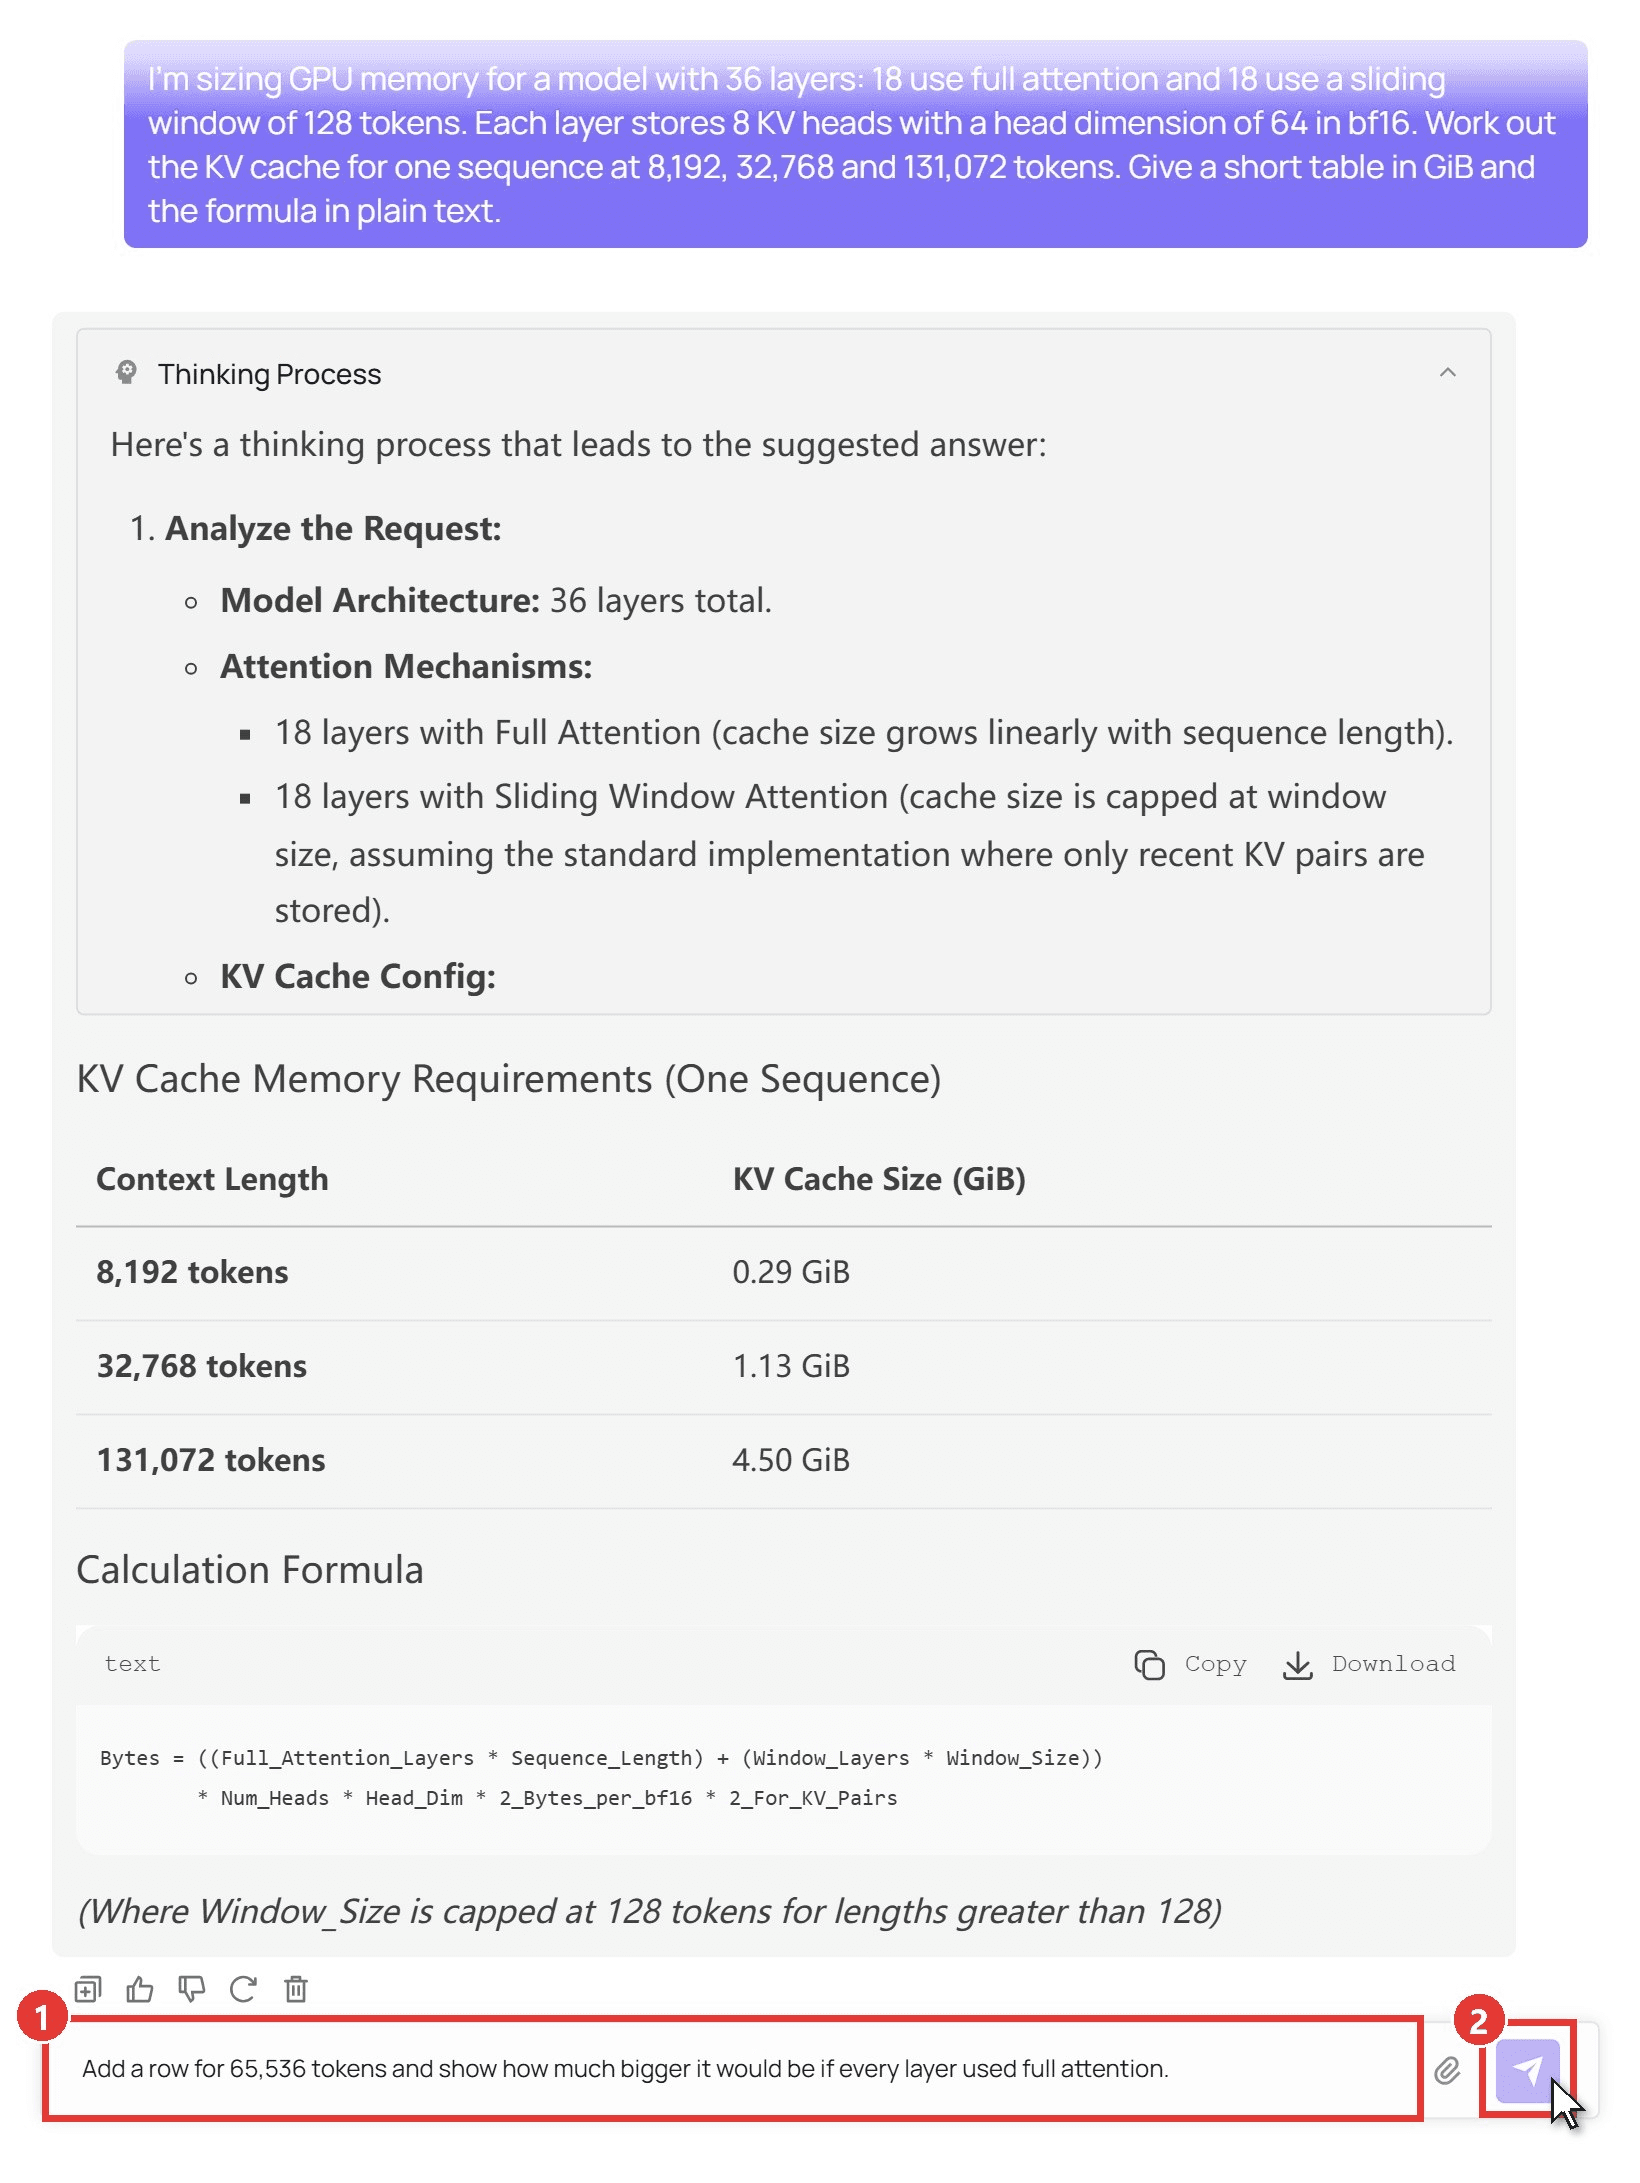
Nous lui avons donné la disposition d'attention issue de la configuration gpt-oss et demandé le cache KV pour trois longueurs. Son tableau correspondait à notre propre calcul à deux décimales près. Si vous souhaitez plus tard un Qwen pour votre propre machine, notre guide du meilleur modèle Qwen pour le codage en local les dimensionne selon la RAM.
Méthode 1 : Essayez Qwen3.5 122B A10B dans le playground
Connectez-vous et ouvrez le playground Qwen3.5 122B A10B, puis :
- Saisissez votre question dans la zone de message.
- Cliquez sur la flèche d'envoi. Le raisonnement apparaît dans un panneau Thinking Process au-dessus de la réponse.
Méthode 2 : Appelez Qwen3.5 122B A10B avec l'API Atlas Cloud
Pour les scripts et applications :
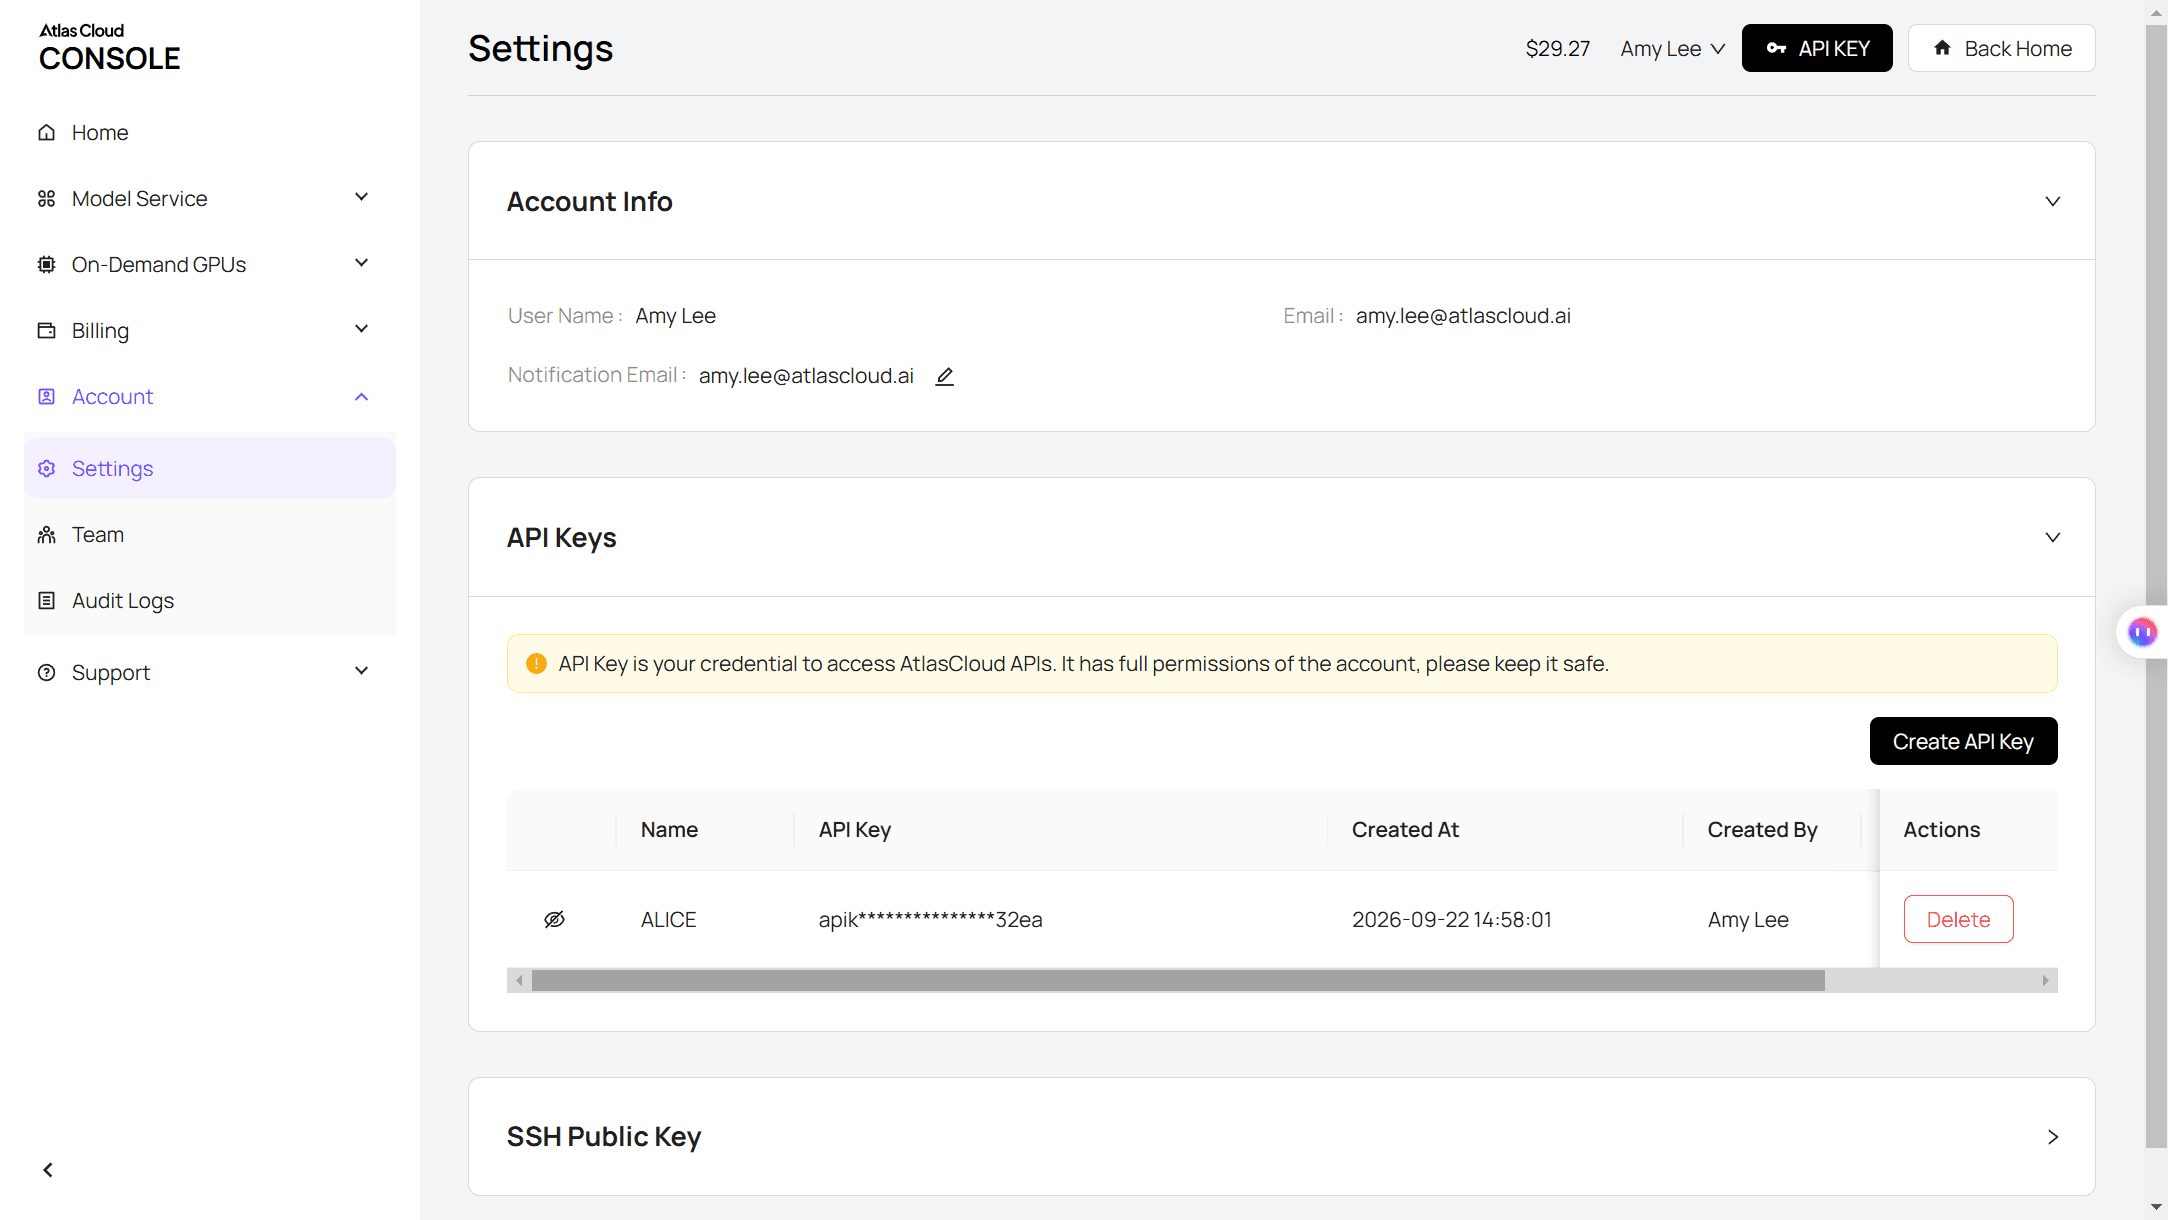
Étape 1 : Créez une clé API. Ouvrez Paramètres dans la console, accédez à Clés API, puis cliquez sur Créer une clé API. Gardez-la côté serveur.
Étape 2 : Vérifiez le format de requête. La documentation API couvre le format des complétions de chat, et la page du modèle dispose d'un onglet API avec un exemple prêt à l'emploi.
Étape 3 : Envoyez votre première requête.
plaintext1curl -X POST "https://api.atlascloud.ai/v1/chat/completions" \ 2 -H "Authorization: Bearer $ATLASCLOUD_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "qwen/qwen3.5-122b-a10b", 6 "messages": [{"role": "user", "content": "Review this llama-server log and tell me which flag to change if VRAM runs out: ..."}], 7 "max_tokens": 4000 8 }'
La réponse revient dans choices[0].message.content. Comme le point de terminaison suit le format OpenAI, le code écrit pour un serveur gpt-oss local n'a généralement besoin que d'une nouvelle URL de base, d'une clé et d'une chaîne de modèle. La même clé fonctionne aussi avec les autres modèles de chat de la plateforme, comme le détaille notre article sur une passerelle API LLM unifiée.
GPT-OSS-120B vs GPT-OSS-20B : compromis entre mémoire et benchmarks
Le petit frère nécessite un cinquième de la mémoire. gpt-oss-20b compte 20,9 B de paramètres dont 3,6 B actifs, et OpenAI indique qu'il tourne avec « à peine 16 Go de mémoire ». La question est de savoir ce que vous abandonnez.
| | GPT-OSS-120B |
GPT-OSS-20B
| | -------------------------------- | ------------ | ------------------------ | | Mémoire à contexte 8K (llama.cpp) | 64,0 Go | 14,9 Go | | MMLU | 90,0 | 85,3 | | GPQA Diamond (sans outils) | 80,1 | 71,5 | | SWE-Bench Verified | 62,4 | 60,7 | | Codeforces Elo (sans outils) | 2463 | 2230 | |
HealthBench
plaintext1 | 57,6 | 42,5 |
Les scores proviennent de la fiche modèle avec un effort de raisonnement élevé. L'écart en codage est inférieur à deux points sur SWE-Bench Verified, tandis que l'écart de connaissances est d'environ 9 points en sciences de niveau master et de 15 sur HealthBench. Pour principalement du code sur une carte de 16 Go à 24 Go, 20b est le choix judicieux. Besoin des connaissances supplémentaires ? C'est là que 120b justifie sa facture mémoire.
GGUF, Ollama ou vLLM : choisir un runtime adapté à votre budget mémoire
Chacun exécute les poids MXFP4 publiés par OpenAI ; ils diffèrent par l'endroit où ces poids peuvent résider.
| Runtime | Téléchargement | Idéal pour |
|---|---|---|
| Ollama (gpt-oss:120b) | 65 Go | Un utilisateur sur une machine qui contient tout le modèle |
| LM Studio | 65 Go | Une application de bureau sur Mac ou PC Windows |
| llama.cpp (GGUF ggml-org) | Environ 63 Go | Moins de 65 Go de VRAM, avec des couches d'experts déportées vers la RAM |
| vLLM | Environ 65 Go de safetensors | Servir de nombreux utilisateurs depuis un ou plusieurs GPU de centre de données |
Pour un démarrage rapide sur une machine à grande mémoire :
plaintext1ollama run gpt-oss:120b
Pour un GPU plus petit, utilisez llama.cpp et ajustez le nombre de déports :
plaintext1llama-server -hf ggml-org/gpt-oss-120b-GGUF --ctx-size 0 --jinja -ub 2048 -b 2048 --n-cpu-moe 21
Les quatre prennent en charge le format de chat harmony d'OpenAI, dont le modèle a besoin pour fonctionner correctement. Cela n'a d'importance que si vous écrivez votre propre code de service.
FAQ
GPT-OSS-120B est-il meilleur que GPT-5 ou Gemini 3 Pro ?
Ils appartiennent à des catégories différentes : GPT-5 et Gemini sont des modèles fermés auxquels vous accédez via une application ou une API, tandis que gpt-oss-120b s'exécute sur votre propre matériel. Gemini 3 Pro Preview a également été arrêté le 9 mars 2026, et son nom pointe désormais vers Gemini 3.1 Pro Preview. Si le contrôle local compte, la gamme à poids ouverts de Google est la famille Gemma 4.
Pourquoi certains sites affirment-ils que GPT-OSS-120B nécessite 255 Go ?
Ces chiffres supposent des poids 16 bits : environ 117 B de paramètres multipliés par 2 octets, plus les frais généraux. Le checkpoint publié par OpenAI est déjà en MXFP4, donc le téléchargement réaliste se situe autour de 61 Go.
L'effort de raisonnement change-t-il l'utilisation de la mémoire ?
Pas pour les poids. Les réglages low, medium et high changent la durée de réflexion du modèle. Un effort élevé écrit plus de tokens de raisonnement, qui remplissent la fenêtre de contexte et font grossir le cache KV ; les longues sessions se rapprochent donc des totaux plus élevés du graphique ci-dessus.
Pourquoi dit-on que GPT-OSS-120B a du mal avec les jeux textuels ?
Les preuves sont anecdotiques. Sur la page de discussion Hugging Face du modèle, certains utilisateurs signalent des refus lorsqu'ils écrivent de la fiction violente, tandis que d'autres affirment que le jeu de rôle fonctionne bien. Pour la fiction interactive, testez vos propres invites avant d'acheter du matériel pour cela.
Combien coûte un modèle hébergé de classe 120B ?
En octobre 2026, Qwen3.5 122B A10B coûte $0.3 par million de tokens d'entrée et $2.4 par million de tokens de sortie sur Atlas Cloud. Cela représente une remise de 25 % sur ses tarifs habituels de $0.4 et $3.2. Notre question de dimensionnement a utilisé environ 5 000 tokens de sortie une fois le raisonnement compté, soit environ un centime au tarif remisé.
Conclusion
GPT-OSS-120B est plus facile à loger que son nombre de paramètres ne le suggère. Prévoyez environ 65 Go pour les longueurs de contexte courantes et moins de 70 Go pour les 131K complets. Un GPU 80 Go, un Mac avec plus de 96 Go, ou un mini PC 128 Go le contiendra, et des cartes plus petites peuvent l'exécuter en déplaçant les couches d'experts vers la RAM système.
Si ces chiffres excluent votre machine, passez à gpt-oss-20b pour un usage principalement orienté codage, ou appelez un modèle à poids ouverts hébergé lorsque vous avez besoin du plus gros cerveau sans acheter de matériel. Dans tous les cas, les besoins mémoire de gpt oss 120b cessent d'être un jeu de devinettes une fois que vous savez que les poids prennent 61 Go et que le reste est de la marge.


