
 Atlas Cloud est désormais revendeur agréé aux États-Unis de Dreamina Seedance 2.5 et Seedream 5.0 Pro.Atlas Cloud est désormais revendeur agréé aux États-Unis de Dreamina Seedance 2.5 et Seedream 5.0 Pro.

GPT 6 Astra est le modèle le plus intelligent et le mieux aligné d’OpenAI, conçu pour les tâches exigeantes de contrôle informatique, de navigation web, d’ingénierie logicielle, de cybersécurité, de recherche scientifique et de travail professionnel. Son jugement permet de gérer des flux de travail complexes impliquant du code, de la recherche et des outils numériques. Atlas Cloud fournit Astra et Astra Codex via une seule clé compatible avec OpenAI, aux tarifs standard de 10 $ par million de tokens en entrée et de 50 $ par million de tokens en sortie. Commencez à créer dès aujourd’hui.
GPT 6 Astra est développé par OpenAI. Atlas Cloud (exploité par Atlas Cloud AI LLC) en fournit l’accès mais n’en est pas propriétaire. Toutes les marques appartiennent à leurs détenteurs respectifs.
Découvrez comment chaque endpoint GPT 6 Astra prend en charge les workflows conversationnels, de génération de contenu et d’IA personnalisée.
| Modalité | Description |
|---|---|
| GPT 6 Astra API (Text) | GPT 6 Astra traite les prompts textuels et renvoie du texte généré grâce à un profil de modèle créatif et intuitif. Choisissez-le pour les conversations naturelles, la génération de contenu et les expériences d’IA personnalisées. |
| GPT 6 Astra Codex API (Text) | Avec l’endpoint GPT 6 Astra Codex, les requêtes textuelles génèrent des réponses textuelles à l’aide du profil créatif et intuitif vérifié. Il convient aux workflows conversationnels, de création de contenu et d’expériences personnalisées qui nécessitent un endpoint de modèle distinct. |
GPT 6 Astra offre un contexte de 1,050,000 tokens, cinq niveaux de raisonnement, la compréhension du texte et des images, des capacités d’utilisation d’ordinateur, deux endpoints de modèles Atlas et une tarification échelonnée transparente au sein d’une intégration compatible avec OpenAI.
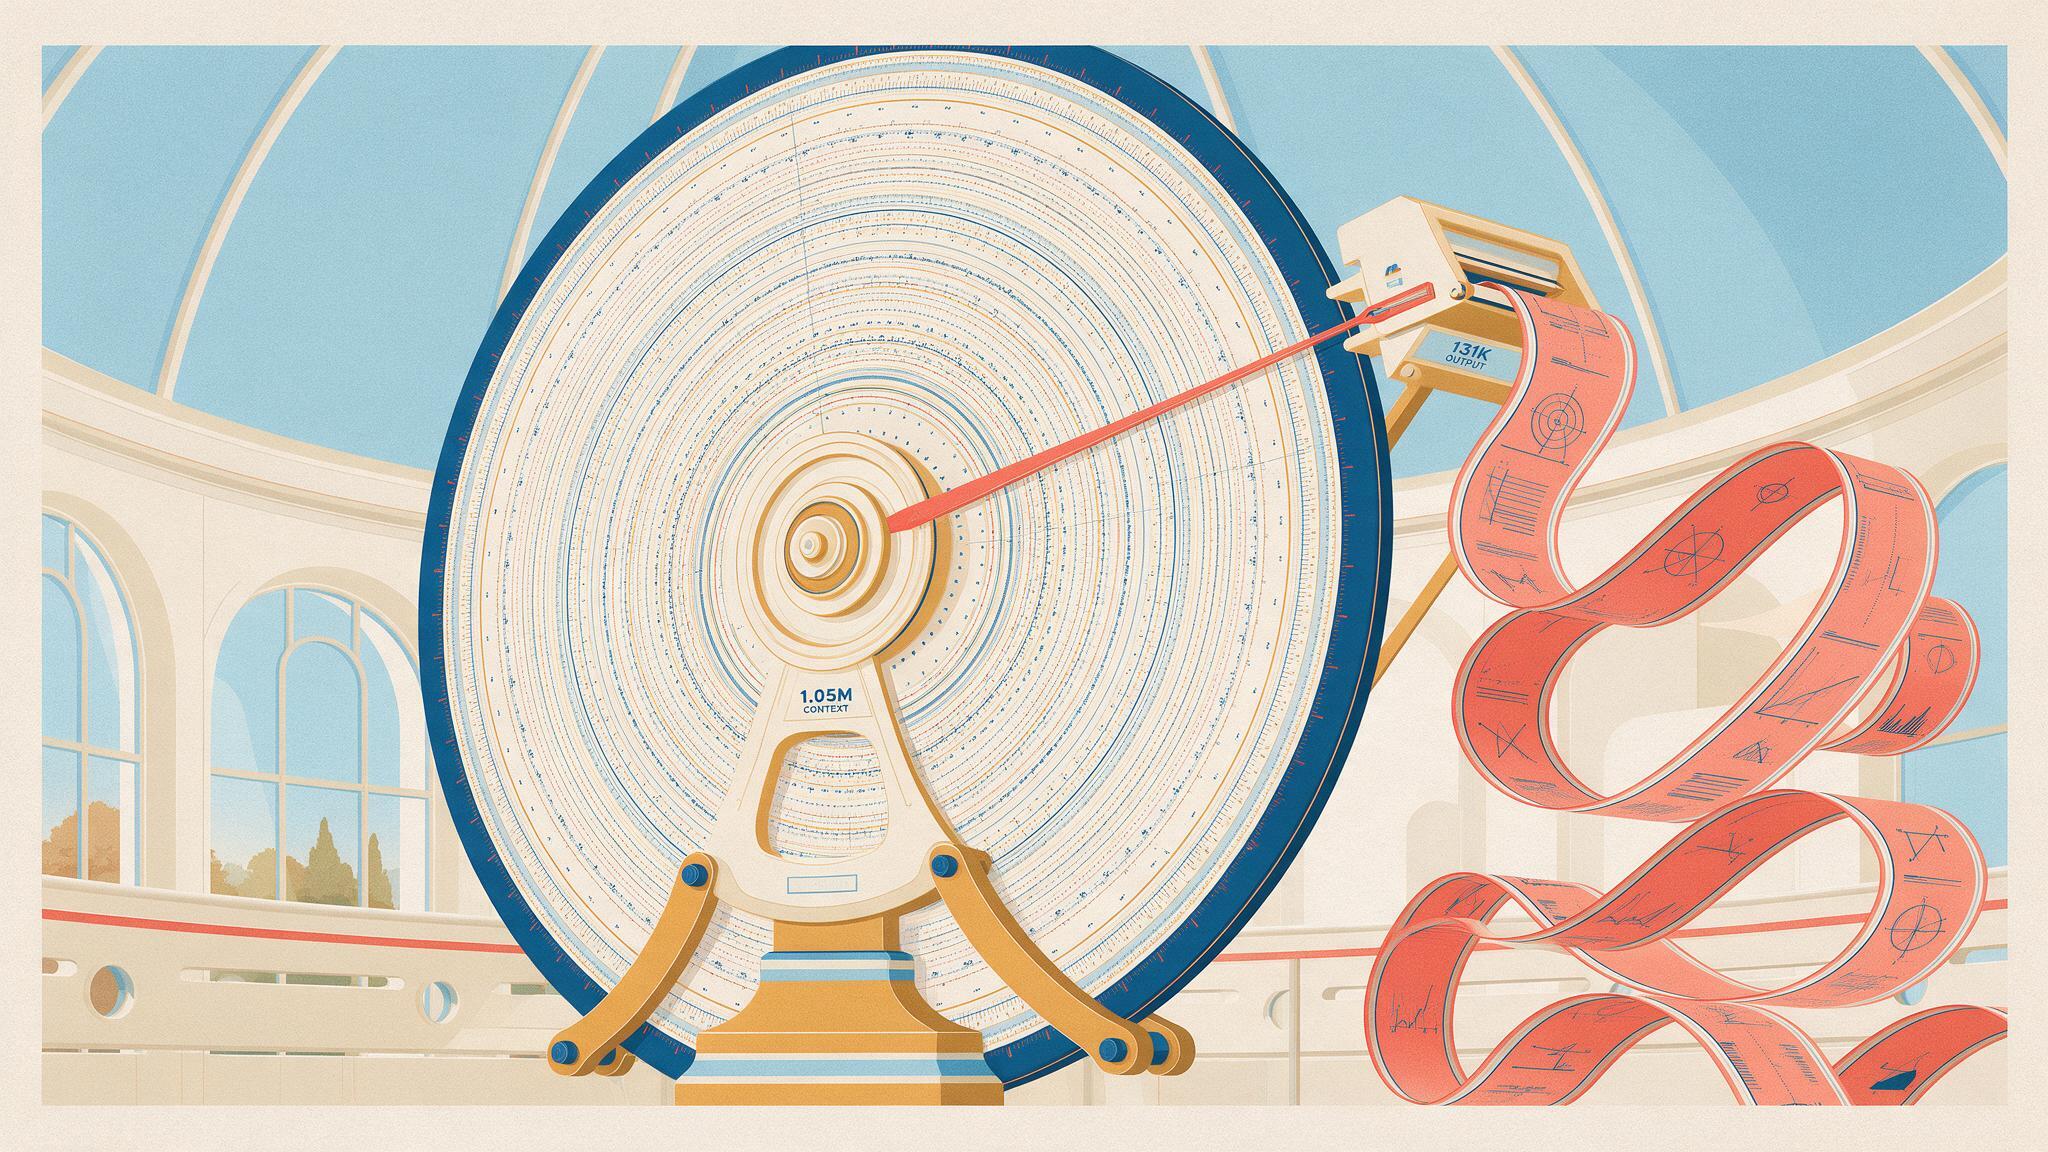
GPT 6 Astra accepte jusqu’à 1,050,000 tokens de contexte et peut renvoyer jusqu’à 131,072 tokens de sortie. Fournissez-lui de vastes dépôts de code, des collections de travaux de recherche ou de longs historiques de conversation en une seule requête. Cette fenêtre de travail étendue réduit le besoin de fragmenter les sources en nombreux appels déconnectés, ce qui rend le modèle particulièrement adapté aux revues de grande ampleur, aux analyses prolongées et aux contextes de projets complexes.
Cinq niveaux d’effort de raisonnement vous permettent d’ajuster le degré de réflexion consacré à chaque requête : low, medium, high, xhigh et max. Choisissez un réglage plus léger pour les tâches simples, puis augmentez l’effort lorsque la planification, l’analyse scientifique ou le débogage difficile nécessitent une réflexion plus approfondie. Ce contrôle au niveau de la requête aide les équipes à équilibrer la vitesse de réponse, la consommation de tokens et la profondeur des solutions sans changer de modèle.
OpenAI présente Astra comme une solution à la pointe pour l’utilisation d’ordinateur et la navigation web. Lorsque votre application fournit les outils et les autorisations nécessaires, le modèle peut interpréter l’état d’une interface, planifier des actions en plusieurs étapes et réagir aux résultats tout au long d’un workflow plus long. Cette combinaison convient à la recherche sur le web, à l’assistance opérationnelle et aux tâches pilotées par logiciel, où le jugement compte autant que le clic suivant.
Atlas Cloud expose à la fois openai/gpt-6-astra et openai/gpt-6-astra-codex via une seule clé compatible avec OpenAI. Chacun offre une fenêtre de contexte de 1,050,000 tokens et jusqu’à 131,072 tokens de sortie, avec la même tarification échelonnée vérifiée. Changez d’identifiant de modèle selon l’évolution de votre workflow tout en conservant une intégration et un parcours d’authentification cohérents. Les équipes disposent ainsi d’un moyen pratique de comparer les variantes générale et Codex au sein d’une même pile.
Les entrées textuelles et visuelles permettent à Astra de raisonner sur des textes, des captures d’écran, des diagrammes et des documents visuels mixtes, tout en produisant des réponses textuelles. Associez des éléments visuels à des instructions écrites afin que le modèle puisse relier ce qu’il voit à la tâche que vous décrivez. Les développeurs peuvent exploiter cette voie d’entrée combinée pour la revue de documents, l’analyse d’interfaces, l’interprétation de graphiques et d’autres workflows dans lesquels le texte seul laisse de côté des éléments de contexte importants.
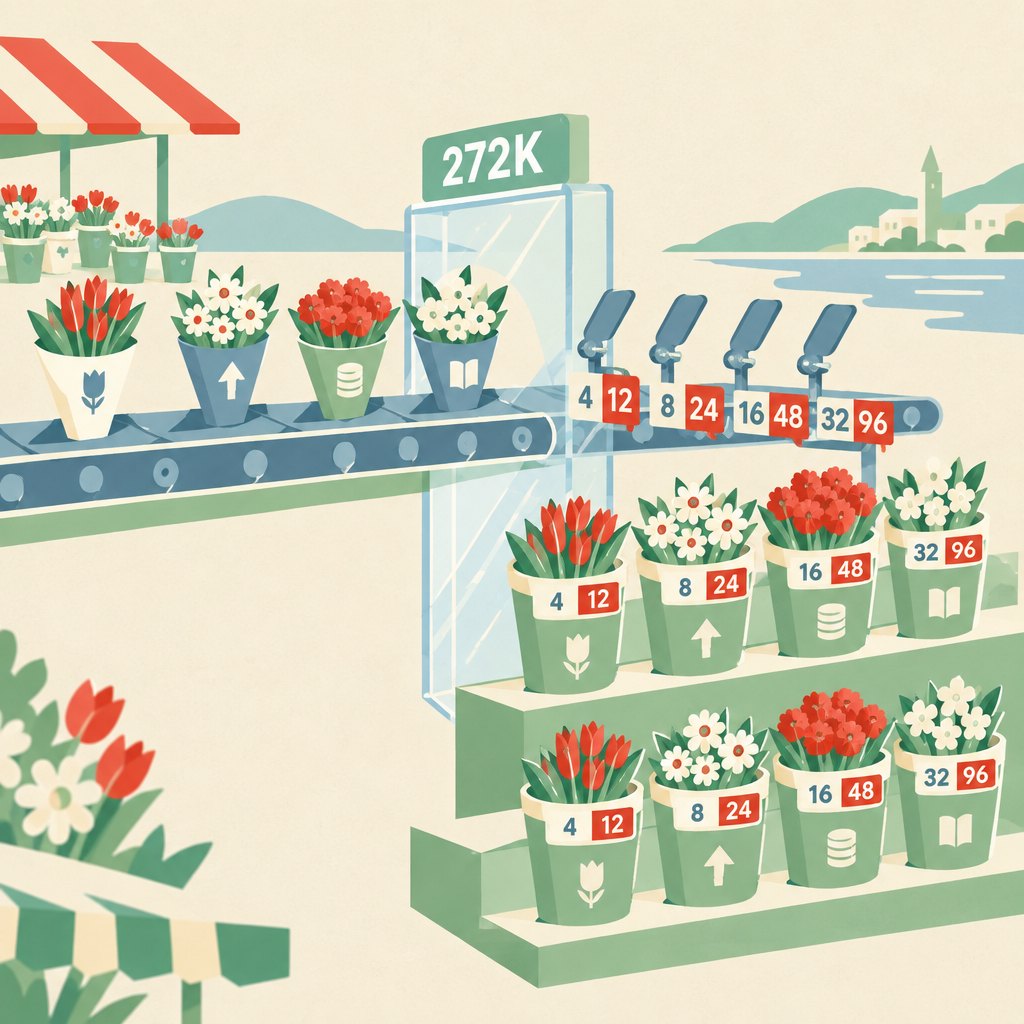
Atlas Cloud applique aux deux variantes d’Astra une tarification transparente, échelonnée et à l’usage. Pour les prompts allant jusqu’à 272,000 tokens d’entrée, les tarifs standard sont de $10 par million de tokens d’entrée, $50 par million de tokens de sortie, $12.50 pour la création du cache et $1 pour les lectures du cache. Au-delà de ce seuil, les tarifs correspondants sont de $20, $75, $25 et $2, ce qui aide les développeurs à estimer le coût des contextes longs avant le déploiement.
Comparez la façon dont GPT 6 Astra et deux alternatives de premier plan transforment des prompts identiques en expériences HTML interactives et soignées.
Créez une page web HTML interactive complète, dans un fichier unique, intitulée « Laboratoire d’accidents de typographie Midnight ». Retournez uniquement le document HTML final, avec tout le CSS et le JavaScript intégrés. La page doit s’ouvrir et fonctionner directement dans un navigateur moderne, sans dépendances externes, CDN, bibliothèques, polices, liens vers des images, fichiers SVG ni autres ressources. Il s’agit d’une page web responsive, et non d’une image fixe au format 16:9 ou d’une composition sur canvas ; elle doit s’adapter harmonieusement aux écrans d’ordinateur, de tablette et de mobile. Créez un simulateur tactile de typographie expérimentale dans lequel l’utilisateur compose une impression en faisant glisser des blocs de caractères en plomb individuels sur une feuille centrale, en les faisant pivoter et en les repositionnant, puis en réglant la quantité d’encre, la pression de la presse et l’humidité du papier avant d’actionner un énorme levier mécanique d’impression. Le résultat imprimé doit réagir de manière procédurale à ces paramètres : un excès d’encre provoque des bavures et obstrue les contreformes, une faible quantité d’encre crée des bords secs et fragmentés, la pression modifie l’indentation et la déformation, l’humidité accentue les bavures et endommage les fibres du papier, un placement imparfait des caractères crée un défaut de repérage, et les impressions répétées produisent des ombres décalées et des images fantômes. Autorisez plusieurs passages de couleur en utilisant uniquement le rouge vermillon, le bleu outremer et le jaune acide, avec un mélange réaliste des surimpressions, un ordre des calques visible, une visibilité par calque, une annulation/répétition étape par étape et la possibilité de soulever le coin du papier pour révéler l’impression qui se forme. Figez le spectacle visuel principal autour de l’instant où le rouleau de la presse vient de remonter et où l’impression terminée est sur le point d’être révélée. Le papier central doit évoquer une scène théâtrale. Disposez les blocs de caractères, rouleaux d’encrage, brucelles, repères de registration, chutes de papier, jauges et commandes en anneau asymétrique autour de lui. Utilisez une base en papier écru et en plomb gris, éclairée par une lampe de travail blanc chaud venant en diagonale depuis le coin supérieur gauche. Rendez l’ensemble avec du CSS, des éléments HTML, Canvas et des textures procédurales, dans un style d’impression sérigraphique physique et de collage artisanal : bords déchirés, grain fibreux du papier, pigment irrégulier, mouchetures en demi-teinte, métal rayé, traces d’encre, fragments de ruban adhésif, légère perspective, défauts de repérage et ombres superposées. Évitez les dégradés brillants, le style SaaS stérile, les cartes génériques, les couleurs cyberpunk néon, les images photoréalistes, les émojis, les illustrations de stock et la géométrie vectorielle parfaitement nette. Incluez un inventaire conséquent de caractères mobiles avec des lettres, signes de ponctuation, chiffres et plusieurs blocs décoratifs. Les utilisateurs doivent pouvoir faire glisser des blocs depuis l’inventaire vers la zone de composition, sélectionner plusieurs blocs, les faire pivoter à l’aide de poignées ou de raccourcis clavier, les déplacer avec les touches fléchées, les supprimer ou les dupliquer, et modifier leur contenu textuel sans perdre l’apparence physique du bloc. Ajoutez des guides d’alignement pouvant être activés ou désactivés, tout en conservant de petites irrégularités manuelles. Fournissez des états clairs au survol, actifs, sélectionnés, désactivés et de focus. Prenez en charge les interactions au pointeur et au toucher, des commandes clavier cohérentes, des libellés accessibles et des indicateurs de focus visibles. Créez trois commandes tactiles pour la quantité d’encre, la pression et l’humidité, dont les valeurs mettent à jour en temps réel l’aperçu du papier, la simulation de texture, les jauges, les libellés d’avertissement et le comportement ambiant de la machine. Le système doit révéler des états d’accident ludiques lors de combinaisons extrêmes, comme des explosions d’encre violentes, des lettres doublées, des caractères déplacés, des fissures de fibres déchiquetées, des vibrations de rouleau et des marques de repérage éclaboussées, tout en conservant une composition lisible. Ajoutez un journal d’expérience compact qui enregistre chaque impression et ses paramètres. Les utilisateurs doivent pouvoir sélectionner une couleur de passage, actionner le levier en le faisant glisser selon un arc convaincant, observer un cycle de presse court mais détaillé, puis décoller le papier. L’animation doit inclure la résistance du levier, les vibrations de la machine, le mouvement du rouleau, la compression du papier, des poussières en suspension, un léger vacillement de la lampe et une pause pleine de suspense avant la révélation. Respectez prefers-reduced-motion. Rendez les fonctions d’annulation et de répétition réellement opérationnelles pour le placement, la rotation, les changements de paramètres, l’impression, les passages de couleur et les actions de révélation. Incluez les commandes Réinitialiser, Accident aléatoire, Réencrer, Ajouter un passage, Annuler et Répéter, ainsi qu’une brève indication d’accueil qui disparaît après la première interaction. Préchargez la page avec une affiche partiellement composée et intrigante afin que la première vue soit visuellement riche, tout en laissant chaque élément important modifiable. Ajoutez un retour visuel subtil évoquant le son sans utiliser de ressources audio. Assurez, lorsque cela est possible, une texture procédurale déterministe afin que l’annulation restaure exactement la même apparence. L’expérience doit sembler cérémonielle, artisanale, tendue et délicieusement incontrôlable, plutôt que simplement décorative. Donnez la priorité aux détails d’interaction soignés, au couplage convaincant des paramètres, aux artefacts d’impression procéduraux superposés, au rythme raffiné des animations et à une composition responsive d’excellente qualité. Utilisez du HTML sémantique et du JavaScript vanilla propre et bien structuré. La réponse finale doit contenir uniquement le document HTML complet et exécutable.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
Créez une page web HTML interactive complète et soignée, dans un fichier unique, intitulée « Théâtre sonore du ramen de minuit ». Retournez uniquement le document HTML final, avec tout le CSS et le JavaScript intégrés. Il doit fonctionner directement dans un navigateur moderne, sans étape de compilation ni dépendances externes, bibliothèques, polices, images, fichiers audio, ressources CDN, requêtes réseau ou ressources liées. Créez une scène interactive expressive située dans une boutique de ramen surréaliste, à minuit. L’objet central est un seul et même ensemble continu de nouilles élastiques, rendu avec Canvas, SVG ou une combinaison soigneusement intégrée des deux. Le paquet de nouilles doit traverser le premier plan en diagonale et sembler physiquement tangible : les utilisateurs peuvent l’attraper n’importe où avec la souris ou le toucher, le faire glisser, l’étirer, le fouetter, le replier sur lui-même et le relâcher. Implémentez une physique de ressort convaincante avec inertie, amortissement, gravité, plusieurs segments connectés, réponse aux collisions et mouvements secondaires visibles. Gardez la simulation stable même lors de glissements brusques, de changements rapides de direction, du redimensionnement de la fenêtre ou d’interactions répétées. Disposez au moins trois bols de ramen distincts et plusieurs ingrédients le long d’un arc qui traverse la composition, afin de créer un rythme visuel fort autour des nouilles diagonales. Chaque bol doit avoir son propre motif de bouillon illustré, son identité chromatique, son libellé et sa signature sonore. Lorsque les nouilles touchent un bol ou y tombent, déclenchez une réponse audiovisuelle synchronisée : un rythme percussif unique synthétisé avec la Web Audio API, une poussée de vapeur montante, des projections de particules vert cébette, des ondulations du bouillon, de petites gouttes, un léger tremblement de repérage façon sérigraphie et des onomatopées manuscrites de style japonais animées, telles que « ZURU ! », « PON ! », « JUU ! » ou « BASHAN ! », créées à partir de texte stylisé plutôt qu’avec des polices externes. L’intensité de la collision doit influencer le volume, la hauteur, le nombre de particules, la taille des ondulations, l’échelle du lettrage et la force de l’animation. L’audio ne doit commencer qu’après la première interaction de l’utilisateur et doit inclure une commande claire pour couper ou réactiver le son. L’état visuel culminant doit évoquer une image figée dans laquelle les nouilles sont spectaculairement tendues dans les airs tandis que le bouillon reste suspendu juste avant d’éclabousser. Soutenez cet effet avec une commande « FIGER L’ÉCLABOUSSURE » et la touche Espace : l’activation du mode figé doit appliquer une brève transition percutante, suspendre la scène physique sans perdre son état, mettre en valeur les gouttes en suspension et la tension des nouilles étirées, afficher une typographie cinétique audacieuse de style affiche et conserver un léger scintillement procédural des lignes afin que la page reste vivante. Appuyer de nouveau sur Espace ou sur la commande doit reprendre la scène sans à-coup. Ajoutez une commande de réinitialisation, un indicateur compact de l’état sonore et un affichage discret en direct du « tempo/impact », calculé à partir des collisions récentes. Les commandes clavier doivent être présentées dans un petit panneau d’aide intégré : Espace active ou désactive le gel, R réinitialise, M coupe le son et les touches fléchées appliquent des impulsions directionnelles aux nouilles. Utilisez un hybride visuellement sophistiqué de design d’affiche sérigraphiée vintage et d’animation procédurale de lignes. Un arrière-plan indigo profond doit dominer, ponctué de chaleur localisée rappelant le feu d’un réchaud autour des bols et des points de collision. Utilisez des tons directs superposés — rouge vermillon, jaune gingembre, vert cébette, crème chaude et presque noir — avec des textures en demi-teinte, des bords d’encre rugueux, un léger défaut de repérage des couleurs, des ombres graphiques marquées et des lignes de contour animées. Le résultat doit sembler artisanal et théâtral plutôt que brillant ou photoréaliste. Incluez une vapeur ambiante subtile, la lueur vacillante du réchaud, un grain flottant et un dessin linéaire en mouvement, tout en préservant un contraste fort et des commandes lisibles. Évitez le style cyberpunk néon générique. Rendez la composition responsive sur les grands écrans, les tablettes et les mobiles ; il s’agit d’une page web, ne forcez donc pas un format fixe 16:9. Adaptez fluidement la position des bols, la typographie, les commandes, les limites de la simulation et les zones tactiles sans recadrer le contenu essentiel. Utilisez les événements de pointeur pour unifier la gestion de la souris, du stylet et du toucher. Empêchez le défilement de la page uniquement lorsque les nouilles sont manipulées activement. Respectez prefers-reduced-motion en réduisant l’animation ambiante tout en conservant l’interaction principale. Maintenez de bonnes performances grâce à un regroupement efficace des particules ou à des limites strictes, requestAnimationFrame, un rendu tenant compte du device-pixel-ratio avec un plafond de résolution raisonnable et une gestion des coordonnées sûre lors du redimensionnement. Exigences de contenu et de finition : incluez un traitement de titre atmosphérique, une courte invitation à interagir sur une seule ligne, au moins trois bols accompagnés de libellés, plusieurs garnitures visuellement distinctes, des mots sonores manuscrits contextuels, des états de commande soignés, des styles de focus clairs, des libellés de boutons accessibles et une indication d’interaction discrète qui s’estompe après la première utilisation. La scène d’ouverture doit déjà ressembler à une affiche de collection terminée avant toute interaction, tandis que l’état actif doit devenir un jouet rythmique vivant, avec des retours superposés et des mouvements émergents surprenants. Contraintes négatives : aucune ressource ou dépendance externe ; aucune URL d’image ; aucun fichier audio préenregistré ; aucun framework ; aucun espace réservé inachevé ; aucun commentaire TODO ; aucune commande défaillante ; aucun canvas fixe au format 16:9 ; aucune interface utilisateur par défaut ; aucun arrière-plan générique composé uniquement d’un dégradé ; aucun émoji utilisé comme élément graphique principal ; aucun texte explicatif excessif ; aucun audio en lecture automatique ; aucune croissance incontrôlée des particules ; aucune physique fragile qui explose ou produit des valeurs NaN ; aucune interaction fonctionnant uniquement avec une souris ; et aucune sortie en dehors du document HTML complet et unique.
Generated with GPT 6 Astra on Atlas Cloud
Generated with Gemini 3.1 Pro Preview on Atlas Cloud
Generated with GPT 5.6 Sol on Atlas Cloud
GPT 6 Astra transforme le raisonnement avancé, la navigation web, l’utilisation d’un ordinateur, l’ingénierie logicielle, l’analyse multimodale et les longs contextes en workflows pratiques pour les développeurs, les chercheurs, les équipes de sécurité et les professionnels du savoir.

GPT 6 Astra prend en charge les tâches d’utilisation d’un ordinateur et de navigation web qui nécessitent plusieurs étapes coordonnées. Déployez-le pour les opérations via navigateur, la collecte d’informations et les workflows numériques dans lesquels un agent doit passer de l’instruction à l’exécution complète.

Au sein de bases de code existantes, GPT 6 Astra peut accompagner les tâches complexes d’ingénierie logicielle. Les développeurs peuvent l’utiliser pour examiner le contexte, déboguer les problèmes, implémenter des modifications et vérifier les résultats avant de les intégrer aux workflows de production.

Transformez de vastes ensembles de sources en recherches structurées grâce aux capacités de navigation web et de long contexte de GPT 6 Astra. Les analystes peuvent comparer les éléments de preuve, conserver le contexte global du projet et produire des conclusions claires pour éclairer les décisions.

Lorsque les travaux de sécurité exigent un raisonnement rigoureux, GPT 6 Astra peut examiner le code, les configurations et les éléments techniques. Utilisez ses résultats pour faciliter la revue des vulnérabilités, la planification des remédiations et les transmissions documentées aux équipes de sécurité.

Les équipes scientifiques peuvent appliquer GPT 6 Astra à des analyses exigeantes combinant texte, images et vaste contexte. Il aide les chercheurs à organiser les observations, à tester différentes pistes de raisonnement et à rédiger des livrables soumis à la validation d’experts.

Réunissez des documents volumineux, des références visuelles et des dossiers de projet au sein d’un même workflow professionnel. Avec GPT 6 Astra, les équipes peuvent mettre en cohérence ces éléments et préparer des rapports, des notes de synthèse ou des décisions tout en préservant le contexte environnant.
Comparez GPT 6 Astra aux principaux modèles multimodaux disponibles sur Atlas Cloud selon les types d’entrée pris en charge, la capacité de contexte, la limite de sortie et la tarification standard des tokens.
| Modèle | Types d’entrée | Fenêtre de contexte | Sortie maximale | Prix standard pour 1 million de tokens |
|---|---|---|---|---|
| GPT 6 Astra | Texte, image | 1,050,000 tokens | 131,072 tokens | $10 en entrée / $50 en sortie ; au-delà d’un prompt de 272K : $20 en entrée / $75 en sortie |
| GPT 6 Astra Codex | Texte, image | 1,050,000 tokens | 131,072 tokens | $10 en entrée / $50 en sortie ; au-delà d’un prompt de 272K : $20 en entrée / $75 en sortie |
| Gemini 3.1 Pro Preview | Texte, image, vidéo | 1,000,000 tokens | 64,000 tokens | $2 en entrée / $12 en sortie ; au-delà d’un prompt de 200K : $4 en entrée / $18 en sortie |
| Grok 4.6 | Texte, image | 500,000 tokens | 500,000 tokens | $2 en entrée / $6 en sortie ; au-delà d’un prompt de 200K : $4 en entrée / $12 en sortie |
| Kimi K3 | Texte, image, vidéo | 1,048,576 tokens | 1,048,576 tokens | $3 en entrée / $15 en sortie |
Soyez opérationnel en quelques minutes — suivez ces étapes simples pour intégrer et déployer des modèles via la plateforme Atlas Cloud.
Inscrivez-vous sur atlascloud.ai et complétez la vérification. Les nouveaux utilisateurs reçoivent des crédits gratuits pour explorer la plateforme et tester les modèles.
Combiner les modèles GPT 6 Astra avancés avec la plateforme accélérée par GPU d'Atlas Cloud offre des performances, une évolutivité et une expérience développeur inégalées.
Faible Latence :
Inférence optimisée par GPU pour un raisonnement en temps réel.
API Unifiée :
Exécutez GPT 6 Astra, GPT, Gemini et DeepSeek avec une seule intégration.
Tarification Transparente :
Facturation prévisible par token avec options serverless.
Expérience Développeur :
SDK, analytiques, outils de fine-tuning et modèles.
Fiabilité :
99,99% de disponibilité, RBAC et journalisation conforme.
Sécurité et Conformité :
SOC 2 Type II, alignement HIPAA, souveraineté des données aux États-Unis.
GPT-6 Astra est le modèle de pointe d’OpenAI pour les tâches exigeantes de contrôle informatique, de navigation web, d’ingénierie logicielle, de cybersécurité, de recherche scientifique et de travail professionnel. Atlas Cloud fournit un accès à l’usage à GPT 6 Astra et GPT 6 Astra Codex via une seule clé compatible avec OpenAI.
Conçu pour les tâches complexes, Astra prend en charge le raisonnement, le code, la navigation web, le contrôle informatique, la recherche et l’analyse de contextes longs. Il accepte des entrées textuelles et des images, et produit du texte pour les workflows agentiques, la création de documents et d’autres tâches professionnelles exigeantes.
Pointez un client compatible avec OpenAI vers le endpoint Atlas Cloud, ajoutez votre clé API Atlas, puis sélectionnez openai/gpt-6-astra ou openai/gpt-6-astra-codex. Atlas Cloud propose cette famille via le protocole Chat Completions, ce qui permet de conserver des structures de requête et de réponse familières.
Atlas Cloud prend en charge les entrées textuelles et les images, avec une sortie textuelle. La fenêtre de contexte indiquée est de 1,050,000 tokens, la sortie maximale est de 131,072 tokens et la date de coupure des connaissances est le 30 avril 2026.
Oui. Le streaming est pris en charge et l’effort de raisonnement peut être défini sur low, medium, high, xhigh ou max. Les niveaux inférieurs privilégient la rapidité et une consommation réduite de tokens, tandis que les niveaux supérieurs permettent un raisonnement plus approfondi pour les tâches difficiles.
Le tarif standard est de 10 $ par million de tokens d’entrée et de 50 $ par million de tokens de sortie. Les tokens d’entrée mis en cache coûtent 1 $ par million, tandis que la création du cache coûte 12,50 $ par million. Pour les prompts de plus de 272,000 tokens, les tarifs correspondants sont de 20 $, 75 $, 2 $ et 25 $ par million de tokens.
Commencez avec un effort de raisonnement low ou medium et mesurez la consommation de tokens sur des tâches représentatives avant d’augmenter le niveau. La mise en cache des prompts peut réduire le coût des entrées réutilisables, tandis qu’un modèle moins coûteux peut être plus adapté aux requêtes courantes ou à fort volume.
Atlas Cloud répertorie deux identifiants de modèle distincts : openai/gpt-6-astra et openai/gpt-6-astra-codex. Tous deux utilisent la même grille tarifaire vérifiée, mais les informations disponibles côté backend n’établissent aucune différence quantifiée en matière de capacités ou de latence. Évaluez-les tous deux sur vos propres charges de travail de programmation et générales avant de choisir une valeur par défaut pour la production.
Choisissez Astra pour les tâches difficiles où la qualité est prioritaire, notamment le contrôle informatique agentique, l’ingénierie logicielle complexe, l’analyse de contextes longs et les tâches scientifiques ou professionnelles exigeantes. Pour les requêtes courantes, le trafic à fort volume ou les workflows où la latence est importante, comparez un modèle plus petit en fonction du taux de réussite et du coût total.
L'API Seedance 2.5 est désormais disponible sur Atlas Cloud ! Elle offre aux développeurs le tout dernier modèle vidéo de ByteDance. Il génère jusqu'à 30 secondes de vidéo native en un seul passage à partir de texte, d'une seule image ou de jusqu'à 50 références multimodales, avec un son synchronisé et du texte multilingue dans le cadre. Sur Atlas Cloud, vous y accédez via une clé unique, la cohérence du sujet et la physique améliorée maintenant la fluidité des plans longs.

L'API Wan 3.0 est la nouvelle génération de la famille vidéo Wan d'Alibaba, conçue pour repousser les limites de la génération de formats longs, du contrôle multi-références et de la qualité audiovisuelle à de nouveaux sommets. Atlas Cloud héberge déjà Wan 2.7, 2.6 et 2.5, et Wan 3.0 fonctionne sur la même clé unifiée sans configuration distincte. Commencez à créer dès aujourd'hui. Faites défiler vers le bas jusqu'à la vitrine pour découvrir ce que Wan 3.0 peut créer.
MiniMax H3 est la famille vidéo multimodale de MiniMax, conçue pour la création guidée par du texte, des images et des références. Sur les routes prises en charge, elle préserve les sujets des médias de référence, offre des rapports d’aspect flexibles et associe un son généré aux visuels via H3 Developer, avec des profils de sortie sélectionnés par endpoint. Atlas Cloud unifie cette famille derrière une seule clé compatible avec OpenAI, avec une tarification transparente à l’usage à partir du tarif standard de 0,038 $ par seconde. Commencez à développer dès aujourd’hui.
La famille gpt-image-2.5 d’OpenAI offre aux développeurs le choix entre Flare et Sunburst pour leurs workflows de génération d’images en production. Générez des images à des résolutions arbitraires allant jusqu’à 3840x2160 et choisissez parmi cinq niveaux de qualité, dont xhigh et max, pour répondre à des exigences de sortie spécifiques. Atlas Cloud fournit une inférence REST prête à l’emploi, sans démarrage à froid, avec une tarification standard à partir de $0.004 par génération. Commencez à développer dès aujourd’hui.
L'API Seedream 5.0 Pro offre aux développeurs le modèle d'édition d'images contrôlable de ByteDance sur Atlas Cloud. Elle positionne les modifications avec précision à l'aide d'ancrages et de coordonnées, sépare les images en calques modifiables, fusionne de multiples références et fait correspondre les couleurs et matériaux exacts, avec du texte multilingue en 2K et 3K. Sur Atlas Cloud, vous y accédez via une seule clé !
Seedance 2.0 est le modèle vidéo de production de ByteDance pour créer des plans avec précision. Transformez vos prompts en vidéos, animez une image de première image avec un guidage facultatif par la dernière image, ou façonnez vos résultats à l’aide de médias de référence et d’une recherche web facultative. Atlas Cloud regroupe ces workflows dans une API unifiée, avec une tarification transparente à l’usage et une clé compatible avec OpenAI. Commencez à développer dès aujourd’hui.
L'API Kling 3.0 apporte la suite vidéo phare de Kuaishou sur Atlas Cloud via une clé compatible avec OpenAI. Elle englobe deux modèles : Kling 3.0 pour la narration AI Director, la synchronisation labiale multilingue et le texte à l'écran précis, et Kling 3.0 Omni (O3) pour le clonage de sujet et de voix à partir d'une courte vidéo ou d'une image. Les deux génèrent un son natif lors du même passage, avec une sortie allant jusqu'à 4K. Créez des récits cinématographiques, du marketing mondial, des publicités multilingues et du contenu de personnages en série sur une infrastructure fiable.
Grok Imagine Video donne aux développeurs accès à la famille de modèles vidéo de xAI pour créer, animer, prolonger et retoucher des clips. Générez des vidéos de 1 à 15 secondes à partir de prompts, guidez des personnes, des objets ou des styles avec jusqu'à sept images de référence, et travaillez en 480p ou 720p. Atlas Cloud réunit ces fonctionnalités via des points de terminaison compatibles avec OpenAI, avec une tarification transparente à l'usage. Commencez à créer dès aujourd'hui.
Vidu Q4 est le dernier modèle vidéo phare de Vidu, conçu pour la génération image-to-video et reference-to-video. Il peut animer une seule image fixe et créer automatiquement des transitions entre les scènes, offrant ainsi aux développeurs deux modes d’entrée pour différents flux de produits. Atlas Cloud fournit des points de terminaison API dédiés, avec des schémas de paramètres publiés, au tarif standard vérifié de $0.04 par seconde. Commencez dès aujourd’hui à développer.
Gemini Omni 1.1 Flash est la famille vidéo nativement multimodale de Google DeepMind, conçue pour des workflows de production flexibles. Modifiez des séquences existantes à l’aide d’instructions textuelles, préservez la cohérence visuelle avec jusqu’à 10 images de référence et 3 clips vidéo, ou prolongez un plan par segments enchaînables jusqu’à 40 secondes. Accédez à tous les workflows sur Atlas Cloud avec une seule clé API compatible OpenAI, une tarification à l’usage et une disponibilité dès le Day-0. Commencez à développer dès aujourd’hui.
Nano Banana 2.1 is Google's image model family built on Gemini 3.6 Flash. It delivers Pro-level generation and editing at Flash-level speed, supports natural-language edits and merges across 1 to 14 input images, and maintains consistency for up to 4 characters and 10 objects. Through Atlas Cloud, developers can access the family with one OpenAI-compatible key, reliable uptime, and Day-0 availability. Start building today.
Créez avec l'API Nano Banana 2, propulsée par le modèle Gemini 3.1 Flash Image de Google. Elle génère des visuels 4K natifs jusqu'à 4096x2304 avec un rendu de texte précis et des personnages cohérents sur un maximum de 14 images de référence pour la génération et l'édition. Sur Atlas Cloud, vous y accédez via une API unifiée aux côtés de plus de 300 modèles, avec des tarifs à partir de 0,04 $ par image, une disponibilité de 99,99 % et des crédits gratuits pour commencer.
Guides, tutoriels et actualités produit pour tirer le meilleur d'Atlas Cloud.



