Kling 4.0 अब Atlas Cloud पर उपलब्ध — 30 सेकंड का नेटिव वीडियो

AI अवतार जनरेटर जो फ़ोटो से आपकी ऑडियो बुलवाता है

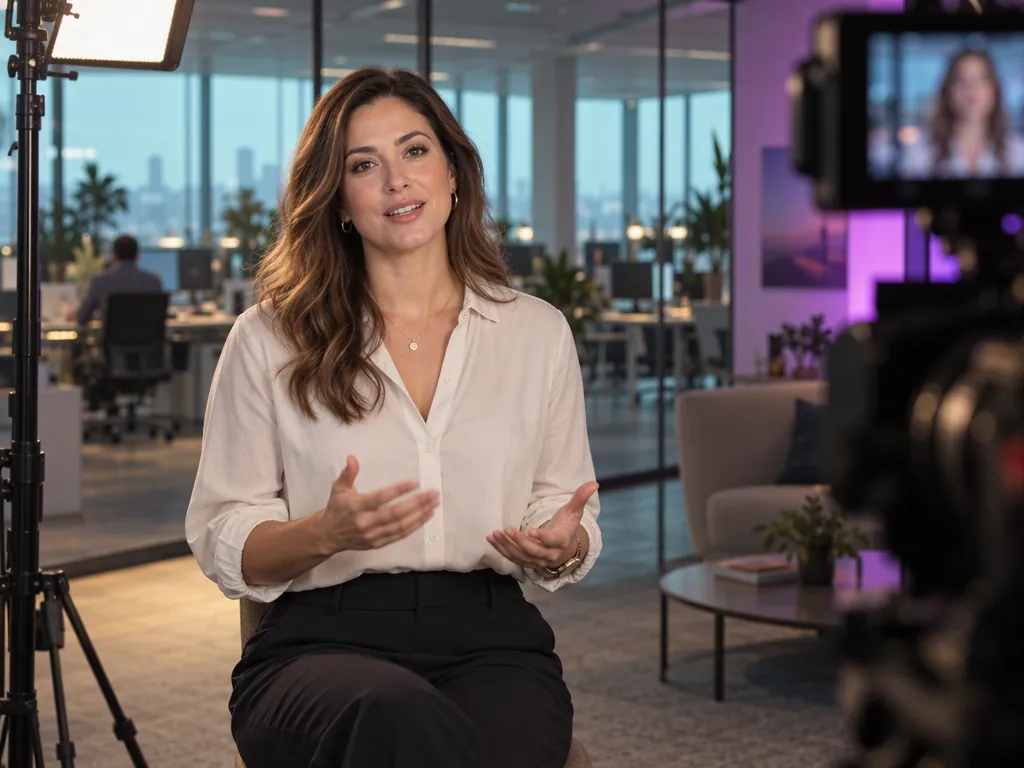
एक पोर्ट्रेट और एक ऑडियो फ़ाइल अपलोड कीजिए। ऑडियो टू वीडियो मॉडल चेहरे को ऐसे एनिमेट करते हैं कि होंठ और भाव रिकॉर्डिंग के साथ चलें, और बोलता हुआ वीडियो डाउनलोड के लिए तैयार मिलता है।

एक ही पोर्ट्रेट से AI अवतार वीडियो

छोटी भावपूर्ण क्लिप हों या दस मिनट के एक्सप्लेनर — दोनों उन्हीं दो इनपुट से।

AI टॉकिंग अवतार जनरेटर

सामने से लिया गया पोर्ट्रेट और MP3 या WAV अपलोड कीजिए। Avatar Omni Human 1.5 उसी व्यक्ति का वीडियो लौटाता है जो ट्रैक बोल या गा रहा हो, जिसमें लिप सिंक, भाव और हाव-भाव सीधे ऑडियो से बनते हैं। आउटपुट 720p या 1080p में मिलता है।

क्लिप 60 सेकंड तक जा सकती है, और 15 सेकंड या उससे कम सबसे साफ़ नतीजा देता है। सीन, एक्शन या भाव को दिशा देने के लिए चाहें तो प्रॉम्प्ट जोड़िए — यह चीनी, अंग्रेज़ी, जापानी, कोरियाई, स्पेनिश और इंडोनेशियाई पढ़ लेता है।

लंबी रिकॉर्डिंग के लिए लिप सिंक AI

जब स्क्रिप्ट छोटी सोशल क्लिप नहीं बल्कि पूरा लेक्चर हो, तब InfiniteTalk वही पोर्ट्रेट और 10 मिनट तक की ऑडियो लेता है। पूरी रिकॉर्डिंग में लिप सिंक ध्वनि-स्तर पर टिका रहता है, और चेहरा, हेयरस्टाइल, कपड़े व बैकग्राउंड शुरू से आख़िर तक एक जैसे रहते हैं। आउटपुट 480p या 720p में मिलता है।

नैरेशन Audio टैब में बनाइए और फ़ाइल यहाँ ले आइए, फिर प्रॉम्प्ट से भाव और मुद्रा सेट कीजिए। इस तरह कोर्स मॉड्यूल या प्रोडक्ट वॉकथ्रू बिना कैमरा और प्रेज़ेंटर बुक किए तैयार हो जाता है।

AI अवतार मॉडल, एक ही जगह

अलग-अलग लंबाई के लिए दो मॉडल। छोटी, भावपूर्ण और 1080p तक की क्लिप के लिए Avatar Omni Human 1.5 चुनिए, और ऑडियो लंबी हो तो InfiniteTalk।

तीन स्टेप में AI अवतार वीडियो कैसे बनाएँ

1

फ़ोटो अपलोड कीजिए

एक ही व्यक्ति की साफ़, सामने से ली गई फ़ोटो इस्तेमाल कीजिए। सादा बैकग्राउंड और बिना ढका चेहरा मॉडल को सबसे ज़्यादा जानकारी देते हैं।

2

ऑडियो जोड़िए

MP3 या WAV जोड़िए: अपनी रिकॉर्डिंग या Audio टैब में बनाई गई स्पीच।

3

जनरेट कीजिए, फिर डाउनलोड कीजिए

मॉडल और रेज़ॉल्यूशन चुनिए, जनरेट कीजिए और तैयार क्लिप डाउनलोड कीजिए।

टॉकिंग अवतार से क्या-क्या बना सकते हैं?

अपने काम से मिलता-जुलता टैब चुनिए और देखिए कि टॉकिंग अवतार कहाँ शूट की जगह ले लेता है।

हर बाज़ार के लिए AI प्रवक्ता क्लिप

एक पोर्ट्रेट, कई भाषाएँ। हर भाषा में स्क्रिप्ट रिकॉर्ड या जनरेट कीजिए, वही चेहरा मॉडल से चलाइए, और किसी को कहीं भेजे बिना कैंपेन को हर जगह एक ही प्रेज़ेंटर मिल जाता है।

स्टूडियो के बिना टॉकिंग हेड लेसन

दस मिनट की लेक्चर रिकॉर्डिंग को InfiniteTalk से वीडियो में बदलिए। पूरे मॉड्यूल में शिक्षक स्क्रीन पर दिखते हैं, और लेसन अपडेट करने का मतलब है सिर्फ़ ऑडियो बदलना, दोबारा शूट नहीं।

AI अवतार वाले प्रोडक्ट एक्सप्लेनर

हर प्रोडक्ट को एक प्रेज़ेंटर दीजिए। Audio टैब की लिस्टिंग स्क्रिप्ट को ब्रांड पर्सोना के पोर्ट्रेट के साथ जोड़िए, और वॉकथ्रू वीडियो प्रोडक्ट पेज या UGC-स्टाइल ऐड के लिए तैयार है।

दोबारा शूट किए बिना अपडेट होने वाले ऑनबोर्डिंग वीडियो

पॉलिसी वॉकथ्रू एक बार ऑडियो में रिकॉर्ड कीजिए और InfiniteTalk से उसे एक जैसा प्रेज़ेंटर दीजिए, जो लंबी रिकॉर्डिंग में भी लिप सिंक बनाए रखता है। कोई प्रक्रिया बदले तो बस ऑडियो फ़ाइल बदलिए और वही चेहरा नया वर्ज़न सुना देगा।

आपके अवतार के आसपास Atlas Cloud के और AI टूल

अक्सर पूछे जाने वाले सवाल

AI अवतार जनरेटर एक ऑडियो टू वीडियो AI है: यह स्थिर पोर्ट्रेट को ऐसे एनिमेट करता है कि वह दी गई ऑडियो बोलता दिखे। आप एक फ़ोटो और एक ऑडियो फ़ाइल अपलोड करते हैं, मॉडल आवाज़ से होंठों की हरकत, भाव और हाव-भाव बनाता है, और आपको उस व्यक्ति के बोलते हुए का वीडियो मिलता है।

Atlas Cloud पर ByteDance का Avatar Omni Human 1.5 और InfiniteTalk मिलते हैं। दोनों पोर्ट्रेट के साथ ऑडियो लेते हैं और मुख्य फ़र्क़ क्लिप की लंबाई और रेज़ॉल्यूशन का है।

Avatar Omni Human 1.5 60 सेकंड तक की क्लिप बनाता है, और 15 सेकंड या उससे कम की सलाह दी जाती है। InfiniteTalk एक बार में 10 मिनट तक की ऑडियो लेता है।

Avatar Omni Human 1.5 का आउटपुट 720p या 1080p होता है। InfiniteTalk का आउटपुट 480p या 720p होता है।

एक ही व्यक्ति का सामने से लिया गया पोर्ट्रेट जिसमें चेहरा साफ़ दिखे। दोनों मॉडल एक क्लिप में एक ही बोलने वाले के लिए बने हैं।

हाँ। Avatar Omni Human 1.5 बोलने और गाने, दोनों के लिए बना है और हाव-भाव व भाव किसी स्क्रिप्ट से नहीं, सीधे ऑडियो से बनाता है।

Avatar Omni Human 1.5 जिन भाषाओं में काम करता है उनमें चीनी, अंग्रेज़ी, जापानी, कोरियाई, स्पेनिश और इंडोनेशियाई शामिल हैं। लिप सिंक ऑडियो के हिसाब से चलता है, इसलिए असल बात रिकॉर्डिंग की भाषा है।

हाँ। टेक्स्ट टू स्पीच मॉडल से नैरेशन बनाइए, फ़ाइल डाउनलोड कीजिए और यहाँ ऑडियो इनपुट के तौर पर जोड़ दीजिए। अवतार जनरेट की गई आवाज़ के साथ भी उतनी ही सटीक लिप सिंक करता है जितनी असली रिकॉर्डिंग के साथ।

हाँ। दोनों मॉडल Atlas Cloud API से उपलब्ध हैं, वही ऑथेंटिकेशन जो इमेज और वीडियो मॉडल के लिए है। बनाना शुरू करने के लिए अवतार मॉडल पेज देखिए।

AI अवतार वीडियो गाइड

पोर्ट्रेट की तैयारी, ऑडियो की लंबाई और भाषा टेस्ट।

एक पोर्ट्रेट से शुरू कीजिए। बाक़ी बात उसे करने दीजिए।