Un report verde sui test API sembra rassicurante finché non ti accorgi che ogni asserzione controlla solo HTTP 200. La risposta potrebbe contenere il record del cliente sbagliato e comunque passare.
Scegli strumenti AI per il test delle API in base al lavoro che già svolgi. Valuta Postman Agent Mode se il tuo team gestisce collezioni, KushoAI se una specifica è il tuo punto di partenza, e Keploy se hai bisogno di flussi generati o test di regressione creati dal traffico registrato. Esamina ed esegui i test risultanti prima di fidarti.
Questa guida copre l'assistenza AI per il test di API ordinarie. Testare l'accuratezza delle risposte di un modello AI è un problema di valutazione separato.
Punti chiave
- Fornisci il contratto, le dipendenze delle richieste e le aspettative aziendali approvate.
- Verifica se le asserzioni rifiutano dati errati, campi mancanti e tipi non corretti.
- Acquista solo dopo che i test revisionati vengono eseguiti ripetutamente nell'ambiente CI previsto.
La comparazione dei prodotti di seguito riflette la documentazione ufficiale verificata il 21 settembre 2026. Non è un benchmark testa a testa di tre account a pagamento.
L'esempio pratico utilizza una specifica Swagger Petstore bloccata e separa le aspettative contrattuali, il comportamento osservato e copie delle risposte deliberatamente modificate.
La nostra esecuzione locale ha superato 5 test live e rifiutato tutte e 3 le copie delle risposte deliberatamente modificate. Una sonda separata per il nome mancante ha comunque restituito 200, dimostrando perché l'ambito di un report verde è importante.
Cosa fanno realmente gli strumenti AI per il test delle API
L'assistenza AI di solito entra in quattro parti del test delle API. Un modello legge la tua specifica, propone scenari, redige asserzioni e aiuta a spiegare i fallimenti. Ogni parte richiede prove diverse. Una spiegazione plausibile di un fallimento non stabilisce che la correzione proposta sia corretta.
Per la revisione della specifica, fornisci il file OpenAPI e le regole aziendali rilevanti. Per la pianificazione degli scenari, aggiungi esempi di dati validi e limiti noti. Per gli script eseguibili, includi il tuo runner, la configurazione di autenticazione e le convenzioni delle fixture. Per la diagnosi, fornisci la richiesta, la risposta e il messaggio di errore effettivi dopo aver rimosso i segreti.
Mantieni separati questi quattro meccanismi quando valuti i prodotti:
- Generazione LLM: propone test da linguaggio, schemi ed esempi. Un revisore deve controllare i risultati attesi.
- Riproduzione del traffico: confronta il comportamento successivo con le interazioni catturate, spesso utilizzando risposte delle dipendenze registrate.
- Test basato su proprietà: costruisce sistematicamente input per mettere alla prova proprietà come la conformità allo schema.
- Esecuzione dei test: invia richieste, valuta le asserzioni e restituisce report e codici di uscita.
Un prodotto può combinare diversi meccanismi. Chiedi quale meccanismo ha prodotto ciascun test e cosa determina il suo risultato atteso. Registrare una risposta errata può preservare lo stesso errore come baseline di regressione. Generare un nome di test ben curato può mascherare un'aspettativa non supportata.
Pensa alle asserzioni su tre livelli. Primo, il server ha risposto con successo? Secondo, il corpo ha i campi e i tipi documentati? Terzo, questo corpo rappresenta la risorsa e l'operazione che hai richiesto?
Per una ricerca di un animale domestico, un oggetto valido con un ID intero fallisce comunque il terzo controllo se quell'ID appartiene a un altro animale. Al contrario, la corrispondenza con l'ID richiesto non prova che ogni campo soddisfi lo schema. Usa entrambi i controlli e aggiungi regole aziendali solo dove il team ha una fonte concordata per esse.
L'output pratico che desideri è un asset di test manutenibile con un oracolo spiegabile: una ragione chiara per cui ogni risultato dovrebbe passare o fallire. Conta gli scenari utili dopo la revisione, compresi quelli che rifiuti, invece di celebrare la lunghezza dell'elenco generato inizialmente.
Strumenti AI per il test delle API confrontati per flusso di lavoro
Inizia con l'artefatto che il tuo team può fornire oggi. Migrare una collezione consolidata, ricostruire regole aziendali mancanti e configurare la registrazione delle dipendenze sono progetti diversi. Uno strumento adatto a un punto di partenza può creare lavoro extra in un altro.
| Strumento o approccio | Input utile | Ruolo dell'AI o dell'automazione | Percorso di esecuzione e CI | Output revisionabile | Domanda principale di prova |
|---|---|---|---|---|---|
| Postman Agent Mode | Collezioni, richieste, risposte, ambienti, specifiche | Redige e modifica script di test nel contesto del workspace | Collection Runner e flusso di lavoro CLI compatibile | Asserzioni JavaScript standard di Postman | Preserva le tue variabili e testa il contratto? |
| KushoAI | OpenAPI, collezione Postman, cURL | Genera scenari e suite di test; supporta il perfezionamento in linguaggio naturale | Esecuzione sulla piattaforma e integrazione CI documentata; verifica l'abilitazione | Ispeziona richieste, dipendenze e risultati attesi generati | Il piano selezionato può eseguire e conservare la suite dove ti serve? |
| Keploy | Specifiche o definizioni di richieste; in alternativa traffico reale | Generazione AI e un percorso separato di registrazione/riproduzione | Flussi generati o test registrati in ambienti locali/CI supportati | Esamina definizioni di test, baseline e mock delle dipendenze | Quale percorso copre i tuoi effettivi modelli di fallimento? |
| Runner esistente più un LLM | Matrice approvata, specifiche, convenzioni delle fixture | Redige codice per la revisione | Il tuo pytest o altro runner consolidato | Codice committato nel tuo repository | La revisione è più economica che scrivere gli stessi test direttamente? |
Postman Agent Mode per collezioni esistenti
Postman è una prima valutazione ragionevole quando la tua collezione contiene già un ordine utile delle richieste, variabili d'ambiente e configurazione dell'autenticazione. Agent Mode può usare quel contesto per generare script di test JavaScript standard. Quegli script possono entrare nel flusso di esecuzione della collezione esistente invece di richiedere un nuovo linguaggio di asserzione.
Una prova mirata è più rivelatrice che chiedergli di testare tutto. Seleziona la richiesta che recupera una risorsa creata in precedenza nella collezione. Fornisci il suo schema e chiedi la validazione dei campi obbligatori, i tipi di campo documentati e un'asserzione che colleghi l'ID restituito all'ID di creazione memorizzato.
Poi esamina le modifiche proposte prima di accettarle. Un esempio di risposta potrebbe contenere un animale chiamato Milo. L'uguaglianza con Milo è significativa se la tua fixture ha creato esplicitamente Milo; è fragile se il generatore ha copiato un nome da un record di esempio condiviso. Lo stesso letterale può essere un'asserzione valida o una dipendenza accidentale, a seconda della sua origine.
Controlla attentamente l'ambito delle variabili. Un ID memorizzato in una variabile d'ambiente deve essere disponibile per la richiesta successiva e deve appartenere a quella esecuzione. Variabili condivise tra esecuzioni concorrenti possono creare fallimenti intermittenti che assomigliano a difetti del server. Chiedi al generatore di spiegare l'installazione e la pulizia oltre alle asserzioni.
Per il primo test di accettazione, esegui la collezione due volte su dati isolati, poi esamina la rappresentazione esportata o versionata. Conferma che un collega possa rivedere gli script modificati senza ripetere la conversazione con l'AI. Verifica anche che la CLI, il reporter e il piano scelti supportino il percorso di esecuzione che intendi utilizzare.
Nessuna generazione Postman operata è presentata qui. La domanda di valutazione utile è se il suo contesto di workspace riduce il tuo lavoro di revisione su una collezione esistente. Ciò richiede la tua collezione e una prova a livello di account, non una conclusione tratta da uno screenshot del prodotto.
KushoAI per la generazione di test basata su specifiche
KushoAI accetta input Swagger/OpenAPI, Postman e cURL e documenta la generazione di test, il perfezionamento in linguaggio naturale e l'esecuzione CI. Ciò lo rende un candidato quando un team ha definizioni API utili ma un arretrato di test non scritti. Queste sono capacità descritte dal fornitore, non risultati misurati di rilevamento dei difetti. (Documentazione KushoAI, settembre 2026)
Scegli l'input con il contesto più ricco e affidabile. Una richiesta cURL può descrivere una richiesta valida, ma di solito dice poco su campi opzionali, valori enum consentiti o errori documentati. Un file OpenAPI aggiunge struttura; una matrice di scenari approvata aggiunge l'intento che la struttura potrebbe lasciare ambiguo.
Per una prova Petstore, chiedi casi separati per un animale valido, un nome obbligatorio mancante, un ID con il tipo sbagliato e un filtro di stato non valido. Verifica se lo strumento distingue i requisiti del corpo della richiesta dai requisiti dello schema della risposta. Questi possono sembrare simili in un esempio pur imponendo obblighi diversi.
Successivamente, esamina un flusso connesso di creazione-lettura-aggiornamento. La lettura deve usare l'ID associato alla configurazione corrente. L'aggiornamento deve puntare alla stessa risorsa e una lettura successiva deve verificare il campo modificato. Quattro richieste indipendenti con nomi di test accattivanti non stabiliscono che la catena di dipendenze funzioni.
Tratta la prima generazione come una proposta. Mantieni le aspettative documentate, rivedi gli script con flusso di dati errato e segnala i risultati sotto-specificati per una decisione sui requisiti. Se lo strumento suggerisce diversi casi equivalenti di campo mancante, conserva le distinzioni utili invece di pagare per mantenere duplicati.
Prima di acquistare, chiedi di eseguire la suite dalla pipeline prevista e ispeziona l'artefatto di fallimento. Conferma i permessi CI attuali, la gestione delle credenziali e i formati di esportazione disponibili sul piano selezionato. Non presumere che una prova interattiva gratuita conceda gli stessi diritti di automazione di una distribuzione team.
Keploy per test generati e riproduzione del traffico
La documentazione di Keploy presenta due percorsi di partenza distinti. La generazione AI accetta risorse come OpenAPI, Postman, cURL o endpoint e costruisce flussi API connessi. Registra e riproduci cattura le interazioni API e le loro dipendenze per un'esecuzione successiva con mock. La descrizione del flusso AI e la descrizione della registrazione delle dipendenze non dovrebbero essere trattate come meccanismi identici. (Documentazione Keploy, settembre 2026)
Se la tua difficoltà è riprodurre ciò che un'applicazione ha fatto con un database o un servizio upstream, valuta il percorso di registrazione. Cattura un piccolo percorso di creazione-lettura-aggiornamento in un ambiente isolato, ispeziona le dipendenze catturate e riproduci dopo una modifica controllata dell'applicazione. Controlla cosa supporta il runtime prima di pianificare un rollout più ampio.
Se la tua difficoltà è derivare casi da una specifica, valuta separatamente il percorso di generazione. Chiedi come le sue richieste proposte ottengono le credenziali, trasportano gli ID tra i passaggi e puliscono i dati. La presenza di funzionalità di registrazione altrove nel prodotto non risponde a queste domande per una suite generata.
I valori dinamici richiedono giudizio. Un timestamp può variare legittimamente; un ID di risorsa può collegare due richieste e quindi richiedere un confronto. Ignorare in modo generalizzato ogni campo che cambia può nascondere errori. Rivedi le esclusioni campo per campo e conserva i confronti che esprimono relazioni significative.
Inoltre, ispeziona la baseline prima di accettarla. Una registrazione che contiene il totale sbagliato, una risposta di fallback accidentale o dati obsoleti può essere riprodotta in modo coerente. La coerenza aiuta a rilevare i cambiamenti, ma il team decide comunque se il comportamento catturato era corretto.
Un supplemento utile: Schemathesis fornisce test API basati su proprietà guidati da schema. Può mettere alla prova un'API con input generati insieme a esempi revisionati. Trattalo come un meccanismo di test diverso, non come sinonimo di un generatore di test LLM. I suoi risultati necessitano comunque di interpretazione rispetto al contratto e all'implementazione.
Strumenti AI gratuiti per il test delle API: limiti e costi
“Gratuito” può descrivere un client, una tolleranza AI limitata, un runner open source o una prova temporanea. Queste offerte coprono parti diverse del flusso di lavoro. Un client gratuito non stabilisce che anche la generazione automatica, l'esecuzione pianificata o l'esportazione dei report siano gratuite.
Come verificato il 21 settembre 2026, il piano Free di Postman elenca 50 crediti AI al mese. I crediti sono la sua unità di fatturazione; non significano 50 test o 50 suite complete. La sua tabella comparativa distingue la tolleranza AI dall'esecuzione, dalle funzionalità basate sui dati e dalle esportazioni dei risultati. (Prezzi Postman, settembre 2026)
L'attuale presentazione dei prezzi di KushoAI utilizza Developer Edition ed Enterprise. Keploy distingue Playground, Pro ed Enterprise, insieme alla sua offerta open source. Usa la schermata di acquisto corrente per confermare i limiti rilevanti. I vecchi elenchi di strumenti possono descrivere nomi di piani ritirati o combinare tolleranze fatturate separatamente.
| Componente di costo | Cosa registrare in una prova | Cosa può rendere fuorviante la bolletta |
|---|---|---|
| Posti e piano | Editor, revisori, intervallo di fatturazione, funzionalità richieste | Confrontare i prezzi annuali di copertina con impegni mensili |
| Generazione AI | Utilizzo dei crediti per lo stesso compito approvato, incluse le riprove | Presumere che un credito equivalga a un test |
| Esecuzione | Esecuzioni locali, esecuzioni ospitate, job CI, pianificazioni, report | Trattare le esecuzioni interattive come permesso per ogni percorso di automazione |
| Modello indipendente | Token di input e output per la redazione e la revisione | Ignorare invii ripetuti di specifiche complete |
| Tempo di ingegneria | Revisione, riparazione delle fixture, triage dei fallimenti, manutenzione | Contare il tempo di generazione iniziale come tempo totale di consegna |
Usa un piccolo compito di accettazione per stimare i costi. Assegna a ciascun candidato le stesse operazioni e aspettative, poi registra quanti scenari sopravvivono alla revisione. Mantieni il tempo di generazione, il tempo di revisione pratica e il tempo di esecuzione in colonne separate. Attendere un modello e correggere un'asserzione pericolosa impongono costi diversi al team.
Un denominatore utile è rappresentato dagli scenari revisionati ed eseguibili che il tuo team manterrebbe. Impedisce che un generatore con molti casi ridondanti appaia più economico semplicemente perché il suo output è più lungo. Registra i casi non supportati che hai rimosso e i requisiti che rimangono irrisolti.
Questo articolo non rivendica una percentuale misurata di risparmio di manodopera né confronta la produttività dei piani a pagamento. Tali cifre richiedono una prova controllata con input equivalenti. Per una decisione di acquisto, includi una modifica di manutenzione realistica, come l'aggiunta di un campo obbligatorio, in modo che la stima copra anche lo sprint successivo oltre alla prima demo.
Strumenti AI per il test delle API: da OpenAPI alla prima esecuzione
Usa un'istanza locale isolata del progetto reale Swagger Petstore. Blocca il commit d57941e8fe959e508796b27469b1e8bba73392dc; la sua specifica dichiara OpenAPI 3.0.4 e versione dell'applicazione 1.0.29-SNAPSHOT. Leggi il file bloccato invece di una demo pubblica aggiornata in modo indipendente. (Specifica Swagger Petstore, settembre 2026)
1. Prepara il servizio e registra l'ambiente. Ottieni il repository tramite quella pagina di origine, estrai la revisione bloccata e installa un JDK e Maven compatibili. Il README del progetto fornisce questo comando di avvio dalla directory del repository:
plaintext1git checkout d57941e8fe959e508796b27469b1e8bba73392dc 2mvn package jetty:run
Jetty utilizza la porta 8080. Imposta BASE_URL sulla tua origine HTTP di loopback su quella porta con /api/v3 aggiunto. Conferma che /openapi.json sia leggibile rispetto a quella base prima di testare.
Questa esecuzione ha utilizzato Temurin JDK 17.0.20.1, Maven 3.9.9, Python 3.12, pytest 9.1.1 e jsonschema 4.26.0. Registra anche le tue versioni. La build dai sorgenti scarica dipendenze e Swagger UI, quindi un commit dell'applicazione bloccato da solo non è una build completamente ermetica.
2. Importa la specifica bloccata. Seleziona /pet, /pet/{petId} e /pet/findByStatus. Mantieni delete disponibile per la pulizia. Sovrascrivi la posizione del server pubblico della specifica con la tua base locale. Controlla questa impostazione prima di inviare qualsiasi richiesta di scrittura.
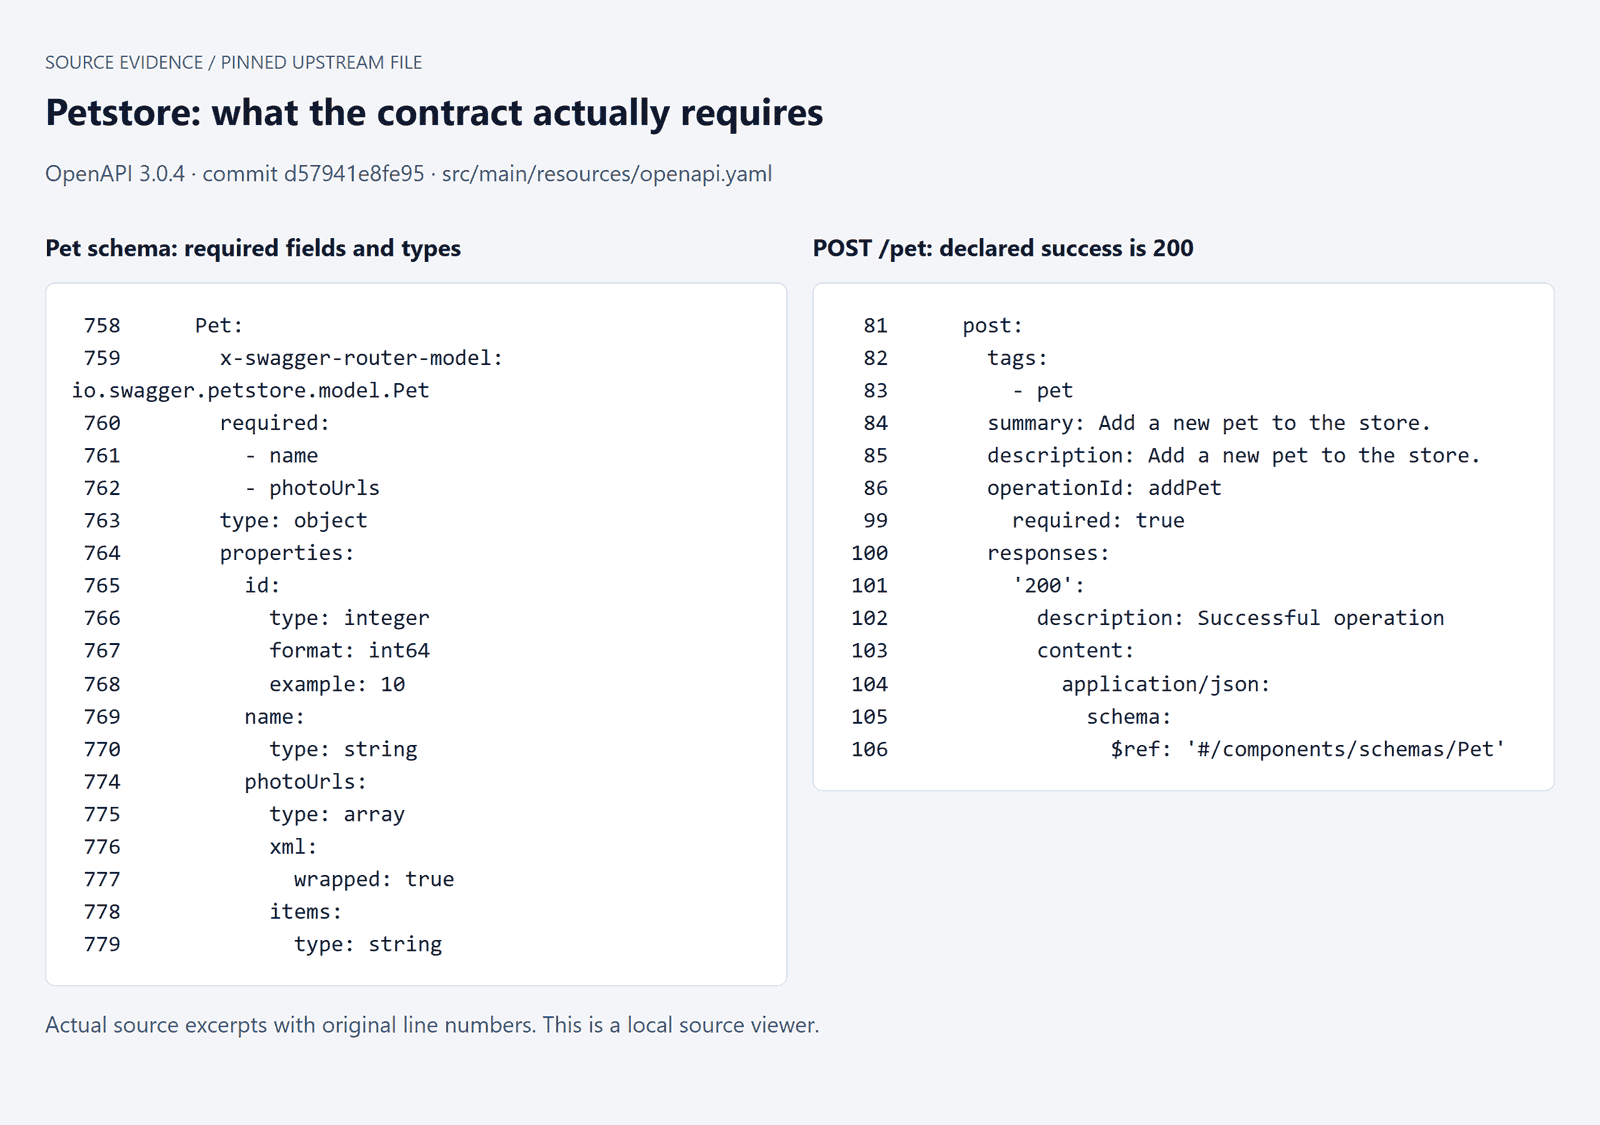 Fonte OpenAPI Petstore bloccata che mostra i campi obbligatori e le definizioni delle operazioni selezionate
Estratti reali del codice sorgente renderizzati localmente: Pet richiede name e photoUrls; POST /pet dichiara 200 per il successo. I numeri di riga originali sono preservati.
3. Genera una matrice prima del codice eseguibile (Prompt A). Allega la specifica e incolla questo prompt nel generatore scelto:
plaintext1Review the attached OpenAPI specification for API test planning. 2 3Scope: the operations on /pet, /pet/{petId}, and /pet/findByStatus. 4 5Produce a test matrix with these columns: 6operationId, scenario, setup, request variation, expected outcome, 7specification evidence, assertion, cleanup, and unresolved assumptions. 8 9Cover valid requests, missing required inputs, invalid types, documented 10enum values, documented error responses, and create-read-update flows. 11 12Do not invent endpoints, authentication behavior, status codes, or business 13rules. Separate documented expectations from exploratory hypotheses. 14Do not claim any test has been executed.
4. Rivedi l'oracolo per ogni scenario. Petstore documenta una creazione riuscita come 200. Il suo schema Pet richiede name e photoUrls; id ha un tipo intero ma non è in quell'elenco di campi obbligatori. La validazione dei campi mancanti e l'identità richiesta-risposta necessitano quindi di controlli diversi.
| Operazione | Input o sequenza | Evidenza del risultato atteso | Asserzione da rivedere | Stato di esecuzione |
|---|---|---|---|---|
| addPet, getPetById | Crea, poi leggi ID corrente | 200 documentato e schema Pet; aspettativa esplicita del flusso | Valida il corpo e confronta l'ID restituito | Superato localmente |
| updatePet, getPetById | Cambia nome e leggi di nuovo | Operazione di aggiornamento più intento approvato della fixture | Stesso ID, nuovo nome, schema valido | Superato localmente |
| findPetsByStatus | Interroga available dopo il setup | Enum documentato e risposta array riuscita | Tutti gli stati restituiti corrispondono; l'ID creato è presente | Superato localmente |
| getPetById | ID percorso non intero | 400 documentato per ID non valido | Stato esatto per questo caso documentato | Superato: 400 |
| findPetsByStatus | Valore enum non documentato | 400 documentato per stato non valido | Stato esatto, conserva qualsiasi discrepanza | Superato: 400 |
| addPet | Ometti name obbligatorio | Campo schema obbligatorio; le descrizioni 400 e 422 non mappano ogni variazione | Registra il comportamento; risolvi la mappatura esatta prima del gating | Restituito 200 senza name; discrepanza conservata |
5. Genera e ispeziona il file di esecuzione (Prompt B). Allega la matrice approvata e la specifica con questo prompt:
plaintext1Generate a pytest test suite from the attached approved test matrix and 2OpenAPI specification. 3 4Use Python requests. Read the service URL from BASE_URL. 5Read any required credentials from environment variables. 6Never embed secrets. 7 8Use isolated test data and explicit setup and cleanup. 9Assert documented status codes, relevant response schemas, and the 10relationships between request data and response data. 11Do not hard-code timestamps or assume that generated IDs are constant. 12 13Set explicit request timeouts. Keep product failures visible. 14List unresolved requirements instead of guessing them. 15 16Return the test file, dependency list, run command, and a short explanation 17of each assertion. Do not claim the tests passed.
6. Esegui, preserva e pulisci. Usa un ID animale specifico per l'esecuzione, cattura la risposta di creazione e passa il suo ID alle richieste successive. Convalida l'aggiornamento tramite una nuova lettura. Una risposta di aggiornamento riuscita da sola non prova che il server abbia persistito la modifica.
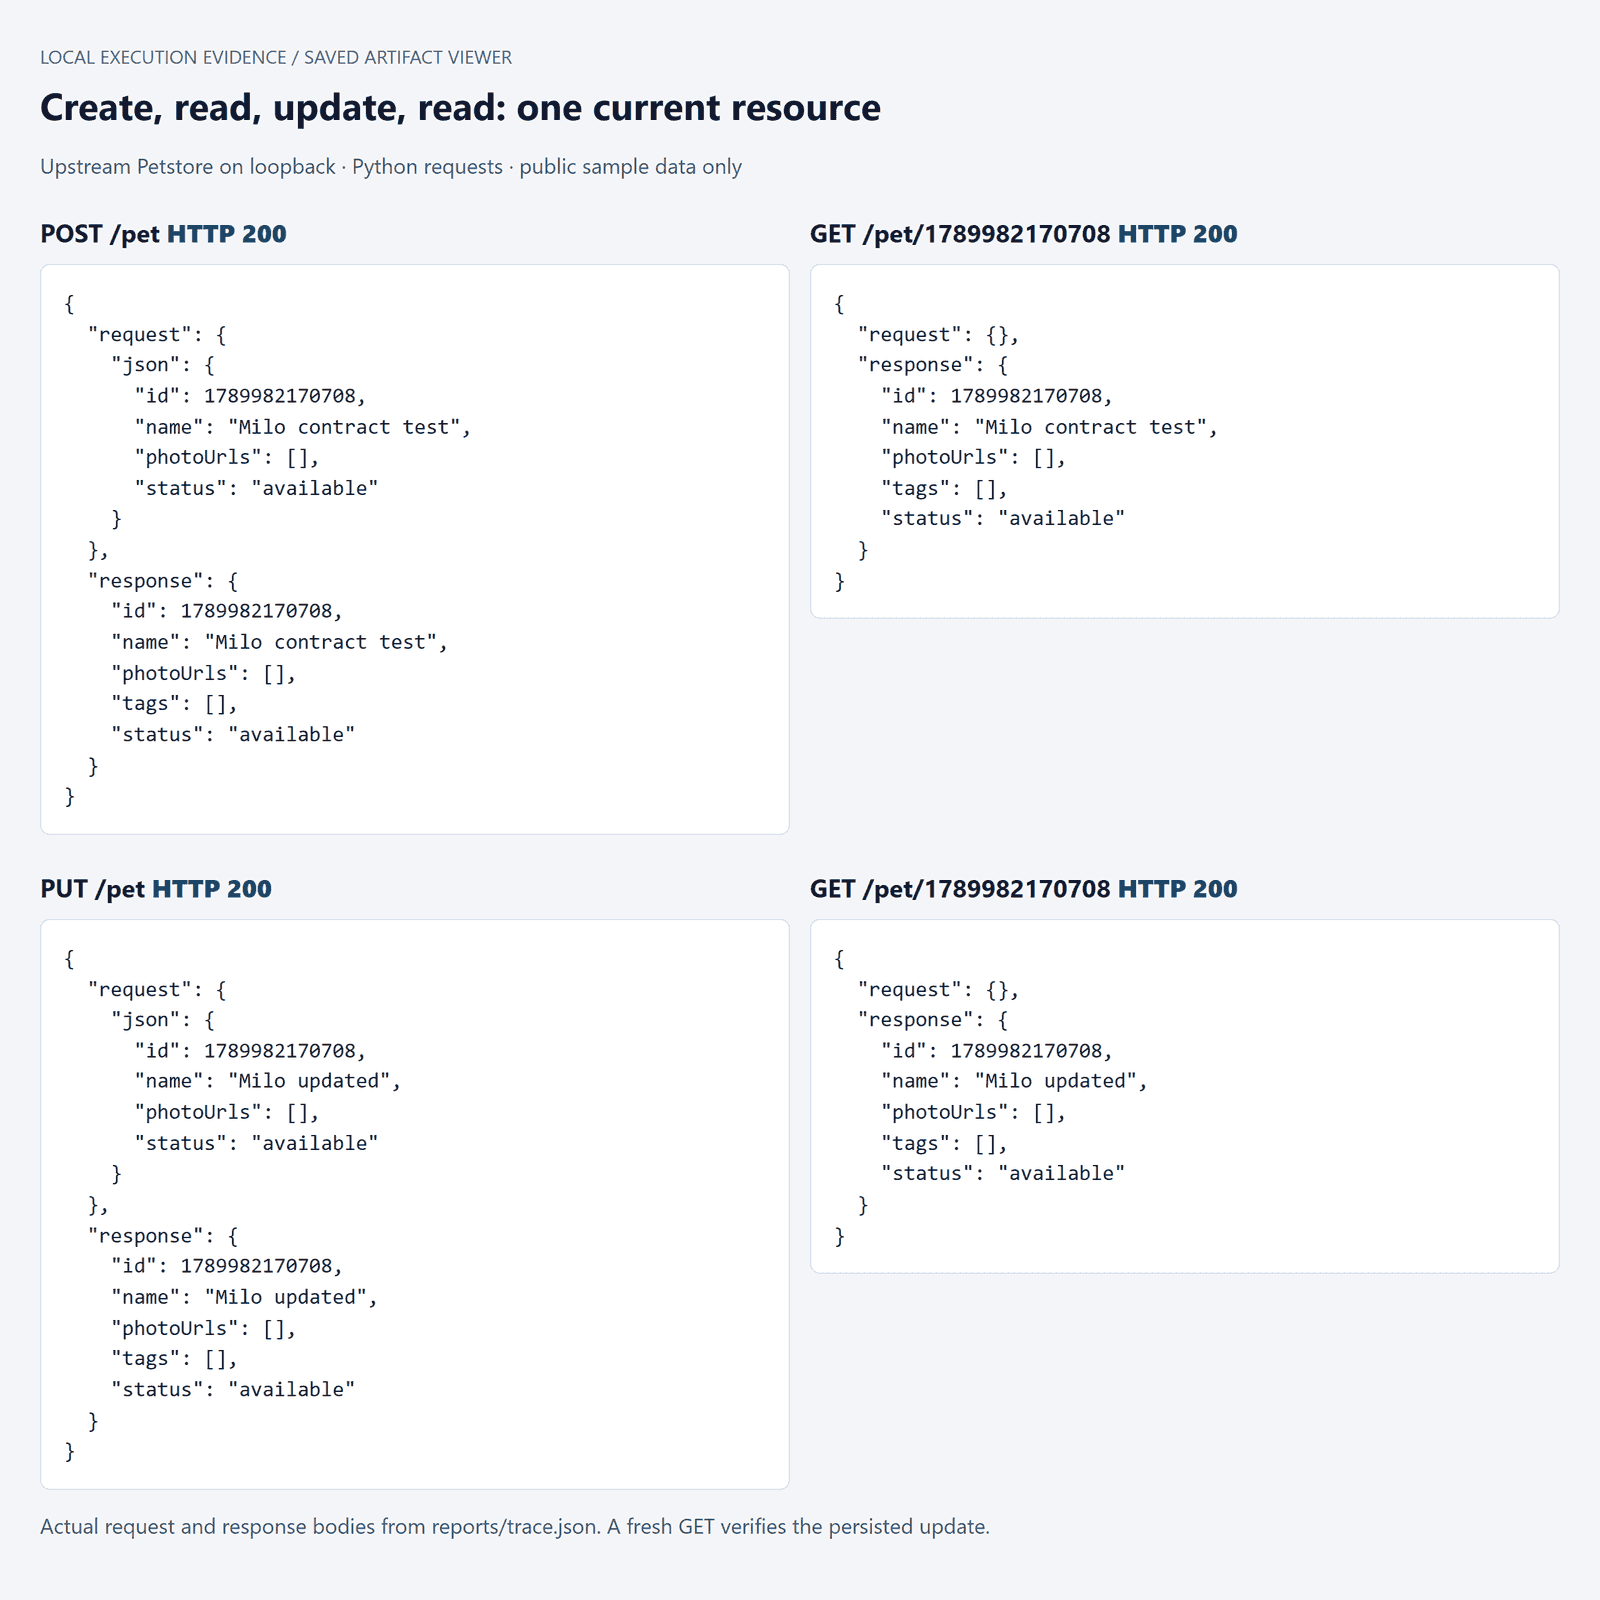 Evidenza della catena di richieste Petstore locale che mostra creazione, ricerca, aggiornamento e trasferimento ID
Richieste e risposte locali salvate: lo stesso ID specifico dell'esecuzione sopravvive a creazione, lettura, aggiornamento e una nuova lettura. Tutte e 4 le richieste visualizzate hanno restituito 200.
Salva corpi delle richieste, risposte, fallimenti delle asserzioni e l'esito della pulizia. Limita l'eliminazione agli ID creati da questa esecuzione. Conserva le risposte inaspettate come risultati, inclusi i casi in cui l'implementazione dimostrativa accetta input non validi. Non modificare le asserzioni solo per ottenere uno screenshot verde.
Cosa ha trovato questa esecuzione: le 5 funzioni di test live sono passate, inclusi i controlli per ID non valido e stato non valido che restituiscono 400. La sonda separata per il nome mancante ha restituito 200 e un corpo senza name. Abbiamo conservato quella discrepanza di schema al di fuori della suite verde; la sua esatta mappatura di errore prevista necessita ancora di chiarimenti. Entrambi i record creati sono stati eliminati con successo.
I test locali sono stati redatti in questa esecuzione dell'articolo, indipendentemente dai tre strumenti commerciali. Tutti e 5 i test live sono stati conservati; nessuno è stato rimosso o ha avuto le proprie aspettative allentate dopo l'esecuzione. Il tempo di revisione umana non è stato misurato. La cartella delle evidenze contiene i file di test, il lock delle dipendenze, le risposte grezze e le istruzioni di riproduzione.
Come convalidare gli strumenti AI per il test delle API
Un'asserzione utile dovrebbe rifiutare una risposta errata rilevante. Puoi testare questa proprietà senza modificare il servizio in esecuzione: salva una risposta reale riuscita, copiala e modifica deliberatamente un campo alla volta. Queste sono mutazioni controllate della risposta, non vulnerabilità di produzione o un benchmark completo di mutation testing.
Mantieni insieme lo stato e il corpo originali. Per prima cosa esegui il validatore sulla risposta non modificata e verifica che accetti la baseline. Poi crea tre copie indipendenti. Cambia l'ID, cambia il tipo del nome e rimuovi il nome obbligatorio. Ogni copia dovrebbe fallire per una ragione che corrisponde all'alterazione.
| Baseline salvata | Modifica controllata | Controllo rilevante | Risultato effettivo |
|---|---|---|---|
| Ricerca riuscita dell'animale corrente | Sostituisci con un altro ID intero; mantieni stato 200 | L'ID restituito è uguale all'ID atteso di questa esecuzione | Fallito: ID atteso ed effettivo differiscono |
name stringa | Sostituisci name con un numero | Tipo stringa dello schema Pet | Fallito: 42 non è una stringa |
name obbligatorio presente | Rimuovi name | Elenco obbligatorio dello schema Pet | Fallito: name è obbligatorio |
L'esempio dell'ID espone una debolezza comune. Un validatore di schema può accettare l'intero sbagliato perché la forma rimane valida. L'asserzione di relazione fornisce il vincolo mancante. Negli altri due esempi, la validazione dello schema fornisce vincoli che un controllo solo sullo stato non può vedere.
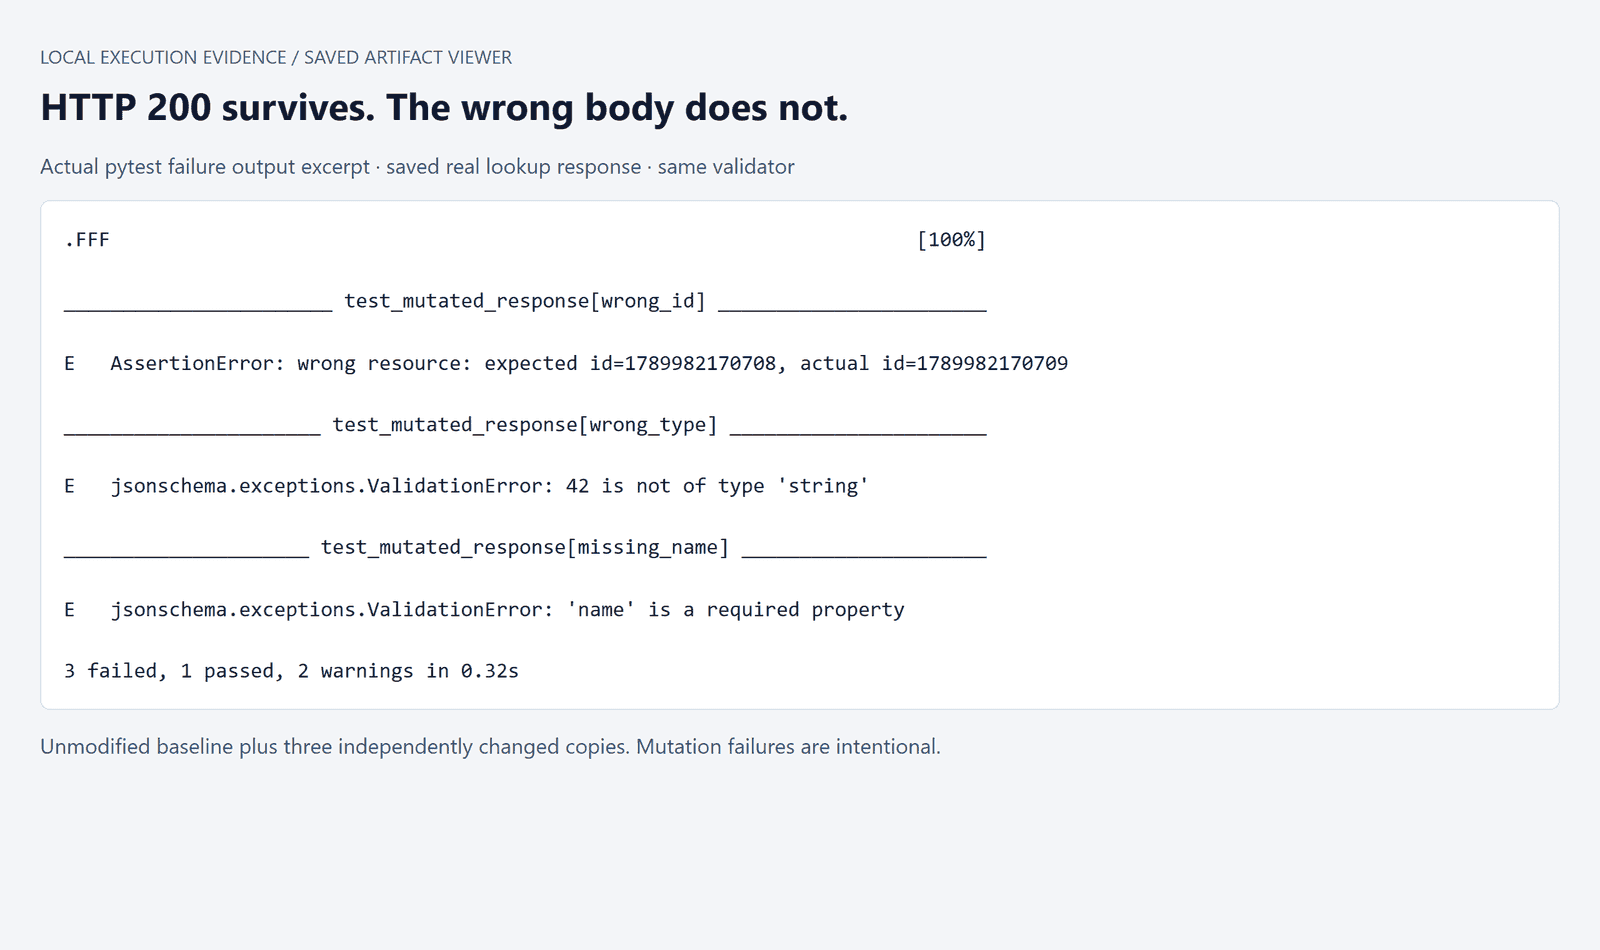 Output effettivo del fallimento delle asserzioni per mutazioni controllate della risposta Petstore
Estratti effettivi di fallimento pytest: la risposta originale è passata e tutte e 3 le mutazioni indipendenti sono fallite. Questi fallimenti sono stati indotti deliberatamente nelle copie salvate.
In questa esecuzione, la baseline non modificata è passata e 3 su 3 copie alterate sono fallite. L'esecuzione della mutazione ha restituito il codice di uscita 1, preservando il segnale di fallimento. Il validatore applica i vincoli strutturali rilevanti dello schema Pet e un controllo separato della relazione degli ID; questa piccola dimostrazione non è un validatore completo di conformità OpenAPI.
Per un audit ripetibile, allega il file di test e la specifica bloccata a Prompt C:
plaintext1Review the attached test file against the attached OpenAPI specification. 2 3Identify: 41. Assertions that would pass with an incorrect response. 52. Expected outcomes that have no specification evidence. 63. Hard-coded dynamic values. 74. Missing setup, cleanup, or request dependencies. 8 9For each issue, give the file location, the reason, and a proposed change. 10Do not weaken an assertion merely to match an observed response. 11 12Suggest three controlled response mutations that should fail the relevant 13assertions. Clearly label these as proposed checks, not executed results.
Esamina le modifiche suggerite di “auto-riparazione” con particolare attenzione. Sostituire un 400 atteso con 200 può nascondere una regressione. Una modifica legittima del contratto necessita di un riferimento ai requisiti e di una modifica del test revisionata. La risposta osservata è un'evidenza per l'indagine, non un permesso automatico per ridefinire la correttezza.
Separa le categorie di fallimento prima di chiedere una correzione all'AI. Un timeout può indicare un ambiente non disponibile. Un fallimento di ricerca può derivare da una fixture rotta. Un errore di importazione appartiene al codice di test. Una discrepanza riproducibile con il contratto concordato può appartenere al prodotto. Conserva abbastanza contesto per distinguerli.
Riporta il denominatore in modo onesto. Rilevare tre modifiche selezionate della risposta prova la sensibilità a quelle tre modifiche. Non stabilisce la copertura degli endpoint, la copertura del codice, la copertura della sicurezza o un tasso generale di rilevamento dei difetti. Allo stesso modo, un numero elevato di test dice poco su scenari duplicati o sulla forza delle loro asserzioni.
Autenticazione e autorizzazione meritano test indipendenti in un'applicazione adeguata: credenziali mancanti, credenziali scadute e accesso alle risorse di un altro utente. Il comportamento dimostrativo di Petstore non può stabilire che i tuoi controlli di accesso di produzione funzionino.
Strumenti AI per il test delle API in CI/CD
Una volta che un revisore accetta la suite, committa quella versione esatta. Una build dovrebbe eseguire aspettative note contro l'applicazione candidata. Rigenerare i test durante ogni build introduce un'altra componente mutevole e rende i fallimenti più difficili da riprodurre.
Blocca il runner, le dipendenze, le fixture e la specifica. Conserva un lock delle dipendenze insieme ai test e preserva la revisione dell'applicazione nel report. Risolvi i segreti dall'ambiente CI, tienili fuori dai file generati e controlla che i log di fallimento non li espongano.
Con pytest, la forma base di reporting è semplice:
plaintext1python -m pytest tests/test_petstore.py -q --junitxml=reports/petstore.xml
Fornisci BASE_URL tramite l'ambiente del job. Avvia il servizio locale nel ciclo di vita del job, attendi che sia pronto, poi esegui la suite. Raccogli sempre il report e il log del servizio, anche in caso di fallimento. Termina fermando il servizio del job stesso e pulendo i suoi dati; evita comandi di pulizia a livello di processo su agent condivisi.
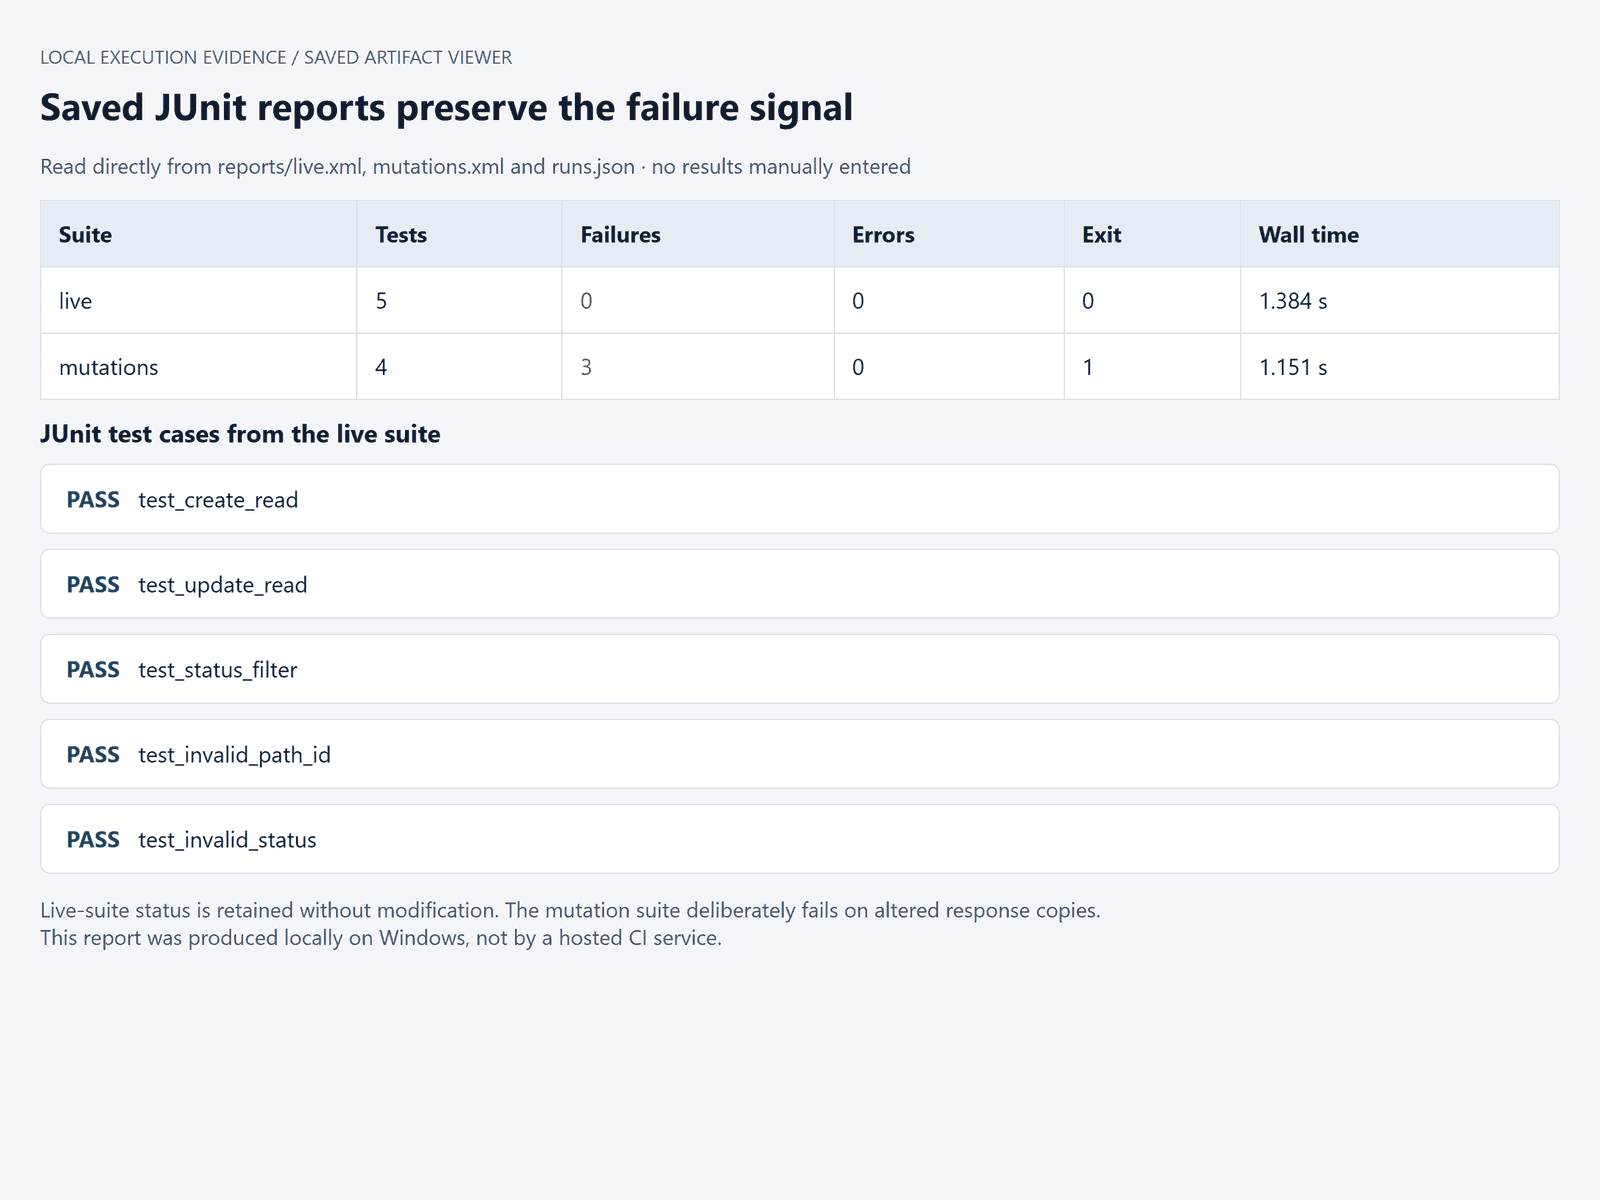 Local pytest JUnit report with separate live-contract and assertion-check resultsActual local
Risultati JUnit: 5 test live superati; la suite a copia controllata contiene 1 baseline superata e 3 fallimenti intenzionali. Nessuna esecuzione CI ospitata è rivendicata.
I tempi reali misurati, inclusa l'avvio del processo Python, sono stati 1,384 secondi per la suite live e 1,151 secondi per la suite a copia controllata. Questi escludono build/avvio del servizio, installazione delle dipendenze, redazione e revisione. I file JUnit e i log non abbreviati sono salvati separatamente.
Testa il percorso di fallimento prima di fare affidamento sul gate. Un'asserzione fallita deve produrre un codice di uscita del job fallito. Le riprove dovrebbero essere limitate e giustificate per transitori noti dell'infrastruttura; riprove ripetute che alla fine nascondono un fallimento del prodotto rendono il gate meno informativo.
Gestisci esplicitamente i fallimenti di pulizia. Mantieni visibile il fallimento dell'asserzione primaria, registra quale risorsa rimane e lascia che il teardown segnali il proprio problema. I job paralleli necessitano di identificatori o namespace separati. Un test che passa da solo ma legge i dati di un altro job non è pronto per l'uso non presidiato.
Se hai già pytest, puoi scegliere separatamente il modello di redazione. Atlas Cloud si adatta a questo ruolo più ristretto: uno strato di modello per un flusso di lavoro personalizzato la cui esecuzione e reporting esistono già. Non è presentato qui come una piattaforma completa di test API o un backend nativo per i tre prodotti sopra.
Per quella valutazione, apri DeepSeek V4.1 Flash, ID modello deepseek-ai/deepseek-v4.1-flash, e fornisci la stessa specifica pubblica e matrice revisionata usata localmente. Usa il Prompt B, poi salva la bozza restituita separatamente dal test revisionato. Confronta le sue ipotesi con il contratto prima di eseguire qualsiasi cosa.
Se esposto dall'interfaccia, una temperatura di 0,2 è un'impostazione di partenza per la redazione, non una garanzia di determinismo. Controlla il limite di output disponibile rispetto alla dimensione della tua suite. Consulta il catalogo modelli corrente per il prezzo dei token invece di fare il budget da un vecchio articolo.
La divisione del lavoro rimane esplicita: il modello propone codice, un revisore approva le aspettative e il runner produce i risultati. Il gate di accesso all'ambiente di test ha impedito un'esecuzione Atlas completata per questo articolo, quindi questa è una ricetta di valutazione piuttosto che un risultato misurato del modello. Puoi valutare questo percorso senza migrare un runner di test funzionante o affidare le sue responsabilità di esecuzione a un modello di chat.
Scegliere gli strumenti AI per il test delle API per il tuo team
Scegli la valutazione più piccola che possa cambiare la tua decisione. Usa un flusso di lavoro connesso, un caso negativo documentato e alcune risposte errate controllate. Mantieni input equivalenti tra i candidati. Un'esperienza di onboarding rifinita non dovrebbe superare un test che non riesce a identificare la risorsa sbagliata.
Per un flusso di lavoro maturo con collezioni, inizia valutando le funzionalità AI in quel workspace. La configurazione dell'ambiente esistente e le dipendenze delle richieste sono un contesto prezioso. Misura se le modifiche generate risparmiano sforzo di revisione senza introdurre assunzioni fragili.
Per un team con una specifica solida e un arretrato di scrittura, valuta la generazione basata su specifiche. Presta attenzione a cosa succede quando la specifica è incompleta. Un generatore che segnala chiaramente le aspettative mancanti è più facile da revisionare di uno che le inventa con sicurezza.
Per un'applicazione i cui fallimenti dipendono dal comportamento upstream, valuta registrazione e riproduzione. Ispeziona le baseline catturate e il supporto delle dipendenze prima di investire in grandi registrazioni. Decidi quali campi dinamici possono variare e quali relazioni devono rimanere intatte.
Per un team con un runner stabile, valuta un modello indipendente per la redazione e la revisione. Mantieni il formato di esecuzione che già conosci, ma possiedi anche l'integrazione, la progettazione delle fixture e la manutenzione. Includi quella proprietà nel calcolo dei costi.
Prima di pagare per strumenti AI per il test delle API, richiedi cinque dimostrazioni concrete:
- La suite revisionata viene eseguita nell'ambiente previsto.
- Errori controllati rilevanti fanno fallire le asserzioni appropriate.
- I test e i report utili possono essere conservati in un formato accettabile.
- Esecuzioni ripetute, inclusa l'esecuzione CI, preservano l'isolamento e i segnali di fallimento.
- I costi di generazione, esecuzione e manutenzione rientrano nel budget del team.
Assegna a qualcuno la manutenzione della suite accettata. Una modifica della specifica dovrebbe attivare una revisione delle asserzioni, delle fixture e dei consumatori interessati. Conserva le vecchie evidenze di fallimento finché il cambiamento non è compreso. Ciò rende la prossima release più facile da valutare e dà al team una ragione per fidarsi di un report verde.
Domande frequenti
Quale strumento AI dovrei usare per il test delle API?
Inizia con i tuoi input esistenti. Valuta Postman Agent Mode per collezioni consolidate, KushoAI per la generazione guidata da specifiche e Keploy per i suoi distinti percorsi di flusso generato e registrazione. Se il tuo team mantiene già pytest o un altro runner, un modello di redazione separato potrebbe adattarsi. Usa lo stesso piccolo flusso di lavoro per valutare asserzioni, esecuzione e sforzo di revisione di ciascun candidato.
Esistono strumenti AI gratuiti per il test delle API?
Esistono client gratuiti, strumenti di test open source e tolleranze AI limitate. Coprono esigenze diverse. Il piano Free di Postman elenca 50 crediti AI mensili al 21 settembre 2026; non è un conteggio di test. Controlla se le funzionalità richieste di esportazione, automazione, reporting e collaborazione sono incluse prima di considerare una prova interattiva come soluzione CI gratuita.
L'AI può generare test API da una specifica OpenAPI?
Sì, un generatore può usare operazioni, schemi, parametri e definizioni di risposta per proporre test. La specifica può comunque omettere regole aziendali o lasciare ambigue le mappature degli errori. Fornisci aspettative approvate e rivedi il risultato. Nell'esempio Petstore bloccato, una creazione riuscita è documentata come 200, il che illustra perché le convenzioni REST familiari non possono sostituire il contratto effettivo.
Come faccio a sapere se le asserzioni generate dall'AI sono utili?
Controlla tre cose: vincoli di schema documentati, relazioni tra richieste e risposte e sensibilità a dati deliberatamente errati. Salva una risposta reale, modifica una proprietà rilevante e riesegui lo stesso validatore. Conserva il messaggio di fallimento. Questo fornisce prove ristrette e riproducibili su quelle asserzioni, lasciando aperte domande più ampie su copertura e sicurezza per test separati.
Posso eseguire test API generati dall'AI in CI/CD?
Sì, quando il formato generato, il runner, l'ambiente e il piano supportano quel percorso. Committa i test revisionati, installa dipendenze bloccate, usa fixture isolate ed esporta un report strutturato come JUnit. Verifica che i fallimenti restituiscano un codice di uscita diverso da zero. Un'esecuzione locale riuscita prepara la suite per la CI; non prova che una pipeline ospitata sia stata eseguita.
L'AI può sostituire il test manuale delle API?
L'AI può ridurre la redazione ripetitiva e aiutare i revisori a trovare asserzioni deboli. Le persone decidono ancora il comportamento previsto, indagano fallimenti ambigui ed esplorano rischi al di fuori degli esempi forniti. Usa strumenti AI per il test delle API per produrre asset di test revisionabili, poi giudicali con prove riproducibili. Una suite più piccola che cattura errori significativi è più facile da fidarsi di una raccolta inspiegata di controlli verdi.


