
Kimi API for Vision-to-Code Generation
Kimi API è la linea K2 open-weight di Moonshot AI, dal K2.5 nativamente multimodale al K2.7 Code specializzato nel coding. Poiché la visione è integrata nel modello, puoi trasformare screenshot, mockup UI e brevi video in codice frontend funzionante, coordinare fino a 100 sub-agent paralleli e ragionare su un contesto da 256K token. Atlas Cloud offre l’intera famiglia tramite un unico endpoint unificato con prezzi trasparenti pay-as-you-go. Inizia a costruire oggi stesso.
Kimi è sviluppato da Moonshot AI. Atlas Cloud (gestita da Atlas Cloud AI LLC) ne fornisce l’accesso ma non ne è proprietaria. Tutti i marchi appartengono ai rispettivi titolari.
Esplora i Modelli di Punta
Atlas Cloud ti fornisce i più recenti modelli creativi leader del settore.

Abbina il tuo workload al modello Kimi API più adatto
Confronta a colpo d’occhio il focus di ciascun endpoint Kimi e i prezzi standard per milione di token.
| Modalità | Descrizione |
|---|---|
| Kimi K2.7 Code API (Text to Text) | Progettato appositamente per il lavoro di engineering, questo endpoint trasforma prompt in linguaggio naturale e file sorgente esistenti in codice funzionante, correzioni e automazioni per sviluppatori. È pensato per programmazione, debugging e workflow di sviluppo AI in cui la priorità è generare codice affidabile, con fatturazione standard a $0.95 per milione di token in input e $4 per milione di token in output. |
| Kimi K2.6 API (Text to Text) | Forniscigli prompt testuali e Kimi K2.6 restituisce risposte ragionate, codice e output strutturato per le attività quotidiane di produttività. Potenziato sia per il reasoning sia per il coding, è adatto ai team che vogliono un unico modello general-purpose per analisi, stesura di contenuti e sviluppo software, con input in cache a $0.16 per milione di token per contesti ripetuti. |
| Kimi K2.5 API (Text to Text) | Quando un’attività coinvolge documenti lunghi o pipeline a più passaggi, Kimi K2.5 acquisisce input testuali estesi e restituisce risposte coerenti e consapevoli del contesto. Creato per la comprensione di contesti lunghi e workflow intelligenti, utilizza prezzi pay-as-you-go trasparenti a $0.60 per milione di token in input e $3 per milione di token in output, mantenendo conveniente l’analisi su larga scala. |
La Kimi API, dal contesto 256K agli sciami da 300 agenti
La Kimi API porta i modelli K2 da un trilione di parametri di Moonshot AI in un unico endpoint, combinando una finestra di contesto da 262,144 token con input nativo di immagini e video, sciami di agenti autonomi e modelli specializzati ottimizzati per coding, debugging e ragionamento a lungo orizzonte.
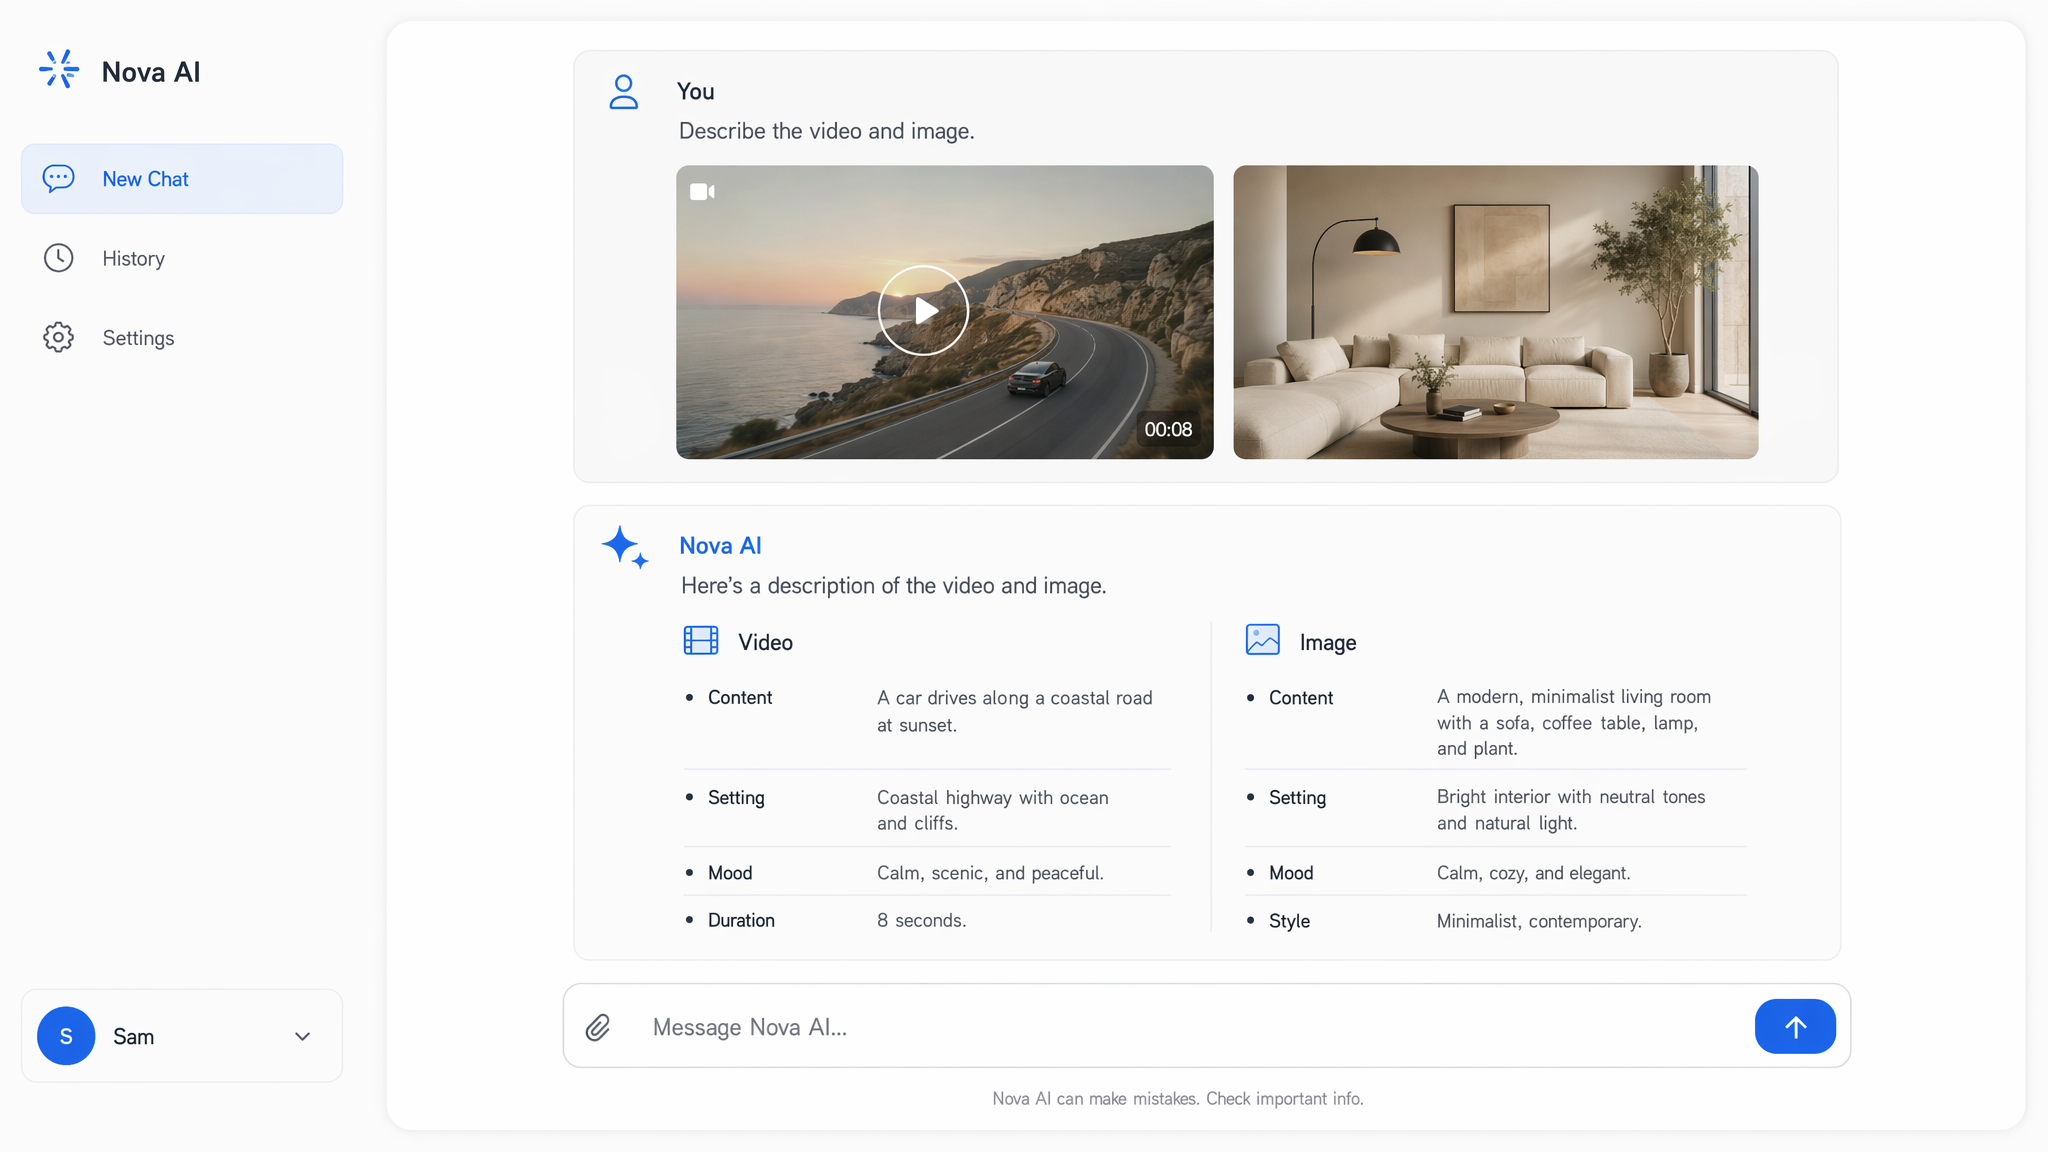
Comprensione nativa di immagini e video
K2.6 elabora testo, immagini e video all’interno di un’unica architettura multimodale nativa, accettando formati da PNG e WebP a MP4, MOV e WebM senza plugin esterni. Il suo encoder visivo MoonViT legge direttamente registrazioni dello schermo, file di design e diagrammi. Mentre K2.5 gestiva testo e immagini, K2.6 estende lo stesso stack alla comprensione completa dei video, così il contesto visivo diventa semplicemente un altro input.
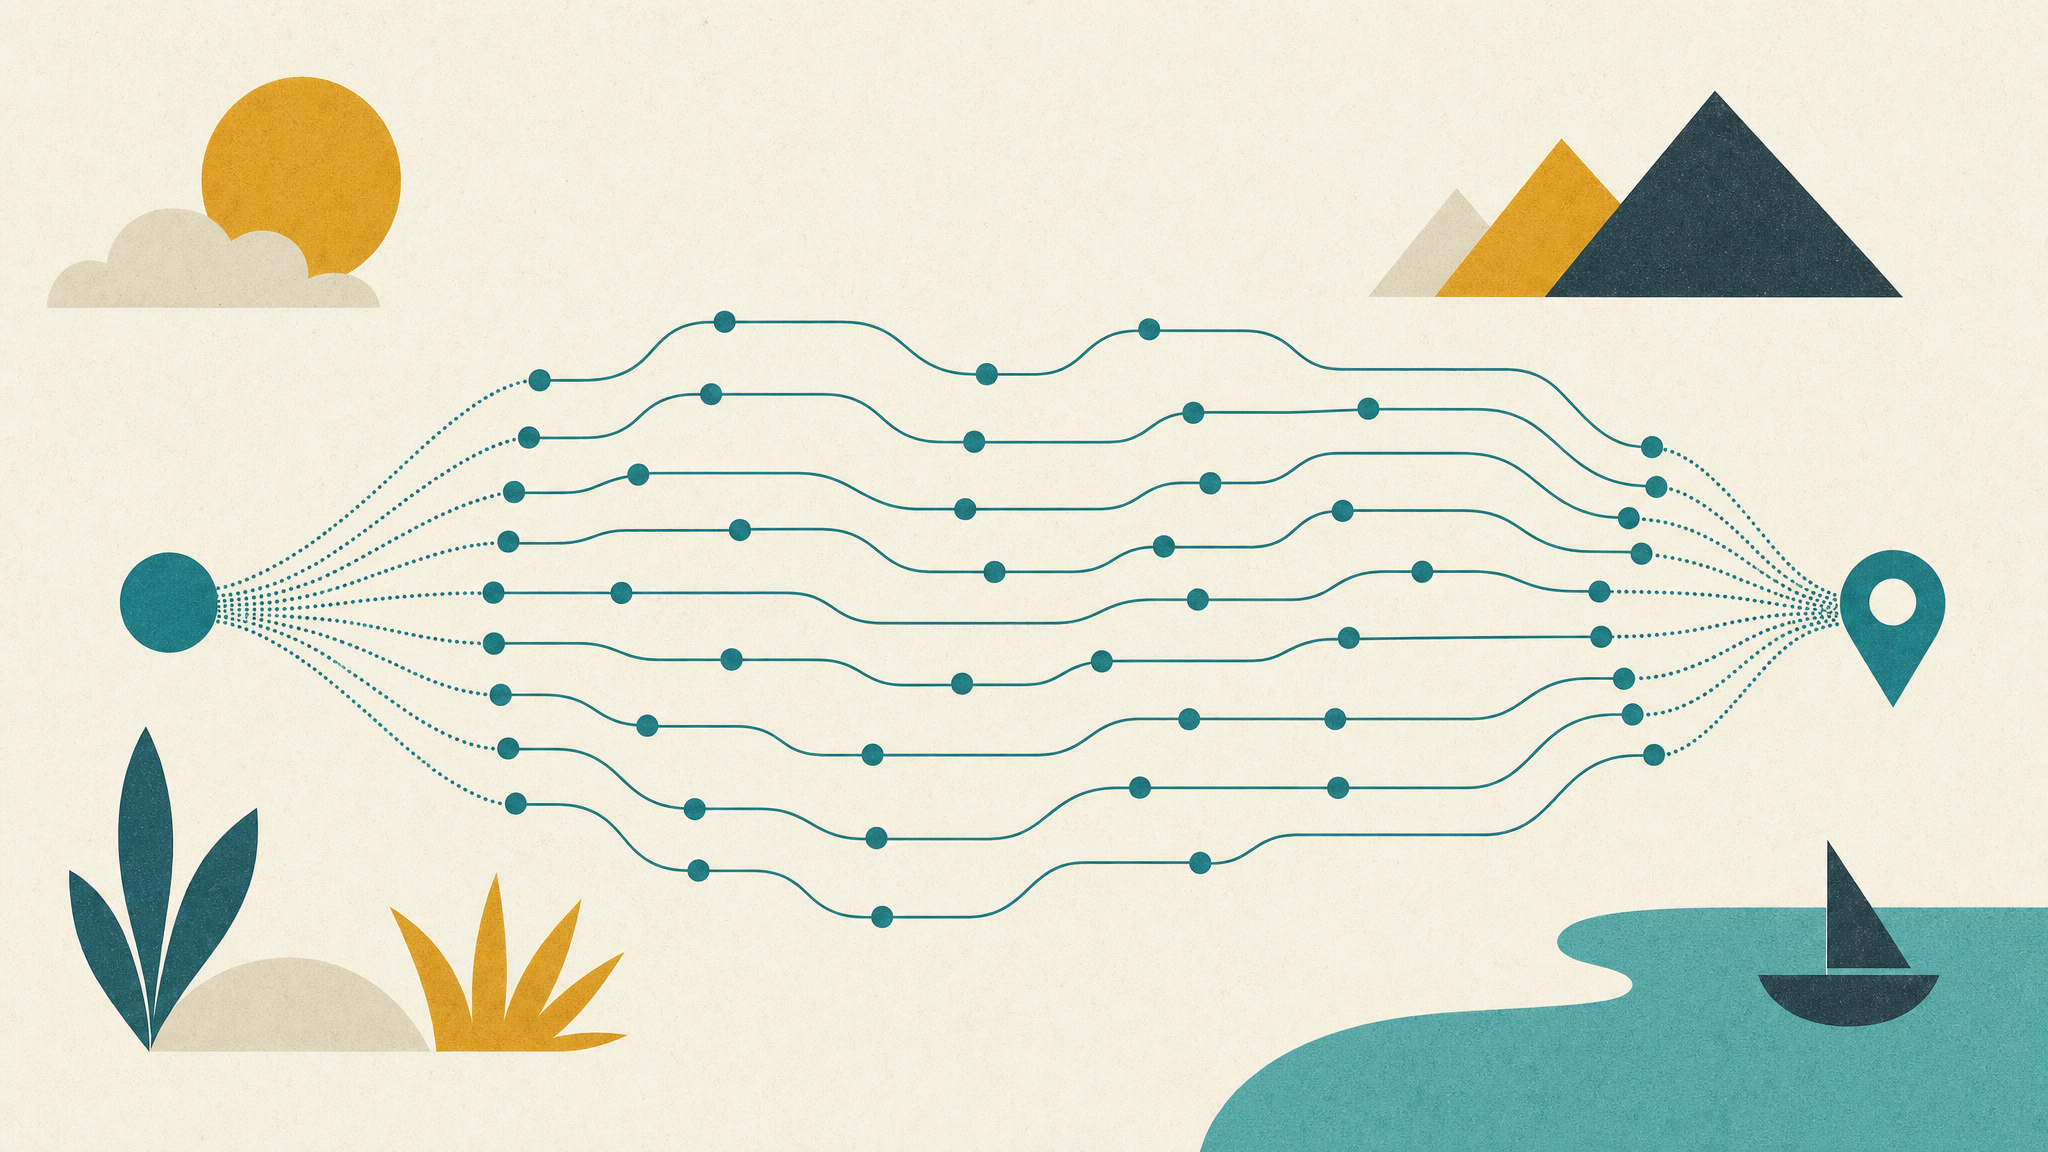
Sciami di agenti autonomi tramite la Kimi API
La Kimi API espone uno sciame di agenti autonomi che scala fino a 300 sub-agents impegnati in circa 4,000 passaggi coordinati. Invece di ragionare su un singolo thread, K2.6 scompone un grande obiettivo in rami paralleli e li orchestra fino al completamento. Ogni sub-agent gestisce la propria porzione del task, poi riporta i risultati nel piano condiviso. Questo design è adatto all’automazione a lungo orizzonte, quando un progetto attraversa molte fasi dipendenti tra loro.
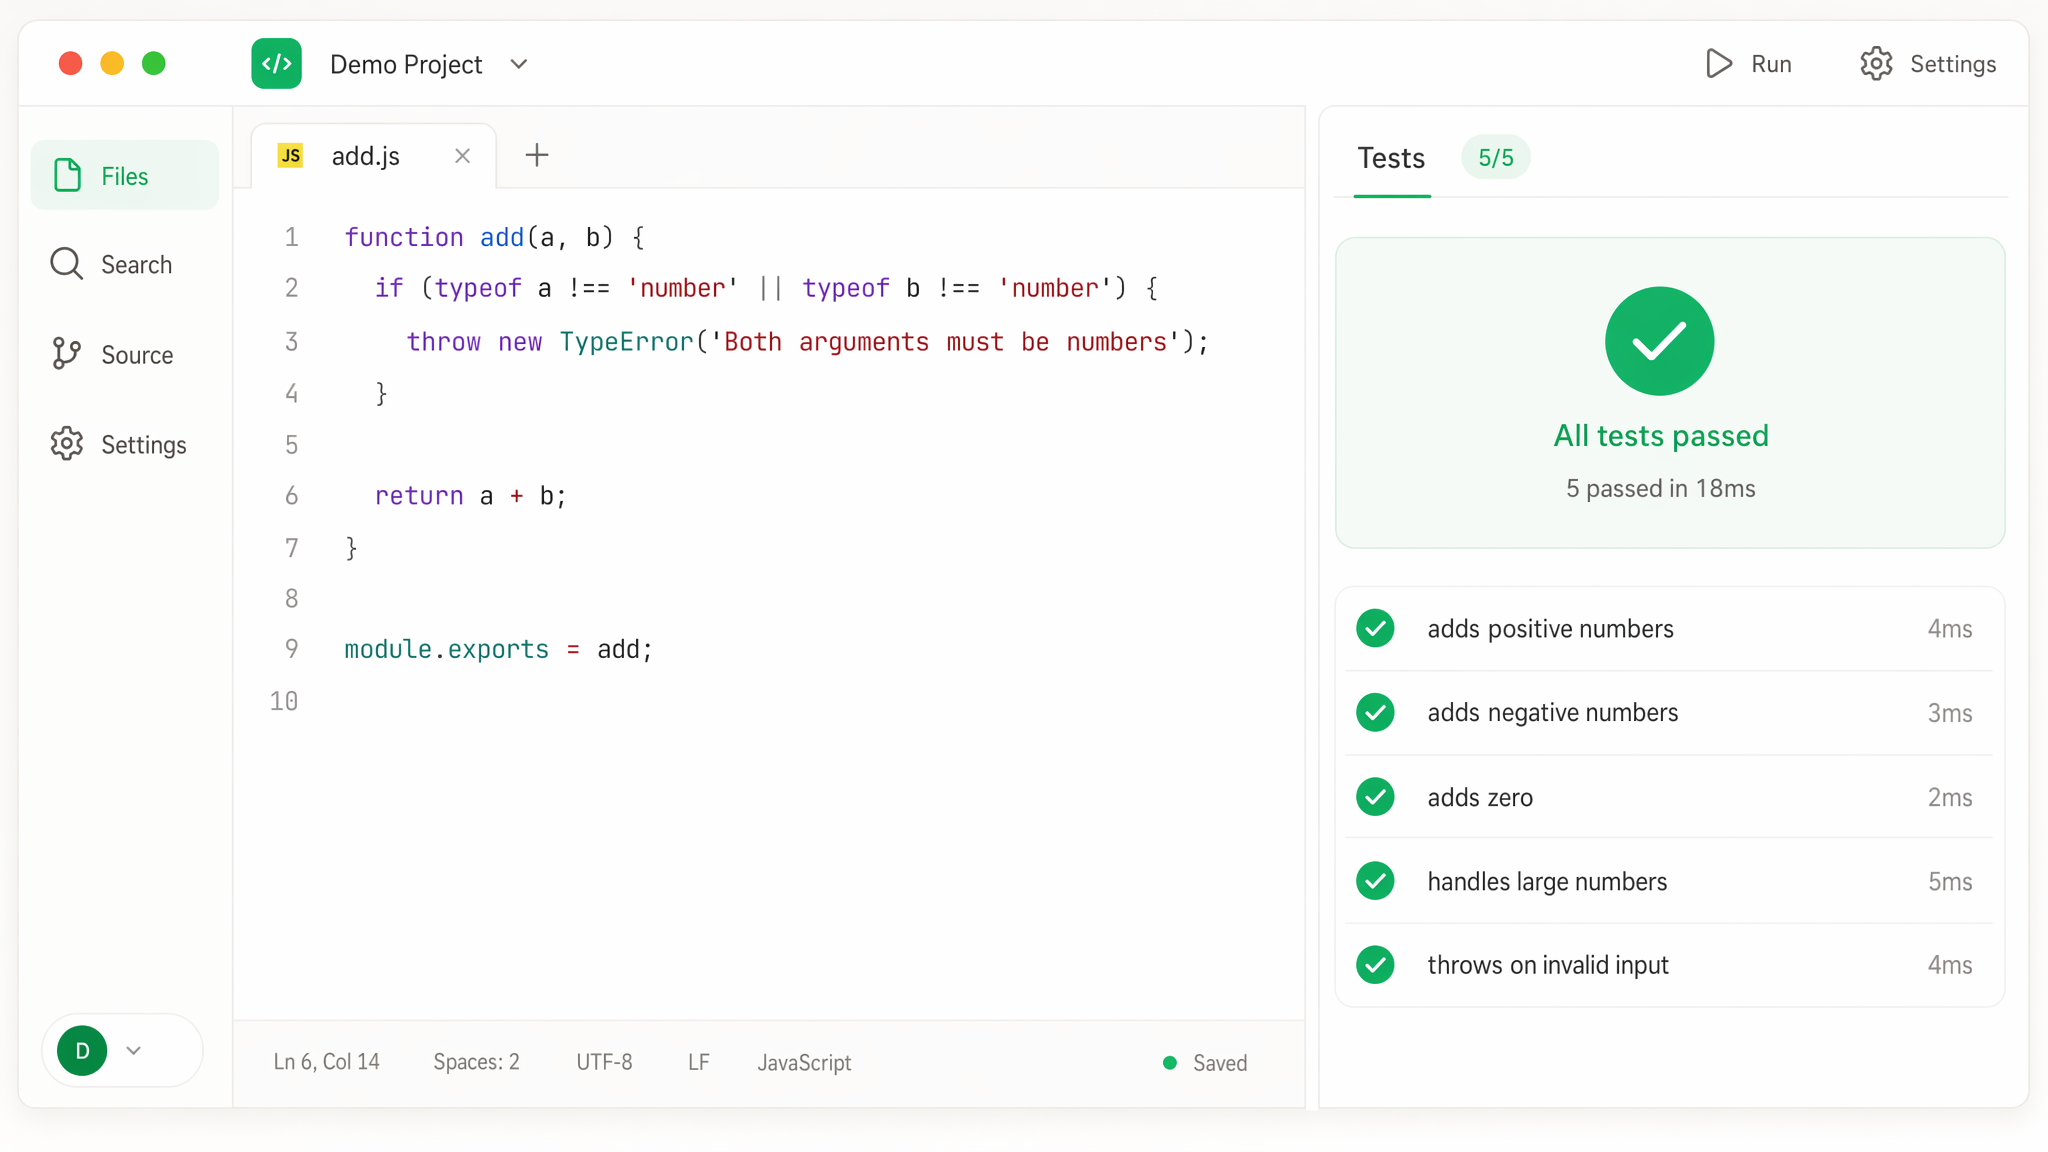
Coding e debugging integrati
Il coding è al centro della famiglia, con Kimi K2.7 Code progettato appositamente per programmazione, debugging e workflow di agenti per sviluppatori. Nel benchmark di coding SWE-Bench Pro, K2.6 raggiunge 58.6, superando di poco diversi modelli frontier su correzioni di repository reali. Punta uno dei due modelli su una test suite che fallisce: individuerà il difetto, proporrà una patch e itererà finché la build non diventa verde.
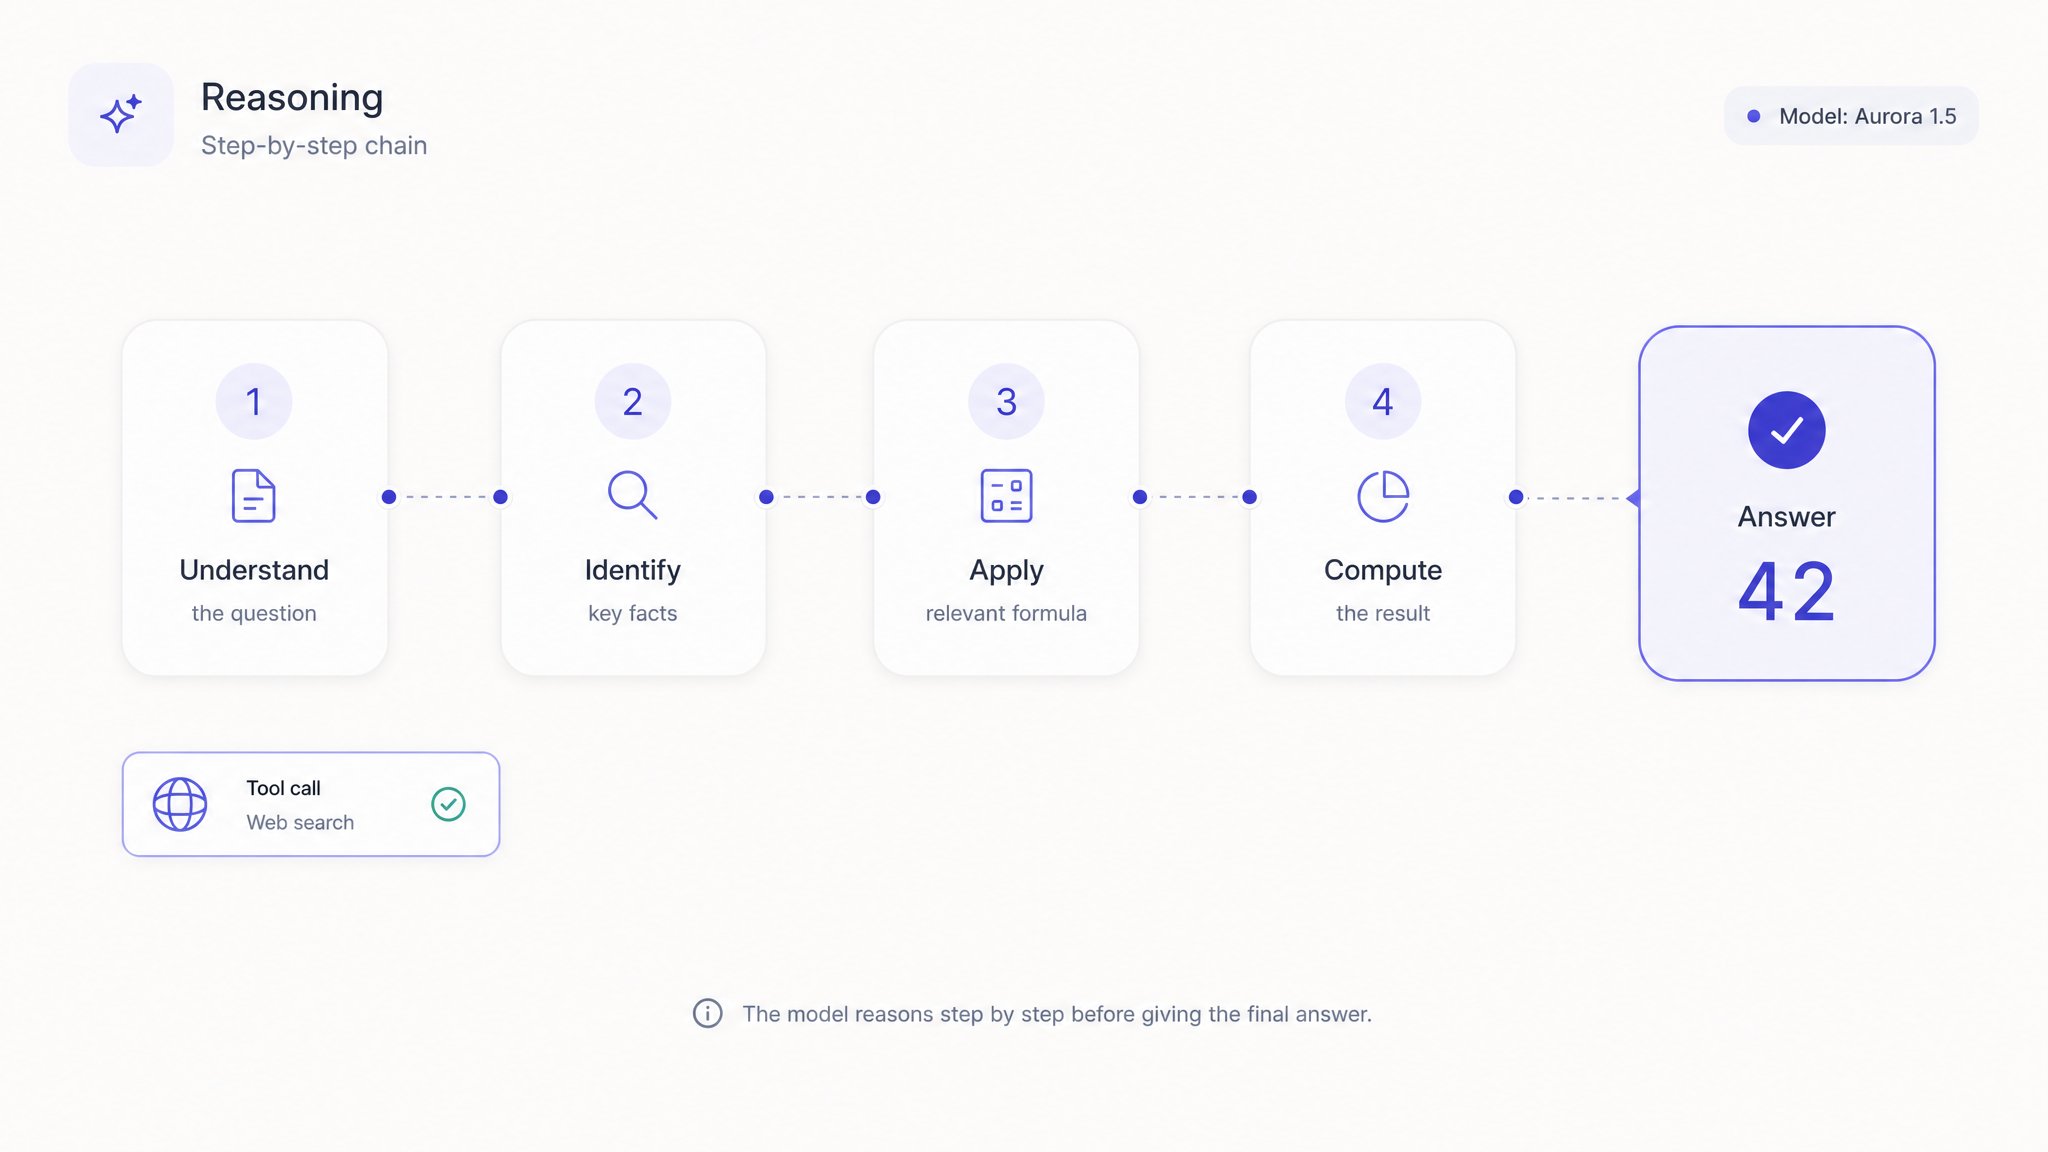
Ragionamento agentico con una sola chiave Kimi API
Ti serve un ragionamento trasparente? Abilita la modalità di pensiero configurabile e il modello mostra la sua catena passo per passo prima di impegnarsi in una risposta, insieme al supporto nativo per chiamate a tool e funzioni. Su Atlas Cloud l’intera Kimi API funziona dietro un’unica chiave compatibile con OpenAI, con prezzi pay-as-you-go per chiamata e accesso Day-0 a ogni nuova release. Cambia il base URL e il codice esistente continuerà a funzionare.
Kimi API a confronto: un prompt, tre modelli
Invia un unico brief identico alla Kimi API e a due modelli rivali, poi confronta la pagina HTML interattiva che ciascuno crea a partire dalle stesse identiche istruzioni.
Crea una pagina HTML completa in un unico file per un gioco arcade Snake giocabile, con tutto il CSS e il JavaScript incorporati e zero dipendenze esterne, CDN, immagini o font. Disegna la griglia su un canvas con una moderna palette neon su sfondo scuro, movimento fluido e una morbida scia luminosa dietro al serpente. Supporta i controlli con frecce e WASD, oltre ai gesti di swipe sui dispositivi touch, mostra il punteggio in tempo reale e un record persistente, e aumenta gradualmente la velocità del gioco man mano che il punteggio cresce. Attiva una piccola esplosione di particelle ogni volta che il cibo viene mangiato, mostra un overlay animato di game over con un pulsante di riavvio e mantieni il layout responsive, così che la griglia resti centrata e leggibile sia su desktop sia su mobile.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Crea un singolo file HTML completamente autonomo (tutto il CSS e il JavaScript incorporati, assolutamente nessuna dipendenza esterna, CDN, immagine o web font) che renderizzi un "terrario digitale vivente" interattivo: un barattolo di vetro sigillato al centro dello schermo, contenente una mini foresta pluviale autosufficiente che cresce in tempo reale. Aperto in qualsiasi browser moderno, deve funzionare subito a 60fps senza alcun passaggio di build. Scena principale e layout: centra la composizione in modo simmetrico, trattando il barattolo di vetro come il palco principale su uno sfondo scuro profondo e vignettato (gradiente radiale da un centro morbido illuminato di muschio che sfuma verso bordi quasi neri), così che tutta l'attenzione ricada sul barattolo. Renderizza tutto su un HTML5 Canvas a finestra intera, stratificato sotto veri elementi DOM/CSS glassmorphism: la parete del barattolo deve mostrare autentiche qualità del vetro — riflessi curvi di rifrazione, una brillante striscia di rim-light speculare, una lieve sfocatura satinata e goccioline di condensa sparse con minuscole lenti — ottenute con gradienti radiali/lineari sovrapposti, backdrop-filter blur, tratti bianchi semitrasparenti e morbide box-shadow. Dentro il barattolo, sul fondo, c'è un terriccio scuro e umido e una tenue foschia volumetrica che deriva lentamente. I tre livelli tecnici che devono sovrapporsi e coesistere (qui si distingue un modello debole da uno forte: un modello debole produrrà un'immagine statica, uno forte renderà vivo l'intero barattolo): 1. Crescita ricorsiva con L-system: rampicanti, fronde di felce e muschi sono generati da un L-system / algoritmo di ramificazione ricorsiva e animano il loro dispiegarsi nel tempo: gli steli si allungano, i rami si suddividono, le fronde si srotolano, le foglie scalano in ingresso con easing. La crescita è organica e leggermente randomizzata per ramo (variazione dell'angolo, assottigliamento dello spessore, decadimento della lunghezza), così che al ricaricamento non esistano due piante identiche. 2. Sistema di particelle: mote luminose ambrate simili a lucciole (a decine) fluttuano e ondeggiano nella foschia con un morbido bagliore additivo e una leggera parallasse, insieme a particelle ascendenti di condensa/polline; le particelle reagiscono in modo sottile alle piante appena cresciute. 3. Ciclo di illuminazione giorno-notte: un loop continuo di luce ambientale sposta la key light dall'alto da alba bianco freddo → tramonto dorato caldo → notte indaco profonda e ritorno, ricolorando di conseguenza l'intera scena, i riflessi del vetro, la foschia e i toni delle piante. Le piante mostrano fototropismo: gli steli si piegano e inclinano le punte verso la direzione corrente della luce mentre si muove. Interazione principale: facendo clic in qualsiasi punto sulla parete o all'interno del barattolo, un singolo seme cade nel terriccio alla posizione x del clic, e quel seme attraversa una vita completa e visibile in sequenza: cade e si posa, germina in un germoglio, il germoglio si ramifica ricorsivamente tramite L-system, poi a maturità sboccia in un piccolo fiore luminoso; ogni fase è easing e chiaramente leggibile, con una morbida increspatura/sbuffo di polvere all'atterraggio. Più clic generano più piante, che coesistono e continuano a crescere, riempiendo gradualmente il terrario fino a trasformarlo in un intrico più fitto. Includi un paio di controlli inline discreti in pulsanti pill glassmorphic (ad esempio "Reimposta terrario" e un toggle "Giorno/Notte: auto ⇄ trascina", in cui l'utente possa scorrere l'ora del giorno, più una pausa opzionale). Fornisci una tenue riga di suggerimento ("tocca il vetro per piantare un seme") che svanisca dopo la prima interazione. Palette e atmosfera: fogliame verde inchiostro di foresta e verde-giallo muschioso, bagliore ambra/miele per le mote luminose e le fioriture, tinte vetro color teal freddo sul barattolo, lavaggi oro caldo e indaco freddo lungo la transizione giorno-notte. La sensazione generale è quieta, respirante, meditativa: movimento lento e gentile, nessuna transizione brusca. Requisiti tecnici: usa requestAnimationFrame con delta-time, così che l'animazione sia indipendente dal frame rate; rendi il canvas responsive al ridimensionamento della finestra con scaling corretto del devicePixelRatio e mantieni il barattolo centrato; limita in modo sensato il numero di particelle/rami affinché resti fluido; mantieni tutta la casualità seedata per pianta, così che la crescita appaia naturale. Tutto — geometria, bagliore, vetro, foschia, illuminazione, particelle e piante ricorsive — deve essere disegnato o calcolato via codice, con zero asset esterni. Consegna solo il documento HTML completo, pronto da salvare come unico file .html e aprire.
Generated with Kimi K2.7 Code on Atlas Cloud
Generated with GPT 5.5 on Atlas Cloud
Generated with Kimi K2.6 on Atlas Cloud
Metti la Kimi API al lavoro in tutto il tuo stack
Che tu stia rilasciando codice in repository enormi, convertendo design in interfacce o orchestrando sciami di agenti, la Kimi API porta ragionamento a contesto lungo e uso nativo degli strumenti nei carichi di lavoro di produzione reali.

Coding su scala repository con la Kimi API
Kimi K2.7 Code legge interi repository all'interno di una finestra da 262K-token, rifattorizzando, eseguendo debug ed estendendo codebase in un unico passaggio. I team lo usano per modernizzare sistemi legacy e rilasciare funzionalità multi-file senza perdere il contesto del progetto.

Trasforma i design in codice front-end
Fornisci a Kimi K2.5 uno screenshot, un mockup o un breve video dimostrativo e restituirà codice front-end funzionante a partire dall'input visivo. Designer e team di prodotto trasformano concetti statici in pagine interattive e prototipi in pochi minuti.

Analizza documenti e dati lunghi
Quando report o contratti arrivano a centinaia di pagine, i modelli Kimi li elaborano in un contesto da 256K-token per far emergere tendenze e conflitti. Gli analisti estraggono risposte strutturate con citazioni invece di leggere manualmente ogni pagina.

Orchestra sciami di agenti tramite la Kimi API
Gli sciami di agenti consentono a Kimi K2.5 di suddividere un obiettivo in un massimo di 100 sub-agenti paralleli, riducendo il tempo di esecuzione fino a 4.5x. I team automatizzano analisi batch e build di lungo formato che un singolo modello non riuscirebbe a completare.

Potenzia agenti autonomi che usano strumenti
Addestrati per l'uso agentico degli strumenti, i modelli Kimi chiamano funzioni esterne, APIs e ricerca per completare attività senza prompt passo dopo passo. Gli sviluppatori creano assistenti che prenotano, interrogano e agiscono su sistemi reali per conto dell'utente.

Migra alla Kimi API in pochi minuti
Poiché la Kimi API è compatibile con OpenAI, basta sostituire l'URL di base e una chiave per instradare il traffico verso i modelli Moonshot. Le startup adottano Kimi senza riscrivere la logica applicativa e pagano prezzi per chiamata trasparenti.
Kimi API vs API LLM concorrenti: contesto, modalità e costo
Confronta Kimi API con altre API di modelli linguistici di punta su Atlas Cloud e scopri dove primeggia per lunghezza del contesto, flessibilità dell’input e prezzo per token.
| Modello | Finestra di contesto | Tipi di input | Prezzo input ($/1M tokens) | Prezzo output ($/1M tokens) |
|---|---|---|---|---|
| Kimi K2.7 Code | 256K tokens | Testo, immagine | $0.95 | $4.00 |
| Kimi K2.6 | 256K tokens | Testo, immagine, video | $0.95 | $4.00 |
| Kimi K2.5 | 256K tokens | Testo, immagine, video | $0.60 | $3.00 |
| DeepSeek V4 Pro | 1M tokens | Testo | $1.74 | $3.45 |
| GLM 5.2 | 1M tokens | Testo | $1.40 | $4.40 |
| Grok 4.5 | 500K tokens | Testo | $2.00 | $6.00 |
| Doubao Seed 2.1 Pro | 256K tokens | Testo | $0.90 | $4.50 |
Come Utilizzare Kimi su Atlas Cloud
Inizia in pochi minuti — segui questi semplici passaggi per integrare e distribuire i modelli tramite la piattaforma Atlas Cloud.
Crea un Account Atlas Cloud
Registrati su atlascloud.ai e completa la verifica. I nuovi utenti ricevono crediti gratuiti per esplorare la piattaforma e testare i modelli.
Perché Usare Kimi su Atlas Cloud
Combinando i modelli avanzati di Kimi con la piattaforma GPU-accelerata di Atlas Cloud, ottieni prestazioni, scalabilità ed esperienza di sviluppo senza pari.
Prestazioni e Flessibilità
Bassa Latenza:
Inferenza ottimizzata su GPU per elaborazione in tempo reale.
API Unificata:
Esegui Kimi, GPT, Gemini e DeepSeek con un'unica integrazione.
Prezzi Trasparenti:
Fatturazione prevedibile per token con opzioni Serverless.
Enterprise e Scalabilità
Esperienza Sviluppatore:
SDK, analytics, strumenti di fine-tuning e template.
Affidabilità:
99,99% di uptime, RBAC e logging conforme alle normative.
Sicurezza e Conformità:
SOC 2 Type II, allineamento HIPAA, sovranità dei dati negli USA.
Domande sulla Kimi API, con risposte
La Kimi API offre agli sviluppatori accesso programmatico alla famiglia Kimi di large language models di Moonshot AI per reasoning, coding e comprensione di contesti lunghi. Su Atlas Cloud la usi tramite un unico endpoint compatibile con OpenAI, quindi una sola chiave copre ogni versione di Kimi con prezzi pay-as-you-go per singola chiamata.
Atlas Cloud ospita diverse versioni, tra cui Kimi K2.5 per workflow a contesto lungo e agentic, Kimi K2.6 come modello generalista più intelligente di Moonshot e Kimi K2.7 Code per programmazione e debugging. Poiché condividono lo stesso formato di richiesta, passare dall’uno all’altro significa solo cambiare una stringa del modello.
Questi modelli eccellono nel coding complesso, nell’analisi di repository multi-file, nel reasoning su grandi quantità di documenti e nelle chiamate a strumenti agentic. I team scelgono Kimi quando un’attività richiede sia un’ampia memoria di lavoro sia una solida logica passo passo, ad esempio per fare refactoring di un’intera codebase o revisionare report molto lunghi.
La fatturazione è pay-as-you-go, senza abbonamento e senza minimi. Kimi K2.5 costa $0.60 per milione di token di input e $3.00 per milione di token di output, mentre Kimi K2.6 e Kimi K2.7 Code costano $0.95 per milione di token di input e $4.00 per milione di token di output. Il context caching riduce il costo dei prompt ripetuti o condivisi.
Poiché Atlas Cloud espone Kimi tramite un’API compatibile con OpenAI, puoi puntare il tuo attuale OpenAI SDK all’endpoint Atlas e sostituire il nome del modello con uno Kimi. Non serve riscrivere la logica dell’applicazione: è quindi un vero drop-in per pipeline di chat, coding e agent.
Kimi K2.5, K2.6 e K2.7 Code supportano ciascuno una finestra di contesto da 262,144 token, circa 256K token. Questa capacità ti consente di inserire intere codebase, lunghi manuali tecnici o centinaia di pagine di report in una singola richiesta, senza suddivisione manuale in chunk.
Le versioni recenti di Kimi sono nativamente multimodali, non solo testuali. Kimi K2.6 accetta input di testo, immagini e video, e Kimi K2.5 ragiona su token visivi e testuali combinati: puoi quindi passare screenshot, file di design o registrazioni e farli interpretare dal modello insieme al tuo prompt.
Gli sviluppatori la scelgono soprattutto per costi e contesto. I report della community indicano risparmi significativi rispetto ai principali modelli proprietari a parità di qualità nel coding, e la finestra da 256K gestisce attività su interi repository e documenti completi che i modelli con contesti più brevi non possono affrontare. Inizia a creare oggi stesso.
Esplora Altre Famiglie
Seedance 2.5
L'API Seedance 2.5 è ora disponibile su Atlas Cloud! Offre agli sviluppatori il più recente modello video di ByteDance. Genera fino a 30 secondi di video nativo in un unico passaggio da testo, una singola immagine o fino a 50 riferimenti multimodali, con audio sincronizzato e testo multilingue nell'inquadratura. Su Atlas Cloud vi si accede tramite un'unica chiave, con la coerenza del soggetto e la fisica migliorata che mantengono coerenti le riprese lunghe.

Wan 3.0
L'API Wan 3.0 è la generazione successiva della famiglia di video Wan di Alibaba, creata per spingere la generazione di formati lunghi, il controllo multi-riferimento e la qualità audiovisiva a nuovi livelli. Atlas Cloud ospita già Wan 2.7, 2.6 e 2.5, e Wan 3.0 funziona sulla stessa chiave unificata senza alcuna configurazione separata. Inizia a costruire oggi stesso. Scorri verso il basso fino alla vetrina per vedere cosa è in grado di creare Wan 3.0.
MiniMax H3
MiniMax H3 è la famiglia di modelli video di MiniMax per la generazione guidata da testo, immagini e riferimenti. Crea clip da 5 a 15 secondi, guida il movimento con un ultimo fotogramma opzionale, mantieni i soggetti delle immagini di riferimento oppure seleziona H3 Developer quando l'audio generato si adatta al flusso di lavoro. Atlas Cloud riunisce H3, H3 Fast, H3 Max e H3 Developer in un unico flusso di lavoro API, con prezzi standard a partire da $0.038 al secondo. Inizia a sviluppare oggi.
Seedream 5.0 Pro
L'API Seedream 5.0 Pro offre agli sviluppatori il modello di editing delle immagini controllabile di ByteDance su Atlas Cloud. Posiziona le modifiche con precisione tramite ancore e coordinate, separa le immagini in livelli modificabili, fonde più riferimenti e abbina colori e materiali esatti, con testo multilingue a 2K e 3K. Su Atlas Cloud puoi accedervi tramite una sola chiave!
Seedance 2.0
L'API Seedance 2.0 ti offre l'accesso in produzione al modello video multimodale di ByteDance: input quadrimodali (testo, immagine, video, audio) e un sistema "Universal Reference" leader del settore che blocca la composizione, i movimenti di macchina e le azioni dei personaggi tra le diverse inquadrature. Integra un controllo di livello registico con una sola chiamata API, una tariffa fissa di $0,09/s, chiave istantanea e nessuna lista d'attesa, il tutto supportato da uptime e conformità di livello enterprise. Seedance 2.0 Native 4K è ora disponibile!
GPT Image 2.5
La famiglia gpt-image-2.5 di OpenAI offre agli sviluppatori la scelta tra Flare e Sunburst per i flussi di lavoro di produzione delle immagini. Esegui il rendering a risoluzioni arbitrarie fino a 3840x2160 e scegli tra cinque livelli di qualità, inclusi xhigh e max, per soddisfare requisiti di output specifici. Atlas Cloud offre un’inferenza REST pronta all’uso, senza avvii a freddo e con prezzi standard a partire da $0.004 per generazione. Inizia a creare oggi stesso.
GPT Image 2
L'API GPT Image 2 offre agli sviluppatori l'accesso all'ultimo modello di immagini di OpenAI, il successore di GPT Image 1.5. Genera e modifica immagini con un rendering accurato del testo nei caratteri latini e CJK, oltre a una solida composizione per poster, mockup e infografiche. Su Atlas Cloud puoi accedervi tramite un'unica API unificata insieme a oltre 300 modelli, con crediti gratuiti, un tempo di attività del 99,99% e nessuna verifica dell'organizzazione OpenAI richiesta.
Gemini Omni Flash
L’API gemini omni porta agli sviluppatori la famiglia Gemini Omni Flash nativamente multimodale di Google DeepMind, incluso Gemini Omni 1.1 Flash. Crea video cinematografici con audio nativo sincronizzato, anima immagini statiche con un controllo preciso dei fotogrammi iniziale e finale oppure modifica filmati esistenti tramite modifiche guidate dal testo, preservando i contenuti non modificati. Atlas Cloud offre un’unica chiave compatibile con OpenAI, accesso unificato e prezzi trasparenti basati sul consumo. Inizia a creare oggi.
Grok Imagine
L'API Grok Imagine supporta i modelli di immagine, video e sintesi vocale di xAI, da Image 2.0 a Video 1.5 e xAI TTS v1. Genera immagini statiche 1K o 2K su 14 proporzioni d'aspetto, crea scene fino a 15 secondi di movimento 1080p, guida gli scatti con fino a 7 immagini di riferimento, o narrarli in 20 lingue. Atlas Cloud esegue ogni modalità su un singolo endpoint, con prezzi pay-as-you-go da $0,02 per immagine e $0,05 al secondo. Inizia a sviluppare oggi.
I modelli creativi più potenti di Google sono tutti disponibili su Atlas Cloud. Veo 3.1 offre la generazione di video cinematografici, Nano Banana 2 alimenta la creazione di immagini ad alta fedeltà e Gemini porta l'intelligenza multimodale in ogni flusso di lavoro. Accedi alla suite completa di modelli Google tramite una singola API key con disponibilità Day-0 e prezzi a consumo (pay-as-you-go).
Seedance 2.0 Mini
Seedance 2.0 Mini porta la generazione video multimodale di ByteDance nei flussi di lavoro in cui velocità e costi sono fondamentali. Offre le capacità principali di Seedance 2.0 con un impatto minore: generazione più rapida, costi inferiori per video e la stessa integrazione API che utilizzi già. Per i team che gestiscono pipeline ad alto volume o prototipazione su larga scala, Mini è l'opzione predefinita pratica.
ByteDance
Dalla generazione di video cinematografici alla creazione di immagini ad alta fedeltà, i modelli più potenti di ByteDance sono disponibili su Atlas Cloud. Esegui Seedance e Seedream su larga scala con i prezzi di inferenza più bassi e zero costi generali di infrastruttura.
Articoli consigliati
Guide, tutorial e novità di prodotto per sfruttare al meglio Atlas Cloud.


