Il codice sembra finito. Poi i test falliscono, la correzione cambia un'interfaccia e parte un'altra richiesta. Scegliere la migliore api ai per il coding significa trovare un modello e un endpoint che completino il tuo tipo di lavoro entro un budget accettabile.
Inizia con Claude, GPT o Gemini come candidato di riferimento. Confronta DeepSeek, Qwen e Kimi sugli stessi compiti se desideri opzioni alternative di deployment e spesa. Per il debug, dai priorità ai test di regressione. Per il refactoring, ispeziona il diff. Per un agente di coding, verifica l'intero ciclo degli strumenti prima di confrontare i prezzi dei token.
La frustrazione è misurabile. Nel sondaggio sugli sviluppatori di Stack Overflow del 2025, il 66% degli intervistati alla domanda sulle frustrazioni ha segnalato soluzioni AI quasi corrette; il 45% ha dichiarato di aver trascorso più tempo a fare debug del codice generato. Queste sono risposte a un sondaggio, non una valutazione di modelli del 2026. (Sondaggio sugli sviluppatori di Stack Overflow, 2025)
Punti chiave
- Scegli l'API e l'agente separatamente.
- Crea una shortlist in base al compito e alle funzionalità endpoint richieste.
- Salva le prime risposte e giudicale rispetto a test di accettazione fissi.
- Includi tentativi falliti e correzioni nel calcolo dei costi.
Questa guida fornisce una shortlist, tre compiti di valutazione copiabili e un foglio di lavoro sui costi. La ricerca è stata verificata il 21 settembre 2026. Disponibilità dei modelli, capacità documentate e risultati misurati sono categorie di evidenza separate in tutto il testo.
Migliore API AI per il coding: la shortlist
Inizia con due candidati: uno adatto alla tua applicazione esistente e uno alternativo. Usa queste sei famiglie per costruire quella coppia iniziale.
La tabella propone test, senza rivendicare prestazioni comparative. L'accesso dipende dal tuo account, regione, quota ed endpoint; una voce nella documentazione non conferma che le tue credenziali possano chiamarlo.
| Modello specifico e ID | Percorso di accesso | Compito da valutare | Confine decisionale principale | Evidenza endpoint | Verifica prezzo |
|---|---|---|---|---|---|
Claude Opus 5, claude-opus-5 | API Anthropic | Modifiche multi-file vincolate | Verifica controlli client e reasoning | Panoramica modello Claude Platform; accesso account non testato | Nessuna tariffa indicata |
GPT-6 Astra, gpt-6-astra | API OpenAI | Compiti di coding multi-condizione | Verifica percorso e strumenti | Documentazione modelli OpenAI; accesso account non testato | Nessuna tariffa indicata |
Gemini 3.8 Flash, gemini-3.8-flash | API Gemini | Generazione e revisione interattive | Verifica latenza e protocollo | Directory modelli Google AI; accesso account non testato | Nessuna tariffa indicata |
DeepSeek V4 Pro, deepseek-ai/deepseek-v4-pro | Atlas Cloud percorso modello | Correzioni numeriche; esperimenti di contesto | Mantieni separata la versione 0813 | Pagina modello esatta verificata; funzionalità runtime non testate | 21 settembre 2026 |
Qwen3.5 122B A10B, qwen/qwen3.5-122b-a10b | Percorso modello Atlas Cloud | Refactoring; interfacce autonome | Versione specificata; non la più recente | Pagina modello esatta verificata; funzionalità runtime non testate | 21 settembre 2026 |
Kimi K3, moonshotai/kimi-k3 | Percorso modello Atlas Cloud | Gli stessi tre compiti; interfaccia CSV | Verifica limiti di output e completamento | Pagina modello esatta verificata; funzionalità runtime non testate | 21 settembre 2026 |
Claude, GPT e Gemini forniscono utili candidati di riferimento. Le loro directory ufficiali dei modelli identificano le versioni sopra. Usa un provider che già conosci come baseline, poi verifica se un'alternativa riduce il costo per compito accettato o il lavoro di integrazione. Non trattare il comportamento di un assistente consumer come il risultato API corrispondente.
La directory dei modelli di OpenAI elenca GPT-6 Astra insieme alla famiglia GPT-5.6. Ciò stabilisce un candidato attuale, non una vittoria nel coding sulle altre righe. La tabella evita deliberatamente di importare vecchi ID modello da pagine di confronto non datate. (Directory dei modelli OpenAI, consultata a settembre 2026)
DeepSeek si guadagna un posto come famiglia di modelli separata da investigare. Verifica se corregge il bug particolare senza ampliare la modifica. Scegli un altro candidato se il percorso distribuito non può soddisfare il formato di risposta richiesto, il comportamento degli strumenti o il limite di latenza, indipendentemente dalla reputazione generale del modello.
Valuta Qwen per versione. Il deployment nominato 122B A10B fornisce un riferimento di prezzo concreto. Esegui i controlli di parsing e browser prima di trarre una conclusione di valore. Le cifre di contesto di altre release Qwen non possono essere assegnate a questo modello.
Kimi è il candidato di configurazione elaborato. La sua pagina pubblica identifica l'ID modello. La revisione della configurazione è possibile; la generazione riuscita rimane non verificata. Valuta l'output completato rispetto agli stessi vincoli degli altri candidati.
Atlas Cloud si colloca a livello di accesso in questo confronto. Non è un settimo modello. La sua rilevanza è pratica: puoi ispezionare diverse pagine di modelli candidati e confrontare i loro requisiti di integrazione prima di impegnarti in un flusso di lavoro.
Per i pesi aperti, verifica la licenza di release esatta e l'artefatto di deployment. L'inferenza ospitata ha termini di servizio e costi operativi separati; la sola famiglia di modelli non può stabilirli.
API, modelli e agenti di coding spiegati
Un modello produce contenuto in risposta a un input. Un'API definisce come la tua applicazione invia quell'input e riceve il risultato. Un agente di coding organizza il lavoro circostante: leggere file, chiamare strumenti, applicare modifiche, eseguire test e decidere se continuare.
Questi tre livelli possono fallire indipendentemente. Un modello può proporre una patch corretta mentre l'agente la scrive nel file sbagliato. Un'API può restituire JSON valido mentre l'applicazione ignora una chiamata a strumento. Un agente capace può bloccarsi perché l'endpoint selezionato rifiuta un parametro.
Supponi di inviare un handler e chiedere un parser di ID. Un'API di generazione di codice di base restituisce testo contenente codice. Il tuo programma deve ancora estrarre quel codice, collocarlo in un workspace adatto ed eseguire i test. Una risposta HTTP riuscita stabilisce la consegna, non la correttezza.
Un agente può automatizzare quei passaggi solo se fornisci gli strumenti e i permessi. Ha anche bisogno di una condizione di arresto. Senza una, può modificare ripetutamente una funzione già accettabile, espandere il compito o spendere richieste aggiuntive cercando di migliorare un dettaglio irrilevante.
Tieni separate tre voci di budget:
- Abbonamento agli strumenti: l'applicazione, l'integrazione con l'editor o il servizio agente che usi.
- Utilizzo dell'inferenza: richieste all'endpoint del modello selezionato, secondo i suoi termini di fatturazione.
- Ambiente di esecuzione: container, test runner, storage e altre infrastrutture.
Alcuni prodotti raggruppano parti di questo stack. Altri si aspettano che tu fornisca credenziali separate. Controlla il piano specifico prima di presumere che un abbonamento editor includa traffico API arbitrario dalla tua applicazione.
Anche la compatibilità di protocollo ha un confine. Un servizio che accetta un array messages familiare può comunque esporre comportamento degli strumenti, eventi di streaming, limiti di contesto o controlli di reasoning diversi. Copiare un base URL non può stabilire il supporto per ogni funzionalità nell'ecosistema di un altro provider.
Mappa applicazione, agente, endpoint, modello, strumenti e test. Identifica il componente fatturabile e l'operatore responsabile a ogni passaggio prima di cambiare modello.
Migliore API AI per il coding: 7 controlli di selezione
1. Correttezza funzionale e comportamento di regressione. Scrivi gli output attesi prima di richiedere codice. Una funzione di prezzo che gestisce interi ordinari ma accetta null come zero viola il contratto. Esegui sia i nuovi casi limite sia i test di progetto esistenti; superare un nuovo test può nascondere un chiamante rotto altrove.
2. Ambito della modifica. Confronta la patch con la richiesta. Estrarre un parser di ID dovrebbe preservare URL, risposta di successo e risposta di errore. Una migrazione di framework non richiesta aggiunge lavoro di revisione anche quando il sostituto compila. Decidi in anticipo se modifiche non correlate squalificano la risposta o richiedono una correzione.
3. Contesto utile e spazio per l'output. La tua richiesta include istruzioni, file rilevanti, definizioni di strumenti e conversazione precedente. Riserva abbastanza spazio anche per la risposta. Un'ampia finestra di contesto pubblicizzata non stabilisce che il modello troverà l'invariante rilevante, né che il tuo endpoint accetti lo stesso massimo.
Testa la qualità del contesto con una dipendenza che conta. Includi un chiamante la cui interfaccia deve rimanere stabile e verifica che il modello la rispetti. Misura la troncatura separatamente: una risposta che termina a metà di una funzione non può essere accettata perché le sue prime righe sembravano promettenti.
4. Tool calling e output strutturato. Verifica il percorso distribuito con il tuo schema di strumenti effettivo. Controlla tipi di argomenti, campi mancanti, identificatori di strumenti e la risposta successiva dopo un risultato di strumento. Un modello che scrive un oggetto JSON plausibile non ha necessariamente completato un round trip nativo di tool-call.
5. Tempo per un risultato accettato. Registra la durata dell'intero tentativo, incluse correzioni e test. Per un assistente interattivo, conta anche il tempo al primo testo visibile, ma non può sostituire il tempo di completamento. Un primo token rapido seguito da una lunga risposta inutilizzabile blocca comunque lo sviluppatore.
6. Addebiti per input, output, cache e retry. Leggi le categorie di fatturazione che il tuo endpoint scelto effettivamente riporta. Separa le letture cache dall'input ordinario quando applicabile. Traccia richieste non riuscite e cicli interrotti. Se il provider non espone il dettaglio che ti serve, segna esplicitamente le ipotesi mancanti della stima.
7. Condizioni di integrazione e gestione del codice. Conferma che il tuo editor o applicazione supporti il percorso, il metodo di autenticazione e il formato degli errori. Rivedi i termini attuali di gestione dei dati del provider prima di inviare codice sorgente privato. I pesi aperti descrivono una scelta di distribuzione del modello; non stabiliscono come un servizio ospitato tratta le tue richieste.
I benchmark pubblici possono aiutarti a selezionare i candidati, a condizione che tu ne legga le condizioni. SWE-bench Verified contiene 500 istanze filtrate manualmente. La sua pagina attuale descrive anche una vista Bash Only che utilizza lo stesso ambiente mini-SWE-agent. Questi dettagli aiutano a spiegare cosa viene confrontato. (SWE-bench, consultato a settembre 2026)
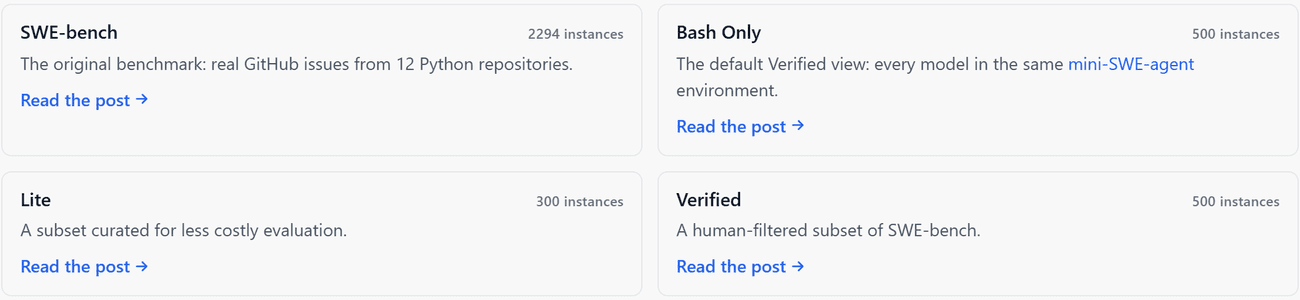 Pagina SWE-bench che mostra la dimensione del dataset Verified e l'ambiente agente condiviso
Evidenza di origine: la pagina reale del benchmark, catturata il 21 settembre 2026. Dataset e condizioni di esecuzione appartengono accanto a qualsiasi affermazione sulle prestazioni.
I risultati dei benchmark descrivono una configurazione particolare. Il tuo linguaggio, le regole di business, i permessi e gli standard di revisione possono differire. Prendi la decisione finale su lavoro che puoi ispezionare.
Migliore API AI per il coding: esegui tre verifiche pratiche
Questi tre esempi di valutazione riproducibili espongono diverse modalità di fallimento. Fissa le loro regole di accettazione prima di richiedere output. Giudica la funzione o la pagina rispetto al suo contratto, indipendentemente dalla qualità della spiegazione.
Per DeepSeek V4 Pro, Qwen3.5 122B A10B e Kimi K3, il protocollo previsto è tre esecuzioni indipendenti per compito. Ciò significa 27 tentativi iniziali. Consenti al massimo una correzione su feedback per tentativo, preserva la prima risposta e riporta separatamente gli esiti iniziali e corretti.
Richiedi temperatura zero solo dove supportato, registrando l'impostazione effettiva accettata. Usa un tetto di output richiesto di 4.096 token per A e B e 8.192 per C dopo aver controllato i limiti dell'endpoint. I valori predefiniti e i controlli non supportati devono essere registrati. Una temperatura bassa non garantisce risposte identiche.
Stato delle evidenze: l'accesso all'ambiente di test è stato bloccato da una schermata di login di Cloudflare Access. I 27 tentativi candidati non hanno potuto essere eseguiti. Le evidenze seguenti mostrano codice originale eseguito localmente e un fixture di riferimento CSV creato per l'articolo, non risultati di modelli candidati. Tassi di superamento dei modelli, utilizzo dei token e costi per compito rimangono non misurati.
Compito A: correggi la selezione numerica del prezzo. Incolla questo prompt esatto in una sessione nuova:
plaintext1Fix this JavaScript function without mutating the input array. 2Accept only finite numbers and non-empty strings that convert to finite numbers. 3Reject booleans, null, undefined, empty strings, NaN, and Infinity. 4Return the lowest valid price as a number, or null if none exists. 5Do not add dependencies. 6Return only the complete function. 7 8function lowestPrice(prices) { 9 return prices.sort()[0] ?? null; 10}
Gli input di accettazione fissi sono [2,10,3], ["12","3"], un array vuoto, valori solo non validi, zero, numeri negativi e stringhe di soli spazi. Rifiuta stringhe vuote dopo il trim. Verifica che l'array originale abbia esattamente gli stessi elementi nello stesso ordine dopo la chiamata.
L'originale usa l'ordinamento predefinito di JavaScript e muta il suo input. Il compito quindi verifica due obblighi distinti: selezionare il minimo numerico corretto ed evitare di modificare i dati del chiamante. Testa esplicitamente le regole di conversione perché una soluzione breve basata su coercizione può accidentalmente accettare booleani o null.
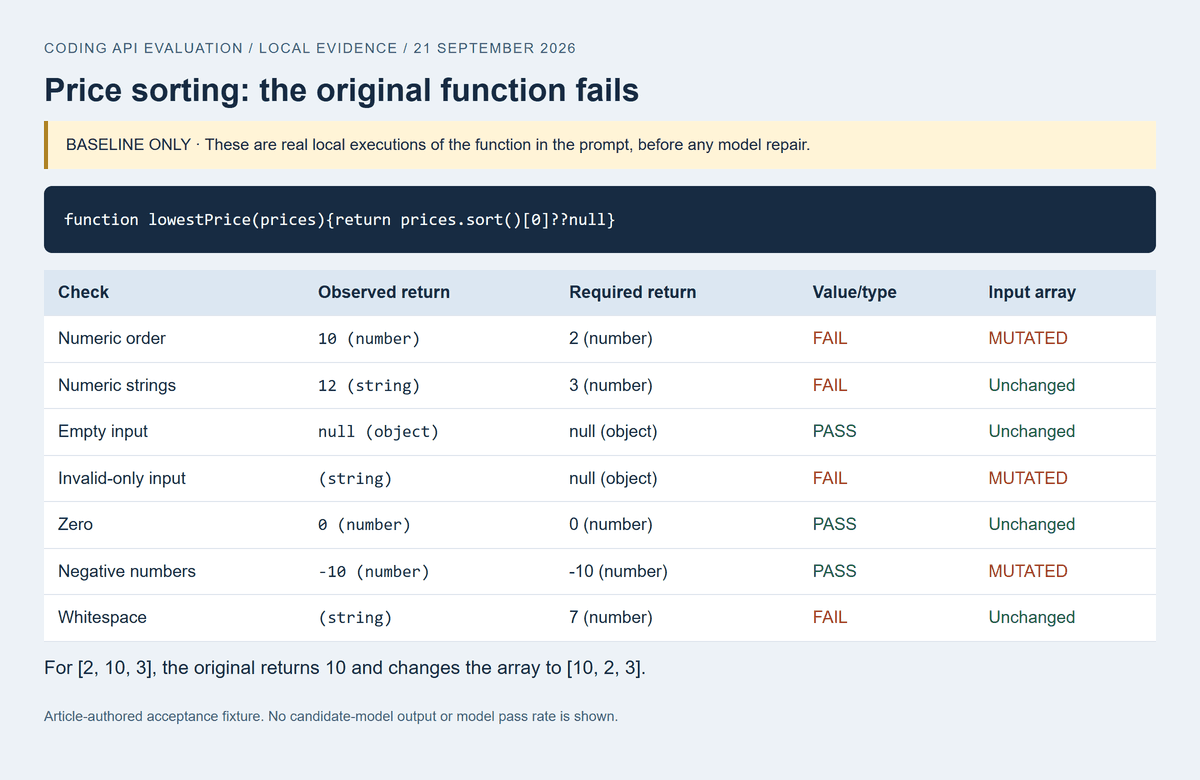 Esecuzione locale della funzione di prezzo originale che mostra ordinamento numerico errato e input mutato
Baseline eseguita: la funzione originale restituisce 10 per [2,10,3] e cambia l'array in [10,2,3]. Anche le stringhe numeriche falliscono il contratto sul valore di ritorno. Nessuna correzione del modello è mostrata.
Compito B: preserva un'interfaccia durante un piccolo refactoring. Usa questo prompt invariato:
plaintext1Refactor this Express-style handler by extracting a pure parseUserId(value) function. 2A valid ID is a string containing only digits, representing a positive safe integer. 3Return null for every invalid value. 4Preserve the handler's existing success response and its 400 error response. 5Do not add dependencies or change the URL. 6Return parseUserId and the updated handler only. 7 8app.get('/users/:id', async (req, res) => { 9 const id = Number(req.params.id); 10 if (!Number.isInteger(id) || id <= 0) { 11 return res.status(400).json({ error: 'invalid id' }); 12 } 13 const user = await findUser(id); 14 return res.json({ user }); 15});
Accetta "12" e "0012" come 12. Rifiuta "1e2", "1.0", negativi, zero, spazi bianchi, input non stringa e valori oltre l'intervallo safe-integer di JavaScript. Verifica il percorso registrato e entrambi i corpi di risposta. L'input non valido non deve raggiungere findUser.
Questo compito verifica se il modello comprende la differenza tra conversione numerica e la grammatica della stringa specificata. Ispeziona il diff per modifiche non correlate, poi chiama l'handler con oggetti request e response stub. Un helper corretto abbinato a un handler invariato e permissivo fallisce comunque.
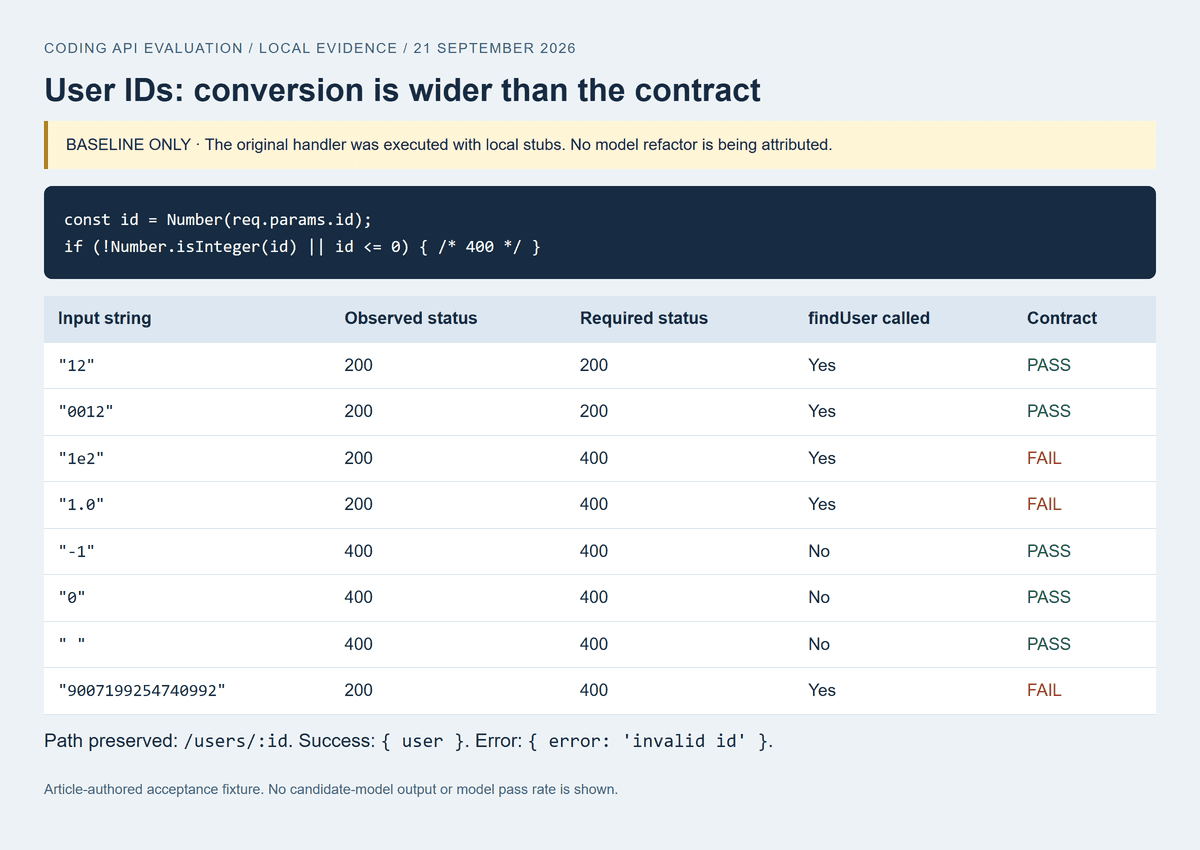 Log di test dell'handler originale che mostra stringhe numeriche non valide accettate con stato 200
Baseline eseguita: l'handler originale restituisce 200 per "1e2", "1.0" e "9007199254740992", nonostante la risposta 400 richiesta. Gli stub locali hanno registrato le chiamate; questo non è un refactoring generato da un modello.
Compito C: costruisci un'anteprima CSV che puoi gestire. Invia:
plaintext1Create one self-contained HTML file for a local CSV preview tool. 2Use plain HTML, CSS, and JavaScript with no external libraries or network requests. 3Include a labeled textarea, a Preview button, an error message area, and a semantic table. 4Support quoted fields, commas inside quoted fields, escaped double quotes, 5and both LF and CRLF line endings. 6Treat the first record as the header. 7Report inconsistent field counts without silently dropping data. 8Insert cell values as text, never as HTML. 9Return only the complete HTML file.
Testa con questi record esatti, prima usando LF e poi CRLF:
plaintext1name,notes 2Alice,"Hello, world" 3Bob,"He said ""yes""" 4Eve,<img src=x onerror=alert(1)>
Aspettati due colonne, tre righe di dati, la virgola di Alice all'interno di una cella e la virgoletta escapata di Bob visualizzata correttamente. Il valore di Eve deve apparire come testo letterale, senza elementi immagine, esecuzione di eventi o richieste di rete. Aggiungi una riga con tre campi e conferma che la pagina segnali visibilmente la discrepanza.
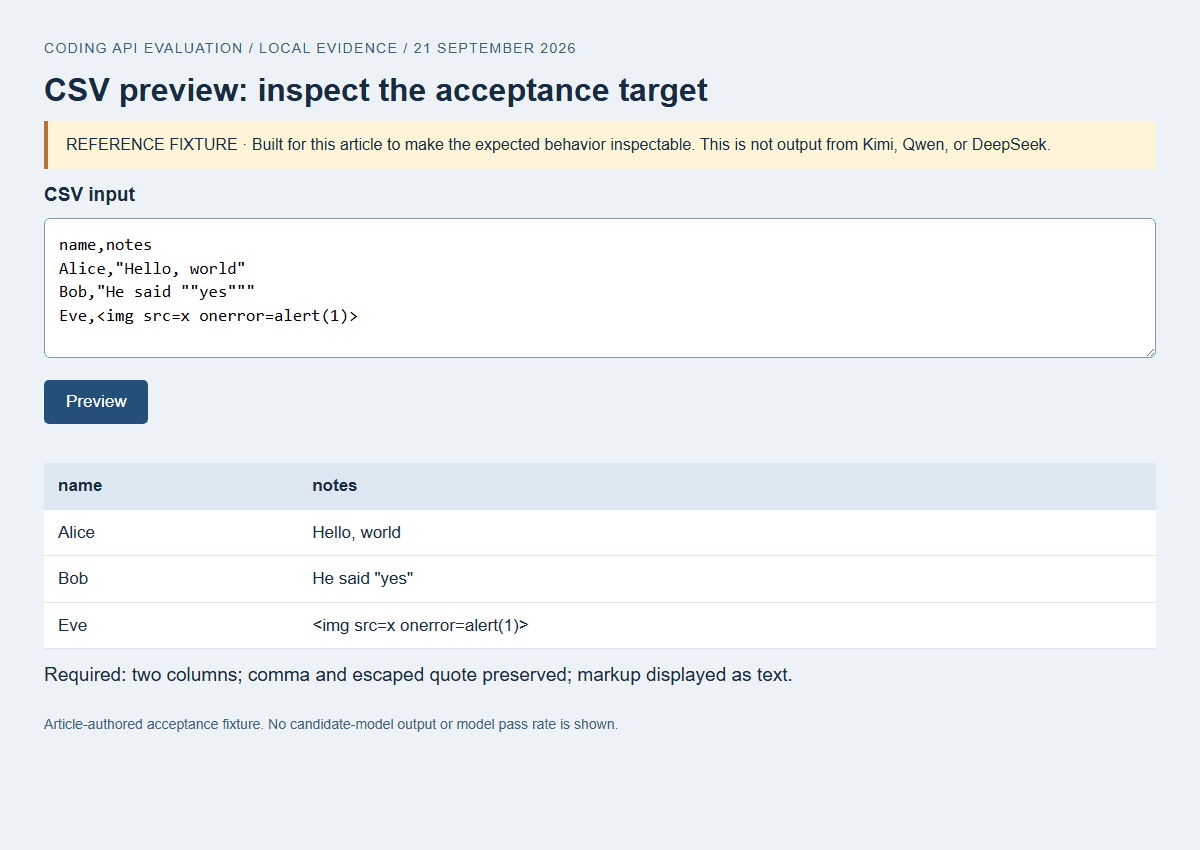 Fixture di accettazione CSV che mostra valori tra virgolette e requisiti di markup letterale
Fixture di riferimento gestita, creata per questo articolo, non generata da un modello candidato. I controlli del browser hanno verificato il parsing LF/CRLF, le virgolette escapate, il markup letterale, errori visibili di conteggio campi e nessuna richiesta HTTP. Lo screenshot mostra lo stato di input valido dopo aver cliccato Preview.
Salva output grezzo, log, ID modello, data, parametri, tempistica, correzioni e modifiche manuali. Invia asserzioni fallite per una correzione senza cambiare gli esiti attesi. Conserva rifiuti, troncature ed errori insieme ai successi.
Migliore API AI per il coding con un budget
Confronta le tariffe dei token insieme a qualità di completamento e utilizzo. Input ripetuti possono dominare i costi di code-review; la generazione di interi file può aumentare gli addebiti di output. Le correzioni ripetute aggiungono entrambi.
Il catalogo Atlas e le pagine di dettaglio esatte mostravano queste tariffe in USD per milione di token il 21 settembre 2026:
- DeepSeek V4 Pro: $1.68 input e $3.38 output. La voce separata V4 Pro 0813 utilizza tariffe diverse; non sostituirla.
- Qwen3.5 122B A10B: $0.30 input e $2.40 output. Il catalogo mostrava tariffe regolari di $0.40 e $3.20 con uno sconto del 25%, a settembre 2026.
- Kimi K3: $3.00 input e $15.00 output.
Queste sono tariffe di produzione visualizzate, non fatture della valutazione dell'articolo. Le tariffe specifiche per la cache e la loro applicabilità non sono state confermate. Gli sconti promozionali per DeepSeek e Kimi non sono stati confermati. L'assenza di un'osservazione di sconto non prova che non esista un'offerta.
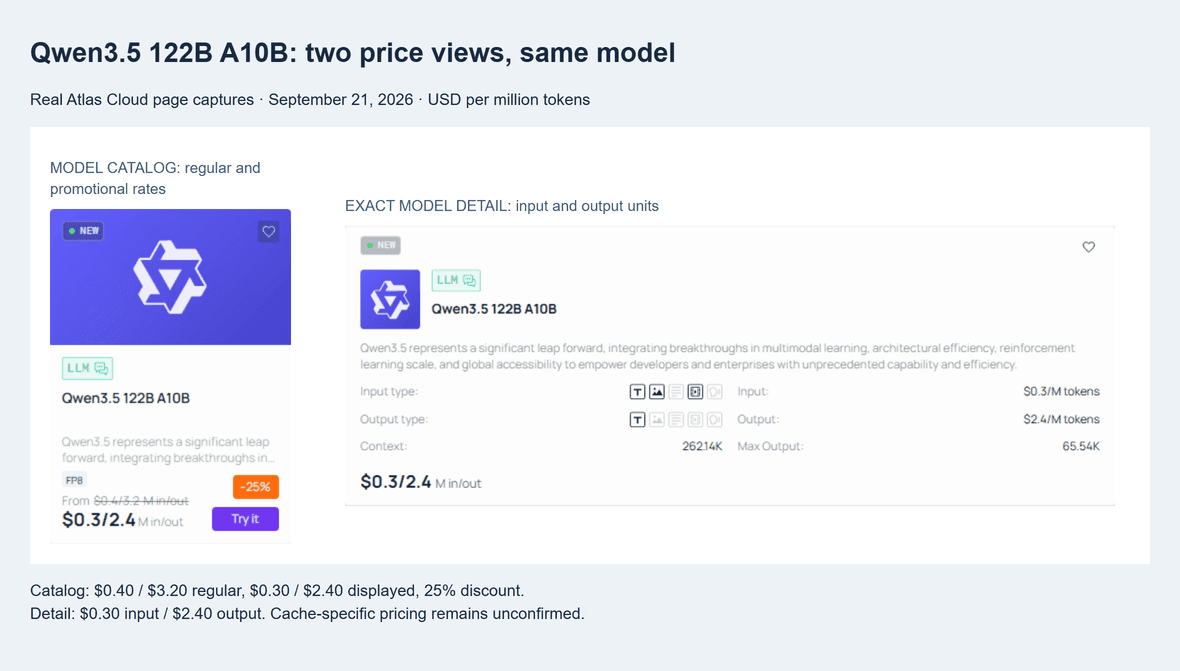 Sconto di catalogo Qwen3.5 122B A10B accanto alle sue tariffe di input e output esatte nel dettaglio modello
Verifica incrociata dei prezzi Qwen, 21 settembre 2026: il catalogo mostra la promozione del 25%; il dettaglio esatto del modello conferma $0.30 input e $2.40 output per milione di token. Le tariffe specifiche per la cache rimangono non confermate.
Calcola la porzione di modello di un compito come:
plaintext1Task model cost = sum of each request's applicable billing categories 2 3Ordinary input cost = uncached input tokens / 1,000,000 × input rate 4Output cost = billable output tokens / 1,000,000 × output rate 5Add separately priced cache reads, cache writes, or other applicable items. 6 7Model cost per accepted task = all evaluation request charges / accepted tasks
Non addebitare di nuovo i token in cache come input ordinario se il record di fatturazione li tratta separatamente. Controlla se l'utilizzo di reasoning è incluso nell'output fatturabile. Se nessun compito passa, riporta "nessun risultato riuscito"; dividere per zero o mostrare un costo di completamento pari a zero indurrebbe il lettore in errore.
Per un esempio aritmetico trasparente, assumi 10.000 token di input ordinario e 2.000 token di output alle tariffe Qwen visualizzate. L'addebito stimato del modello è $0.0078, prima di qualsiasi altro elemento applicabile. Questa è una richiesta ipotetica, non un utilizzo di token osservato o una fattura effettiva.
Una correzione di pari dimensione porterebbe la stima a $0.0156. Le correzioni effettive includono contesto e output diversi, quindi calcola ogni richiesta dal suo utilizzo registrato.
| Compito | Modello | Prima passata | Dopo correzione | Utilizzo token | Fonte costo | Addebito totale | Tempo totale | Modifiche manuali |
|---|---|---|---|---|---|---|---|---|
| A, B, C; 3 ripetizioni ciascuno pianificate | DeepSeek V4 Pro | Non misurato | Non misurato | Non registrato | Nessun record di utilizzo | Sconosciuto | Non misurato | Nessuna valutata |
| A, B, C; 3 ripetizioni ciascuno pianificate | Qwen3.5 122B A10B | Non misurato | Non misurato | Non registrato | Nessun record di utilizzo | Sconosciuto | Non misurato | Nessuna valutata |
| A, B, C; 3 ripetizioni ciascuno pianificate | Kimi K3 | Non misurato | Non misurato | Non registrato | Nessun record di utilizzo | Sconosciuto | Non misurato | Nessuna valutata |
Per il tuo foglio di lavoro, espandi ogni riga in una riga per modello e ripetizione. Conta un successo corretto una volta nel denominatore dei compiti accettati. Includi i tentativi non riusciti nel numeratore e mantieni colonne separate per prima passata e accettazione finale.
Traccia separatamente revisione umana e infrastruttura. Districare una riscrittura non necessaria può annullare un risparmio di inferenza. Confronta candidati che soddisfano sia i requisiti di accettazione sia il tuo budget di tempo di revisione.
Migliore API AI per il coding con Atlas Cloud
Inizia con la pagina del modello Kimi K3, conferma l'ID e ispeziona le viste API e Code. Tieni la versione scelta accanto al record di test.
Leggi la documentazione del protocollo LLM prima di trattare due percorsi come intercambiabili. Identifica Chat Completions come percorso ad ampia copertura e indirizza gli utenti ai supported_apis di ciascun modello. Anche i controlli di campionamento e le funzionalità degli strumenti dipendono dal supporto pubblicizzato del modello.
Ci sono dettagli concreti di integrazione che vale la pena controllare qui. La documentazione afferma che le richieste Anthropic tradotte non applicano cache_control e che gli strumenti ospitati dal provider non sono disponibili su quel percorso tradotto. Questi vincoli contano se il tuo agente esistente presuppone caching nativo o uno strumento di browsing ospitato. Abbina il client al percorso effettivo.
Il seguente esempio Node.js illustra una richiesta di testo. Usa fetch integrato, una variabile d'ambiente per le credenziali e l'ID modello Kimi verificato. Salva il prompt esatto del Compito A come task-a.txt. Imposta la variabile d'ambiente base URL sulla base dell'API Atlas mostrata nella sua documentazione, che termina con /v1.
javascript1// Node.js 20+. Configuration example; not an executed benchmark. 2import { readFile } from 'node:fs/promises'; 3 4const key = process.env.ATLASCLOUD_API_KEY; 5const base = process.env.ATLASCLOUD_BASE_URL; 6if (!key || !base) throw new Error('Missing Atlas configuration'); 7const endpoint = new URL('/v1/chat/completions', base); 8 9const prompt = await readFile('task-a.txt', 'utf8'); 10try { 11 const response = await fetch(endpoint, { 12 method: 'POST', 13 headers: { 14 Authorization: `Bearer ${key}`, 15 'Content-Type': 'application/json' 16 }, 17 body: JSON.stringify({ 18 model: 'moonshotai/kimi-k3', 19 messages: [{ role: 'user', content: prompt }], 20 max_tokens: 4096, 21 stream: false 22 }), 23 signal: AbortSignal.timeout(120000) 24 }); 25 if (!response.ok) throw new Error(`HTTP ${response.status}`); 26 const result = await response.json(); 27 const choice = result.choices?.[0]; 28 if (choice?.finish_reason !== 'stop' || 29 typeof choice.message?.content !== 'string' || 30 !choice.message.content.trim()) { 31 throw new Error('Incomplete or unsupported text response'); 32 } 33 console.log(choice.message.content); 34 console.error(JSON.stringify({ usage: result.usage ?? null })); 35} catch (error) { 36 console.error(error instanceof Error ? error.message : 'Request failed'); 37 process.exitCode = 1; 38}
messages trasporta il compito; model seleziona il deployment; max_tokens richiede un tetto di output. Il lettore della risposta controlla la presenza di testo completato ordinario prima di restituire codice. Il timeout limita l'attesa di questo esempio; non stabilisce che il server abbia smesso di elaborare o che non sia avvenuto alcun addebito.
La temperatura è omessa perché il supporto per modello e il comportamento impegnato necessitano di verifica. L'esempio non ritenta automaticamente. Rivedi la classe di errore prima di aggiungere una politica di retry limitata e non registrare mai l'header di autorizzazione. Questo codice di pubblicazione non è stato eseguito con una chiave API durante la produzione dell'articolo.
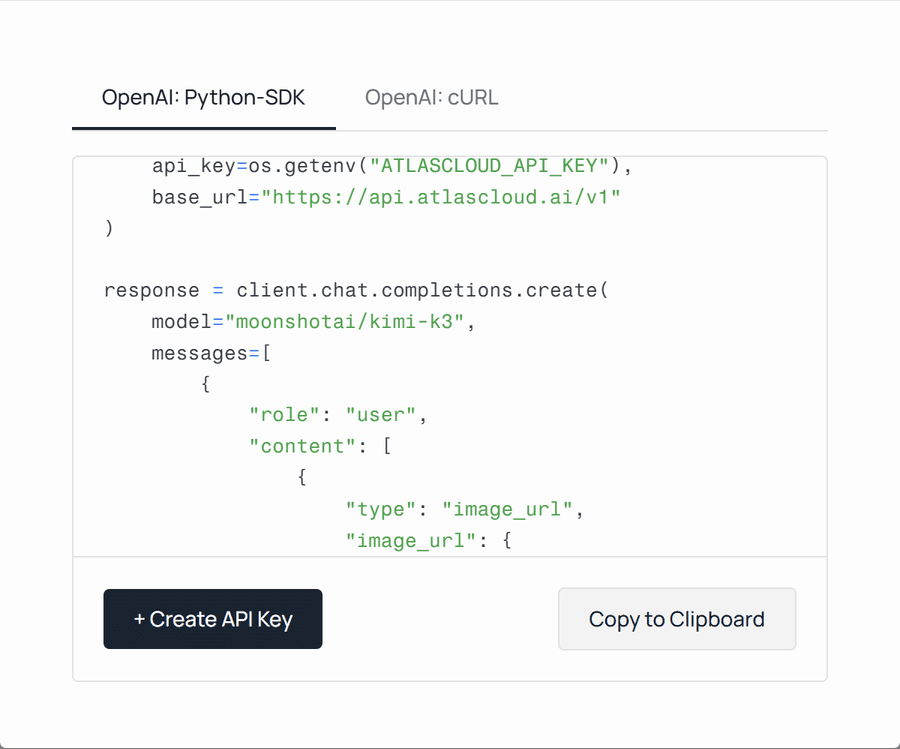 Esempio pubblico di codice API Kimi K3 che mostra l'endpoint Atlas e l'identificatore del modello
Dialogo Code pubblico di Kimi K3, catturato il 21 settembre 2026. Questa è evidenza di configurazione, non un'esecuzione di coding completata. Il campione della pagina include input multimediale; l'esempio dell'articolo usa solo testo.
Esegui i controlli di accettazione del Compito A su qualsiasi funzione restituita. Prima di passare a DeepSeek o Qwen, verifica il suo protocollo e i suoi parametri. Mantieni invariati prompt e test mentre confronti output e utilizzo; una forma di richiesta condivisa non stabilisce un comportamento identico.
Prima di usare un'API di coding in produzione
Esegui il codice generato prima in un branch usa e getta o in un workspace isolato. Per il compito CSV, usa un contesto browser locale con richieste di rete bloccate e nessun accesso a stato applicativo sensibile. Per i compiti su repository, fornisci al processo solo i file e i comandi necessari per la valutazione.
Definisci il successo al di fuori della risposta del modello. Un agente che dice "tutti i test superati" dovrebbe portarti a un log di test effettivo, a un codice di uscita e a una revisione controllata. Archivia il diff con quell'evidenza. Altrimenti, una correzione successiva può cambiare i file dopo l'apparente successo e lasciare il report obsoleto.
Tratta timeout e retry come comportamento applicativo di tua competenza. Imposta una scadenza per la richiesta e un budget totale per il compito. Separa gli errori causati da credenziali o parametri non validi dai fallimenti transitori di trasporto. Ripetere una richiesta non valida spreca tempo; ripetere una richiesta che attiva effetti collaterali può creare lavoro duplicato.
Quando l'agente può chiamare strumenti, distingui l'ispezione in sola lettura dalle scritture. Assegna identificatori di operazione dove il tuo design degli strumenti lo supporta e conferma lo stato prima di ripetere una scrittura incerta. La politica di retry di un endpoint modello non può garantire l'idempotenza per gli strumenti che la tua applicazione esegue successivamente.
Proteggi i log con la stessa attenzione dei file sorgente. Registra ID modello, timestamp, stato, tempistica e utilizzo senza copiare routinariamente segreti o interi repository privati nella telemetria. Conserva qualsiasi evidenza richiesta di output grezzo in una posizione adeguatamente ristretta e stabilisci per quanto tempo il team deve conservarla.
Controlla lo streaming con il tuo client reale. Deve gestire eventi parziali, terminazione, errori e record di utilizzo dove disponibili. Conferma i limiti di frequenza per l'account e il deployment effettivi. Un esperimento tranquillo con un singolo utente non può stabilire come si comporta lo stesso percorso quando un team invia richieste contemporaneamente.
Usa questa breve checklist di rilascio:
- I test di accettazione e le regressioni esistenti passano sulla revisione finale.
- Il diff rimane entro il confine del compito approvato.
- Il comportamento di timeout, annullamento e retry è stato esercitato.
- Le chiamate agli strumenti e le risposte strutturate funzionano sull'endpoint selezionato.
- I log escludono credenziali e codice privato non necessario.
- I termini di gestione dei dati soddisfano i requisiti del team.
- Un fallback ha la propria configurazione verificata e il proprio record di test.
I repository privati richiedono una decisione specifica per il servizio. Rivedi le condizioni attuali di conservazione, uso per addestramento, accesso e contrattuali con la persona responsabile del codice. Invia solo materiale approvato. Non dedurre la riservatezza dal fatto che i pesi del modello siano disponibili o da un protocollo simile a uno che già usi.
Migliore API AI per il coding: fai la scelta finale
Prendi la decisione in tre passaggi.
Primo, elimina i candidati che mancano di una capacità richiesta. Annota le condizioni che devono valere: un formato di output accettato, un ciclo di strumenti funzionante, un'adeguata organizzazione della gestione dei dati o una scadenza di risposta praticabile. Un candidato che ne manca una necessita di una decisione di rimedio separata prima di appartenere al confronto finale.
Secondo, confronta costo per compito accettato e tempo trascorso. Usa tutti i tentativi sotto la stessa politica di correzione. Separa i successi in prima passata dai successi corretti e mostra i record di utilizzo mancanti. Se due modelli soddisfano entrambi il contratto, confronta il loro carico di revisione oltre agli addebiti del modello. I tuoi sviluppatori dovranno convivere con le patch risultanti.
Terzo, mantieni un fallback e definisci il suo trigger. Esempi includono un'interruzione prolungata dell'endpoint, ripetuti fallimenti di output strutturato o costi per compito superiori a un tetto scelto. Testa in anticipo la configurazione alternativa. Cambiare un ID modello sotto pressione può introdurre un secondo problema di integrazione se i suoi controlli o il comportamento di risposta differiscono.
I tre piccoli compiti in questa guida sono un esercizio di screening. Espandi la suite con lavoro rappresentativo dal tuo codebase prima di affidarti a un candidato per modifiche ampie. Tieni alcuni compiti fuori dal prompt tuning in modo da poter verificare se i miglioramenti si trasferiscono oltre gli esempi che hai ottimizzato.
La migliore api ai per il coding è la combinazione che sai spiegare: completa il lavoro richiesto, espone costi che puoi tracciare e si adatta al modo in cui gira la tua applicazione. Non è necessario un vincitore universale per prendere quella decisione.
Apri il catalogo modelli attuale, scegli due candidati e salva i loro ID e impostazioni esatti. Poi usa lo stesso compito, gli stessi test e la stessa regola di arresto per entrambi.
Domande frequenti
Qual è la migliore API AI per il coding con un piccolo budget?
Inizia con un candidato le cui tariffe visualizzate si adattano ai probabili volumi di input e output, poi confronta il costo per compito accettato. Le righe Qwen, DeepSeek e Kimi forniscono versioni concrete da investigare, senza affermare un vincitore di valore testato. Limita i tentativi di correzione, riutilizza deliberatamente il contesto rilevante e traccia le richieste fallite. Includi separatamente il tempo di revisione in modo che una bassa bolletta di inferenza non nasconda un grande carico di pulizia.
Un abbonamento di coding è più economico del pagamento dei token API?
Dipende dal tuo carico di lavoro e da cosa include il piano. Un abbonamento può adattarsi all'uso interattivo all'interno dell'applicazione supportata, mentre la fatturazione a consumo può adattarsi a un servizio personalizzato con traffico variabile. Controlla accesso ai modelli, limiti, concorrenza e se le chiamate API esterne sono incluse del tutto. Confronta la stessa quantità di lavoro utile su un periodo rappresentativo; un prezzo mensile e una tariffa per token misurano cose diverse.
Qual è la differenza tra un modello di coding e un agente di coding?
Il modello genera risposte. L'agente gestisce il ciclo attorno a quelle risposte, inclusi accesso ai file, esecuzione di strumenti, test e regole di arresto. Puoi chiamare un modello di coding tramite un'API senza costruire un agente, per esempio per suggerire una funzione da revisionare umanamente. Se desideri modifiche autonome, valuta il modello insieme all'agente e ai permessi che userà effettivamente.
Quale API AI dovrei usare per debug e refactoring?
Crea una shortlist di candidati che si adattano ai tuoi requisiti di endpoint e gestione del codice, poi usa piccoli bug e refactoring vincolati dal tuo lavoro. Il Compito A controlla correttezza e mutazione dell'input; il Compito B controlla parsing e preservazione dell'interfaccia. Segui quelli con test rappresentativi del repository.
Preferisci il candidato che soddisfa le tue condizioni di accettazione con uno sforzo di revisione gestibile, piuttosto che uno che produce semplicemente la spiegazione più lunga o la riscrittura più estesa.
Esiste un'API AI gratuita per il coding?
Un credito di prova, un'applicazione con un piano gratuito e pesi del modello scaricabili sono offerte diverse. Nessuna dà automaticamente alla tua applicazione inferenza ospitata illimitata. Verifica idoneità attuale, scadenza, quote e modelli supportati prima di fare budget basandoti sull'accesso gratuito. Questo articolo non afferma una quota gratuita attualmente disponibile.
Se ospiti tu stesso i pesi, considera calcolo e operatività anche quando scaricare i pesi non costa nulla.
Posso inviare codice di repository privati a un'API di coding?
Invia solo codice che la tua organizzazione ti permette di condividere secondo i termini applicabili del servizio specifico. Rivedi conservazione, uso per addestramento, controlli di accesso e requisiti contrattuali per il deployment scelto.
Rimuovi credenziali e file non correlati e controlla cosa include automaticamente il tuo agente in prompt e log. Un modello a pesi aperti o un formato API familiare non stabilisce, di per sé, che un servizio ospitato soddisfi i requisiti di riservatezza del tuo team.


