La tua richiesta restituisce un esito positivo. L'applicazione non ha ancora un'immagine utilizzabile. Forse la risposta contiene un ID attività, oppure l'immagine finale include un oggetto in più che la rende inadatta alla pagina.
Un'API di IA generativa per sviluppatori consente all'applicazione di inviare input a un modello e ricevere contenuti generati. Scegline una in base agli input richiesti, al formato di output, ai tempi di attesa e ai criteri di accettazione. Poi costruisci la gestione delle attività e i controlli che trasformano una risposta in qualcosa che un utente possa usare.
Questa guida segue un flusso di lavoro per le immagini, dalla selezione alla consegna. Troverai una tabella di selezione delle attività, esempi corrispondenti in JavaScript e Python, 3 brief di immagini concreti e un foglio di lavoro sui costi. Lo stesso processo decisionale si applica a testo e video, con protocolli e controlli di output diversi.
Punti chiave
- Scegli l'attività e i criteri di accettazione prima del modello.
- Salva gli ID delle attività asincrone così il lavoro interrotto può riprendere.
- Misura il costo per output accettato, incluse le generazioni rifiutate.
- Verifica file e vincoli di business prima di mostrare un risultato finito.
API di IA generativa per sviluppatori: cosa fa
Un modello esegue la generazione. Un'API definisce come il tuo software richiede quel lavoro. Un SDK avvolge l'interfaccia in helper specifici per linguaggio. Una piattaforma ospitata gestisce l'accesso ai modelli, mentre la tua applicazione fornisce l'esperienza utente, i permessi e le regole per accettare il risultato.
Queste distinzioni contano quando si legge una pagina di prodotto. Un'applicazione di chat che crea immagini non dimostra che il suo endpoint per sviluppatori accetti gli stessi input. Un SDK con un metodo comodo non elimina la necessità di comprenderne la risposta sottostante e gli stati di errore.
Inizia con la seguente mappa delle attività. La colonna dell'interazione descrive un progetto applicativo da valutare, non una promessa che ogni provider supporti quella modalità.
| Attività | Input | Capacità richiesta | Output | Interazione da valutare | Criteri di accettazione |
|---|---|---|---|---|---|
| Bozza di risposta al supporto | Ticket e contenuti di aiuto approvati | Generazione di testo fondata | Testo di bozza | Sincrona o in streaming | Risponde al ticket; nessuna policy inventata |
| Estrazione dei campi da documento | Testo del documento o file supportato | Estrazione strutturata | Campi JSON | Richiesta o attività in coda | Schema valido e prove di origine |
| Illustrazione editoriale | Brief visivo scritto | Da testo a immagine | File immagine | Attività asincrona | Oggetti, layout e dimensioni corretti |
| Modifica di immagini | Immagine di origine e istruzione | Modifica condizionata da immagine | Immagine modificata | Attività asincrona | Modifica richiesta; dettagli conservati |
| Generazione di video | Prompt o riferimento supportato | Generazione di video | File video | Attività in coda | Durata, movimento e audio corretti, se richiesti |
| Risposta assistita da recupero | Domanda e passaggi recuperati | Recupero più generazione | Risposta e riferimenti | Sincrona o in streaming | Affermazioni supportate dai passaggi recuperati |
Generare un'immagine, analizzare un'immagine caricata e modificare un'immagine esistente sono capacità separate. Verifica ciascuna esplicitamente. Allo stesso modo, un endpoint video può supportare un fotogramma iniziale senza supportare riferimenti multi-immagine arbitrari.
Gli embedding convertono gli input in vettori utili per il recupero e la similarità. Possono aiutare a trovare documenti rilevanti prima che venga generata una risposta. Non producono di per sé la risposta né stabiliscono che il contenuto recuperato supporti le sue affermazioni.
Il confine pratico è input → richiesta → output → accettazione dell'applicazione. L'ultima fase è tua responsabilità. Un campo di fattura generato necessita comunque di convalida; un'immagine necessita comunque di ispezione; una risposta di supporto necessita comunque dell'autorizzazione a fare la promessa che contiene.
Anche le scelte di protocollo variano. Il riferimento di Google distingue generazione standard, streaming e interazione dal vivo. Consideralo una prova che le modalità di interazione differiscono, invece di presumere un supporto identico altrove. (Riferimento API Google Gemini, consultato a settembre 2026.)
API di IA generativa per sviluppatori: come scegliere
Scrivi un breve brief di accettazione prima di confrontare i cataloghi. Per una funzionalità di immagini editoriali, potrebbe specificare output in orizzontale, un numero limitato di oggetti, nessun branding visibile e una fase di revisione umana. Per la classificazione dei ticket, potrebbe specificare un set fisso di etichette e un esito incerto esplicito.
Valuta i candidati in questo ordine:
- Input e output. Controlla l'endpoint esatto del modello per i file supportati, i limiti di input, i formati di output e il comportamento con immagini di riferimento. Il nome di una famiglia di modelli è troppo ampio per fungere da contratto.
- Conformità all'attività. Prova brief rappresentativi, inclusi quelli scomodi. Conta i fallimenti dei vincoli separatamente dai fallimenti di file o rete, così sai cosa deve essere corretto.
- Idoneità all'integrazione. Conferma autenticazione, envelope delle risposte, valori di stato delle attività e supporto delle librerie client. Includi il lavoro necessario per adattarli al tuo backend esistente.
- Tempi di attesa e concorrenza. Decidi se gli utenti possono andarsene e tornare. Testa il carico di lavoro previsto prima di impegnarti in un'esperienza interattiva con una scadenza breve.
- Chiarezza della fatturazione. Identifica l'unità fatturabile e quali impostazioni la modificano. Controlla la gestione di errori e rimborsi invece di presumere che ogni richiesta inviata riceva lo stesso addebito.
- Requisiti sui dati. Esamina la gestione degli input, la conservazione, la cancellazione e i termini applicabili rispetto ai dati effettivi che intendi inviare. Documenta le domande irrisolte prima di usare materiale sensibile.
- Gestione dei cambiamenti. Mantieni un set di regressione e registra identificatori del modello, prompt e parametri. Pianifica come rivaluterai il comportamento dopo un aggiornamento o una sostituzione.
Le linee guida istituzionali illustrano perché le regole di accesso e sui dati appartengono a questa decisione: Harvard descrive percorsi di accesso approvati e restrizioni relative ai suoi strumenti di sviluppo IA. Queste sono disposizioni di Harvard, non permessi universali per la tua applicazione. (Harvard University Information Technology, consultato a settembre 2026.)
| Percorso di accesso | Team adatto | Lavoro di integrazione | Responsabilità operativa | Limitazione principale | Verifica prima di scegliere |
|---|---|---|---|---|---|
| Provider di modelli diretto | Team incentrato sulle capacità di un solo provider | API, account e adapter specifici del provider | La tua app e le tue attività; inferenza del provider | Provider aggiuntivi aggiungono contratti separati | Funzionalità dell'endpoint, regioni, quote, termini |
| Piattaforma ospitata multi-modello | Team che valuta diversi modelli supportati | Accesso condiviso più convalida specifica del modello | La tua app e le tue attività; inferenza ospitata sulla piattaforma | L'accesso condiviso non standardizza ogni parametro | Modelli esatti, schemi, fatturazione, percorso dei dati |
| Modello aperto self-hosted | Team con competenze di infrastruttura e serving di modelli | Distribuisci, esponi, proteggi e mantieni l'inferenza | Hardware, serving, scalabilità, monitoraggio, aggiornamenti | Capacità e overhead di ingegneria | Licenza, idoneità hardware, throughput, manutenzione |
Atlas Cloud è un'opzione ospitata da valutare quando più capacità di modelli appartengono alla stessa applicazione. Questo articolo usa la sua interfaccia per attività di immagini come esempio concreto. Devi comunque convalidare input e output di ogni modello; cambiare solo un ID modello non è sufficiente.
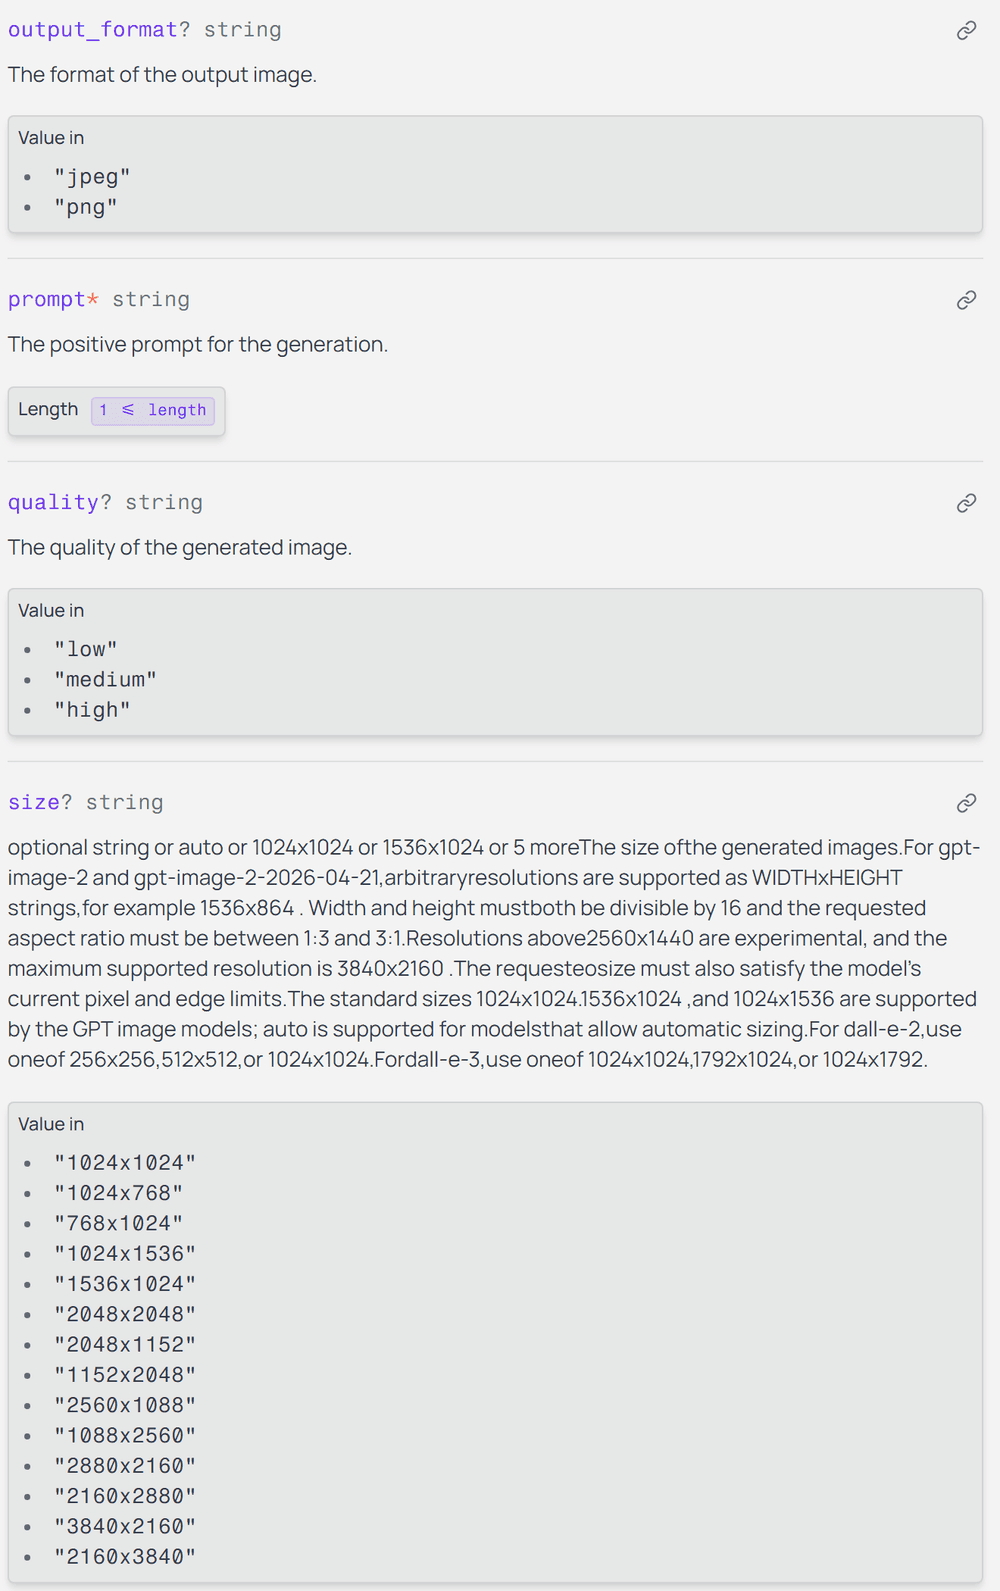
Documentazione ufficiale dell'endpoint immagine che mostra formato di output, qualità e vincoli di dimensione
I parametri specifici del modello fanno parte del contratto di integrazione. Leggi i loro valori consentiti prima di riutilizzare un corpo di richiesta.
Per un piccolo team SaaS, il confronto utile è lo sforzo totale per rilasciare un risultato accettato. Includi codice di adapter, indagine di supporto, tempo di revisione e test di migrazione insieme al costo di inferenza. Così un prototipo comodo non nasconde un flusso di produzione costoso.
API di IA generativa per sviluppatori: prima richiesta
L'esempio usa GPT Image 2 Text-to-Image, con ID modello openai/gpt-image-2/text-to-image. La documentazione del suo endpoint elenca quality: high, size: 2048x1152 e output_format: png. Queste sono le impostazioni richieste per gli esempi seguenti.
1. Stabilisci il prompt nel playground. Usa il brief della colazione riportato sotto senza aggiungere un'immagine di riferimento. Controlla il nome del modello e le impostazioni confermate prima di premere Run. Una selezione che si ripristina quando esci da un campo non è l'impostazione che hai richiesto.
plaintext1Create a realistic editorial food photograph for an article about a simple breakfast. 2 3On a light oak table, show exactly one white ceramic plate holding exactly two slices of toasted sourdough bread, one small clear glass bowl of strawberry jam, and one stainless steel butter knife resting to the right of the plate. 4 5Use soft morning window light from the left, natural colors, a three-quarter overhead camera angle, and realistic bread texture. Keep every requested object fully inside the frame. 6 7No people, no hands, no drinks, no extra dishes, no packaging, no logos, no text, and no watermark. Landscape composition, 16:9.
2. Mantieni l'autenticazione sul server. Il tuo frontend dovrebbe chiedere al tuo backend di avviare un'attività. Archivia ATLAS_API_KEY nell'ambiente del server. Non includerla mai in JavaScript del browser, URL di immagini o log visibili al client. Imposta ATLAS_API_HOST su api.atlascloud.ai; questo è un hostname, senza schema o percorso.
3. Invia una volta e conserva l'ID. La rotta di generazione documentata è POST /api/v1/model/generateImage. Leggi data.id, poi archivialo associato all'attività della tua applicazione. Se la risposta di invio viene persa, indaga prima di creare un'altra attività potenzialmente fatturabile.
4. Esegui il polling dell'attività salvata. Interroga GET /api/v1/model/prediction/{prediction_id}. La documentazione delle predizioni descrive processing, completed e failed, con URL di output in data.outputs. Uno stato completato dovrebbe comunque essere verificato per un array di output non vuoto.
5. Scarica e convalida. Salva il file sotto il tuo controllo, verifica che si decodifichi e ispezionalo rispetto al brief. Solo allora restituisci un risultato accettato all'applicazione. Un errore di download o convalida dovrebbe rimanere associato all'attività esistente.
Il codice seguente è assemblato dalla documentazione ufficiale dell'interfaccia. Non è presentato come benchmark API dal vivo. Il flusso di lavoro multimediale dell'articolo usa il playground di test del browser, non una chiave API.
Salva il prompt esatto della colazione come prompt.txt. Per Node.js, usa un ambiente con fetch integrato, installa sharp e salva questo come generate.mjs. Eseguilo in una directory di lavoro dedicata. Esegui solo uno dei due esempi di linguaggio, a meno che tu non voglia intenzionalmente due attività.
javascript1import { readFile, writeFile, mkdir } from 'node:fs/promises'; 2import sharp from 'sharp'; 3 4const key = process.env.ATLAS_API_KEY; 5const host = process.env.ATLAS_API_HOST; 6if (!key || host !== 'api.atlascloud.ai') { 7 throw new Error('Set ATLAS_API_KEY and ATLAS_API_HOST'); 8} 9const base = 'https:' + '//' + host; 10const headers = { Authorization: `Bearer ${key}` }; 11const sleep = ms => new Promise(resolve => setTimeout(resolve, ms)); 12const payload = { 13 model: 'openai/gpt-image-2/text-to-image', 14 prompt: await readFile('prompt.txt', 'utf8'), 15 quality: 'high', size: '2048x1152', output_format: 'png' 16}; 17await mkdir('output', { recursive: true }); 18await writeFile('output/request.json', JSON.stringify(payload, null, 2)); 19 20async function api(path, method = 'GET', body) { 21 const response = await fetch(base + path, { 22 method, 23 headers: { ...headers, 'Content-Type': 'application/json' }, 24 body: body ? JSON.stringify(body) : undefined, 25 signal: AbortSignal.timeout(30000) 26 }); 27 const requestId = response.headers.get('x-request-id'); 28 console.error(JSON.stringify({ method, status: response.status, requestId })); 29 if (!response.ok) { 30 const error = new Error(`HTTP ${response.status}; request ${requestId}`); 31 error.retryable = [429, 500, 503, 504].includes(response.status); 32 throw error; 33 } 34 const json = await response.json(); 35 if (!json.data) throw new Error('Missing response data'); 36 return json.data; 37} 38 39let id = process.env.PREDICTION_ID; 40try { 41 if (!id) { 42 // Deliberately no automatic retry for submission. 43 const submitted = await api('/api/v1/model/generateImage', 'POST', payload); 44 id = submitted.id; 45 if (typeof id !== 'string' || !id) throw new Error('Missing prediction ID'); 46 await writeFile('output/prediction-id.txt', id); 47 } 48 const deadline = Date.now() + 600000; 49 let errors = 0; 50 let outputUrl; 51 while (Date.now() < deadline) { 52 let job; 53 try { 54 job = await api('/api/v1/model/prediction/' + encodeURIComponent(id)); 55 errors = 0; 56 } catch (error) { 57 const transient = error.retryable || 58 ['TimeoutError', 'AbortError'].includes(error.name) || 59 error instanceof TypeError; 60 if (!transient || ++errors > 3) throw error; 61 await sleep(Math.min(30000, 1000 * 2 ** errors) + Math.random() * 500); 62 continue; 63 } 64 if (job.status === 'failed') { 65 throw new Error(`Task failed; code ${job.error_code ?? 'unknown'}`); 66 } 67 if (job.status === 'completed') { 68 outputUrl = job.outputs?.[0]; 69 if (typeof outputUrl !== 'string' || !outputUrl) { 70 throw new Error('Completed task has no output'); 71 } 72 break; 73 } 74 if (job.status !== 'processing') throw new Error('Unexpected task status'); 75 await sleep(2000); 76 } 77 if (!outputUrl) throw new Error('Polling deadline reached; resume this ID'); 78 const url = new URL(outputUrl); 79 if (url.protocol !== 'https:') throw new Error('Unexpected output protocol'); 80 // Do not forward the API credential to the media host. 81 const file = await fetch(url, { signal: AbortSignal.timeout(60000) }); 82 if (!file.ok) throw new Error(`Download HTTP ${file.status}`); 83 const bytes = Buffer.from(await file.arrayBuffer()); 84 await sharp(bytes, { limitInputPixels: 20000000 }).raw().toBuffer(); 85 const meta = await sharp(bytes).metadata(); 86 if (meta.format !== 'png' || meta.width !== 2048 || meta.height !== 1152) { 87 throw new Error('File format or dimensions differ from the request'); 88 } 89 await writeFile('output/breakfast.png', bytes); 90 console.log(JSON.stringify({ id, state: 'ready_for_review', 91 file: 'output/breakfast.png' })); 92} catch (error) { 93 console.error(JSON.stringify({ id: id ?? null, state: 'needs_attention', 94 error: error.message })); 95 process.exitCode = 1; 96}
L'equivalente Python più breve usa requests e Pillow, lo stesso prompt.txt e impostazioni identiche. Accetta anche PREDICTION_ID per riprendere. Questi script dimostrano una singola attività locale; un servizio distribuito necessita di record di attività persistenti e download limitati.
python1import io, json, os, random, time 2from pathlib import Path 3from urllib.parse import quote, urlparse 4import requests 5from PIL import Image 6 7key = os.environ['ATLAS_API_KEY'] 8assert os.environ['ATLAS_API_HOST'] == 'api.atlascloud.ai' 9base = 'https:' + '//' + os.environ['ATLAS_API_HOST'] 10headers = {'Authorization': 'Bearer ' + key} 11out = Path('output') 12out.mkdir(exist_ok=True) 13payload = dict(model='openai/gpt-image-2/text-to-image', 14 prompt=Path('prompt.txt').read_text(encoding='utf-8'), 15 quality='high', size='2048x1152', output_format='png') 16job_id = os.getenv('PREDICTION_ID') 17try: 18 if not job_id: 19 # A submission timeout needs investigation, not a blind retry. 20 r = requests.post(base + '/api/v1/model/generateImage', 21 headers=headers, json=payload, timeout=30) 22 r.raise_for_status() 23 job_id = r.json()['data']['id'] 24 if not isinstance(job_id, str) or not job_id: 25 raise ValueError('Missing prediction ID') 26 (out / 'prediction-id.txt').write_text(job_id) 27 deadline, errors, url = time.monotonic() + 600, 0, None 28 while time.monotonic() < deadline: 29 try: 30 r = requests.get(base + '/api/v1/model/prediction/' + 31 quote(job_id, safe=''), headers=headers, timeout=30) 32 r.raise_for_status() 33 except requests.RequestException as exc: 34 status = exc.response.status_code if exc.response is not None else None 35 if status not in (None, 429, 500, 503, 504) or errors >= 3: 36 raise 37 errors += 1 38 time.sleep(min(30, 2 ** errors) + random.random() / 2) 39 continue 40 errors = 0 41 job = r.json()['data'] 42 if job['status'] == 'failed': 43 raise RuntimeError('Task failed: ' + str(job.get('error_code'))) 44 if job['status'] == 'completed': 45 outputs = job.get('outputs') or [] 46 if not outputs or not isinstance(outputs[0], str) or not outputs[0]: 47 raise ValueError('Completed task has no output') 48 url = outputs[0] 49 break 50 if job['status'] != 'processing': 51 raise ValueError('Unexpected task status') 52 time.sleep(2) 53 if not url: 54 raise TimeoutError('Polling deadline reached; resume this ID') 55 if urlparse(url).scheme != 'https': 56 raise ValueError('Unexpected output protocol') 57 r = requests.get(url, timeout=60) # No Authorization header here. 58 r.raise_for_status() 59 with Image.open(io.BytesIO(r.content)) as image: 60 image.load() 61 if image.format != 'PNG' or image.size != (2048, 1152): 62 raise ValueError('Unexpected file format or dimensions') 63 (out / 'breakfast.png').write_bytes(r.content) 64 print(json.dumps(dict(id=job_id, state='ready_for_review'))) 65except Exception as exc: 66 print(json.dumps(dict(id=job_id, state='needs_attention', error=str(exc)))) 67 raise SystemExit(1)
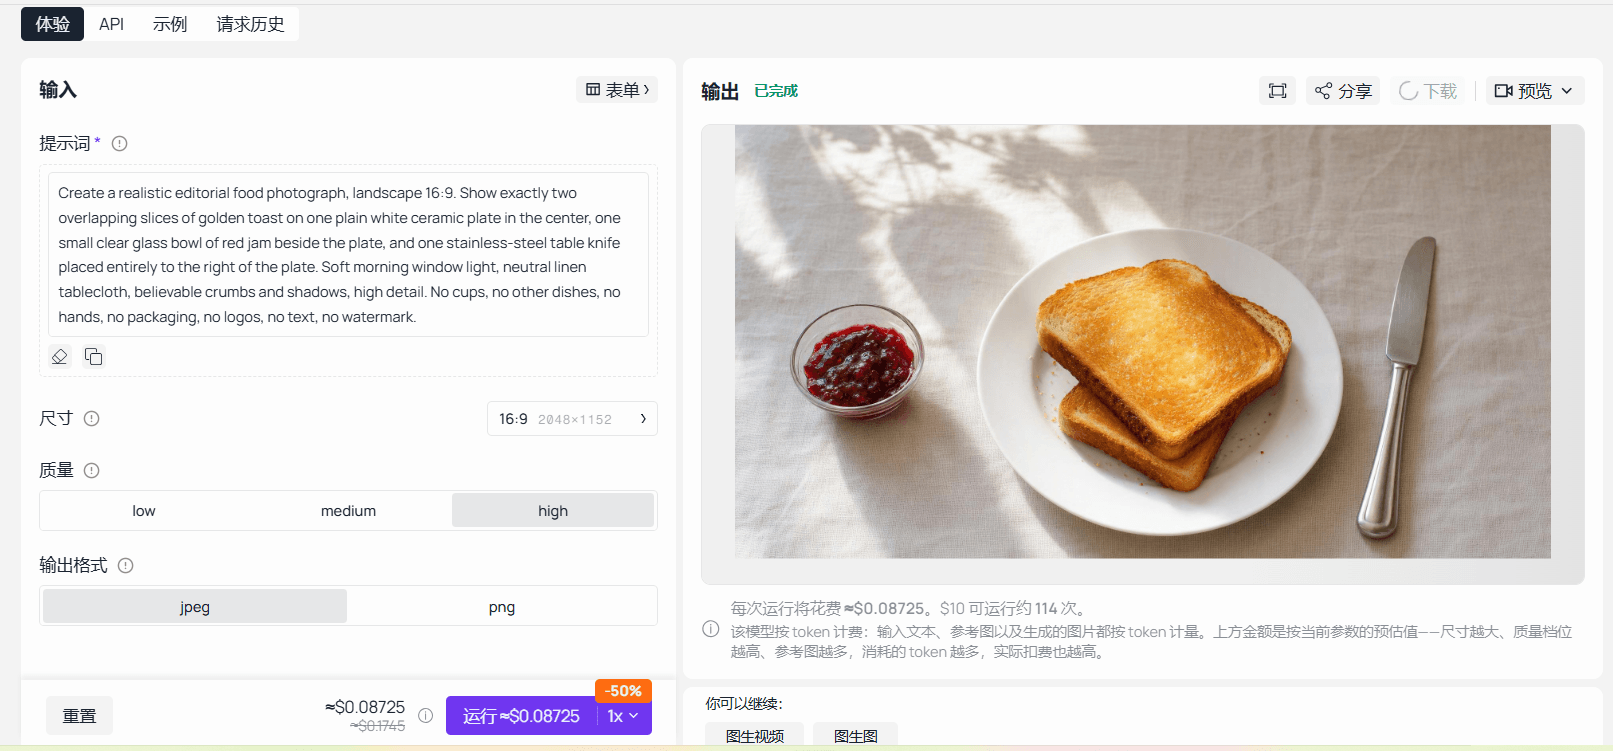 Playground GPT Image 2 completato che mostra il prompt della colazione inviato e l'output finito
Un'esecuzione completata nel playground registra insieme il prompt inviato, la dimensione dell'output, l'impostazione di qualità e il risultato generato.
Una scadenza di polling impedisce a questo client di attendere; non annulla il lavoro lato server. Una richiesta già in corso può terminare dopo la finestra di polling, quindi questa non è una garanzia rigorosa di latenza end-to-end. Conserva l'ID e consenti a un worker di controllarlo più tardi.
API di IA generativa per sviluppatori: usi pratici
I 3 brief seguenti testano requisiti diversi. Sono richieste indipendenti, non una catena in cui un risultato diventa l'input successivo. Mantieni lo stesso modello e le stesse impostazioni richieste, così le differenze tra i brief restano facili da comprendere.
A. Immagine editoriale di cibo: conteggio e posizionamento. Il prompt della colazione verifica se l'output contiene 2 fette di pane tostato, 1 piatto, 1 ciotola di marmellata e 1 coltello. Il coltello deve trovarsi a destra del piatto e tutti gli oggetti richiesti devono rimanere dentro l'inquadratura.
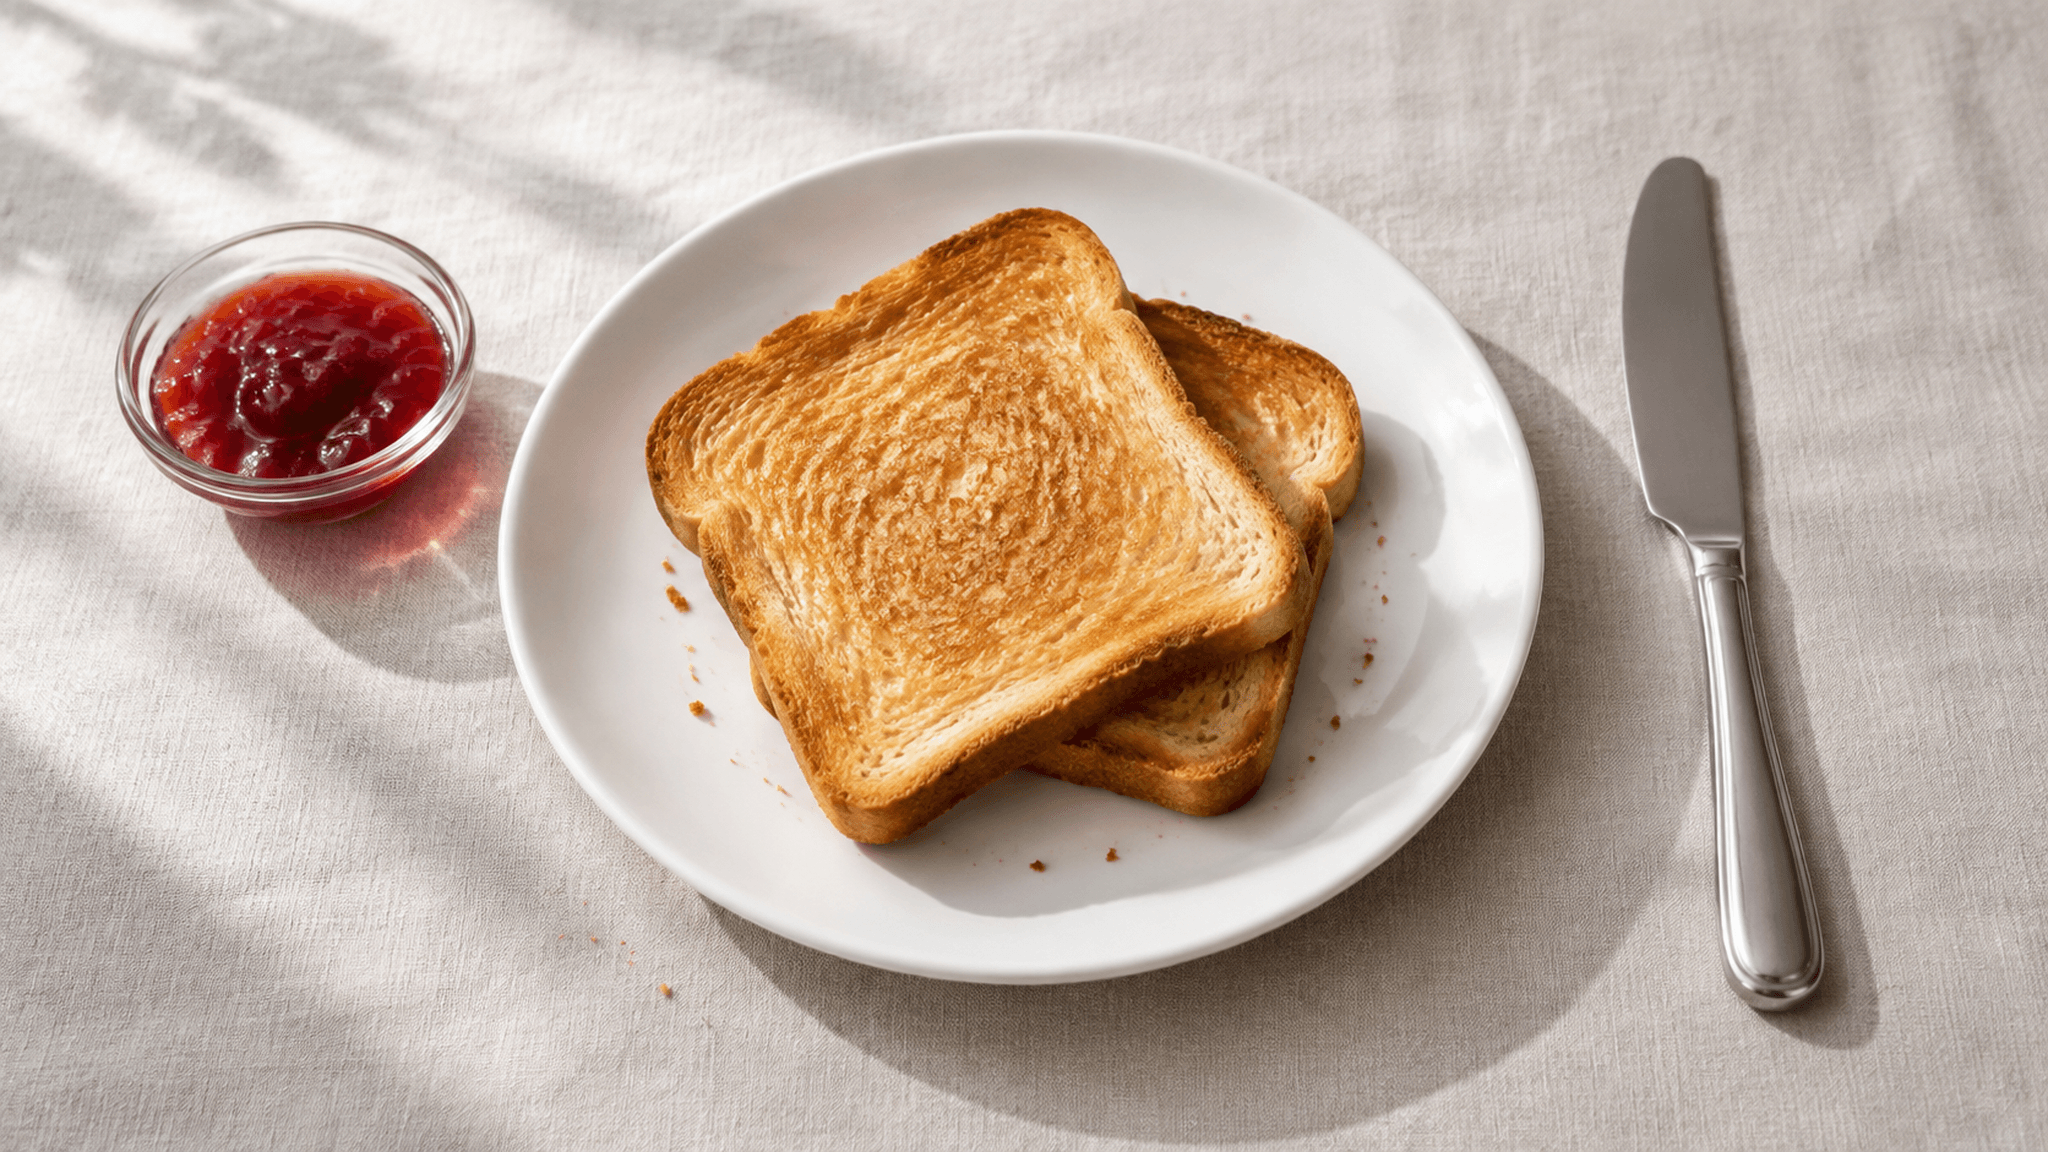 Esempio di generazione di immagine per la colazione abbinato ai controlli del conteggio degli oggetti e del posizionamento del coltello_Il risultato generato contiene il piatto, il pane tostato, la ciotola di marmellata e il coltello sul lato destro richiesti, pronti per la revisione del posizionamento di seguito._
Esamina individualmente le fette sovrapposte. Una colazione visivamente convincente può comunque fallire se una tazza compare sullo sfondo o il coltello si sposta sul piatto. Se un risultato fallisce, rivedi l'istruzione spaziale ambigua, cambia una variabile e conserva il motivo del rifiuto. Evita di chiedere ripetutamente un'immagine genericamente migliore.
B. Copertina dell'articolo: spazio utilizzabile per il titolo. Questa richiesta tratta la composizione come una dipendenza di layout. L'editor della pagina ha bisogno di spazio vuoto a sinistra, mentre il lato destro contiene gli attrezzi e il vaso. Aggiungi il titolo effettivo in seguito usando HTML/CSS, così rimane modificabile e leggibile.
plaintext1Create a realistic editorial photograph for an article about repairing everyday objects. 2 3On the right half of a light wooden workbench, show one pair of worn gardening gloves, one small metal hand trowel, and one unbranded terracotta plant pot. The left 45 percent of the image must remain an empty, softly lit section of the same workbench, suitable for adding a headline later. 4 5Use natural side light from a nearby window, believable material textures, neutral colors, and a slightly elevated camera angle. 6 7No people, no hands, no extra tools, no plants, no logos, no letters, no text, and no watermark. Landscape composition, 16:9.
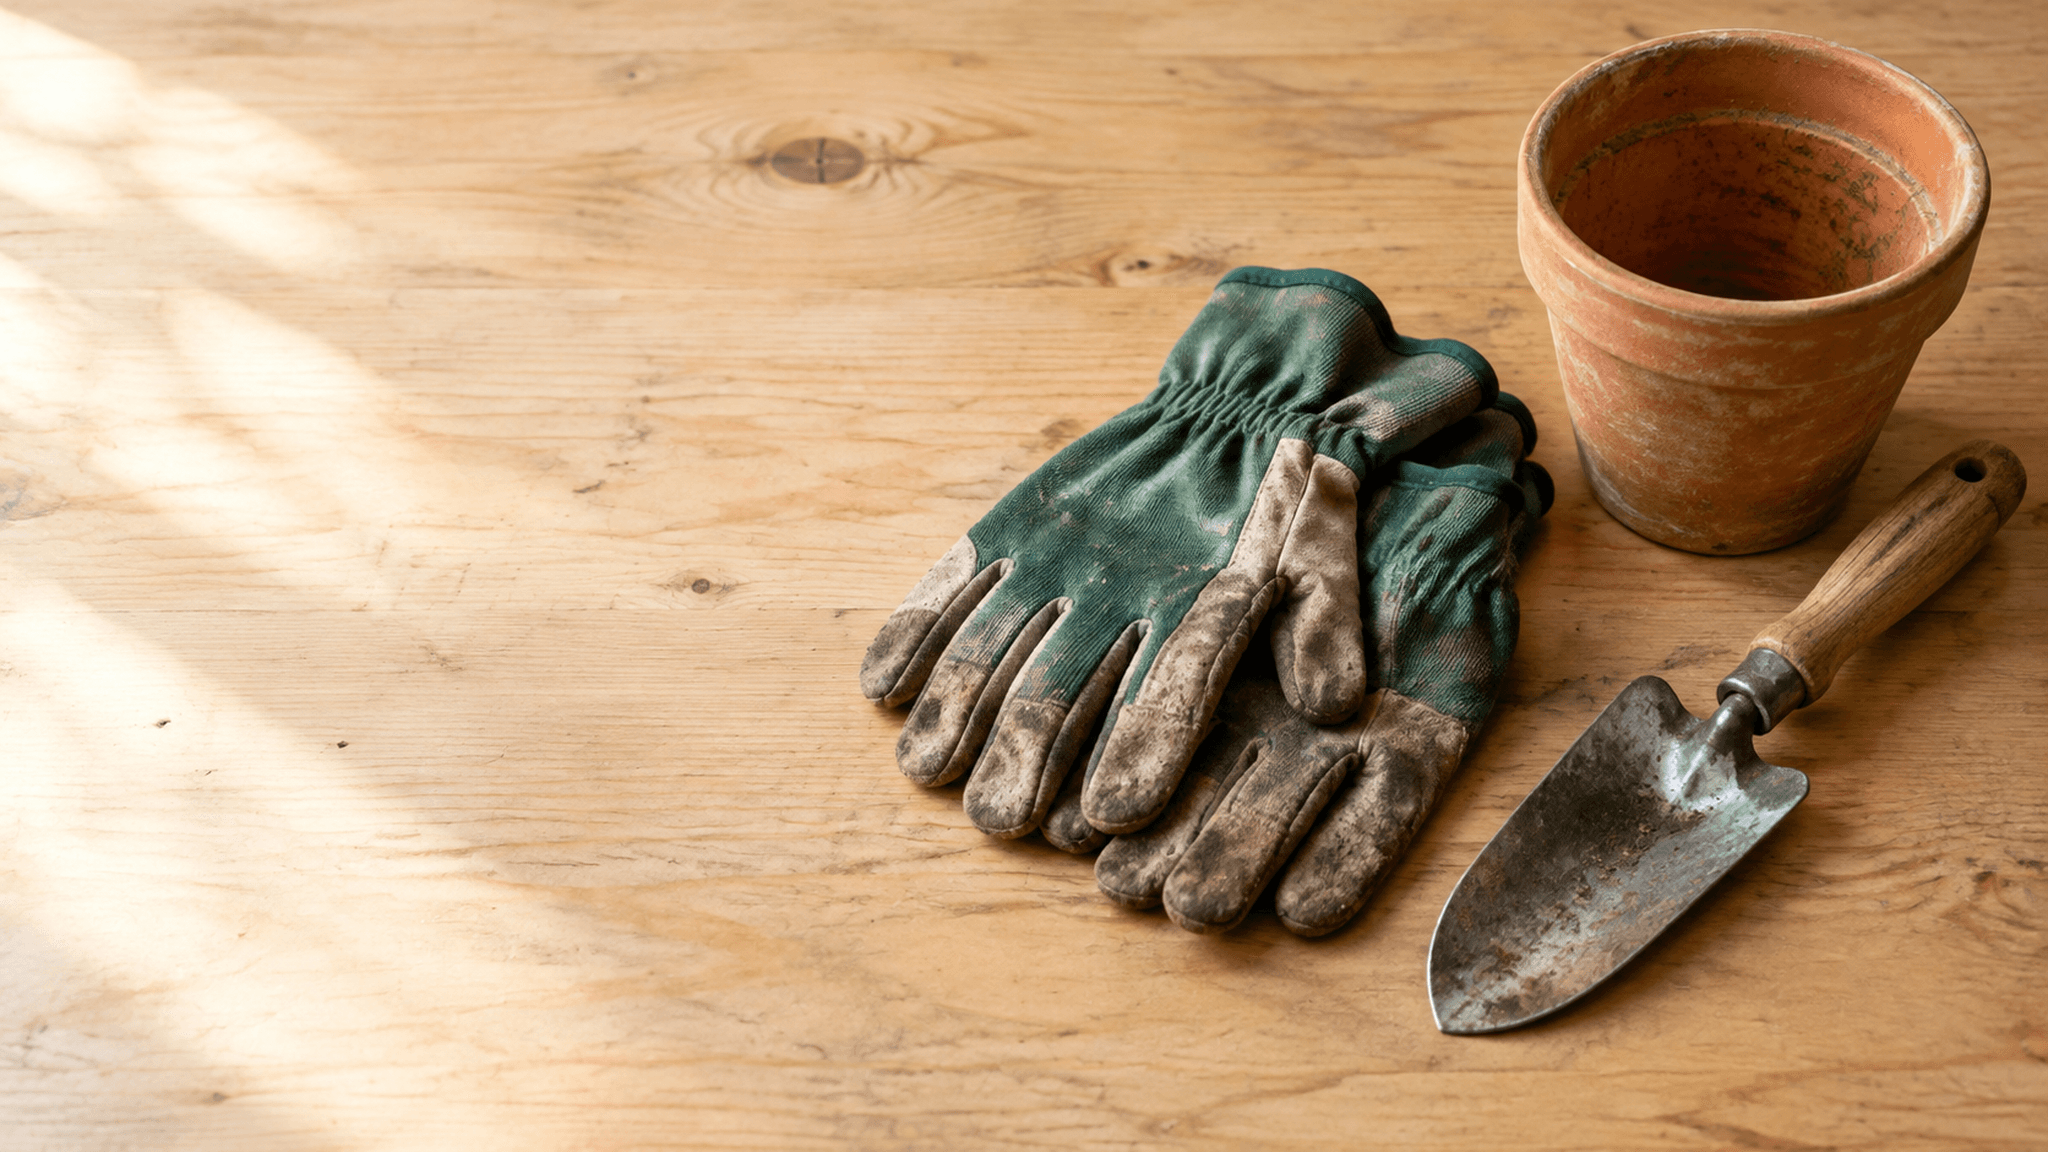 Esempio di copertina con banco da lavoro che mostra lo spazio richiesto per il titolo a sinistra e gli oggetti a destra
Il risultato conserva uno spazio vuoto utilizzabile a sinistra mantenendo guanti, vaso e cazzuola a destra.
Controlla il risultato al ritaglio di pubblicazione previsto. Un master orizzontale può perdere la sua regione vuota utile quando una card mobile ritaglia centralmente. Se la composizione fallisce, specifica confini degli oggetti più stretti o cambia il ritaglio dell'applicazione. Non nascondere il fallimento posizionando testo sopra i soggetti richiesti.
C. Illustrazione di tessuti: dettaglio e ordine. La richiesta successiva chiede 3 campioni piegati con texture visibili distinguibili. Verifica conteggio, posizione e se il risultato supporta un'illustrazione esplicativa alla dimensione che i lettori vedranno.
plaintext1Create a realistic close-up editorial photograph for an article explaining common fabric textures. 2 3Show exactly three folded fabric swatches arranged side by side on a neutral matte gray surface: natural beige linen on the left, blue cotton denim in the center, and dark green wool on the right. 4 5Use the same soft daylight across all three fabrics, an overhead camera angle, and sufficient depth of field to keep the visible weave of each fabric in focus. Preserve natural wrinkles and believable fiber detail. 6 7No labels, no rulers, no sewing tools, no hands, no additional objects, no text, no logos, and no watermark. Landscape composition, 16:9.
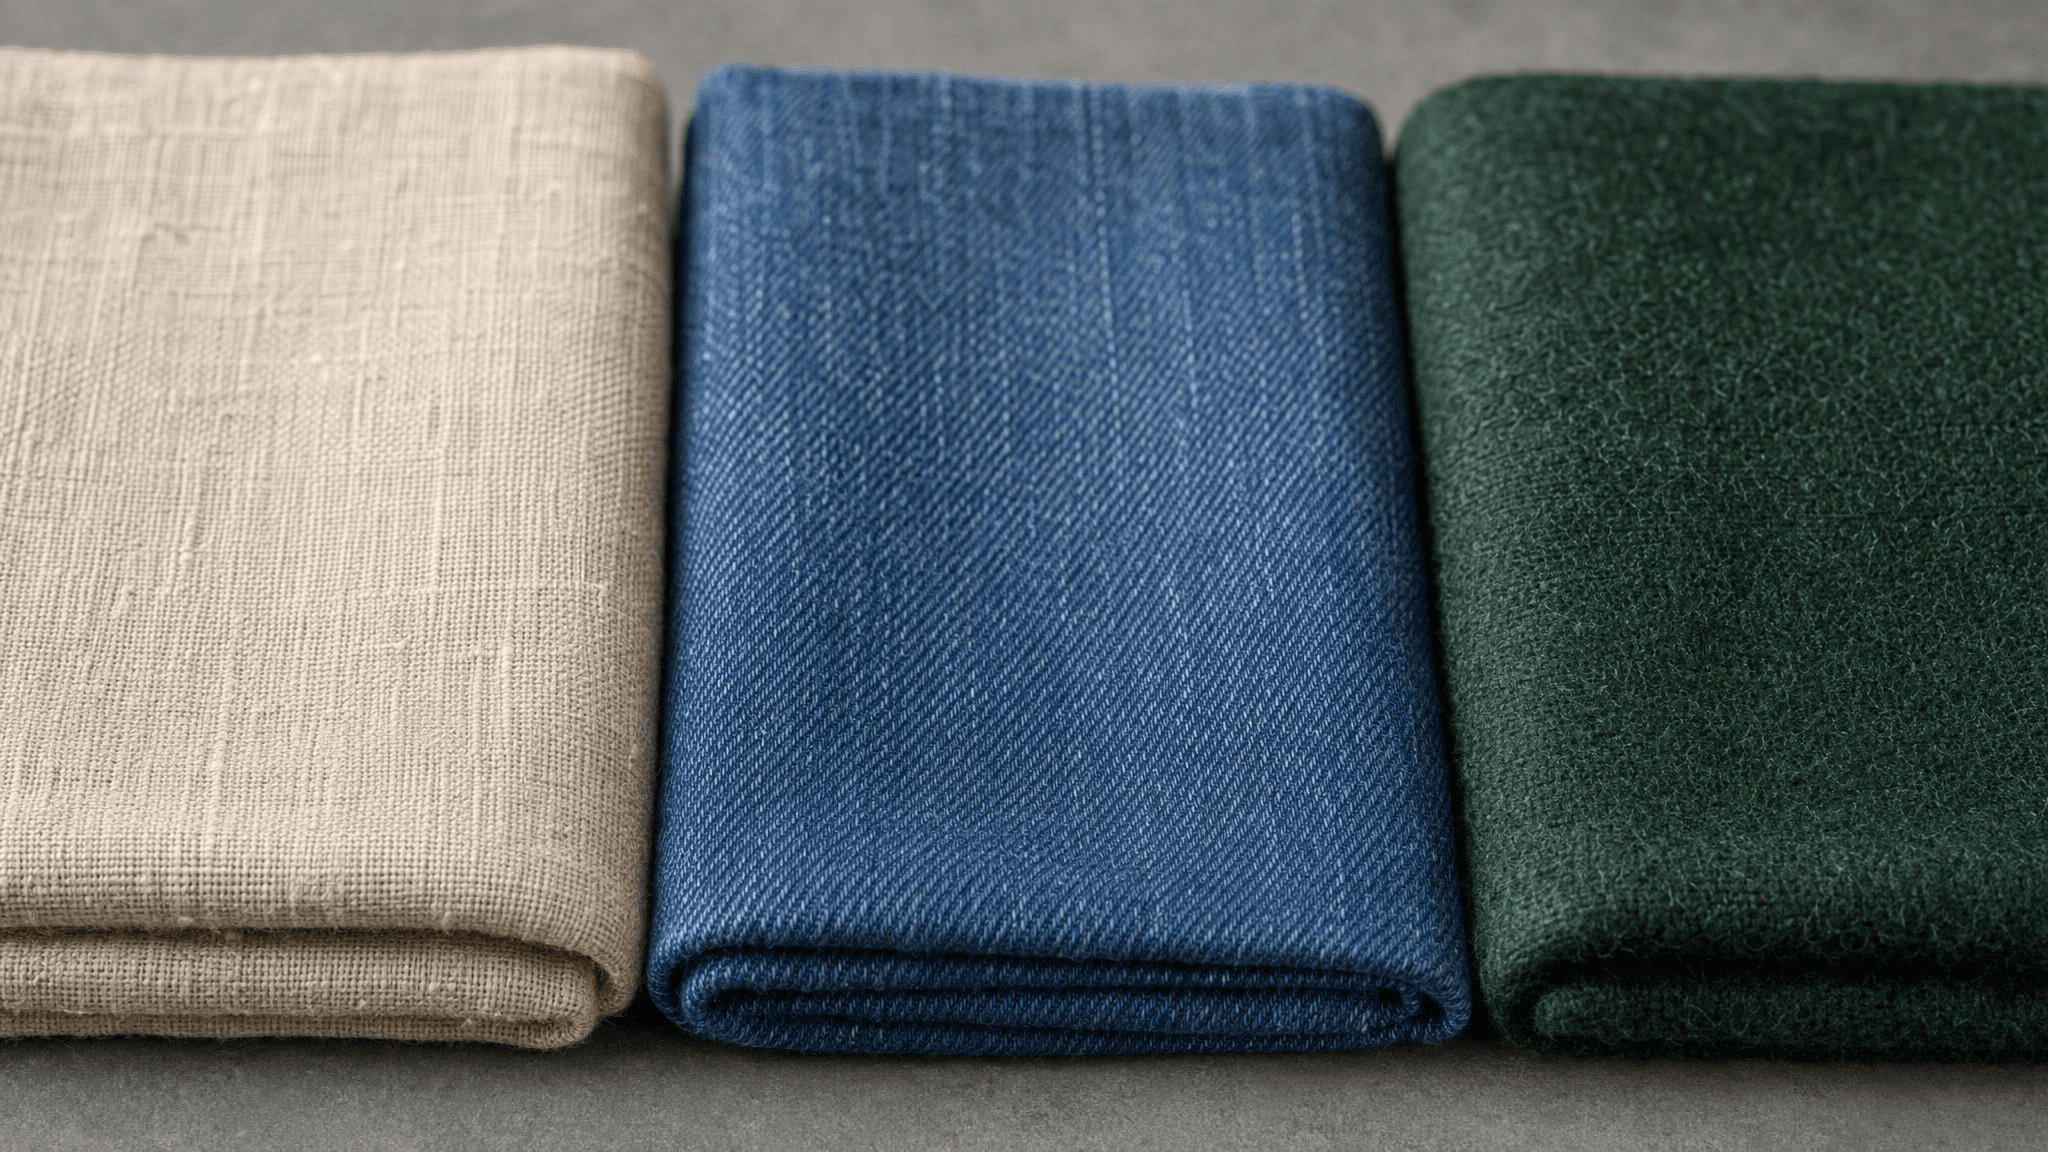 Illustrazione di tessuti generata dall'IA con controlli di posizionamento dei campioni beige, blu e verde scuro
I tre campioni richiesti sono visivamente distinti. Questa texture generata è un'illustrazione, non una prova della composizione in fibre di un prodotto reale.
Se il campione centrale non ha una trama leggibile, registra il problema e regola l'inquadratura o l'istruzione di dettaglio. Non descrivere mai una texture generata come proprietà misurata di un prodotto reale.
Anche le funzionalità di testo richiedono controlli altrettanto mirati. Per la classificazione dei ticket, rifiuta le etichette al di fuori del set consentito e mantieni un percorso incerto. Per l'estrazione da documenti, richiedi campi e intervalli di origine insieme a JSON analizzabile. Una risposta sintatticamente valida può comunque inserire l'importo sbagliato nel campo sbagliato.
API di IA generativa per sviluppatori: gestire gli errori
Traccia separatamente il successo del trasporto, il completamento dell'attività e l'accettazione business. Una risposta HTTP riuscita può contenere un'attività in elaborazione. Un'attività completata può produrre un download corrotto. Un'immagine leggibile può violare il brief. Ognuna richiede un'azione di recupero diversa.
Imposta deliberatamente 3 orologi: un timeout HTTP individuale, un intervallo di polling e una finestra di attesa complessiva. Gli esempi usano un timeout di richiesta API di 30 secondi, polling di 2 secondi e una finestra di polling di 10 minuti. Queste sono scelte applicative, non prestazioni del servizio pubblicizzate.
| Sintomo | Causa possibile | Controllo successivo | Approccio di nuovo tentativo |
|---|---|---|---|
| Errore di parametro | Campo o valore non supportato | Schema esatto dell'endpoint e payload inviato | Correggi prima la richiesta |
| HTTP 401 | Problema di autenticazione o rotta errata | Configurazione della chiave e percorso dell'endpoint | Nessun nuovo tentativo invariato |
| Saldo insufficiente | Saldo disponibile o allowance | Stato di fatturazione dell'account | Risolvi prima il finanziamento o l'allowance |
| HTTP 429 | Limite di frequenza raggiunto | Concorrenza account/modello e frequenza delle richieste | Backoff limitato con jitter |
| L'attività segnala errore | Errore del modello, dell'input o della policy | ID predizione, codice errore, dettaglio errore | Indaga prima di una nuova generazione |
| Timeout del polling | Scadenza del client o attività lenta | Stato dell'attività esistente | Riprendi l'interrogazione dello stesso ID |
| Completato con output vuoto | Risultato mancante o imprevisto | Risposta strutturata completa dell'attività | Segnala per indagine; nessun nuovo invio cieco |
L'attuale documentazione degli errori della piattaforma afferma che gli endpoint LLM e media non forniscono header Retry-After o di limite di frequenza rimanente. Usa una policy di ritardo lato client; non far dipendere il recupero da un header che queste rotte non restituiscono. Altre famiglie di API possono comportarsi diversamente.
Mantieni limitati i nuovi tentativi automatici di lettura. Ritardi esponenziali più un po' di jitter casuale aiutano a evitare che molti worker riprovino insieme. Riduci la concorrenza se la limitazione persiste. I fallimenti ripetuti dovrebbero diventare un incidente osservabile anziché un ciclo infinito nascosto dietro uno spinner.
I nuovi tentativi di invio meritano un trattamento più rigoroso. Quando una connessione si chiude dopo che hai inviato il corpo, potresti non sapere se il server ha creato un'attività. Registra un intento locale prima dell'invio e indaga la cronologia delle richieste o le tracce di supporto quando non arriva alcun ID predizione. Non inventare un header di idempotenza a meno che l'endpoint non lo documenti.
Dopo aver ottenuto un ID, usalo per riprendere. Un errore di download dovrebbe attivare un altro tentativo di download o un controllo di stato, non un'altra richiesta di generazione di immagini. Gli esempi mantengono deliberatamente il comportamento di nuovo tentativo automatico sulle letture di polling e si fermano su un invio fallito.
Per ogni attività, conserva l'ID attività della tua applicazione, l'ID predizione, gli ID richiesta, il modello, le impostazioni, i timestamp e la disposizione finale. Archivia i prompt solo secondo una policy dei dati appropriata. Non inserire mai header di autorizzazione o contenuti utente sensibili nei log di errori generali.
Fornisci al frontend stati che possa spiegare: preparazione, elaborazione, controllo dell'output, pronto o richiede attenzione. Mostra un'attività recuperabile quando qualcuno ricarica la pagina. Disabilita l'invio ripetuto mentre la stessa attività locale è in sospeso, consentendo comunque una nuova richiesta intenzionale quando appropriato.
API di IA generativa per sviluppatori: costi reali
Un prezzo basso per richiesta non ti dice il costo di una funzionalità utilizzabile. Il tuo budget ha bisogno dell'importo addebitato, del numero di output accettati e del lavoro di supporto necessario per consegnarli.
Le API di testo comunemente distinguono token di input e output. Contesto lungo, passaggi recuperati, cronologia della conversazione e risposte ripetute possono tutti contribuire all'utilizzo. Registra le categorie che l'endpoint scelto fattura effettivamente invece di applicare una singola stima di token a ogni carico di lavoro.
Per le immagini, esamina l'unità di fatturazione e la configurazione del modello esatto. Dimensione e qualità possono influenzare la fatturazione in modo diverso tra i modelli. Per i video, durata, risoluzione e scelta del modello possono cambiare l'addebito. Non trasformare il prezzo iniziale di un catalogo in un preventivo per una configurazione specifica.
Il prezzo esatto in alta qualità 2048 × 1152 del modello immagine selezionato non è stato verificato sia nel catalogo sia nella pagina di dettaglio durante la ricerca per questo articolo. Qui non viene affermato alcun prezzo unitario o sconto corrente. Confermalo prima di eseguire una valutazione di produzione a pagamento.
Usa 2 calcoli correlati:
plaintext1API cost per accepted output = actual API charges / accepted outputs 2 3Full feature cost per accepted output = 4(API charges + attributable review + storage + transfer + processing costs) 5/ accepted outputs
Mantieni coerente il periodo di osservazione. Per l'archiviazione continua, specifica se il calcolo copre il primo mese, un periodo di conservazione definito o un costo ricorrente allocato. Evita di confrontare la cifra di sola inferenza di un modello con il costo completamente caricato di un altro flusso di lavoro.
Esempio ipotetico: invii 100 richieste e accetti 80 output. Dividi l'addebito totale effettivo per quel batch per 80. Se tutte le 100 richieste fossero state addebitate un importo identico c, il costo API per output accettato sarebbe 1.25c. Questa condizione conta: non presuppone che ogni richiesta fallita venga fatturata.
| Modello | Impostazioni | Invii | Addebito effettivo | Output accettati | Costo API per output accettato | Data di misurazione |
|---|---|---|---|---|---|---|
| GPT Image 2 Text-to-Image | high; 2048x1152; PNG | Da registrare | Da registrare | Da registrare | Da calcolare | Da registrare |
| Stesso modello, batch di valutazione successivo | Registra le impostazioni esatte | Da registrare | Da registrare | Da registrare | Da calcolare | Da registrare |
Usa questo come foglio di lavoro, non come tabella di risultati. Le dimostrazioni con immagini non stabiliscono un tasso di accettazione rappresentativo o un costo di produzione. Tieni separate le quotazioni del playground dai record di fatturazione consolidati, specialmente quando valuti in un ambiente di test.
Quando gli output accettati sono zero, segnala il batch come non riuscito e mostra la spesa totale. In tal caso un rapporto costo per output accettato è indefinito. Nascondere i batch falliti farebbe sembrare il tuo budget migliore di quanto si comporti l'applicazione.
Riduci prima gli sprechi: convalida gli input prima dell'invio, salva gli ID delle attività, previeni duplicati accidentali e riutilizza gli asset accettati quando il prodotto lo consente. Poi confronta impostazioni più economiche sugli stessi brief e controlli. Un'impostazione che riduce il preventivo ma raddoppia il lavoro di rifiuto può aumentare il costo della funzionalità.
Testa l'output, non solo la risposta
Scrivi i criteri di accettazione mentre redigi il prompt. Questo impedisce a un'immagine convincente di cambiare a posteriori la tua definizione di successo. Tieni i requisiti obbligatori separati dalle preferenze opzionali e registra perché un revisore ha rifiutato un risultato.
Automatizza i controlli che hanno risposte meccaniche chiare: successo del download, decodifica del file, formato, dimensioni e limiti di dimensione del file. Per JSON, convalida schema, campi obbligatori, etichette consentite e tipi. Un campo obbligatorio mancante non dovrebbe diventare silenziosamente un valore predefinito inventato.
Usa la revisione umana per i requisiti che necessitano di interpretazione. Nell'esempio della colazione, un revisore deve distinguere le fette sovrapposte, identificare il coltello, valutarne la posizione e cercare oggetti extra. Un verificatore di visione automatizzato può assistere, ma valuta i suoi errori prima di lasciargli approvare i risultati da solo.
La revisione della colazione dovrebbe includere i seguenti controlli indipendenti:
- Esattamente 2 fette di pane tostato, 1 piatto bianco, 1 ciotola trasparente di marmellata e 1 coltello.
- Coltello a destra del piatto; oggetti richiesti completamente nell'inquadratura.
- Nessuna tazza, piatto, mano, confezione o branding visibile in più.
- PNG leggibile alle dimensioni richieste.
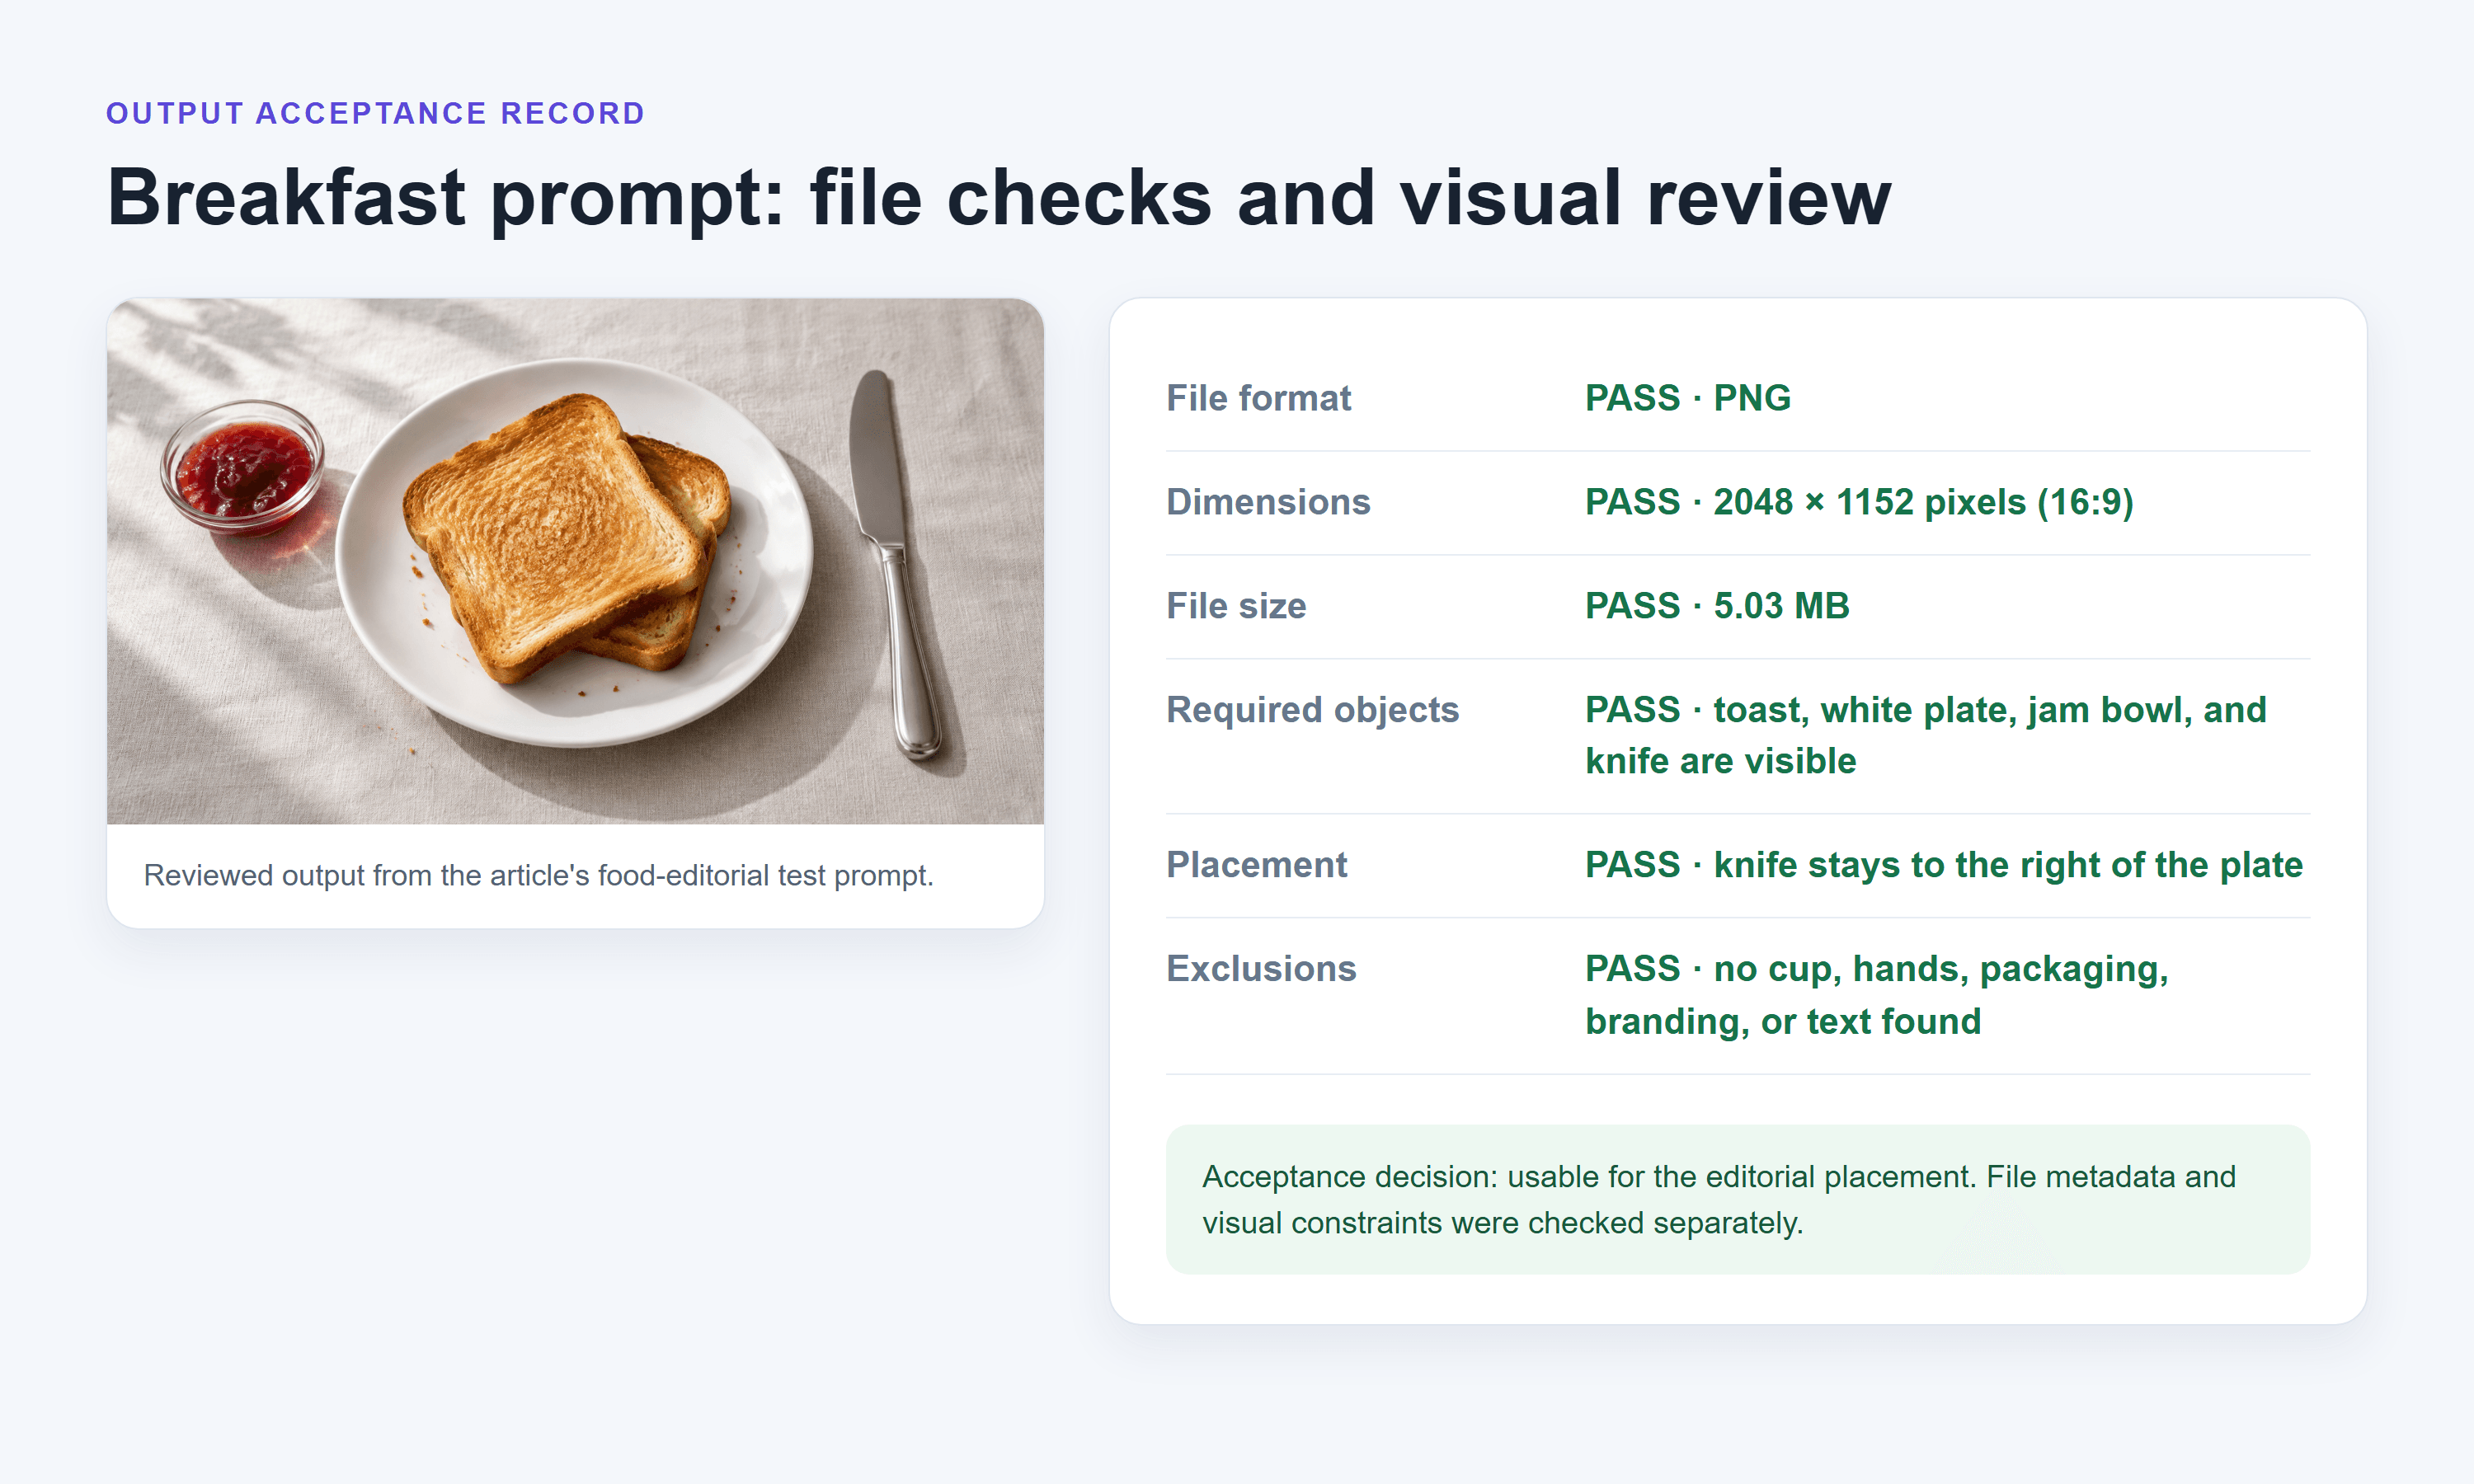 Record di convalida che separa i controlli dei metadati del file dai controlli di accettazione visiva
Il record riporta le dimensioni e il peso reali del file generato separatamente dai suoi controlli di accettazione visiva.
Costruisci un set di regressione fisso dalla funzionalità effettiva: richieste ordinarie, composizioni affollate, istruzioni in conflitto, ritagli difficili e limiti di input rilevanti. Versiona i brief e le regole dei revisori. Ripetili quando cambi modello, template del prompt o impostazioni di output.
Riporta separatamente il successo tecnico e il tasso di output accettati. Un file leggibile che contiene un oggetto in più conta come consegna riuscita e rifiuto del contenuto. Combinare questi esiti in un unico numero di successo nasconde la correzione di cui il tuo team ha bisogno.
Il sondaggio sugli sviluppatori del 2025 ha rilevato che il 46% non si fidava dell'accuratezza degli strumenti IA e il 33% si fidava; il 3% ha riportato un'elevata fiducia. Queste risposte riguardano gli strumenti IA nei flussi di lavoro di sviluppo, non un tasso di errore misurato per le API di generazione. (Stack Overflow Developer Survey, 2025.)
Allo stesso modo, 3 esecuzioni illustrative non possono stabilire l'accuratezza complessiva o una latenza p95 utile. Raccogli un campione più ampio e rilevante nelle condizioni che prevedi in produzione e conserva gli outlier. Usa le dimostrazioni per sviluppare i controlli, poi usa una valutazione sistematica per prendere una decisione di rilascio.
Checklist di produzione prima del rilascio
La prima richiesta funzionante risolve solo una piccola parte della decisione di rilascio. La tua applicazione deve anche contenere la spesa, recuperare il lavoro non finito e spiegare cosa è successo quando nessun risultato è disponibile.
Proteggi l'accesso. Mantieni le credenziali sul backend, separa gli ambienti, limita l'accesso ai record delle attività e pianifica la rotazione delle credenziali. Autorizza ogni richiesta di stato e download rispetto all'utente che possiede quell'attività. Un ID attività non indovinabile non sostituisce i controlli dei permessi.
Limita input e uso delle risorse. Convalida lunghezza del prompt, tipo e dimensione del caricamento, impostazioni di output richieste e combinazioni supportate. Per i media scaricati, applica destinazioni consentite, redirect, limiti di byte e limiti di decodifica. Gli script compatti sopra illustrano il ciclo di vita; non sono un servizio di download pubblico rafforzato.
Imposta budget prima dell'invio. Definisci limiti per utente e per attività, attività concorrenti massime e chi può richiedere impostazioni più costose. Riserva budget mentre il lavoro è in sospeso, così le richieste simultanee non possono superare tutte lo stesso controllo di saldo residuo.
Persisti lo stato. Scrivi l'attività locale prima di chiamare il provider. Salva immediatamente l'ID predizione restituito e rendi il polling riprendibile dopo un riavvio del processo. Se lo stato dell'invio è sconosciuto, usa uno stato di indagine invece di dire agli utenti che l'attività è sicuramente fallita.
Possiedi l'asset consegnato. Decidi dove risiedono i file accettati, chi può accedervi e quando scadono. Verifica la durata dei link del provider e i termini di conservazione invece di dipendere indefinitamente da un URL di output temporaneo. Includi l'eliminazione dei file derivati nel flusso di dati dell'applicazione.
Rendi comprensibile il fallimento. Distingui un'attività ritardata, un risultato rifiutato e un errore di servizio. Offri un percorso chiaro per riprovare intenzionalmente o richiedere una revisione. Conserva il brief dell'utente, così il recupero non richiede di ricostruire il lavoro.
Monitora i cambiamenti. Traccia separatamente completamento, accettazione, costo e tempo di attesa. Riesegui il set di regressione dopo cambiamenti di modello o parametri e mantieni disponibile la configurazione precedente ove fattibile. Redigi i log sensibili e assegna periodi di conservazione sia ai contenuti sia ai record operativi.
Per valutare la piattaforma di esempio per la tua applicazione, inizia con il catalogo modelli Atlas Cloud, poi leggi la documentazione dell'endpoint selezionato e delle predizioni. Scegli un'attività, definisci l'accettazione e registra ciò che la valutazione consegna effettivamente prima di espandere l'accesso.
Domande frequenti
Quale API di IA generativa dovrei scegliere per la mia applicazione?
Scegli in base a input, output, tempo di attesa accettabile e requisiti di revisione della funzionalità. Esegui gli stessi brief rappresentativi sui candidati che puoi usare legalmente e operativamente. Confronta costo per output accettato e lavoro di integrazione insieme alle capacità. Non esiste una scelta universale stabilita da questi 3 esempi di immagini.
Esistono API di IA generativa gratuite per sviluppatori?
Alcuni servizi offrono prove o uso gratuito limitato, ma disponibilità, idoneità, quote e usi consentiti cambiano. Verifica i termini correnti per l'endpoint esatto. Un'allowance gratuita per strumenti di consumo non include necessariamente l'accesso API. Anche il self-hosting usa hardware, elettricità e tempo di ingegneria, persino quando i pesi del modello sono scaricabili.
Serve esperienza di machine learning per usare un'API di IA generativa?
Puoi iniziare con competenze di HTTP, JSON, autenticazione e sviluppo backend ordinario. Rilasciare una funzionalità affidabile richiede inoltre valutazione e lavoro operativo. Devi comprendere le limitazioni del modello abbastanza bene da definire un output accettabile, senza necessariamente addestrare un modello da solo.
Un'API può gestire testo, immagini e video?
Una piattaforma può fornire tutti e 3, ma ogni capacità può usare endpoint, parametri, tipi di output e modelli di attesa diversi. Verifica ogni interfaccia separatamente. Un account o una credenziale condivisi non rendono un corpo di richiesta di testo compatibile con un modello di immagini o video.
Perché la mia richiesta di immagine restituisce un ID attività invece di un'immagine?
L'endpoint invia il lavoro in modo asincrono. Salva l'ID e interroga la rotta di stato documentata. Recupera il file quando l'attività si completa, poi convalidalo. Se il tuo client smette di attendere, l'attività lato server potrebbe essere ancora in esecuzione; riprendi quell'attività prima di inviarne un'altra.
Come posso ridurre i costi API senza rompere il flusso di lavoro?
Previeni invii duplicati, convalida presto gli input, riutilizza gli asset accettati dove appropriato e testa configurazioni più economiche rispetto a criteri di accettazione invariati. Misura gli addebiti effettivi per risultato accettato. Un'API di IA generativa per sviluppatori si guadagna il suo posto quando l'applicazione circostante può consegnare lavoro utilizzabile a un costo che puoi sostenere.


