Un avatar del corso che muove solo la bocca può catturare l'attenzione per una frase, poi perdere la lezione. I video con istruttore per corsi con OmniHuman 2.0 ti offrono un modo per pianificare espressioni visibili, gesti mirati e direzione della telecamera attorno a una spiegazione registrata. L'esempio di contrasto cromatico riportato di seguito mostra una scena completa di 30 secondi con l'istruttore e, altrettanto utilmente, un problema di continuità degli oggetti di scena da individuare prima di pubblicare una lezione.
Punti chiave
- Gli input principali sono un'immagine dell'istruttore e l'audio; un prompt testuale può guidare la performance o la direzione della telecamera.
- Considera OmniHuman 2.0 come la fase video del presentatore. La lezione, le slide, le registrazioni dello schermo, la verifica dei fatti e il montaggio restano di tua competenza.
- L'esempio di contrasto cromatico di 30 secondi mostra utili cambi di gesto e punto di vista, oltre a un cartoncino che scompare e richiede una revisione editoriale.
- Controlla sincronizzazione labiale, espressione, gesti, stabilità dell'immagine e diritti prima di pubblicare.
- Atlas Cloud indica $0.07 al secondo e mostra una tariffa scontata di $0.056; conferma la tariffa attuale prima di generare.
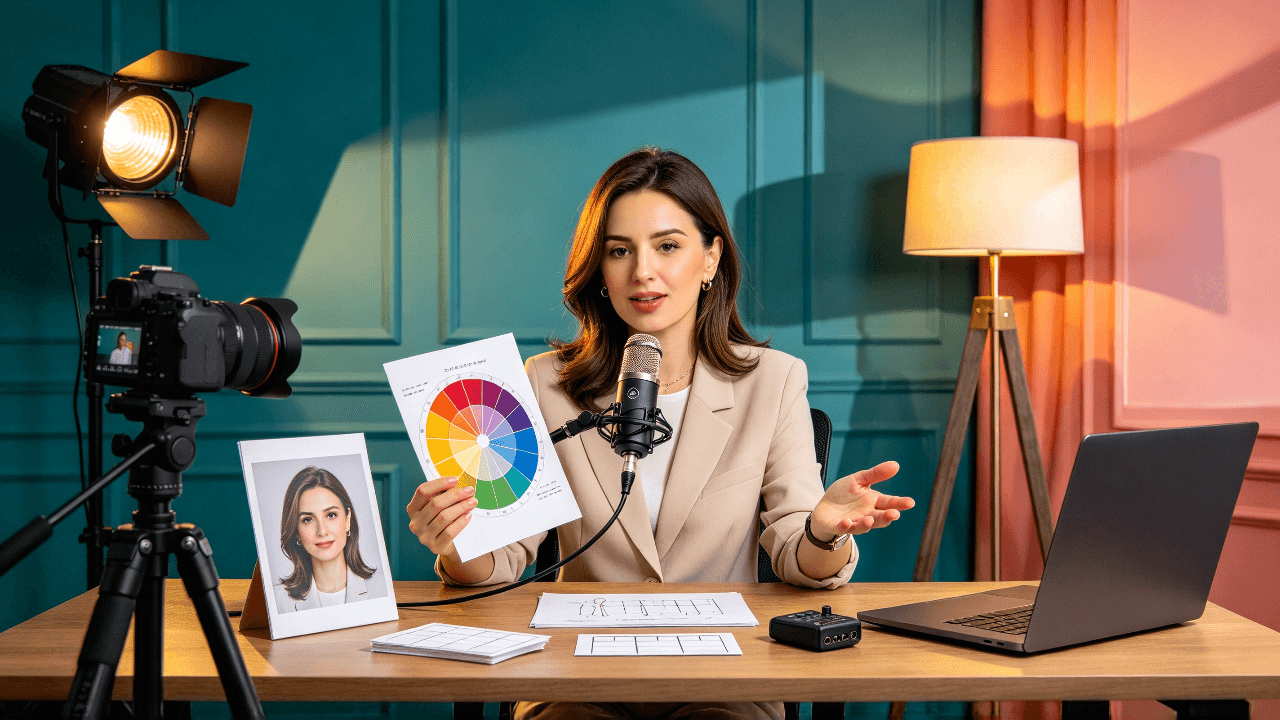
Scena illustrativa di preparazione: un ritratto di riferimento, la registrazione della narrazione e i materiali della lezione sono gli input da pianificare prima di creare un video con presentatore.
Cosa fa OmniHuman 2.0 per i video con istruttore per corsi
OmniHuman 2.0 trasforma un'immagine di riferimento e una traccia audio in un video a 720p del personaggio raffigurato che parla o canta. La directory dei modelli di Atlas Cloud descrive la direzione testuale opzionale, i gesti dinamici, le scene con più persone, il movimento della telecamera e clip fino a cinque minuti. Queste sono funzionalità elencate, non una garanzia che ogni prompt per un corso produrrà una ripresa adeguata.
(Dettagli del modello Avatar Omni Human 2.0)
La suddivisione delle responsabilità è importante. Tu fornisci il contenuto didattico e la registrazione vocale. Il modello genera la performance visibile. Tu decidi dove un presentatore è utile e dove un diagramma, una slide, una cattura dello schermo o una dimostrazione ravvicinata spiegano meglio il materiale.
| Elemento di produzione | Cosa prepari o fai | Cosa contribuisce il modello | Cosa controlli |
|---|---|---|---|
| Immagine dell'istruttore | Un ritratto chiaro e autorizzato | Il riferimento visibile dell'identità | Coerenza di volto, abbigliamento e sfondo |
| Narrazione della lezione | Una registrazione verificata con ritmo deliberato | Performance vocale guidata dall'audio | Tempi, pronuncia e pause |
| Direzione | Una nota concisa su inquadratura e resa | Performance e direzione della telecamera guidate dal prompt | Se il movimento supporta la lezione |
| Visual didattici | Slide, registrazioni dello schermo, diagrammi o esempi | Nessuna sostituzione per questi materiali | Se ogni concetto è facile da seguire |
| Lezione finale | Montaggio, sottotitoli e revisione qualità | Un segmento video generato | Accuratezza, accessibilità e autorizzazioni |
Un primo articolo di ricerca su OmniHuman descrive l'animazione umana condizionata dall'audio, ma riguarda OmniHuman-1 e non va considerato un test di performance della versione 2.0. Per una decisione di produzione di un corso, affidati all'elenco attuale del modello per gli input dichiarati e i limiti di output, poi valuta un campione creato con i tuoi materiali. (Articolo su OmniHuman-1)
Cosa preparare prima di generare un video con istruttore AI
Un campione convincente dipende da più del semplice caricamento di un ritratto e una registrazione qualsiasi. Scegli materiale che renda facile valutare se il risultato è adatto a una lezione reale.
Scegli un'immagine chiara dell'istruttore con autorizzazione
Usa un ritratto frontale o leggermente ruotato con un volto chiaramente visibile, spalle nell'inquadratura e sfondo non confuso. Evita un volto minuscolo, occlusione marcata, ombre drammatiche o un ritaglio che non lascia spazio al movimento naturale della testa. Se vuoi lo stesso presentatore in più moduli, conserva una copia dell'immagine di origine approvata e riutilizzala in modo coerente.
Usa un'immagine tua o conferma che la persona ha dato il permesso per l'uso previsto in video sintetici. La disponibilità di un ritratto online non costituisce permesso di animarlo o pubblicarlo.
Registra l'audio della lezione che suoni naturale in video
Registra un punto didattico coerente a un ritmo misurato. Un breve paragrafo è più facile da valutare e revisionare rispetto a un'intera lezione. Prima di registrare, controlla terminologia, nomi, numeri e le affermazioni fattuali della lezione. Lascia pause naturali tra le idee, ma taglia lunghe interruzioni e rumore di fondo che potrebbero rendere più difficile valutare i tempi.
Ascolta una volta con il testo della lezione davanti a te. Se un numero o un termine tecnico non è chiaro nella registrazione, correggi prima l'audio di origine. Un volto generato non può riparare una spiegazione errata o una pronuncia ambigua.
Mantieni la lezione utile anche senza l'avatar
Scrivi la spiegazione in modo che resti comprensibile se abbinata a una slide o a una cattura dello schermo. Usa il presentatore per contesto, transizioni e brevi spiegazioni. Usa una registrazione dello schermo per un'azione software, un diagramma etichettato per un processo e un esempio svolto per un calcolo. Poi monta questi elementi insieme nel tuo editor di corsi.
Prepara un pacchetto di esempio contenente il ritratto, una narrazione completa, un prompt di direzione e la slide o cattura dello schermo di supporto che prevedi di usare. Questo ti offre un test pratico della catena di produzione, invece di un'animazione facciale isolata.
Come creare un video con istruttore per corsi con OmniHuman 2.0
L'obiettivo della prima generazione è una decisione: questa combinazione di presentatore e audio aiuta questa lezione? Mantieni il test ristretto, così un risultato debole è facile da diagnosticare.
Inizia con un breve segmento di lezione
Scegli un pensiero completo che introduca un concetto, fornisca un esempio e arrivi a un chiaro passaggio successivo. Non tagliare una frase a metà per raggiungere una durata obiettivo. L'esempio fornito di seguito dura 30 secondi, abbastanza da mostrare un'azione visibile e un cambio di punto di vista della telecamera. Controlla la durata audio effettivamente supportata e le regole di input correnti nell'interfaccia live del modello prima del caricamento.
Carica l'immagine e la narrazione, poi dirigi la performance
Apri il playground Avatar Omni Human 2.0 per esaminare gli input correnti. Prepara tu stesso l'immagine e la narrazione; l'elenco del modello descrive un flusso da immagine e audio a video, non un flusso di sintesi vocale. Se non hai già registrato la voce, creala e rivedila nel tuo flusso audio preferito prima di questo passaggio.
Per questo flusso di lavoro, l'audio fornito determina le parole pronunciate e il ritmo. Il prompt testuale dirige azioni visibili, espressioni e movimento della telecamera. Rivedi il tuo risultato generato prima di descrivere qualsiasi movimento pianificato come output riuscito. Atlas Cloud elenca output a 720p e clip fino a cinque minuti, ma i controlli live e il job completato sono il controllo finale per la tua esecuzione.
Rivedi la clip prima di creare una lezione completa
Guarda il risultato una volta con l'audio, poi una volta seguendo il testo della lezione. Annota il momento esatto in cui un movimento della bocca, una pausa o un gesto sembra distrarre. Se il problema compare in una frase particolare, accorcia o registra di nuovo quella frase e genera solo un segmento revisionato. Se il volto resta convincente ma la spiegazione richiede diagrammi, mantieni l'inquadratura del presentatore e aggiungi quei visual in fase di montaggio.
Solo dopo che un segmento supera la revisione dovresti riutilizzare il ritratto approvato, lo stile di registrazione e la struttura del prompt nella sezione successiva della lezione. La coerenza deriva da un processo di input ripetibile; non significa che ogni segmento generato sarà identico.
Esempio pratico: una lezione di 30 secondi sul contrasto cromatico
La lezione ha un unico compito visivo: far vedere agli studenti come cambia un abbinamento brillante corallo e verde acqua quando nell'arrangiamento entra un giallo più tenue. Un'immagine dell'istruttore fornita, due fotogrammi selezionati dal video completato e la clip completa ti permettono di esaminare l'azione didattica reale invece di dedurla da un prompt. L'esempio illustra progettazione della scena e revisione editoriale; testa il flusso di lavoro descritto sopra con la tua immagine e il tuo audio approvati prima di trarre conclusioni sul suo output.
Inizia con una composizione che supporti l'insegnamento
L'immagine di input ha un volto chiaro e mani visibili, con tre cartoncini opachi sul tavolo da lavoro. Corallo, verde acqua e giallo sono tutti presenti prima che inizi qualsiasi movimento. L'arco verde acqua, il pannello corallo e il vetro ambrato dello studio creano un ambiente colorato lasciando al tempo stesso i cartoncini facili da distinguere.
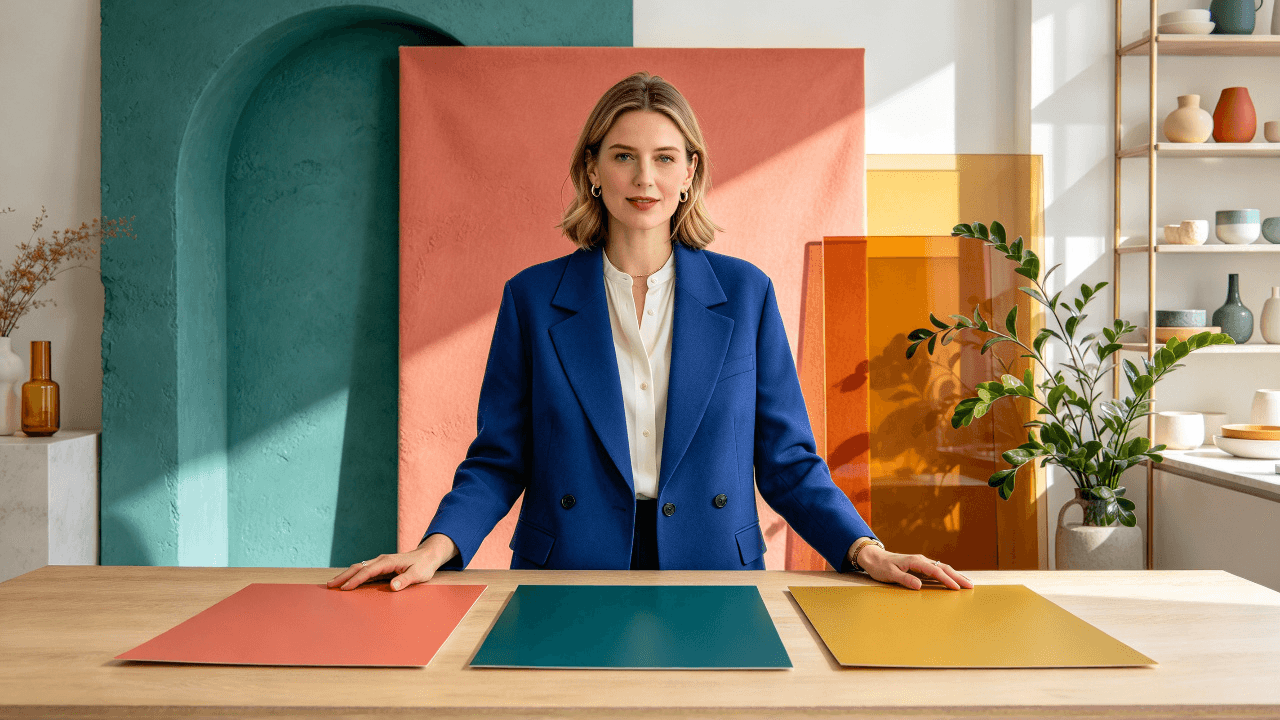
L'immagine di riferimento fornita lascia il volto, le mani e tre oggetti didattici dell'istruttore chiaramente visibili prima dell'animazione.
Il primo confronto è leggibile
All'inizio della clip, l'istruttrice rivolge l'attenzione al tavolo da lavoro e mette una mano vicino al confine tra corallo e verde acqua. La telecamera si è avvicinata rispetto al fermo immagine di riferimento, ma il suo volto e i tre colori originali restano visibili. Questo fotogramma mostra l'azione che lo studente deve seguire: confrontare due colori adiacenti prima di cambiare l'arrangiamento.
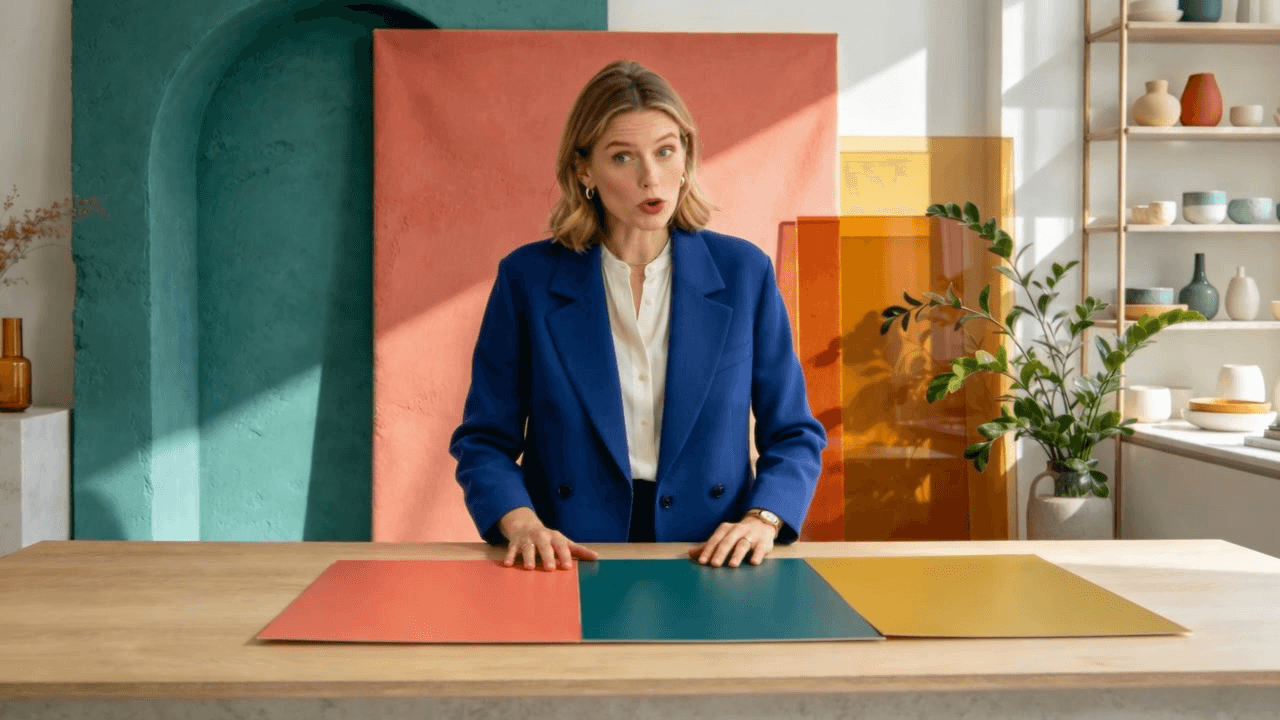
Un fotogramma reale del video fornito: l'istruttrice dirige l'attenzione sul bordo corallo e verde acqua mentre tutti e tre i cartoncini sono ancora visibili.
Il punto di vista cambiato rivela un problema di continuità
Più avanti, il punto di vista si sposta sull'altro lato del tavolo e l'istruttrice fa un gesto verso il giallo. Il cartoncino verde acqua non è più visibile. Questo differisce dall'arrangiamento pianificato a tre cartoncini, in cui il giallo si troverebbe tra corallo e verde acqua. L'inquadratura più ravvicinata e l'espressione danno varietà alla scena, ma il cartoncino mancante cambia l'esempio didattico. Se questa fosse una lezione finale del corso, il cambio di oggetto richiederebbe un'altra ripresa o un montaggio che renda accurato il confronto previsto.
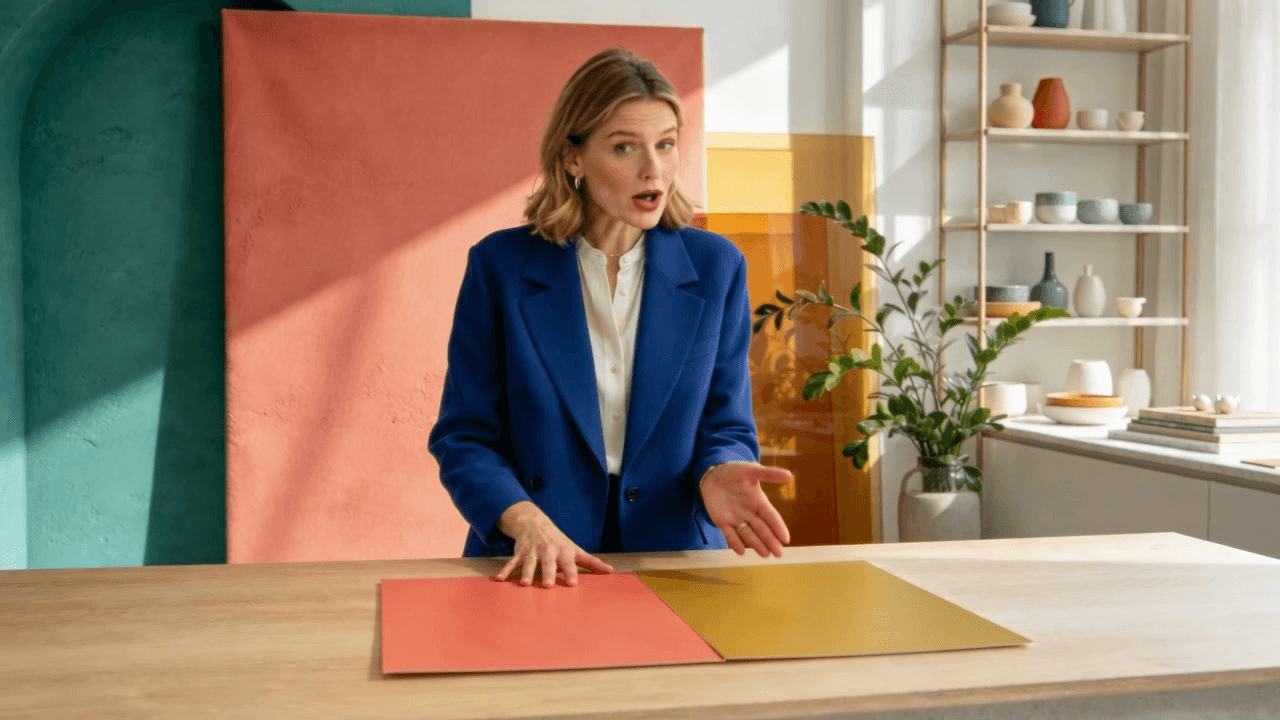
Un fotogramma successivo della stessa clip: l'angolazione della telecamera e il gesto cambiano, mentre il cartoncino verde acqua è scomparso dall'arrangiamento.
Guarda la scena completa con l'audio
Il video fornito dura poco più di 30 secondi e include una traccia audio. Guardalo come un unico esempio continuo, così gesti, espressione, movimento della telecamera e audio possono essere valutati insieme. I due fotogrammi sopra sono prove di momenti diversi, non casi generati separati.
La scena riesce a dare all'istruttrice più da fare che stare semplicemente davanti alla telecamera: maneggia oggetti, cambia sguardo e viene mostrata da più di un punto di vista. Il cartoncino verde acqua che scompare è il risultato di revisione importante. Mantieni una lezione finale solo quando l'esempio visivo corrisponde a ciò che lo studente deve comprendere, e verifica la spiegazione parlata rispetto all'audio prima della pubblicazione.
Come verificare se il video con istruttore AI è pronto
Usa un passaggio di revisione che controlli sia la performance generata sia la lezione come la vedranno gli studenti:
- Sincronizzazione della bocca: I movimenti della bocca seguono grosso modo le sillabe chiave e le pause? Riguarda i nomi difficili e le pause brevi.
- Espressione: Il volto è adatto a una spiegazione calma o passa a un sorriso non correlato o a un'emozione esagerata?
- Gesti: Le mani restano lontane dal volto ed evitano di distrarre da una slide importante?
- Identità e scena: I tratti del volto, l'abbigliamento e lo sfondo restano stabili per tutta la clip?
- Accuratezza audio: Terminologia, nomi e numeri sono pronunciati correttamente nella registrazione fornita?
- Chiarezza didattica: Il montaggio include la slide, la cattura dello schermo, il sottotitolo o l'esempio svolto necessari al momento giusto?
- Diritti e divulgazione: Hai il permesso per l'immagine e la voce e hai controllato le regole di divulgazione e la policy istituzionale per il pubblico e il mercato previsti?
Decidi se mantenere la clip, revisionare l'audio o l'immagine di origine, oppure usare invece una voce fuori campo con le slide. Non mantenere un'inquadratura del presentatore solo perché la generazione ha richiesto tempo. Una chiara registrazione dello schermo può insegnare meglio un passaggio procedurale.
Costi e scalabilità per i video dei corsi
A partire da ottobre 2026, la pagina del modello Atlas Cloud indica una tariffa standard di $0.07 al secondo e mostra una tariffa scontata di $0.056 al secondo con uno sconto del 20%. Semplici stime basate su queste tariffe indicate sono:
| Durata generata | A $0.07/sec | Alla tariffa visualizzata di $0.056/sec |
|---|---|---|
| 20 secondi | $1.40 | $1.12 |
| 60 secondi | $4.20 | $3.36 |
| 5 minuti | $21.00 | $16.80 |
Questi sono calcoli basati sulla tariffa del modello, non un preventivo per il tuo account né una garanzia dell'addebito finale. Lo sconto visualizzato può cambiare, e tasse, condizioni a livello di account o altri addebiti possono influire sul checkout. Ricontrolla i dettagli del modello e la schermata di conferma effettiva prima della produzione.
Un campione breve limita il costo di verifica di un nuovo ritratto, voce o prompt. Per materiale più lungo, dividi la lezione in corrispondenza di reali confini didattici, come un nuovo concetto o un esempio svolto. Non dividere una frase o rimuovere una spiegazione necessaria solo per rispettare un limite di generazione. Alla tariffa standard indicata, un output di cinque minuti costerebbe $21 prima di qualsiasi sconto applicabile; confrontalo con segmenti più brevi più tempo di montaggio e decidi quale formato serve meglio la lezione.
Privacy, consenso e fiducia nel corso
Prima di generare, conferma di poter usare il ritratto e la voce dell'istruttore per video sintetici nel corso, nel canale di distribuzione e nella durata previsti. Se compare un collaboratore esterno, un dipendente, un relatore ospite o uno studente, documenta il permesso e eventuali limiti. Controlla i requisiti della tua istituzione per i media generati o modificati dall'IA e le regole applicabili nei tuoi mercati di riferimento; questo articolo non determina obblighi legali.
Rivedi la lezione finita come farebbe un istruttore. Correggi il copione e la registrazione, dichiara la presentazione sintetica dove il tuo pubblico o la policy lo prevedono e mantieni una persona responsabile delle affermazioni del corso. Un presentatore curato può far sembrare autorevole materiale debole o non verificato, quindi il proprietario della lezione dovrebbe approvare sia le parole sia il montaggio finale.
Per una prima produzione, crea un breve segmento, rivedilo rispetto alla checklist e stima il lotto successivo usando la tariffa attuale al secondo. Questa piccola decisione ti dice se i video con istruttore per corsi con OmniHuman 2.0 appartengono al tuo flusso di lavoro per i corsi.
Domande frequenti
OmniHuman 2.0 può creare un video per un corso solo dal testo?
La scheda di Atlas Cloud descrive un flusso da immagine e audio a video con direzione testuale opzionale. Non elenca il solo testo come sostituto dell'audio di narrazione, quindi prepara la traccia vocale separatamente.
Posso riutilizzare la stessa immagine dell'istruttore in più lezioni?
Puoi preparare la stessa immagine approvata per generazioni separate. Riutilizzarla supporta un riferimento visivo coerente, anche se non garantisce espressioni, inquadrature o gesti identici in ogni output. Rivedi ogni segmento prima di unirli.
OmniHuman 2.0 genera la voce della lezione?
Il flusso di lavoro elencato prende in input una traccia audio. Registra o produci la voce separatamente, controllala e carica la narrazione finita.
Quanto costa una clip per corso di 20 secondi con OmniHuman 2.0 su Atlas Cloud?
Alla tariffa standard indicata di $0.07 al secondo, 20 secondi equivalgono a $1.40. Alla tariffa visualizzata di $0.056, equivalgono a $1.12. Conferma i prezzi attuali e l'addebito finale prima di eseguire una generazione.


