Un'API AI per la generazione in batch è utile quando ogni output può essere individuato, revisionato e ritentato singolarmente. Questo conta più di quanti prompt si inviano contemporaneamente. Il momento costoso non è la richiesta numero 1.000. È quando l'attività 37 va in timeout, l'attività 38 riesce, due file condividono lo stesso nome e nessuno riesce a dire quale immagine sia sicura da pubblicare.
Tratta un batch come una raccolta di job di asset recuperabili. Assegna a ogni job un ID aziendale durevole, salva l'input esatto e le impostazioni del modello, limita la concorrenza e ritenta solo l'elemento che ha effettivamente fallito. Questa guida utilizza un flusso di lavoro di campagna personaggio con 8 asset, così che uno sviluppatore o un team di crescita possa trasformare un manifest in un'esecuzione produttiva controllata.
Punti chiave
- Un job batch e le richieste parallele risolvono problemi diversi di latenza e controllo.
- ID asset stabili e chiavi di idempotenza rendono gestibile il fallimento parziale.
- Inizia con 4-8 asset visivi, rivedili, poi espandi.
- Una risposta API riuscita necessita comunque di una revisione visiva e dei diritti prima della pubblicazione.
API AI per la generazione in batch: prima la risposta
Un'API AI per la generazione in batch invia un insieme di attività di generazione distinte a una coda asincrona, quindi restituisce i risultati tramite controlli di stato, un callback di completamento o un file di output scaricabile. Ogni attività necessita di un'identità che esista al di fuori del provider del modello. L'ID job del provider è utile per le operazioni, ma maya-ridgeline-001 è ciò che consente al tuo sistema editoriale o di campagna di identificare l'asset mesi dopo.
Non fondere tre idee correlate. Un singolo prompt può richiedere diverse varianti. Il tuo worker può inviare diverse richieste normali contemporaneamente. Un job batch lato server è una raccolta gestita dal provider che si completa in seguito. Quest'ultimo si adatta spesso al lavoro offline, mentre le richieste parallele controllate si adattano a una dashboard che necessita di progresso immediato.
L'attuale documentazione di OpenAI Batch API illustra il modello asincrono: le richieste vengono raccolte in JSONL, inviate come job, verificate per il completamento e recuperate come risultati. La sua finestra di 24 ore, i limiti di velocità batch separati e i limiti sono specifici di quel servizio, non una promessa che ogni provider di immagini fa (documentazione OpenAI Batch API, settembre 2026). Anche il riferimento attuale di Gemini documenta job batch a esecuzione prolungata, controlli di stato e supporto webhook per il suo servizio (riferimento Gemini Batch API, settembre 2026).
| Punto decisionale | API Batch | Richieste parallele controllate |
|---|---|---|
| Risposta attesa | Completamento differito | Ogni richiesta ritorna quando termina |
| Ideale per | Lavoro su catalogo, storyboard e libreria di contenuti offline | Strumenti interattivi e brevi cicli di revisione |
| Gestione dei fallimenti | Leggi i risultati per singolo elemento dopo il completamento di un job | Gestisci ogni richiesta figlia quando si risolve |
| Costo e limiti | Le regole batch specifiche del provider possono differire dal traffico live | Utilizza i limiti di richiesta ordinari dell'account |
| Record essenziale | ID asset, ID richiesta, stato del risultato, posizione dell'output | Gli stessi campi, più lo stato del tentativo in corso |
Scegli richieste parallele controllate quando un revisore ha bisogno di vedere rapidamente la prima immagine utilizzabile. Scegli un job batch lato server quando il lavoro può attendere e il provider documenta un percorso batch. In entrambi i casi, salva asset_id, input normalizzato, hash di riferimento, modello, numero di tentativi e URL di output. Questo livello comune mantiene il flusso di lavoro portabile se il meccanismo di consegna cambia.
Perché i progetti di immagini in batch falliscono su larga scala
I batch di produzione di solito falliscono a pezzi. Una richiesta può essere completata, andare in timeout, essere rifiutata o restituire un output tecnicamente valido ma visivamente inutilizzabile. Un'applicazione che registra solo un URL finale ha gettato via le informazioni necessarie per recuperare da tutti i casi tranne il più semplice successo.
Il primo fallimento è l'identità mancante. Se la richiesta porta solo una stringa di prompt, un output non può essere mappato in modo affidabile a un prodotto, a una lingua di campagna o a una riga di origine. I nomi dei file derivati dal prompt sono fragili perché le revisioni del prompt e i prodotti ripetuti si scontrano. Usa un ID asset stabile dal record aziendale, poi assegna a ogni tentativo di generazione il proprio suffisso.
Il secondo fallimento è ritentare senza idempotenza. Un timeout di rete non prova che il provider non abbia fatto alcun lavoro. Se un worker invia immediatamente di nuovo lo stesso asset con una nuova identità di richiesta, può creare output duplicati e addebiti duplicati. Una chiave di idempotenza consente al chiamante di dire, in sostanza: "questo è ancora lo stesso asset richiesto". Se un endpoint specifico supporti quel meccanismo dipende dal provider, quindi verificalo nella documentazione API prima di affidarti ad esso.
Il terzo fallimento è una coda cieca di 40 o 60 prompt. Una deriva di colore, composizione o identità di prodotto può diventare visibile solo dopo il completamento dell'esecuzione. Una recente discussione tra creatori descrive la revisione di pagine di storyboard di circa 7-8 immagini prima di inviare la pagina successiva, specificamente per individuare errori di accuratezza e coerenza (discussione sulla generazione di immagini in batch, giugno 2026). Questa è esperienza della community, non un benchmark, ma è un punto di controllo operativo sensato.
Usa una regola di QC a piccoli batch: esegui 4-8 asset, ispezionali, ripara il prompt o il riferimento se necessario, poi sblocca il gruppo successivo. Conserva il prompt originale, la versione del prompt, il riferimento di input, la revisione del modello quando disponibile, l'impostazione di qualità, le proporzioni, i timestamp, la classe di errore e la decisione di revisione. Un URL da solo non può rispondere al perché un asset esiste o se dovrebbe essere riutilizzato.
Progetta un'API AI affidabile per la generazione in batch
L'implementazione può essere piccola. Un manifest, un worker di coda, un record job append-only e una cartella di output adatta ai revisori sono sufficienti per iniziare. L'obiettivo non è un grande sistema di orchestrazione. È un flusso di lavoro in cui una persona può rispondere: cosa è stato richiesto, cosa è accaduto e cosa dovrebbe essere eseguito dopo?
Assegna a ogni output batch un'identità asset durevole
Rendi asset_id una chiave aziendale, non un ID job del provider. Un record di attività utile può includere i campi seguenti. Conservalo in un database quando operano più worker, oppure in un CSV versionato più un log JSONL per un team più piccolo.
| Campo | Perché esiste |
|---|---|
asset_id | Identità immutabile per l'asset pubblicabile |
source_row | Si mappa al prodotto, alla campagna o al record di contenuto |
prompt_version | Mostra quale modello di istruzioni ha prodotto il risultato |
reference_hash | Conferma quale immagine di origine bloccata è stata utilizzata |
model, aspect_ratio, quality | Rende l'esecuzione abbastanza riproducibile da diagnosticarla |
attempt, idempotency_key, status | Separa un tentativo del job figlio da una nuova richiesta |
output_url, review_status, failure_reason | Collega la consegna e l'accettazione umana |
Ad esempio, maya-train-001 resta l'identità dell'asset. maya-train-001-a2 è il tentativo 2. La chiave di idempotenza può essere maya-train-001-v1, dove v1 identifica la specifica immutabile richiesta. Se il brief cambia in modo sostanziale, crea una nuova versione del prompt invece di sovrascrivere il vecchio record.
Usa una coda batch, non un ciclo illimitato
Imposta un limite di concorrenza, un limite di numero di asset, una protezione monetaria e un limite di tentativi prima dell'invio. Una configurazione iniziale pratica è 4 job in corso, al massimo 2 tentativi di generazione per job e non più di 8 attività visive prima del successivo controllo di qualità. Questi sono valori di partenza, non garanzie della piattaforma. Impostali al di sotto dei limiti documentati del tuo account e regolali dopo aver osservato i tempi di completamento reali e i tassi di errore.
Il worker dovrebbe rivendicare un'attività in sospeso, contrassegnarla come submitted, salvare l'ID richiesta del provider e aggiornare quello stesso record quando arriva un risultato. Quando viene raggiunto un limite di budget, smetti di rivendicare lavoro. Quando la coda è in pausa per la revisione, consenti al lavoro già inviato di risolversi ma non rilasciare automaticamente un altro gruppo.
Ritenta solo il job figlio fallito
Ritenta stati failed, timed_out o ritentabili specifici del provider un asset alla volta. Usa backoff esponenziale limitato con jitter per risposte 429, risposte 5xx transitorie e timeout di trasporto reali. Salva la classificazione dell'errore e il tempo di tentativo pianificato. Non ripetere automaticamente un rifiuto per politica sui contenuti, un input malformato, un riferimento mancante o un rifiuto visivo da parte di un revisore umano.
Non reinviare mai un intero batch perché un figlio ha fallito. Archivia immediatamente i risultati riusciti e preserva la mappatura origine-output. Se un job batch scade con risultati parziali, acquisisci i figli completati, identifica gli ID asset non finiti e crea un nuovo job contenente solo quei record rimanenti. Questa è la differenza tra recupero e duplicazione.
Un flusso di lavoro di immagini in batch con 8 asset copiabile
Il seguente esempio è deliberatamente fittizio: Maya, una fotografa di viaggio adulta in missione sugli altopiani. Rende concreti i meccanismi operativi senza implicare che una persona reale abbia approvato la campagna. Sostituisci i campi con i tuoi dati consentiti su personaggio, liberatoria o campagna e mantieni la struttura.
Passaggio 0: crea il manifest prima di generare
Crea batch-manifest.csv prima di aprire un playground o chiamare un endpoint. Fornisce all'operatore un chiaro obiettivo di accettazione per ogni asset.
| asset_id | batch | use_case | ratio | status |
|---|---|---|---|---|
| maya-master-001 | master | riferimento canonico del personaggio | 16:9 | pending |
| maya-ridgeline-001 | a | immagine campagna crinale all'alba | 16:9 | pending |
| maya-market-001 | a | immagine editoriale mercato di montagna | 16:9 | pending |
| maya-cabin-001 | a | immagine editoriale pianificazione in baita | 16:9 | pending |
| maya-lake-001 | a | immagine note sul campo in riva al lago | 16:9 | pending |
| maya-forest-001 | b | immagine campagna sentiero nel bosco | 16:9 | pending |
| maya-train-001 | b | immagine editoriale viaggio in treno | 16:9 | pending |
| maya-workbench-001 | b | immagine preparazione kit da campo | 16:9 | pending |
| maya-portrait-001 | b | immagine campagna ritratto ravvicinato | 16:9 | pending |
Genera una chiave di idempotenza deterministica per ogni richiesta immutabile, come maya-ridgeline-001-v1. La forma sottostante è volutamente neutrale rispetto al provider. Inserisci l'endpoint del provider e i suoi parametri documentati dentro request; non copiare un endpoint privato fittizio in produzione.
plaintext1{"asset_id":"maya-ridgeline-001","idempotency_key":"maya-ridgeline-001-v1","request":{"model":"your-approved-model","ratio":"16:9","reference_hash":"sha256:...","prompt_version":"maya-highlands-v1"}}
Passaggio 1: crea un riferimento canonico del personaggio
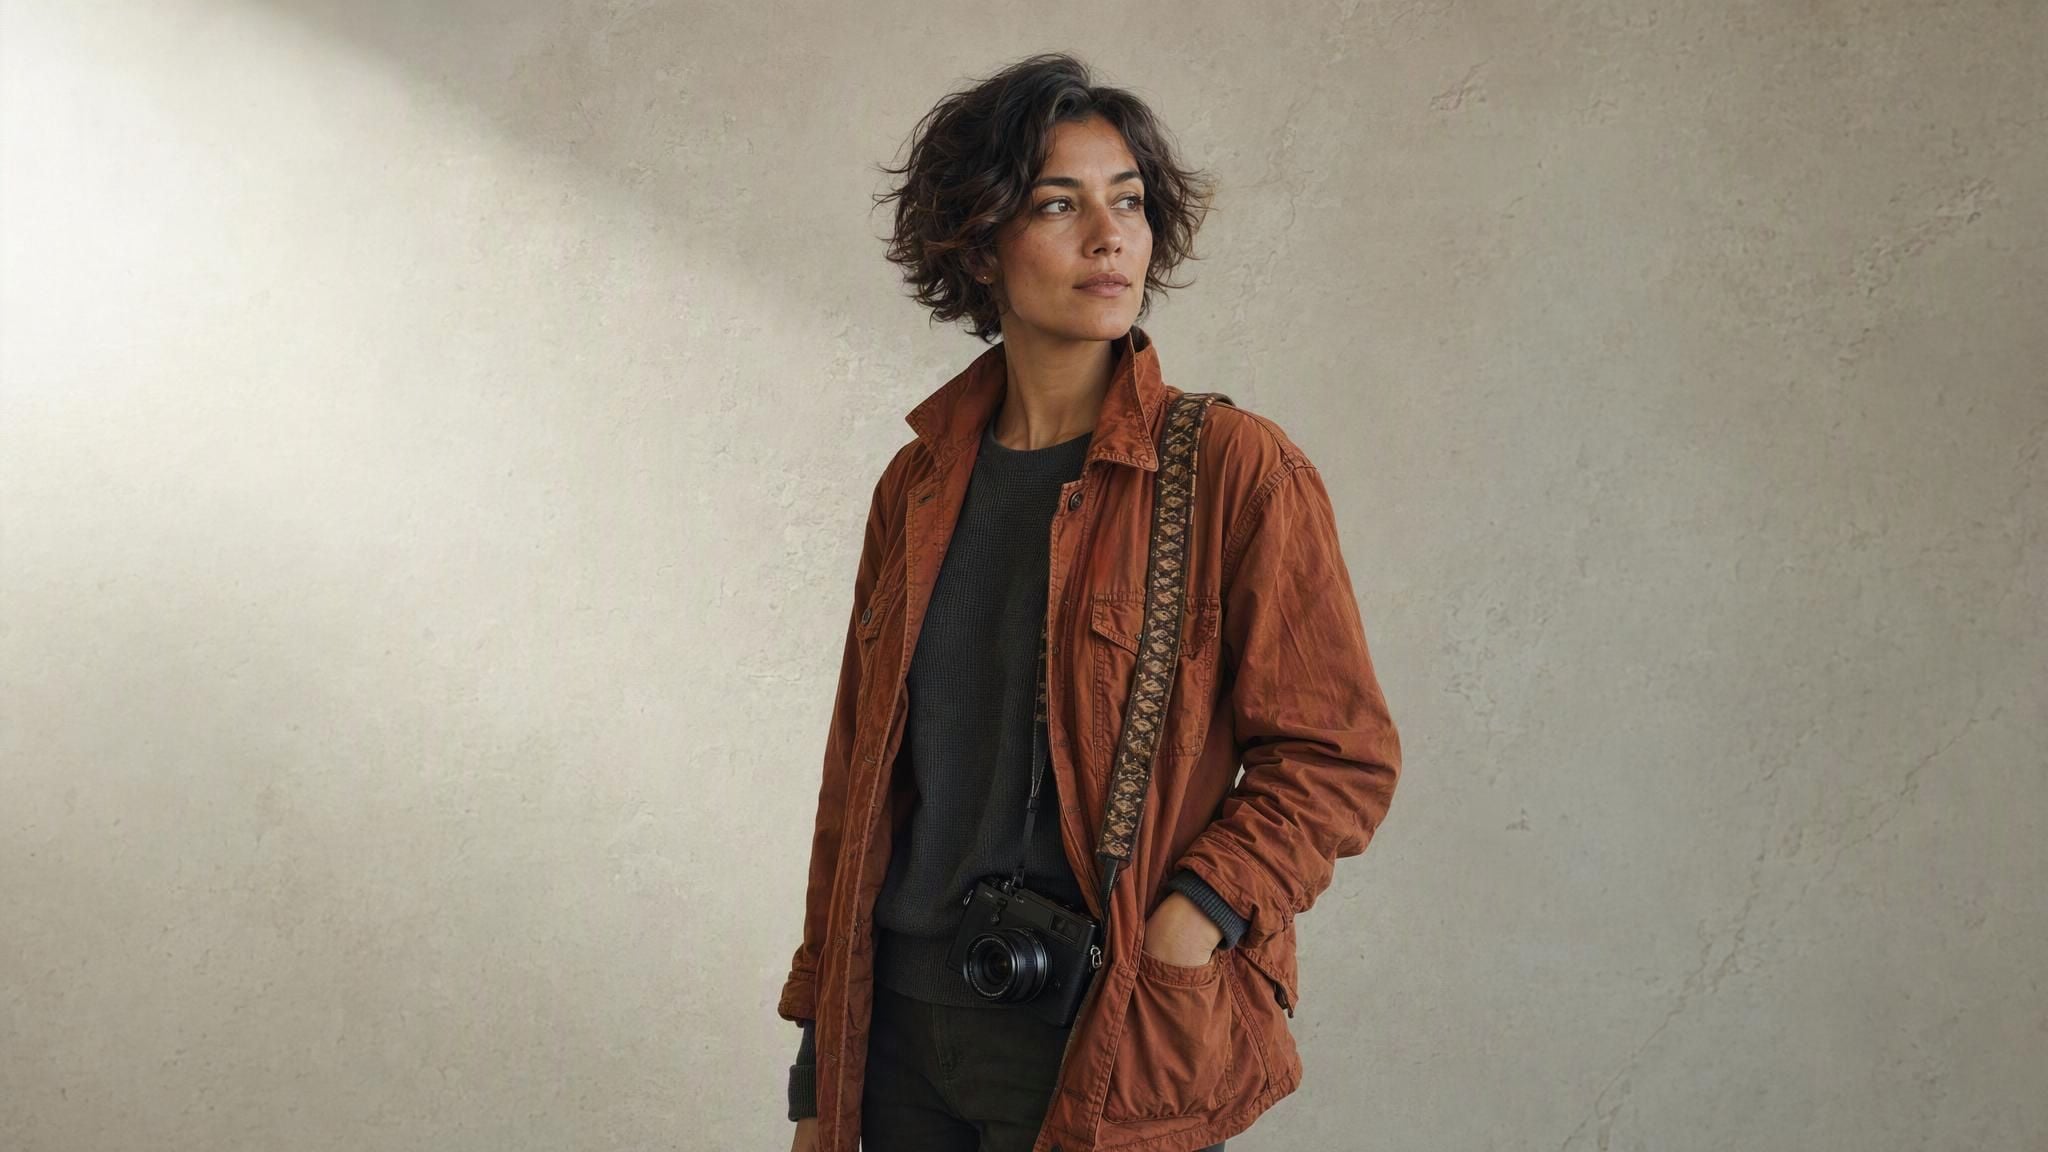
Genera l'immagine master separatamente. È l'ancora identitaria per ogni scena successiva, quindi merita una breve revisione prima che inizi qualsiasi batch. Nel playground GPT Image 2, seleziona qualità High e 16:9, poi usa questo prompt:
plaintext1Editorial portrait of Maya, a fictional adult travel photographer in her early thirties, with short wavy dark-brown hair, warm olive complexion, a weathered rust-orange field jacket over a charcoal knit top, and a compact black camera on a woven shoulder strap. She stands three-quarter length against a softly lit pale-stone studio backdrop, facing slightly right with a calm, observant expression. Soft window light from the upper left, realistic subtle shadow, no logo, no text, no other people, no duplicated hands or camera. Clean cinematic campaign composition with negative space on both sides.
Mantieni un'immagine che mostri chiaramente il viso di Maya, i capelli, la giacca, la tracolla della macchina fotografica e un paio completo di mani, senza testo o persona duplicata. Salvala come maya-master-001.png, calcola un hash di riferimento e allega la stessa origine ai job figli a valle. Non mettere in batch questo passaggio. Un riferimento master debole moltiplica l'ambiguità in ogni scena.
Demo della funzionalità per API AI per la generazione in batch: il prompt del riferimento del personaggio di Maya accanto al ritratto generato della fotografa di viaggio
Un'esecuzione reale del riferimento master con GPT Image 2: il prompt stabilisce la fotografa fittizia la cui identità i successivi job di scena devono preservare.
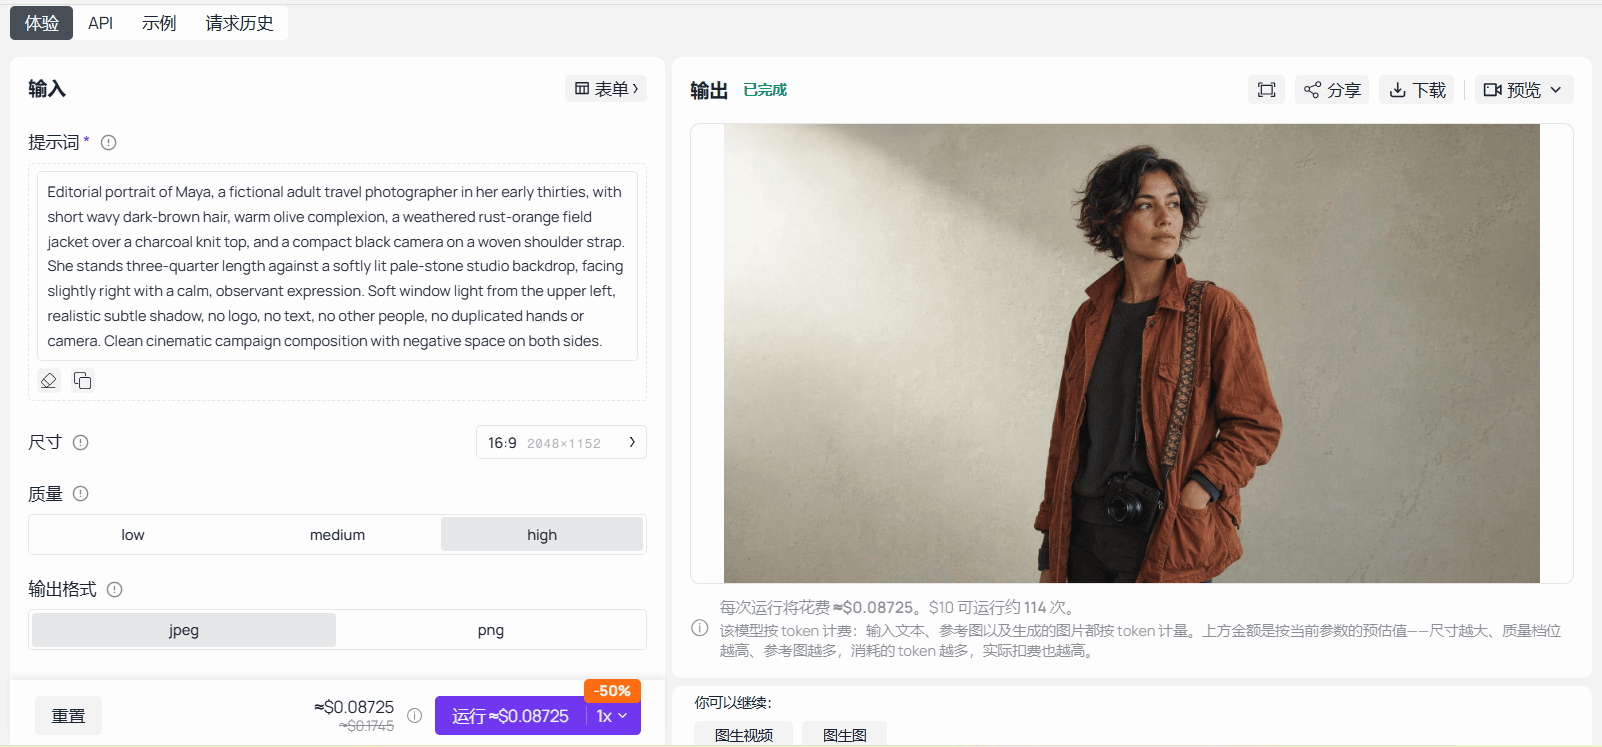
Playground GPT Image 2 completato con qualità High, un'impostazione 16:9 e il ritratto master di Maya
GPT Image 2 su Atlas Cloud con il prompt del riferimento del personaggio dell'articolo e il risultato completato nel pannello di output.
Passaggio 2: esegui il Batch A come 4 scene collegate del personaggio
Carica maya-master-001.png su Seedream v4.7 Sequential. Mantieni costanti il riferimento, il modello del prompt e il rapporto 16:9. Usa questo prompt:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya on a sunlit granite ridgeline, consulting a folded topographic map at sunrise, distant cloud-filled valley below. 4Image 2: Maya walking through a small mountain market, photographing bright woven textiles, soft morning activity behind her. 5Image 3: Maya at a timber cabin table, arranging printed contact sheets and a notebook beside a rain-speckled window. 6Image 4: Maya kneeling by a clear alpine lake, taking field notes while her camera rests on a rock, late-afternoon light. 7 8Keep the composition editorial and realistic. Leave clean negative space on the left third for possible marketing copy, but do not render any text.
Usa la modalità sequenziale o batch coerente che la pagina live effettivamente espone. Accetta solo output che possono essere mappati senza ambiguità da maya-ridgeline-001 a maya-lake-001. Se il playground restituisce un output per richiesta invece di 4 asset figli separati, invia lo stesso modello bloccato come 4 job figli. Preserva lo stesso hash di riferimento e gli stessi parametri invece di fingere che l'interfaccia abbia restituito una funzionalità che non ha.
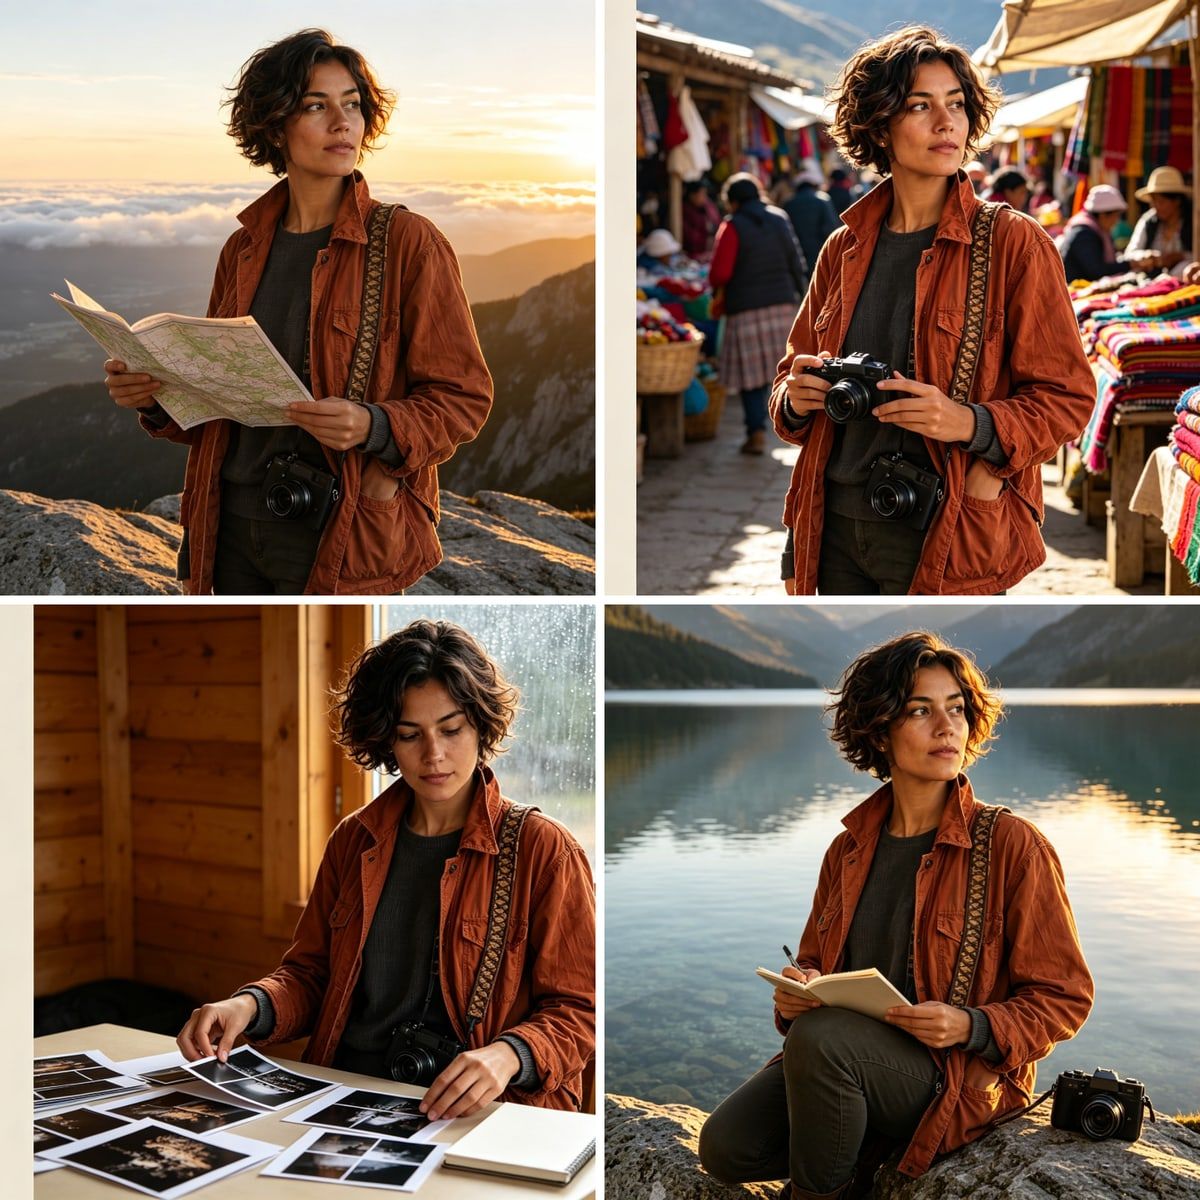
Quattro output reali di scene Maya di Seedream v4.7 Sequential in una griglia, mappati agli ID asset ridgeline, market, cabin e lake
La griglia di output Batch A con 4 scene: ogni fotogramma resta un record asset separato anche quando il modello produce una sequenza coerente.
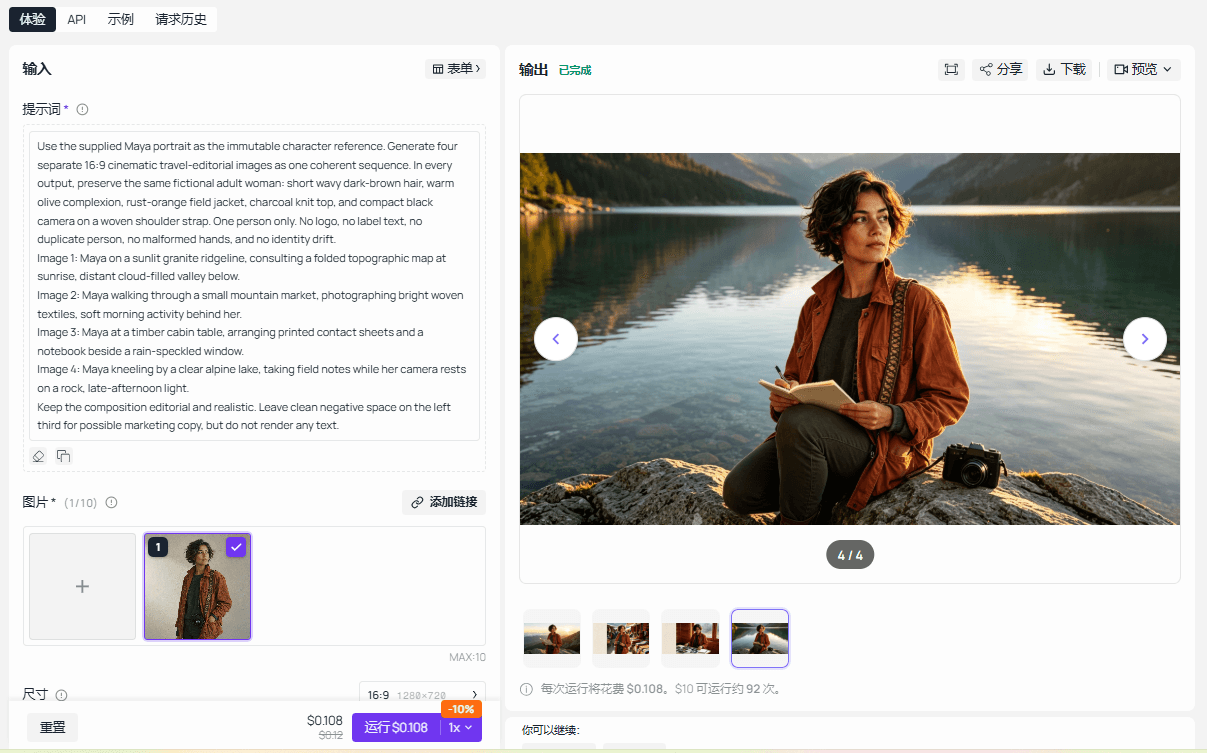
Playground Seedream v4.7 Sequential completato con il prompt collegato della scena di Maya e il suo output reale
Seedream v4.7 Sequential su Atlas Cloud con il prompt collegato della scena del personaggio dell'articolo e un risultato completato.
Passaggio 3: esegui il Batch B, poi fermati per il controllo qualità
Riutilizza il riferimento master approvato. Non ricrearlo e non riscrivere le regole di identità. Invia le 4 scene successive con una nuova etichetta di batch e gli stessi controlli di accettazione:
plaintext1Use the supplied Maya portrait as the immutable character reference. Generate four separate 16:9 cinematic travel-editorial images as one coherent sequence. In every output, preserve the same fictional adult woman: short wavy dark-brown hair, warm olive complexion, rust-orange field jacket, charcoal knit top, and compact black camera on a woven shoulder strap. One person only. No logo, no label text, no duplicate person, no malformed hands, and no identity drift. 2 3Image 1: Maya moving through a mossy cedar forest on a narrow trail, camera raised toward a shaft of morning light. 4Image 2: Maya seated at a train-window table, reviewing contact sheets as a sunlit landscape blurs outside. 5Image 3: Maya at a weathered cabin workbench, packing film canisters, a lens cloth, and a folded paper map before departure. 6Image 4: close three-quarter portrait of Maya outdoors in light mist, camera strap visible, shallow depth of field, no text. 7 8Keep the same visual color treatment as the first sequence. Leave clean negative space on the left third where the composition permits, but do not render any text.
Dopo il Batch B, fermati. Rivedi tutti gli 8 record di scena prima di rilasciare un'altra sequenza di campagna. Questa pausa intercetta i tipi di deriva che le code nascondono: capelli o guardaroba che cambiano, una seconda persona che appare, scritte non richieste, mani malformate o una scena che non serve più al suo canale. Salva la decisione del revisore accanto all'asset invece che in un messaggio di chat non tracciato.
Passaggio 4: applica una decisione di pubblicazione, nuovo tentativo o rifiuto
Contrassegna un'immagine come approved quando contiene una sola Maya, corrisponde al riferimento master per viso, capelli, guardaroba e macchina fotografica, non contiene testo rotto o anatomia malformata e si adatta alla scena assegnata. Contrassegnala come retry quando Maya si duplica, si discosta, perde un oggetto necessario o mostra mani o scritte malformate. Contrassegnala come rejected quando la composizione non può servire il canale previsto o il personaggio non è più riconoscibile.
Per un nuovo tentativo, mantieni maya-train-001 come asset aziendale e crea il tentativo maya-train-001-a2. Invia solo quel job figlio con la specifica della chiave di idempotenza originale regolata solo se il prompt viene deliberatamente versionato. Non rieseguire gli altri 7 asset solo perché una scena necessita di riparazione.
Scegliere i modelli per la generazione in batch
Scegli un modello in base all'unità di lavoro, non a una classifica. Un riferimento master pulito e una sequenza coerente di scene sono lavori diversi. La modifica di una singola immagine fallita è ancora diversa. Se un team vuole testare quelle fasi attraverso un'unica integrazione compatibile con OpenAI, Atlas Cloud fornisce un luogo naturale per validare le due pagine di modelli utilizzate in questo esempio.
| Job | Modello e metodo di lavoro | Contesto di prezzo da verificare prima di accodare |
|---|---|---|
| Crea un master pulito del personaggio | GPT Image 2, un'esecuzione High quality 16:9 che diventa l'ancora di riferimento | GPT Image 2 Developer text-to-image è listato a partire da circa $0,004 per immagine rispetto a $0,009 standard, uno sconto mostrato del 50% a settembre 2026 |
| Costruisci un set coerente di scene | Seedream v4.7 Sequential, stesso riferimento e schema del prompt bloccato tra i job figli | Il catalogo attuale elenca $0,03 per immagine; verifica la modalità di output live e il prezzo prima della produzione |
| Ripara un asset fallito | GPT Image 2 modalità edit, limitata all'asset che ha fallito la revisione | Conferma l'endpoint di edit, la dimensione di output, la qualità e il prezzo attuale prima di impegnarti |
I prezzi cambiano per modello, modalità e impostazioni selezionate. Usa il catalogo dei modelli Atlas Cloud per ricontrollare disponibilità, sconti e la modalità esatta il giorno in cui accodi il lavoro. Tratta la tabella come un input di stima, mai come un'affermazione promozionale o una garanzia di costo.
Controllo qualità, costi e diritti prima di scalare
Il completamento della generazione ha 3 significati separati: il provider segnala il successo, il file è stato archiviato correttamente e un revisore umano lo accetta per la pubblicazione. Rendi tutti e 3 visibili nei tuoi record. Un'attività completata con un file di output mancante è un fallimento operativo. Un file salvato con un personaggio duplicato è un fallimento creativo. Nessuno dei due dovrebbe avanzare automaticamente alla pubblicazione.
Usa una checklist del revisore abbastanza semplice da applicare a ogni asset figlio:
| Controllo | Domanda del revisore |
|---|---|
| Identità del personaggio | Maya corrisponde al riferimento master approvato per viso, capelli, guardaroba e macchina fotografica? |
| Conteggio oggetti | C'è esattamente il numero atteso di oggetti chiave? |
| Corrispondenza del prompt | La scena soddisfa il caso d'uso assegnato? |
| Artefatti di testo | C'è testo indesiderato, malformato o non supportato? |
| Rapporto e nome file | Il file salvato corrisponde al record del manifest? |
| Revisione dei diritti | Il riferimento e le affermazioni previste sono consentiti per questo uso? |
Stima il costo dopo l'esecuzione con costo dell'asset approvato = costo totale dei tentativi completati / asset approvati. Questo espone il costo dei nuovi tentativi e dei risultati rifiutati senza fingere che ogni immagine abbia lo stesso costo finale. Imposta un limite di attività, un limite di batch e un limite giornaliero prima di iniziare. Metti in pausa l'invio se uno qualsiasi di quei limiti viene raggiunto.
Usa solo immagini di riferimento possedute, concesse in licenza o altrimenti consentite. Controlla le politiche attuali della piattaforma e i termini del modello prima dell'uso commerciale. Non chiedere al modello di inventare certificazioni, risultati di laboratorio, promesse di sicurezza, affermazioni mediche o specifiche di prodotto non verificate. Un output rifinito non trasforma un'affermazione non supportata in una pubblicabile.
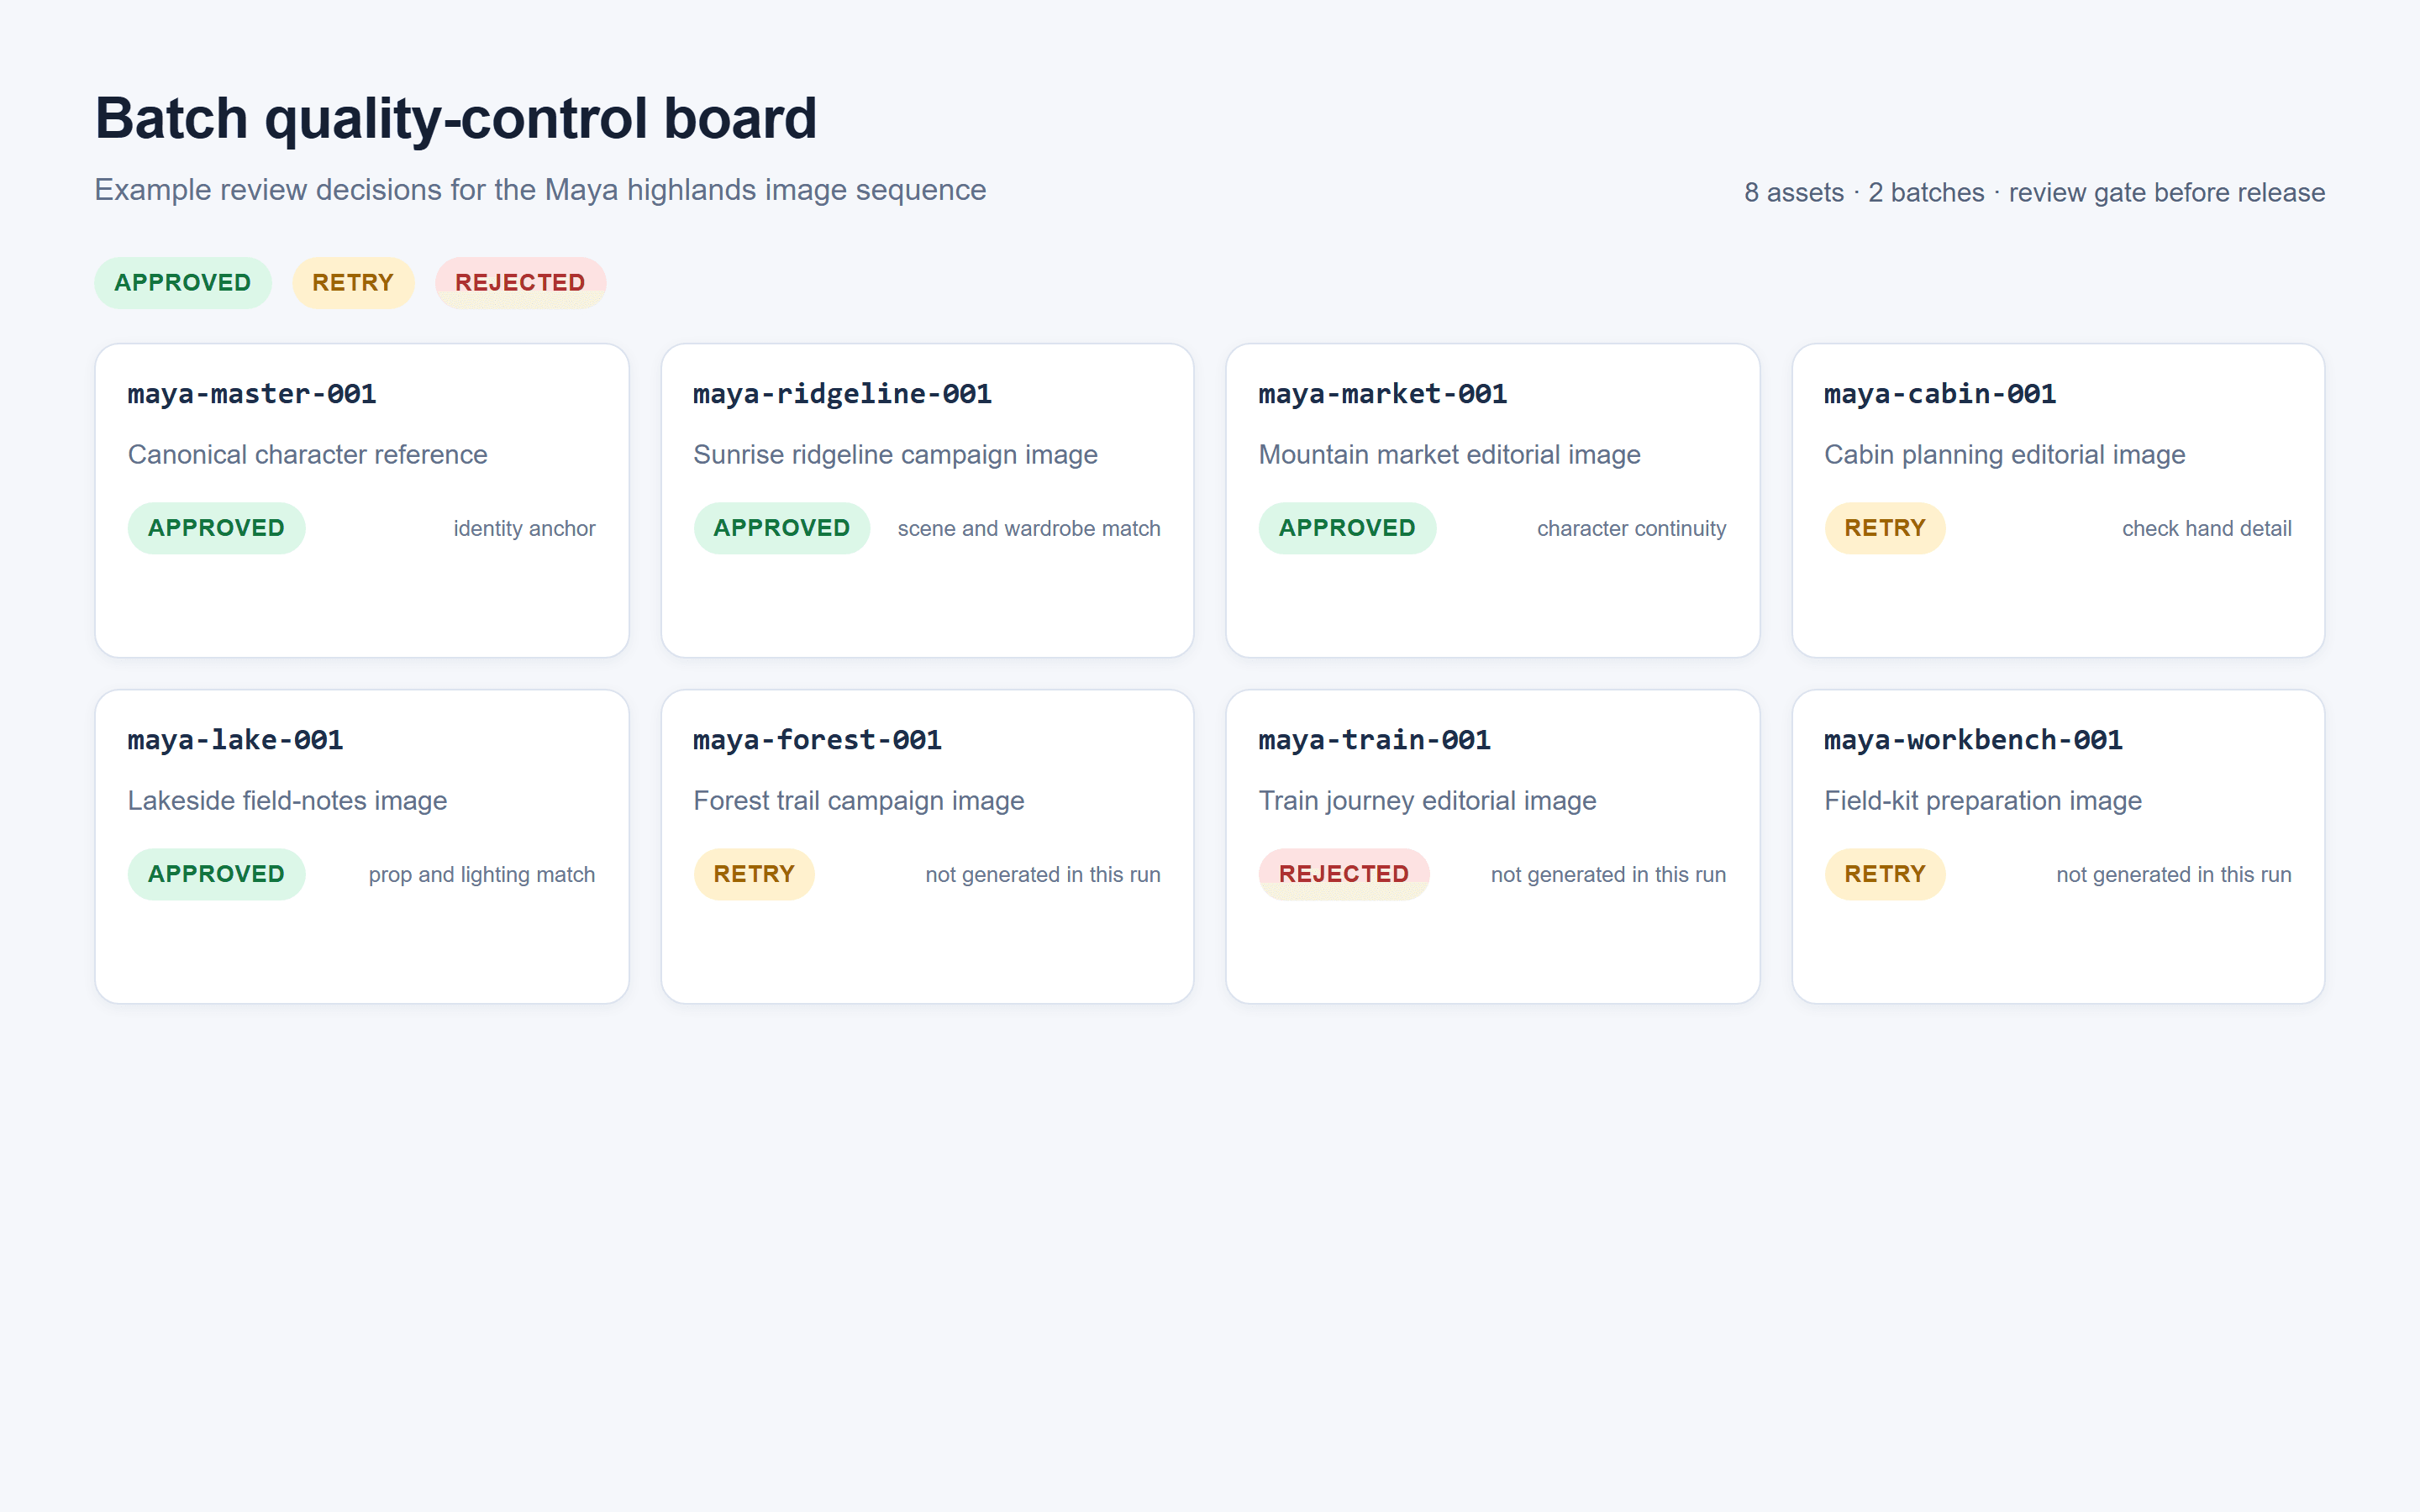
Pannello di controllo qualità batch renderizzato nel browser che mostra 8 ID asset di Maya con stati di revisione approvato, nuovo tentativo e rifiutato
Un pannello di revisione renderizzato nel browser mappa i file di esecuzione reali ai loro 8 ID asset e rende visibile la decisione di pubblicare, ritentare o rifiutare.
API AI per la generazione in batch: checklist di lancio in produzione
Prima di passare dall'esercizio di 8 asset a un catalogo live o a una libreria di contenuti, conferma ogni elemento seguente.
- Ogni asset ha un
asset_idimmutabile. - Il prompt, l'hash di riferimento, il modello, il rapporto e la qualità sono registrati.
- Ogni invio ha una chiave di idempotenza dove il provider la supporta.
- La concorrenza rimane al di sotto del limite effettivo documentato dell'account.
- Esistono limiti di budget per attività, batch e giornalieri.
- Le risposte 429, le risposte 5xx, i timeout e i rifiuti di contenuto seguono regole diverse.
- I nuovi tentativi hanno un massimo rigido.
- I risultati riusciti vengono archiviati e mappati alla fonte immediatamente.
- Un controllo QC a piccoli batch viene superato prima di rilasciare il gruppo successivo.
- Una revisione finale del campione controlla identità del personaggio, testo, rapporto, nomi dei file e diritti.
Questa checklist mantiene utile un'API AI per la generazione in batch quando il volume cresce. Lascia anche una chiara traccia di audit quando un redattore chiede perché una particolare immagine è stata generata, accettata o rieseguita.
FAQ: API AI per la generazione in batch
Cos'è un'API AI per la generazione in batch?
È un modo per inviare molte attività AI indipendenti, tracciarne l'esecuzione e raccogliere i risultati in seguito. Una buona implementazione mantiene un ID asset aziendale durevole per ogni attività, indipendentemente dal fatto che il provider utilizzi un job batch asincrono o normali richieste concorrenti.
Un'API batch è migliore dell'invio di richieste di immagini in parallelo?
Nessuna delle due è automaticamente migliore. Usa richieste parallele controllate quando il flusso di lavoro necessita di progresso immediato. Usa un job batch del provider per volumi non urgenti quando le sue regole documentate su coda, tempi di consegna e costi si adattano al tuo lavoro. Entrambe necessitano di log per asset e revisione.
Quante immagini AI dovrei mettere in un batch?
Inizia con 4-8 asset visivi quando stai convalidando un nuovo schema di prompt o un riferimento di personaggio. Aumenta solo dopo che il team è in grado di mappare ogni risultato, individuare rapidamente la deriva e recuperare un job figlio fallito senza riavviare il gruppo. I limiti del provider possono consentire molto di più, ma un batch operativamente utile è uno revisionabile.
In che modo le chiavi di idempotenza prevengono i costi di generazione duplicati?
Identificano un invio come la stessa operazione prevista dopo un nuovo tentativo. Se l'endpoint supporta l'idempotenza, il provider può evitare di trattare una chiamata di rete ripetuta come una generazione completamente nuova. Salva la chiave con il record dell'asset e conferma la semantica esatta nella documentazione del provider.
Posso generare immagini in batch dallo stesso riferimento di personaggio?
Sì. Usa un'immagine di riferimento approvata e consentita; allega il suo hash a ogni job figlio; blocca le istruzioni di identità; e rivedi un piccolo gruppo di scene prima dell'espansione. La coerenza del riferimento riduce l'ambiguità, ma non sostituisce il QC visivo.
Dovrei ritentare un intero batch fallito o solo gli asset falliti?
Ritenta solo gli asset falliti. Archivia prima i successi, classifica il fallimento e crea un nuovo record di tentativo per il job figlio interessato. Il reinvio dell'intero batch rende più probabili asset duplicati e spese inutili.


