DeepSeek Harness non faceva parte di quel benchmark. È stato rilasciato due giorni dopo. Ciò significa che la domanda utile non è "chi ha vinto?". La domanda utile è come eseguire lo stesso compito con entrambi gli strumenti, sullo stesso modello, e leggere il conto senza ingannarsi.
Punti chiave
- La scelta dell'harness può far variare l'utilizzo dei token di circa 7x in compiti agentici comparabili.
- Misura DeepSeek Harness e OpenCode con lo stesso modello e lo stesso stato del repository.
- Usa chiavi API separate prima di sceglierne una per il lavoro quotidiano.
Due laptop che eseguono lo stesso compito di codifica con due harness agentici
L'impostazione equa: un modello, un compito, due terminali.
Cosa ci dice il benchmark pubblico
Composio ha eseguito 30 flussi di lavoro multi-app complessi attraverso 8 harness agentici, tutti usando DeepSeek V4 Flash, un limite di 900 secondi per compito e valutazione binaria programmatica su 240 esecuzioni (Composio, agosto 2026). Stesso modello, harness diverso.
| Harness | Tasso di successo | Tempo mediano | Token medi per compito |
|---|---|---|---|
| Pi Agent | 66.7% | 132.2s | 559.000 |
| Prime Agent | 62.5% | 242.1s | 1.400.000 |
| OMP | 56.7% | 272.4s | 742.000 |
| Claude Code | 53.3% | 122.7s | 742.000 |
| Codex | 53.3% | 245.0s | 678.000 |
| DeepAgents | 53.3% | 187.1s | 665.000 |
| Hermes Agent | 50.0% | 175.5s | 192.000 |
| OpenCode | 46.7% | 129.7s | 692.000 |
La colonna dei token conta più della classifica. La variazione va da 192.000 a 1.400.000 token medi per compito. Questo è lo stesso modello che svolge un lavoro comparabile attraverso runtime diversi.
OpenCode ci fornisce una base di riferimento: 692.000 token per compito, tasso di successo del 46.7% e tempo mediano di 129.7 secondi. DeepSeek Harness non ha un numero testa a testa pubblico da questo benchmark perché DeepSeek lo ha rilasciato il 13 agosto 2026, due giorni dopo la pubblicazione del benchmark.
Usa la tabella come avvertimento, non come verdetto. Mostra che l'harness può dominare i costi. Non prova se DeepSeek Harness batte OpenCode sul tuo repository.
Cosa cambia quando si cambia harness
Prima di testare, confronta i due strumenti in base agli aspetti che influenzano uno sviluppatore attivo: superficie di configurazione, maturità, visibilità dei token e quanto del ciclo agente puoi sostituire.
| DeepSeek Harness (dsh) | OpenCode | |
|---|---|---|
| Da | DeepSeek AI | Anomaly (originariamente SST) |
| Rilasciato | 13 agosto 2026 | Fine 2025 |
| Stelle GitHub | ~143k | ~198k |
| Licenza | MIT | MIT |
| Linguaggio | TypeScript | Go |
| Interfaccia | Web UI su 127.0.0.1:3080 | Terminale TUI |
| Stato | Anteprima sviluppatore, modifiche sostanziali previste | Maturo, ampiamente distribuito |
| Architettura | Plugin sostituibili per modelli, strumenti, sessioni, sandbox, archiviazione, cicli e UI | Nucleo fisso con agenti di build/pianificazione, supporto MCP ed estensioni LSP |
| Configurazione | $DSH_HOME/settings.yaml | opencode.json |
| Contabilizzazione token | Meter dei token con pressione di contesto e proiezioni di dettaglio | Tracciamento dei token e dei costi per sessione nella TUI |
| Ideale per | Team che vogliono modificare il ciclo agente stesso | Team che vogliono un agente di codifica che funzioni oggi |
OpenCode ti offre un agente di codifica stabile con punti di estensione ai bordi. DeepSeek Harness ti offre un runtime in cui il ciclo stesso può essere scambiato. Questa flessibilità aiuta se stai costruendo infrastruttura agente. Aggiunge rischio se hai bisogno di uno strumento predefinito per codice di produzione questa settimana.
Entrambi gli strumenti possono raggiungere lo stesso endpoint compatibile con OpenAI. Questo rende possibile un test equo: un modello, un URL base, un compito e uno stato di partenza del repository.
Per questa guida, DeepSeek V4 Flash viene eseguito tramite Atlas Cloud, che espone un endpoint compatibile con OpenAI accettato da entrambi gli strumenti. La scheda deepseek-v4-flash-0731 mostra $0.14 per milione di token in input, $0.28 per milione di token in output, una finestra di contesto di 1.048.576 token e un output massimo di 393.216 ad agosto 2026. Qualsiasi provider funziona se entrambi gli harness usano lo stesso endpoint e lo stesso ID modello.
OpenCode pubblica anche dati aggregati sull'utilizzo. I modelli DeepSeek hanno mosso 233 trilioni di token attraverso OpenCode, con V4 Flash che rappresenta l'85.5% e V4 Pro il 14.5% (OpenCode, agosto 2026). Questo schema di utilizzo rende V4 Flash un predefinito pratico per il confronto.
Passo 1: Puntare entrambi gli strumenti allo stesso modello
Crea una chiave API e un URL base, poi fornisci a entrambi gli strumenti la stessa coppia. Crea la chiave nella console di Atlas Cloud ed esportala una volta:
plaintext1export ATLAS_API_KEY="tua-chiave-api" 2
Controlla l'endpoint prima di passarlo a qualsiasi harness:
plaintext1curl https://api.atlascloud.ai/v1/chat/completions \ 2 -H "Authorization: Bearer $ATLAS_API_KEY" \ 3 -H "Content-Type: application/json" \ 4 -d '{ 5 "model": "deepseek-ai/deepseek-v4-flash-0731", 6 "messages": [{"role": "user", "content": "Rispondi con una singola parola: pronto"}] 7 }' 8
Quella chiamata dimostra che il percorso, la chiave e l'ID del modello funzionano prima che un harness aggiunga strumenti, tentativi o replay della conversazione.
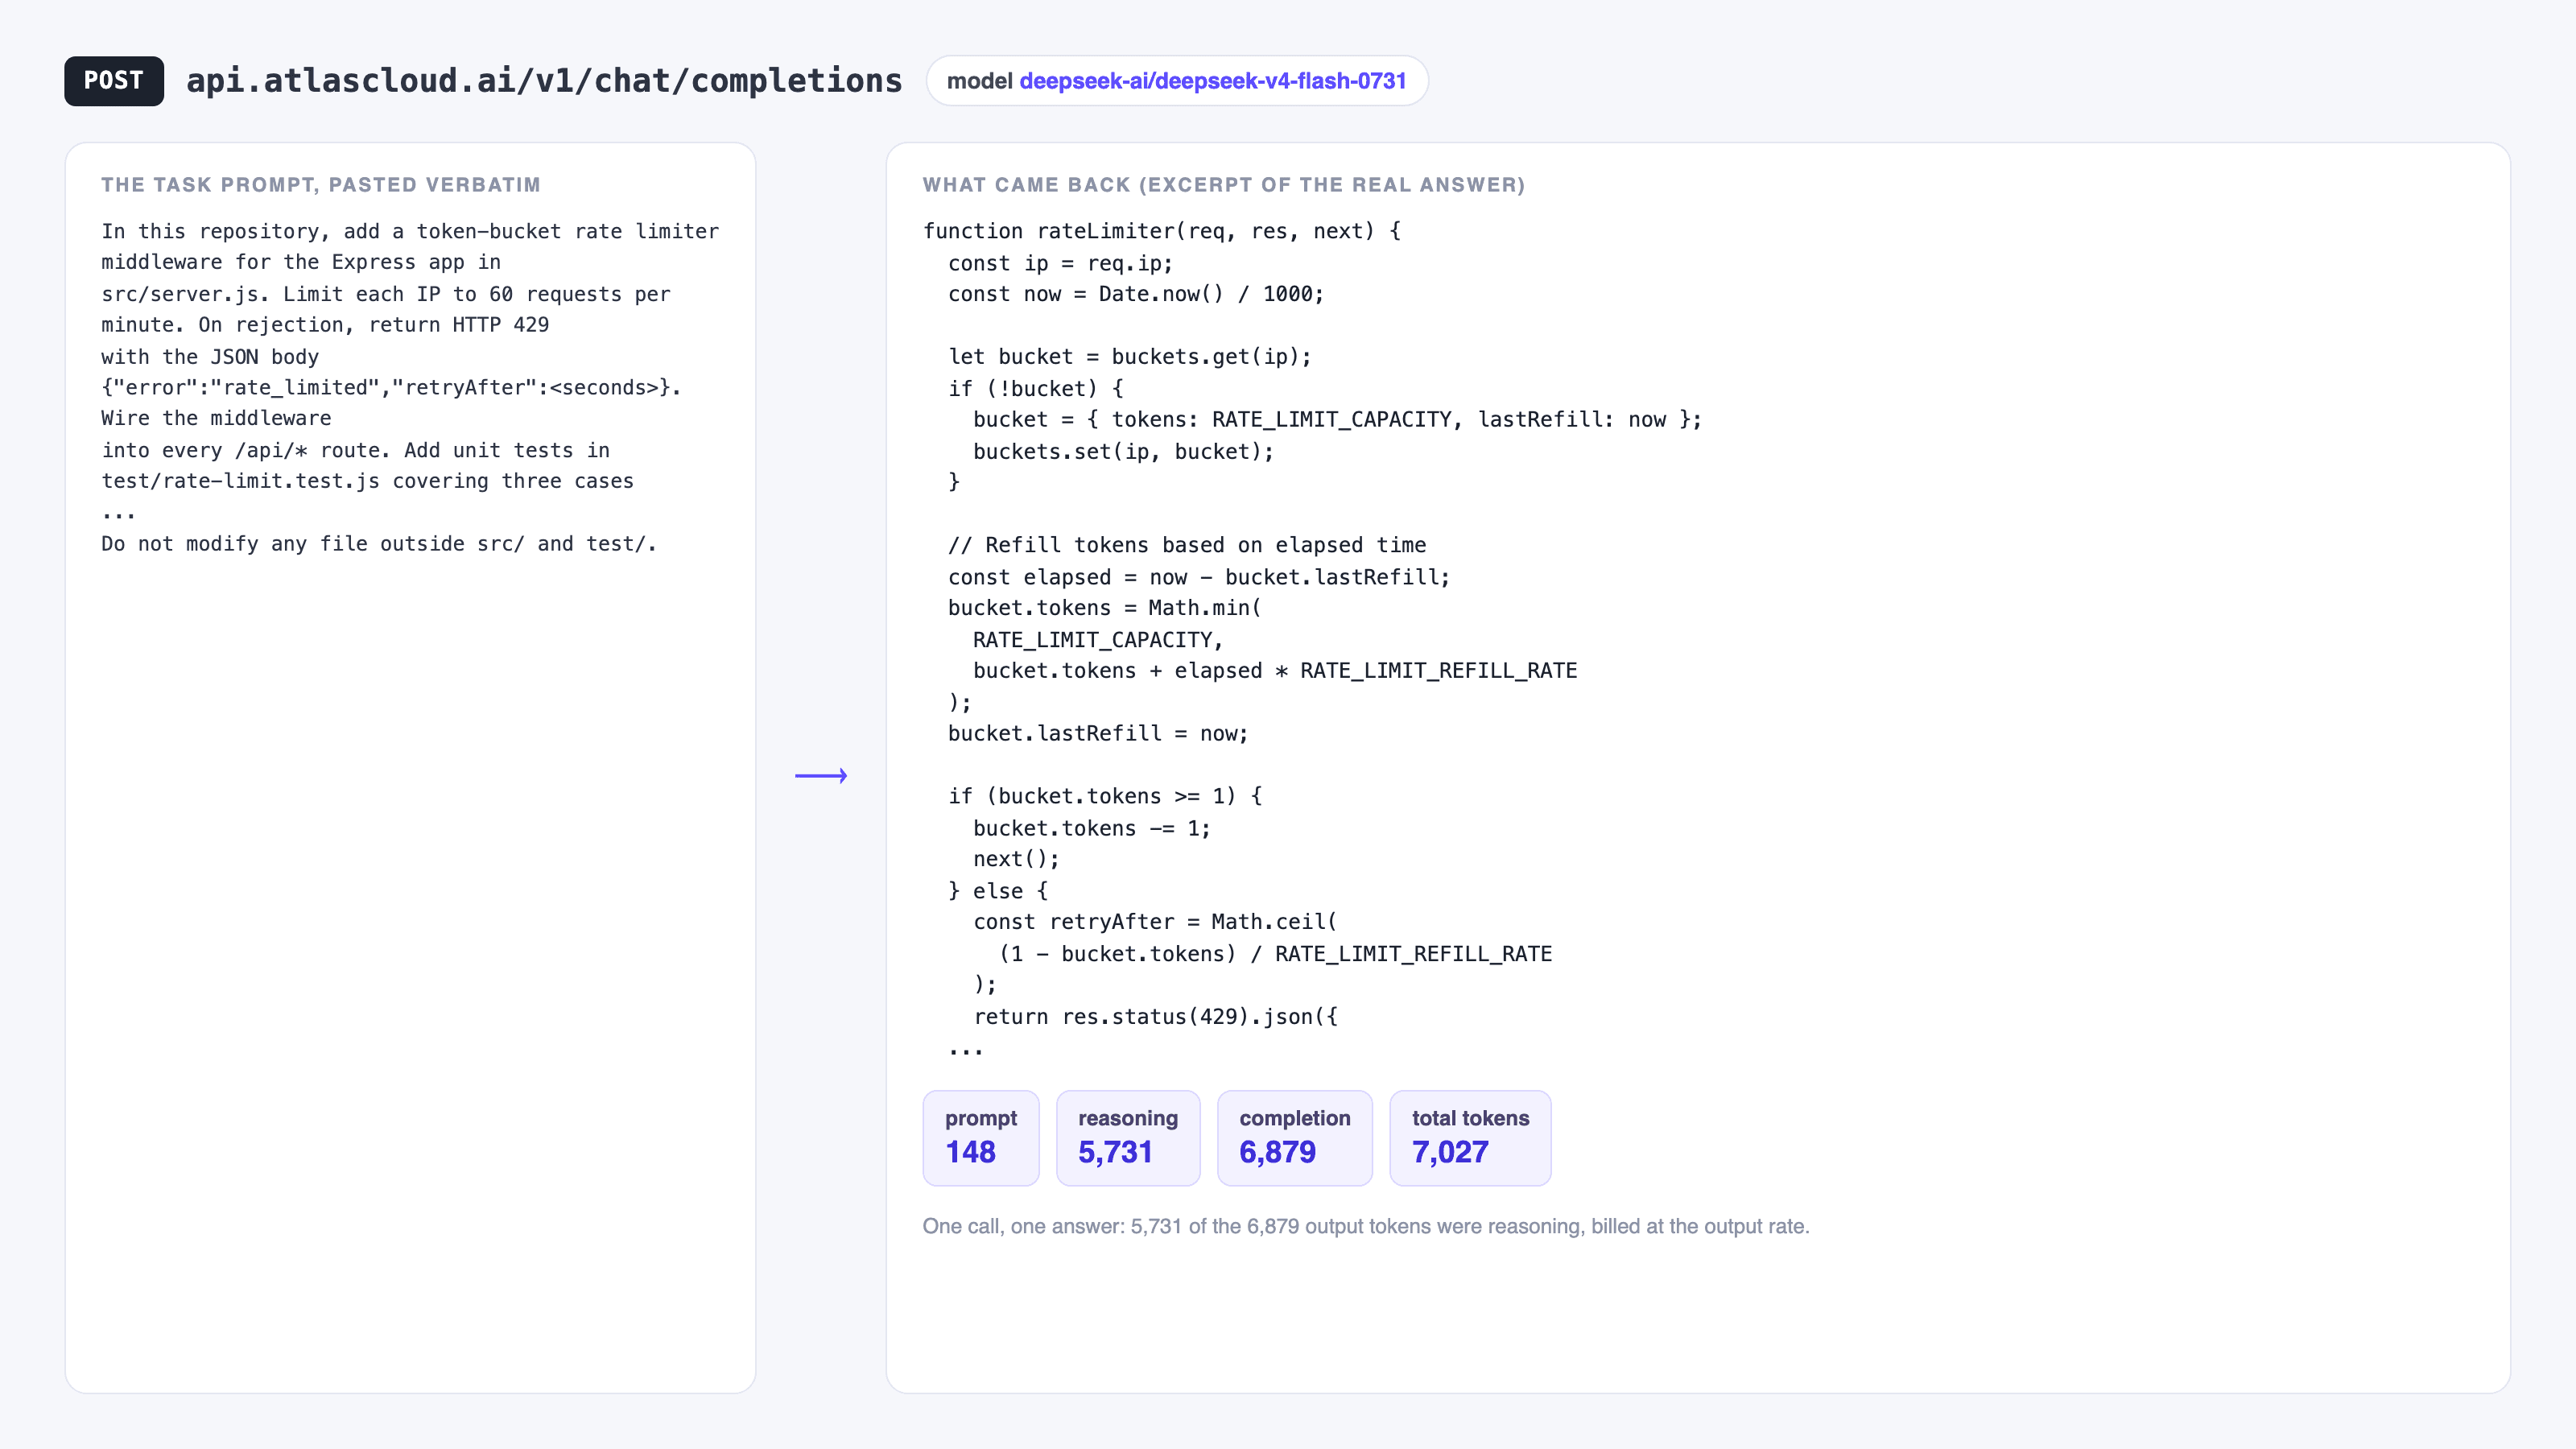
Prompt di codifica, codice generato e statistiche dei token da una chiamata al modello
Una chiamata diretta a `deepseek-ai/deepseek-v4-flash-0731`: 148 token in input, 6.879 token in output, inclusi 5.731 token di ragionamento. Consideralo come il minimo prima che un harness aggiunga schemi di strumenti e cronologia.
DeepSeek Harness legge $DSH_HOME/settings.yaml, e i provider personalizzati compatibili con OpenAI vanno sotto il plugin llm-pi-ai (documentazione DeepSeek Harness, agosto 2026):
plaintext1llm-pi-ai: 2 providers: 3 atlas: 4 apiKeyEnv: ATLAS_API_KEY 5 api: openai-completions 6 baseURL: https://api.atlascloud.ai/v1 7 models: 8 - id: deepseek-ai/deepseek-v4-flash-0731 9
Usa openai-completions per questo endpoint. L'interfaccia web può scrivere lo stesso blocco provider da Impostazioni, Modelli, Aggiungi provider personalizzato, quindi salvare la chiave in $DSH_HOME/.credentials.yaml.
OpenCode legge opencode.json nella root del tuo progetto o nella directory di configurazione globale (documentazione OpenCode, agosto 2026):
plaintext1{ 2 "$schema": "https://opencode.ai/config.json", 3 "provider": { 4 "atlas": { 5 "npm": "@ai-sdk/openai-compatible", 6 "name": "Atlas Cloud", 7 "options": { 8 "baseURL": "https://api.atlascloud.ai/v1", 9 "apiKey": "{env:ATLAS_API_KEY}" 10 }, 11 "models": { 12 "deepseek-ai/deepseek-v4-flash-0731": { 13 "name": "DeepSeek V4 Flash 0731", 14 "limit": { "context": 1048576, "output": 393216 } 15 } 16 } 17 } 18 }, 19 "model": "atlas/deepseek-ai/deepseek-v4-flash-0731" 20} 21
Usa @ai-sdk/openai-compatible, perché questo endpoint serve /v1/chat/completions. Imposta i limiti reali di contesto e output. OpenCode li usa quando decide quando riassumere, e limiti errati possono distorcere il confronto dei token.
Passo 2: Eseguire lo stesso compito di benchmark in DeepSeek Harness
Scegli un compito abbastanza grande da richiedere diverse chiamate a strumenti e abbastanza piccolo da poter essere valutato. Usa lo stesso stato del repository per entrambe le esecuzioni, quindi esegui commit o stash prima di iniziare.
Incolla questo compito esatto in entrambi gli strumenti:
plaintext1In questo repository, aggiungi un middleware di limitazione della velocità a secchiello di token per l'app Express in src/server.js. Limita ogni IP a 60 richieste al minuto. Al rifiuto, restituisci HTTP 429 con il corpo JSON {"error":"rate_limited","retryAfter":<secondi>}. Collega il middleware a ogni route /api/*. Aggiungi test unitari in test/rate-limit.test.js che coprano tre casi: una richiesta sotto il limite è consentita, una richiesta oltre il limite viene bloccata con 429, e il contatore si azzera dopo la scadenza della finestra. Esegui la suite di test e correggi gli errori fino al superamento. Non modificare alcun file al di fuori di src/ e test/. 2
Avvia Harness dalla directory del tuo progetto:
plaintext1cd /path/to/tuo/repo 2npx @deepseek-ai/dsh web 3
L'interfaccia viene eseguita su http://127.0.0.1:3080. Seleziona il provider atlas e il modello deepseek-ai/deepseek-v4-flash-0731, incolla il compito e lascialo terminare. Non aggiungere suggerimenti dopo l'avvio dell'esecuzione. Un aiuto extra per uno strumento invalida il confronto.
Quando Harness termina, apri la vista Traiettoria. Quel record di sessione è dove si trovano i suoi numeri di token.
Passo 3: Ripetere l'esecuzione in OpenCode
Ripristina il repository allo stato iniziale esatto. Il secondo harness non deve ereditare file che il primo ha già modificato.
plaintext1git checkout -- . && git clean -fd 2
Poi esegui OpenCode con lo stesso modello:
plaintext1opencode --model atlas/deepseek-ai/deepseek-v4-flash-0731 2
Incolla lo stesso prompt del compito del Passo 2. Usa l'agente build predefinito. Lascialo terminare senza suggerimenti.
Valuta entrambe le esecuzioni con lo stesso comando:
plaintext1npm test 2
Un'esecuzione che lascia la suite in rosso fallisce, anche se il riepilogo dell'agente sembra sicuro. Usa la valutazione binaria: superato o fallito.
Passo 4: Leggere l'utilizzo dei token
Entrambi gli strumenti tracciano l'utilizzo, ma nessun contatore dovrebbe essere il tuo numero finale di fattura.
DeepSeek Harness include un meter dei token montato di default. Espone tokenUsage, contextPressure e contextBreakdown nella vista Traiettoria. contextBreakdown ti dice se il conto proviene dal prompt di sistema, dagli schemi degli strumenti, dalle letture dei file o dal replay della conversazione. Il meter stima circa un token ogni quattro caratteri, quindi usalo come vista diagnostica.
OpenCode traccia i token e il costo per sessione e li stampa nella riga di stato della TUI. La sua ripartizione integrata è più piccola, quindi i team che necessitano di attribuzione per strumento spesso ispezionano il database delle sessioni con analizzatori esterni.
Usa i numeri dal lato provider per il confronto:
| Cosa confrontare | Dove ottenerlo |
|---|---|
| Token totali in input | Dashboard di utilizzo del provider, per chiave API |
| Token totali in output | Dashboard di utilizzo del provider, per chiave API |
| Numero di chiamate al modello | Vista traiettoria harness / log sessione OpenCode |
| Tempo reale | Cronometro, dall'inizio all'ultima scrittura file |
| Superato o fallito | Codice di uscita npm test |
Crea due chiavi API, harness-test e opencode-test, e usa ciascuna chiave per un'esecuzione. La dashboard del provider ti darà quindi un utilizzo affiancato pulito senza dover riconciliare due stimatori interni.
Perché il conto si muove
L'utilizzo dei token cambia per ragioni concrete. Queste cinque di solito contano più del prezzo del modello.
Il replay della conversazione si accumula. Gli agenti reinviano la conversazione crescente a ogni passo. Un compito di 40 passi costa più vicino alla somma di 40 prompt crescenti che a 40 prompt identici. Gli harness che riassumono presto si attestano verso l'estremità inferiore della variazione del benchmark.
I cache hit riducono il costo di input. I cache hit di DeepSeek V4 Flash costano circa $0.0028 per milione di token contro $0.14 per milione in caso di miss, circa il 98% in meno. La memorizzazione nella cache necessita di un prefisso stabile byte per byte. Se un harness mescola il testo del prompt di sistema tra le chiamate, trasforma gli hit in miss.
Gli schemi degli strumenti viaggiano insieme. Venti server MCP connessi significano venti set di schemi nel prompt, anche se il compito ne usa due. Scollega gli strumenti che non ti servono prima di eseguire il benchmark, altrimenti misuri la configurazione dei tuoi strumenti invece dell'harness.
Output di grandi dimensioni degli strumenti avvelenano il contesto. Un cat di un file di 3.000 righe o un log di test fallito verboso rimane nella conversazione per le chiamate successive. DeepSeek Harness può potare i risultati di grandi dimensioni degli strumenti prima di riassumerli. Attivalo quando il compito produce output rumorosi.
I tentativi si nascondono nel conteggio delle chiamate. Un harness che riprova un test fallito in loop spende token ogni volta. Confronta le chiamate al modello insieme ai token totali in modo da poter separare un ciclo di tentativi da un prompt costoso.
Alla tariffa di Atlas Cloud per DeepSeek V4 Flash, un compito di 692.000 token orientato all'input costa pochi centesimi. È poco per una singola esecuzione e molto per un team che esegue agenti tutto il giorno. Sfoglia il catalogo completo dei modelli se vuoi ripetere il test su un secondo modello e separare gli effetti del modello dagli effetti dell'harness.
DeepSeek Harness è ancora in anteprima per sviluppatori, e il suo README avverte di modifiche sostanziali. Mettilo a benchmark se vuoi il controllo sul ciclo agente. Standardizzalo solo se il tuo team può assorbire il cambiamento. OpenCode è la scelta più stabile per i team che hanno bisogno di uno strumento oggi.
Domande frequenti
DeepSeek Harness è migliore di OpenCode?
Non ancora per la maggior parte dei team. OpenCode è maturo, nativo per terminale, ha circa 198k stelle e un ampio catalogo di provider, e funziona oggi. DeepSeek Harness è più recente, in anteprima per sviluppatori e avverte di modifiche sostanziali. Scegli Harness se vuoi modificare gli interni dell'agente. Scegli OpenCode se vuoi un agente di codifica per il lavoro quotidiano.
DeepSeek Harness funziona solo con i modelli DeepSeek?
No. È agnostico rispetto al modello. Include provider di catalogo per DeepSeek, Anthropic, OpenAI, Bedrock, Vertex, Azure e Codex, e puoi aggiungere qualsiasi provider personalizzato che parli openai-completions, openai-responses o anthropic-messages in $DSH_HOME/settings.yaml. La configurazione del Passo 1 lo punta a un endpoint compatibile con OpenAI senza codice adattatore.
Come posso controllare l'utilizzo dei token di DeepSeek Harness?
Usa il meter dei token integrato nella vista Traiettoria. Espone tokenUsage, contextPressure e contextBreakdown. Trattalo come una stima perché usa circa un token ogni quattro caratteri. Per la precisione di fatturazione, leggi la dashboard di utilizzo del provider, idealmente con una chiave API dedicata per ogni esecuzione.
Quale harness usa meno token, DeepSeek Harness o OpenCode?
Nessun benchmark testa a testa pubblico risponde ancora a questo. Il benchmark di Composio ha misurato OpenCode a 692.000 token medi per compito, ma è stato eseguito prima che DeepSeek Harness fosse rilasciato. Esegui il test dal Passo 2 al Passo 4 sul tuo repository perché l'utilizzo dei token dipende dalle dimensioni del codebase, dalla configurazione degli strumenti e dalla forma del compito.
Posso eseguire DeepSeek Harness e OpenCode con la stessa chiave API?
Sì, per un test informale. Per una misurazione pulita, usa due chiavi separate, una per harness. La dashboard del provider attribuirà quindi ogni token all'esecuzione corretta.
Qual è la differenza tra un agente e un harness?
DeepSeek descrive un agente come Modello più Harness. Il modello ragiona. L'harness collega il modello a file, comandi shell, strumenti, sessioni, approvazioni e il ciclo che decide l'azione successiva. Cambia l'harness e lo stesso modello può spendere un numero diverso di token sullo stesso compito.


