

Un archivio di progetto di 900 pagine è facile da caricare. La domanda più difficile è se il modello riesce a indicare la clausola, il commit o il punto dati esatto di cui hai bisogno. I casi d'uso della finestra di contesto da 1M di DeepSeek V4.1 Flash hanno senso quando diverse fonti correlate devono essere considerate insieme, come una base di codice, un corpus di ricerca o anni di documenti di progetto. La finestra più ampia riduce la necessità di dividere quei materiali in anticipo, mentre i controlli delle prove determinano ancora se una risposta è affidabile.
Le applicazioni più adatte sono la revisione del codice tra file, la sintesi di ricerca, il confronto di policy, l'analisi dei feedback, le tempistiche di progetto e i lunghi record multimodali. DeepSeek elenca un contesto da 1M di token, ma tale capacità non garantisce che ogni dettaglio venga ricordato accuratamente. Controlla i limiti del modello e dell'API per il tuo percorso, poi testa il tuo materiale prima di fare affidamento sul risultato.
Punti chiave
- Usa una finestra da un milione di token quando la domanda dipende da relazioni tra molte fonti rilevanti.
- Chiedi riferimenti a file, sezioni o pagine e separa le prove dirette dalle inferenze.
- Inizia con un test a risposta nota ed espandi il contesto solo quando migliora il risultato.
- Stima il costo da input, output e trattamento della cache, non solo dal limite di contesto.
Cosa significa una finestra di contesto da 1M di token?
Una finestra di contesto è la quantità di informazioni che un modello può considerare in una singola richiesta o stato di conversazione, incluso il materiale fornito e le istruzioni circostanti. L'attuale pagina dei prezzi API di DeepSeek elenca DeepSeek-V4.1-Flash con una lunghezza di contesto di 1M e un output massimo di 384K token. Questo è il limite dichiarato dal provider; la tua applicazione, endpoint o configurazione della richiesta può imporre un limite inferiore. ( Documentazione API di DeepSeek )
I token sono pezzi di testo, non parole o pagine. Un archivio di origine contenente codice, tabelle, markup, boilerplate ripetuto e scansioni può essere tokenizzato in modo molto diverso da una prosa pulita con lo stesso numero di pagine. Per un carico di lavoro reale, stima i token con il tokenizer o il reporting di utilizzo per l'API che chiamerai. Includi istruzioni di sistema, nomi di file, metadati, testo della domanda e budget della risposta nella tua stima.
Il vantaggio pratico è la continuità. Puoi chiedere informazioni su dipendenze tra diversi moduli o contraddizioni tra una policy attuale e i suoi allegati senza prima cucire manualmente i riassunti. Il compromesso è che un prompt molto grande può contenere materiale irrilevante o duplicato, richiedere più tempo per l'elaborazione e rendere comunque più difficile il recupero esatto. Considera “rientra nella finestra” come un controllo di capacità, poi verifica se il modello riesce a trovare i fatti di cui il tuo compito ha bisogno.
I migliori casi d'uso della finestra di contesto da 1M di DeepSeek V4.1 Flash
La domanda giusta non è “Posso caricare tutto?” È “Quali fonti devono essere confrontate per rispondere a questo?” Usa un contesto lungo quando la risposta dipende da collegamenti tra materiali e definisci come verificherai quella risposta prima di inviare l'archivio completo.
| Caso d'uso | Perché un contesto lungo aiuta | Cosa includere | Cosa verificare |
|---|---|---|---|
| Revisione di una grande base di codice | Le interfacce e le convenzioni si estendono su più moduli | Codice sorgente rilevante, test, note di architettura | Percorsi dei file, simboli, prove dei test |
| Sintesi di ricerca | Metodi e risultati necessitano di un confronto affiancato | Articoli, report, limitazioni | Fonte e avvertenze di ogni affermazione |
| Confronto di contratti o policy | Definizioni ed eccezioni ricorrono in più sezioni | Versioni attuali e precedenti, allegati | Numeri di clausola e dicitura esatta |
| Analisi dei feedback | I temi emergono in molti commenti | Feedback de-identificati e regole di codifica | Citazioni rappresentative e metodo di conteggio |
| Cronologia della storia del progetto | Le decisioni si evolvono attraverso i verbali delle riunioni | Verbali, registri delle decisioni, note di rilascio | Date, responsabili, record contrastanti |
| Revisione di incidenti lunghi | Log, ticket e postmortem spiegano fasi diverse | Intervallo di tempo rilevante e documenti dell'incidente | Timestamp, fonte dell'evento, incertezza |
| Revisione di documenti multimodali | Testo e prove visive possono richiedere una lettura congiunta | Immagini supportate e relative didascalie o contesto | Se l'endpoint supporta il tipo di media |
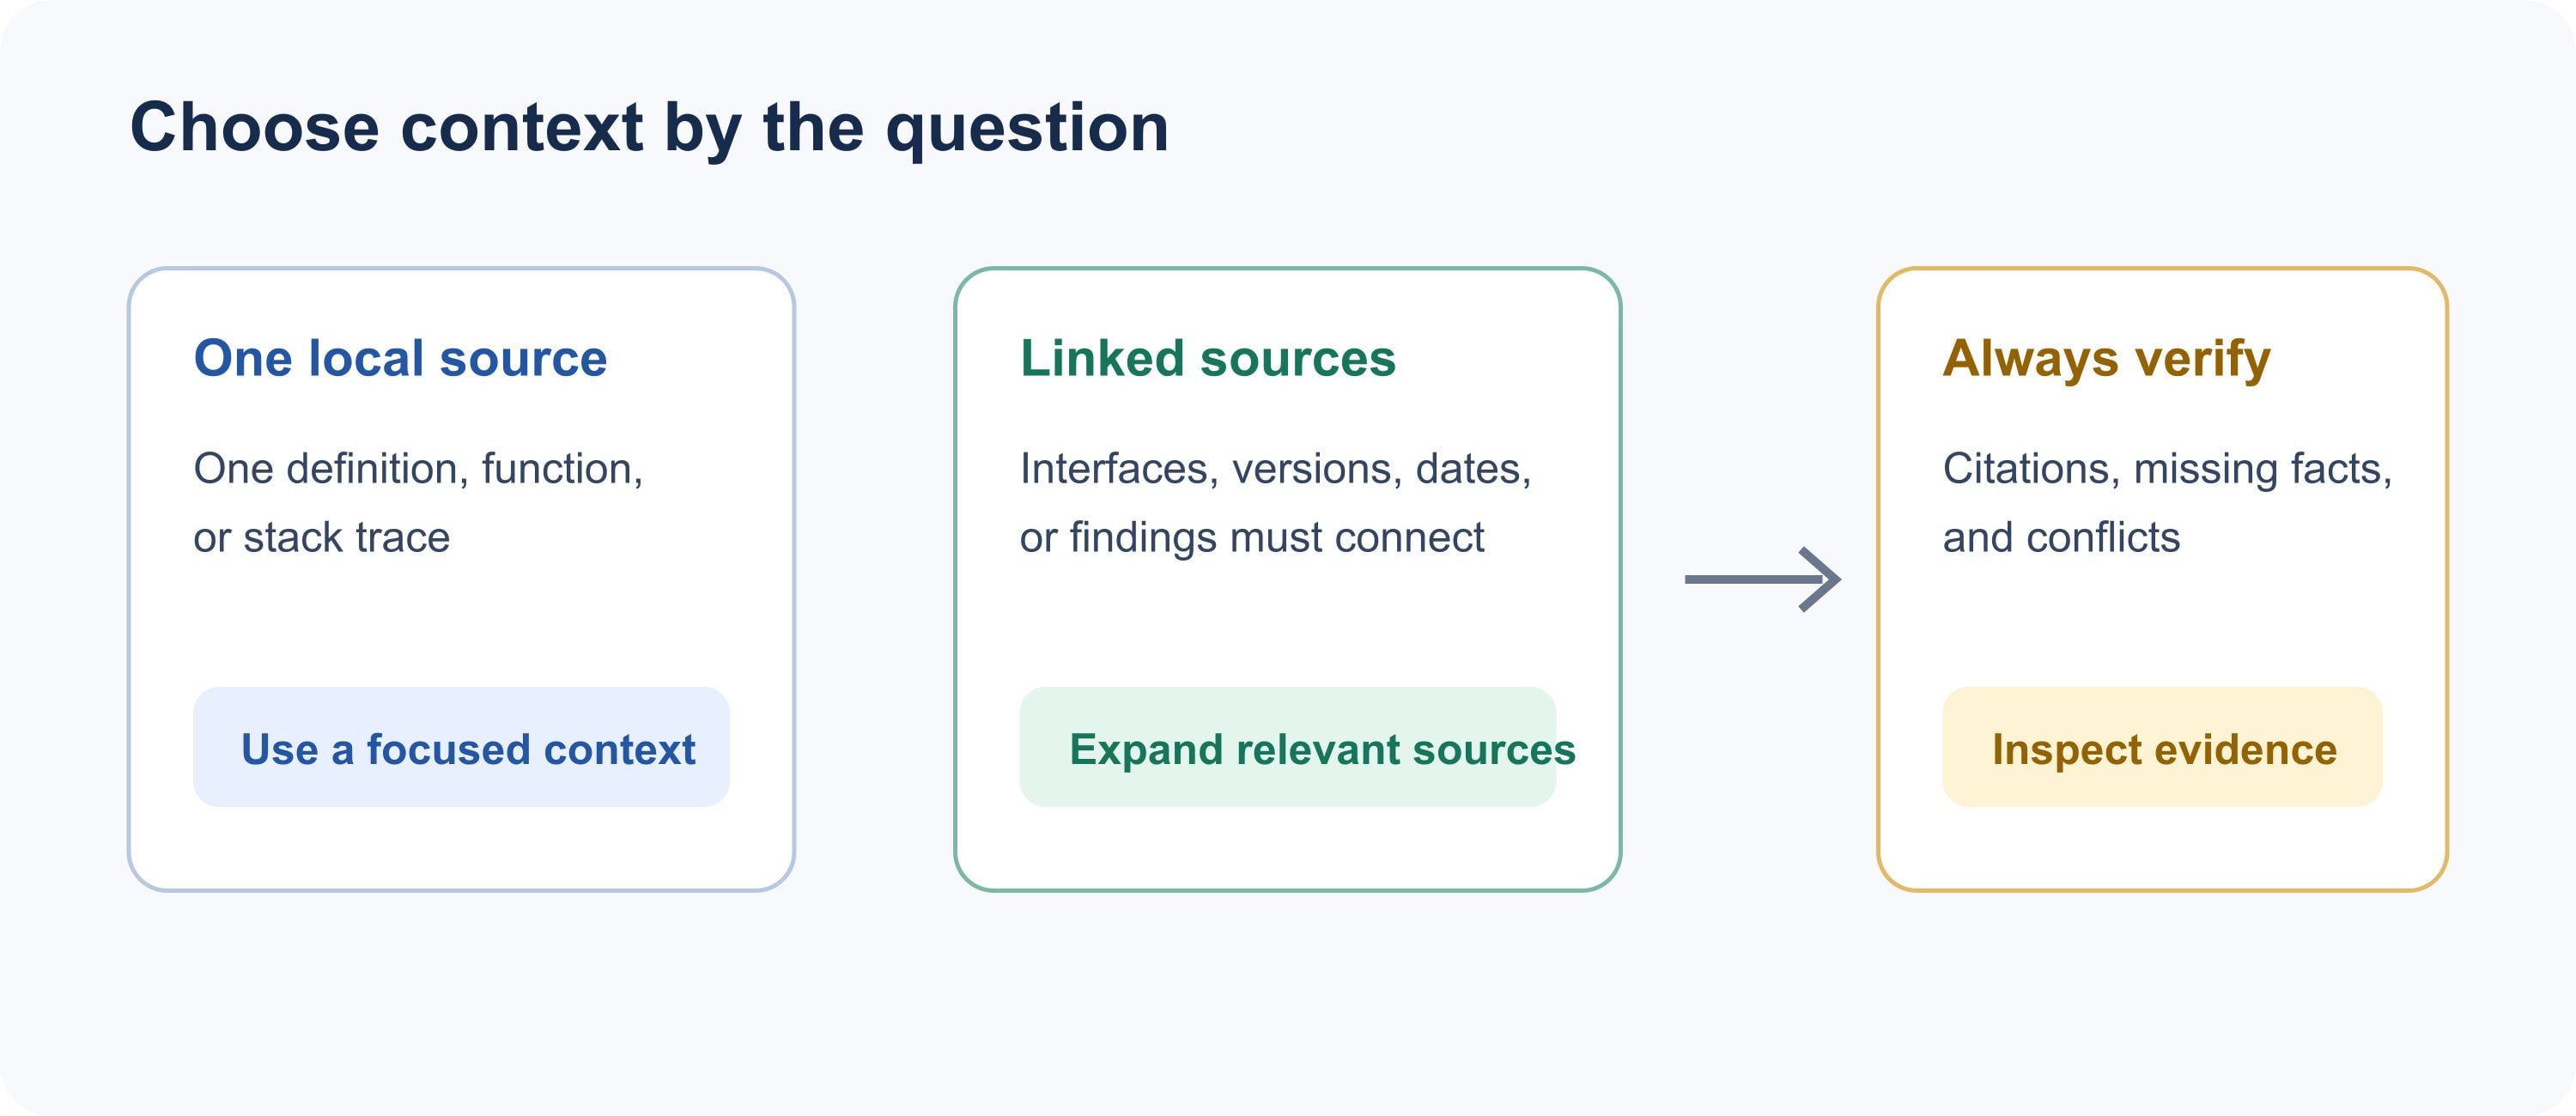
Usa un contesto mirato per una domanda locale; espandi quando le fonti devono connettersi, poi ispeziona le prove.
Revisione di una grande base di codice tra file
Un contesto da un milione di token può aiutare un ingegnere a tracciare una struttura dati dal confine di un'API attraverso la logica di servizio, l'archiviazione e i test. È utile per riassunti di architettura, per individuare i moduli probabilmente interessati e per redigere un piano di refactoring che rispetti le convenzioni documentate in più punti.
Fornisci al modello un'istantanea del repository delimitata anziché un dump completo del disco. Includi i file sorgente rilevanti per la modifica, i test più vicini, i manifest delle dipendenze e le note di architettura. Escludi output di build, dipendenze vendored, bundle generati e copie duplicate a meno che la domanda non li riguardi. Chiedi percorsi dei file e nomi dei simboli per ogni dipendenza proposta, oltre a una distinzione tra comportamento osservato e assunzione.
Usa l'output come piano di revisione. Conferma che ogni simbolo citato esista, ispeziona le righe citate ed esegui tu stesso i controlli del progetto. Il modello non dovrebbe affermare che i test sono passati a meno che uno strumento non li abbia effettivamente eseguiti e restituito il risultato. Per un bug localizzato in una funzione, un contesto più piccolo è spesso più veloce e più facile da verificare.
Sintetizzare la ricerca tra articoli e report
Un contesto lungo aiuta quando gli studi utilizzano metodi, popolazioni, misure o definizioni diversi. Chiedi una tabella di confronto con una riga per fonte e colonne per domanda di ricerca, dati, metodo, risultato, limitazioni e rilevanza per la tua domanda. Mantieni le affermazioni a livello di fonte collegate alla loro fonte anziché lasciare che un riassunto misto cancelli i disaccordi.
Ad esempio, quando confronti valutazioni di uno strumento, distingui un risultato di benchmark da uno studio sul campo e dall'interpretazione di un autore. Chiedi al modello di segnalare misure incompatibili invece di classificare risultati che non possono essere confrontati. Poi apri i passaggi di origine dietro le affermazioni più rilevanti per la decisione. Una sintesi è una mappa delle prove, non un sostituto del controllo degli articoli.
Confrontare contratti, policy o specifiche lunghe
I contratti e le policy spesso definiscono un termine una volta e lo qualificano altrove. Fornire insieme la versione operativa, le modifiche, gli allegati e la bozza precedente rilevante può aiutare a far emergere definizioni modificate, riferimenti incrociati, condizioni mancanti e conflitti apparenti.
Richiedi la sezione o clausola esatta per ogni osservazione e un breve estratto che un revisore possa individuare. Separa le differenze testuali dalle loro possibili conseguenze. Il modello può aiutare a organizzare una revisione, ma l'interpretazione legale, le decisioni di conformità e l'autorità di firma rimangono a persone qualificate che possono tenere conto della giurisdizione e del contesto.
Analizzare i feedback dei clienti su larga scala
Un grande insieme di feedback può rivelare richieste e obiezioni ricorrenti attraverso canali o periodi di tempo. Fornisci un campione definito, rimuovi le informazioni personali non necessarie e specifica uno schema di codifica come “attrito nell'onboarding”, “integrazione mancante” o “confusione sui prezzi”. Chiedi esempi rappresentativi e controesempi, non solo un elenco di temi.
Non presentare percentuali di temi generate dal modello come statistiche di indagine. Se hai bisogno di conteggi, definisci l'unità (messaggio, cliente o problema), deduplica i record, applica una regola di etichettatura coerente e verifica il conteggio con uno script ripetibile o un campione revisionato manualmente. Il modello è utile per proporre categorie e trovare esempi; un metodo documentato supporta le affermazioni quantitative.
Costruire una cronologia dai documenti di progetto
Per un passaggio di consegne o un postmortem, le prove rilevanti possono essere sparse tra verbali di riunioni, note di rilascio, registri delle decisioni e ticket. Chiedi una tabella cronologica con data, evento, responsabile nominato dove indicato, posizione della fonte e confidenza o ambiguità. Istruisci il modello a preservare le date in conflitto anziché sceglierne una in silenzio.
Una cronologia utile aiuta un nuovo membro del team a vedere cosa è stato deciso, quando un requisito è cambiato e quale documento supporta ogni evento. Verifica le transizioni critiche rispetto al record di origine, soprattutto quando una nota è stata scritta in seguito o riassume una riunione anziché registrarla direttamente.
Revisionare lunghi record di incidenti e materiale multimodale
La revisione degli incidenti può trarre vantaggio dal mantenere avvisi, note operative, ticket e postmortem in un unico insieme di prove. Chiedi una sequenza di eventi osservati e distingui esplicitamente i timestamp nei log dalle stime successive nelle note narrative. Questo può rendere la prima analisi più coerente, mentre l'ingegnere di turno controlla comunque i sistemi di origine prima di agire.
L'annuncio ufficiale di DeepSeek afferma che V4.1-Flash è attivo sulla sua API con supporto multimodale nativo. I formati immagine esatti, i metodi di richiesta e i limiti dipendono dall'endpoint e dall'integrazione, quindi conferma quei dettagli prima di presumere che un budget di testo da un milione di token descriva anche la gestione delle immagini. ( Annuncio di DeepSeek V4.1-Flash )
Quando un milione di token aiuta e quando aggiunge rumore?
Più contesto aiuta quando le fonti devono essere correlate. Una modifica al codice che coinvolge un'interfaccia condivisa può richiedere diversi moduli e test. Un confronto di versioni necessita sia delle versioni complete che dei loro allegati. Una cronologia di progetto può richiedere record distribuiti su mesi.
Un bug locale con uno stack trace chiaro può richiedere solo la funzione, i suoi chiamanti e il test rilevante. Una domanda che chiede una definizione può richiedere solo la sezione autorevole. Per questi compiti, includere un intero repository aggiunge spazio di ricerca e può seppellire il passaggio utile.
Prima di espandere il prompt, rimuovi esportazioni ripetute, bozze obsolete, cartelle non correlate, boilerplate e record al di fuori dell'intervallo temporale della domanda. Tieni un manifest di ciò che hai incluso e del perché. Se la risposta cambia quando aggiungi un grande lotto di file non correlati, questo è un segnale per stringere l'insieme delle fonti e rieseguire il test.
Un flusso di lavoro pratico per risposte affidabili con contesto lungo
Usa un protocollo di prove coerente in modo che una risposta fluente non venga scambiata per una verificata. Innanzitutto etichetta le fonti con nomi di file stabili e, ove possibile, numeri di pagina, intestazioni, numeri di riga, date o identificatori di versione. Conserva abbastanza contesto circostante per interpretare correttamente gli estratti.
Poi, enuncia una decisione o domanda di ricerca. Specifica la forma dell'output e le posizioni che il modello deve citare. Un prompt riutilizzabile è:
plaintext1Analyze only the supplied materials. For every factual claim, cite the source filename and the closest available section, page, line, or heading. Separate direct evidence from inference. If sources conflict or evidence is missing, say so. Do not fill gaps with assumptions. Return a concise answer, an evidence table, and a list of unresolved questions.
Per una base di codice, aggiungi: “Cita i percorsi del repository e i nomi di funzioni o classi. Prima di proporre una modifica, elenca i file interessati e le prove dei test che supportano la proposta. Non dire che un test è stato eseguito a meno che il suo risultato non sia incluso nelle prove fornite.”
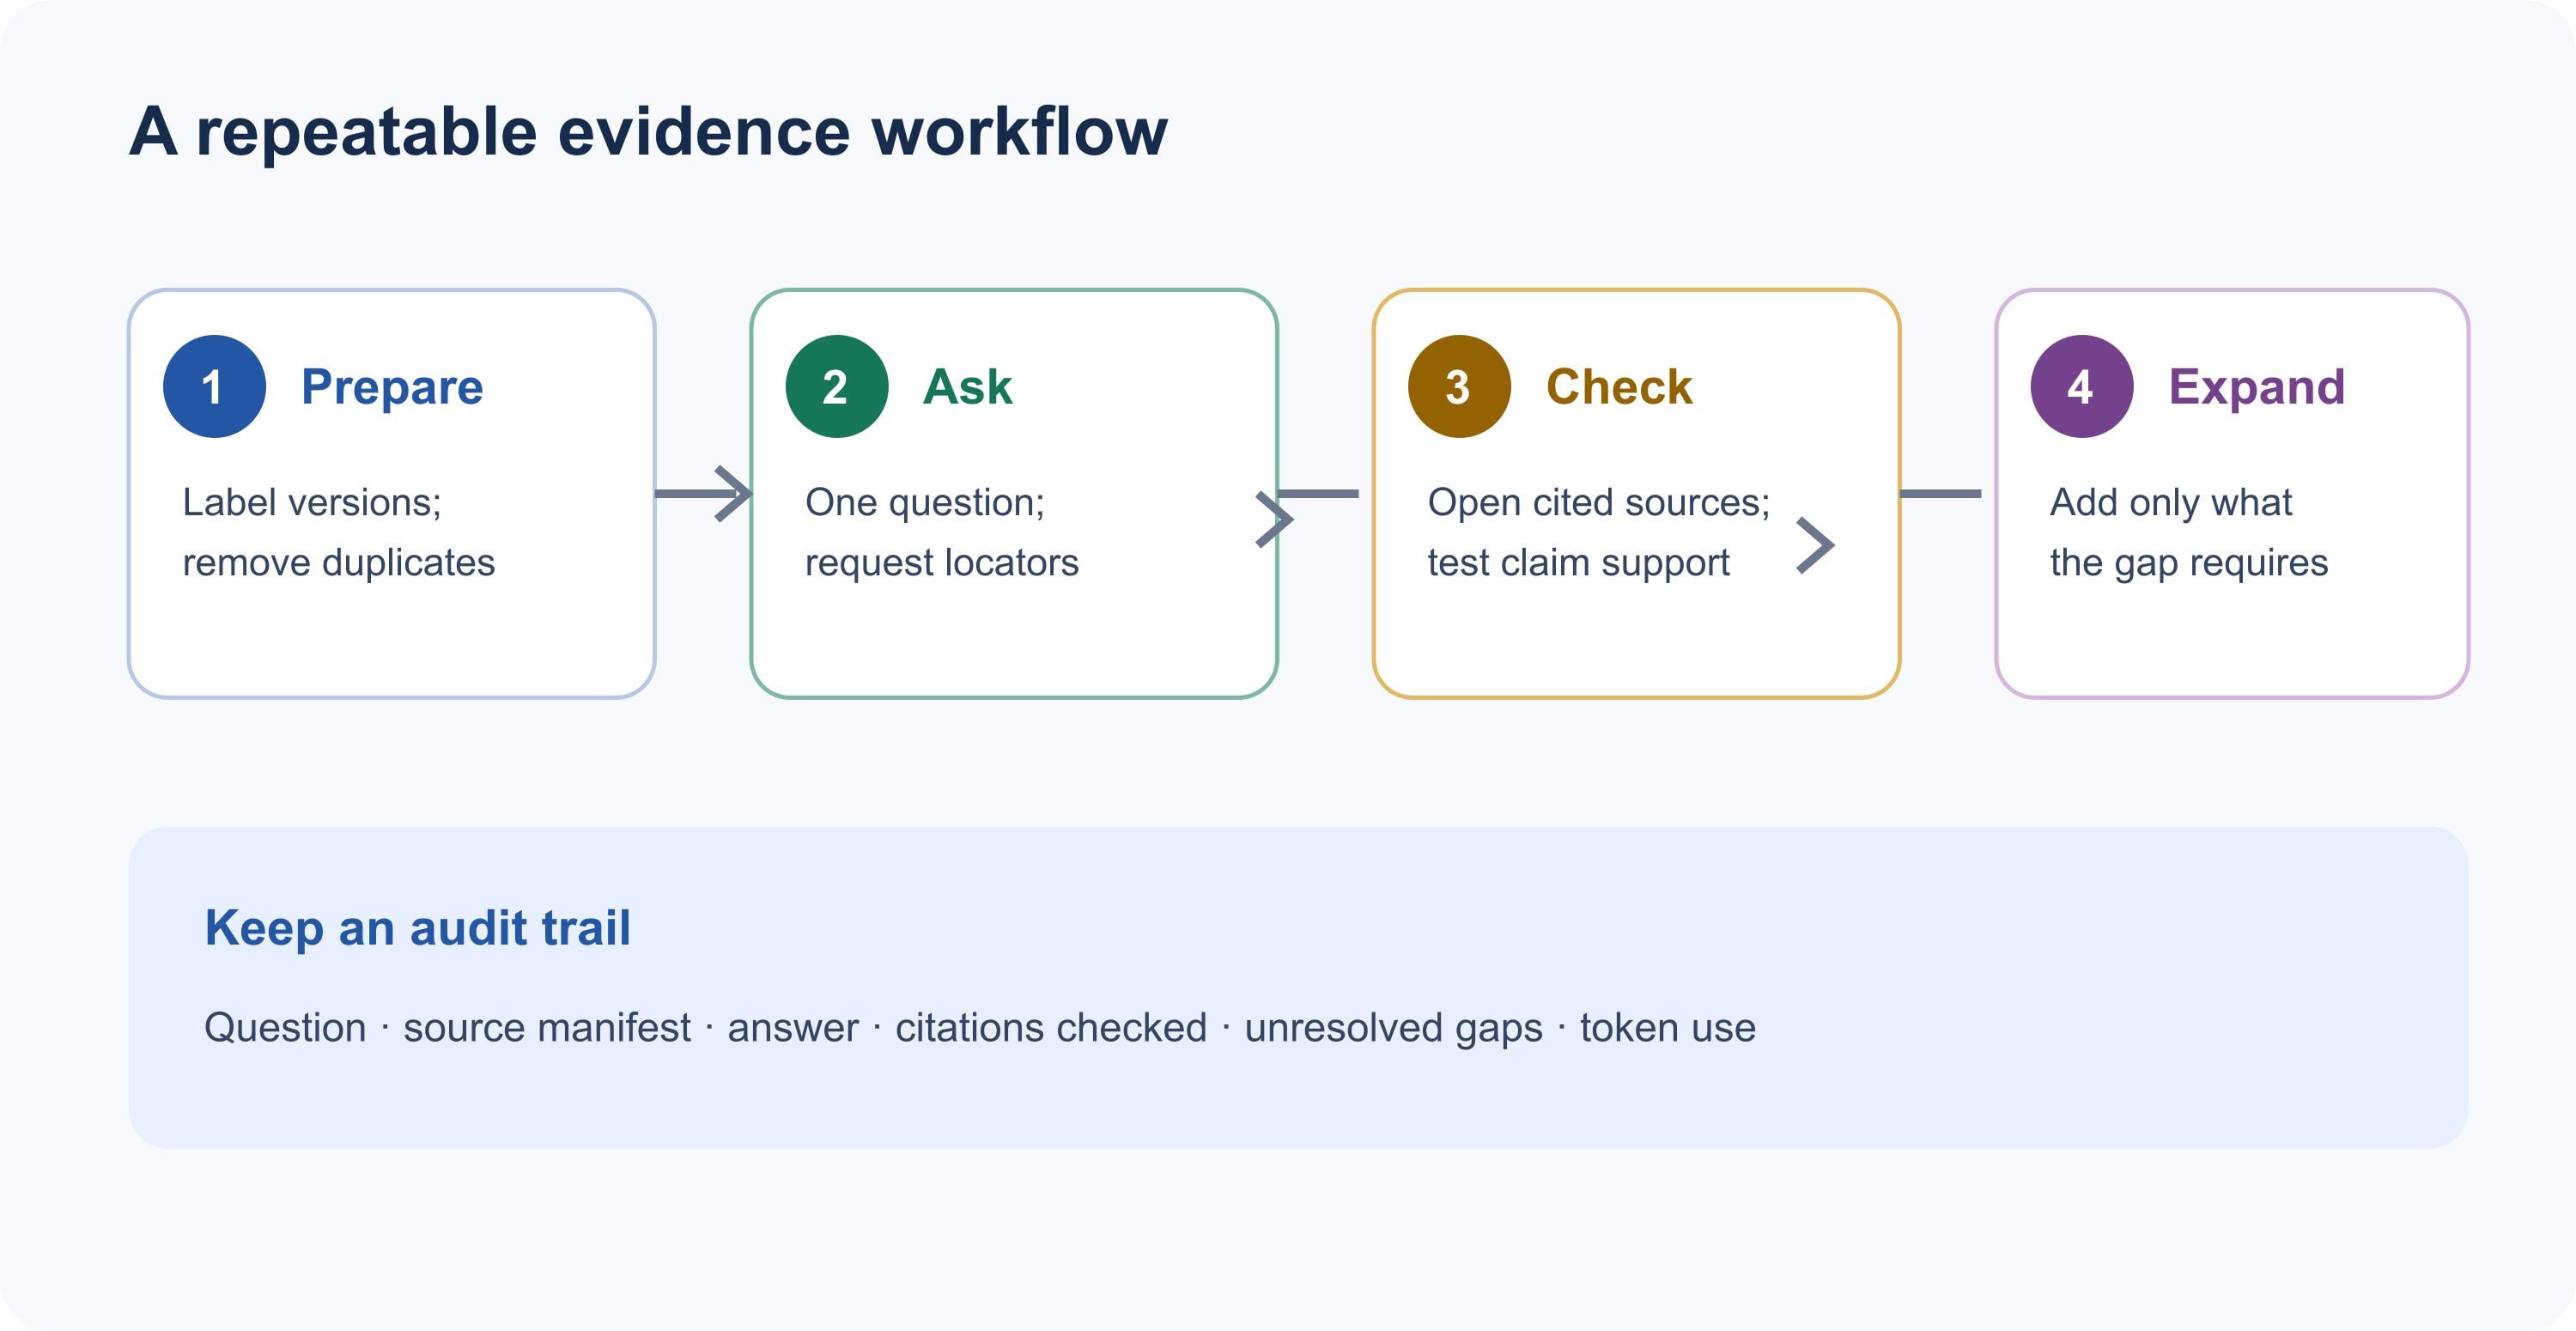
Prepara le fonti, poni una domanda delimitata, controlla le citazioni ed espandi solo per risolvere una lacuna.
Poi ispeziona la risposta in tre passaggi. Controlla se ogni citazione punta a una posizione reale. Controlla se il passaggio citato supporta l'affermazione, anziché semplicemente menzionare l'argomento. Infine, rivedi omissioni e conflitti ponendo domande di follow-up mirate sullo stesso insieme di fonti. Per decisioni ad alto rischio, fai leggere direttamente il materiale di origine a un revisore qualificato.
Mappa delle prove del flusso di lavoro con contesto lungo
| Fase | Azione | Mantieni | Segnale di stop |
|---|---|---|---|
| 1. Preparazione | Etichetta, deduplica e delimita le fonti | Manifest delle fonti e versioni | Provenienza sconosciuta o duplicato obsoleto |
| 2. Chiedi | Imposta una domanda e un formato delle prove | Nomi dei file e localizzatori nella risposta | Richiesta ampia senza obiettivo decisionale |
| 3. Controlla | Apri i passaggi citati e confronta le affermazioni | Affermazioni supportate e lacune esplicite | La citazione non supporta l'affermazione |
| 4. Espandi | Aggiungi solo le fonti necessarie per i collegamenti irrisolti | Miglioramento sui test a risposta nota | Più input senza prove migliori |
Come testare se il contesto da 1M è utile per il tuo compito
Crea un piccolo set di valutazione prima di caricare l'archivio completo. Scrivi domande le cui risposte conosci già dal materiale di origine. Metti alcuni fatti all'inizio, alcuni nel mezzo e alcuni vicino alla fine. Aggiungi almeno una domanda che richiede di collegare due documenti e una che non può essere risposta dalle fonti fornite.
Esegui le stesse domande prima su un sottoinsieme più piccolo e rilevante, poi aumenta il contesto in passaggi misurati. Registra correttezza fattuale, accuratezza dei localizzatori, prove mancate, affermazioni non supportate, rifiuto sulla domanda senza risposta, latenza e utilizzo dei token. Mantieni stabili il prompt e le impostazioni di decodifica in modo che i cambiamenti siano interpretabili. Ripeti una domanda se gli output variano materialmente tra le esecuzioni.
| Controllo | Cosa mostra una risposta superata | Cosa fare dopo un fallimento |
|---|---|---|
| Fatto noto in posizioni iniziali, intermedie, finali | Recupero attraverso l'estensione della fonte | Controlla indicizzazione, etichette dei file e lunghezza del prompt |
| Collegamento tra documenti | Le prove possono essere unite tra le fonti | Chiedi entrambe le citazioni, poi restringi la domanda sul collegamento |
| Domanda senza risposta | Il modello può segnalare prove mancanti | Stringi “usa solo le fonti fornite” e ritesta |
| Audit delle citazioni | Localizzatore ed estratto supportano l'affermazione | Tratta l'affermazione come non verificata fino a correzione |
| Confronto con contesto più ampio | Materiale extra migliora il compito target | Rimuovi il rumore se accuratezza o latenza peggiorano |
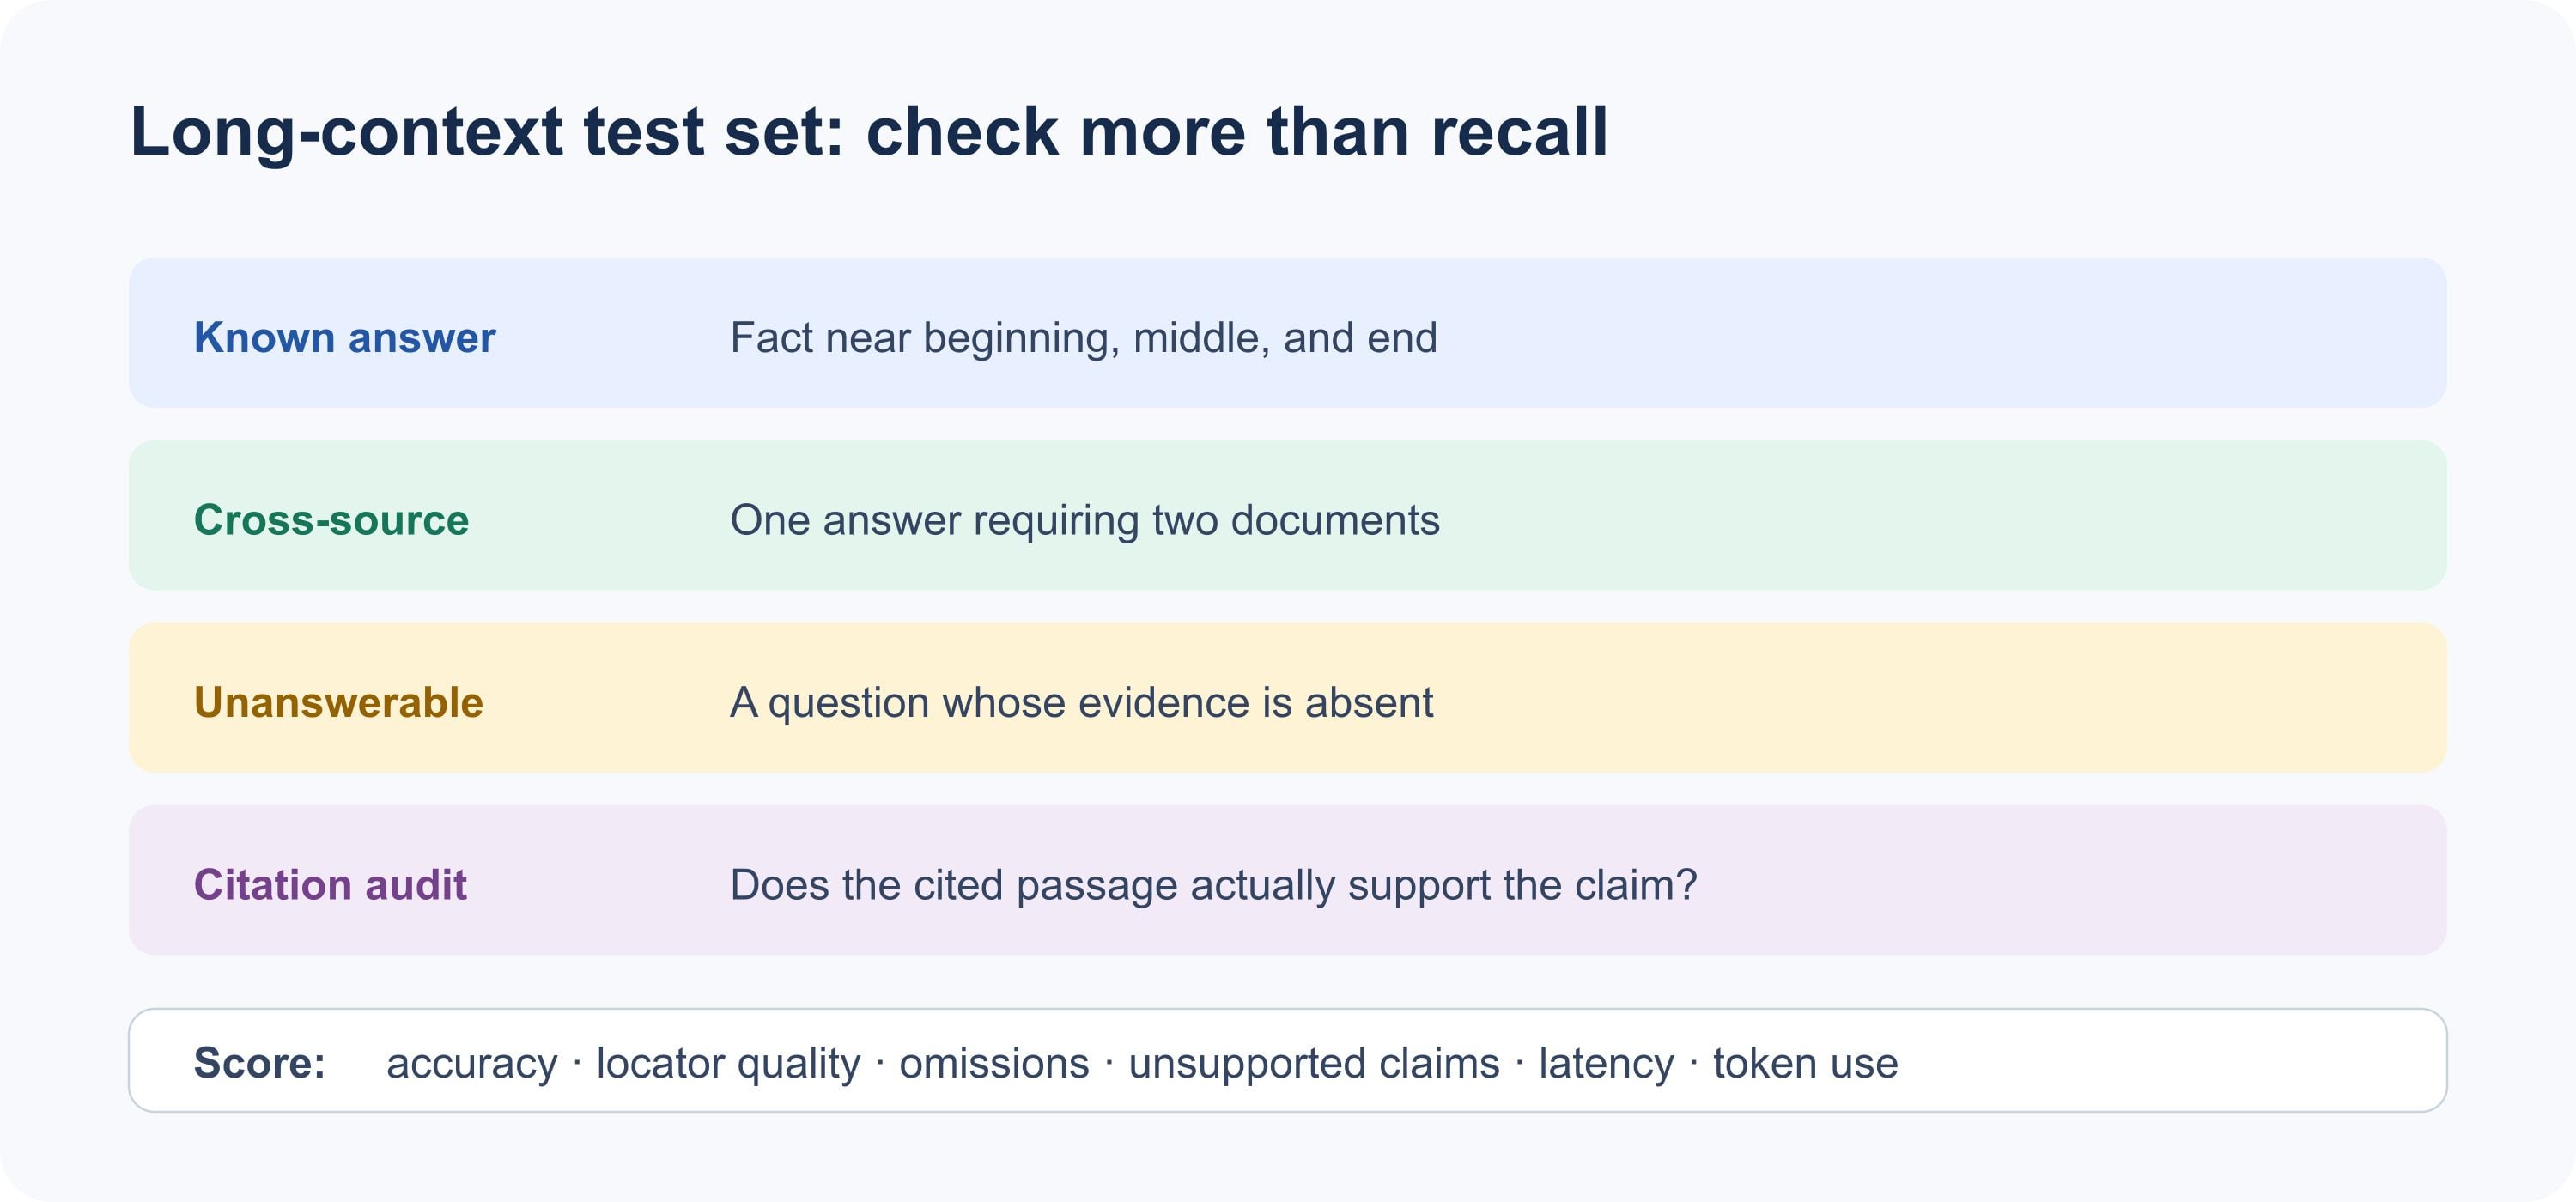
Punteggia recupero, supporto delle citazioni, omissioni, affermazioni non supportate, latenza e utilizzo dei token.
I resoconti della community sono misti e dipendono dal compito. Un utente di Reddit ha condiviso un aumento specifico del harness di argomenti di strumenti malformati a dimensioni di contesto maggiori, mentre i commentatori hanno descritto lavori riusciti con conteggi di token più elevati in altre configurazioni. Questa è una ragione utile per benchmarkare il tuo harness, non una prova di una soglia di fallimento universale. ( Discussione sul contesto di DeepSeek su Reddit )
Un aumento di scala ragionevole è: convalida il prompt su un piccolo campione, aggiungi i gruppi di fonti necessari per domande tra documenti, poi testa una richiesta ampia rappresentativa. Mantieni il contesto più piccolo che risponde alla domanda reale con prove affidabili. Questo rende anche più facili da interpretare i confronti di latenza e costo.
Prezzi e accesso all'API di DeepSeek V4.1 Flash
Su Atlas Cloud, l'elenco dei modelli attualmente mostra DeepSeek V4.1 Flash con un contesto da 1M e tariffe di $0.30 per milione di token di input, $1.20 per milione di token di output e $0.03 per milione di token di cache-read. L'elenco non mostra sconti per questo modello. Queste sono le tariffe di Atlas Cloud, distinte dai prezzi di punta e fuori punta dipendenti dal tempo di DeepSeek. Ricontrolla il catalogo dei modelli di Atlas Cloud e la pagina dei prezzi dei modelli prima di pubblicare o fare budget perché le tariffe possono cambiare.
Alle tariffe elencate, una richiesta con 100.000 token di input non in cache e 2.000 token di output costa circa $0.03 per l'input più $0.0024 per l'output, ovvero $0.0324 in totale prima di eventuali altri addebiti applicabili. Se l'input viene fatturato come letture cache, 100.000 token in cache costerebbero invece $0.003. L'esempio presuppone quei conteggi di token e quelle tariffe; non è un preventivo per un carico di lavoro specifico. La capacità completa di 1M non viene addebitata solo perché esiste. La fatturazione segue l'utilizzo e il trattamento della cache.
Per i team che desiderano un unico punto di accesso API, la pagina del modello DeepSeek V4.1 Flash fornisce il modello e i dettagli di chiamata. Confronta anche il tuo utilizzo misurato dei token e le esigenze di integrazione con l'endpoint ufficiale; nomi dei modelli, limiti e prezzi possono variare a seconda del provider.
Domande frequenti
Una finestra di contesto da 1M di token è uguale a 1M di parole?
No. I token possono essere parti di parole, punteggiatura, frammenti di codice o altre unità. Il numero di parole o pagine che rientrano dipende dal materiale e dalla sua tokenizzazione. Usa conteggi di token misurati anziché una conversione fissa in pagine.
DeepSeek V4.1 Flash utilizza sempre l'intera finestra di contesto?
No. Un milione di token è una specifica di contesto massima, non un obiettivo per ogni richiesta. Un prompt breve ne usa meno e una particolare interfaccia o route API può imporre un limite inferiore. Controlla la documentazione dell'endpoint e i campi di utilizzo effettivi.
Un contesto da 1M è sufficiente per un'intera base di codice?
Può adattarsi a alcune basi di codice per conteggio di token, ma ciò non rende ogni file rilevante o ogni risposta affidabile. Includi i file necessari per la domanda, verifica i percorsi e i simboli citati e testa le modifiche con i controlli reali del progetto.
Dovrei inserire ogni documento disponibile in un unico prompt?
Solo se i documenti riguardano la stessa domanda. Parti da un manifest delle fonti, rimuovi duplicati e materiale non correlato, poi aggiungi altro quando un test tra documenti lo richiede. I migliori casi d'uso della finestra di contesto da 1M di DeepSeek V4.1 Flash sono definiti dalle prove che devono essere confrontate, non dalla dimensione dell'archivio.





