Due team possono riportare centinaia di token al secondo per DeepSeek V4.1 Flash e stare comunque misurando cose diverse. Uno può intendere la velocità di decodifica per una singola richiesta; un altro può intendere l'output aggregato su decine di richieste concorrenti. Per migliorare l'ottimizzazione del throughput di inferenza di DeepSeek V4.1 Flash, scegli prima la metrica di cui ha bisogno il tuo servizio, poi esegui benchmark sul tuo mix di richieste, cambia una variabile di serving alla volta e verifica insieme latenza, qualità e costo. La famiglia di modelli ora include l'aggiornamento Flash-1017 del 17 ottobre, quindi registra il checkpoint esatto prima di confrontare i risultati. I report pubblici mostrano percorsi di ottimizzazione utili, ma nessuno sostituisce un test abbinato sul tuo hardware.
Punti chiave
- L'output aggregato in token/s misura la capacità attraverso le richieste; la velocità di decodifica per richiesta misura l'esperienza del singolo utente.
- Riproduci le lunghezze dei prompt, i limiti di output, la concorrenza, lo stato caldo e l'obiettivo di latenza prima di ottimizzare.
- La KV cache compressa e il replay limitato di V4.1 Flash riducono la pressione sulla memoria, ma non garantiscono un aumento fisso della velocità end-to-end.
- Confronta vLLM e SGLang solo a parità di modello, hardware, carico di lavoro e condizioni di misurazione.
Che cosa significa throughput per DeepSeek V4.1 Flash?
Il throughput è un tasso, ma il numeratore e il confine del test contano. Per un servizio di inferenza, registra almeno cinque misurazioni:
| Metrica | Che cosa ti dice | Uso tipico |
|---|---|---|
| Token di output aggregati/s | Token di output prodotti da tutte le richieste attive al secondo | Pianificazione della capacità ed efficienza della flotta |
| Token di decodifica per richiesta/s | Velocità di generazione sperimentata da una singola richiesta | Reattività interattiva durante la generazione |
| Token di prefill/s | Token di input elaborati al secondo | Prompt lunghi e carichi di lavoro con recupero intensivo |
| Tempo al primo token (TTFT) | Tempo dall'arrivo della richiesta al primo token di output | Ritardo percepito all'avvio |
| Latenza end-to-end, p50/p95 | Durata totale della richiesta lungo la distribuzione del traffico | Obiettivi di livello di servizio e comportamento della coda |
Un server può aumentare il throughput aggregato raggruppando più sequenze in batch, facendo però attendere più a lungo ogni utente tra un token e l'altro. Al contrario, una configurazione ottimizzata per bassa concorrenza può offrire risposte individuali rapide lasciando gli acceleratori sottoutilizzati. Nessuno dei due risultati è universalmente migliore. L'obiettivo giusto è un punto sulla curva throughput-latenza che soddisfa l'obiettivo di servizio del tuo prodotto.
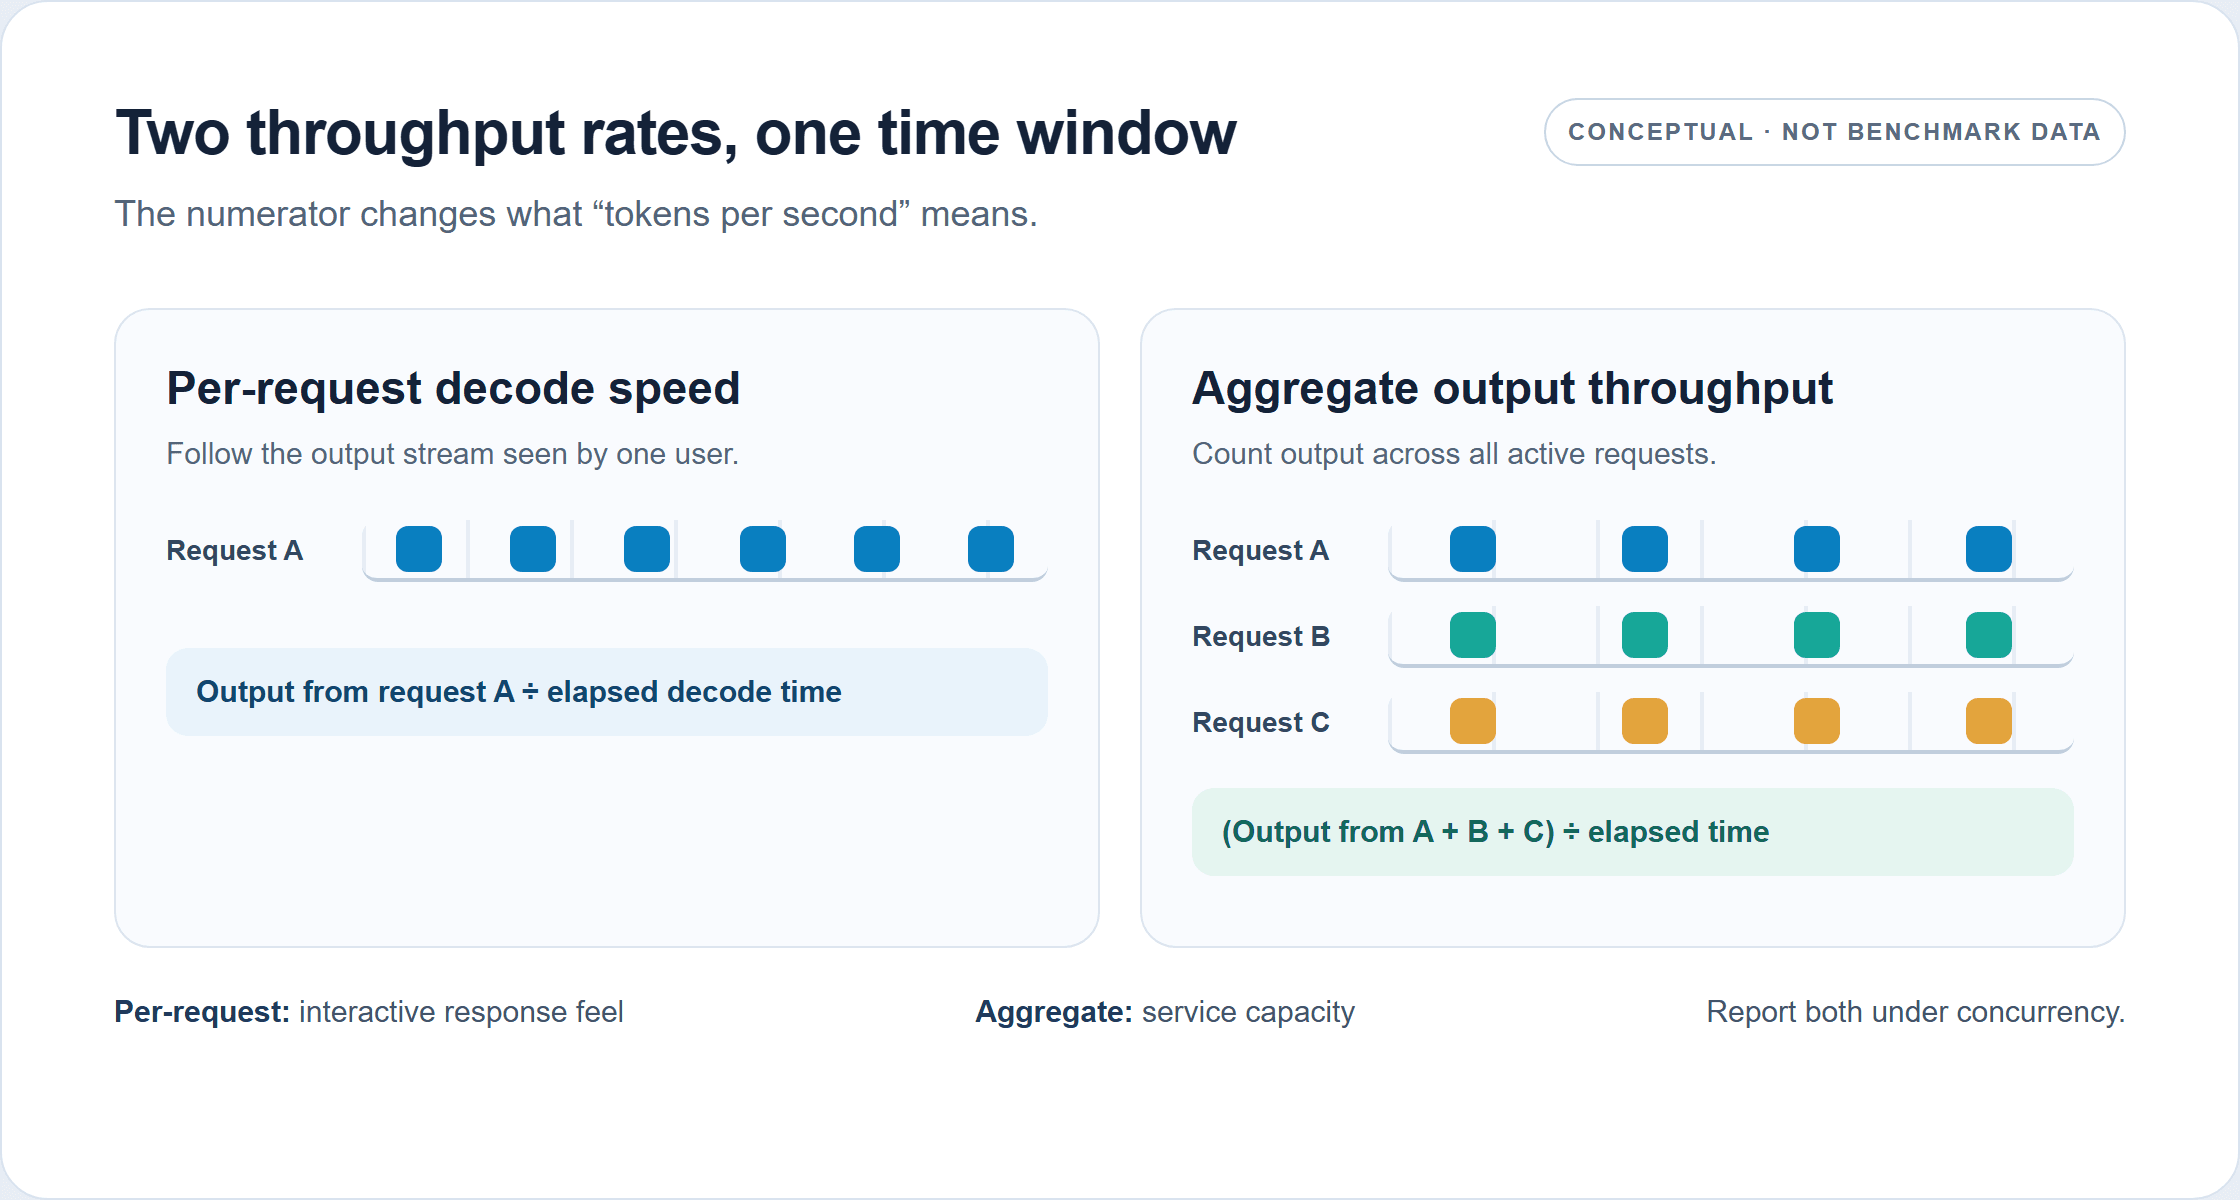
I due tassi conteggiano flussi di output diversi. Questo è un diagramma concettuale, non una prestazione misurata di DeepSeek V4.1 Flash.
Specifica se il throughput include prefill, decodifica o entrambi. Dichiara se dividi per il numero di GPU. Riporta i token di output riusciti anziché i token massimi richiesti e divulga cancellazioni o errori. Senza questi dettagli, un valore di token/s non può dire a un operatore se è predittivo per la sua applicazione.
Costruisci una baseline riproducibile per DeepSeek V4.1 Flash
Una baseline utile assomiglia al traffico di produzione abbastanza da esporne il collo di bottiglia. Un singolo prompt breve è un cattivo proxy per un agente che invia ripetutamente una lunga cronologia di conversazione, e un output fisso di 1.024 token non coglie carichi di lavoro che si fermano presto o variano molto.
Fissa il carico di lavoro e la finestra di misurazione
Crea bucket di richieste dal traffico osservato. Per ogni bucket, preserva la lunghezza di input approssimativa, la lunghezza di output prevista, il pattern di arrivo e eventuali prefissi condivisi. Includi turni di tool o ragionamento se fanno parte del percorso reale della richiesta. Mantieni fissi prompt, impostazioni di campionamento, condizioni di arresto e limiti di output tra le esecuzioni.
Esegui sia un caso a bassa concorrenza sia la concorrenza che il tuo servizio prevede al picco. Poi aggiungi livelli di concorrenza intermedi per rivelare dove il throughput smette di salire o la latenza supera il suo limite. Usa una finestra di misurazione stabile dopo il riscaldamento, ripeti ogni punto e riporta la mediana più l'intervallo. Un burst breve può misurare il comportamento di avvio anziché la capacità di servizio stabile.
Separa le misurazioni a freddo dal serving a caldo. Le esecuzioni a freddo includono il caricamento del modello, la cattura del grafo o il popolamento della cache a seconda dello stack; le esecuzioni a caldo descrivono un sistema pronto a servire. Per un carico di lavoro con prefix caching, misura separatamente il traffico con cache hit e cache miss. Non combinarli in un'unica media a meno che il mix corrisponda alla produzione.
Mantieni un registro dei benchmark
Salva una riga per ogni esecuzione con questi campi: checkpoint o revisione del modello; runtime e commit; modello e numero di GPU; interconnect; precisione e quantizzazione; layout di parallelismo tensor, expert o pipeline; distribuzione dei token di input e output; concorrenza e pattern di arrivo delle richieste; stato caldo o freddo; durata dell'esecuzione; tasso di successo; throughput aggregato; velocità di decodifica per richiesta; TTFT; e latenza end-to-end p50/p95.
Questo registro è più utile di un numero di classifica perché rende riproducibile il prossimo esperimento. Congelalo prima di ottimizzare. Se il carico di lavoro o il checkpoint cambiano, inizia una nuova baseline invece di attribuire la differenza a un flag di serving.
Diagnostica prefill, decodifica, KV cache o scheduling
Usa i sintomi per scegliere la prossima misurazione, non per indovinare una correzione. Un TTFT alto con velocità di decodifica accettabile punta verso elaborazione dell'input, accodamento, cache miss o overhead di avvio. Una decodifica lenta a bassa concorrenza suggerisce di esaminare kernel, larghezza di banda della memoria, comunicazione parallela e percorso di esecuzione del modello. Un throughput aggregato che si stabilizza mentre la concorrenza sale può indicare pressione sulla memoria, limiti dello scheduler, overhead di comunicazione o un percorso di calcolo saturo. Il degrado su contesti lunghi richiede di misurare la residenza in cache, il lavoro di prefill e il movimento host-to-device.
| Osservazione | Primi controlli |
|---|---|
| Il TTFT cresce con la lunghezza del prompt | Velocità di prefill, tempo in coda, tasso di cache hit del prefisso, riscaldamento di grafo o compilazione |
| La velocità di decodifica è bassa anche con concorrenza 1 | Percorso del modello nel runtime, supporto kernel, precisione, utilizzo GPU, overhead di comunicazione |
| I token/s aggregati si stabilizzano mentre la concorrenza sale | Capacità della KV cache, batching dello scheduler, larghezza di banda della memoria, topologia parallela |
| La latenza p95 sale bruscamente mentre l'output aggregato migliora | Dimensione del batch, politica di accodamento, mix di lunghezze delle richieste, obiettivo di servizio |
| Prompt lunghi espellono richieste attive utili | Residenza della KV cache, allocazione della cache, distribuzione del contesto, traffico verso memoria host |
V4.1 Flash ha caratteristiche architetturali pensate per alleviare alcune di queste pressioni. Il report del modello descrive CSA2 con riuso della cache cross-layer e caching KV globale FP4, con un'impronta KV globale dichiarata di 890 byte per token, circa un quarto dell'impronta corrispondente di V4-Flash. SWA Bounded Replay affronta un diverso compromesso di archiviazione: invece di persistere tutto lo stato dell'attenzione a finestra scorrevole, un deployment può ricostruire lo stato mancante riproducendo la finestra recente. DeepSeek riporta una KV cache persistente vicina a un ottavo dell'impronta di V4-Flash per questo design, con una piccola quantità di ricalcolo prefill aggiuntivo. Questi sono risultati di architettura e deployment, non la promessa di un throughput otto volte maggiore. (Report tecnico DeepSeek, settembre 2026)
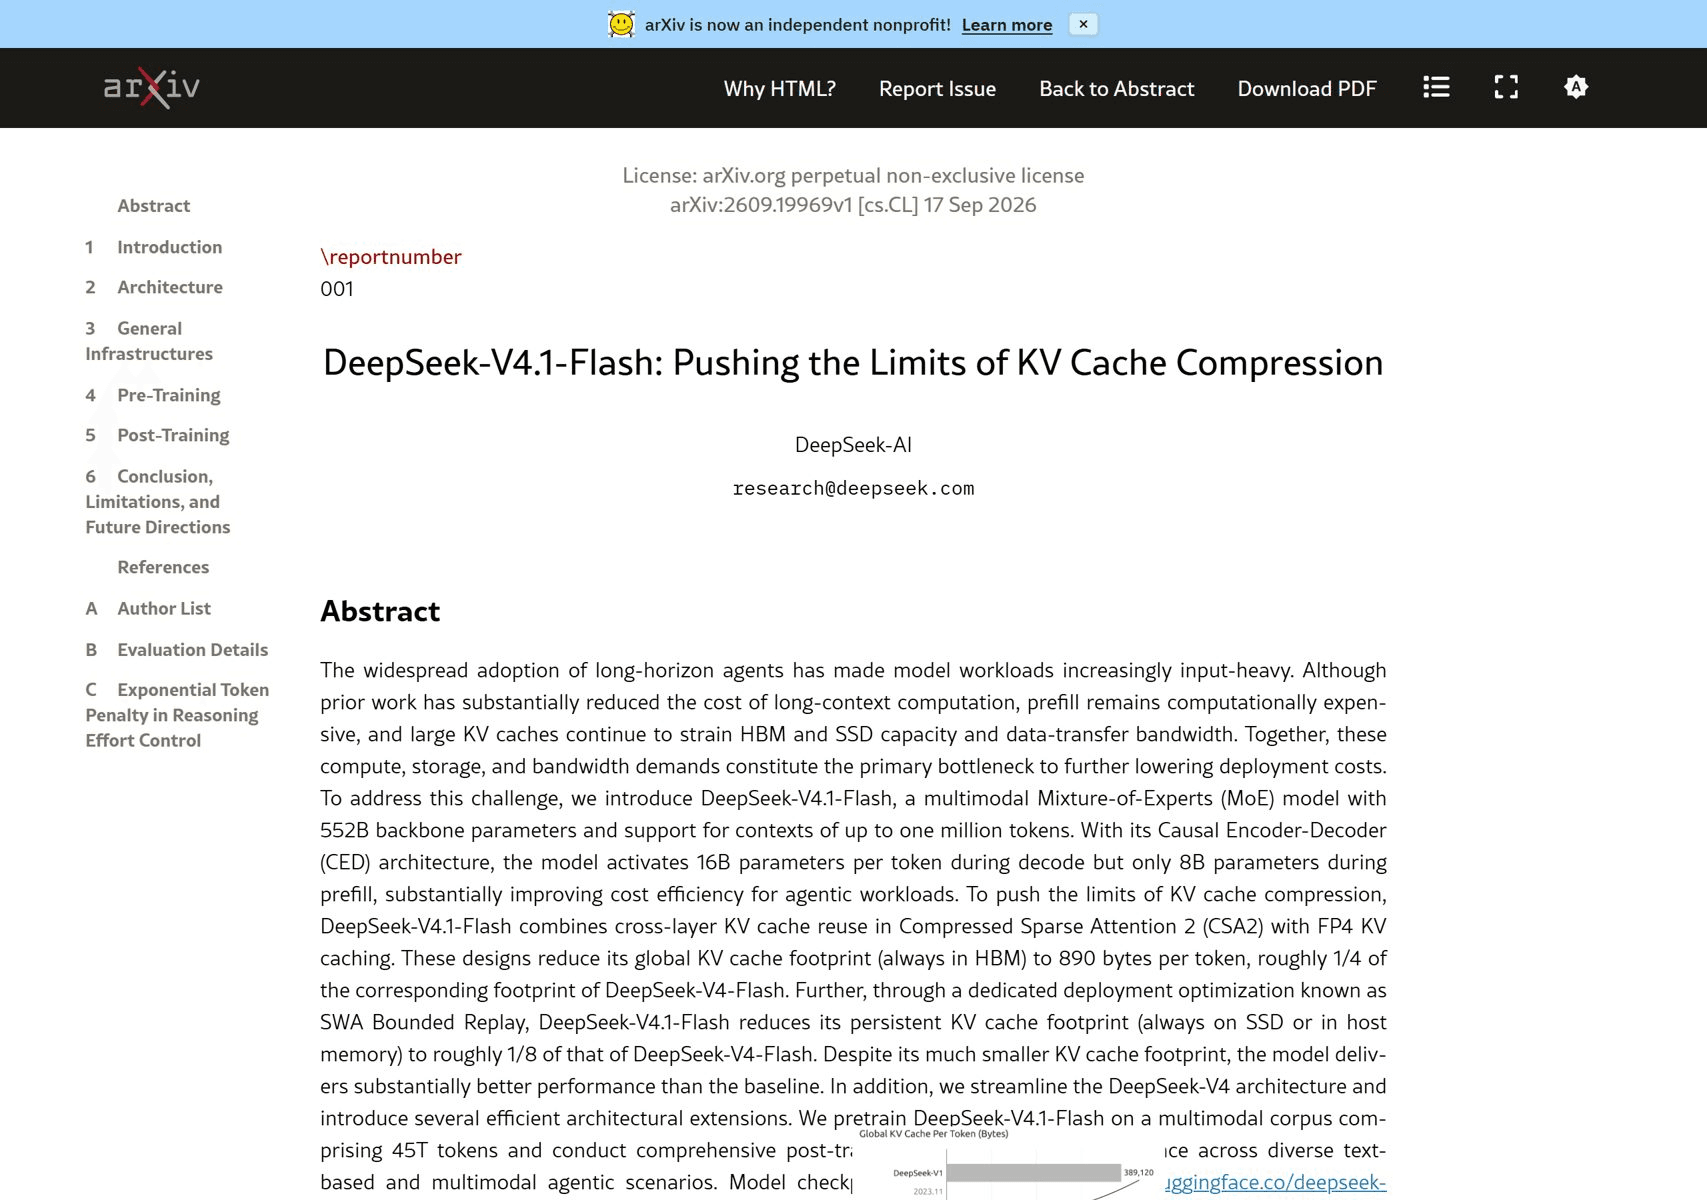
La figura di origine descrive la capacità della cache, non un moltiplicatore di throughput end-to-end per ogni deployment.
Quando la diagnosi non è chiara, profila un'esecuzione rappresentativa e ispeziona tempo in coda, utilizzo GPU, uso della memoria e tempi per fase. Cambia una variabile, riesegui lo stesso carico di lavoro e controlla la correttezza dell'output o la qualità del task. Questo impedisce che un apparente aumento di velocità mascheri una regressione nel servizio o nelle risposte.
Ottimizza vLLM o SGLang rispetto allo stesso obiettivo
Scegli un runtime il cui percorso attuale del modello supporti il checkpoint e l'hardware che intendi distribuire. Verifica la release esatta, i kernel, il comportamento del grafo e il layout parallelo. Il fatto che un modello sia elencato come supportato non significa che ogni quantizzazione o topologia sia ugualmente ottimizzata.
vLLM: convalida il percorso del modello specifico della release
Il report di ottobre del team vLLM descrive una progressione sul suo benchmark AgentX: circa 1,9× di miglioramento nel risultato a bassa latenza e circa 5,3× di throughput con un vincolo di 150 TPS rispetto alla sua baseline del giorno zero. Il lavoro includeva replay limitato SWA con grafi CUDA e integrazione di kernel specifici del modello. Considera quei valori come prove che lo stack è cambiato materialmente nel tempo sotto quel benchmark, non come moltiplicatori da applicare a un altro cluster. (Report di ingegneria vLLM, ottobre 2026)
Per la tua esecuzione, stabilisci prima una release supportata e una configurazione collaudata. Poi misura singolarmente il comportamento di cattura o replay del grafo, il batching e il parallelismo. Preserva il vincolo di latenza usato per selezionare un punto a throughput più alto. Se la cattura del grafo cambia l'avvio o il fabbisogno di memoria, includi quei costi nella decisione di deployment.
SGLang: abbina il suo profilo di concorrenza
Il report del team SGLang offre un esempio insolitamente chiaro del perché il contesto del test conta. Su 8 GPU H200, la sua esecuzione ottimizzata senza decodifica speculativa è passata da circa 76 a 168 token/s per utente a concorrenza 1, e da circa 96 a 221 token di output/s per GPU a concorrenza 64. Usava input fissi da 8.192 token e output da 1.024 token. I suoi risultati separati su 4×GB300 usavano lunghezze dei prompt, impostazioni parallele e decodifica speculativa DSpark diverse. Il report supporta quindi la valutazione delle ottimizzazioni di SGLang sul tuo traffico, non una classifica diretta contro i numeri AgentX di vLLM. (Report di ottimizzazione LMSYS/SGLang, settembre 2026)
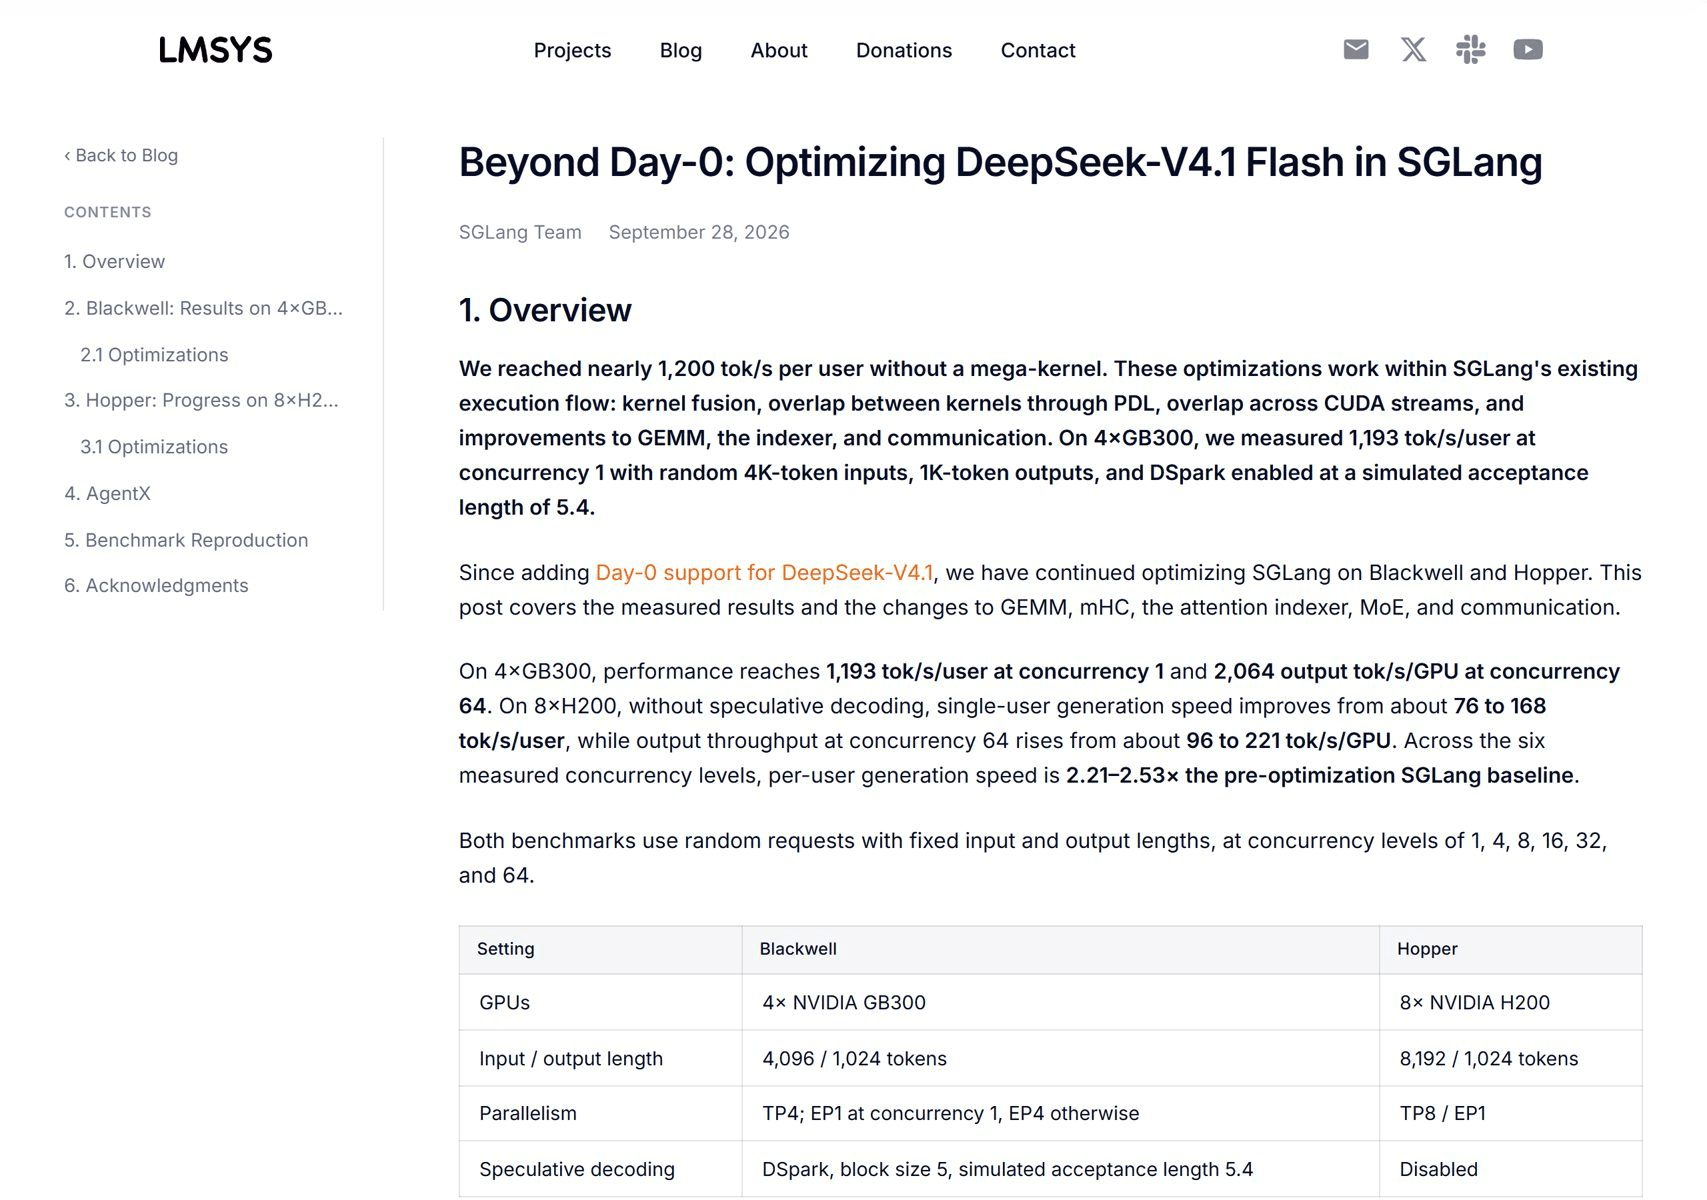
I report di origine usano carichi di lavoro e hardware diversi; i loro numeri non dovrebbero essere letti come un grafico testa a testa.
Inizia con un runtime e ottimizza il suo percorso supportato. Costruisci un confronto con un secondo runtime solo se puoi mantenere costanti checkpoint, allocazione GPU, distribuzioni di prompt e output, concorrenza, riscaldamento e obiettivo di servizio. Quel confronto costa tempo di ingegneria, quindi prima conferma che lo stack attuale sia davvero il fattore limitante.
Ottimizza concorrenza e contesto lungo senza rompere l'SLO
Aumenta la concorrenza a passi e cattura output aggregato, velocità di decodifica per richiesta, TTFT, latenza p95, uso della memoria e fallimenti a ogni passo. Mantieni il punto a throughput più alto solo se la sua latenza e i tassi di errore soddisfano ancora il tuo obiettivo di servizio. Se le richieste si accodano prima della generazione, un batch più grande può migliorare l'utilizzo del dispositivo facendo però percepire il prodotto come più lento.
Per il traffico con contesto lungo, misura la distribuzione del contesto attivo e il tasso di cache hit. Una finestra di contesto massima dichiarata non significa che ogni richiesta possa essere servita in concorrenza a quella lunghezza. La KV cache compete per la memoria con pesi, attivazioni, pool di grafi e buffer del runtime. Lascia margine per lunghezze delle richieste variabili e misura l'eviction o la preemption con traffico realistico.
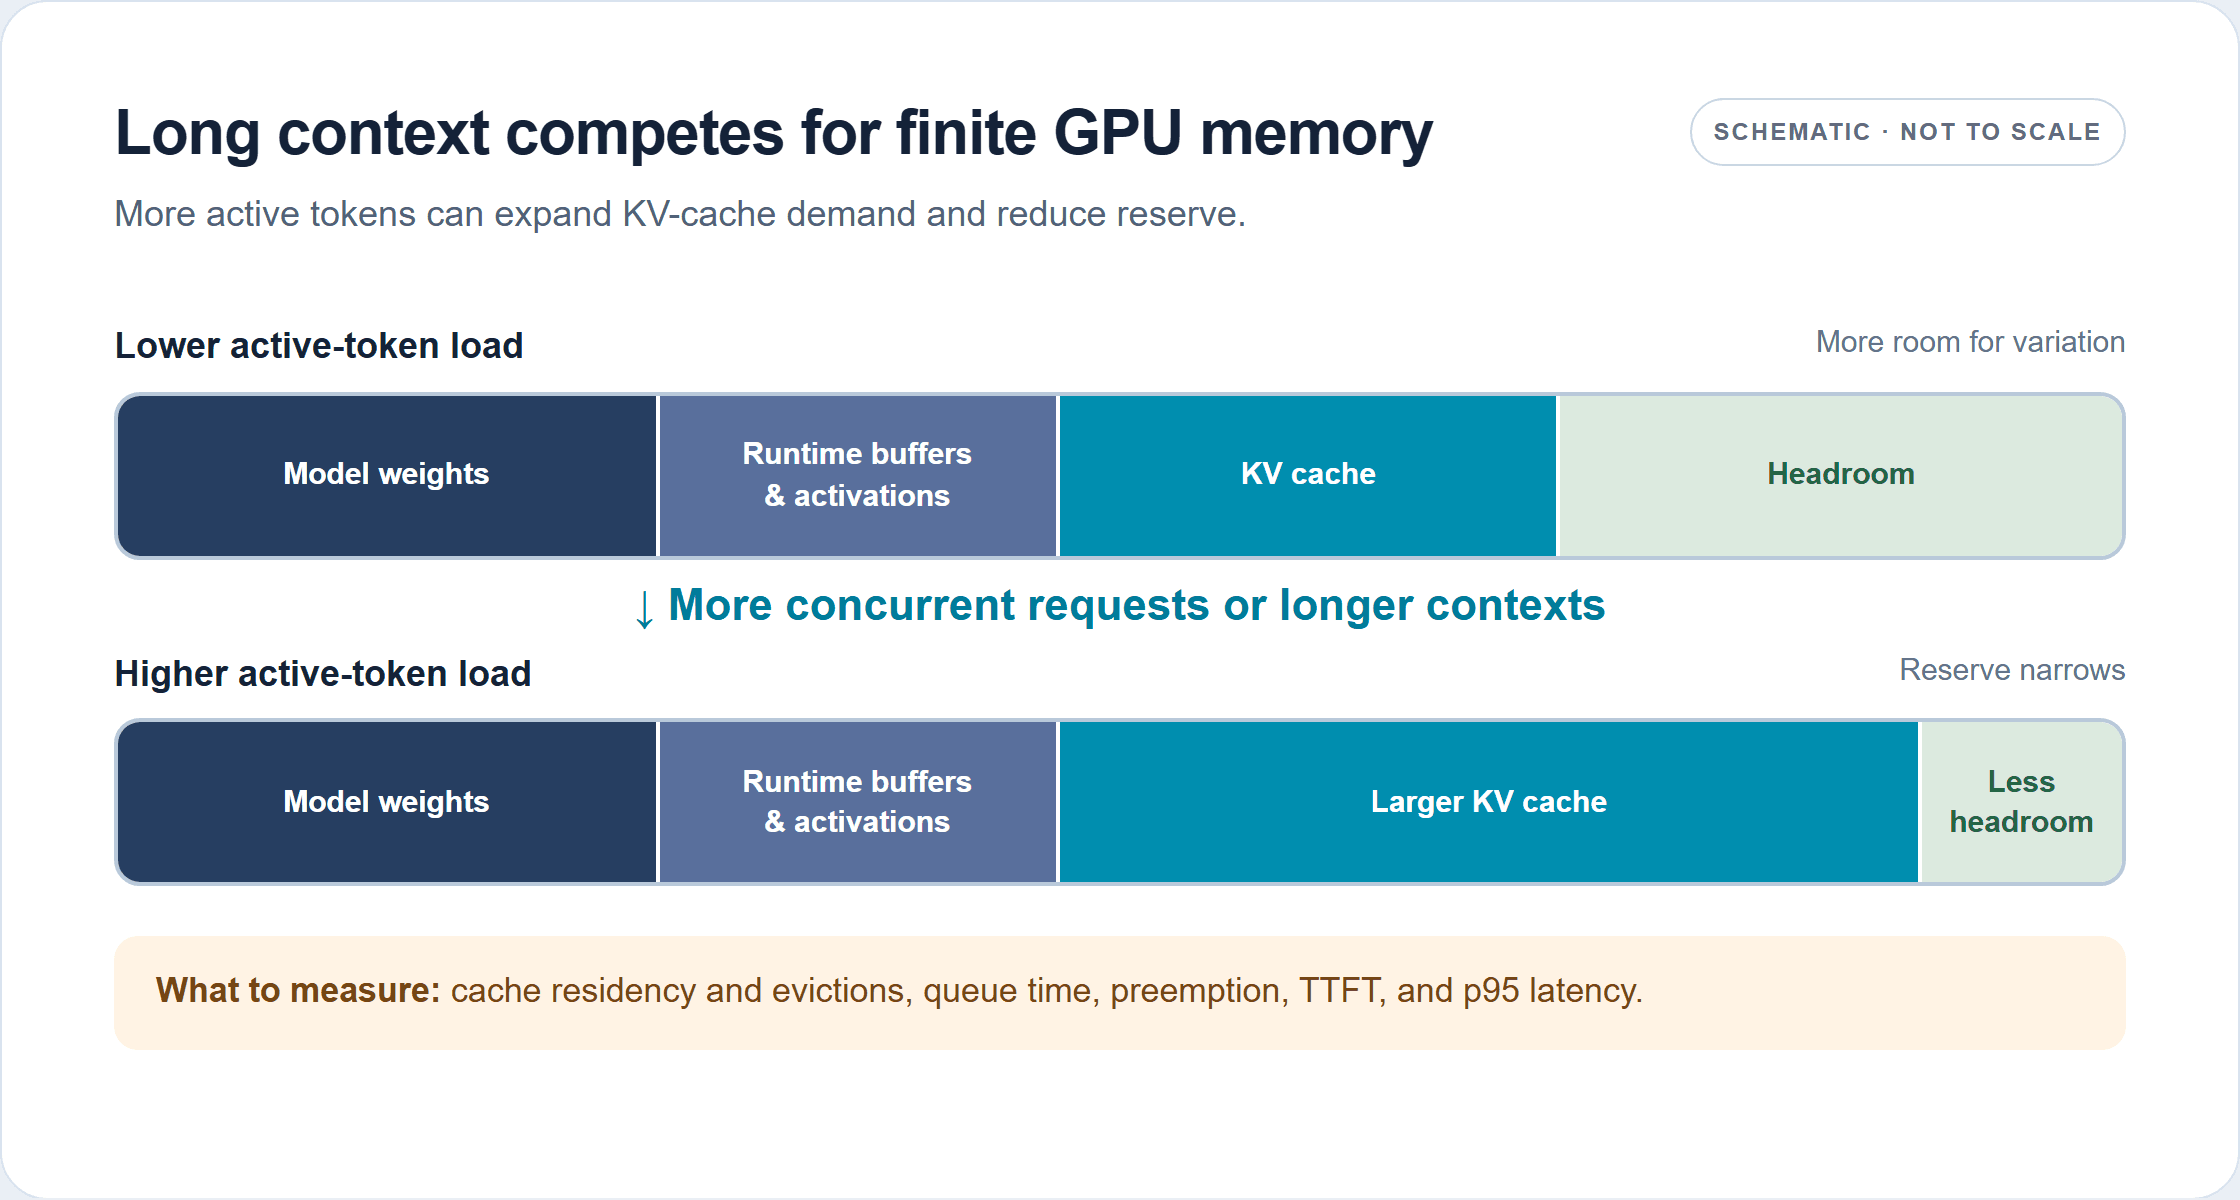
Contesti più lunghi o più richieste concorrenti possono aumentare la domanda di KV cache. I blocchi di memoria sono schematici e non in scala.
Tratta quantizzazione, precisione della KV cache, parallelismo tensor, parallelismo expert e disaggregazione prefill/decode come esperimenti separati. Possono cambiare uso della memoria, comunicazione, selezione dei kernel, qualità dell'output e latenza. Il layout migliore dipende dal tipo di GPU e dall'interconnect; aggiungere più GPU può aumentare i costi di comunicazione o lasciare alcune risorse inattive. Verifica la qualità esatta dell'output e le modalità di errore dopo aver cambiato precisione o esecuzione del modello.
La sequenza pratica è semplice: riproduci la baseline, individua la metrica che non raggiunge il suo obiettivo, formula un'ipotesi sul collo di bottiglia, cambia un'impostazione e ripeti. Se l'impostazione migliora una metrica danneggiandone un'altra, decidi esplicitamente se quel compromesso è adatto al prodotto. Questo rende l'ottimizzazione una decisione controllata invece di un mucchio di flag.
Convalida la decodifica speculativa e ogni velocità dichiarata
La decodifica speculativa può ridurre il lavoro seriale sul modello target quando i token draft vengono accettati in modo efficiente e il runtime implementa bene la verifica. Il suo beneficio dipende dal percorso draft, dal comportamento di accettazione, dalla forma del batch, dall'hardware e dal mix di prompt/output. Può aiutare il traffico limitato dalla decodifica e avere poco valore quando dominano prefill, accodamento o comunicazione.
Esegui un test A/B con speculazione abilitata e disabilitata. Mantieni fissi checkpoint del modello, set di prompt, limite di token, pattern di arrivo, concorrenza, riscaldamento e finestra di misurazione. Registra i token accettati per passo di verifica, se disponibili, insieme a throughput aggregato, velocità per richiesta, TTFT, latenza p95, uso GPU, fallimenti e qualità del task. Una lunghezza di accettazione simulata in un benchmark pubblicato è una condizione di test, non un valore da assumere per i tuoi prompt.
Un aumento di velocità dichiarato è utile solo se supera tre controlli: lo stesso obiettivo di servizio, una qualità delle risposte accettabile e un confronto equo dei costi. Riporta il contesto completo con qualsiasi numero tu pubblichi. Evita di confrontare diversi numeri di GPU, lunghezze dei prompt, lunghezze di output, modalità di precisione, revisioni del modello o metriche come se fossero un esperimento controllato.
Self-hosting o usare un'API gestita DeepSeek V4.1 Flash?
Il self-hosting ha senso quando il traffico è abbastanza stabile da mantenere utili le GPU, il team può gestire l'infrastruttura di inferenza e il controllo su hardware o esecuzione giustifica il lavoro operativo. Includi il costo completo di acceleratori, margine di capacità, alimentazione, rete, storage, manutenzione e tempo di ingegneria. Un risultato elevato di token/s di picco da solo non stabilisce un costo inferiore per attività riuscita.
Un'API gestita è utile quando un team deve convalidare rapidamente la domanda di prodotto, evitare di gestire una flotta di serving o confrontare una baseline API con il proprio deployment. Atlas Cloud elenca DeepSeek V4.1 Flash con l'ID modello deepseek-ai/deepseek-v4.1-flash e un'API compatibile con OpenAI. La pagina del modello DeepSeek V4.1 Flash attualmente mostra $0.30 per milione di token di input, $1.20 per milione di token di output e $0.03 per milione di token di lettura cache, senza sconti visualizzati a ottobre 2026. Controlla il listino prezzi corrente prima di stimare la spesa. Un endpoint gestito non elimina la necessità di misurare la latenza delle tue richieste o l'economia del tuo traffico.
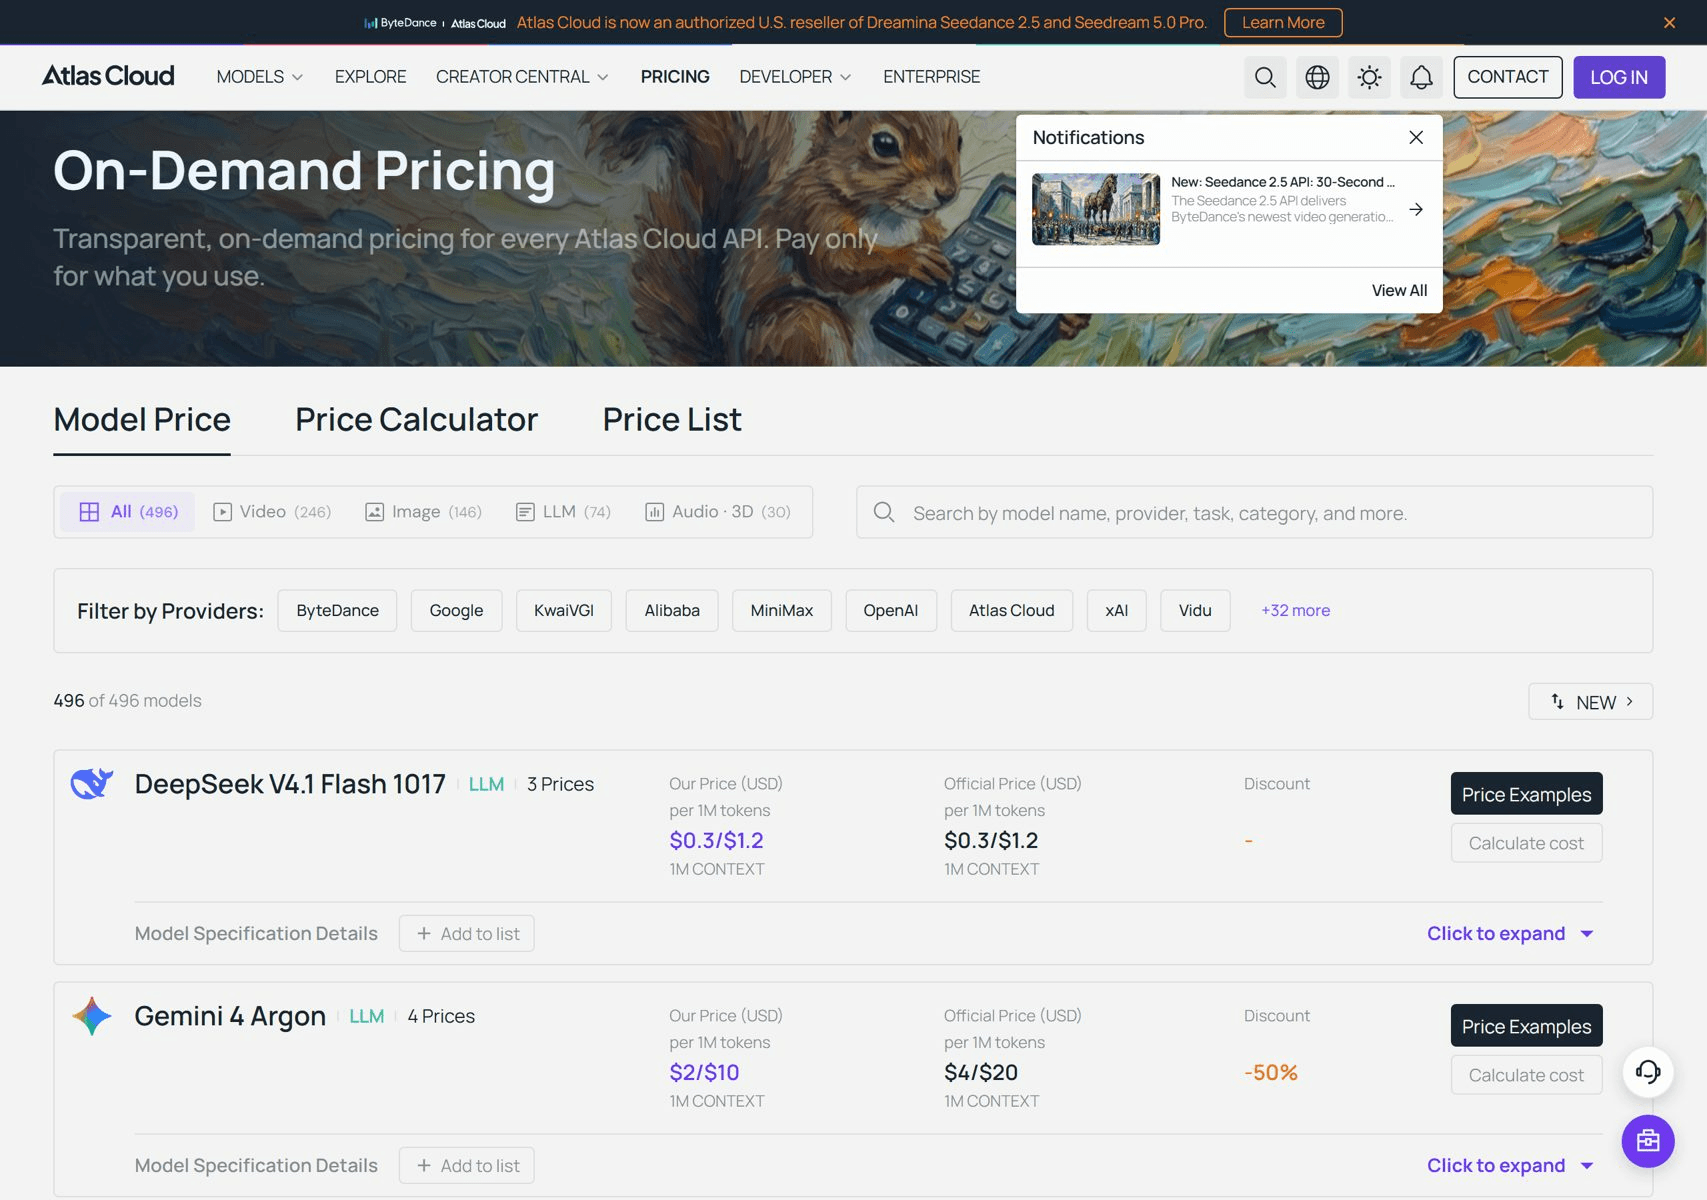
La pagina identifica un'opzione API gestita; non è un benchmark di serving.
Per una decisione di deployment equa, riproduci le stesse richieste di business contro il servizio self-hosted e l'endpoint gestito. Confronta costo per attività completata, distribuzione della latenza, affidabilità e tempo del personale necessario per mantenere ciascuna opzione. Se il tuo obiettivo principale è l'ottimizzazione del throughput di inferenza di DeepSeek V4.1 Flash, mantieni lo stesso carico di lavoro e gli stessi criteri di successo per entrambi i percorsi.
Domande frequenti
Qual è la differenza tra throughput e token al secondo per utente?
Il throughput aggregato conteggia l'output su tutte le richieste attive. I token/s per utente misurano la velocità di decodifica di una richiesta. Il batching può aumentare il primo e ridurre il secondo, quindi riporta entrambi per i servizi interattivi.
Aumentare la concorrenza migliora sempre il throughput?
No. L'output aggregato può salire finché calcolo o memoria si saturano, poi appiattirsi. Accodamento e latenza di coda possono continuare a peggiorare dopo quel punto. Interrompi l'aumento della concorrenza quando l'obiettivo di servizio viene meno.
I numeri di benchmark di vLLM e SGLang possono essere confrontati direttamente?
Solo se revisione del modello, hardware, lunghezze di prompt e output, concorrenza, stato caldo, confine di misurazione e vincolo di latenza coincidono. I report pubblicati usano configurazioni diverse, quindi dimostrano percorsi di ottimizzazione anziché un vincitore diretto tra runtime.
Quando dovrei usare un'API gestita invece del self-hosting?
Usa un'API gestita quando velocità di integrazione e minor lavoro infrastrutturale contano più del possesso dello stack di serving. Fai self-hosting quando utilizzo, competenza operativa, controllo e un caso di costo totale misurato giustificano l'esecuzione delle GPU.





