Una finestra di contesto da un milione di token indica quanto testo un modello può accettare, non quanto affidabilmente interpreterà ogni clausola. Per l'accuratezza di DeepSeek V4.1 Flash nell'analisi di documenti lunghi, le prove pubbliche sono utili ma incomplete: la scheda modello di DeepSeek riporta 45.2 di corrispondenza esatta su LongBench-V2 per il modello base V4.1 Flash in un setup 1-shot, mentre l'API è passata a una build 1017 più recente. Quel benchmark è un segnale su un singolo setup di valutazione, non un tasso di successo per il tuo contratto, rapporto annuale o archivio di ricerca.
La risposta pratica è usare Flash per il recupero rapido e una prima sintesi, quindi richiedere prove a livello di pagina e revisione umana per le decisioni che contano. Nessuna fonte pubblica citata qui fornisce una valutazione riproducibile della build corrente per i cinque compiti documentali di seguito. Il piano di test è un protocollo pronto all'uso, non un'affermazione che tali esecuzioni siano già avvenute.
Punti chiave
- La famiglia di modelli supporta fino a 1M di token, ma un limite di contesto non è una garanzia di accuratezza.
- Il punteggio pubblicato di 45.2 su LongBench-V2 è per il modello base e un setup di benchmark 1-shot.
- L'API di DeepSeek ora serve V4.1-Flash-1017; le sue note di rilascio non pubblicano un nuovo punteggio per documenti lunghi.
- Chiedi le posizioni delle prove, confrontale con la fonte e misura gli errori sui tuoi documenti.
Cosa significa la finestra da 1M di token per l'analisi dei documenti
La scheda modello di DeepSeek descrive V4.1 Flash come supportante contesti fino a un milione di token. La documentazione API attualmente identifica il modello servito come DeepSeek-V4.1-Flash-1017 e elenca una lunghezza di contesto di 1M. Queste sono specifiche di capacità. Non stabiliscono con quale frequenza il modello trovi una nota a piè di pagina, mantenga separate due versioni di un documento o ammetta che un fatto richiesto è assente. (Scheda modello DeepSeek)
Un token non è una pagina. Il numero di pagine varia con tabelle, note a piè di pagina, layout, lingua e qualità dell'estrazione. Un PDF scansionato potrebbe richiedere OCR; una tabella potrebbe perdere le etichette di riga quando convertita in testo; intestazioni e elementi ripetuti della pagina possono consumare contesto senza aiutare la domanda. Anche il prompt e la risposta richiesta usano token. Un tetto nominale di un milione di token quindi non significa che ogni file da un milione di token arriverà intatto attraverso ogni interfaccia chat o client API.
Prima di un test, registra l'identificatore esatto del modello, il client e il metodo di input. Verifica se il testo estratto completo è stato inviato, se il provider lo ha troncato e se la richiesta ha raggiunto la versione del modello prevista. L'API DeepSeek attuale usa deepseek-flash per l'ultima build Flash. Se il tuo gateway o SDK usa un altro alias, registra quell'alias e verifica il suo routing. I team che impostano chiamate hosted ripetibili possono iniziare dalla piattaforma modelli di Atlas Cloud, quindi aprire la sua lista API DeepSeek V4.1 Flash.
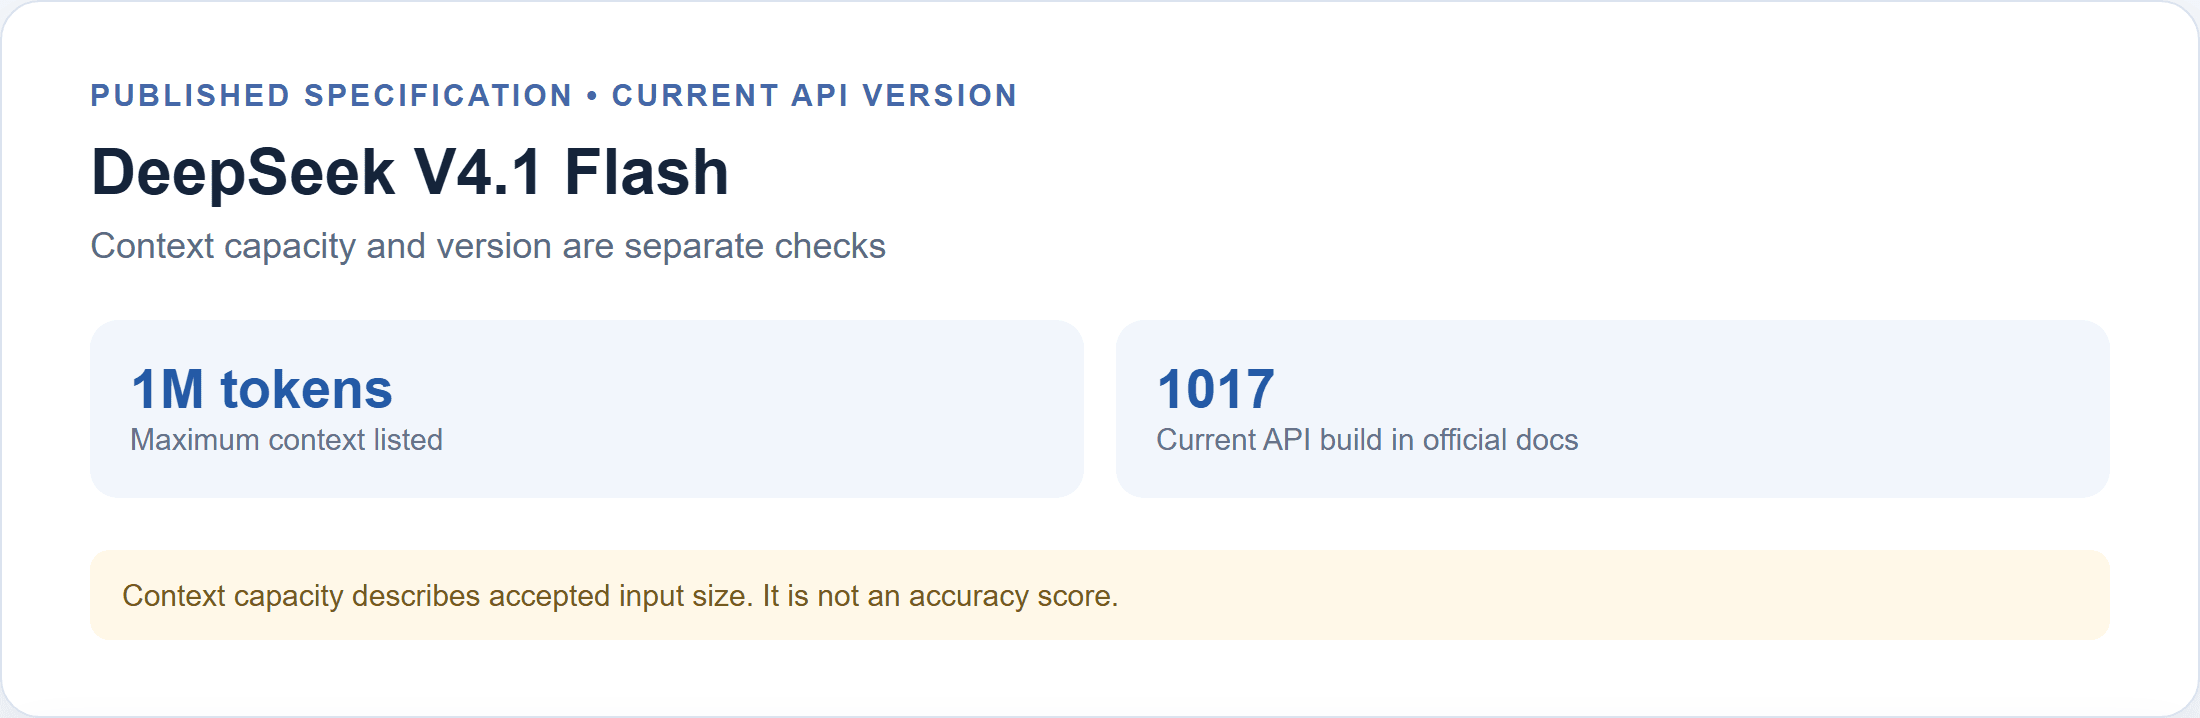
La specifica pubblicata fornisce un massimo di contesto di 1M; la documentazione API attuale identifica la build 1017.
Un caricamento o una richiesta riusciti mostrano solo che il sistema ha accettato un input. Per stabilire che un dettaglio rilevante ha influenzato la risposta, chiedi una posizione precisa, recupera quel passaggio e conferma che il testo circostante supporti l'affermazione.
Cosa mostra e cosa non mostra il punteggio LongBench-V2
La riga LongBench-V2 della scheda modello riporta punteggi di corrispondenza esatta in un'impostazione 1-shot. La sua tabella etichetta i risultati come valutazioni del modello base e afferma che tutti i modelli base usano lo stesso framework di valutazione interno. Afferma inoltre che punteggi entro 0.3 sono considerati equivalenti. I valori sono:
| Modello base nella scheda modello | LongBench-V2 (EM) | Shot |
|---|---|---|
| DeepSeek-V4-Flash-Base | 44.7 | 1 |
| DeepSeek-V4-Pro-Base | 51.5 | 1 |
| DeepSeek-V4.1-Flash-Base | 45.2 | 1 |
Il divario di 0.5 punti tra V4-Flash-Base e V4.1-Flash-Base è più ampio della banda di equivalenza di 0.3 dichiarata nella scheda, ma rimane un confronto ristretto tra benchmark. Il 45.2 non è "accuratezza del 45.2% su PDF lunghi". È un punteggio di corrispondenza esatta per un particolare modello base, set di benchmark, setup di prompt e valutatore. Non valuta direttamente un modello instruct/API hosted che risponde alle tue domande con un prompt diverso.
LongBench-V2 contiene 503 domande a scelta multipla in sei categorie, tra cui risposta a domande su documenti singoli e multipli, dialoghi lunghi, repository di codice e dati strutturati. I suoi contesti spaziano da 8.000 a 2 milioni di parole. Gli autori del benchmark riportano un'accuratezza media del 53.7% per esperti con un limite di 15 minuti, e del 50.1% per il miglior modello di risposta diretta nella loro valutazione riportata. La sua ampiezza lo rende un utile stress test, ma un numero aggregato non può diagnosticare quale operazione documentale è forte o debole. (Paper LongBench-V2)
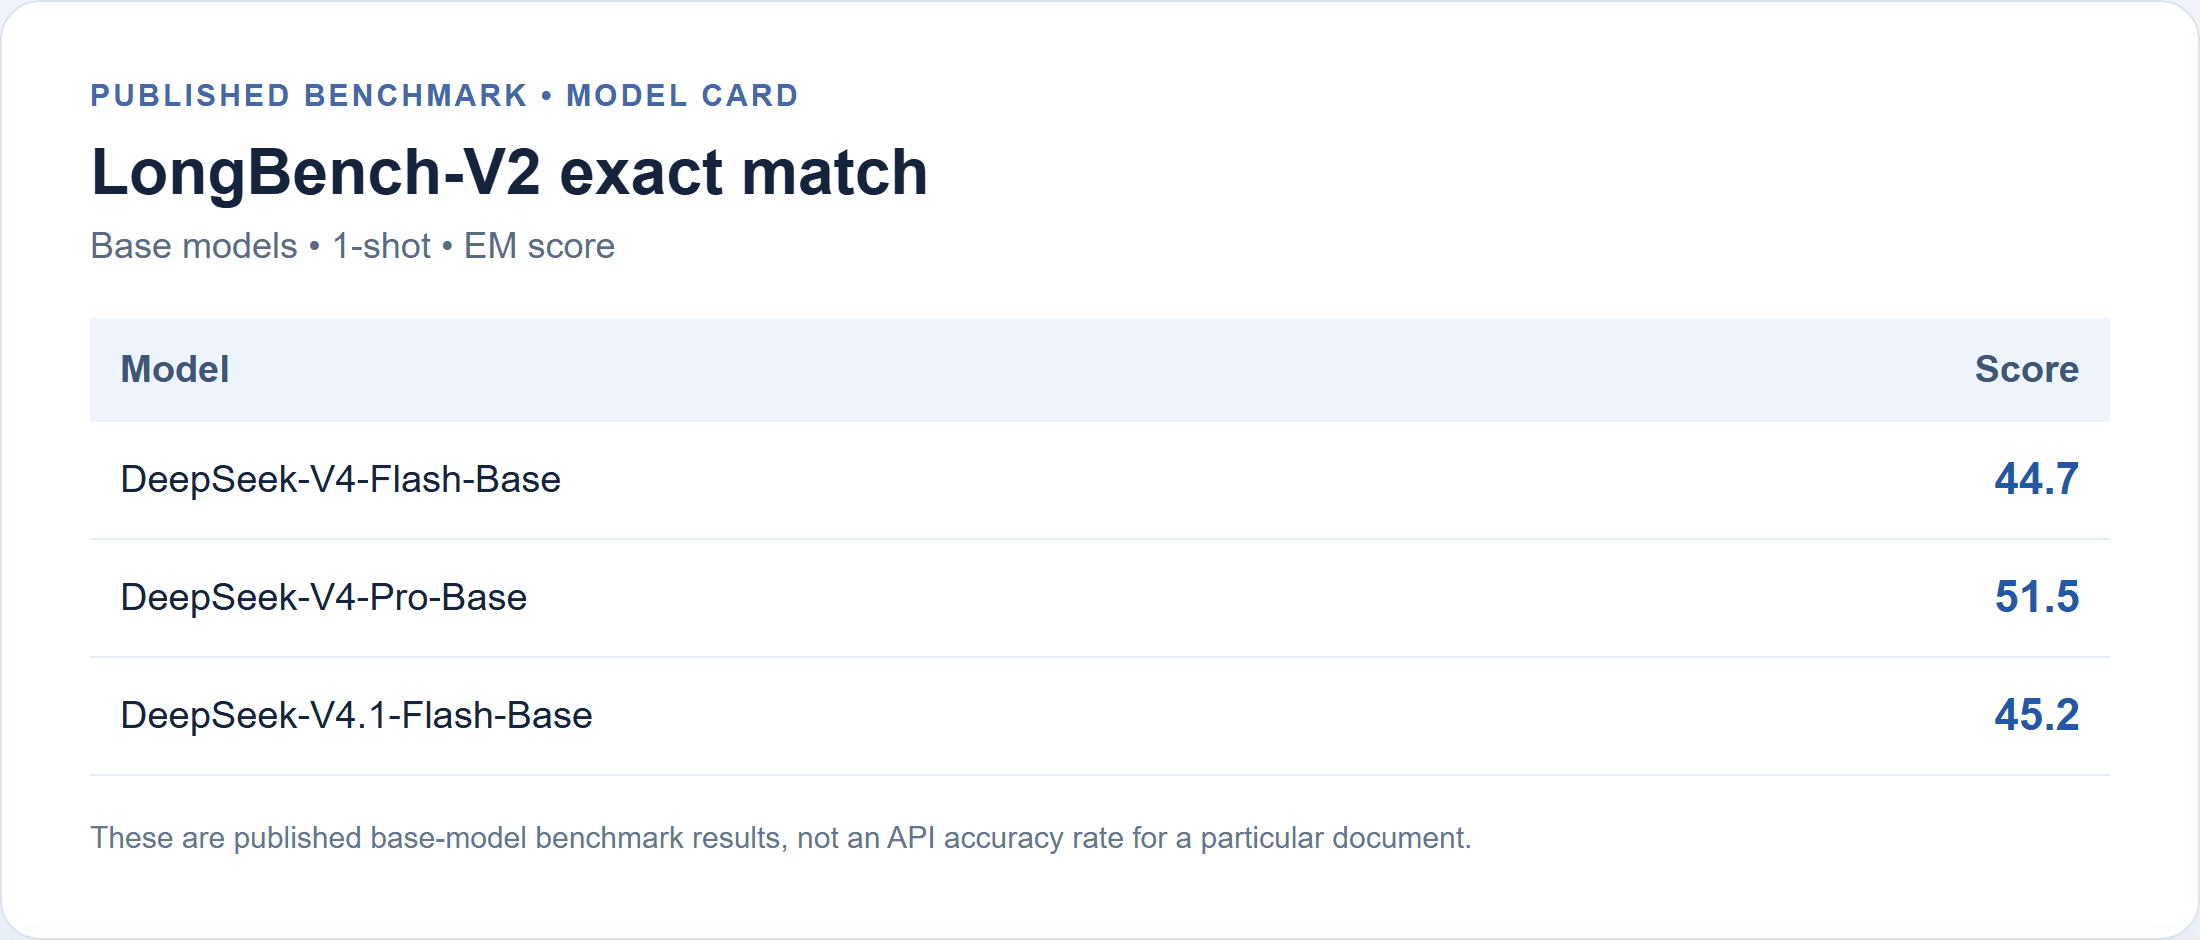
La riga pubblicata è un risultato di modello base, 1-shot. Non è un tasso di successo misurato dell'API.
C'è un'avvertenza sulla versione. Le note di rilascio del 17 ottobre di DeepSeek dicono che l'API e l'app web sono state aggiornate a V4.1-Flash-1017, e il nome del modello API rimane deepseek-flash. Le note elencano benchmark aggiornati di agenti e ragionamento, ma non riportano un nuovo risultato LongBench-V2. Quindi 45.2 rimane un utile riferimento pubblicato per il modello base V4.1 Flash, mentre l'accuratezza della build API attuale su domande relative a documenti lunghi rimane non quantificata in quelle fonti. Non trasferire miglioramenti di benchmark non correlati al QA documentale. (Aggiornamento DeepSeek V4.1-Flash-1017)
Come eseguire un test equo di accuratezza su documenti lunghi
Una valutazione utile necessita di una fonte fissa, una chiave di risposta e regole di punteggio. Inizia con un rapporto annuale o tecnico pubblico la cui versione e struttura delle pagine possano essere condivise. Salva il PDF e il testo estratto, registra l'URL di origine e la data di recupero, e annota se hai usato l'estrazione nativa del testo o l'OCR. Evita di selezionare un documento perché sai già che il modello lo gestisce bene.
Prima di interrogare il modello, scrivi tu stesso la chiave di risposta dalla fonte. Per ogni domanda, registra la risposta attesa e la pagina o sezione esatta. Ciò impedisce che una risposta convincente diventi lo standard di valutazione. Mantieni le domande sufficientemente specifiche da poter essere valutate, preservando al contempo l'ambiguità che un lettore affronterebbe realmente.
Usa lo stesso documento, set di domande, identificatore del modello, prompt, impostazione di ragionamento e formato di output per ogni esecuzione. Se l'API espone controlli di temperatura o ragionamento, registrali. Esegui il set più di una volta se vuoi stimare la variabilità; una singola esecuzione è un campione, non un tasso stabile. Non correggere silenziosamente l'output prima di valutarlo.
Un set compatto può coprire cinque diverse opportunità di fallimento:
| Compito | Esempio di forma della domanda | Cosa verificare |
|---|---|---|
| Ricerca a punto singolo | "Quale data fornisce il report per la politica rivista?" | Valore esatto e pagina citata |
| Collegamento tra sezioni | "Come si collega il rischio nella Sezione 2 al controllo nella Sezione 7?" | Entrambi i passaggi e se il collegamento è dichiarato o inferito |
| Gestione delle eccezioni | "Chi è escluso dalla copertura dichiarata?" | Nota a piè di pagina, ambito e qualificatori |
| Conflitto di versioni | "Quale valore si applica dopo la revisione, e cosa ha sostituito?" | Date, etichette di versione e entrambe le posizioni |
| Informazione mancante | "Quale periodo di conservazione specifica il report per le copie dei fornitori?" | Ammissione se il documento non dice nulla |
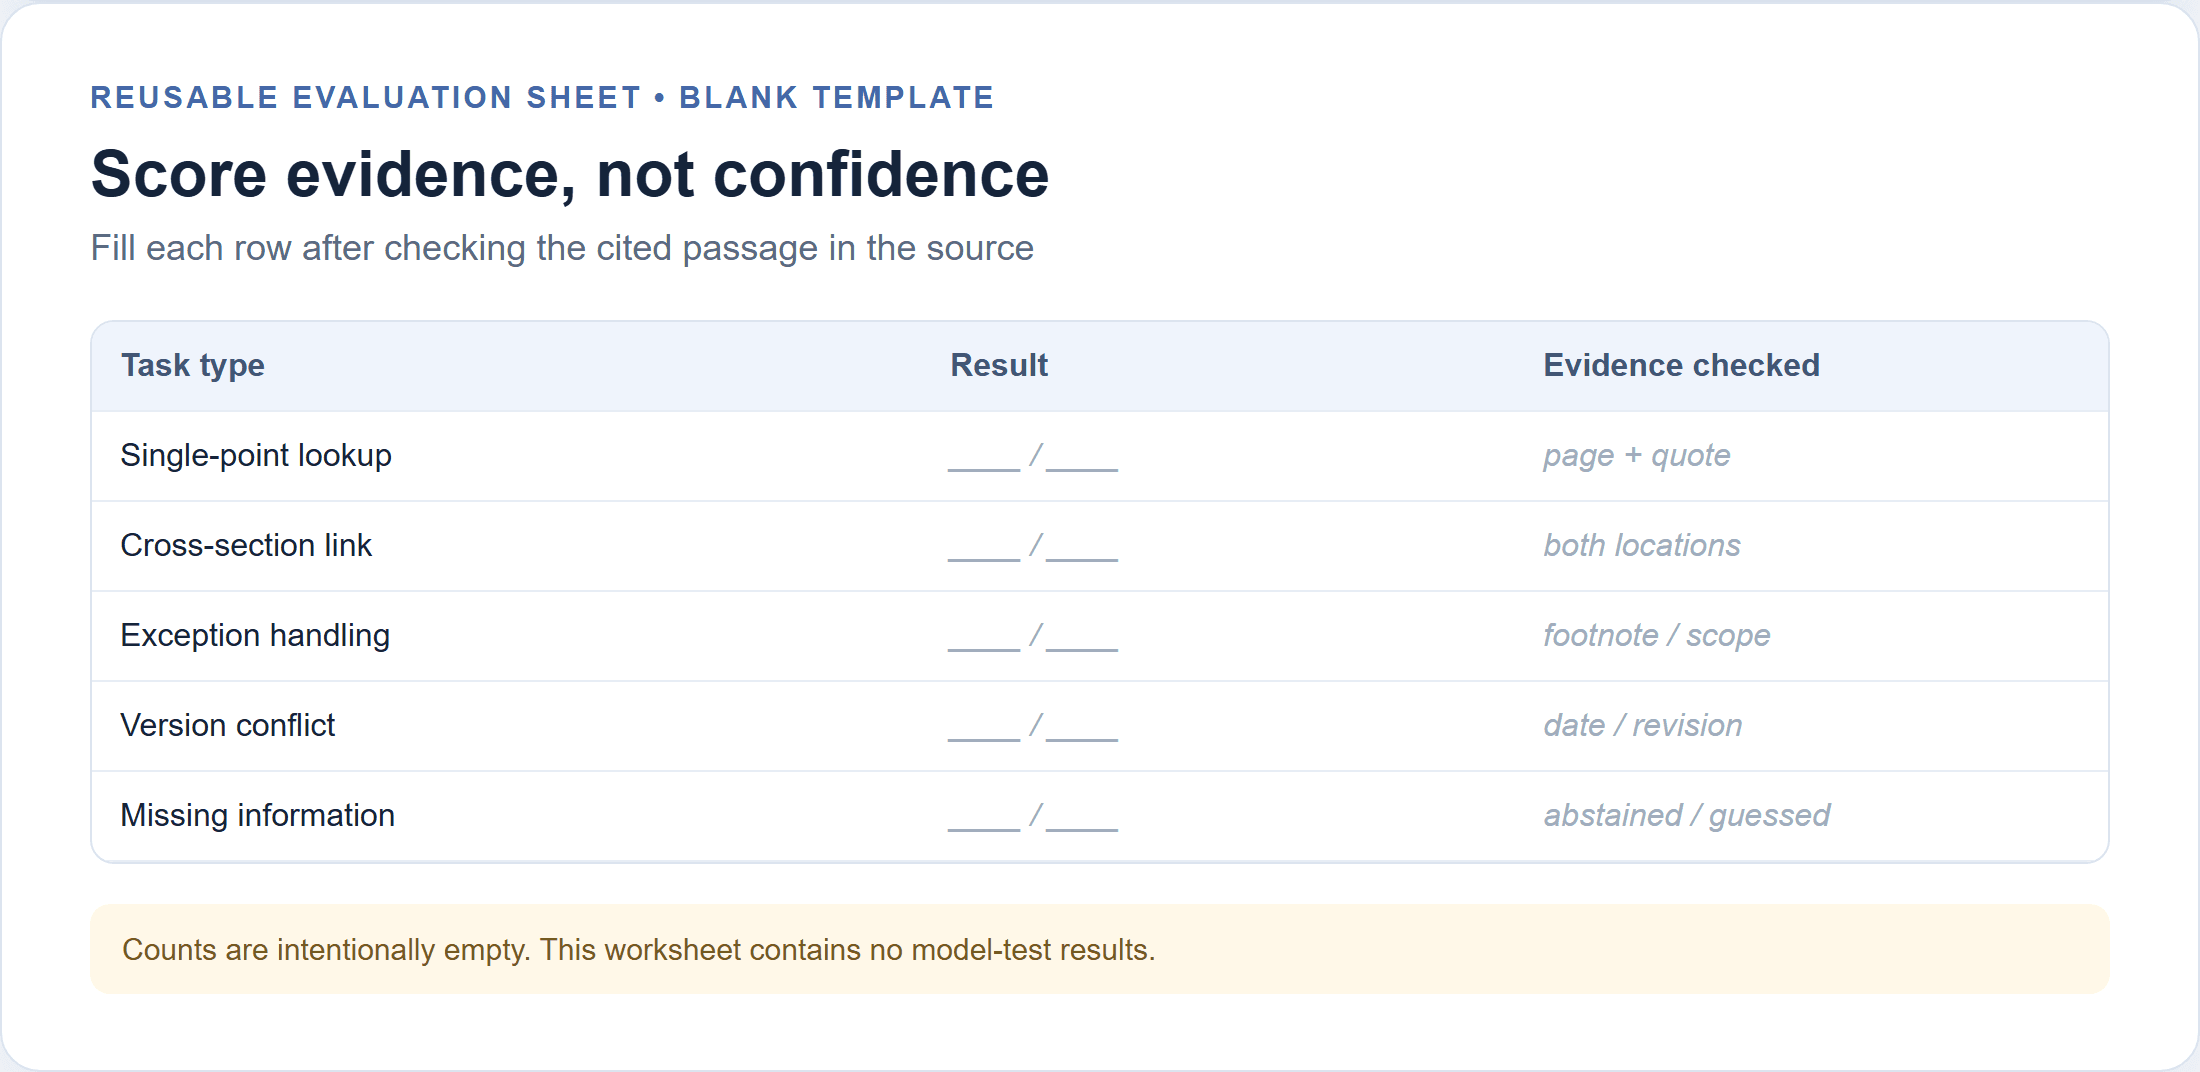
Questo è un foglio di valutazione vuoto, non una tabella di risultati. Compilalo solo dopo aver verificato ogni risposta rispetto al documento di origine.
Valuta ogni risposta come corretta, parziale, errata, non supportata o correttamente astenuta. Conta le affermazioni non supportate separatamente dalle risposte errate perché una risposta può dare la risposta principale corretta e inventare un dettaglio. Verifica se ogni citazione punta al passaggio che supporta l'affermazione. Riporta insieme il conteggio delle domande e i conteggi per categoria. Una percentuale complessiva nasconde se il modello ha mancato note a piè di pagina o ha avuto difficoltà solo quando le informazioni erano sparse tra le sezioni.
Conserva il file di origine esatto, l'estrazione, i prompt, le risposte grezze e il foglio di valutazione. Pubblica solo materiale che hai il permesso di condividere e oscura nomi o dettagli di account riservati. Un revisore dovrebbe essere in grado di tracciare ogni risposta valutata dall'output del modello a una pagina nella fonte salvata.
Dove tendono a fallire le risposte su documenti lunghi
Senza un'esecuzione sulla build corrente rispetto a un documento dichiarato, sarebbe sbagliato affermare che V4.1 Flash abbia mostrato un particolare tasso di errore o modello di fallimento. Le categorie seguenti sono cose da ispezionare, non risultati misurati su questo modello.
Inizia con la perdita di ambito. Un paragrafo del corpo può enunciare una regola mentre una nota a piè di pagina la limita a una regione, un intervallo di date o una classe di clienti. Chiedi esplicitamente l'eccezione e ispeziona se il passaggio citato la include. Una citazione dal solo paragrafo principale potrebbe essere insufficiente.
Poi controlla la confusione di versioni. I report possono ripetere valori simili in una bozza e in una sezione rivista. Chiedi al modello di indicare la data o la versione associata a ciascun valore invece di richiedere solo "il numero attuale". Se ne sceglie uno silenziosamente, valuta la risposta come incompleta anche quando sceglie correttamente per caso.
Le domande trasversali invitano all'inferenza. Un modello può combinare due fatti accurati in una spiegazione causale che il documento non fa mai. Richiedi che etichetti le affermazioni dirette separatamente dalle inferenze. Quindi confronta l'inferenza con le prove e decidi se è ragionevole per il compito.
Infine, testa l'astensione. Includi una domanda la cui risposta è assente. Una supposizione sicura è un fallimento anche se sembra plausibile. Per contratti, conformità, materiale clinico o analisi finanziaria consequenziale, chiedi a una persona qualificata di controllare il testo originale prima di usare una conclusione.
Un flusso di lavoro di verifica per risposte più sicure
Questo prompt rende le risposte più facili da verificare. Non può garantire la correttezza né sostituire la revisione della fonte. Usalo con un'estrazione che preserva le etichette di pagina, poi poni domande mirate invece di richiedere un riassunto generale di un file enorme.
plaintext1Answer using only the supplied document. 2For every factual claim, provide the page number and a short supporting quotation. 3Separate direct statements from inferences. 4If the document does not contain enough evidence, say “Not stated in the document.” 5If sources conflict, list each version and its location instead of choosing silently. 6Return a table with: question, answer, evidence location, confidence, and unresolved ambiguity.
Per un report lungo, suddividi il lavoro per compito, non automaticamente per un numero arbitrario di pagine. Prima chiedi una mappa delle fonti: titoli delle sezioni, date, termini definiti e tabelle rilevanti. Poi interroga un argomento specifico e richiedi i suoi passaggi di supporto. Per una conclusione trasversale, fornisci o recupera entrambi i passaggi nello stesso turno e chiedi al modello di spiegare il collegamento contrassegnando qualsiasi inferenza.
Usa un ciclo di verifica umana:
- Controlla la pagina citata e la citazione nel file originale.
- Conferma che la citazione includa eccezioni vicine e intestazioni di tabella.
- Contrassegna ogni affermazione come diretta, inferita, non supportata o contraddetta.
- Correggi il prompt o suddividi il compito se l'estrazione ha omesso una struttura importante.
- Salva la richiesta e la risposta grezze in modo che un revisore possa riprodurre la decisione.
Quando usi un endpoint hosted, includi l'utilizzo dei token nel log di esecuzione. La pagina dei prezzi dei modelli di Atlas Cloud attualmente elenca DeepSeek V4.1 Flash a $0.30 per 1M token di input, $1.20 per 1M token di output e $0.03 per 1M token di cache-read, senza sconti elencati. Controlla l'elenco attuale prima di fare il budget. Questo riferimento di prezzo è per Atlas Cloud, non un prezzo universale dell'API DeepSeek.
A quelle tariffe elencate, 100.000 token di input non in cache e 3.000 token di output costano circa $0.033: $0.030 per l'input più $0.0036 per l'output.
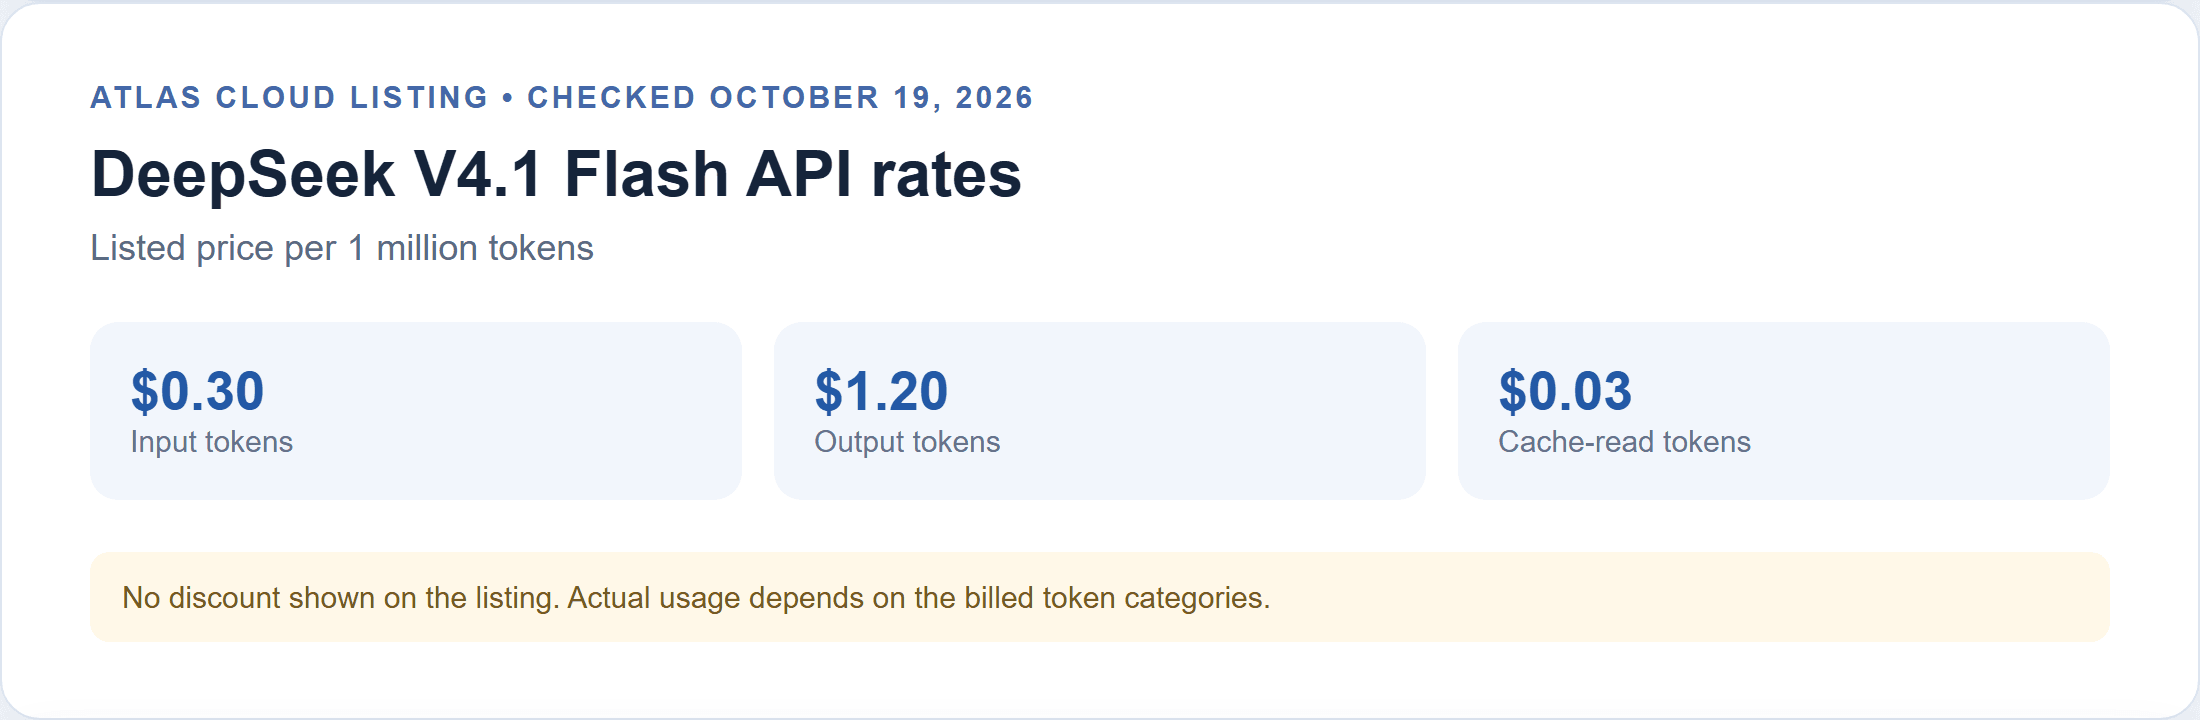
Prezzi di Atlas Cloud verificati il 19 ottobre 2026; l'elenco non mostra sconti. Un input di 1M di token e una risposta di 20.000 token costerebbero circa $0.324 alle stesse tariffe, prima del trattamento della cache o di altri elementi fatturabili. Questi sono esempi aritmetici, non bollette misurate di test documentali. L'input effettivo include il prompt e il testo estratto; le chiamate ripetute aggiungono utilizzo. Usa i conteggi dei token restituiti dal provider invece di stimare dal numero di pagine.
Quando usare DeepSeek V4.1 Flash per documenti lunghi
Flash è una prima passata ragionevole quando devi localizzare definizioni, raccogliere date, creare una mappa delle sezioni o redigere un riassunto che una persona controllerà. Quei compiti hanno tracce di prove visibili e sono facili da rieseguire con domande più precise. Per lavori ricorrenti, conserva domande con risposta nota e rieseguile quando la versione del modello, la pipeline di estrazione o il prompt cambiano.
Aggiungi controlli quando una domanda combina sezioni distanti, dipende da una nota a piè di pagina o confronta revisioni. Usa le citazioni come ausili di navigazione, non come prova di per sé. Se una risposta influenzerà un obbligo contrattuale, una posizione di conformità, una divulgazione finanziaria o un'altra decisione ad alto impatto, fai verificare ogni affermazione materiale nella fonte da un revisore qualificato.
La domanda utile è se questo modello, sulla tua versione del documento e sul tuo flusso di lavoro esatto, restituisca risposte con prove che sopravvivono al controllo. Questo è il test che può stabilire l'accuratezza di DeepSeek V4.1 Flash nell'analisi di documenti lunghi per il tuo caso d'uso.
Domande frequenti
Una finestra di contesto da 1M di token significa che un modello può analizzare accuratamente un documento da 1M di token?
No. Descrive la capacità di contesto supportata. La richiesta effettiva include anche istruzioni e budget di output, mentre estrazione, limiti dell'interfaccia e difficoltà della domanda influenzano se prove utili sono disponibili e interpretate correttamente.
LongBench-V2 è la stessa cosa dell'accuratezza nella risposta a domande su documenti?
No. Include diverse categorie di compiti a contesto lungo e riporta le prestazioni in un setup specifico. È un segnale di confronto, non una garanzia per un particolare PDF, build API, prompt o dominio.
Dovrei usare un unico prompt o dividere un documento lungo in sezioni?
Usa una mappa delle fonti e domande mirate quando la struttura conta. Mantieni i passaggi che devono essere confrontati disponibili insieme per la fase di sintesi e preserva le etichette di pagina in modo da poter verificare la risposta.
Come dovrei verificare le citazioni da un riassunto generato dall'IA?
Apri ogni pagina citata nel file originale, controlla la citazione e il testo circostante e conferma che il passaggio supporti l'affermazione specifica. Verifica intestazioni di tabella e note a piè di pagina oltre alla frase citata.
In che modo i token di input e output influenzano il costo?
I token di input coprono il documento, le istruzioni e la domanda. I token di output coprono la risposta. Prompt più lunghi, chiamate multiple e passaggi ripetuti aumentano l'utilizzo; usa i conteggi dei token fatturati e l'attuale tabella prezzi del provider per le stime.


