

Un developer vede "1M token" e si prepara a inviare un intero repository, la sua cronologia di issue e un lungo report di progettazione in un'unica richiesta. Il dettaglio chiave nella finestra di contesto da 1M di gemini 4 Argon è che 1.048.576 token sono condivisi tra input, thinking e output. Non si tratta di un milione di token di input più un altro milione per la risposta. Google indica un limite predefinito di 65.536 token per l'output sincrono, mentre la decodifica lunga può estendere la generazione fino alla capacità condivisa rimanente. La specifica del modello di Google fornisce i limiti; questa guida li trasforma in un budget e in una decisione su contesto lungo, retrieval e chunking.
Punti chiave
- Il contesto da 1.048.576 token è un budget combinato di input, thinking e output.
- L'output sincrono predefinito è limitato a 65.536 token; la decodifica lunga non aggiunge più contesto.
- Usa il contesto lungo quando contano le relazioni tra un insieme noto di fonti; usa il retrieval o il chunking quando non contano.
Cosa significa la finestra di contesto da 1M di Gemini 4 Argon?
Il budget di 1.048.576 token è condiviso
Una finestra di contesto è il limite di token disponibile per una richiesta. Per Argon, Google documenta un totale unificato di 1.048.576. Il prompt, il materiale sorgente allegato, i token di thinking e la risposta generata attingono da questa disponibilità. Descrive una capacità, non la promessa che ogni dettaglio sarà ugualmente facile da recuperare o su cui ragionare.
Se una richiesta contiene 900.000 token di sorgente, restano al massimo 148.576 tra thinking e output, prima delle restrizioni specifiche dell'interfaccia. Un'applicazione che presume di poter poi richiedere una risposta da 200.000 token ha sovraimpegnato lo stesso budget.
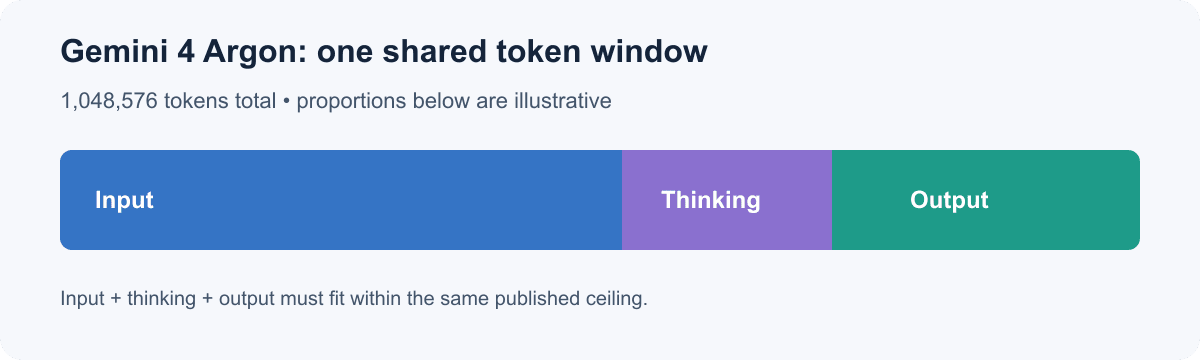
La finestra pubblicata è un unico tetto condiviso. Le dimensioni dei segmenti sono concettuali, non un'allocazione fissa.
Input, thinking e output attingono da un'unica finestra
Un'equazione utile per la pianificazione è:
input tokens + thinking tokens + output tokens <= 1,048,576
Si tratta di un controllo del budget, non dell'affermazione che gli sviluppatori possano impostare un numero esatto di token di thinking per ogni chiamata. Google elenca impostazioni di thinking basso, medio e alto; il consumo interno può variare in base all'attività e alle impostazioni. Riserva spazio per il ragionamento invece di trattare il resto teorico come capacità di risposta garantita.
Argon accetta input di testo, immagini, video, audio e PDF, con output di testo. La contabilità dei media non è equivalente al testo semplice, quindi un conteggio di file o pagine non può prevedere in modo affidabile i token totali. Ispeziona i metadati di utilizzo da una richiesta rappresentativa.
Finestra di contesto vs. limite di output: la differenza cruciale
Il limite di output predefinito
La pagina del modello elenca un output massimo di 65.536 token per la generazione sincrona predefinita, circa un sedicesimo della finestra totale. Una richiesta può rientrare nel limite di contesto complessivo e superare comunque il limite di output attivo.
Per molte applicazioni, quel valore predefinito è ampiamente sufficiente. Una revisione di repository o una sintesi di documenti di solito richiede una risposta mirata, non lunga quanto l'insieme delle fonti. Un output delimitato è più facile da rivedere, archiviare e passare a un'altra fase.
Cosa cambia la decodifica lunga
La decodifica lunga supporta una generazione molto più lunga, fino a 1.048.576 token secondo la specifica del modello. Non espande la finestra totale. Se il prompt ne occupa già la maggior parte, resta meno capacità per thinking e output. Contano anche il percorso API, l'SDK, le impostazioni della richiesta e la gestione della risposta, quindi verifica le indicazioni di integrazione attuali prima di affidarti a una risposta lunga in produzione.
Usa la decodifica lunga solo quando il risultato necessita davvero di materiale generato esteso, come una grande trasformazione strutturata restituita in un'unica operazione. Se la risposta può essere suddivisa in sezioni validate, la generazione a fasi può rendere più facile individuare e recuperare risultati incompleti.
Come pianificare i token di input, thinking e output
Parti dal risultato atteso, poi stima i token di sorgente usando il percorso di conteggio del modello selezionato, dove disponibile. Conta anche istruzioni, risultati degli strumenti, testo dello schema e cronologia della conversazione. Riserva un margine per thinking ed errore di stima invece di spendere il resto teorico.
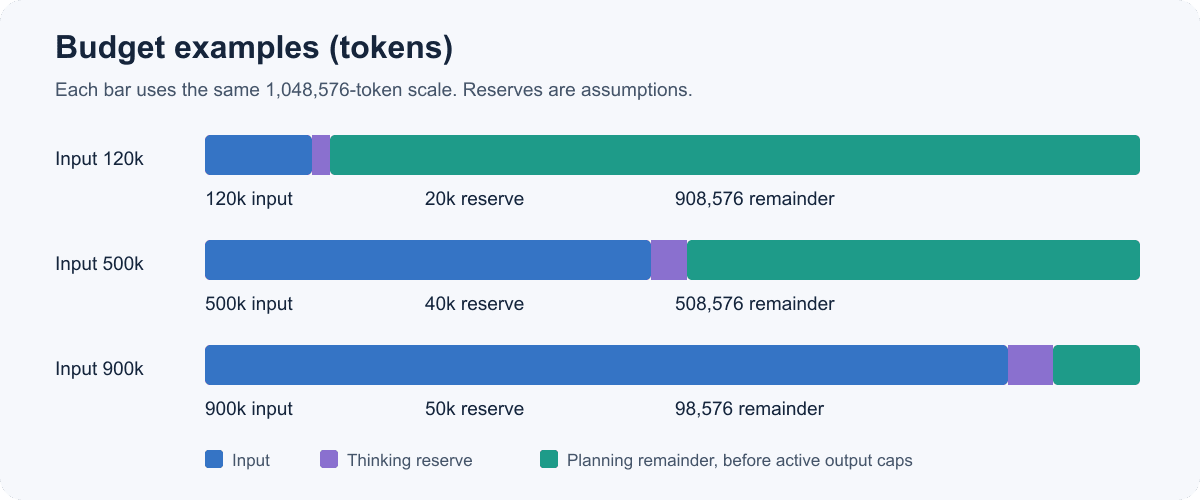
Le cifre seguenti sono esempi aritmetici, non un consumo di ragionamento fisso. Il "resto di pianificazione" è il totale dopo l'input ipotizzato e la riserva di thinking riservata. Si applicano comunque i limiti effettivi del servizio.
| Input ipotizzato | Riserva di thinking | Resto di pianificazione per l'output | Esempio |
|---|---|---|---|
| 120.000 | 20.000 | 908.576 | Diversi manuali, sintesi concisa |
| 500.000 | 40.000 | 508.576 | Revisione di codebase con riferimenti ai file |
| 900.000 | 50.000 | 98.576 | Confronto di archivi con una risposta delimitata |
Aritmetica illustrativa da un tetto di 1.048.576 token; le riserve sono ipotesi di pianificazione.
Usa questa checklist per la pianificazione delle richieste:
- Input: token stimati di sorgente e prompt.
- Thinking: riserva capacità in base alla complessità dell'attività e alle impostazioni supportate.
- Output: scegli un limite adatto al risultato atteso.
- Verifica: somma i tre importi e lascia spazio per l'errore di stima.
- Percorso: conferma che l'endpoint o l'SDK selezionato supporti la lunghezza di output e il comportamento di continuazione.
Per una revisione di codebase da 500.000 token, un team potrebbe riservare 40.000 token per il thinking e puntare a una risposta da 25.000 token. Quel piano usa 565.000 token sulla carta e lascia margine per stime imperfette o istruzioni aggiuntive. Il team dovrebbe comunque verificare l'utilizzo effettivo e i limiti di generazione configurati. La riserva è uno strumento di pianificazione, non una previsione del ragionamento privato.
Prima di un'esecuzione in batch, campiona più di un tipo di richiesta. Una breve pagina di documentazione, un modulo ricco di codice e un PDF con tabelle possono produrre conteggi di token diversi anche quando le dimensioni dei file sembrano simili. Conta input rappresentativi, poi confronta le stime con l'utilizzo restituito dall'API. Se il reporting effettivo del thinking o dell'output del modello differisce dalle tue ipotesi, aggiorna la riserva e il limite prima di aumentare la dimensione del batch. Questo piccolo passo di calibrazione aiuta a mantenere un flusso di lavoro a contesto lungo entro il suo involucro di token e budget.
Cosa entra in un milione di token?
Documenti, codice e materiale multimodale
Un milione di token può rendere plausibile l'analisi in un solo passaggio per un insieme di manuali, diversi contratti, un grande albero di sorgenti o una lunga trascrizione con note. Google ha usato illustrazioni approssimative come circa 1.500 pagine di testo o 30.000 righe di codice. Trattale come esempi di scala, non come garanzie. Layout, densità del codice, lingua, formattazione e tokenizzazione influenzano tutti il conteggio.
Per il lavoro sui repository, includi nella stima file di build, codice generato, commenti, metadati delle dipendenze, test e contesto rilevante delle issue. Poi chiediti se l'attività ha bisogno di tutto. Una revisione architetturale tra moduli può trarre vantaggio da un ampio insieme di sorgenti; una domanda su un singolo messaggio di errore probabilmente no.
Anche gli input multimodali complicano le stime. La durata di un video, il campionamento dei fotogrammi, l'audio, la risoluzione e il trattamento dell'API possono influenzare l'utilizzo e le prove che il modello vede. Per una domanda ristretta, includi solo i media rilevanti e ispeziona l'utilizzo da una richiesta rappresentativa prima di aumentare la scala.
I conteggi dei token non sono conteggi di pagine
Un token è un'unità di elaborazione del modello, non una parola, un carattere, una pagina o una riga. Identificatori, tabelle, codice sorgente e testi non in inglese possono tokenizzarsi diversamente dal testo normale. Una stima in pagine non può dirti se la tua particolare raccolta rientra.
La capacità è anche diversa dalla qualità. Rientrare nell'insieme delle fonti non prova che il modello troverà ogni eccezione nascosta, preserverà ogni dipendenza o risolverà correttamente passaggi contraddittori. La specifica stabilisce un limite, non un richiamo esaustivo o un punteggio di accuratezza specifico per l'attività. Per conclusioni rilevanti, richiedi le posizioni delle fonti e convalida le affermazioni importanti rispetto agli originali.
Quando una finestra da 1M aiuta e quando no
Il contesto lungo è più utile quando una risposta dipende da relazioni sparse in materiale che una semplice query potrebbe non recuperare. È meno convincente per domande ristrette ripetute su un corpus in evoluzione, dove il retrieval può selezionare un insieme di prove più piccolo. Questi sono compromessi di flusso di lavoro, non una classifica universale di accuratezza.
| Approccio | Consideralo quando | Compromesso |
|---|---|---|
| Richiesta a contesto lungo | Un'analisi una tantum necessita di relazioni tra un insieme noto di fonti | Un input grande può aumentare costo e latenza; verifica la copertura |
| Retrieval | Gli utenti pongono domande ripetute su un corpus in evoluzione | Indicizzazione e retrieval determinano quali prove raggiungono il modello |
| Chunking | I documenti possono essere elaborati come unità o fasi indipendenti | Le relazioni tra chunk richiedono riconciliazione |
| Ibrido | Serve un orientamento ampio seguito da verifiche mirate delle prove | Più orchestrazione e gestione dello stato |
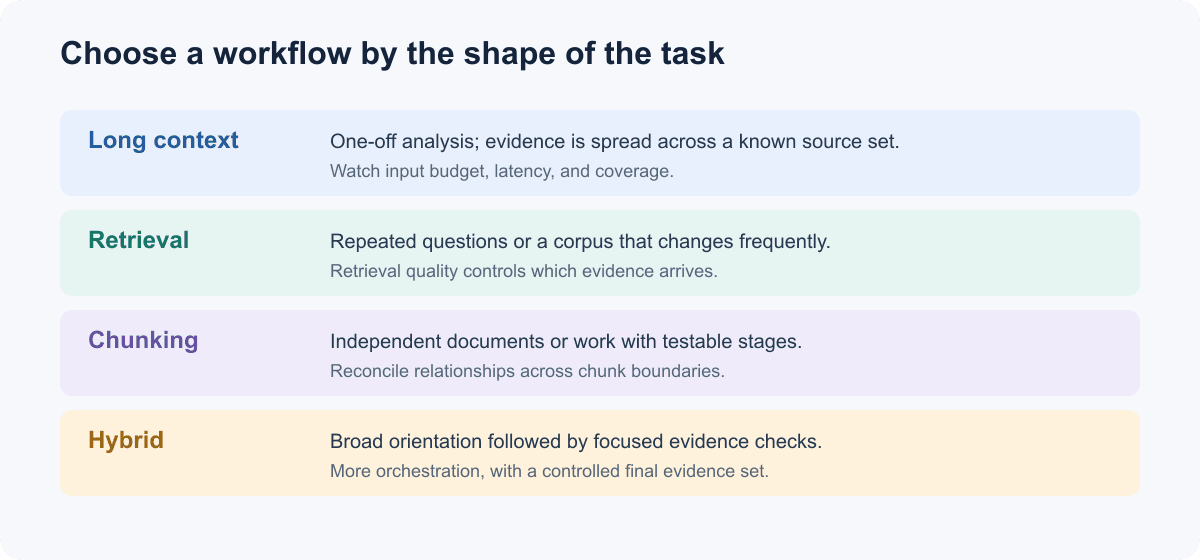 Scegli in base alla forma dell'attività e al modello di query, poi convalida su input rappresentativi.
Considera il contesto lungo per confrontare policy le cui clausole si influenzano a vicenda, rivedere una modifica su molti moduli software o sintetizzare documenti in cui un dettaglio in una fonte cambia l'interpretazione di un'altra. Il retrieval si adatta a domande di supporto ripetute su una base di conoscenza in crescita. Il chunking funziona quando le unità di sorgente sono indipendenti o ogni fase ha un output verificabile. Un flusso di lavoro ibrido può mappare prima la raccolta, poi recuperare e verificare i passaggi per una risposta finale.
Valuta le opzioni sulle stesse domande rappresentative. Tieni traccia se le prove richieste sono state incluse, se le citazioni puntano ai passaggi giusti, l'uso dei token, il tempo di risposta e lo sforzo di recupero dopo una risposta incompleta. Questo dà al tuo team prove per il suo carico di lavoro invece di presumere che una finestra più grande lo migliori automaticamente.
Usare Gemini 4 Argon per attività a contesto lungo
Conferma l'ID del modello e il percorso della richiesta
Google elenca l'ID del modello API Gemini come `gemini-4-argon`. Conferma che sia abilitato per il tuo account e che la superficie API esatta supporti le funzionalità di cui hai bisogno. Lo stesso nome di modello non garantisce che ogni proxy, SDK, console o client esponga limiti identici o lo stesso comportamento di decodifica lunga.
Prima della produzione, verifica:
- L'ID del modello e la disponibilità per il tuo account o la tua regione.
- Il limite di output sincrono e come viene richiesta o restituita la decodifica lunga.
- Se l'SDK gestisce la continuazione e come segnala risposte parziali o fallite.
- Le impostazioni di thinking supportate, gli strumenti, la cache e le modalità per l'API selezionata.
- I campi effettivi di utilizzo di input e output della richiesta.
La guida al contesto lungo di Google descrive il budget unificato. Le sue indicazioni su SDK e API possono cambiare, quindi fissa una versione supportata dell'SDK, ispeziona l'esempio attuale e fai test di integrazione con lo stesso trasporto e la stessa gestione delle risposte previsti per la produzione. Non copiare i nomi dei parametri da un'integrazione di un modello precedente senza verificare che siano ancora validi.
Rendi il contratto di output più piccolo dell'insieme delle fonti
Dai al modello un'attività delimitata e una forma di risposta. Per un audit di repository, richiedi risultati raggruppati per gravità con percorsi dei file e riferimenti di riga, e specifica se includere ipotesi o solo difetti confermati. Per un confronto di contratti, nomina le clausole e richiedi identificatori di sezione o brevi estratti di supporto. È più facile da rivedere rispetto a "analizza tutto". Per risposte grandi, pianifica la continuazione e il completamento parziale. Persisti identificatori e chunk di risposta quando l'SDK li espone, convalida l'output strutturato prima dell'uso a valle e riprova solo la parte fallita quando possibile. Queste sono salvaguardie da implementare e verificare, non l'affermazione che ogni SDK gestisca le interruzioni allo stesso modo.
Prezzi e accesso: cosa verificare prima di eseguire
L'annuncio di Google elenca attualmente tariffe introduttive di 2 $ per milione di token di input e 10 $ per milione di token di output fino al 30 novembre 2026, seguite dalle tariffe dichiarate di 4 $ e 20 $ per milione. Questo è sensibile al tempo: ricontrolla l'annuncio ufficiale di Gemini 4 Argon prima di pubblicare o prevedere la spesa. Stima input e output separatamente perché i carichi di lavoro con molti prompt e quelli con molta generazione hanno profili di costo diversi.
La disponibilità di Argon tramite Atlas Cloud non è confermata nelle pagine della directory consultate per questo articolo. Il catalogo dei modelli Atlas Gemini mostra i modelli Gemini e i dettagli di accesso attualmente elencati lì; non stabilisce che Argon sia disponibile. Conferma una pagina di dettaglio specifica del modello, un protocollo e un prezzo prima di instradare richieste o confrontare costi.
Inizia con una richiesta rappresentativa e registra versioni di modello e SDK, utilizzo dei token, latenza, errori e controlli di qualità specifici dell'attività. Rivedi il budget e la scelta del retrieval quando cambiano gli insiemi di fonti o i modelli di query. La finestra di contesto da 1M di Gemini 4 Argon è utile quando la sua ampiezza risolve un vero problema tra più fonti e la tua richiesta ha un budget chiaro e un piano di verifica.
Domande frequenti
La finestra da 1M di Gemini 4 Argon è condivisa tra input e output?
Sì. Google definisce un'unica finestra da 1.048.576 token condivisa tra input, thinking e output. La quantità rimasta per una risposta dipende dalla richiesta e dai limiti applicabili dell'interfaccia.
Qual è il limite di output predefinito di Gemini 4 Argon?
La specifica elenca 65.536 token per l'output sincrono predefinito. La decodifica lunga può supportare una generazione maggiore, soggetta alla capacità condivisa rimanente e al percorso API.
Gemini 4 Argon può generare 1M di token in una sola risposta?
La pagina del modello elenca la decodifica lunga fino a 1.048.576 token di output, ma questa è una capacità massima, non la garanzia che una richiesta contenente input possa anche restituire un milione di token. Input e thinking occupano la stessa finestra totale.
Una finestra di contesto da 1M significa che ogni dettaglio sarà ricordato con precisione?
No. Descrive il budget massimo di token, non un recupero o un ragionamento perfetti. Richiedi riferimenti alle prove e testa casi limite noti dal tuo materiale.
Gemini 4 Argon è attualmente disponibile tramite Atlas Cloud?
Non ho potuto confermare una scheda o pagina di dettaglio specifica di Argon nel catalogo Atlas Cloud consultato per questo articolo. Controlla la directory attuale prima di presumere il supporto; il link al catalogo Gemini sopra non stabilisce di per sé la disponibilità di Argon.


