

Un video caricato può contenere la risposta che cerchi e ciononostante essere interpretato erroneamente. Gemini 4 Argon può accettare in input testo, immagini, video, audio e PDF, per poi restituire testo che analizza o collega i dettagli tra questi materiali. Le capacità multimodali di gemini 4 Argon sono più utili quando il tuo compito è esaminare materiale esistente, non creare nuovi contenuti multimediali. Il suo limite di contesto unificato è di 1.048.576 token, ma si tratta di un limite di capacità, non di una garanzia di accuratezza. Di seguito una guida attività per attività su ciò che può analizzare, come verificare la risposta e dove si collocano l'API attuale e Atlas Cloud.
Punti chiave
- Argon accetta input di testo, immagini, video, audio e PDF; il suo output documentato è testo.
- Il contesto di 1.048.576 token è condiviso tra input e output. L'output sincrono predefinito è limitato a 65.536 token.
- La generazione di immagini, la generazione di audio e la Live API non sono supportate dal modello Argon.
- Verifica le affermazioni rispetto a numeri di pagina, timestamp o prove visibili prima di utilizzarle in un flusso di lavoro.
Cosa significa "multimodale" per Gemini 4 Argon
Per la Gemini API, multimodale significa che Argon può ricevere diversi tipi di materiale di origine in una richiesta e ragionare su quel materiale insieme alle istruzioni testuali. L'attuale pagina del modello Gemini API elenca input di testo, immagini, video, audio e PDF, con testo come output. Elenca inoltre output strutturato, function calling, esecuzione di codice, ricerca nei file e search grounding tra le capacità supportate. Questi strumenti possono modellare un flusso di lavoro, ma non trasformano la modalità di output in un'immagine, una traccia audio o un flusso di conversazione in tempo reale. (Google AI for Developers, ottobre 2026)
Le cifre relative ai token richiedono un'attenta lettura. Google elenca una finestra di contesto unificata di 1.048.576 token per input e output combinati. Una normale richiesta sincrona ha un output massimo di 65.536 token; la decodifica lunga può raggiungere fino a 1.048.576 nel suo flusso documentato di continuazione in background. Se il tuo prompt e il contenuto allegato consumano la maggior parte della finestra condivisa, rimane meno spazio per il ragionamento e il testo della risposta. Il titolo "contesto da 1M" non significa che ogni richiesta da un milione di token rientri in una singola risposta ordinaria.
| Materiale fornito | Input documentato? | Output di Argon | Un primo compito utile | Prove da verificare |
|---|---|---|---|---|
| Testo e PDF | Sì | Testo | Riassumi un report o confronta affermazioni tra sezioni | Pagina, intestazione, riga di tabella o passaggio citato |
| Immagine | Sì | Testo | Leggi un grafico, identifica oggetti o confronta due immagini | Etichette, valori, posizioni e ritaglio dell'immagine |
| Video | Sì | Testo | Descrivi l'ordine degli eventi o trova un momento in una clip | Timestamp e il fotogramma effettivo |
| Audio | Sì | Testo | Rispondi a domande su una registrazione caricata | Segmento audio, trascrizione, parlante o suono |
| Media generati | Nessuna generazione di immagini/audio elencata | Testo | Restituisci un'analisi scritta o un risultato strutturato | Schema e supporto delle fonti |
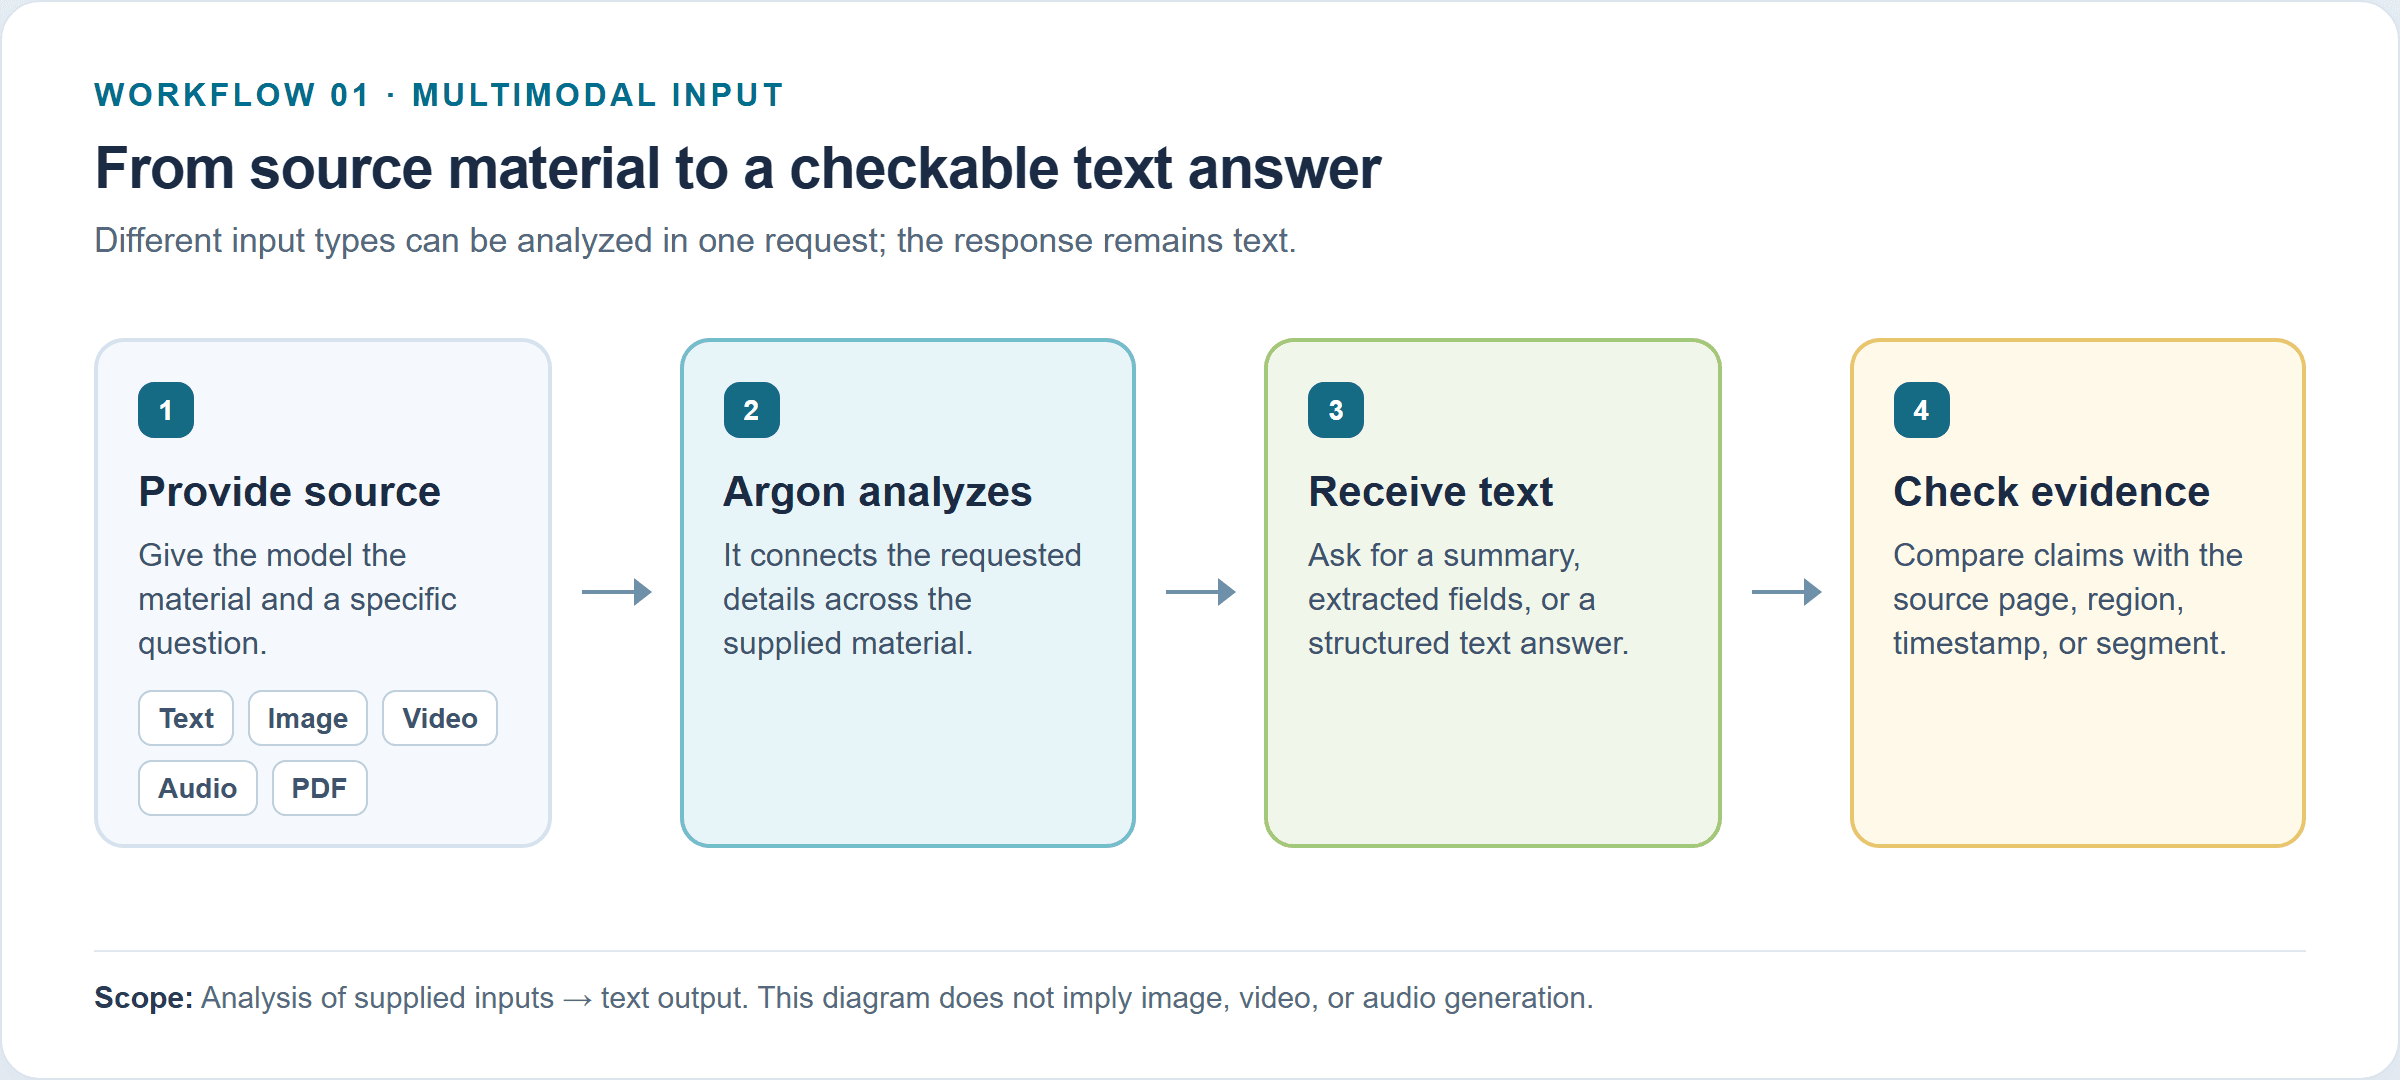 Illustrazione del flusso di lavoro: testo, immagini, video, audio o PDF forniti vengono analizzati in una risposta testuale, poi verificati rispetto alle prove di origine.
L'app Gemini può offrire funzionalità che compongono o creano media tramite altri modelli e strumenti. Non dare per scontato che tali funzionalità a livello di app siano capacità del modello API gemini-4-argon stesso. Per una decisione di implementazione, usa la tabella delle capacità API e l'ID esatto del modello anziché un'etichetta di famiglia di prodotti.
Cosa può analizzare Gemini 4 Argon in immagini, video, audio e PDF
Il modo migliore per decidere se Argon è adatto è nominare le prove di cui il tuo compito ha bisogno. "Comprendere un video" è troppo generico. "Trova ogni volta che l'operatore mette un pezzo nel vassoio, poi cita il timestamp" è verificabile.
Immagini: esamina, confronta ed estrai informazioni visive
Una richiesta con immagine può chiedere ad Argon di descrivere una scena, confrontare due immagini fornite, estrarre testo visibile, interpretare un grafico o restituire risultati visivi in un formato strutturato. Queste sono attività di analisi: l'output è testo o testo strutturato. Possono aiutare un team di supporto a smistare foto di prodotti, un ricercatore a scansionare figure o un operatore a estrarre etichette da un set di immagini.
I test indipendenti offrono un utile riscontro di realtà, a condizione che li si tratti come una singola configurazione di benchmark e non come una previsione per le proprie immagini. Vision Evals di Roboflow di ottobre 2026 riporta Argon tra i modelli migliori nelle sue attività testate di object detection, OCR e ragionamento visivo. La sua valutazione OCR separa la trascrizione esatta e le sottoattività correlate, e il suo articolo segnala punti deboli come testo piccolo o sfocato e letture visive più difficili. La sua configurazione, le immagini selezionate, i prompt e il punteggio definiscono quei risultati; non stabiliscono un tasso di successo generale per ogni scansione o grafico. (Roboflow, ottobre 2026)
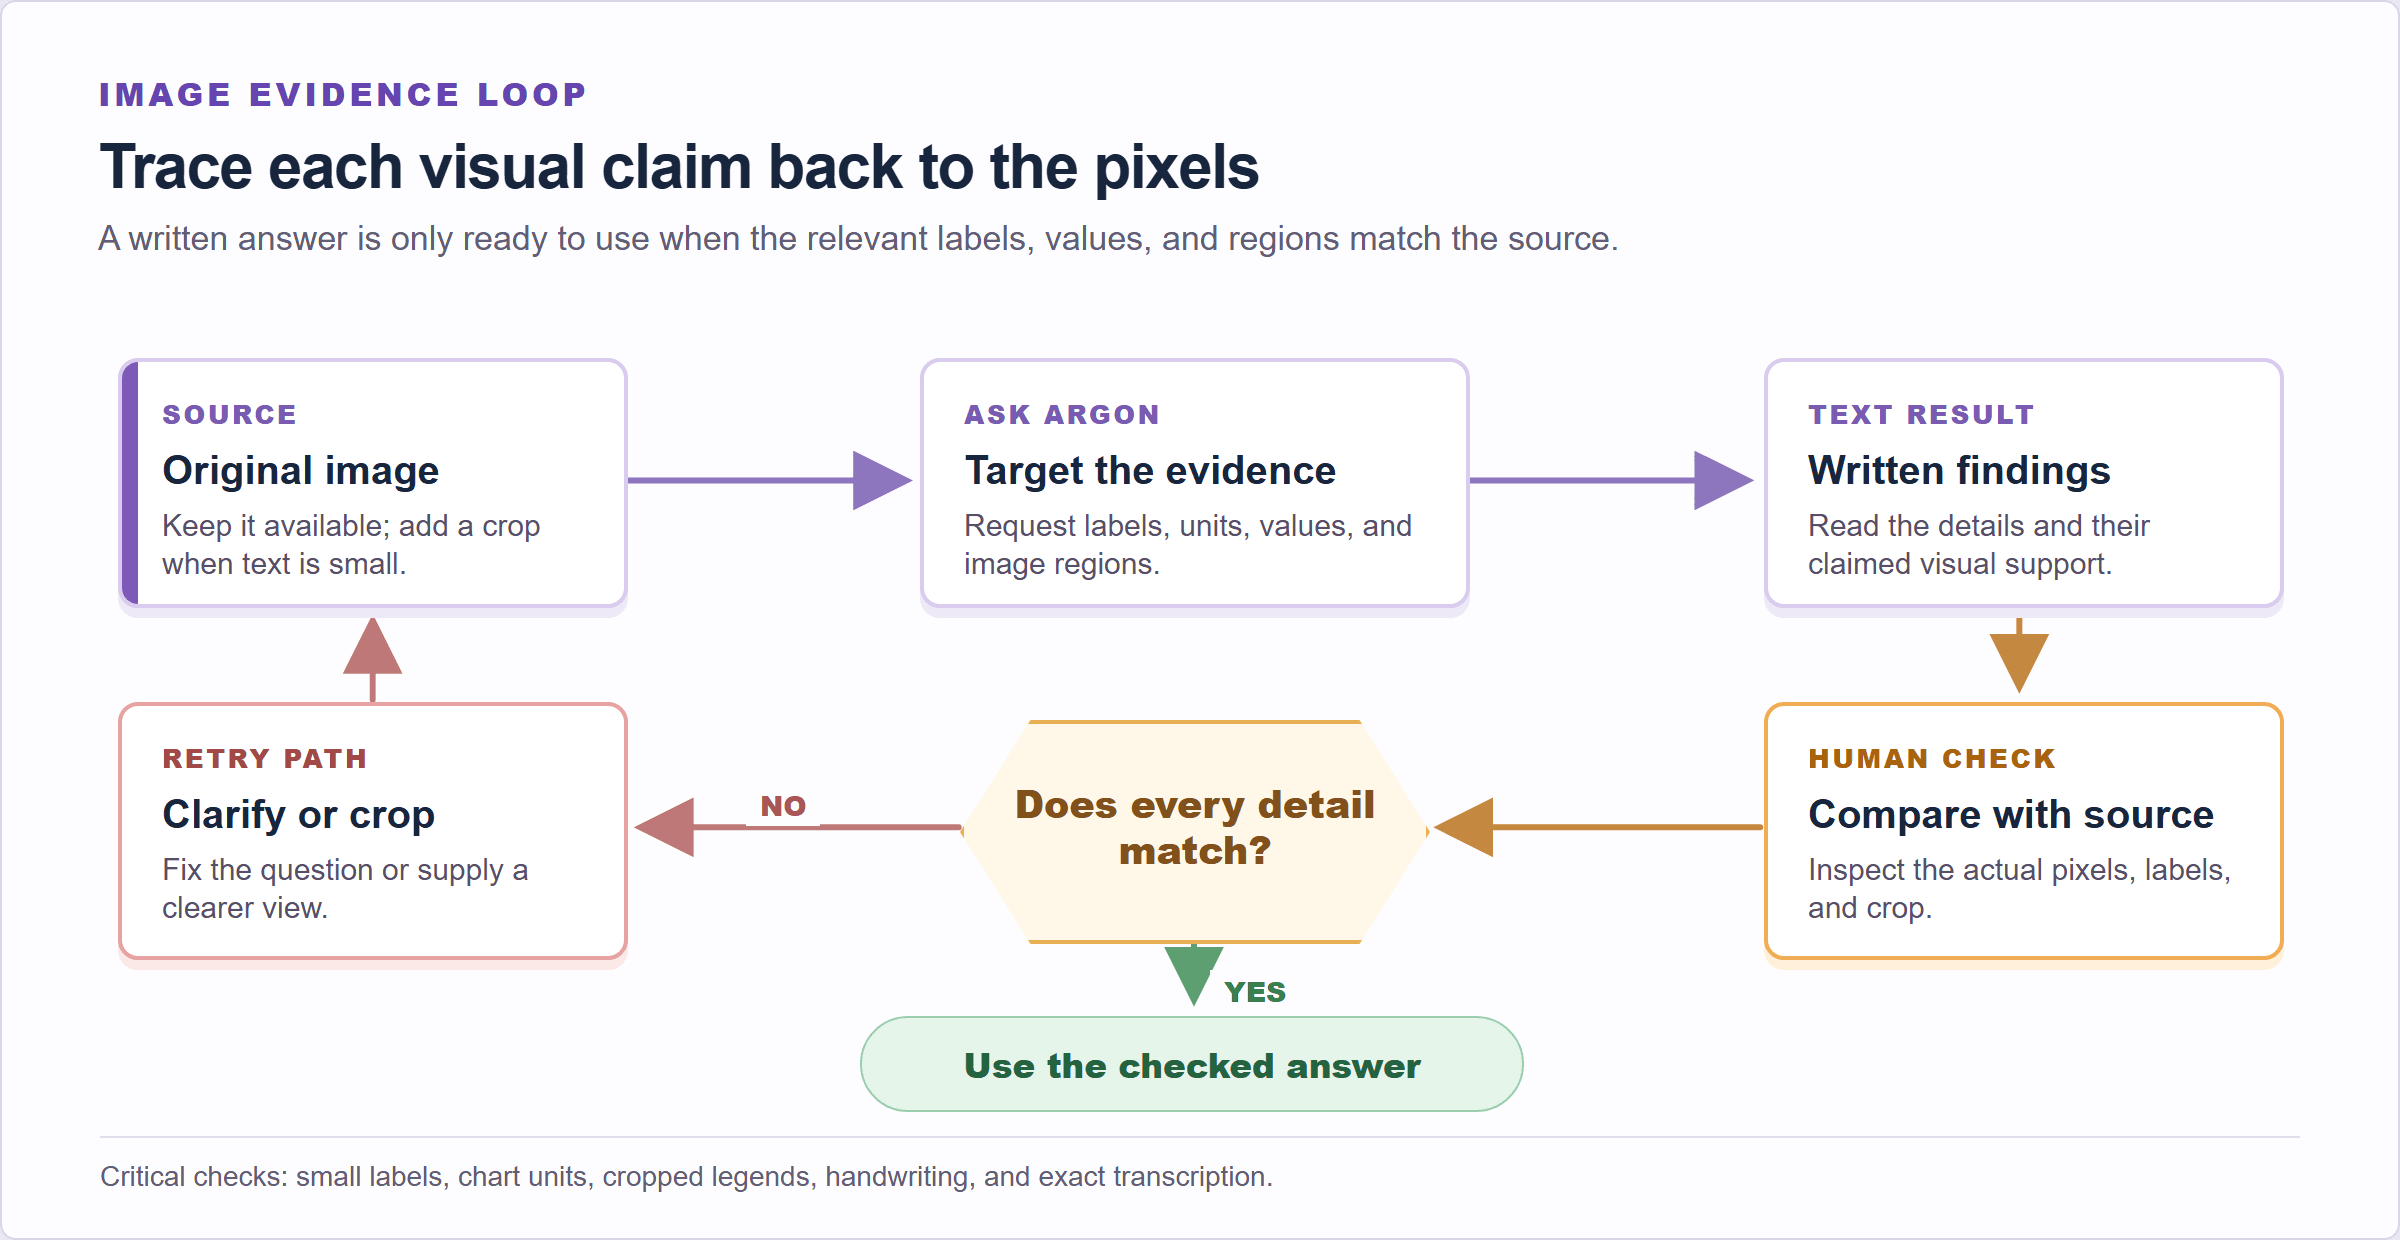 Illustrazione del flusso di lavoro: chiedi i dettagli dell'immagine e le regioni che li supportano, poi verifica ogni affermazione rispetto all'immagine originale.
Per un grafico, chiedi il titolo, gli assi, le unità, i valori rilevanti e la regione dell'immagine che supporta ciascun valore. Poi confronta questi dettagli con la fonte. Etichette piccole, screenshot a bassa risoluzione, scrittura a mano, segni sovrapposti o una legenda ritagliata meritano una revisione manuale. Se la trascrizione esatta è importante, includi un ritaglio chiaro e conserva l'originale così che un revisore possa controllare ogni carattere.
Video: ragiona sugli eventi nel tempo
Il video aggiunge ordinamento e tempo. Argon può rispondere a domande su azioni, cambiamenti ed eventi attraverso i fotogrammi. L'API supporta la comprensione video agentica, un'opzione che può ispezionare dinamicamente la timeline; la sua modalità predefinita documentata è statica. Controlla la guida video e le impostazioni della richiesta per la modalità che la tua integrazione utilizza effettivamente.
Una domanda di produzione utile potrebbe essere: "A che ora il tecnico rimuove il filtro, e cosa succede immediatamente prima e dopo?" Richiedi i timestamp, poi ispeziona quei momenti. Una descrizione fluente senza prove allineate nel tempo non è sufficiente per la revisione di incidenti, i controlli di qualità o i dati di addestramento.
Il team di robotica di Google descrive un flusso di lavoro con Argon che analizza una registrazione dall'alto di 136 secondi di un robot a due bracci che piega la carta in una volpe origami. Il sistema produce una gerarchia di annotazioni allineate nel tempo, dal compito generale alle sottoattività e alle azioni a livello di contatto, con etichette di controllo qualità relative ai tentativi ripetuti. Questo è un esempio concreto di output di analisi video costituito da etichette e struttura legate al filmato. L'articolo è un esempio di ricerca, non una garanzia che una chiamata API generica riprodurrà una pipeline robotica. (Google Developers Blog, ottobre 2026)
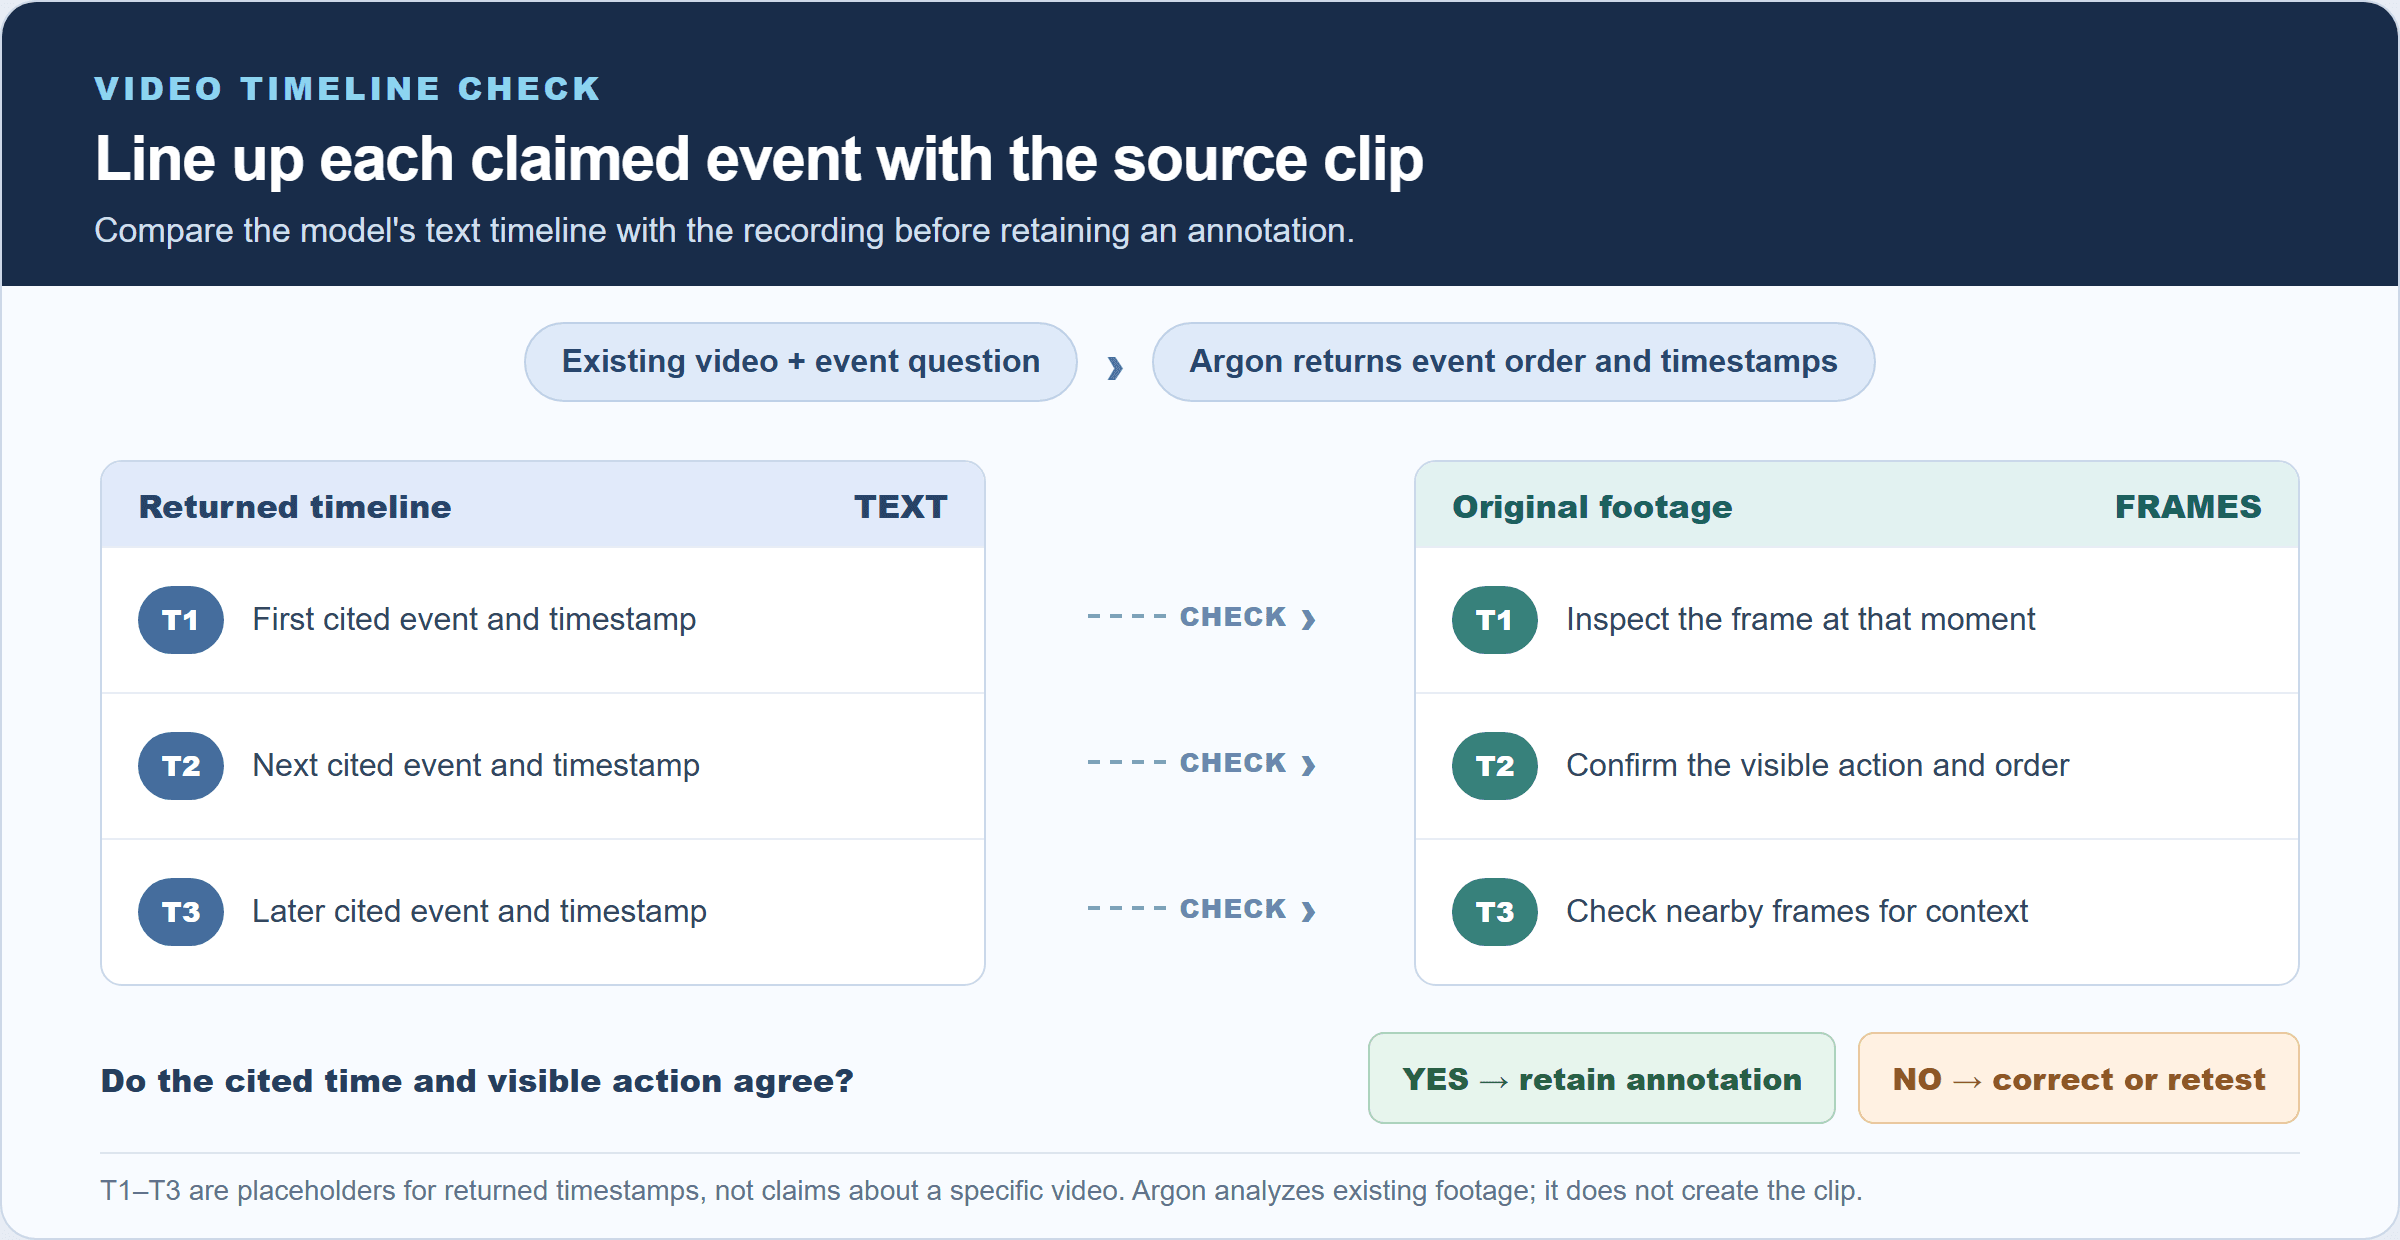 Illustrazione del flusso di lavoro: chiedi l'ordine degli eventi e i timestamp, poi verifica ogni momento citato rispetto alla registrazione originale.
Il movimento può essere facile da interpretare erroneamente quando la telecamera si muove, le mani oscurano un oggetto o due azioni avvengono in rapida successione. Campiona i timestamp restituiti rispetto al filmato originale. Se una risposta influisce sulla sicurezza o su una decisione di superamento/non superamento, fai verificare i fotogrammi critici da una persona o da un sistema di visione creato appositamente.
Audio: analizza le registrazioni fornite
L'input audio ti consente di porre domande basate su una registrazione, come cosa è stato detto, quale suono si è verificato per primo o se compare una particolare frase. Prima di progettare un'integrazione, controlla la documentazione attuale sull'input audio per i formati supportati, i vincoli di durata e campionamento e la forma esatta della richiesta. Il solo "input audio supportato" non specifica ogni comportamento di trascrizione né garantisce che un allegato sia stato effettivamente trasmesso attraverso il tuo client.
Costruisci un piccolo set di test con risposte note da registrazioni che hai il permesso di elaborare. Includi parlato chiaro, parlanti sovrapposti, rumore di fondo, silenzio e suoni non vocali se questi si verificano in produzione. Chiedi timestamp o una breve citazione di prova dove l'interfaccia lo supporta. Verifica che l'allegato sia arrivato al modello, poi confronta il risultato con la registrazione. Questo individua sia gli errori del modello sia gli errori di integrazione come parti di file omesse o codifica non supportata.
PDF e documenti misti: collega i dettagli tra le fonti
Il supporto PDF è prezioso quando una domanda attraversa prosa, tabelle e figure. Un revisore potrebbe chiedere se il sommario esecutivo di un report è coerente con una tabella più avanti nel documento, o estrarre un'affermazione e la sua figura di supporto. Più documenti possono essere forniti per il confronto, soggetti ai limiti di token e file della richiesta.
Chiedi una posizione di origine con ogni affermazione. I riferimenti di pagina sono utili, ma convalidali perché la numerazione delle pagine PDF può differire dall'etichetta di pagina stampata. Per una tabella, richiedi la sua etichetta di riga e l'intestazione di colonna oltre al valore. Per un diagramma, chiedi al modello di nominare l'elemento visivo che ha utilizzato. Se un PDF è scansionato, ruotato, sbiadito o con una composizione tipografica densa, testa pagine rappresentative invece di presumere che tutte le pagine siano state analizzate altrettanto bene.
Uno schema di output compatto può facilitare la revisione: affermazione, posizione di origine, estratto di supporto o dettaglio visivo e confidenza o "non trovato". Gli output strutturati possono imporre una forma, ma un oggetto JSON valido può comunque contenere una lettura errata. La convalida del formato e la convalida fattuale sono controlli separati.
Come testare la comprensione multimodale di Gemini 4 Argon
Usa una breve valutazione prima di collegare il modello a un grande batch. Scegli una fonte in cui un essere umano può stabilire la risposta corretta e definisci cosa conta come risultato corretto. Lo scopo è testare l'intero percorso dalla selezione del file alla risposta del modello, non semplicemente vedere se la risposta sembra plausibile.
- Seleziona un report pubblico con un grafico o un breve video con eventi chiaramente identificabili. Tieni una chiave di risposte verificata da un essere umano.
- Chiedi al modello di usare solo il materiale allegato e di allegare una posizione a ogni affermazione.
- Confronta ogni affermazione con la fonte. Registra omissioni, letture errate, inferenze non supportate e posizioni che non corrispondono a prove.
- Ripeti con diversi esempi che assomigliano ai tuoi file reali, inclusi i casi difficili.
- Imposta una soglia di superamento basata sul costo di un errore. Indirizza i risultati incerti o ad alto impatto alla revisione umana.
Puoi adattare questo prompt:
Analizza solo il materiale allegato. Rispondi alle domande seguenti in una tabella. Per ogni affermazione, cita il numero di pagina, il timestamp o la prova visibile che la supporta. Se il materiale non contiene la risposta, scrivi "non trovato". Non inferire fatti mancanti.
Per un'immagine, sostituisci "numero di pagina, timestamp" con "regione dell'immagine ed etichetta visibile". Per un PDF, chiedi la pagina e il nome della tabella o della sezione. Per l'audio, richiedi un timestamp e le parole o il suono che supportano la risposta. Queste piccole modifiche rendono l'output più facile da verificare.
Tieni traccia degli errori per tipo invece di usare un'unica cifra di accuratezza complessiva. Una cifra errata in un grafico, un evento mancato e una citazione alla pagina sbagliata hanno conseguenze diverse. Questo quadro di valutazione converte un elenco impressionante di capacità in una decisione ripetibile sulla affidabilità del modello per i tuoi file.
Limiti di Gemini 4 Argon: cosa non significa il supporto multimodale
Il supporto dell'input non implica un supporto corrispondente dell'output. L'API attualmente elenca la generazione di immagini, la generazione di audio e la Live API come non supportate per Argon. Se il compito è creare una nuova immagine, una colonna sonora o un'interazione vocale in tempo reale, scegli un modello o uno strumento che elenchi esplicitamente quell'output. Puoi comunque usare Argon per analizzare il prompt, il materiale di origine o il risultato generato.
Una finestra da un milione di token inoltre non garantisce un recupero completo. È condivisa tra richiesta e risposta, e input lunghi possono aumentare la latenza e i costi. Il modello può trascurare un dettaglio, inferire informazioni assenti o restituire un timestamp errato pur sembrando sicuro. La decodifica lunga è un percorso di esecuzione API con requisiti aggiuntivi, non il comportamento predefinito per ogni client.
I benchmark sono prove indicative. Roboflow riporta risultati da dataset di attività specifici e configurazioni di valutazione specifiche, mentre la model card di Google riassume un insieme più ampio di valutazioni interne e pubbliche. Nessuno dei due sostituisce un test che utilizzi la qualità della tua telecamera, i layout dei tuoi documenti, il tuo vocabolario, le tue lingue e la tua tolleranza agli errori. Un punteggio elevato in una categoria non può dimostrare prestazioni affidabili in un compito diverso.
Usa un revisore quando la risposta influenza una decisione finanziaria, legale, di sicurezza, medica o occupazionale. Conserva l'input originale e le prove restituite insieme così che una persona possa verificare la conclusione. Per i flussi di lavoro ricorrenti, registra la versione del modello, il prompt, le impostazioni rilevanti, l'identificatore di origine e l'esito della revisione. Quel registro aiuta a distinguere un cambiamento del modello da un problema di file o di integrazione.
| Attività | Buon primo test | Da rivedere attentamente |
|---|---|---|
| Lettura di grafici | Chiedi valori etichettati con unità degli assi | Caratteri piccoli, legende dense, letture visive approssimative |
| OCR | Usa un ritaglio pulito con una trascrizione nota | Sfocatura, scrittura a mano, rotazione, script misti |
| Eventi video | Chiedi azioni con timestamp in sequenza | Occlusione, tagli rapidi, cause inferite |
| Domande e risposte audio | Poni una domanda nota su una breve registrazione | Rumore, più parlanti, gestione degli allegati |
| Confronto PDF | Chiedi affermazione, pagina e passaggio di supporto | Pagine scansionate, numerazione delle pagine non corrispondente, inferenza tra pagine |
Accesso, prezzi e dove si colloca Atlas Cloud
L'ID pubblico del modello API è gemini-4-argon; Google attualmente elenca Gemini API e AI Studio come vie di accesso. L'avviso attuale di Google elenca una tariffa introduttiva di 2 $ per milione di token di input e 10 $ per milione di token di output fino al 30 novembre 2026, poi 4 $ e 20 $ rispettivamente. L'input in cache ha termini separati, quindi non stimarlo come input ordinario. (Google, ottobre 2026)
L'attuale elenco di tutti i modelli di Atlas Cloud non mostrava Gemini 4 Argon al momento della verifica per questo articolo. Ciò significa che non esiste una pagina del modello Atlas Argon verificata né un prezzo Atlas da citare qui. Non trattare un elenco generico della piattaforma come prova di disponibilità. Se il tuo team sta confrontando provider o costruendo un flusso di lavoro più ampio con i modelli, Atlas Cloud può essere un luogo dove sfogliare altri modelli elencati, ma conferma la pagina esatta del modello e le operazioni supportate prima di pianificare in base a qualsiasi provider.
La verifica della fonte influisce anche sulla raccomandazione: usa la via ufficiale di Google per testare Argon oggi e considera Atlas Cloud come un'opzione di scoperta separata per i modelli effettivamente elencati. Non si afferma qui che Argon sia ospitato su Atlas Cloud.
Gemini 4 Argon è adatto al tuo compito?
Inserisci Argon in una lista ristretta quando il lavoro richiede di ragionare su materiale misto, estrarre dettagli visivi, seguire eventi attraverso un video o rivedere un lungo report. Il suo ampio contesto condiviso e l'output testuale possono aiutare a consolidare le prove in una tabella o in un risultato strutturato. Il passo successivo è una piccola valutazione verificabile da un essere umano usando i tuoi input rappresentativi.
Scegli un modello o uno strumento diverso quando il risultato richiesto è immagini generate, audio generato o una conversazione audio/video in tempo reale. Per l'OCR o le decisioni operative, confronta il suo output con un'alternativa creata appositamente se l'esattezza, la velocità o il costo prevedibile contano più di un ragionamento ampio.
Se la valutazione supera la tua soglia specifica per il compito, avvialo come pilota con registrazione e revisione umana prima di aumentare il volume. Se fallisce, classifica gli errori e decidi se input più chiari, un prompt modificato, un modello diverso o un sistema OCR/trascrizione separato sia la soluzione giusta. La domanda utile è se le capacità multimodali di Gemini 4 Argon soddisfano il tuo budget di errori.
Domande frequenti
Gemini 4 Argon può analizzare video e audio?
Sì. La sua API elenca sia video che audio come input supportati. La comprensione video può restituire descrizioni o analisi con timestamp; l'audio può essere fornito per domande basate sull'audio. Controlla la documentazione attuale sui formati di file e sulle richieste, poi verifica la risposta rispetto al media originale.
Gemini 4 Argon genera immagini o audio?
No. L'attuale tabella delle capacità API contrassegna la generazione di immagini e la generazione di audio come non supportate per questo modello. La sua modalità di output documentata è testo, anche quando il suo input contiene immagini, audio o video.
Cosa significa la finestra di contesto da 1M token di Gemini 4 Argon?
Il limite di 1.048.576 token è condiviso tra input e output. L'output sincrono predefinito è limitato a 65.536 token. Google documenta un flusso separato di decodifica lunga per output più grandi, fino al limite condiviso, con esecuzione in background e passaggi di continuazione.
Quanto costa l'accesso all'API di Gemini 4 Argon?
Al 16 ottobre 2026, Google elenca 2 $ per milione di token di input e 10 $ per milione di token di output fino al 30 novembre 2026. Le tariffe successive elencate sono 4 $ e 20 $. Controlla i prezzi in tempo reale e i termini dei token in cache prima di stimare un progetto.


