Una scena con due persone diventa convincente quando si vede e si sente chi pronuncia ogni battuta. Per rendere facile seguire il dialogo multi-speaker di Gemini Omni 1.2 Flash, assegna a ogni personaggio un'identità visiva e vocale fissa, scrivi battute brevi nell'ordine di parlato e rivedi il video finito con occhi e orecchie. L'aggiornamento di Google di novembre 2026 supporta un parlato multi-speaker più naturale e clip fino a 15 secondi, ma un prompt non può garantire un'assegnazione pulita dei parlanti al primo render. Inizia con un semplice scambio a 2 persone, poi aggiungi un terzo turno o un'ambientazione di strada solo dopo aver imparato a giudicare il passaggio di base.
Punti chiave
- Gemini Omni 1.2 Flash genera video con audio nativo, incluso il dialogo; è diverso dai modelli text-to-speech di Gemini solo audio.
- Usa parlanti con nome, battute tra virgolette esatte, posizioni chiare e un ascoltatore silenzioso per ogni turno.
- Lascia spazio per le pause entro il massimo di 15 secondi, poi verifica ogni battuta rispetto alla clip.
- Preventiva un render in base alla durata e risoluzione selezionate, non alla tariffa più bassa pubblicizzata da una piattaforma.
Cosa significa dialogo multi-speaker in Gemini Omni 1.2 Flash?
Il modello crea una breve scena in cui le persone possono parlare come parte dell'audio e del video generati. Il test pratico è se uno spettatore riesce a capire chi dice ogni battuta senza leggere un transcript. Le parole, la voce, la persona visibile e il movimento della bocca devono concordare nello stesso momento. Una clip può sembrare convincente con l'audio disattivato e fallire comunque quel test.
Google ha annunciato Gemini Omni 1.2 Flash il 5 novembre 2026, con fino a 15 secondi di video generato o montato. Descrive un dialogo più fluido, un lip sync più chiaro e un condizionamento multi-speaker distinto. Sono dichiarazioni di capacità, non una promessa che ogni copione verrà consegnato esattamente come scritto (annuncio di Google di novembre 2026).
La dimostrazione pubblicata da Google mostra la capacità annunciata. È separata dai tre casi video forniti di seguito.
Cosa è cambiato rispetto a Gemini Omni 1.1 Flash?
Il confronto ufficiale assegna alla 1.2 un tetto più lungo: 15 secondi invece di 10. Nomina anche miglioramenti nel parlato, nel lip sync, nel follow dei riferimenti e nell'editing conversazionale. I 5 secondi in più rendono uno scambio a 3 turni più plausibile da sceneggiare, ma una durata maggiore non crea più tempo di parlato se un regista chiede anche pause, reazioni fisiche e cambi di scena.
L'interpretazione più sicura è direzionale. Un condizionamento migliore può rendere il dialogo più facile da dirigere, ma ogni clip consegnata richiede comunque ispezione. Un creator può usare il limite di 15 secondi per fissare un obiettivo di copione. Un produttore che promette un copy legale esatto o una corrispondenza vocale precisa dovrebbe trattare l'output generato come una bozza finché non supera la revisione.
Dialogo video vs text-to-speech multi-speaker
I modelli text-to-speech di Gemini accettano testo e restituiscono audio. Le loro impostazioni dei parlanti e le scelte vocali appartengono a quel flusso di lavoro audio, che Google documenta separatamente (documentazione text-to-speech di Gemini di Google, consultata a novembre 2026). Il percorso text-to-video di Gemini Omni 1.2 Flash accetta un prompt di scena e produce video con audio nativo. Un esempio di speech_config di text-to-speech non è un controllo video di Gemini Omni 1.2 Flash. Questi esempi descrivono il carattere vocale nel testo; non pretendono di caricare, clonare o selezionare una voce registrata. Se un brief richiede la voce di un attore specifico, verifica separatamente accesso e consenso prima di pianificare lo shot.
Se il tuo deliverable è una conversazione podcast o un voiceover bloccato, usa il text-to-speech e monta l'immagine attorno a quell'audio. Se sono due persone che parlano visibilmente in una scena generata, usa il video di Gemini Omni 1.2 Flash e verifica l'allineamento nell'output effettivo.
Dove puoi eseguirlo e quanto costerà una clip?
Scegli il percorso text-to-video
Google elenca Gemini Omni 1.2 Flash tra i suoi prodotti creativi e per sviluppatori. Per un test riproducibile, usa un solo percorso: Atlas Cloud offre il modello e il suo playground Text-to-Video di Gemini Omni 1.2 Flash è il posto dove incollare i prompt seguenti. L'ID del percorso è google/gemini-omni-1.2-flash/text-to-video. I prompt seguenti usano solo testo, senza riferimenti a immagini, movimento o voce.
I prompt richiedono 12 secondi in 16:9 per l'ufficio, 15 secondi in 16:9 per il caffè e 12 secondi in 16:9 per l'intervista di strada. I tre file forniti sono a 720p. Conferma i controlli live e i valori selezionati prima di premere Run. Un'impostazione pubblicizzata su una pagina di prodotto non è prova che uno specifico test run l'abbia accettata. Salva i valori selezionati e il preventivo con ogni output. Questo rende utile come prova ogni render: puoi confrontare il prompt con la risoluzione e il percorso selezionati quando rivedi il suo output. Questa guida specifica il percorso text-to-video, quindi un risultato da un percorso image-to-video o reference-to-video dovrebbe essere identificato separatamente.
I file video forniti non includono una cattura completa del playground, le impostazioni selezionate o un preventivo pre-invio. Il loro percorso e la loro configurazione restano quindi non verificati.
| Percorso | Input per questa guida | Più adatto per | Dove verificare il costo |
|---|---|---|---|
| Prodotti creativi di Google | Un prompt di scena; i controlli variano per prodotto | Creazione manuale nell'editor di Google | Il piano corrente o la schermata dei crediti |
| API di Google | Una richiesta video per sviluppatori | Integrazione applicativa | Il prezzo di Google per la risoluzione esatta |
| Atlas Cloud text-to-video | Prompt, durata, aspect ratio, risoluzione | Ripetere questi test solo testo in un playground | Il preventivo pre-invio della configurazione selezionata |
Verifica il prezzo prima del render
Google indica $0,07 per secondo generato per il 720p tramite la sua API, il 30% in meno rispetto a Gemini Omni 1.1 Flash. A quella tariffa indicata, 12 secondi di 720p sono $0,84 prima di qualsiasi altro lavoro fatturabile. Quel calcolo non è un preventivo di Atlas Cloud per i file forniti; il loro percorso e la loro fatturazione non sono verificati. I crediti in Flow o in un altro editor seguono le regole di quel prodotto.
Atlas Cloud elenca una tariffa di partenza al secondo più bassa nel suo catalogo modelli, ma il minimo può corrispondere a un'altra risoluzione o configurazione. Leggi il preventivo live dopo aver scelto durata e risoluzione. Una bozza a 360p può aiutare a esplorare un prompt; è una generazione separata, non un'anteprima fotogramma per fotogramma di un successivo render a 1080p.
Inserisci due voci in una scena da 15 secondi
Assegna a ogni parlante un'identità visiva e vocale
Scrivi descrizioni che un revisore possa verificare. "Il parlante A è a sinistra con una camicia blu navy" è più chiaro di "il primo collega". Aggiungi una distinzione udibile, come tono medio contro tono più basso. Mantieni nomi, abbigliamento, posizione e voci coerenti in tutto il prompt. Questi ancoraggi rendono più facile individuare una battuta scambiata.
L'identità visiva conta perché l'audio da solo può ingannare un revisore. Se le voci sono diverse ma si muove la bocca sbagliata, la clip ha un problema di lip sync. Se si muove la bocca corretta ma la voce di A cambia al secondo turno di A, c'è deriva vocale. L'esempio del caffè riporta A dopo B, così un revisore può verificare se la voce di A resta coerente.
Preventiva il tempo per parlato e reazione
Leggi il copione ad alta voce al ritmo previsto. Includi una pausa naturale a ogni passaggio, poi lascia spazio per la reazione di un ascoltatore e per lo shot di apertura che stabilisce entrambi i volti. Il copione rivisto dell'ufficio ha 5 turni in 12 secondi. Il caffè ha 8 turni brevi in 15 secondi, rendendolo il test di timing più impegnativo qui. Questi sono copioni di esempio, non una soglia universale di parole al secondo né una promessa sull'output.
| Budget di scena | Sequenza parlata | Tempo necessario oltre le parole |
|---|---|---|
| Ufficio da 12 secondi | A-B-A-B-A | Stabilire entrambe le persone e inserire 4 passaggi |
| Caffè da 15 secondi | Otto turni alternati | Sette passaggi con poco tempo a disposizione |
| Strada da 12 secondi | A-B-A-B-A | Quattro passaggi sopra l'ambiente di strada |
Una battuta lunga invita a correre o a omettere verso la fine. Se la bozza impiega quasi tutti i 15 secondi per essere letta ad alta voce, accorciala prima della generazione. Se lo scenario richiede più dialogo, pianifica shot separati e verifica la continuità come ulteriore attività di produzione. Al primo tentativo mantieni i volti visibili durante le battute parlate. Tagli rapidi e bocche occluse rendono più difficile giudicare l'assegnazione dei parlanti. Fai una lettura a tempo con due persone se l'ordine delle battute conta. Fai pronunciare A a una persona e B all'altra, mentre una terza annota dove finisce ogni frase. Se l'ultima parola cade sul limite della clip, rimuovi una proposizione o un beat di reazione prima del render. Un copione più breve è più facile da verificare perché il revisore può riprodurre l'intero scambio senza dover indovinare se una battuta dovesse continuare fuori campo.
Come impostare il prompt di Gemini Omni 1.2 Flash per 2 parlanti
Un prompt utile si legge come un breve brief di ripresa: ambientazione e camera, identità, dialogo esatto, poi regole di suono ed esclusione. Quest'ordine fornisce anche una checklist al revisore. È un metodo di prompting, non una garanzia documentata di controllo. Mantieni le etichette dei personaggi identiche dal paragrafo delle identità al blocco del dialogo. Evita di riferirti alla stessa persona sia come A sia come "il cliente" nelle istruzioni su un turno successivo, a meno che la mappatura sia già esplicita. Un lettore dovrebbe poter tracciare due colonne, una per persona, e collocare ogni azione richiesta e ogni battuta parlata in esattamente una colonna.
Usa etichette esplicite dei parlanti e battute tra virgolette
Usa una riga per turno con Speaker A: o Speaker B: e parole tra virgolette. Specifica chi resta in silenzio. Chiedere "una discussione sulla readiness al lancio" consente improvvisazione. Un copione esatto ti permette di segnare subito una parola mancante o riscritta.
Ecco il primo prompt da copiare. Mantiene entrambi gli adulti in un'unica ripresa continua così lo spettatore può ispezionare ogni bocca.
plaintext1Crea un video realistico di 12 secondi in un unico campo medio a due in un ufficio tranquillo. Due colleghi adulti restano visibili per tutta la durata. Il parlante A è una donna a sinistra che indossa occhiali e una maglia a righe blu navy, con una voce chiara di tono medio. Il parlante B è un uomo a destra che indossa una camicia bianca, con una voce più bassa. A indica un laptop aperto; B controlla un quaderno. 2 3Dialogo, pronunciato esattamente in questo ordine: 4Speaker A: "Can we publish the page now?" 5Speaker B: "Almost. One link needs fixing." 6Speaker A: "Which one?" 7Speaker B: "The footer link." 8Speaker A: "I'll fix it now." 9 10Solo la persona indicata pronuncia ogni battuta. L'ascoltatore resta in silenzio e reagisce in modo naturale. Mantieni ogni voce legata alla stessa persona per tutta la durata. Mostra la bocca corretta che si muove per ogni battuta, con brevi pause naturali. Tono stanza silenzioso. Nessun narratore, terza voce, sottotitoli, musica o loghi.
Render fornito dell'ufficio, 12 secondi, 720p. Entrambe le persone restano visibili; le cinque battute parlate e il lip sync richiedono comunque una revisione in ascolto.
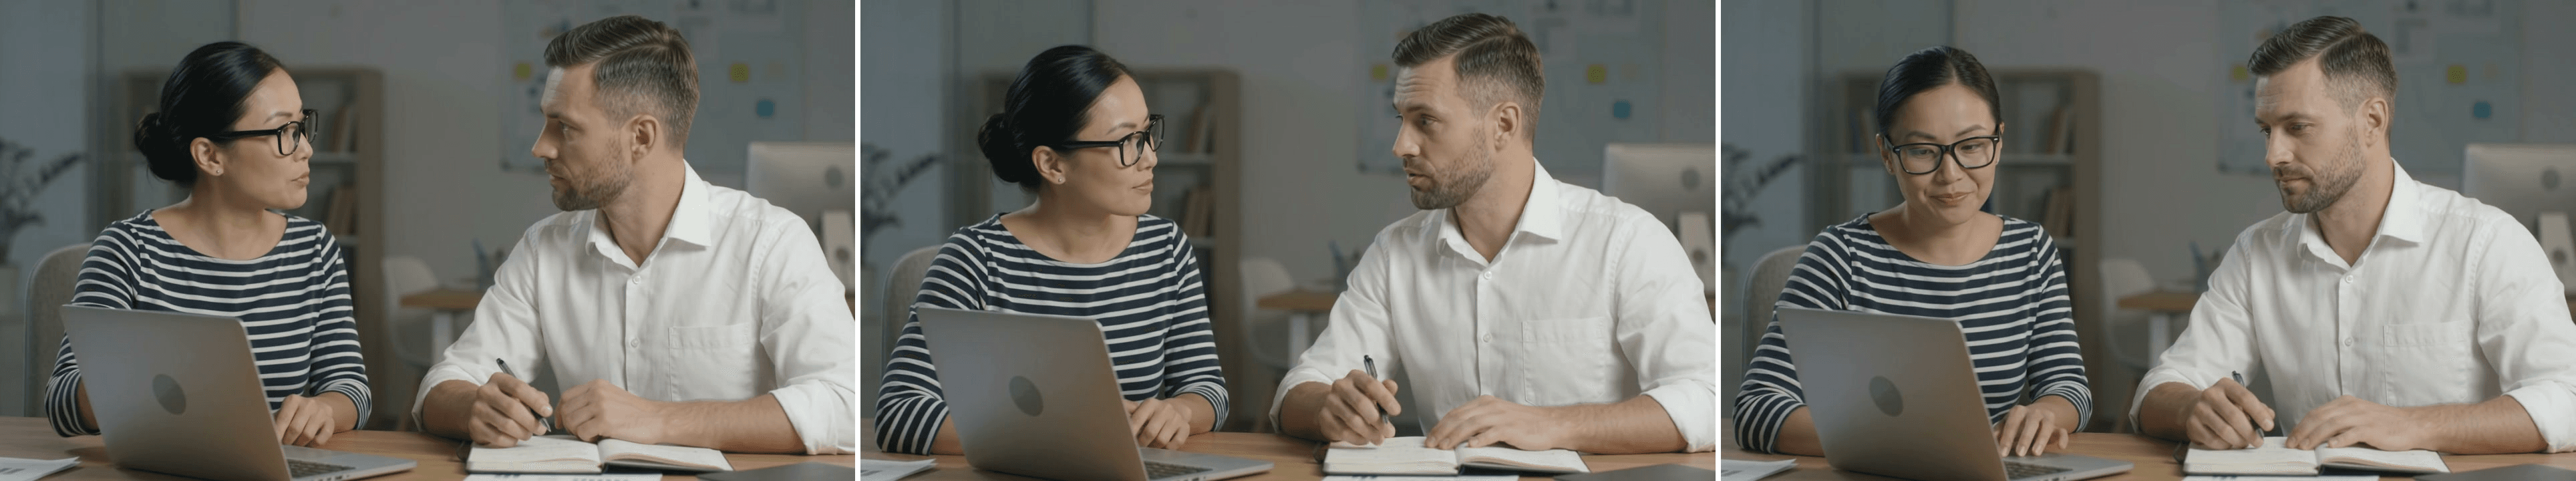 Fotogrammi del caso A, da sinistra a destra (circa 0:02, 0:05, 0:10): la donna si rivolge al collega; lui sembra rispondere mentre entrambi restano in campo; riportano l'attenzione al laptop e al quaderno.
Controlla la camera senza perdere il parlante
Un campo medio a due continuo è una scelta diagnostica. Entrambi i volti restano visibili, quindi un passaggio mancato non può nascondersi dietro il montaggio. Il modello può comunque variare l'inquadratura, ed è per questo che il file finale richiede ispezione.
Una volta che il passaggio funziona per il tuo scopo, prova un movimento modesto che preservi entrambi i volti. Il prompt della strada ne richiede uno in un frame 16:9 che mantiene entrambi i volti visibili, rendendo più facile giudicare i movimenti della bocca. Questo è un motivo per stabilire prima la baseline dell'ufficio.
Mantieni l'audio di sottofondo sotto il dialogo
Nomina l'ambiente e la sua priorità. Un tono stanza silenzioso dà alla clip dell'ufficio poco con cui competere con il parlato. Un suono soft da caffè aggiunge contesto mantenendo le battute verificabili. Il prompt della strada chiede passi e suono distante sotto entrambe le voci, senza parlato di passanti.
Le istruzioni negative possono ridurre l'audio indesiderato, ma restano richieste. Ascolta eventuali terze voci, narrazione, musica e audio di brand. Controlla anche l'immagine per didascalie e loghi.
3 scene di dialogo che mostrano chi parla e quando
I tre file video forniti mostrano le scene previste di ufficio, caffè e strada. Il loro contenuto visivo può essere ispezionato qui, ma i file non stabiliscono quale percorso o impostazioni li abbiano prodotti. I prompt seguenti sono richieste riproducibili, non un'affermazione che l'output abbia pronunciato ogni parola correttamente. L'ufficio verifica 5 turni, il caffè testa 8 turni rapidi e la strada aggiunge suono ambientale.
| Caso | Richiesta del prompt | File fornito | Verifica principale |
|---|---|---|---|
| A: passaggio in ufficio | 12s, 16:9, 5 turni | 12s, 16:9, 720p | Cinque battute, bocche corrette |
| B: scambio al caffè | 15s, 16:9, 8 turni | 15s, 16:9, 720p | Otto battute, voci stabili |
| C: intervista in strada | 12s, 16:9, 5 turni | 12s, 16:9, 720p | Udibilità in strada e turni dei parlanti |
Un passaggio in ufficio a cinque turni
Usa il prompt completo e il video qui sopra. Entrambi i colleghi restano nello stesso shot, così ognuno dei cinque turni richiesti ha una persona visibile da verificare. Registra ogni battuta udibile rispetto al testo e ispeziona la bocca attiva. Il file fornito stabilisce scena e durata, ma le sue parole e il lip sync non sono stati verificati in modo indipendente.
Un passaggio chiaro in una clip supporterebbe una conclusione solo su quella clip, non un tasso di successo a livello di modello. Conserva il primo risultato così ogni revisione può essere confrontata con l'originale.
Uno scambio al caffè a otto turni
Richiedi 15 secondi in 16:9. Otto turni brevi mettono sotto pressione la proprietà ripetuta delle voci e il timing. Confronta la prima e l'ultima battuta di ogni persona, poi controlla se qualche battuta si sovrappone o scompare. Il file fornito è a 720p.
plaintext1Crea un video realistico di 15 secondi in un unico campo medio a due continuo al bancone di un caffè tranquillo. Il parlante A è un cliente adulto a sinistra con un maglione color crema, che tiene una tazza riutilizzabile, con una voce calda di tono medio. Il parlante B è un lavoratore adulto del caffè a destra con una camicia bianca, con una voce più bassa. Entrambi i volti restano visibili per tutta la durata. 2 3Dialogo, pronunciato esattamente in questo ordine: 4Speaker A: "Could I use my reusable cup?" 5Speaker B: "Of course. Hot or iced?" 6Speaker A: "Iced, please." 7Speaker B: "Small or large?" 8Speaker A: "Small." 9Speaker B: "Any milk?" 10Speaker A: "Oat milk, thanks." 11Speaker B: "Coming right up." 12 13Usa un ritmo conversazionale vivace ma naturale. Non correre né sovrapporre le battute. Solo la persona indicata pronuncia ogni battuta; l'altra ascolta in silenzio. Mantieni entrambe le voci coerenti in tutti gli otto turni e abbina ogni battuta alla bocca corretta. Un ambiente soft da caffè resta sotto il dialogo. Nessun parlato extra, sottotitoli, musica o brand visibili.
Una Q&A all'aperto
Richiedi 12 secondi in 16:9. Questo aggiunge un leggero movimento di camera e suono ambientale. Il file fornito è 16:9 a 720p e può essere rivisto per cinque turni dei parlanti e udibilità in strada.
plaintext1Crea un'intervista di strada di 12 secondi in 16:9 alla luce del giorno. Mantieni due adulti visibili dalla vita in su per tutta la durata. Il parlante A è l'intervistatore a sinistra con una camicia scura a quadri, che tiene un microfono semplice senza brand, con una voce brillante di tono medio. Il parlante B è l'intervistato a destra con una giacca marrone chiaro, con una voce più profonda e calma. Usa un leggero movimento laterale della camera che mantenga entrambe le bocche in campo. 2 3Dialogo, pronunciato esattamente in questo ordine: 4Speaker A: "What makes a short video easy to follow?" 5Speaker B: "Clear voices." 6Speaker A: "What about pacing?" 7Speaker B: "Short lines and time to react." 8Speaker A: "Thanks. That's useful." 9 10Solo la persona indicata pronuncia ogni battuta; l'altra ascolta in silenzio. Mantieni entrambe le voci coerenti e abbina ogni battuta alla bocca corretta. Mantieni passi e ambiente stradale distante sotto il dialogo. Nessun parlato di passanti, narratore, musica, didascalie o loghi.
Riproduzione combinata: 0:00–0:15 è il caso B, lo scambio al caffè; 0:15–0:27 è il caso C, l'intervista in strada. Entrambe le clip sorgente sono incluse per intero.
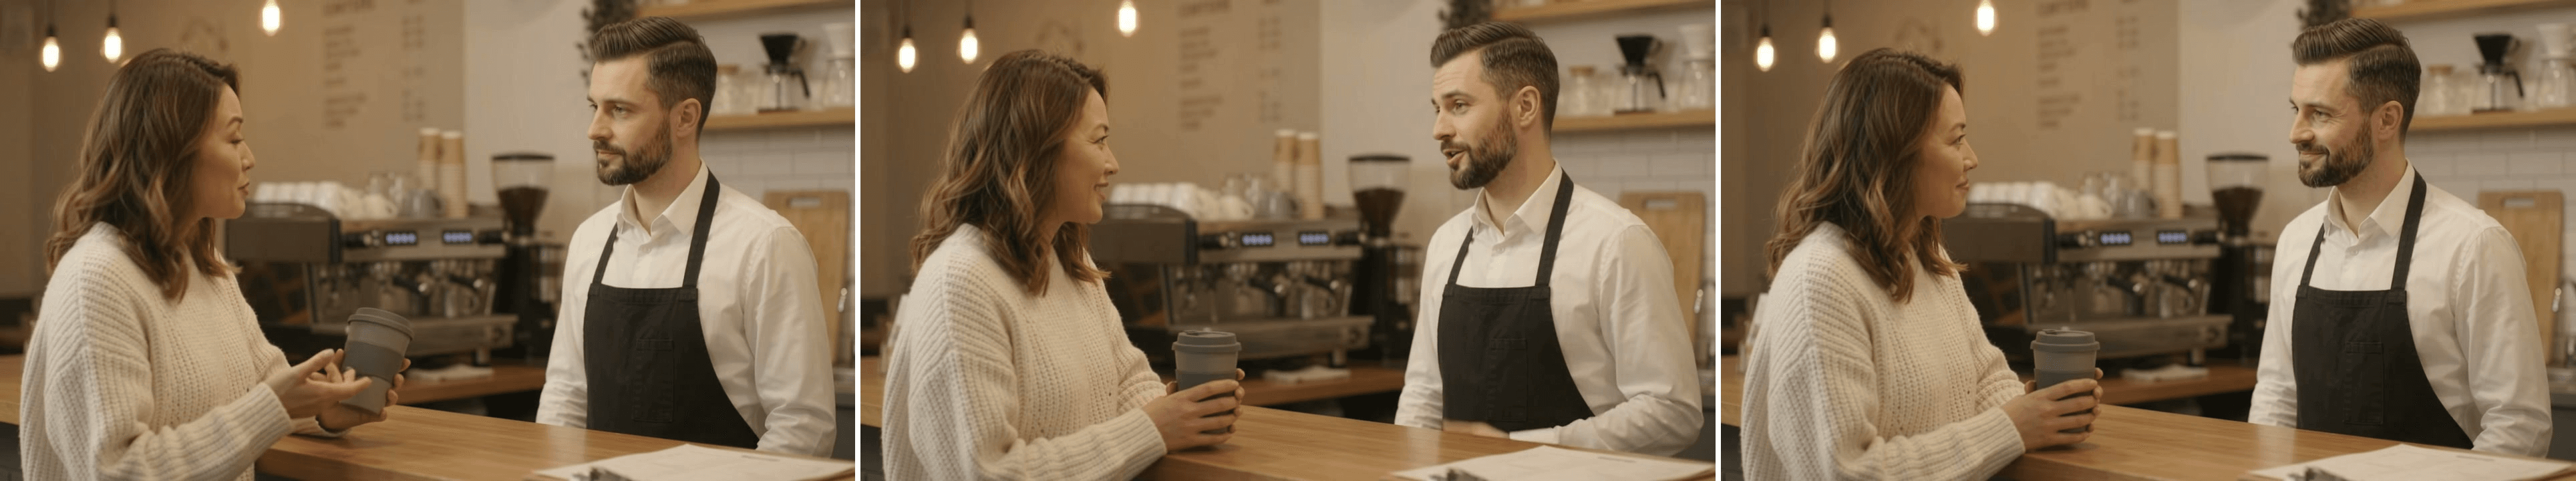 Fotogrammi del caso B, da sinistra a destra (circa 0:02, 0:08, 0:13 del video combinato): la cliente mostra la sua tazza; la lavoratrice del caffè sembra rispondere; si fronteggiano alla chiusura.
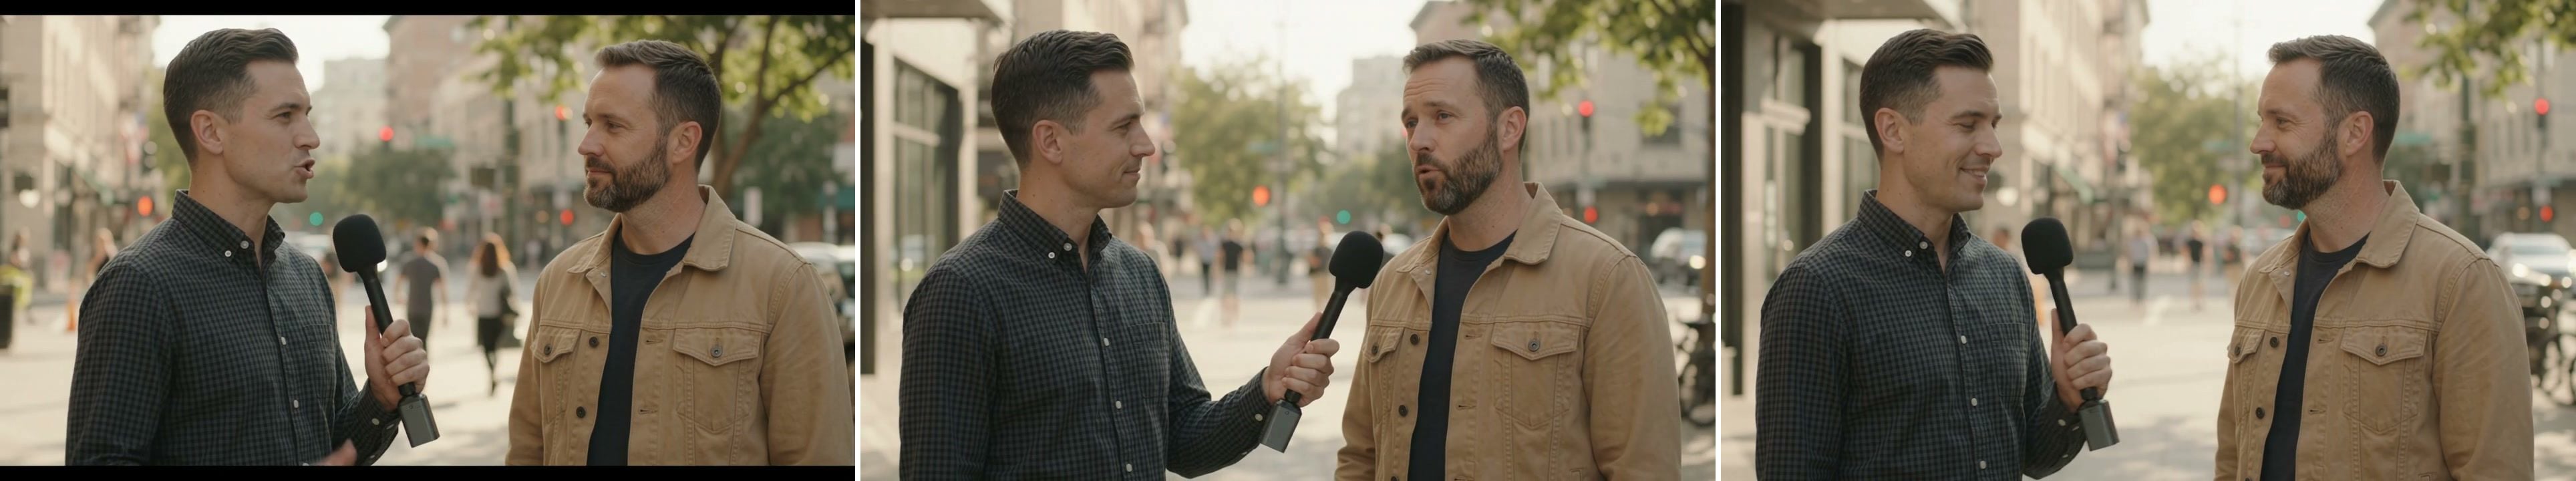
Fotogrammi del caso C, da sinistra a destra (circa 0:16, 0:19, 0:26 del video combinato): l'intervistatore tiene il microfono; lo gira verso l'intervistato; entrambi si fronteggiano alla fine.
Verifica ordine dei parlanti, lip sync e deriva vocale prima di pubblicare
Rivedi la clip battuta per battuta
Scarica il video. Riproducilo una volta senza leggere il copione per individuare confusione evidente, poi riproduci di nuovo con il prompt accanto. Metti in pausa a ogni turno e annota ciò che senti. Ispeziona entrambe le bocche e nota il parlato al di fuori dei turni sceneggiati. Per una revisione ripetibile, registra l'ora di inizio e fine di ogni battuta udibile, il parlante atteso, la voce che hai sentito e la bocca visibile che si è mossa. Scrivi "non chiaro" se un volto è nascosto o il suono maschera una parola. Non trasformare una cella non chiara in un passaggio solo perché il resto della scena sembra convincente. Un secondo ascoltatore che non ha visto il prompt può identificare chi pensa stia parlando; confronta quel giudizio con il copione prima di decidere se uno spettatore pubblico capirà la scena.
Verifica 4 cose per ogni battuta:
- Parole: Le parole tra virgolette sono state pronunciate nell'ordine, senza un finale omesso o una frase aggiunta?
- Proprietario della voce: La persona indicata suonava come il parlante, specialmente quando A è tornato?
- Timing visibile: La bocca di quella persona si è mossa mentre l'ascoltatore restava in silenzio?
- Altri contenuti: La clip ha aggiunto un narratore, un passante, didascalie, un logo o musica?
Una timeline di quality assurance con timestamp resta in sospeso finché audio e movimenti della bocca non sono stati revisionati battuta per battuta.
Modifica un vincolo alla volta
Se l'ultima battuta scompare, accorcia il copione o dalle più durata entro il limite di 15 secondi. Se parla il personaggio sbagliato, ripeti la posizione visiva e specifica che l'ascoltatore resta in silenzio. Se l'ambiente copre una parola, abbassalo o rimuovilo. Se un taglio nasconde la bocca attiva, torna a un campo a due continuo. Cambia un solo fattore per ogni retry così l'output successivo risponde a una domanda chiara.
Nessuna di queste modifiche garantisce una correzione. Se un render richiede revisione, salva il suo file, le impostazioni e il problema che vuoi affrontare. Un produttore può poi decidere se un altro render vale il costo o se voci registrate ed editing manuale darebbero la precisione necessaria. Per uno scambio breve e visibilmente parlato, inizia dal prompt dell'ufficio e accetta una clip solo dopo la verifica battuta per battuta. Questo è lo standard per il dialogo multi-speaker di Gemini Omni 1.2 Flash.
Domande frequenti
Gemini Omni 1.2 Flash può mantenere le stesse voci in clip separate?
Una voce che resta riconoscibile all'interno di una clip generata è un requisito più ristretto rispetto a preservarla tra generazioni separate. Questi esempi solo testo testano il primo caso. Non promettere identità vocale tra clip basandoti su di essi. Una campagna che necessita di un parlante ricorrente dovrebbe eseguire un test di continuità separato.
Gemini Omni 1.2 Flash può generare dialogo in lingue diverse dall'inglese?
Il modello può produrre altre lingue, ma questi prompt sono in inglese. Rivedi la lingua di destinazione parola per parola con un ascoltatore fluente, inclusi nomi, numeri e affermazioni localizzate. Il test linguistico riuscito di un altro creator è una prova per quel test, non una garanzia per il tuo copione.
Come faccio a mantenere ogni battuta assegnata al parlante giusto?
Assegna a ogni persona una posizione visiva e una voce, etichetta ogni battuta tra virgolette e specifica chi resta in silenzio durante il turno dell'altra persona. Rivedi il video generato battuta per battuta. Se un render non soddisfa il brief, accorcia lo scambio o usa un flusso di lavoro audio controllato per una consegna esatta.
Quanti turni di dialogo entrano in una clip da 15 secondi di Gemini Omni 1.2 Flash?
Il prompt del caffè richiede otto turni brevi in 15 secondi, mentre i prompt di ufficio e strada richiedono cinque turni in 12 secondi. Questi sono esempi di copione, non limiti garantiti. Leggi le battute ad alta voce, lascia spazio per le pause e accorciale se l'ultimo turno raggiunge la fine della clip.
Gemini Omni 1.2 Flash ha bisogno di un'immagine di riferimento per il dialogo a due parlanti?
Nessuna immagine di riferimento viene usata in questi tre prompt text-to-video. Descrivono posizione, abbigliamento e voce di ogni parlante nel testo. Se un progetto richiede un volto specifico o uno stile visivo, testa un percorso che accetta riferimenti e rivedi il suo output separatamente.


