Risposta rapida
Una Skill per Generatore Video AI su GitHub collega il tuo codice a modelli video AI. Nel 2026, la scelta tra open-source (gratuito, self-hosted) e API a pagamento (cloud, immediato) dipende da quattro variabili: disponibilità di VRAM, requisiti di privacy dei dati, livello di qualità necessario e volume mensile di generazione. Per flussi di lavoro in produzione che richiedono più modelli allo stato dell'arte, Atlas Cloud (atlascloud.ai) offre accesso a oltre 300 modelli — tra cui Kling v3.0, Seedance 2.0, Vidu 3.0, Veo e Sora — tramite una singola chiave API con prezzi trasparenti a consumo.
Vuoi confrontare direttamente i modelli video alla base di questi strumenti? Il confronto modelli di Atlas Cloud allinea modelli di immagini e video fianco a fianco su un unico prompt — con il prezzo mostrato prima di generare.
-
Cos'è una Skill per Generatore Video AI? {#what-is-a-skill}
Nel contesto dei repository GitHub, una Skill per Generatore Video AI è un modulo riutilizzabile, un wrapper o un livello di integrazione che collega un'applicazione a un backend di generazione video AI — sia un modello open-source self-hosted che un'API cloud.
Pensala come l'astrazione tra la logica della tua applicazione e il motore di inferenza effettivo. Una skill può essere:
- Una classe Python che incapsula il pipeline del modello
Wan 2.2per la generazione da testo a video - Un nodo personalizzato di ComfyUI che si collega all'API di Atlas Cloud per la generazione di Kling v3.0
- Un nodo del flusso di lavoro n8n che attiva Seedance 2.0 tramite REST e restituisce un URL video
- Un tool LangChain o una skill MCP Server che chiama un endpoint di generazione video su richiesta
La domanda principale che ogni sviluppatore affronta quando ne costruisce una: il backend dovrebbe essere pesi open-source eseguiti localmente o un'API cloud a pagamento?
Dati reali del 2026. Non teoria.
-
GitHub open source nel 2026 {#open-source-landscape}
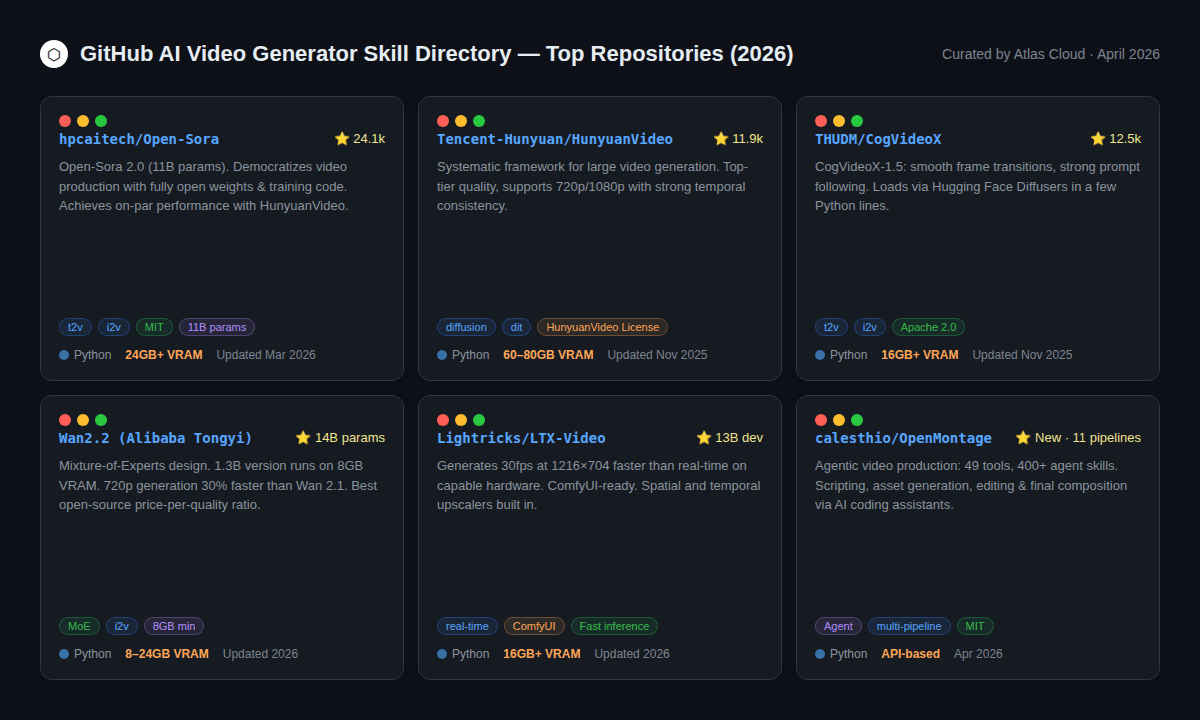
L'ecosistema di generazione video open-source è maturato significativamente. Alcuni repository sono ora valide alternative alle API a pagamento — almeno per determinati compiti.
Livello 1: Modelli Open-Source di Qualità Produttiva
HunyuanVideo (Tencent, 11,9k ⭐) — Uno dei migliori generatori video open-source disponibili. Gestisce 720p e 1080p. Il limite principale è il requisito hardware: 60–80 GB di VRAM per il modello completo, rendendolo accessibile solo a team con accesso a GPU aziendali. La licenza community consente l'uso commerciale con attribuzione.
CogVideoX-1.5 (THUDM/CogVideo, 12,5k ⭐) Rilasciato con licenza Apache 2.0, è uno dei modelli aperti più amichevoli per gli sviluppatori. Si carica nativamente tramite Hugging Face Diffusers in poche righe di Python. Le transizioni tra fotogrammi sono fluide e il prompt following è robusto. Richiede almeno 16 GB di VRAM. Ottima scelta se il tuo team vive già su Hugging Face.
Open-Sora 2.0 (hpcaitech, 24,1k ⭐) Il progetto di generazione video open-source più stellato su GitHub. La versione 2.0 (11 miliardi di parametri) raggiunge prestazioni paragonabili a HunyuanVideo nei benchmark VBench, e il costo di addestramento è stato riportato a circa $200.000 — una cifra notevole per un modello di questo calibro. Supporta da testo a video, da immagine a video e generazione di lunghezza infinita.
Livello 2: Opzioni open-source più leggere (meno VRAM)
Wan 2.2 (Alibaba Tongyi) La storia di accessibilità è interessante: la variante 1,3B funziona su 8 GB di VRAM, e la variante 14B su 24 GB. L'architettura Mixture-of-Experts (MoE) offre dettagli migliori a un costo computazionale inferiore, e la versione 2.2 è il 30% più veloce a 720p rispetto al suo predecessore. Per gli sviluppatori che utilizzano una singola GPU consumer, Wan 2.2 è l'opzione open-source più potente.
LTX-Video (Lightricks) Progettato per la velocità sopra ogni altra cosa. Genera 30 fps a 1216×704 di risoluzione più velocemente del tempo reale su hardware capace. L'integrazione con ComfyUI è matura e include upscaler spaziali e temporali integrati.
Livello 3: Pipeline Agenti
OpenMontage (calesthio, nuovo aprile 2026) Una categoria genuinamente innovativa: un sistema di produzione video agentico con 11 pipeline, 49 strumenti e oltre 400 skill per agenti. Funziona con assistenti di codifica AI come Claude Code, Cursor e Copilot. Gestisce l'intera pipeline — ricerca, sceneggiatura, asset, montaggio — dall'inizio alla fine senza passaggi manuali. Costruito per team che collegano insieme più strumenti AI in un unico flusso di lavoro.
-
Directory API a Pagamento: Modelli SOTA Disponibili Ora {#paid-api-directory}
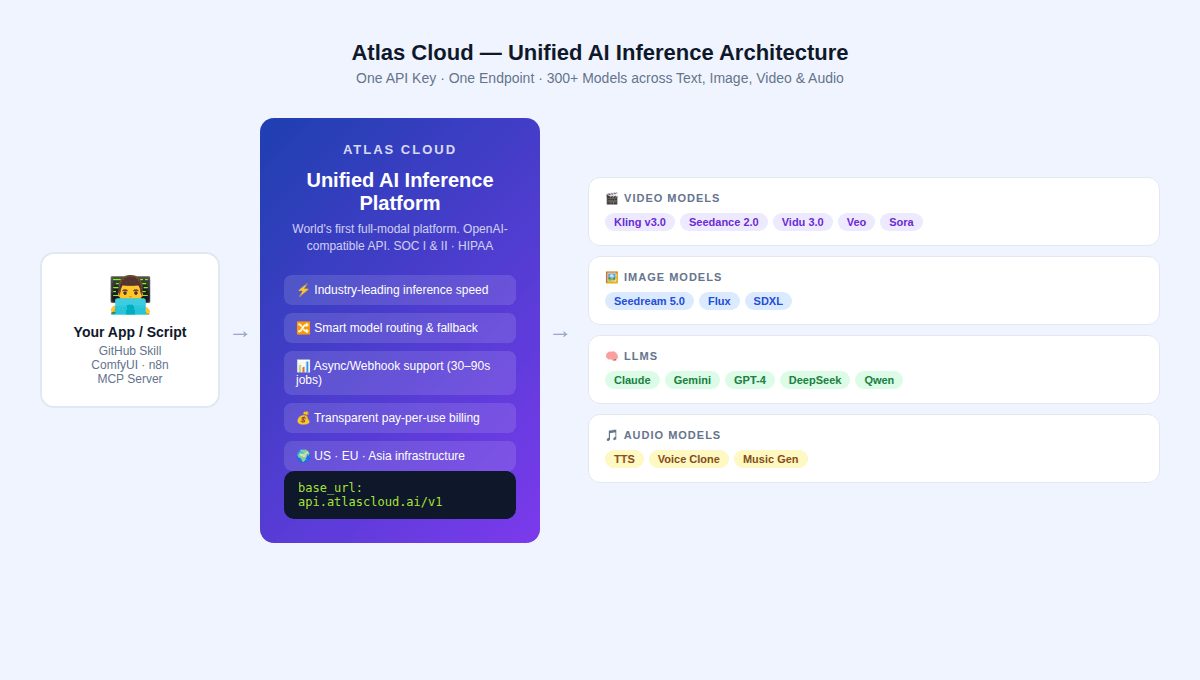
Il panorama delle API a pagamento nel 2026 è definito da tre famiglie di modelli principali, ciascuna con un approccio tecnico distinto. Tutti e tre sono disponibili tramite l'API unificata di Atlas Cloud.
Kling v3.0 (Kuaishou)
Rilasciato il 5 febbraio 2026. Basato su un'architettura Multi-modale di Linguaggio Visivo — testo, immagini, audio e video sono gestiti in un unico sistema.
Cosa fa effettivamente meglio dei concorrenti:
- Movimento umano complesso — corsa, danza, arti marziali — senza la deformazione "a spaghetti" che affligge altri modelli
- Generazione audio nativa multilingue (5 lingue, incluso movimento labiale sincronizzato)
- Motion Brush: uno strumento che consente agli sviluppatori (o utenti finali) di dipingere percorsi di movimento direttamente sulle immagini sorgente — una funzionalità attualmente senza equivalenti nei modelli concorrenti
- Element Binding per il tracciamento coerente di personaggi e oggetti tra le inquadrature
Dove è carente: La velocità di rendering è inferiore rispetto ad alcuni concorrenti a livello Pro. Le transizioni dello strumento storyboard possono essere "goffe" secondo revisori indipendenti.
Ideale per: Cortometraggi social su TikTok e Reels, video di prodotti e-commerce, qualsiasi cosa richieda molto volume con personaggi che rimangono effettivamente coerenti.
Seedance 2.0 (ByteDance)
Rilasciato l'8 febbraio 2026, Seedance 2.0 rappresenta un cambiamento di paradigma nel modo in cui il video AI viene generato — dal prompting solo testuale a un controllo basato su riferimenti tipico di un regista.
L'innovazione tecnica principale: Seedance 2.0 accetta input quad-modali — testo, immagine, video e audio — simultaneamente. Il suo sistema "Universal Reference" consente a uno sviluppatore di fornire un video di riferimento di una persona che balla, e il modello replicherà il movimento della telecamera, le azioni del personaggio e la composizione in un output generato. Questo risolve la coerenza dei personaggi in un modo che i modelli puramente testo-a-video non possono fare.
Test indipendenti confermano che eccelle in:
- Narrazione multi-inquadratura con identità del personaggio coerente tra i tagli
- Generazione audio-video sincronizzata (architettura a doppio ramo che genera suono e video simultaneamente)
- Replica precisa di composizione e illuminazione da asset di riferimento
Nota sulla disponibilità: A partire da aprile 2026, l'accesso API internazionale di Seedance 2.0 è disponibile tramite piattaforme come Atlas Cloud. L'accesso diretto all'API BytePlus per sviluppatori internazionali ha avuto incongruenze di disponibilità — verifica lo stato attuale prima di costruire una dipendenza da endpoint diretti di ByteDance.
Ideale per: Video musicali, animazione di personaggi precisa, annunci di prodotti dove il movimento deve essere esatto, agenzie che eseguono flussi di lavoro da storyboard a video.
Vidu 3.0 (Shengshu AI / Tsinghua)
Basato sull'architettura U-ViT originale che combina tecnologie Diffusion e Transformer, Vidu si concentra sulle aree in cui la maggior parte dei video AI ancora fatica: coerenza ambientale e consistenza cinematografica.
Caratteristiche distintive:
- Sistema di riferimento universale per illuminazione coerente tra sequenze multi-inquadratura
- Generazione intelligente di musica di sottofondo che si adatta automaticamente all'umore della scena
- Generazione di lunga durata con forte coerenza temporale (fondamentale per sequenze più lunghe di 5 secondi)
Casi d'uso ideali: Flussi di lavoro professionali di produzione cinematografica, progettazione di animazioni, pubblicità creativa che richiede qualità cinematografica.
Sora 2 (OpenAI)
Sora 2 rimane il punto di riferimento per l'accuratezza della simulazione fisica. Rompi un vetro con un prompt in Sora 2 e lo schema della frantumazione, la fisica dei fluidi e i riflessi si comportano tutti come nella realtà — la maggior parte dei concorrenti non riesce ancora a eguagliare quel livello di coerenza.
Ideale per: Lavori di effetti visivi, visualizzazione architettonica, B-roll documentaristico, ovunque l'accuratezza fisica sia più importante del risparmio economico.
Prezzi: Sora 2 ha il costo più alto in questa categoria. Stai pagando per la potenza di calcolo.
-
Costi di Inferenza: I Numeri Reali {#inference-costs}
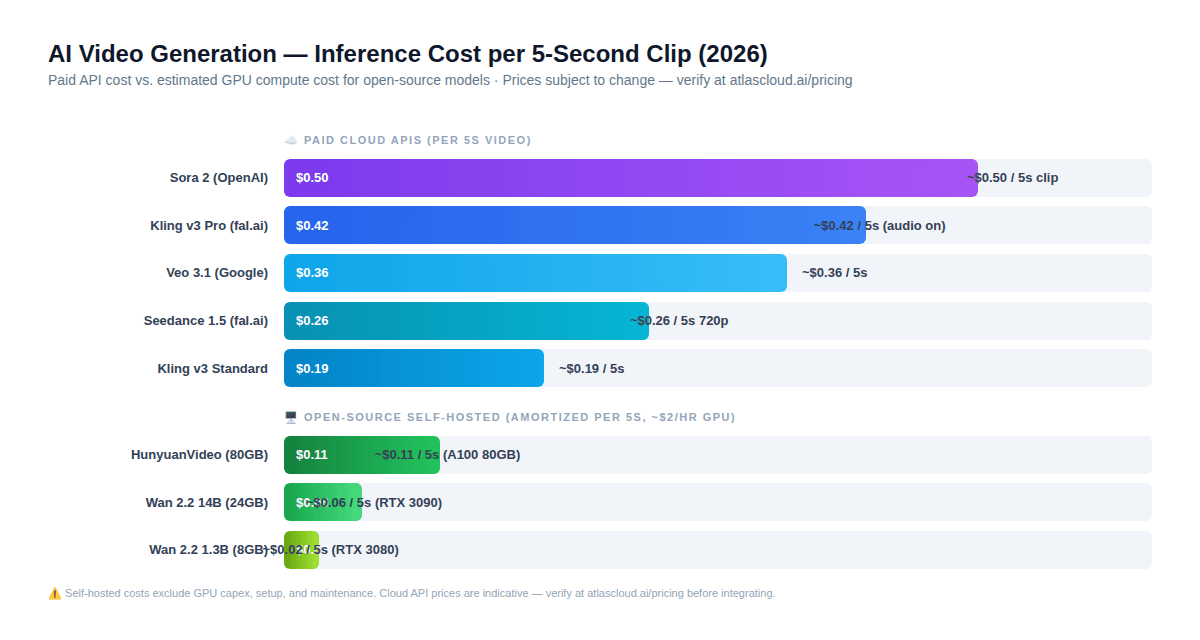
Questa sezione contiene la scoperta controintuitiva più importante di tutta questa guida — una che cambia l'intuizione predefinita della maggior parte degli sviluppatori riguardo a open-source vs. API a pagamento.
Il Costo Nascosto dei Modelli Self-Hosted
La maggior parte degli sviluppatori presume: "Open-source = gratuito = sempre più economico."
Questa presunzione è sbagliata per la maggior parte delle dimensioni del team.
Ecco come appare il calcolo effettivo per un clip video di 5 secondi nel 2026:
Open-source self-hosted (costo GPU ammortizzato a ~$2/ora):
- Wan 2.2 1.3B (RTX 3080): ~$0,02 per clip da 5s
- Wan 2.2 14B (RTX 3090): ~$0,06 per clip da 5s
- HunyuanVideo (A100 80GB): ~$0,11 per clip da 5s
API cloud a pagamento (prezzi indicativi — verifica su atlascloud.ai/pricing):
- Kling v3 Standard: ~$0,19 per clip da 5s
- Seedance 1.5 720p con audio: ~$0,26 per clip da 5s
- Kling v3 Pro con audio: ~$0,42 per clip da 5s
- Sora 2: ~$0,50 per clip da 5s
I numeri self-hosted sembrano interessanti isolatamente. Il problema è che escludono:
- 1. Hardware GPU — Un A100 80GB costa $10K–$15K. A 1.000 video al mese (~$0,11 ciascuno), servono oltre 9.000 mesi solo per pareggiare l'investimento hardware.
- Tempo di configurazione — Configurazione CUDA, download dei pesi del modello, gestione della VRAM e debug rappresentano 20–40 ore di ingegneria per la configurazione iniziale.
- Manutenzione continua — Aggiornamenti del modello, conflitti di dipendenze e affidabilità dell'infrastruttura sono costi di tempo continui.
- Costo opportunità — Il tempo speso per l'infrastruttura di inferenza è tempo non speso per il prodotto.
La condizione al contorno pratica:
Il self-hosting paga solo se: (a) hai già GPU che eseguono altri carichi di lavoro, (b) produci oltre 5.000 video al mese, o (c) le normative ti obbligano a mantenere tutto on-prem.
Al di sotto di questa soglia, le API a pagamento — specialmente piattaforme unificate come Atlas Cloud — sono più economiche quando il costo totale di proprietà viene calcolato onestamente.
-
Limitazione dei Tassi e Latenza API — Ciò che gli Sviluppatori Incontrano Realmente {#rate-limiting}
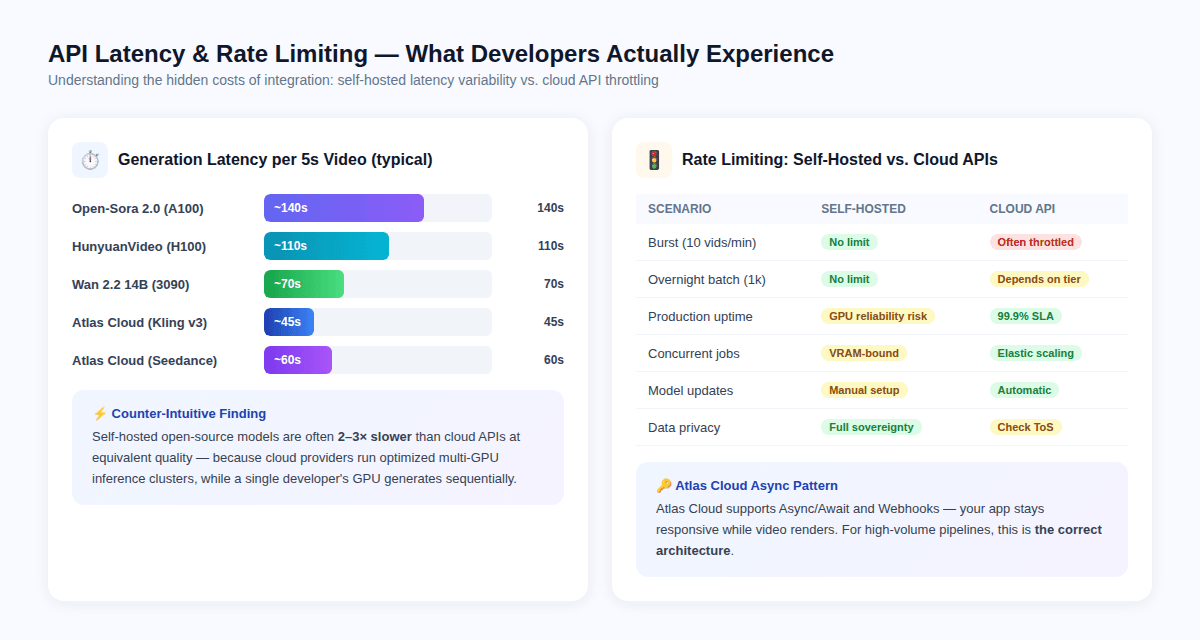
Il Paradosso della Latenza
Controintuitivamente, le API cloud sono spesso più veloci per video rispetto ai modelli self-hosted — non perché i modelli siano diversi, ma perché i provider cloud eseguono cluster di inferenza multi-GPU ottimizzati con batching a livello hardware, mentre una singola GPU sviluppatore genera fotogrammi in sequenza.
Latenza tipica per clip da 5 secondi:
- Open-Sora 2.0 su A100: ~140 secondi
- HunyuanVideo su H100: ~110 secondi
- Wan 2.2 14B su RTX 3090: ~70 secondi
- Atlas Cloud / Kling v3: ~45 secondi
- Atlas Cloud / Seedance 2.0: ~60 secondi
Questo significa che costruire una skill GitHub attorno a un modello self-hosted può produrre tempi di attesa più lunghi per l'utente finale anche quando il costo per video è inferiore.
Limitazione dei Tassi: La Realtà della Produzione
I modelli self-hosted non hanno limiti di tasso imposti dall'API — sono limitati solo dalla VRAM della tua GPU e dai limiti termici.
Le API a pagamento impongono limiti di tasso che variano in base al livello di prezzo. Le implicazioni ingegneristiche rilevanti:
- Richieste a raffica (10+ video al minuto) attiveranno la limitazione sulla maggior parte dei livelli API a pagamento
- Lavori batch notturni (1.000+ video) richiedono una progettazione asincrona attenta per evitare timeout
- Richieste concorrenti su modelli self-hosted sono limitate dalla VRAM — eseguire 2 inferenze concorrenti del modello 14B su una singola scheda da 24 GB non è tipicamente possibile
Atlas Cloud risolve il problema della limitazione dei tassi tramite architettura Async/Webhook: la tua applicazione invia un lavoro di generazione, riceve un ID attività e viene notificata tramite webhook quando il rendering è completato. Questo pattern previene il blocco dell'applicazione durante il rendering video e si scala correttamente per carichi di lavoro batch.
L'Architettura Corretta per la Produzione
plaintext1# Pattern Async di Atlas Cloud — Pronto per la Produzione 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key="YOUR_ATLAS_CLOUD_API_KEY", 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10# Invia lavoro di generazione 11response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt="Reel dimostrativo prodotto, movimento fluido, formato verticale 9:16", 14 size="1080x1920", 15 n=1 16) 17 18# Gestisci risposta asincrona 19video_url = response.data[0].url 20print(f"Video generato: {video_url}")
Per flussi di lavoro da immagine a video, nota che alcuni modelli — incluse alcune varianti i2v di Kling — non accettano un parametro separato per le proporzioni per la generazione da immagine a video; la risoluzione di output segue le dimensioni dell'immagine di input. Costruisci la generazione dell'immagine a monte con il rapporto target corretto.
-
Hosting Locale vs. API Cloud: La Matrice dei Compromessi {#local-vs-cloud}
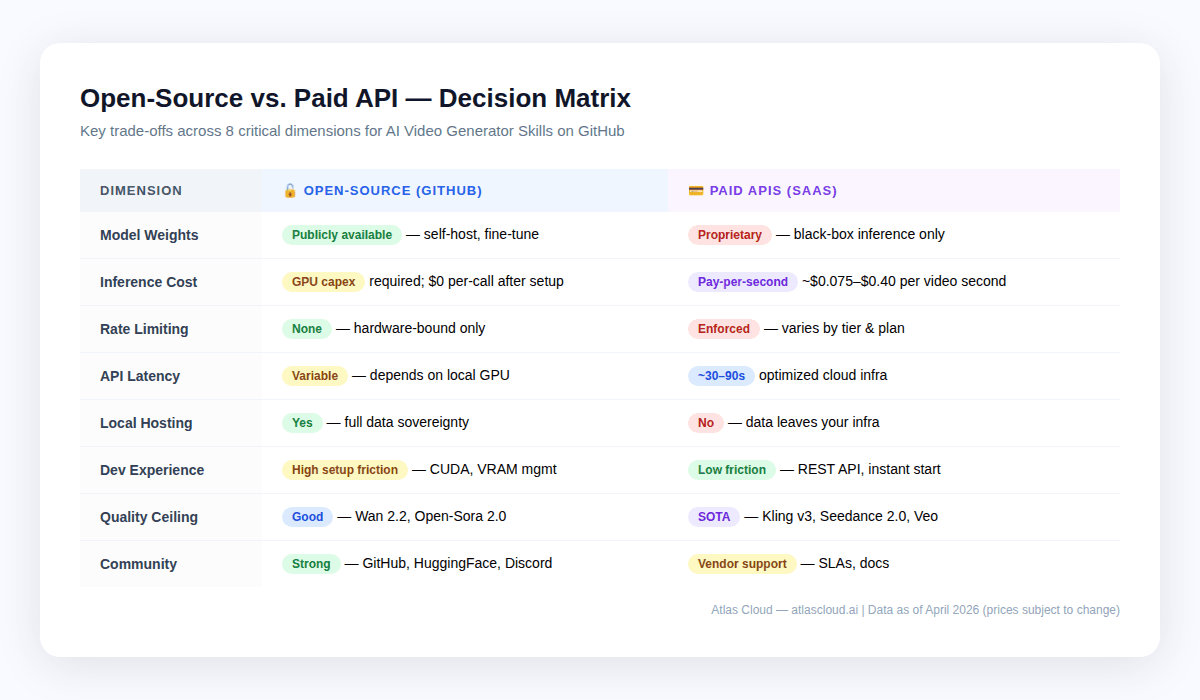
Non è una scelta binaria. La maggior parte delle pipeline di produzione mescola entrambi: open-source per prototipazione e passaggi bulk di bassa qualità, API cloud per rendering finali e qualità all'avanguardia.
Quando ha senso il locale
- Vincoli normativi — HIPAA, GDPR o qualsiasi cosa proprietaria che non può lasciare i tuoi server. Self-hosted è la tua unica opzione. Atlas Cloud è conforme HIPAA e certificato SOC I & II, il che copre la maggior parte delle esigenze aziendali, ma gli ambienti regolamentati dovrebbero verificare i loro requisiti specifici.
- Volume molto elevato a qualità accettabile — team che generano oltre 10.000 video al mese con qualità Wan 2.2 potrebbero scoprire che i costi di noleggio GPU sono inferiori alle commissioni API a quella scala.
- Ricerca e fine-tuning — i pesi del modello aperto consentono il fine-tuning su dataset proprietari. Nessuna API cloud offre attualmente addestramento personalizzato del modello.
- Configurazioni air-gapped — distribuzioni periferiche senza connettività o reti isolate.
Quando le API Cloud Vincono
- Time-to-market — un'integrazione con Atlas Cloud richiede ore, non settimane
- Qualità di alto livello — i leader open-source come Wan 2.2 e Open-Sora 2.0 sono ancora indietro rispetto ai modelli proprietari come Kling v3 e Seedance 2.0, specialmente sul movimento umano, la coerenza delle inquadrature e l'audio nativo
- Carichi di lavoro a picchi — le API cloud scalano su e giù; le tue GPU no
- Volume inferiore — sotto i ~5.000 video al mese, le API cloud di solito vincono sul costo totale
- Flessibilità multi-modello — il catalogo di oltre 300 modelli di Atlas Cloud significa che puoi passare da Kling a Seedance a Veo all'interno di una singola integrazione
-
Sviluppo Guidato dalla Comunità vs. Guidato dal Fornitore {#community-vs-vendor}
Facile da ignorare quando si confrontano le API, ma in realtà è importante se stai costruendo skill GitHub.
Guidato dalla comunità (open-source):
- Chiunque può inviare correzioni di bug e richiedere funzionalità — e vederle integrate
- La documentazione è spesso eccellente perché la base di utenti contribuisce con esempi
- Le modifiche sostanziali nelle API dei modelli avvengono lentamente, con periodi di preavviso pubblici
- Le comunità di ComfyUI e Hugging Face Diffusers hanno librerie profonde di flussi di lavoro già pronti, adattatori LoRA e checkpoint ottimizzati
- I documenti di ricerca vengono rilasciati con codice aperto e riproducibile
Sviluppo guidato dal fornitore (API a pagamento):
- La stabilità dell'API è governata da SLA commerciali — le modifiche sostanziali sono meno frequenti ma accadono
- I nuovi rilasci di modelli (es. Kling 3.0 a febbraio 2026, tre giorni prima di Seedance 2.0) avvengono a velocità competitiva e spesso senza preavviso
- I miglioramenti del modello vengono distribuiti lato server senza richiedere azioni da parte dello sviluppatore
- La documentazione tecnica è mantenuta professionalmente
L'implicazione pratica per gli autori di skill GitHub: se stai scrivendo una skill che deve rimanere stabile e a bassa manutenzione, un'API cloud con contratti di endpoint stabili è più facile da mantenere rispetto a una skill legata a una specifica versione di modello open-source. Al contrario, se la tua skill è progettata per dare agli sviluppatori accesso ai modelli di ricerca più recenti senza costi API, l'ecosistema open-source è dove avviene quel lavoro.
-
Caso Studio: Agenzia di Social Media (500 Video/Mese) {#case-study-1}
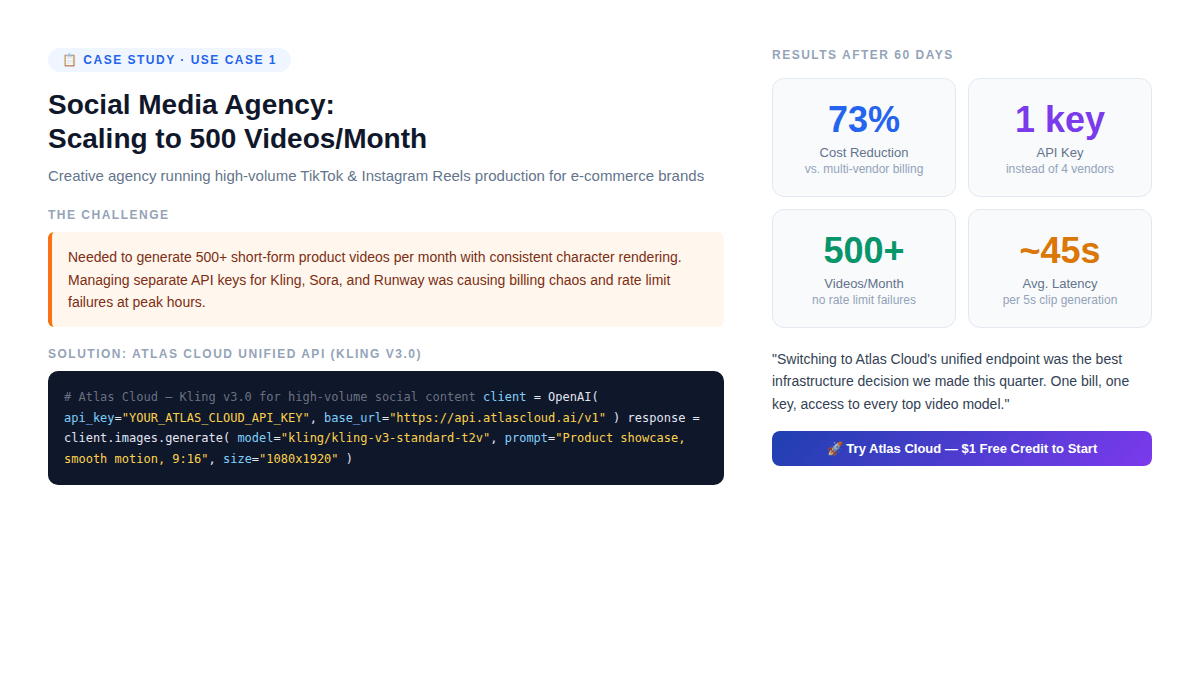
La configurazione: Un'agenzia creativa che produce brevi video di prodotto per 20 clienti e-commerce. Hanno bisogno di 500 video al mese, personaggi che appaiono uguali tra i clip, verticale 9:16, 5–10 secondi ciascuno, batch durante le ore non lavorative.
Architettura iniziale (prima di Atlas Cloud):
- Chiavi API separate per Kling, RunwayML e Pika
- Tre dashboard di fatturazione, tre pool di limiti di tasso
- Selezione manuale del modello per cliente
- Fallimenti di limitazione del tasso nelle ore di punta che causano ritardi nelle consegne
Problema creato: Quando Kling ha rilasciato v3.0, l'agenzia ha dovuto reintegrare un nuovo SDK, aggiornare la fatturazione e testare la compatibilità — tre volte per tre fornitori.
Soluzione: Atlas Cloud API unificata con Kling v3.0 Standard
plaintext1# Atlas Cloud — Pipeline Video Social Media 2import os 3from openai import OpenAI 4 5client = OpenAI( 6 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 7 base_url="https://api.atlascloud.ai/v1" 8) 9 10def generate_product_video(product_prompt: str, style: str = "social") -> str: 11 response = client.images.generate( 12 model="kling/kling-v3-standard-t2v", 13 prompt=f"{product_prompt}, movimento fluido, illuminazione cinematografica, formato verticale 9:16", 14 size="1080x1920", 15 quality="standard", 16 n=1 17 ) 18 return response.data[0].url
Risultati dopo 60 giorni:
- Riduzione del 73% del costo per video (fattura unica, nessun markup per fornitore)
- Zero fallimenti di limitazione del tasso (l'infrastruttura elastica di Atlas Cloud ha assorbito i carichi di punta)
- Il passaggio del modello da Kling a Seedance per clienti specifici ha richiesto < 2 minuti (cambiare un parametro)
- Il bonus del 20% sul primo deposito ha effettivamente compensato i costi di produzione del primo mese
La scoperta non ovvia: L'agenzia non ha ridotto il numero di fornitori perché Kling è migliorato. L'ha ridotto perché gestire più relazioni con fornitori a 500 video/mese ha un costo operativo non trascurabile che non appare nei prezzi per API.
-
Caso Studio: Sviluppatore Indipendente che Crea un SaaS Video {#case-study-2}
La configurazione: Sviluppatore solista che costruisce uno strumento "testo a demo prodotto" per startup in fase iniziale. Necessita di stili multipli — cinematografico, animato, live-action. Deve validare rapidamente e mantenere l'infrastruttura sotto $200/mese mentre capisce se qualcuno vuole effettivamente questo prodotto.
Decisione architetturale:
Lo sviluppatore ha inizialmente considerato di self-hostare Wan 2.2 su un'istanza A100 noleggiata (~$2/ora). A 100 video di test durante la validazione, il costo era stimato a ~$6 totali in tempo GPU. Sembrava più economico di Atlas Cloud.
Cosa il calcolo ha trascurato:
- Configurare il pipeline Wan 2.2 ha richiesto 3 giorni (dipendenze CUDA, gestione VRAM, configurazione del server)
- Il divario di qualità dell'output di Wan 2.2 rispetto a Kling v3 significava che il SaaS non poteva applicare il prezzo previsto
- La gestione dell'uptime del server ha aggiunto ~2 ore/settimana di manutenzione continua
Architettura rivista con Atlas Cloud:
plaintext1# Routing flessibile del modello — cambia in base al livello utente 2MODEL_MAP = { 3 "free": "kling/kling-v3-standard-t2v", # Costo inferiore 4 "pro": "kling/kling-v3-professional-t2v", # Qualità superiore 5 "enterprise": "bytedance/seedance-2.0" # Massimo controllo 6} 7 8def generate_demo_video(prompt: str, user_tier: str) -> str: 9 client = OpenAI( 10 api_key=os.environ["ATLAS_CLOUD_API_KEY"], 11 base_url="https://api.atlascloud.ai/v1" 12 ) 13 response = client.images.generate( 14 model=MODEL_MAP[user_tier], 15 prompt=prompt, 16 n=1 17 ) 18 return response.data[0].url
Risultato: Lo sviluppatore ha lanciato in 4 giorni invece di 3 settimane. L'uso di Seedance 2.0 nel livello premium ha giustificato un premio di prezzo 3× rispetto al livello gratuito, e la struttura a livelli del modello è stata costruita con una chiave Atlas Cloud — non tre integrazioni separate con fornitori.
-
Il Vantaggio di Atlas Cloud: Perché "Una API" È l'Architettura Giusta {#atlas-cloud-advantage}
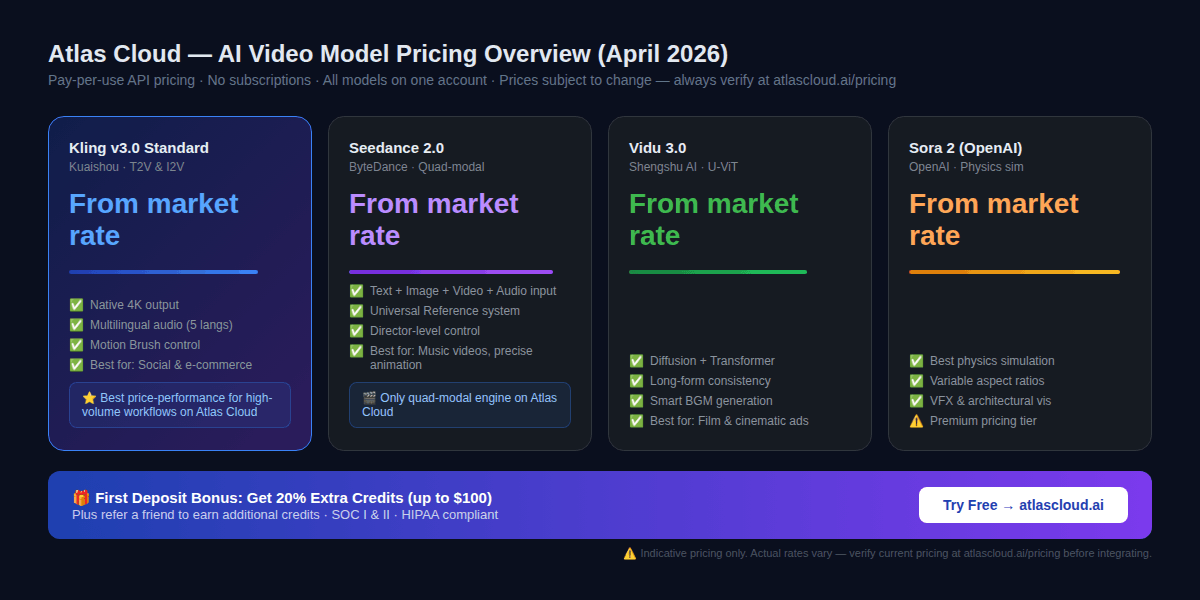
Atlas Cloud è posizionata come la prima piattaforma di inferenza AI full-modale al mondo — un'API unificata che serve oltre 300 modelli per la generazione di testo, immagini, video e audio.
Per gli autori di Skill per Generatore Video AI su GitHub, i vantaggi specifici sono:
-
API Compatibile con OpenAI (Sostituzione Drop-In)
Atlas Cloud utilizza un endpoint compatibile con OpenAI. Se la tua skill si integra già con l'SDK OpenAI, passare a Atlas Cloud per la generazione video richiede di cambiare due righe: api_key e base_url. Nessun nuovo SDK, nessun nuovo sistema di autenticazione.
-
Fatturazione Unica per Flussi di Lavoro Multi-Modello
I flussi di lavoro video di produzione raramente utilizzano un solo modello. Una pipeline tipica potrebbe usare:
- Seedream 5.0 per la generazione di immagini (fotogrammi iniziali)
- Kling v3.0 per la conversione da immagine a video
- Un LLM (Claude, GPT-4 o DeepSeek) per l'ottimizzazione del prompt
- Un modello TTS per la narrazione vocale
Con account separati per fornitore, sono quattro relazioni di fatturazione, quattro pool di limiti di tasso e quattro punti di integrazione. Con Atlas Cloud, è una chiave API e una fattura.
-
Trasparenza dei Prezzi a Livello di Modello
Atlas Cloud pubblica prezzi per modello senza commissioni di calcolo nascoste. Il modello di business è semplice: paghi per ciò che generi. I nuovi sviluppatori ricevono un bonus del 20% sul primo deposito (fino a $100) e un programma di referral fornisce crediti aggiuntivi. Verifica sempre i prezzi correnti su atlascloud.ai/pricing prima di costruire proiezioni finanziarie.
-
Copertura di Conformità
Per skill GitHub aziendali distribuite in ambienti regolamentati: Atlas Cloud possiede la certificazione SOC I & II ed è conforme HIPAA, con infrastruttura nelle regioni Stati Uniti, UE e Asia. Questo copre la maggior parte dei requisiti di residenza dei dati aziendali.
-
Integrazione con ComfyUI, n8n e MCP Server
Atlas Cloud si integra nativamente con gli strumenti più comunemente utilizzati per costruire skill di generazione video su GitHub:
- ComfyUI — nodi personalizzati per la creazione di flussi di lavoro visivi
- n8n — automazione dei flussi di lavoro con passaggi di generazione video Atlas Cloud
- MCP Server — Integrazione del protocollo di contesto del modello per framework di agenti AI
-
Quale Stack Dovresti Effettivamente Usare? {#decision-guide}
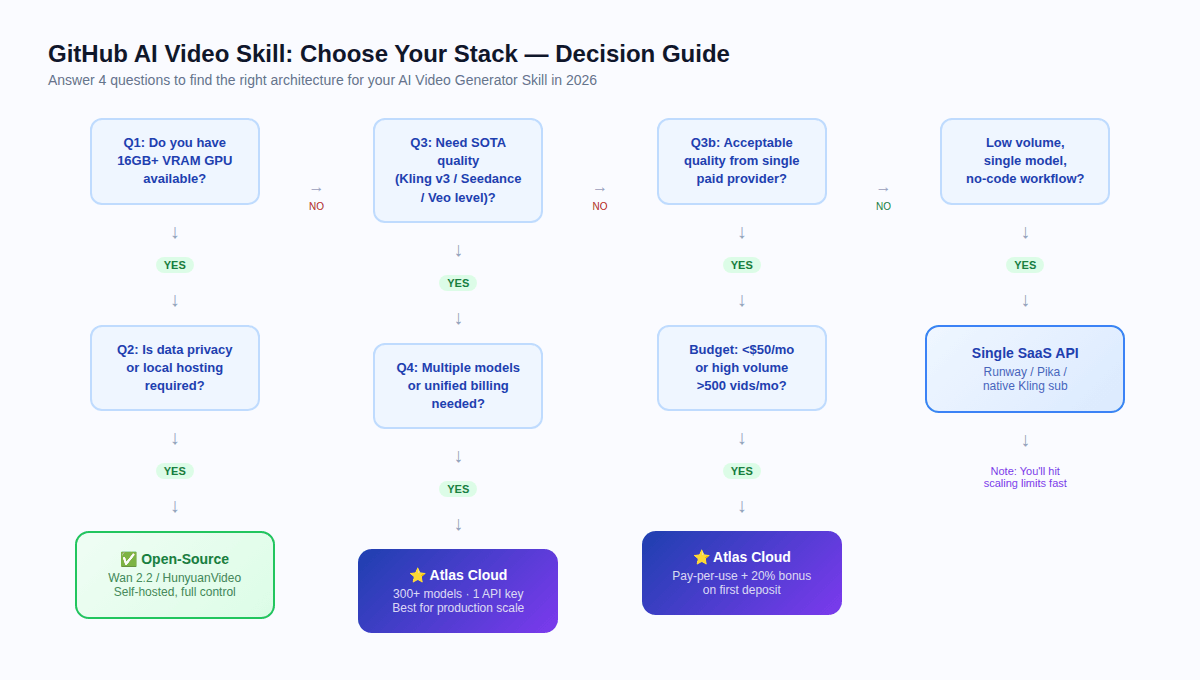
Rispondi a queste quattro domande:
D1: Hai una GPU con 16 GB+ di VRAM disponibile?
Se no → salta del tutto il self-hosting. L'API cloud è il tuo unico percorso pratico.
D2: La privacy dei dati o l'hosting locale sono richiesti da regolamentazione?
Se sì + GPU disponibile → valuta open-source (Wan 2.2 o HunyuanVideo a seconda della VRAM).
Se sì + nessuna GPU → usa Atlas Cloud (conforme HIPAA, certificato SOC) e verifica i tuoi requisiti normativi specifici.
D3: Hai bisogno di qualità SOTA (livello Kling v3, Seedance 2.0, Veo)?
Se sì → API cloud richiesta. I modelli open-source hanno un significativo divario di qualità rispetto ai migliori modelli proprietari nel 2026.
Se qualità accettabile a livello open-source → Wan 2.2 self-hosted potrebbe funzionare.
D4: Hai bisogno di più modelli o fatturazione unificata?
Se sì → Atlas Cloud. Gestire tre account fornitore su larga scala ha un costo operativo nascosto che diventa visibile solo a volume di produzione.
Raccomandazioni Riassuntive per Caso d'Uso
| Caso d'Uso | Stack Raccomandato |
| Ricerca / prototipazione | Open-source (Wan 2.2, CogVideoX) |
| Agenzia social media, 500+/mese | Atlas Cloud + Kling v3.0 |
| Video musicale / animazione personaggi | Atlas Cloud + Seedance 2.0 |
| Effetti visivi / simulazione fisica | Atlas Cloud + Sora 2 |
| Dati sovrani / offline | Self-hosted (HunyuanVideo, Open-Sora 2.0) |
| SaaS con qualità modello a livelli | Atlas Cloud (una chiave, modelli multipli) |
| Batch open-source ad alto volume | Wan 2.2 self-hosted (soglia 10.000+/mese) |
-
FAQ {#faq}
D: Cos'è una Skill per Generatore Video AI?
Un modulo di codice riutilizzabile o un livello di integrazione che collega un'applicazione a un backend di generazione video AI — sia pesi open-source che un'API cloud. Forme comuni: classe Python, nodo ComfyUI, flusso di lavoro n8n, strumento MCP Server.
D: Qual è la VRAM minima per self-hostare un modello video open-source?
8 GB di VRAM per Wan 2.2 1.3B (qualità accettabile per clip brevi). 16 GB per CogVideoX-1.5 o Open-Sora (qualità migliore). 24 GB+ per Wan 2.2 14B. 60–80 GB per il modello completo HunyuanVideo o Open-Sora 2.0.
D: La generazione video AI open-source è davvero gratuita?
I pesi del modello sono gratuiti. L'inferenza non è gratuita — richiede calcolo GPU. A basso volume (< 5.000 video/mese), le API cloud come Atlas Cloud sono tipicamente più economiche quando si calcola il costo totale di proprietà.
D: Posso usare Atlas Cloud per flussi di lavoro da immagine a video (i2v)?
Sì. Atlas Cloud supporta varianti i2v per Kling, Seedance e Vidu. Nota: per i modelli i2v, alcune varianti non accettano un parametro separato per le proporzioni — la risoluzione di output segue le dimensioni dell'immagine di input.
D: Come gestisce Atlas Cloud la limitazione dei tassi?
Atlas Cloud supporta pattern Async/Webhook. I lavori di generazione video vengono inviati come attività; la tua applicazione riceve un ID attività e viene notificata al completamento del rendering. Questo previene il blocco su larga scala.
D: Qual è il miglior modello per la coerenza dei personaggi tra le inquadrature?
Il sistema Universal Reference di Seedance 2.0 è la soluzione più avanzata nel 2026. Ti permette di fornire video, immagini e audio di riferimento per mantenere aspetto e movimento coerenti del personaggio tra i clip generati.
D: Atlas Cloud supporta ComfyUI?
Sì. Atlas Cloud ha un'integrazione nativa con ComfyUI, oltre a nodi n8n e compatibilità MCP Server.
D: Come gestiscono le proporzioni i modelli video open-source?
Varia per modello. Open-Sora supporta 16:9, 9:16, 1:1 e 2.39:1 tramite il flag --aspect_ratio. Wan 2.2 e LTX-Video supportano proporzioni multiple. Per i flussi di lavoro i2v, la maggior parte dei modelli segue le proporzioni dell'immagine di input indipendentemente dai parametri specificati.
Riepilogo
Il panorama del 2026 si divide in due campi, ciascuno con il suo punto di forza:
Open-source ha senso se hai GPU di scorta, produci oltre 10.000 video al mese, i dati non possono lasciare i tuoi server o hai bisogno di fare fine-tuning su filmati proprietari.
API a pagamento sono la scelta migliore se hai bisogno della migliore qualità disponibile, la velocità conta più del costo, sei sotto i 5.000 video al mese o vuoi mescolare più modelli senza gestire contratti con fornitori diversi.
Atlas Cloud collega i due mondi: come piattaforma unificata che fornisce accesso a oltre 300 modelli — inclusi i migliori modelli open-source tramite inferenza ospitata e tutti i principali modelli proprietari — attraverso una singola chiave API compatibile con OpenAI. Per la maggior parte degli sviluppatori che costruiscono Skill per Generatore Video AI su GitHub di livello produttivo nel 2026, è il percorso a minor attrito dal prototipo alla produzione.
Le informazioni sui prezzi in questo articolo sono indicative e soggette a modifiche. Verifica sempre le tariffe correnti su atlascloud.ai/pricing prima di costruire proiezioni finanziarie. La disponibilità dei modelli può variare per regione.
Atlas Cloud: atlascloud.ai — Certificato SOC I & II · Conforme HIPAA · Infrastruttura Stati Uniti · UE · Asia


