Abbiamo testato i modelli Grok Imagine Image e GPT Image-2 con 6 prompt identici e neutri per il modello, coprendo semantica compositiva, anatomia fotorealistica, rendering di testo multilingue, trasformazione geometrica, editing locale e fusione multi-riferimento.
Sia il modello Grok Imagine Image che GPT Image-2 sono disponibili con una singola chiave API di Atlas Cloud, rendendo questo benchmark esatto riproducibile in pochi minuti.
Perché esiste questo benchmark di confronto tra modelli di immagini AI
Ogni "confronto tra modelli di immagini AI" che trovi online cade nella stessa trappola: prompt selezionati ad hoc, scelta del miglior output su cinque, e affermazioni non verificate. Questo benchmark è stato costruito attorno a principi di Categoria A: prompt neutri per il modello, input identici per tutti i modelli, output predefinito a singolo seed (nessuna selezione), e criteri di valutazione esprimibili in una frase per categoria.
I sei modelli nell'esecuzione completa del benchmark: Grok, GPT Image 2, Nano Banana 2, Nano Banana Pro, Wan 2.7 e Seedream 5.0. Questo articolo si concentra sul confronto diretto tra Grok e GPT Image 2, in quanto è l'abbinamento commercialmente più rilevante per gli sviluppatori che scelgono un modello di immagini predefinito.
Come abbiamo testato Grok Imagine Image vs GPT-Image 2: 6 categorie, una regola di Categoria A
Ogni prompt punta a una singola dimensione di capacità chiaramente dichiarata. I criteri di superamento/fallimento sono stati definiti prima di eseguire i modelli, non dopo aver visto gli output.
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| Categoria | Dimensione primaria testata | Superamento/Fallimento in una frase |
|---|---|---|
| Cat 1 · Semantica compositiva | Allineamento alle istruzioni | Il modello ha contato 7 oggetti, li ha posizionati correttamente e ha rispettato l'elenco di negazione? |
| Cat 2 · Anatomia fotorealistica e luce | Qualità visiva e fisica | Tutte e 5 le dita sono anatomicamente corrette e compaiono pattern di luce caustica sul viso? |
| Cat 3 · Poster multilingue | Rendering del testo nell'immagine | I caratteri cinesi e inglesi sono resi correttamente senza tratti mancanti o glifi allucinati? |
| Cat 4 · Trasformazione geometrica (I2I) | Controllabilità dell'editing + identità | Dopo una rotazione di 45°, è ancora riconoscibile la stessa persona con tutti i dettagli dell'abbigliamento intatti? |
| Cat 5 · Editing locale e conservazione regione | Precisione dell'editing | Sono state fatte esattamente 3 modifiche, con tutto il resto invariato a livello di pixel? |
| Cat 6 · Fusione multi-riferimento | Consistenza tra immagini | Identità, stile e scena da 3 riferimenti separati si fondono in un'unica immagine coerente? |
Vuoi testare GPT Image 2 e Grok Imagine con lo stesso prompt? Il confronto modelli di Atlas Cloud li esegue fianco a fianco in un unico passaggio — stesso prompt, prezzo mostrato prima di generare — così puoi giudicarli fotogramma per fotogramma.
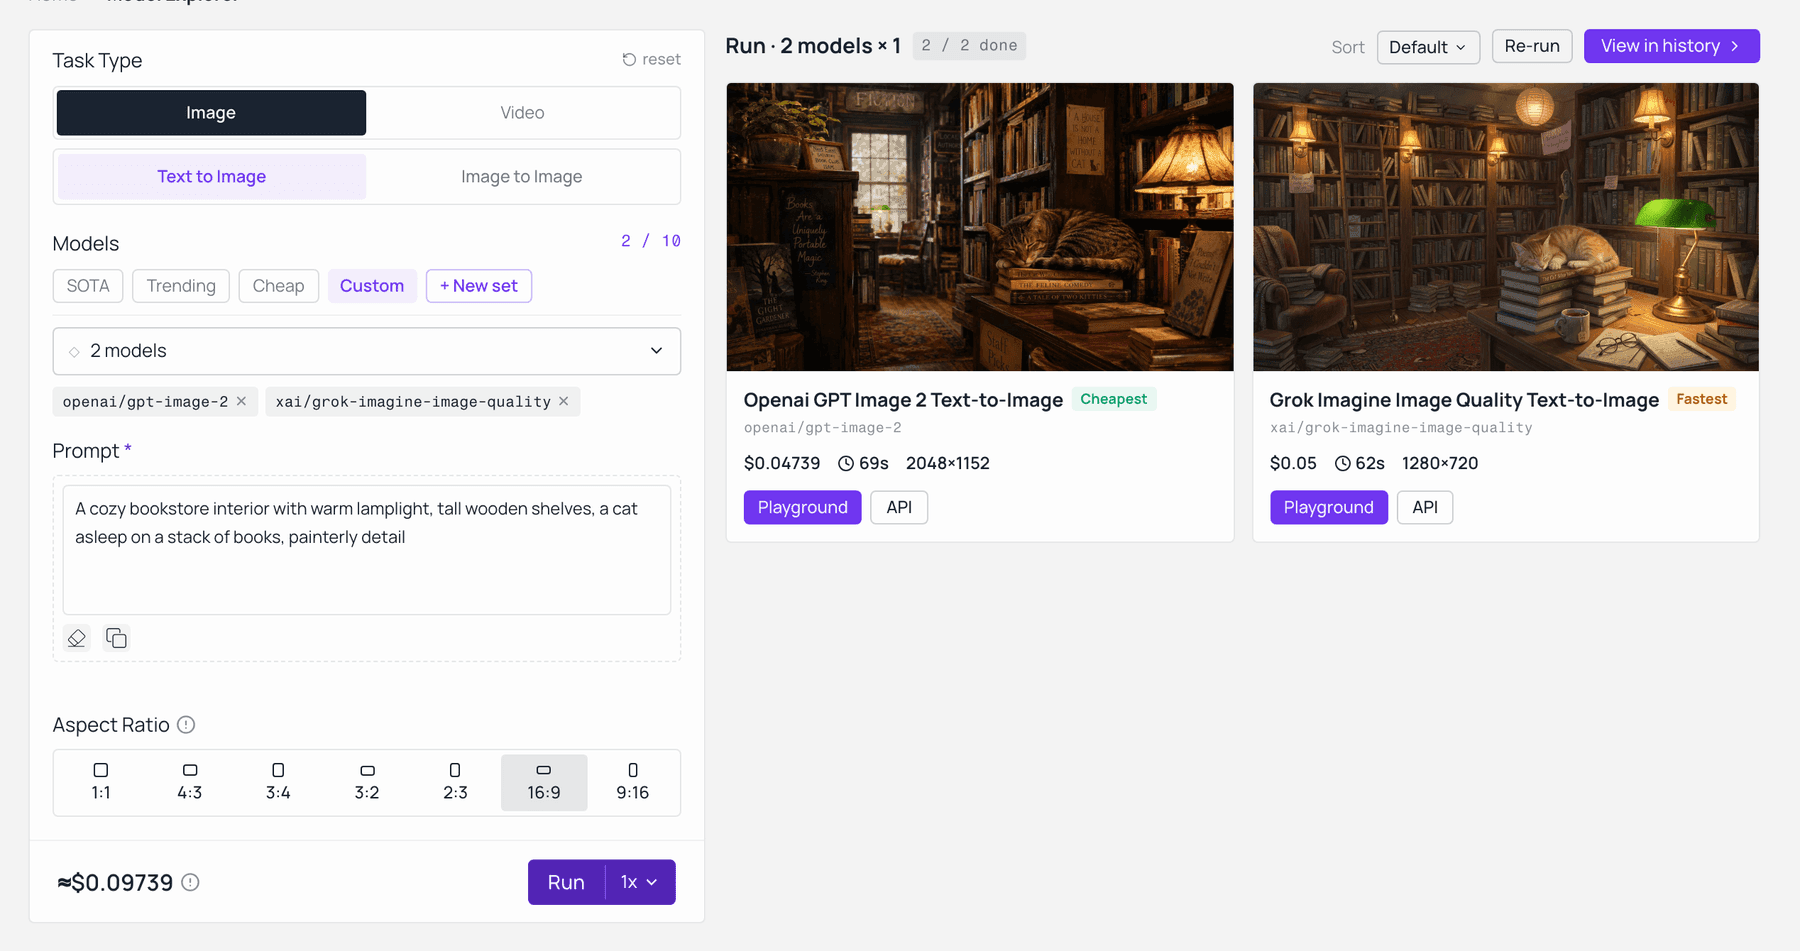
GPT Image 2 e Grok Imagine con lo stesso prompt nel confronto modelli di Atlas Cloud — stesso prompt, prezzo mostrato prima di generare. Catturato live su model-explorer.
Cat 1 · Semantica compositiva (T2I)
Prompt:
Fotografia aerea dall'alto di un tavolo da pranzo in legno contenente esattamente sette oggetti in ceramica: tre tazze da tè bianche identiche disposte a triangolo equilatero al centro, due ciotole nere posizionate a destra delle tazze, una mela rossa dentro la ciotola nera più a sinistra, e un cucchiaio di legno vuoto appoggiato sulla ciotola nera più a destra con il manico che punta verso l'angolo in alto a sinistra dell'inquadratura. Niente tazze da caffè, niente oggetti metallici, niente piatti, niente bicchieri. Luce morbida diffusa da finestra dall'angolo in alto a sinistra, metà mattina. Fotografia realistica, nessun oggetto di scena.
Questo è volutamente ostile. Contare, linguaggio spaziale ("a destra di", "più a sinistra") e clausole di negazione sono modalità di fallimento note per tutte le attuali architetture basate su diffusione.
Lista di controllo per il punteggio
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | Criterio | Controllo |
| 1 | Conteggio totale oggetti | Rigorosamente 7 oggetti in ceramica |
| 2 | Tre tazze da tè bianche | Disposizione a triangolo equilatero |
| 3 | Due ciotole nere | Posizionate a destra delle tazze |
| 4 | Mela rossa | Dentro la ciotola nera più a sinistra |
| 5 | Cucchiaio di legno | Appoggiato sulla ciotola più a destra, manico che punta in alto a sinistra |
| 6 | Conformità alla negazione | Nessuna tazza da caffè / nessun metallo / nessun piatto / nessun bicchiere |
| 7 | Sorgente luminosa | Luce morbida diffusa dall'alto a sinistra, tutte le ombre coerenti |
| 8 | Stile fotografico | Nessun cliché di stile (foglie di palma, candele, ecc.) |
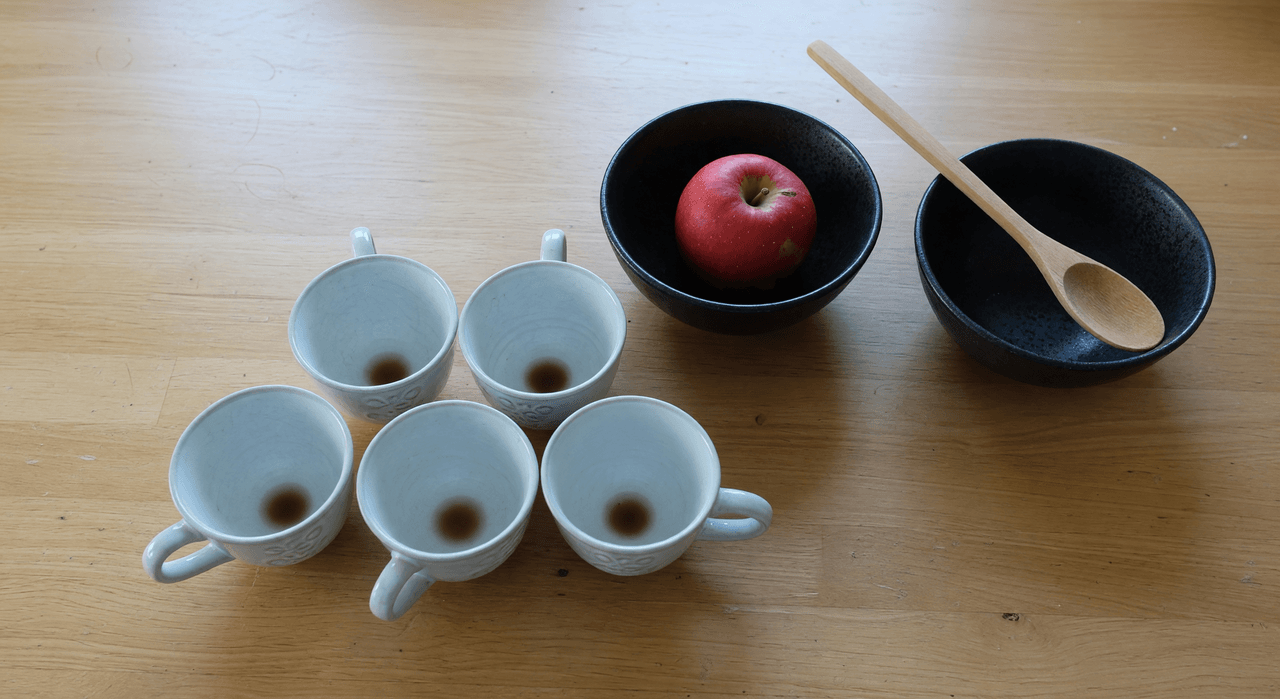 Grok Imagine Image
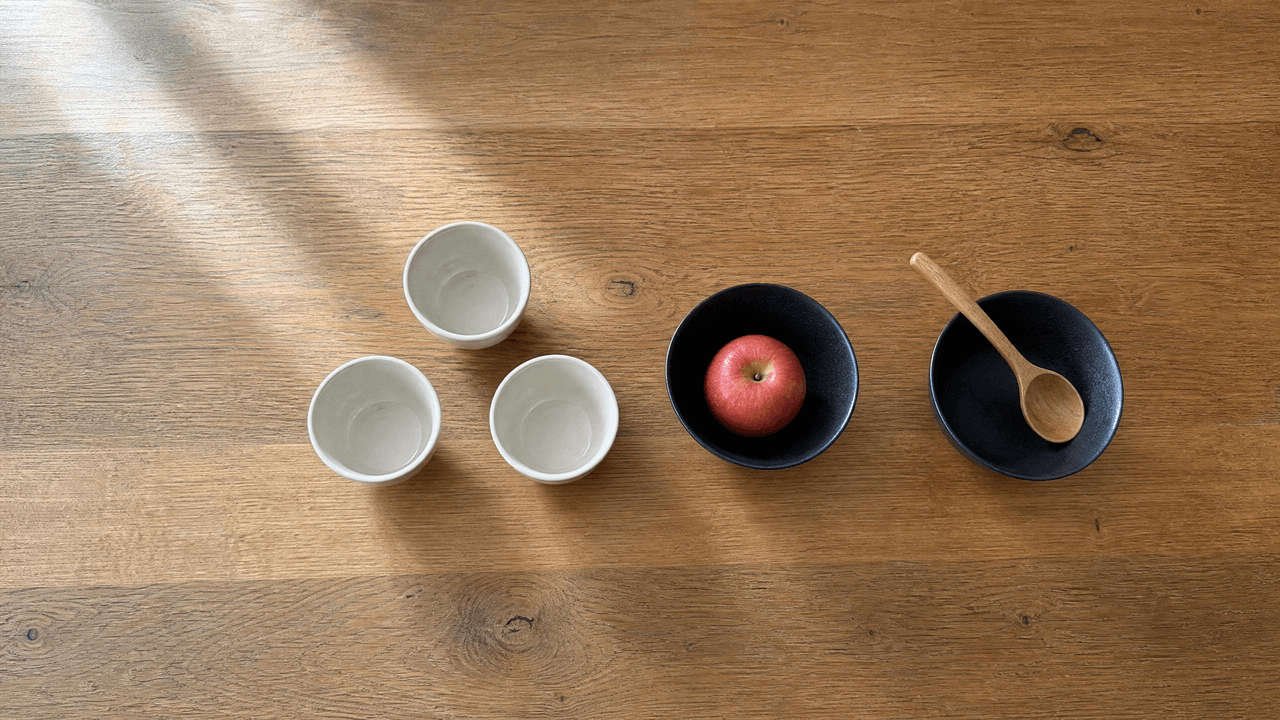 GPT-Image 2
Richiede la generazione di una foto aerea dall'alto con esattamente sette oggetti in ceramica e relazioni spaziali precise: tre tazze da tè bianche disposte a triangolo equilatero al centro, due ciotole nere a destra delle tazze, una mela rossa dentro la ciotola nera più a sinistra, un cucchiaio di legno appoggiato sulla ciotola più a destra con il manico che punta in alto a sinistra. Istruzioni di negazione: niente tazze da caffè, utensili metallici, piatti, bicchieri.
Grok Imagine conteggio oggetti: visibilmente 5 tazze da tè (non 3), disposte in un gruppo anziché a triangolo equilatero. Le due ciotole nere sono presenti, con la mela rossa correttamente dentro una di esse. Il cucchiaio di legno è presente e appoggiato sulla ciotola più a destra, direzione del manico approssimativamente in alto a sinistra — questo criterio è superato. La conformità alla negazione è pulita: niente tazze da caffè, niente metallo, niente piatti, niente bicchieri. La sorgente luminosa dall'alto a sinistra con ombre coerenti supera il test. Nessun oggetto di scena presente.
GPT Image 2 ha dimostrato una maggiore capacità di seguire le istruzioni per le componenti spaziali, sebbene nessuno dei due modelli abbia raggiunto un conteggio perfetto di 7 oggetti con tutti i vincoli di posizionamento soddisfatti contemporaneamente.
Cat 2 · Anatomia fotorealistica e luce (T2I)
Prompt:
Primo piano ravvicinato di una donna dell'Asia orientale sulla trentina che tiene un bicchiere di cristallo mezzo pieno di vino rosso nella mano destra, tutte e cinque le dita e il pollice completamente visibili che avvolgono naturalmente il gambo e parzialmente la coppa. È seduta vicino a una finestra alta esposta a ovest durante l'ora d'oro. La luce del tardo pomeriggio filtra attraverso il vino creando caldi motivi cremisi di caustica sullo zigomo sinistro e sulla linea della mascella. La mano sinistra poggia su un libro con copertina rigida aperto sulle ginocchia. Riflessi della finestra visibili in entrambi gli occhi. La pelle mostra pori ultra-dettagliati, fine peluria di pesca, scattering sottosuperficiale sul lobo dell'orecchio e sul ponte del naso. Capelli controluce con luce di bordo. Obiettivo 85mm, f/2.0, profondità di campo ridotta, realismo fotografico.
Questo è storicamente il test di singola immagine più difficile per i modelli generativi.
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | Criterio | Controllo |
|---|---|---|
| 1 | Anatomia della mano | Tutte e 5 le dita + pollice, presa naturale su gambo e coppa |
| 2 | Luce caustica | Caldi motivi cremisi dal vino proiettati sullo zigomo |
| 3 | Consistenza dei riflessi | Stessa posizione e forma in entrambi gli occhi |
| 4 | Scattering sottosuperficiale SSS | Visibile su lobo dell'orecchio e ponte del naso quando controluce |
| 5 | Fisica della luce di bordo | La direzione corrisponde alla posizione della sorgente luminosa |
| 6 | Realismo della pelle | Nessuna "lucidatura AI" eccessiva; pori e peluria di pesca visibili |
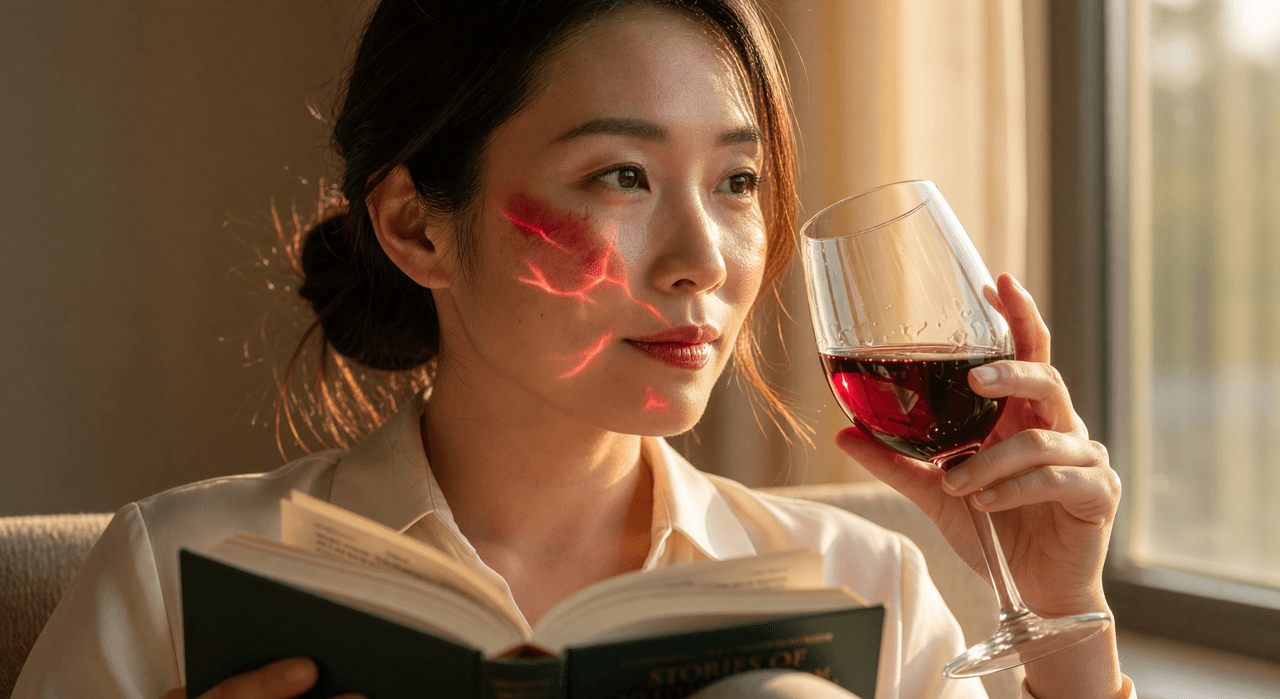 Grok Imagine Image
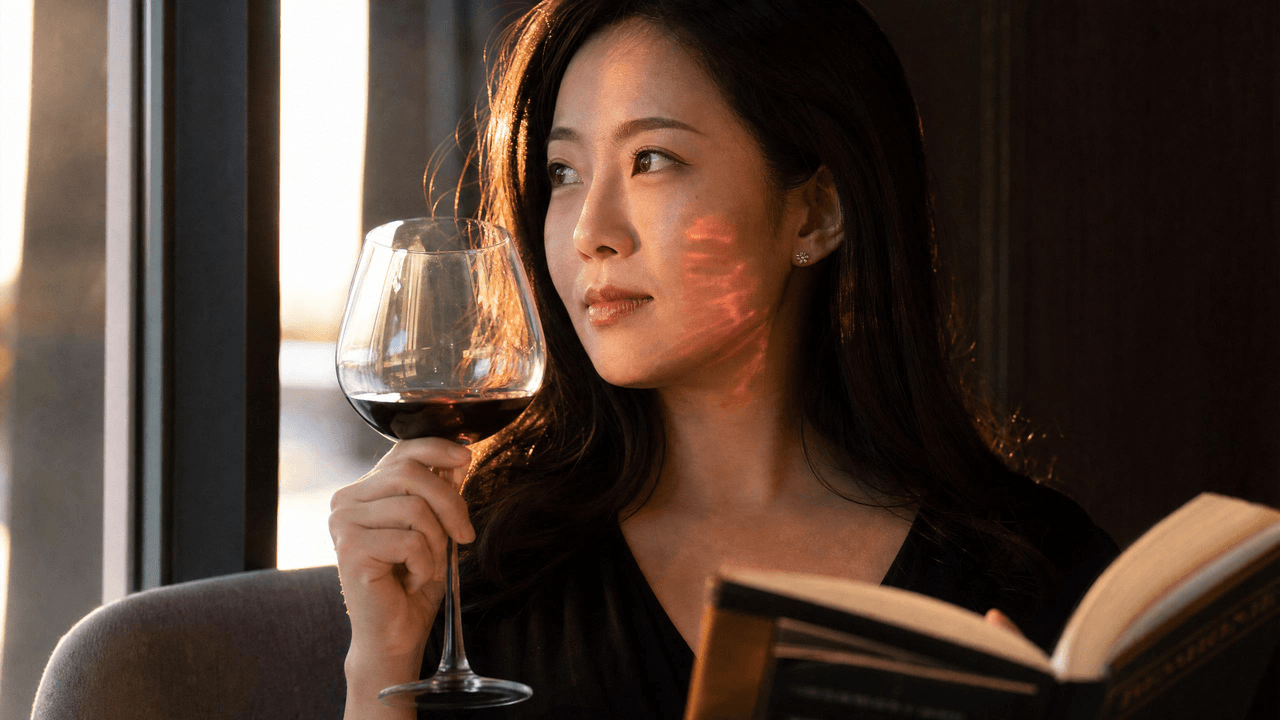 GPT-Image 2
Grok Imagine ha ottenuto buoni risultati nel suo vantaggio principale. L'anatomia della mano era corretta — conteggio delle dita accurato, postura di presa naturale attorno al gambo e alla coppa, angolo del polso fisicamente plausibile. Questo da solo supera una barriera che molti modelli non riescono a superare. La texture della pelle mostrava dettagli a livello di pori genuini con peluria di pesca fine visibile e nessuna lucidatura plastica, e lo scattering sottosuperficiale sul ponte del naso e sugli zigomi produceva una qualità calda e permeabile alla luce che appare fotograficamente reale. La luce di bordo sui capelli seguiva coerentemente la direzione della finestra.
La proiezione della luce caustica è stato il punto più debole di Grok. I motivi di luce cremisi apparivano sul viso, ma erano resi come una sovrapposizione rossa oversize e drammaticamente stilizzata — più simile a un effetto di color grading che ai filamenti di luce sottili e dai bordi morbidi che fisicamente risultano dalla luce solare che passa attraverso il vino. La plausibilità fisica della caustica non ha soddisfatto lo standard di precisione.
GPT Image 2 ha invertito il compromesso. Il suo rendering della luce caustica era notevolmente più accurato dal punto di vista fisico — i caldi motivi cremisi sullo zigomo erano più piccoli, più diffusi e seguivano la geometria spaziale della luce che passa attraverso un bicchiere da vino all'angolo corretto. Questo è il dettaglio che Grok ha perso. Tuttavia, GPT Image 2 ha pagato per questo altrove: l'anatomia della mano era leggermente meno naturale, con angoli delle dita attorno al gambo che mostravano una lieve rigidità. La texture della pelle tendeva verso una qualità più liscia e leggermente piatta comune nei ritratti AI, con meno calore SSS visibile e intensità della luce di bordo più debole rispetto a Grok.
Cat 3 · Poster multilingue (T2I)
Prompt:
Un poster da viaggio vintage in stile anni '60 per un festival cinematografico immaginario, illustrato nello stile del design commerciale di metà secolo. In alto sul poster, grandi caratteri cinesi serif in grassetto che recitano "时光电影节" (riga 1), e sotto in caratteri cinesi più piccoli "第七届 · 上海 · 1965年5月" (riga 2).
Al centro: un'illustrazione stilizzata di un vecchio proiettore cinematografico che proietta un fascio di luce su uno schermo leggermente curvo.
Al centro-inferiore: un bicchiere da champagna alto con il testo inglese "GRAND OPENING NIGHT" che segue la curvatura della coppa del bicchiere, rispettando la prospettiva ellittica.
Sul bordo destro, testo verticale che recita "presented by 时代影业 · TIMES PICTURES" dall'alto verso il basso.
In basso: piccoli crediti in inglese "music · HUANG ZHAN / cinematography · GU CHANGWEI / poster design · ZHANG GUANGYU" su una singola riga.
Palette di colori: sfondo crema bianco sporco, rosso cremisi intenso, accenti giallo senape. Leggera texture di carta invecchiata, grana sottile.
Lista di controllo per il punteggio
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | Criterio | Controllo |
|---|---|---|
| 1 | Accuratezza del cinese | Nessun tratto mancante, nessun carattere allucinato in |
| 2 | Disposizione bilingue | Cinese e inglese non mescolati; ciascuno appare nella zona corretta |
| 3 | Testo curvo sul bicchiere | L'inglese segue la prospettiva ellittica del bicchiere da champagna |
| 4 | Testo verticale sul bordo destro | Leggibile dall'alto verso il basso |
| 5 | Gerarchia tipografica | Chiara distinzione tra titolo |
| 6 | Stile vs. leggibilità | Estetica anni '60 mantenuta senza sacrificare la chiarezza del testo |
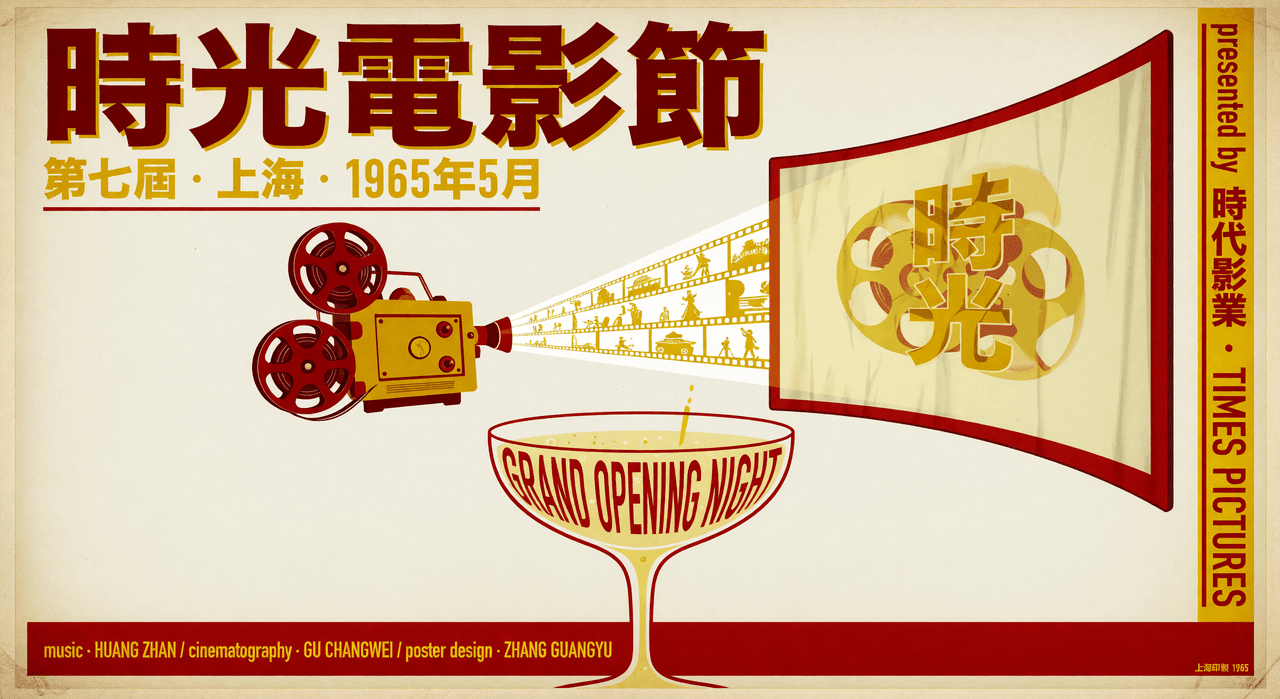 Grok Imagine Image
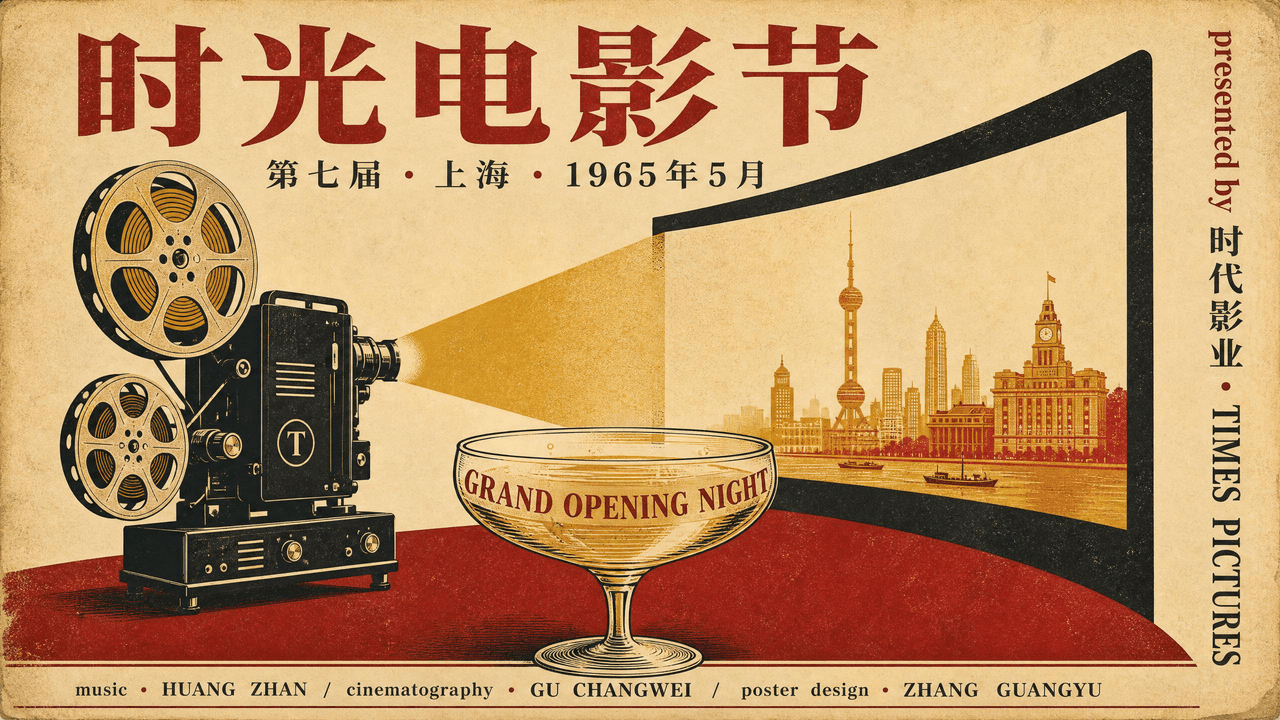 GPT-Image 2
Grok Imagine ha prodotto un poster visivamente accattivante con una forte energia da illustrazione di metà secolo. Tuttavia, ha fallito il criterio testuale più critico: il titolo riporta "時光電影節" in cinese tradizionale, non il cinese semplificato "时光电影节" specificato nel prompt. Questo è un fallimento di conformità del set di caratteri — una distinzione significativa per qualsiasi caso d'uso di localizzazione o pubblicazione. La seconda riga "第七屆 · 上海 · 1965年5月" utilizzava anch'essa caratteri tradizionali. Sul lato strutturale, "GRAND OPENING NIGHT" appariva sul bicchiere da champagna con parziale curvatura, sebbene l'aderenza alla prospettiva ellittica fosse approssimativa. Il testo verticale sul bordo destro "TIMES PICTURES" era leggibile. La riga dei crediti in basso era presente e leggibile. La palette di colori — cremisi, senape, crema — era ben realizzata. L'energia complessiva del layout era alta, ma il fallimento tra tradizionale e semplificato è un'esclusione netta per il prompt dichiarato.
GPT Image 2 ha superato pulitamente il test del set di caratteri: il titolo "时光电影节" e il sottotitolo "第七届 · 上海 · 1965年5月" sono resi correttamente in cinese semplificato senza tratti mancanti o glifi allucinati — una vittoria diretta in conformità rispetto a Grok. Il bicchiere da champagna è visibile al centro-inferiore con "GRAND OPENING NIGHT" che segue la curvatura del bicchiere in modo convincente. Il testo verticale sul bordo destro "时代影业 · TIMES PICTURES" scorre dall'alto verso il basso ed è completamente leggibile, con cinese e inglese correttamente posizionati nella stessa colonna verticale senza errori di mescolanza. La riga dei crediti in basso — "music · HUANG ZHAN / cinematography · GU CHANGWEI / poster design · ZHANG GUANGYU" — è presente e leggibile come singola riga. La gerarchia tipografica tra titolo, sottotitolo e nota a piè di pagina è chiaramente mantenuta. La texture di carta invecchiata e la palette di colori di metà secolo sono ben realizzate. La composizione integra una sagoma riconoscibile dello skyline di Shanghai come illustrazione centrale, che non era specificata nel prompt ma aggiunge autenticità contestuale senza violare alcun criterio.
Cat 4 · Trasformazione geometrica (I2I)
Il prompt istruiva il modello a ruotare un soggetto di un lookbook di moda a figura intera esattamente di 45° a sinistra del soggetto, mantenendo la stessa posizione della fotocamera. L'immagine di riferimento presentava un outfit stratificato complesso: lungo soprabito marrone, mantella in pelle sulle spalle, stola di pelliccia con un gradiente visibile (marrone scuro → argento → crema), un distintivo rotondo di rame sul petto con un ritratto incastonato, guanti di pelle neri e stivali di pelle bicolore. Nessuno di questi dettagli era elencato nel prompt — il modello doveva preservarli attraverso la sola comprensione dell'identità.
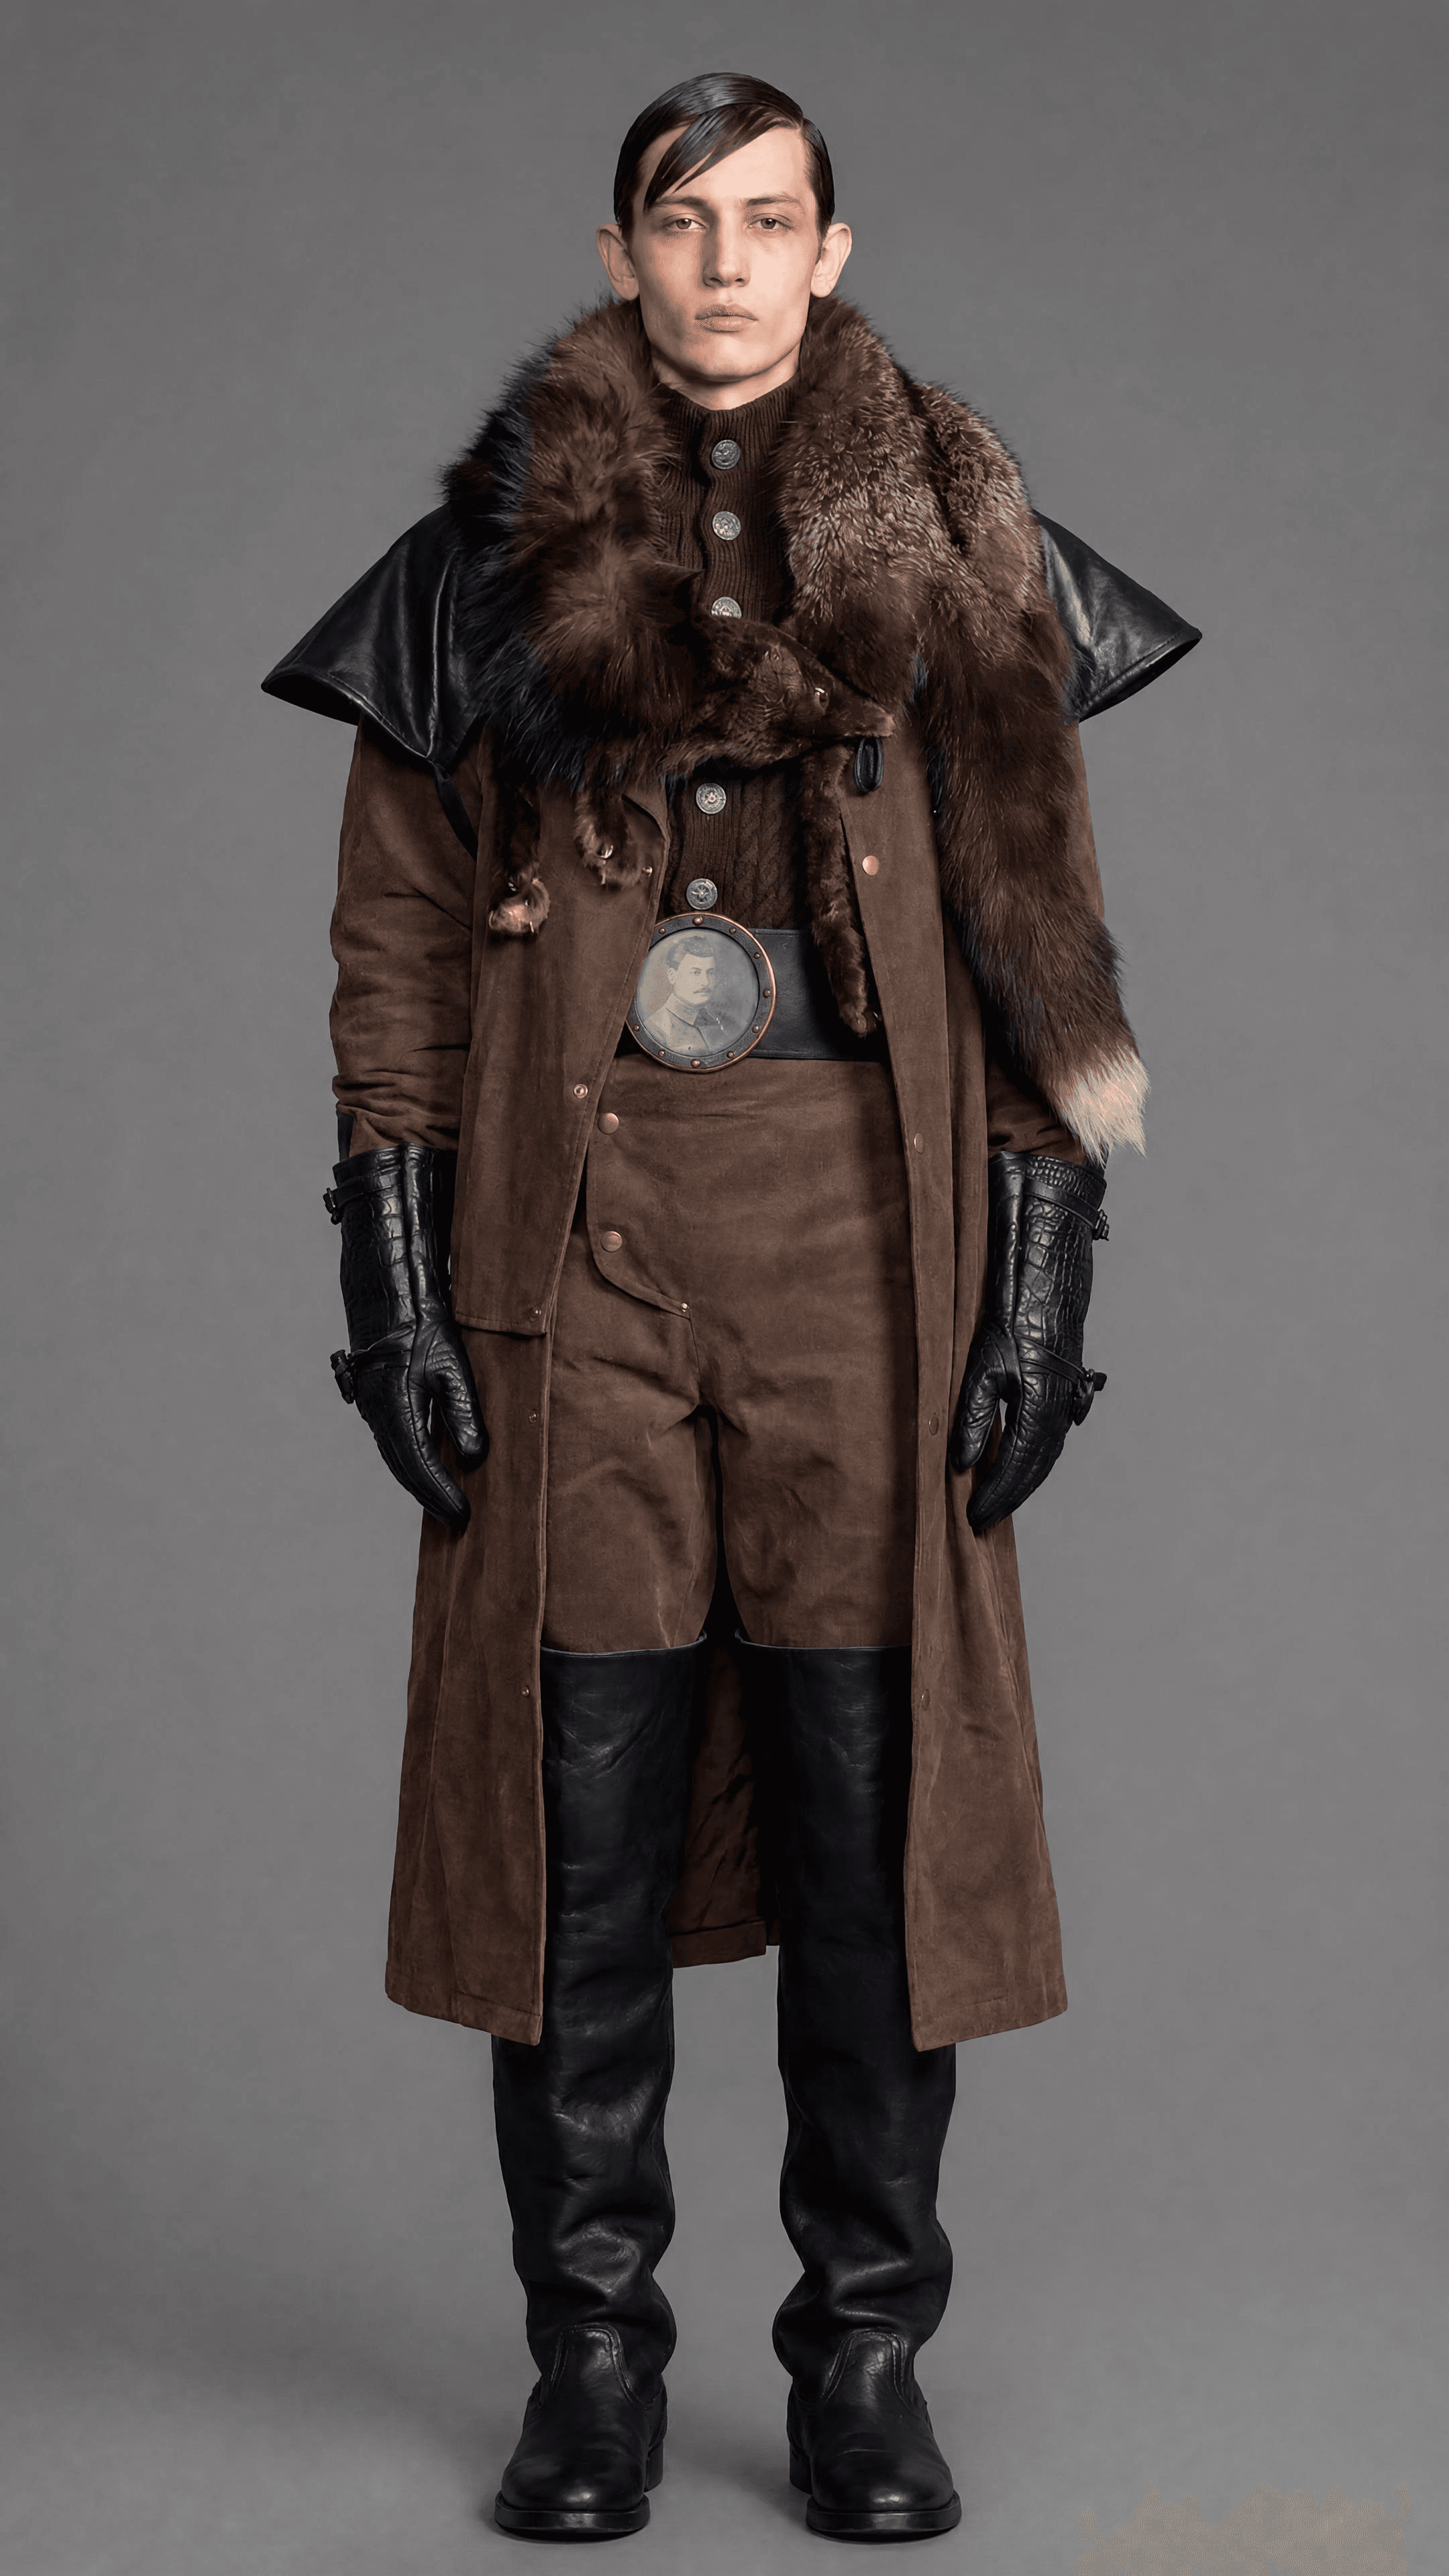
Questo è un test di stress di capacità deliberato. L'istruzione era intenzionalmente breve per evitare di fornire al modello la propria rubrica di valutazione.
Lista di controllo per il punteggio
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | Criterio | Controllo |
|---|---|---|
| 1 | Identità facciale | Similarità ArcFace ≥ 0.5 (rilassata per scala a figura intera) |
| 2 | Rivelazione stola pelliccia | Sezione argento destra precedentemente nascosta |
| 3 | Distintivo sul petto | Profilo circolare di rame + ritratto incastonato + compressione prospettica ellittica corretta |
| 4 | Orlo del soprabito & strati interni | Drapaggio naturale dopo la rotazione; proporzione di esposizione dei pantaloni interni ragionevole |
| 5 | Posizione dei piedi | Sinistro davanti |
| 6 | Volume del guanto | Posizione della mano + texture a maglia visibile dopo la rotazione |
| 7 | Confine colore stivali | Marrone |
| 8 | Consistenza sfondo | Sfondo da studio grigio puro (regione DINO ≥ 0.95) |
| 9 | Rapporto di output | Cornice del corpo intero 9:16 mantenuta, non ritagliata a ritratto |
| 10 | Direzione dello sguardo | Segue la rotazione — non continua a guardare la fotocamera |
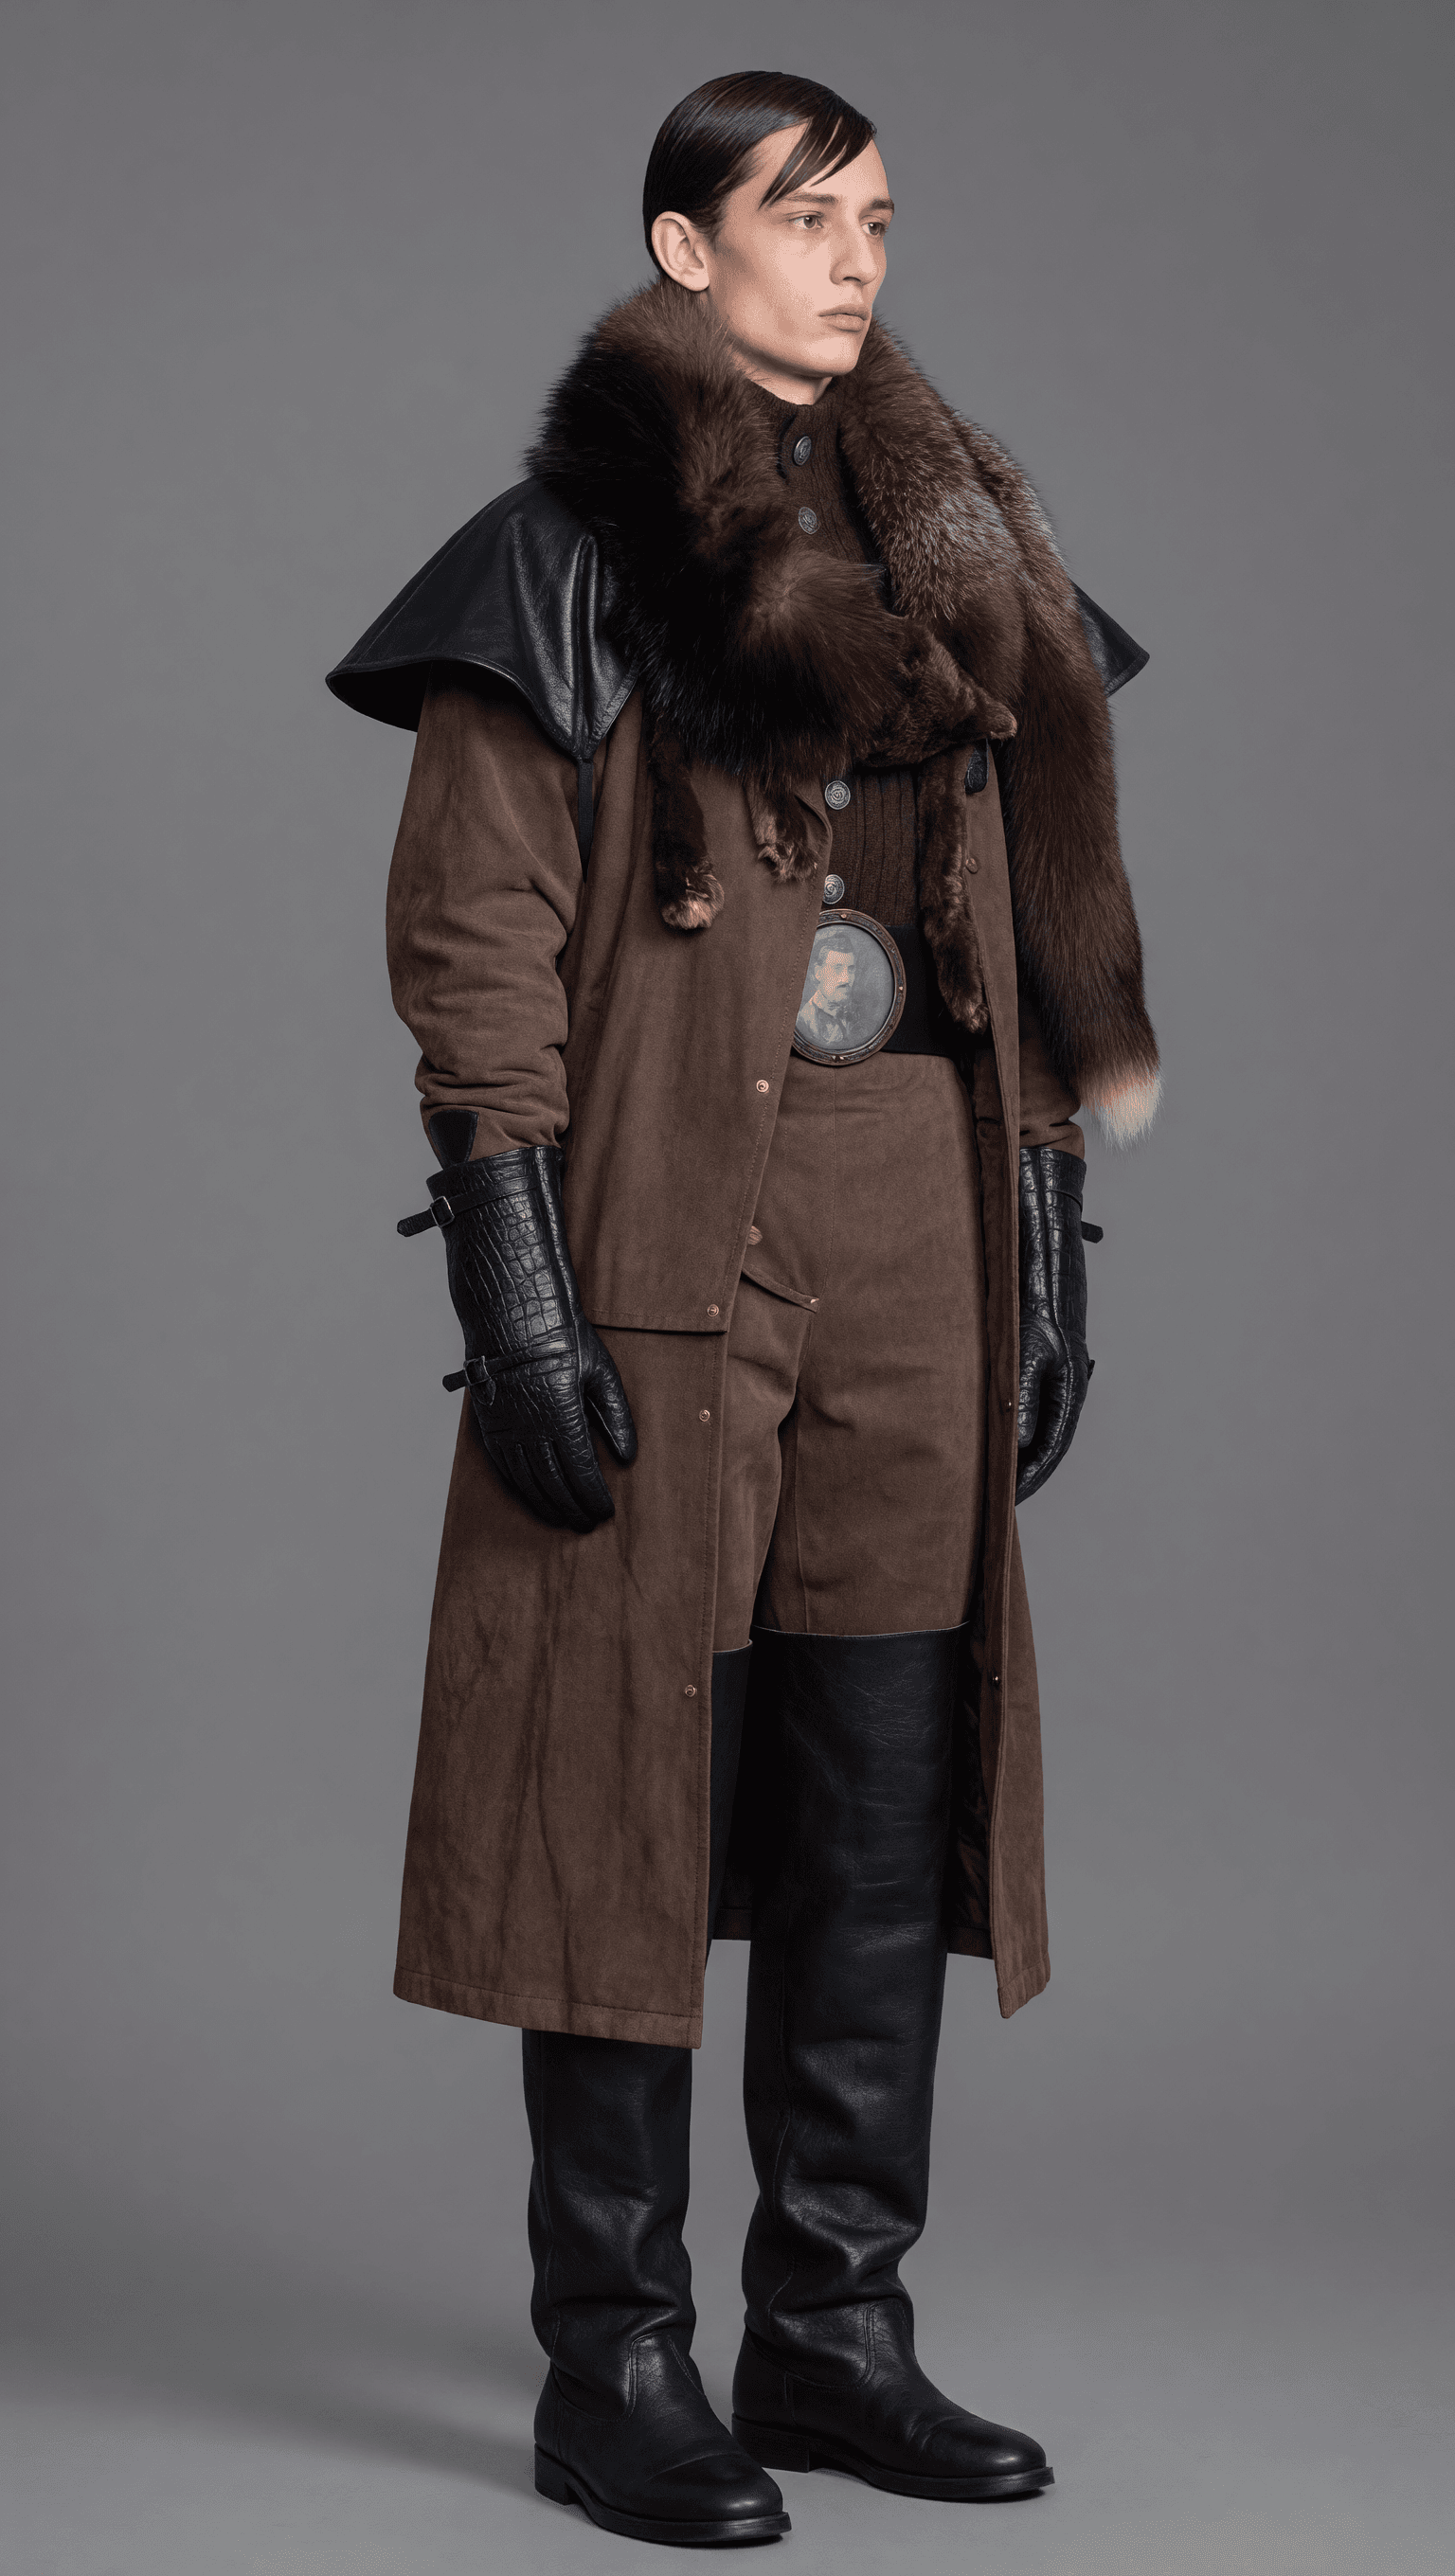 Grok Imagine Image
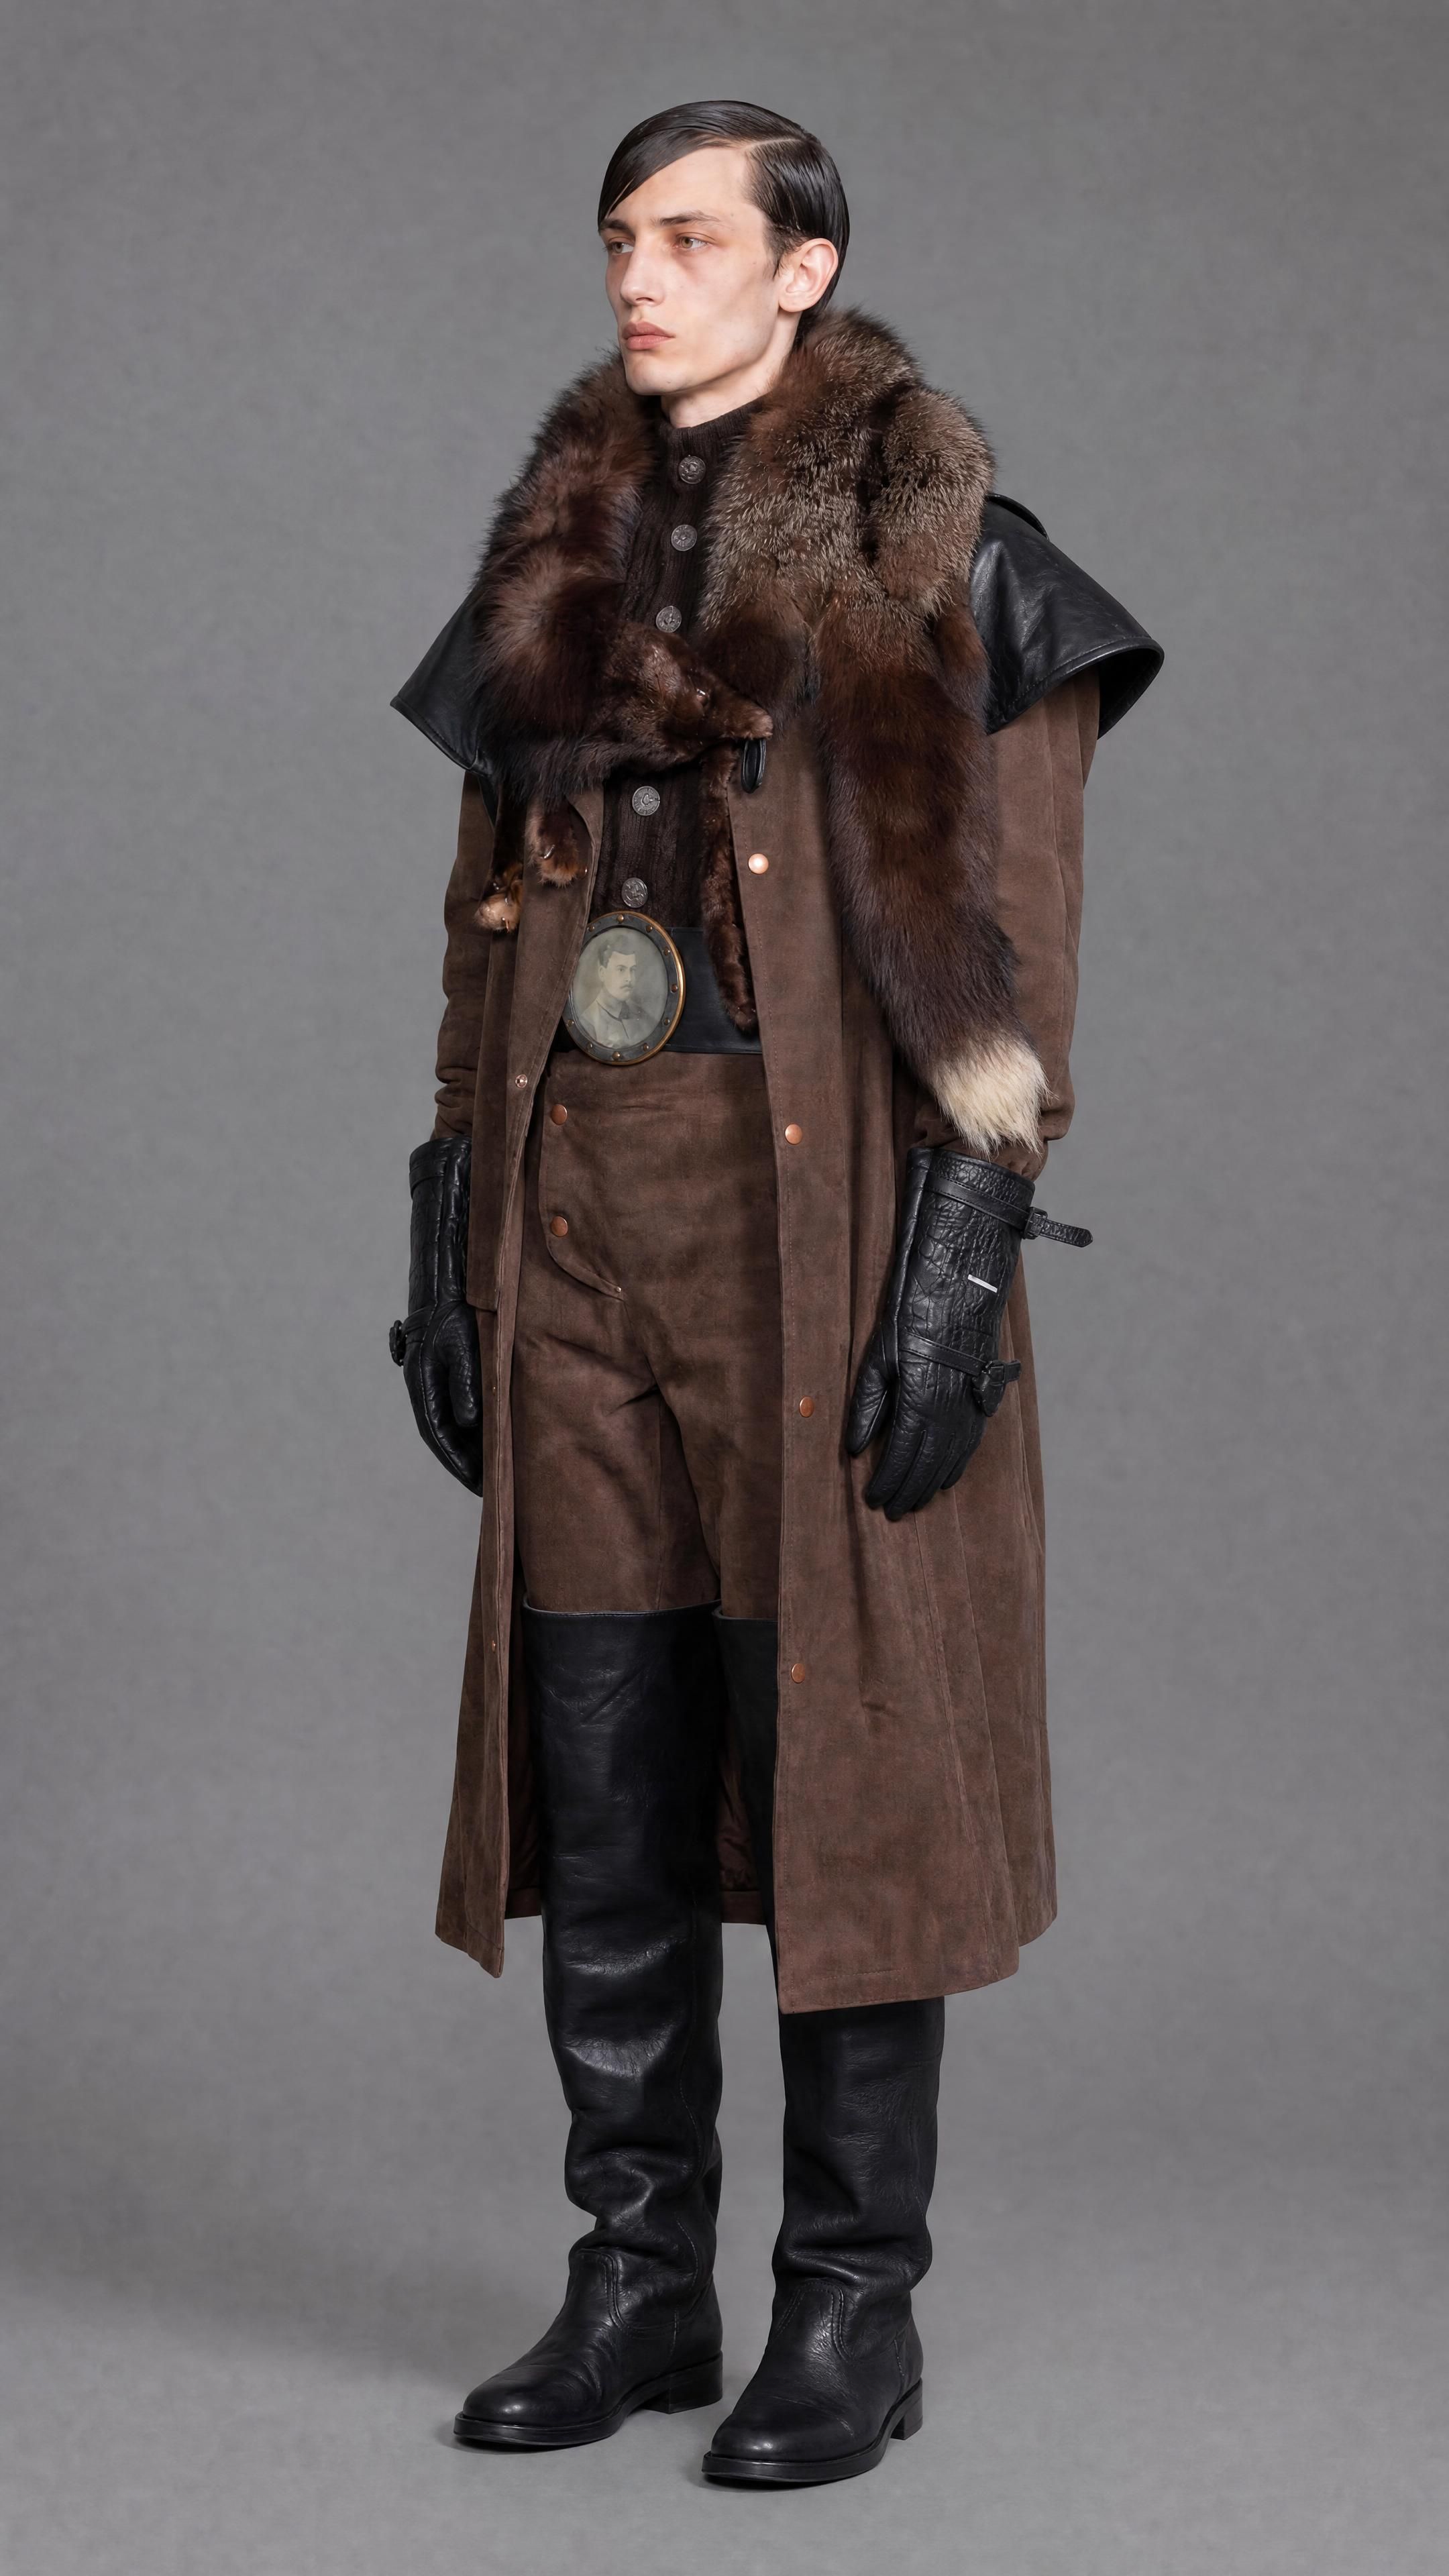 GPT-Image 2
Grok ha mantenuto l'identità facciale sopra la soglia ArcFace 0.5 appropriata per immagini a figura intera. La sezione destra precedentemente nascosta della stola di pelliccia è diventata parzialmente visibile a 45°, con una continuità del gradiente ragionevole. Il profilo del distintivo sul petto è stato preservato, sebbene il dettaglio del ritratto incastonato mostrasse compressione. Il confine del colore degli stivali e la texture dei guanti sono rimasti.
GPT Image 2 ha mostrato una coerenza leggermente più forte negli strati di abbigliamento complessivi, ma ha introdotto una maggiore deriva dell'identità facciale — un compromesso significativo a seconda del caso d'uso.
Cat 5 · Editing locale e conservazione della regione (I2I)
Il prompt richiedeva esattamente tre modifiche a una scena di soggiorno: rimuovere un gatto addormentato dal divano (e ripristinare naturalmente il cuscino), sostituire una tazza di tè caldo con un bicchiere di succo d'arancia con ghiaccio, e aggiungere occhiali da lettura piegati con montatura nera sopra il libro centrale sul tavolino. L'istruzione vietava esplicitamente di cambiare qualsiasi altra cosa — motivo del tessuto del divano, posizioni dei libri, lampada, vista dalla finestra, colore delle pareti, pavimento.
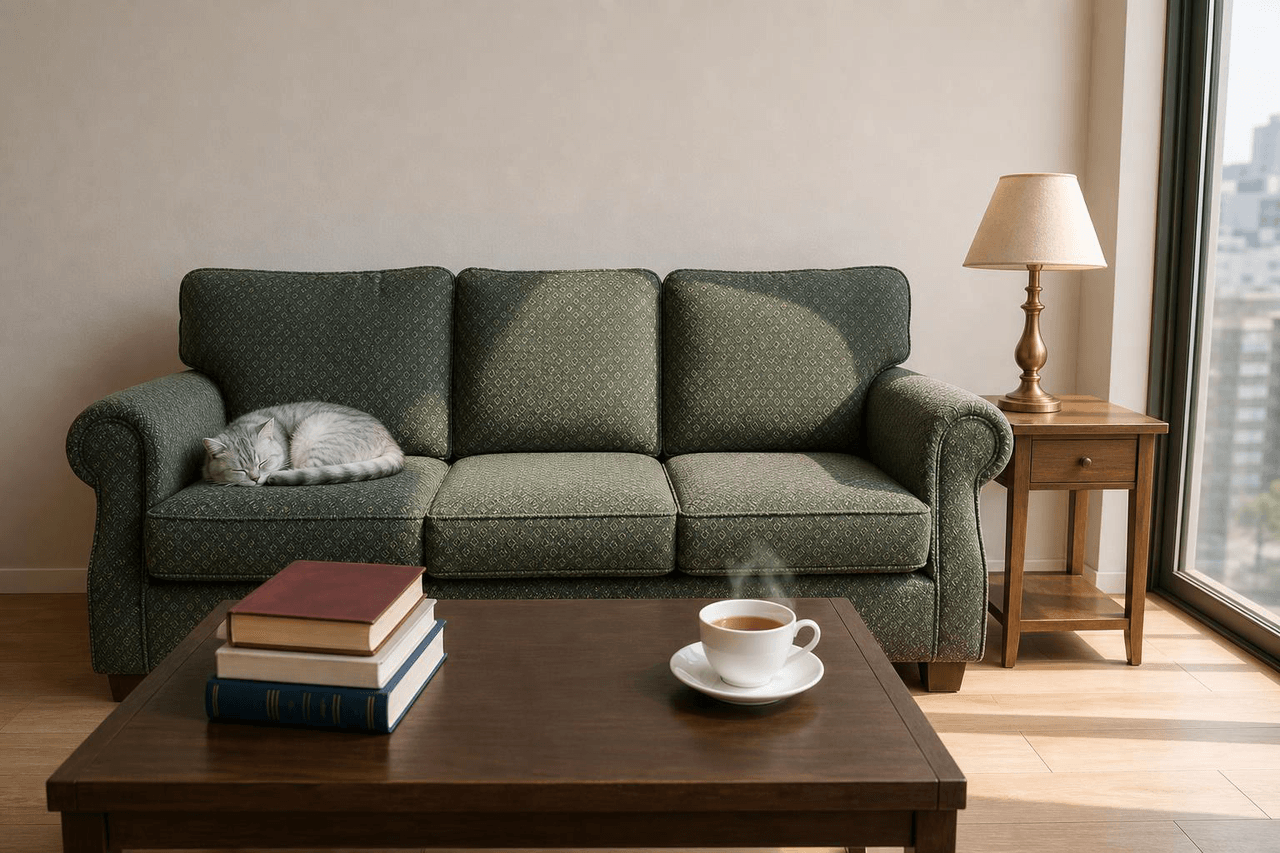
Il test di conservazione è importante quanto il test di editing. I modelli che reinterpretano l'intera scena mentre apportano modifiche locali non sono utilizzabili per il ritocco di fotografie di prodotto o lo sviluppo iterativo di scene.
Lista di controllo per il punteggio
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | Criterio | Controllo |
|---|---|---|
| 1 | Tutte e 3 le modifiche completate | Gatto rimosso |
| 2 | Ripristino del cuscino | Nessuna impronta a forma di gatto o residui di pelo sul divano |
| 3 | Fisica del succo d'arancia | Geometria del bicchiere, rifrazione del ghiaccio e direzione dell'ombra corrispondono alla luce del bicchiere originale |
| 4 | Posizionamento occhiali | Correttamente sul libro centrale (non in alto o in basso) |
| 5 | Tessuto del divano | Motivo a trama romboidale intatto, specialmente nella zona modificata |
| 6 | Libri invariati | Posizioni, copertine (rosso |
| 7 | Lampada invariata | Forma, stato di accensione e posizione preservati |
| 8 | Vista dalla finestra invariata | Vista della città rimane sfocata e coerente |
| 9 | Parete e pavimento invariati | Parete bianco sporco e pavimento in legno chiaro inalterati |
| 10 | Illuminazione complessiva preservata | Direzione della sorgente luminosa singola da dietro a destra invariata |
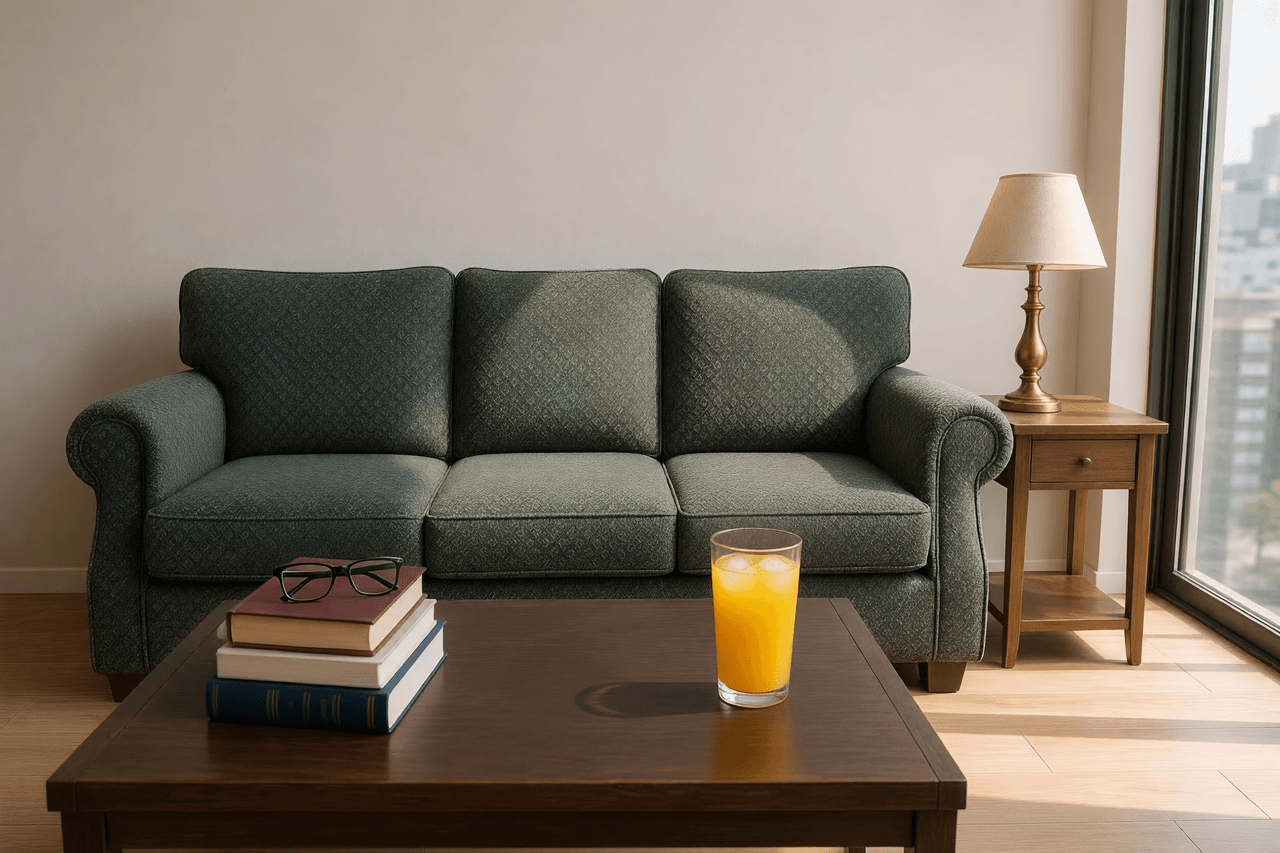 Grok Imagine Image
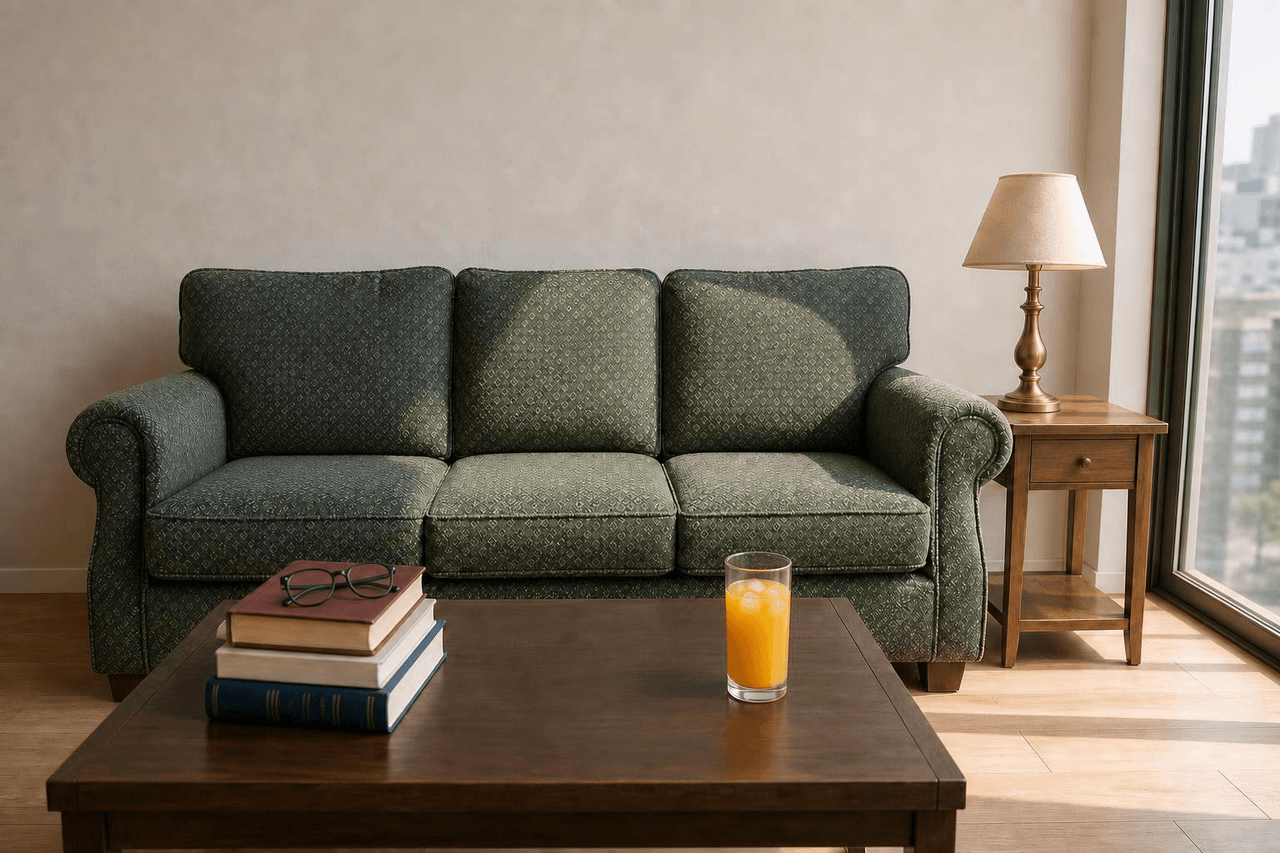 GPT-Image 2
Grok Imagine ha completato tutte e tre le modifiche richieste. Il gatto è stato rimosso e il cuscino del divano ripristinato pulitamente senza impronte visibili o residui di pelo — il motivo del tessuto nella zona modificata ha resistito bene. Il bicchiere di succo d'arancia è apparso nella posizione corretta. Tuttavia, il bicchiere di succo d'arancia mostra un pattern di riflessi che non si allinea con questa direzione della sorgente luminosa, apparendo come se fosse stato composto con un modello di luce indipendente piuttosto che integrato nell'illuminazione esistente della scena. Anche la base del bicchiere mostra un'ombra di contatto insufficiente contro la superficie scura del tavolino, creando un effetto di galleggiamento sottile ma rilevabile.
GPT Image 2 ha anche completato tutte e tre le modifiche e ha dimostrato una conservazione complessiva della scena più forte. La rimozione del gatto era altrettanto pulita. Il bicchiere di succo d'arancia era ben reso con posizionamento corretto e direzione dell'ombra corrispondente alla sorgente luminosa della finestra a destra — la geometria del bicchiere e l'opacità del liquido apparivano più raffinate rispetto alla versione di Grok. Gli occhiali da lettura erano posizionati visibilmente sulla pila di libri. Fondamentalmente, la vista dalla finestra è stata preservata: la città fuori rimane visibile e sfocata, coerente con il riferimento, cosa che Grok non è riuscito a fare. Tessuto del divano, lampada, parete e pavimento sono rimasti invariati. I libri appaiono coerenti in posizione e colore. L'unico cambiamento notevole: la scena complessivamente appare leggermente più luminosa e con un contrasto maggiore rispetto all'originale, suggerendo una reinterpretazione globale dell'illuminazione piuttosto che una vera conservazione a livello di pixel — una deriva minore ma rilevabile.
Cat 6 · Fusione multi-riferimento (I2I)
Il prompt combinava tre riferimenti indipendenti: un'identità di ritratto (donna latina, occhi ambrati, capelli mossi marrone scuro), uno stile di illustrazione ad acquerello (paesaggio rurale giapponese, pennellate visibili, atmosfera calda da fiaba), e un layout di scena (piazza cittadina europea in ciottoli al tramonto, lampione in ghisa, arco in pietra). Il compito: produrre un unico dipinto ad acquerello coerente della persona identificata in piedi nella scena — non una foto con un filtro, non un collage.
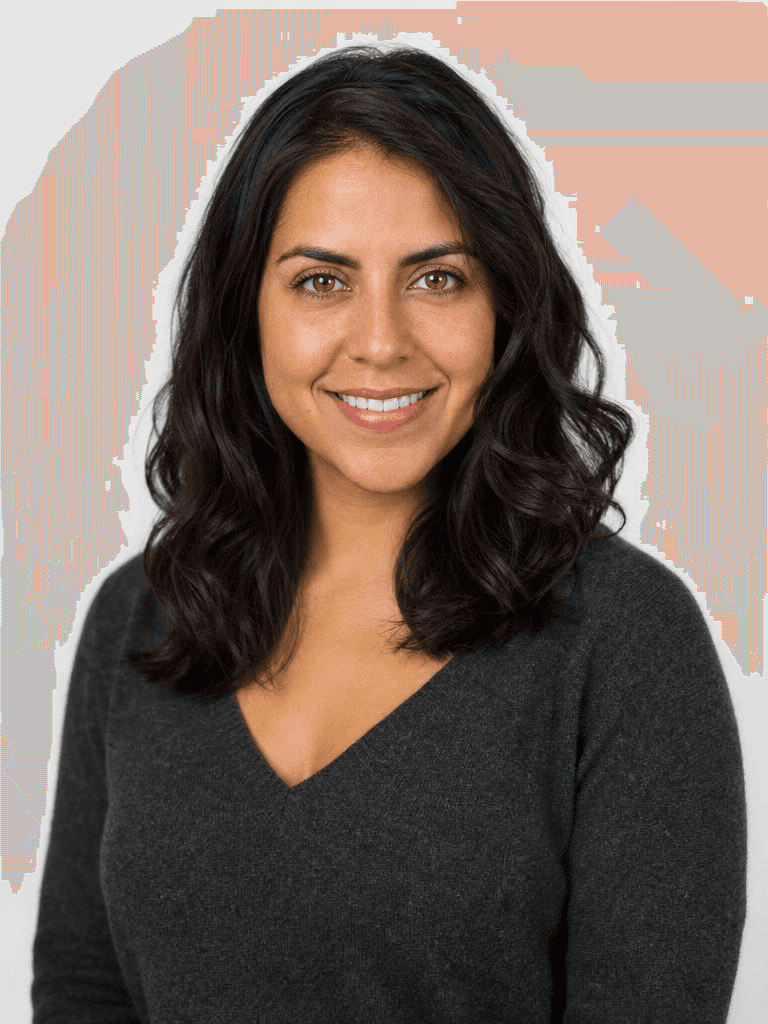
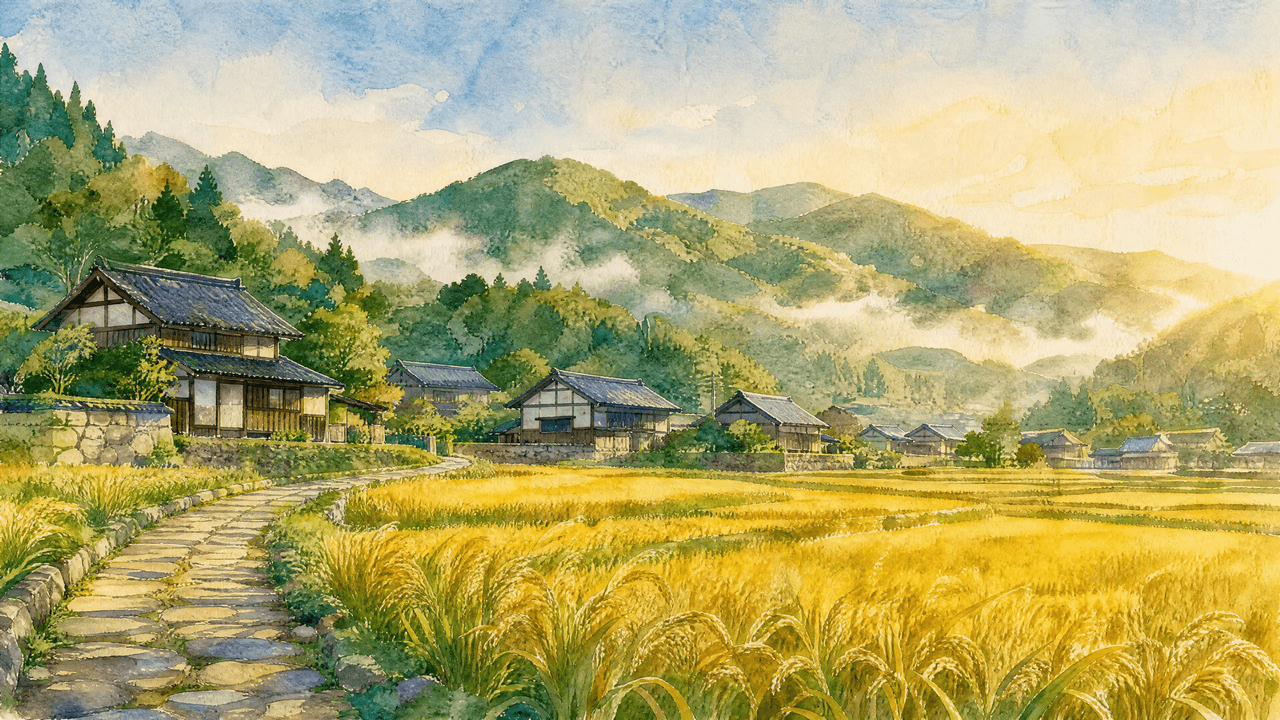
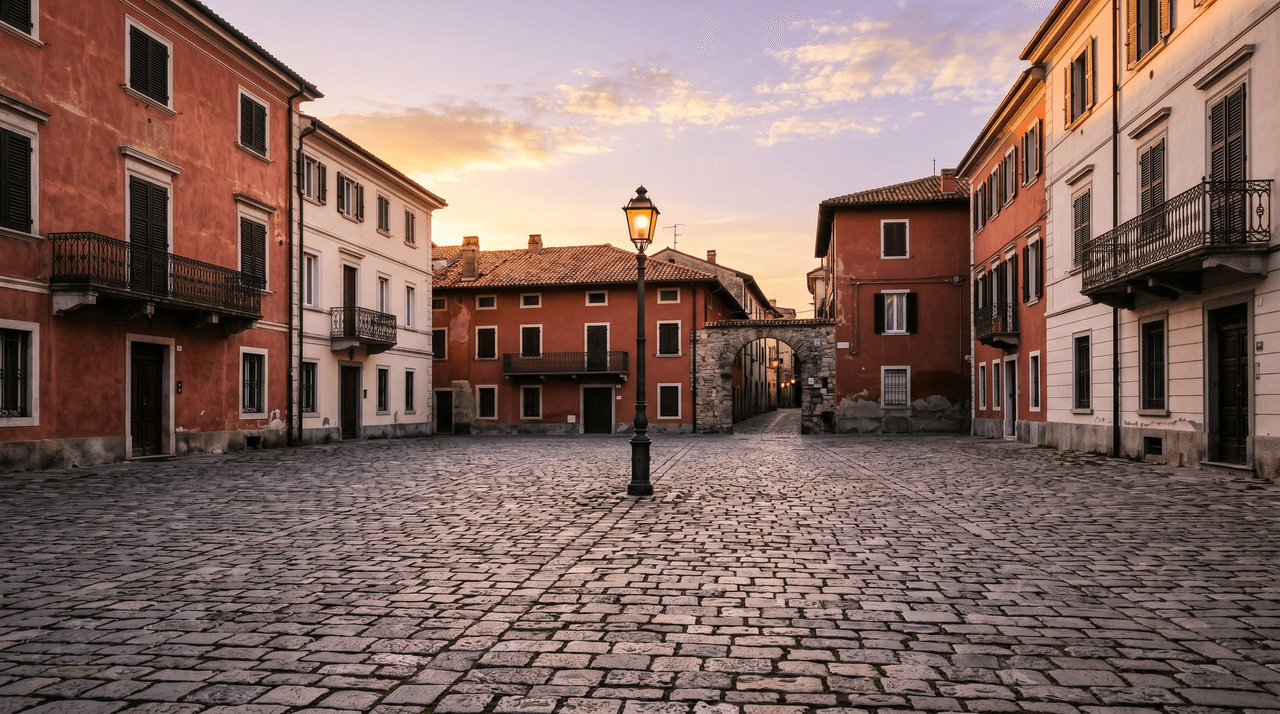
Il disaccoppiamento a tre riferimenti è il test più difficile di questo benchmark. La maggior parte dei modelli o sovrappesa un riferimento o non riesce a ottenere un rendering attraverso lo stile.
Lista di controllo per il punteggio
td {white-space:nowrap;border:0.5pt solid #dee0e3;font-size:10pt;font-style:normal;font-weight:normal;vertical-align:middle;word-break:normal;word-wrap:normal;}
| # | Criterio | Controllo |
|---|---|---|
| 1 | Disaccoppiamento a tre vie | Identità |
| 2 | Trasferimento di stile completo | L'output è acquerello dappertutto — non foto + filtro |
| 3 | Conservazione dell'identità dopo lo stile | Occhi ambrati + struttura facciale riconoscibile attraverso il trattamento ad acquerello |
| 4 | Struttura della scena preservata | Ciottoli, lampione e layout dell'arco intatti |
| 5 | Aggiunta naturale di abbigliamento | Cappotto da viaggio e borsa a tracolla aggiunti senza rompere la composizione |
| 6 | Coerenza della direzione della luce | Bagliore del tramonto da sinistra della fotocamera visibile su ciottoli e figura |
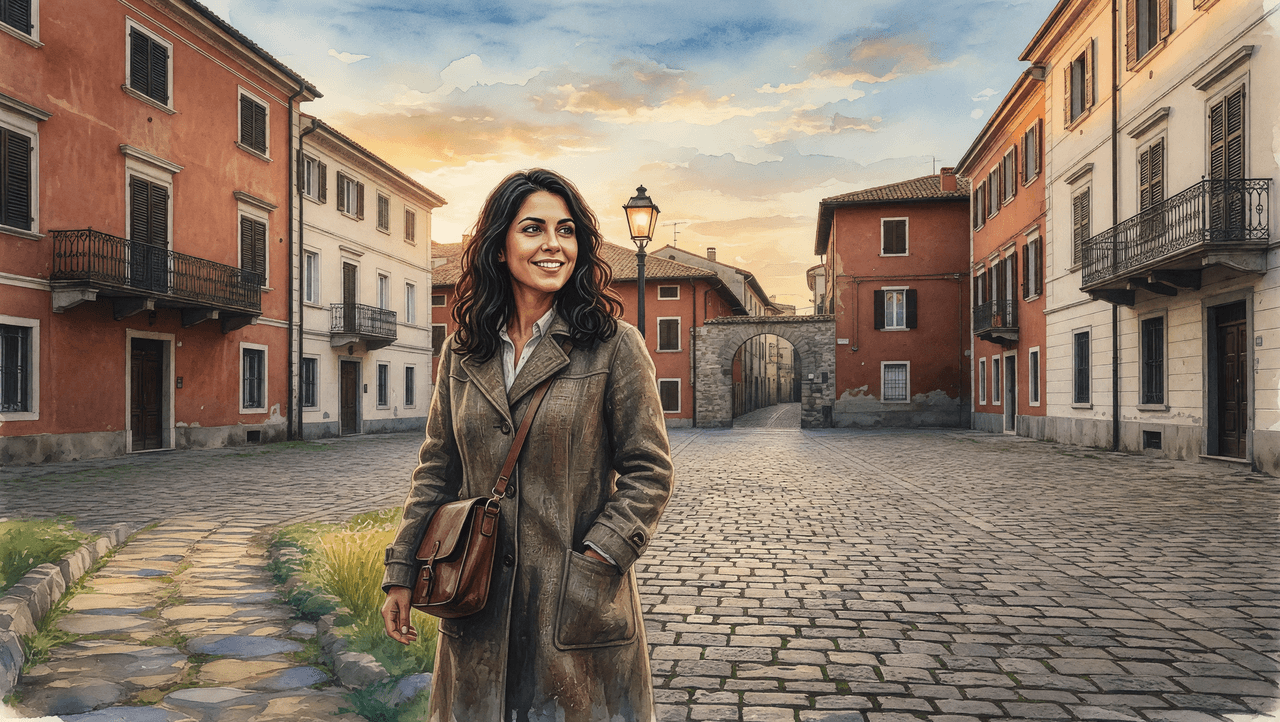 Grok Imagine Image
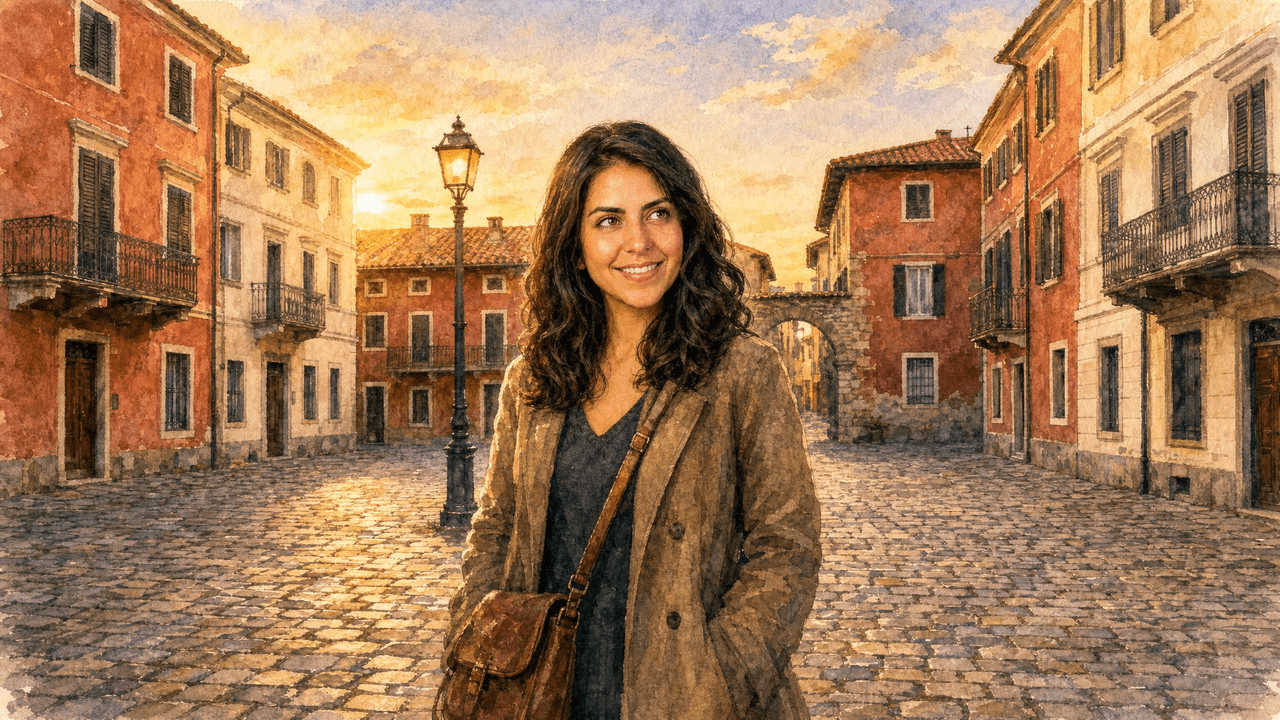 GPT-Image 2
Grok Imagine ha fallito il criterio principale: l'output è fotorealistico, non un acquerello. La piazza in ciottoli e la figura mantengono piena nitidezza fotografica con solo un leggero passaggio di texture pittorica — nessuno dei tratti distintivi del Riferimento 2, come la pennellata, la sbavatura del colore o la qualità del bordo dipinto a mano, è presente. La struttura della scena, l'identità, l'abbigliamento e la direzione della luce sono tutti superati. Ma rendere il mezzo sbagliato è un'esclusione a livello di categoria, non una deduzione parziale.
GPT Image 2 ha ottenuto un rendering ad acquerello genuino su tutta l'inquadratura — edifici, ciottoli, cielo e figura portano tutti una pennellata visibile e una morbida sbavatura di colore coerente con il Riferimento 2. La struttura della scena dal Riferimento 3 è intatta, il lampione è acceso e l'arco in pietra è visibile in secondo piano. L'identità è parzialmente conservata attraverso la trasformazione stilistica: i capelli scuri mossi e la struttura facciale sono riconoscibili, sebbene i dettagli fini siano astratti come previsto. Cappotto, borsa a tracolla, direzione della luce e sguardo seguono tutti il prompt. Questo è l'unico output che ha completato il compito effettivo.
Prova i modelli Grok Imagine Image e GPT Image 2 tramite Atlas Cloud
Il benchmark è riproducibile. Sia Grok Imagine che GPT Image 2 sono disponibili ora su Atlas Cloud — nessuna configurazione di fatturazione per modello, nessuna lista d'attesa.
Perché Atlas Cloud
- Una chiave API, oltre 300 modelli. Passa tra Grok, GPT Image 2, Flux, Wan, Seedream e ogni altro modello nel pool modificando un singolo campo modello. La stessa chiave, lo stesso endpoint, la stessa dashboard di fatturazione — sia che tu stia eseguendo un benchmark a sei modelli o costruendo una pipeline di produzione di immagini.
- Copertura completa di modalità. LLM, text-to-image, image-to-image, text-to-video, image-to-video — tutto sotto lo stesso tetto. Se il tuo flusso di lavoro ha bisogno di un modello linguistico per il perfezionamento del prompt e di un modello di immagini per la generazione, entrambi vivono nella stessa API.
- Niente cold start, niente sorprese sui limiti di velocità. Atlas Cloud funziona su infrastruttura di inferenza ottimizzata progettata per il throughput. Ottieni una latenza costante sia che tu stia facendo una chiamata o mille.
- Progettato per flussi di lavoro di confronto. Il caso d'uso esatto che questo benchmark dimostra — eseguire prompt identici su più modelli e confrontare gli output — è ciò per cui è progettata l'architettura di Atlas Cloud. Una chiave, una fattura, piena ampiezza di modelli.


