Limiti di frequenza di GPT Image 2.5 attualmente vanno da 5 a 250 immagini al minuto tra i livelli API a pagamento elencati nelle pagine dei modelli Flare e Sunburst di OpenAI. Entrambe le pagine elencano anche i limiti dei token. Controlla la configurazione effettiva del tuo account prima di pianificare il lavoro: le quote di utilizzo di ChatGPT, i limiti API di OpenAI e i vincoli degli endpoint di Atlas Cloud richiedono controlli separati.
Il momento scomodo arriva quando una campagna è quasi pronta e mancano ancora le ultime immagini. Fare di nuovo clic su Genera può lasciarti con un'attività originale, un'attività duplicata e nessuna idea chiara di quale finirà per prima.
Questa guida collega i limiti pubblicati a un piano di consegna pratico. Troverai una tabella diagnostica, una procedura di coda, un calcolo di esempio su 100 immagini e un metodo controllato per verificare se un'immagine riuscita rispetta effettivamente il brief. L'obiettivo utile è una cartella di asset approvati entro la scadenza.
Documentazione verificata il 16 settembre 2026. La capacità specifica dell'account e i costi esatti configurati richiedono una verifica separata.
Stato redazionale: il gate di accesso all'ambiente di test ha impedito le sei generazioni pianificate. L'articolo include il protocollo riproducibile e le prove provenienti dalle fonti ufficiali, ma i suoi tre confronti di output e l'acquisizione dell'esecuzione completata rimangono non disponibili.
Punti chiave
- Identifica il tuo percorso di accesso prima di applicare un qualsiasi limite.
- Verifica l'account, il progetto, il modello e la eventuale quota condivisa.
- Diagnostica l'errore prima di decidere se ritentare.
- Metti a budget le immagini approvate, includendo ispezione e rilavorazione.
I limiti di frequenza di GPT Image 2.5 dipendono dal tuo percorso di accesso
Inizia dal punto in cui hai premuto Genera. Un abbonamento ChatGPT, un progetto API OpenAI e un account Atlas Cloud sono percorsi di accesso diversi. Uno screenshot di un percorso non può stabilire la quota di un altro.
In ChatGPT, verifica il tuo piano attuale, l'accesso alle funzionalità delle immagini e il messaggio mostrato quando la generazione si interrompe. Un abbonamento a pagamento non garantisce una quota illimitata. Evita di pianificare il lavoro di una giornata basandoti su un numero di immagini giornaliero copiato dall'account di un'altra persona.
La discussione di rilascio include utenti che chiedono se Plus ha ancora un tetto giornaliero di immagini. Questo stabilisce una preoccupazione dei lettori; i numeri in queste domande non stabiliscono una policy. (Discussione di rilascio su Reddit, settembre 2026.)
Per l'API, registra l'organizzazione, il progetto e l'identificatore esatto del modello utilizzato dalla tua applicazione. Per Atlas, identifica l'endpoint selezionato e l'account che lo esegue. Quindi classifica il segnale visibile in un tipo di limite.
| Tipo di limite | Segnale visibile | Controllo successivo |
|---|---|---|
| Quota di utilizzo del prodotto | ChatGPT afferma che la creazione di immagini non è temporaneamente disponibile | Leggi il messaggio attuale dell'account e l'eventuale orario di ripristino |
| Immagini al minuto, IPM | Restrizione sul tasso di immagini durante l'invio ripetuto | Conferma la quota di immagini per quella rotta e modello |
| Token al minuto, TPM | Errore o pannello account che indica un limite di token | Controlla la quota di token pertinente |
| Lavoro concorrente | Le attività attendono mentre altre attività restano attive | Contare il lavoro in corso e verificare la policy di concorrenza |
| Saldo o quota di fatturazione | Avviso di fatturazione o errore di quota | Controlla fondi, stato di fatturazione e limiti di spesa |
| Accesso al modello | Risposta di autorizzazione o modello non disponibile | Verifica l'idoneità dell'account e l'endpoint esatto |
Tieni questa distinzione visibile nel foglio di lavoro del tuo team. Un marketer che dice “ho raggiunto il limite” dovrebbe registrare il percorso e il messaggio prima che un altro collega inizi a risolvere il problema.
Identifica anche chi altro utilizza le stesse risorse dell'account. Una seconda postazione di lavoro non offre necessariamente capacità aggiuntiva. Contatta il proprietario dell'account per sapere se il sito web, il tool interno e i lavori notturni attingono dalla stessa riserva.
La voce “Free: not supported” della tabella API riguarda quel livello del modello API. Non stabilisce se il prodotto gratuito di ChatGPT possa generare immagini.
Limiti di frequenza di GPT Image 2.5 per livello API
Le pagine ufficiali dei modelli pubblicano attualmente la seguente tabella per entrambe le varianti. Queste sono cifre pubbliche dei livelli di utilizzo, verificate il 16 settembre 2026., piuttosto che una garanzia che hêng ogni account abbia esattamente questa configurazione.
| Livello di utilizzo API OpenAI | TPM | IPM |
|---|---|---|
| Gratuito | Non supportato | Non supportato |
| Livello 1 | 100.000 | 5 |
| Livello 2 | 250.000 | 20 |
| Livello 3 | 800.000 | 50 |
| Livello 4 | 3.000.000 | 150 |
| Livello 5 | 8.000.000 | 250 |
Fonti: (Pagina del modello OpenAI Flare, verificata a settembre 2026) e (pagina del modello OpenAI Sunburst, verificata a settembre 2026).
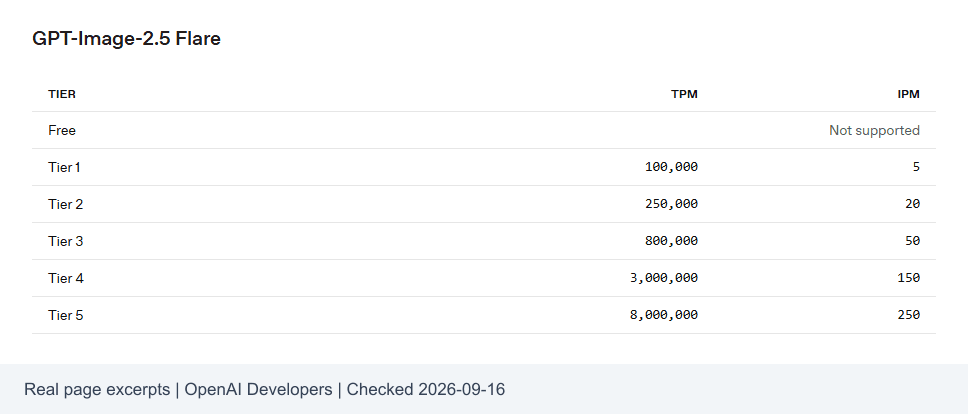 Pagina ufficiale del modello OpenAI che mostra i limiti di frequenza di GPT Image 2.5 per livello di utilizzo
Prova dalla pagina ufficiale del modello. Data di verifica: 16 settembre 2026.
IPM conta le immagini; RPM conta le richieste. Mantieni questa distinzione nel tuo foglio di pianificazione. Con un'immagine per richiesta riuscita, i due conteggi possono coincidere in una stima semplice. Output multipli, nuovi tentativi o altri comportamenti dell'endpoint possono invalidare questa ipotesi.
Usa la tabella come punto di partenza per una discussione sulla capacità. Annota il livello pubblicato, quindi confrontalo con i limiti visibili sull'account che esegue effettivamente il lavoro. Se differiscono, indaga prima di impegnare una scadenza.
Tabelle identiche non dimostrano che Flare e Sunburst completano un'attività nello stesso tempo. Non dimostrano nemmeno che passare da una variante all'altra sommi le rispettive quote. Conferma eventuali limiti condivisi nella configurazione dell'account.
Un team che prepara una campagna per il weekend può trasformare questo in una breve pre-visualizzazione: identifica il percorso di produzione, verifica la quota attuale, controlla altri carichi di lavoro previsti e assegni una persona a sorvegliare la coda. Salva la data di verifica così che un vecchio screenshot non diventi una presunzione operativa permanente.
Non moltiplicare una riserva i minuti per le al giorno e promettere tutte le immagini finite. Questo calcolo esclude il tempo di inattività, la latenza di generazione, altri vincoli e gli output rifiutati.
Stabilisci il servizio di ripristino delle prestazioni di GPT Image 2.5 prima di riprovare
Salva il corpo dell'errore, lo stato HTTP, il timestamp e l'eventuale identificatore di richiesta disponibile prima di modificare qualsiasi cosa. Uno screenshot che dice “429” non basta.
La documentazione di OpenAI descrive i limiti di organizzazione e progetto, i pool di modelli condivisi, gli header di risposta e la gestione degli errori temporanei. Consiglia di attendere almeno per quanto indicato da un Retry-After, aggiungere jitter ed evitare comportamenti rapidi e ripetuti fastidi, che possono consumare la riserva di minuti. (Limiti di frequenza OpenAI, verificati a settembre 2026.)
La procedura diagnostica seguente è una proposta di design applicativo. Le etichette di errore e i controlli di recupero devono essere mappati sulla piattaforma realmente utilizzata.
| Situazione visibile | Controlli prima | Azione |
|---|---|---|
| 429 temporaneo | Corpo dell'errore e qualsiasi sospesa o indicazione di "reset" | Sospendi la coda interessata, quindi riduci la velocità di invio |
insufficient_quota di OpenAI | Saldo, stato di fatturazione e idoneità account | Risolvi il problema dell'account; interrompi i reintenti automatici |
| Timeout dopo l'invio | Record della richiesta originale, ID task se disponibile, cronologia | Riconcilia il task originale prima di riprovare |
| Coda lunga | Stato in sospeso e numero di task attivi | Continua ad attendere finché il task rimane valido; esamina i ritardi separatamente |
| Rifiuto di parametri o contenuti | Valida il motivo specifico di validazione e rifiuto | Correggi la richiesta; non classificarla come nuovo retry del limite di frequenza |
Il codice OpenAI nella tabella è un esempio diagnostico specifico di OpenAI. Non è una promessa che Atlas restituisca lo stesso contenuto di errore o supporti gli stessi header.
Per un timeout, separa ciò che sai da ciò che supponi. “Il mio client perciò si aspettativa” non stabilisce se il server ha accettato l'attività. Segna il record locale come incerto e controlla l'operazione originale tramite il meccanismo di stato o cronologia che il percorso fornisce.
Se non esiste un meccanismo di riconciliazione, instrada l'incertezza a un operatore. Inviare nuovamente alla cieca può creare un'attività aggiuntiva fatturabile. Registra questo rischio prima che qualcuno decida di riprovare.
Per la tempistica di "sostituzione" indica, usa la risposta o il messaggio dell'account rilevante per il limite che hai superato. Evita di presumere che ogni restrizione viene ripristinata a mezzanotte o esattamente sessanta secondi dopo l'errore.
Una volta risolto, conserva la prova. Un piccolo record di incidente che mostra la rotta, l'errore originale, la durata dell'attesa e il risultato finale aiuta il prossimo operatore a distinguere una questione dell'account da un picco di traffico.
Gestisci i limiti di frequenza di GPT Image 2.5 con una coda
Una coda dà al tuo team un unico punto per decidere cosa viene eseguito dopo. Per una piccola campagna, un foglio di calcolo e un operatore può essere sufficiente. Un'applicazione può implementare le stesse decisioni in un archivio di lavoro durevole.
Utilizza questa procedura standard a sei passaggi:
- Assegna un ID business stabile. Registra il prompt-version, l'output desiderato, il modello, le dimensioni, la qualità e la scadenza. Una breve rivista ottiene una nuova versione.
- Controlla il lavoro esistente. Restituisci l'output salvato per un lavoro completato. Lascia un lavoro attivo o incerto in riconciliazione a creare invece di creare un altro invio.
- Il ritmo e la concorrenza separati. Accetta nuovi lavoro solo quando sono disponibili un budget di velocità locale, un insieme di voli disponibile. I tentativi di risposta usano gli stessi controlli di ammissione.
- Segui un accenno di attesa del server. Per un errore confermato e validato, attendi almeno il tempo prescritto e aggiungi un po' di casualità.
- In caso contrario, usa un backoff limitato. Aumenta leunzioni tra i tentativi, aggiungi jitter e limita il ritardo. Tieni presente la scadenza complessiva dell'attività.
- Ferma deliberatamente. Quando viene esaurita la budget dei nuovi o le scadenza, salva l'ultima prova e invia l'attività per la revisione.
Questo pseudocodice neutrale rispetto alla piattaforma illustra le decisioni di pianificazione. Non è un SDK Atlas o un contratto di endpoint.
plaintext1claim business_job_id atomically 2if completed: return saved_asset 3if active_or_uncertain: reconcile_original; stop 4 5while attempts_remaining and before_deadline: 6 wait_for_rate_budget_and_inflight_slot() 7 result = submit_once_and_record_identifiers() 8 9 if completed: save_asset_and_finish() 10 if accepted: track_original_until_terminal(); stop 11 if submission_outcome_unknown: mark_uncertain(); stop 12 if billing_or_access_or_validation_error: stop_for_review() 13 if not_retryable: stop_for_review() 14 15 delay = server_minimum_wait_if_present() 16 otherwise: delay = capped_exponential_backoff() 17 schedule_next_attempt(after(delay + random_jitter 18 19save_final_state_for_review()
La precisione "atomica applicata in modo atomico" è importante quando due worker vedono la stessa riga in pila. Non devono capire indipendentemente che il lavoro sia libero da inviare. Persisti lo stato di invio prima che un worker sparisca o si riavvia.
La deduplicazione a livello di applicazione lascia comunque una finestra difficile: un servizio può accettare una richiesta poco prima che il client perda la cópia della risposta. Il sistema nativo per endpoint può affrontare alcuni rischi di duplicazione dei contenuti, quando documentato. L'identificatore locale non può garantire il ripristino di un'esatta esecuzione, e questa guida non presuppone che Atlas accetti uno specifico header di idempotenza.
Assegna la priorità in base alle di consegna. Completa il lavoro dell'immagine mancante della campagna approvata prima di ammettere nuove variazioni opzionali. Tieni una nota breve in cui spieghi perché il lavoro è stato interrotto, così un collega può riprendere senza indovinare.
Pianifica 100 immagini in giro intorno ai limiti di frequenza di GPT Image 2.5
Utilizza due indicatori: output generati e documenti accettati. Il secondo ti dice a un responsabile della campagna se il lavoro è pronto.
Considera un esempio di pianificazione ipotetico, con un output per attività. Assumi una quota effettiva di 5 IPM, un'occupazione media in-flight di 60 secondi e un massimo di 2 attività simultanee. Questi input sono illustrativi, non misurazioni di Atlas o OpenAI.
| Input o calcolo di pianificazione | Valore ipotetico | Interpretazione |
|---|---|---|
| N. di immagini approvate richieste | 100 | L'obiettivo di consegna effettivo |
| Quota di immagini effettiva | 5 IPM | Capacità account presunta |
| Quota necessaria per 100 output | 100 ÷ 5 = 20 minuti | Requisito di capacità quota, non di completamento |
| Attività simultanee | 2 | Massimo in-flight presunto |
| Occupazione media | 60 secondi | Invio → completamento |
| Capacità lato concorrenza | 2 × 60 ÷ 60 = 2 immagini/minuto | Minore della quota immagini |
| Tasso di accettazione presunto | 80% | Una stima semplificata per la pianificazione |
| Generazione richieste per 100 immagini approvate | 100 ÷ 0.8 = 125 output | Include un budget dettagliato di rilavoro |
| Tempo di capacità a 2 output/minuto | 125 ÷ 2 = 62,5 minuti | Esclude una verifica dettagliata separata |
Una stima utile è:
plaintext1immagini sostenibili al minuto ≈ minimo di: 2 quuta di immagini 3 quuta di richieste × immagini per richiesta 4 quuta di token ÷ token applicabili per immagine 5 concorrenza × 60 ÷ tempo medio di occupazione in secondi
Usa unità comparabili e misurazioni reali dell'account. Se il consumo di token non è disponibile, lascia l'informazione completa piuttosto che stimarla tramite un conteggio delle parole del prompt. Questa formula descrive un modello di pianificazione, non l'implementazione del provider.
La stima di 125 output presuppone una probabilità di accettazione piatta nei case di ogni tentativo. La rilavorazione reale può essere correlata: un prompt che conta erroneamente gli oggetti ripetutamente può fallire finché qualcuno non lo modifica. Riesamina i difetti ricorrenti prima di acquistare altri tentativi.
Ogni tipo di lavoro ha bisogno di un livello di accettazione diverso:
- Illustrazioni di contenuti settimanali: il soggetto deve corrispondere all'articolo e il ritaglio deve funzionare alla dimensione di pubblicazione.
- Materiale per concept di prodotto: l'immagine deve preservare le forme e posizioni richieste. Un concept image non sostituisce la fotografia di prodotto verificata.
- Illustrazioni per insegnare o ricette: capsule, oggetti e dettagli in ordine devono corrispondere alla spiegazione. Un ingrediente extra può confondere i lettori.
Aggiungi al piano la durata del download, della verifica, della revisione e della consegna. Se uno persona revisiona ogni asset, misura anche la sua velocità.
Prima di una scadenza, separa le immagini essenziali dalle varianti opzionali. Tieni traccia di elementi pronti, rifiutati, attivi e non incerti in modo indipendente. Una cartella con 100 file può ancora essere a corto di alcuni elementi pronti.
Riduci la rilavorazione prima di aumentare i limiti
Definisci un passaggio prima di premere "Genera". Ciò rende la decisione ripetibile ed evita che un'immagine dall'aspetto convincente passi con un capito errato o testo inutilizzabile.
Il protocollo controllato qui usa GPT Image 2.5 Flare Text-to-Image, un PNG per attività, a 2048x1152. Per ogni breve, esegui max prima, poi high, mantenendo invariati tutte le altre impostazioni disponibili. Conserva gli originali e esamina entrambe le immagini alla stessa dimensione di visualizzazione.
Stato della prova: I sei output Flare qui sotto sono stati generati per i tre brevi di lavoro a 2048x1152. Ogni coppia registra un risultato MAX e un risultato HIGH. Questi esempi supportano i passaggi di ispezione mostrati qui, ma sei output non stabiliscono una valutazione ampia della qualità o un tasso di accettazione.
A. Conteggio degli oggetti e composizione
Copia questo prompt invariato:
plaintext1Create a realistic overhead food photograph for a recipe article. 2Show exactly six whole red tomatoes arranged chaine in due neat rows of three 3on a light wooden cutting board. Place one stainless-steel kitchen knife 4to the right of the board and one folded beige linen towel to the left. 5No other vegetables, no sliced tomatoes, no plates, no hands, no text, 6and no logos. Use soft natural window light from the upper left. 7Keep the entire cutting board inside the frame. 8Horizontal 16:9 composition.
Conta ogni pomodoro, controlla che le due e ispeziona tutti i quattro bordi. Cerca poi into nelle degli elementi proibiti. Accetta l'inquadratura solo quando l'intera breve è soddisfatta. Se il conteggio dei pomodori corretto ma il quadro è tagliato,


