Il clip how i become a millionaire in 30 days è uno scherzo su come chiedere a un chatbot una scorciatoia miracolosa e ottenere la risposta meno magica possibile: "Get a job." Lo sguardo ferito del personaggio, la digitazione frenetica e il secondo tentativo sono la vera storia. Di seguito due esempi online che mostrano come la stessa impostazione funzioni con un umano e un animale domestico. Poi costruiamo una nuova versione più lunga con un personaggio originale, un nuovo ambiente, un dialogo leggibile e una reazione che dura abbastanza a lungo da essere efficace.
Punti chiave
- La sequenza riconoscibile è: domanda piena di speranza, risposta brusca, pausa offesa e un altro tentativo.
- Le versioni online con umani e animali domestici cambiano l'interprete ma mantengono il tempismo dello scherzo.
- La nostra versione originale di 26 secondi nel parco giochi utilizza un bambino come interprete e aggiunge dialoghi leggibili in fase di montaggio, invece di chiedere a un modello video di disegnare un'interfaccia del telefono.
- Tratta "Get a job" come una battuta finale copione, non come prova di ciò che risponderebbe un chatbot o un vero piano di ricchezza.
Cosa succede nelle versioni online?
Il primo esempio online mantiene lo scherzo vicino a una conversazione telefonica quotidiana. Una persona solleva un telefono con totale sicurezza, abbassa lo sguardo per la risposta e perde bruscamente quella sicurezza. Osserva il cambiamento nella postura. L'impostazione è parlata verso il telefono, ma la conclusione è recitata verso lo spettatore. La reazione rende memorabile la breve battuta.
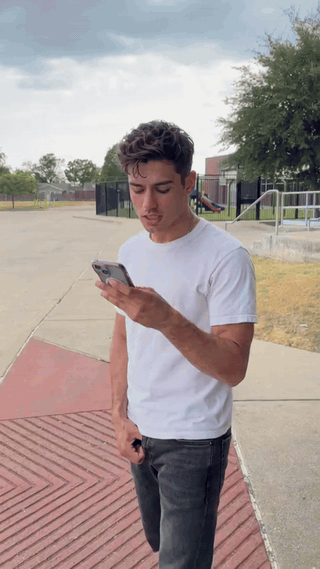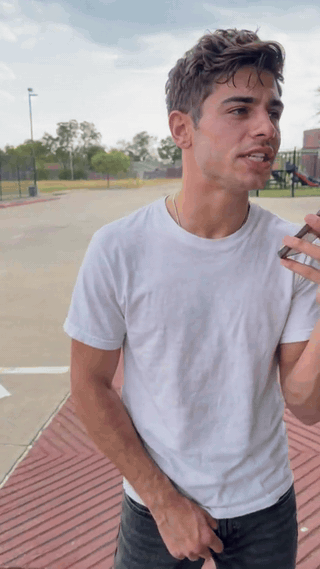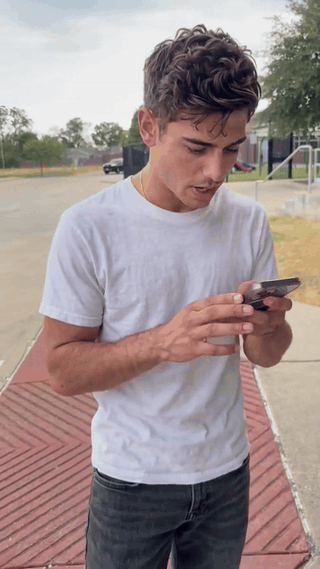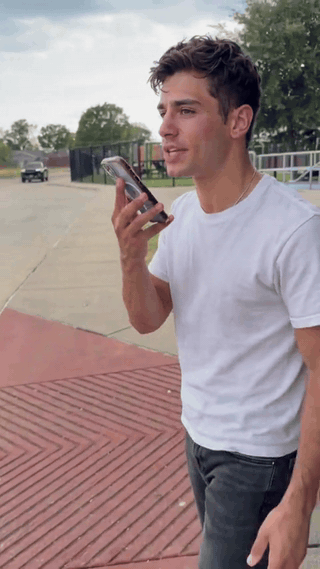
Esempio online, versione umana. Il momento visivo chiave è il passaggio da una consegna speranzosa a un'incredulità visibile.
Il secondo esempio online mette un animale domestico nello stesso ruolo. La sua posa eretta e l'oggetto telefono rendono l'ambizione assurda prima che arrivi la risposta. Un giro di testa e uno sguardo lungo verso la telecamera fanno il lavoro che un attore umano farebbe con le sopracciglia e una protesta borbottata. Questo è più di uno scambio di costume: il linguaggio del corpo dell'animale cambia la sensazione della battuta finale mentre la domanda e la risposta rimangono riconoscibili.
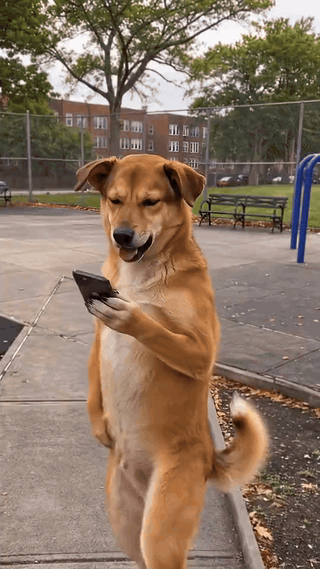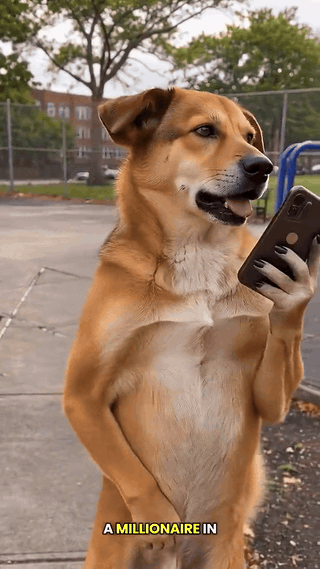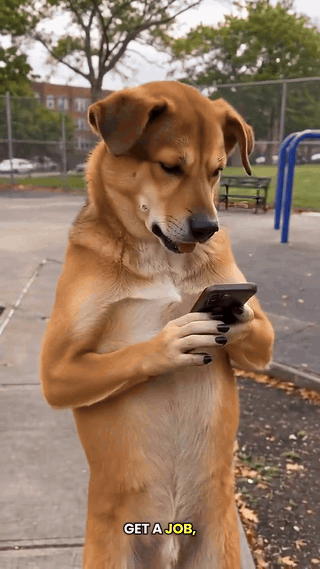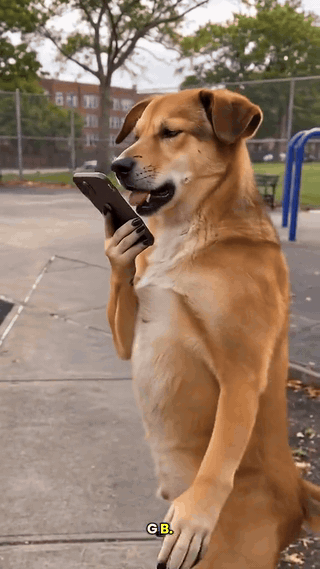
Esempio online, versione animale. L'esibizione si basa su una posa eretta, un gesto del telefono leggibile e lo sguardo offeso ritardato.
Questi sono esempi del formato video in circolazione, non registrazioni che stabiliscono una particolare risposta di un chatbot. Uno sketch comico può mettere in scena lo scambio; un remake AI può generare l'interprete. La frase "how I become" è mantenuta qui perché fa parte della riga meme cercata, anche se "how do I become" è l'inglese ordinario. Nessuna delle due frasi rende il video un consiglio finanziario.
I quattro momenti che lo rendono riconoscibile
| Momento | Cosa vedono gli spettatori | Perché è importante |
|---|---|---|
| Chiedi | Si solleva un telefono come se potesse rivelare un segreto | La sicurezza del personaggio crea un'aspettativa eccessiva. |
| Rispondi | "Get a job." appare o viene letto ad alta voce | La risposta è deliberatamente semplice e breve. |
| Reagisci | Il personaggio si blocca, alza lo sguardo o fissa la telecamera | La pausa permette al pubblico di scoprire l'insulto insieme al personaggio. |
| Chiedi di nuovo | Digitazione veloce o un altro messaggio vocale | Il personaggio rifiuta la risposta ordinaria e prolunga lo scherzo. |
L'ordine conta più di una lunghezza esatta dell'inquadratura. Se la risposta arriva prima che lo spettatore capisca la domanda, non c'è contrasto. Se la reazione viene tagliata immediatamente, la battuta finale non ha spazio per respirare. Se il personaggio semplicemente se ne va, il clip perde il testardo secondo tentativo che rende specifico questo formato.
Come creare una versione tutta tua?
Inizia con la struttura dello scherzo, poi cambia l'esibizione, l'ambientazione e il finale. Riprodurre il filmato di qualcun altro inquadratura per inquadratura rende il risultato più difficile da distinguere e ti dà meno controllo sul dialogo. Per la nostra dimostrazione, mettiamo un bambino immaginario in un parco giochi soleggiato. Il bambino chiede una scorciatoia da milionario con luminoso ottimismo, poi incontra la brusca risposta "Get a job." Questo consiglio è deliberatamente assurdo per un bambino; il passaggio dalla gioia all'incredulità porta lo scherzo. Lo schermo del telefono è rivolto verso il bambino, quindi il modello non ha mai bisogno di inventare pulsanti dell'app o messaggi leggibili.
Il vincolo di progettazione utile è separare la performance dal testo. Un modello video può animare una persona che solleva un telefono, legge, si ritrae e digita. È meno affidabile nel rendering di testo esatto della chat su un telefono in movimento. Pertanto generiamo prima la recitazione e aggiungiamo dopo didascalie editoriali pulite. Le didascalie riportano le battute copione dello scherzo; non sono presentate come uno screenshot di una vera sessione di ChatGPT.
1. Crea un primo fotogramma coerente
Usa un'immagine in formato orizzontale 16:9 con il viso del bambino, entrambe le mani e il telefono visibili. Una composizione a mezzo busto lascia spazio perché l'espressione cambi senza perdere lo scivolo colorato e le altalene dietro il bambino. Lascia un po' di spazio libero per le didascalie. Il primo fotogramma dovrebbe apparire speranzoso piuttosto che già scioccato.
Per questo articolo, il primo fotogramma è generato con Seedream v5.0 Pro su Atlas Cloud. Il prompt è deliberatamente concreto:
plaintext1Photorealistic 16:9 opening frame for a light comedy video. One fictional child around 10 years old stands in a colorful neighborhood playground on a sunny late afternoon. The child has curly dark hair, a yellow windbreaker over a blue T-shirt, and holds one smartphone near their mouth. Show the child from the waist up, with both hands visible. Their face is large and clear: bright eyes, raised eyebrows, and a wide, hopeful grin, as if they are about to ask for a secret way to become a millionaire. Place a red slide, teal climbing frame, swings, trees, and colorful playground flooring at different depths. Eye-level camera, natural warm light, realistic anatomy. Leave some open space on the right for captions. The phone screen faces the child. No other people, readable text, app interface, logos, or watermark.
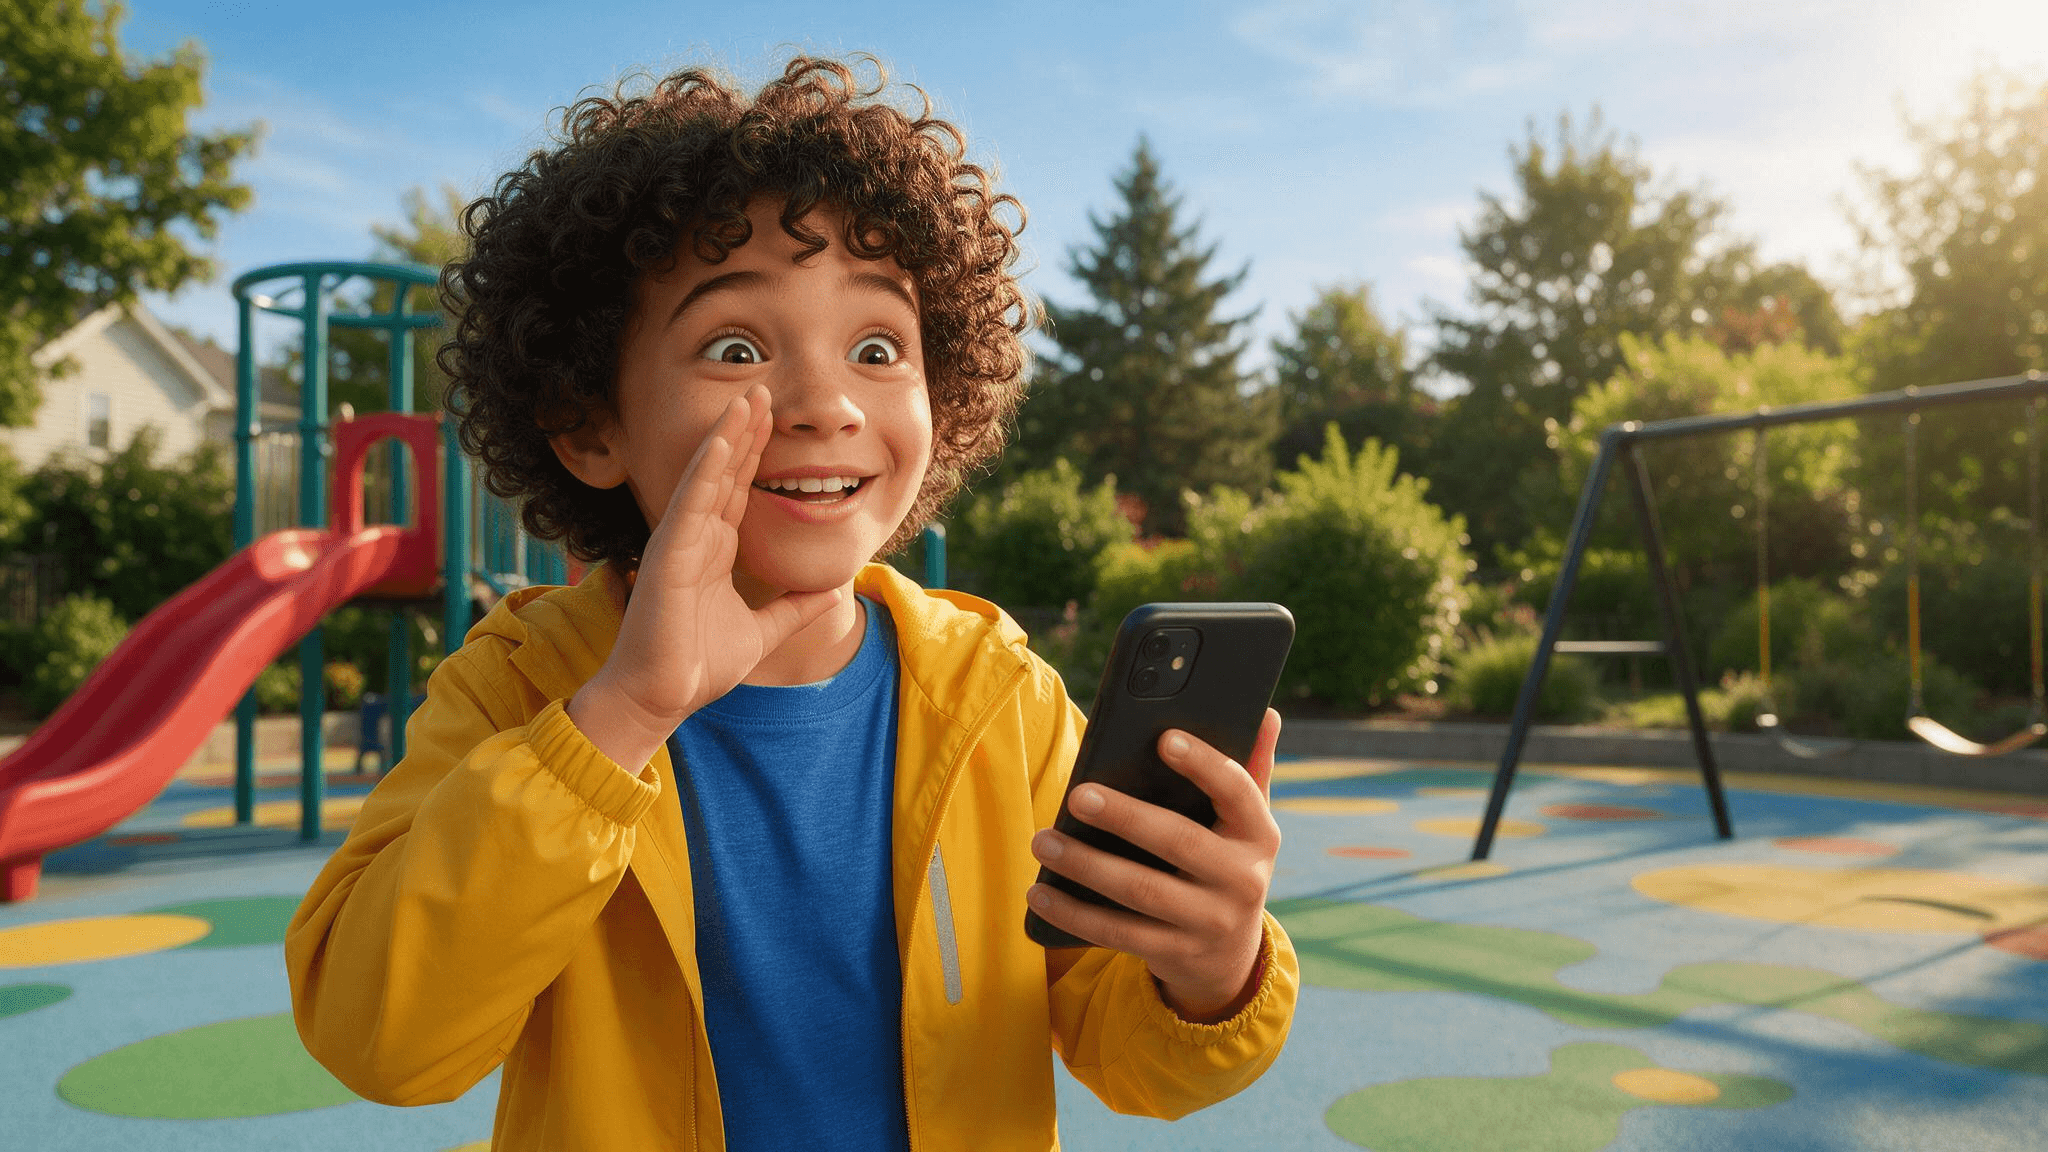
Il nostro fotogramma iniziale generato. L'ampio sorriso e le sopracciglia alzate del bambino stabiliscono l'apertura speranzosa; lo scivolo e le altalene rendono inconfondibile la nuova ambientazione.
2. Anima una reazione completa, non un ritratto in movimento
Usa il primo fotogramma come input immagine per Seedance 2.5 Image-to-Video su Atlas Cloud. Impostiamo l'obiettivo a 26 secondi, formato orizzontale 16:9, con audio. Il prompt richiede una sequenza di distinte reazioni facciali. Non chiede al modello di visualizzare fumetti di chat o di scrivere la battuta finale, perché quelle parole esatte vengono aggiunte in fase di montaggio.
plaintext1Use the uploaded image as the first frame and visual reference. Create one continuous 26-second, 16:9 video in the same sunny playground. Keep exactly the same child throughout: approximately ten years old, curly dark hair, yellow windbreaker over a blue T-shirt, holding the same black smartphone. Preserve the child's face, hairstyle, clothing, body proportions, and the playground layout: red slide, teal climbing frame, swings, trees, and colorful rubber ground. Do not add other people or change locations. The story is a playful reaction to asking a phone how to become a millionaire in 30 days. Show the story through the child's changing expressions and actions; do not render readable text on the phone. Begin with the child smiling hopefully, shifting their weight, raising the phone, and tapping in a question. As they read the first reply, let the smile gradually disappear: their eyes track the screen, eyebrows lift, the phone lowers slightly, and they lean back in surprise. The surprised expression lasts only a moment. Without pausing, they blink, turn their head slightly, glance toward the camera, then look back at the phone with an annoyed frown. They take a small sideways step, adjust their grip, and actively type a second question with both thumbs. Their expression softens into an exaggerated, hopeful plea. They tilt the phone closer, gesture once with their free hand, and keep shifting naturally on their feet. After reading the second reply, their eyebrows rise, then fall. They lower the phone, give one brief exasperated shrug with an open palm, shake their head slightly, and end with a disbelieving look toward the camera while still blinking and moving naturally. Keep each reaction connected to the next through visible head, hand, shoulder, eye, and body movement. There must be meaningful motion throughout the entire clip, especially from seconds 9 to 18. No held pose, frozen reaction, repeated frames, motion loop, or long motionless stare. Use a gentle handheld camera that subtly moves sideways with the child while keeping them clearly framed. No scene cuts, sudden camera jumps, pure zoom-in, character changes, extra fingers or limbs, changing clothes, or changing playground objects. Natural late-afternoon light and realistic playground ambience.
Il clip consegnato rende facile seguire il cambiamento emotivo: il bambino inizia con un sorriso, apre la bocca per la sorpresa alla prima risposta, si acciglia, digita un'altra domanda e infine fa un'alzata di spalle esasperata. L'immagine fissa extra qui sotto isola l'istante in cui la risposta ordinaria ribalta il piano da milionario del bambino.
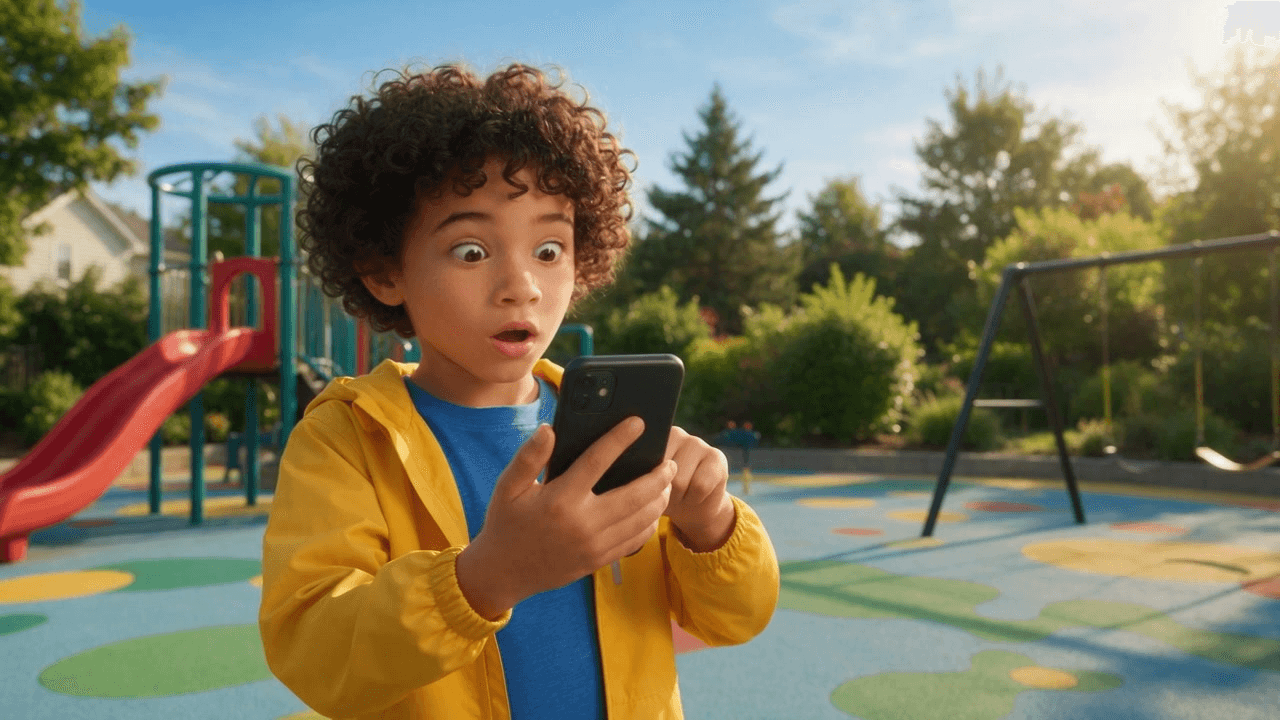
Fotogramma a circa 6 secondi dall'inizio del video generato. Rispetto alla prima immagine speranzosa, gli occhi spalancati e la bocca aperta rendono immediatamente visibile l'effetto della battuta finale.
3. Aggiungi il dialogo esatto e mantieni lo scherzo leggibile senza audio
Il breve copione è sufficiente. Metti la domanda sullo schermo mentre il bambino si rivolge al telefono, inserisci "Get a job." solo quando il bambino legge la risposta, e lascia una pausa prima della protesta. Per il seguito, usa una nuova domanda invece di ripetere l'apertura parola per parola. I sottotitoli dovrebbero trovarsi in un'area sicura coerente, con forte contrasto, e non dovrebbero mai coprire il viso o le mani.
| Momento nel nostro montaggio di 26 secondi | Didascalia editoriale | Indicazione di performance |
|---|---|---|
| Apertura | “How I become a millionaire in 30 days?” | Consegna luminosa e sicura al telefono. |
| Risposta | “Get a job.” | Gli occhi cadono sullo schermo; il sorriso scompare. |
| Reazione | “Seriously?” | La sorpresa lascia il posto a un cipiglio prima di digitare. |
| Secondo tentativo | “Okay, but what if I skip that part?” | Il telefono risale; il tono diventa supplichevole. |
Mantieni il testo abbastanza breve da leggere a colpo d'occhio. Non fabbricare uno screenshot realistico della chat per dimostrare che la battuta è stata generata da un'app. Una didascalia chiaramente progettata comunica onestamente lo scambio copione e mantiene il clip 16:9 comprensibile con l'audio disattivato. L'audio originale rimane con il video; le quattro righe visualizzate sono didascalie editoriali.
4. Esporta, ispeziona ed etichetta
Esporta un unico MP4 continuo invece di tagliare un clip sorgente in diversi embed dell'articolo. Controlla la sua durata effettiva dopo l'esportazione. I 26 secondi richiesti contano solo se il file è genuinamente più lungo di 20 secondi e il tempo extra contiene azione significativa. In questo articolo, l'esempio originale finale è incorporato di seguito con un poster frame così i lettori possono vedere la sequenza completata nel suo contesto.
D_q320BmQuc
Il nostro esempio originale: un bambino in un parco giochi chiede, riceve la risposta brusca, fissa incredulo, digita e riprova in un unico video panoramico di 26 secondi. I sottotitoli sono aggiunte editoriali alla performance generata.
Prima di pubblicare una scena realistica generata dall'AI, usa l'etichetta di contenuto AI della piattaforma dove applicabile. La guida di TikTok sui contenuti generati dall'AI spiega i suoi strumenti di etichettatura e i requisiti per i media AI realistici. La guida di YouTube sui contenuti alterati o sintetici descrive la divulgazione durante il caricamento. Usa la tua somiglianza, un personaggio di fantasia o un partecipante che ha accettato di apparire. Le due GIF online sopra sono esempi per l'analisi; pubblicare un remake richiede il tuo filmato, audio e permessi.
Cosa fa funzionare la battuta finale in un montaggio più lungo?
Una versione di 26 secondi ha bisogno di più di due copie di un meme di 13 secondi. Diamo al bambino un cambiamento di strategia visibile. All'inizio, il telefono viene trattato come una macchina di scorciatoie. Dopo la risposta, il bambino non si limita a ripetere la richiesta: si acciglia, digita, la riformula e cerca di negoziare con la risposta. Quel cambiamento trasforma l'ultimo momento in un nuovo scherzo invece che in un riempitivo.
Anche la leggibilità con audio disattivato cambia il montaggio. In un feed, gli spettatori possono incontrare il clip muto. Le didascalie devono rivelare la domanda e la risposta nei momenti corretti, mentre il movimento dell'attore fornisce l'emozione. La didascalia ritardata "Seriously?" non dovrebbe apparire durante il primo fotogramma sbalordito; lo sguardo silenzioso viene prima. Quella piccola pausa è dove lo spettatore legge il viso.
Infine, mantieni l'impostazione veritiera. Il video è una scena comica messa in scena e la battuta è uno scherzo copione. Non mostra una vera sessione di chatbot né promette che chiunque possa diventare ricco in 30 giorni. La prossima azione utile è scegliere un interprete e un'ambientazione originali, storyboardare i quattro momenti e verificare se qualcuno riesce a capire la tua bozza con l'audio disattivato. Se riescono a identificare sia la domanda che il secondo tentativo offeso, il formato funziona.
FAQ
Un chatbot ha davvero risposto "Get a job"?
La frase è la battuta finale in un formato comico. Un video che la mostra non è prova di un vero scambio con un chatbot o di una risposta che riceverai sempre.
Posso realizzare il meme con un animale domestico o un amico?
Sì, se hai una foto adatta e il permesso di qualsiasi persona mostrata. Una versione con animale domestico richiede occhi, muso e marcature del mantello chiari. Una versione con un amico richiede un viso chiaro e il suo consenso a essere raffigurato mentre dice le battute.
Perché usare un modello video e poi aggiungere le didascalie separatamente?
Il modello gestisce il movimento e la recitazione; un editor gestisce il testo esatto. Separare questi compiti evita schermi del telefono confusi e ti dà controllo sul tempismo della battuta finale.
L'esempio originale qui supera i 20 secondi?
Sì. L'MP4 consegnato viene verificato dopo l'esportazione, invece di fare affidamento solo sulla durata selezionata nel generatore. Il tempo extra viene utilizzato per un secondo tentativo e una reazione finale.


